重力模型看丢的远途客流,公开照片能补回来吗?
论文名片|Mariano G. Beiró、André Panisson、Michele Tizzoni、Ciro Cattuto,Predicting human mobility through the assimilation of social media traces into mobility models,EPJ Data Science,2016,5:30。2016年5月17日收稿,2016年10月13日接受;期刊页面记载2016年10月21日在线发表。DOI:10.1140/epjds/s13688-016-0092-2。本文依据该开放获取正式版解读。
从旧金山出发的国内航班,客流最大的方向包括洛杉矶、圣迭戈、拉斯维加斯和西雅图。只按两地人口和距离来估,这些方向大体还在,飞向东海岸的客流却偏少。这是论文航空地图里的对照。Flickr 上带地理坐标的照片,把用户在不同地区之间的出现记成一张流量表,再和引力模型(gravity model,也称重力模型)线性相加。在留出的官方正流量上,航空网络的决定系数从 0.40 提高到 0.72。
这个提高有明确的记账方式。留出的是官方旅客数;同一对起讫点的照片用户数仍然拿来当输入。被评分的也只是官方流量已经为正的起讫对。照片用户是愿意公开地理照片的人,流量提高描述的是这些正流量的数值更接近了,还没有单独证明一张照片对应一名旅客。
先说结论
- 十折交叉验证中,混合引力模型相对单独的引力模型:航空相关系数从 0.68 升到 0.84,决定系数从 0.40 升到 0.72;县际通勤相关系数从 0.69 升到 0.79,决定系数从 0.41 升到 0.62。样本是官方流量为正的连边,每条连边被留出测试一次。
- 只用照片用户数、再乘一个比例常数,航空决定系数是 0.62,高于拟合后的引力模型 0.40;通勤是 0.47 对 0.41。
- 只保留真实流量超过 1000 的起讫对时,航空决定系数从引力模型的 0.28 升到混合引力模型的 0.66;通勤从 0.34 升到 0.43。
- 照片模型稳定超过引力模型的训练比例,航空不到 1%,通勤大约 10%。航空上把相对训练集从 1% 增到 3%,混合引力模型的决定系数从 0.4 升到 0.6,引力模型基本停在原处。
- 通勤预测里,照片与辐射模型的组合最好,相关系数 0.85、决定系数 0.73。航空预测里,照片与引力模型的组合最好。单独的辐射模型在航空上决定系数是 −0.21,而且没有做交叉验证。
要预测的是两套官方正流量
人类移动性(human mobility)在这里指人群在空间中的移动。论文同时看两种尺度:美国国内航空,以及县与县之间的每日通勤。分析单位是起讫点对上的流量,也就是一段时期内汇总起来的人数。
航空来自美国交通统计局的 Airline Origin and Destination Survey,文中称 RITA 数据。使用的是 2014 年、全部国内行程的 10% 样本,约 1400 万张机票,涉及 466 个机场。一张机票可以有多段航程。作者去掉只作经停的机场,保留旅客真正停留的行程断点,以免枢纽机场被写成目的地。相距不足 30 公里的机场先合并,因为它们服务同一都市区;这种合并也沿用到彼此都不足 30 公里的一组机场。合并之后,按“每个地点划给最近的机场”把美国分成机场盆地(airport basin)。
通勤来自美国人口普查局 2009–2013 年的县际估计,资料规模约为 1.4 亿名通勤者。节点是县。连边权重是居住在其中一县、工作在另一县的估计人数。县界使用普查局 MAF/TIGER 地理库。
两条对角线都被置零:同一机场盆地内部的飞行、居住县和工作县相同的通勤,不进入后文的流量矩阵。清理后的规模是:
| 官方矩阵 | 节点 | 正流量连边 | 流量规模 |
|---|---|---|---|
| 航空 Yr | 204 个机场盆地 | 30,472 | 约 4000 万次流量 |
| 通勤 Yc | 3,144 个县 | 55,578 | 约 3700 万名通勤者 |
约 4000 万次航空流量和约 1400 万张机票是两个计数:前者是去掉经停、合并近距离机场之后,矩阵里累计的旅客流量。约 3700 万名通勤者是跨县连边上的规模;约 1.4 亿是普查通勤资料本身的规模,同县通勤已经在矩阵里被置零。后文的相关系数和决定系数,分母都是这些正流量连边:航空 30,472 条,通勤 55,578 条。流量为零的县对和机场对不在这几项指标里。
文末参考文献 40 和 41 的题名、网址,与方法部分的对应关系是对调的:方法写明航空调查属于交通统计局,通勤估计属于普查局。本文按方法部分记这两套数据。
照片提供的是跨盆地用户数
照片来自 Yahoo Flickr Creative Commons 100M 公开数据集中、在美国拍摄、带时间戳和地理坐标的图片:约 4 万名用户、约 1800 万张。正文没有给出这批照片的起止年份。
在机场尺度或县尺度上,同一用户按拍摄时间排列的照片中,前后两张落在不同盆地,就记一次跨盆地移动,再把所有用户汇总。矩阵元素是在这对盆地之间出现过这种移动的用户数。同一盆地内的连续照片不计数,对角线同样为零。矩阵里记下的是公开了地理照片的用户数。机票张数和通勤调查人数记在官方矩阵里。
汇总之后,机场盆地之间约有 35 万次这样的移动,县与县之间约有 52 万次。非零连边分别约 2.6 万条和 15 万条。县尺度上,照片非零连边约 15 万条,官方通勤正流量连边是 55,578 条。两边的重合有多少,正文没有报告。模型评分时只使用官方流量为正的连边,所以多出来的照片连边不会因为“官方记录为零”而单独被罚分。
同一用户的照片距离可以从几米到几千公里,分布拖着长尾,并带有指数截断。这条分布的具体形状在补充材料里,正文没有给出指数。若不加筛选,市内走动、通勤和长途旅行会混在同一张表里。作者在补充材料里比较距离阈值,正文采用两条规则:通勤只保留 100 公里以内,航空只保留 500 公里以外。纽约市那张地图是例外,图注写明照片流量没有使用距离上限。
两个模型先各自拟合,再决定权重
引力模型要回答的是:只知道盆地人口和盆地之间的距离时,流量该怎么分配。它写成
gᵢⱼ = K × Pᵢᵅ × Pⱼᵞ / d(i,j)ᵝ。
Pᵢ、Pⱼ 是起点和终点盆地的人口,d(i,j) 是两地距离,K、α、γ、β 是拟合参数。航空使用距离的幂律衰减。通勤改用指数衰减 e^{−βd},因为这种写法在通勤数据上结果更好。人口取自 GeoNames,一个盆地的人口是盆地内所有城市人口之和。这个质量和通勤矩阵里的就业人数、航空矩阵里的旅客数,是三种不同的人。正文没有公布拟合出来的 α、β、γ。
照片模型更直接:某对盆地的预测流量与照片用户数 fᵢⱼ 成正比,全表共用一个比例常数。它能把已经出现在照片里的连边缩放到官方人数的量级;fᵢⱼ 为 0 时,这一项不提供额外目的地。
混合模型把两者相加:
hᵢⱼ = A × gᵢⱼ + B × fᵢⱼ。
A、B 也是拟合参数。做法是堆叠回归(stacked regression):引力模型和照片模型先各自拟合,再用线性回归决定两个权重。损失是官方流量 Y 和预测 H 之差的 Frobenius 范数,也就是把纳入计算的每条连边的误差平方相加再开方。稀疏矩阵上只计算官方流量为正的连边。单独的引力模型相当于 A = 1、B = 0;单独的照片模型相当于 A = 0、B = 1。正文同样没有给出 A、B 的数值。
人口和距离给出一条平滑的基线,照片用户数修正基线对不上的起讫对。相加得到的是两项预测的线性权重;交互项和出行决策机制都留在这个式子之外。
辐射模型(radiation model)在文中作为对照。它把出行看成受到沿途机会影响的过程:从起点到终点的流量,依赖起点的总流出、两地人口,以及以起点为圆心、半径到达终点、又不把两端人口重复计算的圆内人口。起点总流出按该地人口的一个比例计算。原模型不用出行数据拟合参数,所以表中的单独辐射模型没有做交叉验证。照片与辐射模型的组合方式与混合引力模型类似,细节在补充材料。
留出的是官方人数,照片计数仍然在场
模型要看的是没在训练里见过的官方流量。十折交叉验证把正流量连边分成 10 份。每一折用 10% 做测试、90% 做训练,每条连边恰好被测试一次。测试时不使用这条连边的官方人数,但这条连边的照片用户数、两端人口和距离仍然是输入。照片模型的输入就是这条起讫对自己的用户数。用户数为 0 时,照片项不再提供目的地信息,预测回到人口和距离的基线。
另一套检验用重复随机抽样,用来改变训练集占全部正流量连边的比例。它和十折里固定使用 90% 连边训练,是两次实验。十折在正流量连边里随机划分。按州或按城市整块留出的检验写在补充材料的地理空间验证里,正文没有写出具体留出规则。
评价指标有两个。相关系数 ρ 看预测和真实流量是否同步升降。决定系数 r² 看预测解释了多少真实流量的方差,分母是被纳入比较的那些正流量。r² 和 ρ 的平方可以不一致:预测整体偏大或偏小时,相关系数仍可以不低,决定系数会更低。辐射模型在航空上的 ρ = 0.47、r² = −0.21 就是这种分离。负的决定系数表示,相对“用这些正流量的平均值去猜”,该模型的误差更大。
| 模型 | 通勤 ρ | 通勤 r² | 航空 ρ | 航空 r² |
|---|---|---|---|---|
| 引力模型 | 0.69 | 0.41 | 0.68 | 0.40 |
| 辐射模型(未做交叉验证) | 0.78 | 0.60 | 0.47 | −0.21 |
| 照片模型 | 0.69 | 0.47 | 0.78 | 0.62 |
| 混合引力模型 | 0.79 | 0.62 | 0.84 | 0.72 |
| 混合辐射模型 | 0.85 | 0.73 | 0.80 | 0.64 |
除单独的辐射模型外,表中数字都来自十折交叉验证。通勤上,照片模型的相关系数与引力模型同为 0.69,决定系数高 0.06(0.47 对 0.41)。航空上,照片模型的决定系数 0.62,比引力模型的 0.40 高出 0.22。混合之后,航空的增益更大:决定系数增加 0.32(0.72 对 0.40)。通勤的混合引力模型增加 0.21(0.62 对 0.41),仍低于混合辐射模型的 0.73。
远距离上,预测比值落在 0 的哪一侧?
下图只画真实流量超过 100 人的连边。纵轴是预测流量除以真实流量之后的对数:0 表示预测等于真实值,负值表示预测偏小。横轴在通勤面板是 0 到 100 公里,在航空面板是 500 到 5000 公里,与前面的距离筛选一致。颜色是落在某个距离和比值格子里的累计流量,色标标出 10、1000 和 10000。箱线表示四分位距。全部预测都来自十折交叉验证。
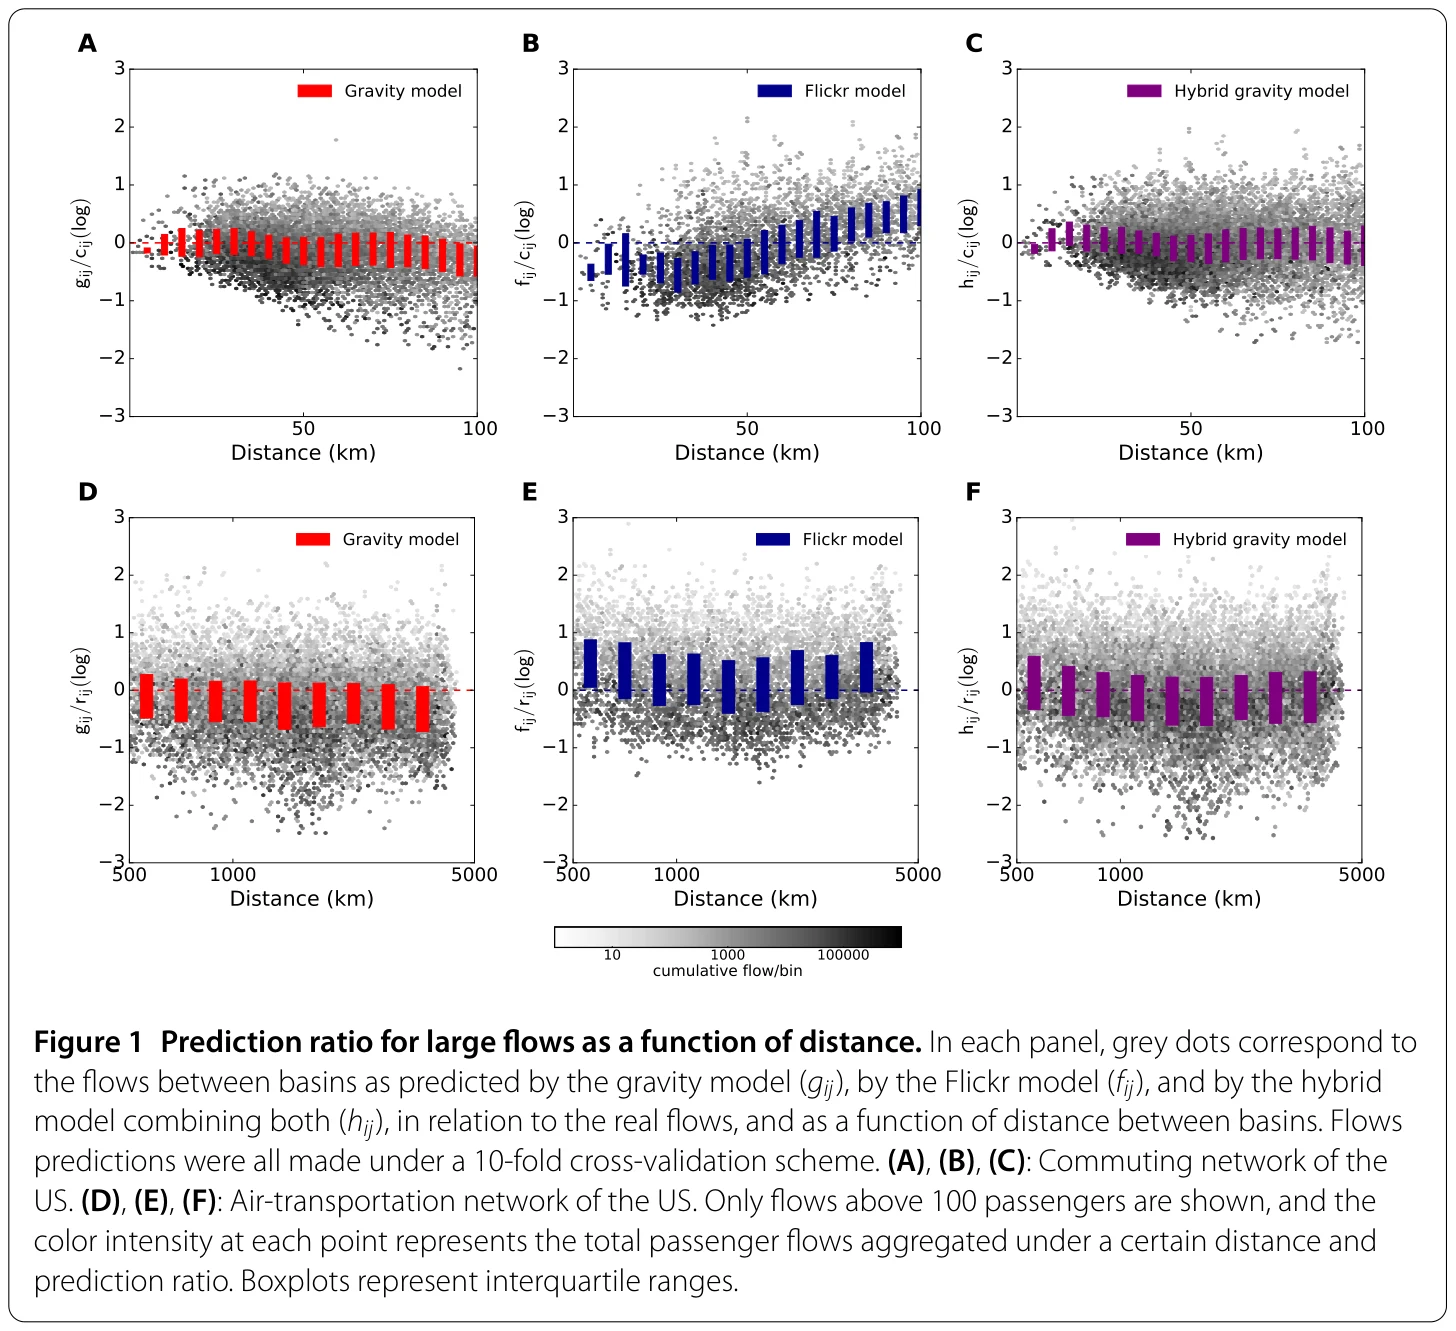
图 1|大流量的预测比值如何随距离变化?
(A)美国通勤,引力模型。100 公里以内的箱线贴近 0,右端略偏低。(B)美国通勤,照片模型。箱线随距离从 0 以下升到 0 以上,短距离偏小、接近 100 公里时偏大。(C)美国通勤,混合引力模型。箱线比(A)更集中在 0 附近。(D)美国航空,引力模型。500 到 5000 公里的箱线整体低于 0,长距离仍偏小。(E)美国航空,照片模型。箱线围绕 0,散点上下都很宽。(F)美国航空,混合引力模型。箱线回到 0 附近,单条连边的散点仍然很散。来源:原论文 Fig. 1。
(B)说明照片流量的距离衰减更慢,也说明它在 100 公里窗口内部先偏小、后偏大。(D)和(F)对应正文的判断:引力模型少估相距较远的大流量,混合之后这种整体偏低减弱。纵轴从 −3 到 3,箱线靠近 0 时,许多连边仍然偏离很远。
纽约州和两条航线,差在邻近还是更远的地方?
整体相关之外,论文用地图看流量落在哪里。纽约州这张图的颜色表示从各县到纽约市的每日通勤规模,色标从 10⁰ 到 10⁵。五个行政区合并后涂黑。
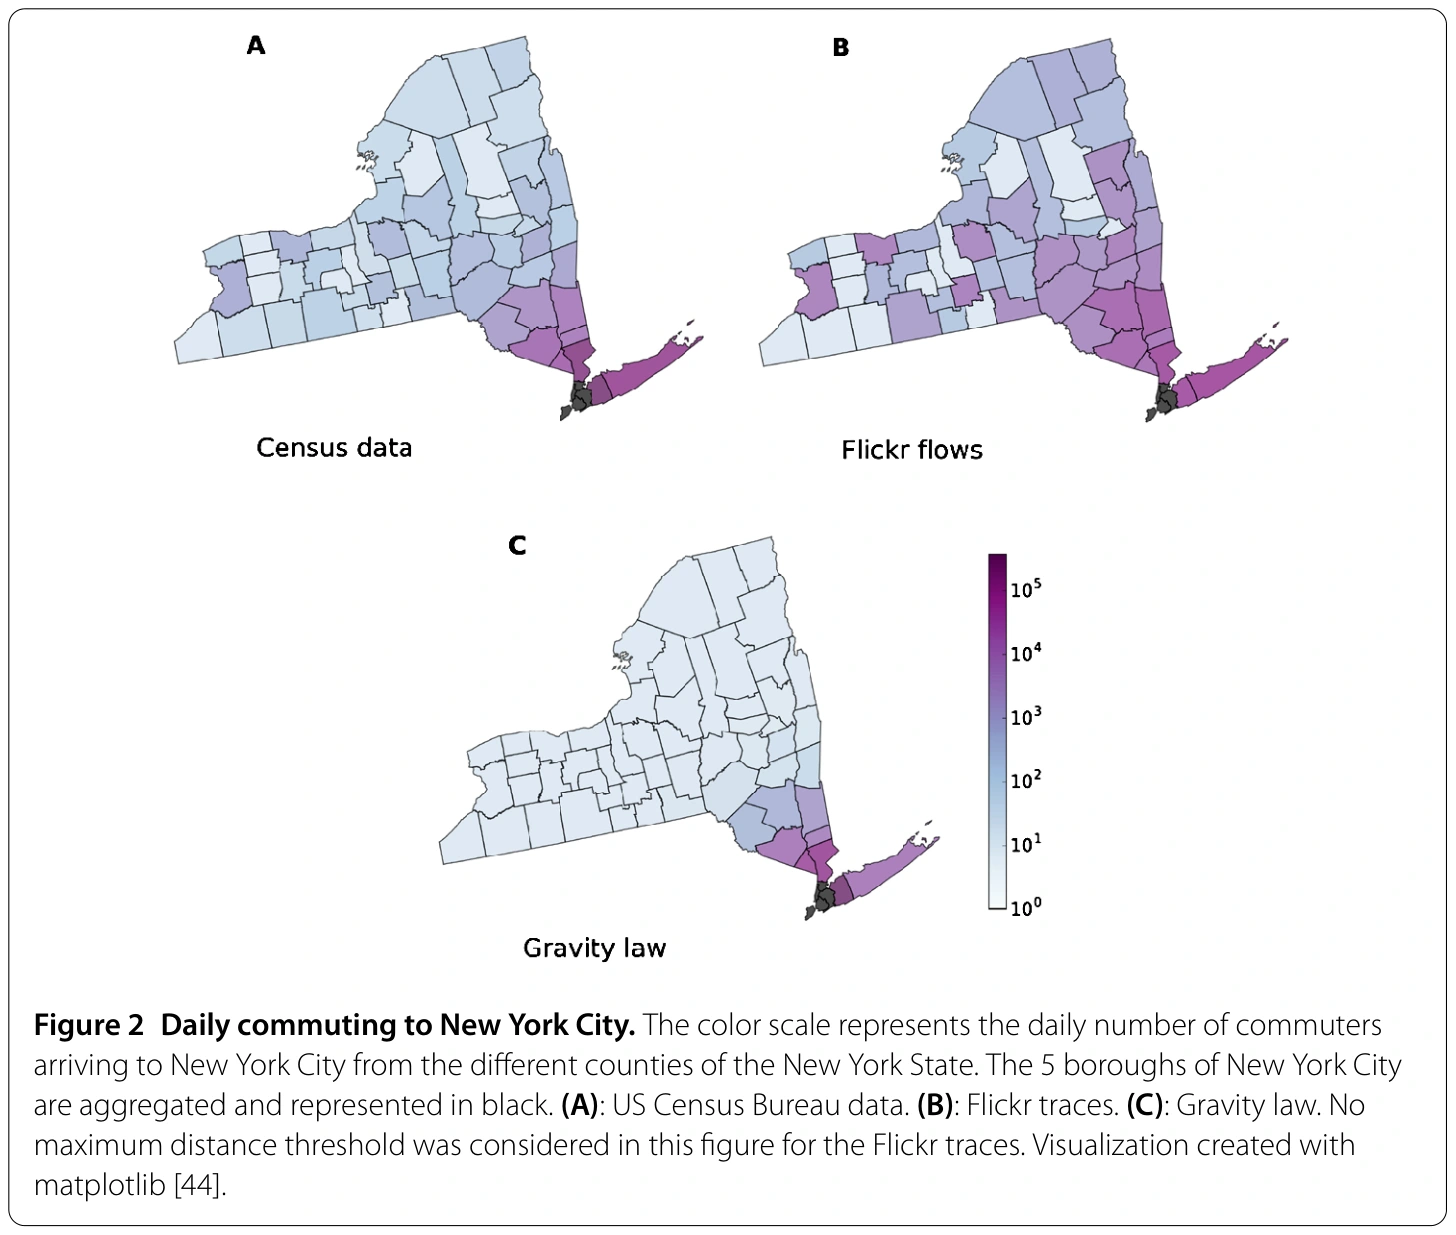
图 2|到达纽约市的通勤,远县是否还看得到?
(A)普查通勤。颜色主要留在纽约市附近,部分中距离县仍有浅色。(B)Flickr 流量。更远的县也出现较深的颜色;这张图没有使用 100 公里上限。(C)引力模型。颜色收缩到纽约市邻近县,远县几乎与底色相同。来源:原论文 Fig. 2。
正文写,邻近县流量占通勤流量的 95% 以上,引力模型抓到了这一部分,同时少估更远的流量;Flickr 的距离衰减更慢,空间形态更接近普查。95% 没有附带“邻近”的公里切分。(B)的图例是 Flickr flows,统计的是照片用户;(A)是通勤人数。三张图放在同一条 1 到 10 万的色标旁,适合比较远近形态,不宜把(b)的颜色深浅读成与普查相同的人数。
航空地图换了两个锚点:从旧金山出发,以及到达迈阿密。色标是每个盆地 10 到 100000,左右两列各自一条。范围是美国本土。
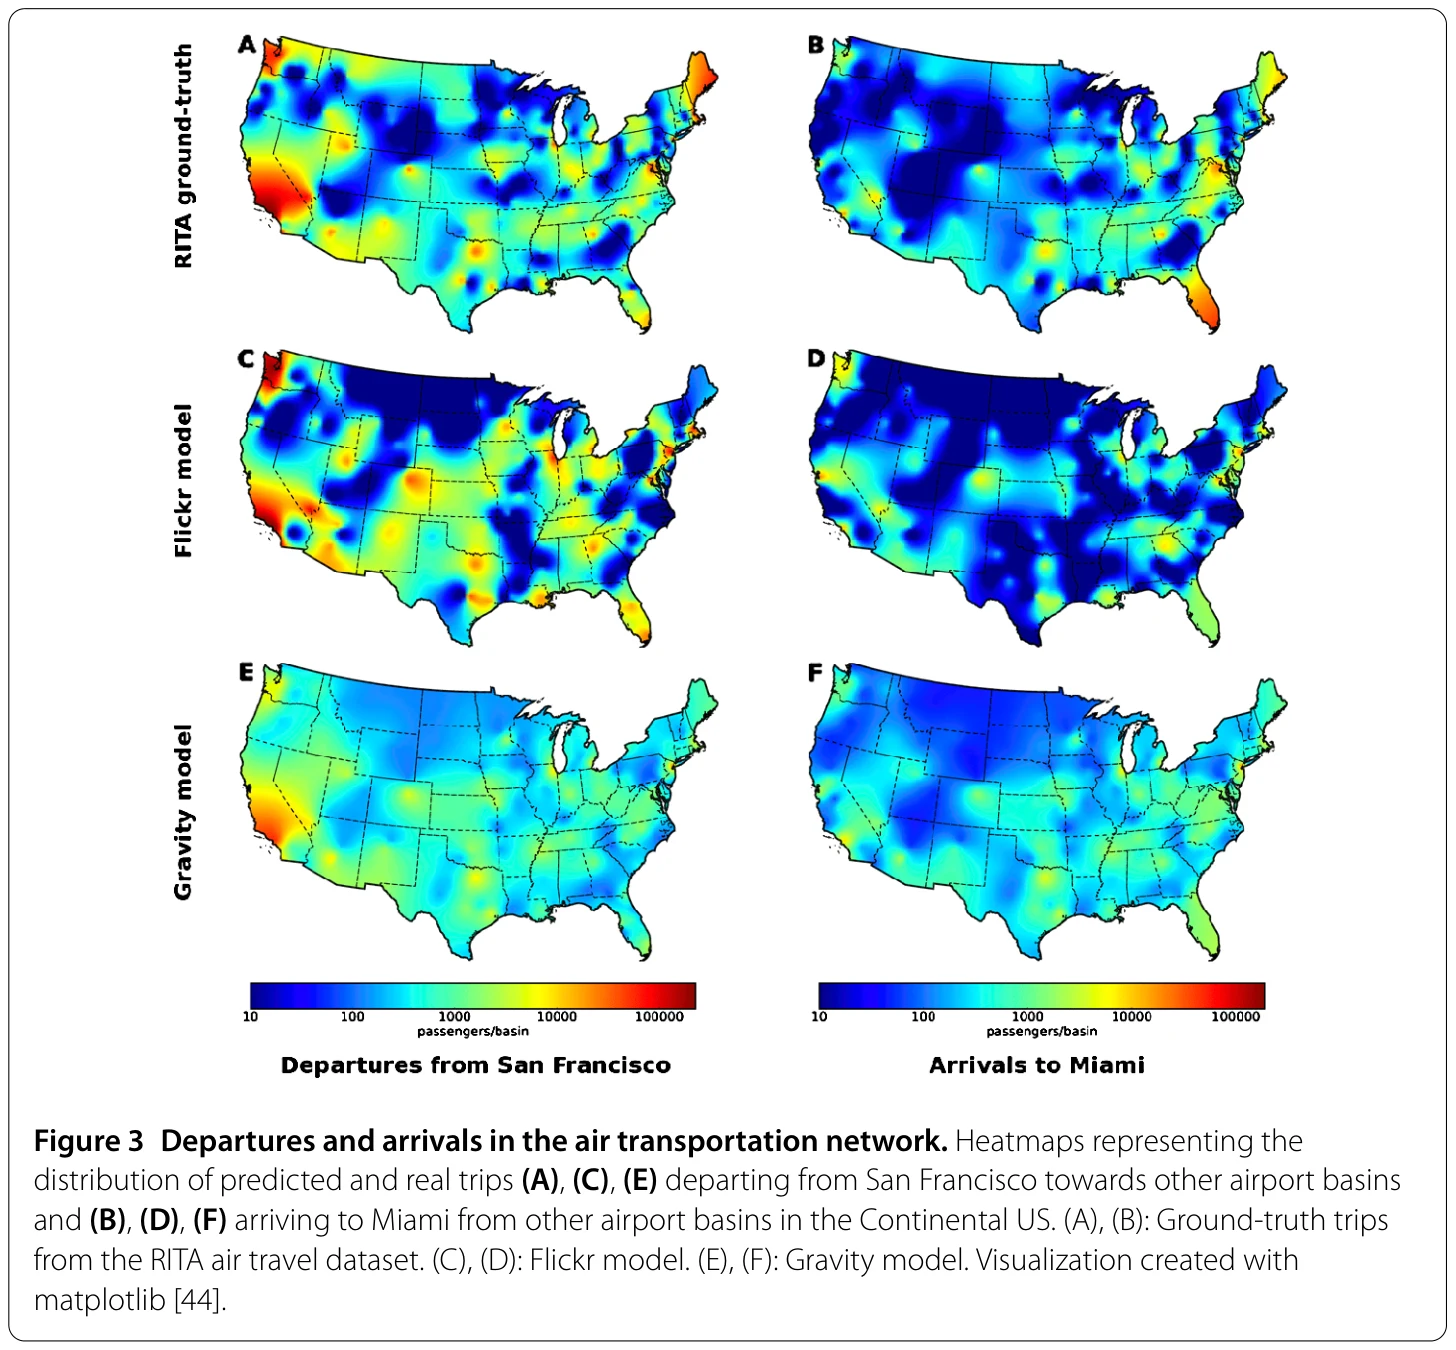
图 3|旧金山出发和迈阿密到达的空间分布是否一样光滑?
(A、C、E)从旧金山飞往其他机场盆地。(B、D、F)从其他盆地飞到迈阿密。(A、B)是 RITA 官方行程。(C、D)是照片模型。(E、F)是引力模型。来源:原论文 Fig. 3。
(A)里旧金山向加利福尼亚、内华达一带和东海岸都有高值。(E)保留了洛杉矶、圣迭戈、拉斯维加斯和西雅图这些大方向,东海岸整体更淡。正文据此说引力模型少估了东海岸。(B)和(F)在迈阿密这一侧更接近,正文称引力模型在这里表现较好,没有给出单独的相关系数。(C、D)的照片模型覆盖范围更广。色标文字写的是 passengers/basin;照片那一行仍是照片模型的空间分布,颜色深浅不宜换算成机票人数。
流量越大,箱线越贴住对角线
把每一对节点的预测和真实值放在对数坐标里,对角线表示完全相等。灰度是每个格子里的节点对数量,色标为 10、100、250。箱线是该流量区间内的四分位距。
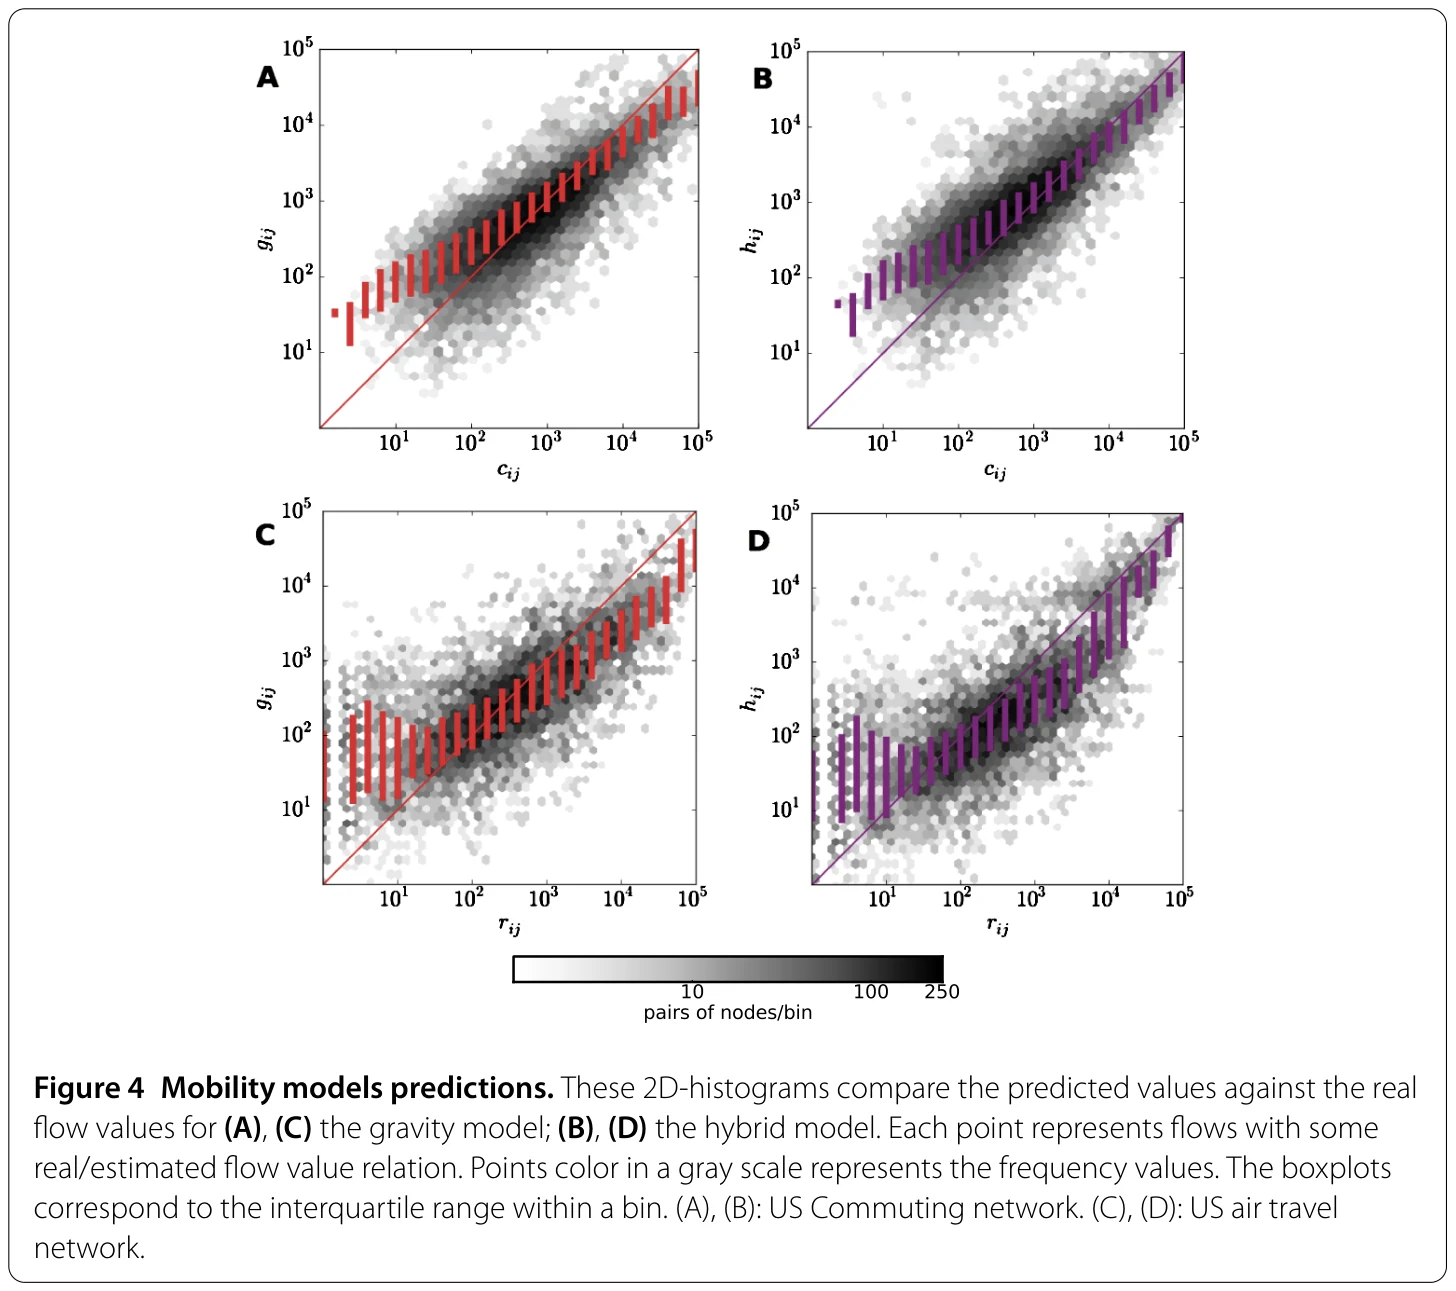
图 4|大流量一端,混合模型是否更贴近真实值?
(A)通勤,引力模型预测 gᵢⱼ 对真实通勤 cᵢⱼ。小流量处箱线常在对角线上方,大流量处围绕对角线。(B)通勤,混合模型 hᵢⱼ 对 cᵢⱼ。右端箱线更短,也更贴对角线。(C)航空,引力模型 gᵢⱼ 对真实航空流量 rᵢⱼ。大流量一端仍有偏离,散点在对角线两侧都很宽。(D)航空,混合模型 hᵢⱼ 对 rᵢⱼ。大流量箱线收短并向对角线靠拢。来源:原论文 Fig. 4。
正文的读法是:多数流量区间的四分位距平均看来变化不大,变化出现在图的右侧。混合模型对大流量同时更集中、也更接近真实值。小流量的云团仍然很宽,整体决定系数的提高集中在大流量连边。
这个判断可以沿流量阈值再切一刀。下图(A、B)的横轴是流量阈值,纵轴是真实流量高于该阈值的那些连边上的决定系数。
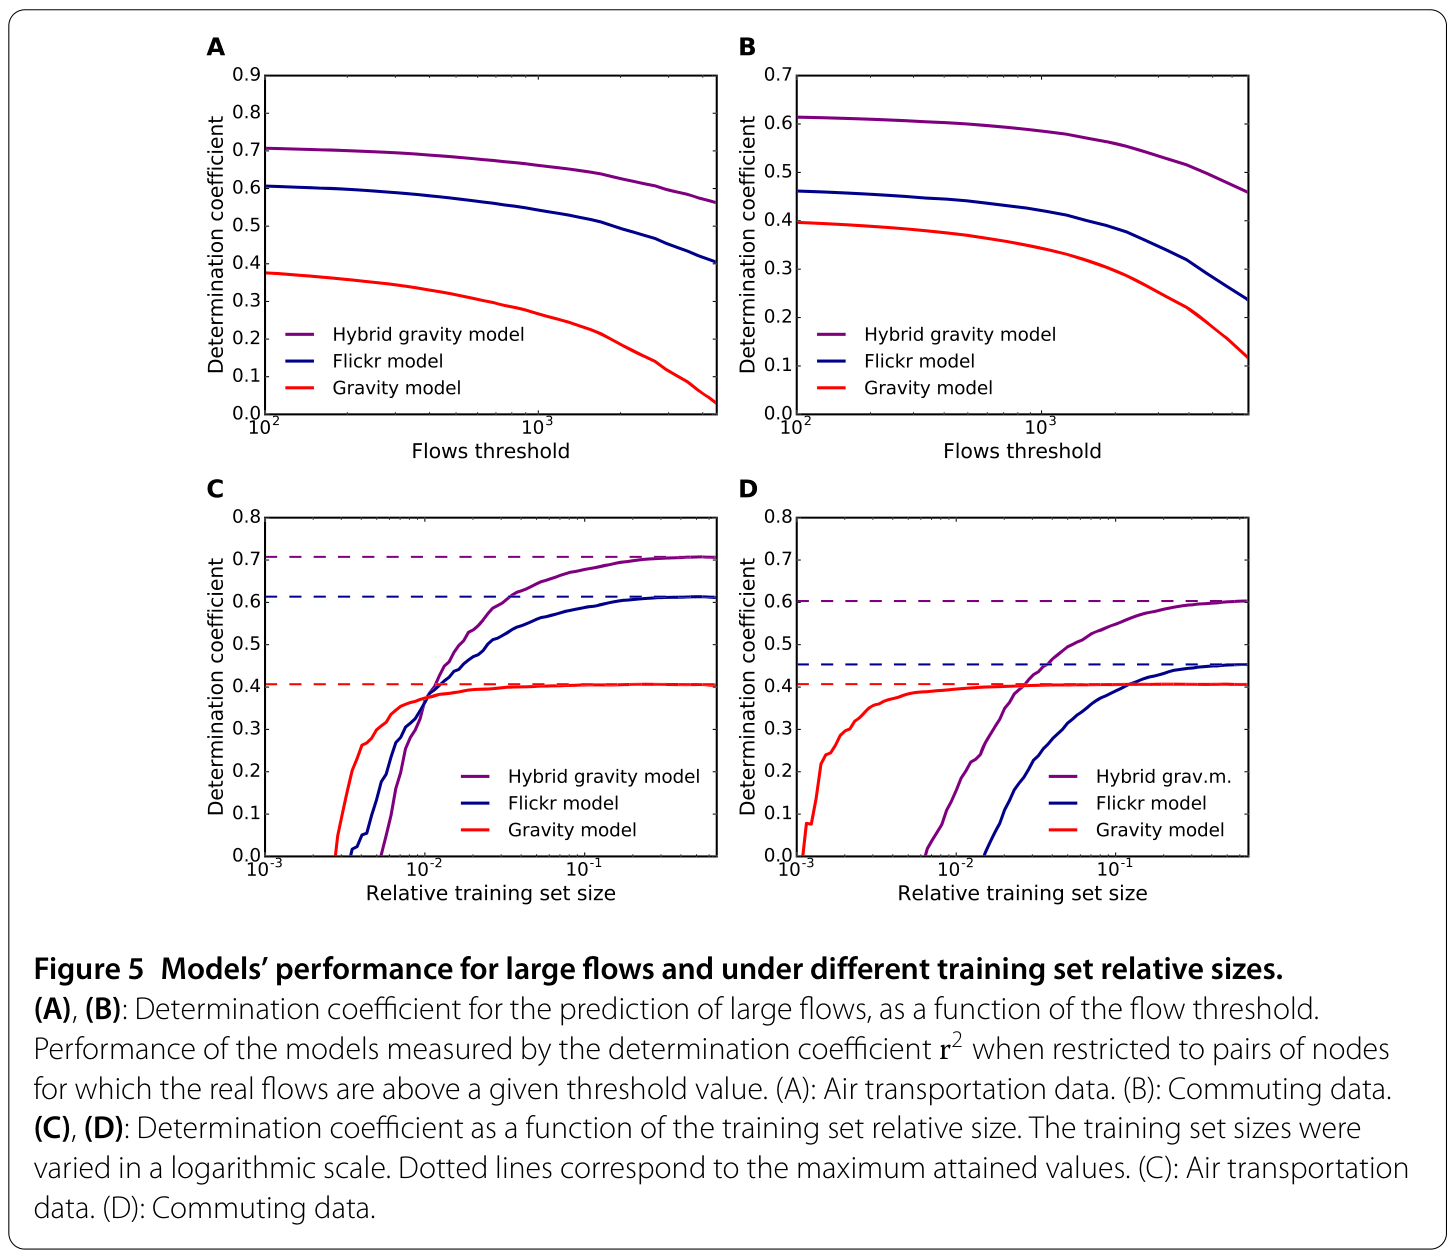
图 5|只留下大流量,或者只拿出一小部分连边训练,决定系数怎么走?
(A)航空。紫线是混合引力模型,蓝线是照片模型,红线是引力模型。三条线都随阈值升高而下降,红线下降最多。(B)通勤。同样是混合模型最高、照片模型居中、引力模型最低,过了大约 10³ 之后红线下降更快。(C)航空,横轴是相对训练集大小,按对数刻度变化。虚线是各模型在这次实验里达到的最高决定系数。红线很快进入平台;蓝线和紫线在更大的训练比例上超过红线。(D)通勤。红线在很小的训练比例上就接近自己的虚线;蓝线和紫线上升更晚,随后超过红线。来源:原论文 Fig. 5。
正文给出两个切点,分母都是真实流量高于阈值的起讫对。航空流量高于 1000 时,决定系数从引力模型的 0.28 升到混合引力模型的 0.66。通勤高于 1000 时,从 0.34 升到 0.43。航空的增益明显大于通勤。正文给出的决定系数就是这两个切点。
官方流量只拿出一小部分时,谁先到平台?
(C、D)的横轴是训练连边占正流量连边的比例。引力模型用不到 1% 的连边就接近自己的最好成绩,继续增加训练连边,决定系数几乎不再上升。照片模型和混合模型随训练比例上升,与引力模型的差距在训练比例只增加一点时就已经出现。
照片模型稳定高于引力模型的那个比例,航空不到 1%,通勤大约 10%。在这个比例以下,图里红线可以先高于蓝线:比例常数和混合权重还不稳定时,人口与距离的基线先可用。航空上把相对训练集从 1% 增到 3%,混合引力模型的决定系数从 0.4 升到 0.6,引力模型保持不动。0.4 和 0.6 是正文对这次抽样实验的记法,和十折表里的 0.40、0.72 属于两套验证。
因此,“少量官方数据加上照片”有一个具体范围。航空上,大约百分之一到百分之三的正流量连边,就足够把混合模型推到 0.6 的决定系数。通勤上,照片模型要到大约一成连边之后才稳定超过引力模型。两条曲线都不能外推成“完全没有官方流量时,全国任何城市都达到表中的成绩”。完全不使用官方流量、只保留照片模型时,能直接引用的是十折表:航空 r² = 0.62,通勤 r² = 0.47,而且测试连边的照片用户数仍然是输入。
通勤和航空选中的组合并不相同
辐射模型只用人口和空间上的介入机会,不按出行数据拟合。它在通勤上达到 ρ = 0.78、r² = 0.60,决定系数高于引力模型的 0.41;在航空上 r² = −0.21,比用这些正流量的平均值去猜更差。正文的解释是:航班目的地更依赖城市规模或人口,辐射模型所依据的沿途机会对不上长途航空。这个负值没有经过交叉验证。
把照片并进辐射模型之后,通勤决定系数升到 0.73,是表中通勤的最高值;航空升到 0.64,仍低于混合引力模型的 0.72。尺度因此直接决定该用哪一个组合:县际通勤更适合“辐射模型 + 照片”,国内航空更适合“引力模型 + 照片”。更多对比图在补充材料中。
正文还用 Sørensen-Dice 系数按距离和人口给模型打分,并写道:混合引力模型的最高表现出现在流向人口较多的盆地时。系数本身和地理空间验证的数值都在补充材料中,这里只保留这句方向。
这些提升能覆盖的范围
相关和拟合发生在连边的流量数值上。模型把照片用户数、城市人口之和与官方人数对齐,没有证明人们因为拍照才出行,也没有证明引力公式是出行决策的机制。堆叠回归给出的是线性权重;正文把更复杂的同化方法留给后续工作。
评分连边必须已经有正的官方流量。官方为零、只在照片里出现的连边,不在十折的损失里。随机划分连边时,相邻县或相似航线可以一边训练、一边测试。地理空间验证写在补充材料里,十折成绩对应的是连边随机划分。
约 4 万名照片用户,相对约 3700 万名跨县通勤者和航空矩阵中的旅客,是会公开地理照片的一小群人。连续两张照片位于不同盆地,中间可以是飞行、驾车、步行或长时间停留后再拍摄。100 公里和 500 公里是为了让照片流量与两类官方数据更一致而设的筛选;纽约市地图故意不用通勤上限,所以那张图里的远县颜色包含筛选前的多种活动。
航空是 2014 年的 10% 机票样本,通勤是 2009–2013 年的估计,照片年份未在正文给出。三者的时间并不对齐。盆地人口是 GeoNames 城市人口之和,未收入该库的居民不会进入这个质量。它和通勤者人数、旅客人数是三套计数。
作者在讨论里认为,这种同化可以进一步用于疫情、灾害响应和城市服务。那是对用途的展望。本文的证据停在两类美国官方正流量的预测成绩上。
一句话总结
在美国 30,472 条航空正流量和 55,578 条跨县通勤正流量上,把 Flickr 的跨盆地用户数线性并入引力模型或辐射模型,能提高留出连边的流量预测,并减轻引力模型对远距离大流量的少估;成绩依赖这些连边已被照片记录,也依赖尺度选择,通勤与航空的最佳组合并不相同。
核心来源
Beiró M.G., Panisson A., Tizzoni M., Cattuto C. Predicting human mobility through the assimilation of social media traces into mobility models. EPJ Data Science, 2016, 5:30. DOI:10.1140/epjds/s13688-016-0092-2。
Mariano G. Beiró 是通讯作者,论文署名单位为意大利都灵 ISI Foundation 数据科学实验室。ISI 基金会的项目记录中,这篇论文的作者名写作 Mariano Gastón Beiró。论文贡献说明里,他与其余作者共同设计研究,与 Panisson 一起收集和处理数据,并完成模拟与作图。
André Panisson 的论文署名同为该实验室。他的个人主页写明,2013 年至 2022 年在 ISI Foundation 任研究员,工作包括用数字痕迹和机器学习研究人类行为与疫情传播。
Michele Tizzoni 的论文署名同为该实验室。他与 Cattuto、Panisson 合作的公开研究包括人类移动、接触数据和传染病传播中的集体行为;都灵大学的机构库收录了这些论文。
Ciro Cattuto 的论文署名同为该实验室。ISI Foundation 的 SocioPatterns 项目页面列出他以数字痕迹研究人类行为。本文的资助说明中,欧盟 MULTIPLEX 项目同时支持了 Tizzoni 和 Cattuto。四位作者都参与了论文写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
县际通勤若改用航空那套“只保留 500 公里以外”的规则,100 公里以内的通勤信号会被整段丢掉;航空若改用通勤的 100 公里上限,留下的会是短途照片移动,而不是航班。图 2 故意取消通勤上限后,远县仍然有颜色。若把这张未筛选的地图当成就业联系,旅游、过路和长途探访会写进通勤表。筛选阈值是在用活动类型给照片分类,阈值换一套,被预测的“出行”就换了一种。
两条尺度的赢家也不同。把通勤上最好的混合辐射模型拿去预测航空,十折决定系数是 0.64,而混合引力模型是 0.72,相差 0.08,分母都是航空正流量连边。反过来,用混合引力模型预测通勤,决定系数 0.62,低于混合辐射模型的 0.73。一个全国仪表板若只保存一种混合公式,就会在另一种尺度上主动放弃表里已经出现的差距。
照片模型在美国航空上能达到 0.62,分母仍是美国官方正流量,而且测试连边自己的照片用户数参与了预测。换到一个官方矩阵从未作为测试目标、地理照片又集中在少数景点的地方,图 3 那种远距离亮斑仍可能出现,通勤表里那些很少有人拍照的县则会从输入里消失。图 1(b)还显示,100 公里以内的照片比值随距离由负转正。若把这种用户流量直接送进疫情的人口分组模型,感染者到达的地点会更像摄影师出没的地点,而不像工人数量最多的地点。本文没有做这个传播实验。
集体预测使用的是盆地之间的用户总数。公开的是带时间的逐张照片时,个人活动序列会暴露得更多。预测成绩来自汇总后的连边计数;把汇总表用于规划,和公开可回溯到个人的照片序列,是两件不同的事。