一座没有历史流量的城市,网格上的进出量还能生成吗?
论文名片|Yudong Li、Jingyuan Wang、Xie Yu、Peiyu Wang、Qian Huang,Cross City Traffic Flow Generation via Retrieval Augmented Diffusion Model,39th Conference on Neural Information Processing Systems(NeurIPS 2025)。通讯作者为 Jingyuan Wang。代码与数据入口:github.com/lyd1881310/CRAFT。
可以想象一位分析人员手里有地图、兴趣点和人口,却没有这座城市过去一年的单车计数。单看某一座城市,地理条件接近的街区往往有接近的日内流量曲线,于是容易把另一座城市里“看起来像”的街区整段借过来。这篇论文要检查的是:这种对应一到跨城市还在不在;若已经散掉,只用源城市的历史流量,能不能仍为没见过流量的目标城市生成每个网格的流入和流出。
实验是芝加哥、华盛顿特区、多伦多、纽约的共享单车,每次留出一座城市。模型名叫 CRAFT,全称 Cross-city Retrieval-Augmented traffic Flow generaTion,一个带地理表示对齐的检索增强扩散模型。在默认的 24 小时窗口上,它在表 1 的 24 个评价格子里都优于 8 个基线。生成对象是归一化之后的区域进出量。目标城市的地图参加了对齐训练,历史流量没有参加。作者写明,起讫矩阵还没有做。
先说结论
- 留一城市的零样本设定下,CRAFT 在 4 座城市、流入与流出、CPC、NMAE、NRMSE 共 24 格上都最好。相对 8 个基线的平均水平,这 24 格的平均相对改进为 59.7%;相对综合第二名 GMEL 为 22.5%;相对普通 DDPM 为 61.5%。
- 消融里,去掉地理对齐的损失最大。条件里的日历嵌入贡献大于检索来的流量序列,检索序列本身仍然稳定地有帮助。
- 用生成数据训练 LSTM 和 Transformer 做流量预测,CRAFT 相对真实流量训练的平均误差升幅为 10.4%。32 个 MAE、RMSE 格子里,最小约 3.8%,最大约 22.2%。相对 8 个基线生成数据的平均误差,CRAFT 低 55.9%;相对 DDPM 低 14.9%。
- 窗口从 24 小时加到 168 小时后,多伦多流入的 CPC 仍在 0.800 以上,芝加哥流入在 T=168 降到 0.645。优势还在,但长窗口的难度并不对每座城市一样。
- 表 1 报的是可调参数范围内的最好结果,没有误差棒。评价用的是归一化流量按区域、月份、星期和小时分组后的均值。
地理特征相近,流量曲线为什么对不上?
单城经验是:兴趣点、道路和人口接近的区域,流量的周期和趋势也接近。跨城市之后,作者认为两件事同时挡住直接迁移。一是域偏移(domain shift):表示空间里挨着的区域,流量行为可以差很远。二是条件不够:静态地理能提供周期和趋势的线索,给不出均值、峰值和方差这些幅度;幅度本来来自历史流量,目标城市恰恰没有自己的历史流量。
这里的生成也不同于预测。预测用目标城市自己的历史流量推未来。CRAFT 在源城市上学参数,到目标城市时只拿区域图和地理特征,直接生成流量。
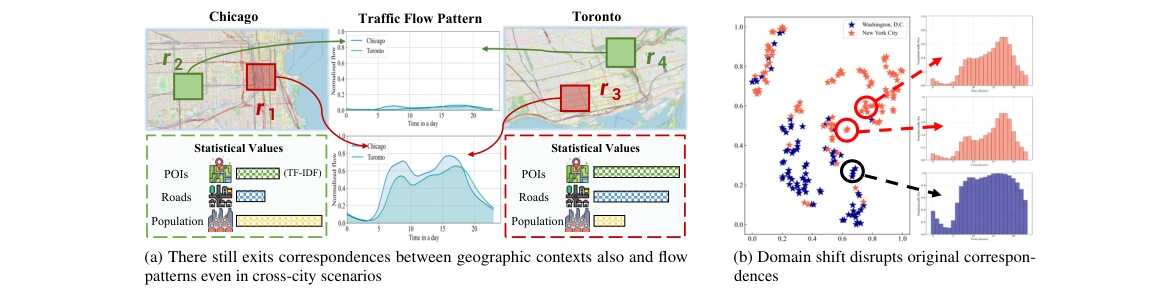
图 1|地理特征接近的区域,跨城市后还共享流量形态吗?
(a)芝加哥与多伦多。地图上的方框是示例区域,下方统计兴趣点、道路和人口,并画出一天内的流量曲线。两座城市内部,地理统计接近的区域可以出现相近的日内形状。(b)散点用颜色区分华盛顿特区和纽约,位置表示地理特征;右侧直方图是被圈出区域的流量分布。特征接近的点,流量分布可以明显不同。来源:原论文 Fig. 1。
图 1 是动机示意图,没有给出跨城市相关系数。它支持“不能把单城对应直接搬到另一座城市”,不支持已经量化域偏移有多大。后面的模型就是对着这两件事做的:地理特征对齐处理表示对不齐,检索增强把源城市的动态幅度补进条件。
这里的流量,是网格每小时进出了多少车
四座城市的原始记录都是共享单车出行,含起终点经纬度与时间戳。作者把每座城市手工分成互不重叠的矩形网格,再数每个网格每小时进入和离开的自行车数,得到流入和流出。分析单位是网格—小时,是区域合计,实验没有输出某一次出行或某辆车的路径。
| 城市 | 出行次数 | 时间 | 网格数 | 兴趣点数 |
|---|---|---|---|---|
| 芝加哥 | 5,136×10³ | 2023.01–2023.12 | 73 | 17,205 |
| 华盛顿特区 | 4,011×10³ | 2023.01–2023.12 | 82 | 14,070 |
| 多伦多 | 2,395×10³ | 2020.01–2020.12 | 61 | 20,621 |
| 纽约 | 35,080×10³ | 2023.01–2023.12 | 96 | 50,776 |
次数来自表 4 的千次单位:纽约 35,080×10³ 等于 3,508 万次出行,多伦多是 239.5 万次。单位分别是出行次数、网格和兴趣点。多伦多是 2020 年,其余三座是 2023 年,留一实验同时换了城市,也换了年份。
地理特征有三类,都是网格上的合计。兴趣点用 TF-IDF,把类别当词、网格内的兴趣点当文档、整座城市当语料,因此逆文档频率是在每座城市内部算的。道路特征是各类道路长度之和。人口来自 WorldPop 经联合国调整的 100 米人口,再汇总到手工网格,并使用人口数量和密度。三部分拼接后经过多层感知机,再送进图 Transformer。区域图的边只表示网格是否相邻。
原始计数很稀疏。作者用线性插值填补中间缺失,再用长度为 3 的滑动平均平滑,然后用长度 T 的窗口切样本。某个样本里缺失仍超过 5% 就丢掉。论文没有报告丢掉了多少窗口。实验里的流量都做了归一化,指标也在归一化值上计算,读不出“生成了多少辆车”。
默认 T=24,也就是从某个时刻起的 24 小时流入或流出。评价有三项。共同部分 CPC 等于两倍的逐点较小值之和,除以生成值之和加真实值之和,越高越好。NMAE 是平均绝对误差除以真实值的最大值减最小值,NRMSE 把平均绝对误差换成均方根误差,再用同一个极差做分母,两者越低越好。为了稳定,作者按目标城市测试样本的网格、月份、星期和小时分组,比较的是组内平均。组数 M 没有报告。因此表里的 0.785 表示分组后的归一化均值有多重叠。
协议是四折留一:一座城市当目标,另外三座当源城市。模型只在源城市的流量上训练,到目标城市做零样本生成,流入和流出分开评。基线是 GMEL、DFG、KSTDiff、CGAN、Diffwave、DiT、DDPM、CVAE。GMEL 和 DFG 属于用地理特征直接估计流量的静态模型,其余是生成模型。引力模型和辐射模型出现在相关工作里,没有进入这张表。清单写明,表中是各方法在可调参数范围内的最好结果,没有误差棒或多种子均值。
先把区域表示拉齐,再按日历检索源城市的流量
目标城市在训练阶段提供的是地理特征。地理对齐会同时看到源城市和目标城市的网格;流量对齐只用源城市的流量。零样本指目标城市没有历史流量标签。目标城市的地图在对齐预训练时已经使用。
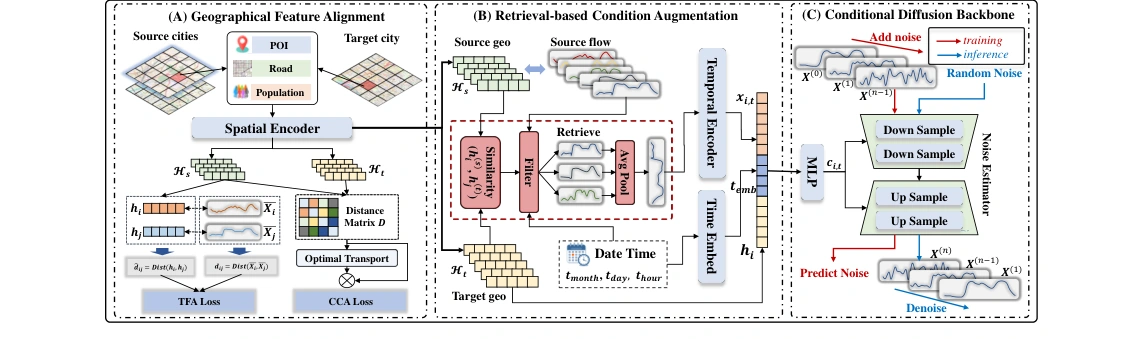
图 2|没有目标城市历史流量时,生成条件从哪里来?
(A)地理特征对齐。源城市和目标城市的兴趣点、道路、人口进入空间编码器;流量对齐比较源城市区域之间的表示距离和平均流量距离,跨城市对齐用最优传输拉近两边的表示。(B)检索增强。按月份、星期、小时和表示相似度,从源城市流量里取出序列,平均后交给时间编码器,再与目标区域表示、时间嵌入合成条件。(C)条件扩散。训练时对源城市流量加噪并用一维 U-Net 预测噪声;推理时从随机噪声出发,在同一条件上去噪,得到目标网格的流量序列。来源:原论文 Fig. 2。
流量对齐只在源城市的网格对上计算。每个网格先取时间上的平均流量。表示距离和平均流量距离分别做最小–最大归一化,损失是二者之差的平方,再对全部源网格对平均,分母是源网格数的平方。它要求表示差得远的网格,平均流量也差得远。
跨城市对齐没有人工标注的“这个网格对应那个网格”。作者把两边的区域表示看成两堆质量相等的点,用网络单纯形求最优传输,损失是传输方案与欧氏距离矩阵的乘积,也就是 Wasserstein 距离。每个网格权重相同,总权重为 1。它度量并压缩两座城市表示分布的差距,不证明某一对网格在功能上真的相同。
检索补的是幅度。对目标网格和指定的开始时刻,源城市流量先切成长度 T 的片段,再同时满足两道筛选:开始时刻的月份、星期、小时一致,区域表示与目标网格相近。取最接近的 K 条,K 的推荐值是 5,先平均,再用一层自注意力抽出形态。时间嵌入把一年中的月份(1–12)、一周中的天(1–7)和一天中的小时(1–24)分别嵌入后拼接。最后把对齐后的地理表示、检索结果和时间嵌入接在一起,映射成扩散条件。
扩散骨干是 DDPM,噪声步数 500,β 从 0.0002 线性增到 0.04。训练用源城市样本加高斯噪声,一维 U-Net 预测噪声,损失是均方误差。推理从标准正态噪声出发,按条件逐步去噪。表 3 的推荐设置还有:图 Transformer 3 层、4 个注意力头,时间编码器 2 层,地理表示 128 维,检索序列隐藏维 256,三种时间嵌入各 64 维,条件向量 256 维,批大小 256,学习率 5×10⁻⁶,训练 300 轮,优化器 AdamW,扩散参数用指数滑动平均。这些是推荐值。全部模型在一块 NVIDIA RTX 3090 上训练,机器为 Ubuntu 20.04.6、24 核 Xeon Silver、503 GB 内存,单个数据集的训练时间不超过 16 小时。
条件里的检索序列来自源城市的区域合计流量,按网格表示和时间槽匹配。这一步使用的是已经加总的进出序列,论文没有把检索写成对个人行程的追踪。
留出一座城市时,24 个格子分别差多少?
下表只摘 CPC,以及 CRAFT 自己的 NMAE 和 NRMSE。8 个 CPC 上,第二名都是 GMEL。CRAFT 的 NMAE、NRMSE 在全部 24 格里也是最低。普通 DDPM 使用同类扩散骨干,但条件没有这套对齐和检索。
| 目标城市 | 流向 | CRAFT 的 CPC | GMEL 的 CPC | DDPM 的 CPC | CRAFT 的 NMAE | CRAFT 的 NRMSE |
|---|---|---|---|---|---|---|
| 芝加哥 | 流入 | 0.785 | 0.730 | 0.415 | 0.140 | 0.216 |
| 芝加哥 | 流出 | 0.786 | 0.725 | 0.416 | 0.140 | 0.216 |
| 华盛顿特区 | 流入 | 0.815 | 0.741 | 0.346 | 0.158 | 0.240 |
| 华盛顿特区 | 流出 | 0.816 | 0.716 | 0.351 | 0.159 | 0.240 |
| 多伦多 | 流入 | 0.804 | 0.735 | 0.592 | 0.178 | 0.267 |
| 多伦多 | 流出 | 0.804 | 0.744 | 0.595 | 0.179 | 0.268 |
| 纽约 | 流入 | 0.782 | 0.585 | 0.523 | 0.103 | 0.170 |
| 纽约 | 流出 | 0.786 | 0.672 | 0.525 | 0.102 | 0.165 |
CPC 的差距并不均匀。纽约流入上,CRAFT 比 GMEL 高 0.197;芝加哥流入只高 0.055。基线的下限也很低:KSTDiff 在芝加哥流入和多伦多流入的 CPC 都是 0.006,几乎没有重叠。若把相对每个基线的百分比直接平均,接近 0 的 CPC 会把百分比撑得很大。正文的 59.7% 来自下面这种先平均基线、再比较的算法。
正文没有写出 59.7%、22.5%、61.5% 的分子分母。按表 1 的 24 格复算,可以和这三个数对齐:每一格先取 8 个基线的平均值,CPC 的相对改进是(CRAFT − 基线均值)/ 基线均值,NMAE 和 NRMSE 是(基线均值 − CRAFT)/ 基线均值,24 格再平均,得到约 59.7%。22.5% 和 61.5% 用同一套 24 格,分母分别换成 GMEL 和 DDPM。综合第二名是 GMEL,并不等于每个误差格的第二名都是 GMEL。纽约流入的 NMAE 上,DFG 为 0.182,GMEL 为 0.310,CRAFT 为 0.103。CPC 高和误差低是两件相关但不相同的事。
用生成数据训练预测,离真实流量还有多远?
作者再用各方法生成的流量训练 LSTM 和 Transformer,在真实流量上测试,并与直接用目标城市真实流量训练的同一模型比较。表 2 的数仍是归一化流量上的 MAE 和 RMSE。附录说明,延长窗口的效用实验用前一半序列预测后一半;正文表 2 没有单独重写这个切分。
32 个格子是 2 个预测模型 × 4 座城市 × 流入流出 × MAE 与 RMSE。CRAFT 相对真实数据训练的升幅,按(CRAFT 误差 − 真实数据误差)/ 真实数据误差平均,约为 10.4%。最小一格是 LSTM、纽约、流出、RMSE:0.110 对真实数据的 0.106,差 0.004,除以 0.106 约为 3.8%。最大一格是 Transformer、华盛顿特区、流入、MAE:0.116 对 0.095,差 0.021,除以 0.095 约为 22.1%,正文写最大降幅 22.2%,与显示到三位小数后的复算差在舍入。
同一 32 格上,先把 8 个基线的误差平均,再算(基线均值 − CRAFT)/ 基线均值,平均为 55.9%。只和 DDPM 比,平均低 14.9%。例如 LSTM、芝加哥、流入、MAE:真实数据 0.102,DDPM 0.117,CRAFT 0.109。CRAFT 更接近真实数据训练,仍然高于它。生成数据上的预测误差变小,说明合成序列保留了对这个下游任务有用的结构,不能因此说网格上的真实计数已经被逐小时还原。
去掉对齐之后,掉下去的是哪一项?
消融有三档。去掉对齐:不再做地理特征对齐,直接用目标网格的原始地理特征去检索和生成。去掉检索:从条件里拿掉检索序列。去掉时间嵌入:从条件里拿掉月份、星期和小时。后两档都属于检索条件这一支。
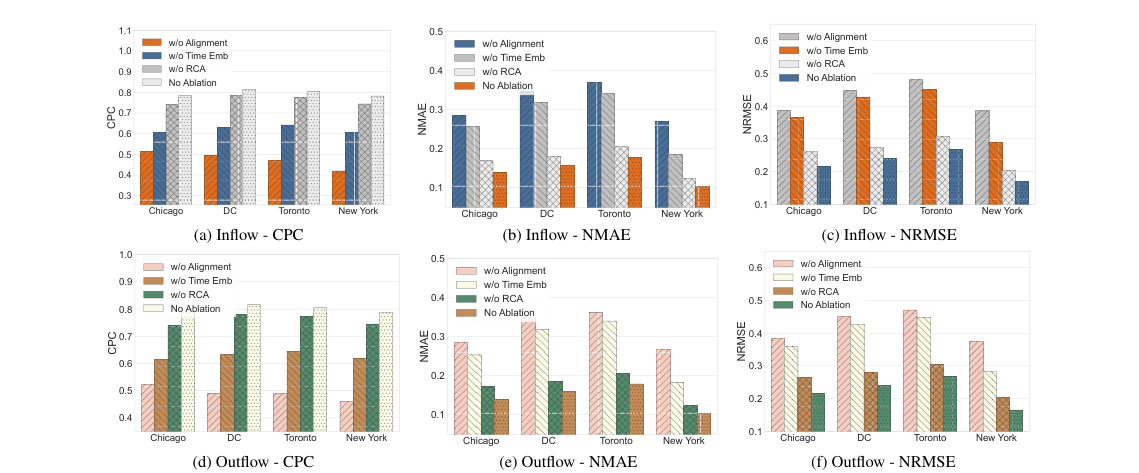
图 3|对齐、时间嵌入和检索序列,各自撑起多少性能?
(a、d)流入与流出的 CPC,越高越好。(b、e)NMAE,(c、f)NRMSE,越低越好。四座城市并排。上排与下排的图例配色不同,同一条件按各图自己的图例认。纵轴没有从 0 起,CPC 从 0.4 附近起,误差从 0.1 附近起,柱高差会被放大。去掉对齐后,CPC 下降最明显,误差也整体变大。只去掉检索序列时,完整模型仍然更好,差距通常小于去掉时间嵌入。图上没有标出每根柱的数字,所以上面只采用正文对方向的概括。来源:原论文 Fig. 3。
正文的读法与图一致:对齐带来的改进最大,说明跨城市时表示偏移是主要障碍;在检索条件内部,日历嵌入的贡献大于检索序列,检索序列仍然稳定加分。图 3 是方向证据。它没有给出“对齐贡献了百分之几”这种可以脱离柱高单独核对的数。
对齐内部还有流量对齐和跨城市对齐。图 4 把纽约作为目标城市,用 t-SNE 看网格表示。t-SNE 只保留邻域关系,轴没有地理单位。
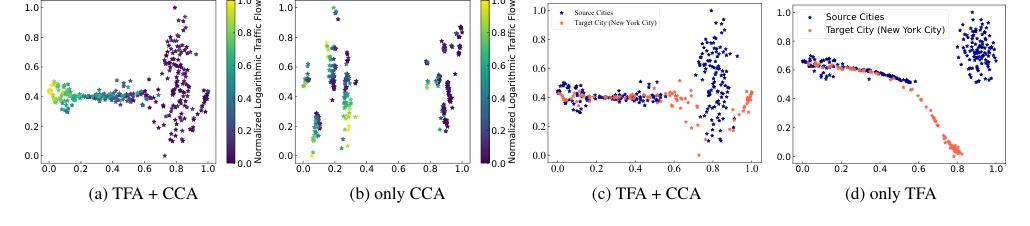
图 4|流量对齐和跨城市对齐,分别改变了表示空间的哪一种结构?
(a)两种对齐都打开,(b)只做跨城市对齐。颜色是归一化对数流量。(a)里高低流量沿表示空间分开得更清楚,(b)里高低流量混在一起。(c)两种对齐都打开,(d)只做流量对齐。蓝色是源城市,橙色是纽约。(c)里两边重叠更多,(d)里纽约有一支点远离源城市的主云团。来源:原论文 Fig. 4。
图 4 支持两个互补作用:流量对齐让表示距离跟着流量大小走,跨城市对齐减轻目标城市表示整体偏出源城市。它不证明某个纽约网格找到了唯一正确的芝加哥对应网格。四座城市都当过目标的版本在图 12。
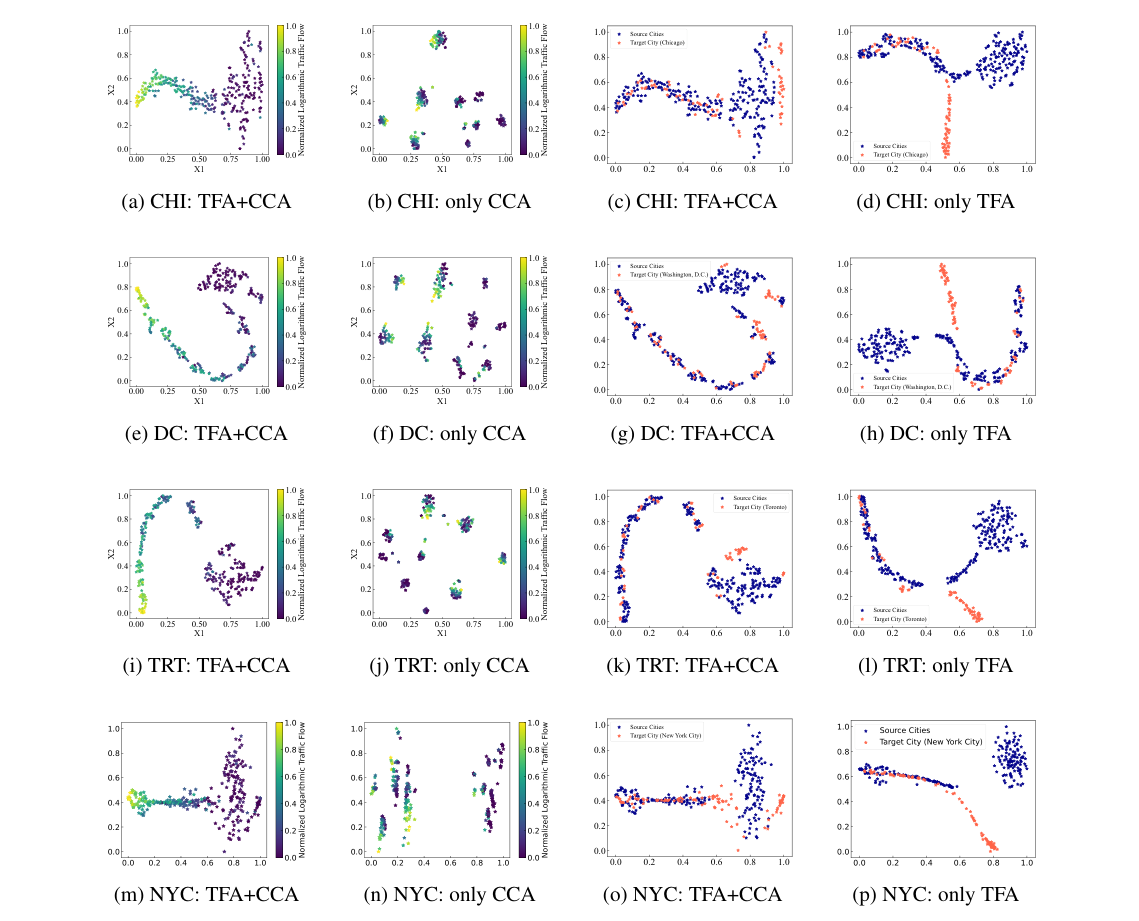
图 12|纽约图里的对齐现象,换目标城市还在吗?
(a、e、i、m)芝加哥、华盛顿特区、多伦多、纽约在两种对齐同时打开时的流量着色;(b、f、j、n)只做跨城市对齐。(c、g、k、o)两种对齐同时打开时的源城市与目标城市着色;(d、h、l、p)只做流量对齐。附录的读法是:两种损失一起用时,高低流量分得开;没有流量对齐时,不同城市容易分成几团,团内高低流量混杂;没有跨城市对齐时,目标城市有一部分表示离开源城市的集中区域。各城的点云形状并不相同,不能把纽约的那一支橙点当成四座城市的共同几何。来源:原论文 Fig. 12。
参数稍微一变,排名会不会翻?
敏感性看三件套:序列编码器层数 1 到 4,时间嵌入维度 64、128、192、256,地理表示维度同样四档。默认分别是 2 层、每种时间嵌入 64 维、地理表示 128 维。正文说最大性能波动为 8.8%,图上没有逐点标出这个百分比。
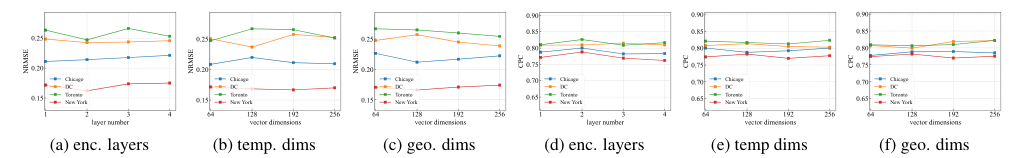
图 6|层数和维度变化时,流入生成还稳吗?
(a、d)编码器层数,(b、e)时间嵌入维度,(c、f)地理表示维度。上排是 NRMSE,下排是 CPC。四条线是四座城市。纵轴都截掉了 0 以下的大段空白,小起伏看起来更陡。四座城市的相对高低基本保持,没有出现换一个维度就排名颠倒的情况。来源:原论文 Fig. 6。
图 8 到图 10 把同一组超参数补到流入、流出和三项指标。纵轴同样不从 0 起。
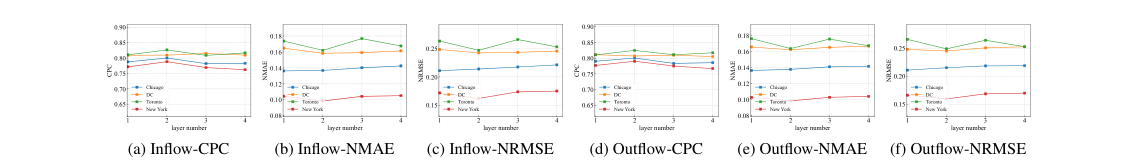
图 8|编码器层数从 1 改到 4,流入和流出是否一起稳?
(a、b、c)流入的 CPC、NMAE、NRMSE,(d、e、f)流出的三项。层数变化下各城曲线较平。多伦多的 NRMSE 最高,纽约的 NRMSE 最低,这个城市顺序没有因层数反转。来源:原论文 Fig. 8。
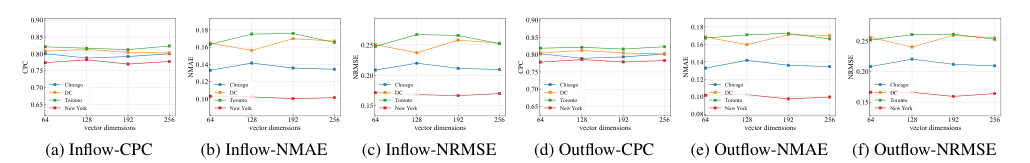
图 9|时间嵌入从 64 维加到 256 维,误差是否持续下降?
面板顺序与图 8 相同,横轴改为时间嵌入维度。加维没有带来单调变好,城市之间的差距仍大于同一城市在四个维度上的起伏。来源:原论文 Fig. 9。
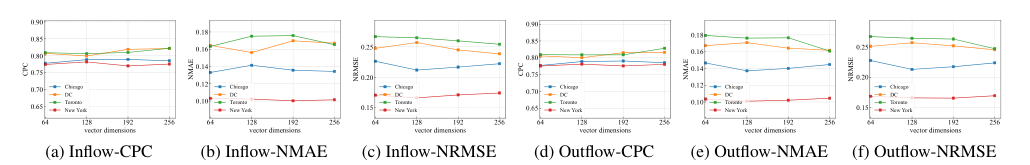
图 10|地理表示维度是否决定了跨城市效果?
面板顺序仍与图 8 相同,横轴为地理表示维度。64 到 256 维之内,完整模型的城市排序保持稳定。这支持“不必为每一座城市细调到唯一维度”,不支持维度选择已经没有影响。来源:原论文 Fig. 10。
地图上的高流量核心还在吗?
数值重叠高,地图上仍可能把高流量画错地方。图 5 画的是芝加哥流入的空间分布,色标 0 到 1,是归一化值。经度约 −87.70 到 −87.58,纬度约 41.86 到 41.94。
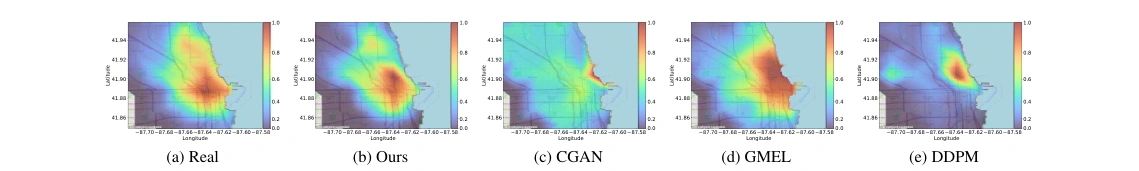
图 5|芝加哥的高流入核心,生成图里还在原来的位置吗?
(a)真实流入。(b)CRAFT。(c)CGAN。(d)GMEL。(e)DDPM。真实图中部有一块高值。(b)保留了这块热点的大致位置。(c)更铺开。(d)也有集中高值,形状与(a)不完全相同。(e)的高值更弱、更散。色标不能读成自行车次数。来源:原论文 Fig. 5。
正文说 CRAFT 和 GMEL 最接近真实分布,同时 CRAFT 的生成更符合真实流量。图 5 本身是目视比较。四座城市、九个方法的平均流量图在图 11,每座城市 10 张,顺序固定为真实、GMEL、DFG、KSTDiff、CGAN、Diffwave、DiT、DDPM、CVAE、CRAFT。
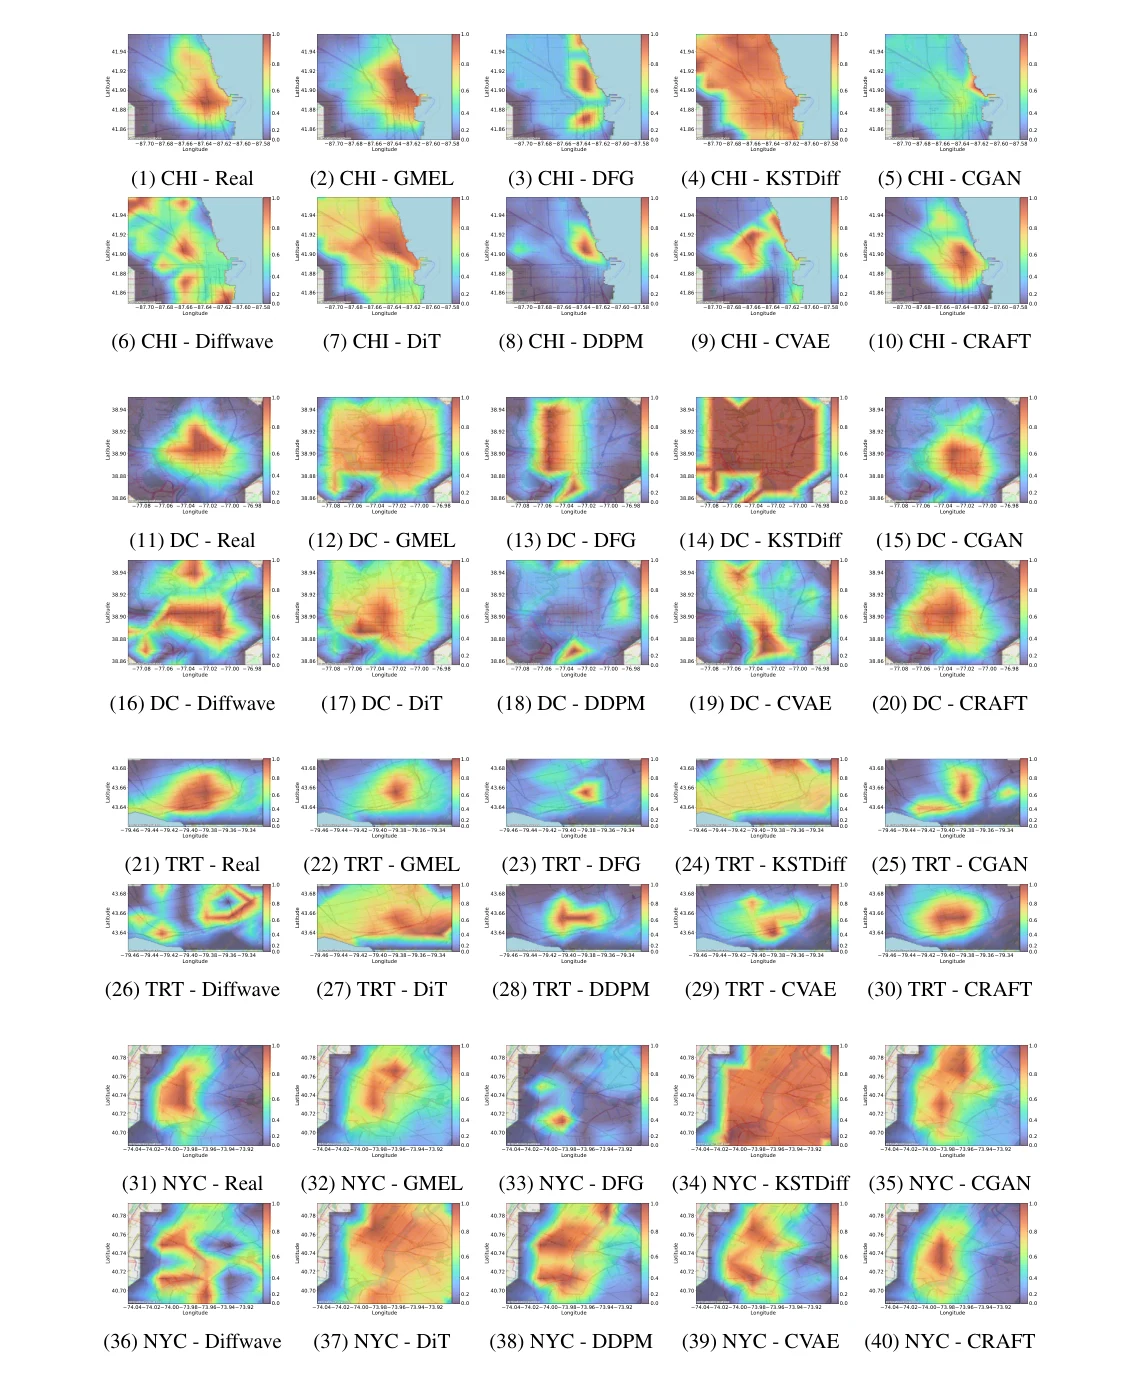
图 11|四座城市的平均流量地图,哪些方法保住了高值核心?
(1–10)芝加哥,(11–20)华盛顿特区,(21–30)多伦多,(31–40)纽约。每组第 1 张是真实值,最后 1 张是 CRAFT,中间依次为 GMEL、DFG、KSTDiff、CGAN、Diffwave、DiT、DDPM、CVAE。色标同为 0 到 1。CRAFT 在四座城市都保留了真实图里较集中的高值区,若干基线要么把高值铺满一大片,要么几乎抹平。各城色标分开归一化,不能跨城比较“哪座城市更红”。地图相像也不能代替表 1 的分组误差。来源:原论文 Fig. 11。
把窗口从一天拉到一周,优势还稳吗?
默认窗口是 24 小时。作者再在 48、72、96、120、144、168 小时上训练若干基线和 CRAFT。窗口变长既更难,也包含更多样本信息。图 7 只评流入。
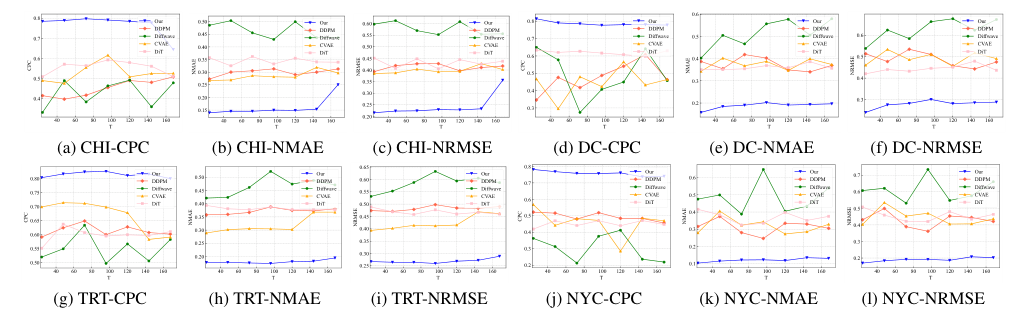
图 7|窗口加长到一周时,流入生成的优势还在吗?
(a–c)芝加哥的 CPC、NMAE、NRMSE,(d–f)华盛顿特区,(g–i)多伦多,(j–l)纽约。横轴约为 40 到 160 小时,对应实验里的 48 到 168。蓝线是 CRAFT,其余为 DDPM、Diffwave、CVAE、DiT。各面板纵轴范围不同,不能跨面板比绝对高度。CRAFT 在多数面板保持更高 CPC 和更低误差。Diffwave 起伏大。芝加哥 CPC 在最右端明显下跌,纽约的 CRAFT 仍贴在较高处。来源:原论文 Fig. 7。
表 6 给出可以核对的格子。芝加哥流入、CRAFT 的 CPC 在 T=48 到 144 为 0.789、0.798、0.791、0.785、0.777,到 T=168 降为 0.645;对应的 NMAE 在 T=48 到 144 为 0.145、0.145、0.150、0.149、0.154,T=168 升到 0.251,NRMSE 升到 0.356。芝加哥流出在 T=168 的 CPC 为 0.656。华盛顿特区流入的 CPC 在 T=48 为 0.791,T=168 为 0.778。多伦多流入从 0.817 到 0.800,中间最高 0.826。纽约流入从 T=48 的 0.769 到 T=168 的 0.741,流出从 0.777 到 0.746。默认 24 小时的纽约流入 CPC 是 0.782,芝加哥流入是 0.785。长窗口上的明显下跌集中在芝加哥的 168 小时。
附录说,在全部数据集和指标里,CRAFT 在超过 98.6% 的延长窗口情形中最好;下游预测里,86.5% 的情形最好。这两个比例的分子和分母没有逐项列出。计算量随 T 增加有限:表 5 在同一块 3090 上,T=24 的模型大小为 51,781,096 字节,每轮训练 40.999 秒,显存 0.343 GB;T=168 为 52,076,008 字节、51.896 秒、0.346 GB。作者因此认为把窗口加长在算力上可接受,同时写明没有做超过 168 小时的实验。
这些结果能说到哪一步
24 格全胜是可调参数下的最好一点,没有多种子方差。一次最好结果可以支持“在这四座城市、这套网格和这套归一化进出量上,CRAFT 高于列出的基线”,不能支持每一次随机初始化都会以同样差距领先。
零样本留出的是目标城市流量。跨城市对齐在预训练时见过目标城市的地理表示。若一座城市的地图也要在编码器冻结之后才出现,那是比本文更严的迁移,本文没有报告。
检索按月份、星期和小时匹配源城市。多伦多是 2020 年,其余是 2023 年,同一月份会跨年匹配。论文没有把年份差和城市差拆开。
CPC、NMAE、NRMSE 都在归一化、分组平均后的序列上。地图相似、预测误差下降和计数还原是三件不同的事。下游任务里,平均 10.4% 的升幅盖住了纽约约 3.8% 和华盛顿特区约 22% 的差别。
作者在结论里写了两条范围:目前只验证了进出流量,起讫矩阵还没有做;受计算限制,时间窗口没有超过 168。图 7 和表 6 说明,即便在 168 以内,稳定性也因城市而异。
一句话总结
别的城市的区域进出序列,加上目标城市的地图对齐,可以在没有目标历史流量时生成网格上的归一化流入和流出,并且在这四座城市的 24 个评价格上优于所列基线;它还没有回答起讫矩阵,也还没有回答地图本身也没见过的城市。
核心来源
- 本页依据的 PDF 首页标题为 Cross City Traffic Flow Generation via Retrieval Augmented Diffusion Model,页脚写明 39th Conference on Neural Information Processing Systems(NeurIPS 2025)。正文图 1–7,附录图 8–12,表 1–8。
- 作者代码与数据入口。原始出行数据链接写在论文脚注:芝加哥 Divvy、华盛顿特区 Capital Bikeshare、多伦多开放数据、纽约 2023 年 Citi Bike。
- 附录 A 给出最优传输和表 3 的超参数,附录 B 给出数据、基线与指标公式,附录 C 给出敏感性、延长窗口和全部城市的地图与对齐图。
作者介绍
以下只写论文署名和论文内可以核对的信息。
- Yudong Li:第一作者,北京航空航天大学计算机学院。论文摘要给出的代码仓库属于这一工作。
- Jingyuan Wang:通讯作者,同时署名计算机学院、经济管理学院,以及工业和信息化部数据智能与管理重点实验室(北京航空航天大学)。致谢列出国家自然科学基金 72222022、72171013、72242101,以及中央高校基本科研业务费 JKF-2025017226182。参考文献中有其参与的交通预测与城市计算工作,例如 LibCity。
- Xie Yu:北京航空航天大学计算机学院。
- Peiyu Wang:北京航空航天大学计算机学院。
- Qian Huang:华为技术有限公司全球技术服务部,北京。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
168 小时不该被看成一个统一难度。芝加哥流入的 CPC 在 T=144 仍有 0.777,到 T=168 落到 0.645,NMAE 升到 0.251;多伦多流入在 T=168 还有 0.800。若把同一周切成七段 24 小时分别生成,再与一条 168 小时序列比较,就能看出变差来自窗口变长,还是来自检索到的跨城周模式对不上芝加哥。论文停在 168,没有做这个对照。
10.4% 的平均升幅也不该直接拿去决定车位。32 格里,纽约 LSTM 流出 RMSE 只从 0.106 升到 0.110,华盛顿特区 Transformer 流入 MAE 从 0.095 升到 0.116。再加上输出是归一化值,要讨论某座城市的投放,至少得先把尺度还原,并按城市分别看误差。
还有一个更严的零样本:编码器在对齐阶段就见过目标城市的地图。若把目标地图也留到推理时才输入,59.7% 里有多少来自“见过地图”、有多少来自“借到同时段流量”,会和现在的留一流量实验不同。起讫矩阵会再改变问题,因为进出总量对了,目的地仍可能配错。这些都需要单独实验。