设施还在图纸上,通勤流量的预测会增加多少?
论文名片|Ana Alice Peregrino、Soham Pradhan、Zhicheng Liu、Nivan Ferreira、Fabio Miranda,Transportation Scenario Planning with Graph Neural Networks,arXiv:2110.13202v1[cs.LG],2021年10月25日。预印本。这是一项把图神经网络用于通勤流量情景推演的方法与案例研究。
累西腓的一个方案,是在四条大道上增加 24 公里自行车道。这四条路连接城市中的重要地点,日常机动车很多,目前没有自行车设施。另一项是市中心若泽·埃斯特利塔码头(José Estelita Pier)原址上的 13 座塔楼,层数从 13 层到 44 层。论文在新的流量观测到来之前,用模型估计这两项改造会怎样改变普查区之间的通勤人数。
经典引力模型把两地流量写成两端规模的乘积,再让它随距离下降。自行车道周长、建筑年代和容积率要进入这种估计,就得有一种能改写这些指标、再重新出流量的做法。本文用地理情境多任务嵌入学习器(Geo-contextual Multitask Embedding Learner,GMEL)做这件事。GMEL 是 Liu 等人 2020 年提出的图神经网络,本文把它用到巴西两座城市的公开城市数据上。
在留出的真实流量上,累西腓和库里蒂巴的共同通勤部分都是 0.73。两个假设情景只报告了累西腓:自行车道情景的平均相对增幅是 13%,标准差 0.59;塔楼情景是 12.5%(原文写作 12,5%),标准差 0.605。这些百分比是模型在指标被修改之后重新预测的结果。训练数据里没有交通方式,论文也没有施工前后的另一套清点可以对照。
先说结论
- 分析单位是普查区之间的通勤流量。累西腓保留 1,347 个普查区、23,336 名通勤者、15,945 条起讫点对;库里蒂巴保留 2,200 个普查区、45,365 名通勤者、32,988 条起讫点对。起讫点对按 60%、20%、20% 分成训练、测试和验证。
- 测试集上,累西腓的均方根误差为 1.43、平均绝对误差为 0.73、共同通勤部分为 0.73;库里蒂巴依次为 1.08、0.70、0.73。误差的分母是测试集起讫点对。本文没有在这两座城市上列出引力模型或其他机器学习模型的对照误差。
- 24 公里自行车道被映射到四条大道所在地带后,质心距这些地带不超过 2 公里的普查区之间,流量的平均相对增幅为 13%,标准差 0.59。论文没有给出参与平均的流量条数。
- 13 座塔楼情景的平均相对增幅为 12.5%,标准差 0.605。正文另写,靠近项目、或原本流量已经很大的高密度单元,最显著的那些流量至少增加 25%。库里蒂巴没有对应的情景结果。
普查区之间的人数,是这里的分析单位
情景规划(scenario planning)在这里的意思是:按今天准备做的用地或设施改动,估计以后的通勤流量。通勤流量(commuting flows)在模型概述里定义为,报告居住在起点普查区、工作在终点普查区的人数,而且是按年汇总的静态值。一次分析对应一对普查区上的人数。
两座城市都用 2020 年普查区(census tract)作地理单元,用开源路径引擎 OSRM 计算普查区质心之间的出行距离。累西腓的流量来自市政府 2018–2019 年调查,对象是在都市区居住、工作、就学或寻求服务的人的典型通勤。库里蒂巴的流量来自市政府 2017 年对都市区通勤格局的调查。模型概述中的“居住地—工作地”和这两次调查的对象范围并不完全是同一句话,论文没有再说明最终是否只保留了居住地到工作地。
和流量拼在一起之后,累西腓得到 1,347 个普查区,覆盖该市一半以上;通勤者 23,336 人,起讫点对(origin–destination pair)15,945 条。库里蒂巴得到 2,200 个普查区,覆盖该市绝大部分;通勤者 45,365 人,起讫点对 32,988 条。论文没有写调查抽样率,也没有说这些人数已经扩成全市就业人口。23,336÷15,945≈1.46,45,365÷32,988≈1.38。这是全部保留起讫点对上的平均人数;测试集自己的平均流量,论文没有单列。
15,945 条和 32,988 条都按 60%、20%、20% 分成训练集、测试集和验证集。论文没有报告验证集误差。表 2 只给测试集。
用地和设施被收成三类指标。累西腓三类相加为 46 项:基础设施 30 项,包括 12 类建筑的数量、4 项居住单元密度、11 个建成年份上的建筑数量、自行车站点、自行车道周长和公交专用道周长;土地利用 14 项,包括 12 项零售/办公用地面积比,以及 2 项容积率;Speciality 2 项,是普查区是否含有地标,以及文化线路数量。库里蒂巴三类相加为 24 项:自行车道周长和 11 个分区各自的地块数量构成 12 项基础设施,11 项分区用地面积比构成土地利用,另有 1 项位于历史地区的地块数量。库里蒂巴的分区依据 2020 年新的分区法规,流量则来自 2017 年。论文没有写明累西腓各地块指标的统计年份,也没有列出 12 类建筑或 11 个年份各自的名称。
| 类别 | 累西腓特征数 | 库里蒂巴特征数 |
|---|---|---|
| 基础设施 | 30 | 12 |
| 土地利用 | 14 | 11 |
| Speciality | 2 | 1 |
同一块地,为什么分成起点和终点两套向量?
GMEL 分两段。前一段学习每个普查区的嵌入(embedding),也就是一组用来代表该区的数值。后一段用这些数值预测流量。
城市被做成一张地理邻接网络:节点是普查区,节点上挂着前面的用地和设施指标,边权表示区与区之间的联系强度。概述里举例的边权包括出行距离和行程时间。巴西实验明确写出的是质心之间的出行距离,没有另行报告行程时间是否进入了这两座城市的模型。
同一普查区作为居住端和作为工作端,条件并不相同。模型因此用两套图注意力网络(graph attention network,GAT):一套编码起点情境,一套编码终点情境。邻居节点的指标会参与这个编码,所以一处指标改动可以进入相邻普查区的向量。多任务学习对嵌入加上更强约束,使它们携带对流量预测有用的信息。
流量预测器在概述里称为梯度提升机(gradient boosting machine,GBM)。它逐轮挑选信息增益大的数值特征并组合起来拟合流量。情景实验写得更具体:GMEL 用随机梯度下降端到端训练之后,把起点嵌入、终点嵌入和出行距离拼接起来,再训练梯度提升回归树(gradient boosting regression tree,GBRT),用留出的数据测试。
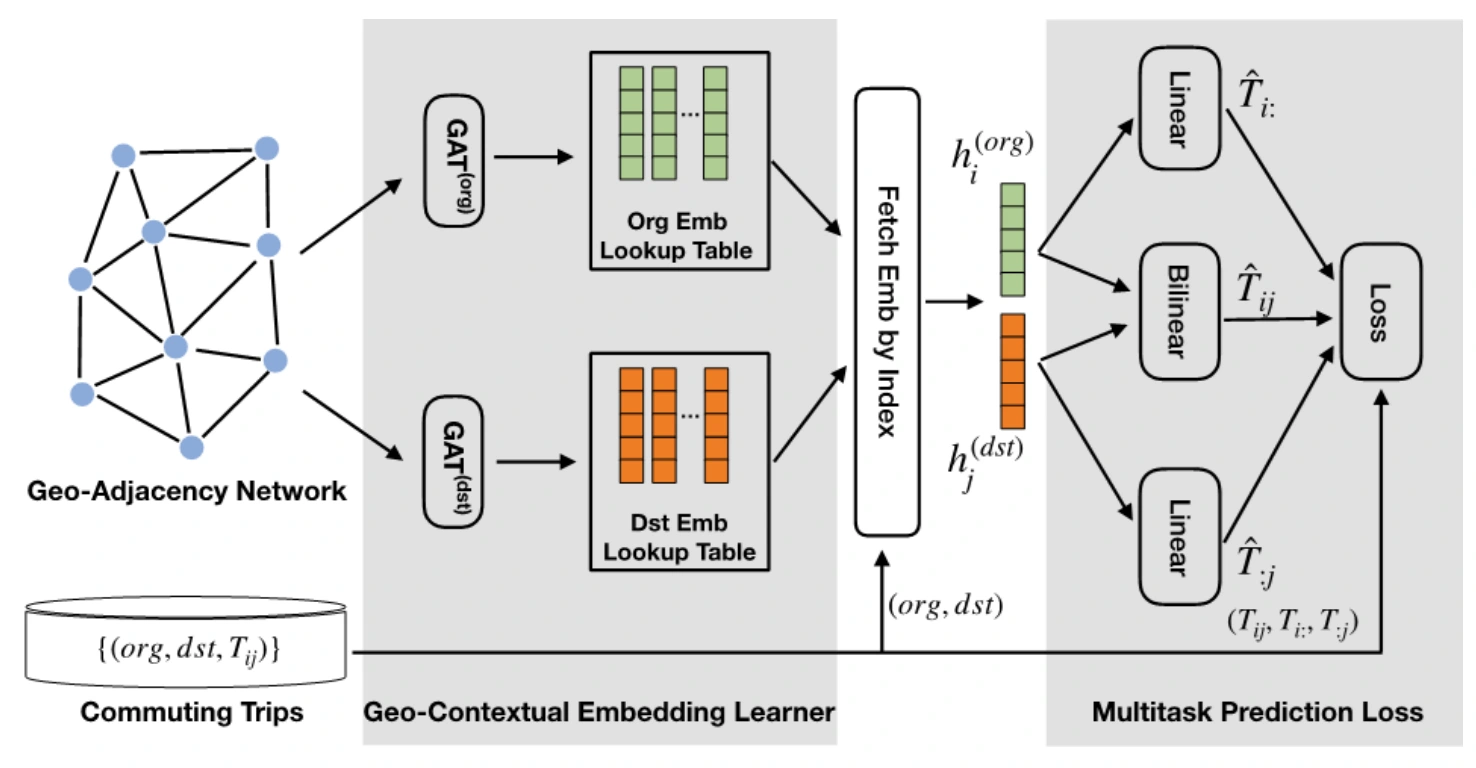
图 1|改指标之前,一个普查区怎样变成可用来预测流量的向量?
无字母子图。左侧是地理邻接网络,以及通勤表中的起点、终点和流量。中间两套图注意力网络分别写入起点嵌入表和终点嵌入表,再按起讫点索引取出这一对的向量。右侧的多任务损失同时比较三条预测:起点总流出、终点总流入,以及这一对本身的流量。来源:原论文 Fig. 1;图注标明结构来自 2020 年的 GMEL 论文。
图 1 解释的是嵌入如何被训练出来。本文情景部分实际用来重算流量的,是训练好的嵌入加上出行距离之后的 GBRT。论文没有在本文给出嵌入维度、学习率或树的棵数。
先前的 GMEL 使用纽约地块级土地利用数据 PLUTO,年份覆盖 2008–2021。其中一次演示用 2013 年数据训练,再按 2015 年改动后的土地利用预测流量。本文只重述了这件事,没有附上那次演示的误差。本文新做的训练和测试覆盖累西腓与库里蒂巴,情景结果只给出累西腓。
情景本身的步骤是:先在当前指标和当前流量上训练并测试;再按拟定改造修改城市指标,更新地理邻接网络,用已训练的模型生成新嵌入,然后预测新的通勤流量。论文报告这些新预测的相对变化。新情景下的真实流量还没有观测,因此这一步没有事后人数可以打分。论文也没有写出相对变化的减数,是修改前的模型预测,还是调查里的原始流量。
测试集上的 0.73,衡量的是哪一种重合?
测试集使用三个指标。均方根误差(RMSE)是每条预测与真实流量之差的平方,在测试集上取平均后再开方。平均绝对误差(MAE)是每条绝对差的平均。两者的分母都是论文公式里的 |T|;表 2 的标题是测试集表现,因此这里的 |T| 是测试集起讫点对,论文没有另写这个集合的条数。
共同通勤部分(Common Part of Commuters,CPC)先对每一对取预测人数和真实人数中较小的值,全部加总后乘以 2,再除以预测总人数与真实总人数之和。0 表示完全没有重合,1 表示每条都相同。它把大流量和小流量放进同一次求和,论文没有按距离或流量大小拆开。
| 城市 | RMSE | MAE | CPC |
|---|---|---|---|
| 累西腓 | 1.43 | 0.73 | 0.73 |
| 库里蒂巴 | 1.08 | 0.70 | 0.73 |
CPC 越高越好。两座城市的 CPC 同为 0.73,MAE 为 0.73 和 0.70,RMSE 为 1.43 和 1.08。论文认为三者里 RMSE 的差别最大,但仍然不大,并把库里蒂巴更低的 RMSE 归因于它的通勤流量和普查区更多。
RMSE 和 MAE 的单位是每条起讫点对的人数。累西腓测试集 MAE 为 0.73,分母是测试集起讫点对;全部 15,945 条的平均规模约为 1.46 人。两个数单位相同,可以用来感觉误差的量级,分母不同。论文没有把 RMSE 除以平均流量,也没有把它写成准确率。
相关工作提到,GMEL 在先前研究中优于梯度提升回归树、随机森林、引力模型和 node2vec。那些比较的数值不在这篇预印本里。本文表 2 只报告 GMEL 自己在两座城市测试集上的误差。
24 公里自行车道,13% 是哪些流量的平均?
自行车道情景选了累西腓四条尚未设自行车设施、机动车日流量高的大道,把 24 公里自行车道分配到这些大道,并映射到它们所在的地带。论文没有写出四条大道的名称。与自行车道直接对应的指标是自行车道周长,论文没有写明这 24 公里如何换算成每个普查区的周长数值。
随后看的是这样一组流量:相关普查区的质心,距离“获得新自行车道的普查区”的质心不超过 2 公里。每一条流量计算一个相对变化。论文没有写出相对变化的除式,只报告这组流量的平均增幅为 13%,标准差 0.59。13% 写成了百分数,0.59 没有再写成百分数;它是相对变化的离散程度。论文没有给出这组流量的条数,因此 0.59 不能换成置信区间。
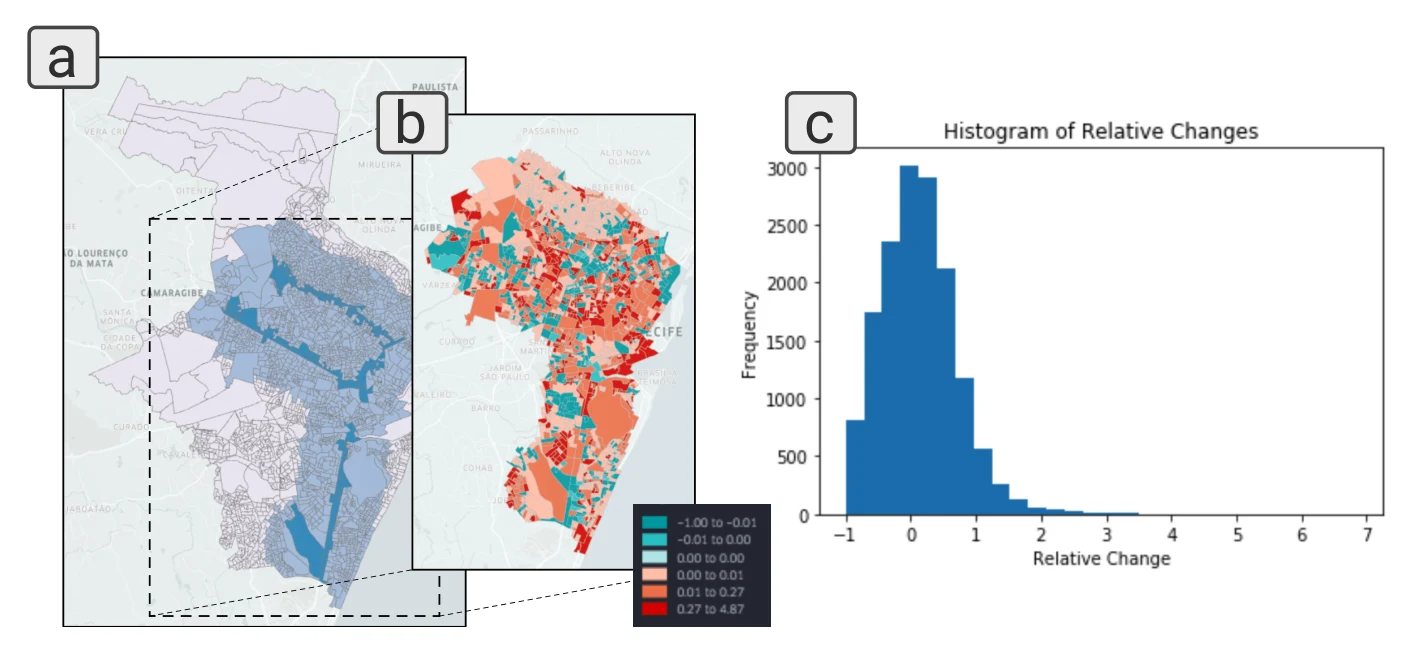
图 2|新自行车道附近的相对变化,是普遍上涨,还是少数流量把平均拉高?
(a)深蓝表示写入新自行车道的普查区,浅蓝表示质心落在 2 公里范围内的普查区;虚线框标出(b)所覆盖的空间范围。底图上能看到奥林达、保利斯塔等地名,论文没有逐区说明它们是否都属于保留下来的 1,347 个普查区。(b)按相对变化给普查区上色。能读清的分界包括 -1.00 至 -0.01、-0.01 至 0.00、0.01 至 0.27、0.27 至 4.87,0 附近还有一档浅色。红色和青色同时出现。论文没有写明一个多边形代表相关流量的总和、平均还是最大值。(c)相对变化的直方图。横轴从 -1 标到 7,纵轴频数标到 3000。最高的柱在 0 附近,顶到 3000 刻度一线;-1 到 0 之间仍有一批流量,右尾在 3 之后已经很稀。频数是流量条数,总条数没有标出。来源:原论文 Fig. 2。
直方图的高峰贴着 0,正文的平均值是 13%。右尾可以把平均抬高,最高的一档仍然集中在 0 附近。色标最高写到 4.87,直方图横轴画到 7,两套上限也不相同。
训练所用的指标里没有交通方式。作者据此设想,这些流量变化可能代表附近骑行增加。该设想没有按自行车、公交或小汽车分开的计数。流量上升表示模型对自行车道指标的改写作出了响应;自行车道是否带来了新的出行,还需要分方式的观测。
塔楼的 12.5%,和“至少 25%”是同一句话吗?
第二个情景使用码头旧址上 13 座塔楼的真实方案,层数 13–44 层。写进模型的信息包括不同类型建筑的数量、密度、建成年份、用地面积比和容积率。论文没有给出每一项相对现状增加了多少。
做法与自行车道情景相同,也是看指标修改所引起的通勤流量相对变化。结果是这些单元之间的流量平均增加 12.5%,标准差 0.605。这句话指向图 3(b、c)。图上呈现的是大范围的相对变化,正文接着写:模型预测的相对变化遍及全城。它没有像自行车道情景那样写明一个 2 公里口径,也没有给出 12.5% 的流量条数。
最显著的变化出现在靠近新项目的单元,以及原本通勤流量已经很大的高密度单元。这些流量被预测为至少增加 25%。25% 是这一部分的下界,12.5% 是指向图 3(b、c) 的那批流量的平均。图 3 色标的最高档从 0.28 起,和 25% 接近,论文没有写明二者是同一条分界。
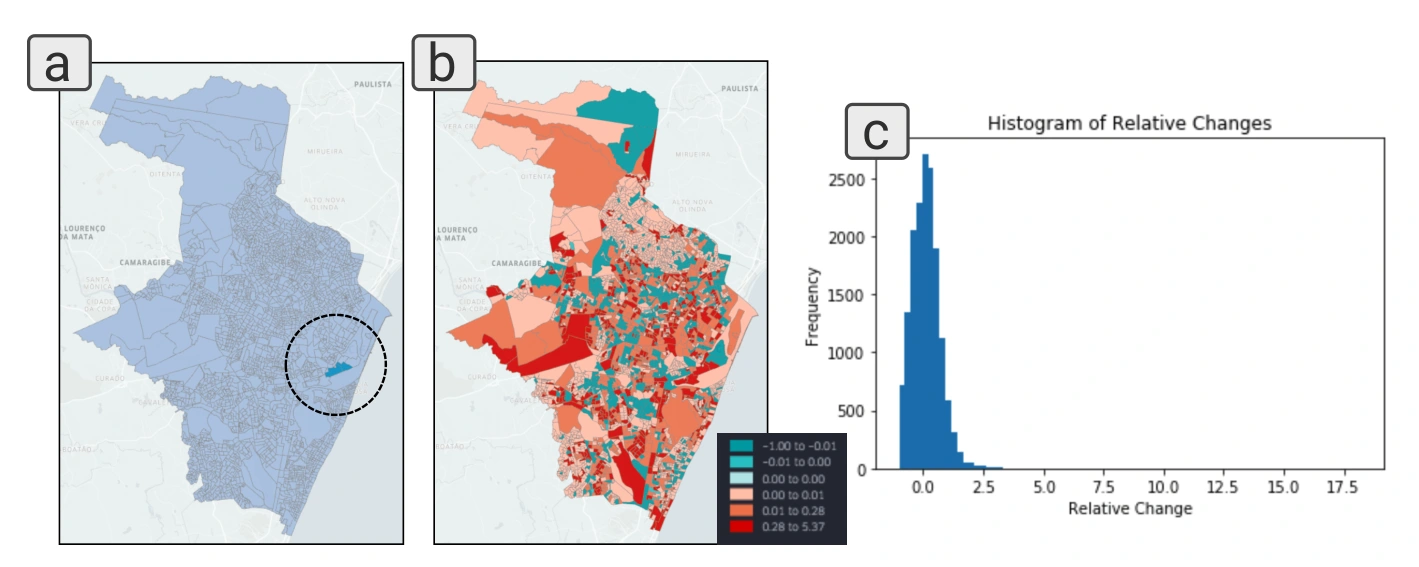
图 3|塔楼情景的平均增幅,对应全城分布的哪一部分?
(a)深蓝色小块是纳入新建筑的普查区,虚线圈出位置;图注没有把大片浅蓝定义为第二类情景。(b)按相对变化给更大范围上色。正值分界包括 0.01 至 0.28 和 0.28 至 5.37,负值从 -1.00 起,0 附近同样有浅色档。北侧有成片偏负的颜色,中南部红色更多。多边形颜色的汇总方式同样没有写明。(c)直方图横轴从 0.0 标到 17.5,纵轴频数标到 2500。主体贴着 0,到 2.5 附近已接近横轴。色标最高只到 5.37,与横轴右端 17.5 不是同一个上限;(b)含有负值,而(c)的刻度从 0.0 标起,论文没有解释负值落在哪一柱。来源:原论文 Fig. 3。
因此,12.5% 是一批流量的平均相对增幅,25% 是作者点出的显著部分的下界。全城图上同时有增加、减少和右尾。
这些增幅能直接写成即将发生的出行吗?
测试集 CPC 为 0.73,说明模型在未改指标的留出流量上能收回相当一部分重合。情景增幅是另一项任务:指标被改写,真实结果尚未发生。0.73 不能自动变成对 13% 或 12.5% 的准确率。
自行车道情景的 2 公里范围是正文写明的。塔楼情景的 12.5% 指向看起来覆盖全城的图,显著部分又被单独描述为靠近项目或原本高流量的高密度单元。两个百分比对应的空间范围不同。
累西腓的 1,347 个普查区只覆盖该市一半以上,情景地图不能直接当成完整市域的普查。库里蒂巴完成了同样的训练和测试,CPC 也是 0.73,但正文的两个初始情景都是累西腓。方法部分提到两座城市都有正在讨论的改造,本文没有给出库里蒂巴的情景流量。
流量年份和指标年份也不对齐:库里蒂巴流量是 2017 年,分区法规是 2020 年。模型依赖这些数据的质量。结论认为,公共部门需要提供准确数据,模型才适合协助规划决策;并准备以后加入分方式的通勤流量。当前结果还不能回答某种交通方式本身增加了多少人。
一句话总结
在留出的真实起讫点流量上,两座城市的共同通勤部分都是 0.73;累西腓两项改造被同一模型预测为平均 13% 和 12.5% 的相对增幅。增幅来自指标改写后的重新预测,施工后的实际人数和分方式流量都还没有观测。
核心来源
- arXiv:2110.13202v1,2021年10月25日。本文的图 1–3 和表 1–2 都来自这一版预印本。
- 累西腓开放数据门户,见论文参考文献[22]:http://dados.recife.pe.gov.br/
- 库里蒂巴城市规划与研究所,见论文参考文献[21]:https://ippuc.org.br
- Zhicheng Liu、Fabio Miranda、Weiting Xiong、Junyan Yang、Qiao Wang、Claudio T. Silva,Learning Geo-Contextual Embeddings for Commuting Flow Prediction,Proceedings of the Thirty-Fourth AAAI Conference on Artificial Intelligence,2020。GMEL 和图 1 的结构来自该文;这篇预印本没有重印它在其他城市上的误差表。
作者介绍
论文只列出五位作者的署名单位,没有个人贡献说明。
- Ana Alice Peregrino:署名巴西伯南布哥联邦大学。
- Soham Pradhan:署名美国伊利诺伊大学芝加哥分校。
- Zhicheng Liu:署名中国东南大学。本文使用的 GMEL 来自他与 Fabio Miranda、Weiting Xiong、Junyan Yang、Qiao Wang、Claudio T. Silva 2020 年发表、并被本文列为参考文献[16]的论文。
- Nivan Ferreira:署名伯南布哥联邦大学。
- Fabio Miranda:署名伊利诺伊大学芝加哥分校,同时也是上述 2020 年 GMEL 论文的作者。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若把 13% 交给一条大道的通行能力设计,等于把右尾很长的分布当成了均匀上浮。图 2 的高峰贴着相对变化 0,色标最高一档标到 4.87。可以单独问:平均里有多大份额来自相对变化超过 0.27 的那一档,这些流量的两端是否落在获得 24 公里车道的四条大道上。论文没有做这个分解。如果超额部分主要落在原本流量就大、只是与新车道普查区相邻的单元上,需要准备的是少数走廊的局部压力。图 2 的高峰靠近 0,读出来的是大量流量几乎不动,平均被右尾抬高。
塔楼情景已经把靠近项目的单元,和原本高流量的高密度单元,并列写成最显著的部分。全城 12.5% 的平均里,因此可能混有项目周边的新增联系,以及模型对既有繁忙地区的放大。一个还没做的核对是:保持塔楼的层数和容积率不变,把同一组指标改写放到一个密度相近、当前流量不大的普查区,看至少 25% 的增幅是否还出现。若增幅明显变小,模型响应的就是项目与既有流量格局的组合。规划简报需要同时给出地点和百分比。