春运回家,距离越远,城际人流就一定越少吗?
论文名片|Xiaofan Luan、Hurex Paryzat、Jun Chu、Xinyi Shu、Hengyu Gu、De Tong、Bowen Li,Different roads take me home: the nonlinear relationship between distance and flows during China’s Spring Festival,Humanities and Social Sciences Communications,2024,11:1356,2024年10月11日发表。收稿日期2024年2月6日,接受日期2024年9月13日。DOI:10.1057/s41599-024-03779-8。这是一项观察研究:用腾讯城际流动和梯度提升树描述距离与流量的非线性关系,不是把距离随机化的实验。
设想春节前有人从深圳回到衡阳。两座城市分别出现在流出表和流入表的前列,直线距离已经跨过省界。重力模型的直觉是,距离每增加一截,两城之间的人就按同一斜率变少。这只是帮助想象的路线,论文没有单列深圳—衡阳这一条记录。春运把距离衰减放到最大尺度上:有人跨省回户籍所在地,有人只在省内来回,也有人去更远的大城市。如果斜率真的恒定,沿海和内陆、省内和跨省,只该是同一条下降线的不同位置。
这项研究看到的不是一条直线。城际联系强度先在较近距离维持一段平台,随后下跌,再在更远处出现有限回升。距离仍然是模型里最重要的变量,但“重要”是重要性合计里的份额,不是把人搬远之后的因果效应。沿海省份和内陆省份的转折也不在同一公里数上。
先说结论
- 方法部分记录的是2018年2月1日至14日的腾讯城际流动:约40,289条日记录,去重并做论文所称的年度汇总后剩20,155条地级市之间的流量。表2、表3和图2、图3却写成2019年春节。两年不能当成同一次观测。
- 表1里,这批城际记录的城市中心距离均值是998.62公里,最短17.16公里,最长3,782.35公里。流量均值是25,377.73,最大2,014,300。表头没有写明均值的分母是20,155条记录还是城市个数。
- 梯度提升模型里,地理距离的重要性是0.5726。正文把它写成影响力的57.26%。分母是图4各变量重要性之和,论文没有报告R²或交叉验证得分。
- 偏依赖图把距离和联系强度都放在对数尺度上。图9、图10的横轴写明是自然对数。正文说的“距离为7”,是对数距离7,约等于e的7次方,即约1,097公里,不是7公里。
- 图上三圈的公里数因省而异:湖北标成平台527公里、下跌907公里、反弹1,978公里;广东标成376公里、550公里、1,495公里。这是分区标注,不是省界位置的测量。21个有足够数据的省份里,黑龙江、吉林、广西、甘肃在下跌段呈两段下降;新疆、西藏、青海、宁夏等被作者认为数据不足。
这14天统计的是城际记录,不是每一个回家的人
研究对象是地级市之间的起讫流量(origin–destination flow,OD流量):从一座城市到另一座城市的联系强度。数据来自腾讯位置大数据,由智能设备定位汇总而来。方法部分写的采集窗口是2018年春节前的2月1日至14日,全国范围并略超出这一范围。大约40,289条日记录包含起点、终点、流量和时间;去重以及论文所称的年度汇总之后,剩下20,155条,代表节日期间的地级市人口流动。
20,155的分母是汇总后的城际记录,不是旅客人数,也不是城市个数。40,289也不是14天乘出来的总人次。引言另写春运最繁忙时近30亿人在回家路上,没有给出处,也不是这20,155条记录的合计。
因变量Flow被定义成城际联系人数。表1的均值是25,377.73,标成statistics的一列是82,548.89,最小2.00,最大2,014,300.00。论文没有说明statistics是不是标准差,也没有说明这个“人数”是腾讯迁徙序列里的相对指数,还是扩样后的人数。图2、图3的图例同样写成Flows (persons)。因此最大2,014,300只能按论文的单位理解成一条城际记录的流量,不能直接当成人口普查里的人数。
主自变量是城市中心之间的几何距离,单位公里。表1均值998.62,statistics一列654.54,范围17.16至3,782.35。这是地图上的直线距离,不是公路里程、耗时或票价。控制变量按重力模型的思路纳入城市人口、GDP、财政支出、科技支出、教育支出、第二产业占比、空气质量指数和PM2.5。正文还写了人口密度。表1没有人口密度的描述统计,但图4的重要性里出现了起点密度和终点密度。人口、GDP和公共服务在表里各占一行,同时覆盖起点和终点,所以这些均值不像流量那样可以肯定是“每条OD记录算一次”。
表1的人口单位是千人,均值5,949.80,范围210.00至33,900.00。GDP单位是百万元,均值592,851.66,最大3,100,000.00。最大GDP相当于3.1万亿元,和超大城市的经济总量同量级;这只说明单位可与公开统计对上,不说明每一行都来自同一次普查。变量取自《中国城市统计年鉴》。进入模型前做了对数变换,以减轻偏态。
这里有一个必须分开的年份。结果、表2、表3以及图2、图3的图注写的是2019年春节,和2018年2月1日至14日的采集句不一致。下面凡是写到地图和前20城,都按那些图表自己的2019年标注转述,不把两年合并成同一次春运。
前20城旁边的人口差额,并不是这14天的客流
表2列出作者称为春节流出最多的20座城市,表3列出流入最多的20座城市。两张表的数字却是常住人口、户籍人口和二者之差,单位都是千人。差额等于常住减去户籍:深圳常住17,560.06、户籍5,510.00,差额12,050.06;北京21,893.10减13,970.00,差额7,923.10;上海24,870.90减14,690.00,差额10,180.90。流入表里,重庆常住32,054.16、户籍34,160.00,差额−2,105.84;周口常住9,026.02、户籍12,570.00,表中差额印为−3,543.99。
这些差额衡量的是“常住比户籍多多少人”,是一个存量缺口,不是2月1日至14日的腾讯流量。排名也不是按差额绝对值排的:周口的负差额大于重庆,重庆却排在流入表第1、周口第4。表头没有写出真正用来排序的节日客流。表3图注还把这些城市说成吸引劳动力的发达地区,名单上却是重庆、衡阳、赣州、周口。正文的解释是,流出表对应人们离开、返乡的城市,流入表对应回老家的城市。这个解释和“常住多于户籍的城市更像务工地”方向一致,但不能把12,050.06千人读成深圳在该窗口流出的人数。
图2、图3才是腾讯流量的地图。两张图都没有子图字母,各有全国、广东、四川、湖北、黑龙江五幅。图例以人数给线着色:大于400,000,200,000至400,000,100,000至200,000,10,000至100,000,另有无数据。黑点在图例中标为 provincial capital,灰点为地级及以上城市。图2是出发视角,看人从这些地方去往全国;图3是到达视角,看人从全国进入这些地方。
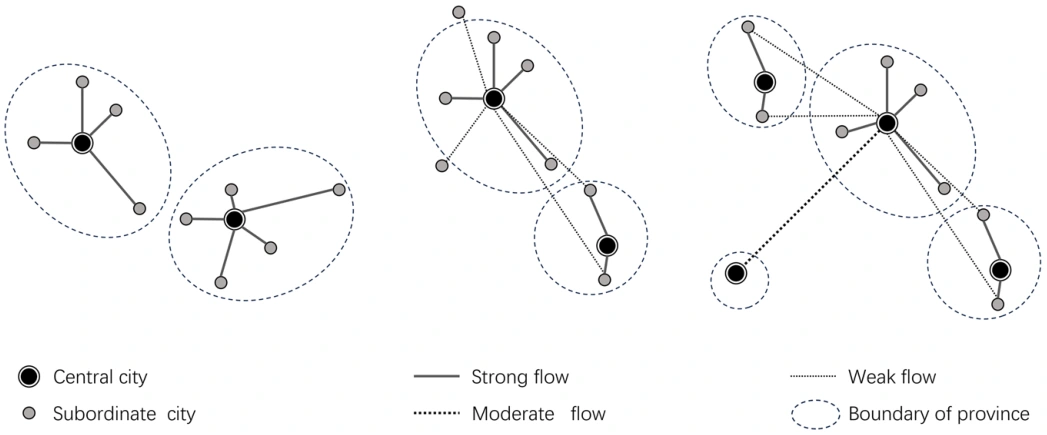
图 1|三种距离关系在省界内外长什么样?
无字母子图,从左到右三组示意,对应正文的平台、下跌、反弹假设。图例里黑点是中心城市,灰点是从属城市,实线、点线和虚线分别是强、中、弱流量,虚线圆是省界。左图是两个省各自内部的强联系;中图出现跨省的较弱联系;右图有一条更长的中等联系进入另一个省的中心。这是概念图,不是20,155条记录的绘制结果。来源:原论文 Fig. 1。
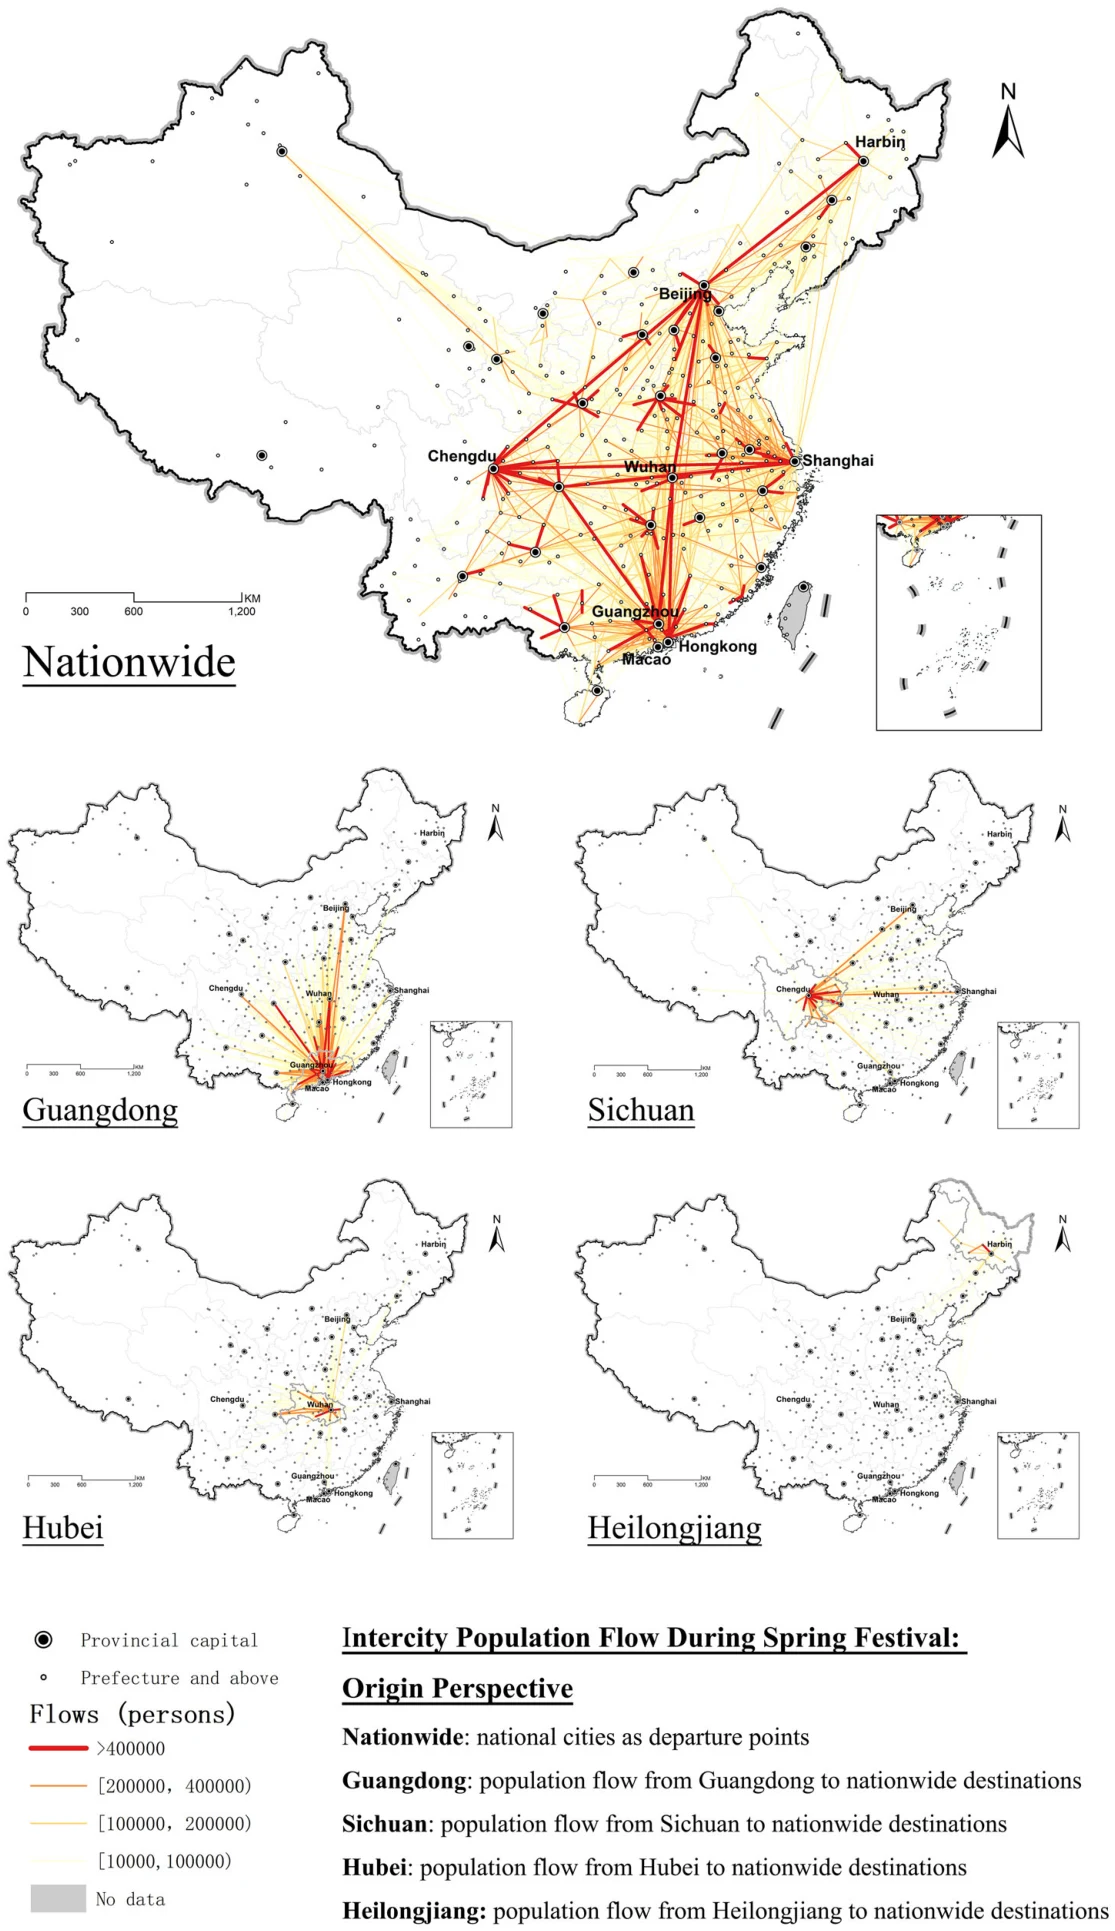
图 2|人从哪里出发?
无字母子图。全国图以主要城市为出发地;其余四幅分别是从广东、四川、湖北、黑龙江出发、到达全国的流量。红色越深流量越高,阈值见上一段图例。正文据此描述一条由东部沿海指向中部和西部的格局,并说全国联系围绕北京、上海、广州(含深圳)和成都。来源:原论文 Fig. 2。
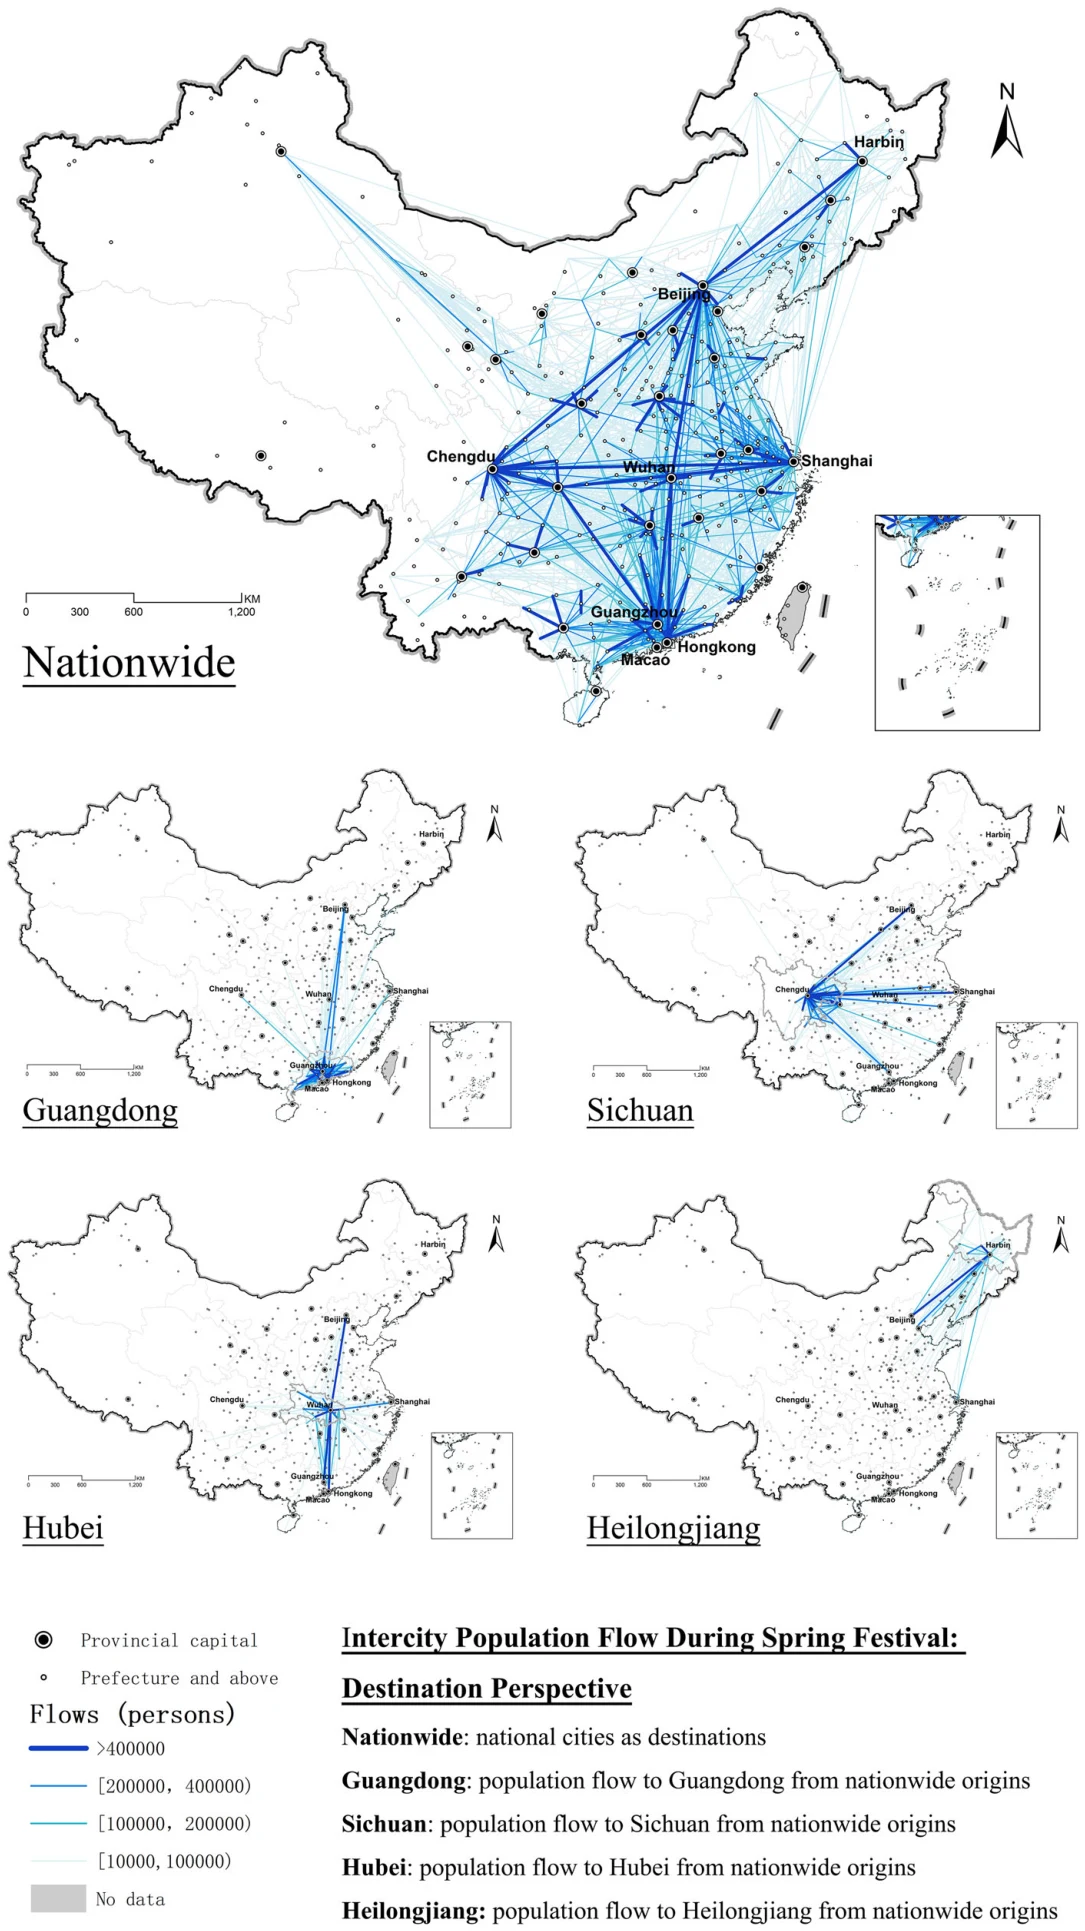
图 3|人到达哪里?
无字母子图,五幅地图与图2同名,方向相反:全国城市作为目的地,以及进入广东、四川、湖北、黑龙江的流量。正文称图3显示四川有超过400万趟、主要向东的人口流动。400万的分母是正文所说的趟次,图上没有这个总数,也没有按天拆开。图3的图例是到达四川,向东出发更接近图2的出发视角。湖北被写成省内和邻省联系强、跨省吸引有限;黑龙江被写成外部就业吸引力弱、节日回流明显。这些是地图阅读,不是每条线的回归系数。来源:原论文 Fig. 3。
直线距离衰减解释不了平台、下跌和回升
重力模型通常让两地流量随规模增大、随距离增大而下降。距离衰减(distance decay)指的就是后一半:距离越远,空间联系越弱。衰减可以写成距离的幂,也可以写成指数,但一旦形式选定,斜率在各距离段是同一种函数,不会自己先走平、再下跌、再抬头。
作者提出三种距离—流动强度假设,并在图1里画成概念。平台假设:省内短距离到中距离上,强度上升很少,很快走平,对应省内社会经济和基础设施连成一片。下跌假设:遇到省界,强度明显下降;行政、社会经济、文化间断以及户籍制度都会加重这种边界。反弹假设:超过某个距离后,强度因为更发达省份的就业和公共服务再次上升。
摘要把三者写成距离衰减参数几乎为零、衰减参数下降、以及先降后升。图5至图10实际画的是联系强度的偏依赖,不是一条单独估计出来的衰减参数曲线。偏依赖(partial dependence)问的是:其他变量按数据里的分布取平均之后,模型预测的联系强度怎样跟着距离改变。它是梯度提升树的读出方式,不是观察到的原始人次,更不是把一座城市挪远的实验。
模型在摘要、图4和结论里叫梯度提升决策树(Gradient Boosting Decision Tree,GBDT),方法部分又写成梯度提升机(Gradient Boosting Machine,GBM)。两者在这里指同一次树模型。超参数用RandomizedSearchCV搜索。正文没有给出树的数量、学习率、最终参数,也没有给出样本外误差。因此后面的曲线是这套拟合模型的边际读数。换一组参数,转折位置可能移动。
57.26%是重要性份额,不是解释掉的方差
图4把各变量的重要性画成横条,并按地理、经济、人口、环境四类上色。距离的柱端标注是0.5726。正文说地理距离占影响力的57.26%。0.5726就是57.26%的小数形式,分母是图中各项重要性之和,各项加总接近1。它不是R²,也不是“距离解释了57.26%的春运人次”。
其余变量的柱都短得多,柱端落在0.1左侧。颜色上,经济变量整体长于人口变量,环境变量最短。起点和终点是分开进入模型的:目的地GDP、目的地科技支出排在距离之后,起点人口和两端密度接近零。重要性低只说明在这组变量和这个模型里贡献小,不能推出空气或人口密度与流动无关。模型也没有放入省界虚拟变量或户籍变量,所以省界效应还不能从图4的排名里直接读出。
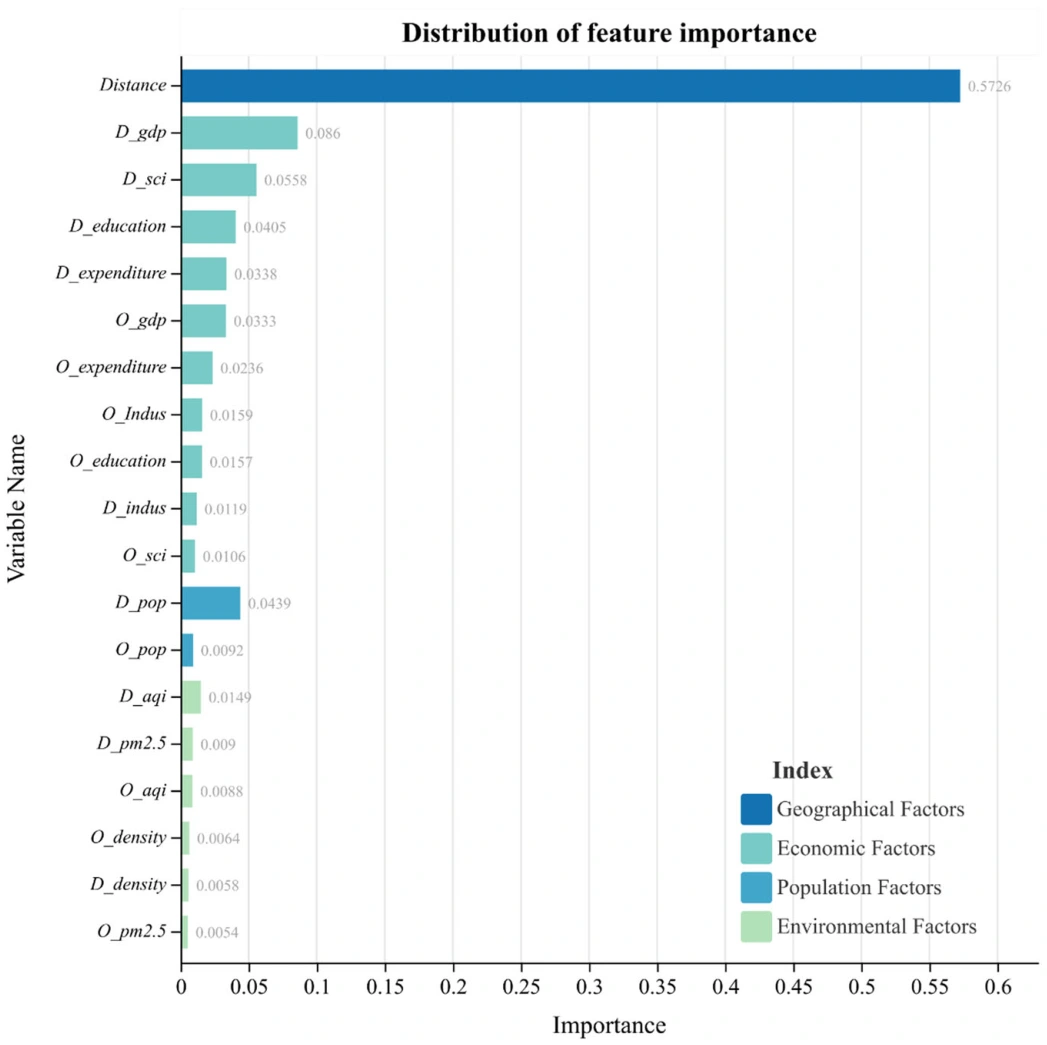
图 4|控制人口和经济之后,距离还剩多少重要性?
无字母子图。横轴是重要性,纵轴是变量名。深蓝距离为0.5726;其余柱端均小于0.1。图例四色对应地理、经济、人口、环境。正文只把距离换算成57.26%,没有逐项公布其余百分比。来源:原论文 Fig. 4。
对数距离上的平台,到了7才进入正文强调的远距离
图5至图8按东部、中部、东北、西部画出各省的偏依赖。横轴是Log(Distance)/km,刻度大约从4到8。表1的距离范围是17.16至3,782.35公里。自然对数ln(54.6)约等于4,ln(2,981)约等于8;常用对数下,3,782公里只约等于3.58,对不上这条横轴。图9、图10更直接写成Distance/Ln(km)。所以横轴是公里数的自然对数。正文写中部省份在“距离为7”之后仍能看到城市群的拉动,指的是对数距离7,即e^7,约1,097公里。
纵轴是偏依赖。因为变量先取了对数,纵轴会出现负值。负值不是负的人数,而是模型在对数尺度上的边际预测低于曲线中间的某个水平。灰带是置信区间,论文没有说明区间怎样计算。灰带在下跌段往往很宽,陡降的精确位置不宜读成单一公里数。
东部图包括广东、浙江、江苏、福建、山东、河北。曲线从对数距离4附近的高位缓缓下降,在6前后明显变陡,之后在0附近波动,远距离还有小的起伏。中部图包括湖北、山西、江西、湖南、河南、安徽。正文强调这里有平台、急跌和随后的峰,并把它和人口大省、乡村劳动力以及其他省份的拉力连在一起。东北图只有辽宁、吉林、黑龙江。吉林和辽宁在中等距离下跌更陡,黑龙江的平台拖得更长。西部图的图例是甘肃、云南、Shanxi、四川、贵州、广西。山西已经出现在中部图里;西部图又写了一个Shanxi,论文没有解释是重复纳入还是陕西的拼写。正文点名的西部例子是甘肃、广西、贵州,并说西部的初始平台更长、平均强度更低、对距离更敏感。
这些比较支持“非线性,而且省与省不同”。它们不支持“东部人更愿意出远门”这种个人偏好结论。曲线是省内所有城际记录放进同一个模型后的平均读数。腾讯数据也看不到旅客是返乡、旅游还是商务。
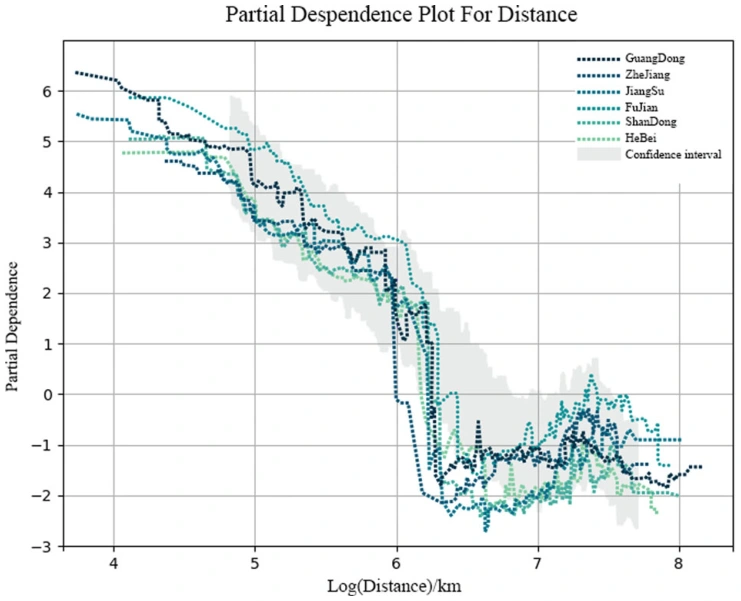
图 5|东部六省的联系强度在哪一段对数距离变陡?
无字母子图。一条线一个省:广东、浙江、江苏、福建、山东、河北。横轴为距离的对数,纵轴为偏依赖,灰带为置信区间。近距离偏依赖更高,对数距离6前后集体下跌,7之后在低位波动。来源:原论文 Fig. 5。
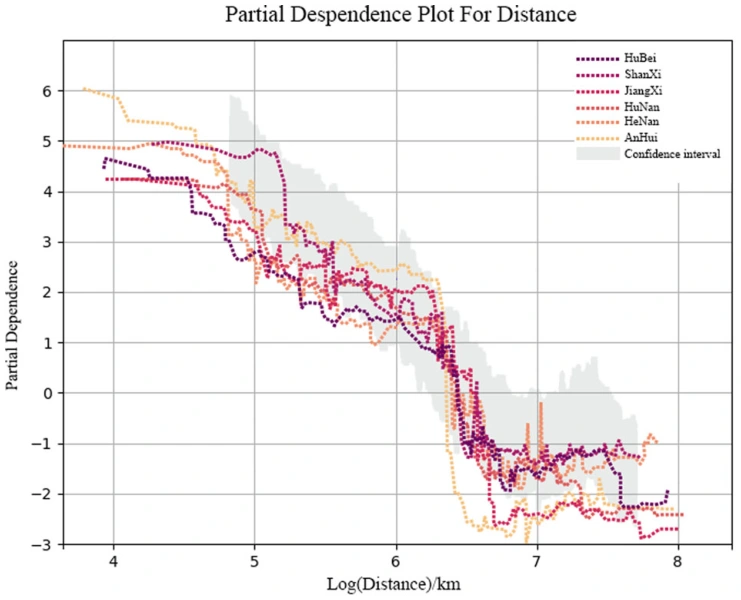
图 6|中部省份有没有平台、下跌再抬头?
无字母子图。线为湖北、山西、江西、湖南、河南、安徽。正文认为人口流出大省仍有高强度流动,并在对数距离7之后出现由城市群拉力带来的峰。图中灰色区间很宽,峰的高度不能读成增加了多少人。来源:原论文 Fig. 6。
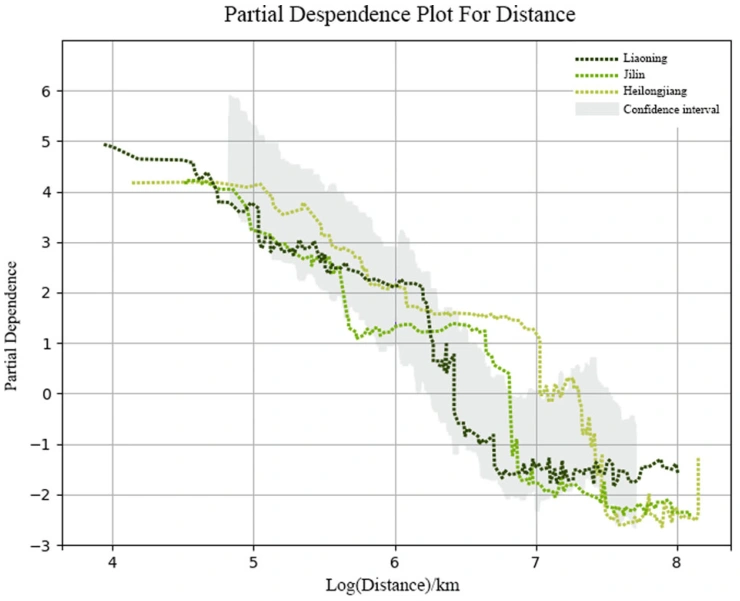
图 7|东北三省的平台停在多近的距离?
无字母子图。辽宁、吉林、黑龙江。短距离有平台;吉林和辽宁在中等对数距离下跌更陡,黑龙江维持高位更久。结论把黑龙江和吉林算进下跌段的两段下降,辽宁不在那四省名单里。来源:原论文 Fig. 7。
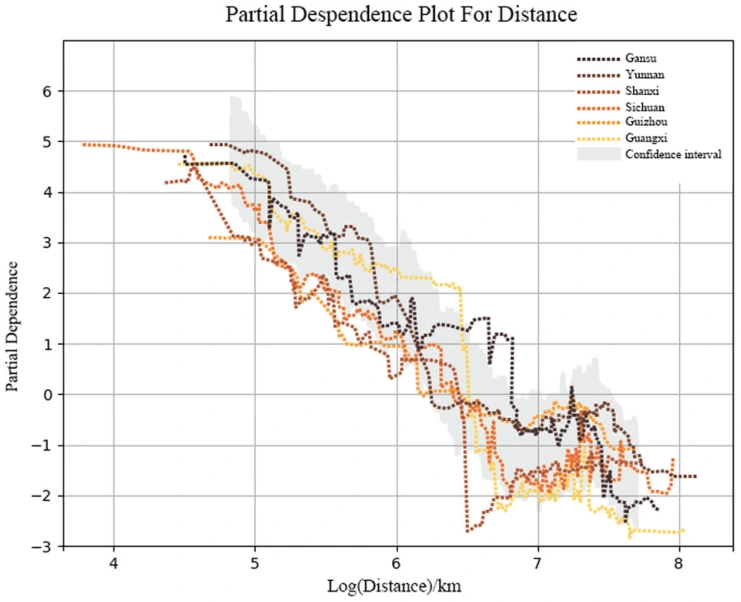
图 8|西部曲线是不是更低、也掉得更快?
无字母子图。图例为甘肃、云南、Shanxi、四川、贵州、广西。多数曲线起点低于东部,随后较快下降,远距离仍有起伏。正文用这组图说明西部平均流动强度低、距离敏感度高。来源:原论文 Fig. 8。
湖北和广东的三圈,公里数并不相同
图9、图10把偏依赖的三段画回地图。颜色表示联系强度,虚线圆分成平台、下跌、反弹,小图是该省自己的偏依赖,横轴同样是自然对数距离。正文有一处把湖北的空间格局写成见图8;图8是西部六条曲线,湖北的地图是图9。
湖北以武汉为中心。地图标出平台527公里、下跌907公里、反弹1,978公里。按自然对数,这三圈约对应6.27、6.81和7.59。强联系集中在武汉及邻近的重庆、信阳、岳阳一带,外圈变弱。作者把湖北读成区域枢纽,而不是全国尺度的吸引中心。这和“常住人口减户籍人口”的存量故事相合:湖北更多是人们出发或短距离往返的区域,而不是把远距离劳动力稳定留下来的地方。模型本身没有检验户籍。
广东的三圈更紧:平台376公里、下跌550公里、反弹1,495公里,约对应自然对数5.93、6.31和7.31。珠三角颜色最深,外圈沿更远的城市延伸,图上能看到上海、武汉、成都、重庆方向的联系。正文说广东的出发地属性明显强于目的地属性,并用高铁走廊解释这种超出邻近地区的拉力。376公里对550公里、再对1,495公里,不能解释成“广东人每到一个圈就少固定比例的出行”。圈是模型曲线换色后标到地图上的距离,换色点取决于拟合。
结论进一步说,所考察的21个省份里,多数符合这三种形态。黑龙江、吉林、广西、甘肃在下跌段是两段下降,作者推测与区位以及北京、广州的特殊吸引力有关,没有单独的检验。西部省份的反弹比其他地区更明显,被解释成从外省特大城市返回。新疆、西藏、青海、宁夏等因数据量不足,没有纳入这一判断。21的分母是作者认为足以描绘形态的省份,不是全国全部省级单位,也不是20,155条记录。
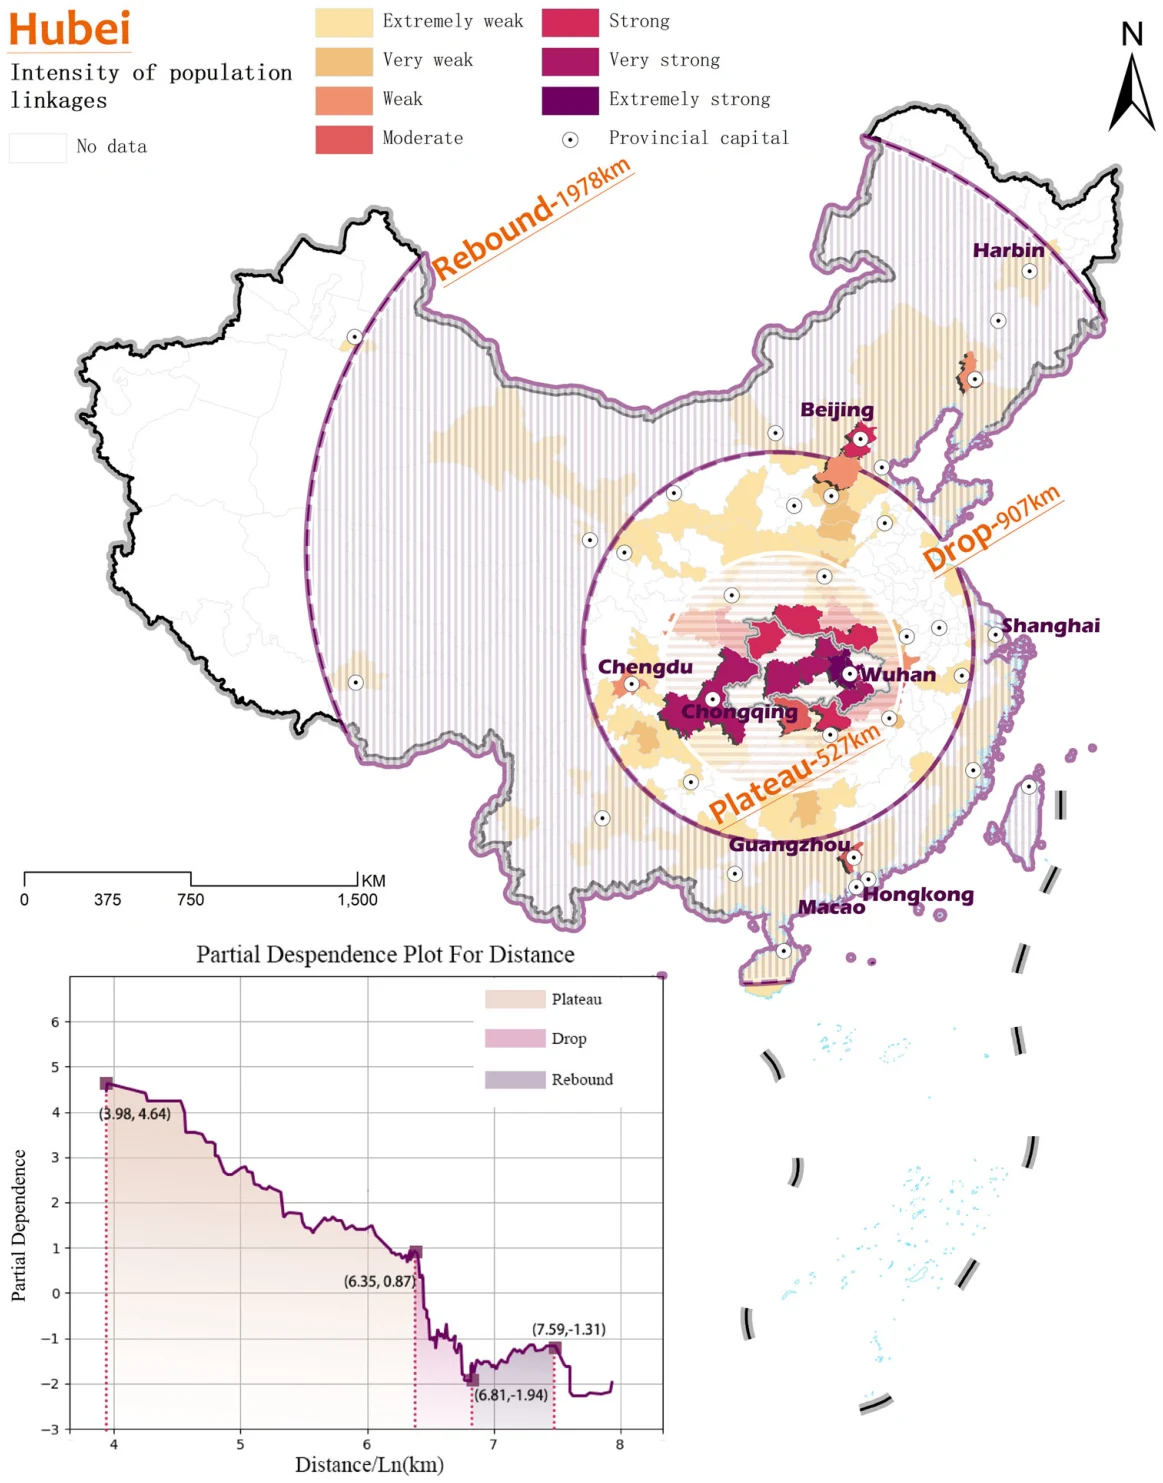
图 9|湖北的强联系停在哪一圈?
无字母子图。地图以武汉为中心,颜色由浅到深表示联系由弱到强,三圈标注平台527公里、下跌907公里、反弹1,978公里。左下小图是湖北的偏依赖,浅色、粉色、紫色对应三段。强色块集中在省内和紧邻城市。来源:原论文 Fig. 9。
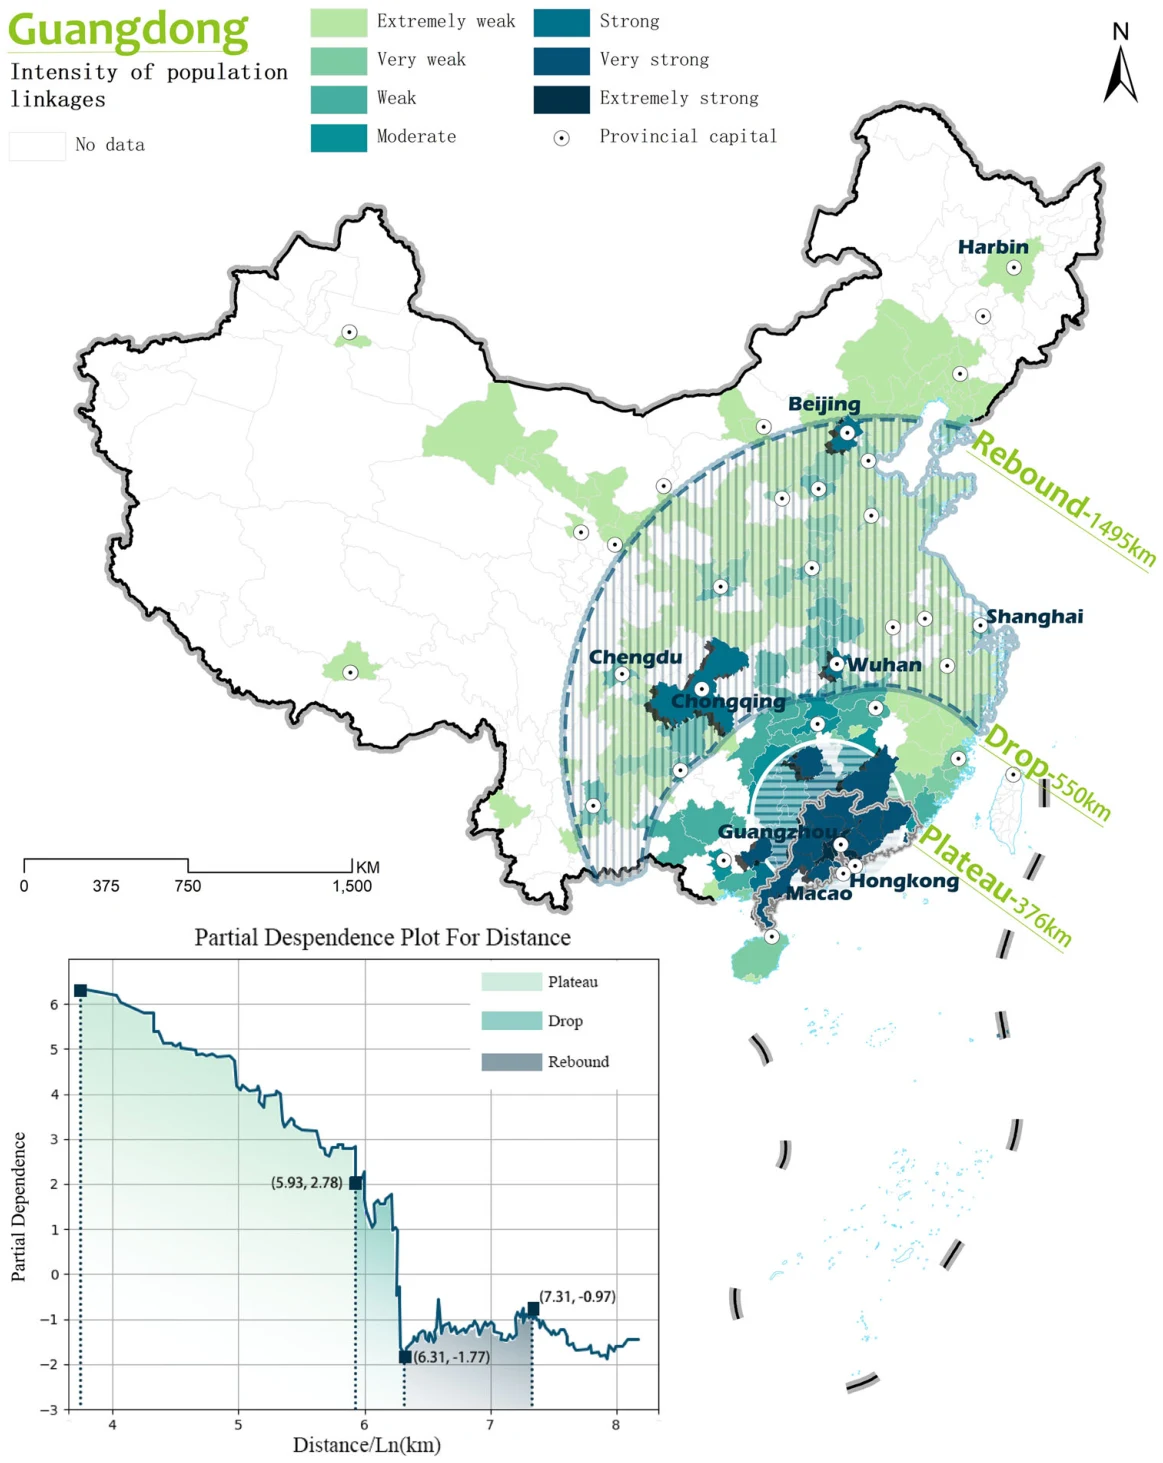
图 10|广东的三圈为什么比湖北更短,远距离却更有联系?
无字母子图。三圈为平台376公里、下跌550公里、反弹1,495公里。深色集中在珠三角,浅色沿更远城市铺开。小图在对数距离约5.93、6.31、7.31换段,与三圈的自然对数一致。纵轴仍是偏依赖,不是人数。来源:原论文 Fig. 10。
曲线能够说到哪里
距离和流量的关系在这套模型里不是单一斜率,这一点有偏依赖图和分省地图支持。把它说成户籍制度或行政权力不平等已经得到证明,则超出了模型。变量表里没有户籍,也没有“是否跨省”的指示变量。省界可能正好落在下跌段附近,也可能是那一段距离上就业、交通和城市规模的混合。作者在结论里把三种形态归结为行政分割下的资源不均,这是解释,不是图4里的一项重要性。
另外几处边界同样限制外推。数据是城际汇总,看不到个人属性和出行目的,返乡和旅游混在同一条OD记录里。只有一个节日窗口,而且正文内部把2018年2月1日至14日和2019年春节并写,无法讨论春运形态怎样随年份变化。国际比较也没有做。21个省份之外的西部省区,作者已经说明数据不够。偏依赖的置信区间在关键下跌段很宽,圈上的527或376公里是标注,不是带标准误的断点估计。
一句话总结
春运城际联系并不是距离每增加一公里就按同一斜率变少;在这20,155条地级市记录和梯度提升模型里,联系强度可以先平台、再下跌、再在更远的对数距离上有限回升,而且湖北与广东的转折公里数不同。这是模型的偏依赖,不是一次把距离改变之后的因果实验。
核心来源
- Humanities and Social Sciences Communications正式页面,核对题目、作者、2024年10月11日发表信息与数据声明。正式题为 Different roads take me home: the nonlinear relationship between distance and flows during China’s Spring Festival。
- 期刊2024年第11卷,文章号1356。收稿日期2024年2月6日,接受日期2024年9月13日。基金注明国家自然科学基金42271219,以及论文原文中的 Peking University (Shenzhen) Future City Lab Techand Open Research Fund [201802]。
- 正文图1至图10、表1至表3均来自这一正式版。数据声明写有补充信息文件;本次解读没有使用未在正文出现的补充表。
作者介绍
以下只写论文署名机构和贡献说明里能够核对的内容。
- Xiaofan Luan:武汉大学城市设计学院,湖北省人居环境工程技术研究中心。负责研究构思、数据分析与解释、文献、改稿、监督、基金和项目管理。
- Hurex Paryzat:同一武汉大学机构。负责数据分析、程序、制图、统计、初稿和修改。
- Jun Chu:北京大学深圳研究生院城市规划与设计学院城市未来实验室,以及超大城市空间治理现代化研究中心。负责研究构思、数据收集、分析、实验设计和文稿。
- Xinyi Shu:武汉大学城市设计学院及上述湖北研究中心。负责文献、初稿、数据分析、制图和统计。
- Hengyu Gu:南京大学地理与海洋科学学院,通讯作者。负责修改、结构调整和技术支持。本文参考文献中,其既有工作涉及中国城际流动与区内迁移的重力模型。
- De Tong:与Jun Chu相同的北京大学深圳研究生院机构,通讯作者。负责研究构思、结构、监督、基金、项目管理和资源。
- Bowen Li:论文署名为 Hubei United Investment Group Hubei Digital Industry Development Group,以及 Hubei Digital Industry Joint Innovation Institute,均在武汉。负责数据分析、程序、统计和技术支持。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果下跌真是省界,同一公里数就不该同时适合大省和小省。湖北的下跌圈标在907公里,广东标在550公里,已经说明阈值随省份移动。下一步可以把“目的地是否出省”单独放进模型,再看对数距离上的陡降还剩多少。若虚拟变量吸走了陡降,边界的解释就比一条全国通用的距离函数更站得住;若陡降仍在,那一段更可能是交通或城市规模的混合。
另一处容易混用的是表2和表3。常住人口比户籍人口多出的千人,是长期留下的存量缺口;20,155条记录是一个节日窗口的城际流量。一座户籍人口很多的城市,可以在春节接收大量返乡流量,也可以因为交通不便而很少出现在腾讯记录里。把存量缺口直接当成14天的客流排名,会把“谁的户口不在这里”和“这14天谁在移动”写成同一件事。