大组散场时,是先走掉几个人,还是对半拆开?
论文名片|Iacopo Iacopini、Márton Karsai、Alain Barrat,The temporal dynamics of group interactions in higher-order social networks,Nature Communications,2024,15:7391。2023年9月4日收稿,2024年7月25日接收,2024年8月27日发表。DOI:10.1038/s41467-024-50918-5。
四个人坐在一张午饭桌边。其中一人起身去取餐,剩下三个人并没有商量要换桌。若只问这三个人想不想走,答案可以是不想;若问原来那一组人还在不在,答案已经是否定的。下面用这个场景说明论文怎样给组记账。它不是数据里某一次被点名的午饭。
论文比较的是两种记账方式留下的不同问题。普通网络只保留谁和谁靠近过。高阶网络(higher-order network)则把同一时刻的一整组人记成一条超边(hyperedge)。组会变大、变小、拆开、再聚上。作者用学前儿童和大学新生的邻近记录看:一个人换组之后,新组的人数离原来有多远;同一批成员能连续待多久;一个组出生前、散掉后,最大的那一块还剩几个人。大学课外这一段,还可以用两条简单规则在现象上重现这些形状。规则能重现形状,仍然是模型输出,不是直接观察到的个人打算。
先说结论
- 五个情境里,换组后的新规模大多贴着原规模;只有独自一人时,下一步更常变成 2 人。组越大,换组后越偏向更小的组。大学上课的转移图画到 20 人,课外到 12 人,周末到 13 人;幼儿园上课到 11 人,课外到 8 人。这些是各图的坐标截止,对应各情境里出现的最大组。
- 组的持续时间是宽分布。组越小,分布越宽。图上只给规模 1 标了参照指数:大学上课约 τ−2.2,课外约 τ−1.7,周末约 τ−1.8;幼儿园上课约 τ−1.7,课外约 τ−1.9。大学一步是 5 分钟,幼儿园原始一步是 5 秒,指数可以对照形状,横轴不能当成同一种钟表时间。
- 中等和较大的组,聚合时最大的一块只比整组略小,解体时也是先少掉一小块。很小的组则在相近规模之间增减。5 人组里分出去的 3 人,只计入 5 人组的解体,不计入 3 人组的形成。
- 课外情境中,人在一组里待得越久,下一步换组的概率越低。所有规模合在一起时,大学课外的拟合约为 0.7τ−0.8,幼儿园课外约为 0.5τ−0.5。新组里已经认识的人占比,明显高于当时随机挑一个组。
- 模型用 700 个代理人、2000 个时间步、β = 0.8,去贴合大学课外的组规模分布和换组矩阵。持续时间分布和聚散热图没有进入拟合目标,形状仍然跟着出现。正文给出参数搜索范围,没有写出最终选中的 ε、α 和 k0。
传感器先记录谁靠近谁,组是后来定义的
大学数据来自哥本哈根网络研究(Copenhagen Network Study,CNS)。706 名丹麦技术大学的一年级学生用手机蓝牙记录邻近,公开部分是一学期里连续四周,时间步长 5 分钟。原始文件有 5,474,289 条记录。每条含时间、本人、对方和接收信号强度 RSSI,单位 dBm。数据论文已经去掉扫描方向。没有扫到别人时记一条 RSSI 为 0 的空扫描,作者把这当作孤立。
公开数据没有精确日期。作者用活动起伏对照该校本科课表,把记录分成三段:周一至周五 8:00–17:00 为上课,周一至周五 0:00–8:00 以及 17:00–23:59 为课外,周六和周日为周末。切分按钟点完成。8:00–17:00 整段都标成上课,落在这段里的课间和午休仍留在上课数据中。课外是工作日这段以外的时间,标签来自时钟,不来自每节课的进出记录。
清理按记录数往下走。去掉扫到未参与实验的设备后,剩 4,646,415 条。只保留 RSSI 高于 −90 dBm 的记录后,剩 3,824,052 条,其中 1,603,916 条是两两互动,2,220,136 条是空扫描。这个阈值比早先研究里大约对应 2 米的 −80 dBm 更松,所以大学里的组可以比面对面谈话更大。作者也把大学组比幼儿园组更大,归到蓝牙距离可能更远,这是对采集方式的解释。
接着补上 163,349 个空洞:某对互动在 t−1 和 t+1 都在、t 却缺席,就用相邻时刻的平均 RSSI 补上,有时替换已有的空扫描。再删掉 130,935 条只在单个时间步出现的两两信号,此时记录数为 3,855,139。因为补洞会替换旧记录,这几个数字不能用一条加减式互相还原。最后做三角闭包:若 i 扫到 j、j 扫到 k,就补上 i 与 k,信号取两条边中较弱的一条,并且只保留不低于 −75 dBm 的新边。作者把 −75 dBm 选成还能保住各情境组规模分布的最低阈值。若某个人因为删边在该时刻不再有任何互动,就重新记为孤立。最终数据有 3,991,329 条记录。
幼儿园数据来自法国一所学前班的 DyLNet 项目。174 名 3 至 6 岁儿童和 34 名成人、助教,分布在 7 个班。徽章用射频识别彼此探测,正文给出的面对面范围是 2 米以内。徽章每 5 秒以 0 dBm 发射 384 微秒,接收灵敏度 −94 dBm。采集覆盖连续 10 个月、每月连续 5 天,共 50 天;每周 9 个时段,5 个上午、4 个下午,周三不上课,周末不采集。徽章每天只同步一次时钟,因此短于 10 秒的互动被去掉。本文去掉成人,只保留儿童。
上课指同一班、并且互动的开始和结束都落在上课时间。不同班在上课时的接触,以及从上课跨到自由活动的接触,都删掉。课外指任意班级之间、开始和结束都在自由活动时间的互动,跨边界的接触同样删掉。某个时间步上没有互动的儿童,只有在同一上学时段里至少有过一次互动时,才被补回成孤立。幼儿园数据因此没有大学那种空扫描的全量底账。
每个时间步上,作者把邻近关系画成普通图,再取极大团(maximal clique):一组人彼此都有边,而且不能再加进一个人。这些团按时间排起来,就是时间超图。同一个人在一个时间步上可以同时属于几个极大团,也可以谁都不属于。后文的模型为了简单,假定每人每步只在一个组里。作者说大部分经验互动符合这一点,依据放在补充表 S1;正文没有写出这个比例。
组的寿命按成员集合计算。同一批人从第一次连续出现到最后一次连续出现,中间的时间步数就是持续时间 τ。出生前一步、死亡后一步,才用来看人是怎么聚上、怎么散开的。从某个人的角度看,别人加入或离开也算他换了组。作者故意不给组起一个会继承下去的名字,免得在成员一变时临时规定哪个组算原来那个。因此换组统计观察的是成员集合的变化,不是谁主动作了决定。
换组之后,新的一组有几个人?
组规模分布只说明某一时刻有多少人待在一起,看不出同一个人下一步去了哪里。转移矩阵补的是条件问题:已知这个人此刻在 k 人组里,而且下一步确实换了组,他出现在 k′ 人组的机会有多大。
计数需要小心。5 人里走开 1 人,剩下 4 人都会经历一次从 5 到 4 的变化。作者把流向某个目标规模的次数再除以目标组人数,使这一次离开不要被剩下的人算成四次。图里每一行又按自己的尺度来画,纵轴各行不同。能比较的是同一行里哪个 k′ 更高,不能把不同行的柱高当成同一种概率单位。
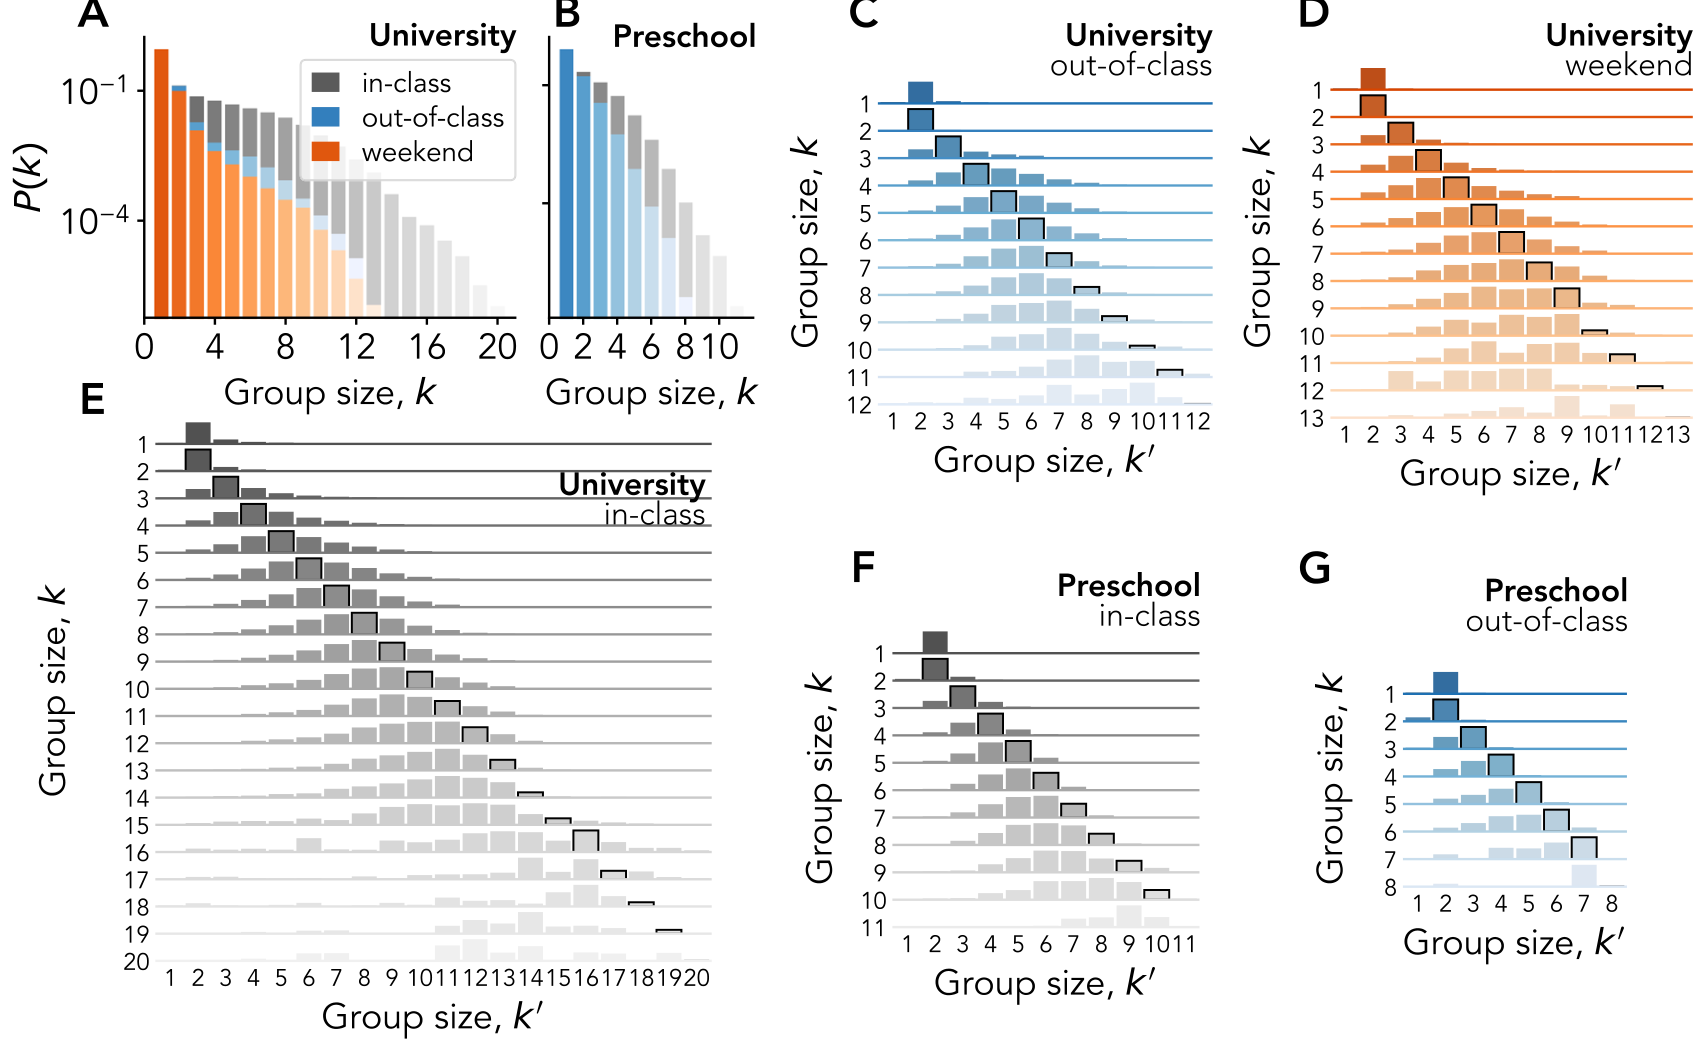
图 1|五个情境里,组有多大,换组后规模往哪边走?
(a)大学组规模分布,纵轴为对数坐标的 P(k)。灰是上课,蓝是课外,橙是周末,横轴画到 20。(b)幼儿园组规模分布,横轴画到 10,只有上课和课外。(c–e)大学课外、周末、上课的换组矩阵。每一行是原规模 k,横轴是新规模 k′,柱高按行显示,各行纵轴尺度不同。(f、g)幼儿园上课与课外的同样矩阵。来源:原论文 Fig. 1。
五个分布都是小组更多、大组更少,自由活动时大组更早变少。大学上课的灰柱拖到接近 20 人,课外和周末在更小的规模上就低下去。幼儿园整体更小,上课的灰柱也比课外的蓝柱延伸得更远。采集距离不同,所以大学和幼儿园的横轴长短不能单独解释成孩子比学生更不愿意成大组。
矩阵的共同形状是:k = 1 时,最高的柱在 k′ = 2;较小的 k 上,最高的柱靠近 k′ = k;k 变大以后,柱子移到对角线左侧,也就是换组后更常变小。离对角线很远的大跳跃很少。上课、课外、周末以及两个年龄段都是这个形状,差别主要在最大组画到哪里。一个人换组后,新组的规模通常离旧组不远;组已经很大时,下一次变化更常把它带向更小的组。
这个矩阵只看人数,不看是不是同一批人。同一个人连续两个组的成员重叠,用杰卡德系数(Jaccard coefficient,交集人数除以并集人数)可以很不一样:可能几乎全换了人,也可能只是有人离开、其余人都还在。作者报告两种情形和大量中间情形都出现过。因此从人数上的平滑变化,还得不出组是一个一个加人、还是整组合并。下一步要把账改记到组本身。
同一批人能连续待多久?
组的持续时间是成员集合保持不变的时间步数。图 2 把这个分布按组规模分开。规模 1 就是这个人当时不在任何多人组里,对应时间网络里说的空白期。空白期长短差得很远,就是阵发性(burstiness):短空白和很长的空白可以同时存在。
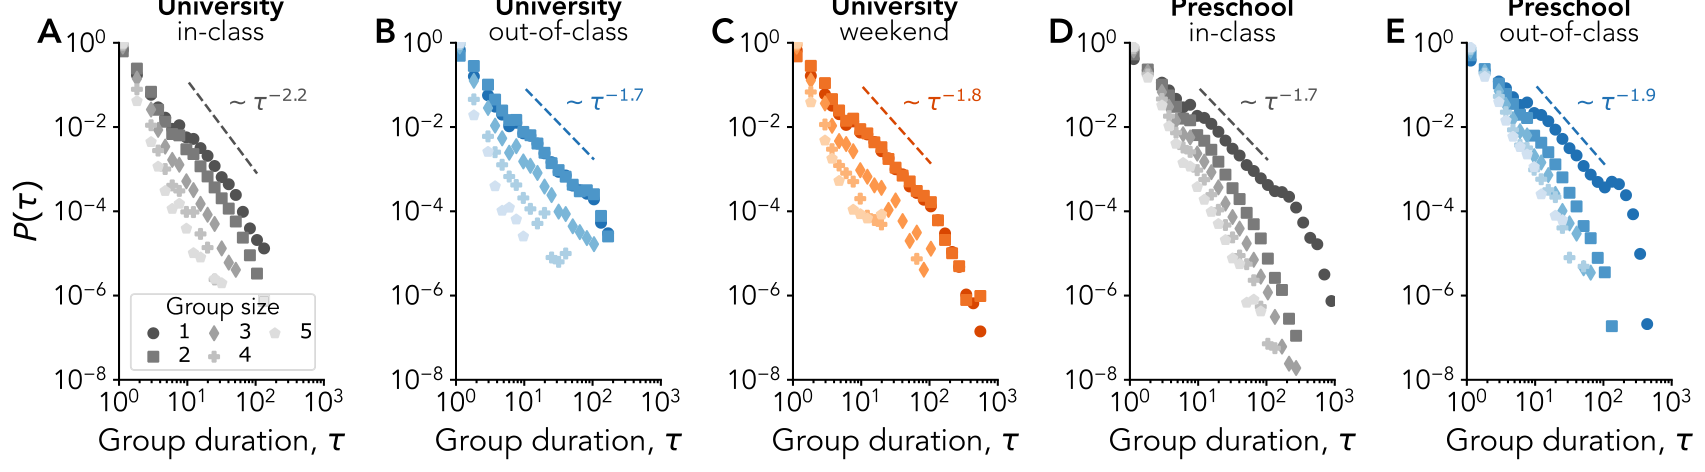
图 2|组越小,持续时间的分布是不是越拖得长?
(a–c)大学上课、课外、周末。(d、e)幼儿园上课、课外。横轴是持续时间 τ,纵轴是 P(τ),都用对数坐标。圆、方、菱形、十字和五边形依次是规模 1 至 5。虚线只拟合规模 1,图上标出的指数分别为约 −2.2、−1.7、−1.8、−1.7 和 −1.9。来源:原论文 Fig. 2。
五个情境的形状同类:都是宽尾,规模 1 的点延伸得最远,规模更大时分布更早掉下去。作者用 powerlaw 工具拟合规模 1,并在图上标出上述指数。这些指数描述的是独自一人这段空白有多宽,不是所有规模共用一个指数,也不是后面模型里的 β。
大学的 τ 以 5 分钟为一步,幼儿园以 5 秒为一步,并且不到 10 秒的互动已被去掉。幂律指数在时间单位成比例变化时可以保持,所以作者拿形状和指数做对照;103 个大学时间步和 103 个幼儿园时间步不是同一段钟表时间。情境在课表边界被切开,一个组也不会跨过作者划定的上课与课外继续累计。
正文还报告,按组规模拆开之后,组与组之间的间隔同样很宽。多人组的持续长短不一,越小的组越容易出现很长的持续。较大的组更短命。它们怎样裂开,要看下一部分怎样给聚合和解体记账。
大组出生前,最大的一块有几个人?
对每个规模为 k 的组,作者在它出生的前一步,找出成员与它相交、并且本身比它小的那些组,取交集最大的那一块有多少人。死亡后一步做同样的计算。热图的中间一列是 k,左边是聚合成 k 之前最大一块的规模,右边是散开之后最大一块的规模。颜色从 0 到 1,表示这个规模在该类事件中的比例。虚线是分布的平均。
这个定义把事件分成长大和缩小。5 人组中分出 3 人,只进入 k = 5 的解体统计,不进入 k = 3 的聚合统计。因此左右两边不是同一批事件的复式记账,也不能把每一格读成“每个人从哪个组走来”的完整去向。
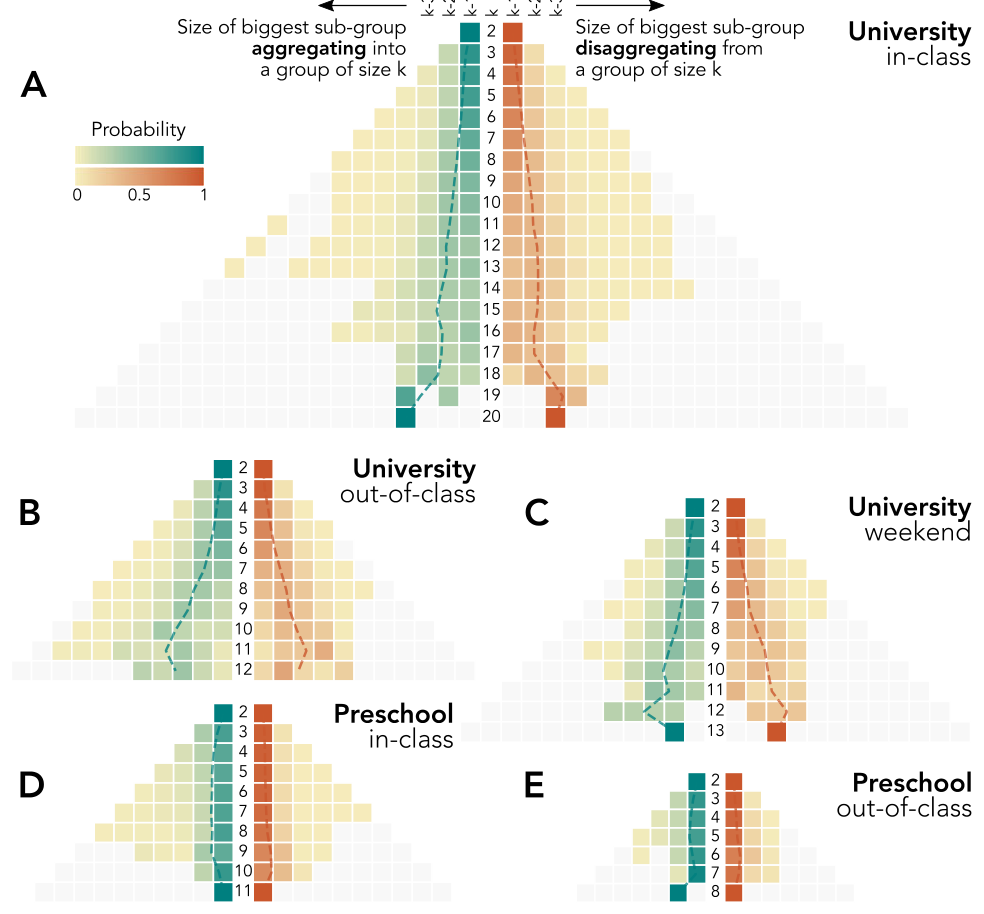
图 3|组是由差不多大的两块拼成,还是由稍小的一块再加人?
(a–c)大学上课、课外、周末。(d、e)幼儿园上课、课外。中间数字是组规模 k。左侧是聚入之前最大子组的规模,右侧是散开之后最大子组的规模。颜色是概率,图例标出 0、0.5 和 1。虚线是该分布的平均。来源:原论文 Fig. 3。
小组的左右两侧都靠着中间的 k,平均虚线也贴着 k。人是在相近规模之间逐渐增减的。组变大以后,颜色和虚线仍然留在比 k 略小的位置,而没有集中到 k 的一半。作者的读法是:中等和较大的组,通常由一个稍小的组再并入一个或少数几个小组而形成;散开时先少掉一小块,留下的仍是中等或较大的组。五个情境都有这种左右大体对称的分层,大组一端会随情境略有差别。
从组合可能性上,两个规模接近的组互相合并并不是不可能。经验图里这种对半拼接没有成为主要颜色。这支持“先有小组,再逐级合成更大的组,散开时按相近的顺序退回来”。它还不区分是谁邀请了谁,也不排除课表、座位或房间同时把同一批人留在附近。
待得越久,下一步就越不容易换组吗?
旧的面对面模型常常让人离开后先变成孤立,再由孤立的人加入任意大小的组。那样做,图 1 里沿对角线的换组就出不来。本文把决定拆成两步。一个人被抽到时,先决定留在当前组还是离开;若离开,再在当时存在的其他组以及独自一人之间选择。
第一步用停留时间。经验上先计算风险率:在规模 k 的组里已经连续停留 τ 步的那些人时里,下一步真的换组的比例。图 4 的 a、d 把所有 k 合在一起,点是分箱后的结果。大学课外标成约 0.7τ−0.8,幼儿园课外标成约 0.5τ−0.5。拟合线表示整体下降。幼儿园课外里,短 τ 的点位于线的上方,较长 τ 的点落到线的下方。正文报告按规模分开后,下降趋势仍在。
模型把这个下降写成
pk(τ) = bk / (τβ / N) = N bk / τβ。
β 调节停留时间的分量,N 是人数。每个时间步里,全部 N 个人会按随机顺序各更新一次,除以 N 是在这个更新节奏下重标尺度。以 1 − pk(τ) 的概率留下。大学课外的模拟把 β 固定为图 4a 的 0.8。按字面代入,N = 700、bk 接近 1、τ = 1 时,这个数会远大于 1。正文没有说明超过 1 时是否截断。它还不能被直接读成已经校准好的每步概率。
bk 让离开倾向随组规模变化。作者先用上面的 β,把各规模的风险率再拟合出一套 bk,然后用 logistic 形式概括它:
bk = 1 / (1 + e−α(k − k0))。
这个函数最高到 1。图上大学课外的经验点随 k 上升,有的点超过 1.0 的刻度,误差棒是 95% 置信区间;作者认为 logistic 曲线落在这些区间内。幼儿园课外的纵轴标到 0.75,点在较小的 k 上上升后变平。这里的 bk 是风险率拟合的系数,本身不必小于 1。模型后来使用的是 logistic 这一族形状,α 和 k0 还要和另一项参数一起,按别的图来挑选。
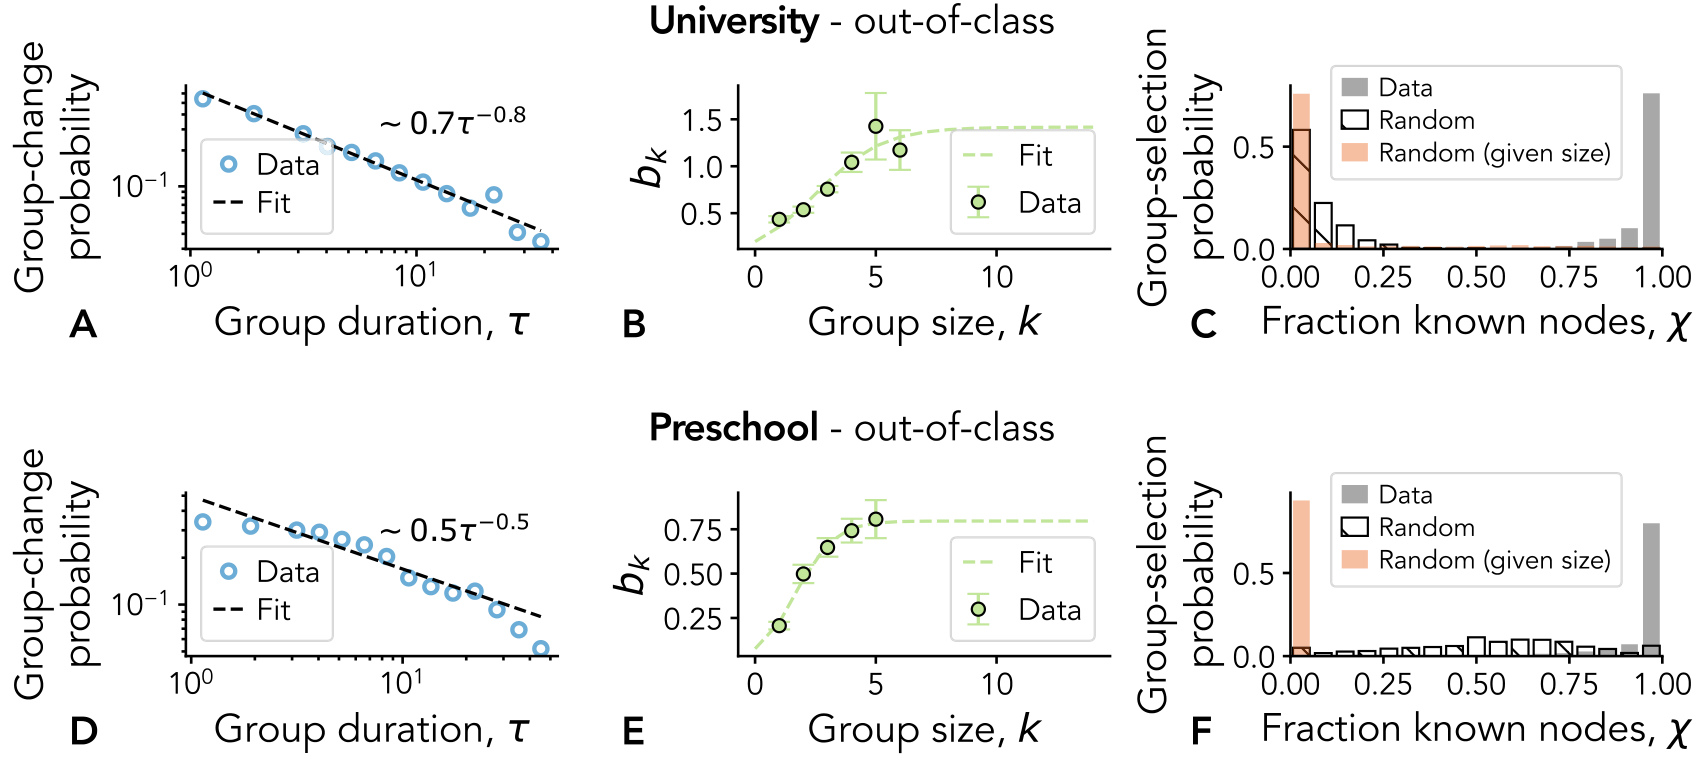
图 4|换组会不会随停留变少,新组里是不是有更多认识的人?
(a、d)课外情境下,所有组规模合在一起的换组概率随 τ 下降。蓝点是分箱数据,虚线是幂律拟合,大学约为 0.7τ−0.8,幼儿园约为 0.5τ−0.5。(b、e)由此得到的 bk 随 k 变化,误差棒为 95% 置信区间,虚线为 logistic 拟合。(c、f)新组中已知成员所占比例 χ 的分布。灰是数据,白是在当时存在的组里均匀随机,橙是在与真实目标同规模的组里随机。来源:原论文 Fig. 4。
第二步检查社会记忆(social memory):换组时,新组里有多大比例的人是这个人以前遇到过的。对照有两个。一个是在下一时刻实际存在的组里均匀随机选。另一个再加上规模必须等于经验中的目标组;变成独自一人的转移无法做这种同规模随机,因此从该对照里去掉。变成孤立时,已知成员比例按定义是 0,去掉这些转移会让数据和对照显得更接近。即便如此,图 4c 和 4f 里,数据在 χ 靠近 1 的位置有一根超过 0.5 刻度的高柱,同规模随机对照则把最高的柱放在 χ 靠近 0、同样超过 0.5 的位置。大学的完全随机对照也挤在低 χ;幼儿园的完全随机对照在中间比例还有一排较矮的柱。已知比例高于随机,说明选择偏向已经一起待过的人。它还没有分开这种偏向来自个人选择,还是来自反复出现在同一间教室。
模型里的选择概率按一个修正后的已知密度:
χ†i,ω(t) =(1 + ω 与 i 过去各组成员的交集人数)/(1 + ω 的人数)。
分子和分母里的 1 把本人算进去,这样全是陌生人的组也不会得到 0。空组按这个定义得到 1。作者再放入 ε 份空组副本,用来调节离开后变成独自一人的倾向。候选人在所有这些组和副本上,按 χ† 归一化后抽取。
两条规则,能重现大学课外的哪几张图?
因为五个情境的形状相近,作者只拿大学课外做模型例子。代理人人数 N = 700,接近但不是队列里的 706 人。模拟 2000 步,β 固定为 0.8。ε、α 和 k0 在 ε 从 1 到 30、α 从 0.05 到 0.95、k0 从 3 到 14 的组合里搜索。正文把被搜索的位置参数写成 n0,对应公式里的 k0。
挑选标准是两个 KL 散度(Kullback–Leibler divergence,衡量两个分布差多远)各占一半:一个比较组规模分布的对数,一个比较换组矩阵。持续时间分布和聚散热图不参加选参。正文展示选中的那次运行,但没有列出胜出的 ε、α 和 k0。
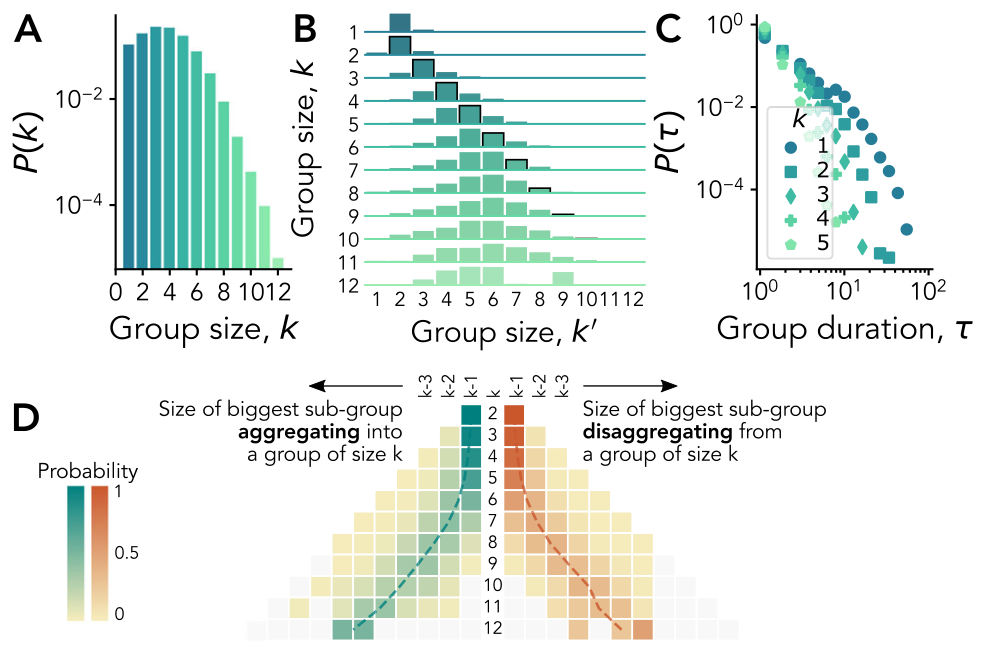
图 5|没有拿去拟合的持续时间和聚散,是否也会出现?
(a)模型的组规模分布,横轴画到 12,纵轴为对数 P(k)。(b)模型的换组矩阵,行是原规模,列是新规模,画到 12。(c)不同规模的持续时间,图例只画出 k = 1 至 5,横轴到约 102。(d)模型的聚合与解体热图,中间一列是 k,左右是最大子组规模,颜色从 0 到 1,虚线为平均。来源:原论文 Fig. 5。
组规模分布覆盖的范围与大学经验图里课外这一档相当。换组矩阵在小规模上沿对角线较高,大规模上偏向更小的新组,和大学课外的经验矩阵同类。持续时间仍是宽尾,规模 1 延伸得更远。聚散热图也是小组贴着原规模、更大的组只比 k 略小。后两张图没有被放进 KL 目标,所以它们是同一套规则的额外后果,不只是把已拟合的两张图再画一遍。
作者把这种一致停在现象层面,并给出原因:时间超图之间还没有公认的距离;不同数据的最大组不同,矩阵尺寸和分布截断也不同;他们不愿为宽分布宣称某种精确函数或普适指数;即便临时造一个综合差距,也没有参照值说明多小才算好。因此“重现了”指的是这些图的主要形状,不是一个经过统一评分的拟合优度,更不是唯一机制。
这些相似,能说到哪一步?
上课时的组受到课表和座位的约束,课外和周末更接近可以自己走位的时间。两类时间都出现相近的换组、持续时间层级和聚散形状。作者在讨论中还写道,四场由 GESIS 组织的学术会议里,参会者年龄和资历更杂,会议日程也比课堂自由,补充分析中仍有相近的组统计和换组模式。会议数据需向原始发布者申请,不在本文这五张主图里。
这种跨情境的相似,说明组规模的动态有稳定的统计外形。它没有证明课堂约束和自由选择背后是同一种个人动机。大学的组来自较松的蓝牙阈值,幼儿园的组来自大约 2 米的面对面探测。同样叫作组,测量半径并不相同。极大团来自两两邻近,一个人还可以同时落在多个团里;没有专门追踪群体互动的纵向数据时,这是一种代理定义。贝叶斯重建、统计显著超边或更松的成组条件,会不会改变矩阵,正文提出了问题,没有在这里重做。
模型每人只在一个组里,记忆只累计以前同组的人,没有地点、课程或意见。社会记忆高于随机组,仍然可以部分来自反复同处一室。公式在短停留和大组上会给出大于 1 的数,实现细节要回到代码才能确认。作者也没有在这篇文章里把疾病传播、规范形成或意见更新放到这条时间超图上跑完。模型被呈现为以后做这些过程时可以用的合成底图。
相关的边界可以收成四句。换组统计记录的是成员集合变了,不是谁想离开。拟合两张图之后又出现另两张相似的图,说明规则足以产生这些现象,不足以证明没有别的规则。未在正文写出的最优参数,不能从搜索区间里猜一个来用。会议和补充图里的稳健性,以作者在正文中的概述为限。
一句话总结
较大的组通常附着在稍小的一组上增减少数几个人,很小的组则在相近规模间变动;停留越久越稳定、并且偏向已经认识的人,这两条规则能重现大学课外的主要形状,但形状一致还不是个人意图或唯一机制。
核心来源
- Nature Communications 论文页面,核对题目、作者、2024年8月27日发表信息、正文图 1–5 与补充材料入口。
- 哥本哈根网络研究公开数据,大学蓝牙邻近的原始发布。
- DyLNet 学前数据,幼儿园邻近数据的原始发布。
- 分析与模型代码,归档版本 10.5281/zenodo.12698353。
- 正文讨论提到的四场会议数据见 10.7802/2351,需向原始发布者申请。
作者介绍
以下只写论文署名机构和本文贡献,不补充论文未列出的头衔。
- Iacopo Iacopini:通讯作者。署名为伦敦东北大学网络科学研究所、波士顿东北大学物理系,以及维也纳中欧大学网络与数据科学系。他完成数据分析、模型实现和数值模拟,并与另外两位作者共同设计研究、讨论结果和写稿。
- Márton Karsai:署名为维也纳中欧大学网络与数据科学系,以及布达佩斯 HUN-REN 阿尔弗雷德·雷尼数学研究所的国家卫生安全实验室。他参与研究设计、结果讨论和写稿。
- Alain Barrat:署名为艾克斯-马赛大学、土伦大学、法国国家科学研究中心 CPT,以及图灵生命系统中心。他参与研究设计、结果讨论和写稿。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若要用这条合成超图讨论传染,规模 1 的长尾会让一些人连续很多步不进入多人组。此时应把两两接触的总时长固定住,只改变这些接触是分散发生,还是被捆成同时在场的组,再比较暴发规模。差出来的部分才更接近高阶同时在场所多出来的效应。论文把模型当作以后可接过程的底图,并没有做这个对照。
另一个可分开的问题是记忆和地点。χ 已经高于当时随机能选到的组,而大学的情境只按钟点切开,同一房间里的反复共现仍会留在对应时段里。可以把课程或房间编号放进选择概率,看在地点之外,曾经同组还能剩下多少。若记忆项因此明显变小,图 4 里靠近 1 的高柱就有相当一部分来自重复出现在同一地点。