知道谁和谁相邻、直线有多远,一座城市的起讫流量就能定下来吗?
论文名片|Zherui Huang、Guanjie Zheng、Hao Xue、Linghe Kong,GeoFlow: Geo-Aware Modeling of Inter-Area Relationships in Origin-Destination Flow Prediction and Generation,Proceedings of the 43rd International Conference on Machine Learning,首尔,PMLR 306,2026。会议稿同时以 arXiv:2607.05257v1 于 2026 年 7 月 6 日发布。代码地址写在摘要中:github.com/ZheruiHuang/GeoFlow。
设想一块待规划的城区。每个片区已经有人口和兴趣点,路网也标出了谁与谁直接相连,片区中心之间的直线距离可以量出来。人多、直线近,流量似乎就该大。可两个片区可以在地图上几乎挨着,沿路却要绕行;也可以落在同一条放射走廊上,彼此争抢同一个终点。通勤流量、货运吨数、到访人天,都要在这种几何里分配。这个场景只用来贴近机制,论文没有把它写成某一座城市的真实规划案例。
GeoFlow 把相对位置、路网跳数和沿路最短距离直接交给模型,并让同一起点的各个终点、同一终点的各个起点互相比较。点预测在通勤、货运、航空三套数据上,三次划分平均后都优于所比较的 TransFlower。生成任务里,通勤和货运的流量重叠更高,航空到访的重叠低于 WEDAN,而样本之间的差异更大。含上百个片区的大区域,以及数量占绝大多数的小流量格子,重叠仍然很低。
先说结论
- 点预测按三次独立划分取平均。通勤上,GeoFlow 的流量重叠 CPC 为 0.604,对照 TransFlower 的 0.486;归一化均方根误差 NRMSE 为 1.727,对照 2.146。NRMSE 的分母是真实矩阵全部条目的标准差。货运、航空的三项指标同样优于这张表里的 TransFlower。
- 生成仍是三次划分的平均。通勤 CPC 为 0.566,对照 WEDAN 的 0.527;货运为 0.485,对照 0.480。航空 CPC 为 0.457,低于 WEDAN 的 0.486。表 1 另有一列不按数据集拆开的多样性,GeoFlow 为 0.069,WEDAN 为 0.053。多样性是同一条件下多张生成矩阵之间的平均成对 RMSE,数值大表示样本彼此差得更远。
- 通勤消融在编码器和解码器都保留时,只输入直线距离的生成 CPC 为 0.462,四项地理特征一起为 0.527。预测 CPC 从 0.594 到 0.597,NRMSE 从 1.994 降到 1.730。货运上,完整模型的预测更稳,生成的 CPC 和 NRMSE 却可以由去掉部分模块的变体更好。
- 2252 个通勤区域里,片区数达到 100 及以上的大区域有 149 个。三种尺度都参与训练时,小区域 CPC 为 0.769,大区域为 0.139。流量数值落在 [0, 5) 的起讫对占全部起讫对的 83.18%,这一档的 CPC 为 0.105。
三套流量,分别在数什么?
研究对象是区域之间的起讫流量(origin–destination flow,OD 流量):从片区 i 到片区 j 的总量,分析单位是一张区域矩阵,到不了某一个人的轨迹。论文把同一套框架用在三种差别很大的流量上。
| 数据 | 区域样本数 | 每区片区数(最小 / 平均 / 最大) | 零格比例 |
|---|---|---|---|
| 美国通勤 CommutingODGen | 2252 | 4 / 30.1 / 1318 | 9.19% |
| 美国货运 FAF5 2022 | 5000 | 10 / 56.9 / 132 | 0.02% |
| 新西兰到访 Tourism Volumes and Flows | 1980 | 43 / 43.9 / 62 | 50.66% |
零格比例是各区域矩阵中零条目所占份额,再对区域取平均。通勤样本平均只有 9.19% 的格子为零,这是该基准里这些区域样本的密度,不能直接当成所有城市通勤矩阵都这么密。货运几乎没有零格,因为子区域是沿着有货流的邻居长出来的。
通勤来自 CommutingODGen,论文称它覆盖美国多种城市环境中的通勤流。本文 PDF 没有再写这套通勤数据的普查年份。货运附录写明,使用 FAF5 2022 的区域间货运吨数,距离取 FAF 距离带的中点;正文介绍数据源时,写的是美国交通统计局货运分析框架 2018 至 2024 年的年度估计。实验表使用的是构造后的 5000 个子区域。子区域规模从 Beta(2, 3.21) 抽到区间 [10, 132],平均约 56.9 个片区,再从货运吞吐量大的 FAF 区出发,按吨数加权向外扩展。这里的流量是吨数,分母也是吨数。
航空到访来自新西兰商业、创新与就业部公布的 Tourism Volumes and Flows,原料是到访人天(visitor-days)的起讫表。它统计的是人天,论文没有把它换成去重后的游客人数。每个分组先做一张完整的客源—目的地二分网络,再随机抽取 70% 客源市场和 70% 目的地,另做 21 张子网络,合计 1980 个区域样本。只有客源到目的地的格子是有效观测,客源之间、目的地之间以及反向格子被标成无效。
三套数据的时间、空间单元和流量单位都不相同。后文的 CPC 可以并排比较形状,不能把 0.604 的通勤重叠和 0.808 的航空重叠读成同一种出行被预测得更好。
点预测交一张表,生成交一组可能的表
给定片区特征和片区之间的地理关系,点预测要估计一张流量矩阵。生成还要从一个随机种子出发,交出同一条件下可能出现的不同矩阵。论文用流匹配(flow matching)学习从噪声走到数据矩阵的速度场;作者认为这是该任务上首次使用流匹配。训练目标是预测速度与目标速度的均方误差。采样时从噪声积分到一张矩阵。附录采用线性插值,目标速度等于数据减去噪声,具体积分步长没有给出一个固定整数。
评价横跨三次独立划分的平均。论文没有写明训练、验证、测试各占多少。
流量重叠用通勤公共部分(Common Part of Commuting,CPC)。尽管名字来自通勤,货运吨数和到访人天也用同一公式:
CPC = 2 × Σ min(预测ᵢⱼ, 真实ᵢⱼ) / (Σ 预测ᵢⱼ + Σ 真实ᵢⱼ)
分子是两边在每个格子上都能对上的流量,分母是预测矩阵与真实矩阵的总量之和。两张矩阵完全一致时 CPC 为 1。它衡量体积有多少叠在一起,回答的是总量对得上多少,单独看它还不知道哪些小格子被放错。
归一化均方根误差(NRMSE)先算全部格子的均方根误差,再除以真实矩阵条目的标准差。标准差和均值都按 n×n 个条目计算。NRMSE 为 1.727,表示均方根误差是真实矩阵标准差的 1.727 倍。詹森–香农散度(Jensen–Shannon divergence,JSD)比较分布,范围是 0 到 1,越低越接近。主表每种方法、每套数据只报一个 JSD;附录才把流入、流出和全部条目拆开。主表没有写这个数是不是三者的平均。
多样性只用于生成。它是同一条件、不同随机种子下,生成矩阵两两之间距离的平均,论文在这项工作里用 RMSE 当这个距离。表 1 给每种生成方法一个数,没有按通勤、货运、航空拆开,也没有在表旁写出平均时用了多少张样本。图 5 展示的是每个区域三张独立样本,不能据此把表 1 的多样性算成三张样本的平均。
预处理把每个区域的原始流量除以该区域总流量,变成一组加总为 1 的份额,并留下总流量,以便之后乘回去。CPC 和 NRMSE 对全体格子的同一倍率缩放不敏感,所以主表这些相对指标可以跨区域比较。附录里通勤尺度实验的 RMSE、MAE 没有再除以标准差,数字是几十到一百多,和表 1 的 NRMSE 不是同一口径。
邻接矩阵和直线距离,漏掉了哪一种几何?
图模型通常保存邻接和直线距离。共线、相对方位、沿路绕行,不容易从这两张矩阵里重新读出来。论文用一个单独的多层感知机做检验:只给邻接和直线距离,让它去预测相对角度、k 跳距离和自由流距离。
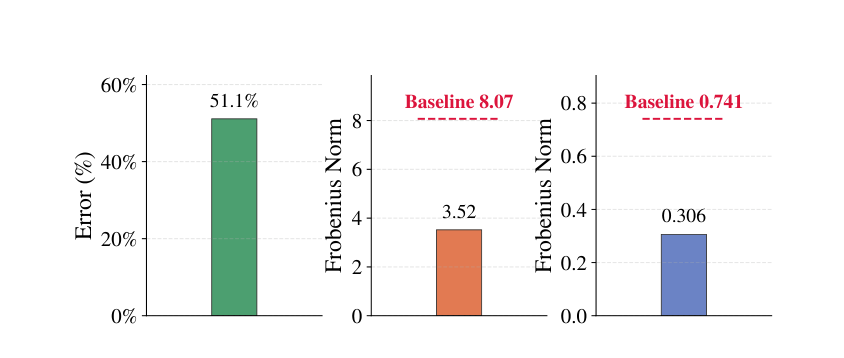
图 2|只靠邻接和直线距离,更高阶的地理量能补回来吗?
无字母子图,三根柱从左到右排列。左柱是相对误差 51.1%,正文把它解释为角度的平均相对误差;图的横轴没有印出 angle。中柱的 Frobenius 范数为 3.52,红色虚线基线为 8.07。右柱为 0.306,基线为 0.741。8.07 和 0.741 分别与表 3 里、按行归一化之后,直线距离相对 k 跳、直线距离相对自由流距离的 Frobenius 范数相同。柱子低于基线,说明这个感知机比“直接拿直线距离代替网络距离”更接近目标;正文仍把剩余误差看作跳数和沿路距离难以隐式补全的证据。来源:原论文 Fig. 2。
表 3 把三种距离矩阵都按行归一化,使每一行的和为 1,再比较差距。直线距离与自由流距离的 Frobenius 范数为 0.741,平均绝对差 0.021,最大绝对差 0.128。平均看起来接近,最坏的格子仍可以差 0.128。k 跳与直线距离的范数为 8.07,平均绝对差 0.149,最大绝对差 0.424;k 跳与自由流距离同样差得很远,范数 7.98。跳数记录的是路网上要经过几段,和按边长算出的最短路不是同一件事。
因此 GeoFlow 对每个起讫对直接附上三种关系。相对位置是区域自建坐标系里的坐标差:原点放在区域几何中心,x 轴转到方差最大的方向,再把坐标缩到 [−1, 1]。这样做减轻平移、旋转和城市尺度的影响,同时留下片区之间的相对方位。k 跳距离是路网上无权最短路的跳数。自由流距离(free-flow distance,也称 geodesic distance)是按路网边长计算的最短路长度,论文把它当作没有拥堵时的行程长度,它还不是高峰行程时间。
方法部分和预处理按直线、跳数、路网最短路构造关系。货运附录又写距离来自距离带中点,航空样本是客源与目的地的二分网络。三套数据里的“沿路距离”不保证都是同一套道路最短路。模型框架相同,地理关系的来源随数据改变。
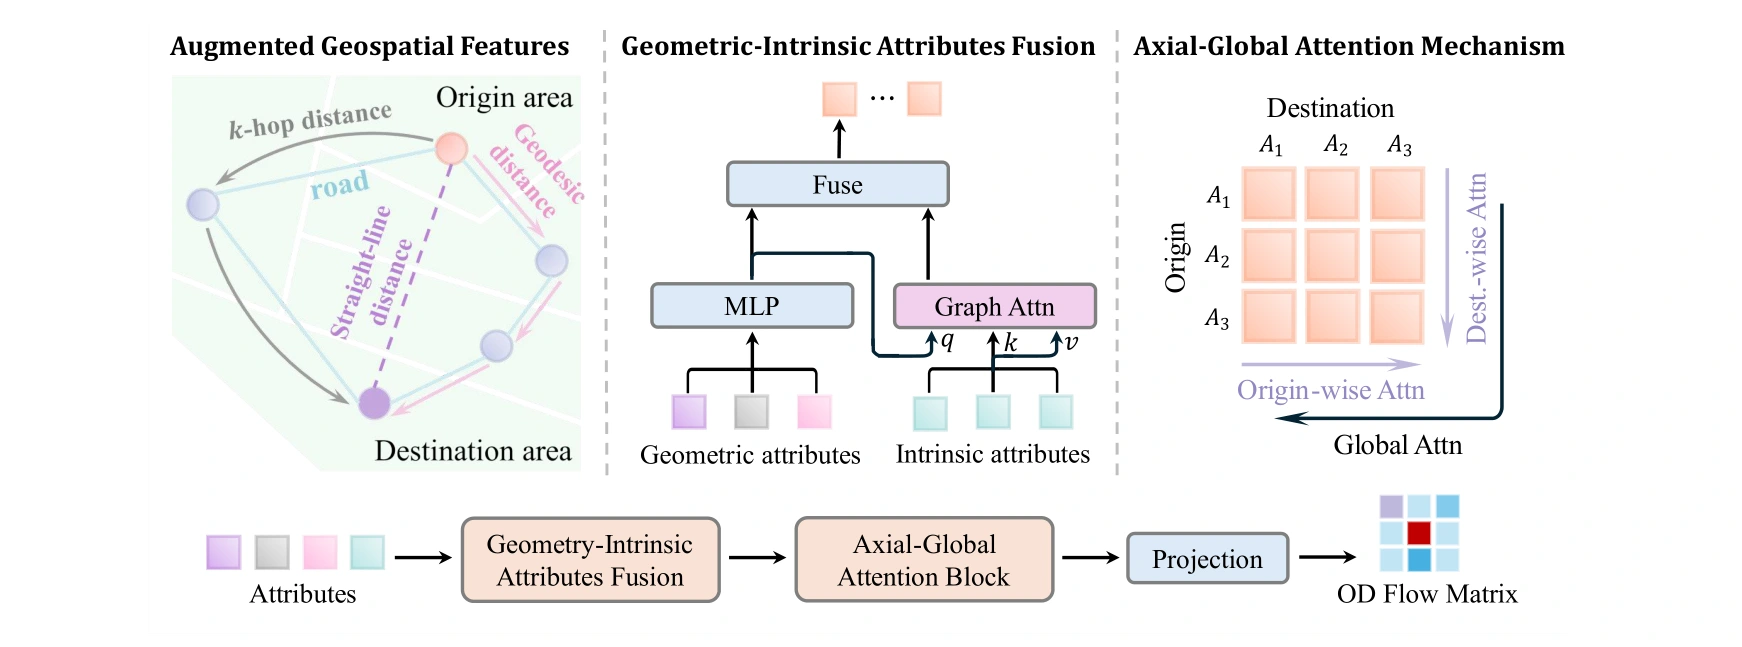
图 1|地理关系、片区属性和起讫竞争,怎样合成一张流量矩阵?
无字母子图。上排左栏把直线距离、k 跳和沿路最短路画在同一对起终点上。中栏用多层感知机编码成对的几何属性,用图注意力汇总兴趣点、人口这类片区内禀属性,再融合成每个起讫对的表示。右栏在起点—终点网格上先做沿起点方向、沿终点方向的注意力,再用区域级的全局注意力把信息送回网格。下排是总流程:属性进入融合模块和轴向—全局注意力块,投影成一张 OD 矩阵。来源:原论文 Fig. 1。
片区内禀属性先在区域内按列除以最大值,缩到 [0, 1]。几何属性另行归一化,再与起点、终点两侧的内禀表示拼接。解码若让每一对起讫都去看其他所有起讫,代价会随片区数的四次方增长。平均一个通勤区域有 30.1 个片区,最大的有 1318 个,对应 1318×1318=1,737,124 个起讫格子。轴向注意力改为:固定起点,比较它的各个终点;再固定终点,比较来自不同起点的流量。全文把后一步理解成目的地容量有限时,不同来源会互相挤占。随后把每个起点、每个终点的表示做平均,在片区数量这个更小的尺度上做全局注意力,再乘回每一对起讫。点预测在解码结果上接一个网络,输出整张矩阵,损失是归一化流量的平均平方误差。
和 TransFlower 比,表 14 在主实验同一配置、预热后的稳态运行里测到:GeoFlow 平均训练时间 0.0160 秒,TransFlower 为 0.0580 秒;推理 0.1104 秒对 0.4468 秒。论文据此写训练大约快 3.6 倍、推理大约快 4 倍。同一张表里 GeoFlow 的平均浮点运算是 6.12×10⁸,TransFlower 是 1.49×10⁸,峰值显存分别是 2.23×10⁴ 与 2.31×10⁴ MiB。更快的墙钟时间与更高的运算量同时出现,说明的是这种实现在当时硬件上的吞吐,不能单独证明每个城市、每种实现都更快。
片区数一旦超过 500,耗时就明显上升。表 13 以毫秒计每步耗时:500 个片区以上,预测推理平均 37.0 毫秒,生成推理平均 918.5 毫秒;200 个片区以下,生成推理大约是 105 到 111 毫秒。生成推理要做多步积分,所以慢于只前向一次的点预测。
三套数据上,它比最强对照好多少?
对照分两列任务。预测侧有引力模型、随机森林、梯度提升回归树、支持向量回归、深度引力模型 DGM、GMEL 和 TransFlower。生成侧有 NetGAN、DiffODGen 和 WEDAN。表 1 的数字都是三次独立划分的平均。
通勤预测里,引力模型 CPC 为 0.287、NRMSE 为 5.631、JSD 为 0.575。TransFlower 升到 0.486、2.146、0.281。GeoFlow 为 0.604、1.727、0.171。CPC 比 TransFlower 高 0.118,这个差值相当于 0.486 的 24%。NRMSE 低 0.419,相当于 2.146 的 19%。货运预测的 CPC 从 0.593 到 0.645,NRMSE 从 1.042 到 0.606,JSD 从 0.098 到 0.048。航空预测的 JSD 全体都较小,引力模型为 0.044,GeoFlow 为 0.013;CPC 从 TransFlower 的 0.773 到 0.808,只高 0.035。航空矩阵更规则时,重叠的提升空间也更小。
生成不能拿来和上面的点预测 NRMSE 直接比大小。通勤生成的 NRMSE 是 4.330,点预测是 1.727;前者交的是一张采样矩阵,后者交的是一个点估计。与同为生成模型的 WEDAN 比,通勤 CPC 从 0.527 到 0.566,NRMSE 从 4.609 到 4.330,JSD 从 0.196 到 0.174。货运 CPC 从 0.480 到 0.485,只高 0.005;NRMSE 从 1.183 到 0.883,JSD 从 0.128 到 0.111。体积重叠几乎持平,格子误差和分布差下降得更多。
航空生成的 CPC 是这张表里的例外:WEDAN 为 0.486,GeoFlow 为 0.457,低 0.029。GeoFlow 的 NRMSE 为 1.213,对照 1.485;JSD 为 0.031,对照 0.036。多样性一列里,GeoFlow 0.069,NetGAN 0.065,WEDAN 0.053,DiffODGen 0.048。航空上,样本彼此差得更远,与真实矩阵的体积重叠却更低。多样性高,支持的是样本没有塌成同一张表;它还不支持每一张样本都更接近真实到访。
地理特征补上的,主要是哪一个指标?
表 2 的消融做在通勤数据上。特征那一组始终使用所提编码器和解码器。编号 1 只勾选直线距离,预测 CPC / NRMSE / JSD 为 0.594 / 1.994 / 0.172,生成对应为 0.462 / 6.162 / 0.252。编号 5 把相对位置、k 跳和自由流距离都加上,预测为 0.597 / 1.730 / 0.171,生成为 0.527 / 4.330 / 0.194。生成 CPC 上升 0.065,相当于 0.462 的 14%;生成 NRMSE 从 6.162 降到 4.330。预测 CPC 只上升 0.003。
拿掉单项并不处处只变差一点。去掉 k 跳、保留其余特征和两个模块时,预测 NRMSE 升到 2.382,高于只留直线距离的 1.994,预测 CPC 降到 0.581。去掉自由流距离时,生成 CPC 为 0.510;去掉相对位置时,生成 CPC 为 0.515。四项一起在这组通勤指标上最好,单项的贡献却不是每条指标都单调。
结构消融把编码器换成常规图卷积,或把解码器换成只有全局注意力的版本。两者都换成对照结构时,预测为 0.567 / 2.134 / 0.201,生成为 0.510 / 6.780 / 0.209。只保留所提编码器,预测 NRMSE 降到 1.800,生成 NRMSE 仍有 6.625。只保留所提解码器,生成 NRMSE 降到 5.100,预测 NRMSE 为 2.092。两个模块一起时,预测 NRMSE 为 1.730,生成 NRMSE 为 4.330。编码器对点预测的格子误差更关键,解码器对生成的格子误差更关键,分开用都没有完整结构低。
这组完整模型的预测 CPC 是 0.597,表 1 的三次平均是 0.604。表 2 的说明没有写它是否也对三次划分取平均。两个数来自两处实验,中间差 0.007,不能当成同一次运行的抖动。
货运的表 5 给出另一面。四项特征和两个模块都在时,预测 CPC 为 0.640、NRMSE 为 0.612、JSD 为 0.048,生成 CPC / NRMSE / JSD 为 0.487 / 0.878 / 0.111。预测 CPC 和 JSD,以及生成 JSD,在各自的消融块里最好。预测 NRMSE 的最低值出现在去掉自由流距离的变体上,为 0.608。生成 CPC 和 NRMSE 的更好值出现在不完整结构上:只保留所提解码器时,生成 CPC 为 0.525,NRMSE 为 0.774。货运生成里,完整模型赢在分布差,重建误差可以由更瘦的解码结构更低。论文自己把这写成指标之间的取舍。
区域变大、流量变小之后,重叠还在吗?
通勤的 2252 个区域按片区数分成三档:小于 10 的小区域 1080 个,10 到 100 以下的中区域 1023 个,100 及以上的大区域 149 个。149 占 2252 的 6.6%。大区域少,却包含更多起讫格子。
表 7 是预测设置。三种尺度都参与训练、再在全体区域上评估,CPC 为 0.630,RMSE 为 72.95,MAE 为 47.09。同一训练方式下,小区域 CPC 为 0.769,中区域为 0.559,大区域为 0.139。大区域 RMSE 为 102.62。这里的 RMSE 没有除以标准差,流量数值更大时它也会更大,所以尺度之间的比较以 CPC 为主。大区域的体积重叠只有 0.139,说明上百个片区的矩阵远没有小矩阵那么容易对齐。
把某一档从训练里拿掉,再专门测试这一档。小区域的 CPC 从 0.769 降到 0.638,中区域从 0.559 降到 0.484,大区域从 0.139 降到 0.115。论文认为相对全量训练的下降有限。数字同时说明另一件事:大区域即便见过,CPC 也只有 0.139;没见过时是 0.115。这一档的困难主要来自大矩阵本身。
只用小区域和中区域训练、再评估全体,CPC 为 0.647,高于三种尺度都训练的 0.630。附录把这归因于小、中区域在样本里占多数,平均误差会被它们拉低。同一训练方式评估大区域时,CPC 回到 0.115。全体平均变好,与大区域变好,是两张不同的成绩单。
城市形态实验仍在通勤数据上。论文用规模、形状、路网连接、距离分布和流量结构描述每个区域,标准化后做 K 均值,分成四组并命名为乡村紧凑(Rural-Compact)、狭长稀疏(Elongated-Sparse)、郊区(Suburban)和都会(Metropolitan)。这些名字只用于划分测试,不作为模型输入。论文没有给出每一组有多少个区域。
全数据训练的总体 CPC 为 0.597。分列来看,乡村紧凑 0.730,狭长稀疏 0.699,郊区 0.541,都会 0.107。只用乡村紧凑训练再测试都会,CPC 为 0.033。只用都会训练再测试都会,CPC 为 0.135,略高于全数据在都会一列的 0.107。全数据的优势体现在四列加总后的总体 0.597,没有体现在都会这一列的最高值上。都会内部的流量重叠,最好的这格也只有 0.135。
东西向的生成实验把区域按经度分成东、西,并做了一个同等数量的随机留出。留出西部再在西部评估,CPC 0.572、RMSE 111.1、JSD 0.176;留出东部为 0.561、116.7、0.177;随机留出为 0.566、101.2、0.174。CPC 和 JSD 很接近。随机划分的 RMSE 更低,所以“CPC 差不多”还不能写成地理分区对格子误差毫无影响。这个实验测的是生成模型跨经度带的稳定性,和上面的点预测尺度实验不是同一次测试。
再按流量大小切开通勤矩阵。表 10 的比例,分母是起讫对;参与片区比例,分母是片区。NRMSE 在这一张表里是该流量档内部的归一化,和表 1 用整张矩阵标准差做分母的 NRMSE 不同。
| 流量档 | 占起讫对 | 至少出现在该档的片区 | CPC | RMSE |
|---|---|---|---|---|
| [0, 5) | 83.18% | 85.84% | 0.105 | 146.1 |
| [5, 20) | 11.62% | 96.46% | 0.269 | 185.7 |
| [20, 100) | 4.49% | 100.0% | 0.493 | 256.1 |
| [100, 500) | 0.69% | 99.71% | 0.620 | 373.9 |
| [500, 1000) | 0.02% | 48.08% | 0.640 | 665.9 |
| [1000, ∞) | 0.01% | 8.55% | 0.513 | 1330 |
83.18% 的起讫对流量数值低于 5,CPC 只有 0.105。流量在 [100, 1000) 的两档加起来只占 0.71% 的起讫对,CPC 为 0.620 和 0.640。1000 及以上只占 0.01% 的起讫对、涉及 8.55% 的片区,CPC 回落到 0.513。小流量档的 RMSE 可以远大于流量本身,因为绝对误差和这一档很小的基数放在一起时,CPC 会非常敏感。论文据此认为,很低的计数里有相当一部分随机成分。表 1 的总体 CPC 主要由那些少而大的格子拉高。
距离用的是归一化起讫距离,表 11 没有给出换成公里的公式。[0.2, 1) 两档占起讫对的 31.13% 与 40.33%,合计 71.46%,论文概括为超过 70%。最短一档 [0, 0.1) 占 4.67%,CPC 为 0.556,是距离分档里最高的。归一化距离达到 2 及以上的起讫对只占 0.05%,却涉及 39.82% 的片区,CPC 为 0.251。长距离格子稀少,总体指标几乎看不出它们是否被对齐。
流匹配的训练曲线,不能当成表 1 的分数
附录把 GeoFlow 里的流匹配换成扩散模型,其余配置保持在可比较的模型和计算量上,再看训练过程。
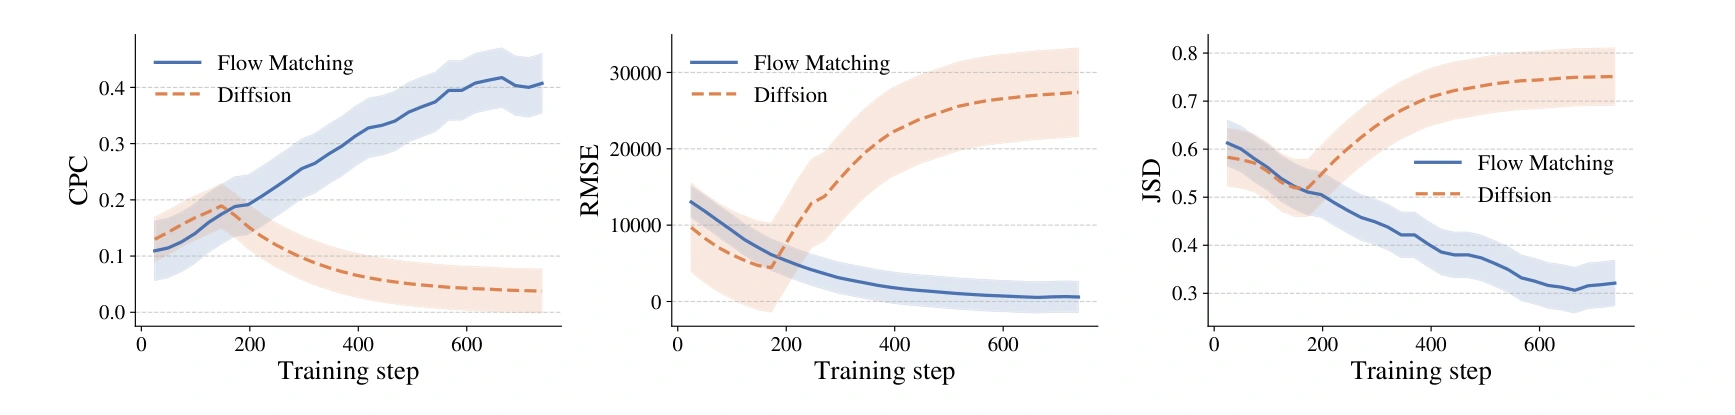
图 3|换成扩散模型后,训练过程还稳吗?
无字母子图,从左到右是 CPC、RMSE、JSD,横轴都是训练步,大约画到 600 步以上。蓝色实线是流匹配,橙色虚线在图例里印成 Diffsion,即扩散模型,色带是波动范围。流匹配的 CPC 上升,RMSE 和 JSD 下降。扩散模型在早段之后 CPC 回落,RMSE 和 JSD 转而上升。正文没有给出曲线终点的精确读数。左图 CPC 的纵轴停在 0.4 附近,低于表 1 通勤生成的 0.566,所以这些轨迹是训练中的监控,不是表 1 的测试结果。来源:原论文 Fig. 3。
论文的解释是扩散训练更慢、噪声更大。图 3 支持的是这一次替换实验里的稳定程度。它还没有证明任何扩散实现都无法把最终测试 CPC 训练到与流匹配相同。
一个县的注意力,标出的是片区,不是某一个人
定性例子选了美国亚拉巴马州巴伯县(Barbour County)。热力图是片区表示之间的注意力权重。论文的影响声明写明,这种案例只提供部分的定性解释,不能当成移动行为的完整因果或物理机制。
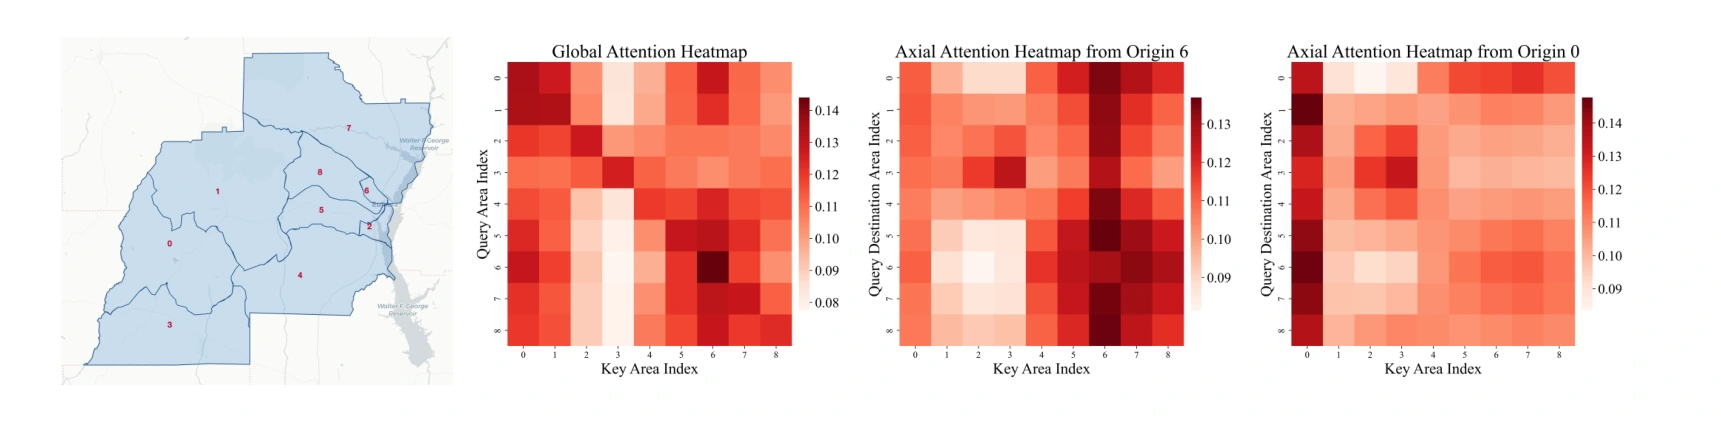
图 4|巴伯县的注意力,集中在县城还是边界片区?
无字母子图,从左到右四块。第一块是片区地图,编号 0 到 8。第二块是全局注意力,行是被更新的片区,列是提供信息的片区,颜色约从 0.08 到 0.14;第 6 列整体更深。第三块是起点为片区 6 时,对各终点的轴向注意力,颜色约到 0.13。第四块是起点为片区 0 时的轴向注意力,颜色约到 0.14,对角线附近更深。来源:原论文 Fig. 4。
正文把片区 6 对应到尤福拉(Eufaula),并称它是该县最大的城市和经济中心。许多片区对片区 6 给出较高注意力,与枢纽角色相符。靠近县界的片区 3 得到的注意力更弱。起点 6 的注意力最大值约为 0.137,分散在终点 5、7、8 等邻近片区。起点 0 的最大值约为 0.148,集中在它自己。论文据此描述中心片区的影响面更散、边缘片区更依赖自身属性。这是一个县、九个片区上的权重分布。它与“引力模型只看距离”的差别,停在这个例子的注意力形态;它没有测量如果改变尤福拉的岗位,全县通勤会如何变化。
热力图能对上骨架,色标却各用各的
图 5 随机抽了五个区域。每一行六列:区域底图、真实流量、点预测,以及三张独立生成样本。行标题是区域编号 26031、35055、36009、40139、48181。论文没有在图注里说明这些编号对应哪一座城市。
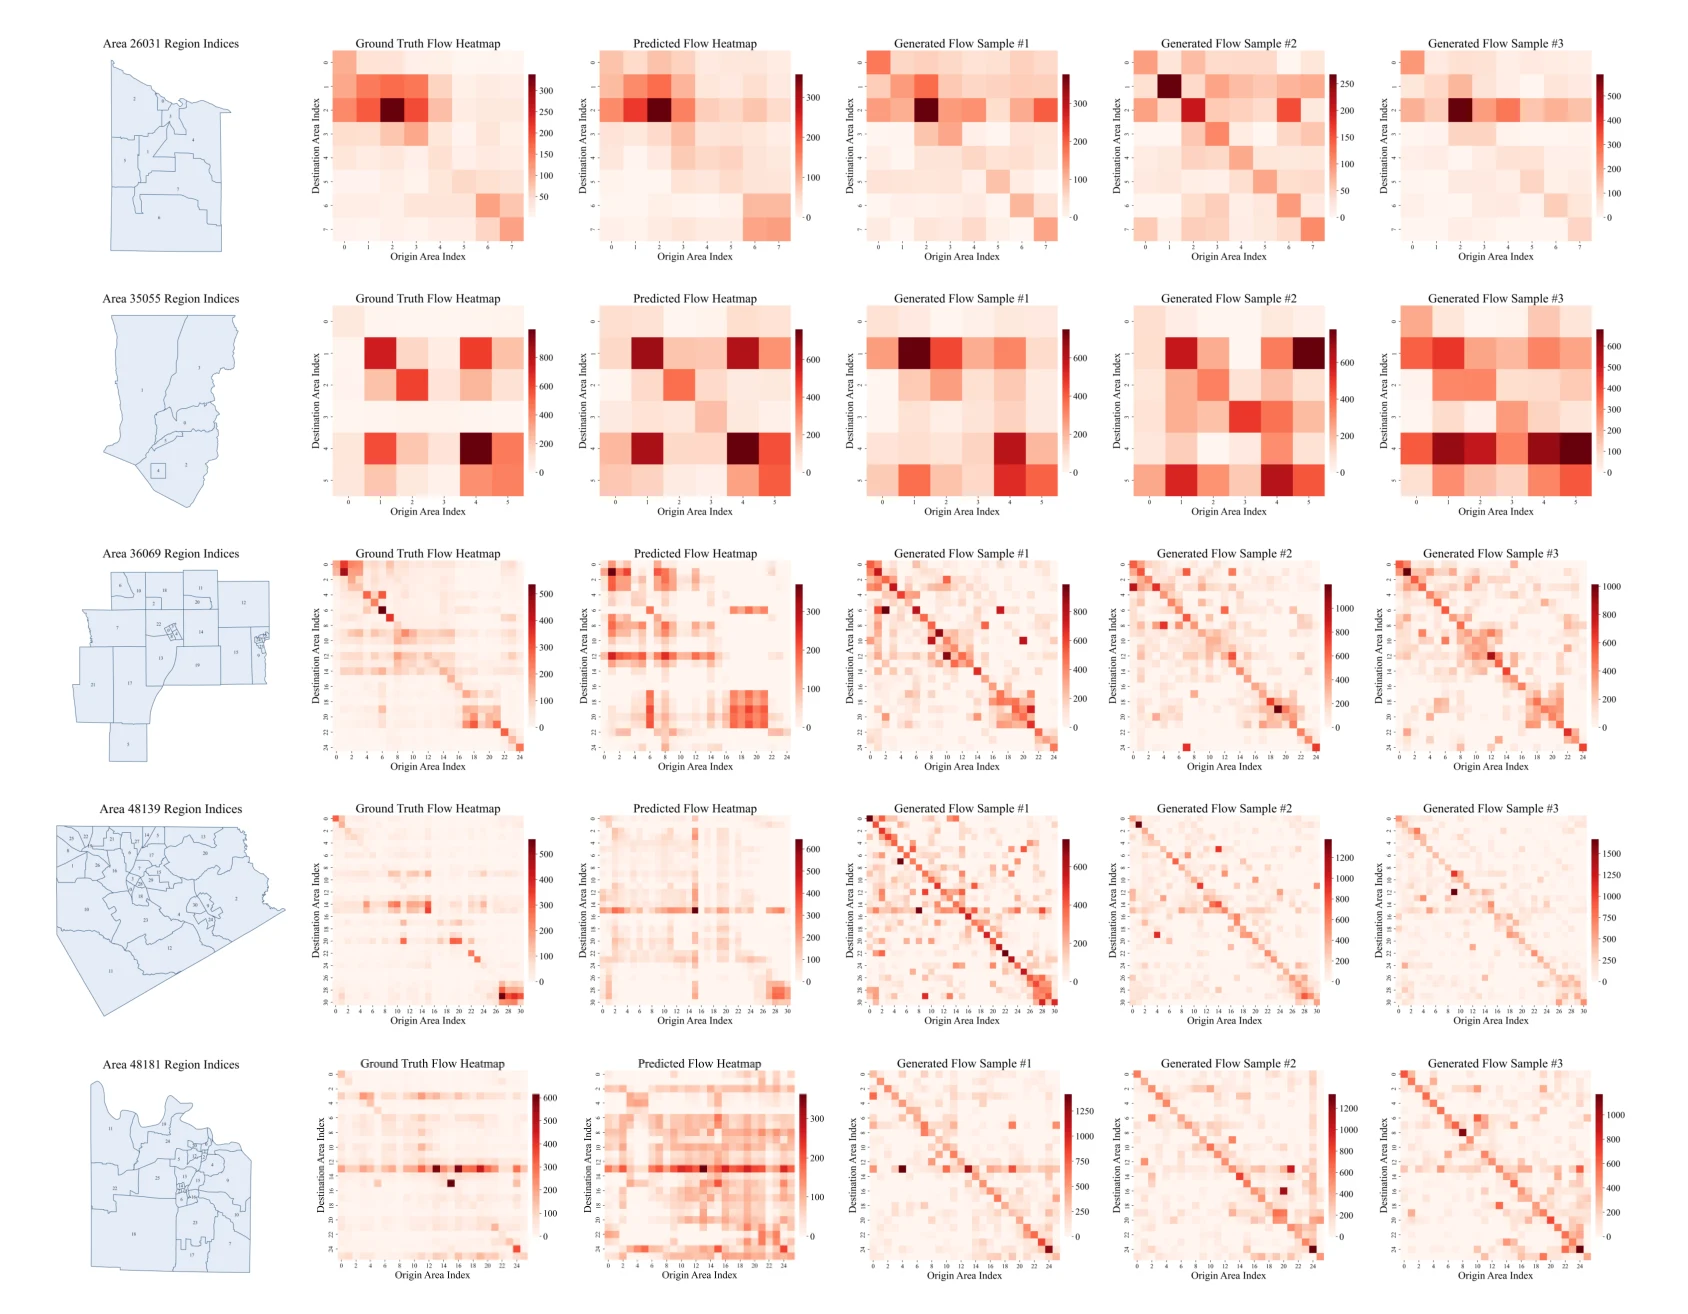
图 5|预测和三张生成样本,保留了真实矩阵的哪些深色格子?
无字母子图,五行对应五个区域,六列从左到右是区域索引地图、真实流量、点预测、生成样本 1 到 3。颜色是该热力图自己的流量刻度,各列色标上限并不相同,例如有的真实图刻到几百,相邻生成图可以刻到一千以上。点预测往往保留真实图里最深的若干格子。生成样本保留部分条带或对角线,也出现真实图中较弱的深色位置。因为色标不共享,不能凭“都是深红色”判断两格流量相等。来源:原论文 Fig. 5。
这张图回答的是结构是否还能被看出来。格子级的重叠仍要回到 CPC,稀少格子的失败仍要回到表 10 和表 11。视觉上的相似,使用的是同一批已经见过的区域,不是下一座没有进入训练的城市。
这些数能用到哪一步
主结果是区域矩阵上的预测误差和生成分布,在三次划分里取平均。划分比例没有公布,所以还不知道成绩对某一套固定测试集有多敏感。模型输出是估计或采样得到的矩阵,要另有观测才成为新的流量记录。影响声明写得很直接:它是黑箱神经网络,分布变了或输入异常时可以给出看似合理、其实不可靠的矩阵;地理网络和最短路若过时或有偏,误差会进到流量里。高风险的规划决策不能只靠这一张输出。
自由流距离按路网长度计算,高峰拥堵没有进入特征。货运距离带来自距离带中点,航空是二分的到访人天。把通勤上 0.604 的 CPC 拿去承诺一条货运走廊或一条国际航线的重叠,已经换了流量单位和几何定义。
都会形态的 CPC 停在 0.1 附近,大区域停在 0.139,低于 5 的流量档占 83.18% 的起讫对而 CPC 只有 0.105。总体指标会被少数大流量格子主导。若一项服务依赖的正是这些稀或小的联系,表 1 的排序还没有在那个子集上重新比过。
一句话总结
把相对位置和路网距离直接放进区域矩阵模型后,三套数据的点预测都更接近真实流量,生成也能交出差异更大的样本;航空到访的体积重叠不是最好,大区域和占绝大多数的小流量格子也还没有被可靠对齐。
核心来源
- 会议稿正文与附录 A–G,Proceedings of the 43rd International Conference on Machine Learning,PMLR 306,2026;同一版本为 arXiv:2607.05257v1。正文图 1–5 与表 1–14 都出自这一篇。
- 摘要中的代码入口:ZheruiHuang/GeoFlow。
- 通勤基准来自 Rong、Ding、Liu、Li,CommutingODGen,ICLR 2025。货运构造使用美国交通统计局 FAF5 2022 的吨数,数据源页面为论文脚注中的 bts.gov/faf。到访人天来自新西兰商业、创新与就业部,论文脚注指向其旅游数据发布页。
作者介绍
四位作者的机构以论文首页脚注为准,下文只补充能够从机构或作者公开页面核对的身份。
- Zherui Huang:论文署名上海交通大学。Guanjie Zheng 的公开论文列表中,他与 Zheng 合作过交通仿真和信号控制研究,包括 2023 年 KDD 的大规模交通仿真工具 CBLab。本文没有写他的职级。
- Guanjie Zheng:通讯作者,论文中的邮箱为 gjzheng@sjtu.edu.cn,与其主页一致。他是上海交通大学约翰·霍普克罗夫特计算机科学中心的长聘轨副教授,公开研究方向是城市时空环境与交通系统中的人工智能方法。
- Hao Xue:论文同时署名香港科技大学(广州)和新南威尔士大学。其个人主页写明,2026 年 2 月起任香港科技大学(广州)助理教授,并任新南威尔士大学高级访问学者,研究时空数据、交通与人类移动。
- 孔令和(Linghe Kong):论文署名上海交通大学。上海交通大学计算机学院主页列他为教授,研究兴趣包括物联网、大数据、人工智能与移动计算。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一项公交或自行车规划关心的是那些很细的联系,表 10 已经给出警告:83.18% 的起讫对流量数值低于 5,CPC 只有 0.105,而 [100, 500) 这一档只占 0.69% 的起讫对,CPC 却有 0.620。总体 CPC 可以被少数大格子抬起来。下一步值得把表 1 里的每一种对照都按同样的流量档重新计算 CPC,再看 GeoFlow 是否仍排在前面。论文没有做这张分档排行榜。若小流量档上的名次颠倒,面向稀疏服务的模型选择就会和面向总运量的选择分开。
另一个可以单做的检验是区域边界。相对坐标的原点和主轴取决于这一次把哪些片区画进同一个区域。都会形态的 CPC 已经低到 0.107,而这一数字还是在论文自己的聚类边界里测到的。若把同一个都会沿行政界、通勤圈或河流切成两块,主轴和“中心”都会变,深色走廊可能跟着移动。这能区分模型记住的是可迁移的相对几何,还是某一刀切出来的区域形状。论文没有报告这种重切边界的实验。自由流距离与直线距离在行归一化后的平均绝对差只有 0.021,最大绝对差有 0.128;高峰行程时间可能把这个最坏差距再拉开,尤其是在都会区。那将是拥堵条件下的另一张特征表,也还不是本文的结果。