换一个州生成通勤流量,差的是模型,还是两地本来就不一样?
论文名片|Zhiyong Zhou、Song Gao、Qianheng Zhang、Feng Zhang、Zhenhong Du,Quantifying geographic domain shift to decouple the geospatial transferability of human mobility flow generation models,arXiv:2608.21567v2,2026年8月26日。arXiv:2608.21567。PDF首页写明此为预印本稿,正式版将刊于 Annals of the American Association of Geographers;首页和文末均未印出DOI。本文依据这一版预印本。
假设一个县没有可用的通勤调查。手里有另一个州的人口普查区通勤,以及两边都能拿到的人口特征和兴趣点。常见做法是在数据较全的州训练一个流量生成模型,再拿到这个县里,给每对普查区填上通勤量。
若只比模型结构,换到哪里都像同一场考试。这项研究把考试难度单独量出来:源州和目标县的地理特征差多少,空间上是更聚还是更散。难度不同时,同一个模型的成绩不能直接横比。迁移也不对称:甲州训出的模型能在乙州用,并不自动说明乙州训出的模型能在甲州用。
研究对象是县内人口普查区之间的通勤起讫流量,是人群汇总后的流量,不是一个人的轨迹。全文不涉及个体追踪或再识别。
先说结论
- 表1里,深度重力模型在源训练州的未见区域上平均通勤重叠比例(CPC)为0.603,标准差0.101;平均均方根误差(RMSE)为82.533,标准差61.706。随机森林、梯度提升回归树和GMEL的平均CPC更低、平均RMSE更高。表1没有写出对应多少个县或多少条起讫对。
- 跨州迁移的成绩随地区变化,而且有方向。不同源州训练的深度重力模型,平均CPC大约在0.58到0.65之间,相差约0.07。CPC不对称的范围是0到0.2。
- 互信息偏移大体在0到0.14,多数落在0到0.06;莫兰偏移大约在−0.75到0.6,多数落在−0.4到0.2。互信息接近0时,莫兰偏移仍然可以差很多。
- 线性混合效应回归中,四个模型的符号一致:互信息偏移更高时,logit变换后的CPC更低、对数RMSE更高;目标县比源州更聚集时,方向相反。全部p值小于0.001。深度重力模型的互信息系数是−0.023,这是logit(CPC)上的系数,不是CPC下降0.023。
- 平均到源州之后,充当起终点的普查区数量取对数,与logit平均CPC、平均RMSE的系数都不显著(p=0.171和0.496)。此时只有平均互信息仍与logit平均CPC显著相关(−0.026,p=0.018),只有平均莫兰偏移仍与平均RMSE显著相关(−0.015,p=0.018)。
生成的是县内普查区之间的通勤量
人类移动性(human mobility)在这里具体落到通勤起讫流量(origin–destination flow,OD流量):一条记录是从一个人口普查区到另一个人口普查区的通勤量。论文把个体轨迹生成和汇总流量生成分开,只做后者。
数据来自2018年的CommutingODGen。原始数据含美国50个州、华盛顿特区共3233个县。分析去掉阿拉斯加、夏威夷和华盛顿特区,保留美国本土48个州的2265个县。流量只包括县内部的普查区往来。跨出县界的通勤不在这套基准里,所以结果不能直接说成州与州之间的通勤,也不能说成一个人一天的全部出行。
每个普查区有97个人口社会特征和36类兴趣点(point of interest,POI)。这些特征既是生成模型的输入,也是后面计算地理差别的全部材料。
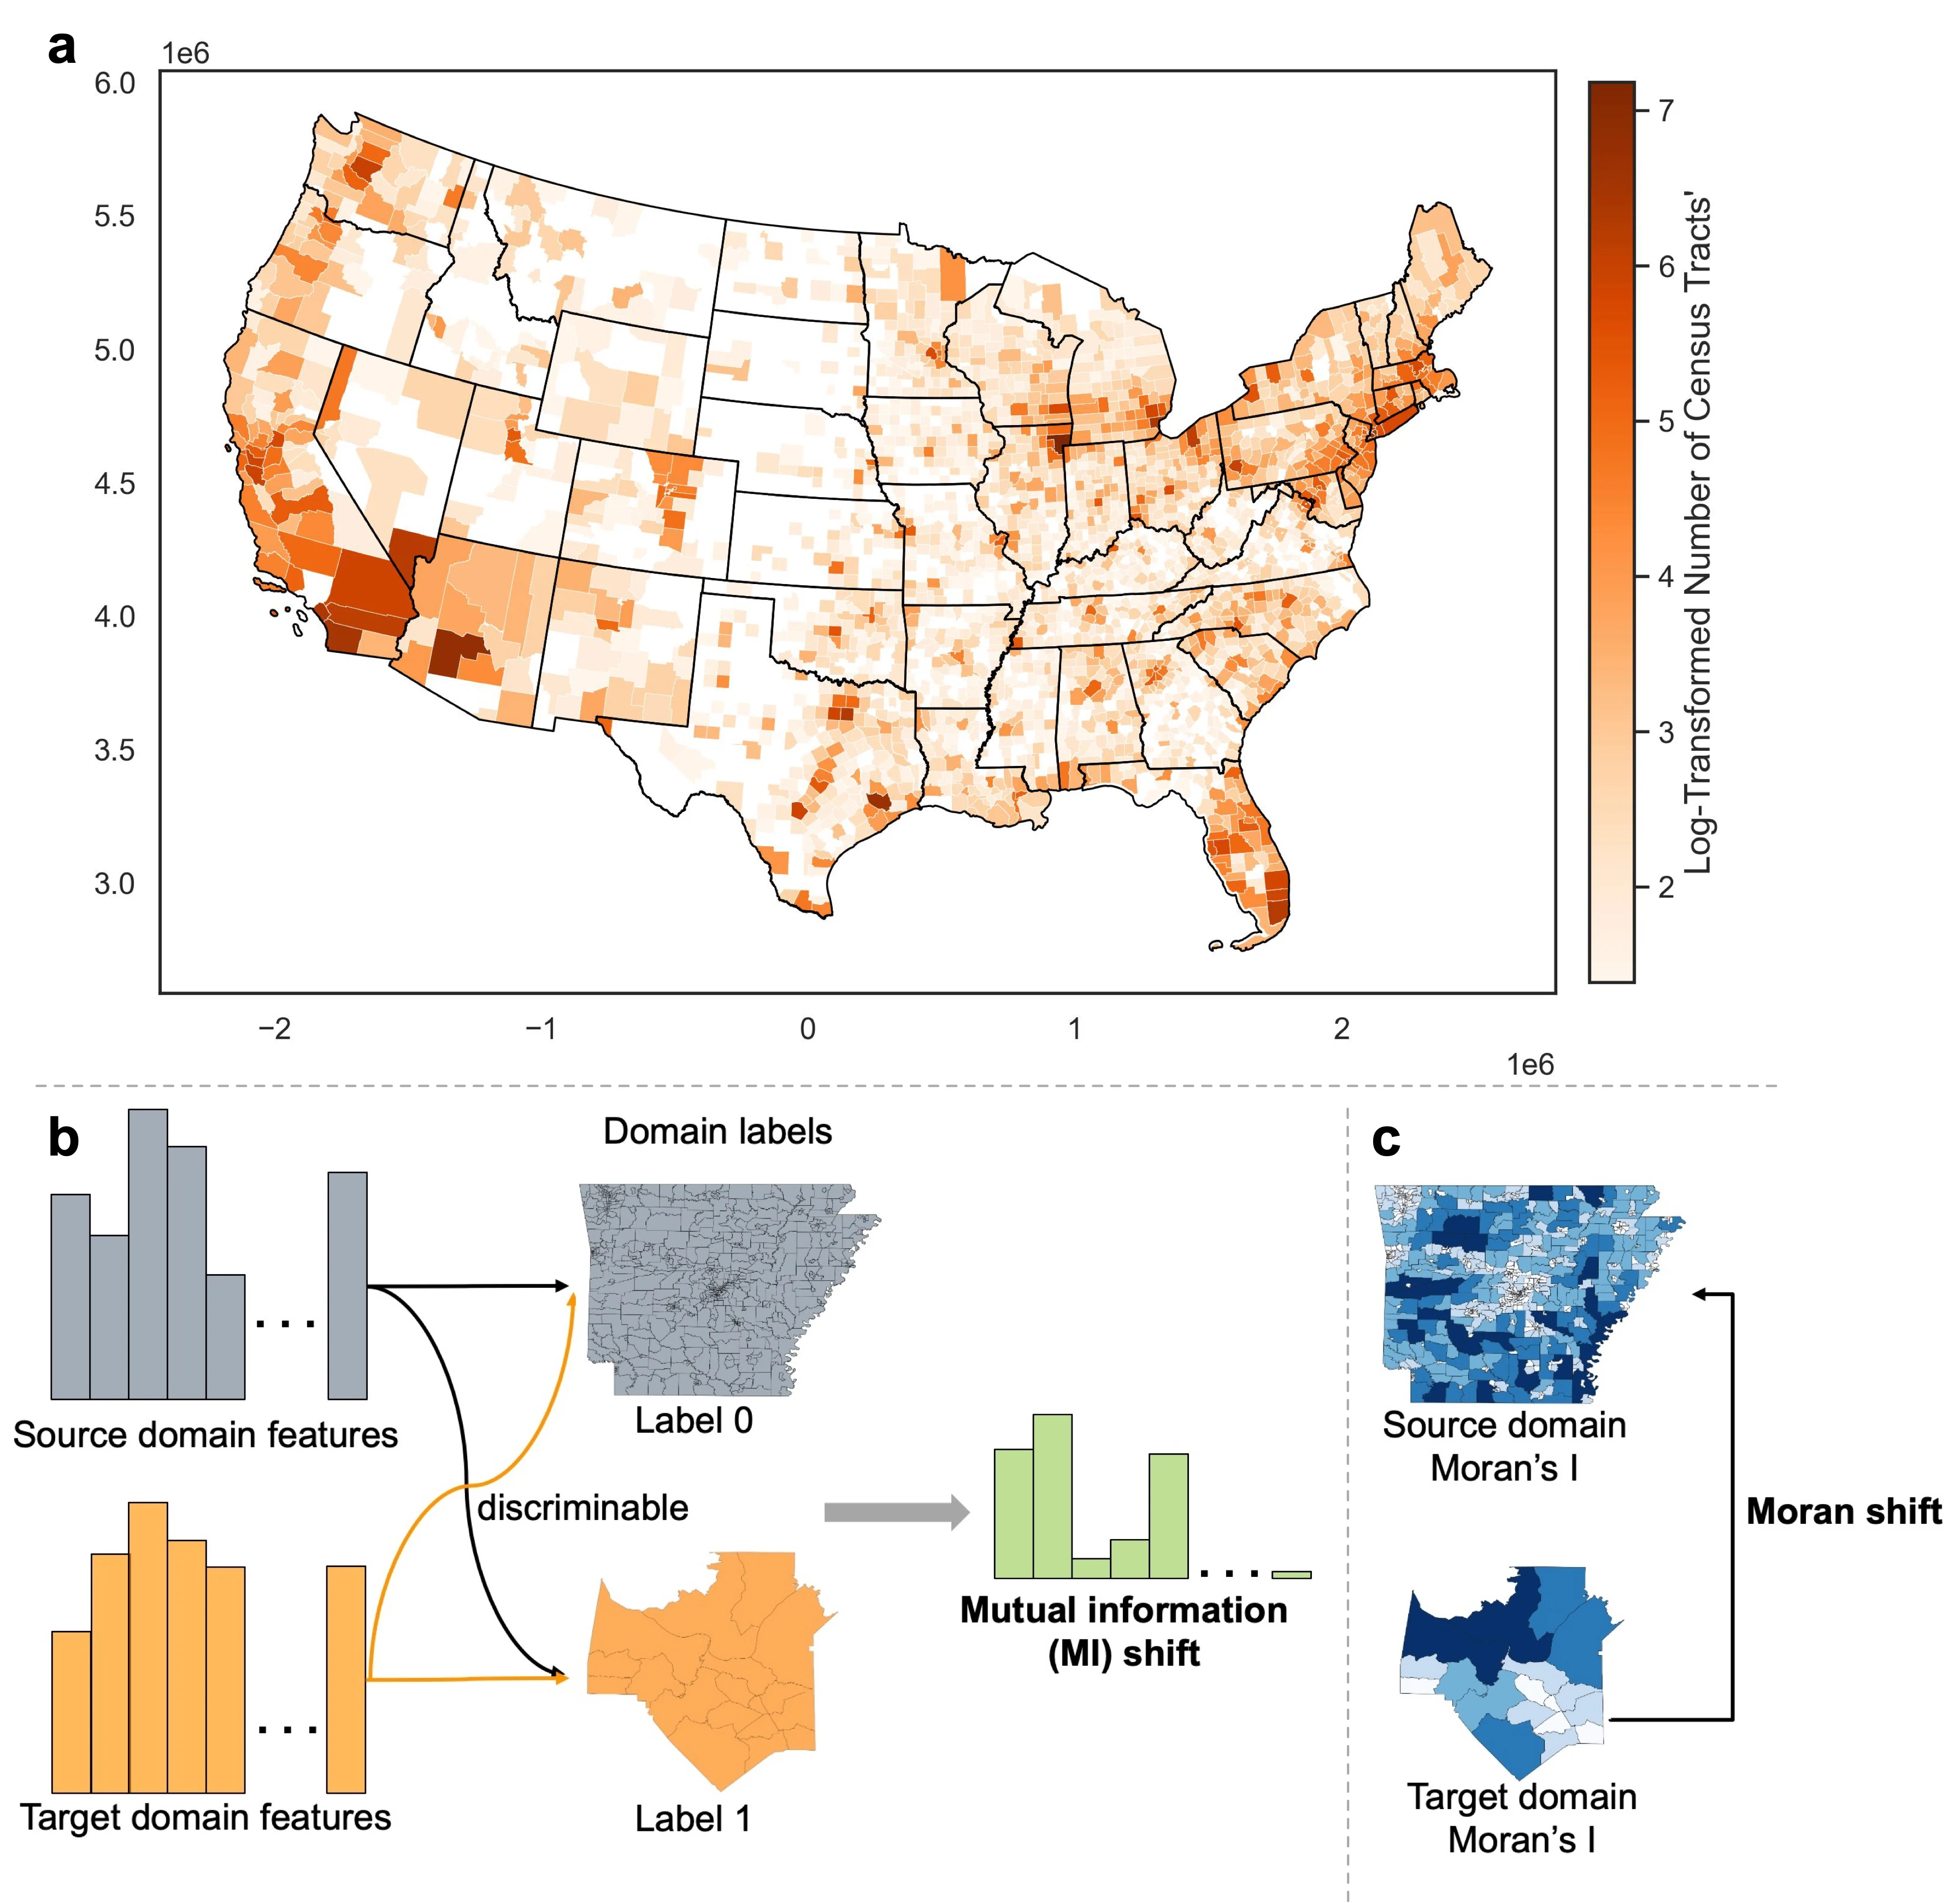
图 1|研究覆盖哪些县,地理差别准备用哪两把尺子量?
(a)美国本土各县的人口普查区数量,颜色是取对数后的普查区个数,越深越多。坐标是地图投影位置。阿拉斯加、夏威夷和华盛顿特区不在图中的分析范围内。这张图说明数据覆盖哪里,不说明流量预测准不准。(b)示意图:源地区特征标为0,目标地区特征标为1;特征若有助于分辨这个标签,互信息偏移就高。直方图是示意,不是某两个州的真实分布。(c)示意图:分别计算两边的莫兰指数,莫兰偏移等于目标减去源。箭头表示做减法,不表示人的移动方向。来源:原论文 Fig. 1。
同一套深度重力模型,换一个训练州,地图为什么不一样?
实验是留一州。每一次用一个州训练和验证:该州70%的县训练,30%的县验证;然后把模型用到其余州的县。48个州各训一个模型。华盛顿特区因为凑不齐7:3的划分,没有作为训练州。
主要模型是深度重力模型(DeepGravity)。它借用重力模型的想法,把流量生成写成多项逻辑回归:条件包括起点的地理特征、起点到各个可能目的地的距离,以及已知的起点总流出。网络有15个隐藏块,每块是一个线性层加LeakyReLU。批大小512,学习率3×10⁻⁴,最多100个训练轮次;验证损失连续上升超过10轮就提前停止。
另外三个模型用来看关联是否只属于这一个网络:随机森林(random forest,RF)、梯度提升回归树(boosting regression tree,GBRT),以及地理情境多任务嵌入(geo-contextual multitask embedding learning,GMEL)。它们的参数沿用Rong等人2025年的设置,本文只写明把GBRT的最大深度从无限制改为3。已知总流出这一条件,论文只明确写在深度重力模型上。
评价用两个数。通勤重叠比例(common part of commuting,CPC)先对每条起讫对取生成流量和真实流量中较小的一个,全部加总后乘以2,再除以生成流量总和与真实流量总和。它落在0到1,越高表示两边重叠越多,关心的是流量放对了哪些目的地。均方根误差(root mean squared error,RMSE)是起讫对流量差的平方平均后再开方,分母N是参与比较的起讫对数量,更关心数值差了多少,也更容易被特别大的流量拉高。
表1比较四个模型在源训练州未见区域上的表现。深度重力模型平均CPC 0.603(标准差0.101)、平均RMSE 82.533(标准差61.706)。随机森林是0.558和90.061,梯度提升回归树是0.525和93.515,GMEL是0.464和146.94。对应标准差分别为0.115、0.117、0.164,以及68.789、70.256、97.759。深度重力模型同时是CPC最高、RMSE最低的一个。四个模型的RMSE标准差都很大,深度重力模型的61.706大约是其均值82.533的四分之三,论文指出流量数值存在极端情况。表1没有给出每条均值背后的县数或起讫对数量。按原文,这是源训练州内部的未见区域,后文的地图才是迁到其他州。
图 2|换训练州之后,重叠比例和流量误差在地图上怎么变,来回迁移是否对称?
(a)CPC。颜色是六边形范围内目标县的平均CPC,柱高是不同源州模型的标准差,并且放大到标准差的5000倍,所以柱高不能当成CPC本身。图例最浅一档约0.33–0.48,最深一档从0.70以上起到约0.83。正文写道,中西部许多地方超过0.70,沿海浅色区大约在0.33到0.48;原文把沿海写成 east and east coasts。CPC标准差高的地方,也是平均CPC高的地方。(b)RMSE。颜色是六边形内的平均误差,柱高是标准差的10倍。图例大约从5.8延伸到603。西部和中西部误差较大,从中西部往东部总体下降,缅因和佛罗里达有例外。这里的分级是区域平均,不是表1的82.533。(c)州对之间的CPC不对称。每一行是一个源州迁到其他州。正文给出的范围是0到0.2;差是有方向的,大于0表示源州模型迁到目标州的可迁移性高于反向。亚利桑那、加利福尼亚、科罗拉多、康涅狄格、特拉华、佛罗里达、新泽西和内华达训出的模型,迁到其他州时CPC通常更低。(d)RMSE不对称。爱达荷、南达科他和怀俄明训出的模型倾向于低估其他州的绝对流量,新泽西训出的模型倾向于高估。颜色是有符号的差,不是通勤人数。来源:原论文 Fig. 2。
讨论里还有一个直接关系到“模型比模型高了多少”的数字:不同源州训练的深度重力模型,其平均CPC大约从0.58到0.65,相差约0.07。论文指出,已有一些研究里基线模型之间的CPC差距小于这个范围。那样的差距,有可能来自换了训练地区,而不只来自换了网络。本文没有列出那些对照研究的具体差值。
CPC高的地区往往RMSE也大。两套指标一个看整体放对了没有,一个看每条流量的数值。它们画出不同的地图,是指标分工不同,不是互相否定。
从甲州迁到乙州,和从乙州迁回来,为什么要分开记?
不对称的定义是:源州迁到目标州的成绩,减去目标州迁回源州的成绩。CPC上,这个差的范围是0到0.2。大于0,表示用源州训练、到目标州测试,比反过来更有可迁移性。
论文把亚利桑那等八个州迁出时较低的CPC,读成这些州的流量分布更异质。这是对迁移结果的解释。它没有另外计算一套独立的流量分布距离来证明这一点。
RMSE一侧,论文没有给一个像0到0.2那样的总区间,而是直接说流量被估高还是估低。用较小流量的州去估计其他州,容易整表偏小;用新泽西去估计其他州,容易整表偏大。绝对流量的方向和重叠比例是两件事。一个模型可以重叠还行、数值偏大,也可以重叠差、数值也偏。
这种有方向的差别,也是后面要使用带正负号的莫兰偏移的理由。只说两个地区“像不像”,会把甲到乙和乙到甲写成同一个数。
两地的差别,怎样在训练之前就算出来?
地理域偏移(geographic domain shift)指源地区和目标地区在地理特征上的内在差别。它分成两块。协变量偏移看输入特征的分布变了没有。概念偏移看同样的特征所对应的流量关系变了没有。目标县的流量在真正外推时可能还未知,所以本文主要量化协变量偏移,没有量化概念偏移。
互信息偏移(mutual information shift)看这些特征在多大程度上能减少“这个地方属于源地区还是目标地区”的不确定性。每一维特征先和域标签算一次互信息,再对97个人口社会特征和36类兴趣点取平均。分数越高,特征越能把两边分开,分布差别越大。它不是概率,也不是通勤人数的比例。
莫兰空间偏移(Moran spatial shift)看空间依赖变了多少。莫兰指数(Moran’s I)衡量邻近单元的特征有多相似。本文的莫兰偏移等于目标县的指数减去源州的指数。大于0,目标县的特征比源州更聚集;小于0,目标县更分散;等于0,只说明总体自相关强度相同,不说明聚集出现在同一位置、数值也相同。
数据只提供县级多元距离矩阵,没有普查区坐标,所以莫兰指数算到县。源州的指数是州内多个县的平均。因此这把尺子描述的是县这一级的总体聚集差别,不是普查区街道尺度的多中心或单中心结构。
两把尺子都只用地理特征,在训练任何流量模型之前就能算。它们与后面的CPC、RMSE相关,并不等于已经完成一次“按偏移挑选训练州、再证明成绩提高”的实验。
互信息很小的时候,空间聚集还可以差很多吗?
源州到目标县的配对里,互信息偏移大体从0到0.14,多数在0到0.06。莫兰偏移大约从−0.75到0.6,多数在−0.4到0.2。联合分布的形状说明,互信息几乎为0时,莫兰偏移仍可以铺得很开。两把尺子不是同一根轴上的重复测量。
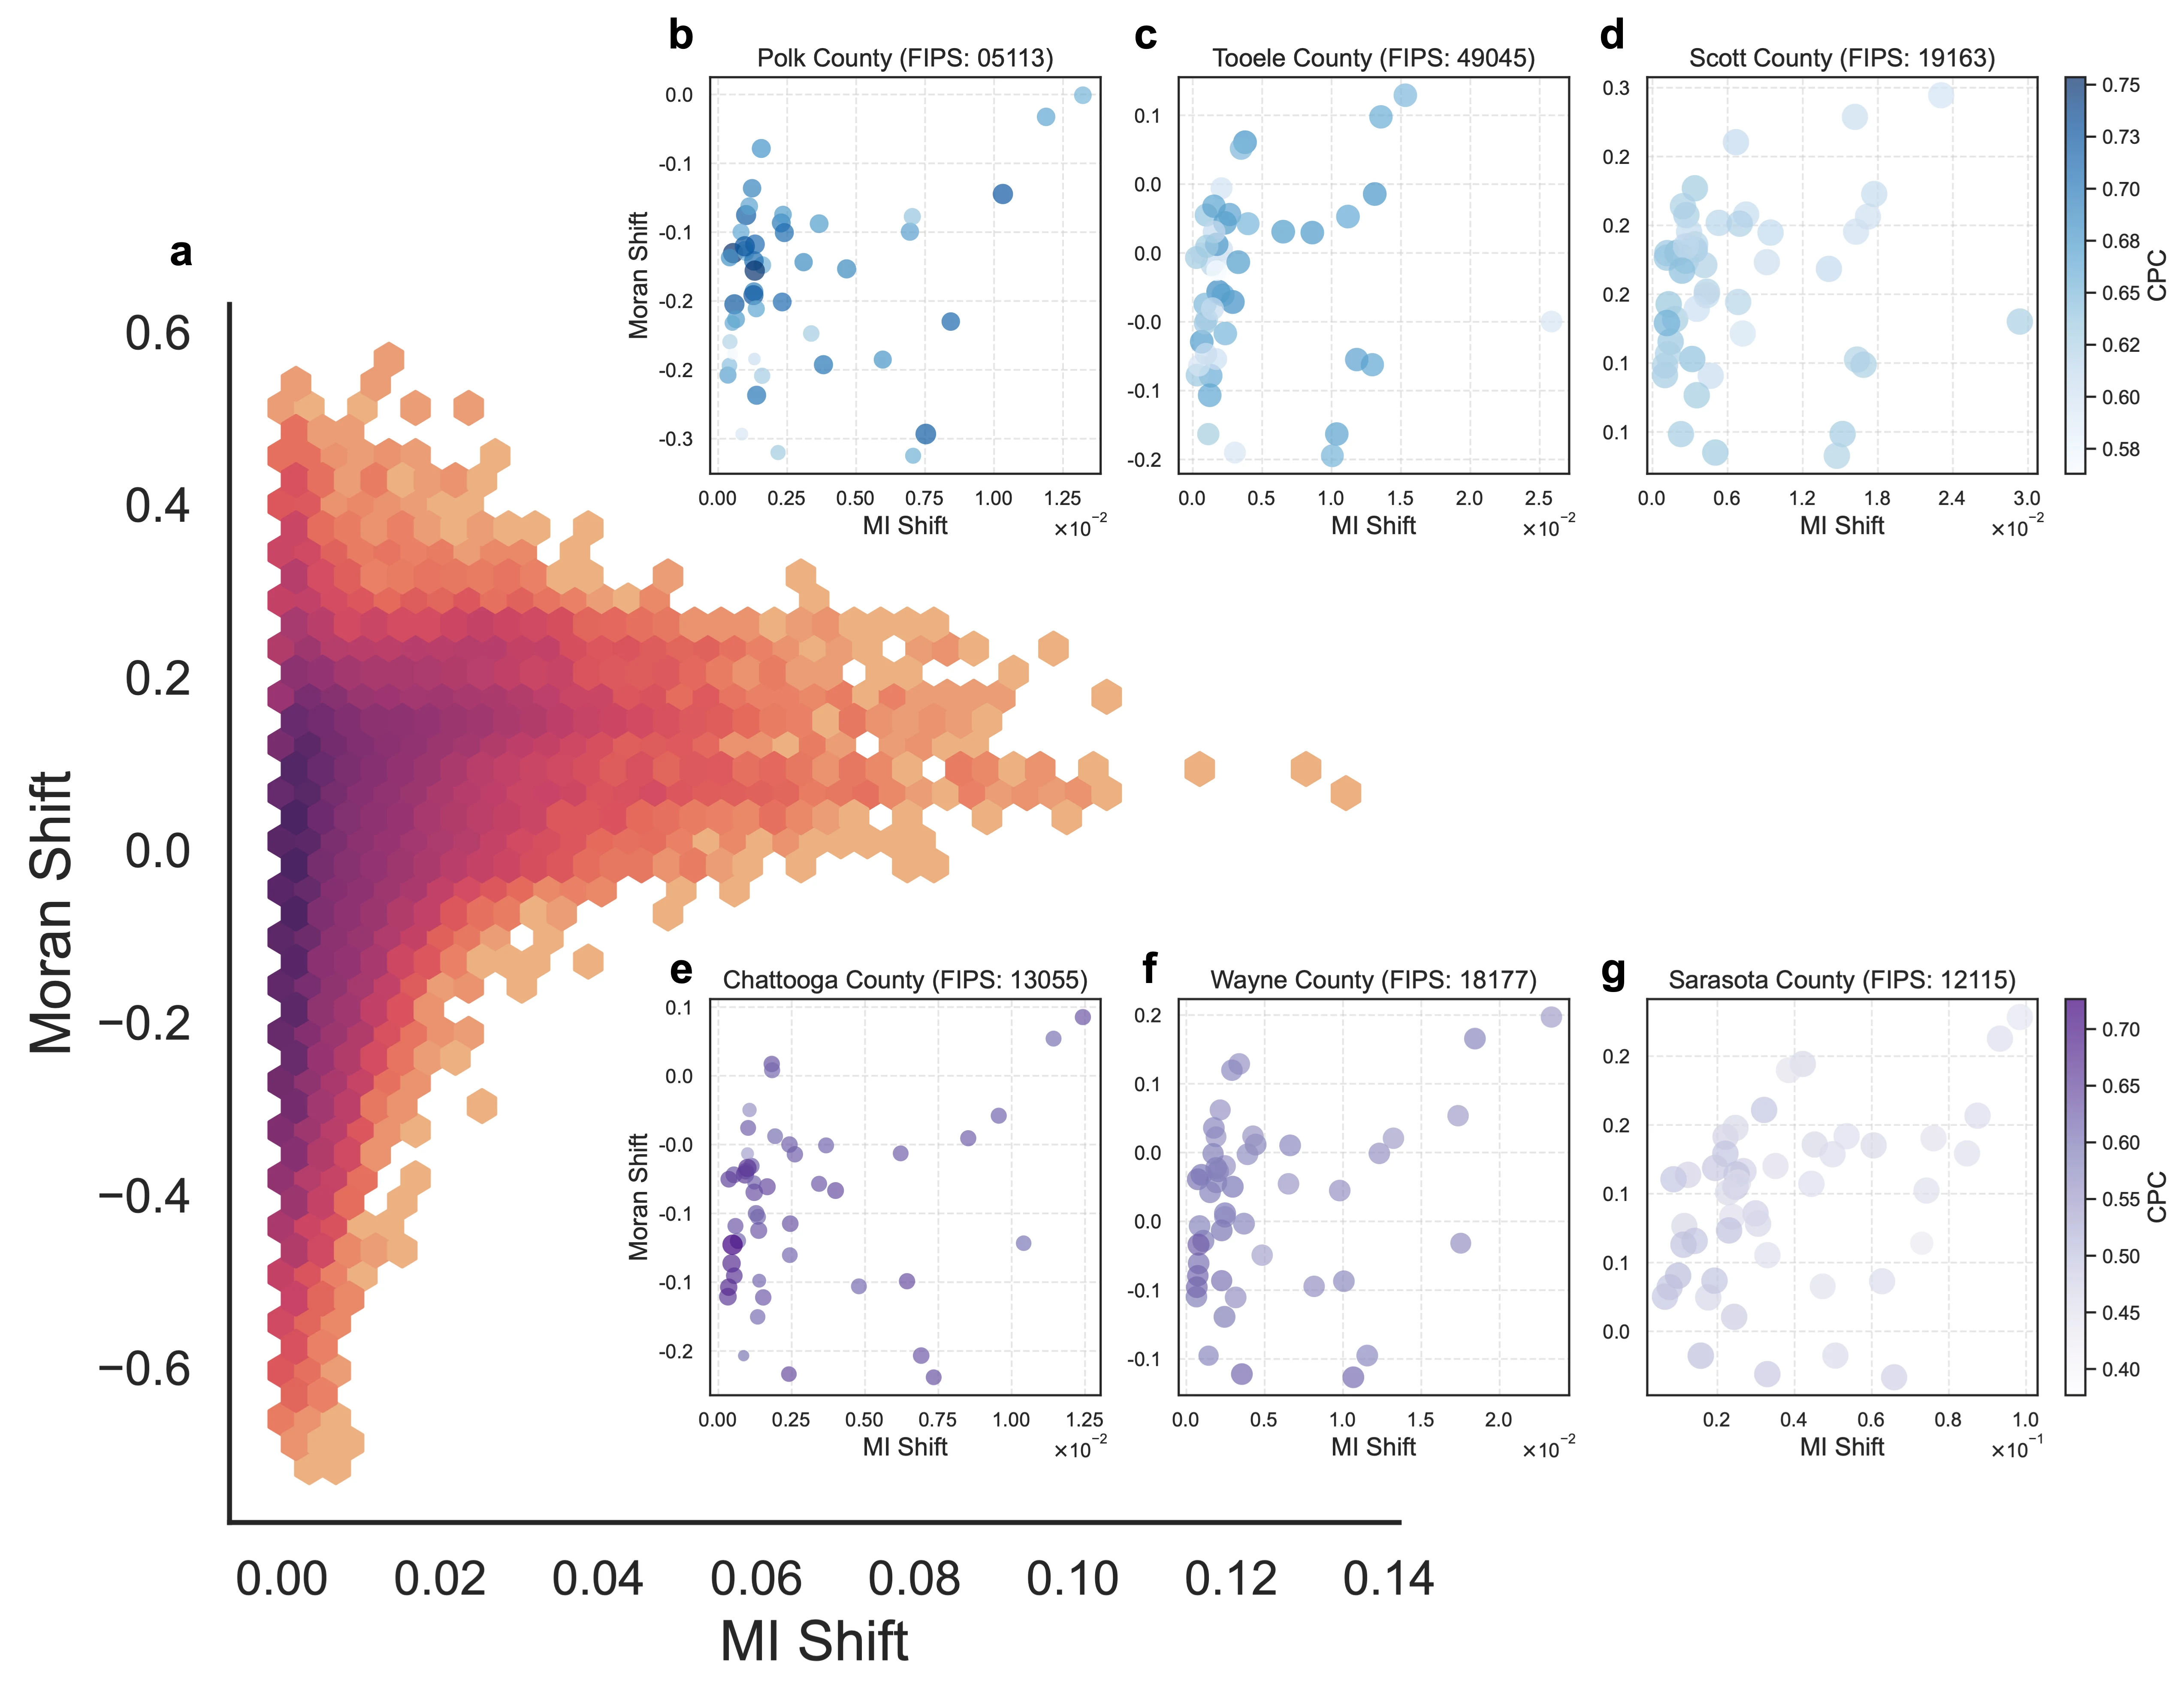
图 3|特征分布差和空间聚集差是否一起变化,换源州时一个县的成绩如何散开?
(a)全部源州—目标县配对。横轴互信息偏移,大约0到0.14;纵轴莫兰偏移,大约−0.75到0.6。颜色深浅表示配对密度。互信息接近0的一列仍然在纵向上拉得很长。(b)阿肯色州波尔克县(FIPS 05113),互信息偏移的25%分位。横轴带×10⁻²。莫兰偏移大约在−0.3到0。颜色是该源州模型在这个县的CPC。(c)犹他州图埃勒县(FIPS 49045),50%分位。横轴×10⁻²,刻度到2.5,对应的互信息大约到0.025。莫兰偏移大约在−0.2到0.1。(d)艾奥瓦州斯科特县(FIPS 19163),75%分位。横轴×10⁻²,刻度到3.0。莫兰偏移大约在0.1到0.3。这一排的CPC色标大约从0.58到0.75。(e)佐治亚州查图加县(FIPS 13055),莫兰偏移的25%分位。(f)印第安纳州韦恩县(FIPS 18177),莫兰偏移的50%分位。正文写它的互信息跨度是[0.0, 2.5],横轴标注为×10⁻²,刻度画到2.0,因此2.5是0.025这一量级,不是互信息等于2.5。(g)佛罗里达州萨拉索塔县(FIPS 12115),莫兰偏移的75%分位。横轴是×10⁻¹,刻度到1.0,实际互信息大约到0.10;CPC色标大约从0.40到0.70。上下两排色标不同,不能用颜色深浅跨排比较。每个县的点来自其余47个源州。点越大,RMSE越大。来源:原论文 Fig. 3。
正文说韦恩县的互信息跨度最大,写成[0.0, 2.5]。按图上的数量级,萨拉索塔县的横轴可以到大约0.10,大于韦恩县换算后的大约0.025。读这张图时要以各子图自己的×10⁻²或×10⁻¹为准。(a)的横轴才是和0.14同一套刻度。
论文认为,较低的互信息偏移(例如波尔克县)以及一部分较低的莫兰偏移下,CPC通常更好。同一县里换源州,点仍然散开。这对应图2里那些被放大的高柱:架构相同,训练州一换,成绩就变。
系数显著之后,重叠比例到底动了多少?
同一个县会被47个其他州的模型反复评价,观测并不独立。回归因此写成:某个县在某个源州模型下的成绩,等于截距,加上互信息偏移和莫兰偏移的两项,加上该源州的固定效应,加上该县自己的随机截距和残差。源州被当作固定效应,因为这48个州就是实验里的全部训练条件。CPC先做logit,因为它被限制在0到1;RMSE先取对数,因为分布右偏。
| 模型 | 互信息对 logit(CPC) | 莫兰偏移对 logit(CPC) | 互信息对 log(RMSE) | 莫兰偏移对 log(RMSE) |
|---|---|---|---|---|
| DeepGravity | −0.023 | 0.013 | 0.010 | −0.007 |
| RF | −0.357 | 0.178 | 0.239 | −0.097 |
| GBRT | −0.430 | 0.175 | 0.287 | −0.098 |
| GMEL | −0.213 | 0.071 | 0.149 | −0.058 |
表中16个系数的p值都小于0.001。符号可以连成一句:特征分布差得越开,重叠越低、数值误差越高;目标县比源州更聚集时,重叠更高、数值误差更低。四个模型方向相同,说明这组关联不依赖单独一个网络。
系数大小差很多。深度重力模型的−0.023约是梯度提升回归树−0.430的十九分之一。论文没有说明不同模型的回归是否对偏移做了不同标准化,因此不能把这个差距直接读成“深度模型对地理差别不敏感”。能确定的是方向,以及这些系数都在变换后的因变量上:−0.023不是CPC减少0.023,0.010也不是RMSE增加0.010。
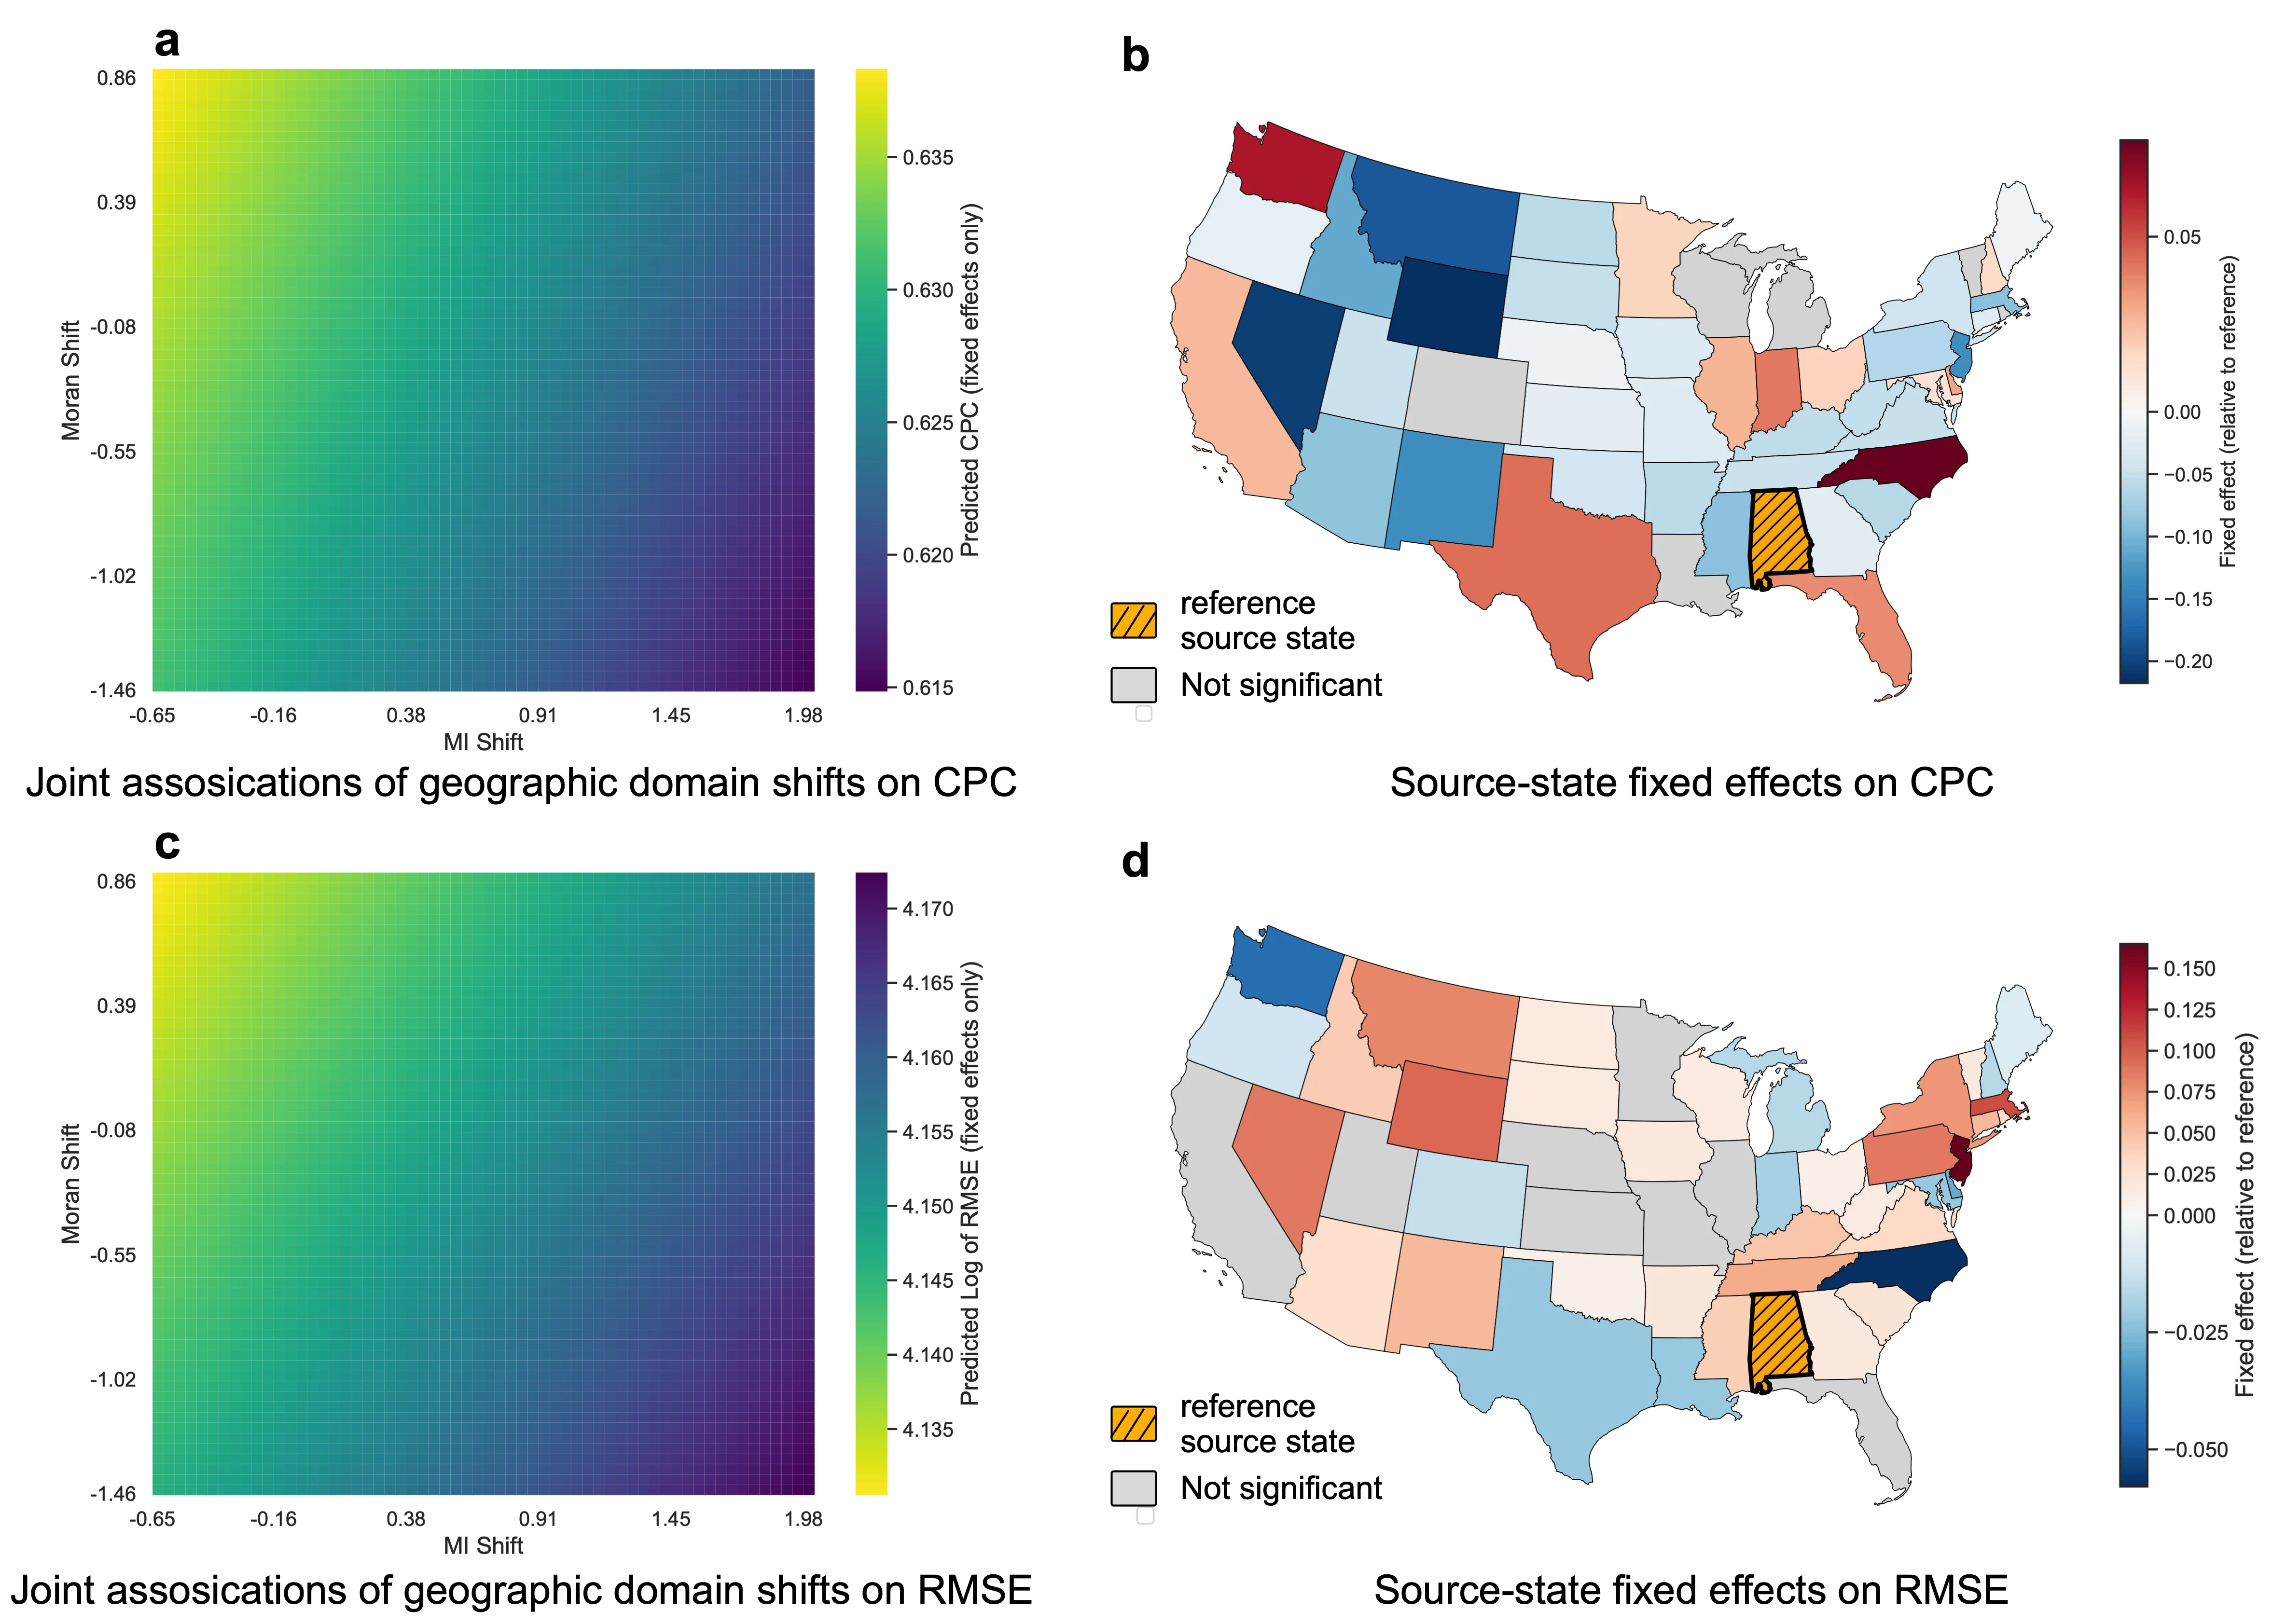
图 4|两种偏移同时变化时,模型预测的重叠和误差移动多少,源州本身还留下多大差别?
(a)深度重力模型的拟合曲面上,横轴互信息偏移大约从−0.65到1.98,纵轴莫兰偏移大约从−1.46到0.86,颜色是只含固定效应的预测CPC,大约从0.615到0.635。真实配对的互信息在0到0.14,且不会为负,所以网格有一部分是回归式向外延伸,不是观测散点。(b)各源州对CPC回归的固定效应,相对斜线标出的参照州。灰色表示不显著。色标大约从−0.20到0.05。48个源州里有6个不显著。斜线是参照州,正文没有写出州名。(c)同一网格上的预测对数RMSE,色标大约从4.14到4.17。整张曲面的变化远小于表1里几十到上百的RMSE差距。(d)各源州对对数RMSE的固定效应,色标大约从−0.05到0.15。48个源州里有8个不显著。参照州同样是斜线。这些颜色都在变换后的回归尺度上,不是CPC或RMSE的原始点数。来源:原论文 Fig. 4。
把(a)和(b)放在一起看:两种偏移画出的预测CPC只在大约0.02的宽度里移动,而源州固定效应的色标可以到大约−0.20。统计显著来自大量县—州配对,显著本身还不等于换一个更接近的州,重叠比例就会明显抬高。混合模型的公式里也没有放入训练集大小,所以表2的系数还没有按普查区数量调整。
普查区更多的州,迁移就更好吗?
各州的普查区数量本来就不同。若深度模型总是数据越多越好,训练集规模会和偏移缠在一起。论文把互信息、莫兰偏移、CPC和RMSE先对留出的目标县取平均,再在源州这一级做普通最小二乘。规模变量是充当起点和终点的普查区数量,取对数后进入回归。论文没有报告这个回归的样本量;按留一州设计,每个源州一行。
平均CPC因为落在0到1之间,做了logit。这一列里,对数普查区数量的系数是0.015(p=0.171),平均互信息是−0.026(p=0.018),平均莫兰偏移是0.003(p=0.674)。平均RMSE这一列没有再取对数:对数普查区数量0.006(p=0.496),平均互信息0.012(p=0.152),平均莫兰偏移−0.015(p=0.018)。
和县—州配对的混合模型相比,州平均之后两种偏移不再同时对两个指标显著。数据量在两个指标上都不显著。不显著不等于增加普查区完全没有作用,尤其州一级只有几十个点,检验很粗。它说明的是:在这48个州的平均水平上,对数普查区数量没有表现出独立于两种偏移的显著系数。这还不是一个“给目标县追加多少条相似普查区”的实验。
这些关联能用到哪一步
相关停留在模型成绩和输入特征的差别之间。地理特征同时被用来训练模型、计算偏移,CPC和RMSE又来自这些模型的输出,指标之间可能有部分依赖。回归没有识别出“改变聚集方式就会提高重叠”的因果。
数据只有美国、2018年、县内通勤这一套。跨县通勤、其他年份、其他国家和别的出行目的都没有测。莫兰指数是县级总体自相关,再平均到州;它不区分多中心和单中心,零也不表示两张地图相同。概念偏移没有被量化。
深度重力模型使用已知的起点总流出,任务更接近把已经观察到的流出分到目的地。RMSE仍然可以很大,因为流量可以分错地方。不能把表1的82.533理解成模型在完全不知道总通勤量时估错了多少人。另外三个模型是否同样使用总流出,本文没有写明。
摘要希望这些指标帮助做出更稳健、更公平的流量合成。正文没有按人群分组报告公平性指标。公平是作者提出的后续用途。论文也还没有报告:若按互信息或莫兰偏移挑选训练州,留出县的CPC会提高多少。
一句话总结
一个州训出的通勤流量模型能不能用到另一个县,既要看两边的特征分布差多少,也要看空间聚集是变聚还是变散;这种关联方向稳定,但还没有大到可以代替对具体州对、以及来回两个方向的检查。
核心来源
- arXiv:2608.21567v2,2026年8月26日预印本。首页题目、作者、机构、四张正文图和三张表均按该PDF核对。首页写明正式版将刊于 Annals of the American Association of Geographers,文件中没有DOI。
- CommutingODGen 数据,论文给出的2018年县内通勤基准入口。
- GeoDomainShift-Mobility,论文给出的数据与代码入口。
- Rong、Ding、Li与合作者,2025,A large-scale dataset and benchmark for commuting origin-destination flow generation。本文的GBRT、随机森林和GMEL参数指向这一基准,除GBRT最大深度外,参数表不在本PDF中。
作者介绍
五位作者的机构以论文署名为准,补充经历只采用可核对的机构页面。
- Zhiyong Zhou:论文同时署威斯康星大学麦迪逊分校地理系GeoDS实验室与浙江大学地球科学学院。其个人主页与ORCID写明,2025年9月至2026年3月他以瑞士国家科学基金会Postdoc.Mobility学者在麦迪逊工作,2026年4月起任浙江大学地球科学学院助理教授。论文致谢该奖学金,编号235381。研究关注以人为中心的地理人工智能。
- Song Gao:通讯作者,署名为麦迪逊分校地理系GeoDS实验室。地理系页面列他为教授、地理空间数据科学实验室主任,研究地理信息科学、地理人工智能与人类移动。论文中的联系邮箱与系页面一致。
- Qianheng Zhang:署名为麦迪逊分校GeoDS实验室。实验室成员页介绍他是地理系制图与地理信息系统方向的研究生,关注地理可视化、地理人工智能和城市交通。
- Feng Zhang:署名为浙江大学地球科学学院。学院地理与空间信息研究所页面列他为教授,研究时空数据库、时空大数据与智慧城市。
- Zhenhong Du:署名为浙江大学地球科学学院。研究所页面列他为教授、院长,研究遥感与地理信息系统、地学大数据。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一篇流量生成论文只报告一个跨城市平均CPC,0.07这个由换训练州造成的幅度就值得先写进对照。两个网络的差距若小于不同源州之间的差距,下一步更有信息的数字是两边的互信息偏移、莫兰偏移,以及甲到乙和乙到甲两行,而不是再加一个总平均。
图4把预测CPC压在大约0.615到0.635,源州固定效应的色标却可以到大约−0.20。更值得单独检验的是:把特征的直方图固定住,只打乱它们在县内的空间排列,迁移成绩是否还会变。现在的县—州配对做不到这一步,因为分布差和聚集差是一起观察到的。
州平均回归里,普查区数量没有显著系数。这对数据采集的启发是,从特征分布差得很远的州再增加普查区,和从分布更接近的地区增加普查区,可能不是同一种扩充。表3只说明前一种比较在这48个州的平均值里看不显著,它没有给出某个县应该停止收集通勤数据。