节前比节中少掉的手机用户,就是这座城市的外来人口吗?
论文名片|Yuxia Wang、Lei Dong、Ye Liu、Zhou Huang、Yu Liu,Migration patterns in China extracted from mobile positioning data,Habitat International,2019,86:71–80,2019年3月22日在线发表。DOI:10.1016/j.habitatint.2019.03.002。正式稿2018年8月6日收稿,2019年1月27日修回,2019年3月1日录用。
2016年春节前的五个工作日,广州城区腾讯系应用的活跃用户大约到2000万这一量级,都江堰大约到90万;两条曲线在除夕前后都向下。同一时期,绥中和潜江的曲线向上。若全国只是同一批人从工作地回到老家,不同城市的人数变化就应当方向相反,而且能够对上谁离开、谁到达。
这篇论文把节前活跃人数减去节中活跃人数,称作迁移格局,再看这个差和产业、工资、外资在各地是否同步变化。方向性的结果是:多数地级单元节中人更多,少数单元节前人多得多,把全体均值拉到零附近;二、三产、工资和外资与这个差有统计关联,关联强弱随地点改变。数据记录的是每个地方当天有多少人用过这些应用,回归给出的是标准化之后的空间相关。
先说结论
- 表2给出进入模型的地级单元:节前减节中的活跃人数中位数是 −40.798 万,均值是 +1.833 万。最大值 +2045 万,最小值 −534.08 万。少数极大的正值把均值拉到零以上。
- 九个样例分成三类:呼和浩特、昌平、太原、武汉、都江堰、广州在节前较高、节中下降;绥中、潜江上升;洞头在大约6.5万到8万之间来回波动。区和县的曲线方向可以相反。
- 287个地级单元上,地理加权回归的调整后 R² 为0.856,普通最小二乘为0.617。全局模型里,二、三产人均地区生产总值、职工平均工资、人均实际利用外资在0.005水平上显著;年末总人口和一产人均地区生产总值在0.05水平上不显著。
- 局部系数并不处处与全局系数同号。二、三产的局部系数从 −0.542 到 1.009,外资从 −0.254 到 2.641。作者把劳动力流入地的正系数读成更多人前来,把流出地的正系数读成更多人留在本地;同一符号对应两种人口故事。
普查要等十年,手机格子每天都有数,数的是谁?
既有中国国内迁移研究多靠人口普查。普查大约十年一次,公开迁移信息往往只覆盖过去五年的居住地变化,发布尺度也较粗;户口登记地和实际居住地还可能错开。手机应用只要被打开,就能在当天留下位置汇总,时间密、格子细。
数据来自腾讯。正文引用 Analysys:2015年安装腾讯移动应用的设备,占移动设备用户的94.6%。QQ 2017年第一季度月活跃用户8.61亿,微信9.38亿;这两个季度晚于本研究的观察窗口,用来说明平台覆盖面,代表的是平台用户规模。
本研究的原始记录从2016年1月16日到2月13日,共29天,覆盖当年春节。大陆研究范围写明有2396个县级单元、347个地级单元、31个省级单元;香港、澳门和台湾因数据可得性问题排除。用户使用应用后,位置按 0.01×0.01 的地理格子、以日为间隔汇总;同一天重复定位只记一次。正文没有在这句话里写明 0.01 的单位是度还是公里。全日平均1366百万条记录,数量接近普查人口的量级,却同时漏掉不用这些应用的人,也可能把一个人的多台设备算成多个人。作者假定各地渗透率大体可比,活跃量与真实人数之间大约差一个常数系数,并假定春节窗口足以代表全国劳动力迁移。游客、返乡学生和不再打开应用的人,都会进到同一个差里。
五个工作日减五个节日,差出来的是存量
2016年2月7日是除夕。节中人口用2月7日到11日的日均活跃人数代表,节前工作日用1月18日到22日的日均代表。1月18日是数据中的第一个周一。因变量 DIF 等于节前减去节中,单位是千人。正值表示节前比节中多,负值表示节中比节前多。
节中总记录略少于节前,作者把数据缩放到节前合计14亿。1366百万是全期日均记录数,14亿是缩放后的节前合计,两数的分母不同。正文没有给出缩放系数,也没有给出缩放后的节中合计。
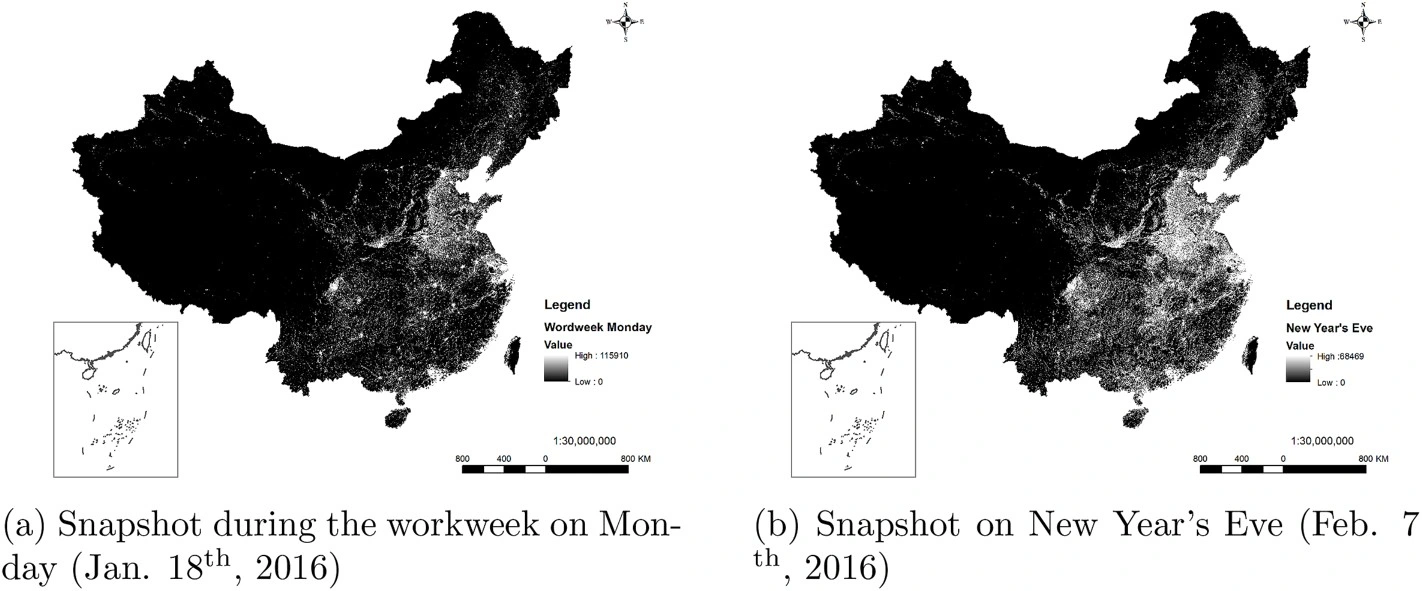
图 1|节前一个周一和除夕当天,格子上的活跃用户哪里更密?
(a)2016年1月18日,图例写作工作周周一(图中拼作 Wordweek Monday)。灰度从低到高,最高115910,最低0。(b)2016年2月7日除夕,最高88469,最低0。两图都是单日快照,比例尺1:3000万;最高值是当天最密格子的图例上限,分母是单个 0.01×0.01 格子,加总后才是全国或城市人数。来源:原论文 Fig. 1。
图1是两天的单日快照。后面的回归使用1月18–22日和2月7–11日两个五日平均,和这两张单日图的时间窗口不同。东部和四川盆地在两天都更密,除夕当天的格子上限低于1月18日。西部大片区域在这张灰度图上很淡;人少和应用使用更少,都会把格子压暗。
把节前五日均减节中五日均,再除以面积,得到图2的地级差异密度。正文在这张图之后给出全局 Moran’s I=0.325,z=9.31,在0.05水平下高于 z 临界值1.96。空间上相邻的地级单元,差异密度倾向于同高或同低,所以后面采用系数可以随地点变化的回归。Moran’s I 的计算单元,正文没有单独再写一句话;它紧跟在地级密度图之后。
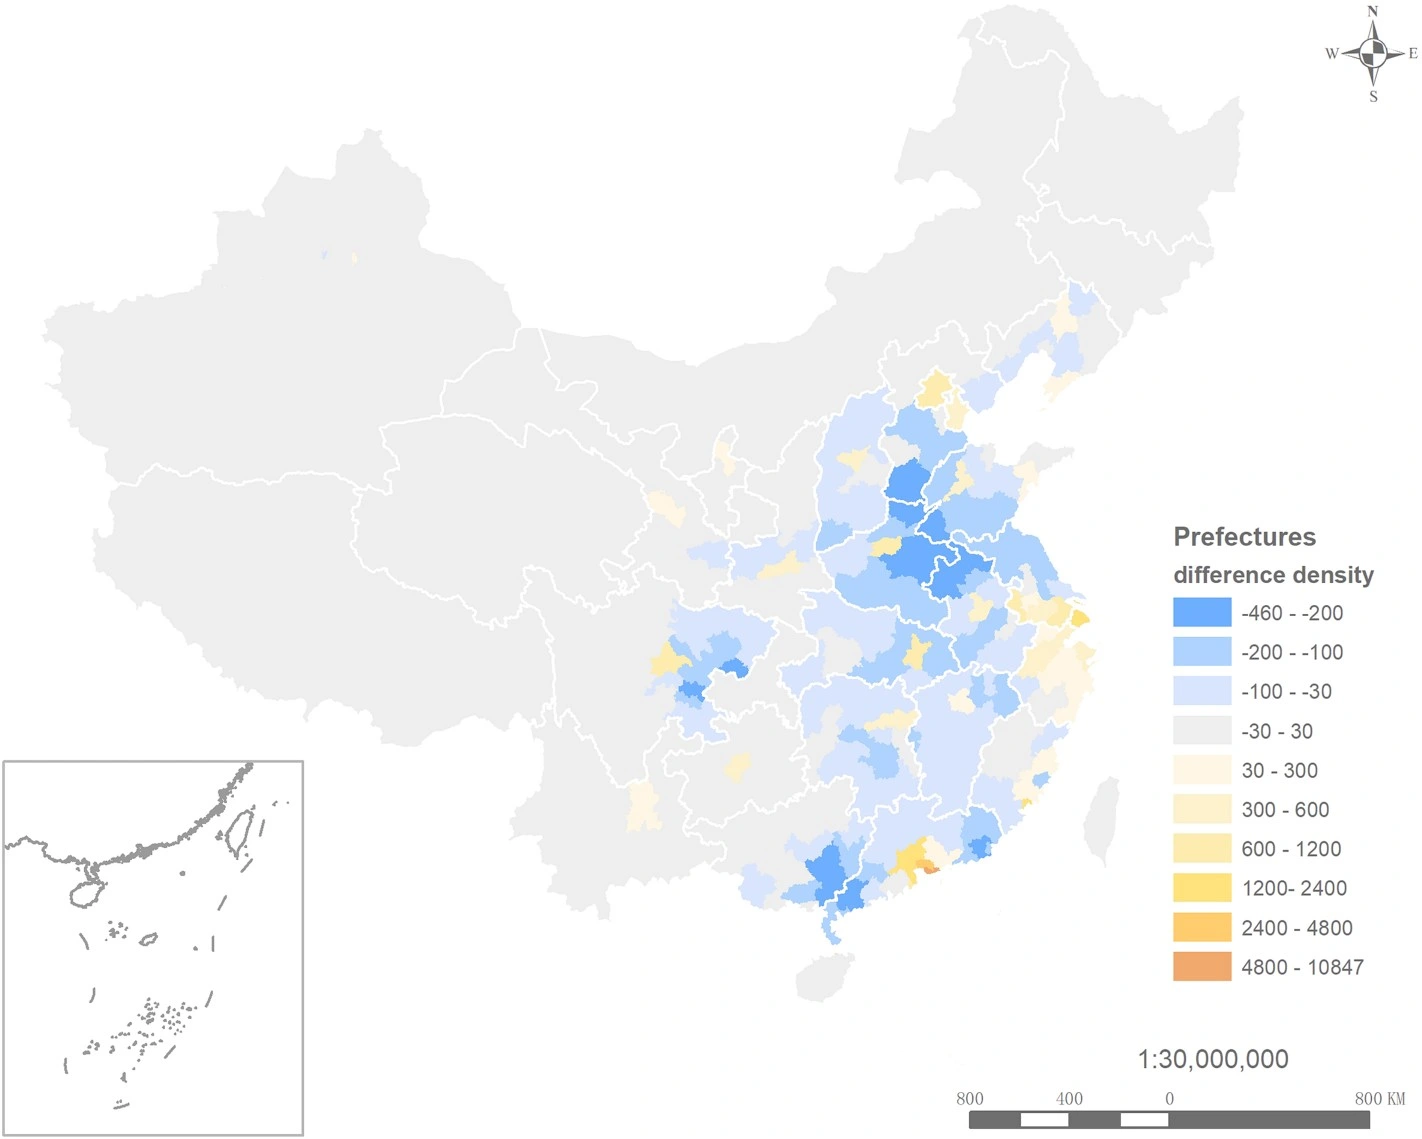
图 2|节前减节中之后,哪些地级单元在工作日更“满”?
无字母子图。图例为地级单元差异密度,蓝色为负、黄色到橙色为正,灰色为 −30 到 30。分级从 −460 至 −200,一直到 4800 至 10847;图例没有写出密度的面积单位。比例尺1:3000万。中部有成片负值,东部沿海和若干大城市为正。正值表示节前五日均高于节中五日均。来源:原论文 Fig. 2。
这张密度图和后面的回归用的是同一套差的两种呈现:图2看每单位面积,表2和回归看人数。表2里 DIF 的均值是18.330千人,也就是1.833万人;中位数是 −407.98千人,也就是 −40.798万人;最大20450千人(2045万),最小 −5340.8千人(−534.08万),标准差2909.7千人(290.97万)。表2没有另印样本量。正文写回归覆盖287个地级单元,下标从0到286。347个地级单元和287个回归单元之间的60个差额,正文没有给名单;图4里大片西部标成无数据,与此相符。
中位数为负、均值为正,是因为右尾很长。多数地级单元在节中人数更高,少数单元的节前超额很大,把平均数拉过零。把均值读成“全国地级单元平均都在节前净流出约1.8万人”,会掩盖这个分布。
九个地方的29天,为什么不能画成一条全国曲线?
五日平均会抹平假期内的逐日起伏。正文先给出九个样例的29天曲线,行政级别从直辖市市辖区、省会城区到地级市和县级单元,方向也分散;县级全部单元的29天曲线另外做聚类。图中横轴第1天对应1月16日,第3天是1月18日,第23天是2月7日除夕,第29天是2月13日。两条竖虚线标在第3天和第23天。纵轴是手机应用活跃用户数,每个小图的刻度不同。
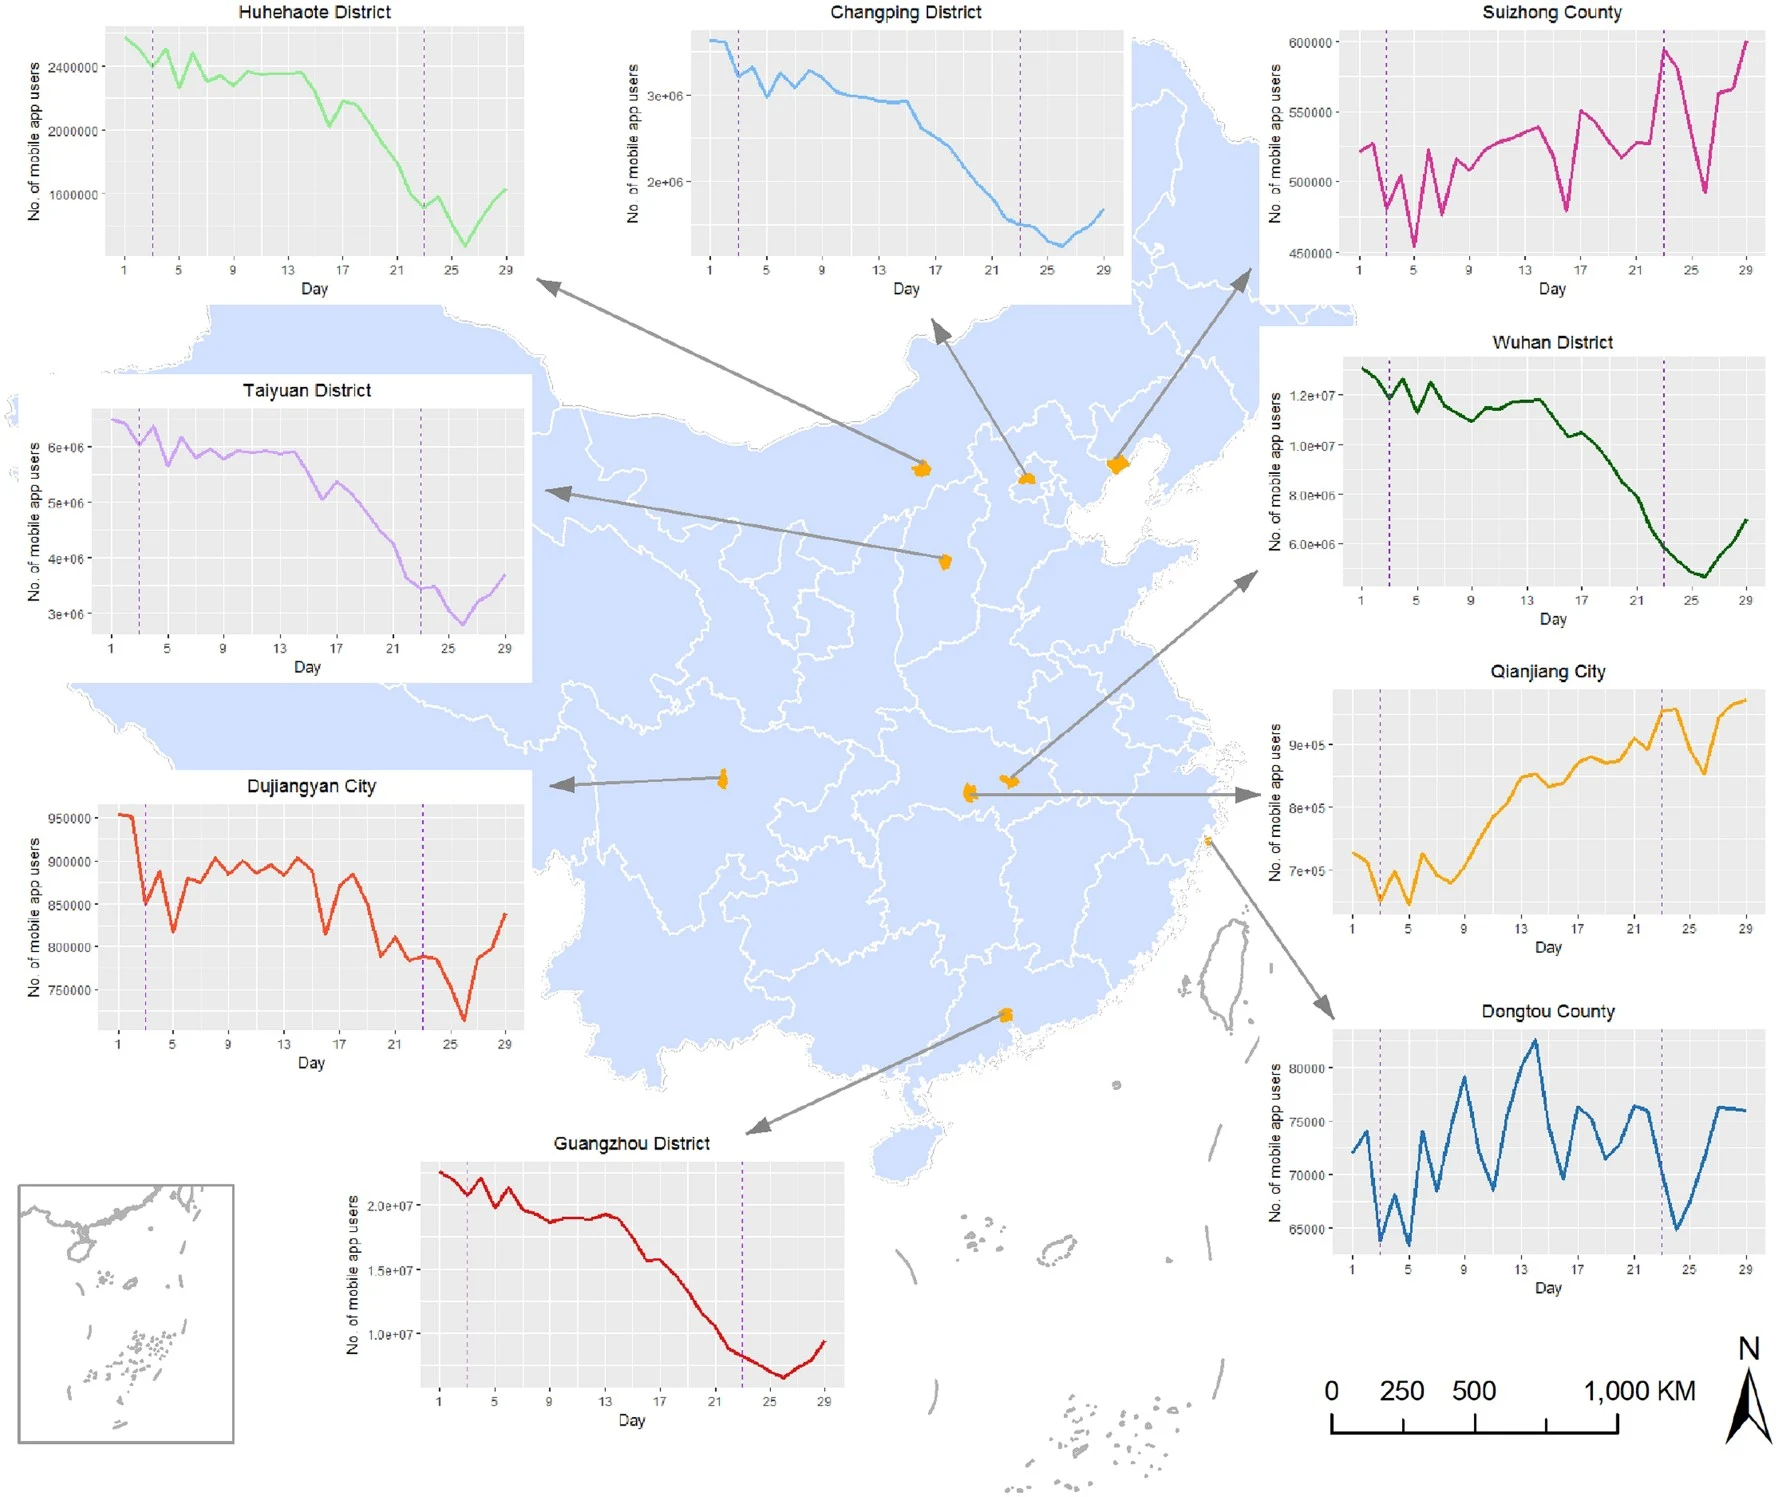
图 3|春节前后,城市和县城的活跃用户朝同一方向变吗?
图上没有 a–i 字母,九条曲线按地名对应到地图上的位置。呼和浩特市辖区(图题作 Huhehaote District)纵轴可见100万、200万、240万,曲线从240万上方降到100万刻度以下再回升。昌平区纵轴可见200万、300万,节前高于300万,节中降向200万后再略升。太原市辖区纵轴可见约300万至600万以上,节前高、临近除夕下降。武汉市辖区纵轴可见约800万至1200万以上,两道虚线之间总体下降。都江堰纵轴从75万到95万,节前接近95万,节中降到75万刻度附近再回升;正文概括为大约90万。广州纵轴有1000万、1500万、2000万,起点在2000万以上,随后下降并在除夕后略有回升;正文概括为大约2000万。绥中纵轴刻度为45万、50万、55万、60万,除夕后升到60万附近。潜江纵轴可见70万、80万、90万,全期整体上升,终点高于90万。洞头纵轴为6.5万到8万,多次上下穿越,没有稳定的节前高、节中低。来源:原论文 Fig. 3。
正文把绥中和潜江的人数写成大约20万、且数量级相近。图3坐标轴上,绥中大约在45万到60万,潜江大约在70万到90万以上。二者都远小于广州,彼此也更接近;20万与图轴不一致。读数量时以各图纵轴为准,20万只是正文的概括。
九条曲线说明,节前减节中的符号取决于样例落在哪一类地方。正文写所选的四个区都下降。图3标题中带 District 的有呼和浩特、昌平、太原、武汉、广州五处,五条曲线都下降。绥中、洞头是县,潜江、都江堰在图上标为 City;其中绥中和潜江上升,都江堰下降,洞头波动。这九个样例的分母是9,县级单元总数是2396。
县级全样本的29天曲线另做了分层聚类。正文写结果为9类,并提到一些一线城市被欠发达地区包围;平行坐标图放在补充材料。正文同时写到,中国80%的贫困县位于西部,中部和东北也有欠发达县。这句话没有给出贫困县名单、年份和统计来源,这里只把它当作正文中的背景句,不把它算作手机数据计算出来的比例。
全国一条方程不够时,各地系数差在哪里?
候选解释变量来自《中国城市统计年鉴》2016年的地级数据:年末总人口 TP,一、二、三产人均地区生产总值,职工平均工资,人均实际利用外资,年末移动电话用户数。DIF 仍是节前减节中的活跃人数。全部变量先做 z 分数:减去自身均值,再除以自身标准差。系数因此表示“自变量高出1个标准差时,DIF 高出多少个标准差”。0.495的单位是标准差;换成人数时,要再乘表2里 DIF 的标准差。
高相关、以及与因变量关系不显著,被用作删变量的标准。删减过程在补充材料;正文保留 TP、一产人均 GRP(Avg_GRPPI)、二、三产合计人均 GRP(Avg_GRPST)、平均工资和人均外资。模型中的最大方差膨胀因子小于3,作者设定的上限是7.5。移动电话用户数以及分开的二产、三产没有进入最终方程,补充材料中的相关系数正文没有列出。
表1把一、二、三产人均 GRP 的单位印成百万元/人,表2把一产和二、三产合计印成千元/人。表2的均值是:一产4.5888,二、三产合计52.218,工资53.710(千元),人均外资179.51美元。若按表1的百万元/人理解,一产人均约459万元,与常见的地区生产总值量级不符;表2的千元/人则大约是4589元和5.22万元。回归使用标准化数值,系数比较不依赖这一单位,但把系数换回货币时必须先选定哪一张表。下文涉及原始货币时按表2。
地理加权回归让每个地级单元有自己的系数。权重是固定的高斯距离衰减,距离越近权重越大;最优带宽用校正 AIC 选定,为261.70公里。第 i 个地级单元的方程是:
DIFᵢ = β₀(uᵢ, vᵢ) + β₁(uᵢ, vᵢ)·TPᵢ + β₂(uᵢ, vᵢ)·Avg_GRPPIᵢ + β₃(uᵢ, vᵢ)·Avg_GRPSTᵢ + β₄(uᵢ, vᵢ)·Avg_wageᵢ + β₅(uᵢ, vᵢ)·Avg_FCᵢ + εᵢ
(uᵢ, vᵢ) 是该地级单元中心的坐标。带宽261.70公里意味着每个局部方程都会借用相当远的邻居,局部系数是一段空间范围的平滑结果。
全局普通最小二乘有6个参数,AICc=546.45,调整后 R²=0.617。地理加权回归的有效参数个数为67.89,自由度219.11,AICc=334.07,调整后 R²=0.856。287减去67.89等于219.11,自由度与单元数、有效参数一致。ANOVA 里,相对全局模型的改进平方和78.746、自由度81.186、均方0.970;地理加权回归残差平方和28.531、自由度199.814、均方0.143。F=6.793,95%置信水平的 F 临界值为1.26。两行自由度相加为281,等于287减6。表3同时把 Global Residuals 的自由度印成6.000,与普通最小二乘的参数个数相同;正文没有解释这一格。
全局标准化系数,括号内是标准误和 t:
| 变量 | 估计 | 标准误 | t | 正文给出的检验 |
|---|---|---|---|---|
| 截距 | 0.000 | 0.036 | 0.000 | — |
| 年末总人口 | 0.027 | 0.039 | 0.715 | p > 0.05 |
| 一产人均 GRP | −0.039 | 0.039 | −1.018 | p > 0.05 |
| 二、三产人均 GRP | 0.495 | 0.064 | 7.720 | p < 0.005 |
| 平均工资 | 0.169 | 0.046 | 3.658 | p < 0.005 |
| 人均外资 | 0.213 | 0.058 | 3.640 | p < 0.005 |
截距估计为0,与因变量已经标准化一致。三个显著变量里,二、三产的标准化系数最大。按表2,DIF 的标准差是2909.7千人。0.495个标准差约等于144.0万人(0.495×2909.7=1440.3千人);工资0.169个标准差约等于49.2万人;外资0.213个标准差约等于62.0万人。这是全局模型里、其他变量同时进入方程时的关联幅度,分母是这287个地级单元的标准化尺度。按表2,二、三产的1个标准差是52.255千元/人,对应的 DIF 关联幅度约为144万人。
局部系数的分布进一步说明,全局 t 检验隐藏了方向混合:
| 变量 | 局部均值 | 最小 | 下四分位 | 中位 | 上四分位 | 最大 |
|---|---|---|---|---|---|---|
| 截距 | 0.018 | −0.400 | −0.156 | −0.016 | 0.107 | 0.763 |
| 总人口 | 0.004 | −0.212 | −0.106 | −0.022 | 0.092 | 0.393 |
| 一产 | −0.121 | −0.344 | −0.211 | −0.103 | −0.037 | 0.145 |
| 二、三产 | 0.392 | −0.542 | 0.032 | 0.426 | 0.801 | 1.009 |
| 工资 | 0.300 | −0.047 | 0.130 | 0.244 | 0.404 | 1.162 |
| 外资 | 0.312 | −0.254 | −0.038 | 0.181 | 0.333 | 2.641 |
二、三产的下四分位是0.032,至少约四分之三的局部系数为正,最小值仍到 −0.542。工资的最小值是 −0.047,下四分位已经是0.130。外资的下四分位是 −0.038,因而至少约四分之一的局部系数不超过 −0.038,最大值到2.641。一产的上四分位仍是 −0.037,多数地方为负。总人口的中位数是 −0.022,正负都有,全局检验也不显著。
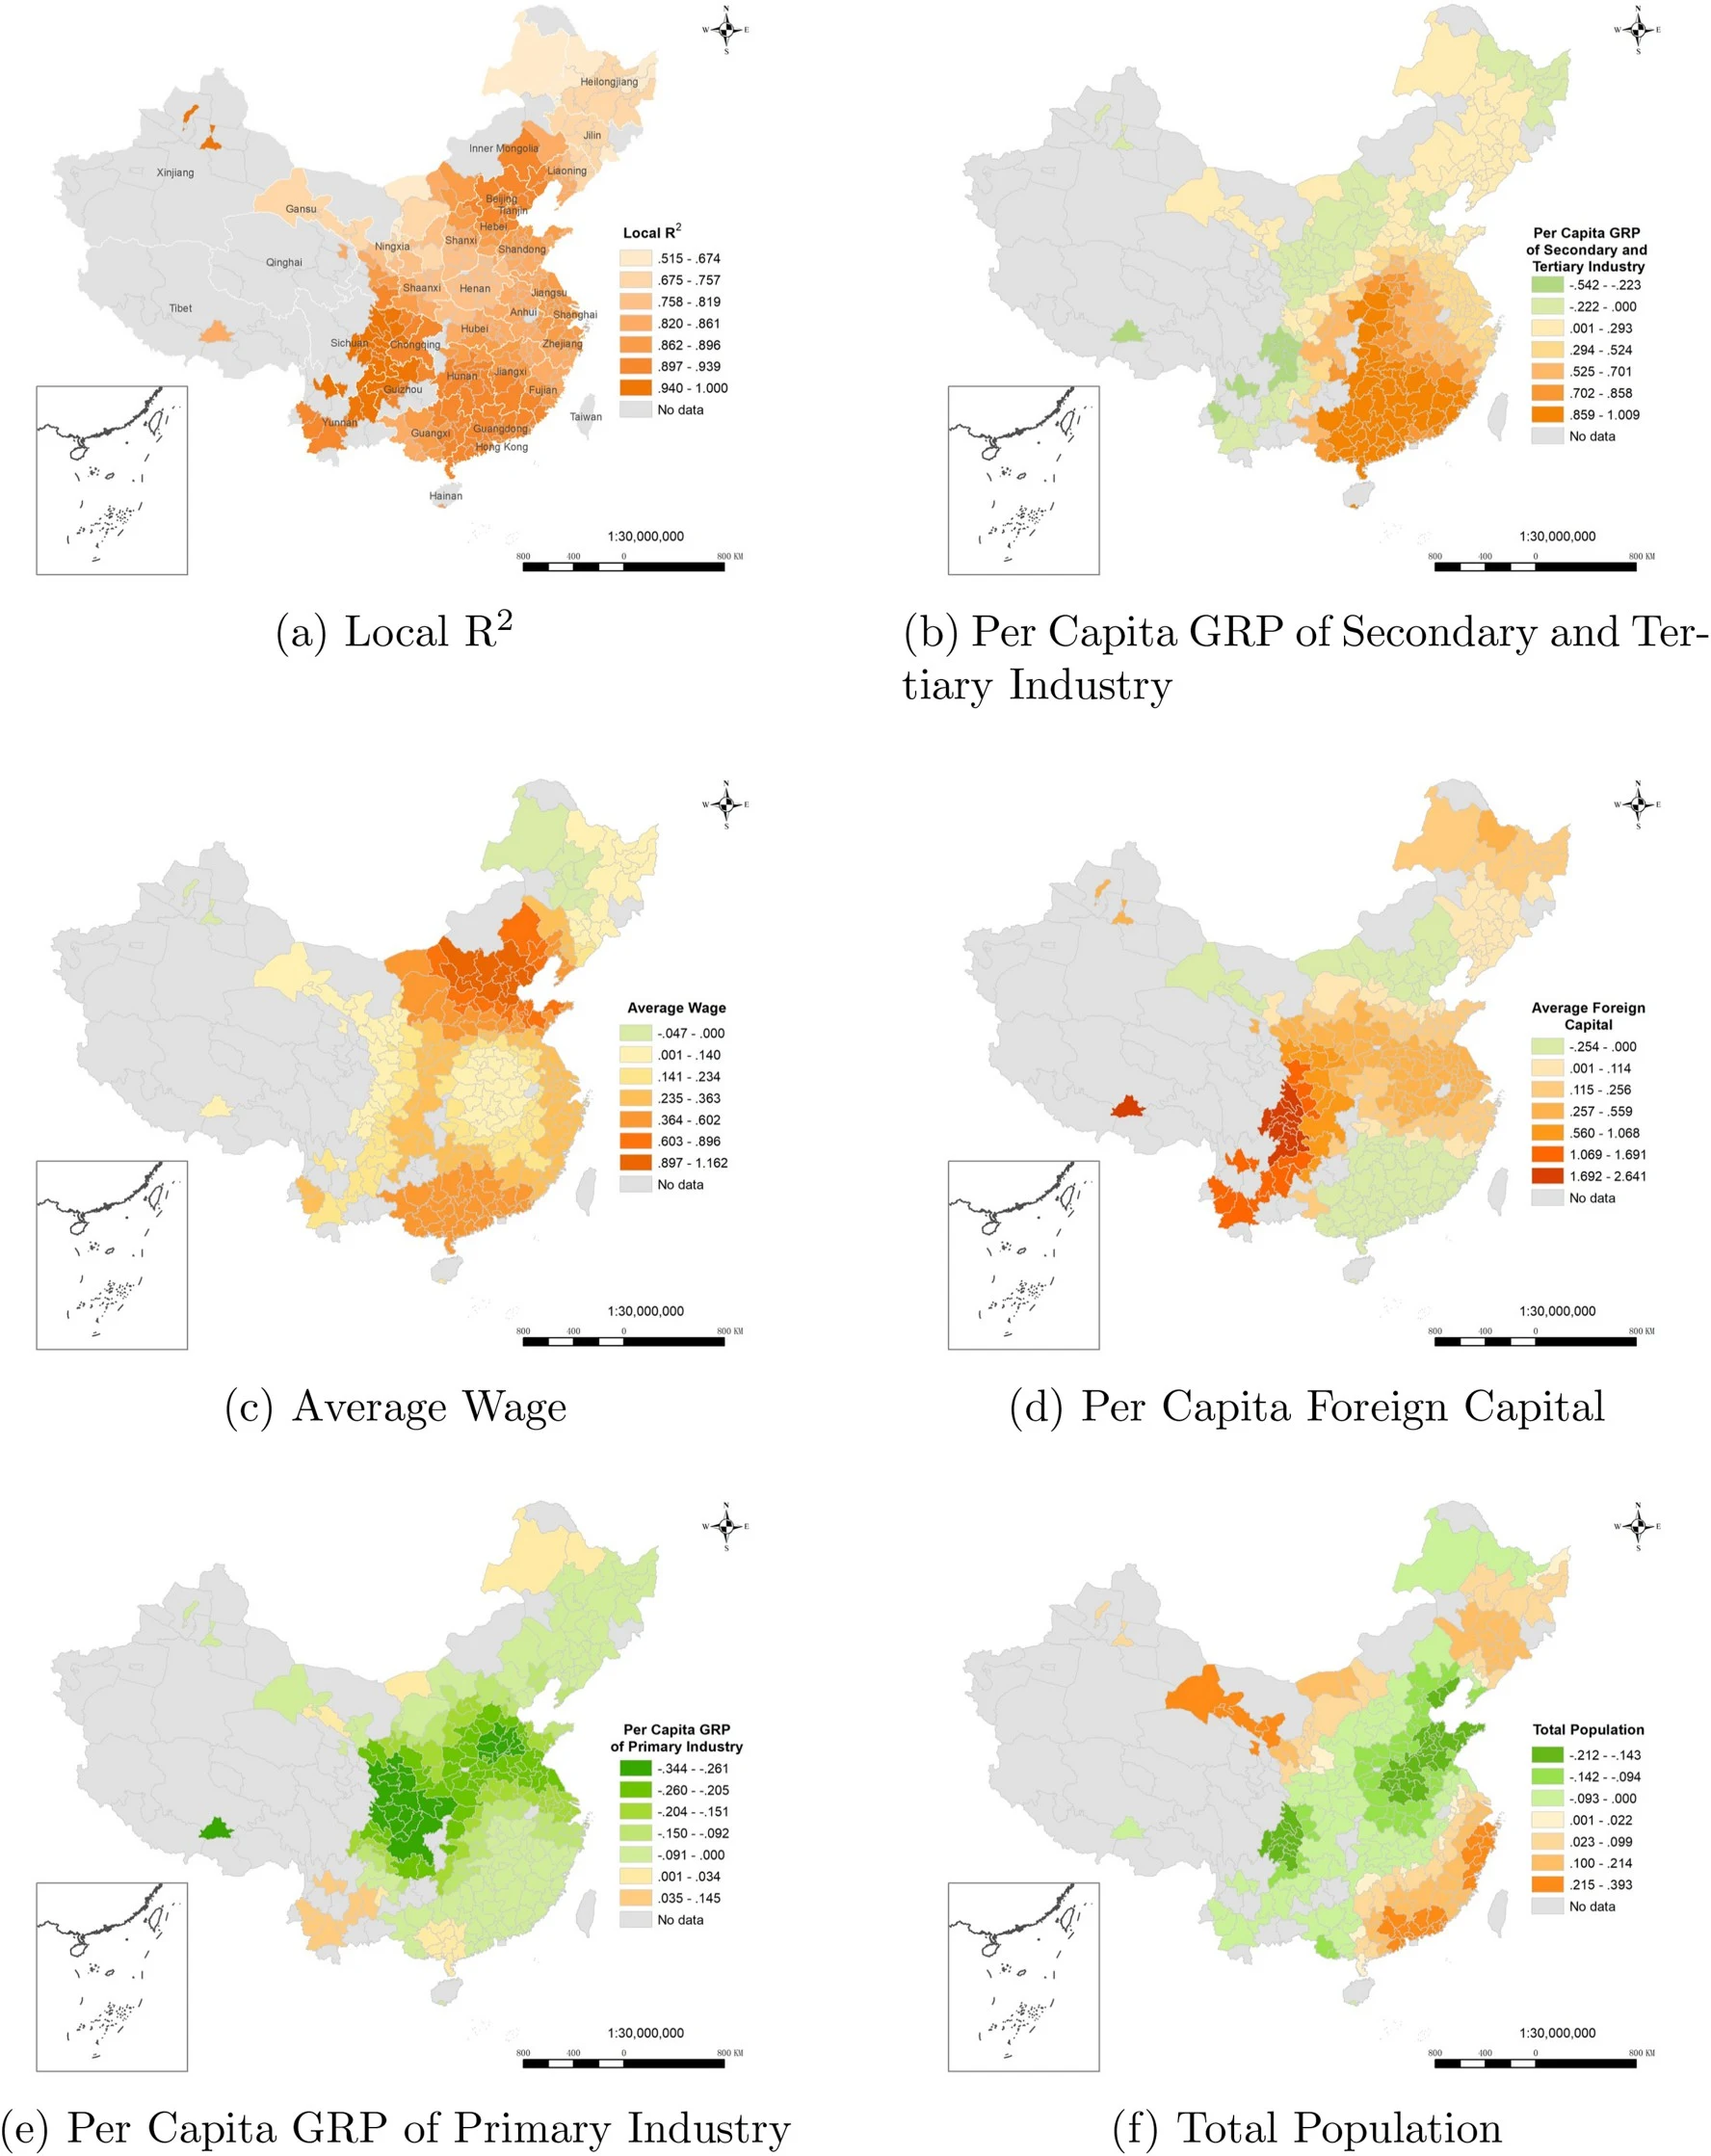
图 4|局部拟合和五个系数,在地图上哪里强、哪里反号?
(a)局部 R²。图例有数据的最低一档是0.515–0.674,最高一档是0.940–1.000,灰色为无数据。作者对整个模型设定的可接受标准,是调整后 R² 大于0.5;全局调整后 R² 为0.856。局部 R² 与这个调整后 R² 分开计算。东部、华北和四川盆地颜色更深,青藏高原和新疆大部为无数据。(b)二、三产人均 GRP 的局部系数,图例从 −0.542 到1.009,与表4的最小、最大一致。中部和南部正系数更强;正文写四川、黑龙江、内蒙古、山西、陕西以及京津附近有较弱的负向关系。(c)平均工资,图例从 −0.047 到1.162。京津及周边、广东的正系数更强;河南、湖北、山东以及甘肃、宁夏等地较弱;呼伦贝尔(正文拼作 Hulunbiur)和黑龙江、吉林的部分地区为很小的负值。(d)人均外资,图例从 −0.254 到2.641。四川一带最强,中部和西部许多地方为正;京津周边和南部出现较弱的负值。(e)一产人均 GRP,图例从 −0.344 到0.145。河北、山东、甘肃、陕西、四川、重庆的负系数更强,与(b)的高正值区域大体错开。(f)年末总人口,图例从 −0.212 到0.393。山东、河南、四川偏负,东南沿海和甘肃有正值。六张图的灰色都表示无数据。图2的灰色则是 −30 到 30 这一档有数据的分级。来源:原论文 Fig. 4。
作者对符号的解释依赖劳动力流入地和流出地这一事先划分。发达、提供岗位的地方,节前人多被读成外来劳动力在节后会回来,所以产业、工资或外资更高,对应更大的正 DIF。欠发达、输出劳动力的地方,同样的正系数被读成岗位把人留在本地,从而减少外出。农村产业若同时雇用本地人和更远乡村的人,流入和少外出会叠在同一个正号上。两种读法都与正号相容。方程使用的是当地存量差,起点、终点和个人移动标识都没有进入模型。
正文还把京津附近二、三产的弱负系数,推测为产业已经过熟、政策控制和环境压力使人不再继续流入;把南部外资的弱负系数,推测为这些地方已经吸收了大量外资,再增加外资不会带来同样多的人。两处都写明是推测。标准化残差被描述为空间上随机分布,正文没有单独给出残差地图。拟合变好,说明在261.70公里带宽和67.89个有效参数下,这五个变量的局部线性组合能跟上 DIF 的空间起伏;同一批287个单元既用来估计,也用来计算 R²。
关联能支持到哪一步?
可以支持的说法有边界。在这287个地级单元、2016年这一对五日窗口、以及 z 分数之后的线性地理加权回归里,二、三产人均 GRP、工资和人均外资与节前减节中的活跃人数同向变动,调整后 R² 从0.617升到0.856,F 检验拒绝“地理加权没有改进”。局部地图显示,工资的正关联在京津和广东更强,外资的正关联在四川更强,二、三产的正关联在中部和南部更强。
往前再走一步,证据就不够了。DIF 是两个时期的活跃存量之差,含有返乡劳动力,也含有游客和学生,以及节中少打开应用的人。渗透率被假定为各地相同的常数,正文同时承认发达地区和年轻人被代表得更好,这个假定与后一承认之间存在张力。年鉴变量是地级年末或年均经济指标,手机差是2016年1–2月的十天对比,时间对齐方式正文没有再分解。作者据此讨论的政策,例如四川更值得引入外资、京津的工资增长会伴随更多流入、中部劳动者更在意产业和外资而较少在意家乡工资,是对系数地图的解读。地图来自同期截面的相关,政策句子里的“会留住人”需要后续的人或企业如何响应才能检验。
作者也写到,迁移会继续拉开地区差距,并带来留守儿童、外来工人医疗和耕地流失等社会后果。这些后果的规模,论文没有给出测量。作者把宜居因素留到下一阶段,论文尚未报告这部分结果。
一句话总结
节前比节中少掉的手机活跃用户,画出了2016年春节前后的人口再分布,也和产业、工资、外资在空间上一起变化;要把它当成某一座城市的外来人口,还缺少从哪里来、到哪里去、以及为何移动的记录。
核心来源
- Habitat International 正式页面,题目、作者、86卷71–80页、2019年3月22日在线发表与 DOI:10.1016/j.habitatint.2019.03.002。
- 正式 PDF 正文10页,图1–4,表1–4。补充材料由正文指向同一 DOI,其中包含变量删减、补充图 S3 的分布与相关系数,以及县级29天曲线的分层聚类和平行坐标图。
- 基金写在致谢中:国家自然科学基金41625003、41830645、41801299、41771425、41871140。
作者介绍
机构以论文首页署名为准。通讯作者是 Yu Liu,邮箱 liuyu@urban.pku.edu.cn。
- Yuxia Wang:署名北京大学地球与空间科学学院遥感与地理信息系统研究所。
- Lei Dong:署名同一研究所。
- Ye Liu:署名中山大学地理与规划学院,以及广东省城市化与地理环境空间模拟重点实验室;首页两处校名拼写分别为 Sun Yat-sen University 与 Sun Yat-Sen University。
- Zhou Huang:署名北京大学地球与空间科学学院遥感与地理信息系统研究所。
- Yu Liu:通讯作者,署名同一研究所。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若要检验“节前减节中”是不是劳动力返乡,可以用一个劳动迁移很少、旅游很多的窗口做同样的差,例如一段普通工作周对一段非春节长假。春节窗口里广州下降、潜江上升;如果换到旅游假期,沿海县城上升、工地城市下降的格局重现,当前这个差里就混有很强的出游成分。比较时仍要用五日均减五日均,并说明是否做了同样的14亿缩放,否则全国应用打开率的整体下降会先制造一批正的 DIF。
另一个可计算的检查,是把流入地和流出地分开报告效应,让同一个正号对应到已经分开的两组样本。可以先用节前减节中的符号把287个地级单元分成两组,再在组内看外资或工资的系数;也可以改用能对上起点和终点的流量。若流出地组里外资系数的中位数仍高达四川地图上的那一档,而流入地组里接近零,作者关于“外资把人留在输出地”的读法就有了组间差异;若两组系数差不多,同一套年鉴变量只是在重复全国经济格局,并没有区分留下与前来。