走路和共享单车,在大波士顿补的是同一段路吗?
论文名片|Christian Bongiorno、Daniele Santucci、Fabio Kon、Paolo Santi、Carlo Ratti,Comparing bicycling and pedestrian mobility: Patterns of non-motorized human mobility in Greater Boston,Journal of Transport Geography,2019,80:102501,2019年9月6日在线发表。DOI:10.1016/j.jtrangeo.2019.102501。2019年1月29日收稿,6月26日修回,8月19日接受。本文依据这一正式发表版,属于同一地区、同一时段上的观察比较。
从地铁站走出来,有人只穿过几个街区,有人要到两三公里外的另一个市镇中心。规划里常把走路和骑车并成非机动出行(non-motorized mobility):人不靠机动车,自己把身体挪到下一个地方。并在一起之后,很容易把它们看成同一种需求的快慢两档。
大波士顿(Greater Boston)2014年8月到2015年5月的这两组记录,给出的是另一种画面。步行多停在几百米、中午还会再出现一截;共享单车多走一两公里到数公里,早晚方向更容易对调。降水小时里,两种每小时出行率都下降,共享单车降得更多。形态上它们互相补位。数据里没有出行目的字段,不能把这种形态直接写成一份目的调查。
先说结论
- 统一到2014年8月1日至2015年5月1日、并去掉同站进出的共享单车后,分析样本是144,128次步行和795,531次共享单车。步行中间50%的路程在368米到948米,中位数510米;共享单车中间50%在1.41公里到3.42公里,中位数2.2公里。
- 时长比距离更接近。步行中间50%为3.9到12.4分钟,中位数7分钟;共享单车中间50%为6.1到17分钟,均值10.1分钟。图中的纵轴是各自密度,不能当成两种方式的绝对人次。
- 在两种网络都有连边的142个格子上,PageRank的Pearson相关只有0.34。按到达出行算的基尼系数,重叠范围内步行0.52、共享单车0.37;步行若扩到全部有出行的格子,基尼系数为0.75。两张网都呈同配。
- 早晚合并后的加权互惠性,步行0.14、共享单车0.39。出行最多的200条连边上,同一方向占比在早晚之间的相关,共享单车为−0.87,步行为0.66。
- 按温度匹配之后,降水小时的出行率相对晴好小时,步行低13%(95%区间9%到16%),共享单车低46%(95%区间41%到51%)。工作日7时至19时,每小时出行次数与气温的相关为步行0.25、共享单车0.68。
两次记录,量的是同一批出行吗?
研究区是马萨诸塞州大波士顿的城市化地区。作者给出的数量级是大约200平方公里、2016年约90万人,并说明这里有大西洋沿岸、Charles River、湖泊和多中心的市镇结构,例如Cambridge的Harvard Square、Boston的Downtown和Back Bay、Somerville的Union Square。这是文中的范围描述,不是把整个波士顿都会区人口塞进这200平方公里。
步行来自一款面向活动记录的手机应用,论文没有写出应用名称。2014年5月到2015年5月,大约26万次出行、6,000余名匿名用户;轨迹经OpenStreetMap路网做隐马尔可夫地图匹配。为降低重识别风险,每次出行的起点和终点各抹去最多100米。共享单车来自当时的Hubway系统,论文写作时系统已更名为Bluebikes;用的是每次租还的起点站、终点站和时间。文中“1,800辆车、308个桩站,覆盖Boston、Brookline、Cambridge和Somerville”描述的是2018年的系统规模,不是2014–2015年分析窗里的站点普查。
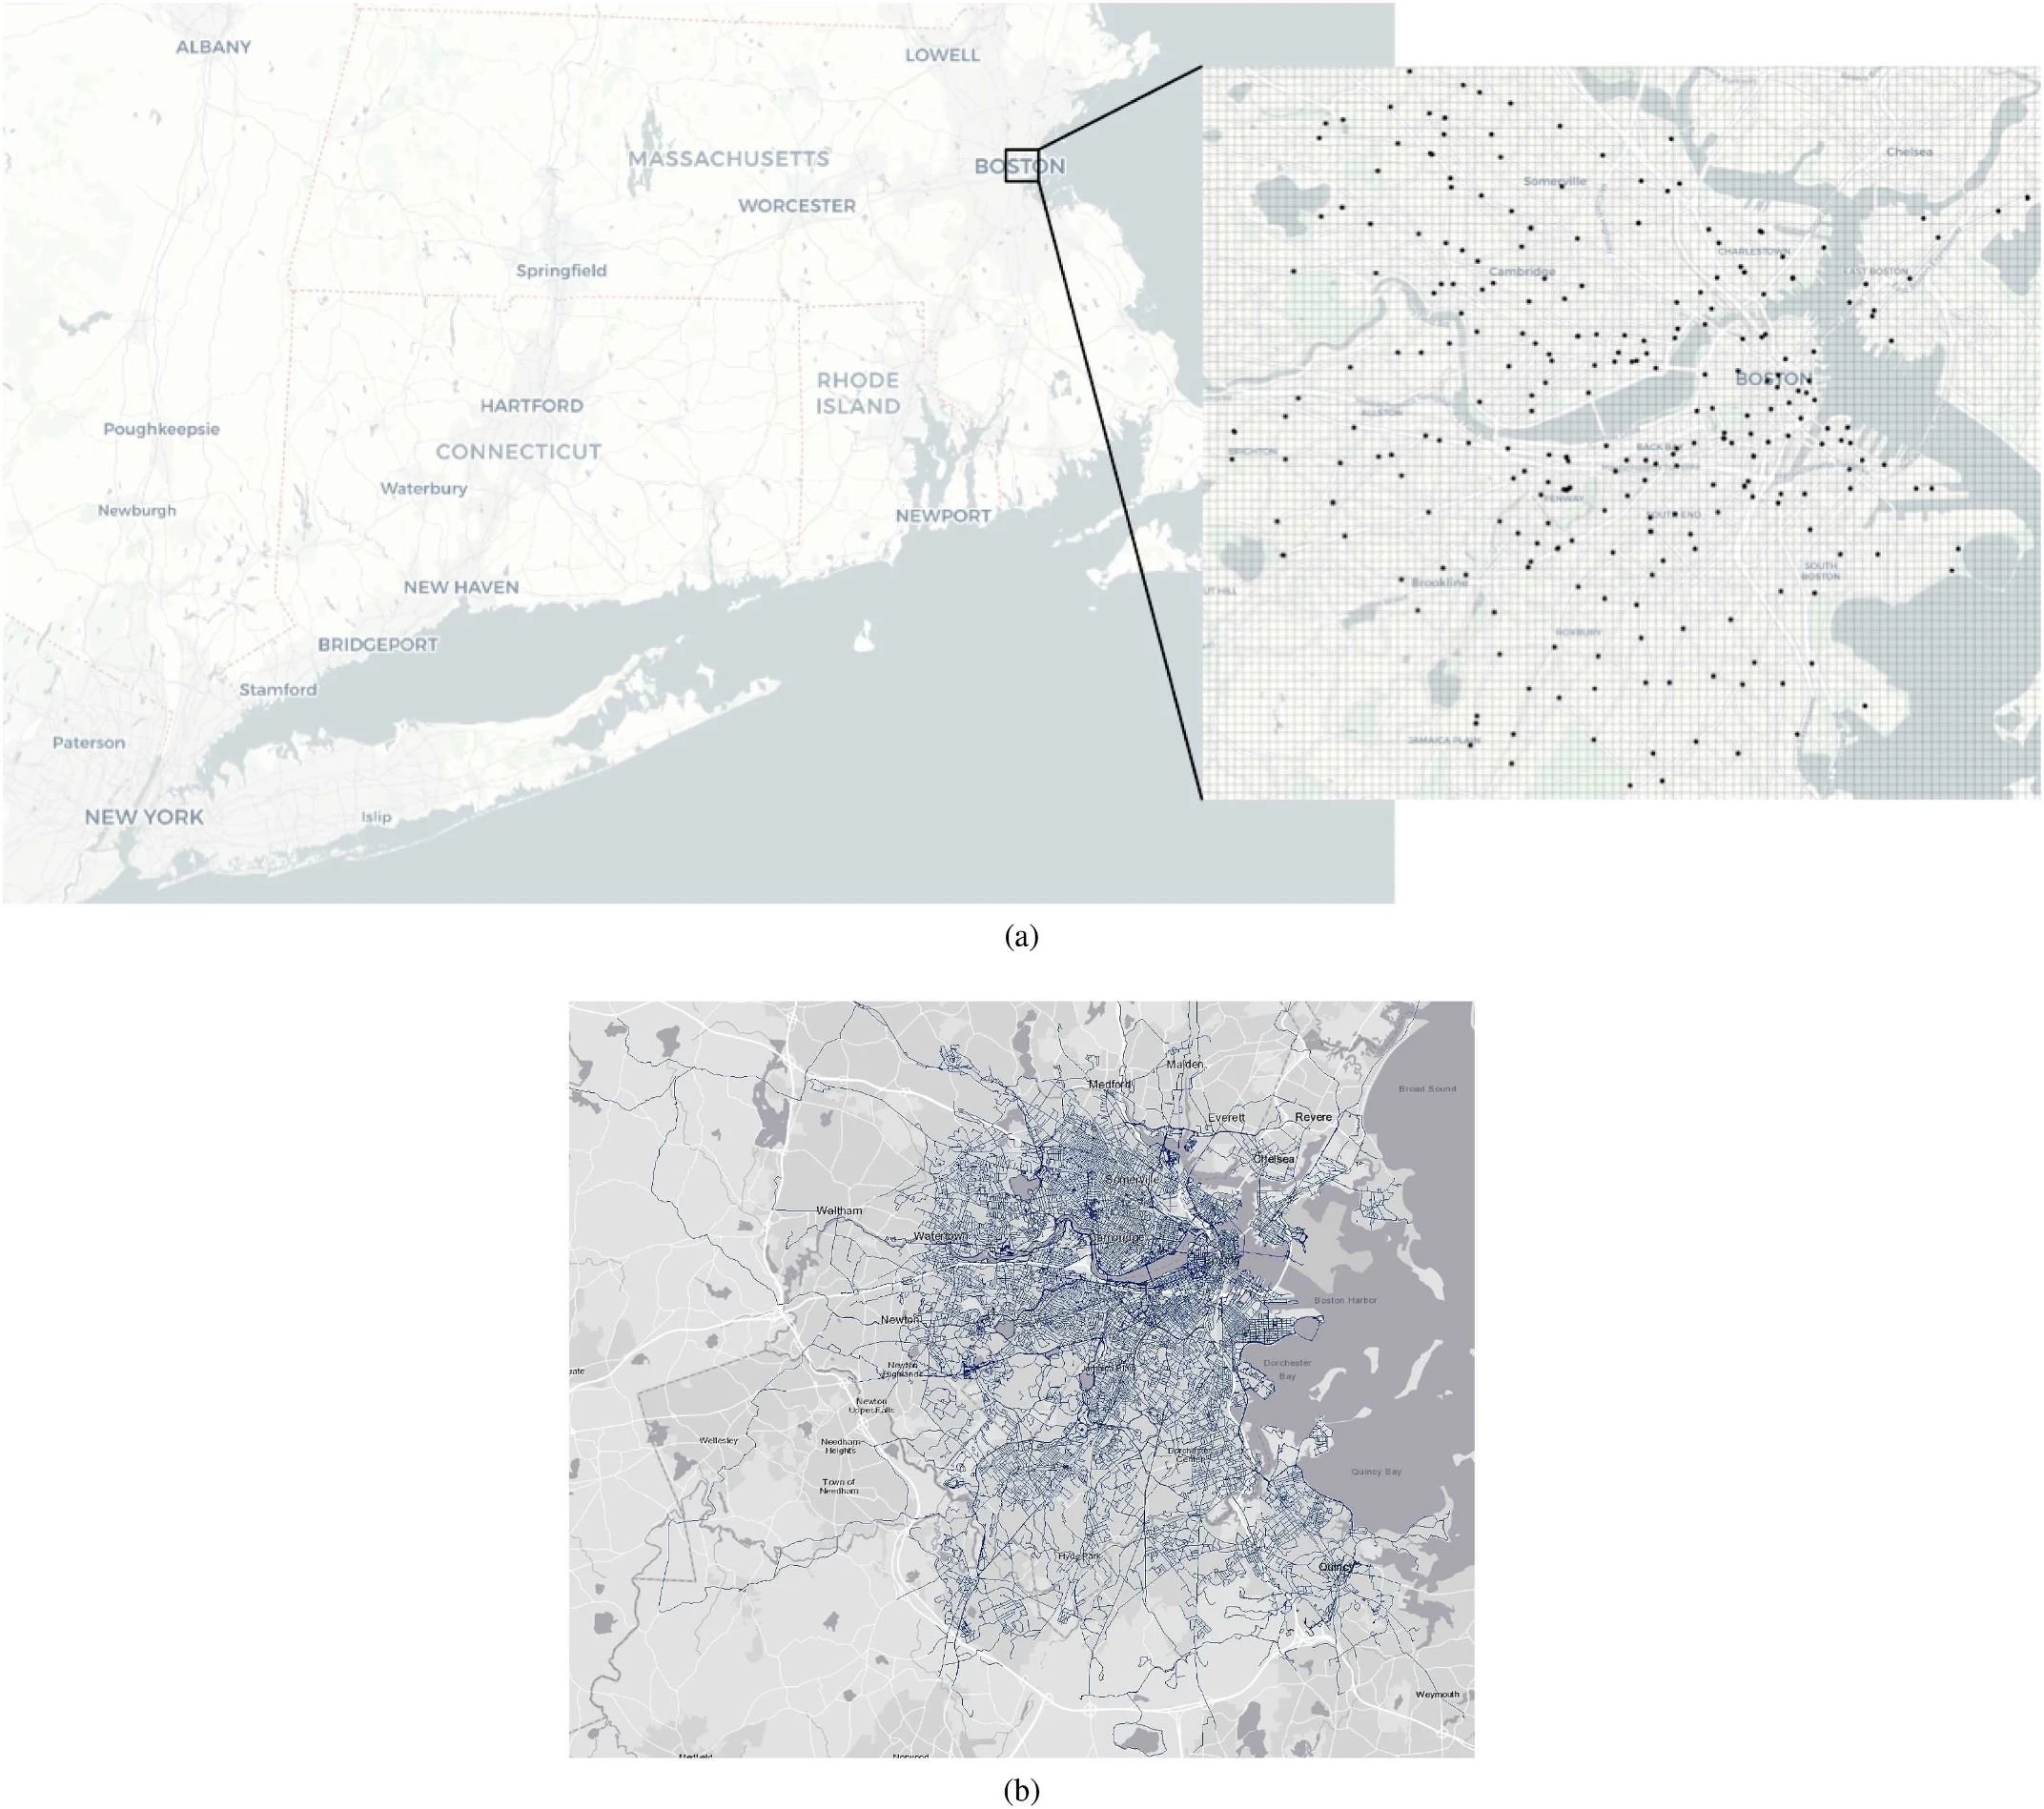
图 1|这两组出行落在大波士顿的哪一片?
(a)左为美国东北部,方框标出Boston一带;右上插图是约200平方公里上的100×100网格和共享单车站点。(b)步行轨迹铺得更开,约400平方公里,多数仍挤在插图里的中心商业区、商业区和校园附近。来源:原论文 Fig. 1。
绝对次数不能横比。共享单车数据是该时段这套公共系统的出行,步行数据只是打开这款应用的人。作者因此只做各自内部的相对比较。应用样本在既有文献里通常偏向较年轻、教育程度较高、收入较高的人群;本文没有用户年龄、教育和收入,不能把这个偏向量化到这6,000人身上。
时间也先对齐。2014年8月以前步行记录太少,分析只用2014年8月1日至2015年5月1日,并删去从同一站点出发又回到同一站点的共享单车。得到144,128次步行、795,531次共享单车。工作日之间形态相近,周末差得大,作者通常把两类日子分开;正文后面的流向和天气相关没有另附一张周末数值表。一天里重点看三个时段:早高峰7:00–10:00、午饭11:00–14:00、晚高峰17:00–20:00。
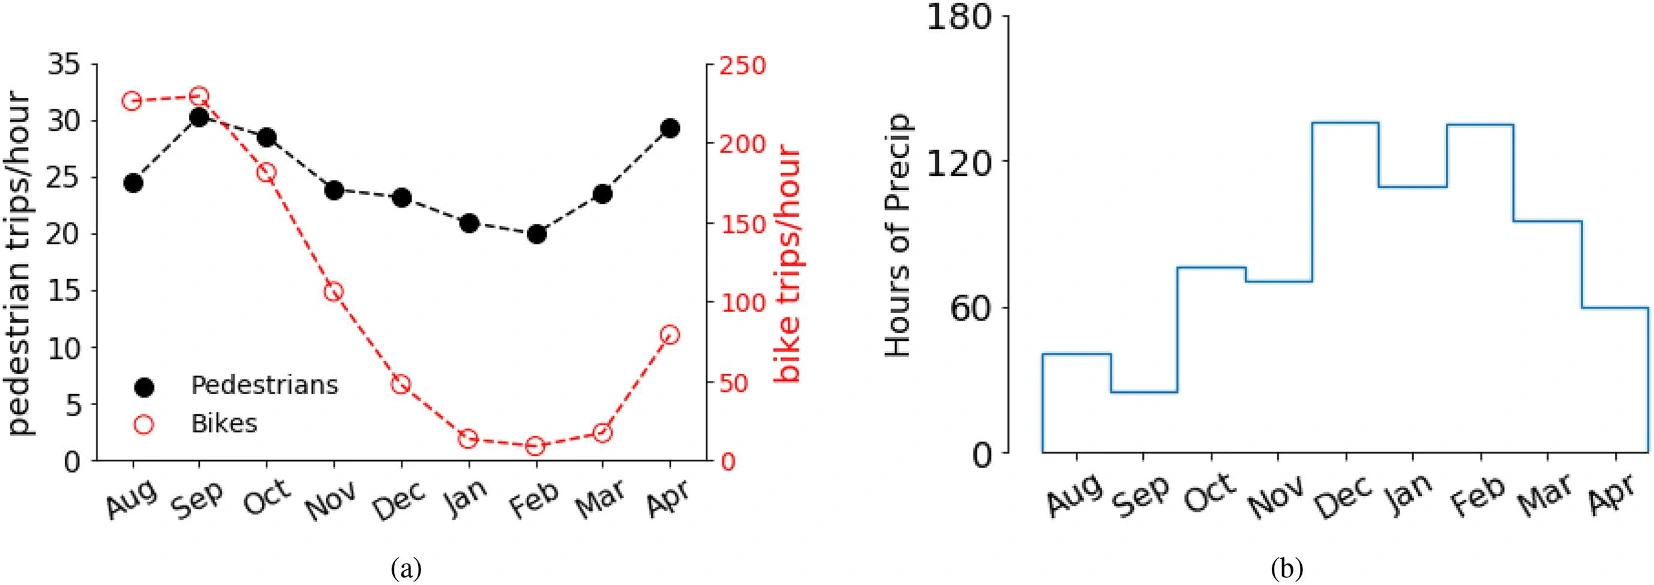
图 2|一年里,每小时还有多少次出行?
(a)左轴是数据集中的步行每小时次数,右轴是共享单车每小时次数,黑点为步行、红圈为共享单车。作者读出的两端是:步行从8月每小时33次到2月20次;共享单车从9月每小时230次到2月13次。2月的共享单车小时强度约为9月的13/230。两条曲线来自覆盖范围不同的数据集,230和33不能相减。(b)纵轴是当月7时至19时被记为降水的小时数。冷季更高;正文没有逐月抄出小时数。来源:原论文 Fig. 2。
距离差一截,为什么时长仍挤在十几分钟里?
距离用的不是地图直线。步行是匹配到路网之后的轨迹长度,而且两端已被抹掉最多100米,短出行会少记一截。共享单车是GraphHopper按自行车友好路径估计的站点间路程,不是骑行者的真实轨迹;这条建议路径平均比直线长约30%。两种“公里”不是同一把尺子,但后文的差距是几百米对一两公里,大于这段测量差的量级。
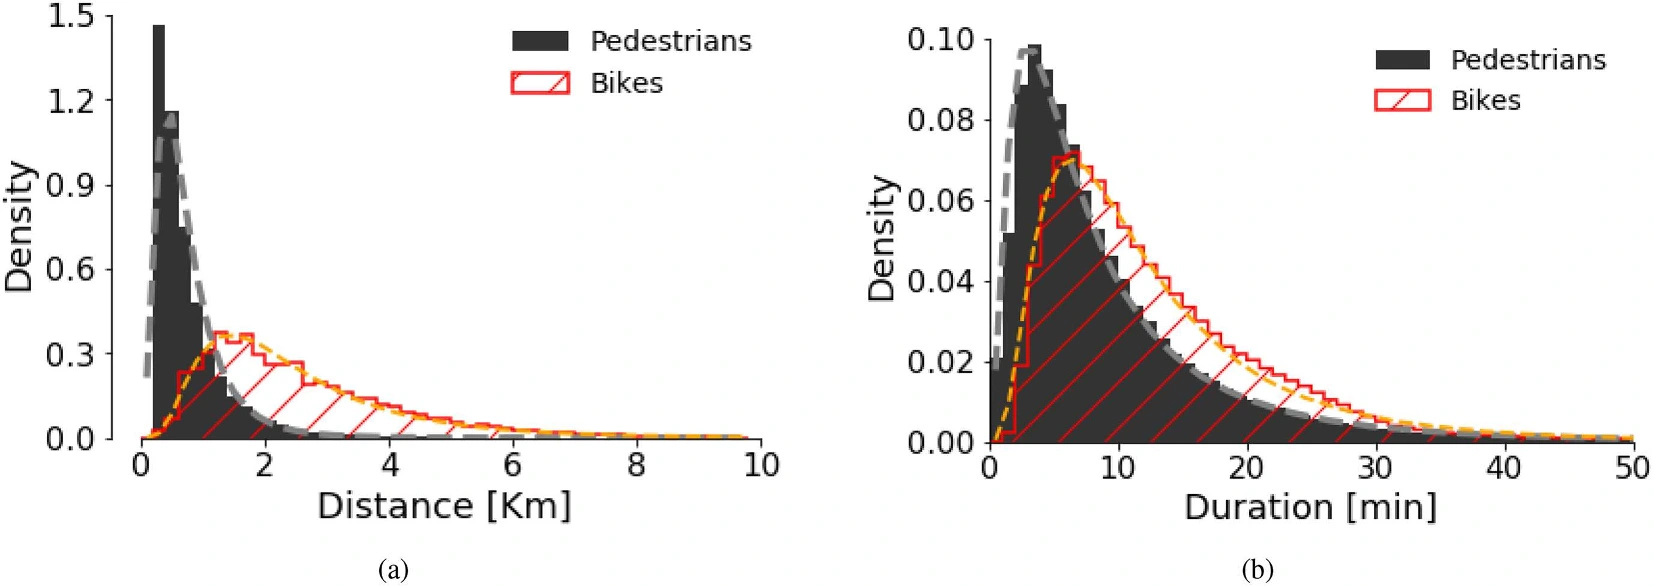
图 3|路程和时长,各自的中间一半落在哪里?
(a)横轴公里,纵轴密度。深色为步行,橙色为共享单车;虚线是对数正态近似。步行中间50%为368米至948米,中位数510米,均值789米。共享单车中间50%为1.41公里至3.42公里,中位数2.2公里,均值2.6公里。均值高于中位数,长尾拉高了平均。拟合参数是对数值的均值和标准差:步行 μ = −0.48、σ = 0.66,共享单车 μ = 0.76、σ = 0.62,只说明形状可近似,不替代上面的样本分位数。(b)横轴分钟。步行中间50%为3.9至12.4分钟,中位数7分钟;共享单车中间50%为6.1至17分钟,均值10.1分钟。对应近似为步行 μ = 1.9、σ = 0.91,共享单车 μ = 2.34、σ = 0.70。密度各自积分为1,图比较的是形状。来源:原论文 Fig. 3。
作者把重叠带概括为约600米到1公里:更短的多靠步行,约1公里到4公里多靠共享单车。这是分布的主体,不是一条没有例外的分界。共享单车还有取车成本:走到桩站、开锁、把车拉出架子,往往就要几分钟,短于大约5分钟的移动很少值得租车。时长仍挤在几分钟到一刻钟附近,作者用来对照1980年代Yacov Zahavi的出行时间预算:人每天留给移动的时间大致稳定,距离可以变。本文没有单独检验时间预算是否恒定,只是两套时长分布比两套路程分布更接近。
出发时刻的密度,午饭时为什么只抬高了步行?
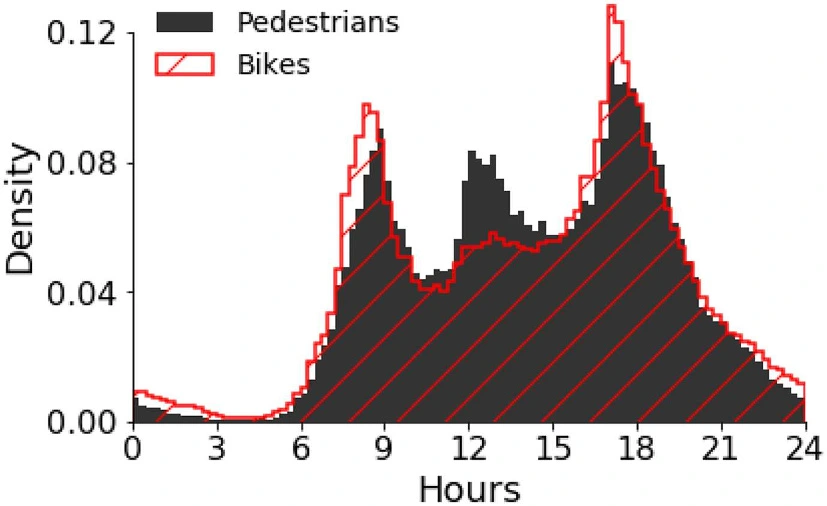
图 4|一天24小时里,出行从什么时候出发?
无字母子图。横轴是小时,纵轴是出发时刻的密度;深色为步行,红色斜线为共享单车,各自积分约为1。两条分布在全天大体同形,步行在中午明显高于共享单车。讨论里把步行的三个峰概括在上午通勤约9:00、午饭约12:30、下午通勤约18:00;共享单车保留早晚峰,午饭峰不明显。密度高只说明该方式自己的出发更集中在这些钟点,不表示中午的步行人次超过共享单车系统的绝对租车次数。来源:原论文 Fig. 4。
这个差别支持一种直观说法:共享单车更多承担通勤,Boston一带的人午饭更常走路。直观说法还不是目的标签。数据没有“去上班”或“去吃饭”的字段,午饭峰也可以来自应用用户更愿意在中午打开记录。
格子之间的箭头,早中晚各在连接什么?
空间比较先把大波士顿铺成100×100的均匀网格,共10,000个可能的起终点格子,单格边长接近300米。每对格子数有多少次出行,再画成箭头:线宽和透明度正比于次数。脚注说明,步行箭头只相对步行总次数,共享单车箭头只相对共享单车总次数。图5的比例尺在步行面板标3000、在共享单车面板标6000,两列的粗细不能当成同一种人次。
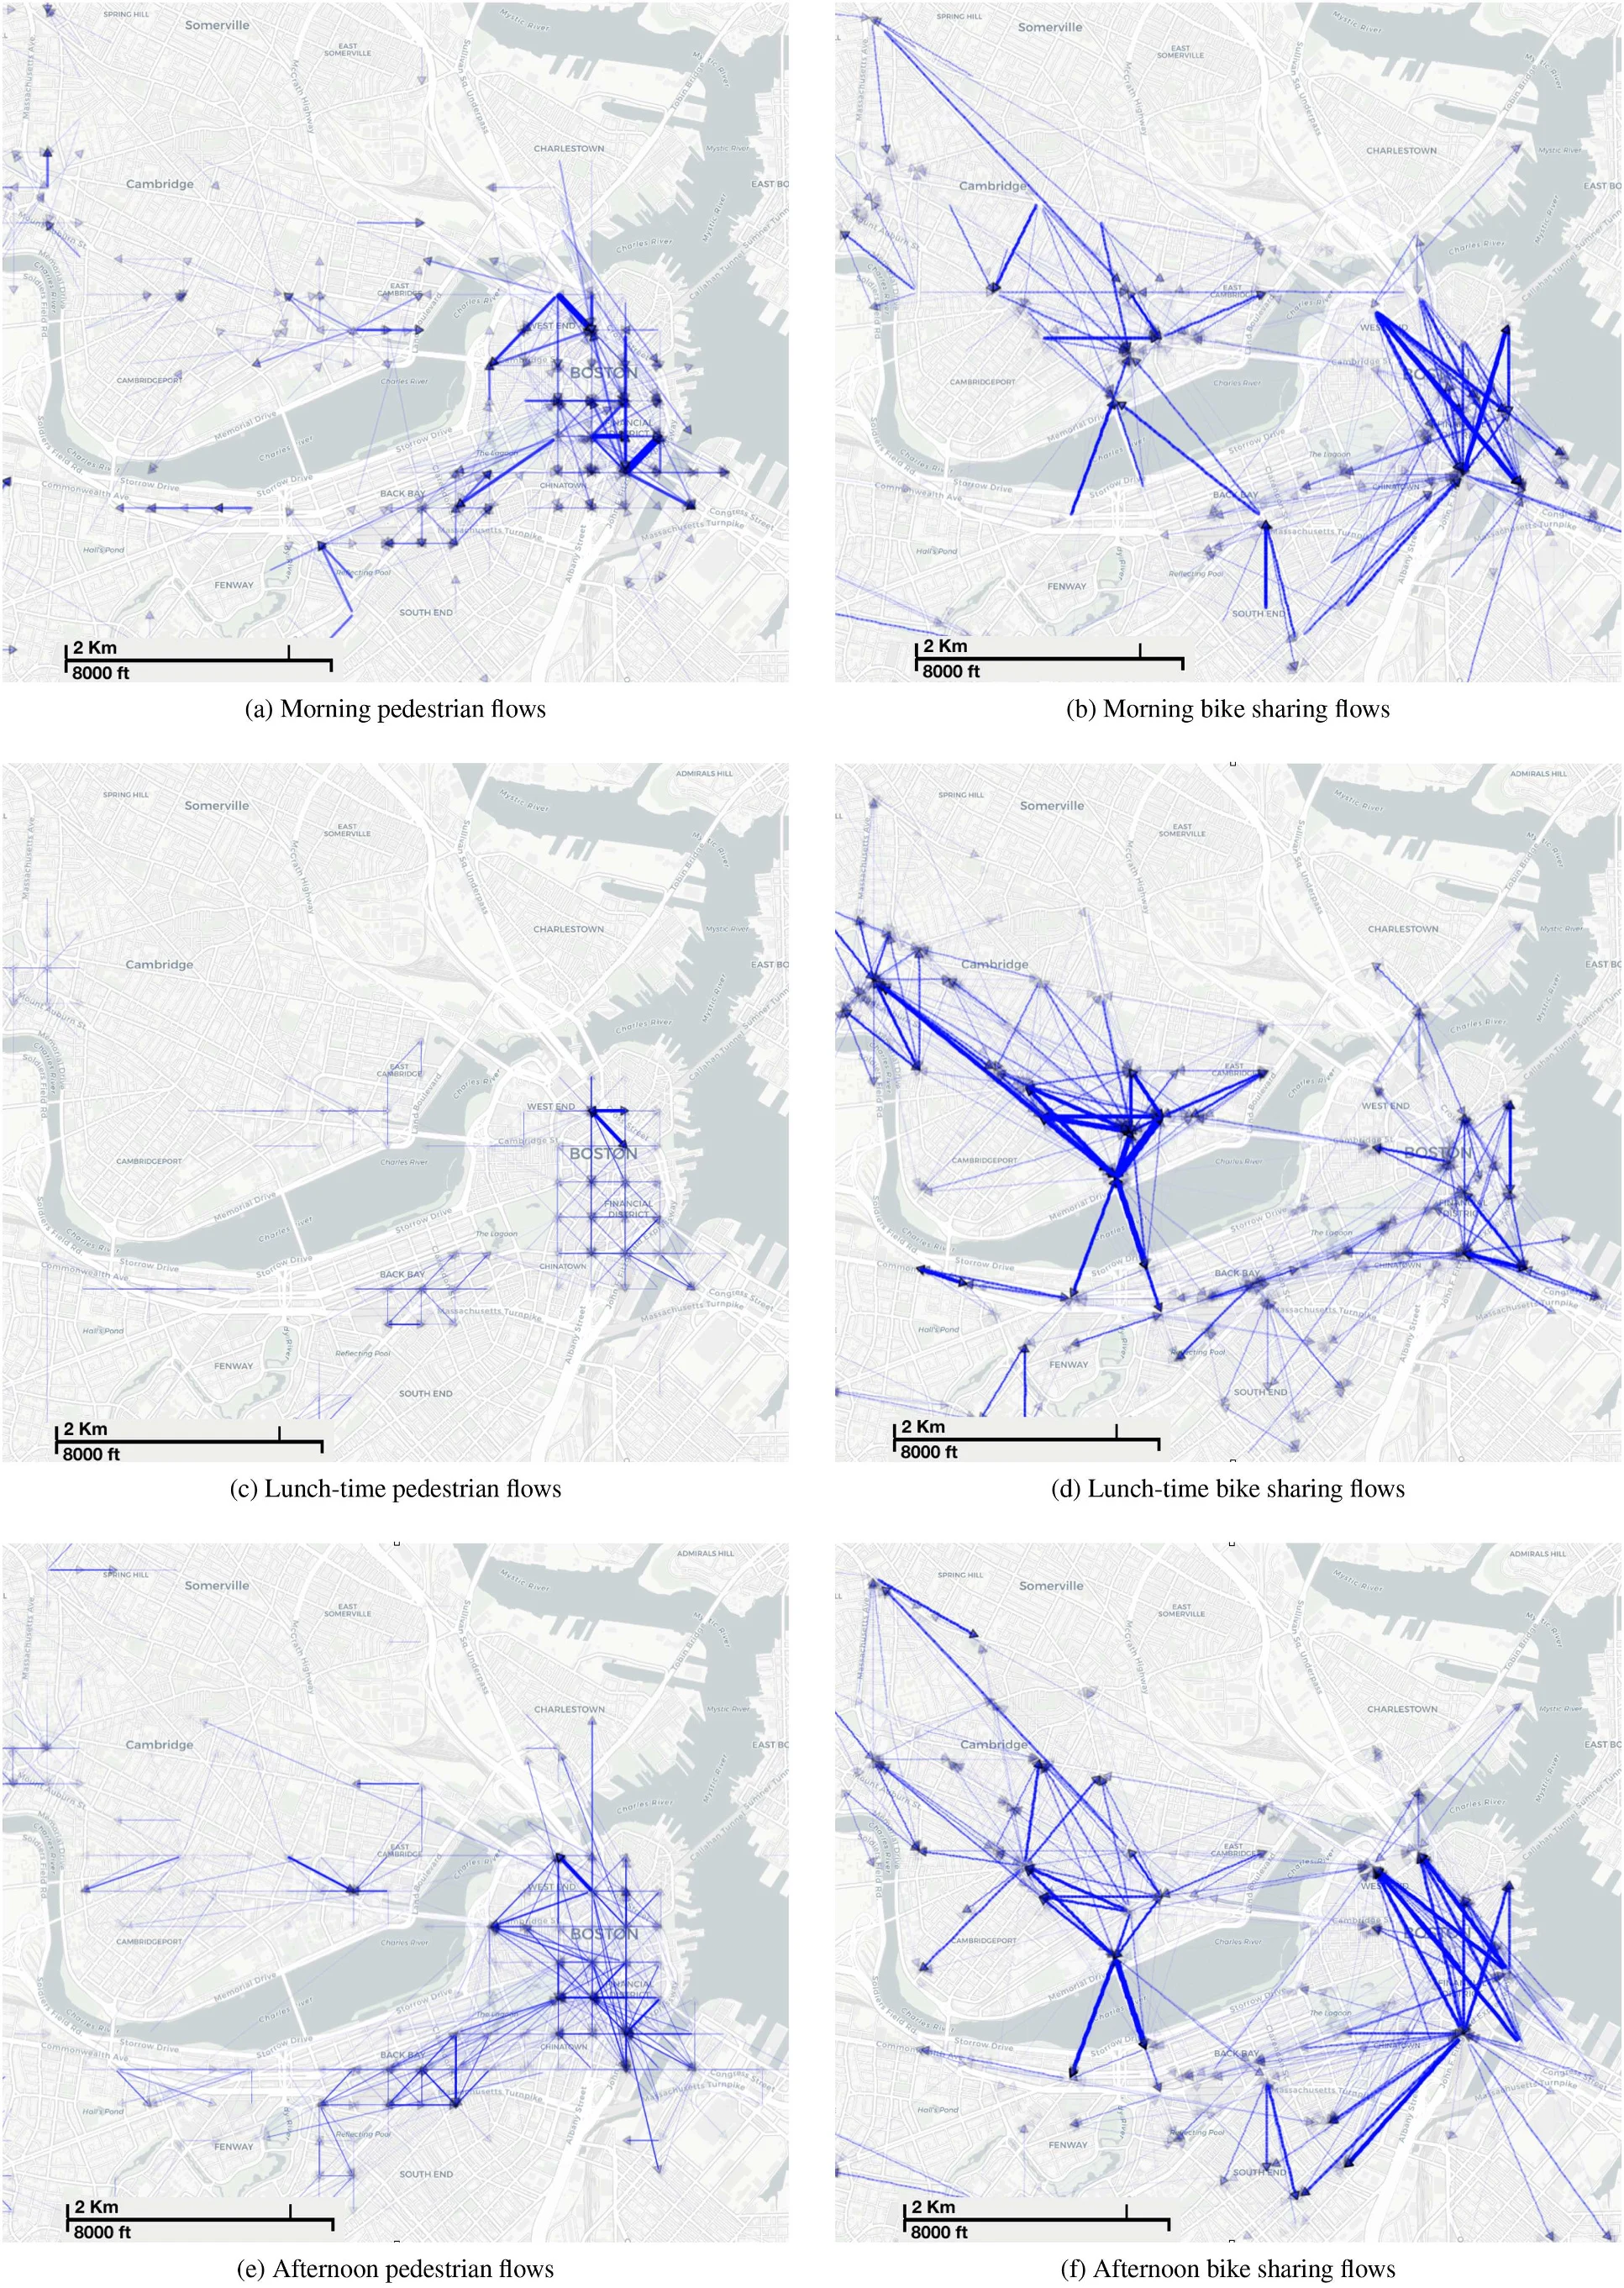
图 5|早、中、晚的主要流向是否重合?
(a、c、e)步行,依次为早高峰、午饭、晚高峰;比例尺2公里,流量标尺3000。(b、d、f)同一三个时段的共享单车,流量标尺6000。步行箭头更短,聚在商业区和校园一带;共享单车把相距约2至5公里的市镇和街区连起来,早晚更像住区与就业、校园之间的往返,也汇向主要地铁和火车站。绝大多数出行集中在图中大约50平方公里的中心,而不是图1里那400平方公里处处均匀。来源:原论文 Fig. 5。
作者由此写:两种方式的功能不同,合在一起才覆盖从街区到数公里的一段距离。他们引用美国交通部2017年全美家户出行调查:美国小汽车出行中35%短于2英里,将近一半短于3英里。后文把2英里写成约3.2公里,并把35%收成“多达三分之一”。这是全美调查里的小汽车出行,不是大波士顿这次步行或共享单车样本里有多少趟可以改方式。
同样的格子,两种网络把“重要”排在同一处吗?
把格子当节点、出行次数当有向边的权重,就得到一张加权有向流网。作者比较的是2014年8月到2015年4月的全部出行,和前面“到5月1日”的样本窗差一个月的表述,后文按他们写的8月至4月理解这张网。
边上若有站点,格子才可能出现共享单车连边。共享单车网里度大于0的节点只有142个;步行网有5,571个。PageRank在这里的意思是:一个人按流量随机走,走很久以后落在这个格子上的可能性。数值大,表示这个格子在该张流网里更常被走到。两张网的节点数不同,PageRank的绝对大小不能跨方式当成“这个路口有多重要”。
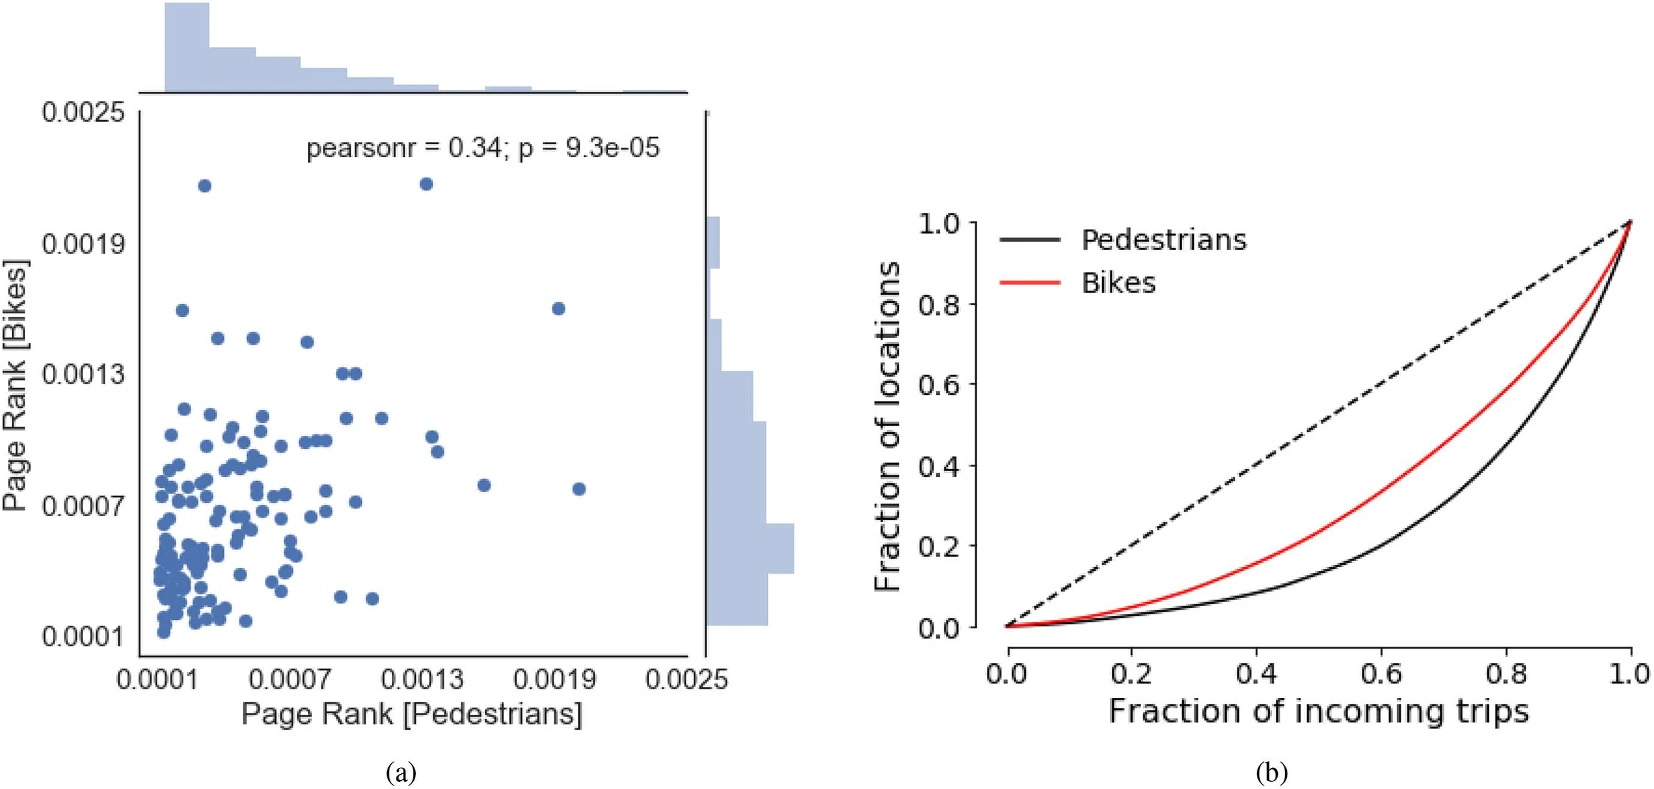
图 6|重要格子是否重合,到达量有多集中?
(a)只画两种网络度都大于0的142个格子。横轴步行PageRank,纵轴共享单车PageRank,边缘直方图是各自的分布。图例给出Pearson相关0.34,p = 9.3×10⁻⁵。相关为正,但只有弱相关:步行的高PageRank格子并不自动是共享单车的高PageRank格子。步行直方图更挤在低值,少数格子很高;共享单车在这142个格子上铺得更开。(b)洛伦兹曲线。横轴是累计到达出行占比,纵轴是地点占比,虚线是完全均质。基尼系数是虚线与曲线之间面积的两倍,范围0到1。按这些对照地点,共享单车0.37,步行0.52。步行若把全部有出行的格子都算进去,脚注给出的基尼系数是0.75。曲线更弯表示到达量更集中,不表示步行总次数更多。来源:原论文 Fig. 6。
作者把步行更集中理解成枢纽结构,并给出一个尚未验证的解释:工作日步行高度集中在商业区,共享单车因为能到达更多目的地,枢纽没那么突出。桩站位置本来可能制造枢纽,数据却显示共享单车比步行更分散。这是对流网的描述,不是对“人故意选择枢纽”的实验。
枢纽若像航空网络那样,辐条大多连到少数枢纽,邻居的强度会随自身强度下降。这里用节点强度,也就是连在该点上的出行次数之和。对每个节点,计算其邻居强度的加权平均;若这个平均值随自身强度上升,网络就是同配(assortative mixing):枢纽连枢纽,弱格连弱格。无相关时,这条邻居强度应接近一个由原网络强度算出的常数,图里画成虚线。
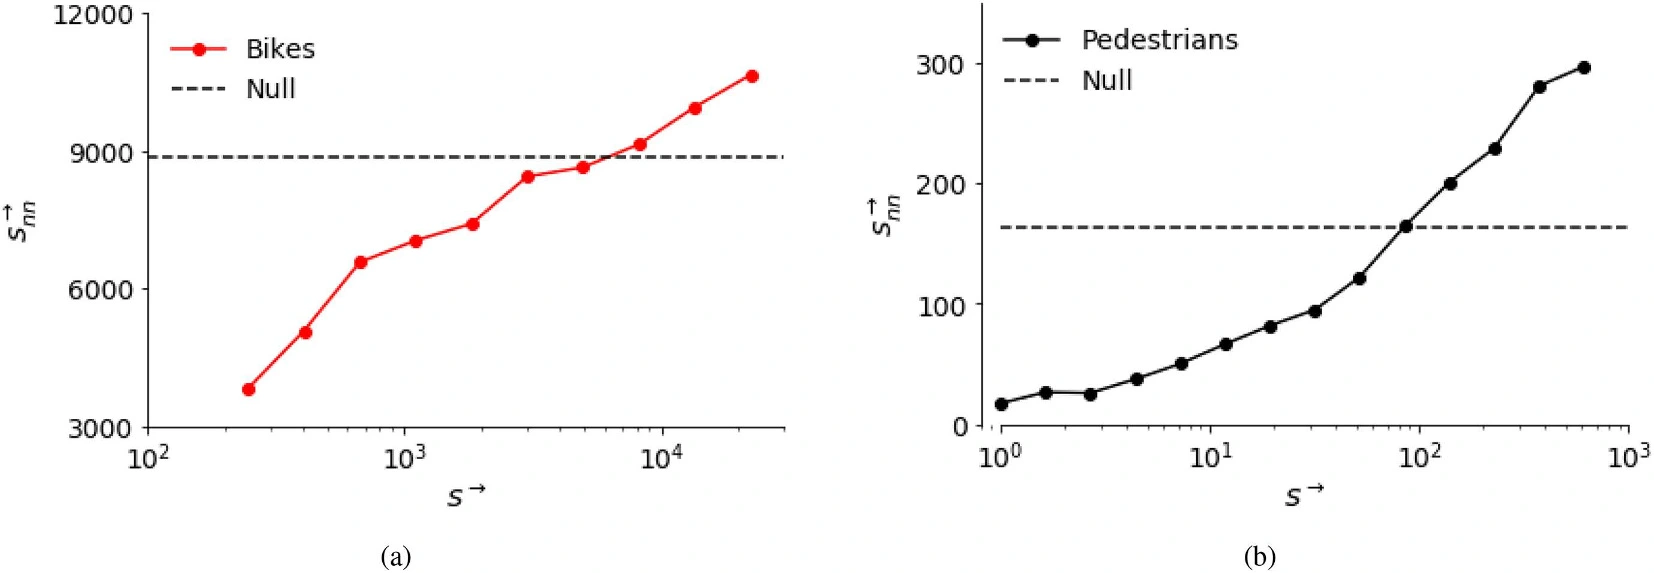
图 7|强格子是连着强格子,还是连着弱格子?
(a)共享单车,(b)步行。横轴是节点的出强度,纵轴是其邻居的平均出强度,横轴按对数分箱。实线随自身强度上升,高强度一端位于虚线之上,低强度一端位于虚线之下。两条虚线的高度不同,因为出行总量和格子数都不同,纵轴不能跨图相减。入强度的结果作者称同样为同配,图上画的是出强度。地理上看,高强度格子集中在商业区,低强度格子更多在外围和居住区。来源:原论文 Fig. 7。
所以两张网都更集中于一部分地点,同时又是同配,而不是航空式的“弱地点只连接大枢纽”。同配描述的是格子和格子怎样相连,基尼系数描述的是到达量在格子之间是否不均,两件事同时成立。
早上的方向,下午会不会倒过来?
加权互惠性把“有没有反向流量”收成一个0到1的数:分子是每条有向边与其对向边权重的较小值之和,分母是全部有向边权重之和。0表示权重都是单向的,1表示每份流量都有等量反向。它不是“有百分之多少的路是双向车道”。
早高峰7:00–10:00,步行0.13,共享单车0.18,两边都以单向为主。晚高峰17:00–20:00,步行0.14,共享单车升到0.28。把早晚合在一起,步行仍是0.14,共享单车到0.39。作者把0.39说成将近四成流量是双向的,并据此认为共享单车更像通勤:早上一个方向,下午倒回来。步行合在一起几乎不升高,说明下午并没有把早上的步行流量成对地走回去。作者也写明,这不证明步行者不是通勤者:他们下午可以换一条路,或者换成别的交通方式。把早晚高峰再收窄,作者说结果非常接近,但没有给出那一组数值。
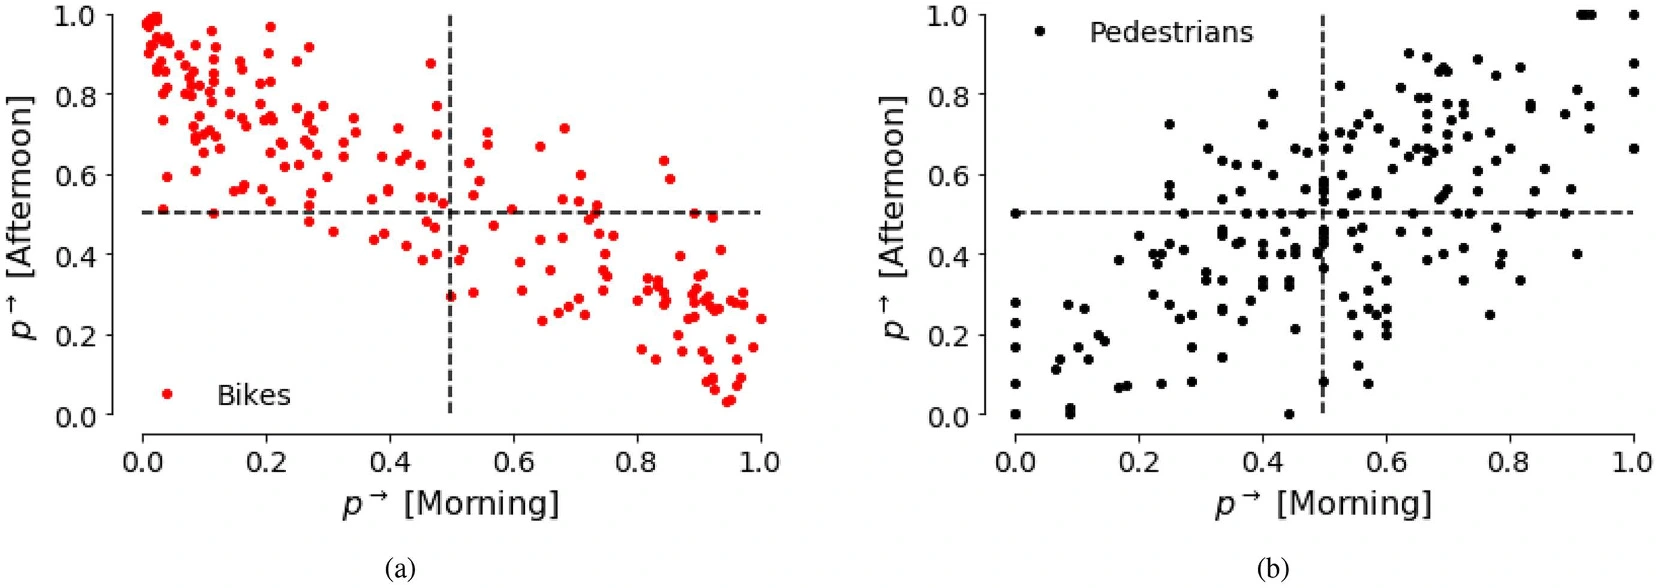
图 8|最忙的连边,下午还走早上的方向吗?
(a)共享单车,(b)步行。每点是早晚累计出行最多的200条连边之一。横轴是早上沿某一固定方向的出行占比 p→,纵轴是下午仍沿该方向的占比;0.5的虚线表示该方向与反方向各半。共享单车从左上到右下,相关−0.87:早上占优的方向,下午往往不再占优。步行整体从左下到右上,相关0.66:早上的方向下午仍倾向保持。相关是这200条连边的方向占比之间的关系,不是200条里有多少条完全对调。来源:原论文 Fig. 8。
降水和温度,减少的是每小时出行率的哪一部分?
降水记录来自weather.com的逐小时报告。只要该小时被标成雪、毛毛雨、雨、风暴、雷暴、雨夹雪、冬季混合降水或降水,都算降水小时。图9的横轴写成rain,读的时候应按这一组合,而不是只有降雨。比较的是降水小时和晴好小时的每小时出行次数。Boston的降水更集中在冷季,气温也更低,所以不能把冬天的低出行直接算到下雨头上。
先看气温本身。工作日7:00–19:00,每小时出行次数与气温的Pearson相关,共享单车0.68(p值接近0),步行0.25(p = 10⁻⁵²)。小时数很多,p值很小并不自动等于效应很大;强弱要看0.68和0.25。步行与气温的线性关系更弱。
作者用标准化偏差衡量降水小时和晴好小时的气温是否已经可比。分子是两组平均气温之差,分母是两组方差平均值的平方根,再乘100%。他们采用的经验线是25%:高于这条线,就不直接比出行率。匹配前,步行的气温标准化偏差是53%,共享单车是42%。
匹配把气温按华氏10度一档切开。每一档里,步行晴好、步行降水、共享单车晴好、共享单车降水四组记录都有,从每组有放回地抽取,抽取个数等于四组中最少的那一组,再把各档拼起来。这样复制10,000次。匹配后,标准化偏差的平均值降到步行1.5%(95%区间0.2%到3.1%)、共享单车1.4%(95%区间0.1%到3.0%)。这是在观察到的气温分布上重新配平,不是把人随机分到下雨和晴天。
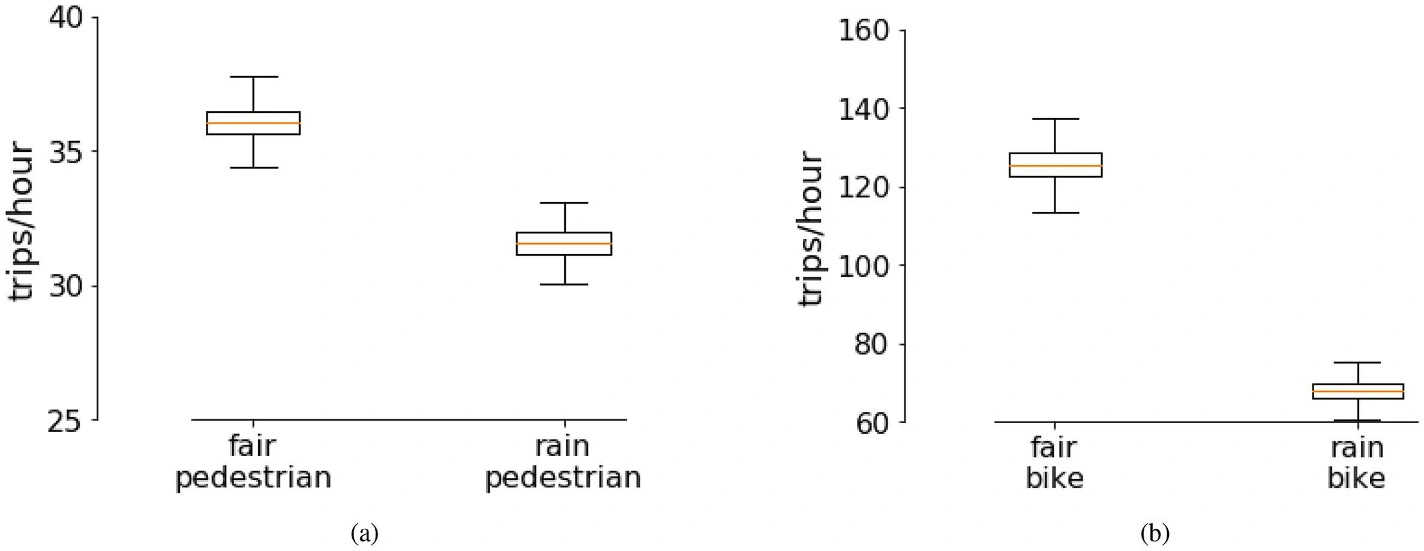
图 9|配平气温之后,降水小时的出行率还低多少?
(a)步行,(b)共享单车。箱线来自10,000次自助匹配。橙线是中位数,箱子是25和75分位,须是1.5倍四分位距。纵轴是匹配样本里的每小时出行次数,左右两图刻度不同。相对晴好小时,降水小时的出行率步行低13%,95%区间9%到16%;共享单车低46%,95%区间41%到51%。分母是配平后的晴好小时出行率。46%是这套共享单车记录的小时出行率变化,不是调查里“一半的人决定不骑车”。来源:原论文 Fig. 9。
同样的读数,体感随月份改变。作者举例:15°C在夏天可能觉得凉,在冬天可能觉得暖。所以下一段不看温度计上的绝对度数,而看某一小时比该月同一钟点的平均温度高多少,以及该小时的出行次数比该月同一钟点的平均次数高多少。只保留无降水的工作日小时,周末另有形态,不进入这个相关。相对增量写成(该小时次数 − 该钟点月均次数)/ 该钟点月均次数,温度增量是该小时温度减去该钟点的月均温度。线性关系是:相对增量 = β × 温度增量(°C)。表1列出的是100×β,也就是温度比月均高1°C时,出行次数相对月均变化的百分比。区间是β的95%自助法区间,刻度与表中的百分数一致。
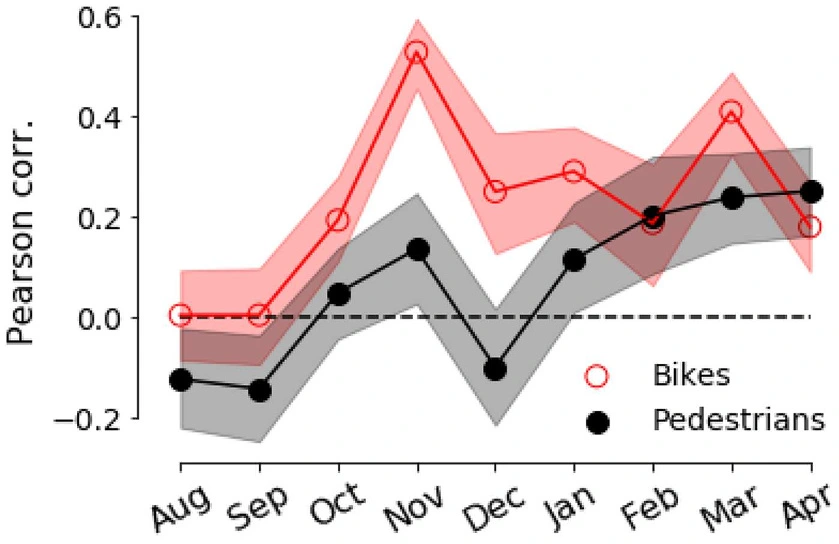
图 10|比当月同钟点更暖时,出行率向哪边动?
无字母子图。横轴月份,纵轴是“出行相对月均的增量”和“温度相对月均的增量”之间的Pearson相关。红圈为共享单车,黑点为步行,色带是95%自助法区间,虚线为0。夏天步行相关为负,共享单车的区间跨过0;秋末到春初共享单车为正。图上没有逐月标出相关系数,百分比斜率以表1为准。来源:原论文 Fig. 10。
| 月份 | 共享单车,每高1°C | 95%区间 | 步行,每高1°C | 95%区间 |
|---|---|---|---|---|
| 8月 | 0.0% | (−0.8, 0.9) | −1.5% | (−2.7, −0.3) |
| 9月 | 0.0% | (−0.5, 0.5) | −1.0% | (−1.7, −0.3) |
| 10月 | 1.3% | (0.7, 1.8) | 0.4% | (−0.4, 1.2) |
| 11月 | 3.8% | (3.1, 4.4) | 0.8% | (0.2, 1.5) |
| 12月 | 2.7% | (1.4, 3.9) | −1.0% | (−2.2, 0.2) |
| 1月 | 3.1% | (1.9, 4.5) | 1.2% | (0.1, 2.2) |
| 2月 | 2.1% | (0.7, 3.4) | 1.9% | (0.8, 2.9) |
| 3月 | 3.1% | (2.5, 3.8) | 1.5% | (0.9, 2.1) |
| 4月 | 3.2% | (1.6, 4.7) | 2.3% | (1.5, 3.1) |
区间含0的月份,不能说成“温度一高,出行就增加”。共享单车在8月和9月的区间含0;10月到4月为正,11月最大,1°C对应3.8%(区间3.1%到4.4%)。作者举例:11月若比月均高10°C,线性外推大约多38%的共享单车出行。那是同一条直线乘出来的,不是另一次只比较“相差10度的日子”的观测。步行在8月、9月为负,区间不含0;10月和12月的区间含0;11月、1月至4月为正,幅度多小于同期的共享单车。12月步行的点估计是−1.0%,区间跨过0。
这些差别能用到哪一步
作者把天气敏感,尤其是骑车,看成非机动出行在冬季的硬约束,并估计Boston若只靠宜骑的月份,收益大约只覆盖一年中的8个月。他们推测人行道比自行车道更完整,所以步行没那么怕雨和温度;骑车的人在雨、雪和结冰时更觉得不安全。这是讨论中的机制假设。文中没有测量每条街的自行车道质量,也没有把基础设施评分放进回归。
共享单车只是城市自行车出行的一部分。自有自行车可能不出桩站、路线也不同。步行样本不代表全体行人,也无法确认用户是否为每次步行都打开了应用;两端各抹去最多100米后,短距离的起终点更粗。两种数据都没有个人社会经济属性,共享单车甚至没有用户编号,因此做不到同一个人在步行和骑车之间的对照。
网络指标也停在流网上。PageRank、基尼系数、同配和互惠性描述的是格子之间的出行次数,不是街道几何,也不是某人当天的全部活动链。相关和匹配后的差异都还不是“下雨导致某人放弃骑车”的随机实验;风、日照、节假日和“雪与毛毛雨被合成一类”都还留在这46%里面。
一句话总结
在2014年8月到2015年5月的大波士顿记录里,步行和共享单车按距离、午饭是否再起一峰、早晚方向是否对调、以及降水小时里出行率下降的幅度分开,合在一起才覆盖从街区到数公里的非机动出行。
核心来源
- Journal of Transport Geography 正式页,DOI:10.1016/j.jtrangeo.2019.102501。题目、作者、卷期和在线日期以该页及PDF首页为准。正文图1至图10和表1都出自这一版。
- 步行数据为活动记录类手机应用中的匿名轨迹;共享单车为Hubway/Bluebikes公开的站点间出行,论文脚注给出系统数据页。降水为weather.com逐小时记录。全美2英里、3英里的小汽车比例来自文中引用的USDOT 2017家户出行调查,不是本样本的实地计数。
作者介绍
五位作者的单位以论文署名和致谢为准。
- Christian Bongiorno:署名为MIT Senseable City Lab与意大利都灵理工大学(Politecnico di Torino)。
- Daniele Santucci:署名为MIT Senseable City Lab与德国慕尼黑工业大学(Technical University of Munich)。
- Fabio Kon:通讯作者。论文署名为MIT Senseable City Lab与巴西圣保罗大学;致谢写明他是圣保罗大学教授,以富布赖特访问教授身份在该实验室参与研究。通讯地址为Cambridge,麻省理工学院。
- Paolo Santi:署名为MIT Senseable City Lab与意大利国家研究委员会的IIT(IIT, CNR)。
- Carlo Ratti:署名为MIT Senseable City Lab。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若步行的午饭峰留在商业区内部,而共享单车的2至5公里箭头负责市镇之间的早晚对调,街道路权就可以按距离拆开,而不是只设一条“鼓励非机动”的总预算。几百米的格子里,连续的人行道和过街更对着图5左侧;跨河、跨市镇的专用骑行空间更对着右侧。只加长自行车道,补不上中午那截步行;只加宽人行道,也替代不了中位数2.2公里的站点间路程。
另一个可以单独检验的问题是:46%里有多少来自“骑行本身”,有多少来自“还要走到桩站”。论文已经把走到桩站、开锁算进共享单车的固定成本。自有自行车若停在家门口,降水小时的下降幅度可能小于这套桩站系统。把私人自行车轨迹按同样的气温分箱再匹配一次,才能看出46%是骑车这件事的天气弹性,还是公共租车这套手续的天气弹性。