家校之间的路,和商场门口的停留,能不能用同一种人群数据来回答?
论文名片|Yuren Zhou、Billy Pik Lik Lau、Chau Yuen、Bige Tunçer、Erik Wilhelm,Understanding Urban Human Mobility through Crowdsensed Data,IEEE Communications Magazine,2018,56(11):52–59。本文依据 arXiv:1805.00628v2(2019年5月24日);该文件首页写明发表于上述期刊期次。arXiv:1805.00628。首页与参考文献之后没有印出 DOI。这是一篇综述兼教程,后半部分用新加坡的两个观察性案例演示整条流程。
学生背上一个能连续工作一周的小盒子,盒子每隔一会儿扫一次周围的 WiFi 热点。商场连廊的门口没有人发问卷,树莓派却听得见手机在寻找无线网络。两种记录都来自人们随身的设备,群智感知(crowdsensing,从人们携带的设备收集数据)因此比普查和固定交通传感器更密、更广、也更能跟着时间变。它们能回答的问题却不一样:前者要跟上一个人在全城的停留和乘车,后者只守在楼与楼之间的门口。
这篇杂志论文把常见数据收成七类,把城市里的人类移动性(human mobility,人在空间中的移动)收成六个问题,并用一张对照表标明哪些搭配有人做过、哪些搭配作者认为不合适。随后的两个案例都用 WiFi,尺度不同。城市案例只靠周围 WiFi 热点记录,在 2015 年的学生行程里看到:家校距离标在 1.67 公里时,步行占该距离行程的 55.8%;标到 5 公里及更远的五档时,图上的步行份额是 0%,地铁份额从 16.9% 升到 18.33 公里处的 61.9%。建筑案例用手机发出的 WiFi 探测请求,把同一扇门进出的长时间停留,和穿楼而过的短停留分开。
先说结论
- 七类群智感知数据和六个移动问题不能随意搭配。表 I 用示例研究填上做得通的格子,用短横线或空白标出作者认为不合适的搭配。表里的样本量分属设备、人、行程、刷卡和场所,不能横比谁的数据更大。
- 蜂窝记录覆盖广、空间粗;GPS 定位通常更细,收集却费人、费电。周围 WiFi 扫描的能耗,论文转述为大约是一次 GPS 定位的 15%,依据是 Lin 等人 2010 年的测量,不是本文设备自己测的。
- 新加坡国家科学实验在 2015 与 2016 年有 90,991 名中小学生参与者,来自全城 100 所以上学校。移动分析只用周围 WiFi。逐点交通方式识别准确率是 81%,分母没有写成测试集里有多少个点。
- 图 2 用的是 2015 年数据。每一柱四种方式之和为 100%,分母是该家校距离上的单趟行程。小汽车在六个标出的距离上都在 11.2% 到 14.7% 之间。图上没有各距离的行程数,也没有学生是否选择最近学校的比例。
- 建筑群案例把去重后的设备当作行人。2016年11月21日至27日,商场 A、办公楼 F 和最远端的 G 用同一 0–4000 台设备的纵轴比较。2017年1月5日傍晚,A 与 B 之间两个方向占该傍晚连廊流量的 15.12% 和 16.48%;这两个百分数不能换成早晨的绝对人数。
数据能看见一座城,还是只能看见一扇门?
早期移动研究多用普查,样本和覆盖都有限。手机普及之后,研究转成由数据驱动,也可以按数据类型和移动主题来归类。本文把主题按尺度分成两类。城市尺度看人怎样在全市范围出行;建筑尺度看人怎样在邻近建筑之间,或在一座大型建筑里移动。综述只收四类最常见的城市主题和两类建筑主题。
城市主题是:S.1 距离与时长的分布,S.2 起讫点矩阵(origin–destination matrix,地点之间的人数或平均行程时间),S.3 基于活动的个人移动模式,S.4 个人交通方式识别。建筑主题是:S.5 一栋建筑内的密度与流动,S.6 一群建筑之间的密度与流动。
七类数据按收集方式划分。蜂窝业务记录(cellular service records,CSR)来自电信公司记下的手机活动,带有时间和所连基站。周围 WiFi 热点记录(surrounding WiFi AP records,SWFAPR)由随身设备扫描附近热点,热点有唯一 MAC 地址。GPS 定位(GPS locations)由额外设备或手机应用采集。带地理标签的社交媒体(geotagged social media,GTSM)如带位置的推文,或 Foursquare 场所一侧的签到统计。公共交通智能卡记录(public transport smart card records,PTSCR)来自公交和地铁的自动收费。蓝牙探测记录(Bluetooth detection records,BDR)和 WiFi 探测请求记录(WiFi probe request records,WFPRR)都是在现场被动收听设备发出的信号。
表 I 的左右两侧都是数据类型,中间六列是六个主题。左侧五行对应城市尺度更常用的五类数据;右侧把建筑尺度常用的蓝牙和探测请求换了上来。同一行左右标签并不总是同一种数据:第三行左边是 GPS,右边是蓝牙;第四行左边是社交媒体,右边是 WiFi 探测请求;第五行只有智能卡,右边为空白。空格里的短横线,以及建筑侧的空白,表示作者认为这一对组合不合适。格子里的人名、年份和数量,是一篇示例研究,加上后文定义的分析方法编号 M.1–M.7。
城市尺度的示例样本量如下。单位跟在数字后面,分母是该示例研究自己的计数对象。
| 数据 | S.1 距离与时长 | S.2 起讫矩阵 | S.3 活动模式 | S.4 交通方式 |
|---|---|---|---|---|
| 蜂窝记录 | Kung 等,2014,1,600 万台设备 | Iqbal 等,2014,690 万台设备 | Jiang 等,2016,320 万台设备 | Wang 等,2010,100 万台设备 |
| 周围 WiFi | — | — | Sapiezynski 等,2015,130 名参与者 | Shin 等,2015,30 名用户 |
| GPS | Alessandretti 等,2017,851 名学生 | Ge 等,2016,18 万名个体 | Vazquez-Prokopec 等,2013,582 名参与者 | Ghorpade 等,2015,10 名志愿者 |
| 地理标签社交媒体 | Jurdak 等,2015,Twitter 156,607 名用户 | Yang 等,2013,Foursquare 16,021 个场所 | Hasan 等,2013,Twitter 39,040 名用户 | — |
| 公交智能卡 | Liang 等,2013,667,584 趟行程 | Munizaga 等,2012,7,400 万次刷卡 | Zhang 等,2015,2,203 万趟行程 | — |
建筑尺度的示例是另一组标签:
| 数据 | S.5 单栋建筑 | S.6 建筑群 |
|---|---|---|
| 蜂窝记录 | Zhong 等,2016,1,800 万台设备 | — |
| 周围 WiFi | Biczok 等,2014,2 万台设备 | 同一示例,2 万台设备 |
| 蓝牙探测 | Yoshimura 等,2014,7 个传感器、24,452 台设备 | Yoshimura 等,2017,5 个传感器、400 万台设备 |
| WiFi 探测请求 | Schauer 等,2014,2 个热点、9,995 台设备 | Prentow 等,2015,798 个热点、18,000 台设备 |
正文对量级的概括,和表中个例并不重合。正文说 GPS 数据集是数百到数千这一量级;表 I 的 GPS 起讫矩阵示例是 18 万名个体。正文说社交媒体是数千这一量级;表中的 Twitter 示例是 156,607 名用户和 39,040 名用户。读表时要看单位:2 万台设备可以是被动听到的手机,130 名参与者才是被招募来背设备的人。
正文 S.2 末句写:就 WFPRR 的性质而言,它只适合构建公交站与地铁站之间的矩阵。表 I 里,公交与地铁起讫矩阵的示例放在智能卡一行(7,400 万次刷卡);WFPRR 只出现在 S.5 和 S.6。匹配关系以表 I 的空格和示例为准。那一句不能单独当成探测请求能够做城市公交矩阵的证据。
同样问人怎么移动,七种记录各自漏掉什么?
蜂窝记录受益于手机保有率,地理和人群覆盖大,数据量按正文的说法可达数百万这一量级,采集成本也低。表 I 的蜂窝示例从 100 万到 1,800 万台设备。城区基站间距从 50 米到数公里,这句话来自 Jiang 等人的新加坡手机研究,引用号 [4]。从全市看,蜂窝记录的空间粒度仍是数百米到数千米,时间上不连续,还会因为基站切换而跳动。表 I 认为它可以做 S.1 到 S.5,做不到建筑群 S.6。
周围 WiFi 的热点比基站密。论文转述商业定位的通常精度在 100 米以内,GPS 通常在 20 米以内,两句都来自 Lin 等人 2010 年,引用号 [5]。同文还比较能耗:一次 WiFi 扫描大约消耗一次 GPS 定位的 15% 能量;相对周围 WiFi,GPS 追踪大约多耗七倍能量。这是文献中的能耗比较。收集周围 WiFi 仍要额外设备或专门的手机应用,所以参与规模受限。表 I 的城市示例是 130 名参与者和 30 名用户;建筑示例的 2 万是检测到的设备。表 I 认为周围 WiFi 可做 S.3 到 S.6,距离分布和起讫矩阵两格是短横线。
GPS 定位最细,同样要额外设备和招募,人群多样性低于蜂窝记录。表 I 认为它覆盖 S.1 到 S.4。社交媒体容易获取,还能从文字里看到地点含义,但时间断续、空间有空洞,而且地理标签由用户自己加。正文指出,社交媒体受心情、想法和外部激励影响;数据集里缺少相应信息时,这种人为噪声很难处理。智能卡体量很大,表中有 7,400 万次刷卡和 2,203 万趟行程,地理上却稀疏,而且只覆盖乘坐公交和地铁的人。
蓝牙在手机上的典型范围约 10 米,WiFi 约 35 到 100 米,两句来自 Schauer 等人,引用号 [6]。两者都要在现场安装接收器,主要对应 S.5 和 S.6。蓝牙的第二项限制是:只有一小部分手机会开着蓝牙。同文认为人们打开 WiFi 的可能性高于蓝牙,所以探测请求能感应到更多不同设备。这个比较是引用,不是后文商场案例里实测的开启率。
六个主题因此要挑数据。S.1 想拟合出行距离、时长一类属性的概率分布,例如列维行走(Lévy walks)。蜂窝结果更接近总体,但属性基本上是从起点跳到终点的位移。GPS 可以更细,也方便挑选样本群体。社交媒体更适合回访某地的概率,若没有个人信息,覆盖的人群很难讲清。智能卡只看到公共交通行程。
S.2 的矩阵可以是人数,也可以是平均行程时间。蜂窝覆盖广,基站却很难对到想要的交通节点。GPS 节点更准,样本和人力是限制。社交媒体因为随机和大段空间空白,常被用来连接大片城区,而不是具体路口。智能卡自然落在公交站和地铁站上。
S.3 关心人去了什么地方,例如识别家、工作和购物,或预测下一次到访。蜂窝容易拿到,时空空洞却让活动难以抽出。周围 WiFi 和 GPS 更适合细任务,收集则费人力。社交媒体靠文字更容易抽出活动,样本偏差要单独看。智能卡即使能用,也限于识别家和工作地这类较简单的任务。
S.4 要识别步行、驾车、乘公交等方式,因此需要连续轨迹。表 I 里只有蜂窝、周围 WiFi 和 GPS 进入这一列。蜂窝只能训练较简单的算法,区分步行和乘车。GPS 能把骑车、跑步、乘公交再分开。周围 WiFi 的精度和时间连续性居中,算法更难训,电耗低于 GPS。
S.5 和 S.6 看建筑内部或邻近建筑之间的密度与流向。蜂窝不必加装传感器,但要有足够基站和数据权限。周围 WiFi 更细,却难扩大招募。蓝牙和探测请求要安装设备,布点灵活,收集可以扩展。S.6 的利弊与 S.5 相同。
预处理把噪声分成系统噪声和人为噪声。系统噪声来自采集系统本身,主要出现在蜂窝、周围 WiFi、GPS、蓝牙和探测请求里,通常用过滤和插值处理。人为噪声主要在社交媒体。
七类分析方法是:M.1 可视化,包括地图散点、柱状图或直方图、热力图;M.2 统计,包括汇总指标、拟合分布和显著性检验;M.3 启发式规则,也就是按生活经验设阈值;M.4 图论,用来连接停留点或到访地点;M.5 优化,用来拟合分布或把行程对到起讫点;M.6 聚类,用来找停留点、给人分组,或给基站和传感器分组;M.7 分类,用来识别地点类别、人群画像和交通方式。正文举的一个启发式例子来自他人的呼叫详单研究:距离阈值 300 米、时间阈值 10 分钟。这是 [4] 的设定,不是后文学生案例的阈值。
只扫周围的 WiFi,怎样标出学生的交通方式?
城市案例是新加坡国家科学实验(National Science Experiment,NSE)。参与者来自小学、中学和高中(primary, secondary and high schools)。为了少打扰日常,作者设计了传感设备 SENSg,可以连续工作一周而不充电。2015 与 2016 年,全城 100 所以上学校共有 90,991 名参与者。引言里的大约 9 万人,指的是同一次收集的约数。
设备同时采集周围 WiFi、惯性测量和环境数据。后两类留给其他研究。这里的移动模式只来自周围 WiFi。作者用它回应既有 WiFi 研究的两个常见弱点:收集规模小到做不出全市结论,以及结果还要依赖别的数据类型。
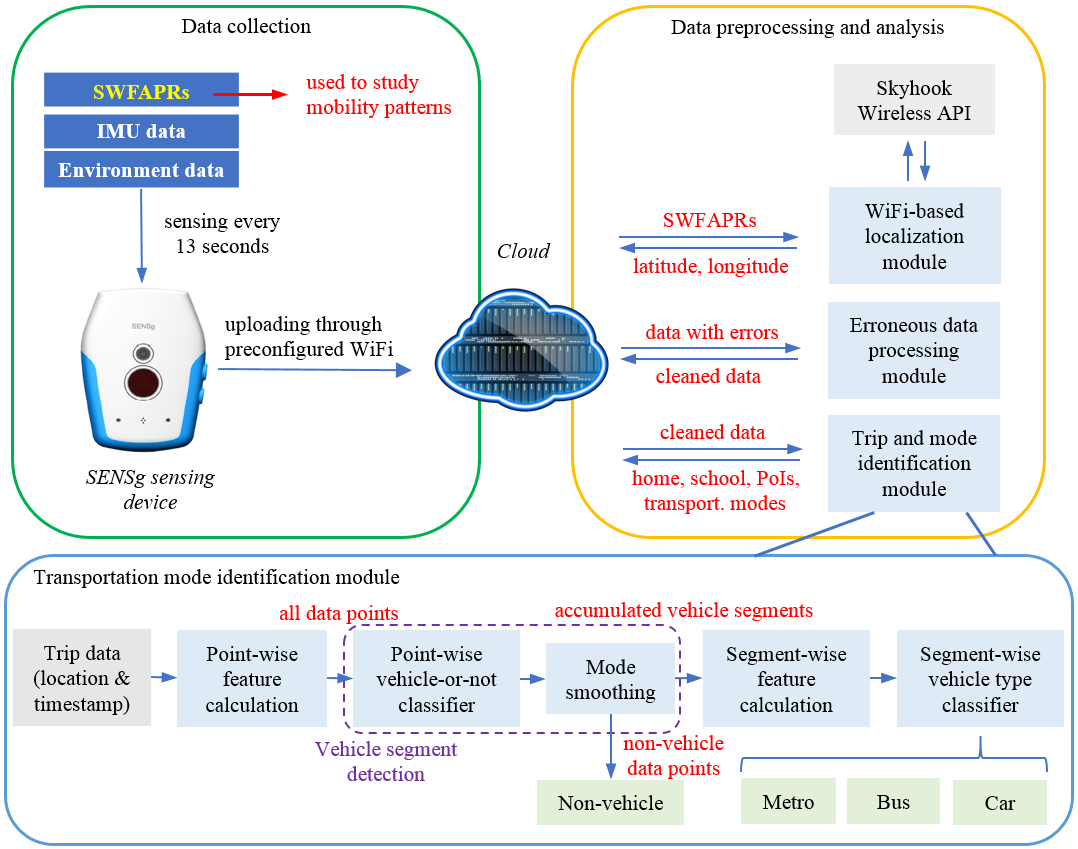
图 1|学生身上的 WiFi 扫描,怎样变成家、学校和四种交通方式?
图中没有子图字母。左上绿色部分是采集:SENSg 每 13 秒扫描一次,经预先配置的 WiFi 上传到云端;红色箭头标明,移动模式只用周围 WiFi,惯性测量和环境数据不进入这条分析。右上黄色部分是预处理:调用 Skyhook Wireless 的接口,把热点扫描变成经纬度,再去掉传感器数值异常的点,其中包括异常位置。下方蓝色部分是分层识别。兴趣地点内的点直接标为非机动车。行程上的点先用移动平均速度和加速度做逐点的乘车与否分类,平滑后累积成车辆段,再用段特征区分地铁、公交和小汽车。来源:原论文 Fig. 1。
标签不是学生手填的。作者认为让年幼学生提供高质量标签不现实,于是自己标注。同一对起讫点若换成不同交通方式,地理轨迹、距离和时长都会变。他们把采集到的行程与 Google Maps Directions 接口给出的各条可能路线比较,找到一条很像的路线,再把该路线已知的交通方式赋给这次行程。正文写的是常常可以找到很像的路线,没有给出匹配成功的行程比例。因此后面的 81%,衡量的是分类结果与这套路线匹配标签的一致程度。
分析分四步。先从清洗后的位置算速度:速度低于一个预先设定的阈值,并持续一段时间,就记为一次停留,停留点的位置取这些点的平均。阈值的具体速度和时长,正文没有写出。兴趣地点(places of interest,PoI)比停留点更大,因为人在大型建筑里仍会走动。停留点用 DBSCAN 聚类得到兴趣地点;聚类参数没有写出。按时间顺序,相邻两个兴趣地点之间的点组成一趟行程。
家和学校从兴趣地点的起止时间来认。时间跨度过夜且很长,该地点标为家。时间与预先设定的上学时段大面积重叠,该地点标为学校。上学时段的钟点没有写出。
交通方式分成四类:非机动车、地铁、公交、小汽车。非机动车在结果里按步行理解,因为作者认为自行车不是新加坡常见的通勤工具。图 2 的 Walk 就是这一类,不是把步行和骑车分开识别之后的份额。兴趣地点内的点标为非机动车。行程上的点走图 1 的分层模块。乘车与否用两个逐点特征:移动平均速度和加速度。车辆类型用 16 个段特征,最重要的三个是段内速度的第 85 百分位数、段内速度的平均值,以及这段乘车开始前的等待时间。试过多种分类器之后,乘车与否采用自适应提升(Adaptive Boosting),车辆类型采用随机森林。最终逐点交通方式识别准确率是 81%。正文没有给出测试点的数量、各类别的召回率,也没有给出一个对照分类器的准确率。
家校距离一拉长,步行让给了谁?
更深的描述用 2015 年数据画成图 2。参与者总数 90,991 覆盖 2015 与 2016 两年,图 2 没有说明 2015 年占其中多少人、多少趟行程。
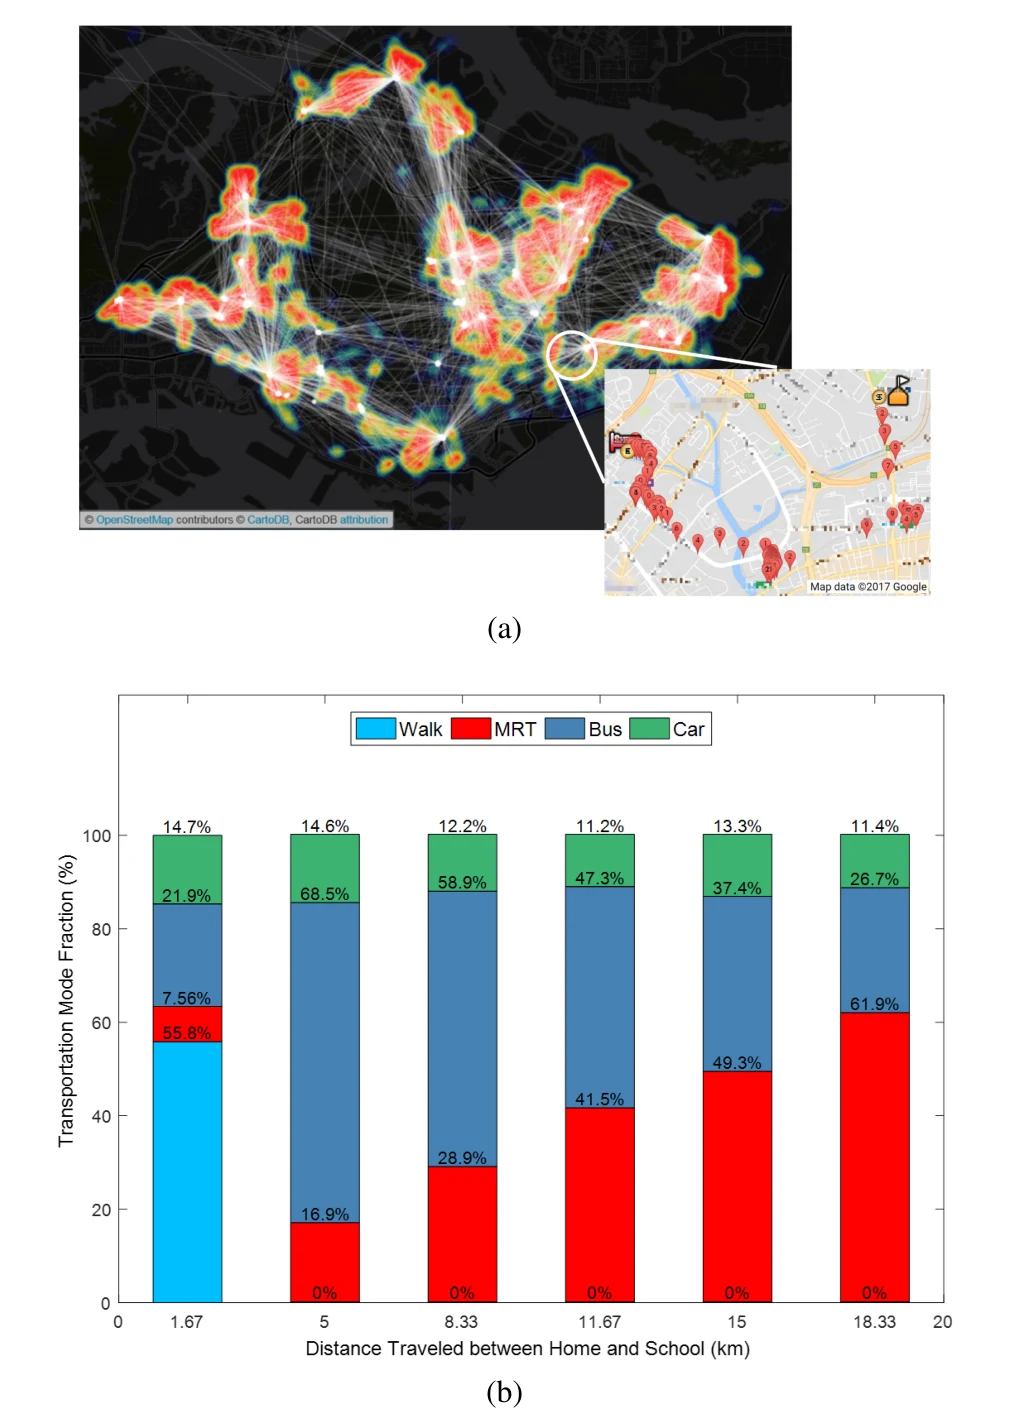
图 2|家离学校更远之后,学生的行程从步行换成了哪种车?
(a)深色底图上的亮斑是学生家庭的热力,白点是学校,白线连接家与学校;圆圈放大的是一条示例行程,红点沿街道排列。图中没有家校连线的条数,也没有最近学校被跨过的比例。(b)横轴是家与学校之间的出行距离,标出的位置为 1.67、5、8.33、11.67、15 和 18.33 公里,轴画到 20 公里。纵轴是交通方式份额,每柱四种颜色之和为 100%。青色为步行,红色为地铁 MRT,蓝色为公交,绿色为小汽车。计数单位是第二步分析里抓到的单趟行程。各距离的行程数和区间端点都没有标出,所以 55.8% 的分母是 1.67 公里这一柱里的行程,不是全部学生,也不是全部行程。来源:原论文 Fig. 2。
图 2(b)各柱印出的份额是:
| 标出的家校距离 | 步行 | 地铁 | 公交 | 小汽车 |
|---|---|---|---|---|
| 1.67 公里 | 55.8% | 7.56% | 21.9% | 14.7% |
| 5 公里 | 0% | 16.9% | 68.5% | 14.6% |
| 8.33 公里 | 0% | 28.9% | 58.9% | 12.2% |
| 11.67 公里 | 0% | 41.5% | 47.3% | 11.2% |
| 15 公里 | 0% | 49.3% | 37.4% | 13.3% |
| 18.33 公里 | 0% | 61.9% | 26.7% | 11.4% |
1.67 公里这一柱,步行是四种方式里最高的,55.8%。5 公里这一柱,公交升到 68.5%,步行印为 0%。此后公交逐柱下降,到 18.33 公里为 26.7%;地铁从 5 公里的 16.9% 升到 18.33 公里的 61.9%。小汽车六柱都在 11.2% 到 14.7% 之间,最低出现在 11.67 公里,最高出现在 1.67 公里。1.67 公里柱的四个印出数字相加为 99.96%,其余五柱相加为 100%,差额在四舍五入的显示范围内。
正文据此概括四件事:家校很近时,多数学生选择步行而不是乘车;距离不适合步行、又还不算太长时,公交更常见;家校距离继续增加,乘地铁的行程多于乘公交;小汽车份额在不同家校距离上相对稳定。这些句子的比较对象,是同一距离柱内部的方式份额。
(a)里家与学校之间的连线大量交叉。正文的解读是:许多学生去的学校并不是离家最近的那所,地理接近不是择校的主导因素。这是对热力图的目视解读。图上没有最近学校的基线比例,也没有把学额、入学规则和居住选择分开。交叉连线说明家校配对在地图上经常跨过更近的学校,不能单独证明家庭在择校时看轻距离。
人不填问卷,门口的路由器看见了什么?
建筑案例改用被动的 WiFi 探测请求。手机为了发现热点,会向外发出探测请求;请求里带有设备 MAC 地址,因此可以串起同一台设备的路径。作者强调收集过程不干扰行人。研究区域是一个繁忙的公共片区,包含商场、办公楼和一个交通枢纽,正文没有写出地名。七栋建筑 A–G 由二楼有顶连廊相连。每栋建筑在连廊系统中的入口部署多台网关,网关用树莓派,以覆盖经过的行人。
网关为每条探测请求补上进入时间、离开时间、信号强度和 MAC 地址,上传到云端。预处理把同一栋建筑里的网关按或关系合并,并去掉同一栋建筑、同一时间窗内重复的 MAC。之后把相同 MAC 的记录连起来,得到行人路径。纵轴和箭头上的行人,操作定义是这样去重之后的设备。一个人多台设备、或关闭 WiFi 的手机,不会在这套计数里被校正;本片区的 WiFi 开启比例也没有测量。
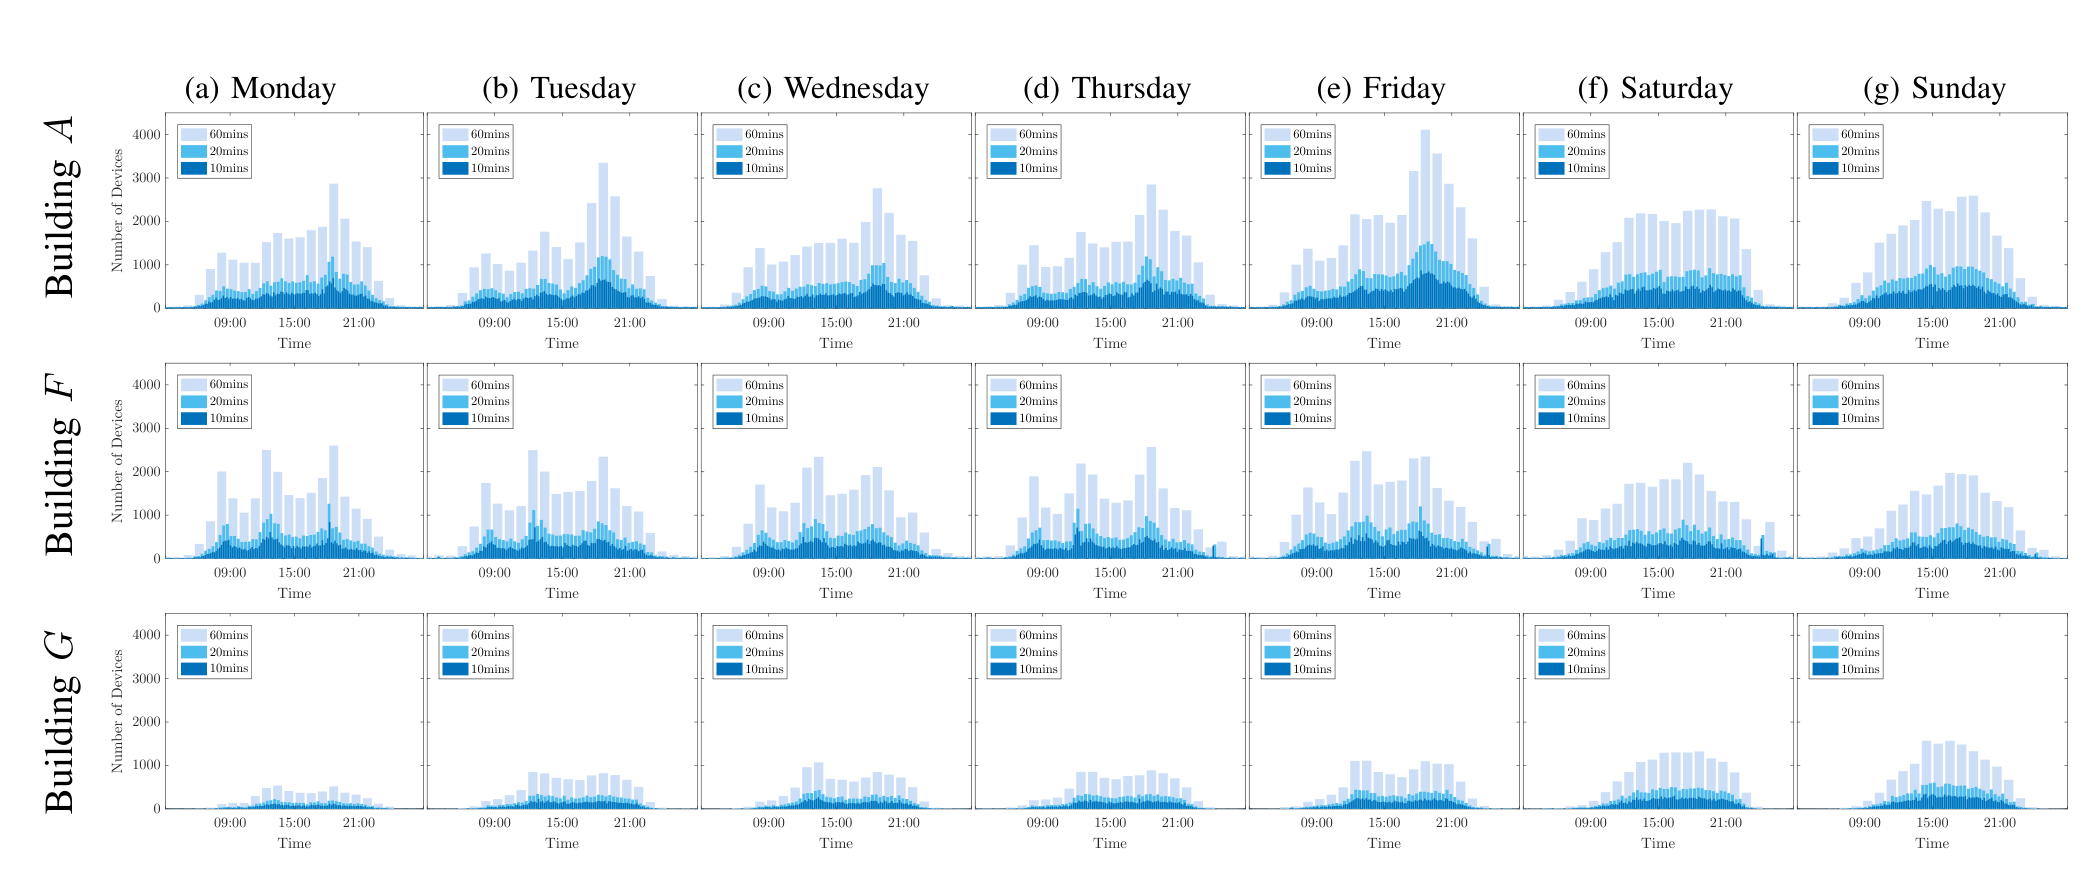
图 3|一周里,三栋楼的门口各自在什么时候最忙?
三行分别是建筑 A、F、G,纵轴都是设备数,刻度从 0 到 4000,因此行与行可以在同一刻度上比较高低。横轴是时刻,标出 09:00、15:00 和 21:00。图例中最浅色是停留 60 分钟,中间色是 20 分钟,最深色是 10 分钟,柱子按这三档叠放。日期是 2016年11月21日周一至 27 日周日。(a)周一、(b)周二、(c)周三、(d)周四的 A 行在夜间升高,F 行白天有多处尖峰,G 行整体矮一截。(e)周五的 A 行夜间高于同周其他几天,这是正文所说的一周高峰;柱顶没有印出精确设备数。(f)周六和(g)周日没有工作日那种整齐的上下班尖峰,A 行全天仍有一截浅色长停留。来源:原论文 Fig. 3。
正文对三栋楼的功能解释与图形对应。A 是商场,又靠近交通枢纽,工作日的日内高峰在夜间,一周高峰在周五夜间;作者把它解释为通勤者下班后用餐或购物。F 是有人上班的功能性建筑,一天三个峰对应到达、午休和下班离开。G 检测到的设备更少,因为它离交通枢纽最远,又位于连廊系统末端,经连廊到达的人更少。功能是作者给出的解释。图本身显示的是入口处去重设备的时间分布,不包含问卷调查到的活动目的。
连廊上的份额,早晨和傍晚各以哪一段为重?
下一张图把问题从单栋入口收成连廊上的方向。它只覆盖 2017年1月5日这一个周四。早晨是 05:00 至 10:00,傍晚是 17:00 至 22:00。每个箭头旁的百分数,是该方向占连廊系统在该时段流量中的份额。早晨的分母是早晨的连廊流量,傍晚的分母是傍晚的连廊流量。两个时段的总设备数都没有给出,所以傍晚某个百分数更高,不能换成绝对人数更多。
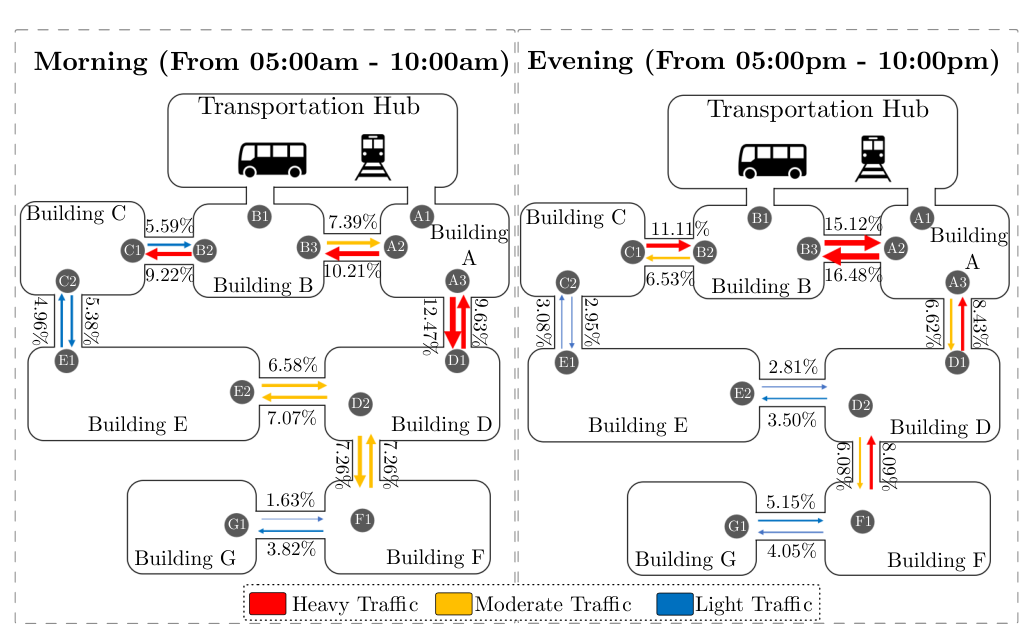
图 4|同一个周四,连廊上的重流量从哪几栋楼之间经过?
左图是早晨 05:00–10:00,右图是傍晚 17:00–22:00。建筑 A–G 由连廊相连,上方是带公交和火车图标的交通枢纽。红色为重流量,黄色为中等流量,蓝色为轻流量;图例没有给出三类的人数阈值。箭头上的百分数是该方向占本时段连廊系统流量的份额。来源:原论文 Fig. 4。
早晨 14 个箭头的印出份额是:C 内部两个方向 4.96% 与 5.38%,B 与 C 之间 5.59% 与 9.22%,A 与 B 之间 7.39% 与 10.21%,A 与 D 之间 12.47% 与 9.63%,D 与 E 之间 6.58% 与 7.07%,D 与 F 之间两个方向都是 7.26%,F 与 G 之间 1.63% 与 3.82%。这 14 个数相加为 98.47%,不是 100%。正文没有解释少掉的 1.53 个百分点。
傍晚 14 个箭头是:C 内部 3.08% 与 2.95%,B 与 C 之间 11.11% 与 6.53%,A 与 B 之间 15.12% 与 16.48%,A 与 D 之间 6.62% 与 8.43%,D 与 E 之间 2.81% 与 3.50%,D 与 F 之间 6.08% 与 8.09%,F 与 G 之间 5.15% 与 4.05%。这 14 个数相加为 100%。
把成对方向加起来,仍然只在各自时段内部比较。早晨 A 与 D 两个方向合计占早晨连廊流量的 22.10%,A 与 B 合计占 17.60%,D 与 E 合计占 13.65%,F 与 G 合计占 5.45%。傍晚 A 与 B 合计升到该傍晚流量的 31.60%,B 与 C 合计为 17.64%,D 与 E 合计降到 6.31%,F 与 G 合计为 9.20%。F 与 G 的傍晚份额高于早晨份额,只说明它在傍晚流量里占的比例更高。
正文的读法是:早晨更多人向下走,也就是从 A、B 去其他建筑;傍晚方向反过来。这被解释为人群从交通枢纽进入各建筑,例如去上班。与早晨相比,C、D、E 之间的移动在傍晚较不活跃,A、B、C 之间在傍晚更活跃。作者用功能来解释:D 和 E 是普通功能性建筑,工作时间人更多;A、B、C 是商场,下班后人更多。颜色和份额支持 A、B 段在傍晚成为重流量,D、E 段在傍晚变成轻流量。一个周四不能代表一周,份额也不能代替两个时段的总人数。
进了同一扇门再出来,和穿楼而过,停的时间不一样
尺度再收到商场 C。C 有两个入口 C1 和 C2,位置见上一张连廊图。统计日是 2016年11月28日,周一。每根柱子分成停留至少 10 分钟,和不足 10 分钟。
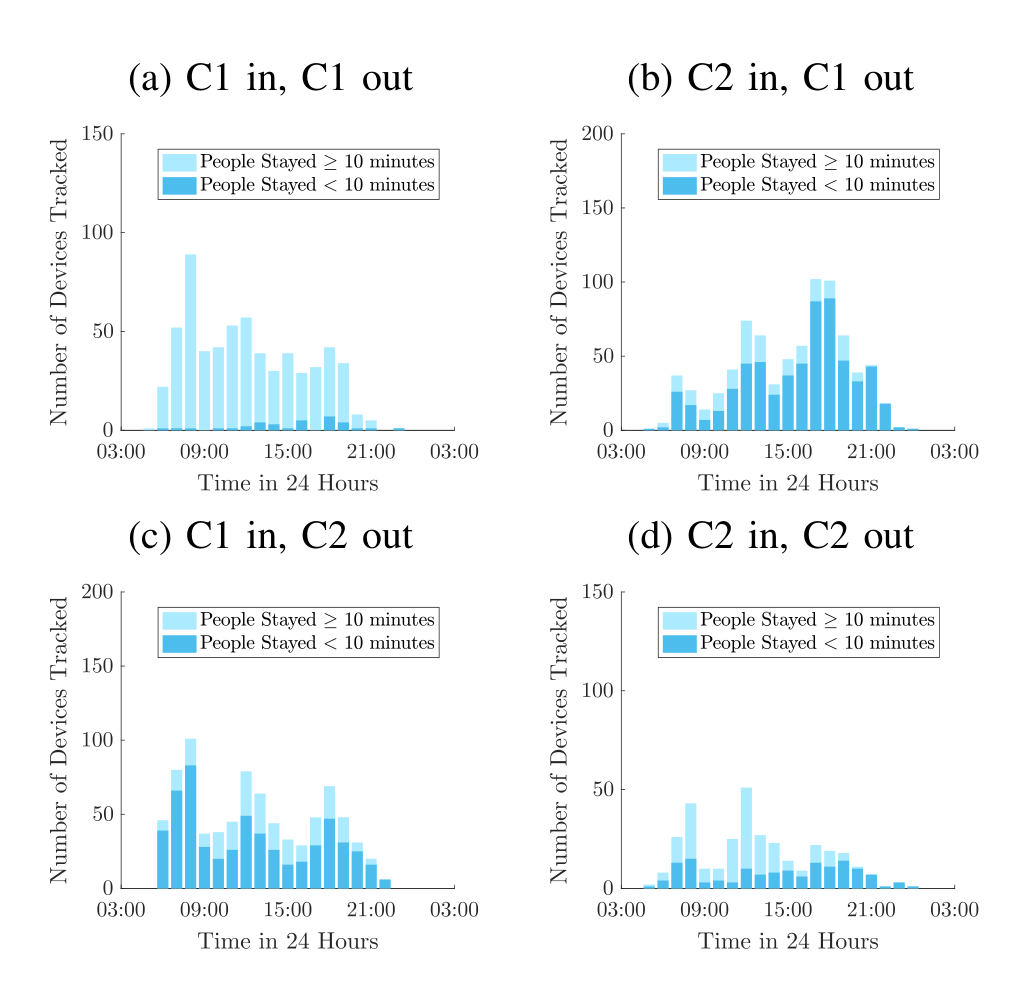
图 5|从 C1 进、从 C2 出的人,在楼里停留超过 10 分钟了吗?
四个面板都是 2016年11月28日的设备数,横轴从 03:00 画到次日 03:00。浅色是停留至少 10 分钟,深色是不足 10 分钟。(a)C1 进、C1 出,纵轴画到 150,浅色占大部分。(b)C2 进、C1 出,纵轴画到 200,下午的深色明显加厚。(c)C1 进、C2 出,纵轴也画到 200,深色在上午和傍晚都占有可见的一段。(d)C2 进、C2 出,纵轴画到 150,白天有几处浅色尖峰,下午混有深色。(b)(c)的 200 与(a)(d)的 150 不是同一刻度,柱高不能直接跨面板比较。各柱没有印出精确设备数。来源:原论文 Fig. 5。
正文的读法与图例一致。从 C1 进入、从 C2 离开,或相反方向,多数停留不超过 10 分钟,作者据此认为行人把 C 当成穿行路线。从同一个入口 C1 进出的人,多数在 C 里停留较长时间。从同一个入口 C2 进出的计数,在上午 9 点、下午 1 点和下午 6 点有三个峰,作者解释为其他建筑的人来 C 用餐。下午从 C2 进入的人,多数目的仍是穿行。9 点、1 点和 6 点是正文指出的峰位,图上没有给这三个时刻的设备数。
这些数字能说到哪里
两个案例都是描述性结果。学生案例的交通方式标签来自与地图路线的相似,81% 是逐点分类和这套标签的一致率。家校连线的交叉没有最近学校的基线比例。交通方式份额的分母是每个标出距离上的行程,距离区间端点和行程数都没有公布,2015 年图也没有对应到 90,991 名参与者中的哪一部分。
建筑案例的行人是去重设备。图 3 是 2016年11月21日至27日这一周的三栋楼,图 4 是 2017年1月5日一个周四的份额,图 5 是 2016年11月28日一个周一的一栋商场。早晨箭头份额相加为 98.47%,傍晚相加为 100%,两个时段的总流量都没有给出。建筑功能是作者对图形的解释。
表 I 是文献匹配,不是这七类数据在一切城市都成立的实验结论。正文里的定位精度、能耗、基站间距和蓝牙范围,分别转述自 [5]、[4] 和 [6]。空格表示作者认为不合适,不表示将来不可能做出该组合。
一句话总结
群智感知数据先要和问题的尺度配对:周围 WiFi 扫描在新加坡学生的 2015 年行程里,把 1.67 公里处 55.8% 的步行份额和更远距离上的地铁上升连在一起;门口听到的探测请求,则把穿楼而过的不足 10 分钟,和同一扇门进出的更长停留分开。
核心来源
Zhou, Y., Lau, B. P. L., Yuen, C., Tunçer, B., & Wilhelm, E. (2018). Understanding Urban Human Mobility through Crowdsensed Data. IEEE Communications Magazine, 56(11), 52–59. 解读依据 arXiv:1805.00628v2,2019年5月24日。图 1–5 与表 I 均来自该文。文末致谢写明,这项工作部分由新加坡总理公署国家研究基金会的国家科学实验项目资助,资助号 RGNRF1402;部分由新加坡国家发展部可持续城市生活计划资助,资助号 SUL2013-5。致谢没有把两个资助号拆开对应到两个案例。
五位作者在论文中的署名单位都是新加坡科技设计大学(Singapore University of Technology and Design),地址为 8 Somapah Road, Singapore 487372。论文以第一人称报告城市尺度的 WiFi 采集和建筑尺度的探测请求分析,五人共同署名。论文没有另列个人职务。
Yuren Zhou 与 Billy Pik Lik Lau 的论文邮箱在 mymail.sutd.edu.sg。Chau Yuen、Bige Tunçer 与 Erik Wilhelm 的论文邮箱在 sutd.edu.sg。可核实的信息就是这一署名单位、邮箱域名,以及上述两项资助。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
图 2 里 5 公里处公交占该距离行程的 68.5%,18.33 公里处地铁占 61.9%。若用来调整校车,还缺每一柱有多少趟行程。55.8% 的步行若只来自很少几趟短途,全城校车的站点就不能按这个份额来排。把 2015 年的份额直接套到 90,991 人的两年样本上,也会把一张图的分母说大。
图 4 傍晚 A 与 B 合计占该傍晚连廊流量的 31.60%。若傍晚的总设备数远小于早晨,这 31.60% 仍可能是较少的人。商场若只按份额把夜班店员集中到 A、B 之间,而不同时看 17:00–22:00 的设备总数,会把结构比例当成客流规模。一个周四也还没有周五夜间那种商场高峰;图 3 已经显示 A 的一周高点在周五夜间。
图 5 能把穿行和停留分开,是因为同一 MAC 能在入口之间被连上。若手机后来对探测请求使用随机 MAC,同一人会被切成许多只出现一次的设备,不足 10 分钟的深色柱会变高,而 C1 同门进出的长停留会变少。2016 年 11 月 28 日的这张图,不能直接当成今天商场门口的停留比例。