同一座城市的四种出行记录,能共用同一套移动模型吗?
论文名片|Wenjun Lyu、Guang Wang、Yu Yang、Desheng Zhang,Mover: Generalizability Verification of Human Mobility Models via Heterogeneous Use Cases,Proc. ACM Interact. Mob. Wearable Ubiquitous Technol.,2021,5(4):Article 171(2021年12月),21页。DOI:10.1145/3494997。本文依据这一正式版本解读。框架在正文中写作 MOVER,取自 MObility VERification;题目本身是 Mover。
深圳同一个人,早上开车经过高速收费站会被记一次,中午刷卡进地铁会被记一次,晚上打一通电话又会在某个基站留下一个点。三种记录都来自人的移动,可地点有多细、隔多久记一次,完全不是一回事。移动模型常在某一种记录上设计并验证,换到另一种采集系统后,误差会不会一起变掉,很少被放在同一套比较里看。
这项工作没有再提出一个新的生成公式。它在深圳一个月的四套城市尺度数据上,用九项群体和个体指标,检查两类理论模型和三类经验模型还准不准。方向性的结果是:看群体流量时,采集的空间越细,随机路点和列维游走这些不靠历史习惯的理论模型相对越站得住;看个人轨迹时,记录越缺少稳定周期,理论模型往往比依赖历史的经验模型更能保持较低误差。这是同一城市、各系统用自己的历史或规则生成轨迹之后的误差比较,不是证明人真的按这些公式走路,也不是把一个系统上训好的参数原封不动拿到另一个系统上零样本测试。
先说结论
- 四套数据的用户数按表1相加超过330万:车辆追踪1万、摄像头系统80万、移动支付130万、蜂窝网络120万。地点从70个高速收费站、118个地铁站到3600多座基站;预处理后的个人日均跳数分别是2.48、2.18、1.56和6.9(后文讨论WHERE时写作6.94)。
- 群体访问次数上,移动支付场景里理论模型的平均绝对百分比误差大约是经验模型的2到13倍。空间更粗的摄像头场景里,理论模型更差。这和“格子越粗、简单理论越好用”的直觉相反。
- 起讫矩阵比只看终点总访问更细。蜂窝网络上,起讫矩阵的误差大约是访问次数误差的7到50倍;摄像头场景的理论模型并不按同样方式放大。
- 车辆GPS改成500米网格时,日访问次数等于2的位置上,73.7%的地点已经落在累积分布内;放到2公里网格,这一比例降到35.5%。网格变粗后,经验模型的访问误差下降,理论模型变差。
- 个人平均跳跃长度上,列维游走在距离指数为3或4时,三个场景都较稳。WHERE只围绕两三个重要地点生成轨迹,而蜂窝用户一天平均要走6.94跳,所以它在蜂窝上明显变差。
四种记录,量的不是同一种“去过哪里”
人类移动性(human mobility)在这里指人在城市空间里的地点移动,不是户口意义上的人口迁移。论文先按两个轴给采集系统分类:横轴是空间粒度,一条记录能把人定到多小的面积上;纵轴是时间连续性,相邻记录隔多少秒。左下角又细又密,右上角又粗又稀。
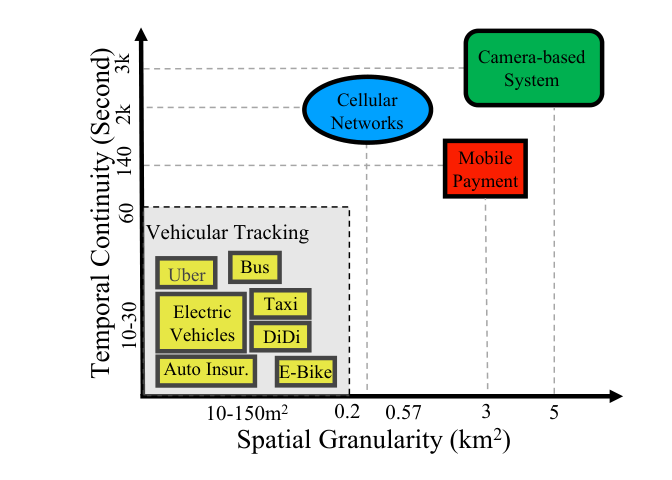
图 1|这四套系统在“多细、多密”上到底差多远?
图中没有子图字母。横轴是空间粒度,单位平方公里;纵轴是时间连续性,单位秒,越往上间隔越长。左下灰色区域是车辆追踪,空间粒度标在10–150平方米,时间间隔约10–30秒,里面放着Uber、公交、电动车、出租车、滴滴、车险和电动自行车。蓝色蜂窝网络大约落在0.2到0.57平方公里、2k秒附近。红色移动支付大约在3平方公里、140秒附近。绿色摄像头系统大约在5平方公里、3k秒附近。虚线只是把这三个系统对到刻度上,不是实测的基站覆盖半径。来源:原论文 Fig. 1。
真正拿来检验的是深圳四套系统,各有一个月数据,由服务提供方和深圳市交通运输委员会收集。车辆追踪用车载GPS,大约每10秒一个点,停传就被当成一次停留。摄像头系统记的是车辆进出高速,全城70个收费站。移动支付系统记的是地铁刷卡进出,118个车站。蜂窝网络只在打电话或发短信、手机连上附近基站时留下记录,涉及3600多座基站。后三者覆盖支付、通信、交通和公共安全这几类城市用途,但一条记录仍然是设备或卡的一次观测,不是这个人当天的全部出行。
| 项目 | 车辆追踪 | 摄像头系统 | 移动支付 | 蜂窝网络 |
|---|---|---|---|---|
| 用户数 | 1万 | 80万 | 130万 | 120万 |
| 每日数据量 | 84.6M | 201M | 550M | 1.44G |
| 每日记录数 | 120万 | 240万 | 400万 | 1400万 |
| 主要字段 | 设备、时间、GPS、速度 | 车牌、时间、起讫收费站和道路 | 车站、时间、闸机、进出 | 卡、时间、GPS、基站 |
用户数、数据量和记录数都来自表1。1.44G是数据体积,不是14.4亿条记录;记录数是最右一行的1400万。用每日记录数除以用户数,车辆大约是120条/人·日,支付约3.1条/人·日,摄像头是3条/人·日,蜂窝约11.7条/人·日。车辆预处理后的日均跳数只有2.48,所以原始GPS点不能当成模型里的一步。
跳(hop)按图2的定义,是一个人一天里连续且地点发生变化的步数:A到B再回到A算2跳,A到A再到B只算1跳。车辆、摄像头、支付、蜂窝的个人日均跳数分别是2.48、2.18、1.56、6.9。
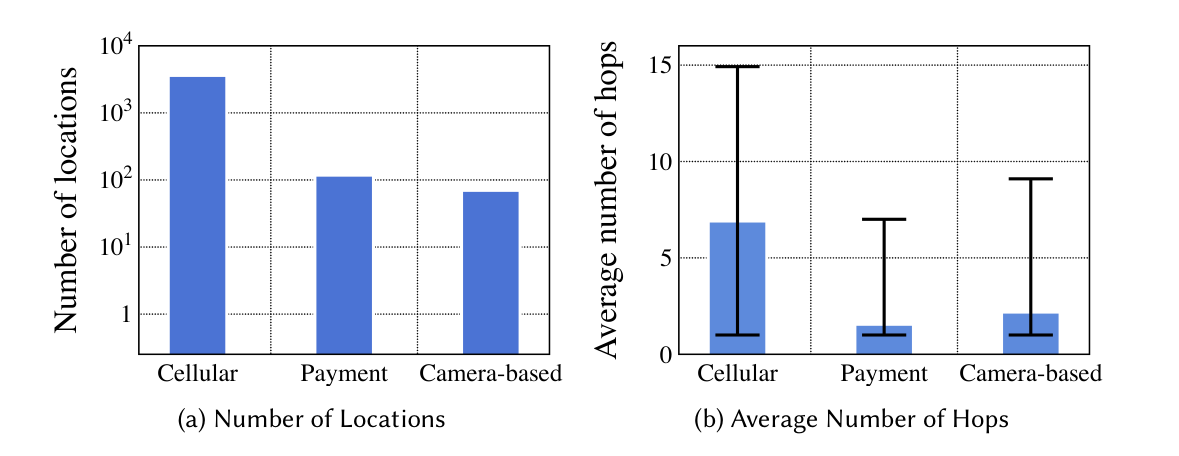
图 2|地点多不多,和一个人一天跳几步,是两回事吗?
(a)纵轴为地点个数,对数坐标。蜂窝的柱落在10³和10⁴之间,与正文“超过3600座基站”一致;支付靠近10²,对应118个地铁站;摄像头略低于10²,对应70个收费站。不要把柱高再读成另一套精确地点数。(b)纵轴是个人日均跳数。三根柱的高低与正文的6.9、1.56、2.18同一方向;蜂窝的误差线很长,上端到达坐标15。正文没有说明误差线是标准差、标准误还是别的范围,后文各图的误差线同样如此。车辆追踪没有画在这张图里。来源:原论文 Fig. 2。
五类模型,各自记住了什么?
理论模型不看这批人过去怎么走。随机路点(Random Way-point)从当前位置在全部地点里等概率抽下一个目的地,到达后停一阵,再抽一次。它没有参数,也不使用历史。列维游走(Levy walk)把距离放进选择概率:
Pᵢⱼ = 1 / (Z ‖dᵢⱼ‖ᵅ)
dᵢⱼ是地点i和j的距离,Z用来把概率加总成1。α越大,远距离越不容易被选中。图里比较了α=1、2、3、4。
经验模型要用历史。WHERE来自通话详单,认为多数人往返于家、工作地等少数重要地点,并用群体历史里的家、距离、工作、通话时间和每人每天通话次数这些分布去生成个人轨迹。WHERE3在此之上再加一个重要地点。通用模型(Universal model)同时用目的地一侧的人口规模和个人历史。表2的形式是:
Pᵢⱼ 正比于 mⱼ / [sⱼᵢ (1 + λ / rankⱼ)]
mⱼ是地点j的人口或吸引力相关量,sⱼᵢ是以j为圆心、半径取i到j距离的圆里已有的访问数,rankⱼ表示j的吸引力排序,λ是调节参数。论文说λ在更发达的地区通常更小,这里试了25、35和50,并没有报告它们是深圳的最优值。Buscope(图中写作 BuScope)优先相信个人历史:若从起点出发的历史支持度高,就去置信度最高的终点;支持度低,才退回从该起点出发的群体流量概率。它原本为公交设计。
需要群体或个人历史的模型,用大约三周做历史,用这个月余下的日子做核对。随机路点和列维游走不吃这段历史。因此后文的“换系统还准不准”,指的是同一种建模办法在另一套采集系统上、用该系统自己的地点和历史重新生成后,误差变不变,不是参数零样本迁移。
正文把模型写成五类,但图里把WHERE3以及α、λ的不同取值拆成不同柱子,所以每个场景通常有十一根柱:Buscope、WHERE、WHERE3、三个λ的通用模型、随机路点,以及四个α的列维游走。引力模型和辐射模型只出现在相关工作里,不在这五类的检验之中。
误差按什么比?
核对分两层。群体层看地点之间的汇总:每个地点的日访问次数、任意两地之间的日出行数(起讫矩阵,origin–destination matrix)、每个地点的日独立用户数,以及地点的不相关熵。个体层看一个人:平均跳跃长度、最大跳跃长度、一天去过的不同地点数、个人不相关熵,以及回转半径。
地点不相关熵表示一个地点的访问在不同人之间有多分散,不算时间顺序:
Eⱼ = − Σᵤ Pⱼ(u) log Pⱼ(u)
个人不相关熵把同一个人去过的地点做同样的计算。回转半径是这个人各次位置离开自己行程质心的典型距离:
rᵤᵍ = √[ (1/Nᵤ) Σᵢ (rᵤᵢ − rᵤ₀)² ]
Nᵤ是这个人的位置记录数,rᵤ₀是质心。它是轨迹的空间尺度,不是通勤时间,也不是路网距离。
所有指标都用真实数据当参照,用平均绝对百分比误差(MAPE)衡量:
MAPE = (1/n) Σᵢ |ŷᵢ − yᵢ| / yᵢ
ŷᵢ来自模型生成的轨迹或流量,yᵢ来自真实记录,分母是真实值。n是地点、地点对或个人的个数,随指标变化。MAPE为1,表示平均下来偏差和真实值一样大。真实值为0时,这个除法没有定义;正文只说,真实访问为0而生成结果不为0时,误差会接近1。图中的误差线没有定义,柱子靠得很近时不能靠目测分出胜负。
空间越细,理论模型为什么没先垮掉?
群体访问次数先看蜂窝、支付、摄像头。图3从左到右,空间由细到粗。
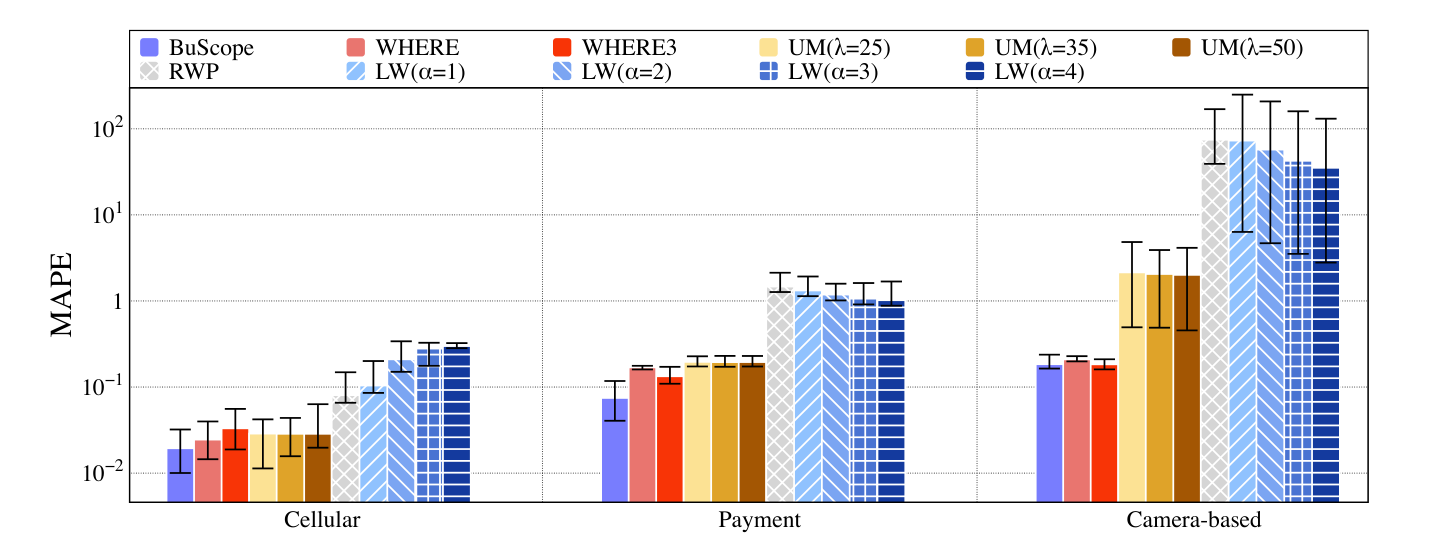
图 3|只看每个地点被访问多少次,哪类模型先失准?
无字母子图。纵轴MAPE,对数坐标。横轴从左到右是蜂窝、支付、摄像头,空间由细到粗。蜂窝上各模型的柱都较低,理论模型略高于经验模型。支付上,经验模型明显低于理论模型;正文给出的倍数是,理论模型的MAPE大约为经验模型的2到13倍,没有逐对列出每一个比值。摄像头上理论模型整组抬高,经验模型仍低一个数量级以上。误差线在摄像头的理论模型上很长,不能把其中某一根柱读成精确最优α。来源:原论文 Fig. 3。
摄像头只有70个收费站,随机路点又让每个站被选中的机会几乎相同,所以它造出的访问很平均。列维游走至少还会随距离改变概率。α=4时,访问次数的累积分布可以贴近真实分布,但逐个收费站看,生成结果会在真实曲线上下剧烈摆动。地点一少,少数站点上的大偏差就无法被其他站点平均掉。
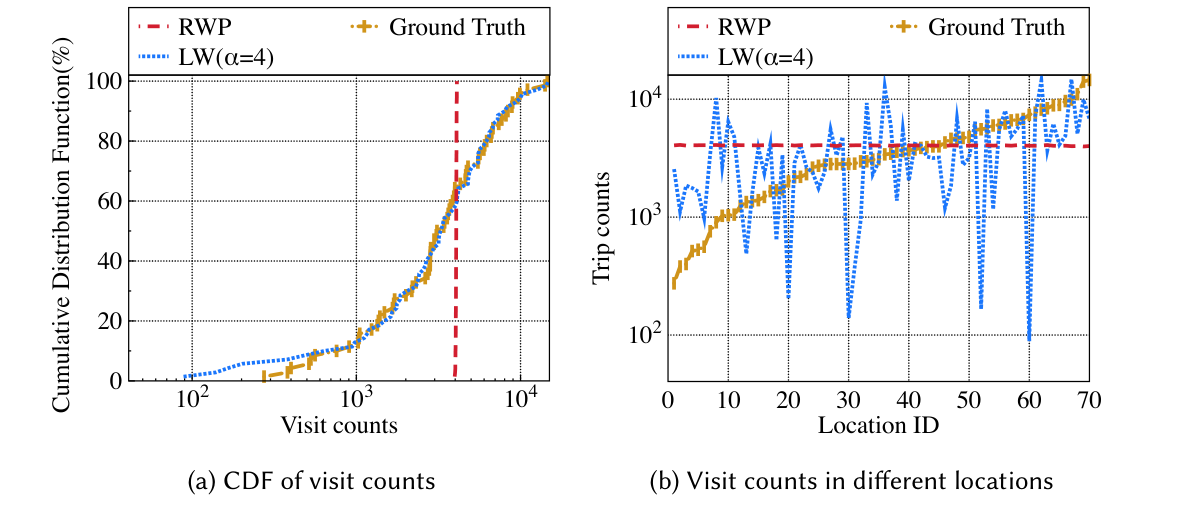
图 4|分布看起来像,是不是每个收费站都预测对了?
(a)横轴为访问次数,对数坐标;纵轴为累积分布。红色竖虚线是随机路点,表示各站访问挤在很窄的范围内。蓝色点线是α=4的列维游走,黄色点线是真实数据,两条累积曲线上升的位置接近。(b)横轴是地点编号0到70,纵轴标注为 trip counts,对数坐标;子图标题仍称不同地点的访问次数。黄色真实曲线整体上升,红色随机路点几乎是一条水平线,蓝色列维游走在大约10²到10⁴之间来回摆。分布接近不能推出每个站的客流都接近。来源:原论文 Fig. 4。
经验模型在群体层整体好于两个理论模型。Buscope同时用较细的个人历史和群体流量,支付场景里好于通用模型。三个λ的通用模型彼此接近,说明在25到50这个区间里,λ不是访问误差的主要来源。WHERE和WHERE3特别适合跳数少的系统:支付日均1.56跳,摄像头2.18跳,而它们本来就只给每个人安排两个或三个重要地点。
把同一批车载GPS放大网格,误差为什么反向变化?
车辆追踪的空间和时间都最细,但只有1万用户,渗透率最低。论文把它单独拿出来,把深圳划成500米、1公里和2公里网格,看空间聚合怎样改变访问误差。
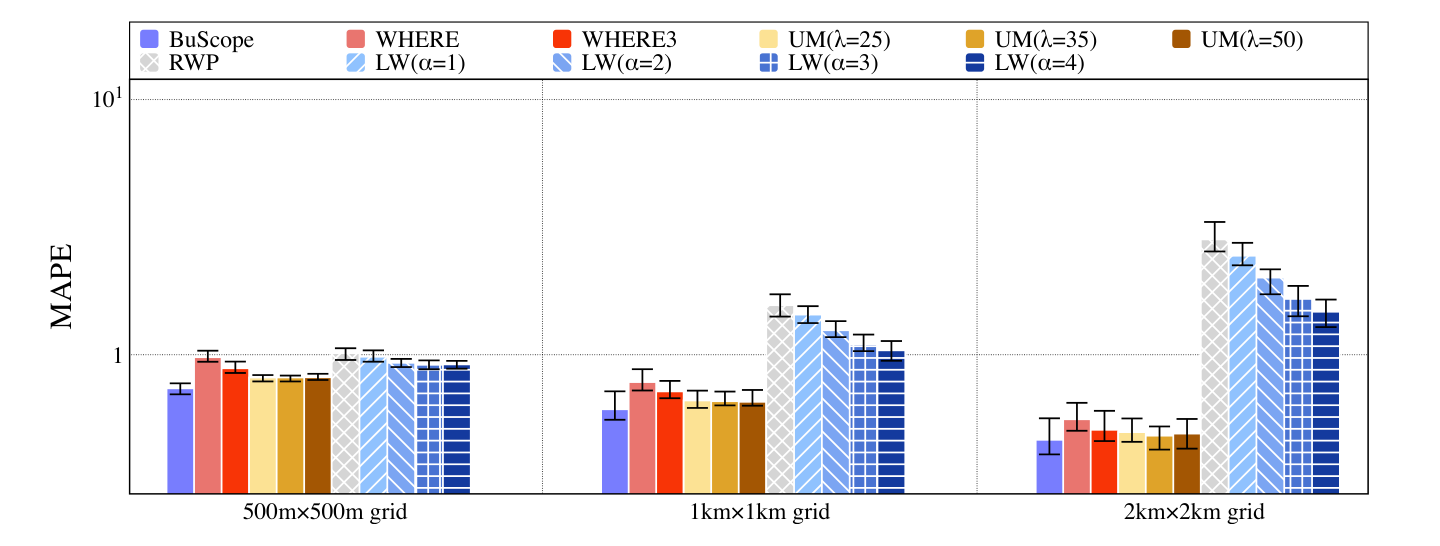
图 5|网格变粗之后,经验和理论模型谁的误差在降?
无字母子图。纵轴MAPE,从大约0.4到10。三组从左到右是500米、1公里、2公里网格。500米时各类模型都在1附近。网格变大后,左侧的经验模型下降到1以下,右侧的理论模型升到1以上,2公里时理论模型更高。这和正文的方向一致:网格变粗,经验模型更好,理论模型更差。来源:原论文 Fig. 5。
原因可以在访问次数本身的分布里看到。500米网格下,很多格子一天几乎没人经过。经验模型只要把目的地选错一格,真实值是0、生成值不是0,MAPE就会接近1。格子变大,平均访问变多,这种“空格子被点中”的惩罚被摊薄。理论模型没有把车流集中到真正热的格子里,格子一大,均匀或只按距离抽样的偏差更明显。
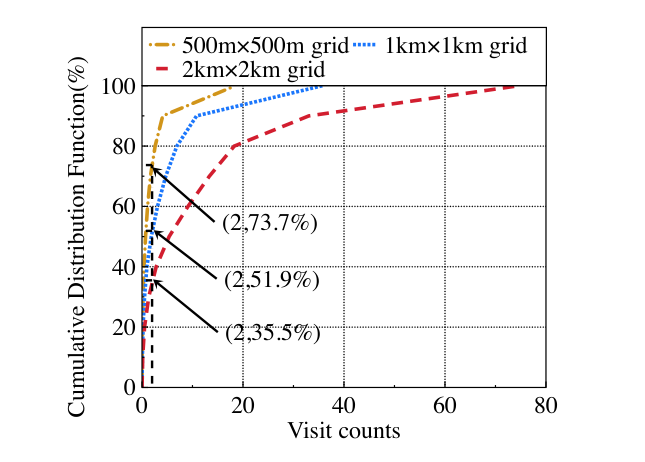
图 6|大多数格子一天被访问不到两次,是哪一种网格的事?
无字母子图。横轴是访问次数,纵轴是地点的累积百分比。橙黄点划线为500米,蓝色点线为1公里,红色虚线为2公里。图中三个箭头标在访问次数等于2的位置:500米网格的累积比例是73.7%,1公里是51.9%,2公里是35.5%。正文据此说,500米网格下大多数地点的日均访问不到2次。这是地点的累积分布,不是1万名车主里有73.7%的人每天出行少于两次。来源:原论文 Fig. 6。
起讫矩阵会把访问次数里的误差放大吗?
访问次数只关心到达一个地点的总流量。起讫矩阵要逐一核对从每个起点到每个终点的流量,格子多得多,一般也更难。
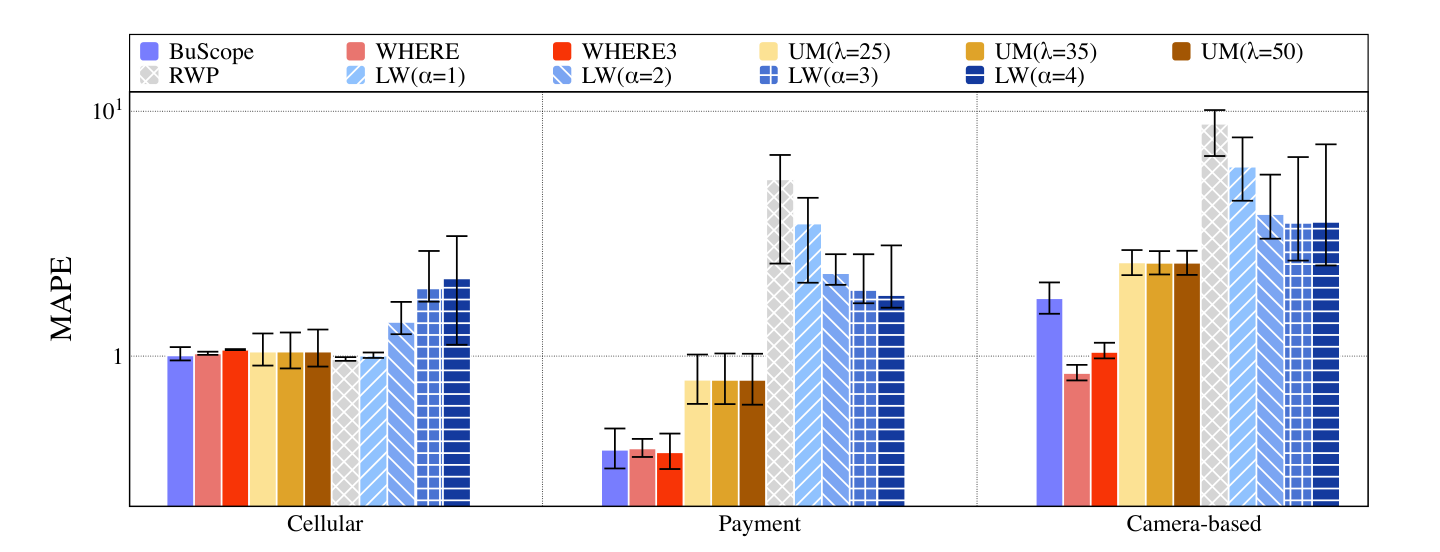
图 7|从“到过这里”改成“从哪到哪”,误差放大了多少?
无字母子图。纵轴MAPE,对数坐标,横轴仍是蜂窝、支付、摄像头。蜂窝上多数柱在1附近,α较大的列维游走更高。支付上,WHERE、WHERE3和Buscope低于1,通用模型接近1,理论模型高于1。摄像头上全部高于1,WHERE和WHERE3低于同组其他模型。正文说,相对图3的访问次数,蜂窝网络的起讫矩阵MAPE大约是其7到50倍(原文 about 7 to 50× larger),没有给出每个模型的逐对比值。摄像头的理论模型是例外:地点对很多,少数站点对上的巨大偏差被更多元素平均,起讫矩阵的MAPE不一定比访问次数更大。来源:原论文 Fig. 7。
群体层因此得到第一条选择建议:空间粒度越细,理论模型的可泛化性越好;经验模型对空间粒度不那么敏感。所谓更好,是MAPE相对更低,不是理论模型在蜂窝上已经够用来部署基站。蜂窝访问次数的误差低,部分是因为地点多,局部选错被平均掉了。
个人一天跳多远时,历史为什么有时帮倒忙?
个体指标从左到右改按周期性时间连续性排列:蜂窝、摄像头、支付。蜂窝由通话和短信触发,周期最弱;支付的通勤进出更有规律。车辆追踪没有进入这组柱状图。
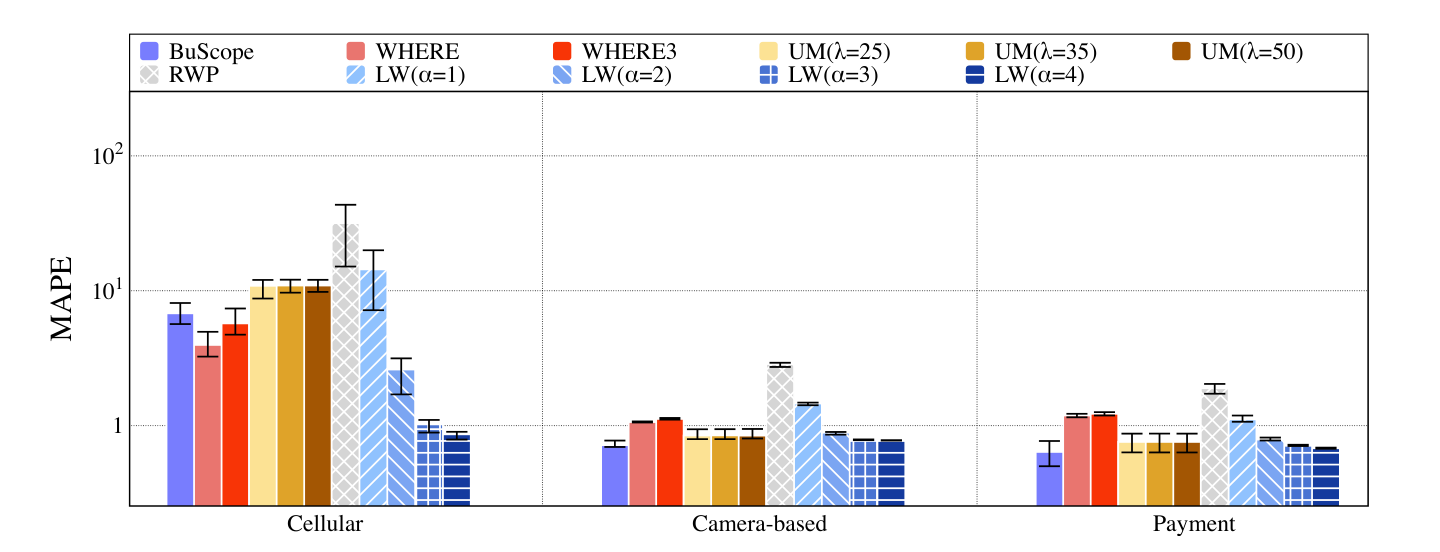
图 8|一个人相邻两地的平均距离,谁还能跟得上?
无字母子图。纵轴MAPE,对数坐标,可到10²。横轴从左到右周期由弱到强。蜂窝上,WHERE、WHERE3、通用模型和Buscope大约在数倍到十倍,随机路点和α=1的列维游走更高;α=3和α=4降到1附近。摄像头和支付上,多数经验模型在1上下,α=3、4也在1附近,随机路点仍然更高。来源:原论文 Fig. 8。
WHERE和WHERE3在蜂窝上变差,是因为它们只围绕两个或三个重要地点生成轨迹,而蜂窝用户的日均跳数是6.94。模型结构里就没有那么多步,自然对不上真实的平均跳跃。通用模型和Buscope也变差,论文把它归因于蜂窝记录缺少稳定周期,而不是再拟合一个新的λ。列维游走在α=3或4时,三个场景的这项误差都较低。这来自跳跃长度的重尾,以及该指标不要求具体落到哪一个地点;它不能说明α=4已经还原了每个人的路线。
不同地点数问的是一天去过几种地方,不关心每一步有多远。正文给出随机路点在车辆追踪上的一组对照:不同地点数的MAPE低于平均跳跃长度,两个数字是31.7和2。原句没有把两个数字分别标到两项指标上,图9也没有车辆追踪这一组。结合图8纵轴可以到10²、图9大多低于10,较大的31.7更像跳跃长度、较小的2更像地点数;这里只保留作者写明的方向,不把顺序说成图上读出的柱高。
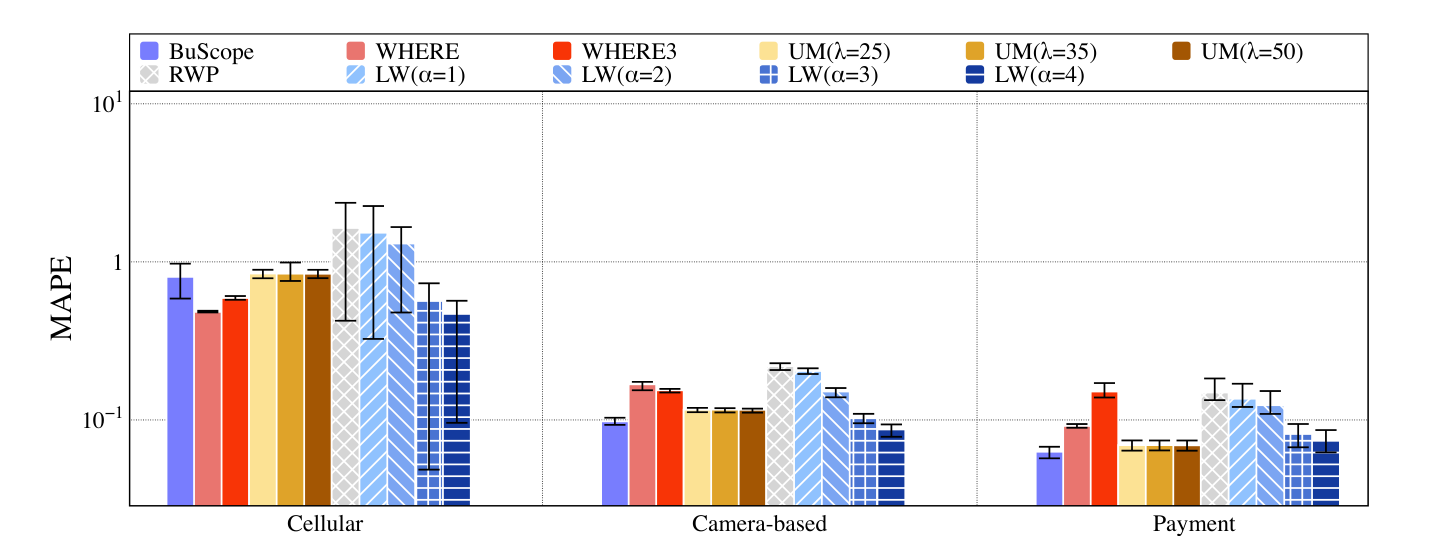
图 9|一天去过几种地方,误差为什么整体更小?
无字母子图。纵轴MAPE,对数坐标,主要范围在0.1到10。横轴仍是蜂窝、摄像头、支付。蜂窝各柱多在1上下,α=1高于α=4。摄像头和支付上,Buscope低于WHERE,三个λ的通用模型彼此接近,α较大的列维游走低于随机路点。正文认为WHERE只用群体统计去生成个人轨迹,所以在支付和摄像头上不如使用个人历史的经验模型。Buscope在这两个场景最好,因为地铁进出和高速进出都比较像它原来服务的公交:地点有限,而且反复出现。来源:原论文 Fig. 9。
个体层的第二条建议因此是:周期性时间连续性越低,理论模型通常比经验模型更能泛化。证据主要是蜂窝相对支付、摄像头的对比,不是一组把采样间隔连续调细的实验。
没画进正文主图的指标,是另一套故事吗?
附录把剩下的两项群体指标和三项个体指标补全。正文的总结是:用户数的趋势像访问次数;最大跳跃长度和回转半径像平均跳跃长度;个人不相关熵像不同地点数。地点不相关熵虽然被归在群体指标里,却对个人在地点之间的分配更敏感,所以它的场景顺序反而像个体指标。
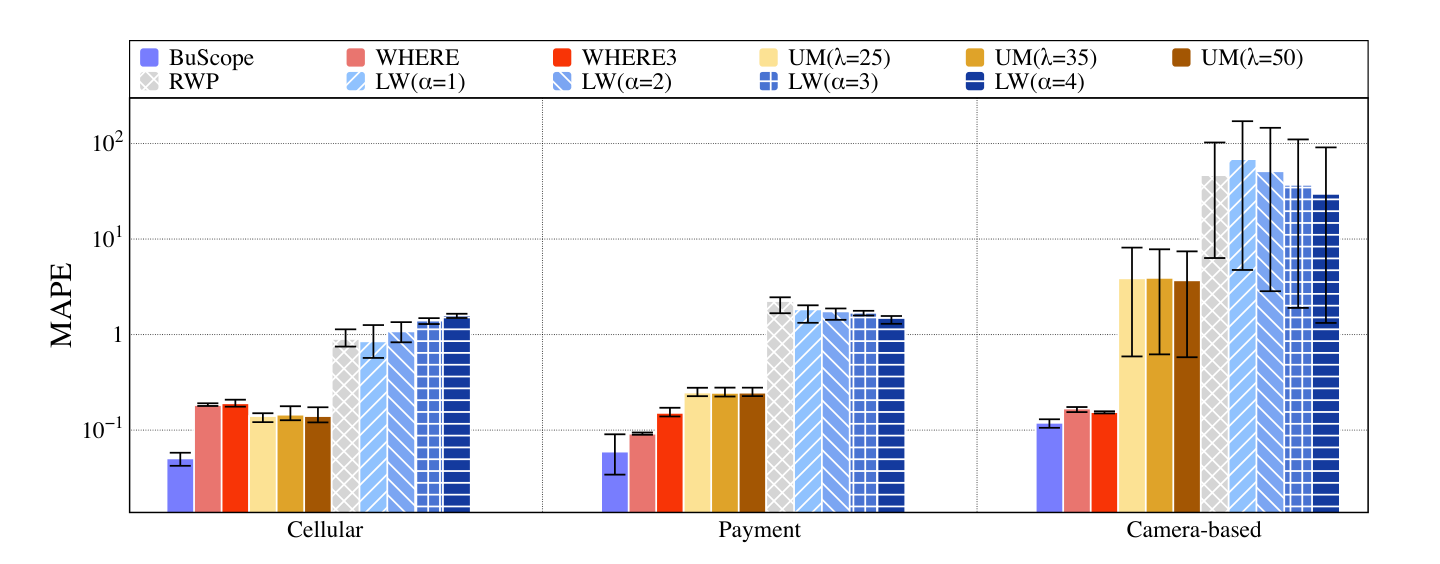
图 10|换成每个地点的独立用户数,排序还像访问次数吗?
无字母子图。纵轴MAPE,对数坐标。横轴是蜂窝、支付、摄像头,仍按空间由细到粗。蜂窝上Buscope最低,理论模型大约在1附近或略高。支付上经验模型低于1,理论模型高于1。摄像头上通用模型和全部理论模型明显升高,WHERE、WHERE3和Buscope仍低。方向与图3的访问次数相同,不能据此说用户数和访问次数是同一个量。来源:原论文 Fig. 10。
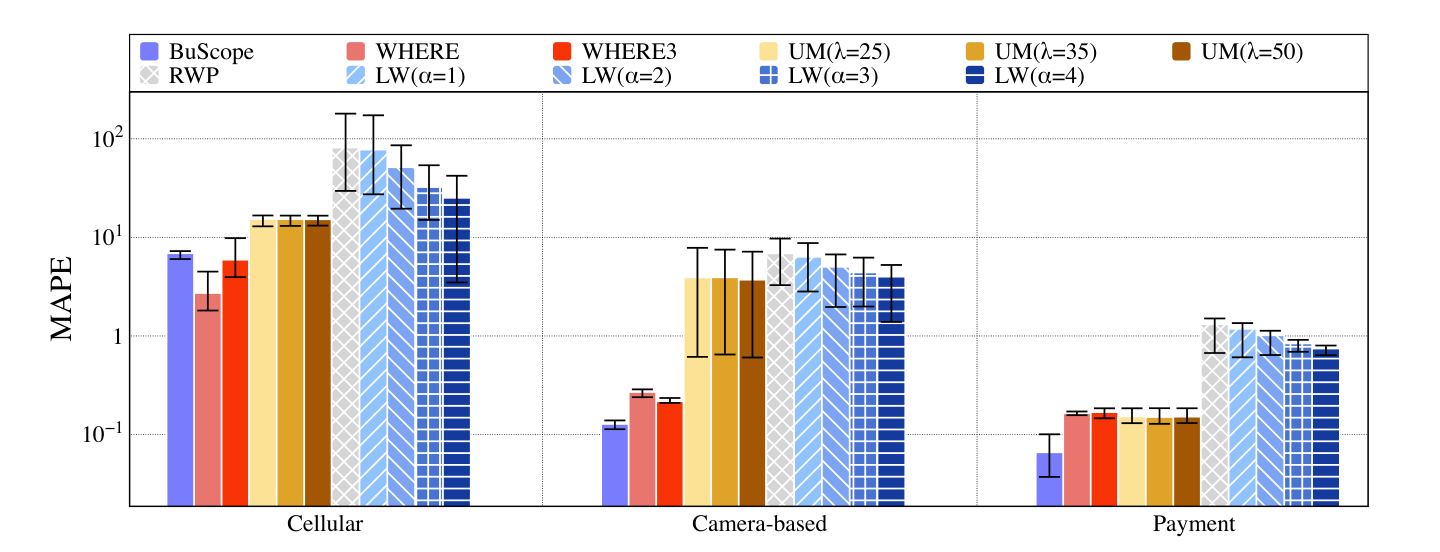
图 11|地点的访问在人与人之间有多分散,误差跟谁走?
无字母子图。纵轴MAPE,对数坐标。横轴改成蜂窝、摄像头、支付,按周期由弱到强,不再按空间粒度。蜂窝上理论模型可以到数十甚至更高,部分经验模型也在10上下,而且误差线很长。摄像头上通用模型和理论模型大约在数倍,WHERE和Buscope低得多。支付上各模型大多在1附近或以下,Buscope最低。它是群体指标,场景顺序却更接近图8的个体跳跃长度。来源:原论文 Fig. 11。
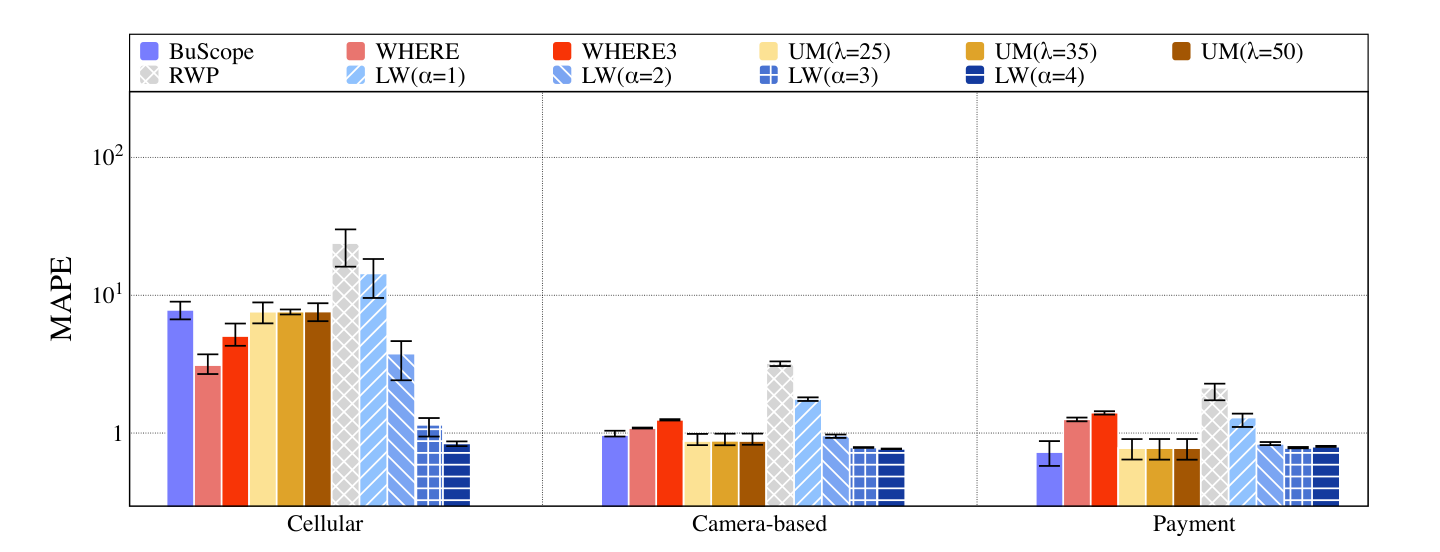
图 12|一天里最远的那一步,谁还跟得上?
无字母子图。纵轴MAPE,对数坐标。横轴为蜂窝、摄像头、支付。蜂窝上随机路点和α=1较高,α=3和α=4降到1附近;经验模型多在数倍。后两个场景里,α=3、4和多数经验模型在1上下,随机路点仍然更高。形状接近图8,所以最大跳跃并没有带来一套新的模型排序。来源:原论文 Fig. 12。
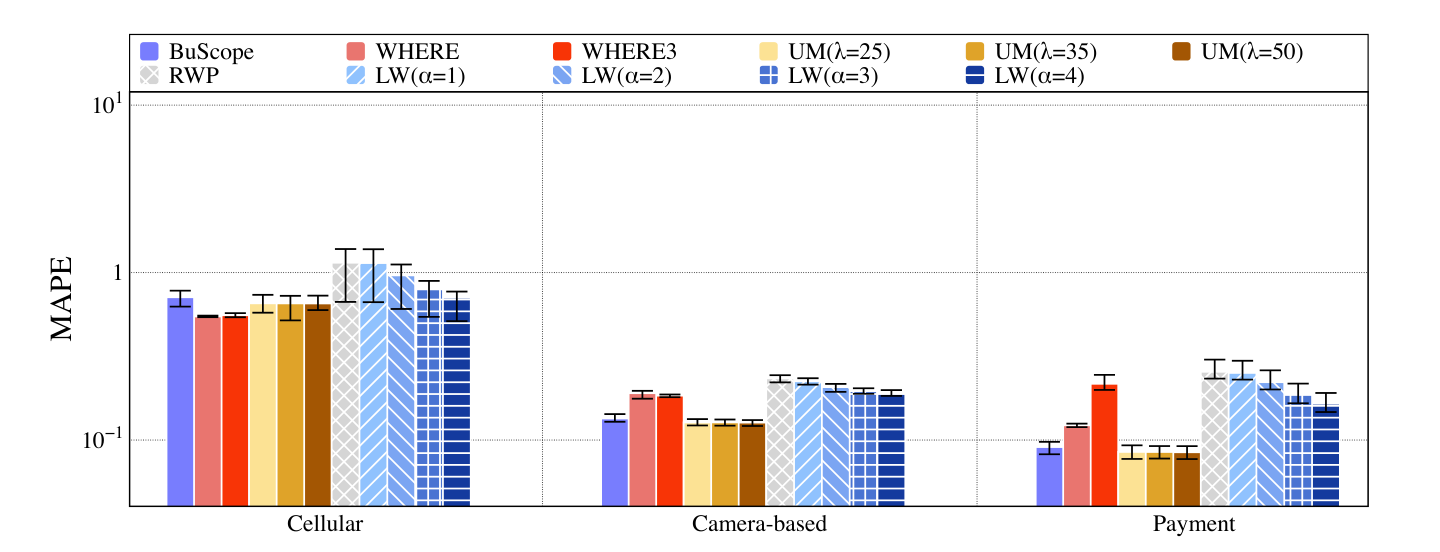
图 13|一个人的地点分布有多不确定,误差大不大?
无字母子图。纵轴MAPE,对数坐标,图中范围主要在0.1到10。横轴仍是蜂窝、摄像头、支付。多数柱低于或接近1,蜂窝略高,支付上Buscope和三个通用模型更低,WHERE3在支付上高于同组其他经验模型。量级接近图9的不同地点数,而不是图8那种可以到几十的跳跃误差。来源:原论文 Fig. 13。
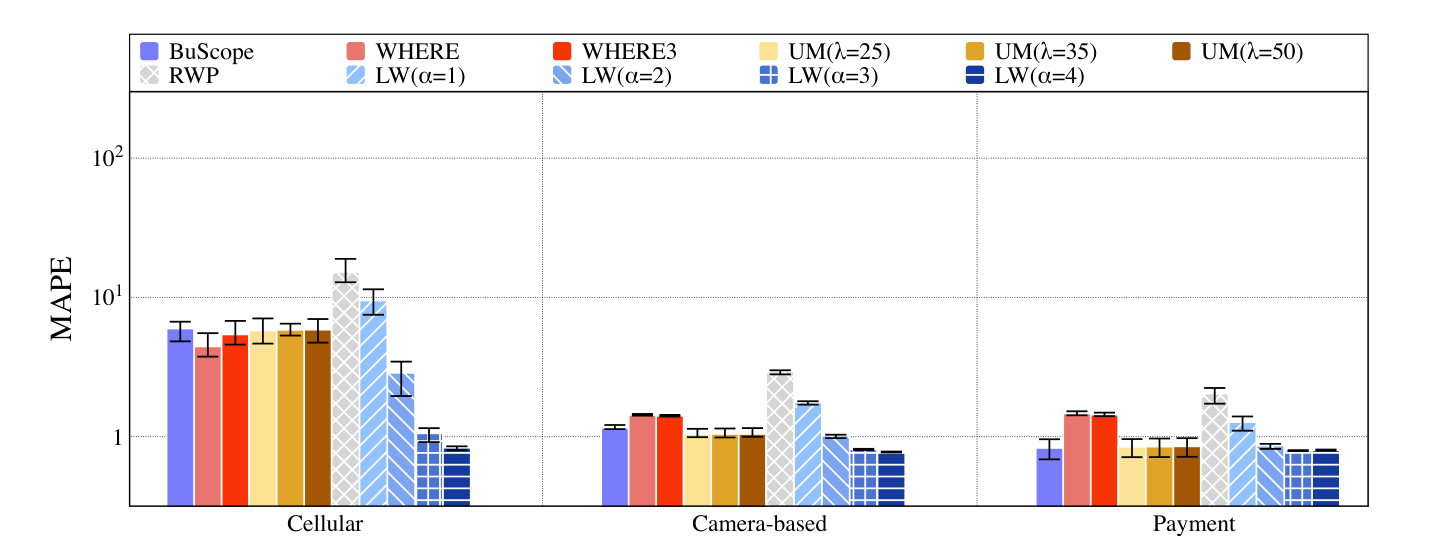
图 14|一个人活动范围的典型半径,还是同一条规律吗?
无字母子图。纵轴MAPE,对数坐标。横轴为蜂窝、摄像头、支付。蜂窝上随机路点和小α的列维游走更高,α=3、4接近或低于1,经验模型大约在数倍。摄像头和支付上,较大的α与Buscope、通用模型都在1附近。它支持“回转半径的模型排序类似平均跳跃长度”,不支持把回转半径解释成真实通勤距离。来源:原论文 Fig. 14。
表4把这些结果收成四格。理论模型配群体指标:空间越粗越不好泛化;摄像头上起讫矩阵与访问次数的关系不同于蜂窝和支付。理论模型配个体指标:较大的α更好。经验模型配群体指标:同时使用个人和群体历史的模型彼此接近,并且好于理论模型;数据稀疏时,更粗的空间划分对经验模型更有利。经验模型配个体指标:支付和摄像头上,用个人历史的模型好于只用群体历史的模型;周期性时间连续性会明显影响经验模型;不同λ的通用模型表现稳定。
讨论里的应用建议也建立在“找一个时空特征相近的系统”上,而不是新的实验。高速公路上的车辆起讫,作者建议参照摄像头系统,WHERE和WHERE3是合适候选。估计地点访问、为基站选址时,建议在蜂窝这类系统上优先经验模型。用回转半径和不同地点数看疾病传播风险时,作者建议蜂窝上用α=3或4的列维游走,支付上用Buscope。这些是基于重尾和系统相似性的选择意见,不是疫情数据上的验证。
这些比较停在哪里?
全部数据来自深圳这一座大城市的一个月,具体月份没有写出。其他国家、较小城市或不同的出行文化,不能自动沿用同一套高低排序。四套系统已经拉开了空间粒度和时间连续性,但网约车轨迹、共享单车或纯GPS手机还没有进入检验。模型也只覆盖五类,近年大量生成模型没有被逐一比较。
MAPE对每个地点或每个人一视同仁。图4已经显示,累积分布接近的同时,单个收费站可以差出一个数量级。误差线没有定义,柱高接近时的细小差别不应写成显著优劣。经验模型使用大约三周历史、余下日子做核对,理论模型不使用历史,两类模型的信息量本来就不同。较低的MAPE说明生成轨迹的某项汇总更接近真实汇总,不说明找到了唯一机制,也不说明参数可以跨城市照搬。
数据由服务方和交通部门在用户同意下合法采集,并经合作者匿名化。作者写明无法据此追回驾驶人身份,蜂窝连接细节等与本题无关的字段已删除。公开数据仍停留在计划:与深圳智慧城市研究组合作,准备对个人标识做哈希、去掉敏感字段并加入差分隐私后再释放样本。正文没有给出已经可以下载的链接。
一句话总结
同一座城市里,空间越细,理论模型越能守住群体流量误差;记录越缺少稳定周期,依赖个人历史的经验模型越容易在个体尺度上失准。模型该怎么选,取决于采集系统的粒度,而不是取决于它在原来那一种数据上有多著名。
核心来源
- ACM Digital Library正式页面,对应 DOI 10.1145/3494997,Proc. ACM Interact. Mob. Wearable Ubiquitous Technol. 5, 4, Article 171,2021年12月,21页。
- 同一PDF内的正文图1–9、表1–5,以及附录图10–14。附录补的是用户数、地点不相关熵、最大跳跃长度、个人不相关熵和回转半径,没有另册补充材料。
作者介绍
以下只采用论文署名页上的机构与邮箱,不补充论文没有列出的职务。
- Wenjun Lyu:署名罗格斯大学,新泽西,邮箱 wenjun.lyu@rutgers.edu。
- Guang Wang:署名罗格斯大学,新泽西,邮箱 guang.wang@rutgers.edu。
- Yu Yang:署名理海大学,宾夕法尼亚州伯利恒。论文地址页未给出邮箱。
- Desheng Zhang:署名罗格斯大学,新泽西,邮箱 desheng.zhang@cs.rutgers.edu。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一座城市只拿到地铁刷卡,Buscope这类相信个人重复路线的模型会在日均一两跳的数据上显得很准。把同一选择拿到通话记录上,人并不是按通勤钟点留下位置,历史里的“最可能下一站”就会把一天6到7跳压成两三处重要地点。部署前至少应该先看日均跳数和记录是不是由稳定事件触发,而不是只看模型在原始论文里的数据种类。深圳这一座城市还不足以证明换到其他国家会保持同样的分界。
另一件容易误用的事是网格。500米时73.7%的格子日访问不超过2次,经验模型的MAPE接近1,很大程度是因为点错一个空格子就整格失败。放到2公里,误差下降,可能只是指标变得更宽容,而不是模型突然理解了驾驶。若目标是找出哪几个路口真正拥堵,把格子放大到误差变漂亮,会把要找的差异一起平均掉。评价应该同时报告空格子比例和最差地点的误差,而不是只保留一个全市MAPE。