日常活动范围,两周的定位够不够?
论文名片|Kevin Stanley、Eun-Hye Yoo、Tuhin Paul、Scott Bell,How many days are enough?: capturing routine human mobility,International Journal of Geographical Information Science,2018,2018年4月25日在线发表。收稿日期2017年7月13日,接收日期2018年1月28日。DOI:10.1080/13658816.2018.1434888。
萨斯卡通的大学生被要求连续几周开着手机定位。研究者想拼出的是活动空间(activity space):一个人日常活动所覆盖的那一片地方,家、教室、商店会反复出现。手机大约每五分钟就能记一个点,也能因此多记下参与者并未打算交给研究的生活。天数于是变成一个可以测量的问题:再记一天,地点比例还会明显改变吗?
三组校园参与者、三种格子的结果方向一致。累积地点直方图在不到两周里就很少再变,格子越大,变得越快。这里的“够”,指的是这段观测窗口里新增信息已经很小。窗口落在学期还是一段特殊日子,稳定下来的会是不同的地图。
先说结论
- 三组研究各取连续21天。去掉21天内有整天无记录的人之后,样本量是35/61、42/74、42/88,合计119人次。论文写明有人跨数据集重复出现,独特个体数没有给出。
- 比较的是同一个人相邻两天的累积空间直方图。KL散度(Kullback–Leibler divergence)衡量后一张概率表相对前一张还多出多少信息;两张表相同就是0。
- 作者把散度降到0.1以下当作足够定位的操作阈值。0.1取的是这批数据里典型高值1的10%;散度1已经盖住除最极端离群点以外的情形。
- 降到0.1以下的时间,100米格子在两周内,400米在12天内,1600米在8天内。大约一周已经明显收敛,两周后新增信息很少。
- 三组的逐日平均散度都接近 A/t。100米的 A 分别为0.307、0.253、0.215。这是拟合曲线,拟合优度最高0.976、最低0.833,而且非线性回归的 R² 只能作参考。
计步器说三四天就够,为什么地点要另算?
旅行日记、问卷和访谈能记下活动和移动,也费时,还受回忆影响。GPS和手机把记录变成高时间分辨率的点,公共卫生、暴露评估和出行调查都在用。点越密,参与者的负担和隐私代价越高。作者把这个张力写成一个问题:捕捉个人和群体的日常活动格局,多少天够用?
已有研究给过“最少天数”,量的却是另一件事。Tudor-Locke等人用方差分析、组内相关和回归,认为任意3天的计步器数据就足以估计成年人一周的身体活动。Hart等人在老年人里得到:加速度计3天、计步器4天,或活动日志4天,可以预测习惯性身体活动和久坐。那些统计比较的是同一个人各天之间的波动,相对于不同人之间的波动,对象是活动量这类健康指标。
活动空间在这里指人们日常活动所经过的局部地区。锚点假说认为,一个人有相对少、又比较稳定的锚点,常见类型包括家、工作、休闲和购物;不同人的锚点并不相同。所以这篇论文要的指标是同一个人随时间的空间变化,比较的是这个人自己前后的地点直方图。人与人之间谁更爱动,需要另外的比较。
这119人次是谁,21天里留下了什么?
数据来自2016年7月到12月的三轮Saskatchewan Human Ethology Dataset,即SHED的第7、8、9轮。参与者都是萨斯喀彻温大学社区成员,住在萨斯卡通市区或附近。定位由Ethica应用采集,论文称它基于该系更早的iEpi工作。手机系统给出的是WiFi、基站和辅助GPS综合后的位置。大约每5分钟记一次,保证间隔不超过10分钟;为省电,每次记录大约一分钟,并可能把其中一次略微挪开,以便和其他进程对齐。手机有电就记录,参与者被要求夜间充电。三组原始采集长度为4到7周,分析为了对齐,每组只用连续21天,而且是每项研究最开始的21天。
三组的设计目的不同。SHED7本来研究建成环境的可步行性和步行倾向,采集恰好碰上Pokemon Go在加拿大上线。SHED8本来要看公交系统劳工中断,中断在行动开始前已经和解,并被写成Paul等人2016年工作的后续。SHED9看的是校园一座有盖天桥关闭后,学生校内通勤有什么变化。这些是采集时的背景。论文没有把后面的散度曲线归因于游戏、罢工或天桥。
问卷里的性别、年龄和校园身份见图2。三组都是女性明显多于男性,年龄集中在二三十岁,校园身份以研究生和本科生为主,职工、博士后和其他身份很少。SHED7的年龄柱在27–29岁最高,SHED9在21–23岁最高。身份类别也不完全一样:SHED7印出研究生、其他、职工、本科生;SHED8在此之外有博士后;SHED9印出的是研究生、博士后、职工、本科生。柱上没有标数字,正文也没有逐柱给人数。这张图出现在“整天无记录就剔除”的说明之前,纵轴刻度也高于后面的35、42、42,因此不能把柱高读成进入KL分析的人数。
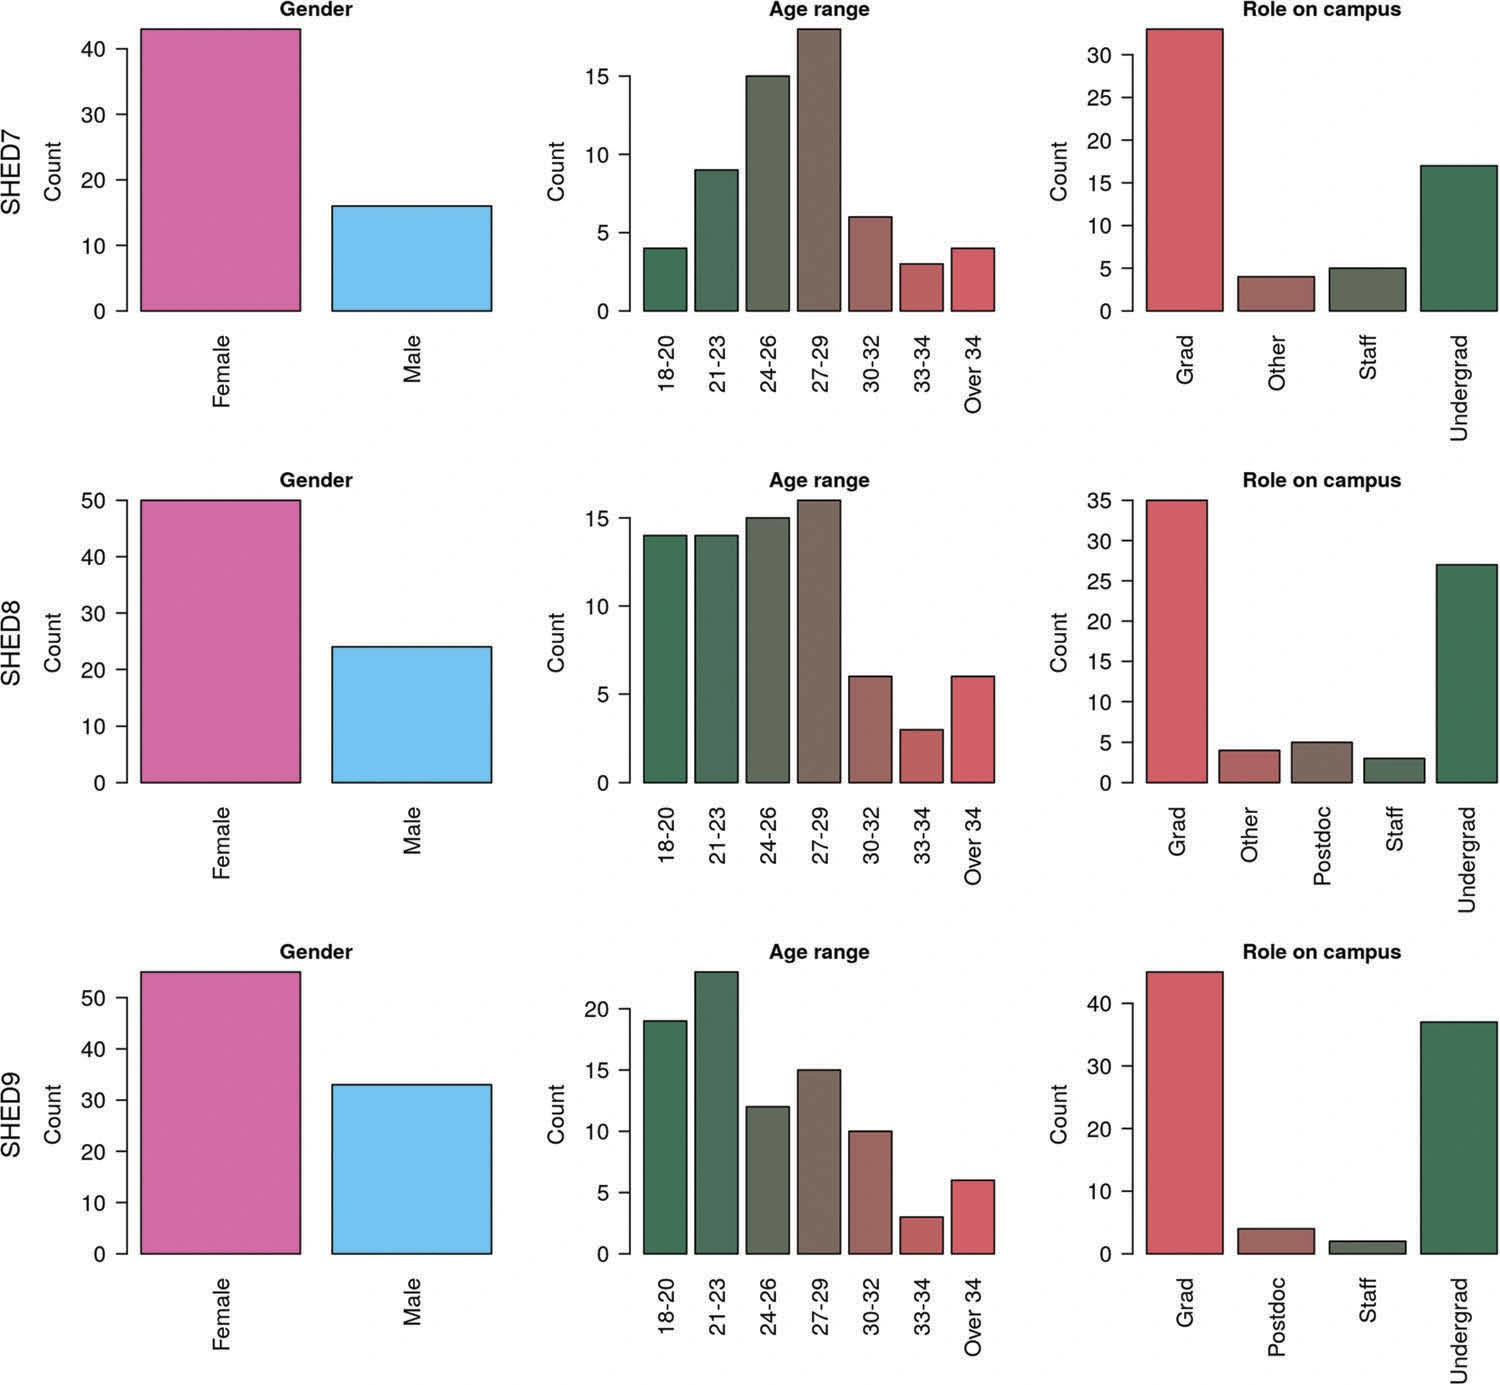
图 2|三组问卷样本的性别、年龄和校园身份各是什么构成?
无字母子图。三行依次为SHED7、SHED8、SHED9,三列依次为性别、年龄段、校园身份,纵轴都是人数。性别上都是女性柱高于男性柱,并接近或达到该图最上端刻度。年龄段从18–20到34岁以上,主体在18–29岁。校园身份都以研究生最多、本科生其次。来源:原论文 Fig. 2。
分析只用定位。研究也采集了加速度计、电量、蓝牙和WiFi,正文没有把它们放进这个天数指标。定位先做了四道过滤:只保留安卓报告精度达到100米或更好的点;时间只留每项研究的前21天;空间限制在萨斯卡通及周边的城市移动;21天里只要有一整天没有任何记录,这个人整份数据去掉。最后一条是为了避免假的“已经稳定”。缺一天时,前后两张累积直方图相同,KL散度会返回0,把全体平均值往下拉。论文同时写明,散度本身对缺失日是有定义的,去掉这些人是为了让总体均值不被这个计算特性压低。
| 数据 | 筛选前人数 | 筛选后人数 | 筛选前定位记录 | 筛选后定位记录 |
|---|---|---|---|---|
| SHED7 | 61 | 35 | 11,141,544 | 4,765,907 |
| SHED8 | 74 | 42 | 12,646,521 | 5,204,079 |
| SHED9 | 88 | 42 | 15,878,570 | 7,001,289 |
表中的前后人数和定位记录来自表2。筛选前的定位记录与表1的GPS条数一致,所以“之前”是全部GPS记录,“之后”是精度、天数、范围和整天缺失这几步一起作用的结果。定位条数同时受精度、天数和地理范围影响,少掉的人只是其中一步。三组筛选后合计35+42+42=119人次,对应筛选前61+74+88=223人次。因为有人跨研究重复,119是人次合计,独特个体少于此数。
参与者里包括住在校园的学生。格子从100米到1600米。Ethica当时把50米当作不可再拆的最小单元,这个限制后来在软件里改过,但仍约束了本次分析的下限。作者把最小格子放在100米,以提高换格对应真实移动的可能。400米和1600米用来看同一种指标在更粗分区下是否还成立。1600米已经覆盖通常不按步行距离理解的范围。宿舍和教室有可能落进同一个粗格子。
再记一天,地点比例会怎么改?
每个人、每一天,都把从观测开始直到当天的定位放进规则格子,数每个格子里有多少个GPS样本。论文把这张表叫空间直方图:格子频率表示在该地理位置上的到访,样本次数用来近似停留。采样大约五分钟一次、每次约一分钟,因此它接近时间分配。一般所说的任意二维直方图或热力图,在文中被特意和这个定义分开。
KL散度回答的是:已经有分布X,还要多少新信息才能写成分布Y。经典写法是 D(Y‖X) = ∫ Y log(Y/X)。用在这里时,X是截至某一天的累积直方图,Y是再加入下一天之后的累积直方图,对离散格子求和。两张表完全一样,散度是0;Y相对X越不同,数值越大。格子先排成一条向量再计算。只要两天用同一套编号,按纬度排还是打乱顺序,结果相同。所以这个数不直接度量“新地点离旧地点有多远”,它度量的是各格子概率有没有改写。
因为后一张直方图包含前一张里的全部点,比较只能顺着时间做。KL本身不对称,从Y还原X和从X还原Y可以不相等;在这个设计里,时间方向把比较固定成“后相对前”。它也没有像方差分析那样的现成显著性检验。作者因此先定一个操作性标准:散度稳定到最大散度的10%以下,就算足够定位。在这批数据里,该标准被写成0.1,因为散度1通常已经盖住除最极端离群点以外的情况。0.1是参照1的十分之一,换一批人或另一种最大散度,同一个0.1不一定还表示10%。
他们还计算了散度的逐日变化,以及散度沿时间的积分。逐日变化接近0,表示再测一天带来的信息增量停住了;负值表示这一天的散度比前一天更低,信息增加在放缓。积分被用来看累积之后的收益递减。正文图只画出散度和它的逐日变化,积分没有单独的图。
两种极端情况说明,散度下降的速度才是有用的部分。若一个人整个研究期都待在同一个格子里,概率始终集中在那一格,后续直方图与前面相同,散度一直是0。若一个人在研究期内从不重复地点,每个到过的格子只出现一次,概率是1/Nvc,Nvc是到过的格子数。再增加一个新格子,分布仍然均匀,只是格子更多;相对于已经到过的全部格子,新增的那一份比例越来越小,信息增益也会变小。所以散度随时间下降,并不自动等于“一个丰富的日常路线已经被认全”。锚点很多的人,只要这些锚点每天都稳定出现,散度也可以和锚点很少的人差不多快地收敛。
图4印出的是这个改写过程的一张3×3示意。方法部分把同类草图称作图1,图4的图注则写成“每项实验全体参与者的第1天和第1–2天”。印刷面板只有两处格子有点和概率,全体参与者的城市地图不在这个图框里。图注后面的正文还描述了另一张图:400米格子、全体参与者、校园为金色和青绿色、其余为零的紫色背景,并说只看两天已经很难找出差别。那张全体地图在这版PDF里没有单独的图。下面按印刷出来的面板读。
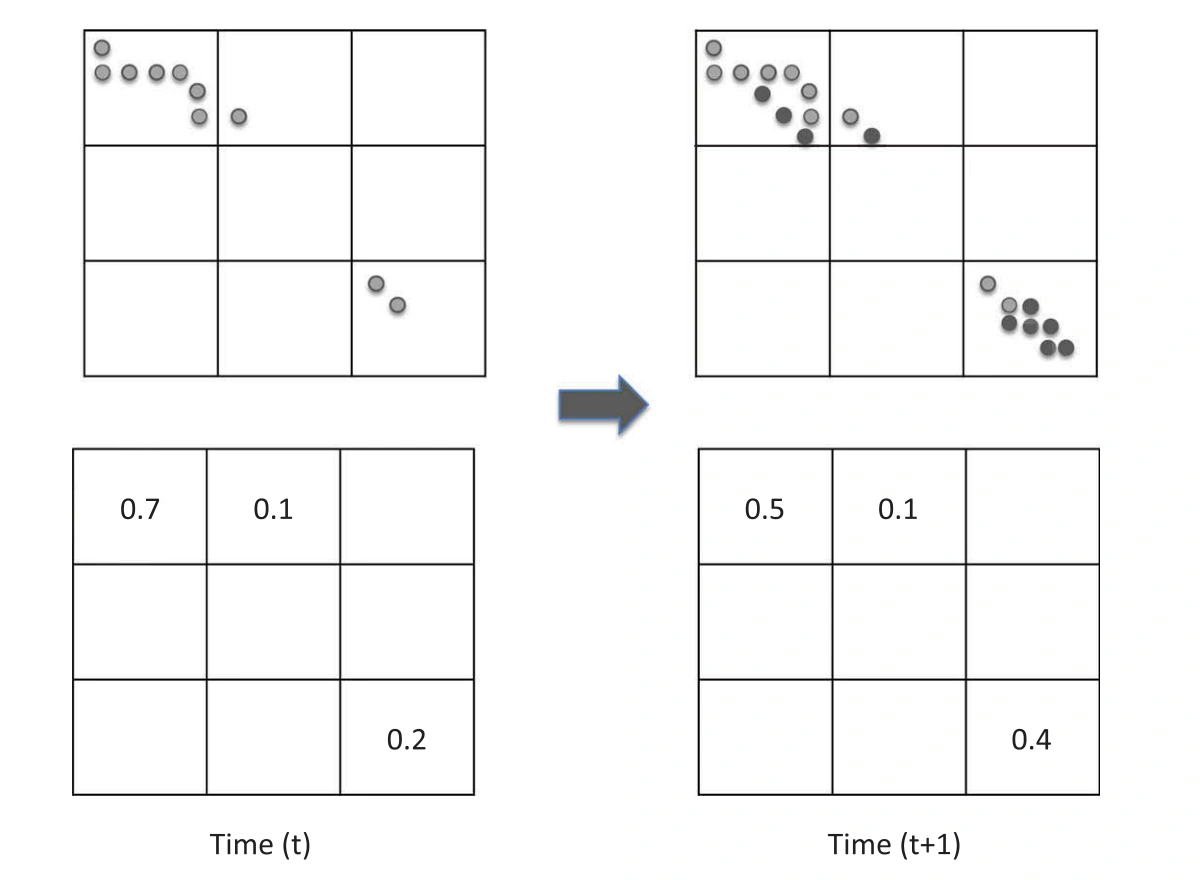
图 4|多记一天之后,累积地点比例怎样被改写?
无字母子图。上排是示意点,下排是对应的3×3概率,左为Time (t),右为Time (t+1)。t的三个非零格是0.7、0.1和0.2,相加为1;t+1是0.5、0.1和0.4,相加也是1。左上格的份额从0.7降到0.5,右下格从0.2升到0.4,上中格保持0.1。右上的点更多,其中一部分颜色更深。这是用来看累积比例如何重分配的例子。119人次的实测散度见后面的箱线图。来源:原论文 Fig. 4。
同一段方法还把这个指标和移动熵分开。Song等人2010年的移动熵量的是一串到访地点里有多少信息;KL量的是两段到访累积成的两张直方图差多少信息。一个人轮班上下班,离开和返回的钟点可以很不稳定,家和工作地却不变。按天累积的空间直方图会抓住后面这件事,抓不住前面这件事。比一天更细的时间起伏,在“以天为步长”的汇总里被合掉了。
校园上的两天,格局已经很像
图1的图注写着“两个时段的空间直方图示意”,面板上的文字却是SHED9 day t和SHED9 day t+1,内容是校园底图上的热度。结果部分关于College Drive和周一、周二教学楼的句子,描述的也是这种校园热度:第一天覆盖本科教学楼的一部分,两天合在一起覆盖常用教学楼的范围;第二天把南部College Drive一带通勤中的空档补得更完整。热度从蓝到红表示到访更集中。KL计算使用的是规则格子上的原始直方图,作者把空间平滑列为后续工作,因此这张连续色斑不能逐格当成后面的散度输入。
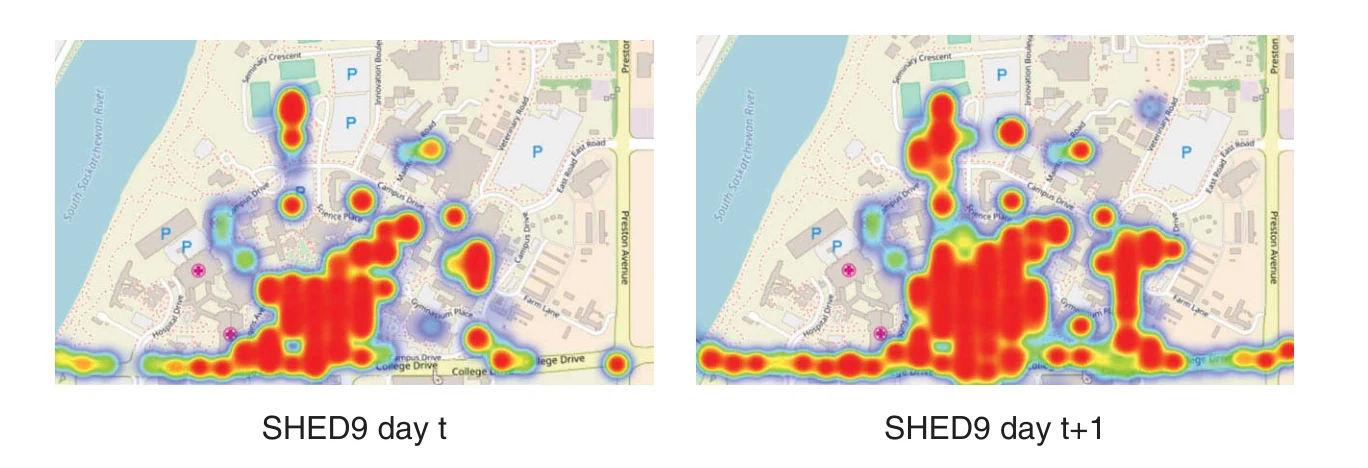
图 1|相邻两天的校园到访热度,差在哪里?
无字母子图。左为SHED9 day t,右为SHED9 day t+1。两天的高热度都集中在校园中南部建筑一带;右图南部道路走廊的色带更连续,东部也多出成片高热度。图注称其为示意,面板是带底图的热度。来源:原论文 Fig. 1。
图3是另一张两天对比。正文有一处写这是从SHED9随机抽的10人、任意两天;印刷图则是三行都有,列为Day 1和Day 2,图注写的是每组10人、研究最初两天、范围在大学校园。为符合伦理要求,图被裁到参与者都去的校园,并且以10人合计呈现。真正计算KL时,比较是在每个人、未合计的直方图上做的。这六张小图展示的是校园窗口里的合计分布,KL数值画在图5至图7。
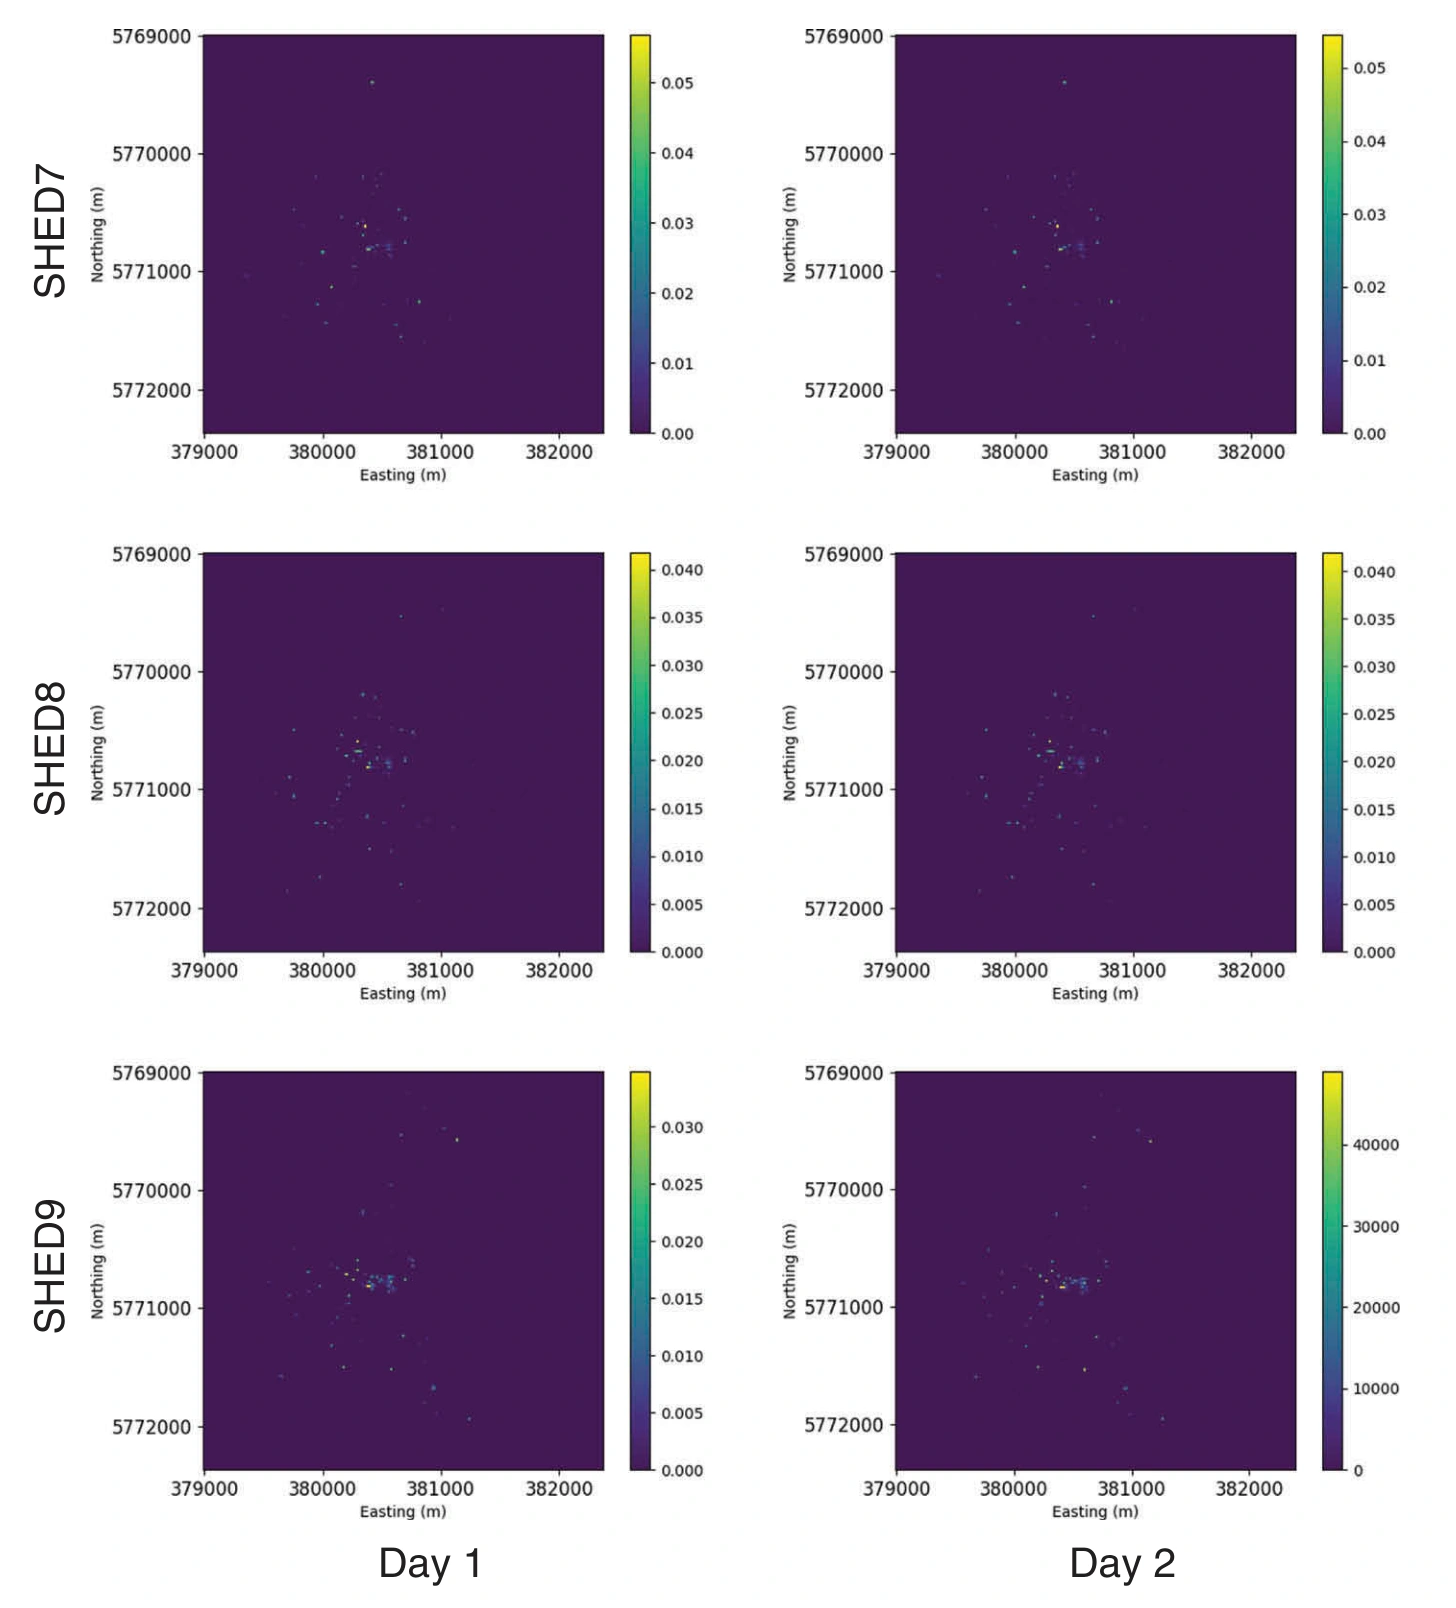
图 3|十人合计后,三组研究的头两天在校园窗口里如何分布?
无字母子图。行是SHED7、SHED8、SHED9,列是Day 1、Day 2。横轴为东向、纵轴为北向,单位米;东向刻度约从379000到382000,北向刻度印成上端5769000、下端5772000,跨度大约3公里,对应正文所说的校园范围。底色接近0。色标各自独立:SHED7两天最高都标到0.05,SHED8两天最高标到0.040,SHED9第一天最高标到0.030,SHED9第二天最高标到4000。因此不能把不同小图里的黄色当成同一种比例。来源:原论文 Fig. 3。
作者另外说,全体参与者在400米格子上只累积两天,差别就已经很难看出来,大部分活动落在校园,其余地点概率很低,并散布在学生常住和购物的地区。支持这句话的金、青、紫地图不在图4的图框里,这版PDF也没有另给一张对应的图。能直接看到的是图1和图3:相邻两天的主要质量都落在同一片校园窗口,第二天的差异表现为走廊补全或色标改变。
散度降到0.1,三种格子各要几天?
图5到图7把每个参与者、每一天的散度画成箱线图。每组一个箱子的分母,是该组筛选后的人数:SHED7为35人,SHED8和SHED9各42人。正文写明,箱子从实验的第二天之后开始,因为算法做的是相邻两天的成对比较;21天因此不会有21个彼此独立的“第一天”。箱子是内四分位,须线是外四分位,圆点是离群点,中线是中位数。这里的外四分位是论文自己的说法,正文没有写成1.5倍四分位距。
横轴印的是月中的日期,轴上没有研究日序号。三组起点各不相同:SHED7从13日前后跨进下个月,SHED8从27日前后跨月,SHED9从2日排到20日前后。这与“每项研究各自的前21天”一致,三张图各用各的日历。纵轴左列是散度,画到2.00;右列是散度的逐日变化,画到1.00和−1.00。图注写的是右为散度、左为导数。坐标轴标题是左列Divergence、右列Change in Divergence。下文按坐标轴阅读。
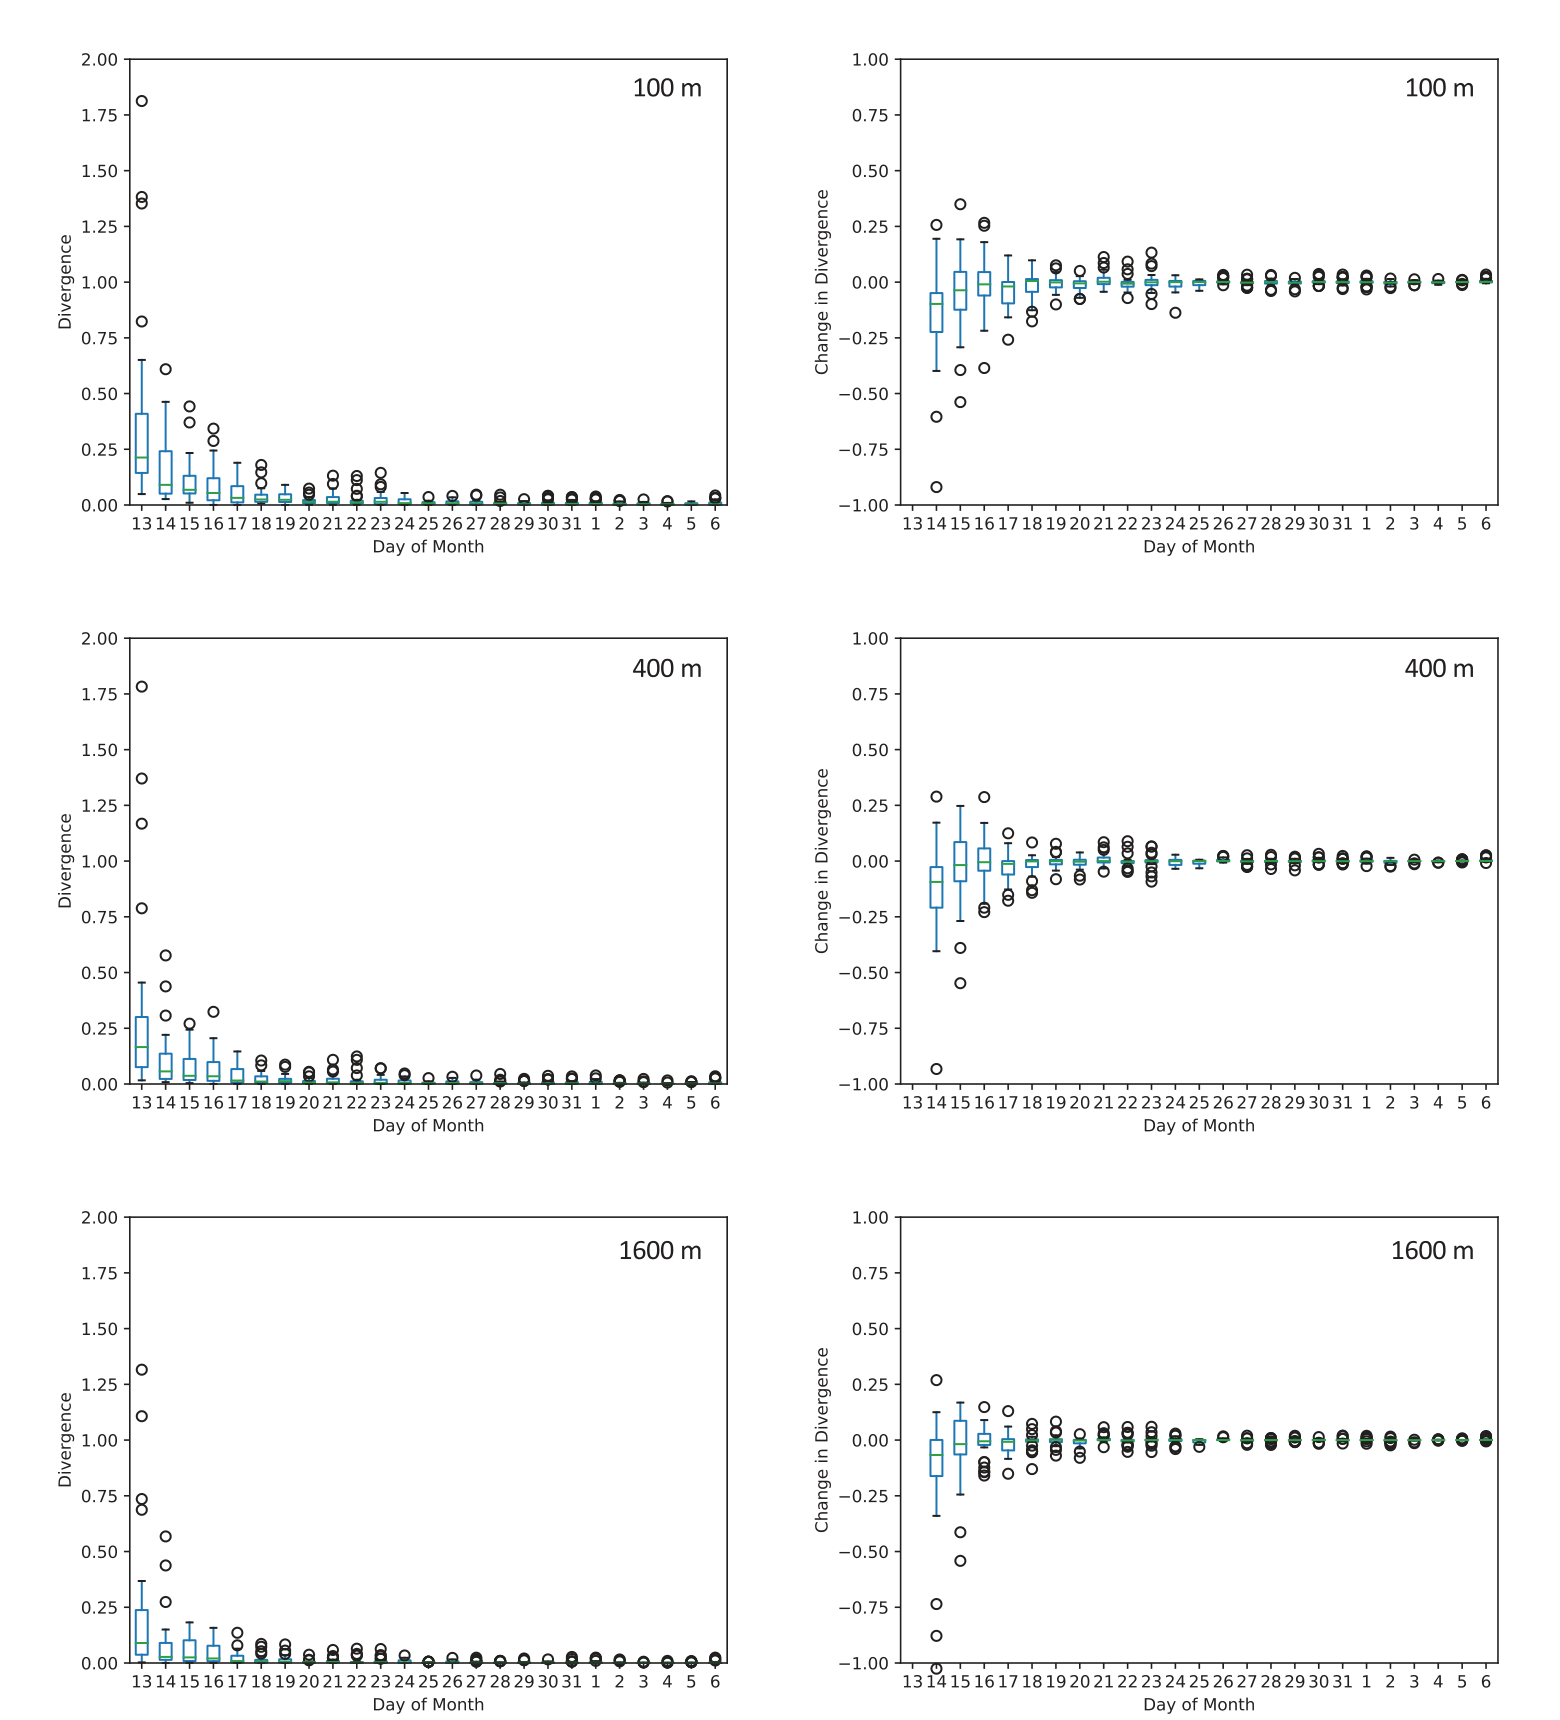
图 5|SHED7在三种格子上,散度多久靠近0?
无字母子图。上、中、下为100米、400米、1600米;左列为散度,右列为散度的逐日变化。三行左列的中位数和箱子都很快贴向0,早期有高于1的离群点,1600米的箱子从一开始就更矮。右列早期有明显的负向离群点,随后集中在0附近。每个箱子汇总的是35名筛选后参与者。来源:原论文 Fig. 5。
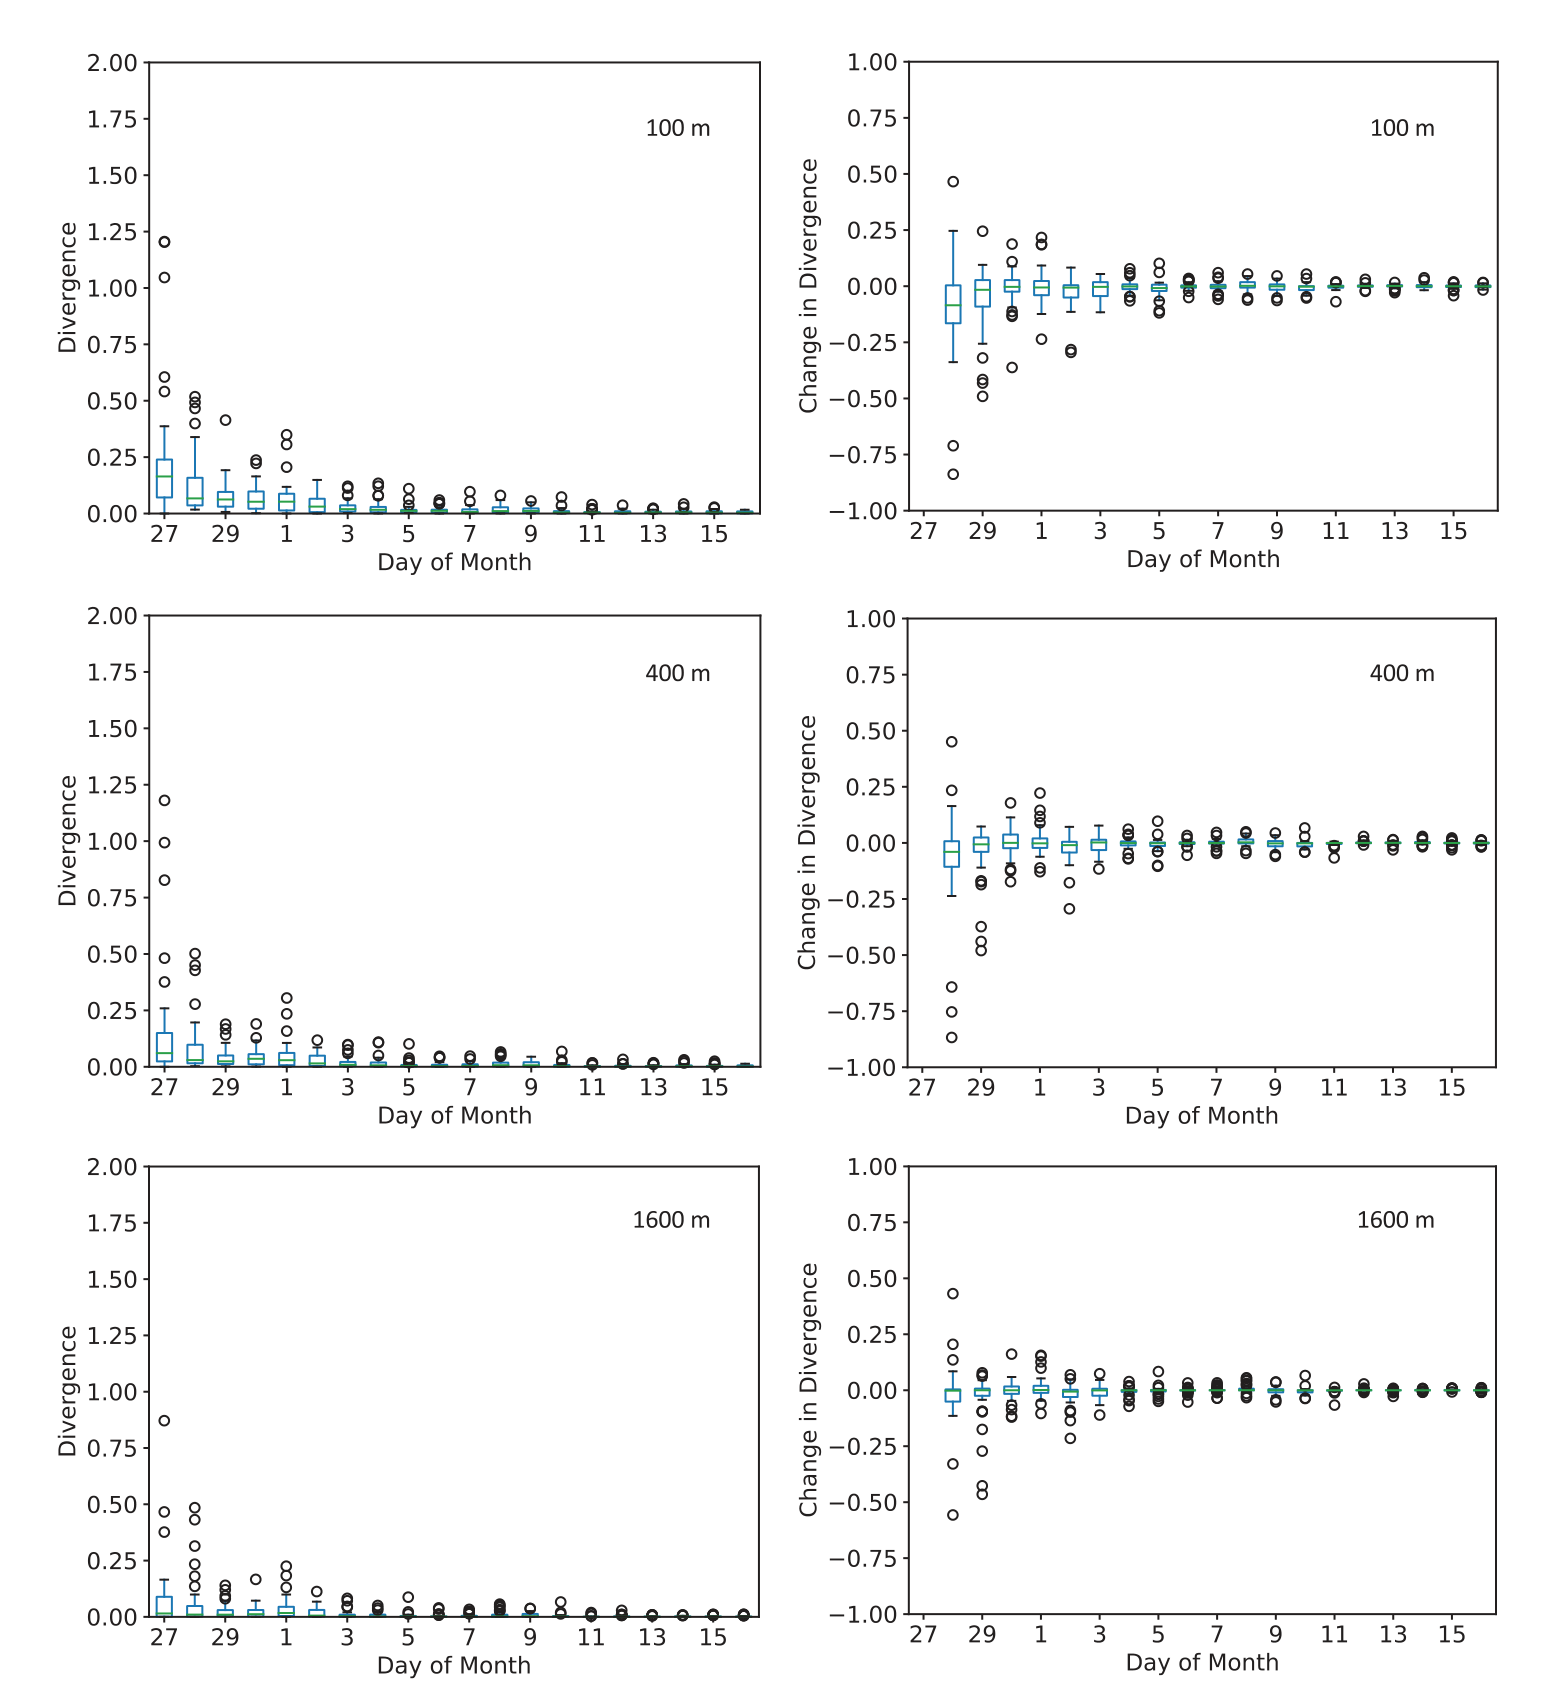
图 6|SHED8是否重复了同样的下降?
无字母子图。排列与图5相同,分母换成42人,日历从27日前后跨月。100米、400米、1600米的左列同样在最初几天下降,粗格子更早贴近0;右列的负向变化也集中在开头。早期离群点仍然存在。全体中位数下降的同时,仍有个别参与者在同一天保持较高散度。来源:原论文 Fig. 6。
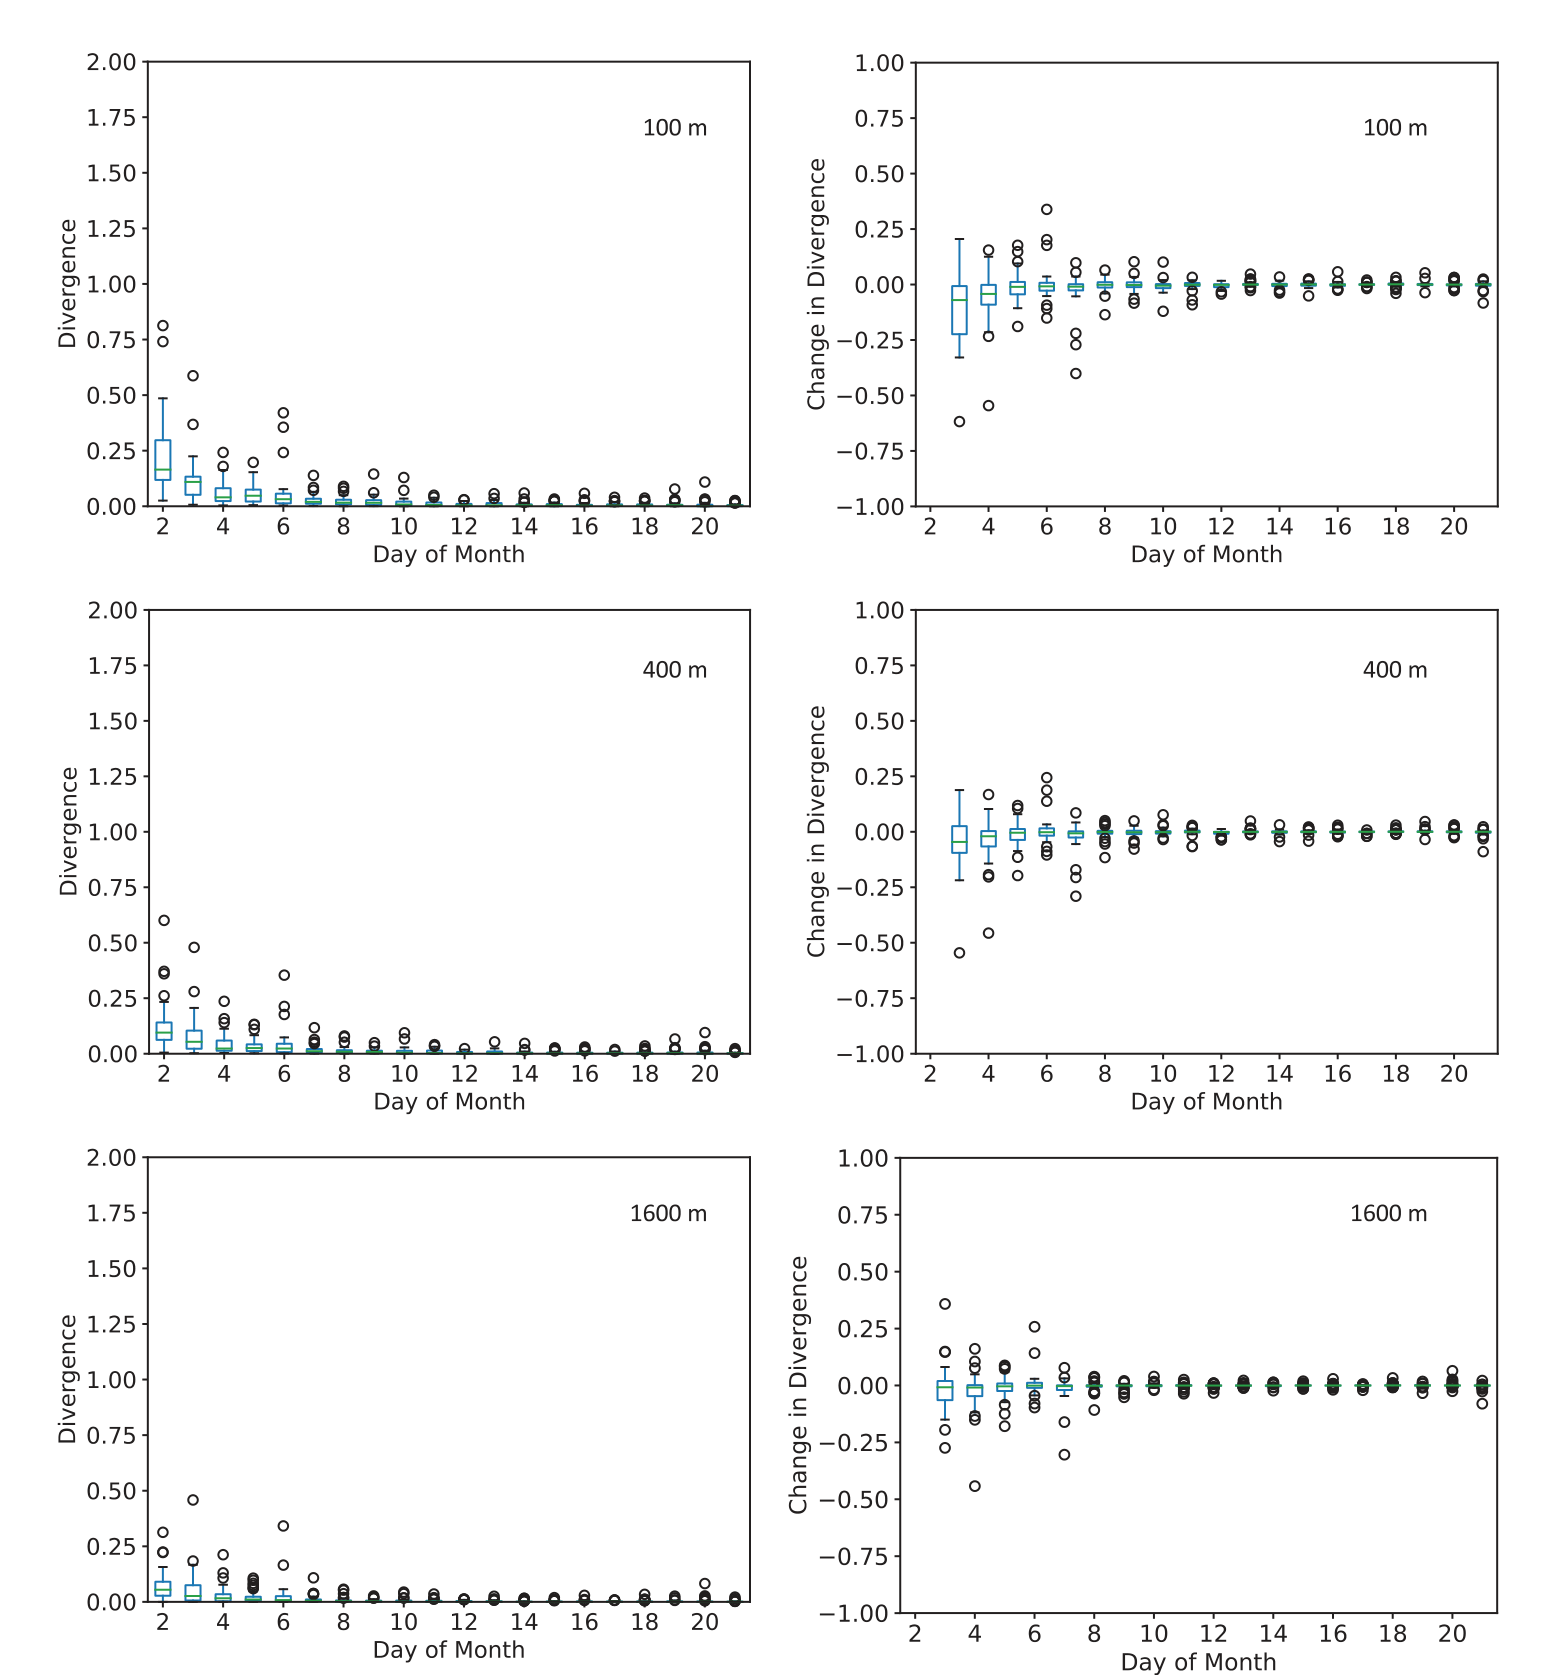
图 7|SHED9的起点为什么更低,结局是否不同?
无字母子图。排列仍与图5相同,分母为42人,日历从2日前后连续向后。左列开头的箱子低于图5、图6的对应位置,和正文所说SHED9的初始均值与方差明显更低一致;高于1的早期离群点也更少。三行仍然落到接近0,右列在第一周之后挤在0附近。起点更低,并不变成另一种收敛日期。来源:原论文 Fig. 7。
正文给出的时间是:散度达到小于0.1,100米在两周内,400米在12天内,1600米在8天内。讨论里的说法更粗:这些人群至少一周后已经足够定位,两周后接近完全定位;两周以后,额外测量对最终的空间直方图影响很小。摘要则写成少于14天。这些句子都指向同一批箱线图,严格程度并不相同。0.1是预先写明的操作阈值,图上没有显著性星号。组间差异主要在开头的均值、方差和离群点,SHED9更低;三组走到“很低的散度”所用的时间被作者称为大体相同。
粗格子下降更快,也有一个直接的计数原因。格子越大,一个人可能落入的状态越少,直方图里的信息越少,起始散度往往更低。锚点假说在这里被用来理解:大多数移动集中在少数稳定地点,格子变大以后,收敛仍落在几天到两周这一段。作者也预期,当多数行为被少数格子吞并时,散度可能出现阶段性变化。因为时间步长已经是天,比一天更碎的行为在进入散度之前就被合计掉了。周末第一次被观测到,会在各种格子尺寸上同时出现。格子大小改变的是这一事件占多少概率。周末是否到来,与格子尺寸无关。
平均散度为什么接近天数分之一?
作者把每个数据集、每种分辨率上全体参与者的逐日平均散度交给Eureqa做非线性回归。三组都得到同一类简单关系:
x̄(t) = A / t
x̄(t)是第t天全体参与者散度的平均值,t从1到T。A在每组和每种分辨率上各估计一次。t增大一倍,这条曲线上的平均散度减半。
| 数据 | 参数 | 100米 | 400米 | 1600米 |
|---|---|---|---|---|
| SHED7 | A | 0.307 | 0.206 | 0.144 |
| SHED7 | R² | 0.955 | 0.873 | 0.879 |
| SHED8 | A | 0.253 | 0.154 | 0.0738 |
| SHED8 | R² | 0.943 | 0.833 | 0.941 |
| SHED9 | A | 0.215 | 0.128 | 0.0738 |
| SHED9 | R² | 0.976 | 0.960 | 0.898 |
A越大,同样的天数上平均散度越高。表3里100米的A都高于同组的400米和1600米,和箱线图里细格子下降更慢一致。R²从SHED8在400米的0.833到SHED9在100米的0.976。论文写明,非线性拟合的R²要谨慎使用,它只是拟合质量的一个标志。SHED8和SHED9在1600米的A都印成0.0738,这是表上的相同小数,正文没有再解释成两组机制相同。
若把 A/t 沿时间积分,得到对数曲线。作者把这条积分理解为每一天测量带来的累积信息。观测时长每增加一倍,对数积分增加的量相同,所以要再得到同样一份累积增益,需要把时间加倍。这是“多测一天,收获更小”的一种定量说法,依据是这三组人的拟合。箱线图没有另外给出逐日积分的实测表。
直方图稳定了,研究问题就回答了吗?
这个指标回答的是活动空间摘要在观测日之前有多完整:再加入一天,地点概率还改写多少。它同时留下几道边界。
它描述的是这段采集窗口里的精度。作者举的例子是,一个人在夏威夷度假两周,活动空间可以收敛到一个很精确的值,那张图描述的是度假时的地点;同一个人在特拉华的家中,会是另一张图。研究要自己保证窗口就是关心的情境。SHED7碰上游戏上线,SHED8的公交中断没有发生,SHED9有天桥关闭。三条曲线都在下降。游戏上线、未发生的公交中断和天桥关闭仍是采集背景,论文没有估计它们各自对散度的影响。
样本是萨斯喀彻温大学社区,年龄和身份偏向二三十岁的学生,性别偏向女性,其中还有住校学生。作者认为,对北美其他中等大学城的学生,出现类似收敛是合理预期;更一般的人类空间行为,不能由这批数据推出。他们预期出租车这类更常移动的对象会收敛得更慢、基线波动更大,并把这件事留作以后的工作。萨斯卡通的观测里,有意义的活动没有超出城市建成范围。城市范围、形状、人口密度和基础设施会怎样改变收敛,正文提出了问题,没有在别的城市检验。
0.1是作者按这批数据设定的操作阈值,正文没有配显著性检验。粗格子更快,一部分来自可能状态变少。一个人若几乎不移动,散度可以立刻是0;一个人若总去新格子,散度仍会变慢地下降。读“两周够了”时,要连同格子尺寸和这个人的锚点是否稳定一起看。
右列那些衍生读法,包括收敛有多快、最后停在多高、停住之后的方差有多大,作者认为以后可以用来描述习惯有多规律、空间占用有没有漂移、以及例行波动有多小。他们同时写明,这些读法还没有被验证,绝对含义也还没有建立。本次数据里,收敛之后的散度很小,方差也小,这和相对规律的学生生活相符。要把它当成标定好的标尺,还需要论文所写的后续验证。
KL也不直接回答暴露、设施可达或病原接触够不够。它回答的是继续测量还能不能给这张累积直方图增加信息。特定应用要不要停,还要另选指标。其他非参数比较,例如Kolmogorov–Smirnov检验或直方图的平方距离,正文没有并行计算。原始直方图也没有先做空间平滑。
一句话总结
对这三组萨斯卡通大学社区参与者,100米到1600米的累积地点直方图都在不到两周内把新增信息降到作者设定的0.1以下,格子越粗越快;这个“够”衡量的是该观测窗口里的信息增量,窗口和人群一换,天数就要重新估计。
核心来源
- International Journal of Geographical Information Science论文页面,核对题目、作者、在线发表日期与DOI。本文依据该刊2018年4月25日在线发表版,使用正文图1–7和表1–3。
- 文中用来对照的天数研究:Tudor-Locke等,2005,成年人计步器;Hart等,2011,老年人的加速度计、计步器和活动日志。二者估计的是身体活动指标需要几天。地点直方图的天数由本文另行计算。
- 活动空间与锚点的概念来源,按论文引用包括Hägerstrand 1975、Couclelis等1987、Golledge等1995。移动熵的对照来自Song等2010年发表在Science的可预测性界限。
作者介绍
四位作者的介绍只采用论文署名、资助说明和正文能够核对的相关研究。
- Kevin Stanley:萨斯喀彻温大学计算机科学。SHED数据采集的参与者;论文引用了Knowles、Stanley与Osgood 2014年关于健康相关行为数据的采集架构,以及Stanley等人2016年用数字遥测观察公交中断的研究。
- Eun-Hye Yoo:布法罗大学地理系,署名第二作者。资助说明把美国国立卫生研究院国家普通医学科学研究所项目5R01GM108731标为授予第二作者。正文引用Yoo等人2015年按活动估计个人空气污染暴露的工作。
- Tuhin Paul:萨斯喀彻温大学计算机科学。论文把SHED8写成Paul等人2016年人类移动分布标度研究的后续。
- Scott Bell:萨斯喀彻温大学地理与规划,通讯作者。论文引用了Golledge、Dougherty与Bell 1995年关于空间知识,以及Griffin与Bell 2009年关于信号检测和地理信息的工作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果研究真正要看的是一座关闭的天桥、一条公交线路或一种污染物,全城格子的直方图先稳定下来,并不保证那个地点已经被访到足够多次。停止规则可以分成两层:一层看全体格子的KL是否落到事先声明的阈值以下,另一层看问题所指向的那些格子,访问次数是否还在明显增加。两层分别报告,才不会把“地图整体不再变”当成“关键地点已经测够”。
把“学生两周”抄到轮班、配送或跨城通勤上,会错过这批数据里锚点又近又稳定的条件。作者已经预期出租车会更慢。更稳妥的做法是在同一人群、同一格子尺寸上先做一段试点,公布到计划停止那天仍有多少人高于0.1,再决定正式采集停在第几天。0.1要随这批试点里的高散度重新取值。萨斯卡通用来参照的1,只属于那三组数据。
119人次还不能当成119段独立生活。三组日历不同,又共享一个未报告人数的重复参与者池,还分别叠着游戏上线、未发生的公交中断和天桥关闭。后续若要检验“两周”是否搬得动,至少应报告跨研究的重复人数,并在校园约束放松的人群里重新估计A。A若随人群和城市明显改变,两周就只是这三组学生的时间尺度。