早高峰出行最集中,汇散热点为什么反而更少?
论文名片|Xiping Yang、Zhiyuan Zhao、Shiwei Lu,Exploring Spatial-Temporal Patterns of Urban Human Mobility Hotspots,Sustainability,2016,8,674。2016年5月8日收稿,7月5日接收,7月16日发表。DOI:10.3390/su8070674。本文依据这一正式发表版。研究类型是对一个工作日手机基站记录的观察描述。
工作日早上七点到九点,深圳有很多人离开住处、走向就业地。若把热点理解成人多的地方,这段时间全城的热点应该最多。这篇论文换了一个数法:看每个基站在两小时窗口里是净进入还是净离开,再在连续的密度面上找比周围更高的峰和比周围更低的谷。这样数出来的峰和谷,在通勤时段、尤其是早高峰,反而少于一天里的其他时段;靠近午夜时,彼此靠近的局部热点很多。
方向先说清楚。热点个数少,说明移动挤在少数地方,不说明这段时间出门的人少。把这些峰和谷按一整天的强弱变化分成六类后,城南商业中心和城北的工业、居住区并不是同一种昼夜节奏。功能区与这些节奏在地图上重合,是空间对应,不是用地造成流动的实验证明。
先说结论
- 汇聚热点是净流量密度面上的局部峰,发散热点是局部谷。净流量是一个基站在某个两小时窗口里的流入减去流出。比较对象是邻近位置,不是全城总人数。
- 早高峰窗口 T8(7:00–9:00)、搜索带宽 1000 米、分级数取 9 时,汇聚热点 53 个、发散热点 60 个。分母是这一个窗口里找到的局部极值个数。同一窗口把分级数从 5 调到 15,发散热点从 27 个增到 88 个;汇聚热点从 12 个增到 79 个后,在 15 级变成 78 个。
- 全天 23 个重叠的两小时窗口里,通勤时段的热点个数少于其他时段,早高峰尤其少,午夜附近很多而且更碎。12:00–14:00 发散热点明显多于汇聚热点。论文没有给出这条曲线每个点的数值表。
- 按 23 步的分级时间序列聚类,得到六类平均节奏。北部的就业集中区与居住区大致早晚对调;南部商业中心白天强汇聚,靠近它的居住区白天强发散。城市边缘的一类全天都是正值。
- 图 9 的图例把负的分级标成汇聚、正的分级标成发散,与正文定义和图 4 相反。按正文读,正值是汇聚,负值是发散。图 9b 里,商业中心类在早高峰达到图例最红的一档,邻近居住区的早高峰达到最蓝的一档。这两档是分级,分母不是人数。
这里的热点,是净流量比周围高,不是人比周围多
研究区是深圳,论文给出的面积约 1996.85 平方千米。它引用《深圳统计年鉴 2013》,写当地人口密度为每平方千米 5282 人,并称这是当时中国城市中的最高密度。这个密度的分母是土地面积,来自年鉴,不是手机记录算出来的。
手机记录来自中国移动,覆盖 2012 年一个典型工作日里 1600 万用户的踪迹。论文写这家运营商约占当地移动用户市场的 60%。60% 是运营商的市场份额,1600 万是这一天数据集里的用户数,两者都不是城市常住人口,也不能当成全部居民的出行。运营商原来以约一小时一次的间隔记录手机所连接的基站,用于故障排查。作者拿到数据之前,用户编号已经加密。每条记录是时间以及基站的经纬度,不是这个人站在地面上的精确坐标。从中整理出 5940 座基站。
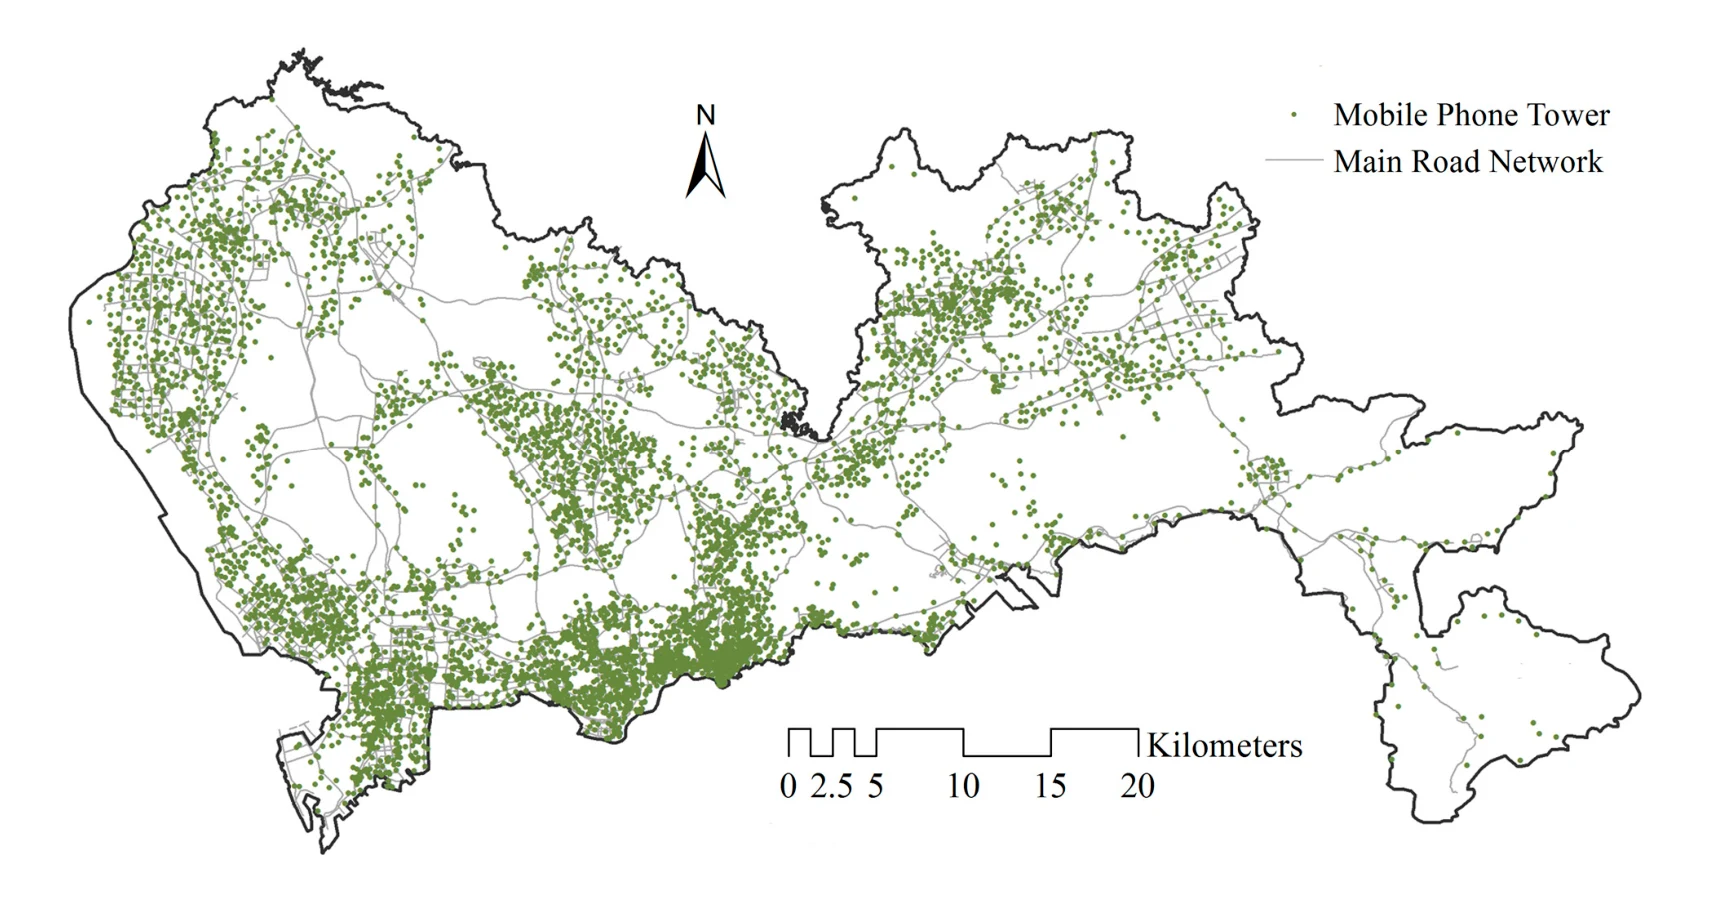
图 1|这些基站在深圳怎样分布?
绿点是手机基站,灰线是主要道路,比例尺以千米计。基站在南部和主要道路附近更密,东部和北部更稀。后面所有峰和谷都从这些点的净流量长出来,所以南部更容易出现细碎的局部结构。来源:原论文 Fig. 1。
另一个底图是城市功能区。论文参照《深圳市城市总体规划(2010–2020)》,把土地利用收成十类:行政、商业、工业、居住、教育、交通、旅游、体育、水域和其他。后面用它解释六类节奏落在什么地方,不把它当成流动的原因。
一个基站在某个时段的净流量(netflow),就是流入人数减去流出人数。论文把相邻两次小时记录之间基站发生变化的移动,计入由这两个小时合成的窗口。第 j 个窗口覆盖 (j−1):00 到 (j+1):00。因此 T1 是 0:00–2:00,T8 是 7:00–9:00,一天一共 23 个窗口,不是 24 个互不重叠的小时。相邻窗口共用一个小时,时间曲线会比按整点切开的统计更平滑。净流量为正,表示这个基站在该窗口里人数增加,论文称为汇聚状态;为负,表示人数减少,称为发散状态。
汇聚热点(convergent hotspot)是净流量相对邻近位置更高的地方,发散热点(dispersive hotspot)是相对邻近位置更低的地方。人可以很多,只要周围也一样多,这里就不是热点。反过来,一个不太大的净流出,只要比周围更低,也可以成为发散热点。
峰和谷是在哪张面上找的?
直接在 5940 个基站上比大小,近处的基站会互相遮挡,也画不出连续的高低。论文把全市分成 100 米乘 100 米的格子,用核密度估计(kernel density estimation,KDE)把基站净流量摊到每个格子上,得到一张可正可负的密度面。带宽越大,越远的基站也参与这个格子的取值。实际计算用了哪一种核函数,论文没有写明。
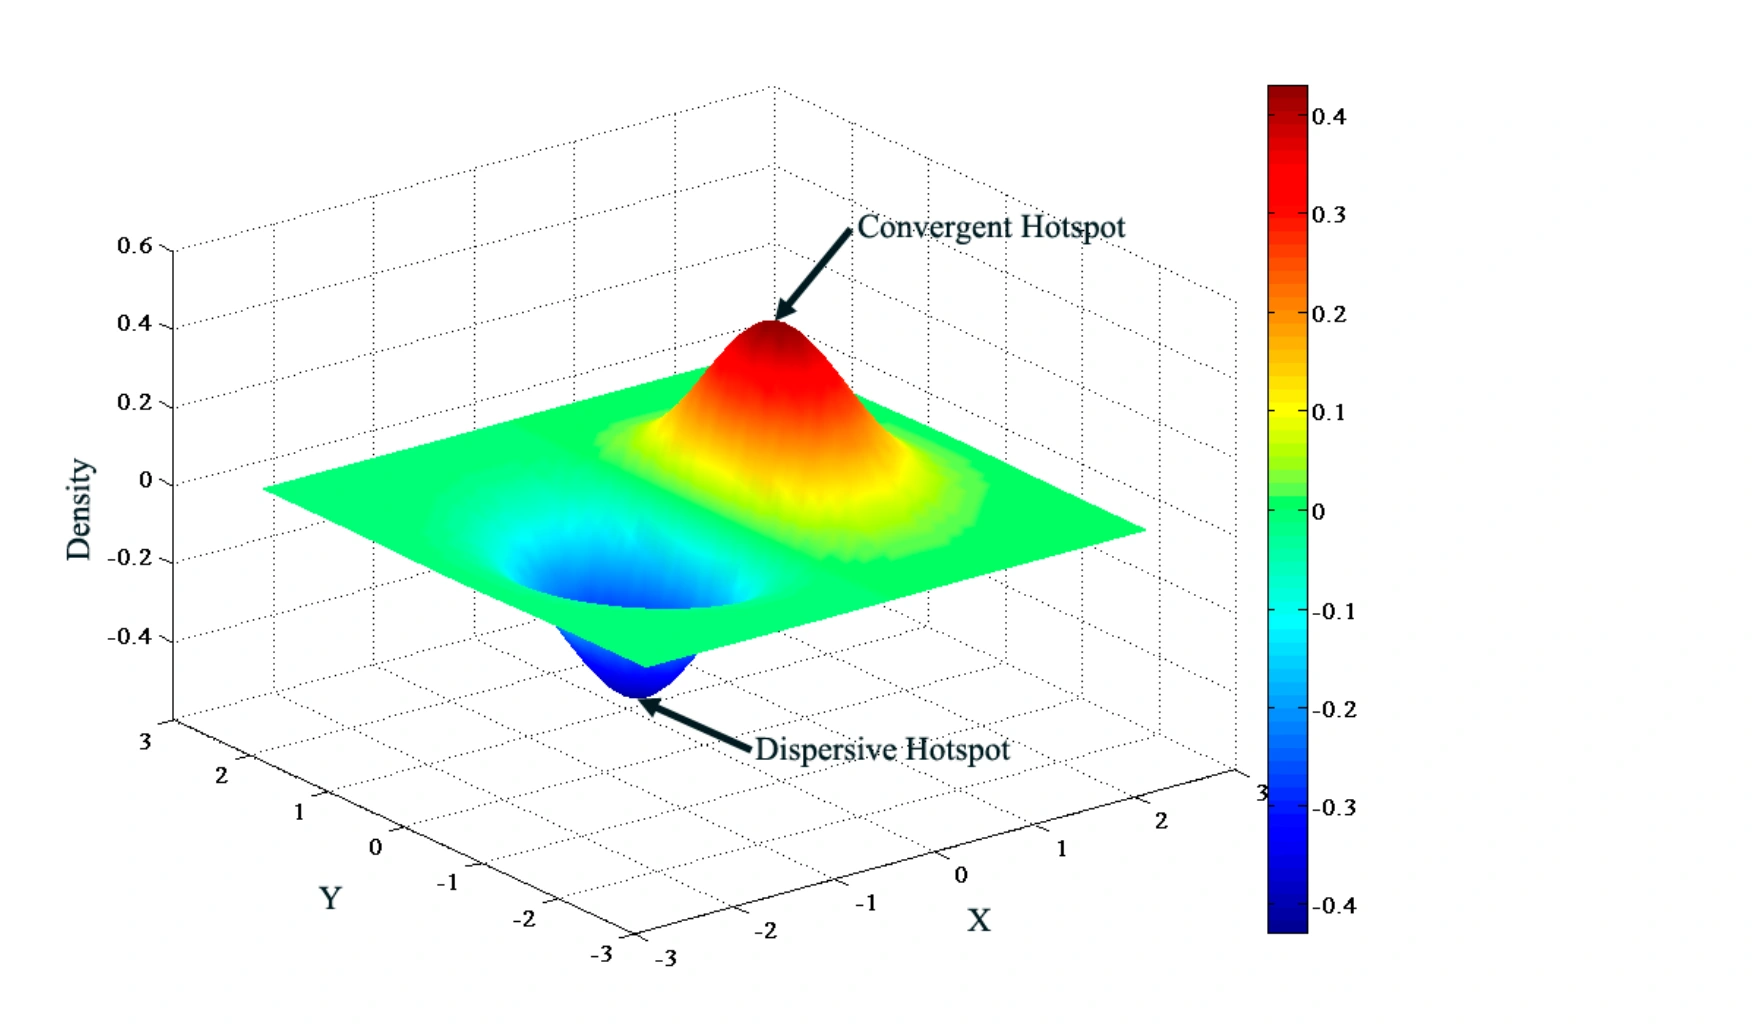
图 2|峰和谷在这张面上各指什么?
这是一张用来说明定义的高斯密度面,不是深圳的实测。纵轴是密度,颜色从约 −0.4 到 0.4。红色凸起标为汇聚热点,蓝色凹陷标为发散热点。它只固定“峰对汇聚、谷对发散”这件事,不能从色标读出深圳有多少人。来源:原论文 Fig. 2。
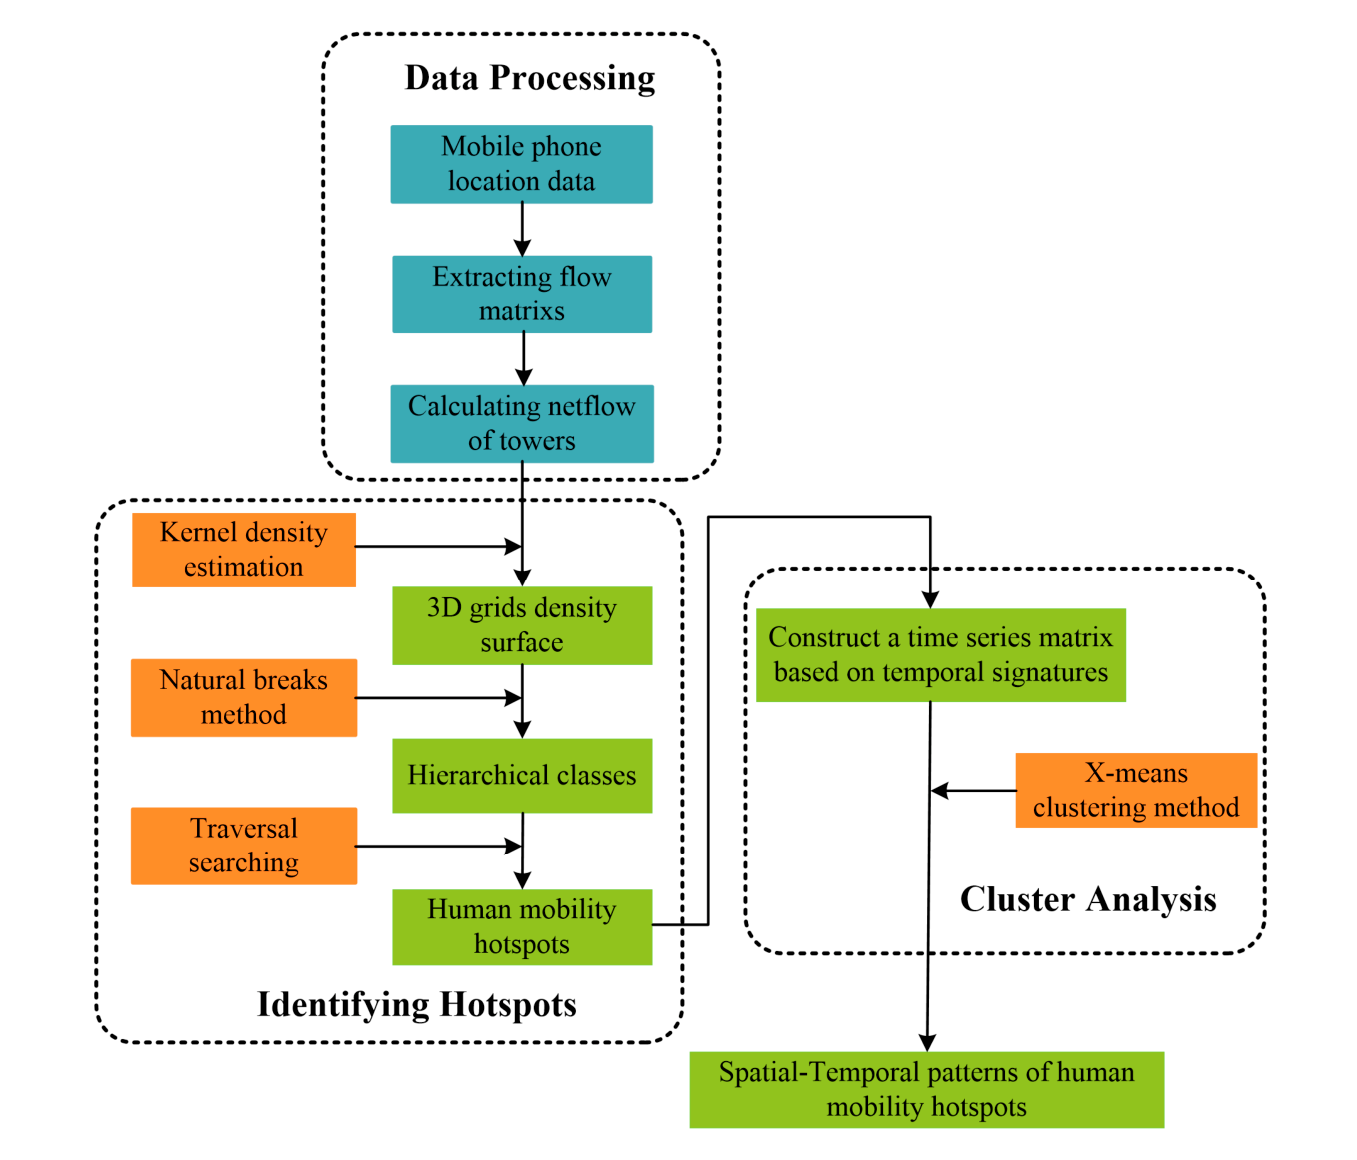
图 3|从基站净流量到六类节奏,中间经过哪些产物?
左侧先把手机定位整理成流量,再算出各基站净流量。中间用核密度得到三维密度面,用自然间断点做成分级,再取出人类移动热点。右侧把这些热点的分级排成时间序列,用 X-means 聚类,得到时空格局。图上没有搜索半径、分级数和类别个数。来源:原论文 Fig. 3。
带宽按试算选择,比较了 250、500、750、1000、1250 和 1500 米。250 米接近基站的平均最近邻距离 246.7 米,这个距离的分母是基站之间的最近距离,不是出行距离。论文写,750 米及更短会过于贴着基站本身的分布,1250 米及更长又过平滑,北部一些局部高低会被抹掉。他们之后固定用 1000 米。这是在平滑和局部之间的判断,不是一个由统计检验唯一决定的最优值。
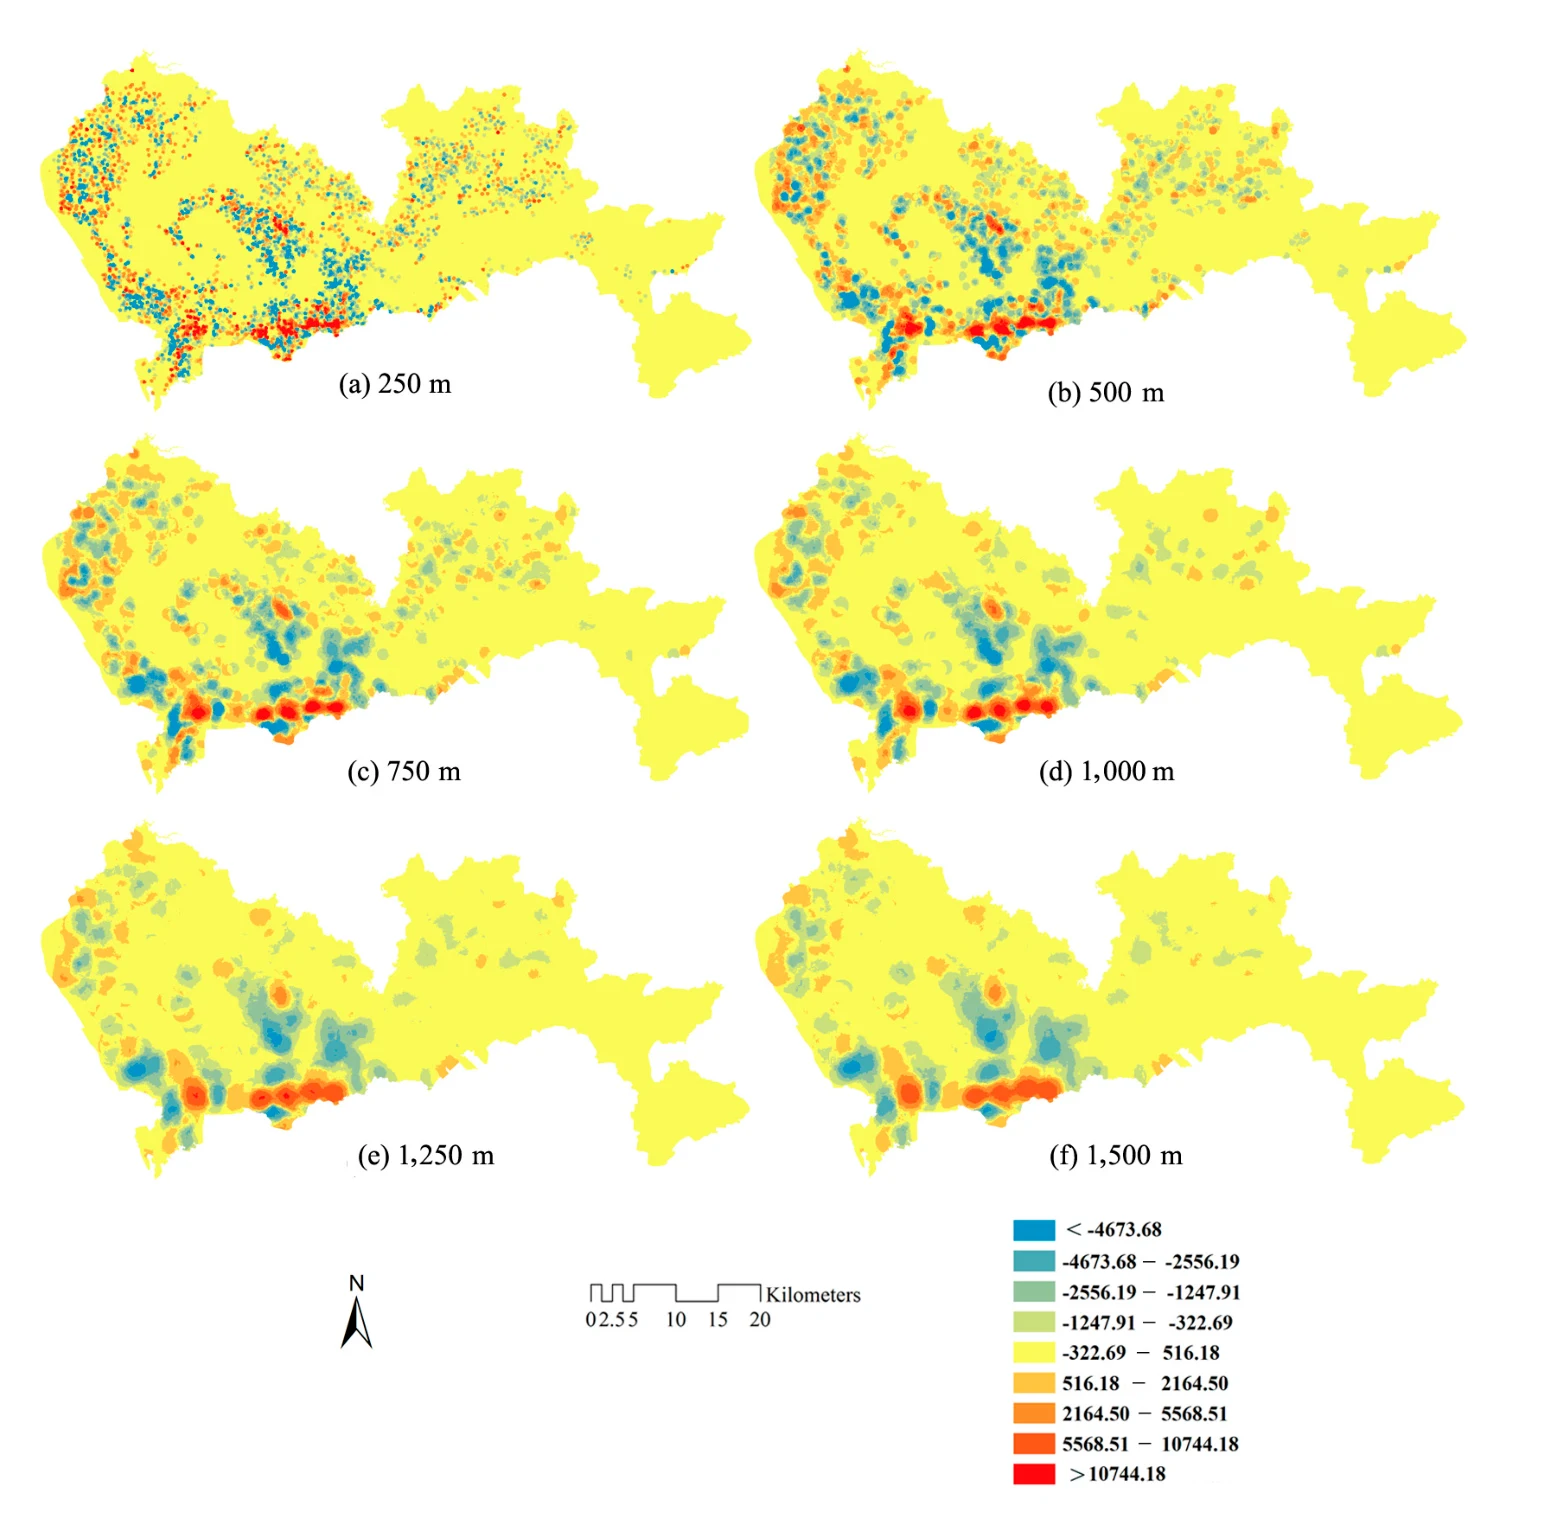
图 5|带宽变长以后,密度面损失了什么?
(a)250 米、(b)500 米、(c)750 米的表面仍很碎,红点和蓝点贴近基站的疏密。(d)1000 米保留了南部沿边的成片高低,北部也还看得到局部蓝区。(e)1250 米、(f)1500 米进一步连成大块,北部的局部结构更少。六幅图共用一套分级。图例最蓝的一级小于 −4673.68,最红的一级大于 10744.18,黄色跨过零,范围是 −322.69 到 516.18。这些是核密度分级,不是人数。来源:原论文 Fig. 5。
连续的密度面仍不方便规定“多高才算一座峰”。论文用自然间断点法(natural breaks)把格子按密度的统计差异分成若干级,使级内更齐、级间更开。分级数记为 BreakNum。因为密度有正有负,他们只试了 5、7、9、11、13、15 这些奇数,希望正负两侧大体对称。跨过零的那一级记为 ClassNum 0,表示净流量在这一级里不明显。全负的级取负号,全正的级取正号。绝对值越大,汇聚或发散越强。
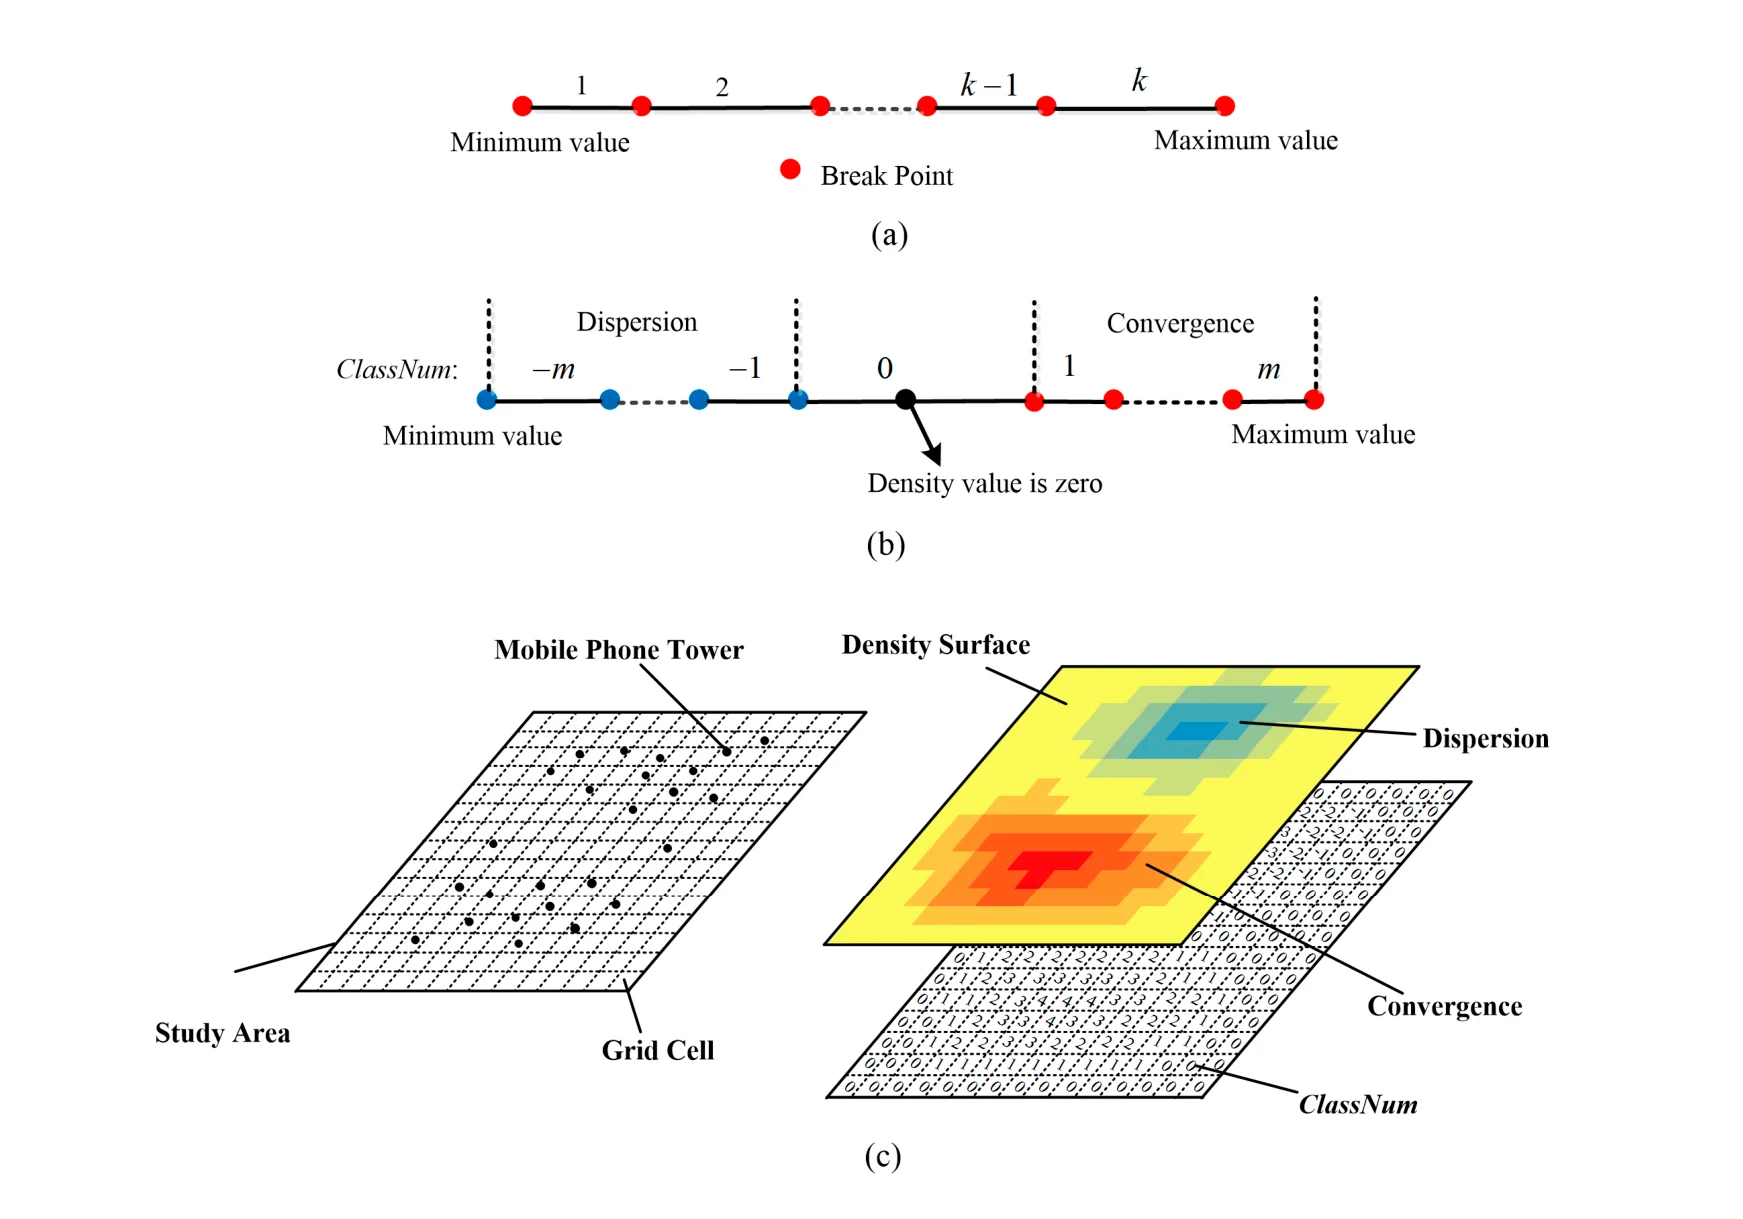
图 4|正负号在分级里怎样赋值?
(a)间断点把最小值到最大值分成 k 级,k 就是后面的 BreakNum。(b)负的一侧标为发散,零标在密度由负变正的位置,正的一侧标为汇聚。绝对值从 1 排到 m。(c)基站落在研究区的格子上,密度面的蓝区对应发散、红区对应汇聚,另一张面把同一套格子写成 ClassNum。读后面的结果时,以这一张图和正文为准:正是汇聚,负是发散。来源:原论文 Fig. 4。
每个窗口在分级后的面上取局部极值。正的极值是汇聚热点,负的极值是发散热点,绝对值表示该窗口的强度。参数试验放在 T8,也就是 7:00–9:00 的早高峰窗口,带宽已经固定为 1000 米。
| BreakNum | 5 | 7 | 9 | 11 | 13 | 15 |
|---|---|---|---|---|---|---|
| 汇聚热点 | 12 | 30 | 53 | 59 | 79 | 78 |
| 发散热点 | 27 | 48 | 60 | 65 | 75 | 88 |
表中每一格都是 T8 这一个窗口、1000 米带宽下的局部极值个数。分级数增加时,两类热点大体变多:原先不明显的区域、尤其是北部,会新冒出热点;已有的热点也会拆成两个靠得很近的极值。汇聚热点不是严格递增,13 级是 79 个,15 级是 78 个。论文选定 9 级,理由是再分更细就会带上很近的、以及他们视为不明显的热点。9 级因此是分析尺度,不是城市里客观存在的热点总数。
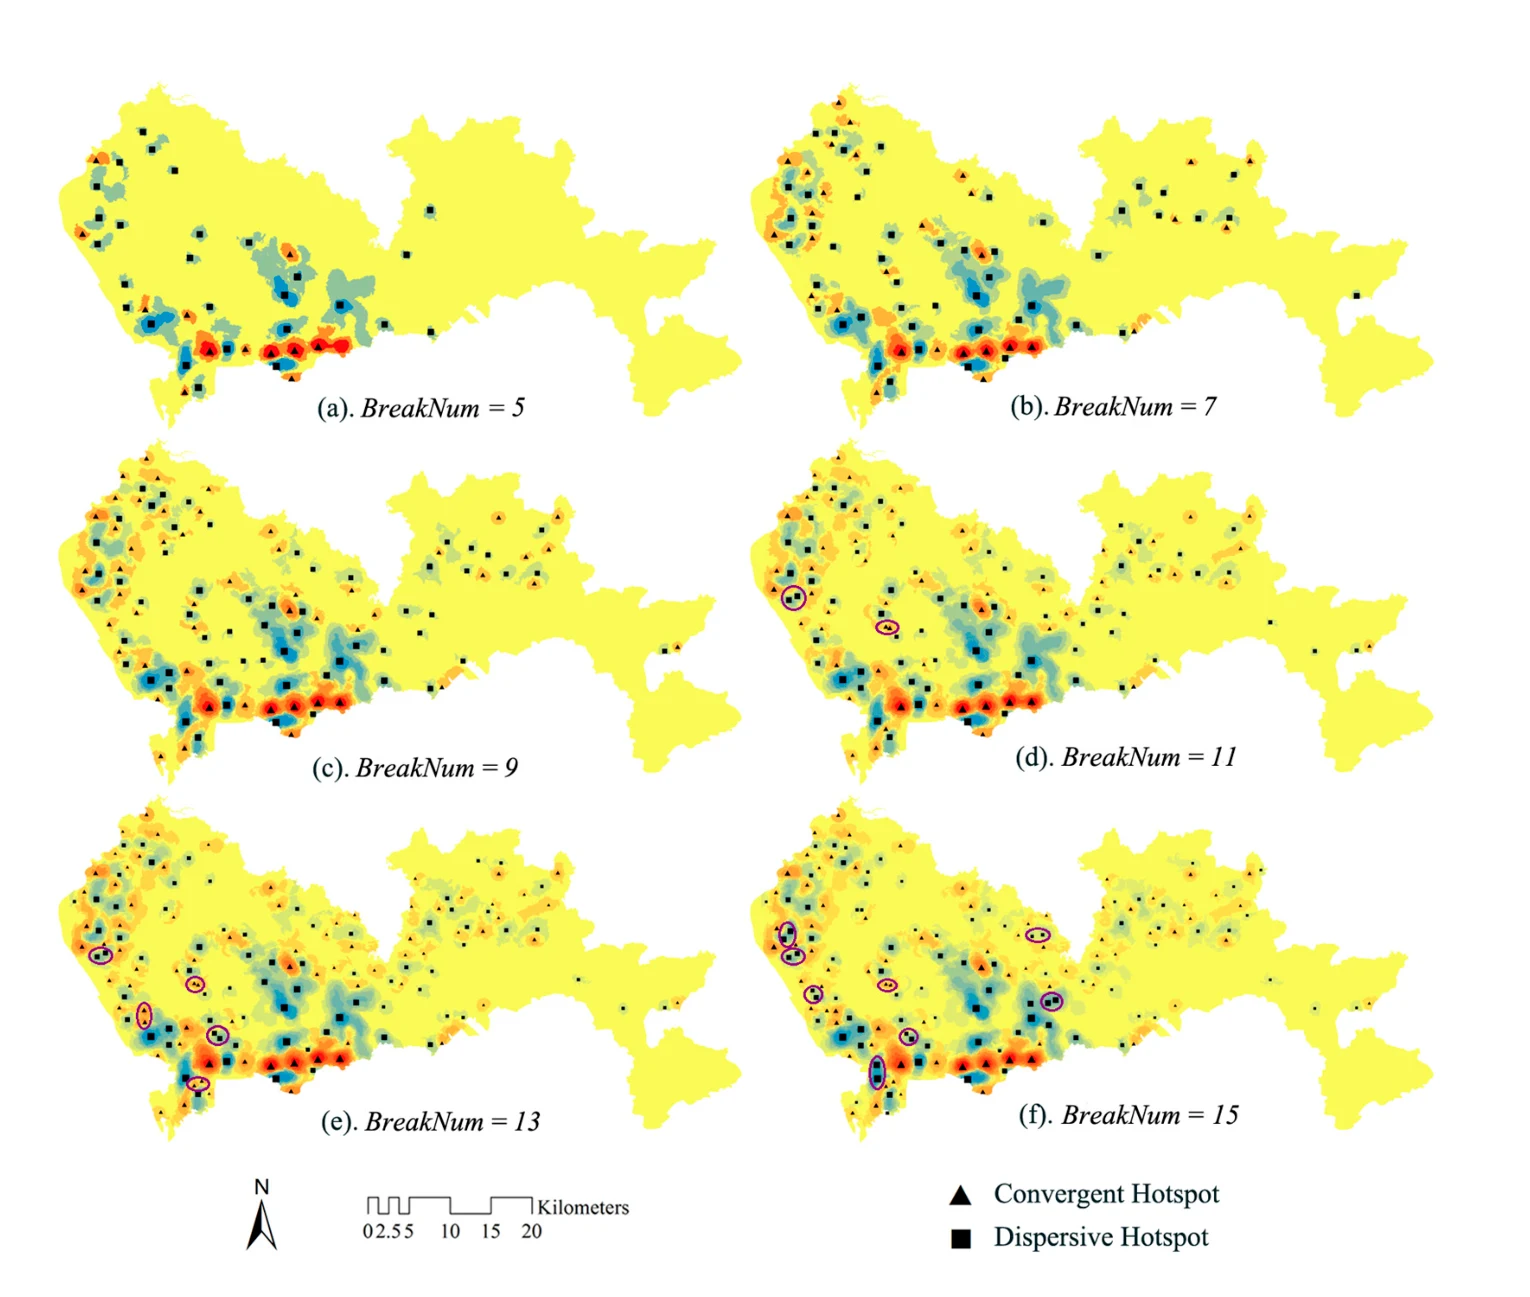
图 6|分级变细以后,热点增加在地图的哪里?
六幅图都是 T8。三角是汇聚热点,方块是发散热点,符号越大,该点的汇聚或发散越强。底图颜色仍是净流量密度。(a)5 级时符号少,主要留在南部沿边的强密度区。(b)7 级、(c)9 级后,北部和内部开始出现更多较小的符号。(d)11 级、(e)13 级、(f)15 级里,紫色椭圆标出靠得很近、开始拆开的局部热点。来源:原论文 Fig. 6。
通勤时段热点更少,数的到底是什么?
把 9 级用到全部 23 个窗口后,热点个数的昼夜变化和“高峰时段人最多”对不上。论文写,通勤时段的汇聚热点和发散热点都少于其他时段,早高峰尤其少;靠近午夜时热点个数高。12:00–14:00,发散热点明显多于汇聚热点。图 7 的纵轴是热点个数,横轴是第 1 到第 23 个窗口,但图上没有逐点标数,正文也没有另附 23 行计数。因此除了已经落在表里的 T8 以外,不把曲线上的高低读成精确整数。T8、9 级的 53 个汇聚热点和 60 个发散热点,就是这张曲线在早高峰窗口上的那两个点。
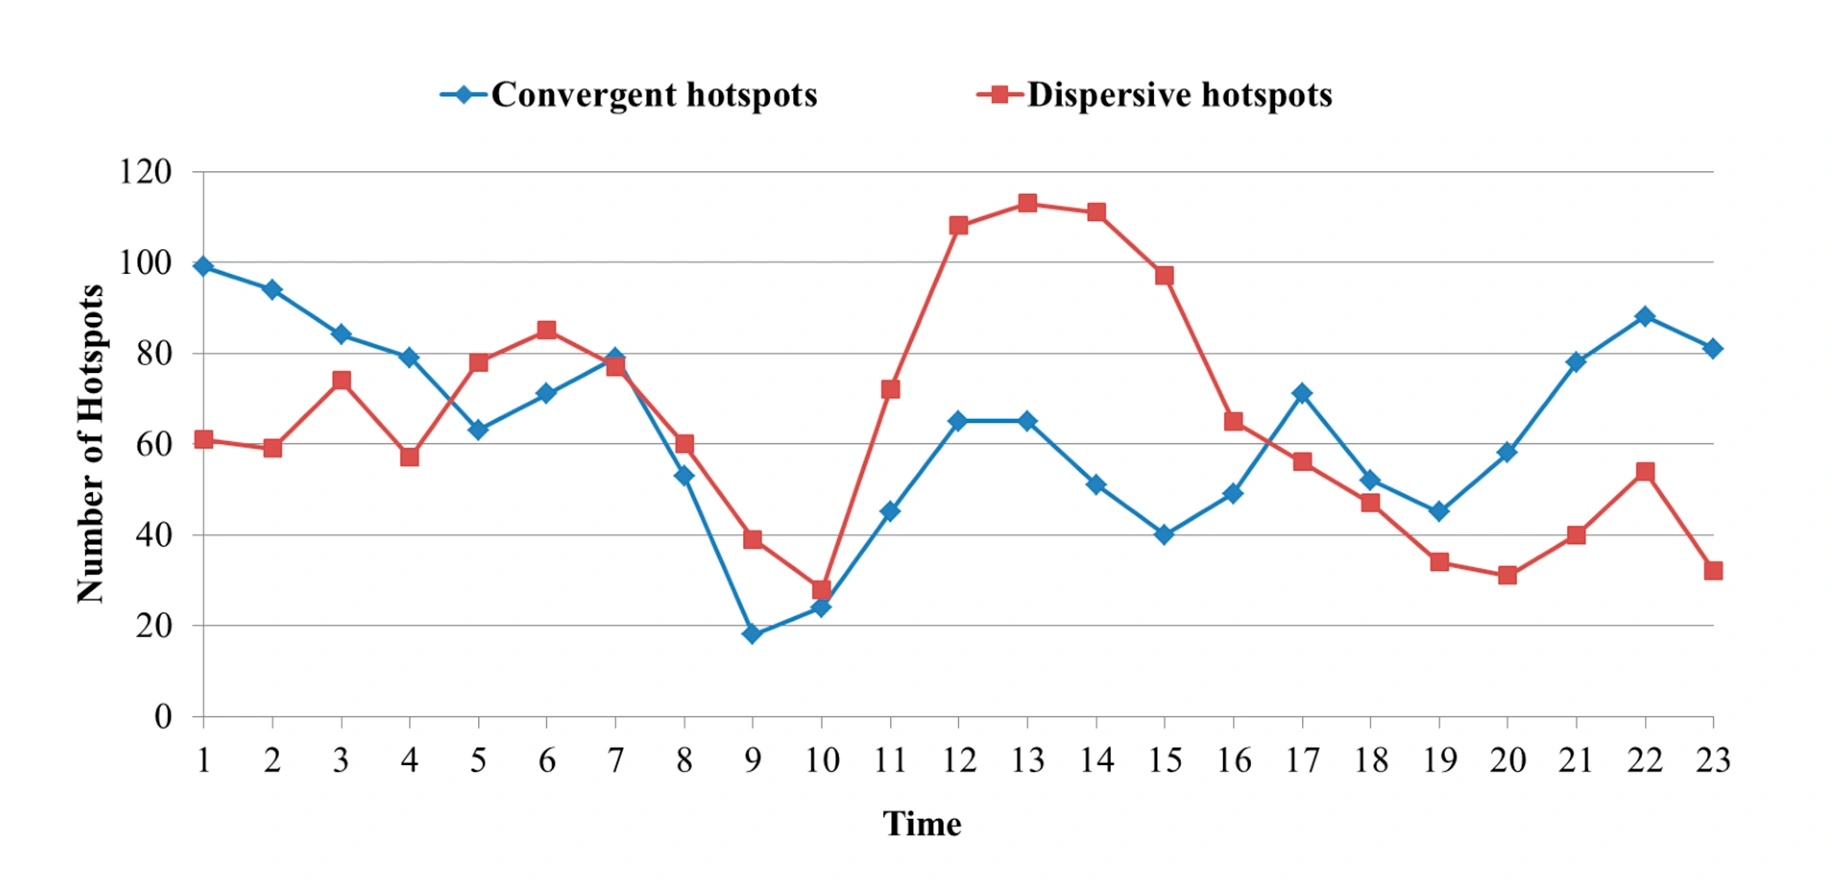
图 7|一天里哪类热点更多?
蓝线是汇聚热点个数,红线是发散热点个数,分级数为 9。横轴 1 到 23 是重叠的两小时窗口。早高峰附近两条线都降到全天的低位;午间红线升到明显高于蓝线的位置;接近午夜时蓝线又回到高位。纵轴最高刻度是 120 个热点,不是 120 万人。来源:原论文 Fig. 7。
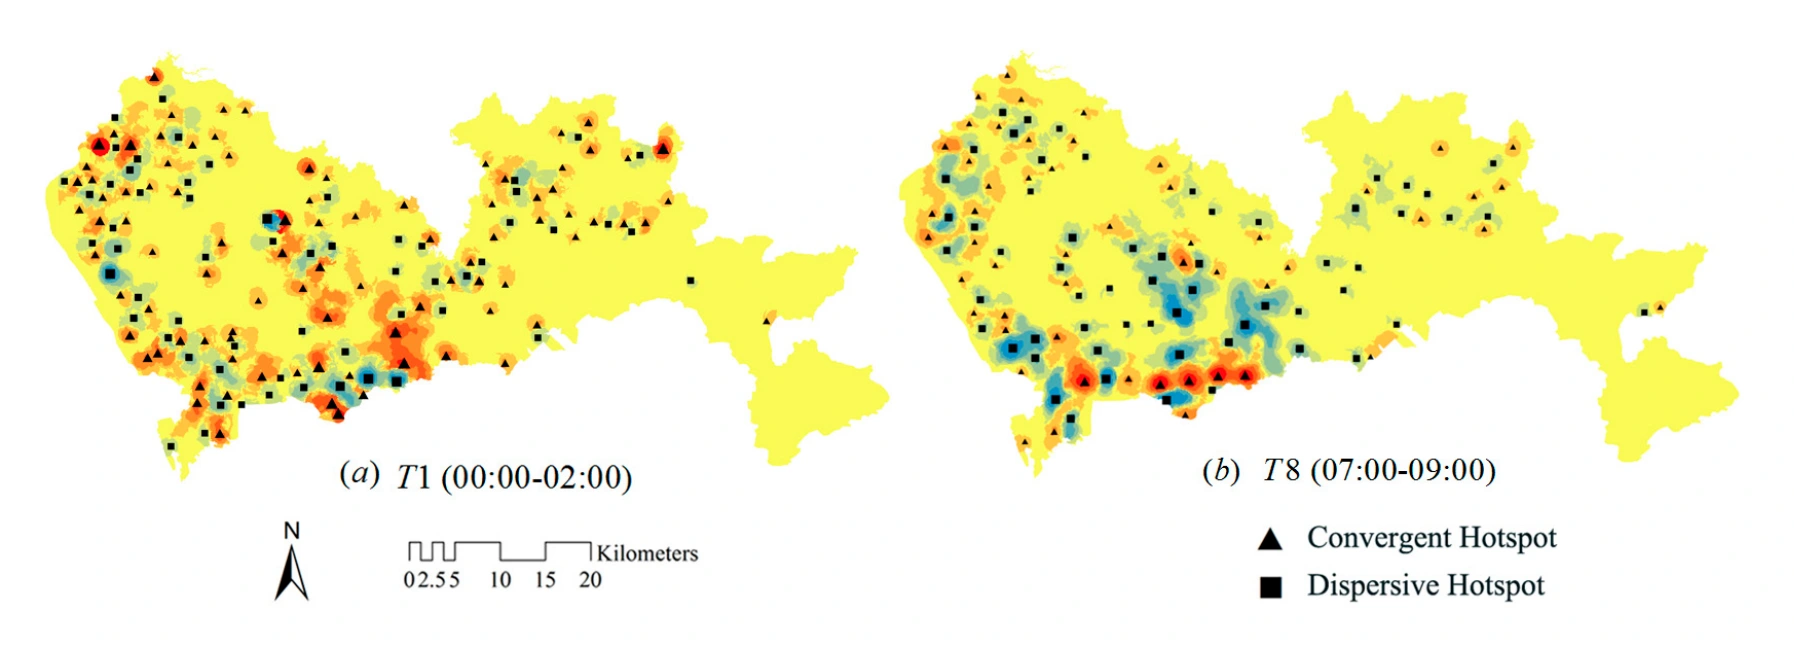
图 8|同样的分级,午夜和早高峰的热点有什么不同?
(a)T1,0:00–2:00。三角和方块又多又近,北部和西部都有成团的局部极值。(b)T8,7:00–9:00。符号少得多,较强的汇聚和发散更集中在南部和若干成片的区域。两幅图的符号含义与图 6 相同。来源:原论文 Fig. 8。
论文对这三条曲线给了解释,依据是节奏与功能区的对应,没有另附班次表、就餐调查或出行目的。午夜前后,人可以去做不同的事,热点因此散在若干休闲集中的地方。北部一些工业可能实行三班,时间被写成 0:00–8:00、8:00–16:00 和 16:00–24:00,换班窗口 T1 就会多出热点。早高峰里,多数人去上班或回家,峰和谷主要落在就业或居住集中的少数地方,极值个数就少。午间发散热点更多,被解释为住家和工地都有人出去吃饭,餐馆所在的地方才表现为汇聚。
所以早高峰热点更少,读法是:移动的目的更一致,局部峰谷更少、也更大片。它不读成早高峰的出行量更低。这篇文章没有报告各窗口的总出行人数,无法把热点个数换算成人数。
六类昼夜节奏和功能区怎样叠在一起?
每个曾经成为热点的格子,都有一串 23 步的 ClassNum。论文没有给出这样的格子一共有多少个。聚类只用这串时间序列,没有把格子之间的距离放进算法。算法是 X-means,用贝叶斯信息准则(Bayesian information criterion,BIC)自行决定类别数,在 WEKA 里运行。论文没有报告 BIC 的数值,也没有报告每一类有多少个格子。结果是六类,记为 C1 到 C6。
地图上,同一类的点往往靠在一起。这是聚类之后才看见的空间结果。论文的解释是:位置靠近的热点,时间节奏也更像。它不是“算法按距离分组”的证据。
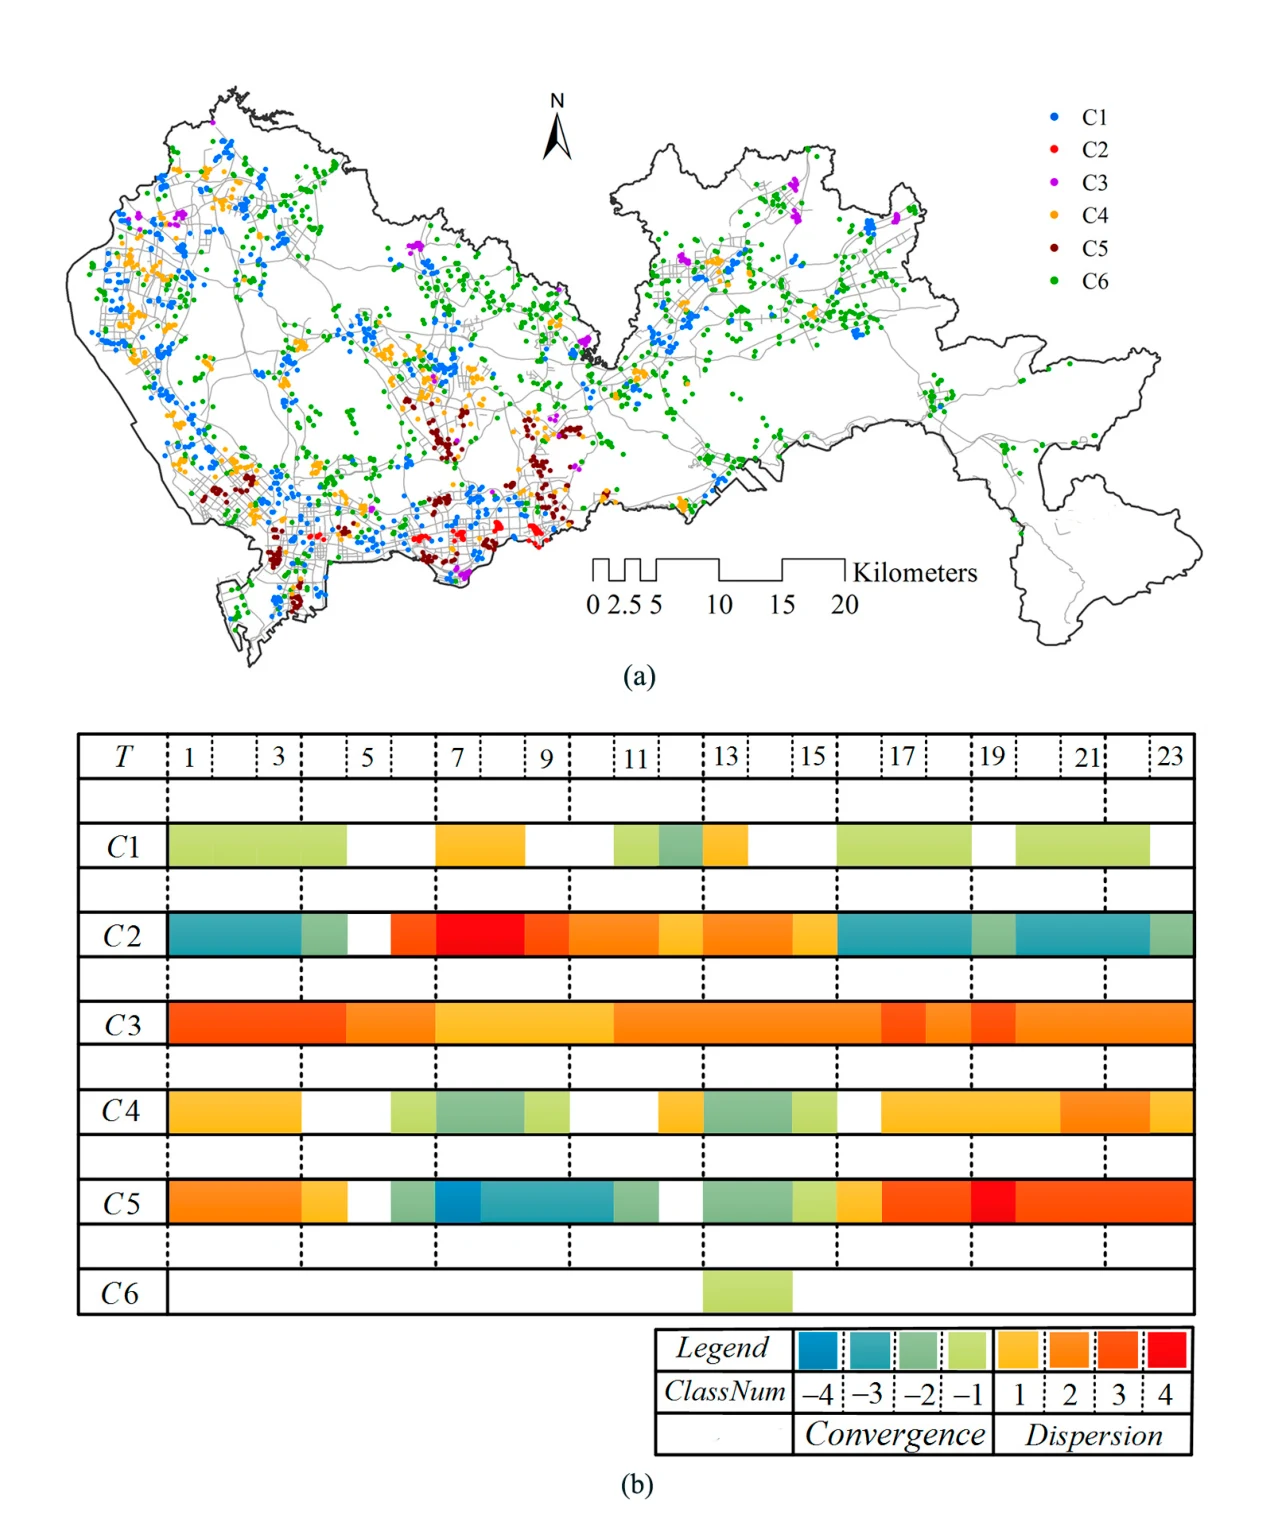
图 9|六类热点在哪里,一天里的正负号怎样变化?
(a)点是热点格子的中心。蓝为 C1,红为 C2,紫为 C3,橙为 C4,褐红为 C5,绿为 C6。C2 和 C5 集中在南部建成区,C3 多在外缘,C6 在北部和东部更散。(b)每一行是该类的平均时间模式。横轴只标出奇数窗口,空白表示 ClassNum 为 0。颜色从蓝到红对应图例中的 −4 到 4。图例把左侧负值写成 Convergence、右侧正值写成 Dispersion。这与正文和图 4 相反。下面各段按正文读:暖色、正值是汇聚,冷色、负值是发散。来源:原论文 Fig. 9。
按这个读法,图 9b 和正文的时钟能够对上。C1 在 6:00–9:00 对应的窗口是较弱的正值,16:00 以后多为较弱的负值;中午前后先出现负值,紧接着出现正值。C2 从接近 6:00 的窗口一直正到 15:00 前后,早高峰两个窗口达到图例里的 +4,其余时间多为 −2 到 −3。C3 的 23 个窗口全部为正,强度在 +1 到 +3 之间。C4 在 6:00–9:00 为负,早高峰窗口到 −2,17:00 以后转正,晚间部分窗口到 +2。C5 与 C2 方向相反,白天为负,T7 达到 −4,其他时间转正,晚间有一个窗口达到 +4。C6 的 23 个窗口里,只有第 13 和第 14 个是 −1,其余为 0。第 13 个窗口是 12:00–14:00,第 14 个是 13:00–15:00。这些等级是平均色条在图例上的位置,不是每一座热点的人数,也不是论文在正文里印出的小数。
功能区用同一套颜色画在后面几张图上:行政为品红,商业为红,工业为棕,教育为深蓝,居住为黄,交通为灰,体育为暗蓝,旅游为绿,水域为蓝,其他为浅绿。
C1 的节奏是早晨进入、傍晚离开,中午先离开再回来。论文写这些热点主要落在工业、行政和教育用地,北部工业园尤其多,中午的来回被联系到吃饭或购物。黑点在北部更集中,南部和西部也有分布。
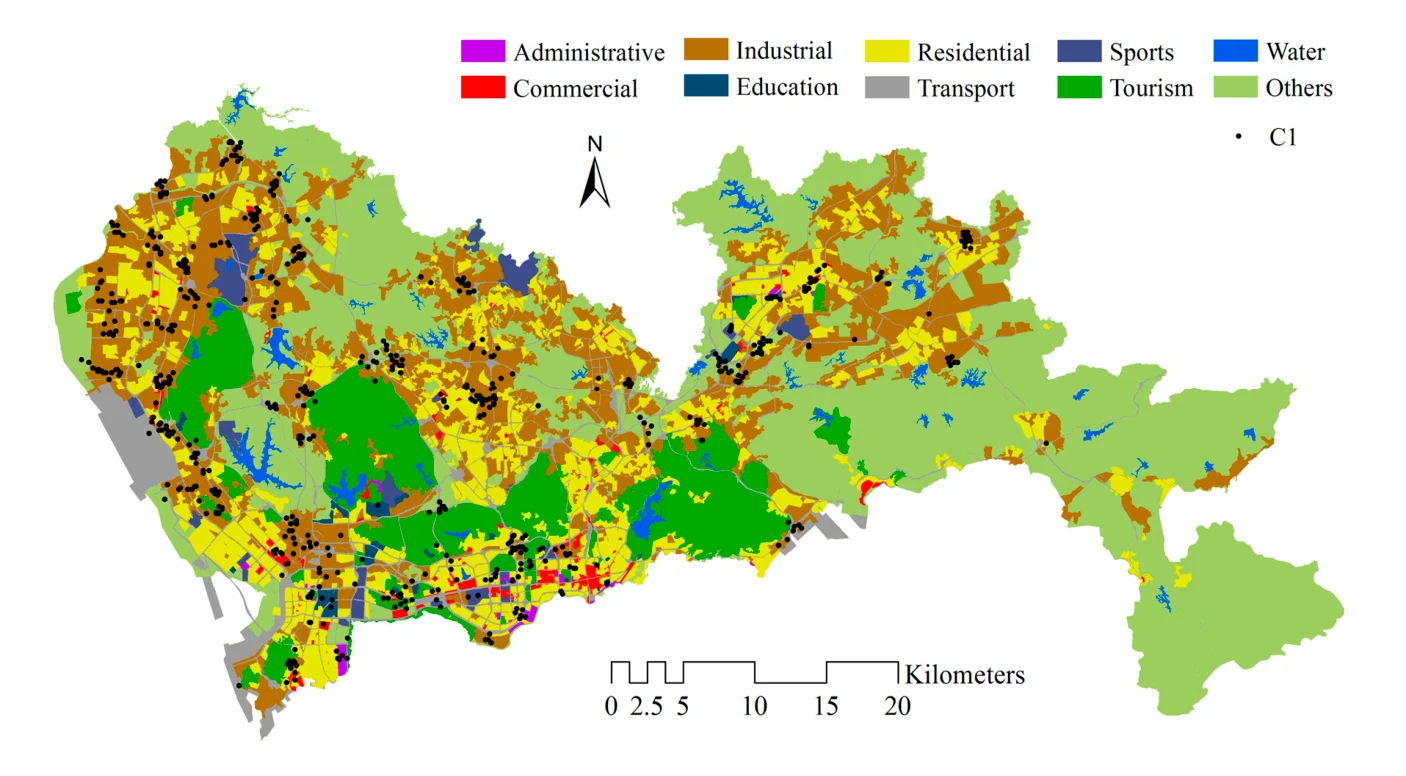
图 10|C1 的黑点落在哪些用地上?
黑点是 C1。北部棕、黄相间的工业和居住用地里黑点成片,西部和南部的教育、行政色块附近也有点。空白的大片浅绿是其他用地,点很少。图上不能区分一个点是上班进入还是访客进入。来源:原论文 Fig. 10。
C2 主要在市中心商业区。论文把这些地方称为中心商务区,里面有商场、政府机构、金融服务和办公楼,白天吸引上班、购物和其他活动。图 9b 的高强度与这句话对应:无论汇聚还是发散,都离开了最弱的一档。它仍是净流量分级,不能换成商场营业额或办公楼出勤率。
C3 主要在城市边缘。论文检查后写到若干连接市外的交通节点,包括高速公路交叉口,以及连接香港的口岸;原文拼作 Futain Port。这一类全天为正。论文给出的原因是:数据不包括离开本市的移动,人从这些节点出去之后无法被继续记下,于是这里只剩下进入的一侧。因此全天汇聚不能读成口岸整天只有人进来、没有人离开。
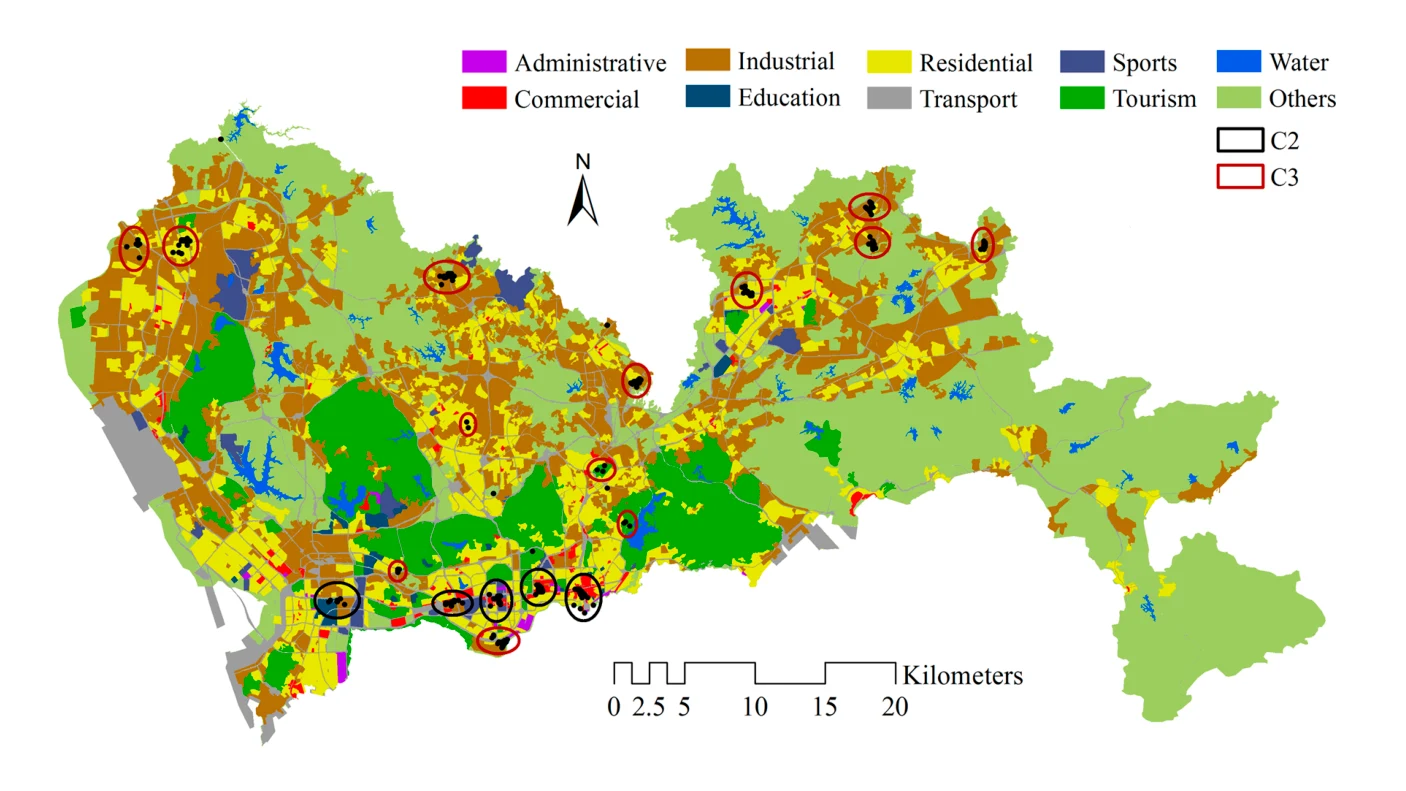
图 11|商业中心和城市边缘的热点是否分开?
黑圈是 C2,红圈是 C3。黑圈沿南部红色商业用地排成一串。红圈出现在北部、东北部和西部的外缘,不与南部那串商业黑圈混在同一位置。圈是示意位置,圈的大小不是图 6 那种强度。来源:原论文 Fig. 11。
C4 的时间方向与 C1 相反:早晨发散,17:00 以后汇聚,中午两种符号都出现。论文写它们主要在居住用地,并且在城市北部,用早晨离家、傍晚回家来解释;中午的一来一回,被联系到回家吃饭或休息。C5 也在居住用地,但在南部、靠近中心商务区。论文推测住在这里的人大多到市中心就业,所以 C5 与 C2 互补。这是推测。净流量看不出一个人的家和就业地是否成对。
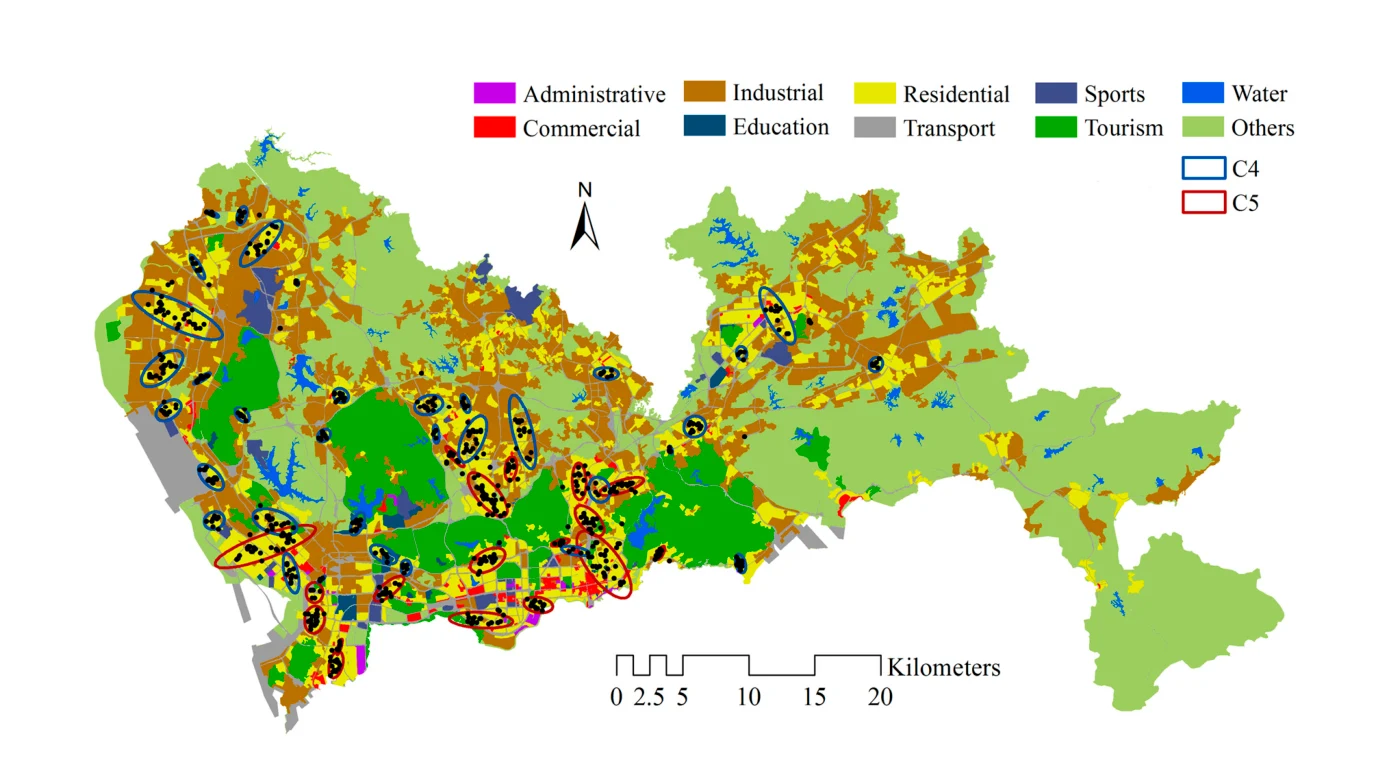
图 12|北部居住区和南部居住区是否是两类?
蓝圈是 C4,红圈是 C5。蓝圈多在北部黄色居住用地及与工业相邻的地带。红圈多在南部、贴近红色商业用地的居住区。论文的图题只写了 C4,图例和正文同时包含 C5。来源:原论文 Fig. 12。
C6 在一天的大多数窗口里几乎没有可分辨的汇聚或发散,只有中午前后两个窗口为很弱的负值。点主要在北部的工业和居住用地。论文依据对深圳的了解写道:这里有许多小工厂,工人的住处就在工厂旁边或厂内,活动范围小,即使在通勤时段,汇散强度也很弱。活动范围小这一点,论文指向另一项用被动手机定位做的聚合研究,并不是本数据里直接量出的个人活动半径。
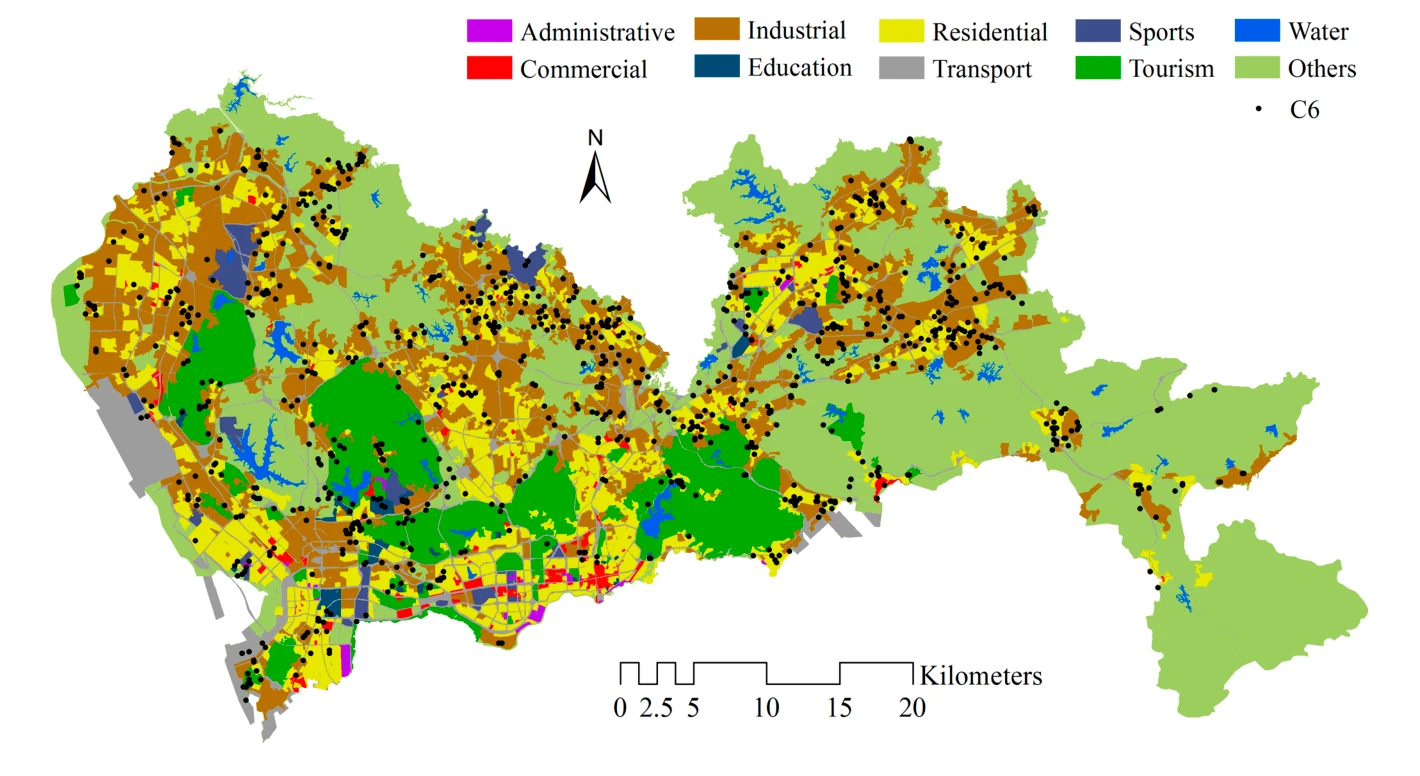
图 13|弱节奏的点是否避开了南部商业核心?
黑点是 C6。北部棕色工业用地和黄色居住用地里点很密,东部也有散点。南部红色商业核心里几乎看不到这一类。点多只说明这类格子多,不说明每个格子的净流量大;图 9b 显示这类的平均强度接近零。来源:原论文 Fig. 13。
放在一起,C1 与 C4 位于北部,一个偏就业进入,一个偏居住离开;C2 与 C5 位于南部,一个是白天的强汇聚,一个是白天的强发散。论文把这种南北差别联系到深圳的长期规划:南部被定为金融、商业、教育和高技术中心,北部更多是制造业。这是规划方向与观察到的节奏在空间上一致。文章没有对南北的就业岗位、收入或工厂班次做统计比较。
论文还说,这六类与上海出租车 GPS 研究里的源汇区相似。那是对既有研究的对照,不是用同一套分级在上海重做了一遍。
这些对应能说到哪一步?
这是一个工作日、一家运营商、按小时记在基站上的观察。1600 万用户和约 60% 的移动市场份额,都留在各自的分母里:前者是数据集中的用户,后者是市场比例。没有周末,也没有第二天,所以六类节奏有没有跨日重复,文中看不出来。
热点个数会随带宽和分级数改变。1000 米和 9 级是试算后的选择。把 9 级下的 53 和 60 说成深圳早高峰的热点总数,会把分析尺度误当成城市事实。
ClassNum 的强弱是密度分级的名次。图 5 的颜色可以到四位数,那仍是核密度值。文章没有把某一级换算成净增加多少人。图 9 图例的英文正负号与正文相反;若不先按正文改回来,商业区白天会变成强发散,居住区早晨会变成强汇聚,和功能区解释整段对调。
C3 全天为正,论文自己把它联系到市外行程没有进入数据。在用这张图讨论口岸或高速口的到达需求之前,需要先确认离开的一侧是否被记录。C5 的人是否去市中心上班、北部是否三班、午间是否回家吃饭、C6 是否住在厂里,都是结合功能区和地方知识的解释。净流量只有进入与离开的差,没有起点和终点的用地。
聚类没有报告类别大小和 BIC。空间上的成团是结果,不是输入。相邻窗口重叠一小时,也会让相邻时段的符号更不容易突然翻转。把这六类直接套到另一座只知功能区的城市,是论文结尾的设想,不是这次数据检验过的迁移。
一句话总结
早高峰的移动挤在少数居住地和就业地,局部汇散热点反而更少;深圳这一天可以分成六种昼夜节奏,城南商业中心与邻近居住区、城北工业与居住区各自大致互补,功能区说明它们落在哪里,不证明用地造成了这些流动。
核心来源
- DOI:10.3390/su8070674,对应 Sustainability 2016 年第 8 卷文章 674。正文共 18 页,图 1 至图 13、表 1 和表 2 都在这一版里。首页印有收稿日期、接收日期和发表日期。
作者介绍
三位作者在论文中的署名单位都是武汉大学测绘遥感信息工程国家重点实验室。下面只写论文里能够核对的分工。
- Xiping Yang:通讯作者,与 Zhiyuan Zhao 共同构思并设计研究,完成分析并撰写文稿。
- Zhiyuan Zhao:与 Yang 共同构思并设计研究。
- Shiwei Lu:提出修改意见,并帮助润色文字。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若交通调度只盯热点个数,早高峰可能被排到资源较少的时段。这篇论文里,早高峰的极值个数少,南部商业中心类的平均分级却可以到最强的一档。个数下降和单点强度上升是同时发生的。用个数分配出租车或公交加班,会错过那些更少、但净流入更突出的地方;至少应同时看分级的绝对值。这需要各窗口的人数或净流量原值,本文没有给出。
C6 还提供一个反例。北部工业与居住贴在一起时,平均分级几乎全天为零。若把“没有热点”理解成“不需要通勤服务”,厂区宿舍会被看成没有出行需求。实际可能是居住和就业离得太近,净流量互相抵消。要区分这两种情况,得知道同一批人的居住地和就业地是否在相邻格子里,而净流量热点图做不到。
口岸和高速口也一样。C3 全天为正,论文已经说明离开本市的一侧没有被记下来。另一座城市若只用行政边界内的基站或卡口,边界上的枢纽也会稳定地只剩一侧。在把它标成全天到达热点之前,应先把边界外的下一次记录接回来,看正值还在不在。