只知道每个地方飞向各大区的客流,能不能补出全球航空起讫网?
论文名片|Giulia Fischetti、Anna Mancini、Giulio Cimini、Jessica T. Davis、Abby O. K. Leung、Alessandro Vespignani、Guido Caldarelli,Block-fitness modeling of the global air mobility network,Nature Communications,2026年10月12日。DOI:10.1038/s41467-026-78115-6。期刊页面给出这一发表日期;本稿核对的文本页眉仍为 Article in Press,收稿日期 2026年2月11日,接收日期 2026年9月8日。Fischetti 与 Mancini 为共同贡献。研究类型是网络重构与元种群传播模拟。
全球疫情模型要的往往是一张起讫表:从伦敦最终到达纽约的旅客有多少,中途在法兰克福停留并不另算成一次人口混合。这张表通常来自机票销售,商业许可才能使用。公开时刻表更容易拿到,它记录的是一段一段的飞行。
这篇论文试的是一条更窄的信息:每个子人口区飞向每个地理大区的客流,加上大区之间有多少条连接。分块适应度模型用这些聚合量生成稀疏的起讫网络。在 2019 年 9 月至 11 月的 OAG 网络上,真实连边上的模型概率平均为 75%,而网络密度只有 1.8%。拿生成的网络去做集合种群疫情模拟,全球患病率曲线的差距接近真实网络模拟自身的起伏;逐个子人口区的患病率误差更大。换成覆盖不全的公开数据后,单条连接上的客流误差会明显变大,而且开放数据流程仍把度数缩放到 OAG 的密度。
先说结论
- 分析单位是子人口区之间的无向日均客流。2019 年秋季 OAG 网络的密度为 1.8%。度数和强度呈带截断的重尾;图 1 上两条幂律斜率标为 −1.83±0.08 和 −1.7±0.1。强度随度数的拟合在散点图上为 1.224。
- 分块适应度给出的召回率是 75%。分母是全部真实连边,分子是这些边上的模型概率之和,所以 75% 是真实连边上的平均概率。随机分类器在同样定义下的期望召回率等于密度 1.8%。只在已经实现的连边上,分箱后的权重均方根相对误差为 0.063。
- 元种群 SIR 里,全球患病率曲线的多项差距与真实模拟彼此之间的差距重叠。分区患病率的 RMSE 是例外:模型对真实为 0.050±0.006,真实模拟彼此为 0.024±0.005,两组标准差区间不重叠。
- 公开数据只覆盖 739 个子人口区,约为全部子人口区的 25%,对应 OAG 总客流的 45%。这一子集上的召回率为 0.58,已实现权重的 RMSRE 升到 4.53。
直飞航段为什么会把枢纽看重、把终点看轻?
世界航空运输网络(World Air Transportation Network,WAN)在这里指全球航空起讫网络:旅客从出发机场到最终目的地的人数,不按中转把旅程拆开。官方航空指南(Official Aviation Guide,OAG)提供 2019 年的月度计数。公开的航班时刻和座位数描述的是直飞航段。航段流量会把中转枢纽上的过站人数算进该机场的重要性,同时少算旅客真正要去的终点。起讫流量更接近疫情模型里的人口混合。它也更难公开分享。
引力模型用人口、经济和距离去估两地流量,机器学习可以吃进更多外部变量。两类方法通常会给出很密、甚至接近全连接的网络,除非另外规定一张航线骨架。真实航空连接受运力、成本和地理限制,密集程度低得多。本文要同时生成“有没有这条连接”和“有的话有多少人”。
2019 年秋天,这张网实际上有多稀、多成团?
机场先被归进子人口区。论文称 basin:用地球表面的 Voronoi 划分,得到超过 3200 个以主要交通枢纽为中心的子人口区,再把机场之间的起讫客流加总到子人口区对上。划分细节在补充方法里,正文没有给出精确的区数、机场数和剔除规则。
月度网络取 2019 年 9 月到 11 月。边权 wᵢⱼ 是两个子人口区之间、两个方向加在一起的日均旅客数。网络无向,看不出去程和回程。子人口区 i 的强度 sᵢ = Σⱼ wᵢⱼ,是与它相连的客流总和;度数 kᵢ 是 wᵢⱼ > 0 的连接个数。两地距离是两个区质心的大圆距离(Haversine),是地图上的球面距离,不是航线里程或飞行时间。
子人口区被划进 11 个地理区域,依据联合国地理方案和世界银行区域分类:非洲、亚洲、中美洲、东亚、欧洲、欧洲/亚洲、中东、北美、大洋洲、南美、东南亚。正文没有逐国列出成员。
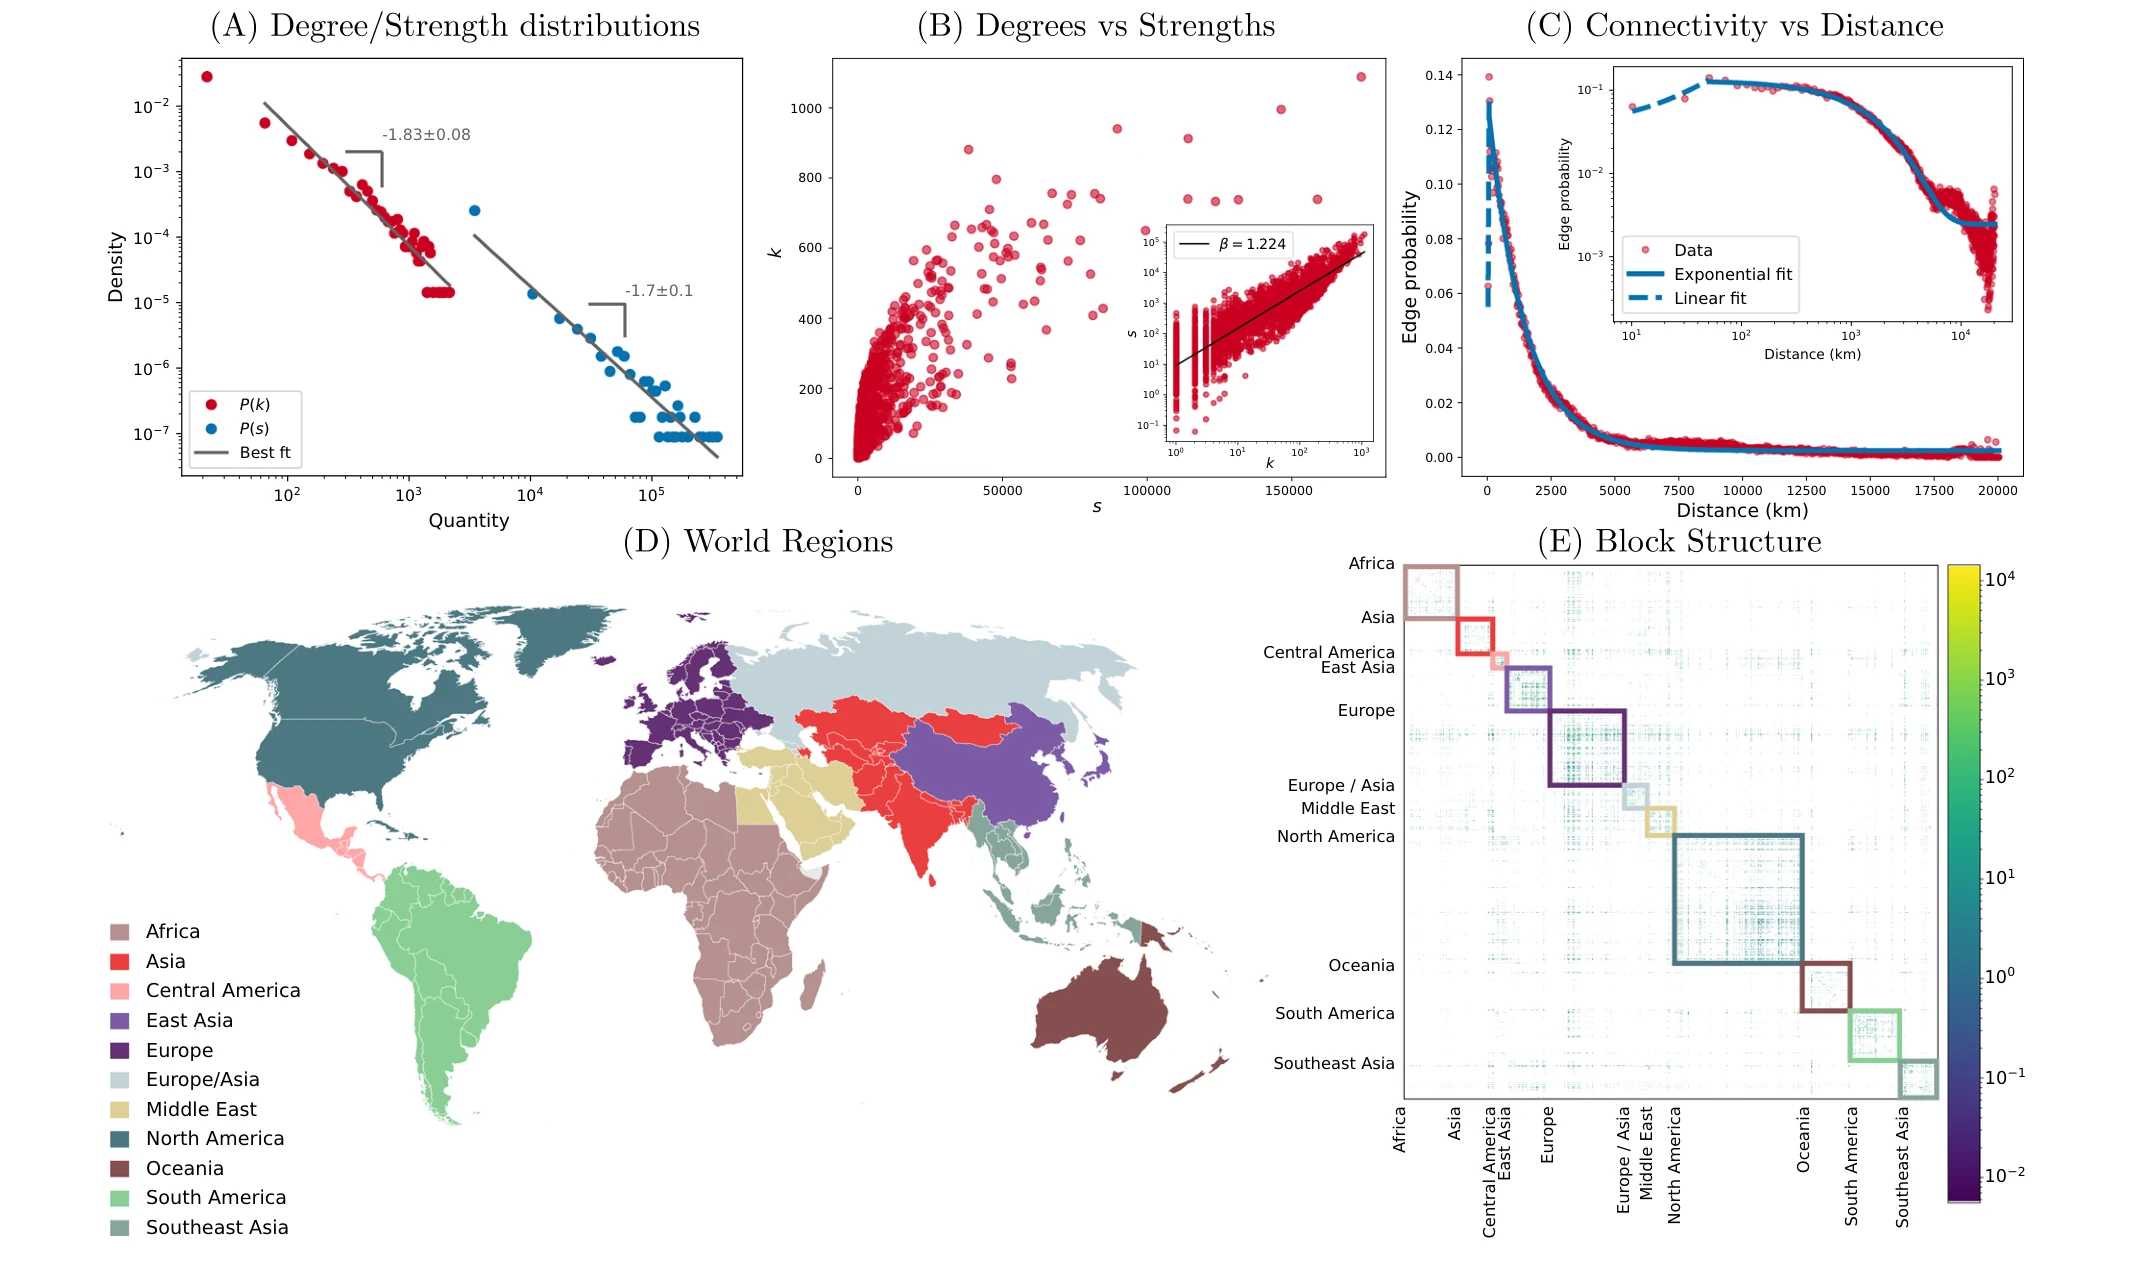
图 1|2019 年秋季的全球起讫网,稀在哪里、又按地理聚成什么样?
(A)度数分布 P(k) 与强度分布 P(s),各用 50 个箱子表示。图中幂律拟合标为 −1.83±0.08 与 −1.7±0.1;图注写作 γₖ = 1.8(3)、γₛ = 1.(7)。两套记法都印在论文里。分布在高端转弯,论文将其联系到单个子人口区能容纳的连接数和客流有限。(B)每个子人口区的度数对强度。主图横轴 s 到 15 万、纵轴 k 到 1000;插图的普通最小二乘拟合标成 β = 1.224,图注写作 β = 1.2(2),形式是 s ~ kᵝ。度数高的地方,客流总量涨得比度数更快;反过来,度数随强度的增长慢于一条直线。云团很散,同样的强度可以对应差很多的连接数。(C)连边概率随质心距离变化,1000 个箱子、每箱大约 20 公里。50 公里以内用直线 l(d) = 0.003d − 0.0013,其后用指数衰减,图注给出的拟合优度 R² = 0.99。短距离处概率最高,随距离迅速下降;对数插图里,很远的箱子波动变大。(D)11 个地理区域的世界地图。欧洲/亚洲在图例中单列,正文没有逐国定义边界。(E)按这一分区重排后的矩阵,对角块更密。图注给出的模块度 M = 0.67。色标跨多个数量级,图注没有单独写出颜色的单位。来源:原论文 Fig. 1。
图 1B 的相关,是后面用强度代替度数的理由:连接多的地方,通常也是客流大的地方。相关留有很大散点,所以强度只能是度数的代理,不能逐点读出连接数。
只保住每个地方的总客流,为什么会连成一张密网?
最大熵网络的想法是:在平均意义上保住指定的量,其余尽量随机。若只保住每个点的强度、不保住度数,权重会被铺到几乎所有点对上,因为强度本身没有说“应该只有少数边”。论文指出,这样会得到和引力模型类似的稠密网。
要得到稀疏网,需要同时知道强度和度数。度数往往拿不到,或者逐点求解太贵。适应度(fitness) ansatz 用一个与度数正相关的节点属性,代替度数对应的参数。这里首先使用强度:客流大的地方更可能有很多连接。经典两步法先按连接概率独立抽样边,再按密度校正后的引力形式赋权。
全球航空还有一块地理结构:区域内连接密,洲际连接稀。分块适应度(block-fitness)把约束拆到区域。对每个子人口区 i 和每个区域 g,约束 sᵢᵍ = Σⱼ∈g wᵢⱼ,也就是 i 与区域 g 之间的客流,j 不等于 i。这是模型真正吃进去的客流量,比一个总数 sᵢ 更细,仍比完整起讫矩阵粗。
设 i、j 分属区域 gᵢ、gⱼ。连接概率是
pᵢⱼ = (z{gᵢgⱼ} · sᵢ^{gⱼ} · sⱼ^{gᵢ}) / (1 + z{gᵢgⱼ} · sᵢ^{gⱼ} · sⱼ^{gᵢ})。
z_{gᵢgⱼ} 不是自由调参去最小化误差。它被定成:gᵢ 与 gⱼ 之间的期望连边数等于经验连边数。因此,每一对大区之间有多少条连接,是输入;模型决定的是这些连接更倾向于落在哪些高客流点对上。全网密度因此在期望意义上与真实网络一致,这不是被预测出来的结果。
边以概率 pᵢⱼ 被抽中后,权重取
wᵢⱼ = (sᵢ^{gⱼ} · sⱼ^{gᵢ}) / (pᵢⱼ · W_{gᵢgⱼ}),
没抽中则为 0。W{gᵢgⱼ} 是两个区域之间的客流总和。因为抽中的概率是 pᵢⱼ,系综平均变成 ⟨wᵢⱼ⟩ = sᵢ^{gⱼ} · sⱼ^{gᵢ} / W{gᵢgⱼ}。每个点对每个区域的客流,以及总强度,都在平均意义上被保住。单次实现里,稀有边一旦出现,权重要比这个平均值再大 1/pᵢⱼ。图 2C 比较的是系综平均,不是某一次抽样的单张航线图。
11 个区域时,每个子人口区提供的是指向各区域的客流,全网超过 3200 个区,输入是数万个聚合量这个量级。正文没有把精确区数写成一个整数,所以这里不算精确的输入维度。
75% 是真实连边上的平均概率,不是阈值判对的比例
强度按构造被保住,所以强度重合本身不检验模型。可检验的是度数、哪些点对被连上,以及已有连边上的权重。
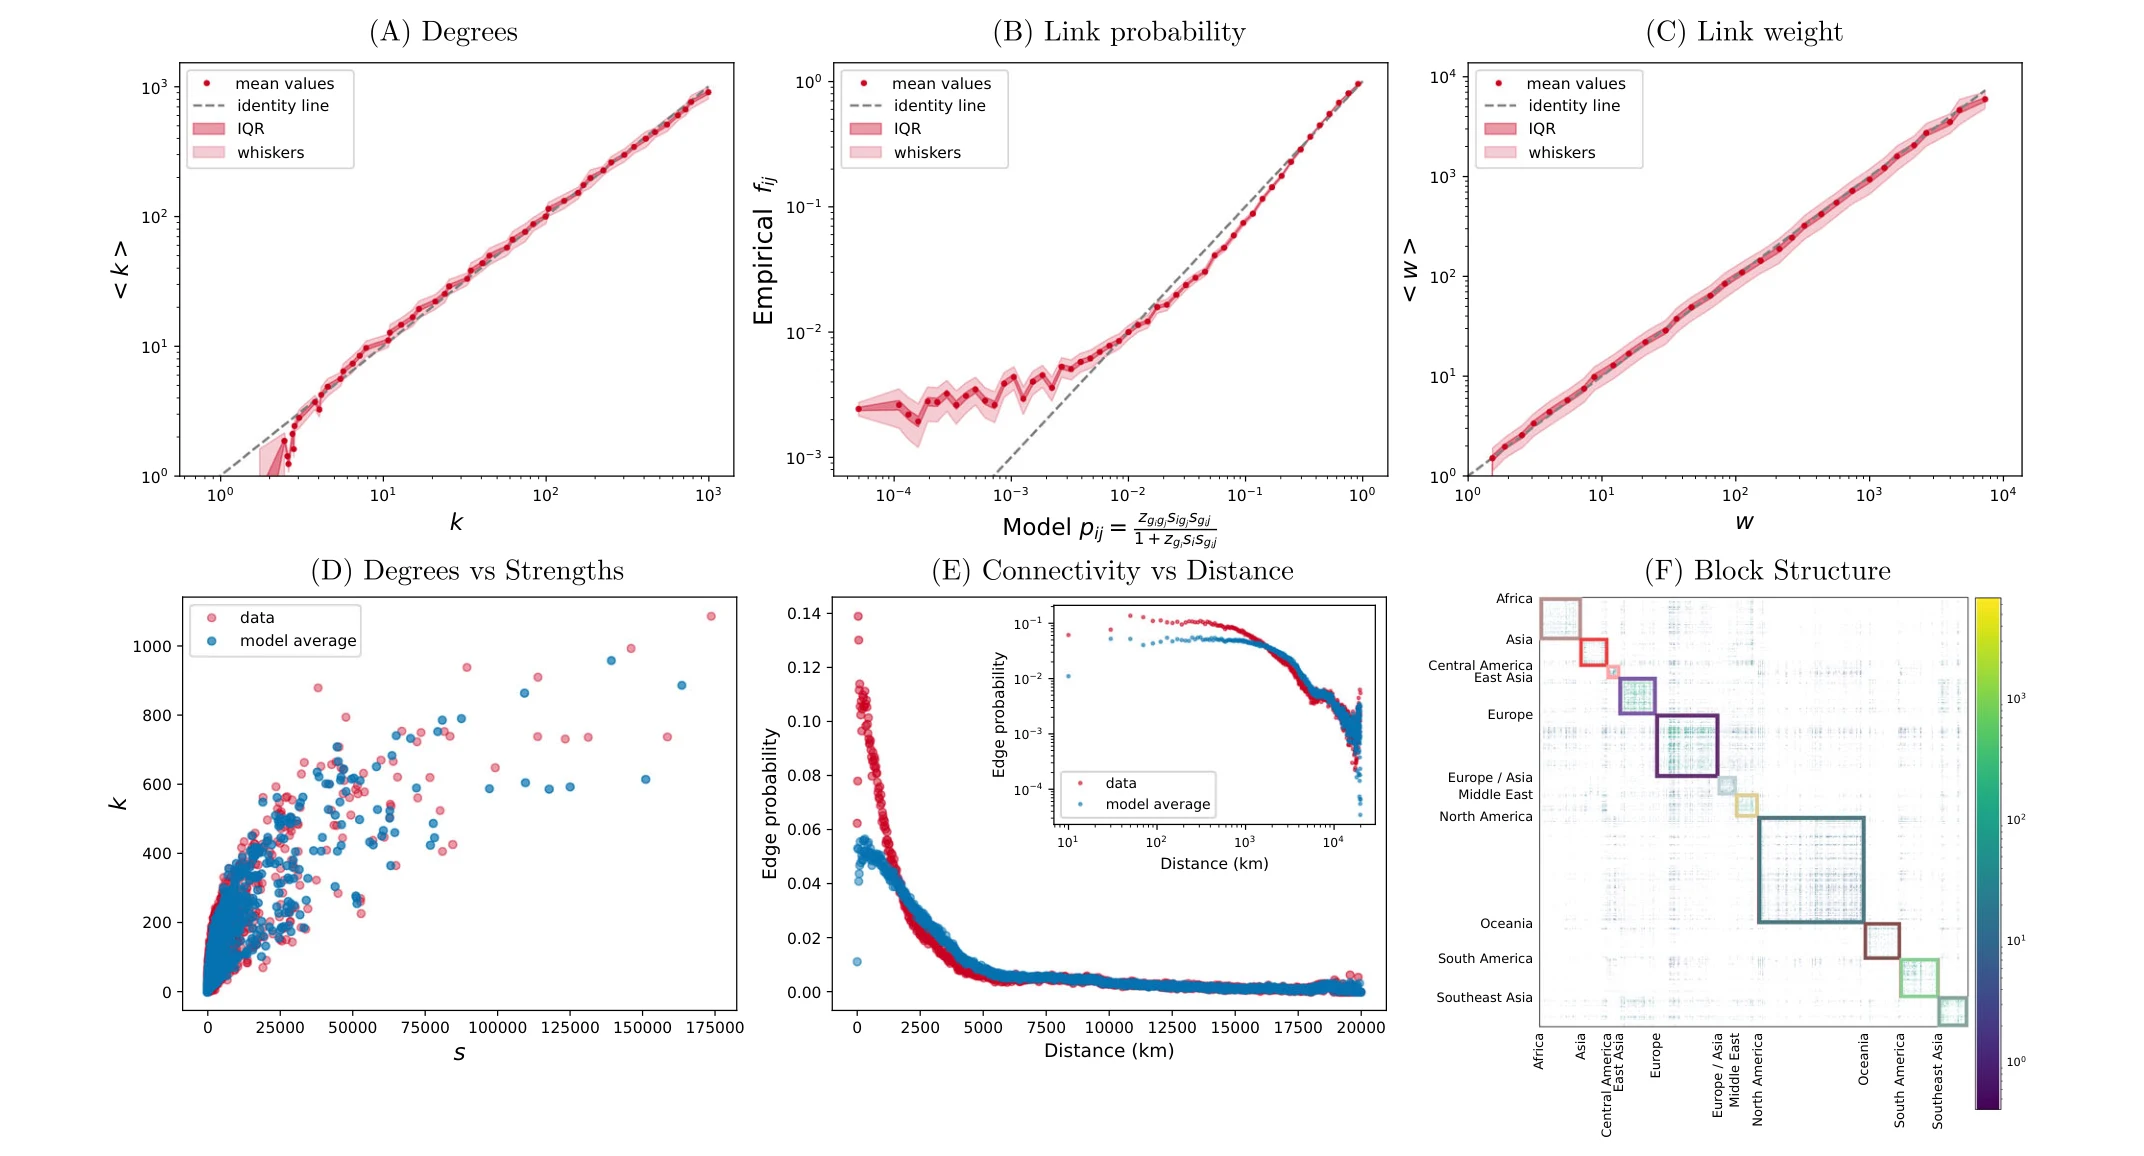
图 2|只用分区客流和区间连边数,网络的哪些部分被重新生成?
(A)模型期望度数 ⟨kᵢ⟩ = Σⱼ≠ᵢ pᵢⱼ 对经验度数。横轴按对数分成 50 档。对角线表示完全重合,阴影是模型值的四分位距和须线。分箱后的均方根相对误差 RMSRE = 0.18。低度数端略偏离对角线,主体沿对角线上升到约 10³。(B)横轴是模型概率 pᵢⱼ,纵轴是该档内真正有边的点对比例 fᵢⱼ。RMSRE = 0.016。低概率端经验比例高于对角线,高概率端贴近对角线。这一档只有一个 fᵢⱼ,误差线来自二项分布的正态近似。(C)系综平均权重对经验权重,只保留 wᵢⱼ > 0 的边。RMSRE = 0.063。从大约 1 到 10⁴ 沿对角线分布。没有客流的点对没有进入这个误差。(D)度数—强度云团。经验数据的拟合指数为 β = 1.2(2),模型为 β = 1.17(0)。模型云团盖住经验散点的走向和幅度。(E)连边概率对距离。图注写分箱方式同图 2C,并给出两条曲线的均方误差 MSE = 1.61。线性坐标上,最短距离附近的经验概率高于模型平均,之后一起下降。图注没有说明 1.61 是对概率、对数概率还是未平均的平方和,因此不要把它读成“概率平均差了 1.61”。(F)一次抽样得到的矩阵,对角块仍然更密。该划分下模型系综的平均模块度是 0.63,图注写真实数据 M = 0.64。来源:原论文 Fig. 2。
图 1E 的真实网络模块度是 0.67,图 2F 写的是 0.64。两个数字都在正文图注里,本稿不把它们收成一个数。块结构本身在很大程度上由构造保证:区间连边数已经被 z 配平,分区又是事先指定的。模型平均 0.63 与图 2F 的 0.64 接近,说明抽样网络保住了这一约束,并不说明模型自己发现了社区。
连边预测用的是概率,不是先画一条阈值再数对错。召回率 = Σᵢⱼ aᵢⱼ pᵢⱼ / Σᵢⱼ aᵢⱼ,精确率 = Σᵢⱼ aᵢⱼ pᵢⱼ / Σᵢⱼ pᵢⱼ。aᵢⱼ 在有边时为 1。因为期望边数等于经验边数,两个分母相等,精确率与召回率相同。召回率因此等于真实连边上 pᵢⱼ 的平均值。这个平均值是 75%:论文说大约四条真实连接里能识别三条。随机分类器若把每条可能边都猜成密度那么大的概率,同一公式给出的召回率就是密度 1.8%。75% 对 1.8% 比的是这个概率平均,分母都是真实连边;它不是平衡测试集上的分类准确率,也不是“75% 的边被一个硬阈值判对”。
距离没有出现在 pᵢⱼ 的公式里。图 2E 仍得到随距离下降的连边概率。大区划分本身是地理的,区域内的高客流会让近距离点对更容易被连上。正文没有做打乱区域地理含义的对照,所以这条曲线说明模型与距离格局相容,还没有把“公式里的客流异质性”和“区域就是近邻”分开。讨论写到,分块适应度优于显式纳入强度—度数超线性关系的模型,以及把连边概率写成距离函数的模型;定量比较在补充说明 1,正文没有列出那些对照的召回率或 RMSRE。
全球曲线接近噪声,分区曲线的误差大约是噪声的两倍
结构像,不保证把网络放进传播模型后,疫情的时间和空间还像。论文把每个子人口区做成一个 SIR 集合:易感、感染、恢复,三者之和为该区人口 Nₘ。区与区之间用起讫客流耦合。单区平均场方程是 dS/dt = −β I S / N,dI/dt = β I S / N − γ I,dR/dt = γ I。传播率 β = 0.3,恢复率 γ = 0.1。若一个区不与外界交换,这两个率之比是 3;论文没有把 3 报告成全球再生数,跨区流动会改变实际增长。
从 m 到 n 的出行概率写成 πₘₙ = wₘₙ / (Nₘ + Nₙ)。无向边权因此被分到两个方向,分母是两端人口之和。一个时间步内离开 m 前往 n 的期望人数是 Nₘ · wₘₙ / (Nₘ + Nₙ)。人口 Nₘ 从哪套数据来,正文没有写,细节指向补充材料。
每个种子区一开始有 I₀ = 10 名感染者,模拟 300 个时间步。正文没有把一步定义成一天。种子是六个大洲里连接最多的四个子人口区,共 24 个:约翰内斯堡、开罗、开普敦、阿尔及尔、香港、上海、北京、曼谷、伦敦、巴黎、莫斯科、米兰、纽约、洛杉矶、旧金山、迈阿密、悉尼、墨尔本、布里斯班、奥克兰、圣保罗、里约热内卢、波哥大、圣地亚哥。论文写每个种子在真实网络上做 5 次、在不同的模型实现上做 20 次,并写总共 504 次。24 乘以 25 等于 600,与 504 对不上。下面的表使用的是成对比较,不是把 504 次简单平均。
中转不进入传播。论文给出的理由是:客舱换气和过滤使飞行中的呼吸道传播相对少见,旅客旅行时常常仍处于潜伏阶段,中转停留也短于在目的地的停留。这些是对既有研究的转述,不是本文新测的机上传播率。
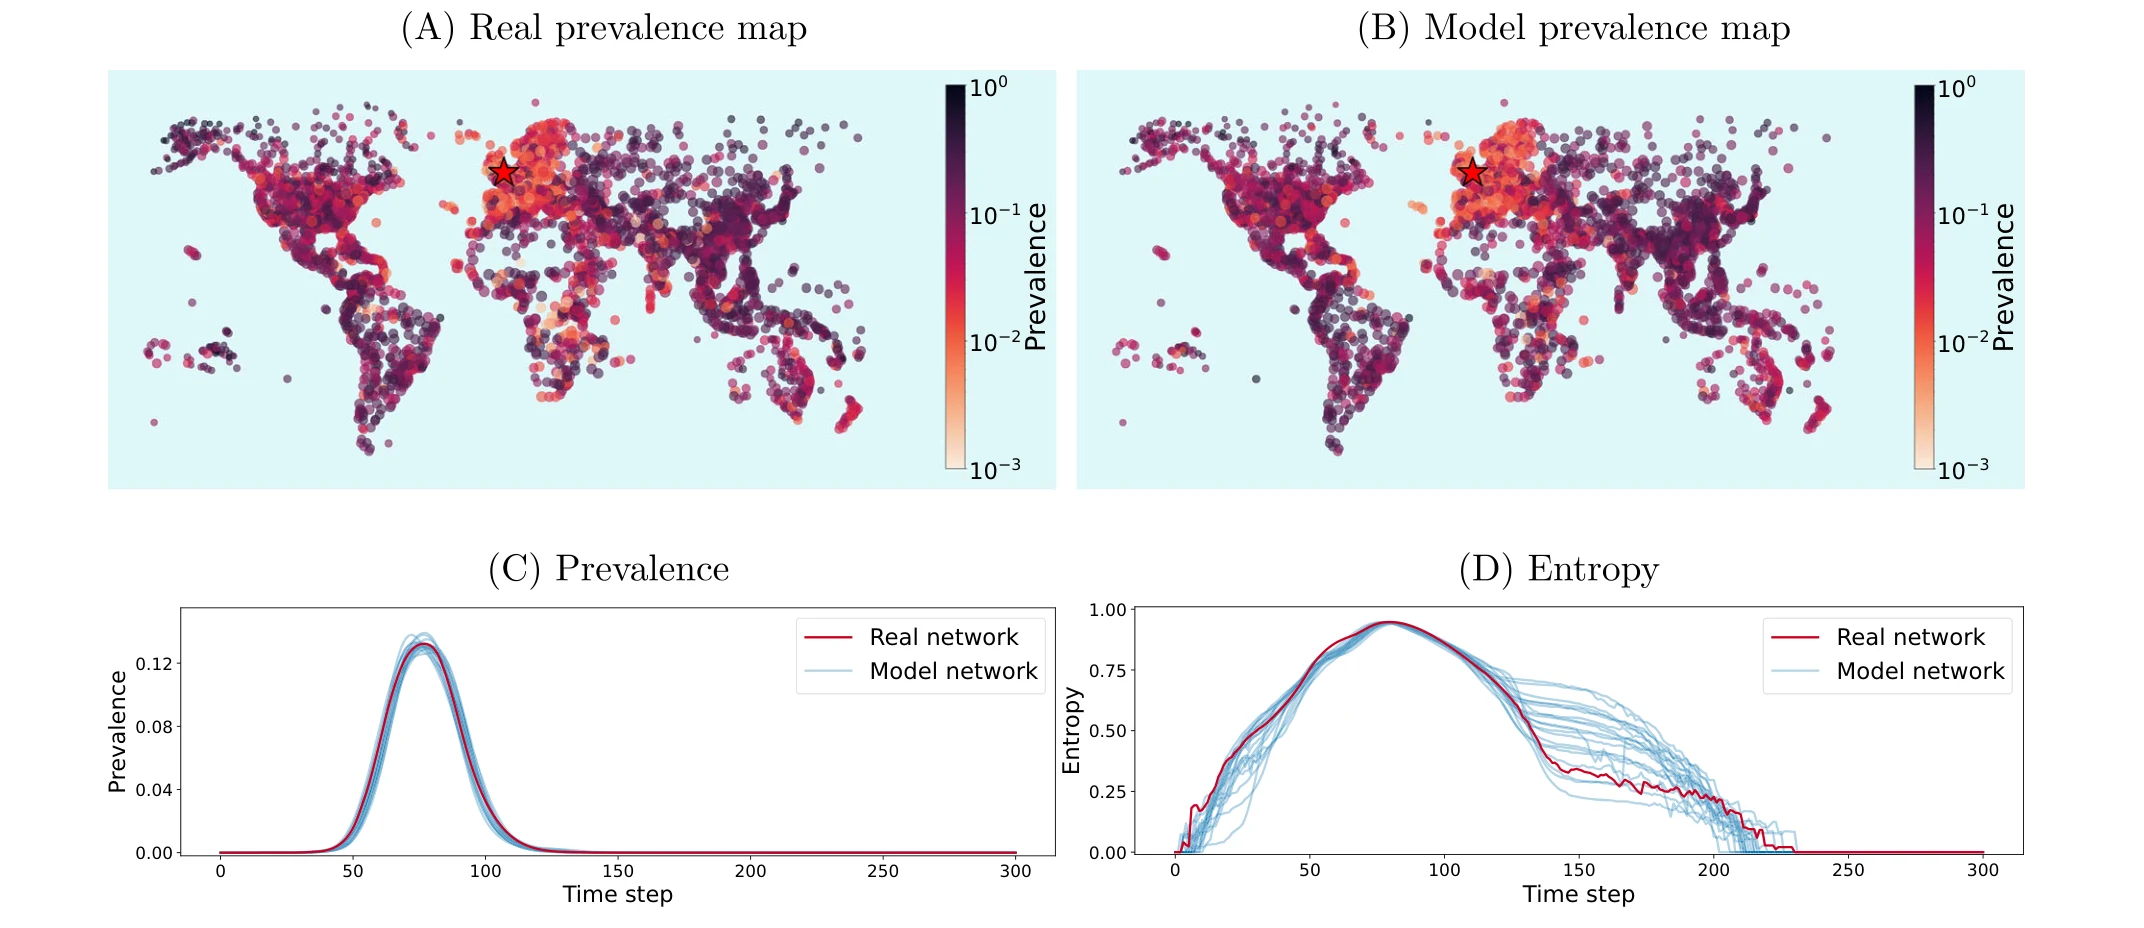
图 3|从伦敦播起时,真实网络和模型网络的疫情像到哪一步?
(A、B)第 80 个时间步的患病率地图。点位于子人口区坐标,大小正比于度数,颜色是患病率 iₘ(t),即该区感染者占该区人口的比例。只画出患病率至少为 10⁻³ 的区,色标从 10⁻³ 到 10⁰。伦敦一带颜色深,其他大陆也已出现感染。这是一次代表性运行的快照,论文没有把第 80 步定义成峰值时刻。(C)全球患病率 i(t),即全世界感染者占全世界人口的比例。红线是一次真实网络模拟,蓝线是 20 次模型模拟。曲线先升后降,纵轴画到 0.12,两条线在高峰附近几乎重合。(D)患病率空间分布的熵。ρₘ(t) = iₘ(t) / Σₙ iₙ(t),熵与 −Σₘ ρₘ log ρₘ 成正比。ρ 用的是各区患病率,没有再乘人口,所以它度量的是患病率在区与区之间是否均匀,不是感染人数的人口加权份额。纵轴从 0 到 1。高峰附近熵升到接近图的上沿;下降段上,20 条模型曲线比那一条真实曲线更散。来源:原论文 Fig. 3。
定量比较不靠这一张伦敦图。同一种子下,模型行是“一次真实模拟对一次模型模拟”的平均,再跨种子汇总;数据行只比较真实网络上的模拟,用来表示随机 SIR 本身有多抖。不确定度是标准差。指标定义在补充表 3,正文说明它们分别对应曲线之间的面积、患病率曲线的 L2 距离、峰值时刻之差、峰值高度之差、流行时长之差、各区患病率的时间平均 RMSE,以及熵曲线的 L2 距离。
| 比较 | Δ面积 | L2[i] | 峰值时刻 | 峰值高度 | 流行时长 | RMSE[iₘ] | L2[H] |
|---|---|---|---|---|---|---|---|
| 模型对真实 | 0.56 ± 0.31 | 0.073 ± 0.040 | 2.3 ± 1.8 | 0.0048 ± 0.0035 | 4.5 ± 3.2 | 0.050 ± 0.006 | 14.5 ± 6.1 |
| 真实对真实 | 0.43 ± 0.32 | 0.058 ± 0.042 | 2.0 ± 1.7 | 0.0043 ± 0.0034 | 2.2 ± 2.2 | 0.024 ± 0.005 | 13.1 ± 6.1 |
全球曲线的面积、L2、峰值时刻、峰值高度和熵距离,模型行与真实对真实行的标准差区间互相覆盖。图 3D 下降段看起来更散,对应的 L2[H] 仍落在这一重叠里。分区患病率 RMSE 不同:0.050±0.006 与 0.024±0.005 的区间不重叠,模型误差大约是真实模拟彼此差异的两倍。流行时长之差的均值是 4.5 对 2.2,标准差很宽,区间仍然重叠。因此,全球一条总曲线接近,不能推出每个子人口区的疫情时间都和真实网络不可区分。
公开航班和维基客流,能代替 OAG 到哪一步?
开放数据版把两套来源拼在一起。拓扑来自 OpenSky 的 2019 年 9 月至 11 月航班记录:用每趟航班首次和末次被探测到的位置近似起降机场,再归到最近的子人口区。直飞航段会把中转拆开,这样得到的度数系统性地低于起讫网络。论文于是把这些度数缩放到 OAG 的网络密度。密度这一档仍然参照了专有数据。
客流用 Wikidata 上各机场 2019 年 9 月至 11 月的旅客量,加总到子人口区,当作强度的代理。结果部分称这一统计来自 Wikipedia,方法部分称 Wikidata。维基计数包含中转旅客,因此系统性地高于 OAG 起讫强度;论文说参数重标定会吸收这一水平差,并滤掉少量小的离群点,没有给出离群点个数。大区之间的客流,是按缩放后的 OpenSky 分区连通性,把维基强度拆开。
公开记录只覆盖 739 个子人口区,约为全部区数的 25%,却占 OAG 总客流的 45%。比较对象是 OAG 在这 739 个区上的子网络。
| 指标 | RMSREₛ | RMSREₖ | RMSREₚ | RMSRE_w | 召回率 | β | 距离曲线 MSE | 模块度 |
|---|---|---|---|---|---|---|---|---|
| 开放数据模型 | 8.36 | 0.28 | 0.057 | 4.53 | 0.58 | 1.3(8) | 0.56 | 0.18 |
筛过的经验网络自身是 β = 1.2(4)、模块度 0.26。0.26 和 0.18 的分母是这 739 个区,不能与全网图 1、图 2 里 0.6 以上的模块度比高低。RMSREₛ = 8.36 比较的是维基口径的强度和 OAG 强度,数值大,说明两套客流总量并没有对齐;模型按构造保住的是它拿到的维基强度。权重 RMSRE 从全网 OAG 模型的 0.063 升到 4.53,召回率从 75% 降到 0.58。0.58 的分母仍是这一子集上的真实连边,而且度数已经被拉到 OAG 密度。
同一套疫情指标在这个子集上是:
| 比较 | Δ面积 | L2[i] | 峰值时刻 | 峰值高度 | 流行时长 | RMSE[iₘ] | L2[H] |
|---|---|---|---|---|---|---|---|
| 模型对真实 | 1.2 ± 0.5 | 0.17 ± 0.07 | 4.3 ± 2.4 | 0.0071 ± 0.0049 | 7.2 ± 2.4 | 0.0086 ± 0.0010 | 13.2 ± 2.8 |
| 真实对真实 | 0.55 ± 0.34 | 0.076 ± 0.047 | 1.7 ± 1.4 | 0.0042 ± 0.0039 | 3.3 ± 2.7 | 0.0055 ± 0.0004 | 7.4 ± 3.6 |
模型与真实的差距大于真实模拟自身的起伏,峰值高度的区间仍有重叠,分区 RMSE 的区间不重叠。RMSE 和熵距离随节点个数变化,表 2 的 0.0086 不能因为小于表 1 的 0.050 就被看成更准。论文的判断是:输入不完美时模型仍然可用,结构误差尤其出现在单条边的权重上。
这些数字支持到哪一步
模型生成的是与聚合约束相容的网络系综。拟合好、召回率高,说明这组约束已经带有很多结构,并不证明旅客按适应度公式选目的地,也不证明它是唯一能生成同样边缘的机制。
分区事先给定,作者没有针对模块度去优化这 11 个区。换成国际民航组织区域的结果写在补充说明 3。把节点从子人口区换成单个机场后,讨论说结论仍然稳健,数字在补充说明 2,正文没有给出机场尺度的召回率。
疫情实验是指定的 β、γ 和 10 名初始感染者,种子都是高度数枢纽,时间是 2019 年秋季的一张静态网。它回答的是“合成网能否代替这张 OAG 网来跑这个 SIR”,不是某一次历史大流行的回顾性预报,也没有包含发病潜伏、行为改变或旅行限制。
一句话总结
分区客流加上大区之间的连边数,可以在 2019 年秋季的全球航空网上补出平均概率为 75% 的真实连接,并让全球患病率曲线落在真实模拟的噪声附近;逐区疫情和公开数据下的单条航线客流,仍然比这张全球曲线所显示的更难对齐。
核心来源
- Nature Communications 论文页面,题目、作者、DOI 与 2026年10月12日的发表日期。
- 本稿图表与数值核对自带有 Article in Press 页眉的该 DOI 文本。正文图 1–3 与表 1、表 2 来自这一文本。补充方法、补充说明 1–4 和补充表 2、表 3 在该 PDF 之外。
- OAG 原始起讫数据为商业许可。OpenSky 与 Wikidata 的入口见论文数据可用性说明。论文给出的代码与开放数据仓库为 WAN-fitness-modeling。
作者介绍
- Giulia Fischetti:署名威尼斯大学 DMSN,以及温特图尔苏黎世应用科学大学工程学院 IAMP。与 Anna Mancini 共同贡献。贡献说明中,她参与代码、分析、结果讨论和图表文稿。
- Anna Mancini:署名罗马第二大学物理系与国家核物理研究院,以及恩里科·费米研究中心。共同贡献。她与 Cimini 收集开放数据,并参与代码与分析。
- Giulio Cimini:通讯作者,署名罗马第二大学物理系与国家核物理研究院、费米研究中心、意大利国家研究委员会复杂系统研究所。他参与研究设计、开放数据、分析与写作。其公开研究页将适应度 ansatz 用于在只有聚合敞口时重建经济金融网络;本文把同类约束用到航空客流。
- Jessica T. Davis:署名东北大学 MOBS 实验室。与 Leung 整理 OAG 数据。本文参考文献 33 为 Davis, J. T. 等人 2021 年发表于 Nature 的论文,主题是新冠病毒的隐匿传播与第一波疫情。
- Abby O. K. Leung:署名东北大学 MOBS 实验室。贡献说明中与 Davis 整理 OAG 数据,并参与结果分析和修稿。
- Alessandro Vespignani:署名东北大学 MOBS 实验室,与 Cimini、Caldarelli 共同设计研究。本文引用的航空网络与全球疫情可预测性论文(Colizza、Barrat、Barthélemy、Vespignani,PNAS,2006)以及复杂网络上传播过程的综述(Pastor-Satorras、Castellano、Van Mieghem、Vespignani,Reviews of Modern Physics,2015)都有他的署名。
- Guido Caldarelli:通讯作者,署名威尼斯大学 DMSN、国家研究委员会复杂系统研究所、威尼斯 ECLT 和伦敦 LIMS。参与研究设计、结果讨论与修稿。本文引用他与 Capocci、De Los Rios、Muñoz 2002 年在 Physical Review Letters 提出的节点适应度模型。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
公开数据流程里,OpenSky 度数被拉到 OAG 的密度。若下一年没有 OAG 密度可以对照,方法部分写出的这套缩放就缺一个标尺。全网密度或连边总数比完整起讫矩阵小得多。一个值得单独检验的问题是:只公开这一个数,再配合各机场客运量和一份直飞航段表,召回率能从完全不知道密度时的水平,回到本文 739 个区上的 0.58 附近多少。这个检验要求把“缩放所用的密度”从输入里拿掉,本文的开放数据实验没有这样做。
表 1 还提示城市尺度的用法。全球患病率曲线的差距与真实模拟的噪声重叠,分区 RMSE 却大约是噪声的两倍。若决策关心的是某一个枢纽城市的峰值落在哪一个时间步,不确定性应按分区误差来给,而不是按图 3C 两条几乎重合的全球曲线来给。可以把 24 个种子各自的峰值时刻差分开报告,看伦敦这类高度数种子是不是系统性早于或晚于真实网络;表 1 只给了跨种子的平均差 2.3±1.8 个时间步。