不挨着的两个区,为什么仍有人每天通勤?
论文名片|Youjun Tu、Peixiao Wang、Julie N.Y. Zhu、Zhiyuan Zhao、Junli Li、Sheng Wu,GAGNN: a geography-aware graph neural network for citywide commuting flows prediction,International Journal of Applied Earth Observation and Geoinformation,2026,147:105175,2026年2月23日在线发表。DOI:10.1016/j.jag.2026.105175。正式版,开放获取(CC BY)。收稿日期 2025年9月10日,修回 2026年2月9日,接受 2026年2月14日。
可以先想象福州的两个街道:它们不共享边界,地图上不算邻居,但同一条主干路把两个街道串在一条走廊上。只按“有没有公共边界”建图,这条走廊上的通勤会被当成远距离、弱相关的流量。论文要问的是,把道路、公交和地铁定义的功能联系放进同一张图,能不能把行政区之间已经发生的通勤流量补得更准。
方向先说清楚。在福州 2023 年 1–2 月工作日的手机定位通勤上,地理相邻和交通语义相邻一起建模,误差低于只用其中一种,也低于先做图卷积、再做图注意力的 GSGNN。道路语义补得最多,公交次之,地铁再次之;格子从 1 公里放到 5 公里后,道路设定变差,公交和地铁设定变好。这里的任务是在同一批行政区里,补上被随机留出的起讫对流量。它不提供下一天的路况,也没有换一座城市再检验。
先说结论
- 道路语义、测试集、10 次独立运行的均值:GAGNN 的平均绝对误差 MAE 为 3.26(标准差 0.05),GSGNN 为 3.83(标准差 0.06)。MAE 下降 (3.83−3.26)/3.83 = 14.9%。共同通勤比例 CPC 从 0.94 升到 0.96,相对提高 (0.96−0.94)/0.94 = 2.1%。重力模型的 MAE 是 30.24,CPC 是 0.35。这些误差的单位是区对上的通勤流量,分母是测试集中的区对,不是全市人数。
- 同一模型换语义边:道路 MAE 3.26、CPC 0.96;公交 MAE 4.06、CPC 0.93;地铁 MAE 7.73、CPC 0.89;不用语义边时 MAE 10.28、CPC 0.86。相对“不用语义边”,道路把 MAE 降低 (10.28−3.26)/10.28 = 68.3%。
- 验证集上拆掉模块:以道路语义为例,去掉地理邻接、去掉语义邻接、只留多层感知机,MAPE 相对完整 GAGNN 升高 20.3%、39.5%、70.0%,CPC 下降 6.2%、12.4%、23.0%。公交和地铁两种语义下,完整模型仍然更好。
- 空间尺度从 1 公里变到 5 公里:道路语义的 MAE 上升约 17.2%;公交下降 35.3%,地铁下降 20.1%。1 公里格子上,地铁只有 1.10% 的格子被线路连到,公交为 16.99%。
- 居住地和工作地按停留半径 500 米、停留超过 5 小时识别,聚合得到 1,374,963 条通勤。这是通勤记录条数。图 12 里这组设定的 MAPE 为 0.420;把停留改成 4 小时、半径仍为 500 米,MAPE 为 0.418,只低 0.002。
要补的是留出的区对,不是明天的交通
通勤流在文中指居住地和工作地之间的周期性人口移动。分析单位是行政区之间的起讫流量:从区域 i 到区域 j 的流量记为 fᵢⱼ,并且 fᵢⱼ 与 fⱼᵢ 可以不同。全市被分成 m 个互不重叠的地理单元。补充表 S4 给出这张图的节点总数是 193。地图同时画出县级边界和更细的乡镇街道边界;正文把每个行政区当作一个节点,没有逐个列出这 193 个单元的名称。
图的边不由通勤本身来画。地理邻接矩阵里,两个区共享边界就是 1,否则是 0。语义邻接矩阵里,两个区被同一条交通线路连上就是 1,否则是 0。两条边都是无向的。流量的方向留到后面:把起点特征和终点特征按固定顺序拼在一起,模型才会把 i→j 和 j→i 学成不同的数。
预测被写成半监督的链接补全。节点集合固定,地理知识对所有节点都可见,已观测的起讫对被随机打乱,60% 训练、20% 验证、20% 测试。作者称这是直推式链接预测:补的是同一批福州行政区之间没放进训练集的流量。每个模型用验证集网格搜索后的参数跑 10 次,报告均值和标准差。重力模型和辐射模型没有随机性,标准差写成 0.00。
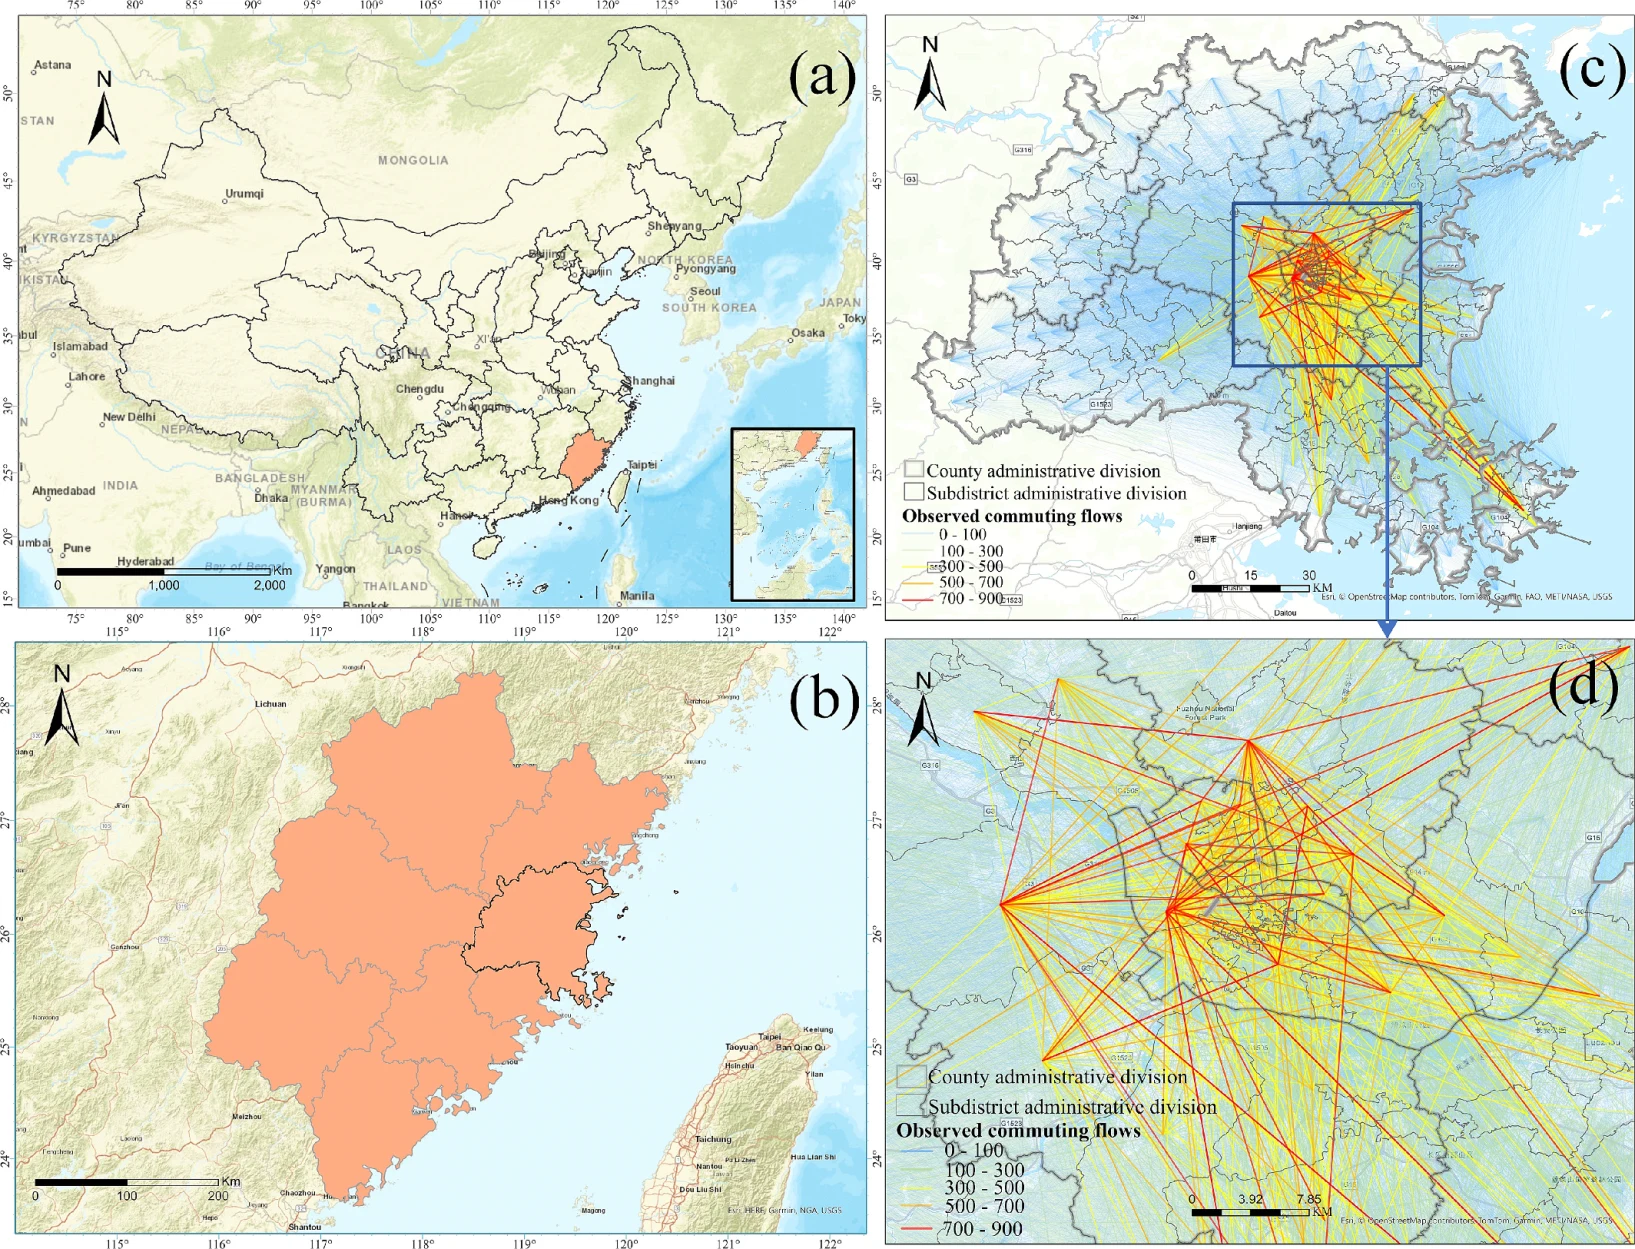
图 5|福州的通勤流量,在全市和核心区各是什么形状?
(a)福州在中国东南沿海的位置。(b)市域范围。(c)全市观测通勤流,黄到红表示流量升高,图例分为 0–100、100–300、300–500、500–700、700–900;灰线是县级边界,更细的线是乡镇街道边界,黑框是核心区。(d)核心区放大后的观测流量,高流量线集中在中心。来源:原论文 Fig. 5。
一条线路穿过的区,怎样才算连上?
语义边的规则按交通方式分开,三种方式不会混成一张边表。
道路只保留 OpenStreetMap 的高速公路、主干路、主要道路和次要道路,去掉三级路、居住区道路和支路。同名路段先拼成一条完整路线,再赋一个路线编号。一条路线经过 A、B、C 三个区,三个区两两连边,形成一个团。作者想抓住的是整条走廊的共享可达性,不是路段端点是否相接。
公交和地铁更严:两个区各自有车站,而且这两个车站属于同一条线路,才连一条边。换乘不算。作者的理由是,把换乘也连上会把图连得过密,多层图网络还会把这种间接联系再扩散一次。
节点属性来自三处。高德地图 18 类兴趣点,分成居住与生活服务、交通与基础设施、公共服务与文化旅游三组。人口来自国家统计局第七次人口普查页面,论文没有另写统计年份,因此这套人口与 2023 年 1–2 月的手机数据并不同期。路网密度由 2023 年 OpenStreetMap 道路计算。兴趣点、人口密度和路网密度进入节点特征;起点到中央商务区的距离、终点到中央商务区的距离、起终点之间的距离,留到解码阶段再拼接。区际距离在定义里写的是通常用欧氏距离,也就是地图上的直线距离。中央商务区落在哪个具体坐标,正文没有写。
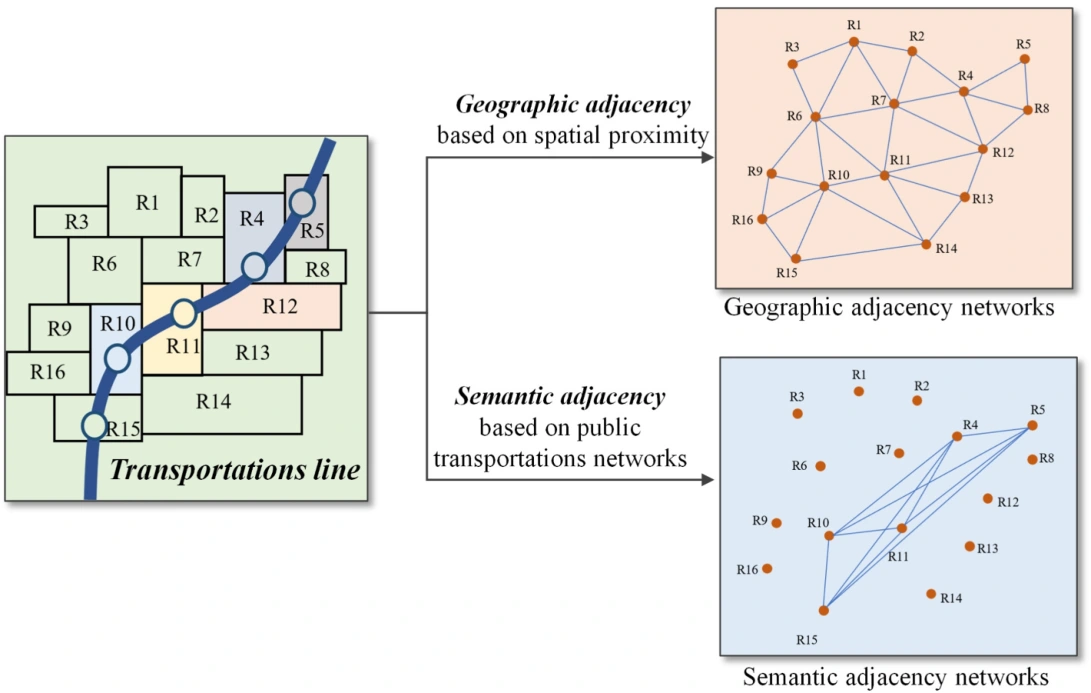
图 1|共享边界的邻居,和同一条线路连起来的邻居,差在哪里?
左图是示意:R1 到 R16 是区块,蓝线是一条交通线路。右上按空间邻近把共享边界的区块连成地理邻接网络。右下只把线路经过的区块连成语义邻接网络,没被这条线碰到的区块成为孤立点。这是机制示意,不是福州的真实分区。来源:原论文 Fig. 1。
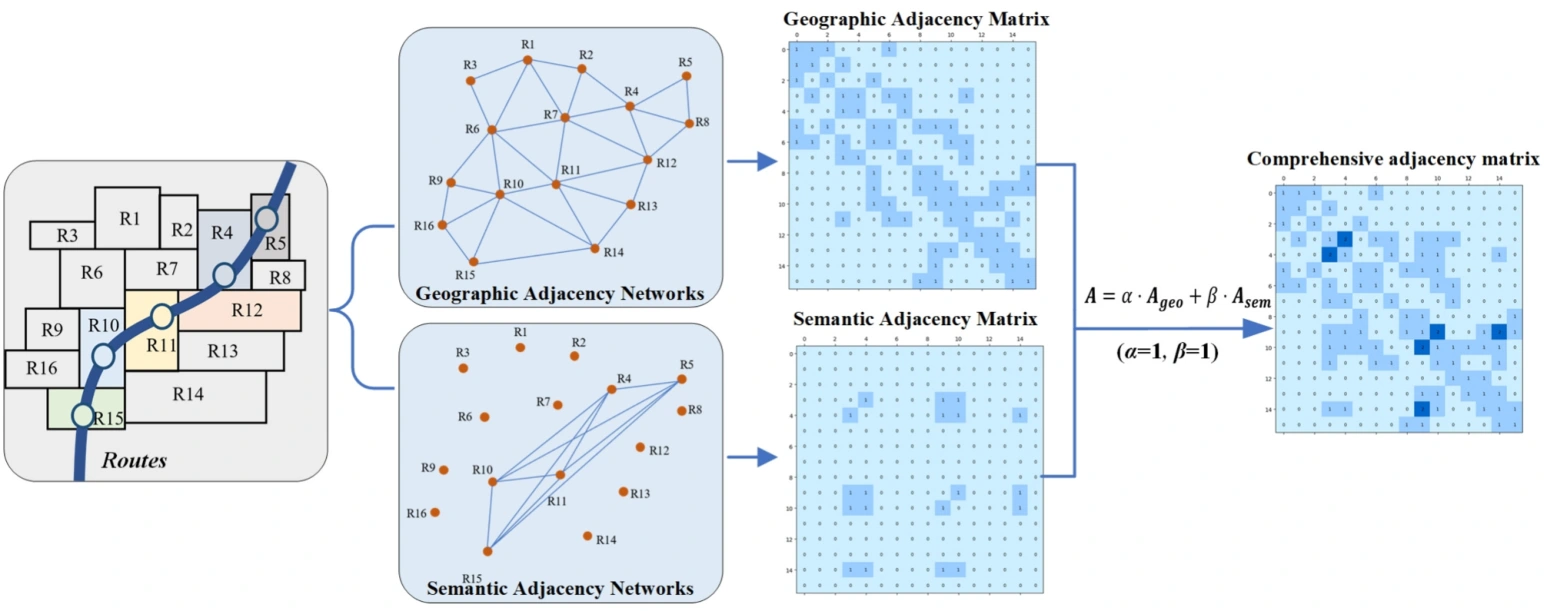
图 3|两类 0-1 矩阵怎样合成一张综合邻接?
左侧仍是线路穿过区块的示意。中间把共享边界收成地理邻接矩阵,把线路联系收成语义邻接矩阵。右侧综合邻接 A = α·地理邻接 + β·语义邻接。主实验把 α 和 β 都设为 1:只共边界或只共线路,元素是 1;两种关系都有,元素是 2;两种都没有,元素是 0。来源:原论文 Fig. 3。
补充表 S4 给的是这 193 个节点上的实际稀疏程度,不是示意图。
| 语义网络 | 活跃节点 / 总节点 | 边数 | 连通分量 | 覆盖面积 | 面积覆盖率 |
|---|---|---|---|---|---|
| 城市道路 | 181 / 193(93.78%) | 15,198 | 13 | 14,013.77 km² | 95.07% |
| 公交 | 144 / 193(74.61%) | 1,837 | 52 | 9,984.57 km² | 67.74% |
| 地铁 | 39 / 193(20.21%) | 274 | 155 | 1,256.7 km² | 8.53% |
活跃节点比例和面积覆盖率回答的是两件不同的事。道路连上了 93.78% 的节点,这些节点的面积占 95.07%,所以连上的区略大一些。正文 3.2 节引用的 93.8%、74.6%、20.2% 是活跃节点比例;4.2 节引用的 95.07%、67.74%、8.53% 是面积覆盖率。两套数都在表 S4,并不是互相矛盾的两次实验。
分量数需要和孤立节点一起读。没有语义边的节点各算一个分量。道路的孤立节点是 193−181 = 12,分量共 13,因此 181 个有道路边的节点落在同一个连通块里。公交的孤立节点是 49,分量共 52,144 个活跃节点分成 3 块。地铁的孤立节点是 154,分量共 155,39 个有地铁边的节点只构成 1 块。地铁“155 个分量”里,绝大多数是没有车站的区,不是 155 条互不相连的地铁走廊。
家和工作地是怎样从定位点里圈出来的?
通勤来自一家位置服务商提供的福州手机定位,时间是 2023 年 1 月到 2 月的工作日。周末和节假日没进这张网。正文没有写出运营商名称,也没有给出用户数。
停留点用两个门槛提取:空间半径 R = 500 米,时间 T = 5 小时。夜间 19:00–08:00 停留最久的位置算居住地,工作日白天 08:00–19:00 停留最久的位置算工作地。居住地到工作地的这一对,就是一条通勤。全部记录聚合后得到 1,374,963 条通勤,再汇总到行政区。论文没有给出汇总后有多少个非零区对,因此测试集 20% 对应多少条区对,也无从反推。MAE 公式里的 n 是被预测的区对数,具体数值正文没有单列。
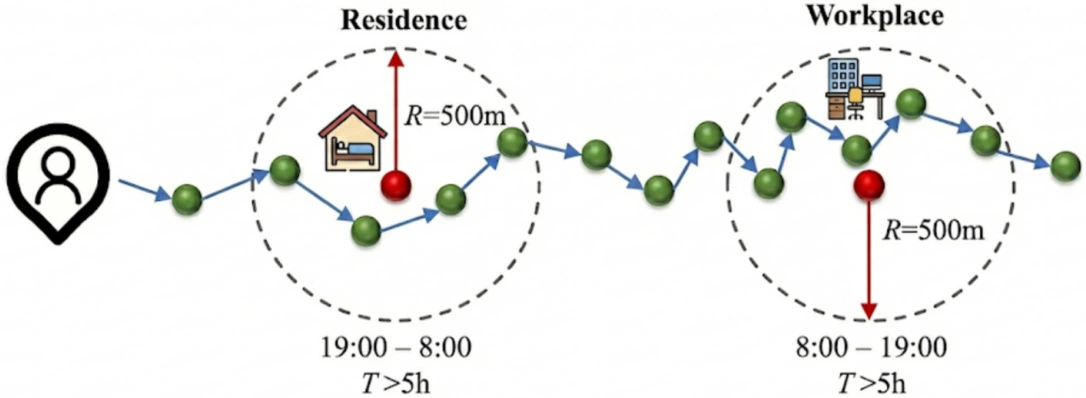
图 6|一条定位轨迹要满足什么,才变成通勤起讫?
左半是居住地:夜间窗口里,半径 500 米、停留超过 5 小时的最久停留。右半是工作地:白天窗口使用同一套半径和时间门槛。两端确定之后,居住地指向工作地,记为一条起讫流。来源:原论文 Fig. 6。
图注意力在乘什么?
编码端把综合邻接和节点特征一起送进两层图注意力网络。节点特征先乘一个可学习矩阵,得到初始表示。普通注意力只看两个节点的特征像不像;这篇在分数上再乘综合邻接的元素,并乘一个调节系数 θ。主实验 θ = 1。补充材料在 0.5、1.0、1.5、2.0 上做了检查:三种语义的验证误差变化不大,道路仍最好,公交次之,地铁最弱;地铁在 θ = 1.5 时略好于 θ = 1,差距很小。随后对邻居做 softmax,用指数线性单元更新节点。嵌入维度 k 在 4、8、16、32、64 里选择,验证集 MAE 在 k = 8 最低。
解码端不再改图。每个起讫对拼成一条 2k+3 维的向量:起点的 8 维嵌入、起点到中央商务区的距离、起终点直线距离、终点的 8 维嵌入、终点到中央商务区的距离,共 19 个数。多层感知机的隐藏层宽度取 128,隐藏层用 sigmoid,损失是均方误差。优化器用 Adam,学习率 0.001,一阶和二阶矩的指数衰减率是 0.9 和 0.999,批大小 128,最多 700 轮,并使用早停。地理属性和距离矩阵先做归一化。
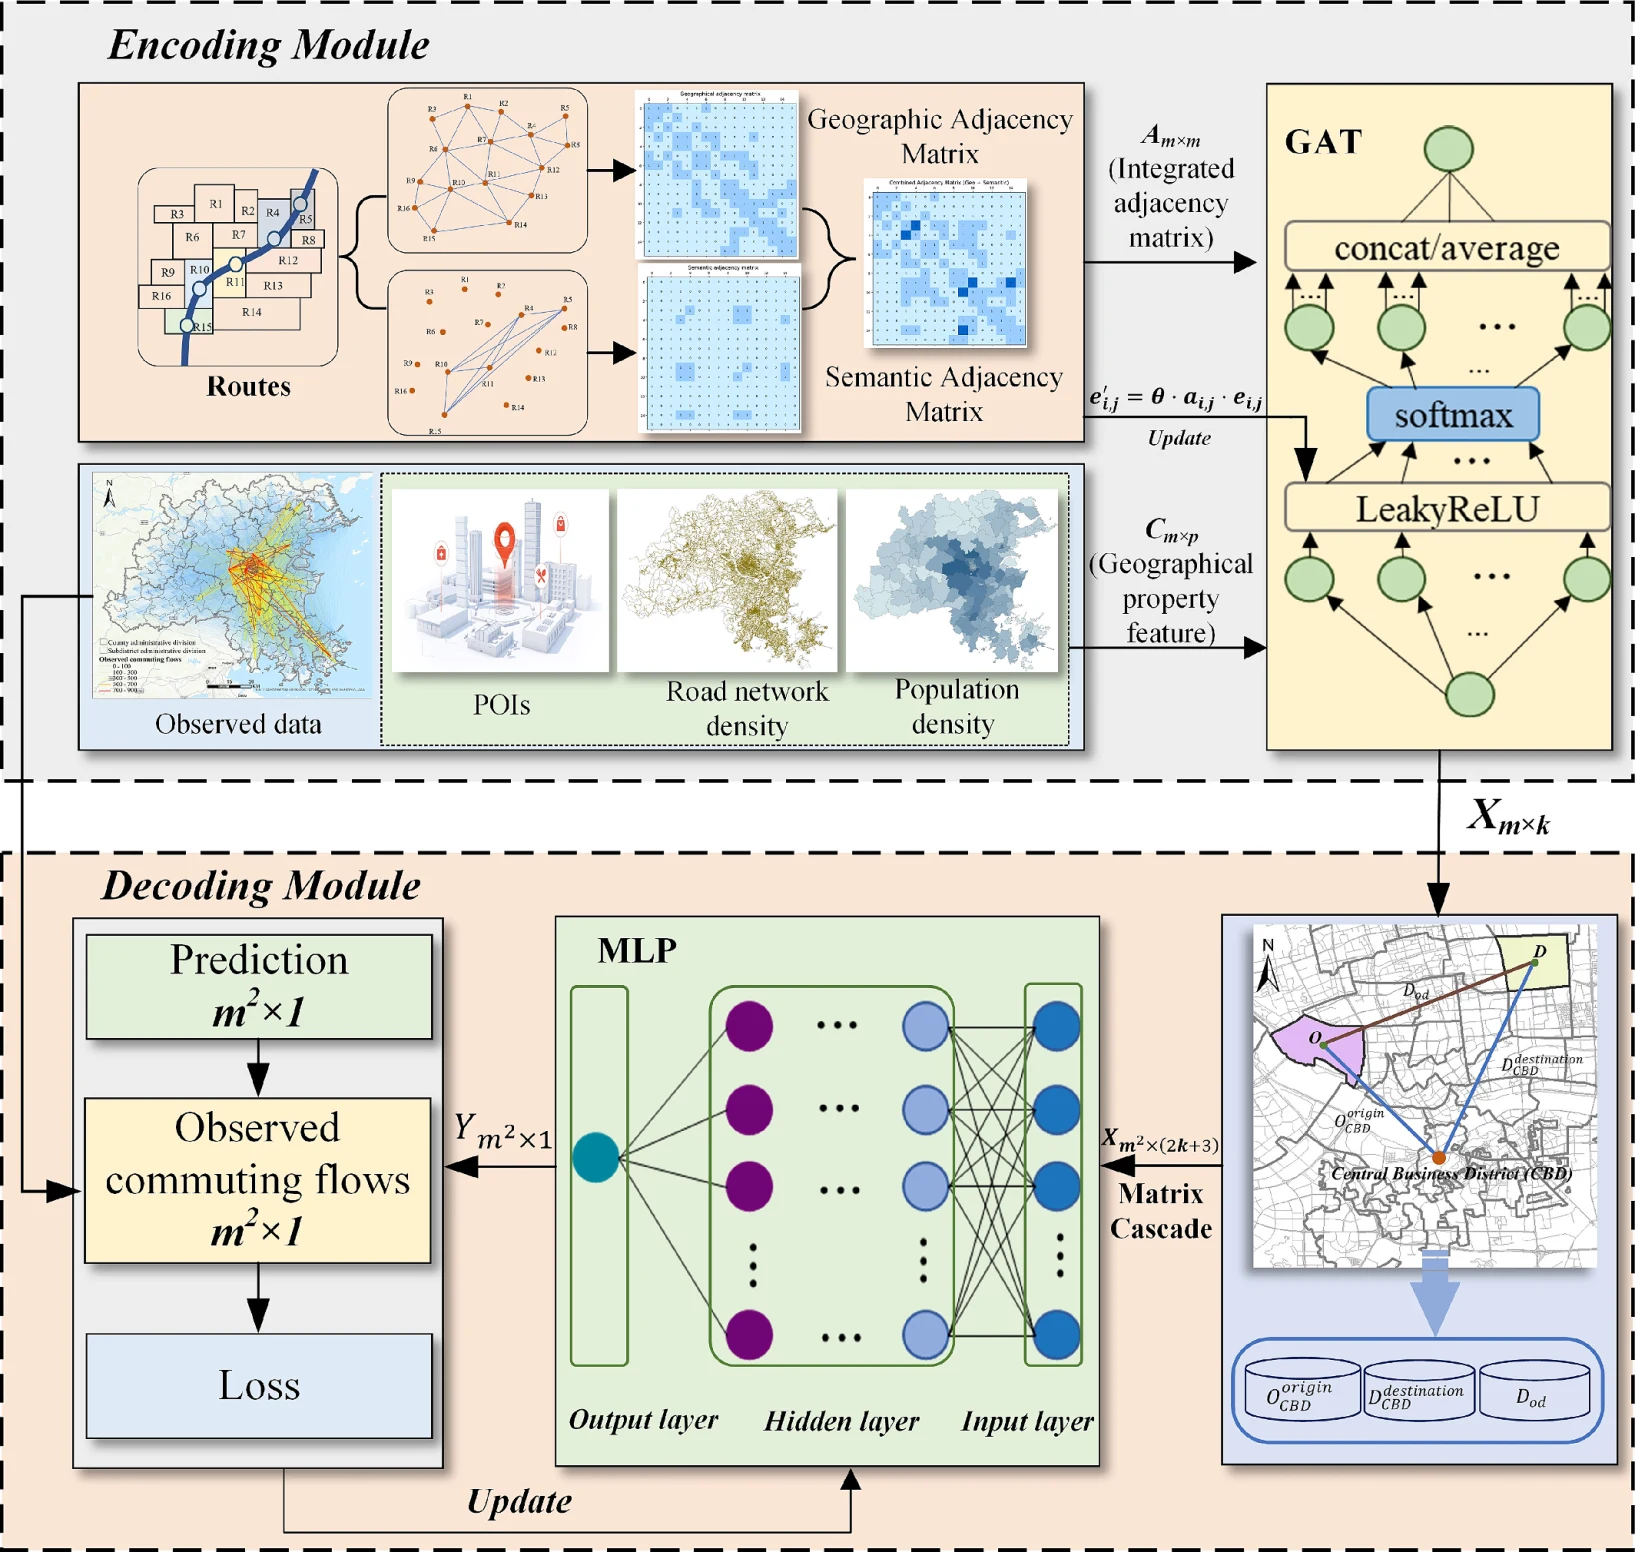
图 2|从邻接和地理属性到一条流量,中间经过哪两段?
上半是编码:路线关系分成地理邻接和语义邻接,节点一侧放入兴趣点、路网密度、人口密度和观测数据,图注意力按综合邻接做加权,输出每个区的嵌入。下半是解码:嵌入与到中央商务区的距离、区际距离拼接,多层感知机输出全部区对的预测流量,再和观测流量算损失并回传。图中的 m²×1 表示区对数量这一维。来源:原论文 Fig. 2。
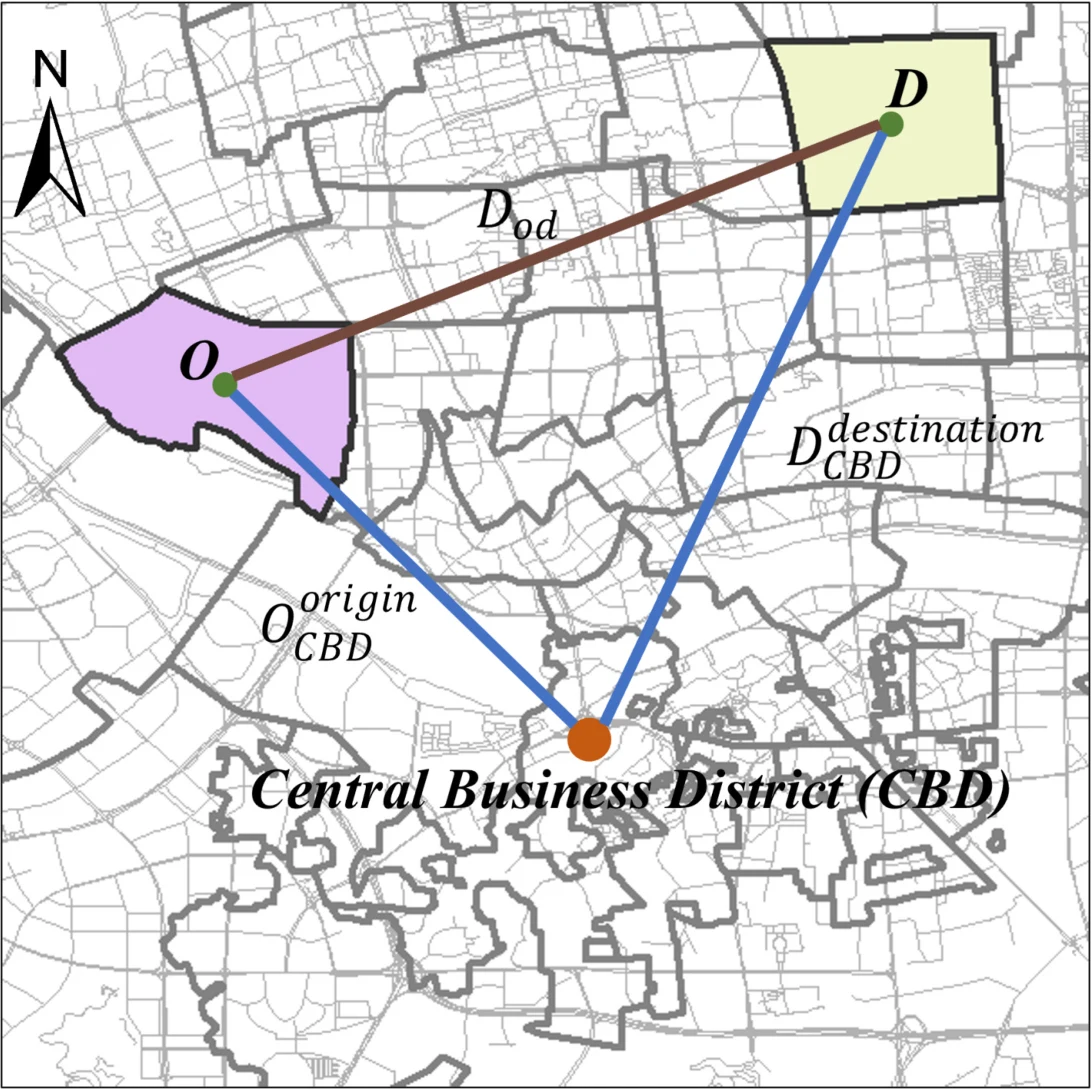
图 4|区对向量里的三个距离各量哪一段?
棕色线是起点 O 到终点 D 的直线距离。两条蓝色线分别是起点、终点到中央商务区的直线距离。这三个标量跟两端的嵌入拼在一起,流量方向就由“谁放在起点位置”决定。来源:原论文 Fig. 4。
同样用了两类边,为什么还比 GSGNN 低一截?
对照分三层。重力模型用两端人口和距离。辐射模型用起点、终点和中间机会的人口,本身不估计距离衰减参数。XGBoost 和随机森林只用起点和终点的兴趣点。GMEL、GCN-RF、GCN-MLP 以及去掉语义边的 GAGNN-SA,只使用地理邻接。GAGNN-GA 只使用语义邻接。GSGNN 和完整 GAGNN 两类边都用。差别在用法:GSGNN 先用图卷积处理地理邻接,再把结果送进图注意力处理语义邻接;GAGNN 先把两类边加权合成一张矩阵,再在同一层注意力里同时看物理邻近和线路联系。
表 4 是道路语义下、测试集上 10 次运行的均值,括号里是标准差。
| 模型 | MAE | MAPE | RMSE | CPC |
|---|---|---|---|---|
| 重力模型 | 30.24(0.00) | 1.76(0.00) | 35.92(0.00) | 0.35(0.00) |
| 辐射模型 | 26.75(0.00) | 1.98(0.00) | 28.38(0.00) | 0.44(0.00) |
| XGBoost | 9.86(0.25) | 0.84(0.04) | 16.65(0.81) | 0.76(0.02) |
| 随机森林 | 8.34(0.12) | 0.82(0.02) | 18.35(0.28) | 0.78(0.03) |
| GSGNN | 3.83(0.06) | 0.49(0.02) | 6.35(0.12) | 0.94(0.02) |
| GMEL | 7.78(0.18) | 0.71(0.02) | 7.54(0.21) | 0.88(0.05) |
| GCN-RF | 6.04(0.14) | 0.55(0.04) | 7.02(0.16) | 0.93(0.03) |
| GCN-MLP | 7.23(0.16) | 0.98(0.03) | 11.23(0.25) | 0.82(0.04) |
| GAGNN-GA(只留语义) | 6.43(0.11) | 0.64(0.02) | 7.43(0.15) | 0.90(0.06) |
| GAGNN-SA(只留地理) | 6.28(0.09) | 0.58(0.02) | 6.82(0.14) | 0.93(0.05) |
| GAGNN | 3.26(0.05) | 0.42(0.02) | 5.32(0.08) | 0.96(0.04) |
MAPE 的分母是每个区对自己的观测流量,再对区对取平均。表里的 0.42 表示平均绝对误差约为观测流量的 42%,不是 0.42 人次。CPC 把每个区对上预测和观测的较小值加总,乘 2,再除以预测总和与观测总和。大流量区对对 CPC 的拉动更大;MAPE 则让小流量区对和大流量区对各占一条。辐射模型的 MAE 26.75 低于重力模型的 30.24,MAPE 却是 1.98 对 1.76,所以“绝对误差更小”和“相对误差更小”在这里不是同一句话。
GAGNN 相对重力模型,MAE 下降 (30.24−3.26)/30.24 = 89.2%。相对只留地理邻接的 GAGNN-SA,MAE 从 6.28 降到 3.26。只使用地理邻接的 GCN-RF,MAE 6.04、CPC 0.93,已经接近 GAGNN-SA。两类边都用之后,GSGNN 把 MAE 降到 3.83;GAGNN 再降到 3.26。后一截小于从“只有地理边”到“两类边都有”的那一截。
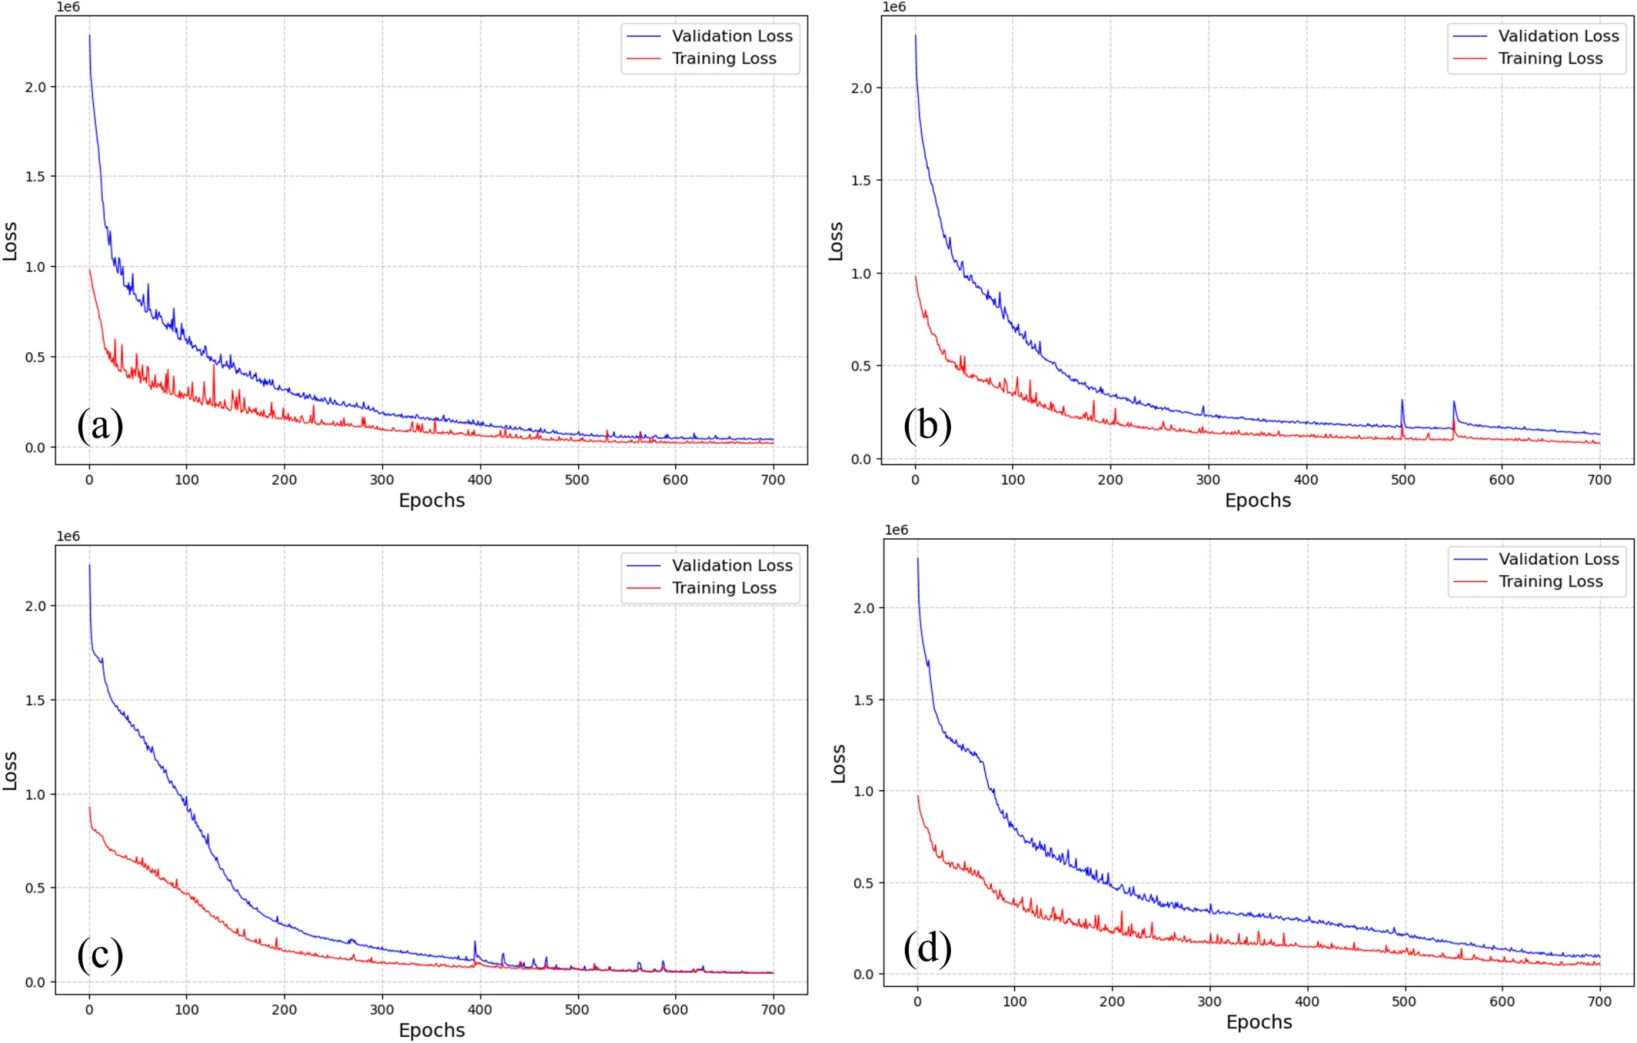
图 7|四种语义设定下,训练有没有发散?
横轴是训练轮数,纵轴是损失,蓝线为验证损失,红线为训练损失。(a)道路。(b)公交。(c)地铁。(d)没有语义连接。四条曲线都下降并趋于平稳,验证损失高于训练损失。没有语义边时,损失降得更慢,后段仍高于另外三幅。图中没有印出最终损失的数值。来源:原论文 Fig. 7。
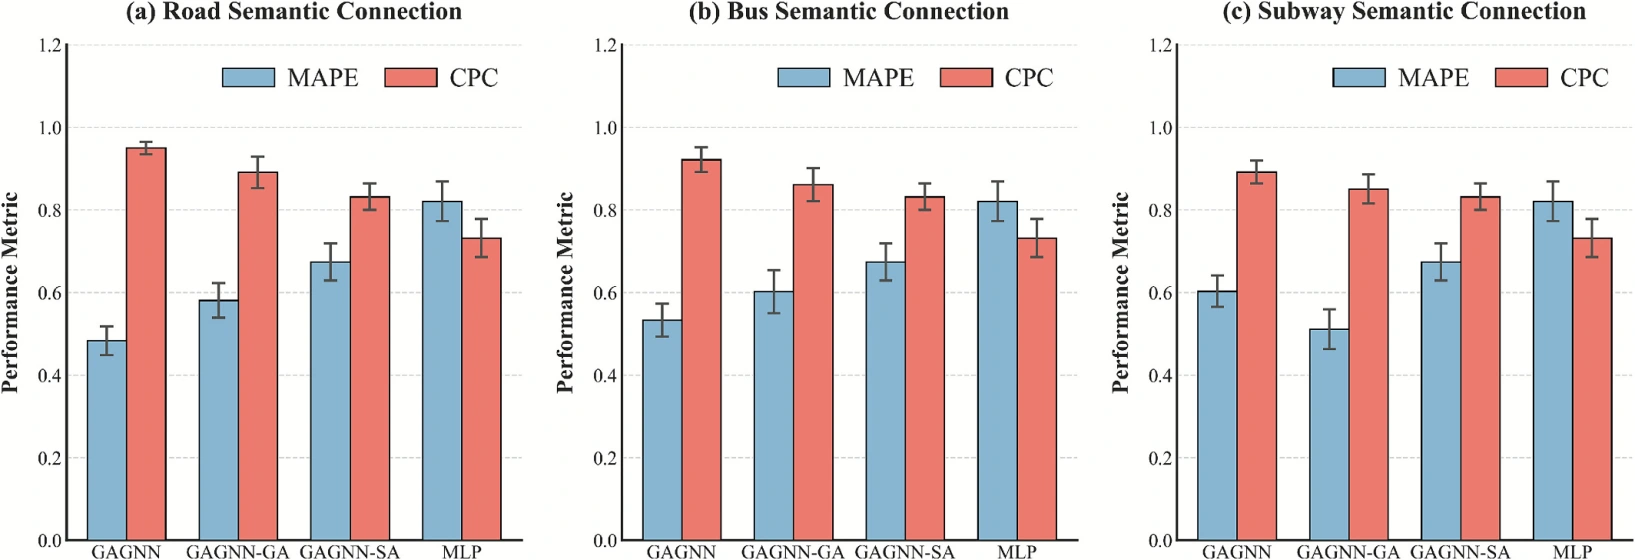
图 8|去掉地理边、去掉语义边,或两条都去掉,验证误差升多少?
蓝柱是 MAPE,红柱是 CPC,误差棒是 10 次运行的标准差。正文写这组标准差低于 0.05。(a)道路语义:相对完整 GAGNN,GAGNN-GA、GAGNN-SA、只含预测器的 MLP 使 MAPE 升高 20.3%、39.5%、70.0%,CPC 下降 6.2%、12.4%、23.0%。(b)公交:MAPE 升高 12.9%、26.5%、54.0%,CPC 下降 6.6%、9.8%、20.6%。(c)地铁:MAPE 升高 18.0%、31.9%、60.7%,CPC 下降 4.6%、6.7%、17.9%。这是验证集上的相对变化,和表 4 的测试集绝对均值不是同一张成绩单。来源:原论文 Fig. 8。
道路补上的流量,公交和地铁补不上同等的一块
把语义网络换成公交、地铁,或者完全不用,残差图给出另一组汇总。横轴是观测通勤流量,纵轴是预测减观测。红色虚线是残差为 0。图内标注是这一张散点图的汇总,正文叙述只引用了其中的 MAE 和 CPC。
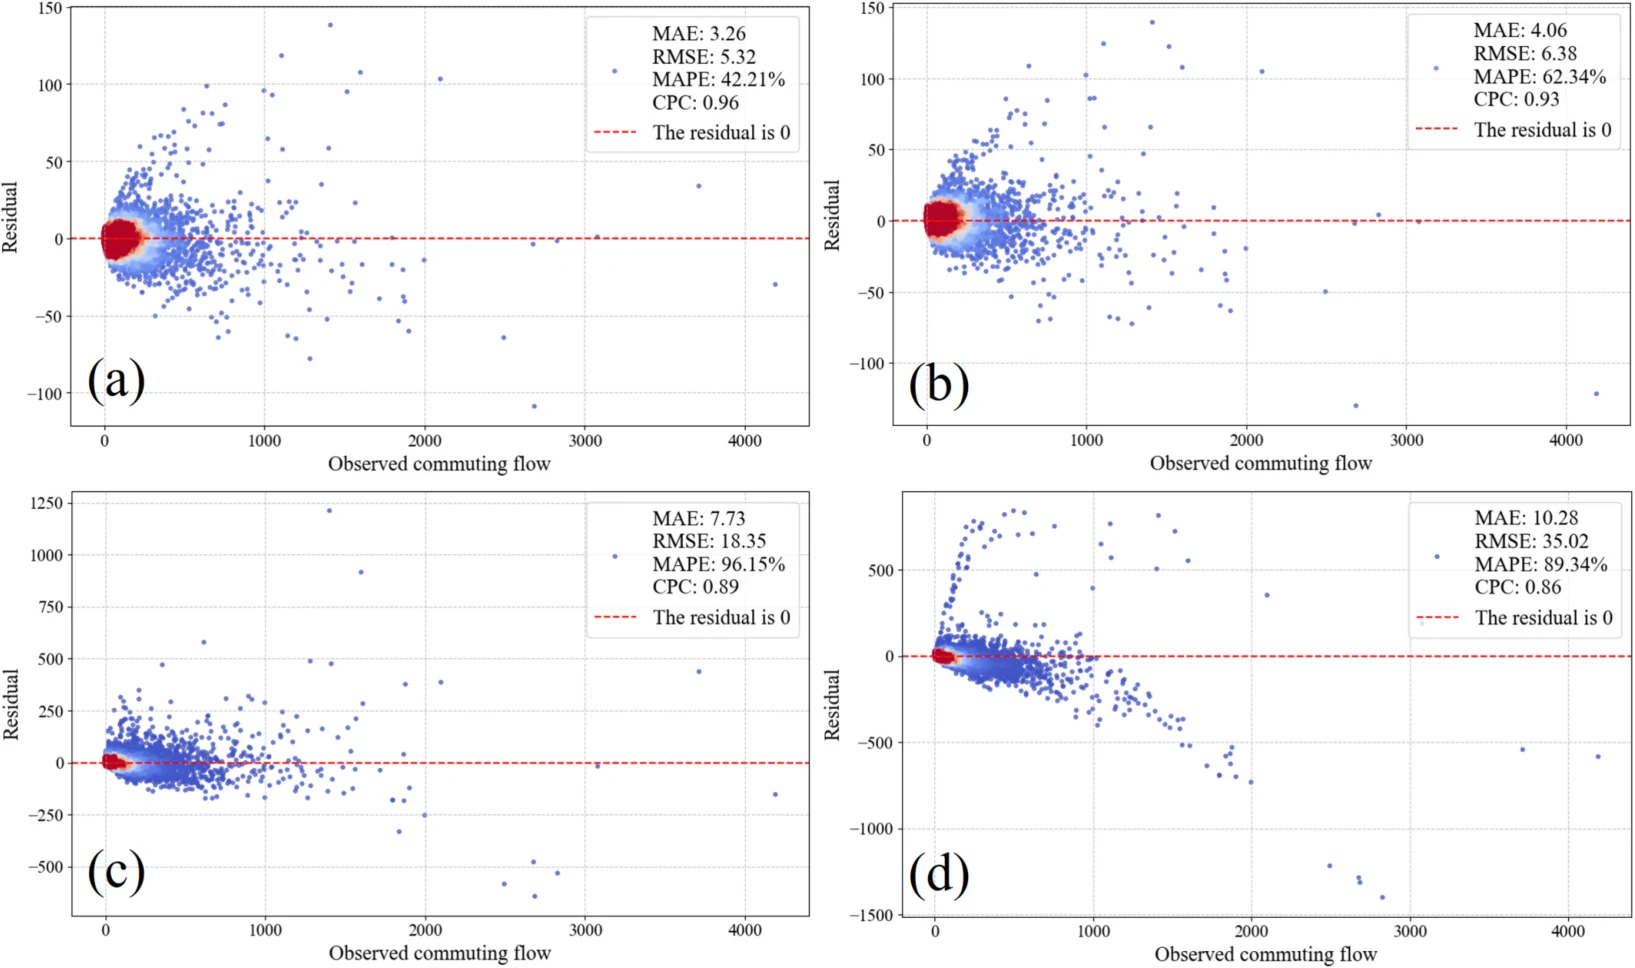
图 9|流量越大,哪一种语义边还能把点留在零残差附近?
(a)道路:MAE 3.26,RMSE 5.32,MAPE 42.21%,CPC 0.96。点在小流量处最密,大流量处有正负偏离,纵轴大约落在 −150 到 150。(b)公交:MAE 4.06,RMSE 6.38,MAPE 62.34%,CPC 0.93。(c)地铁:MAE 7.73,RMSE 18.35,MAPE 96.15%,CPC 0.89;纵轴拉到约 −500 到 1250,大流量处出现很大的正残差。(d)无语义连接:MAE 10.28,RMSE 35.02,MAPE 89.34%,CPC 0.86;残差向下伸到约 −1500。道路的 MAPE 42.21% 与表 4 的 10 次均值 0.42(标准差 0.02)是同一指标的两种写法。摘要把地铁写在公交之前;按这四组 MAE,顺序是道路、公交、地铁、无语义连接。来源:原论文 Fig. 9。
地铁 MAPE 达到 96.15%,同时 CPC 还有 0.89。两件事可以同时成立:CPC 由大流量的重叠撑住,MAPE 对每个区对等权,再除以该对的观测流量,小流量区对的相对误差会把 MAPE 抬高。
空间分布把同一比较画回地图。预测流量仍用 0–100 到 700–900 五档。误差图把偏差画成连线,图内没有可逐级读出的误差人数色标,所以只能比较线的疏密,不能把某一种红色读成“误差等于多少人”。
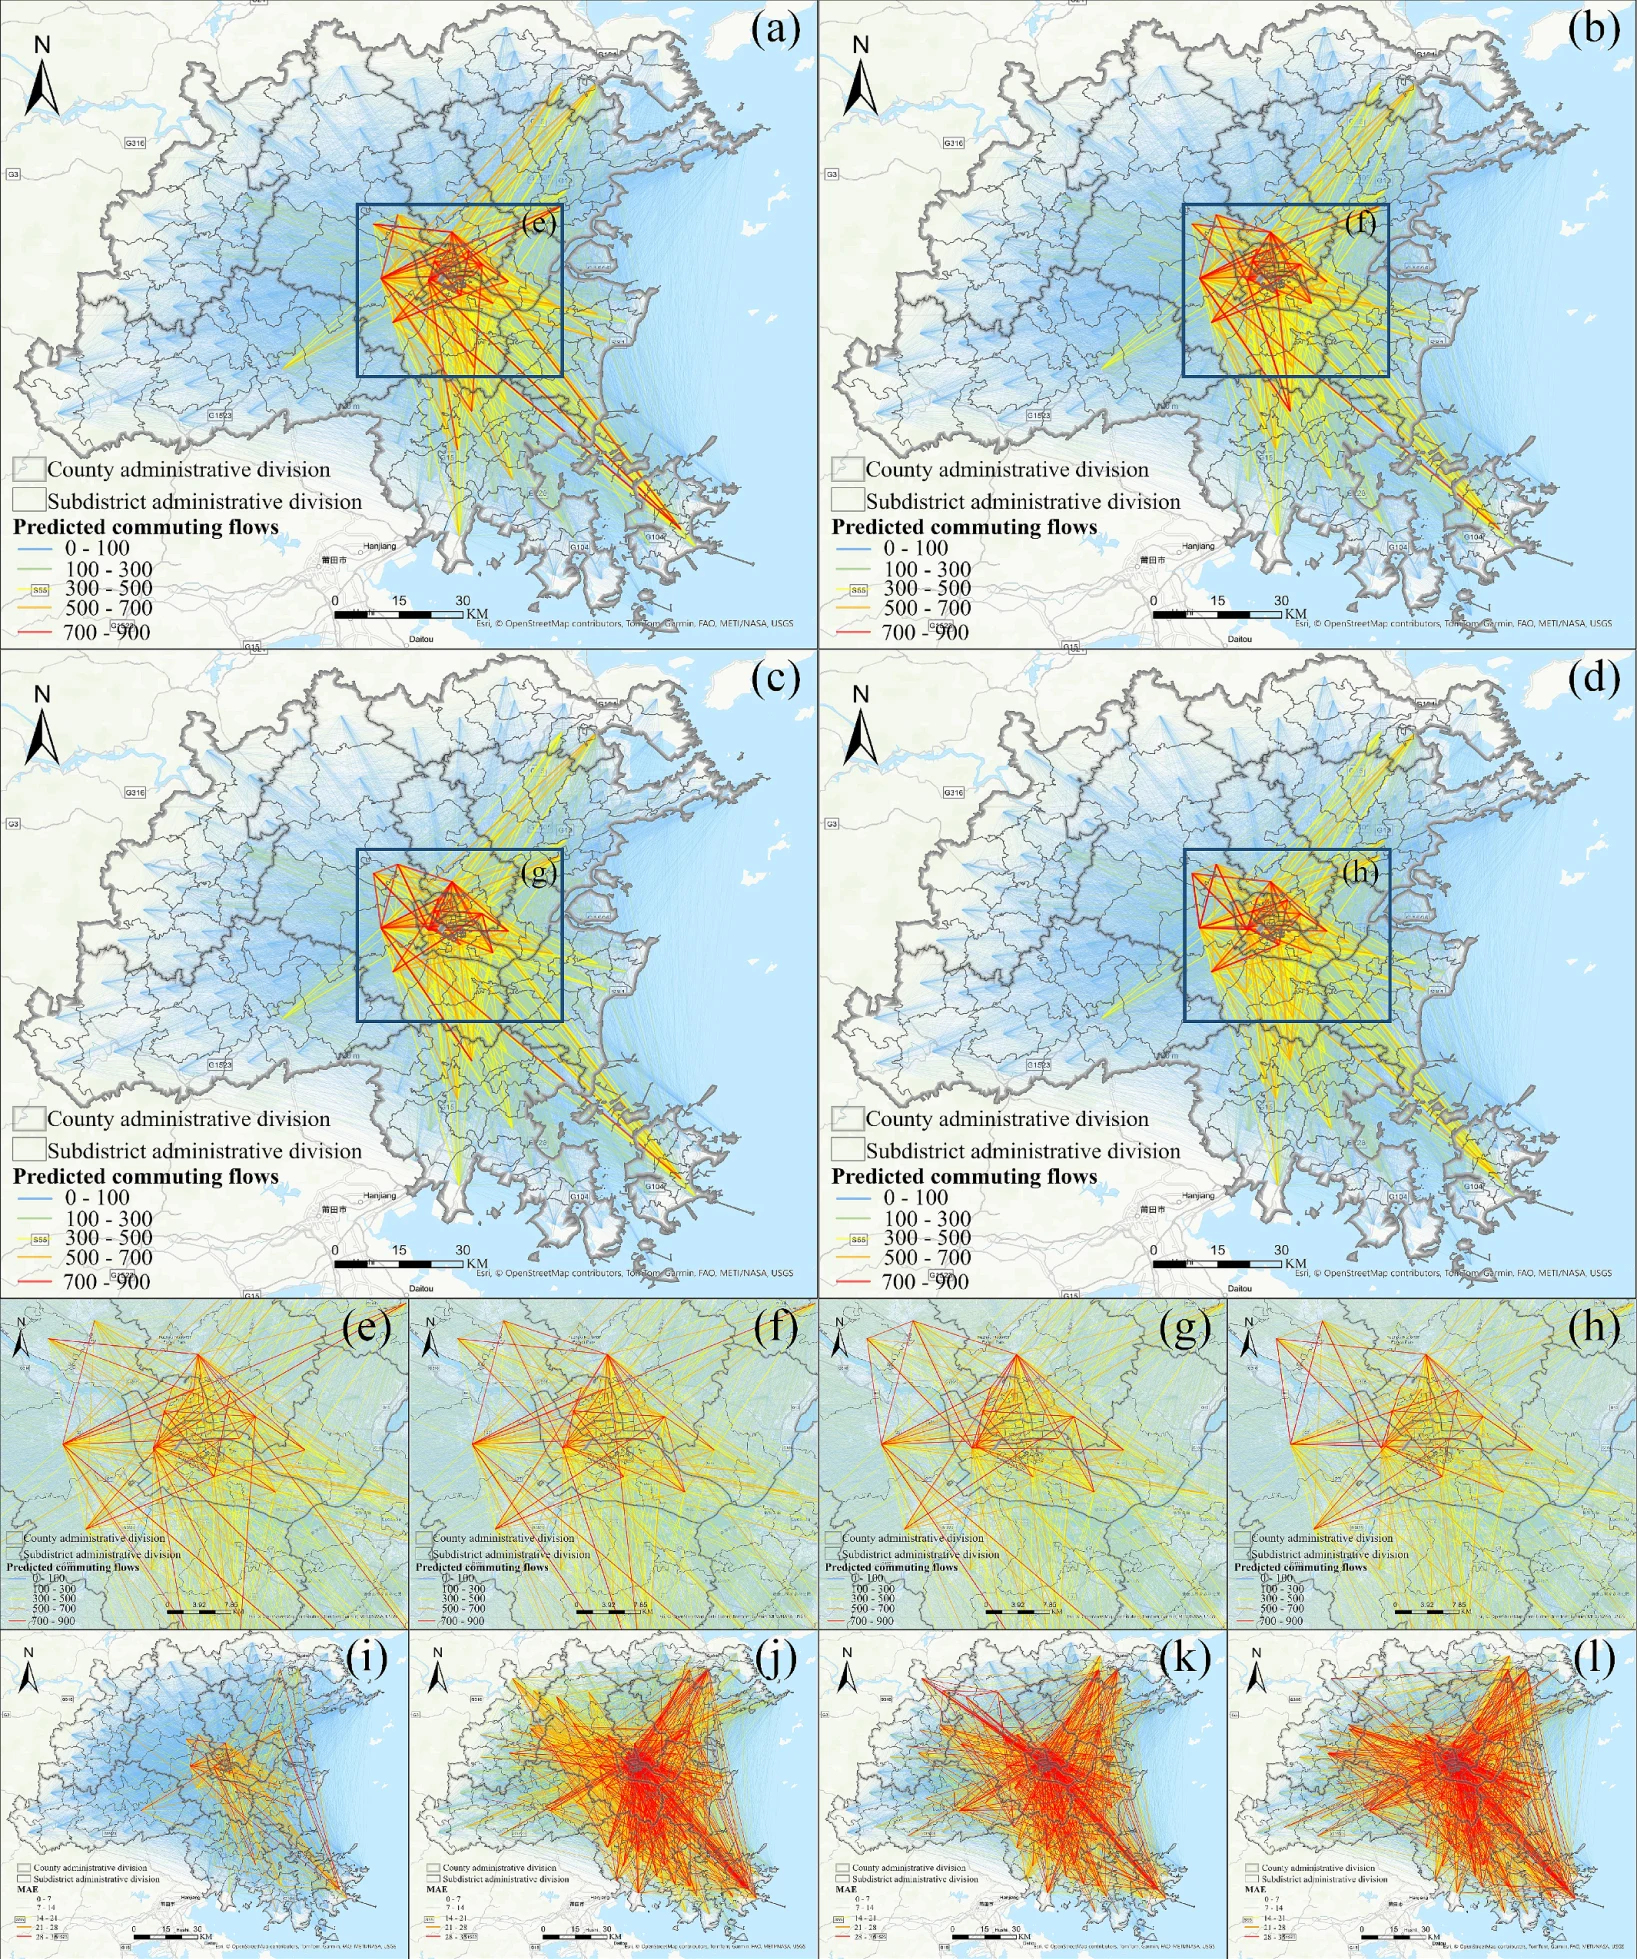
图 10|预测流量和误差,从核心区到外围怎样变?
(a、e、i)道路语义:全市预测、核心区放大、误差线。(b、f、j)公交。(c、g、k)地铁。(d、h、l)没有语义连接。(a–d)的高流量仍集中在黑框所示的核心,向外围变稀;没有语义边时,外围的中等流量线更散。(e–h)把核心区拉开,道路和公交的粗线更多,地铁和没有语义边时核心内部的线更乱。(i–l)误差线在核心最密;公交、地铁和没有语义边时,误差线更明显地伸向外围。正文据此说道路对长距离流量的误差较小,公交和地铁在外围留下语义空档。来源:原论文 Fig. 10。
格子放大以后,谁的图还留得住细节?
主实验的 193 个行政区之外,作者另做了一组 1、2、3、4、5 公里格子。图 11 的横轴写成 1×1 到 5×5。补充表 S5 说明,覆盖面积等于有语义边的格子数乘格子面积。
1 公里时全市有 15,956 个格子。道路连上 3,258 个,边数 3,376,033,覆盖 3,258 km²。公交连上 2,711 个(16.99%),边数 132,192,分量 13,251。地铁连上 176 个(1.10%),边数 3,929,覆盖 176 km²,分量 15,781。按孤立格子单独计分量,地铁这 176 个活跃格子仍在同一个连通块里;15,781 个分量里,15,780 个是没有车站的格子。
5 公里时格子总数降到 755。道路边数降到 76,620,活跃格子 439,覆盖 10,975 km²。公交活跃格子 306,覆盖 7,650 km²,活跃节点比例 40.52%。地铁活跃格子 27,覆盖 675 km²。地铁覆盖从 176 km² 增到 675 km²,大约是四倍,因为一个 25 km² 的格子更容易把同一条线路的车站罩进去。
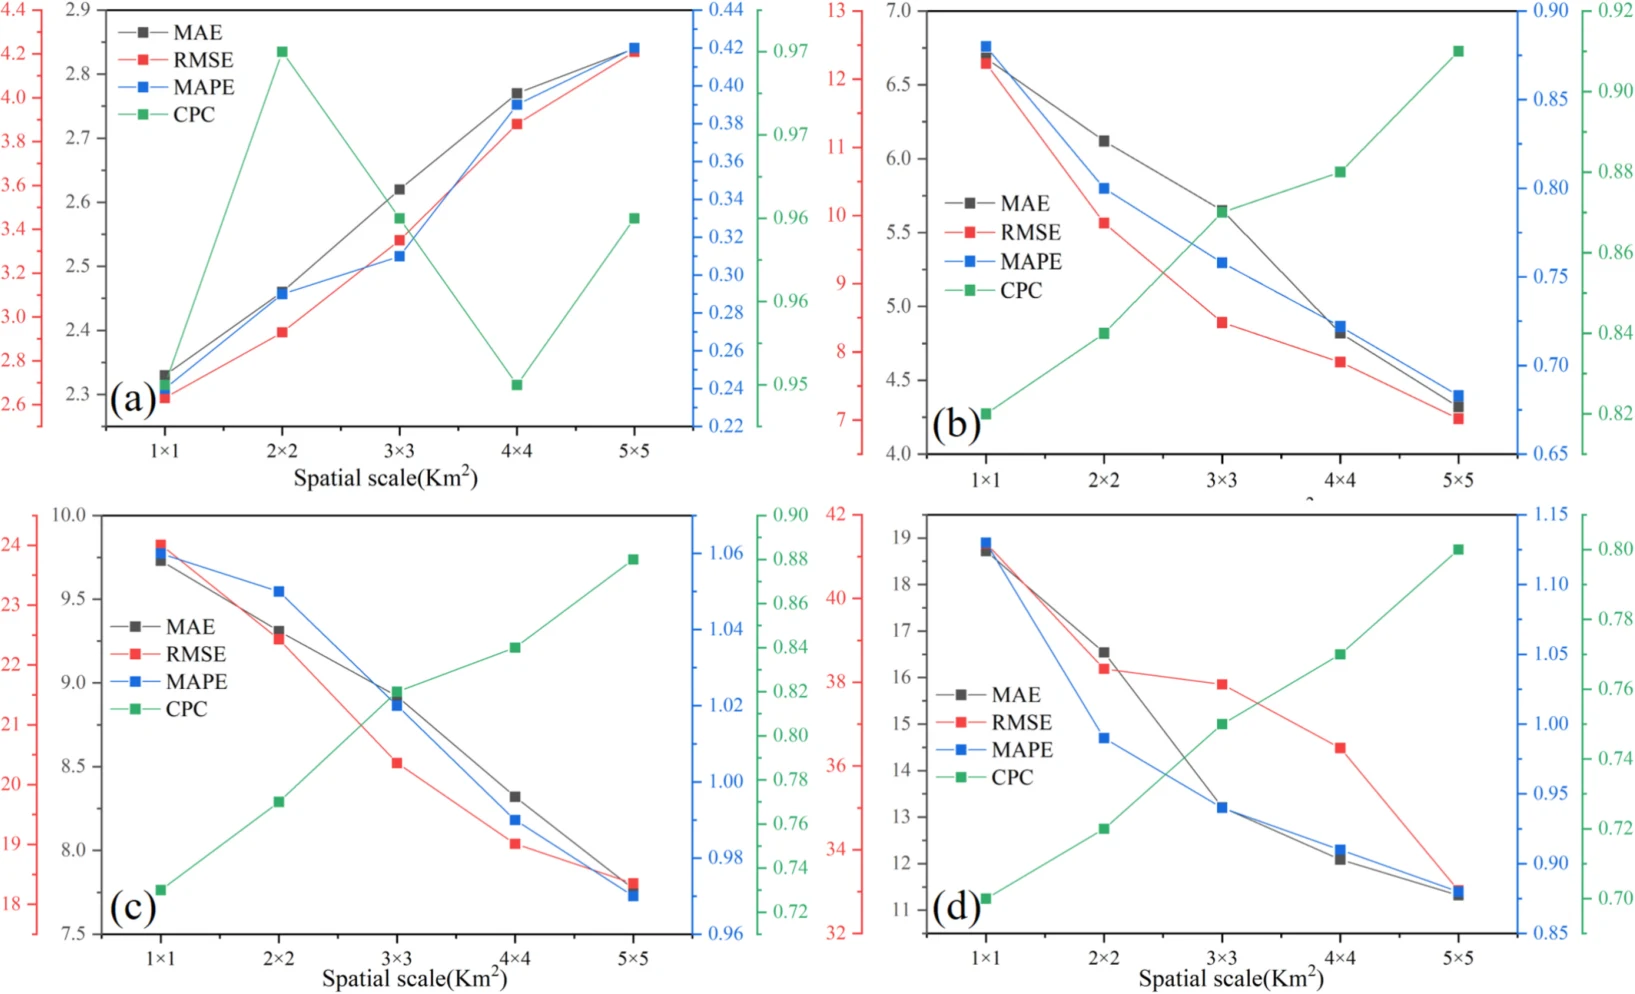
图 11|尺度从 1 公里放到 5 公里,四条语义曲线往哪边走?
黑、红、蓝、绿分别是 MAE、RMSE、MAPE、CPC,左右纵轴刻度不同。(a)道路:MAE、RMSE、MAPE 随尺度上升,正文给出的幅度是从 1 公里到 5 公里 MAE 约升高 17.2%;CPC 有起伏,正文没有逐尺度列出。(b)公交:三条误差曲线下降,CPC 上升,MAE 降 35.3%。(c)地铁:误差下降,CPC 上升,MAE 降 20.1%。(d)没有语义边:误差下降,CPC 上升,整条曲线仍差于有语义边的设定。除这三个百分比外,图上各点没有逐点数值表,不把曲线高度读成精确 MAE。来源:原论文 Fig. 11。
道路在细格子上边极多,模型能看见局部差异;格子变粗后,同一条路线把更大的范围连成团,局部流量被抹平,作者把这称为过平滑。公交和地铁在 1 公里上太碎,很多起讫对在语义图里根本没有路径;格子变粗后,车站的服务范围被格子吃进来,长距离联系才变得可见。没有语义边的模型在粗格子上也会变好,因为零散流量被加总成更稳的数。它始终差于带交通语义的版本,所以变好的那一部分来自统计上的归并,不来自线路结构。
停留门槛和两种边的权重,动一动会怎样?
居住地和工作地的门槛在道路语义上做了网格:半径 300、400、500、600 米,停留 3、4、5、6 小时。格内括号是识别出的通勤条数,单位是百万;粗体是 MAPE。黑框是正文采用的 500 米、5 小时。
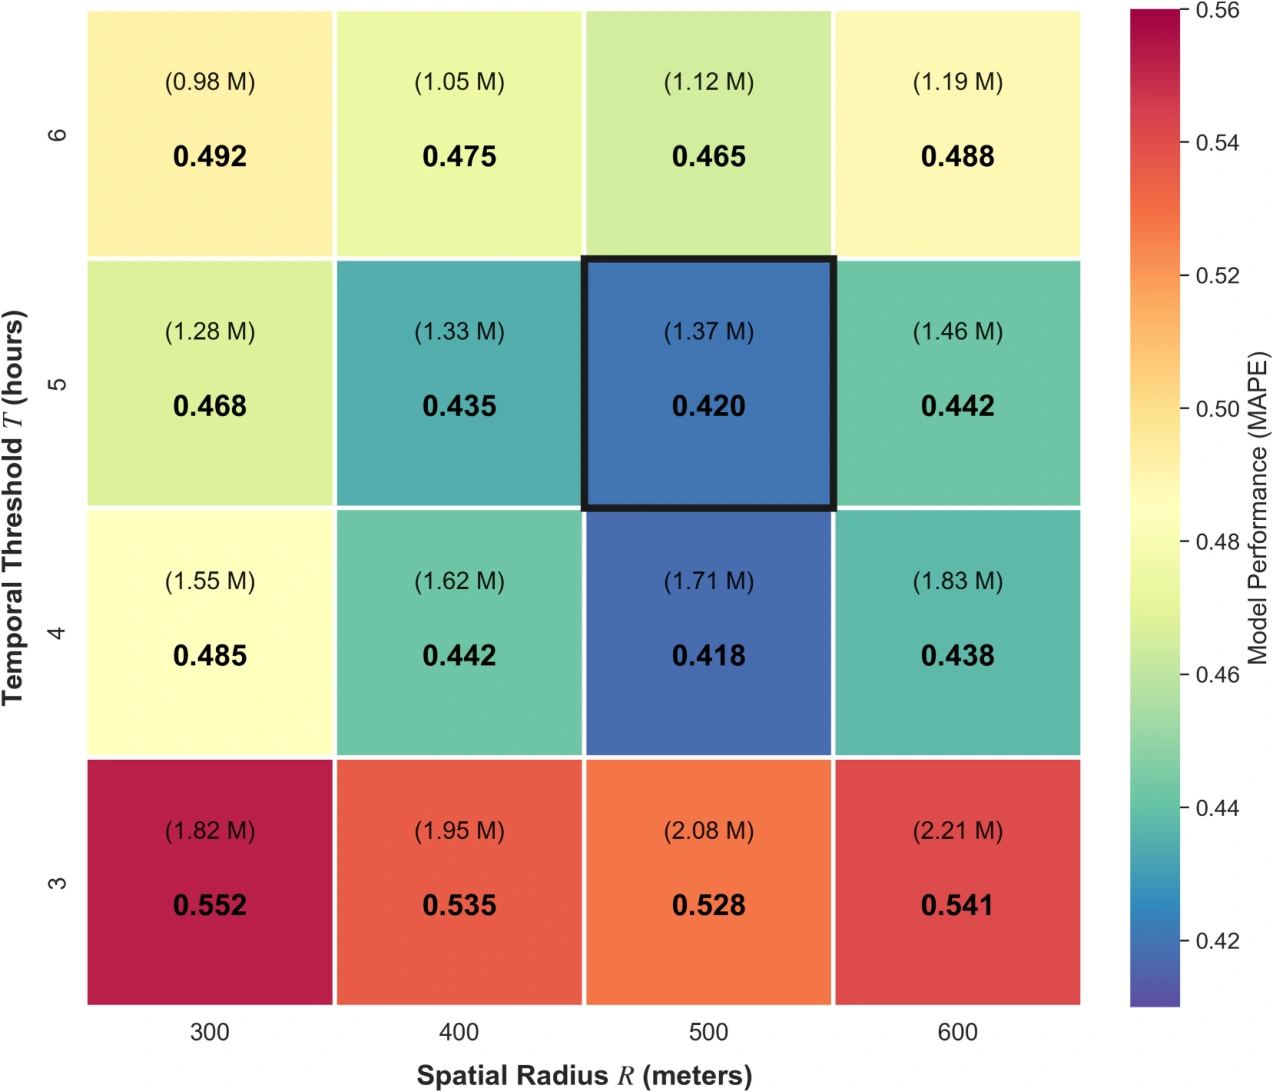
图 12|多圈进一些停留,MAPE 会不会更好?
颜色越蓝,MAPE 越低。500 米、5 小时:1.37 百万条,MAPE 0.420,与正文的 1,374,963 条相符。500 米、4 小时:1.71 百万条,MAPE 0.418,是图中最低。3 小时、600 米最多,2.21 百万条,MAPE 0.541;3 小时整行都在 0.528 以上。6 小时、300 米只剩 0.98 百万条,MAPE 0.492。作者保留 5 小时,是为了和既有居住地识别研究一致,并写明与最低点只差 0.002。来源:原论文 Fig. 12。
α 和 β 在 0.2 到 1.4 之间变动。道路和公交的最低 MAPE 出现在 α = β = 1,分别是 0.450 和 0.570。地铁在等权处是 0.870,全图最低出现在 α = 1.0、β = 0.8,MAPE 0.835。把任一权重降到 0.2,道路热图边缘升到大约 0.55–0.60;正文举例说 MAPE 会冲到 0.58。公交和地铁在低权重处更高,地铁角上接近 1。权重大于 1.2 之后,三幅图的波动都小于把权重降到 0.2。
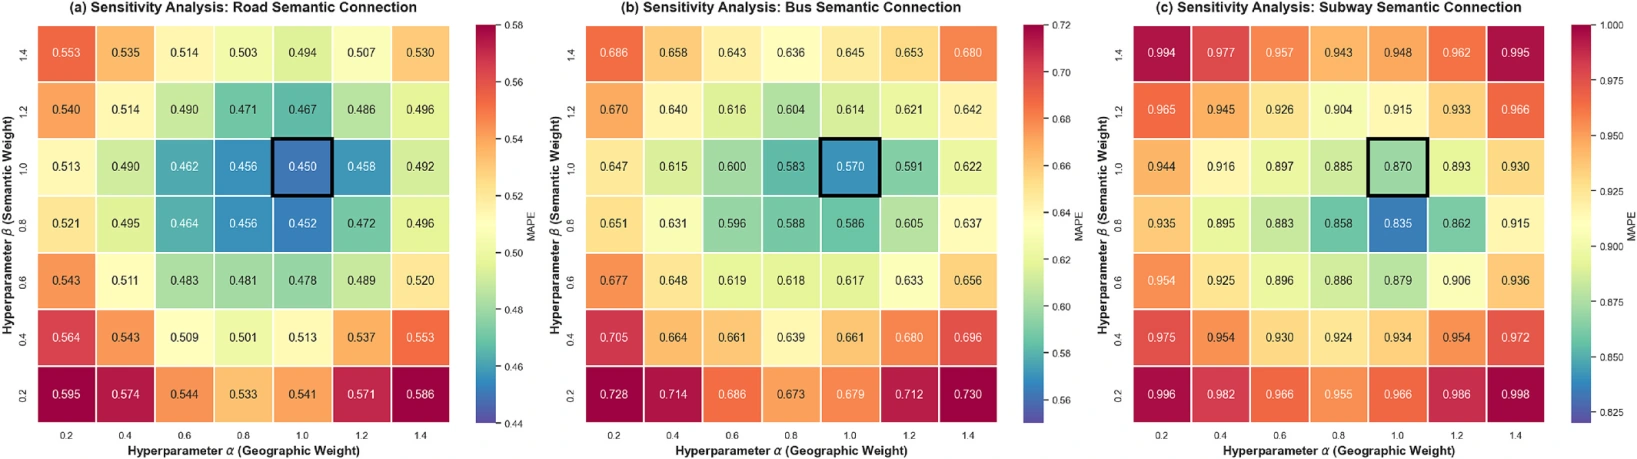
图 13|地理边和语义边必须五五开吗?
横轴是地理权重 α,纵轴是语义权重 β,颜色是 MAPE,黑框是 α = β = 1。(a)道路,框内 0.450,低权重的边缘变红。(b)公交,框内 0.570。(c)地铁,框内 0.870;β = 0.8、α = 1.0 的格子是 0.835,低于黑框。三幅图的色标范围不同,不能把颜色深浅直接跨图比较。来源:原论文 Fig. 13。
这些数停在哪一层?
误差下降说明这张图的结构有预测贡献。它没有证明通勤者先查看道路拓扑再决定去哪上班,也没有证明道路比公交“更重要”可以外推到福州以外。道路边覆盖 181 个节点和 14,013.77 km²,地铁只覆盖 39 个节点和 1,256.7 km²。覆盖更全的网络更容易降低全市区对的平均误差。地铁在自己那几条走廊上的高运量,会被二进制边抹平:有车站就是 1,没有班次、容量或换乘次数。作者也写到,市中心的边过密会带来过平滑,核心区功能不同的邻里被编成过于接近的向量。图 10 的误差线在核心仍然密集,和这句话一致。
数据被压成一张两个月的静态网。工作日内部的周一和周五、1 月和 2 月的差别,模型看不见。手机用户不能代表低智能手机使用的人群,作者点名老年人是预期的薄弱部分。样本只来自福州,正文写明换到更小的城市或多中心城市后表现如何,还没有系统检验。
还有一张成绩单不要和表 4 混读。结论写道,去掉地理邻接使 MAPE 升高 14%、CPC 下降 4.7%,去掉语义邻接使 MAPE 升高 20.4%、CPC 下降 8.8%。4.1 节的验证集按道路、公交、地铁分别给出了另一组相对变化,表 4 又是道路语义的测试集均值。结论这四个百分比没有写出分子、分母和对应的交通方式。可以逐格核对的是表 4、图 8 的文字和图 9 的标注。
随机划分还会让同一个区的其他流量进入训练集。模型见过这个区的嵌入邻居,再猜它的一条留出边。这和“用过去几周预测未来一周”不是同一种考验。
一句话总结
在福州 193 个行政区、2023 年 1–2 月工作日聚合出的通勤网上,把共享边界和同一条道路连成的语义边一起送进图注意力,留出区对的 MAE 平均为 3.26,低于同样使用两类边的 GSGNN 的 3.83;公交和地铁因为连上的区和面积更少,补上的流量更有限,而且格子变粗之后,这三种网络的优劣会换位置。
核心来源
Tu, Y., Wang, P., Zhu, J. N. Y., Zhao, Z., Li, J., & Wu, S. (2026). GAGNN: a geography-aware graph neural network for citywide commuting flows prediction. International Journal of Applied Earth Observation and Geoinformation, 147, 105175. https://doi.org/10.1016/j.jag.2026.105175
补充材料与正文同 DOI。代码仓库:https://github.com/241010017-sys/GAGNN。原始定位数据论文写明可来函索取,正文没有附带。
Youjun Tu(涂有军)是福州大学计算机与数据科学学院、数字中国研究院(福建)2024 级博士研究生,论文第一作者,负责写作与方法。数字中国研究院(福建)的成果新闻写明了这一身份。
Peixiao Wang(王培晓)的论文署名是中国科学院地理科学与资源研究所、资源与环境信息系统国家重点实验室。同一则研究院新闻称他为助理研究员。论文中的工作是验证与指导。
Julie N.Y. Zhu 的论文署名是福州大学经济与管理学院,贡献栏为资助。没有核到与这篇署名对应的中文姓名和进一步职务,这里只保留论文所列身份。
Zhiyuan Zhao(赵志远)是通讯作者,邮箱 zyzhao@fzu.edu.cn,署名单位与涂有军相同。研究院新闻称他为副研究员,并把他列为这项工作的负责人;论文贡献是概念、指导和资助。2025 年一篇 IJGIS 论文的作者介绍写明,他是福州大学副研究员、数字福建政务大数据研究所副所长,研究方向包括人口动态观测与应用建模。
Junli Li 的论文署名是安徽农业大学资源与环境学院,贡献是指导与软件。没有在论文或上述机构新闻里核到中文姓名,不另作履历。
Sheng Wu 的论文署名机构与涂有军、赵志远相同,贡献是项目管理与形式分析。地理空间信息技术国家地方联合工程研究中心的管理页将 Wu Sheng 列为教授、副主任;皮书数据库的专家简介对应福州大学数字中国研究院(福建)教授吴升,研究领域包括大数据分析与可视化、数字化规划与数字政府。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若把这套模型交给线路规划,尺度要先选对。1 公里格子上地铁只连起 176/15,956 个格子,覆盖 176 km²;公交也只有 16.99% 的格子。此时地铁语义的 MAE 偏高,主要是因为大多数起讫对在语义图里没有边。放到 5 公里后,地铁覆盖增到 675 km²,MAE 下降 20.1%。这个下降发生在格子变大之后,不能当成“新开通一条地铁、客流就会按同样比例变化”的证据。模型没有把线路班次、运力或票价放进边权,也没有做线路开通前后的对比。
第二个用法上的区分来自两个指标本身。道路设定的 CPC 是 0.96,MAPE 仍有 0.42,图 9 还标出 42.21%。CPC 的分子是每个区对上预测和观测的较小值,大流量对总和的贡献大。MAPE 先除以该对的观测流量,再对区对平均,小流量对会被放大。核心区的粗线重叠好,不足以说明外围 0–100 这一档也估准了。图 10 的误差线在核心和外围都还在,只是道路设定下外围更收。若一个应用关心的是低流量乡镇有没有被低估,应该回到残差散点的左下角,而不是只报 CPC。
第三个可检验的外推是权重。道路和公交的最低点恰在 α = β = 1,地铁却在把语义权重降到 0.8 时更好,MAPE 从 0.870 降到 0.835。福州地铁只有 39/193 个节点、1,256.7 km²。一座地铁网更短、或者公交走廊更碎的城市,若直接抄等权,稀疏语义边会和几乎到处都有的地理边以同样的系数进入综合邻接。这只是从福州的热图推出来的设计猜测。论文没有第二座城市,也没有把 β 设成覆盖率的函数再做检验。