人没动,轨迹为什么还在两个基站之间来回弹?
论文名片|Zhiyuan Zhao(赵志远)、Qinyi Lin、Wenting Zhang、Zhixiang Fang(方志祥)、Xiping Yang(杨喜平)、Sheng Wu(吴升),Detecting hidden ping-pong records in mobile phone location data by considering daily activity patterns,Travel Behaviour and Society,2026,45:101350,2026年7月8日在线发表。DOI:10.1016/j.tbs.2026.101350。收稿日期 2025年6月28日,修回 2026年5月8日,接受 2026年6月30日。这是一篇方法论文:用日常活动里少见的重复往返和急转弯,去找手机定位里的乒乓记录。
人可以站在原地。手机却可能在两座信号重叠的基站之间来回切换,轨迹上就像刚跑了一个来回。这种被基站切换制造出来的假移动,叫乒乓效应(ping-pong effect)。以往常用速度来抓它:相邻两点算出来的速度超过 200 km/h,就当异常。手机定位往往几十分钟才记一个点。两点相距 2 公里、间隔 30 分钟,速度只有 4 km/h,规则完全看不见。
这篇论文换了一个不那么依赖时间间隔的办法。人很少在半小时里出门 6 次,也很少在一天里于两个地点之间走 12 趟;这两个次数是作者根据 2010 年深圳居民出行调查给出的参照,不是西宁样本里统计出来的。若轨迹在短时间里反复走同一对基站,或连续走出很大的折返角,就更像信号在弹,而不像一次日常出行。
方向性结论:在西宁 2018 年 8 月 6 日这批手机定位里,速度规则只能标出大约 1% 的记录;把重复往返、急转弯和速度合在一起,大约标出 14% 的记录,并涉及大约 45% 的用户。这些多出来的记录会把日出行距离和移动熵抬高,回转半径稳得多。检出比例不是准确率。论文没有一份事先标好真假的对照集,真实的高频往返,例如快递员,也可能被同一条规则碰到。
先说结论
- 速度阈值已经放到 120 km/h,仍只标出大约 1% 的记录。多规则大约标出 14% 的记录、45% 的用户。分母分别是抽样子集里的定位记录和用户,不是有真值的乒乓记录。
- 采样间隔拉到 5 分钟以上后,速度规则几乎不再检出;重复往返和急转弯在间隔超过 40 分钟时仍有检出,多规则最多。纵轴是条数,变稀以后点本身也变少。
- 易发性白天高于夜间。多规则下,超过 500 米的跳跃大约占七成;速度规则超过九成,重复往返只有大约四分之一。
- 在 1 万名用户的前后对比里,日出行距离相对变化落在 ±5% 以内的用户占 64.79%,移动熵占 83.47%,回转半径占 91.05%。距离的其余用户几乎都在负偏差一侧,对应处理前的距离更大。
- 上海、西宁、深圳的柱高并不是正文所说的“用户比例相差不超过 3 个百分点、记录比例不超过 5 个百分点”。深圳各柱都贴近横轴。
半小时才记一个点,速度规则还看得到来回弹吗?
手机定位被用来估计活动范围、下一次会去哪、以及城市里的起讫流量。乒乓记录把一次停留拆成许多短段,出行次数和短距离比例都会被抬高。基站侧已经用信号强度和滞后阈值减少不必要的切换,天线朝向、小区负荷和高楼阴影仍会让手机快速换塔。
速度规则因而成为常见清洗手段。它要求相邻记录算出的速度超过一个上限。文献里这个上限常取 200 km/h。间隔一长,同样的空间跳动除以更长的时间,速度就掉到阈值下面。重复出现在同一对基站之间、以及连续走出很尖的折返,这两件事不需要用那么密的时间戳才能看见。
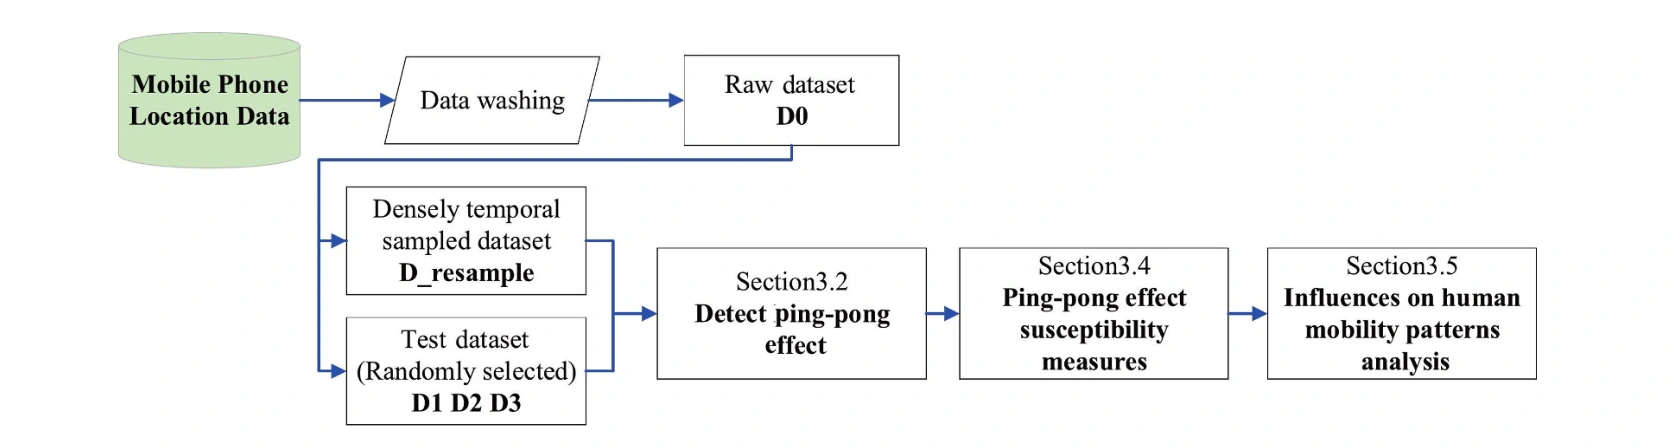
图 1|整篇检验分成哪几步?
原始话单和信令先清洗成 D0。加密子集 D_resample 用来看采样间隔的影响;D1、D2、D3 是从原始数据随机抽出的测试集,正文记作 DT1、DT2、DT3。随后依次做乒乓检测、时空易发性,以及三个移动指标的前后对比。这张图是流程示意,没有数据结果。来源:原论文 Fig. 1。
怎样才把一条记录判成乒乓?
单看一个点,无法知道它是停留还是弹跳。论文先标乒乓移动(ping-pong move),也就是相邻两点之间那段被规则看成异常的位移;再决定中间那条记录算不算乒乓记录(ping-pong record)。
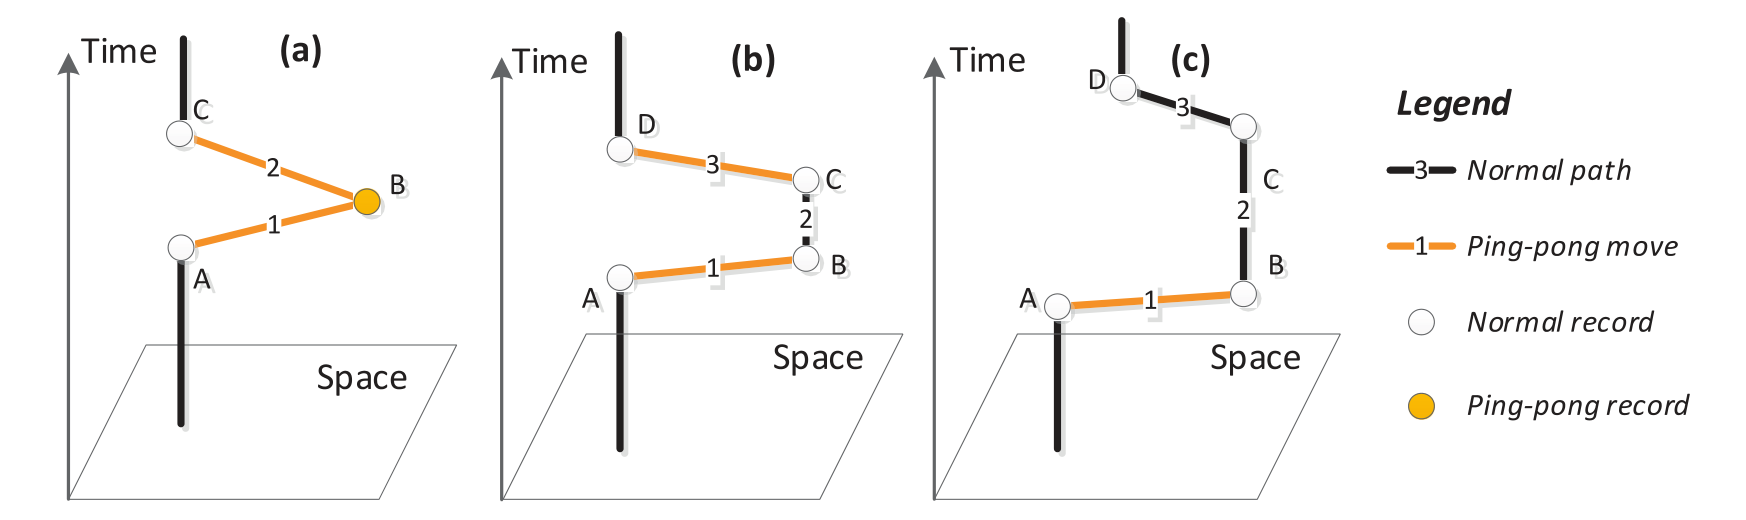
图 2|为什么不能看见一次跳动就把点删掉?
(a)记录 B 前后两段都是乒乓移动,B 标成乒乓记录;A 和 C 只挨着一段,仍算正常记录。(b)轨迹只是路过一段乒乓移动,A、B、C、D 都保持正常。(c)只有一段乒乓移动时,A 和 B 仍算正常。灰线是正常路径,橙线是乒乓移动,白点是正常记录,黄点是乒乓记录。来源:原论文 Fig. 2。
三条规则可以单独用,也可以取并集。
速度规则:相邻记录的速度超过 120 km/h,这段位移算乒乓移动。作者提到城市道路限速多在 80 km/h 以下,因而没有沿用文献里的 200 km/h。阈值放低,本应标出更多段;后面会看到,标出的记录仍然很少。
重复移动(repeat move pattern,RMP):把基站对看成无方向的,从甲到乙和从乙到甲算同一次往返。以某条记录的时间为中心开一个时间窗,窗内这对基站的移动次数超过阈值,窗里对应的移动都算乒乓移动。
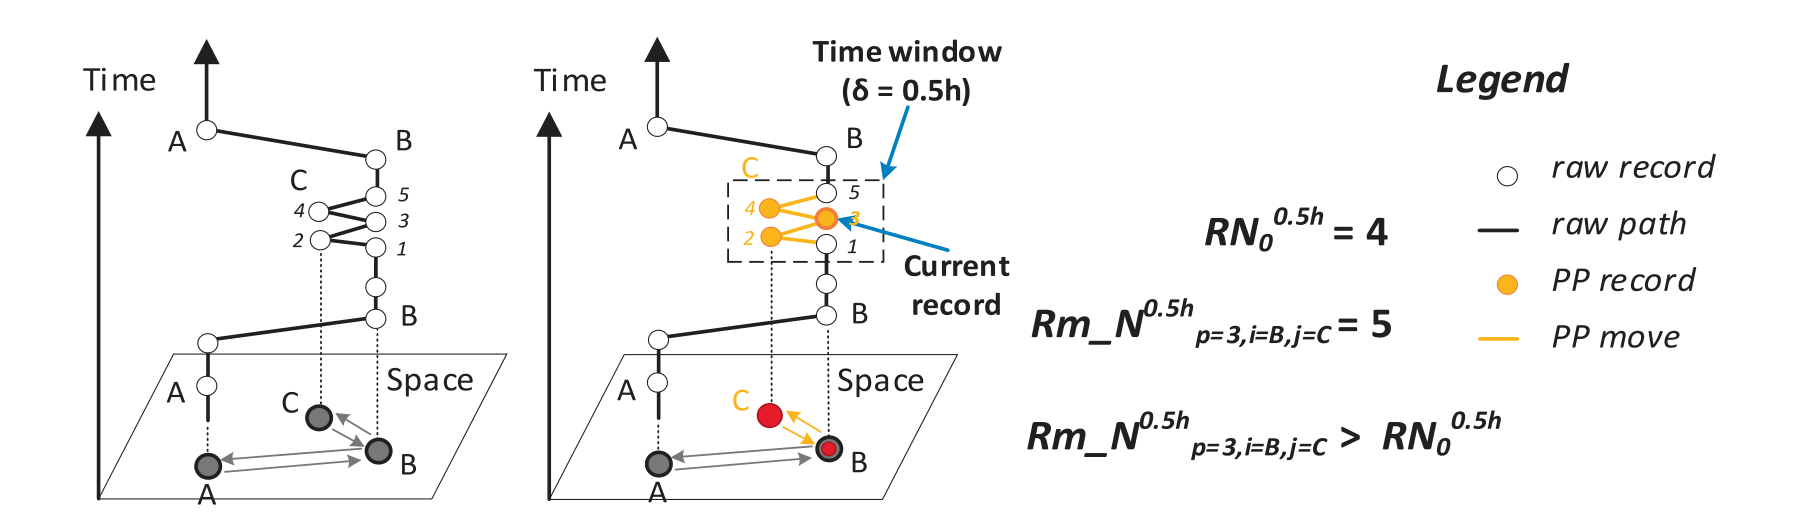
图 3|短时间里同一对基站来回太多次,怎样被标出来?
左图是原始轨迹,右图把时间窗里超过次数的移动标成乒乓。示意里的时间窗是 0.5 小时,阈值是 4 次,例子里实际数到 5 次。这是讲规则的例子,不是后文实验使用的 1 小时、8 小时和 24 小时阈值。来源:原论文 Fig. 3。
急转弯(frequent sharp turn pattern,FSTP):连续三个点构成一个转角,角度取 0 到 π。角度大于 150° 算一次急转弯。时间窗内急转弯次数超过阈值,这些转角对应的移动算乒乓移动。作者的理由是,日常出行很少连续走这种绕远的尖角。
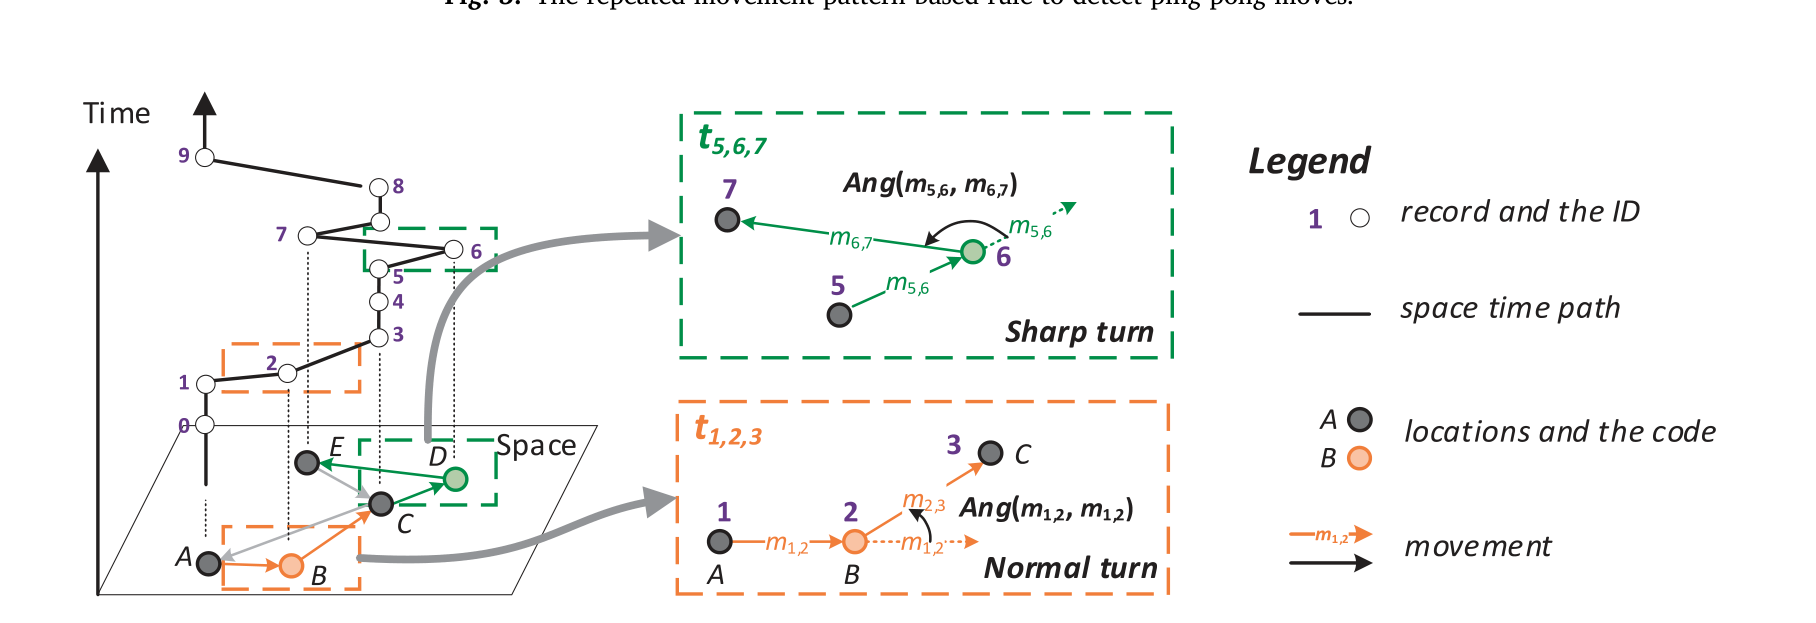
图 4|多大的折返才算急转弯?
连续三点的夹角小于等于 150° 时,图中画成正常转弯;大于 150° 时画成急转弯。实验统一用 150°。来源:原论文 Fig. 4。
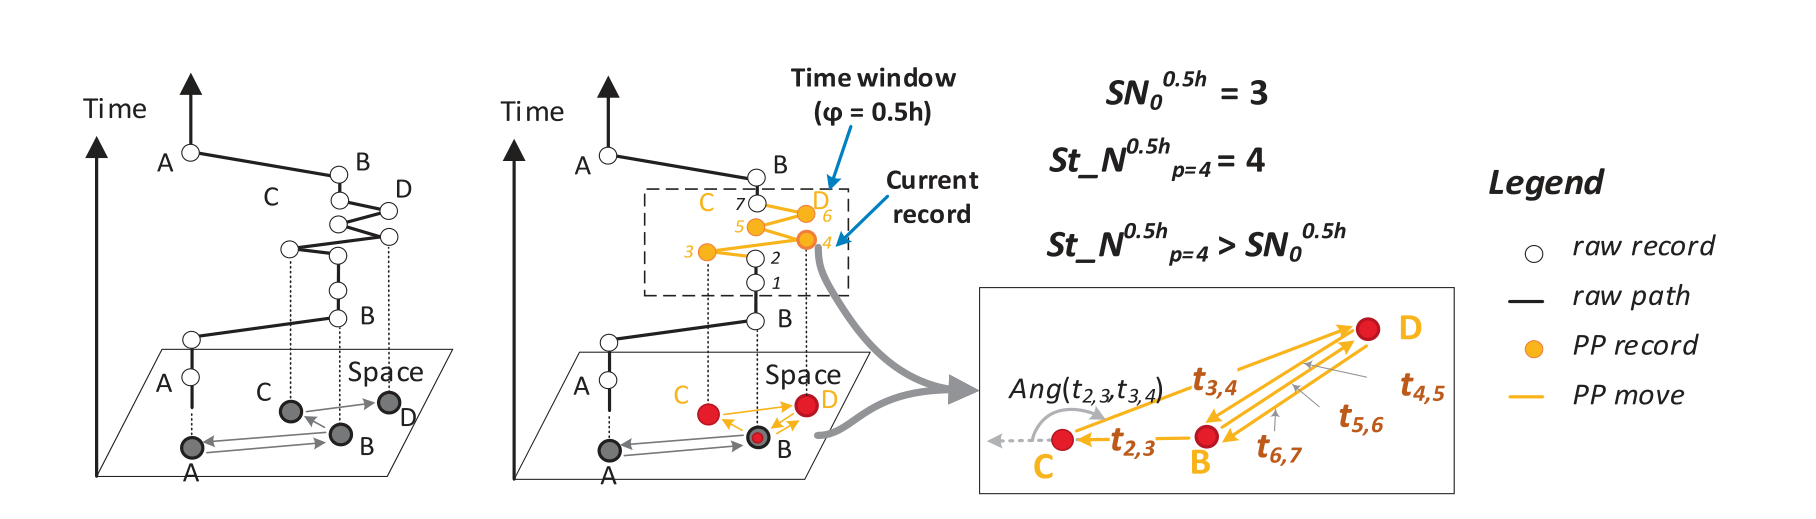
图 5|急转弯要密到什么程度才整段标出?
示意同样用 0.5 小时的窗,阈值是 3 次急转弯,例子里数到 4 次,于是窗内对应移动被标出。正式实验不用这组 0.5 小时参数。来源:原论文 Fig. 5。
多规则(MULTI)是并集:速度、若干个时间窗下的重复移动、若干个时间窗下的急转弯,满足任何一条,这段移动就算乒乓移动。实验实际使用的三档是:
- Th1:1 小时窗,次数超过 4。
- Th2:8 小时窗,次数超过 6。
- Th3:24 小时窗,次数超过 12。
正文主体用 Th2。1 小时里超过 4 次,针对的是短促连跳;24 小时里超过 12 次,针对的是全天都在同一对基站之间折返。西宁居民日均出行大约 2.65 到 3.15 次,作者还引用既有结果说一个人一天通常走 2 到 6 次、一般少于 6 次。8 小时内同一对地点超过 6 次,已经高于他们给出的日常水平。这个对照来自出行调查和既有文献,不是从这批手机记录里估计出来的真实出行次数。
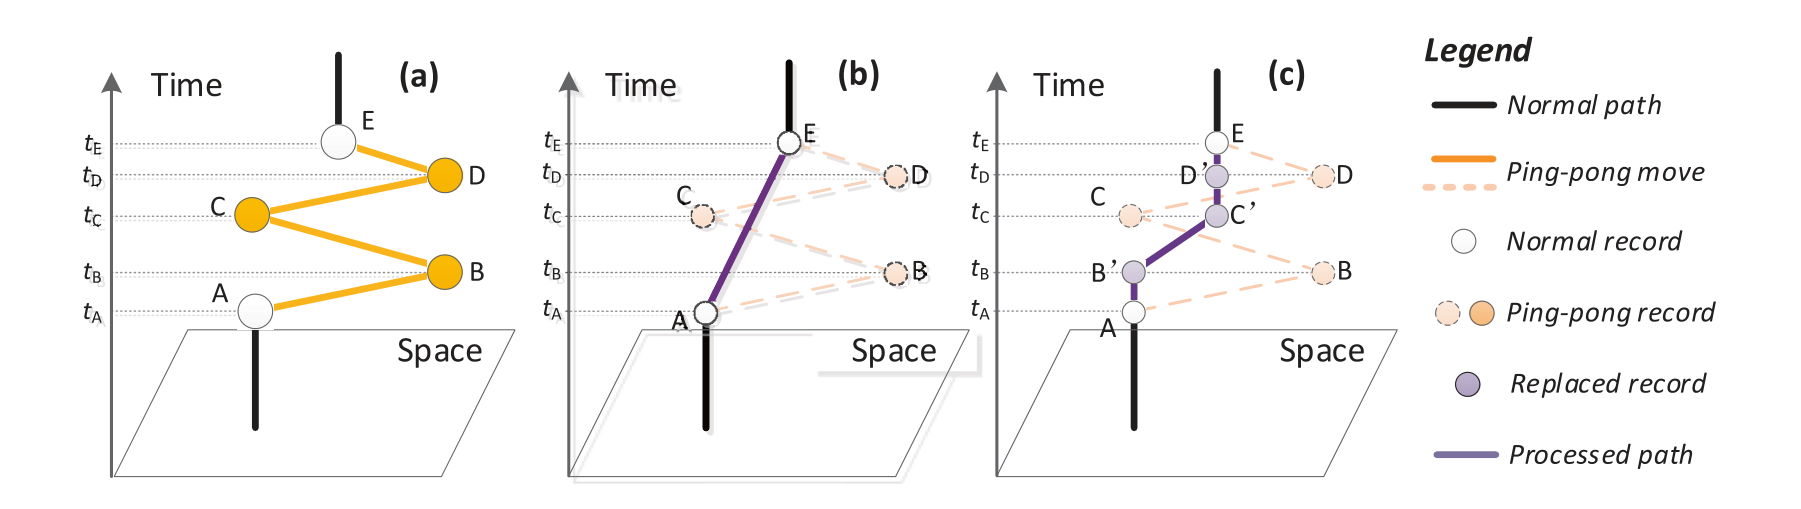
图 6|检出之后,为什么不直接删点?
(a)原始轨迹里,B 和 D 是夹在异常移动之间的乒乓记录。(b)直接删掉 B 和 D,时间轴上会少掉这些时刻。(c)保留时刻,把 B、D 的位置改成时间上最近的邻点,轨迹改走处理后的路径。后文的指标对比用的是这种替换,不是删除。来源:原论文 Fig. 6。
西宁这一天的记录有多密?
数据来自一家运营商,日期是 2018 年 8 月 6 日,星期一。内容是通话详单和手机信令的混合,字段为匿名用户号、时间和基站经纬度。去掉重复、异常和缺字段之后,数据集 DT0 有 4269 万条定位、近 39 万名用户,人均 109 条。基站大约 2600 座,与最近邻基站的平均距离是 192 米。
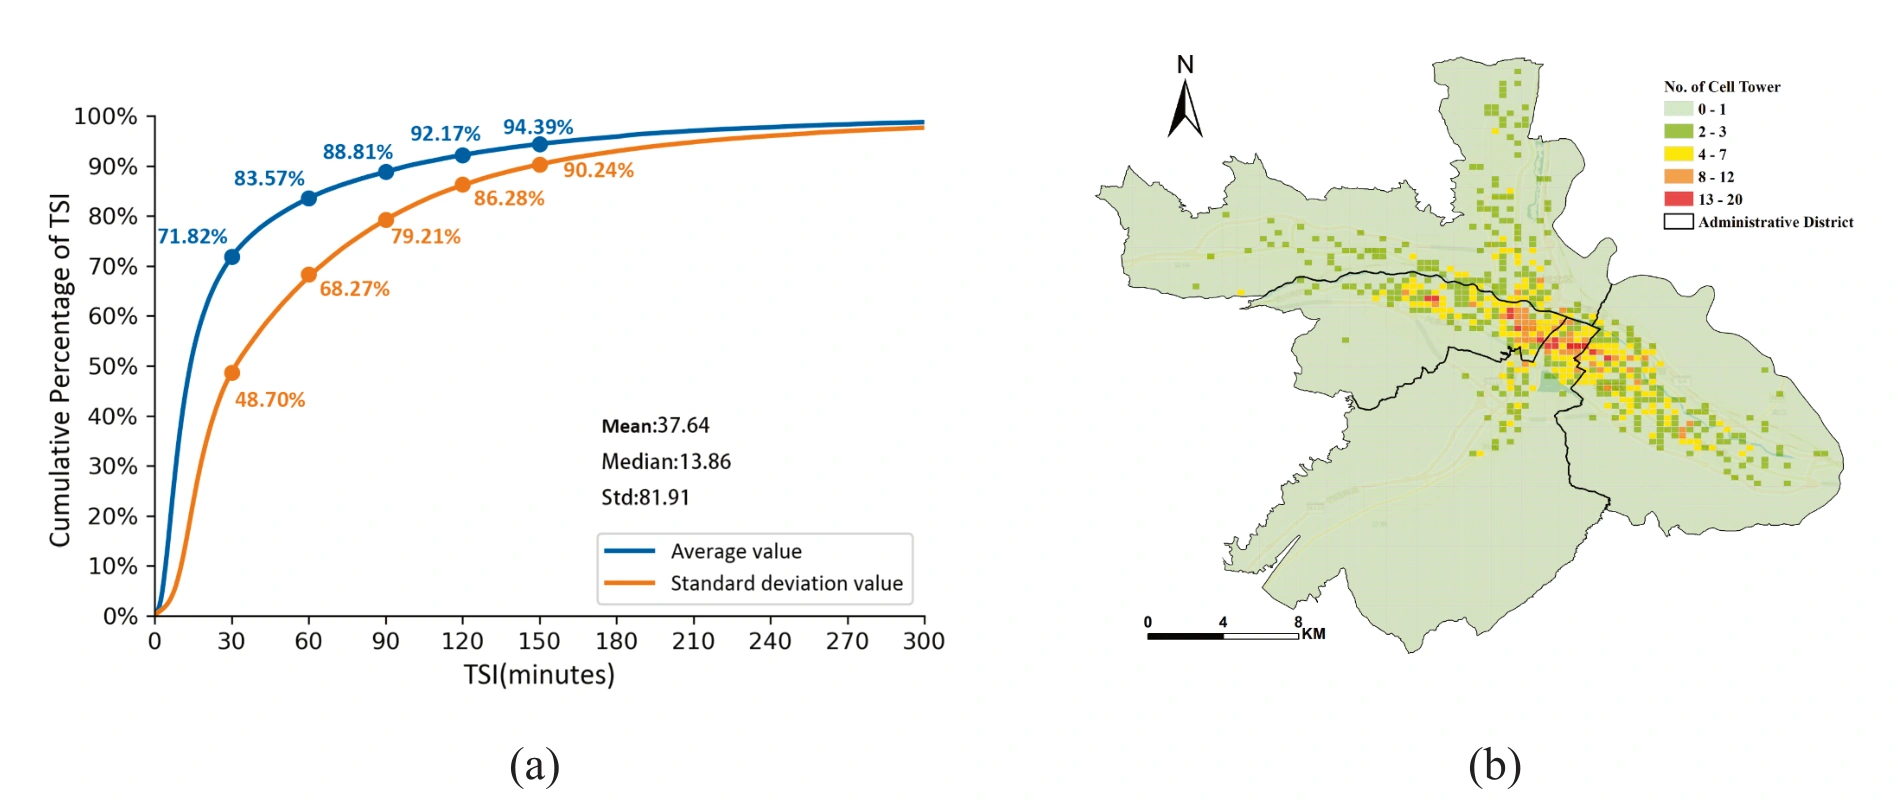
图 8|这批记录的时间间隔和基站分布各是什么样子?
(a)横轴是采样间隔,纵轴是累计百分比。蓝线是用户平均采样间隔,橙线是采样间隔的标准差。图中标出均值 37.64 分钟、中位数 13.86 分钟、标准差 81.91 分钟。平均间隔曲线从左到右标出的五个点是 71.82%、83.57%、88.81%、92.17%、94.39%,标准差曲线是 48.70%、68.27%、79.21%、86.28%、90.24%。最左边的 71.82% 与正文一致:超过 70% 的用户,平均采样间隔小于 30 分钟。正文另写平均采样间隔小于 15 分钟,这个说法贴近中位数 13.86 分钟,不是图中的均值 37.64 分钟。分布右偏,少数很长的间隔把均值拉高。(b)西宁基站密度,颜色从少到多;中心城区更密,四周更稀。比例尺为 4 公里。来源:原论文 Fig. 8。
为了看规则在不同疏密下的表现,作者先从原始数据里抽出一份更密的子集 DTresample,条件是:单用户跨度超过 16 小时,记录数超过 96 条,相邻记录的最大间隔小于 1 小时。得到约 377 万条记录、11,097 名用户。11,097 人约占近 39 万用户的 2.8%;377 万除以 11,097,大约是每人 340 条,密于全体用户的人均 109 条。这个子集里,90% 用户的采样间隔小于 10 分钟。
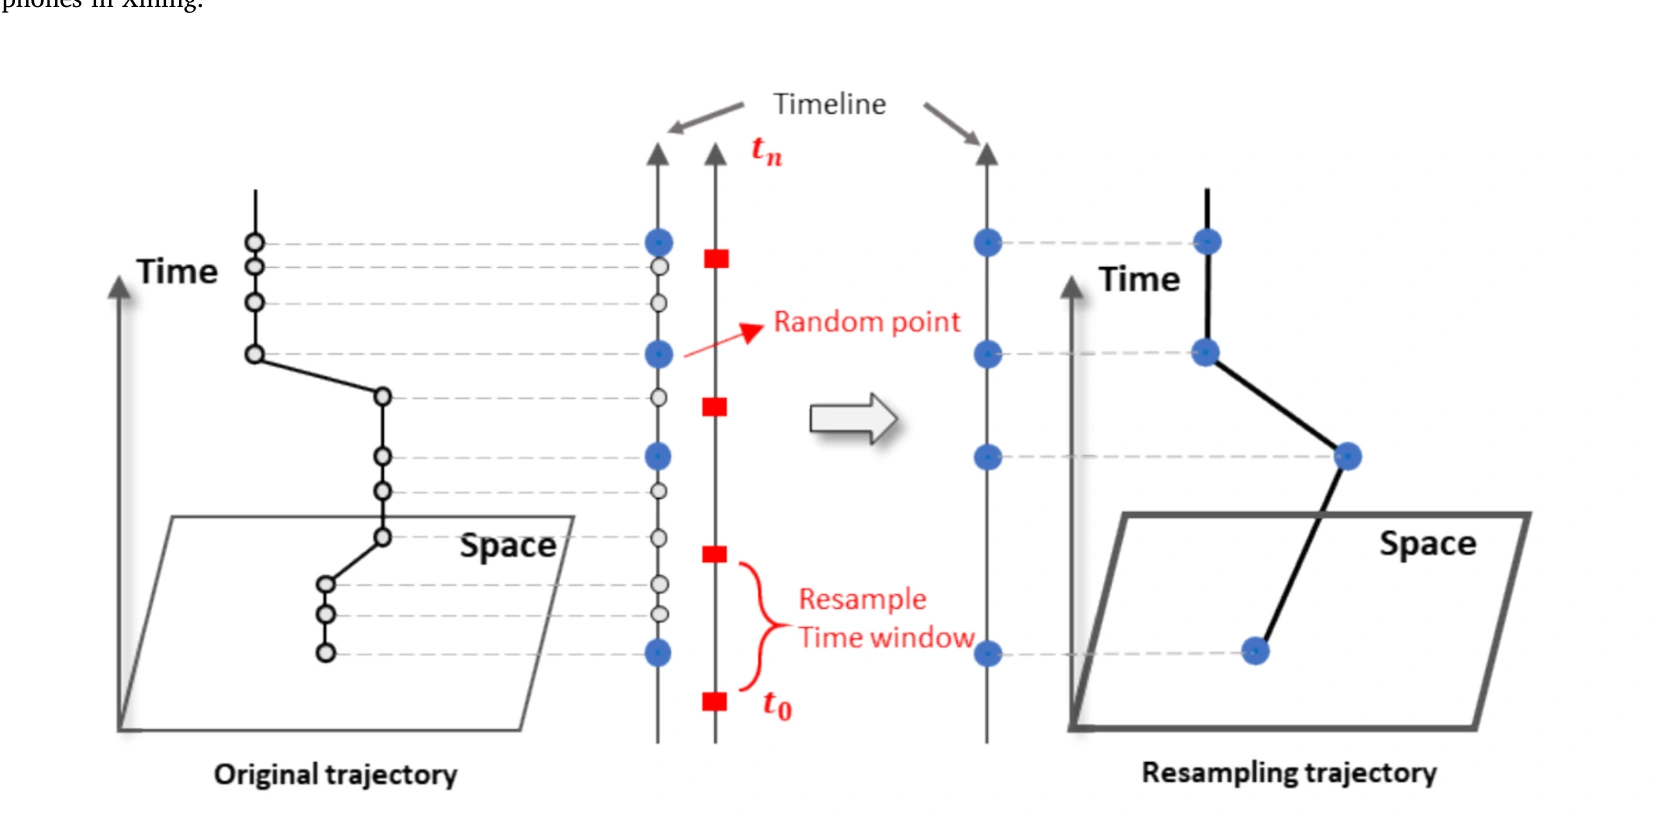
图 9|更稀的轨迹是怎样造出来的?
在原始密轨迹上按固定窗宽切开,每个窗随机留一个点,拼成新轨迹。窗宽从 5 分钟加到 60 分钟,步长 5 分钟。这是抽样实验,不是运营商又采集了一遍。来源:原论文 Fig. 9。
多标出来的,是全部记录的百分之几?
比较对象是速度规则。从 DT0 随机抽三个子集:DT1 为 1 万名用户、952,913 条记录;DT2 为 5,000 名用户、481,178 条记录;DT3 为 1,000 名用户、90,519 条记录。这里没有人工标好的真乒乓,柱高是被规则标中的比例。标得更多,只说明规则更松或更敏感,不能直接换成准确率。
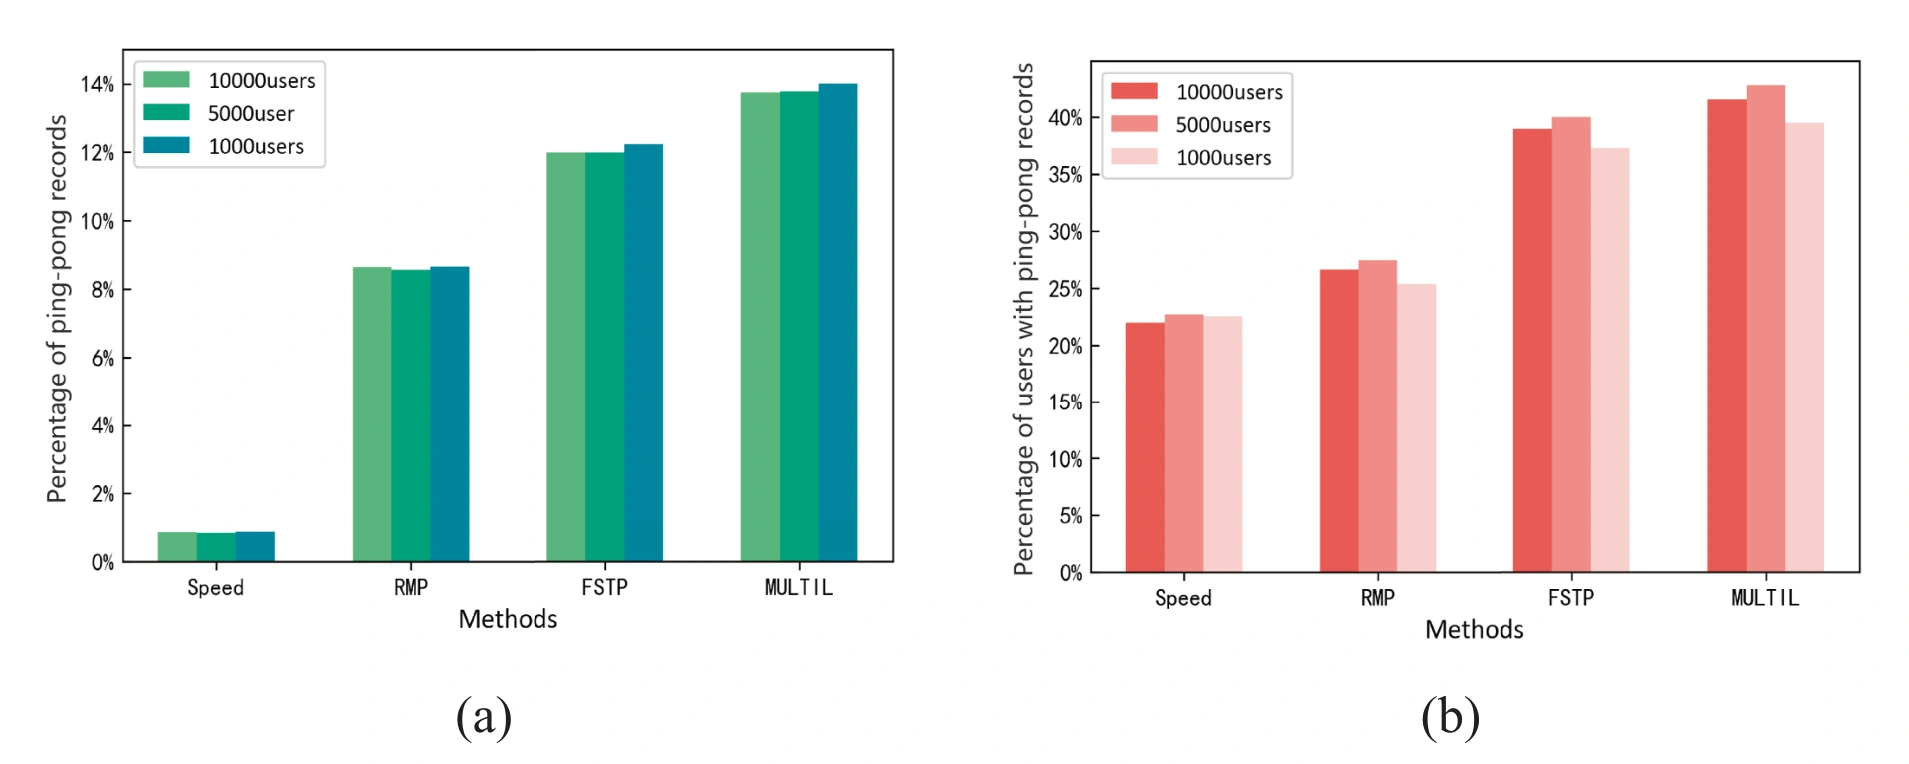
图 10|速度规则漏掉的那些记录,多规则能多标出多少?
(a)纵轴是被标成乒乓的记录占该子集全部记录的百分比。速度规则大约 1%。重复移动、急转弯、多规则依次升高,多规则大约 14%。1 万、5,000 和 1,000 名用户三组柱高接近。(b)纵轴是至少有一条乒乓记录的用户占比。多规则大约 45%,速度规则只有很小一截。正文说这是相对速度规则十倍以上的检出能力;14% 对 1%,倍数确实超过十倍,但分母是全部记录,不是已知的真乒乓记录。来源:原论文 Fig. 10。
附录换了阈值,样本量仍是这三档。Th1 把短窗放宽到 1 小时超过 4 次,Th3 要求 24 小时超过 12 次。
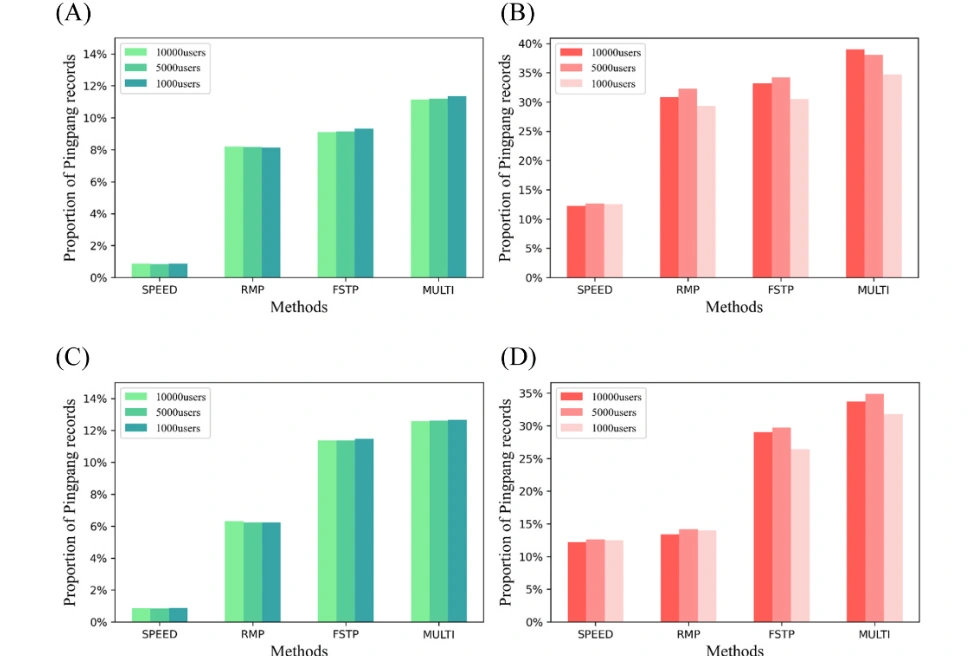
图 A1|换成 1 小时或 24 小时的次数阈值,排序还在吗?
(A、C)记录占比,纵轴 0 到 14%。(B、D)用户占比。(A、B)是 Th1,(C、D)是 Th3。两种阈值下都是速度规则最低、多规则最高,三种样本量接近。Th3 的重复移动明显矮于 Th1:全天要累计超过 12 次才触发,短促连跳不一定够得到。来源:原论文 Fig. A1。
换到上海和深圳,三座城市真的差不多吗?
西宁之外,作者又拿了上海和深圳。深圳采样间隔大约 1 小时,上海大约 24 分钟。基站最近邻平均距离,上海 0.21 公里,深圳 0.19 公里,西宁是 192 米。论文没有给出这两座城市的用户数和记录数。
正文写:三座城市检出的乒乓记录比例波动不超过 5 个百分点,有乒乓记录的用户比例波动不超过 3 个百分点,因此方法稳定、可推广。图 11 的柱高不是这个图案。
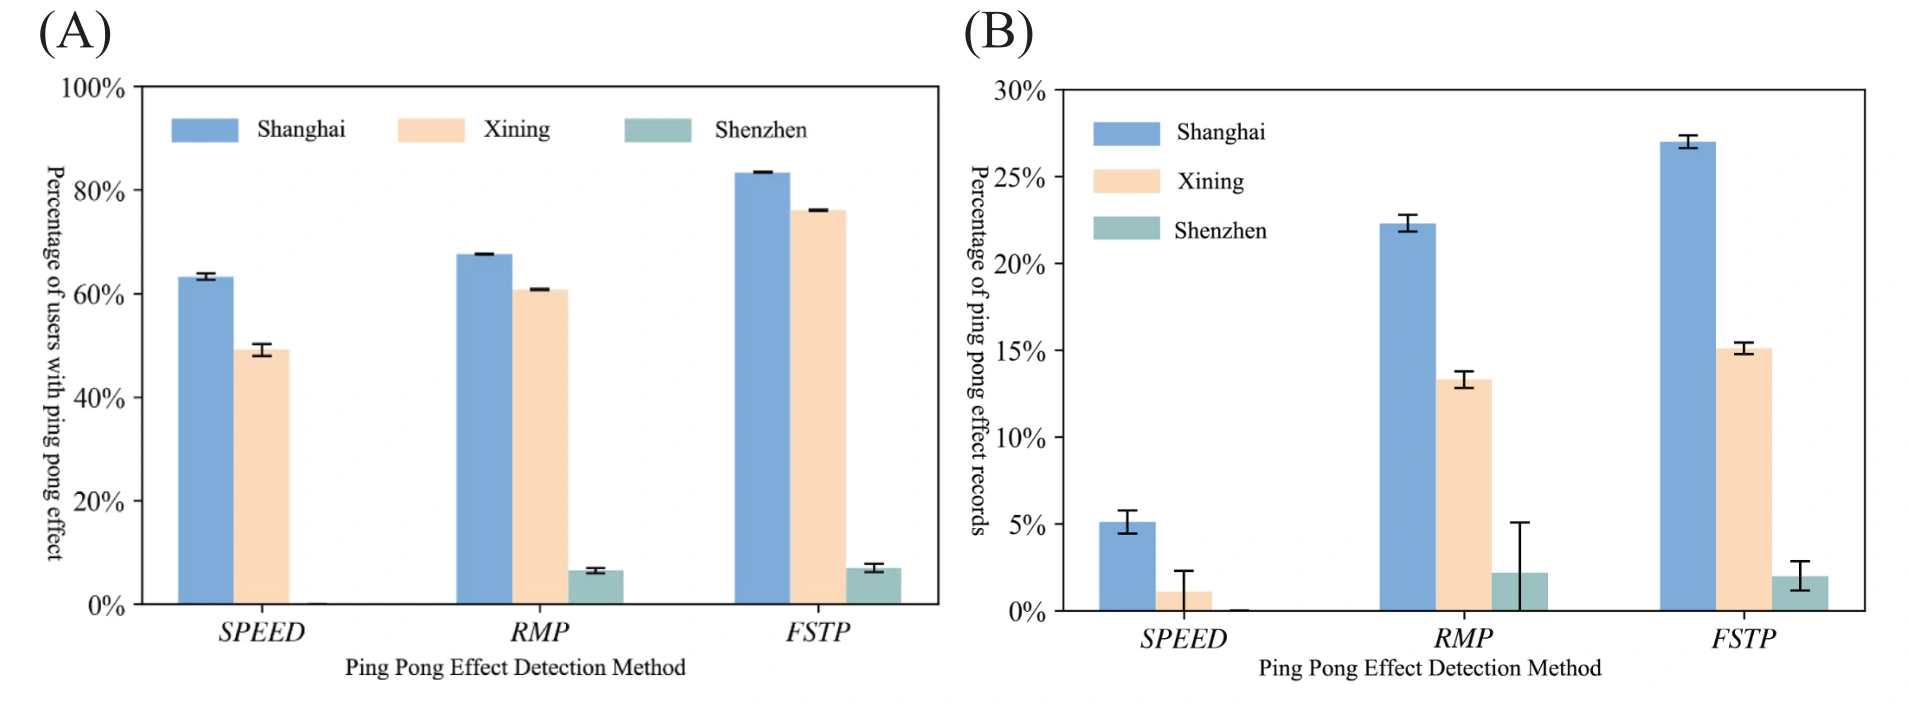
图 11|三座城市的检出比例差了多少?
图中没有逐柱标数字,下面是按柱顶相对刻度读出的近似值。(A)纵轴是有乒乓记录的用户占比,刻度到 100%。速度规则大约是上海 63%、西宁 49%,深圳的柱贴着横轴;重复移动大约是 68%、61%、7%;急转弯大约是 83%、76%、8%。(B)纵轴是乒乓记录占比,刻度只到 30%。速度规则大约是上海 5%、西宁 1%、深圳接近 0;重复移动大约是 22%、13%、2%;急转弯大约是 27%、15%、2%。深圳重复移动的误差线可以伸到大约 5%。上海和西宁远高于深圳,差距是几十个百分点,不是正文说的 3 个或 5 个百分点。同一座西宁,图 10 的多规则大约影响 45% 的用户,图 11 的急转弯已经大约 76%。正文没有说明两张图是否用了同一阈值、同一批用户。来源:原论文 Fig. 11。
深圳大约 1 小时才一个点,120 km/h 的速度规则很难触发,这能解释(B)里深圳速度柱接近 0。它解释不了为什么深圳的重复移动和急转弯也贴在横轴上,更解释不了正文中的“3 个百分点”和“5 个百分点”。
记录变稀以后,谁还检得出来?
把密子集按 5 到 60 分钟重采样之后,检出条数随间隔变长而下降。纵轴单位是 10^4 条,也就是万条。间隔变长时,每个窗只留一个点,轨迹上的点本来就变少,所以条数下降不全是规则失灵。
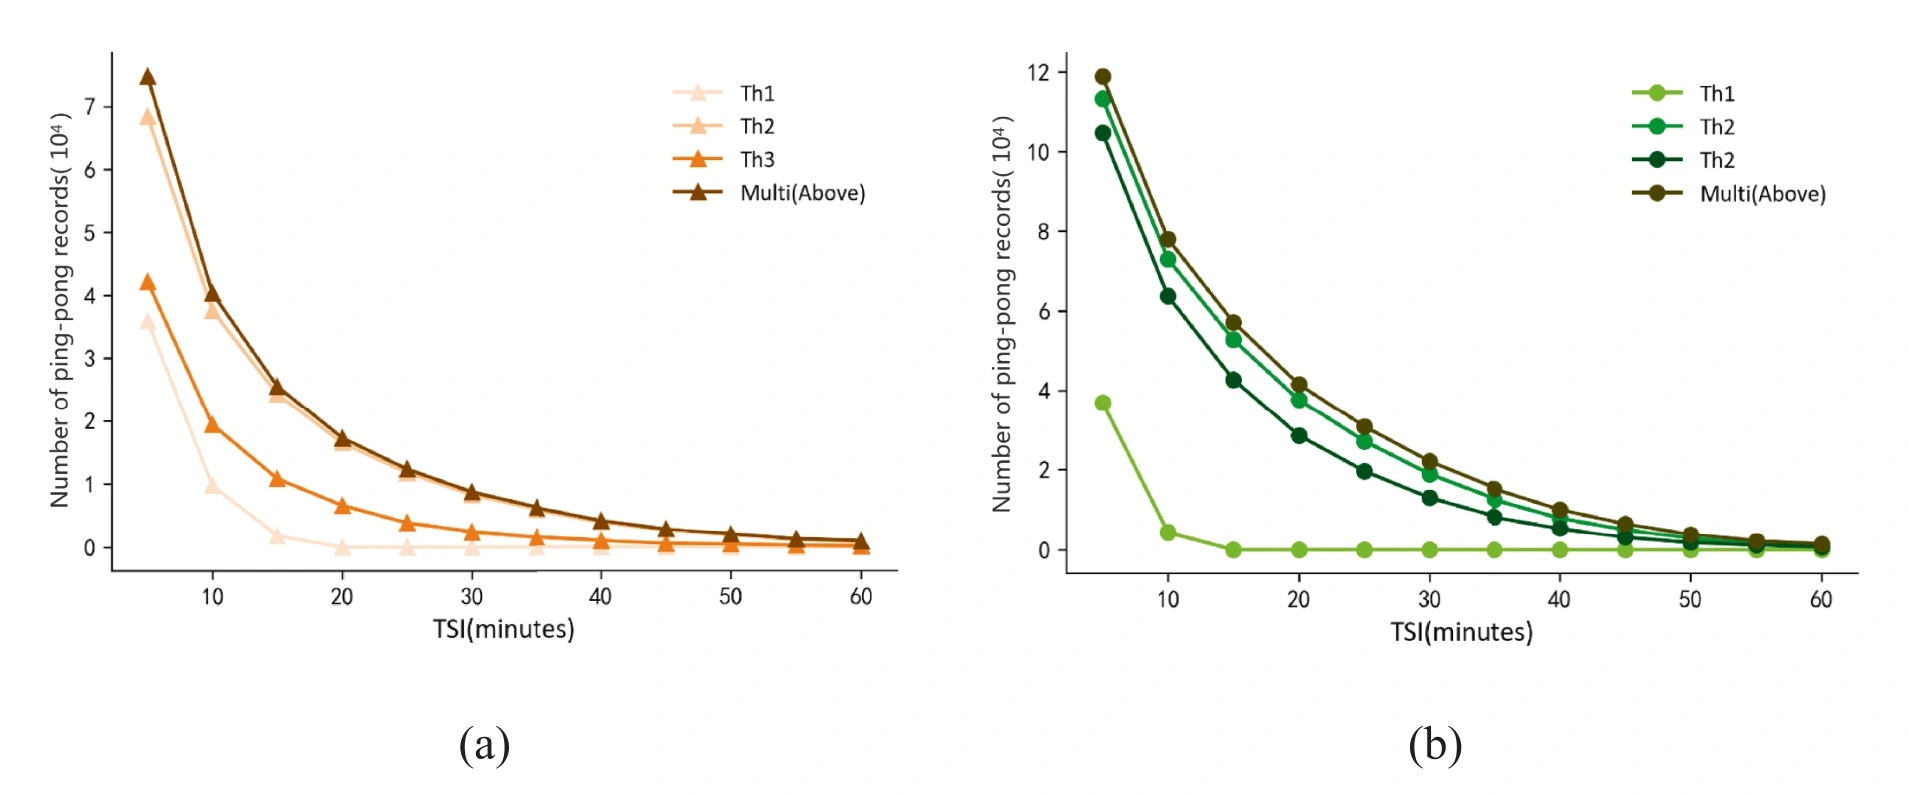
图 13|1 小时规则为什么先失效?
(a)重复移动。(b)急转弯。横轴是采样间隔,纵轴是检出条数,单位万条。Th1 在间隔大于 15 分钟后贴近 0。Th2 与多规则接近,并且高于 Th3 和 Th1。急转弯图里 Th1 下降更快,大约 15 分钟以后就不再有可观的条数。来源:原论文 Fig. 13。
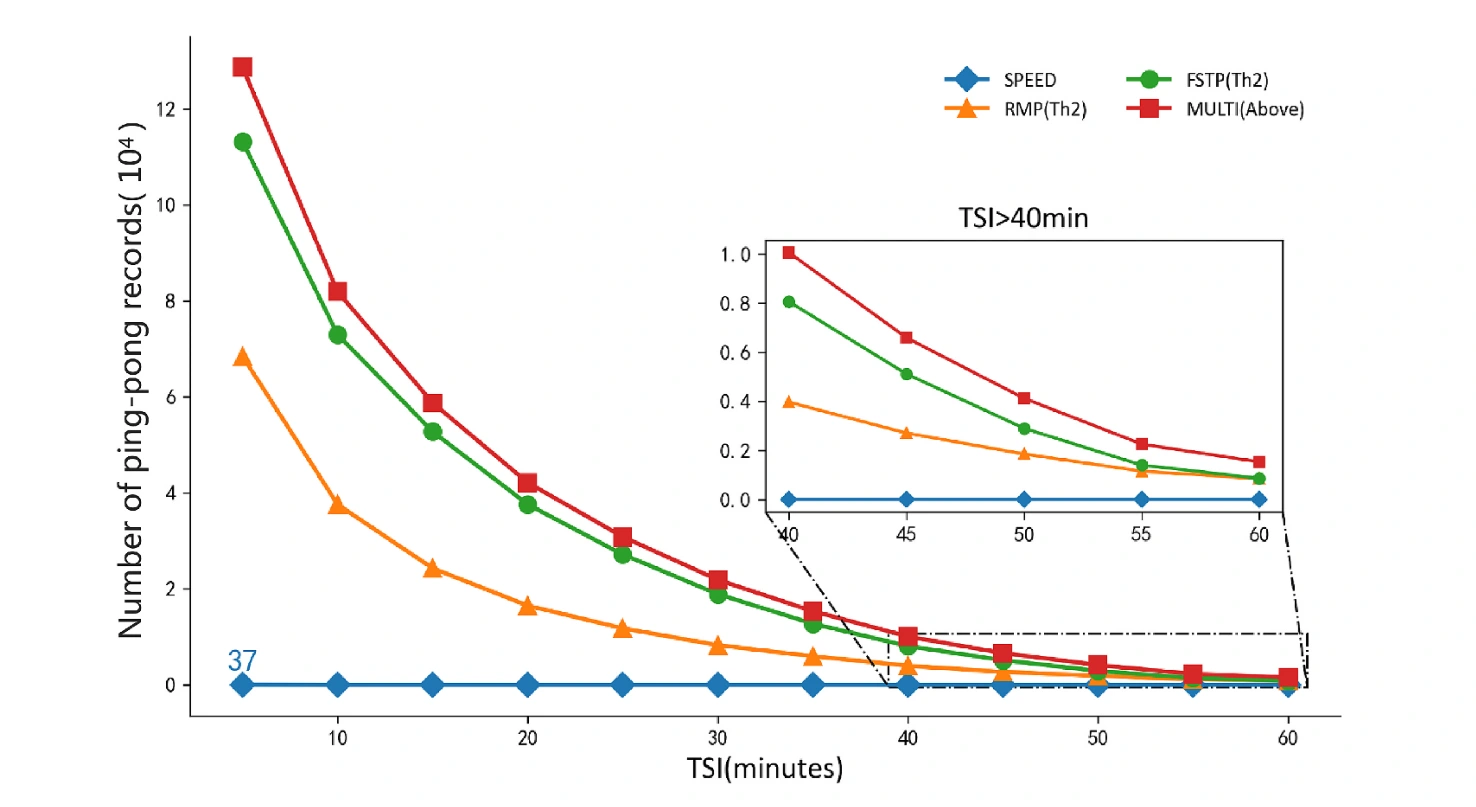
图 14|速度规则在 5 分钟以后还剩什么?
四条线都用 Th2,多规则是各规则的并集。速度曲线贴着 0;图上在最密处标了 37,即这一档只检出 37 条。另外三条在 5 分钟附近达到数万到十余万条,随后下降。插图把 40 到 60 分钟放大:速度仍是 0,多规则高于急转弯,急转弯高于重复移动,60 分钟时多规则仍有大约一两千条的量级。正文据此说,间隔大于 5 分钟后速度规则不再检出,而另外三种在超过 40 分钟时仍然有效。来源:原论文 Fig. 14。
这些记录偏爱白天,也偏爱市中心吗?
时空分析用的是 DT1 和 Th2。易发性比较的是“乒乓记录在各时段或各区域的份额”与“全部记录的份额”。时间指数写成:
Rt =(该小时乒乓记录数 / 全部乒乓记录数)÷(该小时全部记录数 / 全部记录数)− 1
Rt 大于 0,表示这个小时在乒乓记录里的占比,高于它在全部记录里的占比。它不是该小时的乒乓发生率,也不能当成因果上的“这个小时制造了乒乓”。
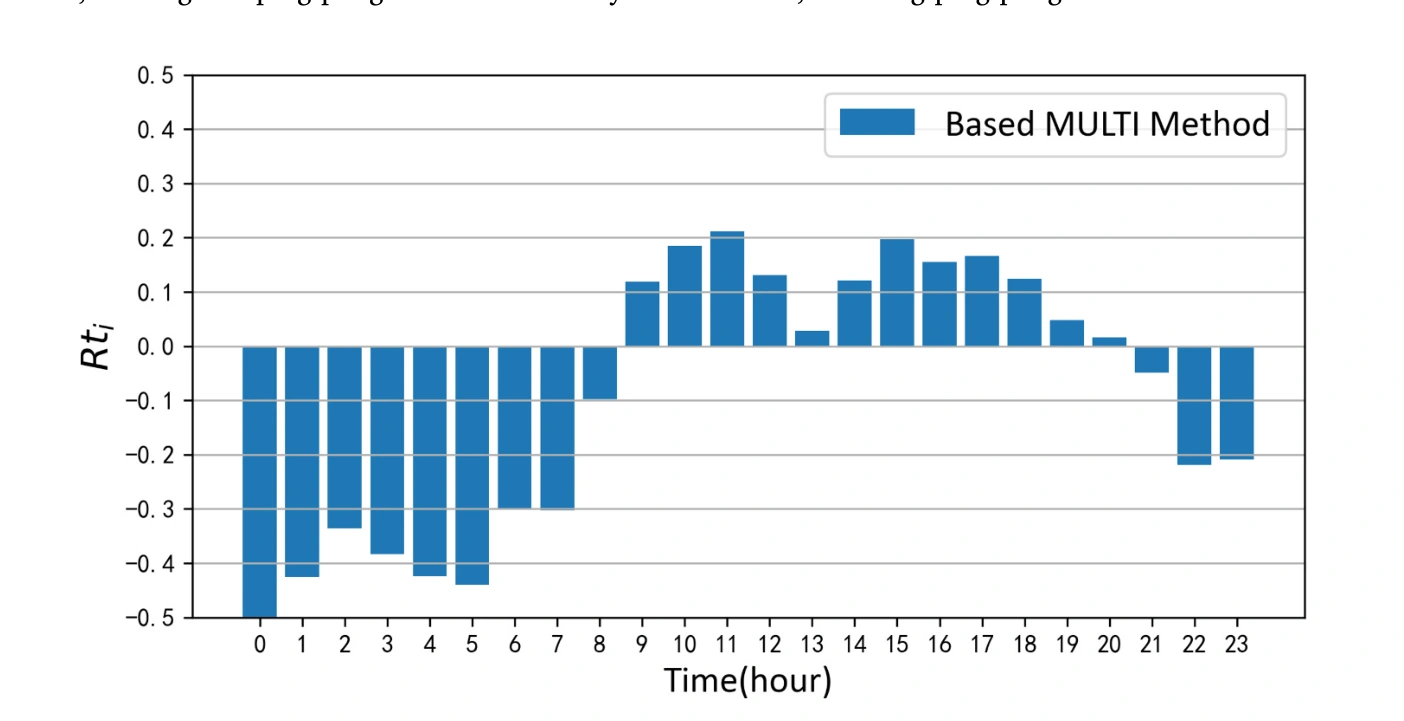
图 15|一天里哪些小时更容易出现乒乓记录?
横轴是 0 到 23 时,纵轴是 Rt,大约从 −0.5 到 0.5。0 时最低,夜间到清晨多为负;9 时到 12 时转正,13 时接近 0,15 时前后再次升高,21 时以后又转为负。这与正文一致:9 时到 20 时较高,21 时到次日 6 时以及清晨较低,正午低于相邻的早晚高峰。作者给出两种可能:白天出行和换塔更多;午间和深夜手机姿态更稳、连接的基站更少换。两种都是解释,不是这张图单独能证明的机制。来源:原论文 Fig. 15。
另外三种规则的 24 小时图放在附录。重复移动和急转弯仍是夜间为负、白天为正。速度规则不是同一形状,傍晚有一截正值,并不简单重复“日出而作”的曲线。所以“乒乓偏爱白天”主要是重复移动、急转弯和多规则的结果,不是速度规则的结果。
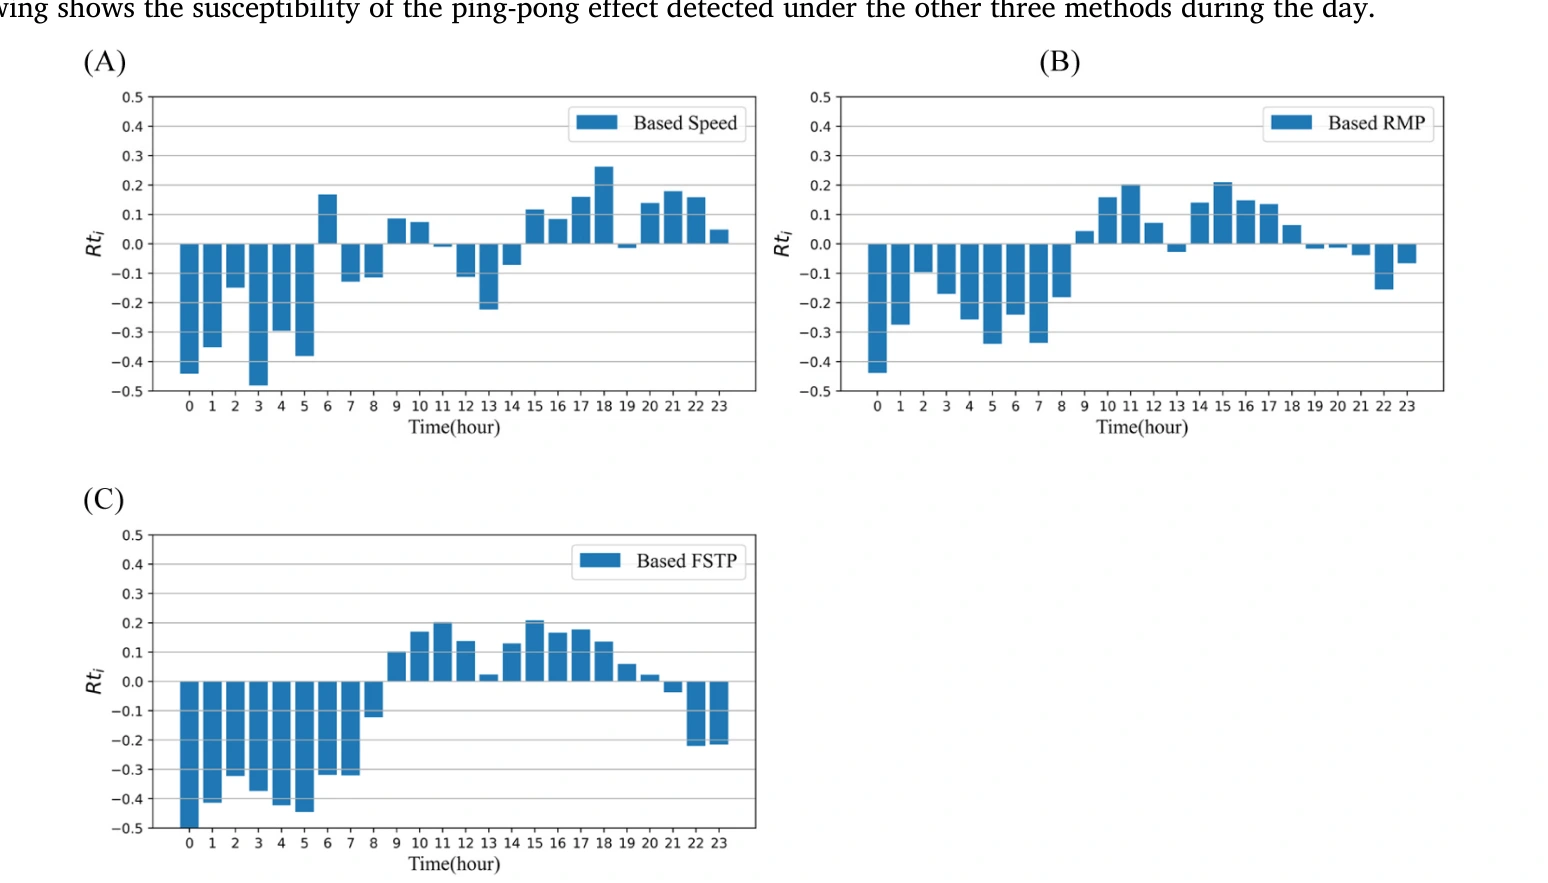
图 B1|白天更高,是不是每种规则都如此?
(A)速度规则,夜间为负,但 6 时附近和 17 时到 22 时为正,形状不同于图 15。(B)重复移动,夜间为负,午后为正。(C)急转弯,同样是夜间为负、白天为正,22 时和 23 时又降到 0 以下。纵轴都是 Rt。来源:原论文 Fig. B1。
跳跃距离是乒乓记录前后两段位移的平均长度,用基站之间的直线距离,不是沿路里程。
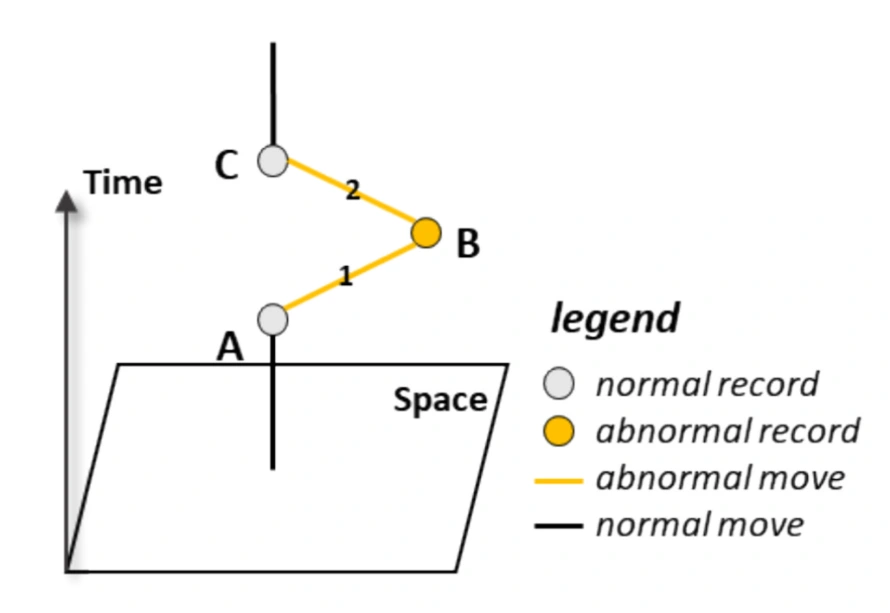
图 7|一个乒乓点的跳跃距离怎么量?
记录 B 的跳跃距离是段 1 和段 2 的平均长度。黄点是被标出的异常记录,橙线是异常移动。来源:原论文 Fig. 7。
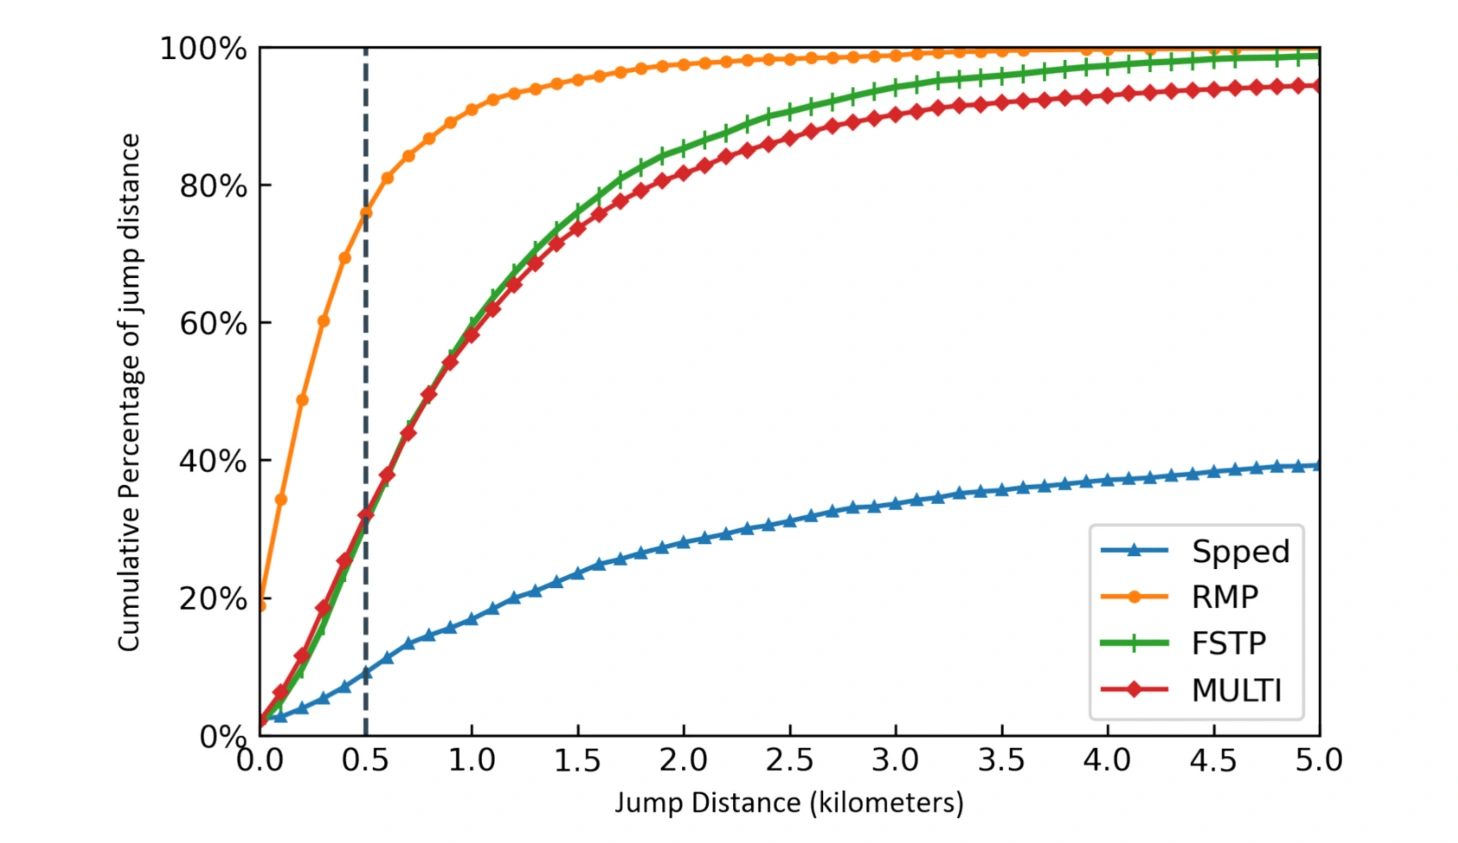
图 16|被标出的跳动,有多少超过了 500 米?
横轴是跳跃距离,单位公里,虚线在 0.5 公里。纵轴是小于该距离的累计比例。正文给出的读数与曲线一致:速度规则超过 500 米的跳跃多于 90%,所以它的累计曲线在 0.5 公里处只有大约一成;重复移动超过 500 米的大约 25%,累计曲线在虚线处大约七成五;急转弯和多规则超过 500 米的大约 70%,累计曲线在虚线处大约三成。速度曲线到 5 公里仍只有大约四成,意味着大约六成速度规则跳跃长于 5 公里。作者提醒,停留识别若把 500 米以内的点聚成一次停留,超过 500 米的乒乓就会把停留拆开。来源:原论文 Fig. 16。
空间易发性用同样的份额比,分析单元可以是行政区或交通小区。图 17 画的是多规则、Rs 大于 0.05 和小于 0.05 的基站。正文把分界写成小于等于 0.05,图例写成小于 0.05。
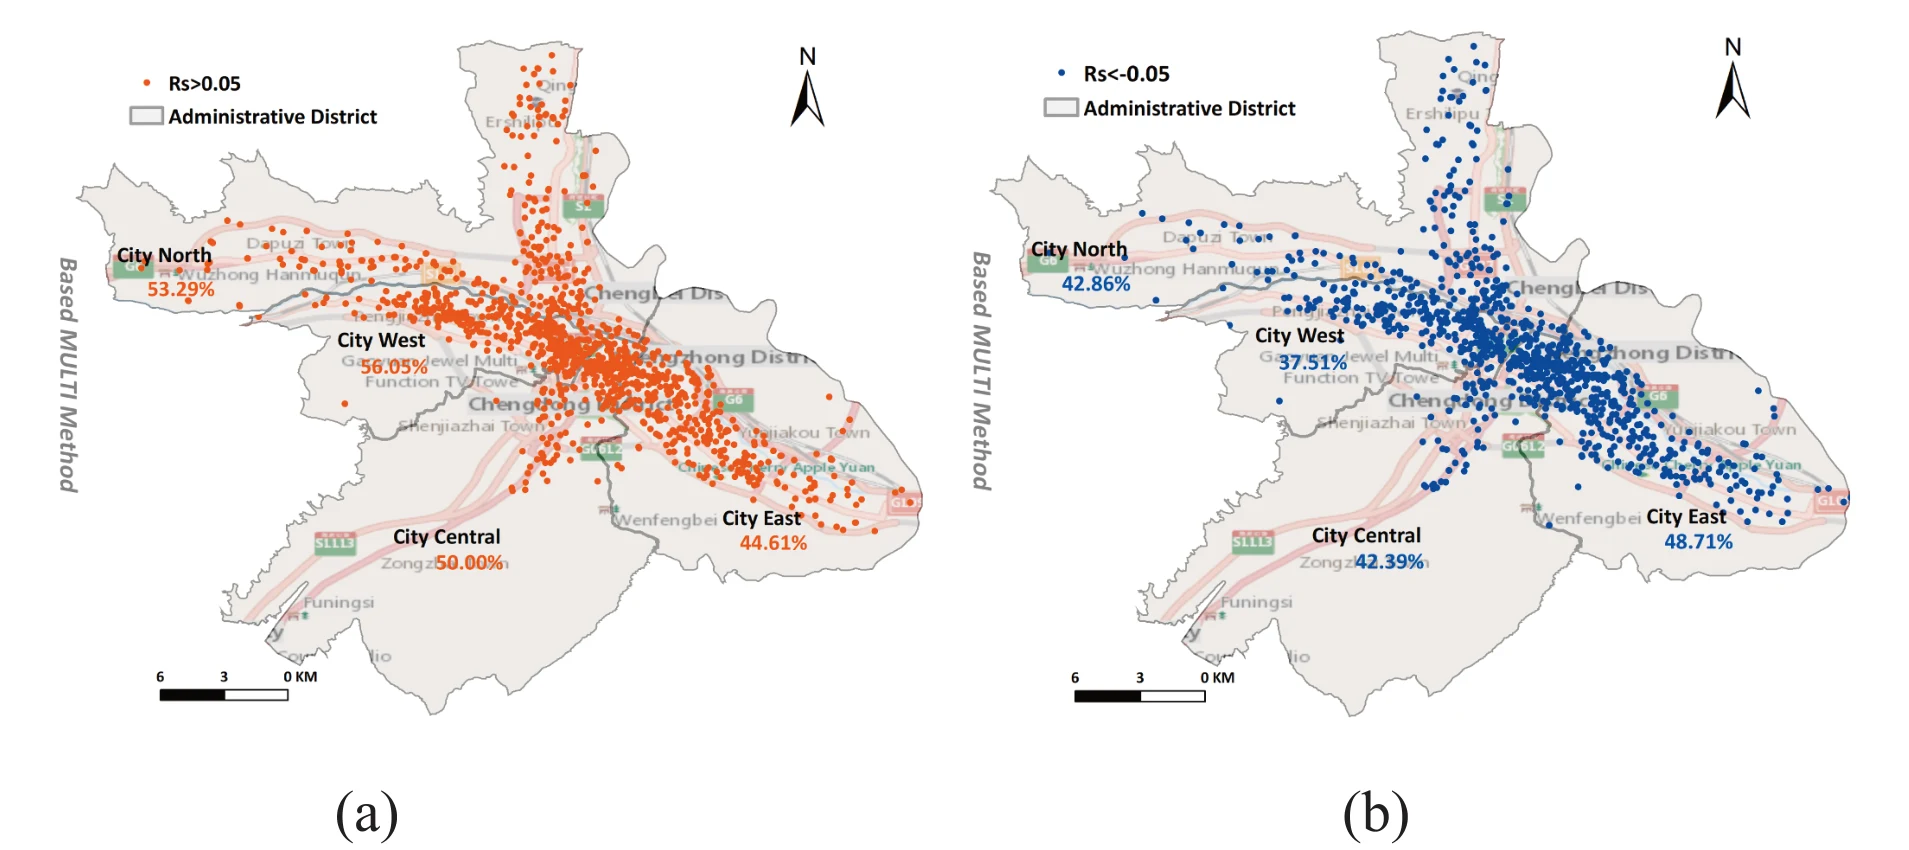
图 17|城西是不是比其他城区更容易弹?
(a)橙点为 Rs 大于 0.05。图上四个城区的标注是城西 56.05%、城北 53.29%、城中 50.00%、城东 44.61%。(b)蓝点为 Rs 小于 0.05,标注是城东 48.71%、城北 42.86%、城中 42.39%、城西 37.51%。两组百分数加起来不是 100%,图也没有写明分母是基站数还是记录数,不能读成同一批基站的互补比例。城西在高易发图上最高、在低易发图上最低,和正文“四个城区大体均衡、城西略高”相符。点的疏密同时显示,中心比外围更密。作者把它归因于中心基站更密、覆盖重叠更大,并认为这种重叠使重复移动和急转弯更难检。后半句是解释。来源:原论文 Fig. 17。
清掉以后,距离、熵和活动范围各变多少?
仍用前面的检测设置,比较处理前和处理后。三个指标都在个人、这一天的尺度上计算。
日出行距离是相邻点直线距离之和。移动熵是 −Σ p_n log2(p_n),p_n 是该用户落在地点 n 的记录占比,地点越分散,熵越大。回转半径是各点到全部点重心的直线距离的均方根,表示活动范围摊开的程度。替换乒乓点的位置以后,时间点还在,只是坐标变了。
偏差定义成(处理后 − 处理前)/ 处理前。按这个式子,偏差为负表示处理后变小,也就是处理前偏大。正文有一处把偏差大于 0 说成“乒乓造成高估”,符号和公式相反。图的坐标能把方向核对清楚。
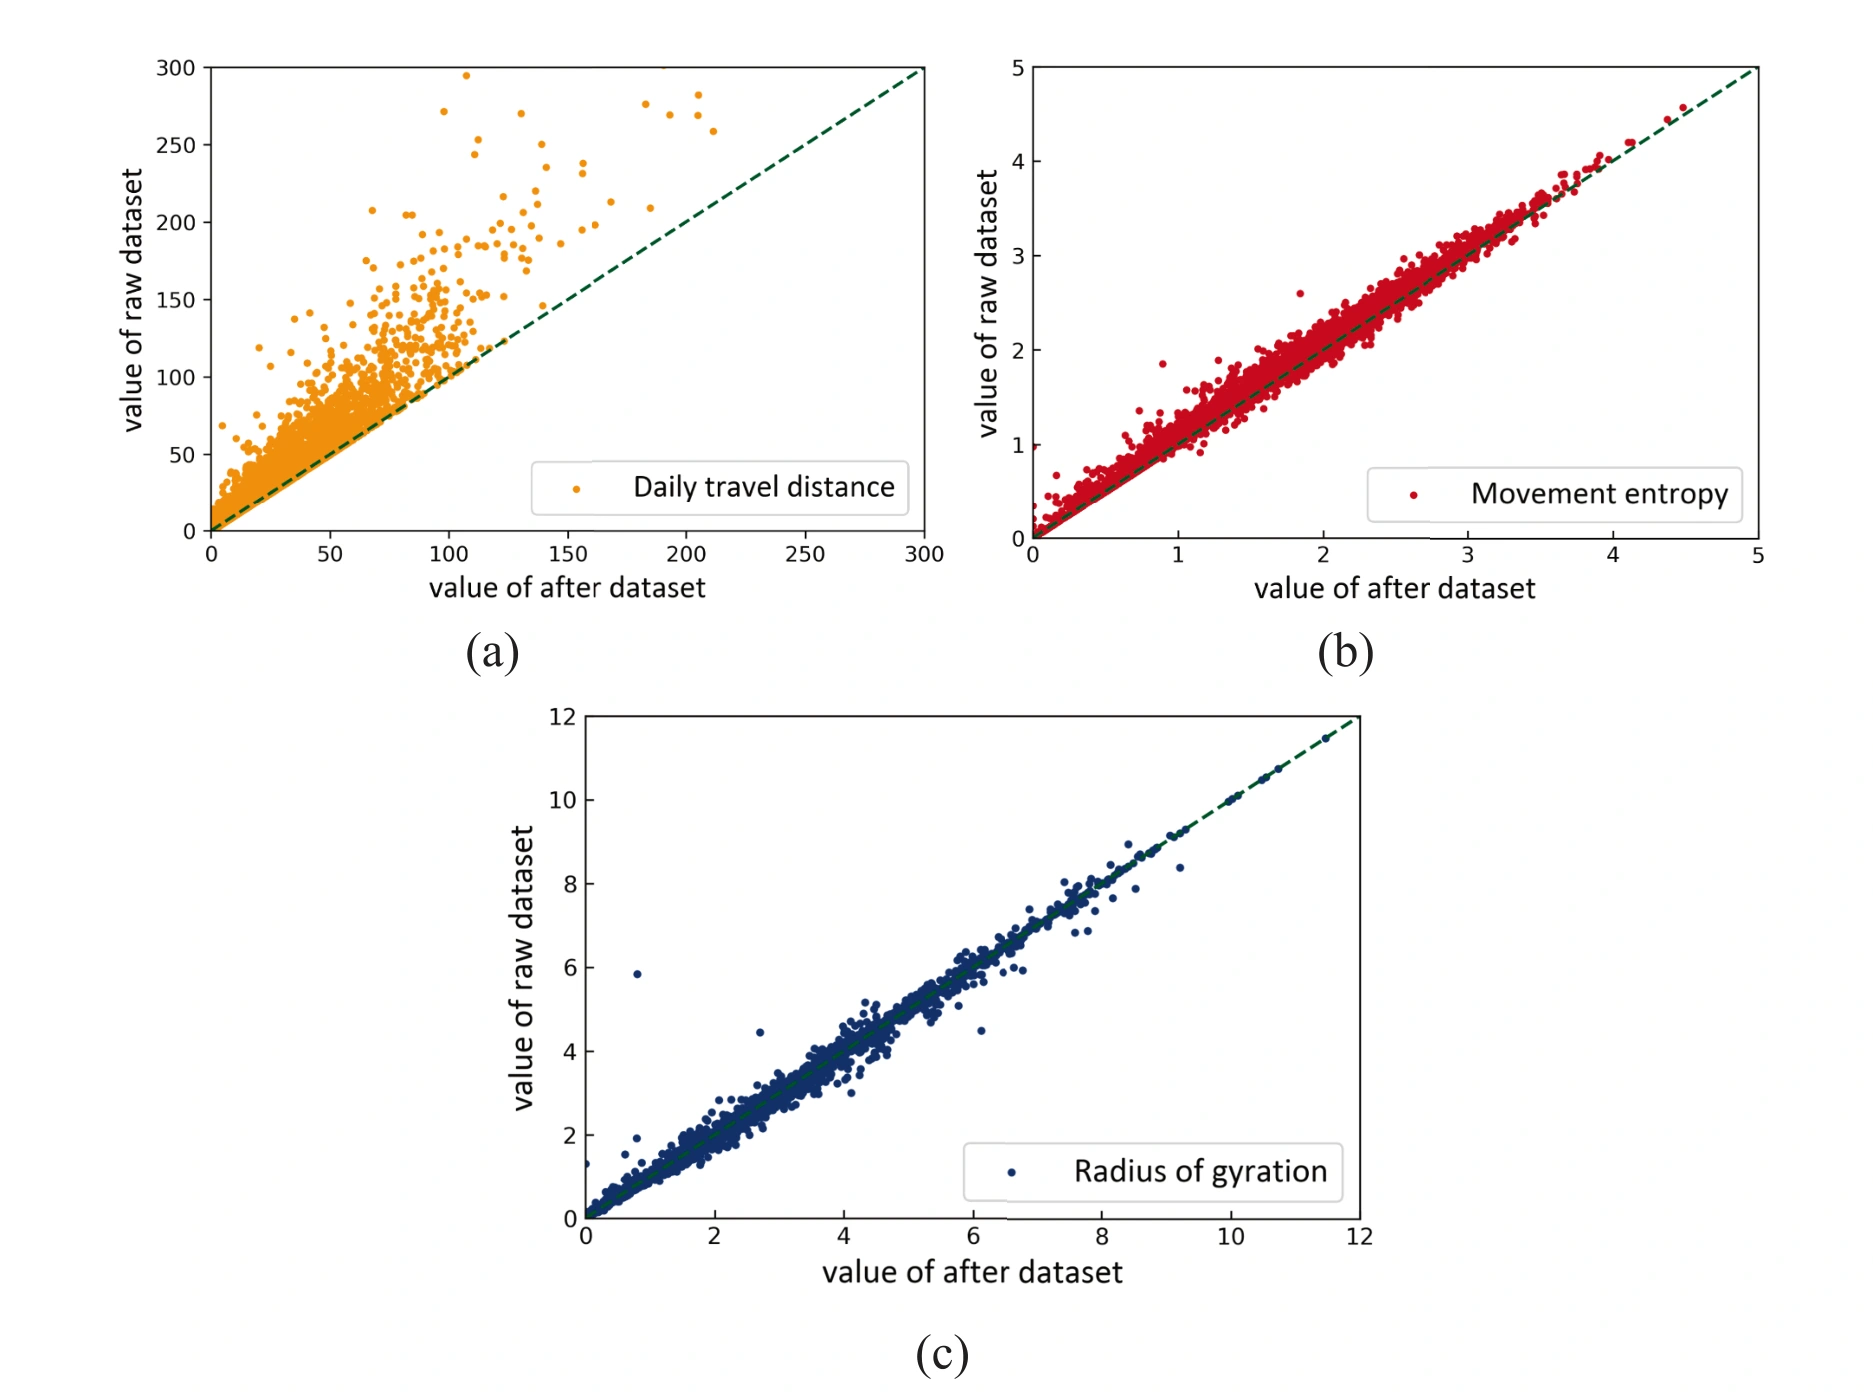
图 18|处理前的指标,是更大还是更小?
横轴都是处理后,纵轴都是处理前。点在对角线上方,表示处理前更大。(a)日出行距离,多数点在对角线上方,原始距离被算高了;坐标没有写单位。(b)移动熵,点更贴着对角线。熵较小的一侧,上方的点更明显;正文说熵超过 1 以后,偏高和偏低的差别不大。(c)回转半径,点最贴对角线,两侧都有,整体比距离稳。正文另有一句写“落在对角线下方代表高估”。按图上的坐标,高估对应的是上方。来源:原论文 Fig. 18。
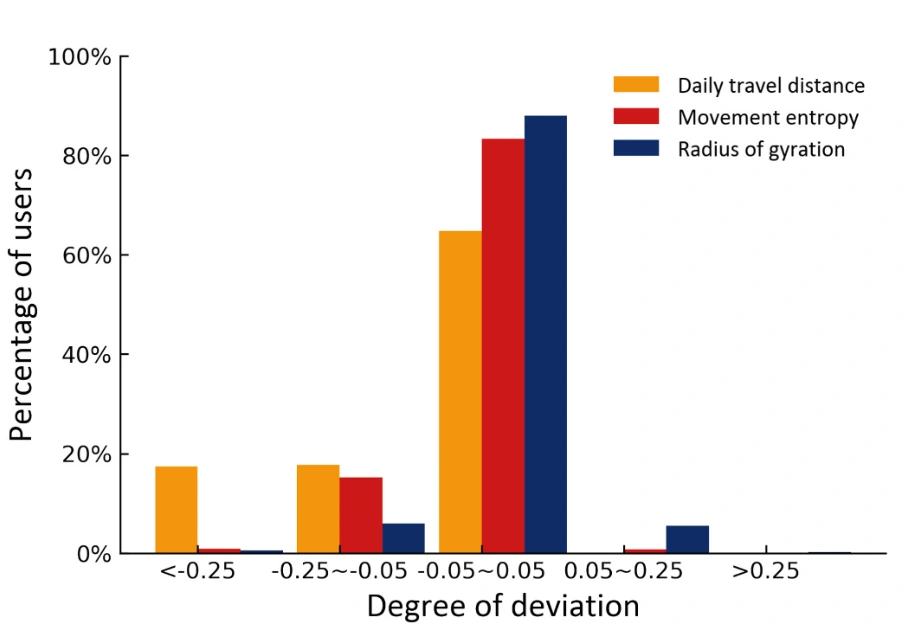
图 19|有多少用户的指标几乎没变?
横轴是相对偏差,纵轴是用户占比。落在 −0.05 到 0.05、也就是相对变化不超过 5% 的用户,回转半径占 91.05%,移动熵占 83.47%,日出行距离占 64.79%。分母是做了前后比较的用户;正文没有说明处理前指标为 0 时怎样处理。距离剩下的大约 35 个百分点几乎都在负偏差一侧,其中小于 −0.25 和 −0.25 到 −0.05 各有大约不到两成的用户。熵在 −0.25 到 −0.05 还有一小截,正偏差一侧很低。回转半径在中段以外只剩不到一成,左右都有一点。负偏差按公式意味着处理前更大。摘要说日出行距离和移动熵被明显高估、回转半径影响有限,和这两张图一致。正文另一处写三个指标“更可能被低估”,与图 18、图 19 和摘要不一致。来源:原论文 Fig. 19。
一个用户的例子用来看规则实际碰到了什么。
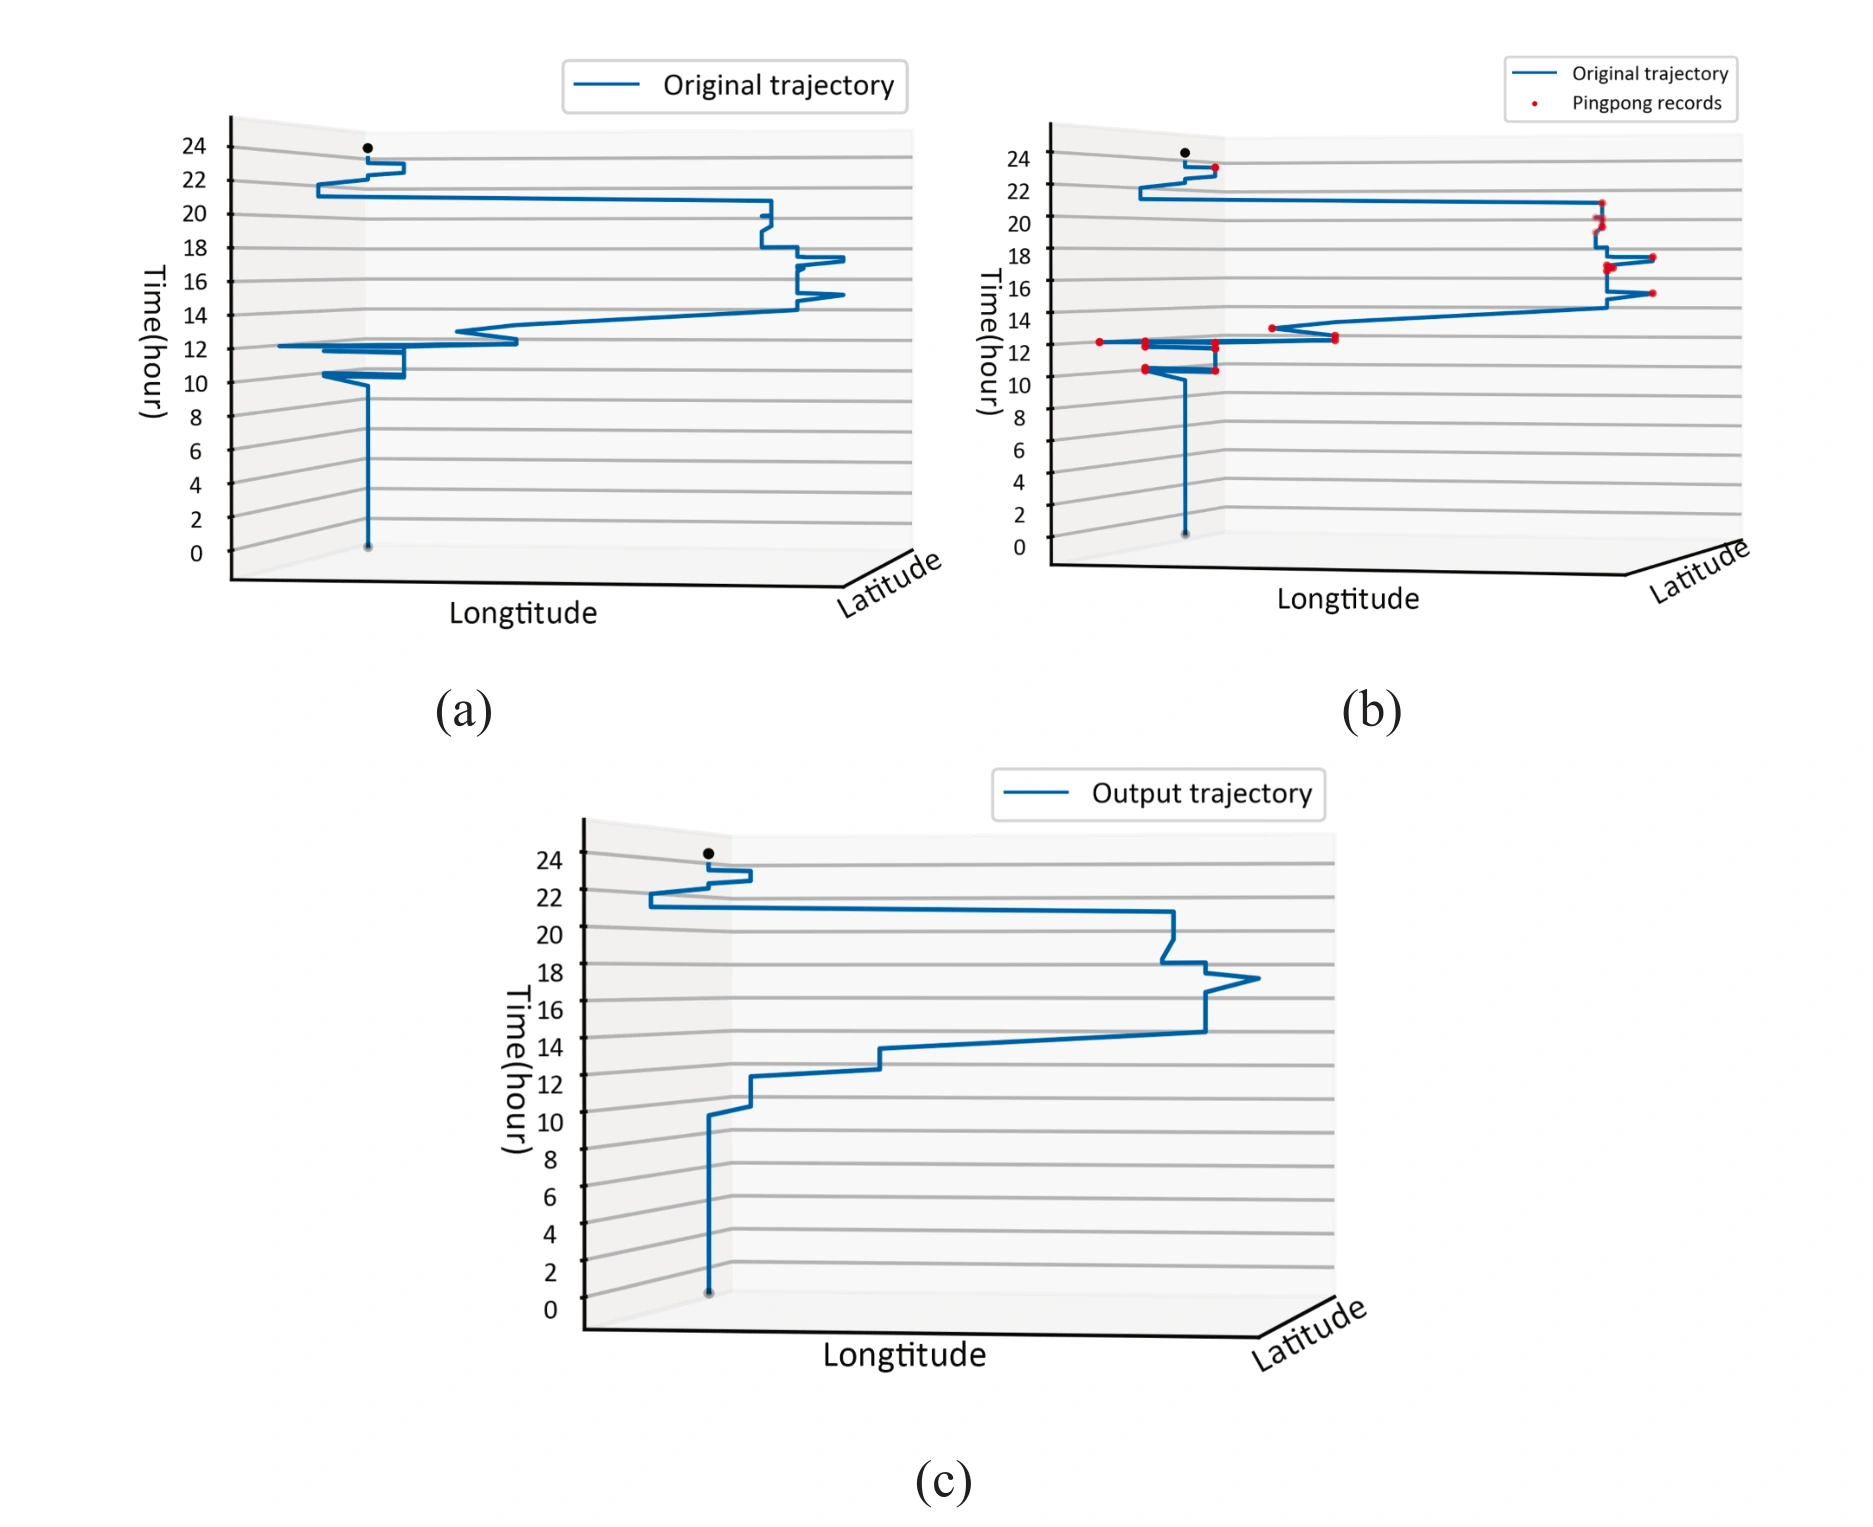
图 12|替换位置以后,一个人的一天变成什么样?
(a)原始轨迹,横轴是经纬度,竖轴是时刻。(b)红点是多规则、Th2 标出的乒乓记录,集中在午前和午后的来回上。(c)把这些点的位置换成时间上最近的邻点之后,短促折返减少。作者同时写明,16 时到 18 时的跳跃没有满足规则,所以没有被标成乒乓。这是一名用户的示意,不能当成 1 万名用户的平均路径。来源:原论文 Fig. 12。
规则也会漏,而且算得慢
速度规则最快,另外三条慢两个数量级。测试从原始数据随机抽 2,000 名用户、194,459 条记录,平均采样间隔大约 28 分钟,每种方法跑 30 次。机器是 Intel i7-8700 3.20 GHz、8 GB 内存、Windows 10、Python 3.6。表 2 没有标明时间单位。若把表中的均值当成同一种单位,速度规则 1.856,重复移动 206.429,急转弯 256.236,多规则 451.652。后两者相对速度规则大约是 111 倍和 138 倍,多规则大约是急转弯的 1.8 倍。正文写重复移动和急转弯接近速度规则的 200 倍、多规则大约再翻一倍。200 倍和表内均值对不上;“再翻一倍”和 1.8 倍接近。
漏检也有固定形状。转角都小于 150°,而且每次跳动的间隔又大于时间窗时,轨迹仍可能在几座基站之间绕圈,规则却不会标。
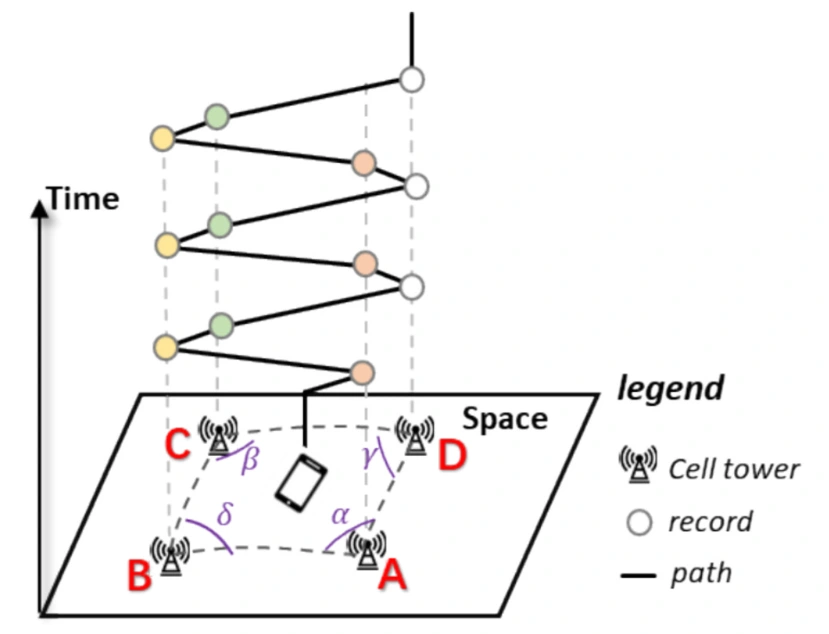
图 20|什么样的异常轨迹会整段漏过?
A、B、C、D 四座基站围着手机,转角 α、β、γ、δ 都不够大,时间间隔又超过窗口。作者指出立交和环岛一类复杂道路更容易出现这种情况。这是示意,不是西宁实测的漏检比例。来源:原论文 Fig. 20。
因此,这套规则的边界可以收成几句。它没有真值,检出比例不能当成精度或召回率。阈值按西宁的出行次数经验设定,换城市应重设;固定阈值会碰到快递员这类真实的高频往返。只分析了一个工作日、一家运营商,上海和深圳的图也不支持“三城只差几个百分点”。算法在文中的实现偏慢,转角小而间隔大的绕行会漏掉。相关的下游说法,例如疾病传播会因为熵被高估而失真、拥堵收费会因为距离被高估而失准,是作者的应用推断,不是这篇论文做了流行病模型或收费评估。
一句话总结
人站着不动时,粗采样的手机定位仍会在重叠基站之间来回弹;用重复往返和急转弯能把速度规则看不见的记录找出来,它们主要抬高这一天的出行距离和移动熵,很少改变回转半径,但更高的检出比例还不是一份有真值的准确率。
核心来源
Zhao, Z., Lin, Q., Zhang, W., Fang, Z., Yang, X., & Wu, S. (2026). Detecting hidden ping-pong records in mobile phone location data by considering daily activity patterns. Travel Behaviour and Society, 45, 101350. https://doi.org/10.1016/j.tbs.2026.101350
赵志远,署名单位是福州大学数字中国研究院(福建),以及地理空间信息技术国家地方联合工程研究中心。论文中的贡献是写作、调查和获取资助。本文参考文献里他的前期工作讨论通话详单偏差、停留识别和时间采样间隔。中文姓名见于其访学单位公开成员名单,与福州大学的去向一致。
Qinyi Lin,署名单位是福州大学数字中国研究院(福建),贡献是审阅和调查。论文没有给出可与机构页面核对的中文姓名,这里保留署名原文。
Wenting Zhang,同一研究院,贡献是起草、方法、调查和数据整理,是方法与数据部分的主要执笔者。中文姓名同样未在可核对的机构页面上确认。
方志祥,署名单位是武汉大学测绘遥感信息工程国家重点实验室,贡献是审阅。杨喜平在陕西师范大学的论文列表中,与他、赵志远有多篇手机定位与人群聚散的合作论文。
杨喜平,通讯作者,署名单位是陕西师范大学地理科学与旅游学院。学校主页列出其学科为地图学与地理信息系统,研究方向包括时空轨迹大数据、交通 GIS,以及城市居民和游客的时空行为。
吴升,署名单位是福州大学数字中国研究院(福建)和空间数据挖掘与信息共享教育部重点实验室,贡献是审阅。该实验室公开名单中有同名研究人员,方向包括网络地理信息共享服务。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
停留识别若先按 500 米把点聚成一次停留,重复移动规则找到的跳动大约有四分之三短于这个距离,很可能会被聚进同一次停留;多规则和速度规则找到的跳动则大多长于 500 米,聚类消不掉。清洗和聚类谁先谁后,会决定短跳和长跳哪一种还留在出行距离里。只报告“已经做了停留识别”而不写顺序,距离偏差的来源就说不清。
8 小时内同一对基站超过 6 次就整段替换,也会碰到真实的快递员和网约车司机。他们的轨迹被换成邻近点之后,城市尺度的就业空间、夜间配送和低收人通勤都会少一截。若后续研究关心的是这几类人,阈值应把沿路前进的往返和原地弹跳分开,而不是全城共用一个次数。
图 11 已经表明,大约 1 小时一个点的深圳和大约 24 分钟一个点的上海,不能共用西宁的检出比例。把西宁这一天的 14% 和 45% 写成手机数据的普遍噪声水平,会高估小时级数据里的乒乓,也会低估密采样城市里的短跳。换城市之前,至少要重新看采样间隔和基站间距,而不是只改一个速度阈值。