手机记下了位置,为什么还是说不清人为什么出门?
论文名片|Zhenzhen Wang、Sylvia Y. He、Yee Leung,Applying mobile phone data to travel behaviour research: A literature review,Travel Behaviour and Society。DOI:10.1016/j.tbs.2017.02.005。本文依据 Elsevier 未校正校样解读。校样页眉与文末建议引用行均印为 Travel Behaviour and Society (2017),卷、期、页码仍是 xxx;收稿日期 2016 年 7 月 26 日,修回 2017 年 2 月 2 日,接收 2017 年 2 月 28 日。这是一篇文献综述,不是一次新的出行调查。
规划早高峰的公交时,想知道的是人们从哪里出发、到哪里去、当时在做什么。传统做法是请人回忆昨天的行程:样本有限,采集贵,过几个月又过时。手机却几乎一直开着,连上哪座基站、卫星定到哪个点、加速度计有没有晃动,都会留下痕迹。看到一份覆盖数百万用户的记录之后,很容易觉得出行日记可以被换掉。
这篇综述检查的就是这个判断。手机数据把“何时、何地出现”推进得很远,也能看到一些反复出现的统计规律;一旦要问这是谁、去做什么、为什么这样选,多数已有研究仍停在分组描述。空间和时间信息很多,社会人口属性很少,其他因素通常没有放进同一个模型。
先说结论
- 出行研究里常用的手机数据分成两类:电信运营商的蜂窝网络数据,以及智能手机传感器数据。综述举例,中国城区基站服务半径大约 100–500 米,郊区大约 400–10,000 米;网络驱动数据在中国城市大约每 30 分钟到 1 小时记一次。三座及以上基站可用时,三角定位的空间分辨率被写成数米。这些是转引的量级,不是本文新测的误差。
- 从定位点切出停留,依赖阈值和数据有多密。传感器轨迹里,最常被接受的停留时间阈值是 120 秒。蜂窝数据更常靠“反复出现、停得够久”来认家和工作地,短暂停靠很容易消失。
- 出行方式的准确率不能脱离类别数来读。蜂窝数据主要区分静止、步行和机动车,Sohn 等报告的总体准确率是 85%,综述没有给出测试条数。GPS 和运动传感器可以把方式拆得更细:一项研究分出 5 类,一项分出 8 类;正文还列举了 9 类,表 4 又把其中一项写成 8 类。
- 两个“能预测”的数字分母不同。用熵衡量,个体出行的可预测性平均可达 93%。用当天前半段的特征行为去重建后半段,准确率是 79%。影响因素研究大多只比较不同人群、时段和地点,没有放入其他协变量,所以还不是因果。
出行研究想问的事,调查为什么经常答不全?
出行行为在综述里是一组具体问题:一天出行几次、去做什么、几点出发、花多久、走多远、用什么方式、行程怎么串成链、去哪里、和谁一起。变化分成两层。一个人自己的变化,包括白天和夜晚、工作日和周末这类短期差别,搬家、换工作、买车这类中期差别,以及结婚、生育、退休这类生命阶段差别。人与人之间的差别,则常被放在性别、种族、职业、教育、收入、生活方式和家庭结构上。
要解释这些差别,传统研究先看描述性差异,再用多变量方法估计每个因素和出行的统计关联。人口和社会经济属性、建成环境(城市形态、土地利用、邻里设计),以及生活方式、态度和偏好,是反复被检查的几组因素。在此之上才谈预测。较早的集合模型按交通分析区(traffic analysis zone,TAZ)预测流量,典型是出行生成、出行分布、方式划分和路径选择这四步。后来的个体模型则模拟一个人的选择,依据包括时间地理学里的约束,以及效用最大化。
支撑这些问题的数据,长期主要来自问卷调查和回忆式出行日记。采集工具从纸笔、电话、电子邮件发展到电脑和互联网,研究却越来越需要更全、更准的记录。综述归纳的短板是:贵、抽样率低、调查期短、少报,而且很快过时。便携 GPS 可以连续记下轨迹、少麻烦受访者,但给每个人配设备仍然贵,完全有效的应答率也低。综述没有给出这个应答率的具体百分比。
与调查并行出现的还有智能卡、出租车 GPS 轨迹和路侧传感器。综述把手机数据视为其中应用最广、也最有潜力的一类,并借用大数据文献的五个特征来描述它:体量大、类型杂、生成快、原始特征在处理中应被保留,以及有可能帮助决策。后文要分开的是这些记录怎么来的:有的是运营商为计费留下的,有的是研究者打开传感器记下的。
位置和运动,是两套系统记下来的
手机上和出行有关的记录,来自两套系统。定位系统靠射频信号判断设备在哪里,信号可以来自蜂窝网络、GPS、辅助 GPS、Wi-Fi 和蓝牙。运动系统靠机内传感器判断设备处于什么运动状态。图 1 把这套框架画成一张示意图,来源是 Pei 等 2013 年的图,不是本文新做的精度实验。
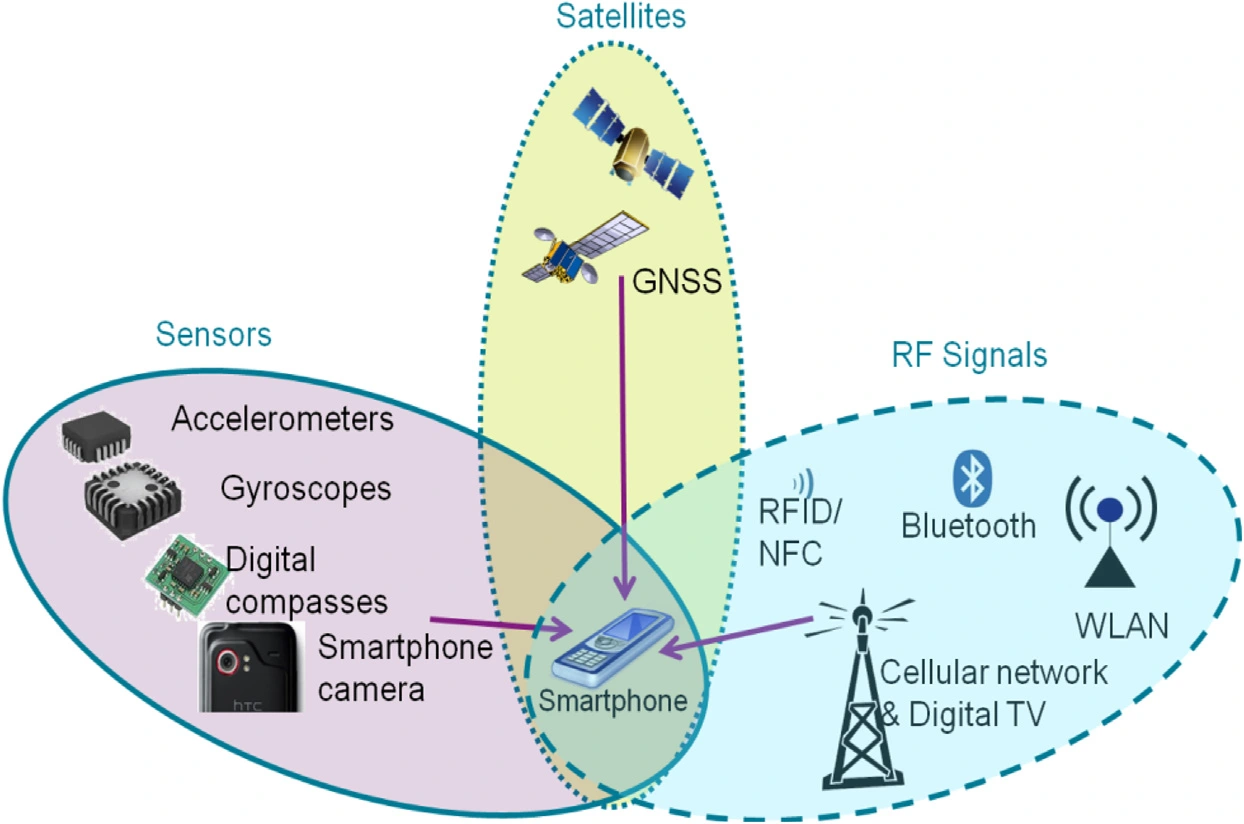
图 1|手机靠什么知道人在哪里、在怎么动?
图中没有(a)(b)式的子图字母,而是三个交叠的采集来源,箭头都指向中间的智能手机。左侧 Sensors 列出加速度计、陀螺仪、数字罗盘和手机摄像头。上方 Satellites 是 GNSS,也就是卫星定位。右侧 RF Signals 列出 RFID/NFC、蓝牙、WLAN,以及蜂窝网络与数字电视。图上的设备清单比正文点名的更宽。正文强调的定位信号是蜂窝网络、GPS、辅助 GPS、Wi-Fi 和蓝牙,强调的运动传感器是加速度计、磁传感器和罗盘。这张图说明采集框架长什么样,不能当成每种信号都已经在出行研究里达到图中所示的可用性。来源:原论文 Fig. 1,转引 Pei 等(2013)。
蜂窝定位有两种记法。最初记下的是手机所连接小区的 Cell-ID,每个 Cell-ID 再对应一对经纬度。空间分辨率取决于基站服务半径,不同运营商、不同地区不一样。综述举的中国例子是:城区大约 100–500 米,郊区大约 400–10,000 米。两档在 400–500 米上重叠,并不是把城市和郊区切成互斥的两档误差。若测量信号强度和传播时间、用三角定位,并且范围内有三座及以上基站,位置可以直接写成经纬度,分辨率被写成只有数米。
GPS 在室外也可以到数米,但在城市峡谷里信号会丢失,反射造成的多路径也会让定位不准。Wi-Fi 利用接收信号强度,分辨率大约数米;再结合三角定位,综述写成甚至可以到 1 米以内。蓝牙则是在大约 100 米的无线通信距离内,设备经过装有蓝牙信标的地点时留下带时间的位置。这里的 100 米是通信距离的通常说法,不是定位误差。
运动传感器里,加速度计被用于主动出行和身体活动研究,用来区分上楼、下楼、站立、行走、跑步、骑车或开车等状态。磁传感器在布置磁体作为检测器之后,可以测设备和磁体的距离以及移动速度。手机还会做传感器融合:按当时哪种信号可用,自动选择定位方式。一些出行调查已经同时采集多种定位和运动数据。
话单很密的人,和传感器一直开着的人,不是同一类样本
真正进入出行研究的数据,大体仍是两类来源:蜂窝网络数据,和智能手机传感器数据。谁在采、为了什么采,决定了样本偏差和时间间隔。
蜂窝数据由运营商采集,地理覆盖和手机普及率都高,抽样偏差相对小。偏差仍在:不同运营商的市场份额不同,欠发达地区的手机普及率低,很少打电话、很少用手机的人贡献的记录也少。按触发方式,它再分成事件驱动和网络驱动。事件驱动是在通话或上网时记录,运营商据此生成呼叫详单(call detail records,CDR)用于计费。话单的时间间隔不稳定,而且多数情况下很稀。网络驱动按周期记录,或者在手机从一个小区进入另一个小区时记录,时间间隔更高也更稳。综述举的中国城市例子是大约 30 分钟到 1 小时。空间上,同一套蜂窝数据可以从几百米到数米,取决于城区还是郊区、基站密不密、用的是 Cell-ID 还是三角定位。
这类数据因为隐私,通常要凭许可和协议向运营商获取,应用因此受限制。也有运营商向研究社区发布数据。Orange 的 Data for Development(D4D)发布过匿名手机数据,综述转引的结果是:相关研究成果中有三分之二与出行行为有关,并认为这推动了非洲的出行研究。三分之二的分母是这项活动的研究成果,综述没有给出成果总数。
传感器数据有两条路。一条是大众应用顺带留下的:社交媒体上带地点和时间的签到,运动应用里的轨迹。另一条是研究者为调查专门做的应用,例如在澳大利亚试点出行调查中使用的安卓记录程序。大众应用的偏差往往更重,因为每个应用服务特定人群;运动应用的使用者多是喜欢锻炼的人。专用应用则不容易招募,样本通常小,代表性也没有保证。综述据此认为,它们对一般性的出行调查用处不大。空间分辨率和细节可以更高,时间却不一定密:专用应用若要求一直开着,可以连续记录;大众应用往往只在被人使用时才有数据。
表 1 到表 3 不是本文的调查样本,而是两种记录格式的例子。Cell-ID 记录先是一串标识,位置要再联到小区坐标表。示例里,主叫标识 24393943 在小区 10121 呼叫对方,时长一栏是 29;同一主叫还有小区 5621、时长 38,以及小区 31041、时长 111。综述没有标明时长单位。小区 10121 在坐标例表中对应纬度 44.658885、经度 10.925102。三角定位的例子则直接给出经纬度:设备 18029034 在 2011 年 9 月 1 日星期四的 7:26:21、9:52:27 和 10:15:09,三行都是纬度 34.0863、经度 −118.07733。三行坐标相同,只说明这种记录长什么样,综述没有把它定义成一次停留。两张例表都没有出行目的、交通方式和同伴。
研究者自采并公开的例子,是 2011 年在莱芒湖地区采集、放在研究机构网站上的一套手机数据。综述只把它当作可申请使用的数据来源,没有在这里报告分析结果。
从坐标到一次出行,阈值决定了你看不见什么
不同定位方式带来的问题不一样,所以要先清洗。蜂窝数据里的噪声,主要是信号漂移造成的不合理位置,以及基站服务范围模糊、相互重叠带来的粗定位。常见处理是先按时间顺序忽略漂移,再用传播模型和凝聚层次聚类,从原始点里提取更可用的位置。GPS 会在遮挡严重时失败,信号弱或受干扰时不准。有些误差可以用地图匹配改正;改不了的,要用相邻两点之间的距离或速度阈值滤掉。综述没有给出这些距离和速度阈值的具体数值。
最基础的一步,是认出停留,再抽出出行。Cell-ID 数据的时间往往很稀,多数研究只抓那些反复出现、持续时间相当长的停留:把连续记录和历史记录合在一起,数每个小区里的定位次数。三角定位写下的是带误差的经纬度,不能再靠“出现在同一个小区编号里”来计数,通常改用聚类,例如把彼此接近的点合成一处停留。停留一旦划出,个体层面可以统计出行次数和距离,集合层面可以做起讫矩阵(origin–destination matrix,OD 矩阵)和流量分布。
传感器轨迹更密,短暂停靠和较少出现的停留也能被看见,于是有可能认出包含多次停留的复杂出行链。基于规则的做法,是给相邻定位点之间的停留时间设阈值。综述写到,最常被接受的阈值是 120 秒。另一些研究不先定秒数,而是寻找挤在一起的 GPS 点束。120 秒是文献中的常用约定,不是这篇综述自己标定的最优切分。用它切出来的一次停留,和用大约 30 分钟到 1 小时一记的网络驱动记录切出来的一次停留,数的不是同一种事件。
活动类型继续依赖规则。蜂窝数据大多只能认那些经常发生、持续较久的活动。综述举的例子是:夜间(例如 19:00–8:00)反复出现的停留标成在家;工作日工作时间(例如 8:00–19:00)反复出现的停留标成在办公室;其余笼统归为其他活动。对应的出行类型,最常被分开的是:基于家的工作出行、基于家的其他出行、非基于家的工作出行、非基于家的其他出行。这些是类别,综述没有给出各类占全部出行的比例。GPS 还能看到频率低或时间短的停留,再借助停留时刻、停留时长和兴趣点的服务时间来贴标签,例如早晨或下午出现在学校附近,可能是接送孩子。Wi-Fi 或 GSM 的位置再配上加速度计,还可以区分商场购物、在家做家务等室内活动。规则来自经验和常识,贴上的标签是推断。
路线图上的红线,是估计,不是已经核对过的真路径
路径是在停留和出行之上再做的一步估计。蜂窝数据先把定位点落到具体位置,再做地图匹配:通常取最近的道路或交通节点作为起点或终点,然后把这对起终点套到交通网络上。若中间还有定位点,匹配可以更有依据。综述同时写明,路网密的地方一条起终点之间有多条道路,这种估计相当不准。
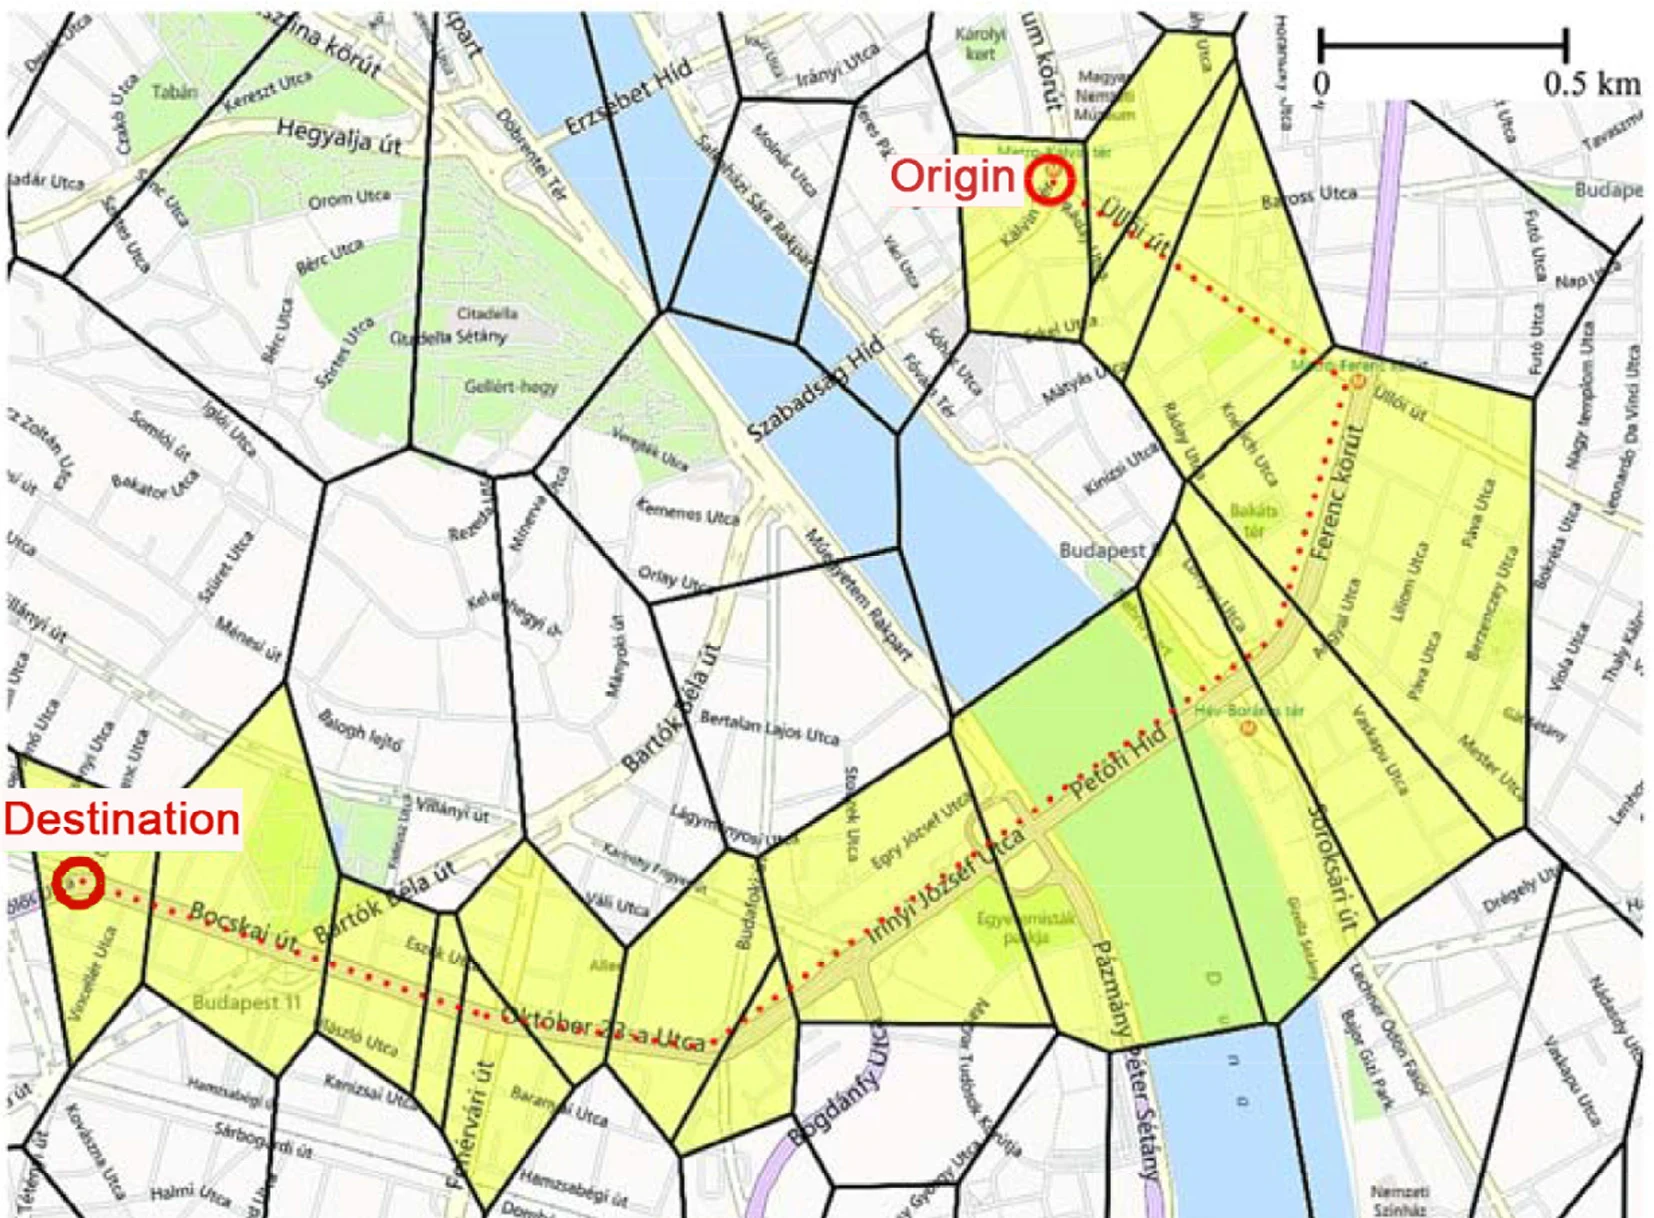
图 2|只知道小区起终点时,估计出来的路径长什么样?
无字母子图。底图是带街道名称的城市路网,图面上印有 Budapest。黑色折线把地图分成许多多边形,一部分多边形着黄色,并沿一条走廊连起来。红色虚线从右上方标为 Origin 的圆点连到左下方标为 Destination 的圆点。右上角比例尺为 0.5 公里,表示图上该线段对应的地面距离,不是这条红线已经被量成 0.5 公里。综述没有在这张图上给出匹配命中率,也没有说明黄色多边形的统计定义。它用来展示 Cell-ID 起终点如何被画成一条估计路径;路网越密,同一对起终点对应的道路越多。来源:原论文 Fig. 2,转引 Tettamanti 等(2012)。
手机 GPS 的轨迹更连续,把一串点按顺序套到路网上会容易一些。信号差或缺失时,有研究改用概率地图匹配:先生成许多可能路径,再给每条路径一个似然,取得分最高的那条。图 3 是这种比较的一个例子。
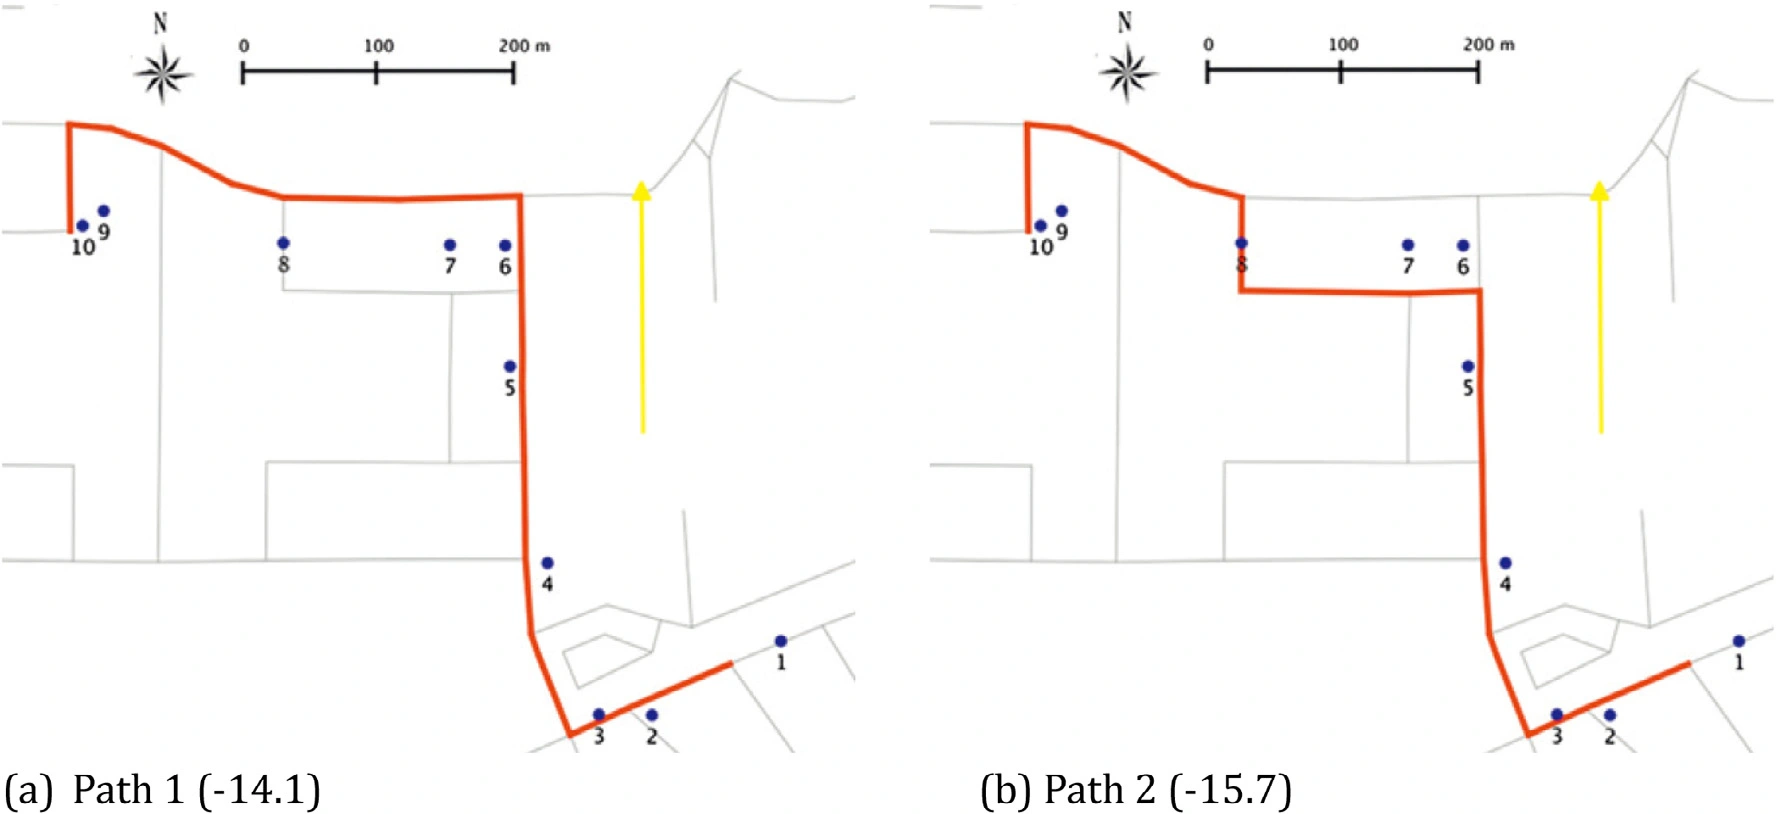
图 3|同一组 GPS 点,两条候选路径哪条更像?
(a)Path 1,图上印的似然是 −14.1。蓝点编号从 1 到 10,红色实线沿上方再沿右侧把这些点连成一条候选路径。指北针、0–200 米比例尺和一支向上的黄箭头都在图内;综述没有解释黄箭头。(b)Path 2,似然是 −15.7。点号、比例尺和指北针与左图同一套,红线中途向路网内侧拐了一段。−14.1 高于 −15.7,所以综述判断左路更可能是真实路径。这两个数是这一组点上的两条候选路径的似然得分,不是 0 到 1 之间的概率,也不是许多次出行上的命中率。来源:原论文 Fig. 3,转引 Bierlaire 等(2013)。
方式识别的粗细,同样跟着数据走。蜂窝数据用小区切换的快慢和信号强度的起伏来估计一个粗速度,能分开的方式仍然有限,主要是静止、步行和机动车。综述认为这类估计的准确率可以相当高,并给出 Sohn 等的总体准确率 85%。85% 的分母是那一项研究的总体准确率,本文没有重述测试了多少段行程或多少个时间片,也没有给出三类方式各自的准确率。GPS 和运动传感器能提供更细的速度和运动状态。Reddy 等用 GPS 和加速度计分出 5 类:静止、步行、跑步、骑车、机动车。Widhalm 等区分 8 类:公交、小汽车、自行车、有轨电车、火车、地铁、步行、摩托车。Nitsche 等在正文里被写成 9 类:步行、自行车、摩托车、小汽车、公交、有轨电车、地铁、火车,以及等待。分类器包括决策树、隐马尔可夫模型、基于规则的分类器、人工神经网络和贝叶斯分类器。方式通常先靠速度,有的研究再补上个人历史出行和交通网络。综述没有做一场分类器竞赛,没有报告哪一种分类器在同一测试集上高出多少。
规律很稳,并不等于原因已经分开
另一批研究不太追问每一次出行的目的,而追问人的移动在统计上是否有稳定形状。使用的主要是运营商蜂窝数据。人会以很高的频率回到某些地点,同时以一定概率探索其他地点。在常去地点之上,活动范围常用两个指标。位移(displacement)是连续两次识别出的停留之间的直线距离,不是沿路里程。回转半径(radius of gyration)被用来表示活动地盘有多大;综述把它说成活动范围的直径。位移和回转半径的分布被概括为截断幂律:大多数人的活动范围有限,少数人会到很远的地方。综述没有给出这条幂律的指数,也没有重做拟合。
香农熵用来衡量出行有多随机。熵越大,模式越随机,越难预测。综述转引的一项结果是:个体出行行为的可预测性平均可达 93%。这是熵意义下的可预测性,综述没有在这里重述用户人数,也没有把公式再写一遍。另一项用熵讨论人会落在何处的研究认为,人们倾向于在到访最多的地点之间做选择,其中包括家和工作地。偏心率(eccentricity)被用来描述轨迹的形状。Yuan 等发现,人的移动轨迹更接近圆,而不是一条线,意思是常去的地点散开分布,而不是排在一条线上。凸包也被当作活动范围的另一种画法,综述没有给出对应的数值结果。
这些规律说明移动在统计上高度可重复,也因此显得可预测。综述自己后来也提醒:人类移动的熵这一类发现,并不直接就是交通系统里的结论,怎样用到城市交通建设和管理上,仍然留待以后。
分组比较试图回答谁的活动范围更大。Yuan 等比较了半径、偏心率和熵:男女之间没有显著差别;青年和中年人比青少年和老年人走得更远,随机性也更高。综述没有给出年龄分组的岁数界限。没有显著差别,只说明这项比较没有检出显著差异,不能写成男女的出行完全相同。一天之内的熵来自 Wang, M.(2014)的博士论文,不是本文第一作者的结果:早晨上升,下午最高,傍晚下降,被解释为早晨和傍晚更常回到已去过的地方,下午探索更多地方。Yuan 等还报告,工作日的熵高于周末,周末的偏心率更高;前一项被解释为工作日出行更不规则,后一项被解释为周末到访地点更呈线状分布。Isaacman 等则发现,洛杉矶和纽约的人都在冬季出行更少。这几项都是被引研究里的比较,本文没有报告差值的具体数值。
空间上,Kang 等看了中国 8 座城市:紧凑度更低、城市尺度更大的城市,居民的日常出行距离总体更长。Yuan 等比较家和工作地的位置:住在市中心并且在市中心工作的人,平均活动半径最小,对照是家或工作地至少有一处在市中心以外的人;住在市中心、工作在中心以外的人,出行模式最随机。Isaacman 等发现洛杉矶的人总体比纽约的人走得更远,综述转述的解释是城市形态更铺展。这是形态上的对应,不是已经分离了收入和交通供给之后的因果。工作地点属性相近的人,出行模式也相近;综述称这种相关很强,但没有给出相关系数。
社交联系是另一组观察。短距离出行相当规则,并且独立于社交网络结构;长距离出行则表现出受社会关系影响。两人之间的手机通信强度,与他们出现在同一地点的频率显著正相关。同样,综述没有给出相关系数或人数。上述因素研究的共同限制写在原文里:它们比较的是不同情境下看到的出行模式,大多数没有纳入可能的协变量,得到的是描述性结果。
流量能模拟,选择机制仍可能是空的
集合模型仍然可以按四阶段来做,但前两步的输入变了。传统上用地数据和人口普查预测交通分析区之间的流量;手机数据则可以先得到 OD 矩阵,再把矩阵放大到全部交通量,然后用其他数据核对,例如路侧录像得到的观测流量。已有研究也进入了后两步:先模拟小汽车和其他方式的选择,再把不同方式分配到相应网络上。综述据此认为,这些工作表明手机数据可以成为成本较低、并且可靠的流量建模来源。本文没有汇总那些核对的误差,因此“可靠”是综述对这一组研究的归纳,不是一张统一的误差表。
个体层面的预测,建立在“统计上很有规律”这一判断上。模型从数学、物理和计算机领域引进。有人用调整后的静电力模型预测下一步目的地。特征行为(eigenbehaviour)用来描述重复出现的日常结构:把某一天前半段的个体特征行为做加权求和,再重建当天剩下的部分,准确率是 79%。79% 的分母是这一项“用前半段重建后半段”的任务,不是下一周、也不是另一座城市的预测。另有统计上自洽的微观模型,依据移动过程的自抑制特征(self-quenching)预测轨迹选择。综述没有在这里给出该模型的参数。
这里留下的缺口是双向的。为传统调查设计的统计模型,要求数据准确、完整,并且对偏差敏感,而偏差和噪声在手机数据里很常见;数据体积大、维度多、结构不整齐,长程相关和人与人之间的依赖也不是旧模型擅长的对象。从其他学科引进的模型可以只凭历史轨迹预测、不必先放入全部影响因素,但综述认为它们对机制的洞察有限,预测结果怎样指导交通建设和管理,仍然不清楚。神经网络和深度学习被写成对交通研究者来说技术门槛高、计算负担重,不是已经完成的方法替换。
同一张表里,人、出行和定位点不是一个分母
综述用一张挑选出来的研究表,展示不同数据能做的题目。表 4 不是全文献普查。各行的计数单位不同,不能求一个“平均样本量”,也不能把 15 名志愿者和数百万用户连成同一项精度。
| 研究 | 数据 | 表中写出的样本 | 用来做什么 |
|---|---|---|---|
| Chen 等(2014) | 蜂窝,三角定位 | 7,989 人 | 识别活动及到访地点类型 |
| Iqbal 等(2014) | 蜂窝,Cell-ID | 287 万用户,约一个月 | 建立 OD 矩阵 |
| Li 等(2016) | 蜂窝,三角定位 | 表中写明未提供细节 | 识别居民出行的时空属性 |
| Patrick 等(2015) | 蜂窝,Cell-ID | 400 万条样本,12 天 | 建立 OD 矩阵 |
| Çolak 等(2015) | 波士顿三角定位;里约 Cell-ID | 波士顿 200 万用户、2 个月;里约 280 万用户、5 个月 | 做四阶段模型、OD 和出行目的 |
| Pei 等(2013) | GPS、Wi-Fi;加速度计、陀螺仪、磁传感器 | 560 个样本检验定位精度,1,200 个样本做运动识别 | 定位、运动识别和行为建模 |
| Nour 等(2016) | GPS | 658 次出行,457,945 个点 | 改进方式推断 |
| Oksanen 等(2015) | 运动应用的预处理数据 | 2,424 名用户的 36,757 条锻炼记录,31 个月 | 生成保护隐私的骑行热度图 |
| Geurs 等(2015) | GPS、Wi-Fi、GSM、蓝牙;加速度计 | 600 名参与者、超过 18,000 次出行、2 周 | 智能手机面板调查,自动识别出行细节 |
| Widhalm 等(2012) | GPS、三角定位;加速度计、磁传感器 | 15 名志愿者,2 个月 | 自动检测出行方式 |
| Nitsche 等(2014) | GPS、蜂窝定位;加速度计、磁传感器 | 15 名志愿者,2 个月 | 检测出行段及出行方式 |
表中的 287 万、200 万、280 万、400 万,分别对应原文的 2.87 million users、2 million users、2.8 million users 和 4 million samples。前三个分母是用户,Patrick 等这一行的分母是样本,不是用户。Pei 等的 560 和 1,200 是两项任务的样本数,不是两个人数相加。Nour 等同时有出行次数和定位点数。Oksanen 等的 36,757 是锻炼记录,2,424 才是用户。Geurs 等的“超过 18,000”是出行次数,600 是参与者。Widhalm 等和 Nitsche 等在表里都写成 15 名志愿者、2 个月;正文说前者区分 8 种方式,后者区分 9 种方式(含等待),表 4 却把 Nitsche 等写成 8 类出行方式。综述没有解释 8 和 9 差在哪里。Li 等被放进表里,但样本细节写的是未提供。因此这张表证明的是“这些题目已经有人用手机数据做”,不能证明每一行都达到了同样的证据强度。
把这些研究放回综述的总判断:交通领域的手机数据研究,很多是用新数据重做旧题目,并拿其他来源的数据当对照,检查手机数据能不能成为更便宜、仍然可靠的替代。出行次数和距离被重新看了一遍,对造成这些模式的机制仍然少有新的解释。原因被归结为三点。应用还在早期,精力花在数据处理而不是提出新问题上。数据本来不是为研究采集的,偏差和噪声使清洗和验证占用大量工作。记录富于时空和数量,缺的是用户的社会人口属性,所以很难解释是什么造成了看到的模式。把手机数据和其他数据融合以补上这些信息,仍处在试验阶段。
物理和计算机领域的研究被综述称为已有的突破性结果:出行在统计上呈现可重复的幂律(标度律)和截断重尾,而不是早先认为的随机游走和列维飞行;高度规律因此可预测,简化的微观模型才变得可行。这是对既有研究的转述。这篇综述没有重新估计幂律指数,也没有用同一批数据同时否定列维飞行。
还能往前走,但偏差和旧模型都还在
采集上,手机相对独立 GPS 设备的优势,是普及率高、人们本来就带着,样本可以更大,观察可以更长,加速度计和磁传感器还能补上别的维度。综述没有给出一个全球或全国的普及率数字。从“顺便留下的运营数据”转到“专门用手机辅助的出行调查”,被认为有机会同时处理研究伦理和用户背景信息不足。日本有把 GPS 和网络日记结合的探针式人员调查试点,奥地利有安卓应用试点。综述认为这些小规模试点表明大规模调查可行,它们本身还不是已经完成的大规模调查。更长的面板则可能记下搬家、换工作之后的行为变化,并更新社会人口信息。综述建议这类调查放在研究机构和政府机构的监督下进行。
位置隐私被写成获取数据的首要障碍。较常见的做法是去掉姓名、改用假标识;也有研究认为只这样做不够,并进一步提到位置模糊和 k-匿名。综述点到这些方法的名称,没有展开操作。传感器虽然已经装在手机里,缺少配套设施时仍然很少被用于出行,例如蓝牙采集取决于现场有没有信标。长期连续记录还会带来存储量,以及格式、结构不统一的管理问题。
在认出出行模式这件事上,手机数据有机会看到小样本调查看不全的差异,包括游客这类传统调查常常不覆盖的人,以及去医院、步行到附近餐馆这类次数不多或距离很短的出行。它也有机会看到非典型日:公共假日、洪水,而不是只保留一个“正常工作日”。月度、季度的规律在传统调查里很少被做,因为调查很难连续跟踪;手机的连续记录被看成补这块的条件。这些是潜力,不是本综述已经给出的新测量。
偏差仍会把模式认错。即便运营商数据覆盖了大部分人和大部分地区,没有手机或几乎不用手机的人仍然缺席。大众应用偏向它要服务的那群人。专用应用则要同时解决招募人数和样本结构。Cell-ID 这一类粗数据能认出的模式有限;靠推断去补,结果仍需要继续验证。
解释影响因素时,传统做法是把可信的变量放进模型,把每个因素的关联分开。手机数据缺少用户的人口属性,这条路不好直接走。在集合层面,已有研究用卡尔曼滤波、人工神经网络等做数据融合;把轨迹和个人信息配到一起的个体层面融合,进展很少。从手机数据反推社会经济属性的尝试,综述认为确定性和准确性仍然不足。季节、油价和公交票价、室内家务与户外出行、家庭成员之间的车辆分配、锻炼习惯,都被列为以后可以检查的因素。它们出现在“潜力”一节,不是已经得到的结果。
建模上,新认出的因素有可能改善旧模型。社交互动被放进模型后,预测表现有所提高;综述没有给出提高了多少。活动链和个体规则,则为基于活动的模型,以及基于主体(agent-based)的模拟,提供了校准素材。另一种预测不从理论自上而下规定效用,而直接从一个人过去的出行历史往下推,因为把所有影响因素都放进模型几乎不现实。同一篇综述同时认为,这种只凭历史的模型对机制帮助有限。连续到来的蜂窝数据还有可能支持动态交通模拟,而不只是一张静态快照。诺基亚研究中心和加州大学伯克利分校的 Mobile Millennium 被当作已有先例。旧模型如何吃进这种数据,新模型的结果如何变成交通管理动作,仍是开放问题。
结论里,综述把后续研究收成几条可做的事:用连续记录看月和季节的规律与不规则,传统调查很少覆盖到这一层;用更细的记录把个体出行看清楚;从其他学科引入更合适的理论和方法,做跨学科合作。交通教育被对应成三类能力:处理不同结构数据的深入分析能力,提出问题并解释结果的交通专业知识,以及开发软硬件、管理数据库的支持技术。综述认为不必要求每个学生同时具备三类,期望的是不同背景的人一起做。
这些话可以说到哪一步
这篇综述自己的证据等级,是对既有研究的归纳,不是新的抽样调查,也不是统一重算的模型比较。85%、93%、79% 都是被引研究的结果,分母分别是总体方式准确率、熵意义下的平均可预测性、用半天重建另半天的准确率。三者不能相加,也不能换成“手机数据的预测准确率是某一个数”。
中国的 100–500 米和 400–10,000 米,是综述举出的基站服务半径,随运营商、城区或郊区而变;三角定位在三座及以上基站可用时被写成数米。30 分钟到 1 小时是网络驱动数据在中国城市的例子;话单由通话或上网触发,间隔不稳,而且多数时候更稀。120 秒是传感器轨迹里常用的停留阈值。把这些时间格子切出来的出行次数直接比大小,差值里混着仪器本身的采样间隔。
图 2 的红线没有命中率。图 3 的 −14.1 和 −15.7 是一组点上的两个似然,不是全样本准确率。两张图都是转引的例子。表 4 各行的单位是人、用户、样本、出行、定位点或锻炼记录,而且有一行明确没有样本细节。
性别、年龄、星期、季节、城市形态和社交联系上的差别,是分组描述。原文写明大多数研究没有纳入协变量。住在市中心是否导致活动半径更小、洛杉矶是否因为形态更铺展而出行更远,都还不是这篇综述证明了的因果。幂律和截断重尾是对物理、计算机文献的转述,本文没有给出指数,也不能把“模型能够重现统计分布”说成已经找到唯一机制。
样本偏差贯穿全文:没有手机的人、很少使用手机的人、某个应用的特定用户,都不会自动代表全体居民。运营商数据相对更广,仍然不是人口普查。
一句话总结
手机数据已经能在很大的人群上认出停留、出行和一些反复出现的统计规律,但这些记录长于何时何地,短于是谁、去做什么;现有研究大多还在检验它能否替代出行调查,分组差异尚未把其他因素分开。
核心来源
Wang, Z., He, S. Y., Leung, Y. Applying mobile phone data to travel behaviour research: A literature review. Travel Behaviour and Society. 未校正校样,页眉与建议引用行年份为 2017,卷期页码未排定。DOI:10.1016/j.tbs.2017.02.005。图 1–3 分别由综述转引 Pei 等(2013)、Tettamanti 等(2012)和 Bierlaire 等(2013)。
Zhenzhen Wang、Sylvia Y. He 和 Yee Leung 在论文中的署名单位,都是香港中文大学地理与资源管理学系及未来城市研究所(沙田,新界)。
Zhenzhen Wang 是第一作者。
Sylvia Y. He 是通讯作者,论文列出的邮箱是 sylviahe@cuhk.edu.hk。参考文献中署名为 He, S.Y. 的工作,涉及通学方式与学校及居住环境、弹性工作时间与早晨出发时刻、家长是否护送孩子上学,以及远程办公、收入与户外活动。这些是本文引用的既有研究,不是本综述的新结果。
Yee Leung 是共同作者,署名单位与前两位相同。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若用基站话单去评估一份 GPS 日记是否少报了出行,两边的“一次出行”可能从定义上就不相同。网络驱动记录在综述所举的中国城市大约 30 分钟到 1 小时才有一条,传感器轨迹里常用 120 秒来切停留。接送孩子、步行去附近餐馆,可以出现在后一种记录里,并在前一种记录里消失。消失的那一部分,首先是时间格子太稀,不能直接记成居民少出门。
93% 和 79% 也不能接成一句“明天的通勤已经知道”。93% 是熵给出的平均可预测性,综述没有在这里重述人数;79% 是用同一天的前半段重建后半段。交通调度若把前一个数字当成跨日通勤预测的命中率,就换了分母。图 3 里 −14.1 和 −15.7 同样只比较了一组点上的两条路径,不能当作全路网的匹配准确率。
Yuan 等(2012)在参考文献中是哈尔滨案例。正文用它比较半径、偏心率和熵,男女之间没有显著差别。这不能外推成出行没有性别差异。那是三个指标上的描述性比较,年龄界限和协变量都没有在综述里给出。同一篇综述回顾的传统研究,本来就把性别和事务链、非工作出行放在一起讨论。三个指标没有检出显著差别,留不出男女出行相同这个结论。表 4 里 Li 等一行甚至没有样本细节。把已经有人做了读成已经做成了,证据会被抬高一档。