把最可能的出行活动写成车站之间的边,真实下车站能排到第几名?
论文名片|Qi Zhang、Zhenliang Ma、Pengfei Zhang、Erik Jenelius,Mobility knowledge graph: review and its application in public transport,Transportation,2025,52:1119–1145。2023年11月17日接收,2023年12月8日在线发表。DOI:10.1007/s11116-023-10451-8。期刊卷期年份是 2025,DOI 里的 2023 对应在线发表年份。这是一篇知识图谱综述,并用香港城市铁路刷卡数据做下车站排序的案例。
乘客进站时,闸机记下车站和时刻。论文写到,斯德哥尔摩等城市的公交卡只记录进站,出站没有留下。若把相似乘客去过的车站排成一份名单,这份名单会混进这个人并不去的站。
这篇论文把车站写成点,把某一时段里最可能的出行活动写成两点之间唯一的一条有向边,称为移动性知识图谱(mobility knowledge graph,MKG)。用来核对的是香港城市铁路 2018 年 1 月 1 日至 3 月 31 日、90 座车站的公交卡。这套卡同时有进站和出站。1 月 1 日至 2 月 28 日用来学习图,3 月用来测试。
方向性的结果是:早高峰、关系数取 30 时,神经网络抽出的图让大约 0.77 的测试行程把真实下车站放在第一名。同一口径下,按这个人自己的历史起讫去排,大约是 0.82;只按相似用户组统计,大约是 0.29。平峰更散,神经网络的第一名大约是 0.45。这些比例的分母是该时段的全部测试行程,论文没有写出行程总条数。学习图和核对答案时都能看到出站记录,所以数字描述的是两端都有记录的铁路系统,还不是只有进站闸机的城市上的实测。
先说结论
- 2015 年 1 月至 2022 年 12 月,作者在 Scopus 和 Web of Science 的标题里检索 knowledge graph 与 knowledge base,去掉无关和重复后得到 6238 篇。另有 689 篇被归入具体应用领域,纯方法论文不在这 689 篇里。城市交通在这 689 篇的分布里是最短的一类。
- MKG 被定义成按时段切开的四元组:地点、关系、地点、时段。每个时段里,一对地点只留一条有向边,边上是最可能的出行活动。这是在沿用知识图谱里一对实体只有一条有向关系的约束。
- 关系不能从刷卡记录里直接读到。规则法把起点的时间潜向量与终点的空间潜向量拼接后再聚类;神经网络同时学习车站和关系。聚类数被设成与神经网络抽出的关系数相同。关系向量的维度和关系的个数是两个数。
- 香港 90 座车站上,早高峰、30 个关系时,前 1 名大约是:个人历史 0.82,神经网络 0.77,规则法 0.63,用户组 0.29。前 5 名时,神经网络和参照都大约 0.88。平峰前 1 名,神经网络大约 0.45,个人历史大约 0.50。关系从 10 个增到 30 个,早高峰神经网络的前 1 名从大约 0.68 升到大约 0.77;再增到 60 个,大约 0.79。
- 把关系编号译成上班、上学或其他,正文给的是一张示意流程。论文没有报告这 90 座车站已经用出行调查完成并核对过语义标注。作者也写明,这个案例是在展示建图过程,还不是该问题的最佳模型。
知识图谱的论文很多,城市交通有多少篇?
要判断再为出行建一张知识图谱是不是在重复已有工作,先得看文献堆在哪里。作者检索的是 2015 年 1 月到 2022 年 12 月的论文标题,关键词是 knowledge graph 和 knowledge base。筛选后的 6238 篇是论文篇数,分母既不是作者人数,也不是被引次数。检索没有覆盖只在摘要或关键词里出现这些词的论文。
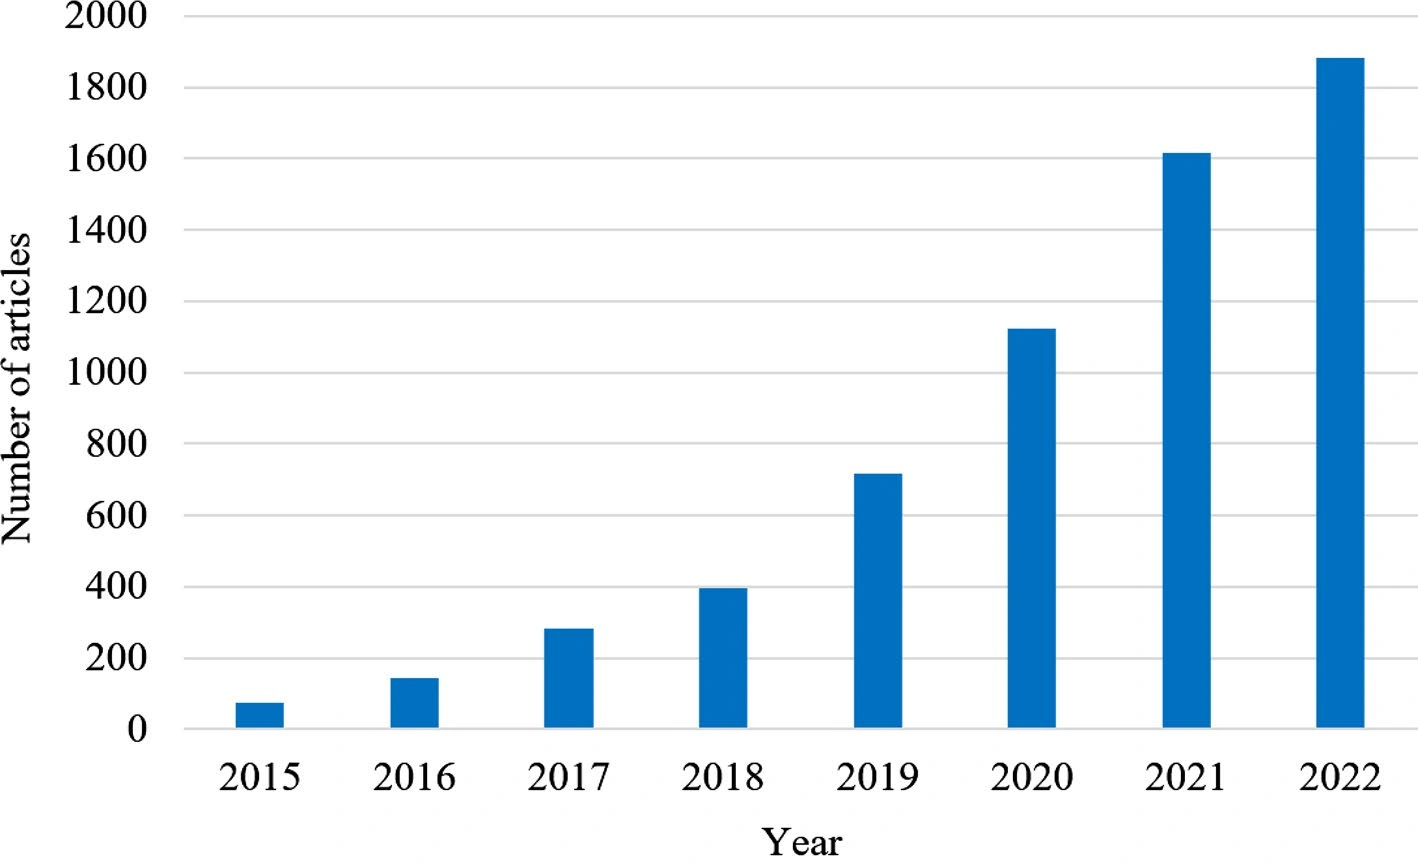
图 1|知识图谱论文在检索窗口里是怎样变多的?
这张图没有子图字母。横轴是年份,从 2015 到 2022;纵轴是文章数,刻度从 0 到 2000,每 200 篇一条横线。柱上没有印出每年的篇数。2015 年的柱远低于 200,2018 年之后升高明显,2022 年是最高的柱,接近 2000 但没有碰到 2000。图注印的是 2015–2021,横轴实际画到 2022,与正文的检索截止日期一致。因此图注的截止年不能当成这张图的数据范围。来源:原论文 Fig. 1。
6238 篇里,多数是方法,或没有被归进下面这张领域图。作者另数了 689 篇进入具体应用领域的论文,并写明纯方法发展的论文不进入这 689 篇。689 的分母是已归类的应用论文。
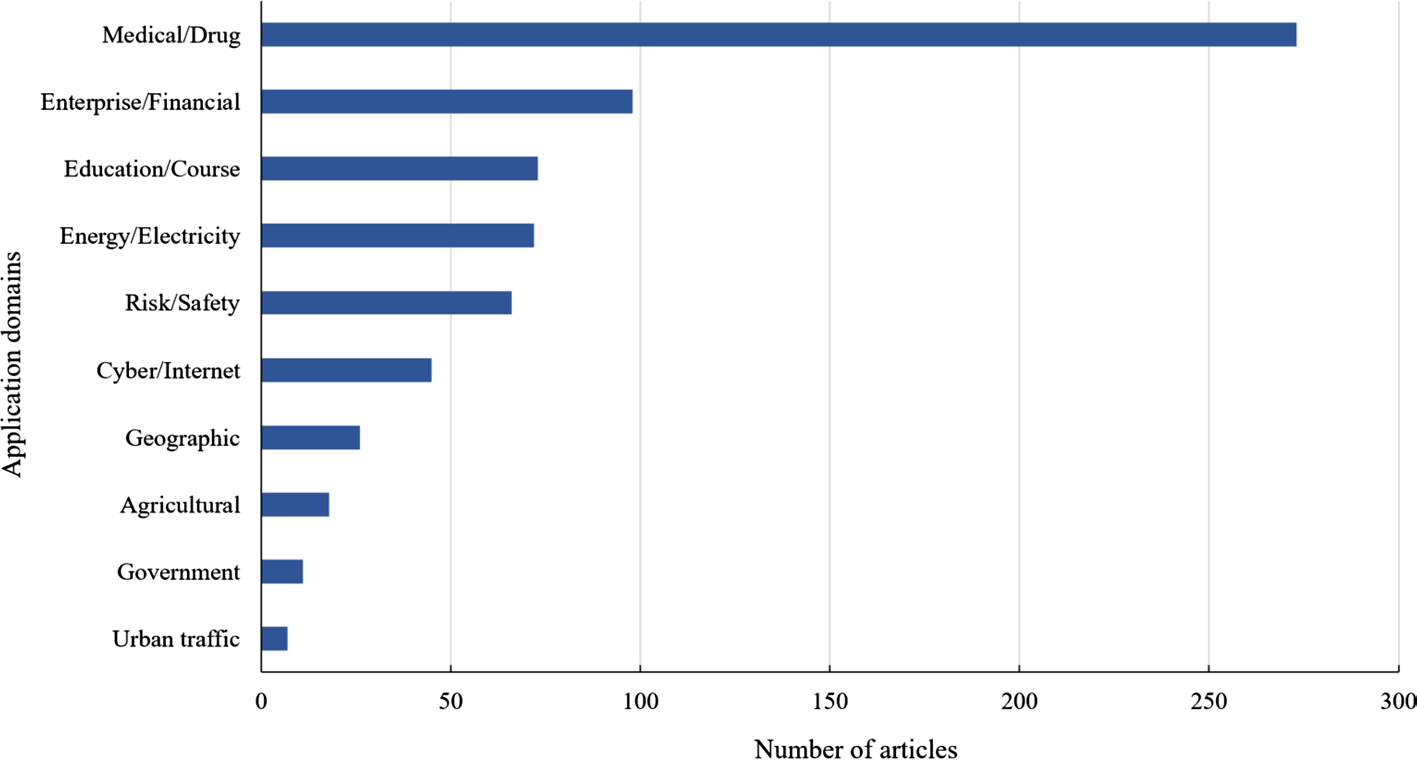
图 2|在已归类的应用论文里,城市交通有多少篇?
这张图没有子图字母。横轴是文章数,刻度 0 到 300,每 50 篇一条竖线;纵轴是应用领域。柱上没有数字。按刻度量柱长,医疗/药物大约 270 篇,企业/金融大约 100 篇,城市交通大约 6 篇。十根柱相加大约 684 篇,与正文的 689 篇相差大约 5 篇,处在柱端差一两个像素的读图误差里。教育/课程与能源/电力都大约 70 篇,柱长几乎一样;正文点名的第三类是教育/课程。城市交通是最短的一条,已经出现,但远少于医疗和企业。这些是刻度读数,不是表内精确计数。来源:原论文 Fig. 2。
交通方向被点名的工作包括:Tan 等人用道路、车站、公交和地铁组成城市交通知识图谱,例子是用户 A 从北京站出发;Hu 等人用公交卡上的个人出行链和出行调查识别公共交通通勤者;Shan 和 Cao 用兴趣点、天气和时间片推断行人量;Wang 等人把车站、线路、客流和事件放进图,再交给时空图神经网络预测地铁客流。这些是别人的系统。它们说明交通图已经能存静态邻接、归属和属性。它们还没有回答同一对车站在不同时段、不同活动下是不是同一条边。
一对车站为什么要按时间切开?
知识图谱的基本单位通常是三元组:实体、关系、实体。金融图里可以写成 Steve Jobs、创立、Apple。有的领域写成四元组,再加一项属性。医学例子是肺癌、相关症状、血痰、概率 8.89%。8.89% 来自 Li 等人的医学图,是该文给出的症状概率,不是本文测到的出行概率。
作者整理文献后看到一个共同限制:一对实体只允许一条有向关系。图上任意两点之间只能有一条有方向的边。上班途经的两站和傍晚返回的两站,若只能留一条边,通勤和购物就会被压成同一种活动。静态图还不带时间,关系不随早高峰、周末或季节改变。
表 2 把数据分成三类。时间序列同时勾了时间、地点和轨迹顺序;面板数据勾了时间和地点,没有勾轨迹顺序;截面数据只勾了地点。被综述的研究大多用截面或面板数据。作者写道,没有找到能够表达时间序列顺序和依赖的知识图谱研究,而这正是城市移动需要的。
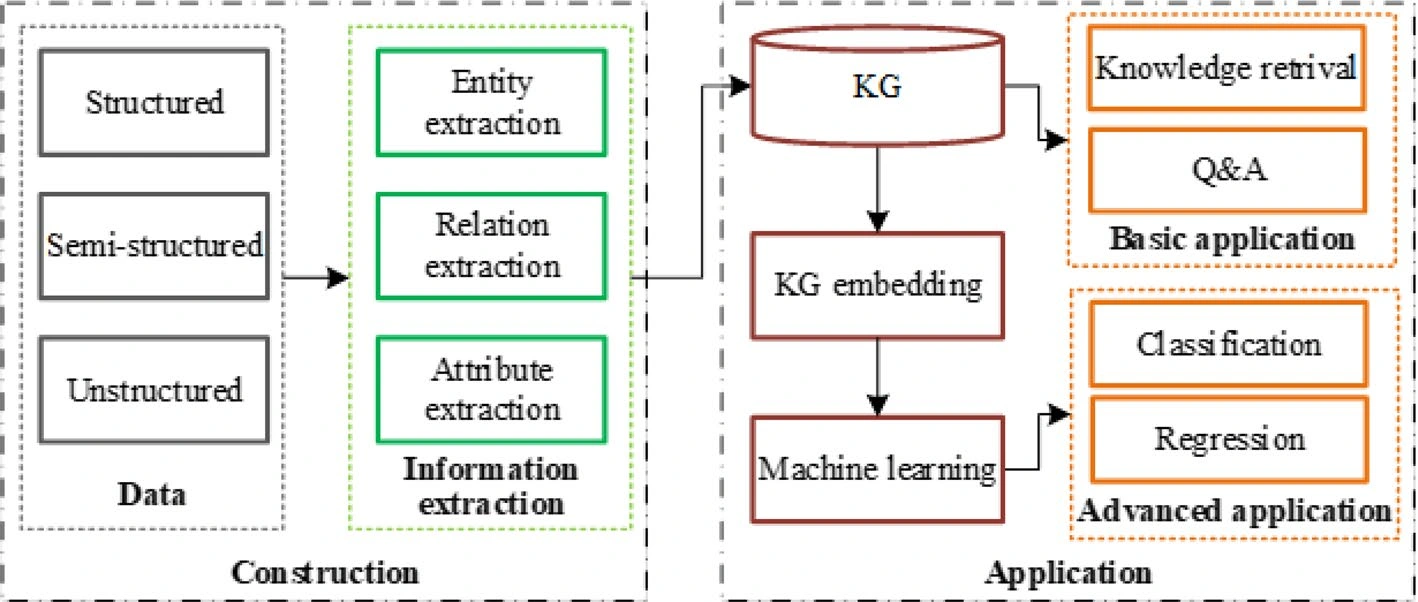
图 3|一张通用知识图谱从数据走到应用,要经过哪些箱子?
图中没有子图字母。左半是构建:结构化、半结构化和非结构化数据进入实体抽取、关系抽取和属性抽取。右半是应用:抽取出的信息进入知识图谱,再做知识图谱嵌入和机器学习。基础应用在图上画的是知识检索和问答;高级应用画的是分类和回归。正文还提到知识可视化、知识推理,以及预测一串带时间观测的轨迹规划。轨迹规划在这张流程图里没有单独的箱子。综述也没有找到轨迹规划类应用,分类应用则远多于回归。来源:原论文 Fig. 3。
因此后面的 MKG 被定义成若干张子图,每张对应一个时段。每张子图是四元组:地点、关系、地点、时段。例子是地点 A、工作、地点 B、07:30–09:30,表示该时段里 A 与 B 之间的出行最可能是工作。07:30–09:30 是定义里的例子。案例部分只说测试早高峰和平峰,没有给出这两个时段的钟点。
实体在公交场景里可以是车站、网格或兴趣点。关系是购物、工作、上学这类活动,而且不能从轨迹里直接看见,所以要在潜在空间里抽取。因为仍然遵守一条有向边的约束,边上放的是最可能的活动。作者也说,换成最不可能的活动,就会得到另一套子图。他们构建的是当前稳定运营状态下的图,不包含线网或运营变化后的自动更新。
两张矩阵怎样变成一张分时段的图?
个人轨迹被写成一串行程。每段行程有起点、出发时间、终点、到达时间。建图要做的事是:给定这些轨迹,抽出时段 p 内地点之间的隐藏关系,得到图 G。
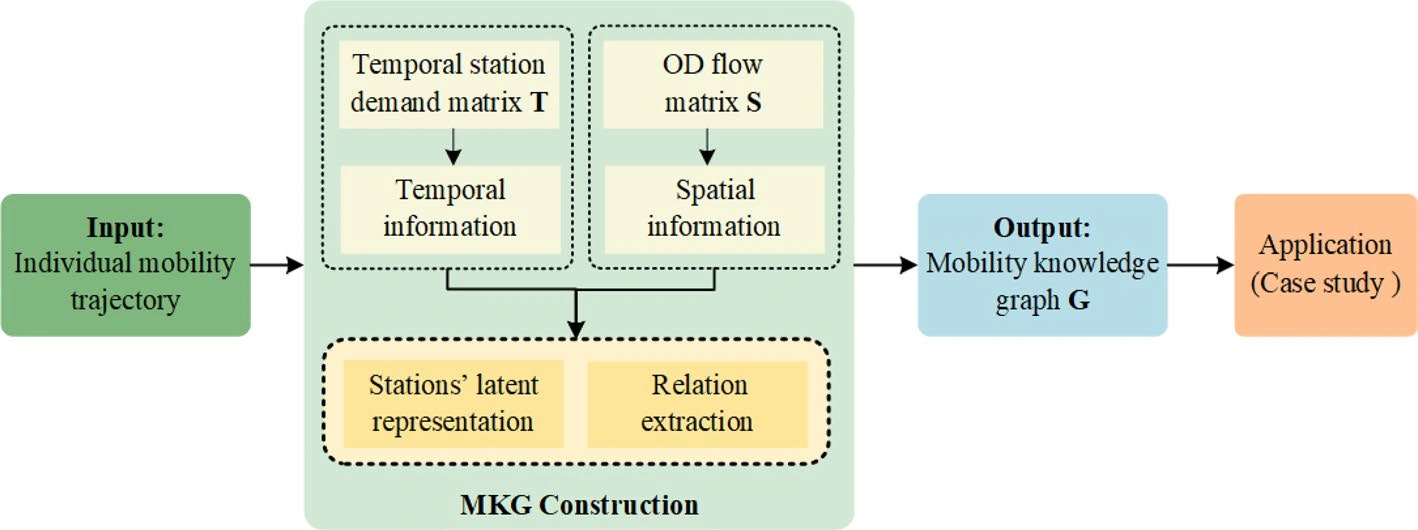
图 4|从刷卡轨迹到一张可用的图,中间拆成哪两块信息?
图中没有子图字母。输入是个人移动轨迹。轨迹被整理成两张矩阵:时间上的车站需求矩阵 T,以及起讫流量矩阵 S。T 提供各站随时间的到访特征,S 提供站与站的空间联系。两者进入车站潜在表示和关系抽取,输出移动性知识图谱 G,再交给案例里的下车站预测。来源:原论文 Fig. 4。
T 的尺寸是车站数 n 乘以时段 p 里的小时数 a。元素 Tᵢⱼ 是第 i 个车站在第 j 小时的到访次数。案例里 n 等于 90,a 没有单独给出。非负矩阵分解把 T 近似成 Vt 乘以 Q。Vt 的每一行是一个车站的时间潜向量,长度 kt;Q 把这些潜在特征还原到各个小时。
S 是 n 乘 n。元素是从起点到终点的到访量,而且是归一化之后的值,所以格子里的数不能读成原始乘客人次。平方矩阵分解把 S 近似成 Vs、对角矩阵 D、再乘 Vs 的转置。Vs 的行是车站的空间潜向量,长度 ks。D 表示潜在空间里的相互作用。
两个分解放进同一个目标:S 的重建误差、T 的重建误差,再加上 Vt、Vs、Q、D 的范数惩罚。惩罚的强度是正则系数 λ。案例网格搜索后取 kt = 5、ks = 5、λ = 0.01。时间特征和空间特征各 5 维,是后面规则法那张示意图里橙色 5 格、绿色 5 格的来历。
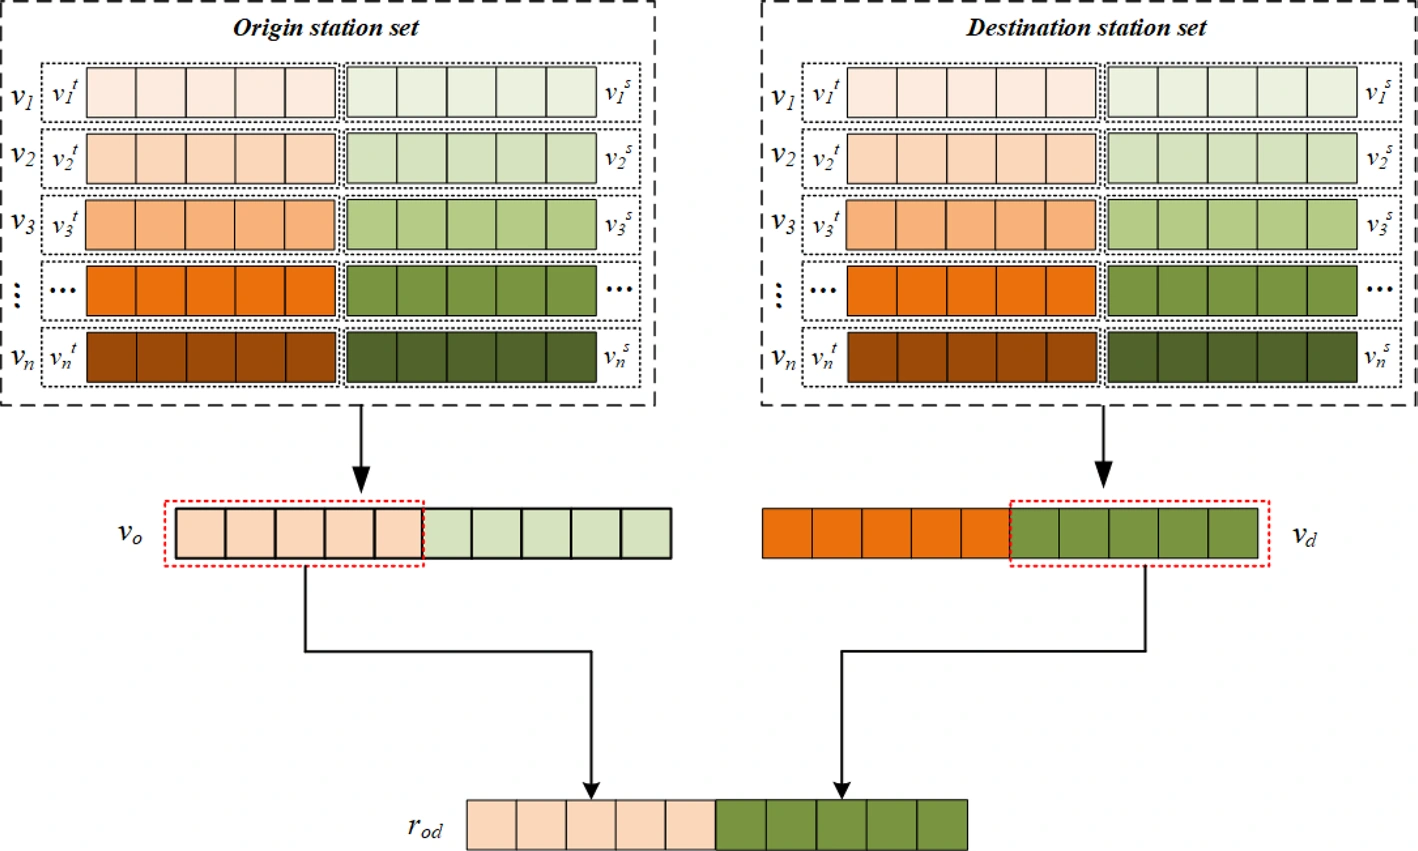
图 5|规则法怎样把两个车站拼成一条有向关系?
图中没有子图字母。上排左边是起点车站集合,右边是终点车站集合。每个车站向量左边暖色是时间潜向量,右边绿色是空间潜向量,各画了 5 格。下排选中一对起点 vo 和终点 vd 后,关系向量 rₒd 只取起点的时间段和终点的空间段,再左右拼接。它是两段特征的拼接,不是两个完整车站向量相加。来源:原论文 Fig. 5。
拼完以后还要用 k-means 把关系向量分成若干类,一类对应一种可再映射到语义的关系。聚类数被设成神经网络方法抽出的关系个数,所以两种方法的关系数是对齐后的,不是各自独立选出来的。规则法有一个结构问题:多个起点指向同一个终点时,这些边很容易落进不同的类。真实世界里它们可能是同一种活动。作者因此认为,拼接更适合一对一的关系,难以稳定得到多对一或一对多。
神经网络改成同时学习。车站的时空潜在矩阵 Vts 尺寸是 n 乘 kts,关系矩阵 Rts 尺寸是关系数 m 乘 kr。一条有向关系由索引向量 h 从 Rts 里取出。输入是起点向量、关系向量、终点向量横着拼在一起,前馈网络用 Sigmoid 隐藏层去拟合 S 里的非零流量。目标函数同时要求这张网络拟合起讫流量,并且 Vts 还能还原时间需求矩阵 T,再加上正则项。
这样比较的是两种分解能不能重建同一批站间流量,并留下可聚类或可索引的关系。它直接优化的是流量重建,下车站有没有排对是后一步。后一步用已经建好的图去约束候选站。
求解用梯度下降,对起讫矩阵的元素遍历一轮,复杂度写成 O(n²),n 是车站数。90 座车站对应的是一张 90 乘 90 的矩阵,不是 90 名乘客。网格搜索的范围是:潜特征数 5、10、15、20,隐藏神经元 10、20、30,学习率从 0.1 到 0.00001,λ 和收敛误差 ε 各为 0.1、0.01、0.001。选中的是 kts = 10、kr = 10、隐藏神经元 20、学习率 0.00001、λ = 0.01、ε = 0.01。这里的 10 是每条关系的特征长度 kr,以及车站时空向量的长度 kts。图 6 里的 30 个关系,是关系的个数 m。
在 90 座车站上,第一名离个人历史有多远?
预测任务给定出发时刻、起点站,以及个人历史活动,去给可能的下车站排序。候选站先按这些活动算条件概率,再用起点站在 MKG 里的活动分布把概率更新一遍。一个候选终点的分数,是活动概率乘以在该活动下到达这个终点的条件概率。三种模型是:
Stat_Group 按用户组统计。论文列出的分组特征包括家站、工作站、日均出行次数和到访车站数。预测依据是这一组的起讫转移概率。家站和工作站如何从刷卡里判定,正文没有给出操作定义。
MKG_Rule 用规则法建的图提供活动分布。MKG_NN 用同一套打分,图改由神经网络抽出。
参照上界用每个人自己的历史起讫转移概率。作者把它当作这项任务的上限:若只根据这个人过去去过哪里,最好的猜测就是这个人自己的目的地分布。它是个人历史统计。模型若用了个人历史之外的信息,仍可能在个别行程上不同。
命中率写成 Accuracy@TopM = m / N。N 是测试行程总数,m 是真实下车站出现在前 M 个候选里的行程数。M 取 1 到 5。论文用一个教学例子说明口径:假如共有 1000 次行程,其中 800 次的前两名包含真实终点,则前 2 名命中率为 0.8。1000 和 800 是例子,分母是这个假设里的行程数,不是香港实验的样本量和命中次数。实验的 N 没有报告。
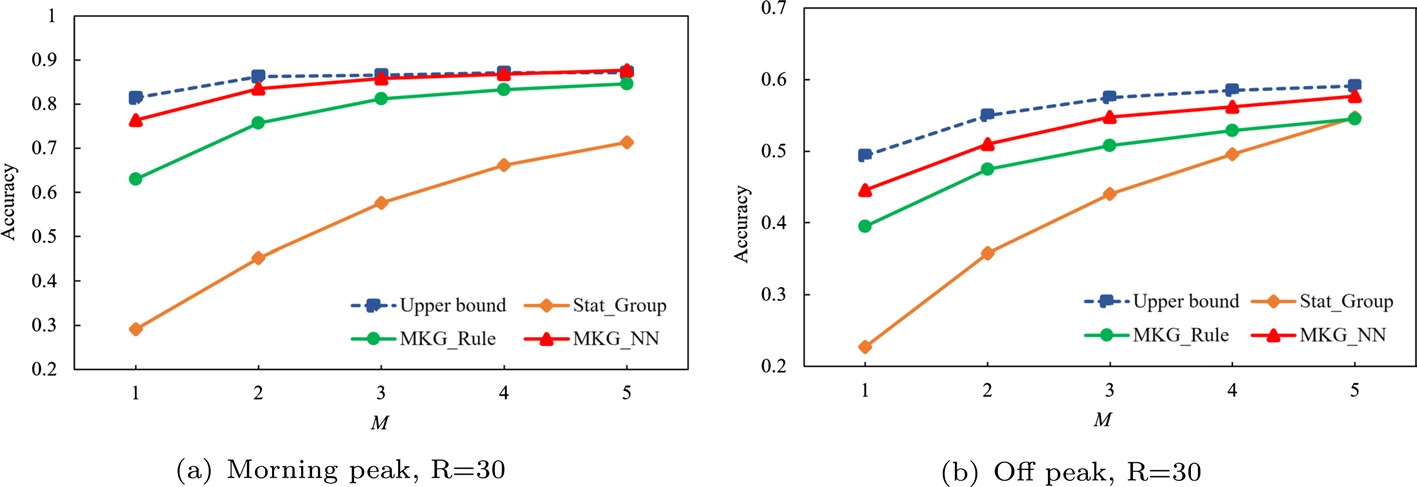
图 6|加上车站关系之后,真实下车站排进前几名的比例有多高?
图上没有数据标签。下面的数是按坐标刻度读标记中心、四舍五入到 0.01 的结果,读图误差大约 0.01。关系数都是 30。纵轴是 Accuracy@TopM,横轴是 M。蓝色虚线是个人历史参照,红色三角是 MKG_NN,绿色圆点是 MKG_Rule,橙色是 Stat_Group。分母都是该时段的测试行程。
(a)早高峰。纵轴大约从 0.2 到 1.0。M=1 时参照约 0.82,神经网络约 0.77,规则法约 0.63,用户组约 0.29。到 M=5,参照和神经网络都约 0.88,规则法约 0.85,用户组约 0.72。神经网络与参照的差距在第一名大约是 0.05,到第五名时两条线接近。参照从第二名起略高于神经网络,标记与虚线挤在大约 0.87 到 0.89。
(b)平峰。纵轴大约从 0.2 到 0.7,四条线都低于早高峰。M=1 时参照约 0.50,神经网络约 0.45,规则法约 0.40,用户组约 0.23。M=5 时参照约 0.59,神经网络约 0.58,规则法约 0.55,用户组升到与规则法几乎同一高度。
来源:原论文 Fig. 6。
按每 100 次测试行程来理解这些比例:早高峰第一名,用户组大约对 29 次,神经网络大约对 77 次,个人历史参照大约对 82 次。由于 N 未知,这仍是比例的说法,不能换成一个绝对行程数。
早高峰更高,是因为活动更集中。平峰活动更杂,四种方法一起变差,所以差距主要来自时段里的出行是否重复。用户组最低,作者的解释是相似用户访问过的车站被放进同一候选池,带入了大量无关站。这是对聚合噪声的解释,不是对每位乘客动机的测量。
神经网络高于规则法,与前面的结构判断一致:它同时拟合时间和空间。两种方法的关系数被对齐过,所以这张图比较的是抽取方式。30 个关系对两种方法是同一个 m,不是一个用了 30 类、另一个用了别的类数。
既有的下车站推断很多用行程链:只根据进站记录和一组事先定好的阈值规则去猜终点。因为真终点缺失,那些研究常报告推断率:进站记录里,有多大比例能套上作者事先写好的规则。推断率的分母是进站记录,分子是被规则接受的记录。本文的 m/N 则以测试行程为分母,分子是真实下车站进入前 M 名的行程。少数同时有上下车记录的研究,准确率在 60% 到 75%;用调查数据的大约 80%,但样本小。论文认为这些数字明显低于自己早高峰的图 6(a)。这句话指向整张子图,没有指定 M。图 6(a)里,神经网络从 M=1 的约 0.77 到 M=5 的约 0.88,高于 0.75;规则法在 M=1 约 0.63,落在 60%–75% 的区间内。这些文献用的城市、规则和样本都不同,所以这是作者引用后的对照,不是在同一批行程上重跑行程链。
关系分得更细,第一名还涨多少?
关系个数会改变下车站排序。作者以早高峰、M=1 为例,把关系数从 10 测到 60,步长 10。
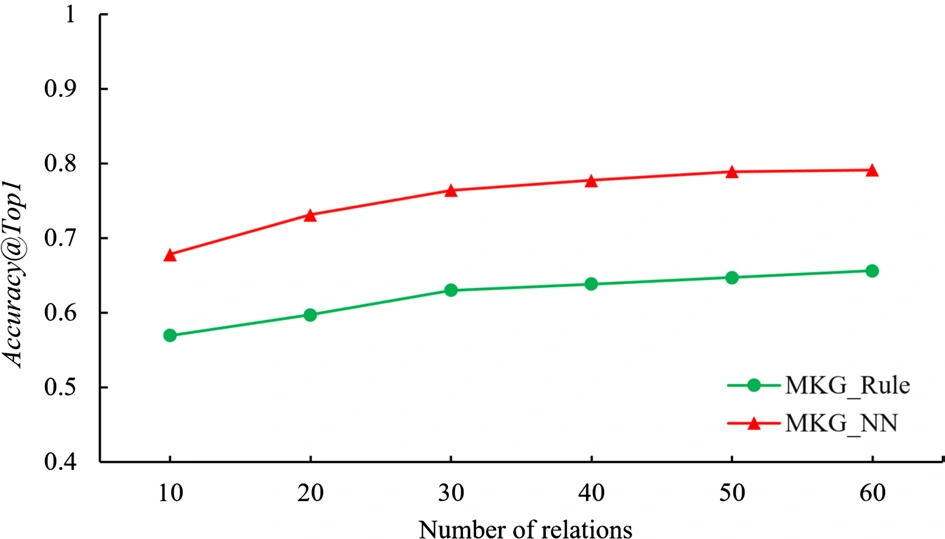
图 7|关系分得更细之后,第一名还会继续升高吗?
图中没有子图字母。只画早高峰的前 1 名。横轴是关系数,从 10 到 60,步长 10。纵轴是 Accuracy@Top1,大约从 0.4 到 1.0。红色三角是 MKG_NN,绿色圆点是 MKG_Rule。点上没有数字,下面按刻度读标记中心,四舍五入到 0.01。神经网络在 10、20、30、40、50、60 个关系时大约是 0.68、0.73、0.77、0.78、0.79、0.79;规则法大约是 0.57、0.60、0.63、0.64、0.65、0.66。30 个关系处的两个数,与图 6 早高峰 M=1 的约 0.77 和约 0.63 对得上。30 之后,神经网络大约再升 0.02,规则法大约再升 0.03,都小于从 10 个关系增到 30 个时的升幅。来源:原论文 Fig. 7。
因此 30 是这张早高峰、前 1 名曲线上收益变缓的位置。图 7 没有画平峰,也没有画前 5 名,这个变缓不能直接推广到所有时段和所有 M。
关系编号怎样对应上班或上学?
无监督学习得到的是 r1、r2、r3 这样的编号。编号本身没有上班或上学的含义。作者给了一条定性映射:先准备一组语义,如工作、上学和其他;再用家庭出行调查这类外部数据,看某些车站对的主要活动是什么;若编号图与调查图的模式对得上,就把编号换成语义,并更新整张图。兴趣点在起终点周围的分布,以及这些兴趣点在某时段的热度,也被提到可以充当外部证据,例子是地图平台。
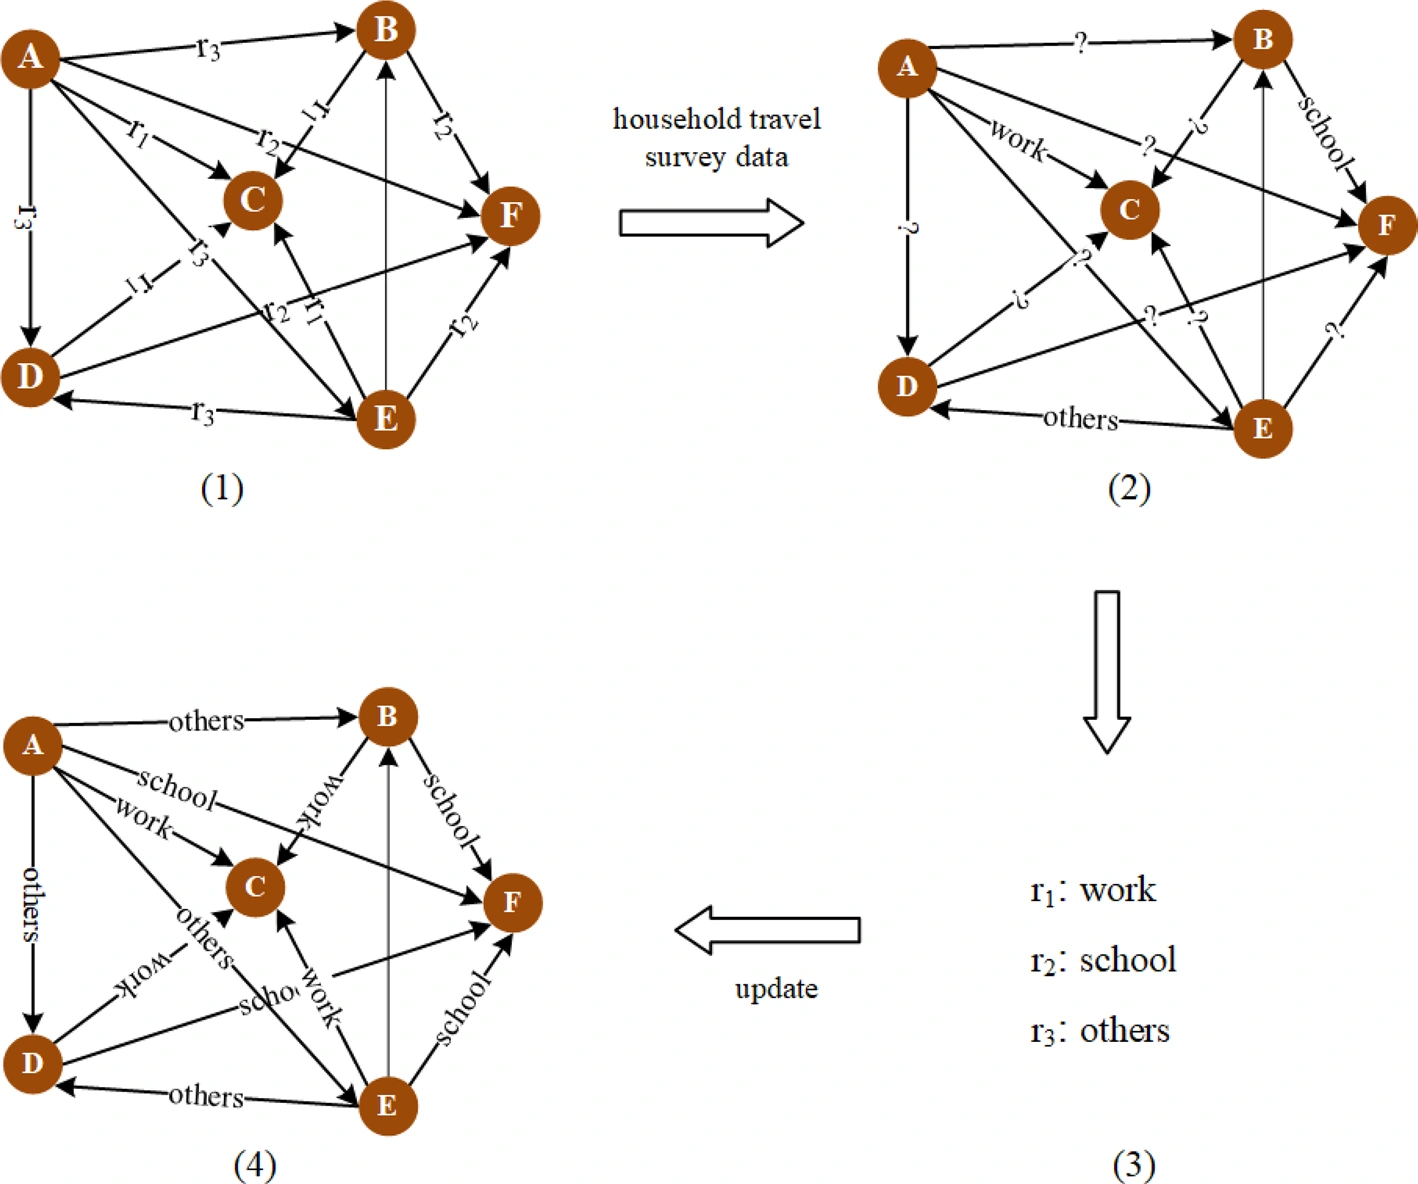
图 8|编号关系要经过哪些步骤,才变成人能读的活动?
(1)六个示意车站 A 到 F,边上是 r1、r2、r3。这是神经网络得到的数值关系,还没有语义。
(2)借助家庭出行调查,把部分边写成 work、school 或 others,对不上的边保留问号。正文举的例子是 A 与 C 之间主要是工作,B 与 F 之间主要是上学。
(3)对照前两步,得到 r1 对应 work,r2 对应 school,r3 对应 others。
(4)用这组对应更新全图,边上换成工作、上学或其他。
来源:原论文 Fig. 8。
A 到 F 是图里的示意节点。正文用可以揭示来写调查数据的作用,讨论部分又把系统化映射和用家庭出行调查做验证放进未来工作。因此图 8 说明的是映射程序,不是香港 90 座车站上已经核对完成的活动比例,也没有给出有多少条边被标成工作。
这组排序能用在只有进站记录的城市吗?
案例能算出命中率,是因为香港这套铁路卡同时记录了出站。模型在学习图和核对答案时都看得到终点。讨论里写到,斯德哥尔摩等地只有进站、没有出站,个人轨迹不完整,同一张卡建不出同样的 MKG。作者建议用同城的出租车轨迹或地理签到去推断地点关系,并写明这需要以后再检验。所以大约 0.77 和大约 0.82 描述的是两端都有记录的铁路系统上、3 月测试行程的排序。
预测输入里仍然包含个人历史活动。神经网络接近个人历史上界,说明这张图在这批重复出行上重组出了和个人历史相近的排序。一个没有历史的新乘客会得到怎样的第一名,这篇文章没有单独报告。用户组、规则法和神经网络都在重建聚合后的出行模式;上界才是个人目的地分布。四者都来自同一套观测刷卡,不能把命中率读成建了知识图谱就改变了乘客的目的地。
图本身还有几条作者已经写明的边界。每个时段只留最可能的一种活动,混合目的会被压成一条边。图对应稳定运营状态,不随中断、疫情或改线自动更新。早高峰和平峰的钟点、乘客人数、卡数和测试行程数 N 都没有在正文给出。数据需向通讯作者合理申请,文章里没有行程级附表。
作者在讨论里还提出一种解释:同一时段、同一起点、同一种活动的人,更可能去同一个终点;因此即使用户没有被观察到访问某站,图仍可能表示一种关注。这是对缺失访问的解释。论文没有单独测量关注或兴趣。精准营销、广告投放和个性化推荐被列为可能的下游用途,案例里实际跑完的是下车站排序。
一句话总结
在同时有进站和出站的香港城市铁路数据上,30 个关系的神经网络图把 3 月早高峰大约每 100 次测试行程里的 77 次真实下车站排到第一名,个人历史大约 82 次,相似用户组大约 29 次;只有进站记录的城市,这篇文章还没有给出同样的检验。
核心来源
Zhang, Q., Ma, Z., Zhang, P., & Jenelius, E. (2025). Mobility knowledge graph: review and its application in public transport. Transportation, 52, 1119–1145. https://doi.org/10.1007/s11116-023-10451-8
期刊页眉的卷期年份是 2025。DOI 印在首页,其中的 2023 对应 2023 年 12 月 8 日的在线发表,接收日是 2023 年 11 月 17 日。图 1 至图 8 均来自该文。案例数据为香港城市铁路公交卡,可向通讯作者合理申请。资助包括中国国家留学基金管理委员会项目 202006950007,以及 KTH 的 TRENoP 与 Digital Futures。
Qi Zhang,论文署名为瑞典皇家理工学院(KTH)土木与建筑工程系。文末介绍他获武汉理工大学交通信息工程及控制硕士,当时正在 KTH 交通规划方向攻读博士,研究兴趣包括个体移动、知识图谱、因果图发现和延误传播。本文中他参与选题、方法、数据、结果分析和初稿。
Zhenliang Ma,通讯作者,论文署名为 KTH 土木与建筑工程系。文末介绍他是 KTH 道路交通工程助理教授,研究方向是用统计、机器学习和计算方法,对公共交通与铁路等系统以及个人信息系统做建模、模拟、优化和控制。本文中他参与选题、方法、数据、结果分析和改稿。
Pengfei Zhang,论文署名为河南省科学院物理研究所。文末介绍他是该所助理研究员,2017 年获河海大学控制工程硕士,2021 年获华南理工大学交通信息工程及控制博士,2019 至 2020 年在美国东北大学 NU-MIT Transit Group 访问。研究兴趣包括交通中的深度学习、个体移动建模、计算机视觉和交通方式选择。本文中他参与选题、方法、数据收集和改稿。
Erik Jenelius,论文署名为 KTH 土木与建筑工程系。文末介绍他是交通规划方向教授,负责城市移动性小组,并担任 iMobility 实验室主任。研究兴趣包括数据驱动的交通与移动性管理、交通网络与韧性、公交规划与运营。本文中他参与结果分析和改稿。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
早高峰第一名从用户组的约 0.29 升到神经网络的约 0.77,差距大约是每 100 次测试行程里多对 48 次,读图误差大约 2 次。这个差距是在出站记录已经存在的铁路网上量到的。若一座只有进站记录的城市改用出租车轨迹来借地点关系,出租车的上下客点还要对齐到铁路站。对齐若错开一站,这 48 次里有一部分会在进模型之前丢掉。值得单独报告的是:地点匹配误差控制在一站、两站时,前 1 名还剩多少。论文只把这种跨数据源的检验留到了以后。
一条边只保留最可能的活动,也会改写后续名单。假使某对车站在早高峰同时有通勤和陪读,图上只会留下其中更可能的一种。向这条边推荐工作地点周边的服务,会漏掉同一时段的另一类出行。图 8 里的 others 把剩余活动收进一个桶,桶内的差别在后续推荐里仍然不可见。六成和四成只是这个反例里的假设,论文没有给出任何车站对的活动比例。
关系数在 30 之后,早高峰前 1 名只再上升大约 0.02 到 0.03。这是 2018 年 3 月、一张稳定铁路网上的现象。一次临时封站会同时改变到访矩阵 T 和起讫矩阵 S,而这篇方法明确不自动更新图。封站当日若仍用 2 月学到的 30 个关系,第一名会退到多靠近用户组,文章没有证据。下一个该报告的是测试行程数 N,并按事件日把命中率分开计算。