很少发生的活动,怎样对应主要城市的经济结果?
论文名片|Shenhao Wang、Yunhan Zheng、Guang Wang、Takahiro Yabe、Esteban Moro、Alex ‘Sandy’ Pentland,Infrequent activities predict economic outcomes in major American cities,Nature Cities,2024年4月,1:305–314,2024年3月15日在线发表。DOI:10.1038/s44284-024-00051-7。观察数据上的城市与普查区预测研究。Wang 与 Zheng 并列贡献,Wang 与 Moro 共同指导。
波士顿、芝加哥和迈阿密一天里数量最大的到达,多半是办公室和居住地。若一片普查区的经济状况跟着人流规模走,这几类最常见的访问就应该最能对上家庭收入和房产价值。
三座都市区的比较把这条直觉倒了过来。与普查区经济结果更对齐的,是次数少、日程也不规律、但仍能覆盖整座都市区的活动。摘要写,这些活动占全部访问的不到 2%,并对应经济结果超过 50% 的变异。比较的是一片普查区里许多家庭的收入中位数和房产价值。
先说结论
- 移动记录覆盖波士顿、芝加哥、迈阿密,时间为 2016 年 9 月 30 日至 2017 年 4 月 1 日。方法部分记为 560,000 名匿名用户、386,000 个场所、1.26 亿次访问、687 类活动;摘要写超过 560,000 名用户。分析单位是人口普查区(census tract),输出是该区的家庭收入中位数和房产价值。
- 只用活动时,弹性网络的交叉验证决定系数 R² 大多在 40%–60%;梯度提升在多数情形到 50%–70%。正文说多数情形高于 50%,点明的例外是迈阿密的简单线性模型。波士顿的例子里,预测收入时社会人口变量大约 55.8%、活动大约 48.1%;预测房产价值时活动大约 55.9%、社会人口变量 52.2%;两者合并后收入 61.5%、房产价值 60.4%。分母都是相应经济结果在普查区之间的变异。
- 摘要写这些有预测力的活动只占全部访问的不到 2%,并对应超过 50% 的变异。图 3b 的横轴是流动联系的累积占比,曲线在大约 2% 附近达到高位,对应收入和房产价值大约 40%–60% 的变异。波士顿房产价值的单变量散点里,全部访问 R² = 0.001,居住访问 R² = 0.019,法式餐厅访问 R² = 0.258。
- 时间规律性用另一套 R² 衡量:日历周期和趋势能解释多少日访问量变化。波士顿 2017 年 2–4 月,全部访问为 0.78,办公室为 0.86,法式餐厅为 0.47。把其他大城市识别出的前 20 类活动拿到新城市,平均解释 55.6% 的方差;前 10 类为 44.2%。这些都是预测对应,论文写明还没有分开因果方向。
这些数字属于哪一座城市、哪一片普查区?
人类移动性(human mobility)在这里指人在城市里到达不同场所。论文把自愿加入、已经匿名的定位记录汇总到普查区:一条连接从居住地所在的普查区出发,指向某一类场所所在的普查区。场所类别来自 Foursquare,细类 687 个,并归入 15 个父类。发表分析使用的是这张普查区网络,比较的是区与区的经济指标。
两个经济结果来自美国社区调查(American Community Survey,ACS)的普查区数据:家庭收入中位数,以及房产价值。正文把同一窗口的移动同时用来对应 2016 年的当期结果和 2018 年的后续结果。记录本身从 2016 年 9 月 30 日持续到 2017 年 4 月 1 日,论文仍把这半年标成 2016 年的输入。代表性对照使用的是 2012–2016 年五年期 ACS,参考文献另列 2015–2019 年五年期估计。2016 与 2018 年每一张表的版本,正文没有逐项展开。
样本大约占三座城市合计普查人口的 2.61%。分城市看,波士顿样本约占该市普查人口的 1.54%,芝加哥 3.82%,迈阿密 4.68%。这些百分比的分母是普查人口,不是访问次数。样本估计的人口与普查区人口的相关系数约为波士顿 0.7、芝加哥 0.66、迈阿密 0.58。收入和房产价值的分位数对照,正文只说整体上相当接近,没有给出一个汇总数字。报告摘要写,曾用事后分层校正用户样本的偏差;校正步骤在补充材料。
社会人口变量大约十项,正文举例包括教育、性别和种族构成。完整名单在补充材料。后面凡是把“活动”和“社会人口变量”并列,都是这两类普查区尺度的输入,输出仍是该区的收入中位数或房产价值。
两套模型各做 2 个经济结果、3 座城市、2 个年份,一共 24 组。弹性网络(elastic net)在预测误差之外,同时惩罚系数的绝对值和系数的平方,从而在 687 类活动里把一部分系数收缩到零。梯度提升回归(gradient boosting regression,GBR)用多棵决策树拟合非线性关系,报告的是重要性而不是带正负号的系数。超参数在训练集上用五折交叉验证选择。结果部分把弹性网络的成绩称为交叉验证 R²。
对普查区 i 和活动 c,线性模型先看从 i 连到其他普查区的访问次数是否达到一个量级阈值,达到才保留这条边,再把这些边相加。这个和是该区在这类活动上的连接数,论文称为节点度(node degree)。687 类连接数分别乘上系数后相加,用来预测 i 的经济结果。阈值的具体数字写在补充信息里,正文没有印出。因此,回归里的“活动”是超过阈值的连接有多少,和图里直接画出的访问次数是两种口径。
活动次数相差有多大?
687 类活动的总访问次数差得很远。六个月里,办公室访问 5,594,655 次,在 687 类中排第 1;法式餐厅 65,534 次,排第 267。前者大约是后者的 85.4 倍(5,594,655 ÷ 65,534)。这是三座城市、六个月数据里该类活动的总次数。
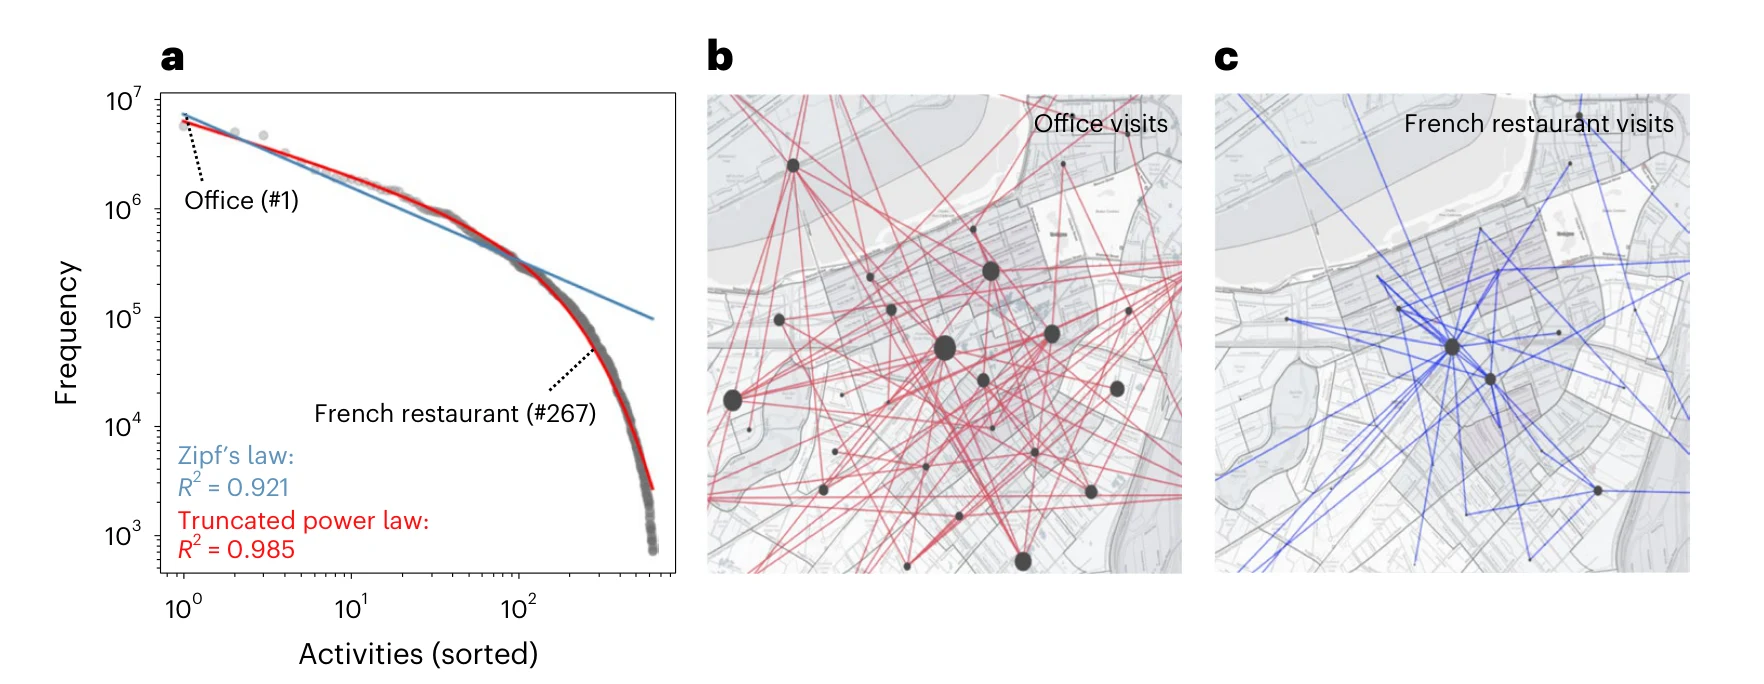
图 1|城市里的活动次数,从最常见到较少见差多少?
(a)横轴是按次数排序后的活动名次,纵轴是访问次数,两轴都是对数。灰点为 687 类活动。蓝色齐夫定律(Zipf’s law)只有幂次衰减,拟合 R² = 0.921;红色截断幂律(truncated power law)在名次靠后的尾部再加指数衰减,R² = 0.985。这两个 R² 的分母是活动次数分布的变异,不是收入或房产价值。办公室标在第 1 位附近,法式餐厅标在第 267 位附近。(b)办公室访问的空间网络,连线多而分散,作为常见、规律活动的例子。(c)法式餐厅访问的网络更集中,作为较少见、不规则活动的例子。图注没有标明两张地图各是哪一座城市,也没有定义点的大小。来源:原论文 Fig. 1。
次数能被一条长尾曲线描述,只说明常见活动占掉绝大部分访问。它还没有回答:经济结果的差异落在这条曲线的哪一段。
活动构成能对应多少经济差异?
只用活动、只用社会人口变量、以及把两者合并,是三套对照。弹性网络在三座城市、两种经济结果、当期和未来一共 12 组里,只用活动的交叉验证 R² 大多落在 40%–60%。梯度提升把多数组进一步提高到 50%–70%,该范围是正文对补充材料的概括,图 2 的柱状图本身只画弹性网络。正文写,多数情形高于 50%,例外是用简单线性模型预测迈阿密。波士顿和芝加哥高于迈阿密;论文把这和密集城区、铺展城区的差别放在一起讨论,但没有单独检验密度是不是原因。
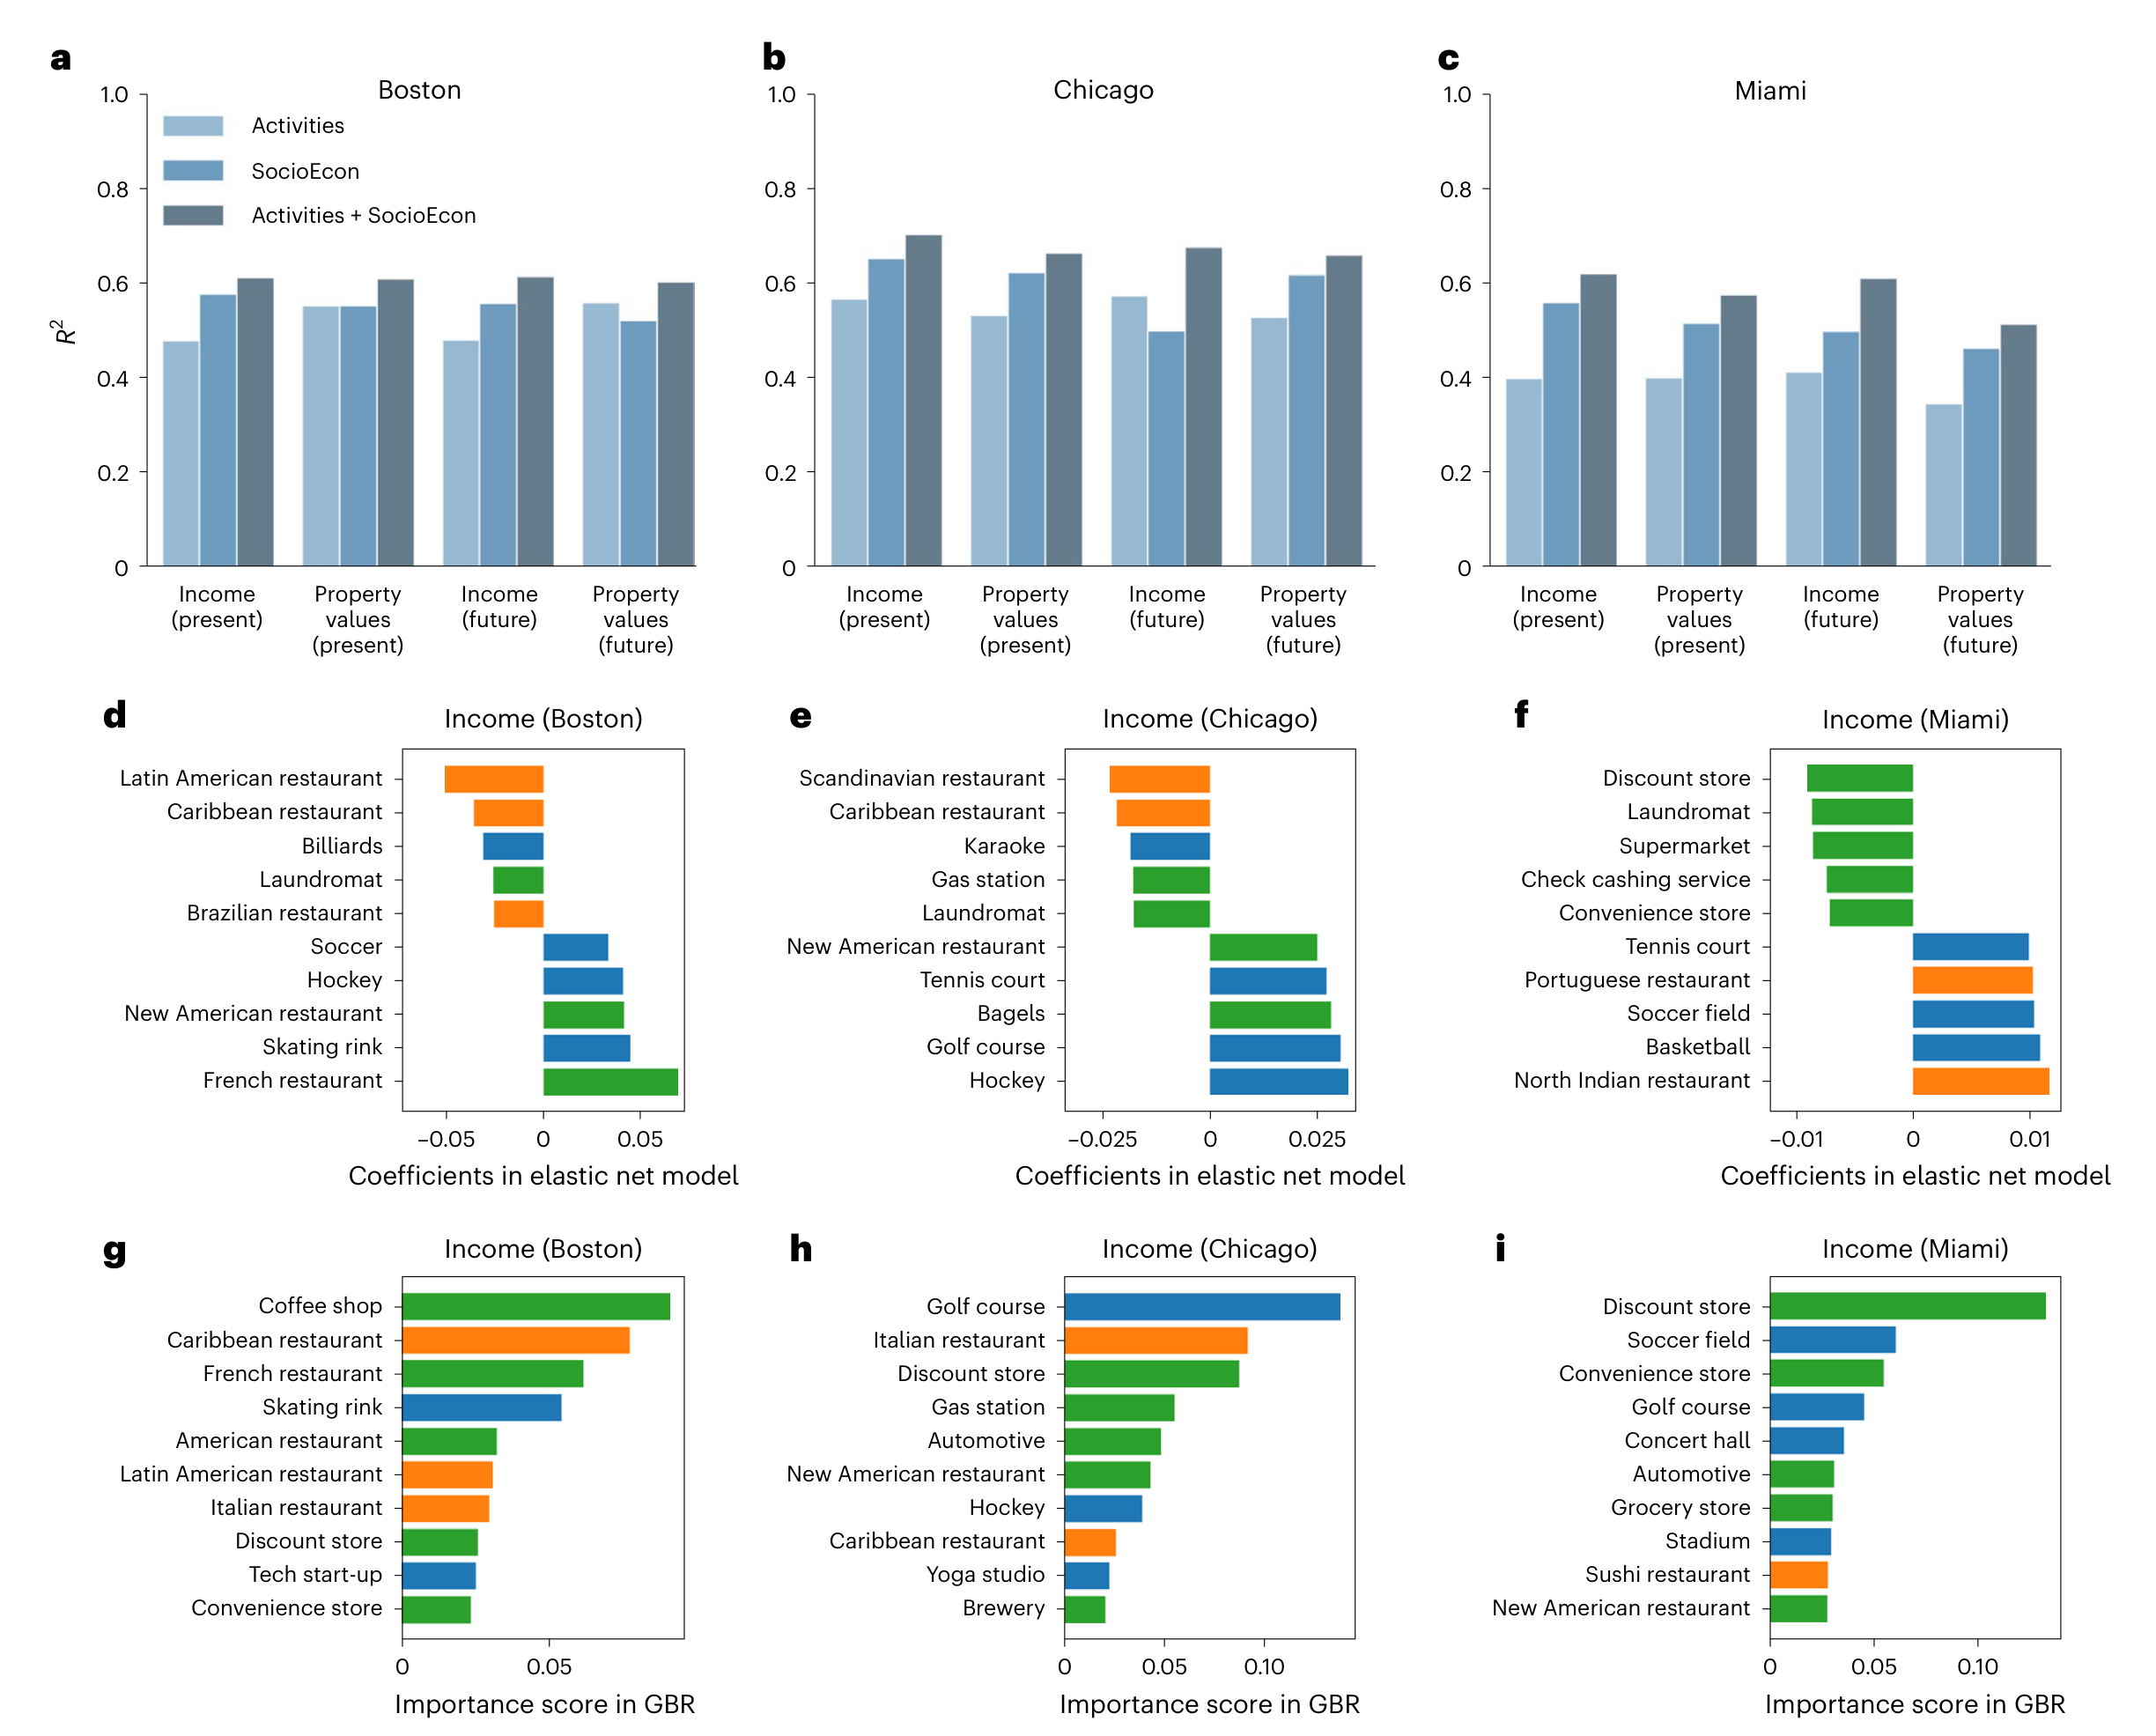
图 2|普查区的活动构成,能对应多少收入和房产价值差异?
(a)波士顿、(b)芝加哥、(c)迈阿密的弹性网络。每组三根柱依次是只用活动、只用社会人口变量、两者合并;四组成簇的结果依次是当期收入、当期房产价值、未来收入、未来房产价值。纵轴 R² 从 0 到 1,分母是该城市、该经济结果在普查区之间的变异。合并模型高于单独使用任一类输入。(d)波士顿、(e)芝加哥、(f)迈阿密,收入模型里弹性网络系数较大的活动。横轴是系数,三座城市的刻度大约分别为 −0.05 到 0.05、−0.025 到 0.025、−0.01 到 0.01,系数绝对值不能跨城市直接比较。蓝色、绿色、橙色是论文为阅读加上的三类标签。(g)波士顿、(h)芝加哥、(i)迈阿密,收入模型里梯度提升的重要性。重要性从 0 向右增大,波士顿刻度到 0.05,芝加哥和迈阿密到 0.10;这里没有正负方向。来源:原论文 Fig. 2。
正文给出的波士顿例子是:预测收入时,社会人口变量大约 55.8%,只用活动大约 48.1%;预测房产价值时,只用活动大约 55.9%,社会人口变量为 52.2%。合并后,收入 61.5%,房产价值 60.4%。正文没有把这六个百分数逐一标到“当期”或“未来”的某一根柱上。梯度提升在合并输入后,波士顿和芝加哥大约到 70%–80%,同样是正文对补充结果的概括。
两类输入合并后始终更高,说明活动网络里有一部分与普查问卷并列、而问卷没有直接问到的差异。论文把这一成绩和以往研究里大约 0.40–0.46、有时低至 0.25 的 R² 相比,并称至少提高 20%。那是跨研究、跨指标的文献比较,不是在这三座城市的同一批普查区上,对着同一个旧模型算出的提高。
哪些活动进入了模型,方向是否相同?
弹性网络给出方向,梯度提升给出重要性,两份名单并不相同。图 2d–i 画的是收入模型里靠前的活动,不是房产价值模型的另一套排名。
论文用三种颜色帮助阅读,并写明这三类既不互斥,也不覆盖全部活动。蓝色是需要额外体力或脑力的活动,例子有网球、冰球。绿色是非必需消费,例子有法式餐厅;折扣店也被画进这一组。橙色是论文所称的潜在社会经济线索,例子有拉丁美洲餐厅和加勒比餐厅。正文还写到,巴西、加勒比、西班牙和北印度等餐厅类别同样有预测力;讨论认为,在波士顿和迈阿密,亚裔、西裔内部的细分比总的族裔分组更能对应经济结果,依据是预测模型里的显著系数。这是对普查区系数的解读,正文没有印出标准误。
方向在城市内部就不一致。波士顿收入的弹性网络里,拉丁美洲餐厅、加勒比餐厅和巴西餐厅在负侧,足球、冰球、新式美国餐厅、溜冰场和法式餐厅在正侧。芝加哥收入模型里,斯堪的纳维亚餐厅、加勒比餐厅、卡拉 OK、加油站和自助洗衣店在负侧,新式美国餐厅、网球场、贝果店、高尔夫球场和冰球在正侧。迈阿密收入模型里,折扣店、自助洗衣店、超市、支票兑现服务和便利店在负侧,网球场、葡萄牙餐厅、足球场、篮球和北印度餐厅在正侧。负系数只表示在这个线性模型里,该类连接较多的普查区对应较低的收入拟合值。它没有证明这类场所把收入拉低,也没有证明相反的方向。
梯度提升的重要性不分方向。波士顿靠前的包括咖啡馆、加勒比餐厅和法式餐厅,芝加哥靠前的包括高尔夫球场,迈阿密靠前的包括折扣店。同一类活动可以在一座城市的系数图里出现,在另一座城市的重要性图里位置不同。弹性网络还会把单个系数向零收缩,论文因此提醒,单个系数不适合当成精确效应;他们更看重预测是否稳,而不是逐个系数的大小。
有对应关系的活动有多常见?
图 2 只列出靠前的活动,还没有把它们放回次数分布。图 3a 用每个活动与每种经济结果的皮尔逊相关系数绝对值衡量单独对应强度。最常见的活动,包括办公室和居住地,相关系数小于 0.2。法式餐厅、高尔夫球场等最有预测力的活动大于 0.4。横轴是次数的对数。论文据此说,有预测力的活动大体比最常见的活动少四个数量级,大约是一万分之一。这个倍数是对整张对数图的概括,比较的是预测力较高的活动与最常见活动。办公室与法式餐厅相差约 85.4 倍,用的是六个月总次数,法式餐厅只排第 267。
最稀少的活动也不是最有预测力的。它们覆盖不到一整座都市区的普查区,就很难对应所有区的经济结果。图中的蓝线连接各次数段里预测力较高的前 5% 活动,平滑后呈凹形:比每日例行活动少得多、但仍有足够空间覆盖的那些活动,单独相关系数更高。
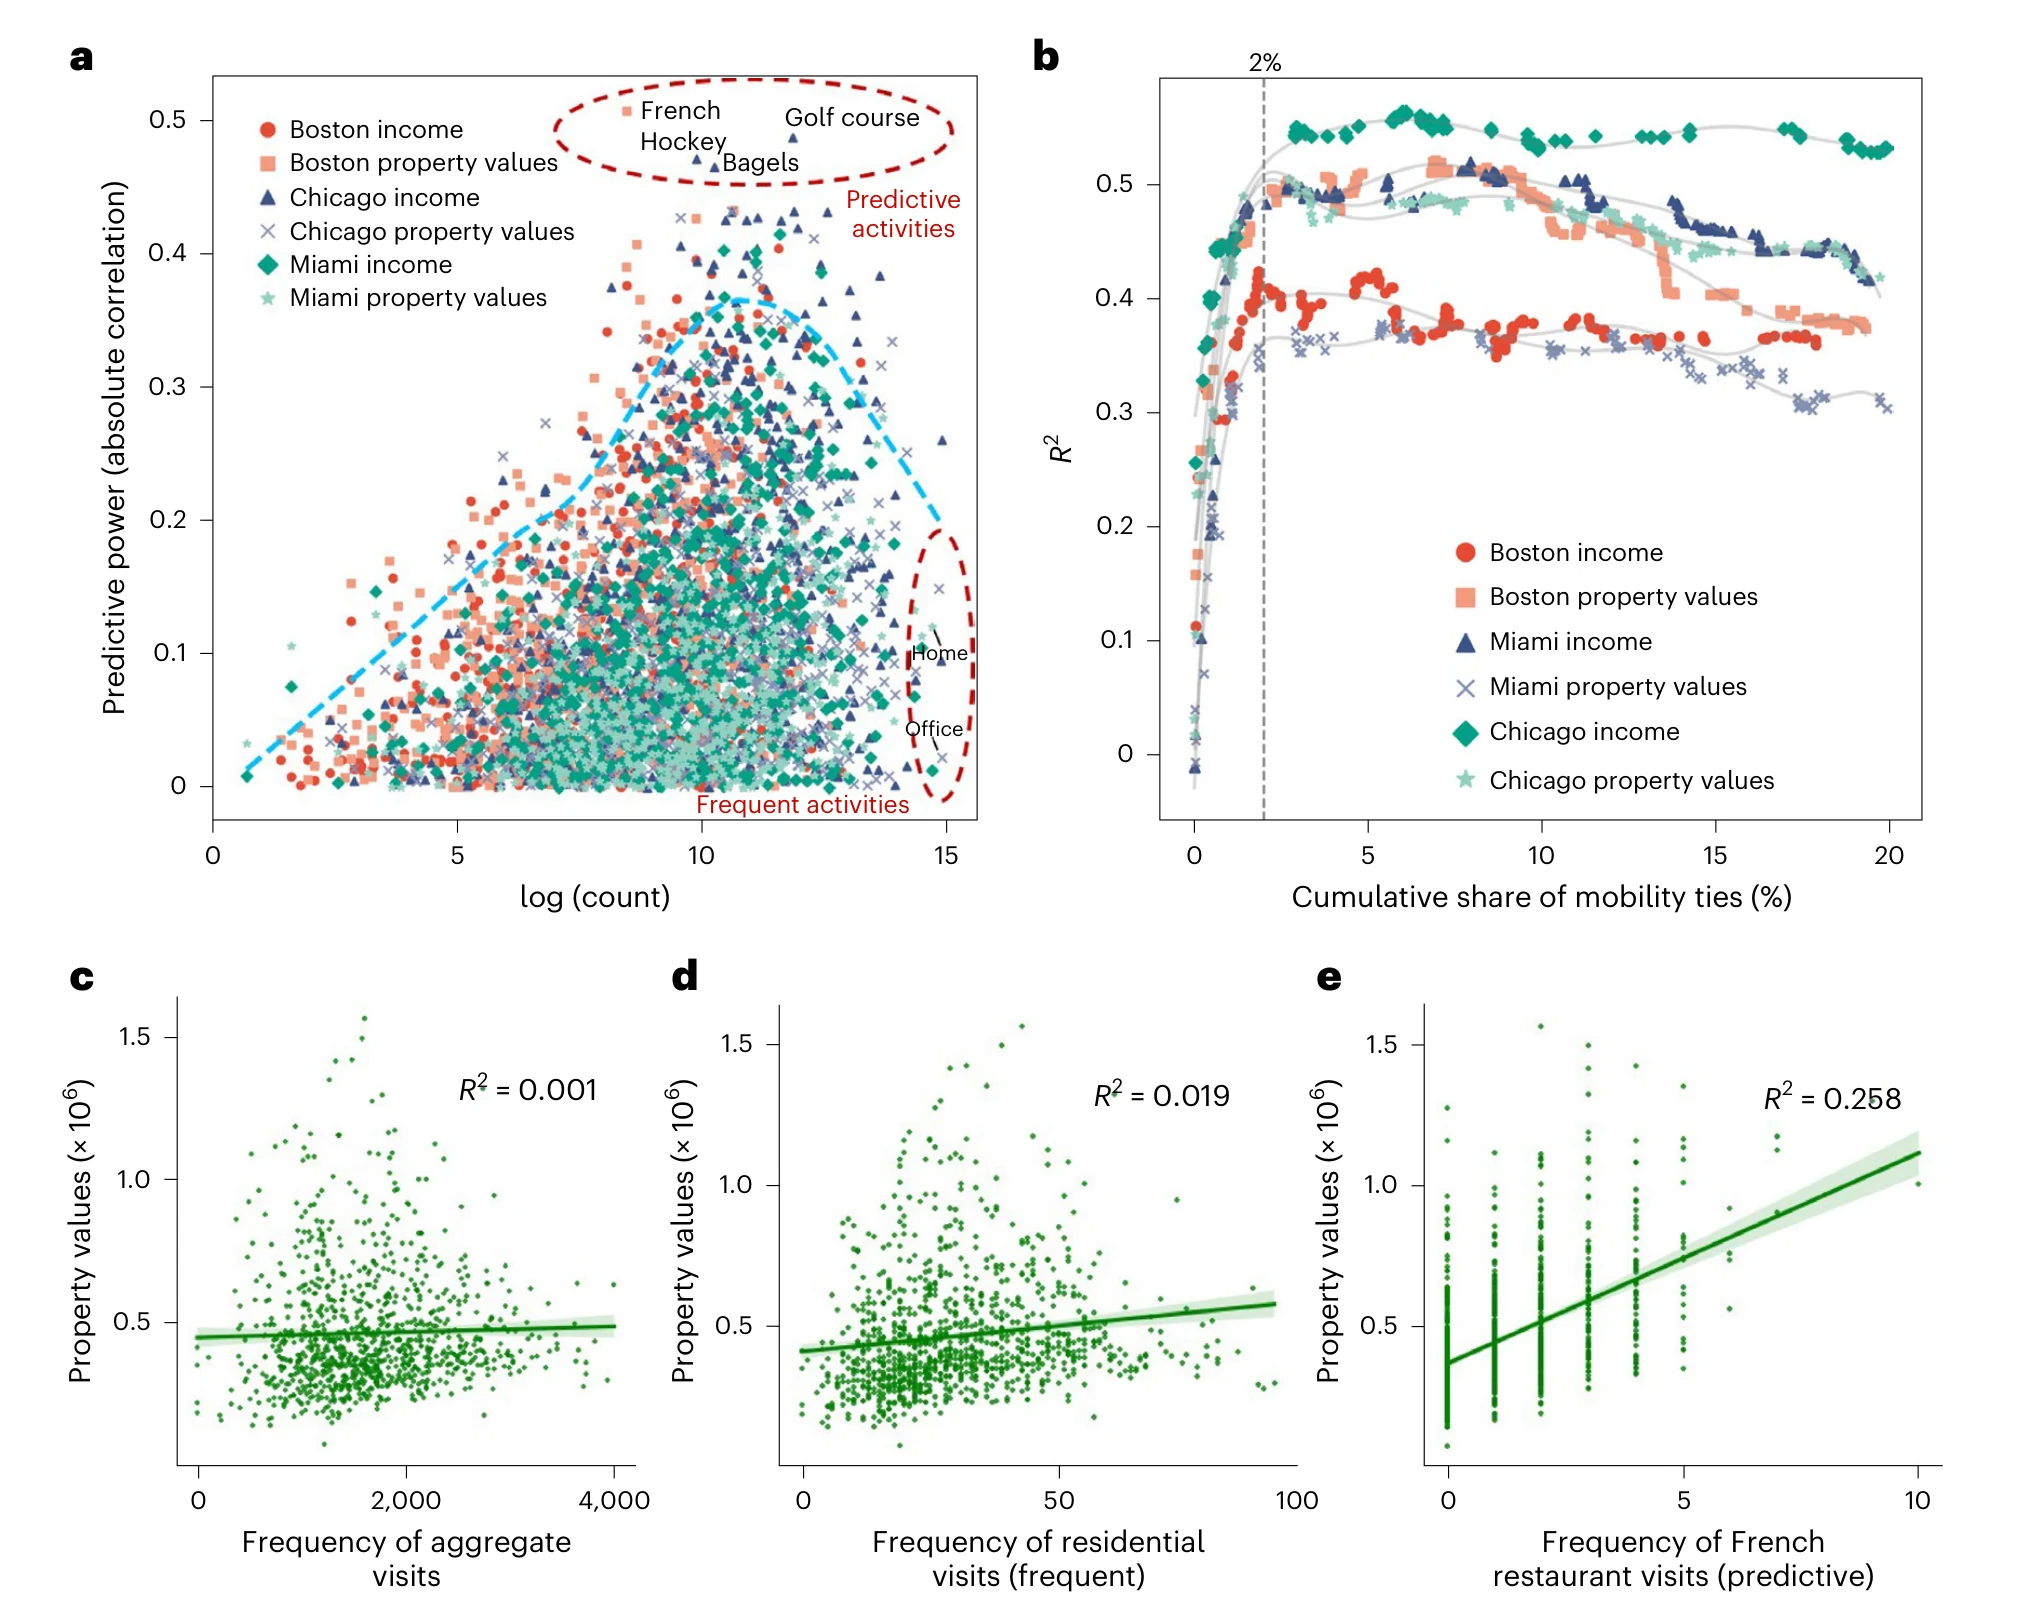
图 3|和收入、房产价值对齐的活动,落在次数分布的哪一段?
(a)纵轴是活动与经济结果的相关系数绝对值,横轴是访问次数的对数,刻度为 0、5、10、15。六种符号对应三座城市的收入或房产价值。右侧红圈标出居住地和办公室等常见活动,上方红圈标出法式餐厅、冰球、贝果和高尔夫球场等预测力较高的活动。蓝线是各段预测力前 5% 的平滑曲线。(b)弹性网络里,按预测力从高到低累加活动后的 R²。横轴是流动联系的累积占比,虚线标在 2%;纵轴 R² 的分母仍是收入或房产价值的变异。六条曲线对应三座城市的两个经济结果,在 2% 附近进入高位,其后并不重合。(c)波士顿普查区的房产价值对全部访问次数,横轴刻度到 4,000,R² = 0.001。(d)对居住访问,横轴刻度到 100,R² = 0.019。(e)对法式餐厅访问,横轴刻度到 10,R² = 0.258。纵轴是房产价值,单位为百万美元,刻度标到 1.5。直线是拟合线,色带是 95% 置信带。来源:原论文 Fig. 3。
图 3b 把活动按预测力累加进弹性网络。六条曲线在横轴靠近 0 时迅速上升,并在流动联系累积大约 2% 处达到高位,对应收入和房产价值大约 40%–60% 的变异;再继续加入,论文概括为预测表现会下降。图注把这个位置写成大约 2% 的活动,正文同一段又用累积流动模式的占比来描述这一个 2%。摘要则说有预测力的活动占全部访问的不到 2%,并对应超过 50% 的变异。活动种类、访问次数和流动联系是三个分母。摘要里的“超过 50%”接近全文多数模型的成绩;图 3b 写的 40%–60% 是这条累积曲线的高位,其中包含低于 50% 的情形。
波士顿房产价值的三张散点把同一对照收成一个城市、一个结果。全部访问 R² = 0.001,大约只对应 0.1% 的房产价值变异;居住访问 R² = 0.019,大约 1.9%;法式餐厅单独 R² = 0.258,即 25.8%。前两个接近一条平线,只说明这条直线几乎没有拟合到差异,不是证明完全没有别的关系。第三张的拟合线向上,横轴刻度只到 10。正文说这大约是每天十次;轴题本身只写访问频率,没有再印“每个普查区”或“每天”。与网络定义一致的读法是:点是波士顿的普查区,横轴是与该区相关的这类访问次数。25.8% 是这一类活动的单变量拟合,不是 687 类一起的模型,也不能换成“修建法式餐厅就会抬高房价”。
少见的活动,在日历上也不规律吗?
次数少,还可以再问时间上是否稳定。论文用每天的访问序列做时间序列回归:一条三次趋势,加上星期几、月内第几周和月份的周期项。这个 R² 的分母是日访问量的起伏,不是收入。线性趋势和二次趋势的结果与三次趋势差别不大,周期项比趋势的具体形状更要紧;另外两种趋势的细节在补充材料。
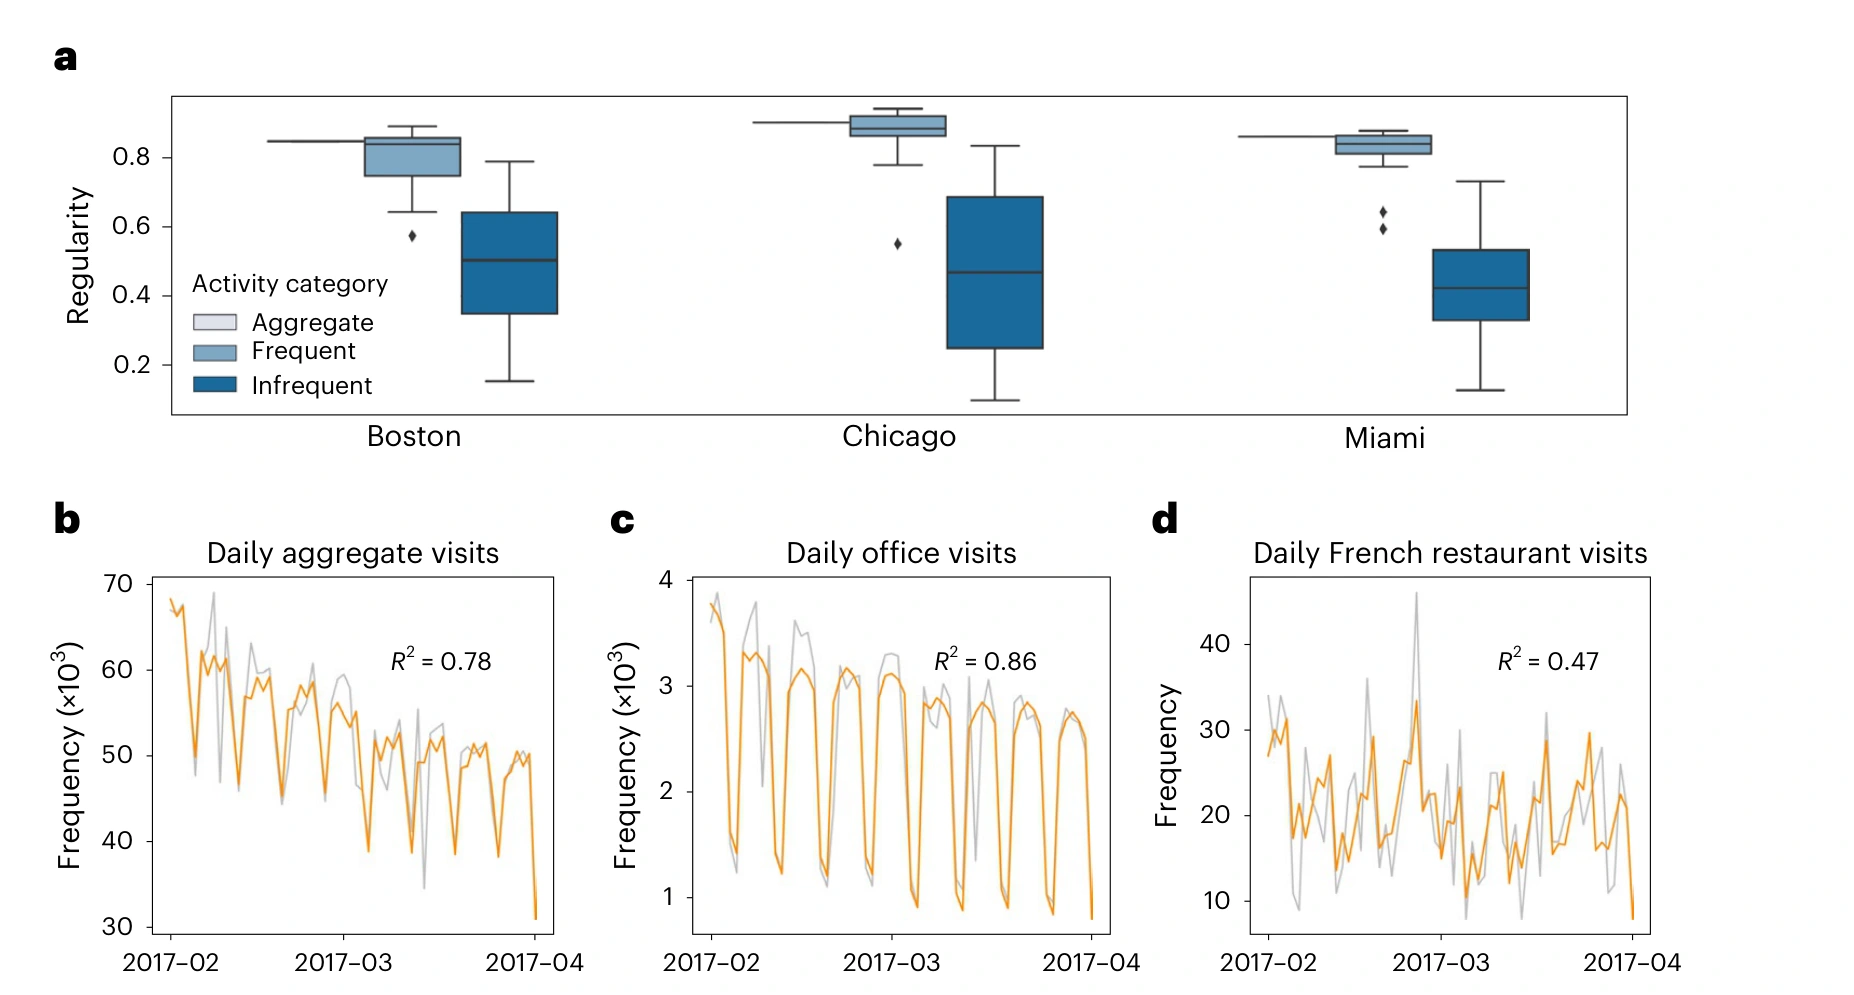
图 4|有经济对应的活动,日访问量是否更不规律?
(a)波士顿、芝加哥、迈阿密的时间规律性。浅色为全部访问合计,中蓝为常见活动,深蓝为不常见活动;图中第三组的标签是 Infrequent,正文把它作为有预测力的那一组。箱子中线是中位数,箱边是上下四分位数,须线延伸到 1.5 倍四分位距。常见活动每座城市 20 类;不常见活动波士顿 26 类、芝加哥 21 类、迈阿密 23 类。合计活动没有单独给出类数。(b)波士顿 2017 年 2–4 月的每日全部访问,纵轴为次数除以 1,000,刻度约 30–70,即大约每天 3 万到 7 万次,R² = 0.78。(c)每日办公室访问,纵轴同样除以 1,000,刻度约 1–4,R² = 0.86,工作日和周末的起伏清楚。(d)每日法式餐厅访问,纵轴是次数本身,刻度约 10–40,R² = 0.47。灰线是观测,橙线是趋势加周期的拟合。来源:原论文 Fig. 4。
三座城市里,不常见活动的规律性都低于合计和常见活动。论文的概括是:合计与常见活动大约 80% 的日变化能被趋势和周期拟合,有预测力的活动不到 50%。箱线图的须线上下都有延伸,这个“不到 50%”是一组活动的总体描述,不是每一类都不超过 0.5。波士顿的三个例子把差距落到具体序列上:全部访问 0.78,办公室 0.86,法式餐厅 0.47。办公室之所以规律,是因为工作日明显高于周末。法式餐厅仍有一些季节起伏,但同一套日历项只能拟合不到一半的日变化。图中只画了 2017 年 2 月至 4 月的波士顿,不是六个月、三座城市的全部天数。
换城市、加噪声、合成大类之后还在吗?
正文用四项检验看这个对应是否只在一种设定里出现,具体图表都放在补充材料,正文保留了结论和一部分数字。
第一项给经济结果加上方差为其原方差 10% 的高斯噪声,随机去掉 10% 的轨迹数据,并删去上下界以外的离群点。正文说 R² 和有预测力的活动仍然高度稳定,没有列出扰动之后的新 R²。
第二项在波士顿、芝加哥、迈阿密之外加入华盛顿特区、底特律和费城。用来自其他城市的前 20 类活动,平均能解释 55.6% 的方差;前 10 类平均 44.2%。正文没有在这里写明这是收入、房产价值还是二者合在一起,也没有给出每一座城市的单独数字。
第三项把不常见活动与最常见活动对比。弹性网络选出变量后,再用普通最小二乘计算对数似然。似然比检验拒绝“不常见活动并不更好”的原假设。检验统计量正文没有列出。
第四项把 687 个细类合成 15 个父类。父类仍能达到大约 25%–50% 的 R²,正文认为这是流动网络对经济结果的一个保守估计,并且明显低于那些不常见细类的表现。两个区间在边界上可以重叠,所以“明显低于”是论文对这组比较的判断,不是从 25% 直接减到某一个细类数字。父类里,相对不那么常见的体育和艺术/博物馆更有预测力。15 个父类的名称和系数表在补充材料。
对应关系停在哪一步?
这些模型生成的是可继续检验的假说。进取型活动可能对应更高的社会经济状况,因为它们和创业、承担风险有关;相反的因果同样没有被排除。法式餐厅、新式美国餐厅这类高端消费更像经济状况的结果,论文认为它们不像高收入的原因。弹性网络和梯度提升都可能漏掉变量,也可能把因果方向做反,单个系数因此会偏。论文写明,需要实验和因果模型才能再往前走。
适用范围也停在较大的美国都市区。较穷的地区和乡村没有纳入转移检验。普拉提、瑜伽馆这类信号强的活动,往往只出现在相对富裕的地方。当铺虽然对应较低的社会经济状况,它的存在本身已经意味着当地有基本的金融服务。没有这类场所的地方,不一定重复同一套活动与经济的对应。疫情、衰退和政策变化可以同时推动移动和经济,本研究没有把这些因素单独放进模型。数据窗口是 2016–2017 年,文中把疫情当作政策需要及时信号的例子,不是这套数据已经检验过的事件。
各市样本大约只占该市普查人口的 1.54%–4.68%,和普查人口的相关是中等偏高。2018 年的“未来”预测使用的仍是 2016–2017 年这同一套活动构成,它可以反映经济地理的持续性,不能单独证明 2016 年的访问改变了 2018 年的收入。连接数和原始访问次数也不是同一个量。父类、细类、单变量散点和多活动模型的 R²,分母都要看当时的经济结果,不能和日历规律性的 R² 放进同一个百分比。
一句话总结
在波士顿、芝加哥和迈阿密,普查区之间的收入与房产价值差异,更对应那些次数少、日程不规律、但仍覆盖都市区的活动;最常见的办公室和居住地访问几乎对不上这些差异,而这种对应还没有被证明为因果关系。
核心来源
- Nature Cities 正式发表页面,核对题目、作者、在线发表日期与正文图 1–4。补充材料由期刊在线提供,正文引用其中的数据处理和稳健性检验。
- 移动数据来自 Cuebiq 的 Data for Good 项目,许可范围内使用,不公开发布。申请说明见 Cuebiq Data for Good。场所与活动类别经由 Foursquare 的 Public Search API。
- 普查数据与分析代码的公开入口为 economic_growth_usa。代码公开不等于原始定位记录公开。
作者介绍
六位作者的单位和分工以论文署名、脚注和贡献说明为准。
- Shenhao Wang:佛罗里达大学城市与区域规划系,麻省理工学院媒体实验室。与 Yunhan Zheng 并列贡献,与 Esteban Moro 共同指导,也是通讯作者。贡献说明中,他参与概念、方法与实验、撰写初稿、整理数据、可视化,并与 Alex ‘Sandy’ Pentland 共同监督和管理项目。
- Yunhan Zheng:麻省理工学院土木与环境工程系。并列贡献。参与方法与实验、数据整理、可视化和修改。
- Guang Wang:麻省理工学院数据、系统与社会研究所,佛罗里达州立大学计算机系。参与概念和修改。
- Takahiro Yabe:麻省理工学院数据、系统与社会研究所,纽约大学坦登工程学院。参与概念和修改。
- Esteban Moro:麻省理工学院媒体实验室与数据、系统与社会研究所,东北大学网络科学研究所。脚注中与 Shenhao Wang 共同指导,也是通讯作者。参与概念和数据整理。
- Alex ‘Sandy’ Pentland:麻省理工学院媒体实验室与数据、系统与社会研究所。参与概念,并与 Shenhao Wang 共同监督和管理项目。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一座城市只用最繁忙的办公室和居住地访问做成一个总流量指标,波士顿房产价值的散点已经给出 R² = 0.001;法式餐厅这一类单独对应 25.8%,用的却是横轴只到 10 的少见访问。值得单独做的检验是:把 2016–2017 年在一座城市选出的短名单冻结,换到下一次独立发布的社区调查,并要求这些场所在两次调查之间有开业和关闭,短名单还能不能对应普查区收入。论文的 2018 年结果使用的仍是同一窗口的活动构成,回答不了场所更替之后的问题。
另一项检验可以把“居民从本普查区出发去了哪里”和“这类场所开在本普查区里面”拆开。文中的网络从居住地普查区连到活动所在的普查区,收入也记在居住地普查区上。一片区内没有法式餐厅,仍可能因为居民外出就餐而在这项活动上得分很高。高端消费在论文里更像经济状况的伴随结果。若一个城市把新开餐厅当成已经证实的增收手段,就把标记和原因叠在了一起。进取型活动是否反过来推动经济,仍是这篇预测研究留下、还没有用实验分开的假说。