走不同通勤路的收入阶层,谁会先把生态创新传开?
论文名片|Weiyu Li、Lixin Tian、Huanling Liu、Qi Su,Heterogeneous adoption of eco-innovation considering commuting mobility patterns,Journal of Cleaner Production,2020,期刊预校样(Journal Pre-proof)。首页建议按该刊 2020 年引用;DOI 印为 10.1016/j.jclepro.2019.119499。2019 年 3 月 29 日收稿,11 月 1 日修回,11 月 28 日接收。PDF 未印卷期与页码。这是把真实通勤多重网络放进采纳模型的模拟,临界点另有特征值近似。
早上从家到工作地,傍晚再回家。若生态创新要靠见面时的交谈传开,当时同处一个地区的人就可能互相影响。生态创新(eco-innovation)在文中覆盖可再生能源技术、污染预防、废物管理设备、绿色金融产品和生物农业。容易想到的画面是,收入最高的人先采纳,再带动别人。
这篇论文把哥伦比亚麦德林(Medellín)六个收入阶层各自的通勤流量叠在同一批地区上,让跨阶层的说服概率随阶层差下降,看采纳会在哪一层先越过临界点。下面说到的一次出门只是在解释模型里的一个时间步,不是论文跟踪的某一个居民。
方向是:在这套模型里,带动整网临界点的是第 2 层,第 6 层的采纳比例最低,第 5 层次之。把跨层说服按阶层差打折,会拉大各层采纳比例的差距。移动概率升高时,临界采纳率下降,各层开始抬升的位置更接近,但各层采纳比例的差距也可以变宽。更有利于起发的人口安排,是同一个地区里六个阶层的人数更均匀。
先说结论
- 麦德林通勤网有 413 个地区、6 个收入阶层。四种折扣设定下,第 2 层的采纳比例都最高,并带动临界起发;第 6 层最低,第 5 层次之。各层初始采纳比例为 0.001,退出率 μ 固定为 0.2。
- 跨层采纳率按阶层差打折后,层与层的差距变大,慢非线性模型的差距最大。临界采纳率从常数模型、快非线性、线性到慢非线性略有上升。图中的 λ 已乘以 1000,横轴上的 1 对应模型里的采纳率 0.001。
- 移动概率 p 从 0 增到 1,临界采纳率下降。总体采纳比例随 p 先升后降;λ 较大时,下降段变得不明显。p 增大使各层的起发位置更接近,同时把各层采纳比例的差距拉宽。
- 六层连边概率都是 0.126 的随机网,与六层分别为 0.052、0.0816、0.1112、0.1408、0.1704、0.2 的随机网,平均连边概率仍是 0.126。两张总体采纳热图没有明显差别。
- 常数模型下,每个地区内部把当地人数均分给 6 个阶层,比把每个阶层在 413 个地区上摊匀更容易起发。全系统初始采纳比例同为 0.001 时,种子放在哪一层不改变稳态总体比例;单层种子是 0.006,按 6 层平均后仍是 0.001。这组比较画在 p = 0.4 的常数模型上。
六个收入阶层为什么不能共用一张通勤网?
扩散发生在人与人见面的时候。收入、知识和对新事物的态度接近时,交谈往往更有效。以往有的扩散模型把人当成同质的,有的则按创新倾向区分人。创新倾向很难直接测到。本文改用社会经济差异来设置采纳率,并把通勤放进接触过程。
数据是 Lotero 等人 2016 年已经建好的麦德林多重网络(multiplex network)。同一组地区出现在每一层,层与层的差别是通勤连边。第 1 层对应最低收入,第 6 层对应最富;第 α 层就是第 α 个阶层的通勤移动模式(commuting mobility pattern)。地区之间只要在该层至少有一次出行,就有一条有向边,边权是该层的通勤流量。节点从 1 编到 413,所以下文的地区数 N = 413,阶层数 L = 6。
本文直接使用这张按阶层和地区汇总的通勤网。分析单位是地区上的阶层,不是从个人轨迹找回某一个居民。总人数 R 在正文里没有给出单一数字。图 5(a) 的色标从 0 到 4822,大约每隔 536 标一档,表示的是色标范围,不是文中点名的某一个地区人数。
出门、见面、回家,采纳发生在哪一步?
每个时间步分成三段。开始时所有人都在自己的家所在地区。每个人以概率 p 出门,以概率 1 − p 留在家里。出门后,第 α 层、家在地区 i 的人去地区 j 的概率,是该层从 i 出发的通勤流量占比:
cα(i,j) = wα(i,j) / 该层从 i 出发的流量之和。
人更新位置之后,只与当时在同一地区的人相互作用。状态只有两种:未采纳(U)和已采纳(A)。未采纳者与已采纳者交谈后,可以按采纳率变成已采纳;已采纳者每个时间步以退出率 μ 回到未采纳。论文把 μ 称为 recovery rate,并把它解释为使用门槛:投入高或不方便,μ 就设得更大。步末所有人回到家,下一步重新开始。因此这里的移动是反复通勤,不是搬家。
同一阶层内部的采纳率记为 λ。阶层 α 与 β 之间用折扣后的采纳率 λαβ = γαβ λ,其中折扣因子 γαβ 在 0 到 1 之间。γ 越小,跨阶层说服越难。PDF 没有给时间步对应的日历长度,所以 μ = 0.2 不能直接读成每天或每年流失 20%。
阶层差每增加一档,说服概率按什么下降?
作者提出三种折扣,并与不作折扣的常数模型比较。阶层差记为 |α − β|,最大是 5,因为分母用的是 L − 1 = 5。
常数模型里 γ 始终为 1,也就是 λαβ = λ,阶层之间和阶层内部用同一个采纳率。
线性模型:γαβ = 1 − |α − β| / (L − 1)。
快非线性模型:γαβ = cos(π/2 · |α − β| / (L − 1))。阶层差越大,下降越快;差很小时曲线还比较平。
慢非线性模型:γαβ = 1 − sin(π/2 · |α − β| / (L − 1))。阶层差越大,下降越慢;最先的那一档下降更陡。
正文没有另附这些公式的数值表。把 L = 6 代入后,相邻阶层 |α − β| = 1 时,线性模型的 γ 是 0.8,快非线性是 cos(π/10) ≈ 0.951,慢非线性是 1 − sin(π/10) ≈ 0.691。阶层差达到 5 时,三种折扣模型的 γ 都是 0,也就是第 1 层与第 6 层之间的采纳率被设为 0。这是模型设定,不是测到的社会事实。
慢非线性在相邻阶层上已经降到约 0.691,所以它把主要发生在相近阶层之间的扩散分得最开。快非线性在相邻阶层上仍有约 0.951,第一档折扣很轻。名字里的快和慢,说的是斜率怎样随阶层差变化,不是哪一个模型对邻居更宽容。
临界采纳率由什么决定?
要判断生态创新能不能在系统里维持,需要看稳态。临界点附近,采纳比例接近 0。作者在这一点把接触公式线性化,得到一张把地区和阶层排在一起的矩阵 H。临界采纳率是
λc = μ / Λmax(H)。
Λmax(H) 是 H 的最大特征值。H 里同时放着双方都留在家里的接触、只有一方出门的接触,以及双方都出门时由两层通勤矩阵相乘得到的相遇;各地区各阶层的人数和折扣 γ 也在里面。μ 越大,或者这张接触结构的最大特征值越小,临界采纳率越高。
这个特征值给出的是种子能否增长的位置,不是热图上最终有多黄。正文所有模拟都把 μ 固定为 0.2,因此后文临界点的左右移动,来自移动概率、网络或折扣改变了 H,不是退出率换了一个数。
总体采纳比例 ρA 是 413 个地区、6 个阶层上采纳比例的简单平均,分母是 N · L = 413 × 6。某一层的 ρα 是该层在 413 个地区上的简单平均,分母是 413。某一个地区的 ρi 是该地区 6 个阶层的简单平均,分母是 6。三处都没有按人数加权。ρA 不能读成全市人口中的采纳份额。
整座城市的平均采纳比例怎样随出门概率变化?
模拟从每一层 0.001 的初始采纳比例出发,更新到稳态。热图是蒙特卡洛模拟(Monte Carlo),白色点线是上面的理论临界点。论文报告二者在起发位置上吻合较好。
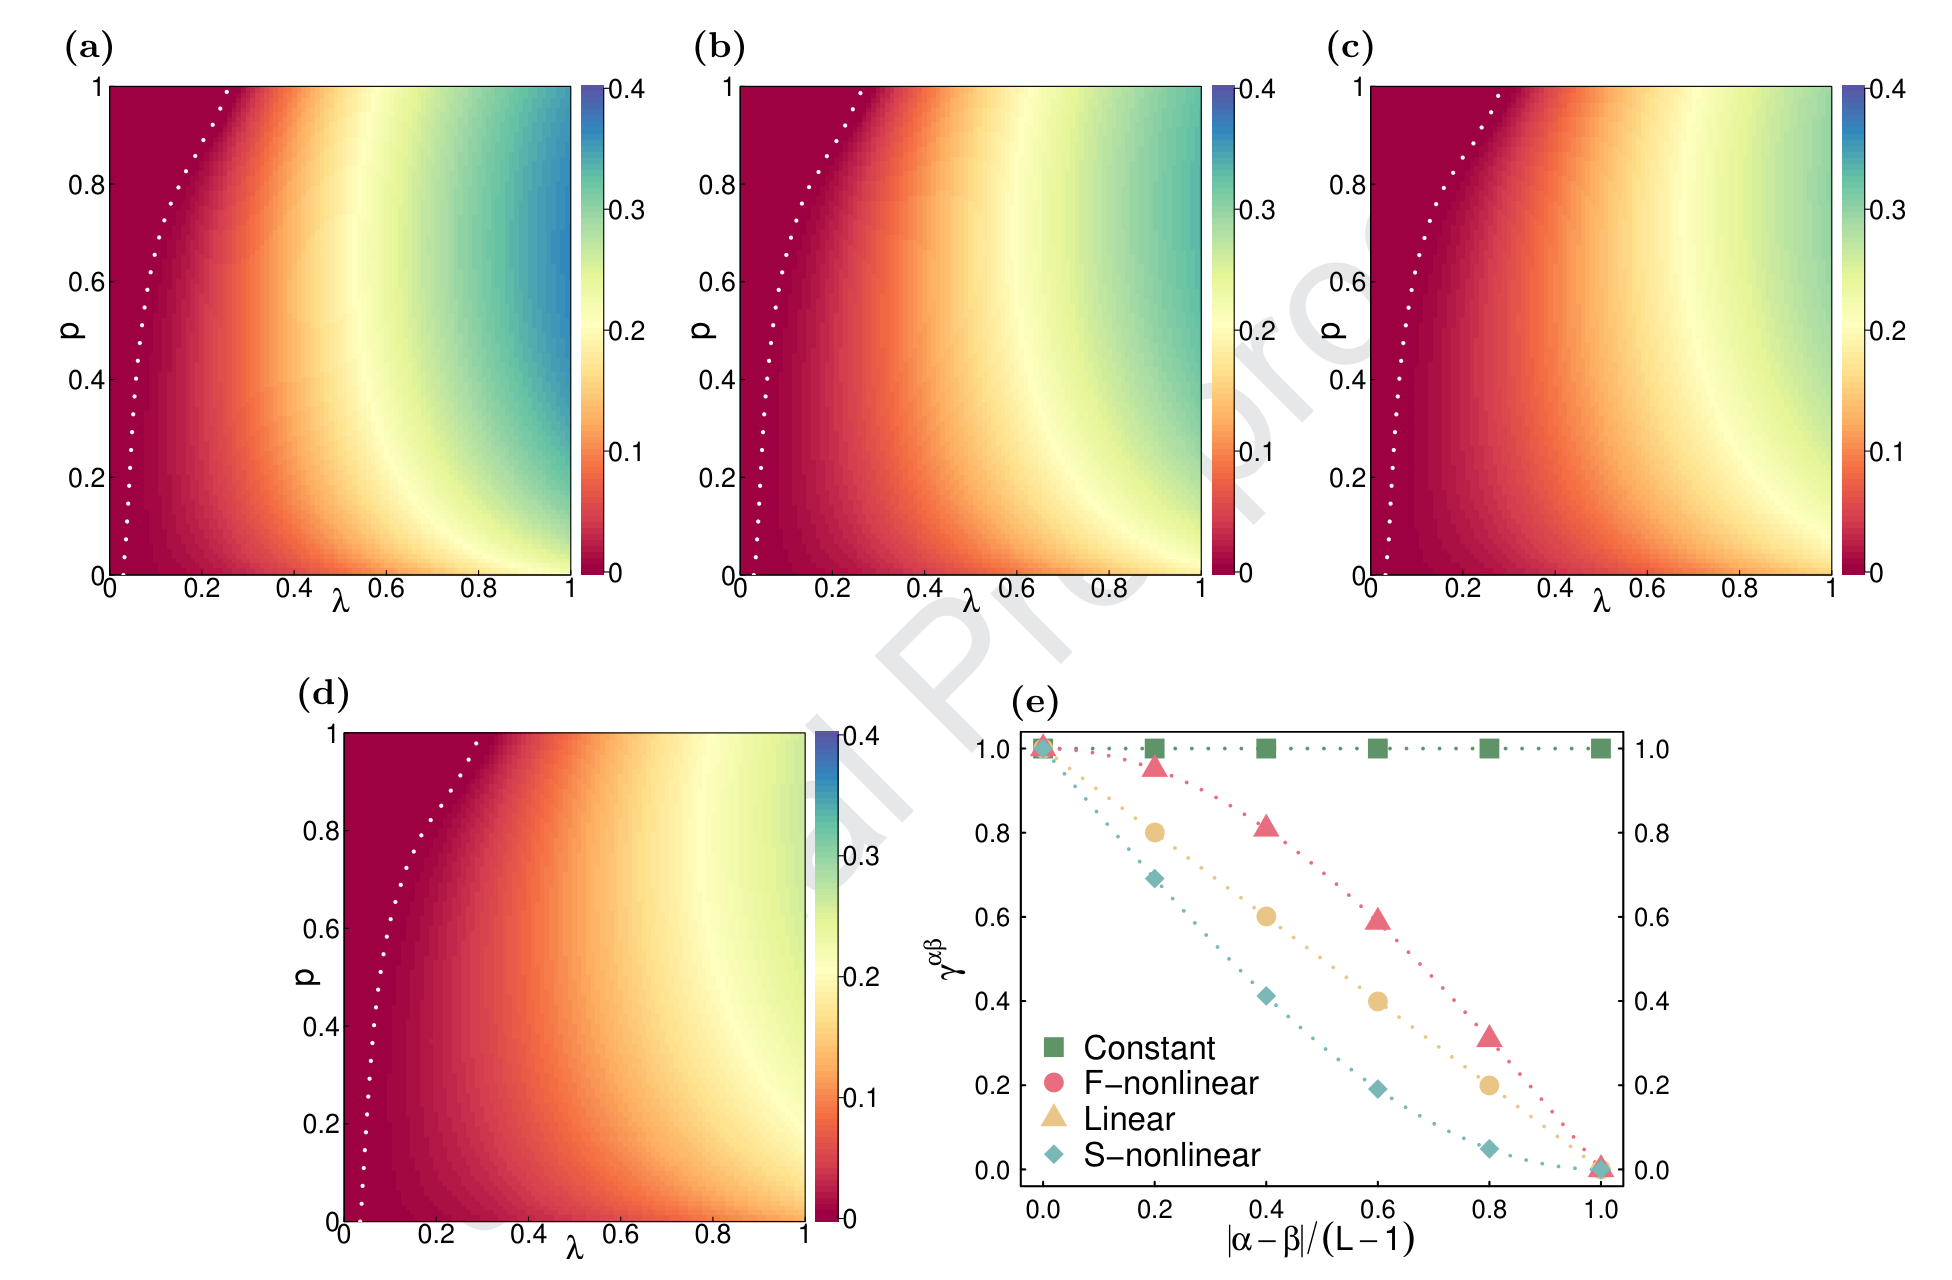
图 1|总体采纳比例如何随采纳率和移动概率变化,四种折扣差在哪里?
(a)常数模型,跨层不打折。横轴 λ 已乘 1000,纵轴是移动概率 p,颜色是总体采纳比例 ρA,色标 0 到 0.4;白点线为理论临界点。(b)快非线性模型,坐标与色标同(a)。(c)线性模型。(d)慢非线性模型;白点线相对(a)略向右,临界采纳率略高。(e)横轴为阶层差除以 L − 1,范围 0 到 1;纵轴为折扣因子 γ,范围 0 到 1。常数模型在整个横轴上保持为 1;快非线性先缓后陡,线性均匀下降,慢非线性先陡后缓,这三条在阶层差比例为 1 时降到 0。来源:原论文 Fig. 1。μ = 0.2,初始采纳比例 0.001。
p 从 0 增到 1,白点线向左移动,临界采纳率下降。更高的出门概率让人在非家所在的地区产生接触,临界点因此更容易跨过。ρA 随 p 先升后降;λ 较大时,下降段变得不明显。从常数模型到快非线性、线性、慢非线性,临界点略向右。忽略折扣,会把临界采纳率估得偏低:图上看起来更小的 λ 就能起发。
色标到 0.4,读的是地区—阶层简单平均,不是 413 个地区的人口加权比例。热图没有逐格数值表,这里不从颜色里摘某一个 p 上的精确 ρA。
第 2 层的采纳比例为什么最高?
总体平均会把层与层的差别盖住。把六个层分开以后,折扣的作用才明显。
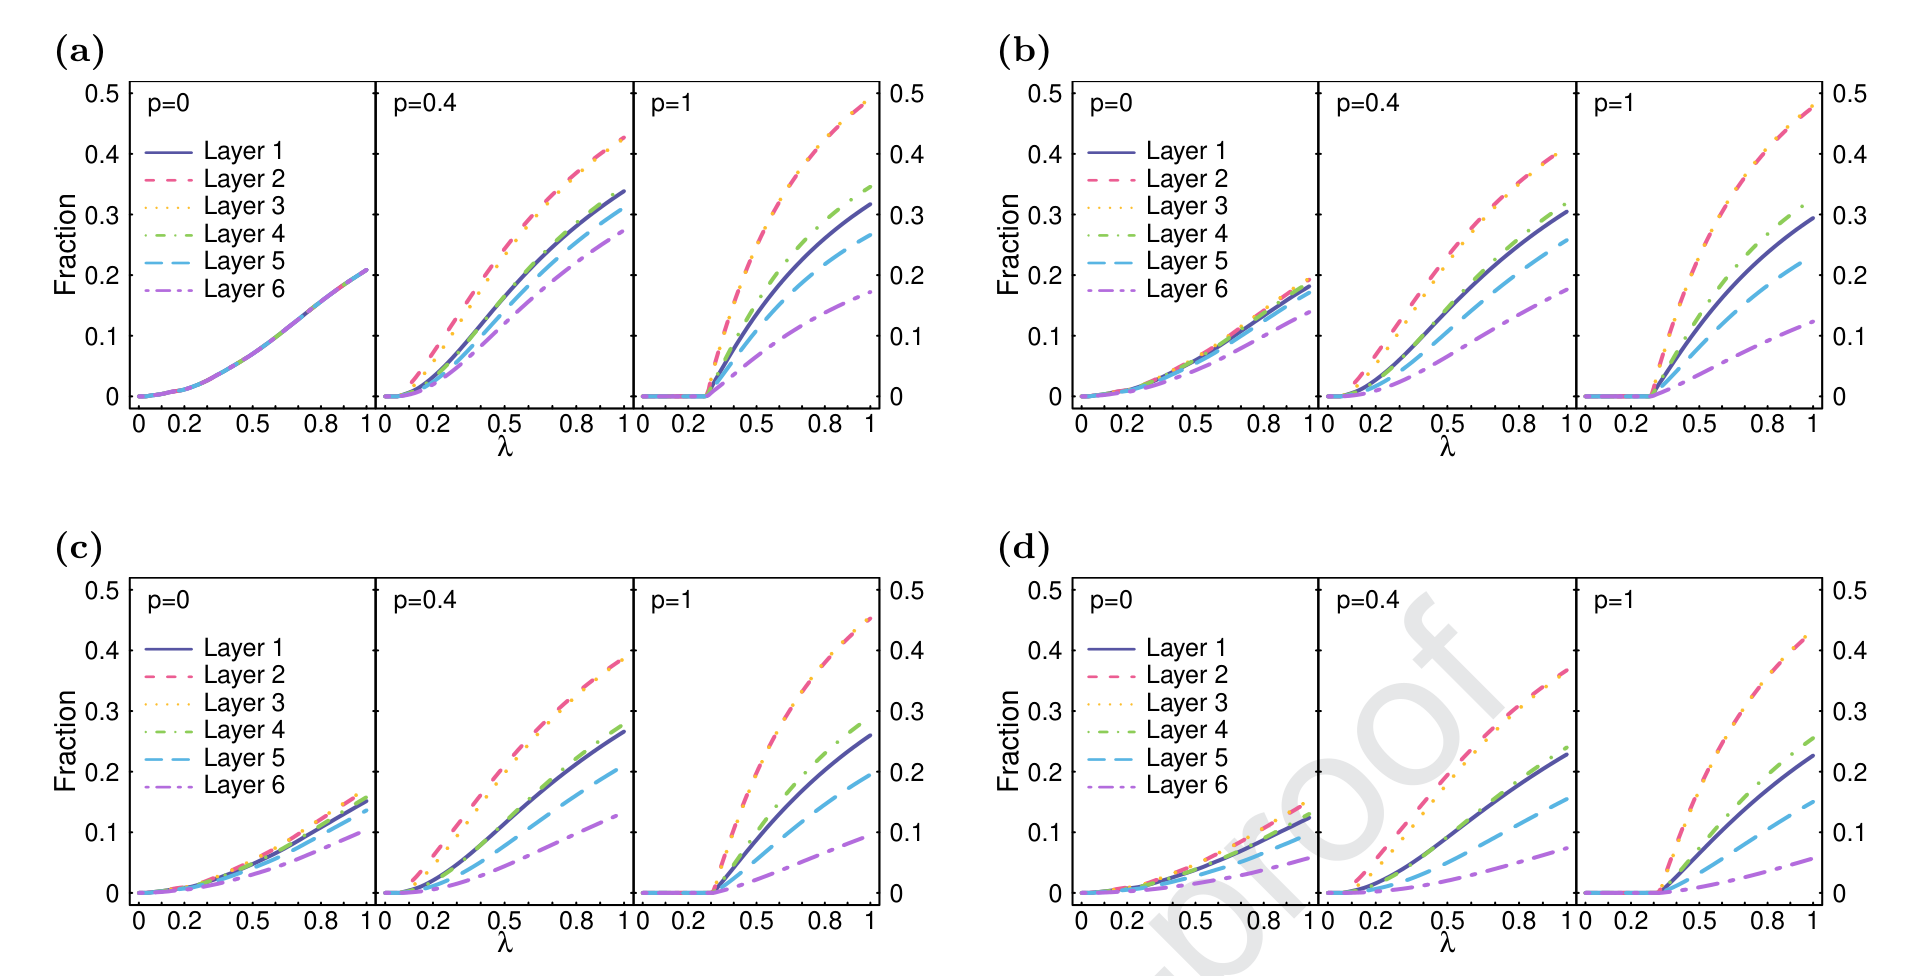
图 2|六个阶层的采纳比例是否被折扣拉开?
(a)常数模型。每个子图从左到右是 p = 0、0.4、1。横轴 λ 已乘 1000,纵轴是该层采纳比例,范围 0 到 0.5,分母是 413 个地区的简单平均。图例 Layer 1 到 Layer 6 对应六个阶层。(b)快非线性模型,坐标同(a)。(c)线性模型。(d)慢非线性模型,各层曲线分得最开。来源:原论文 Fig. 2。μ = 0.2,各层初始采纳比例 0.001。
四种模型里都是第 2 层最高,第 6 层最低,第 5 层次之。常数模型没有阶层折扣,这个排序已经出现,所以它来自这张通勤网和人数分布,不是只靠 γ 制造出来的。论文把第 6 层写成最不容易被公众带动。模型没有测量环境态度或支付意愿,这句话是对最低曲线的解读。
引入折扣后,层间差距变大,低移动概率时更明显;慢非线性的差距最大。这与相邻阶层的 γ 一致:慢非线性在第一档就降到约 0.691,而扩散主要发生在相近阶层之间。p 增大以后,各层开始抬升的 λ 位置更接近,这是不同阶层在地区里混合的结果;与此同时,曲线右端的纵向差距仍然可以很宽。第 2 层在 p = 0、0.4 和 1 时都保持领先。
论文把这一结果与另一些把个人分开、假定信息完全的支付意愿研究对照:那些研究里最富群体对绿色属性的支付意愿很高。本文的采纳取决于接触。两套问题并不测量同一件事,不能用第 6 层曲线最低去否定支付意愿调查,也不能用支付意愿直接代替这张网上的临界点。
地区之间的起发会被通勤抹平吗?
层是一种分组,地区是另一种。图 3 把每个地区六个阶层的平均采纳比例画出来,分母是 L = 6。
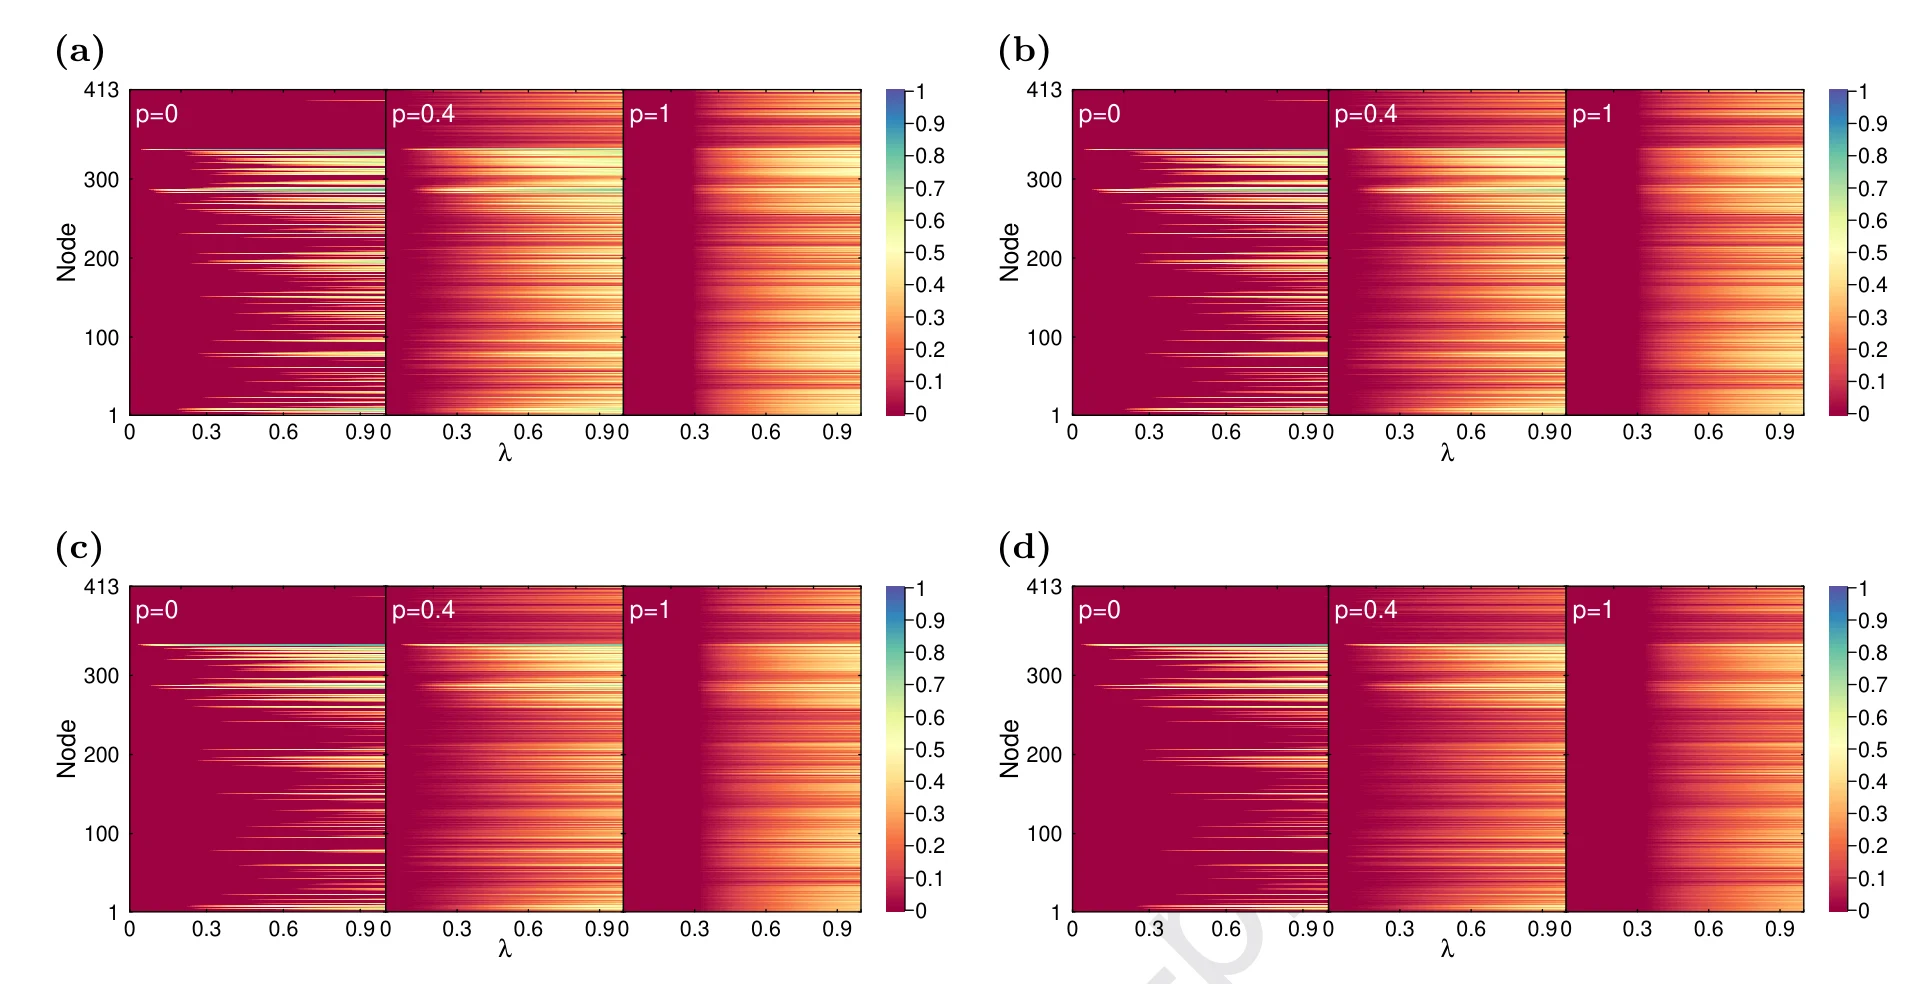
图 3|413 个地区的起发是否随移动概率对齐?
(a)常数模型。纵轴是地区编号 1 到 413,每个子图内从左到右为 p = 0、0.4、1。横轴 λ 已乘 1000,颜色是该地区的 ρi,色标 0 到 1;偏低的一端为红色。(b)快非线性模型。(c)线性模型。(d)慢非线性模型。来源:原论文 Fig. 3。μ = 0.2,初始采纳比例 0.001。
p 增大时,离开红色的地区变多,而且这些起发地区开始抬升的 λ 位置趋于接近。通勤把不同地区的人带到同一个地方,地区之间的起发因此更齐。比较(b)(c)(d)与(a),不作折扣时,地区起发的位置更靠左,全系统的临界点也更靠左。左移表示临界采纳率被估低了。图上没有统计离开红色的地区个数,正文也没有给出这个人数。
把每一层的连边概率改掉,热图会分开吗?
真实网络里,各层的通勤结构本来就不同。为了分开网络结构和人口分布,作者做了两张人工多重网络,都有 6 层。节点数、人口的空间分布和平均出度与真实网络对齐。同质多重网络(HoMN)的每一层都是有向随机网,连边概率都是 0.126。异质多重网络(HeMN)从第 1 层到第 6 层的连边概率依次为 0.052、0.0816、0.1112、0.1408、0.1704、0.2,六层平均仍是 0.126。
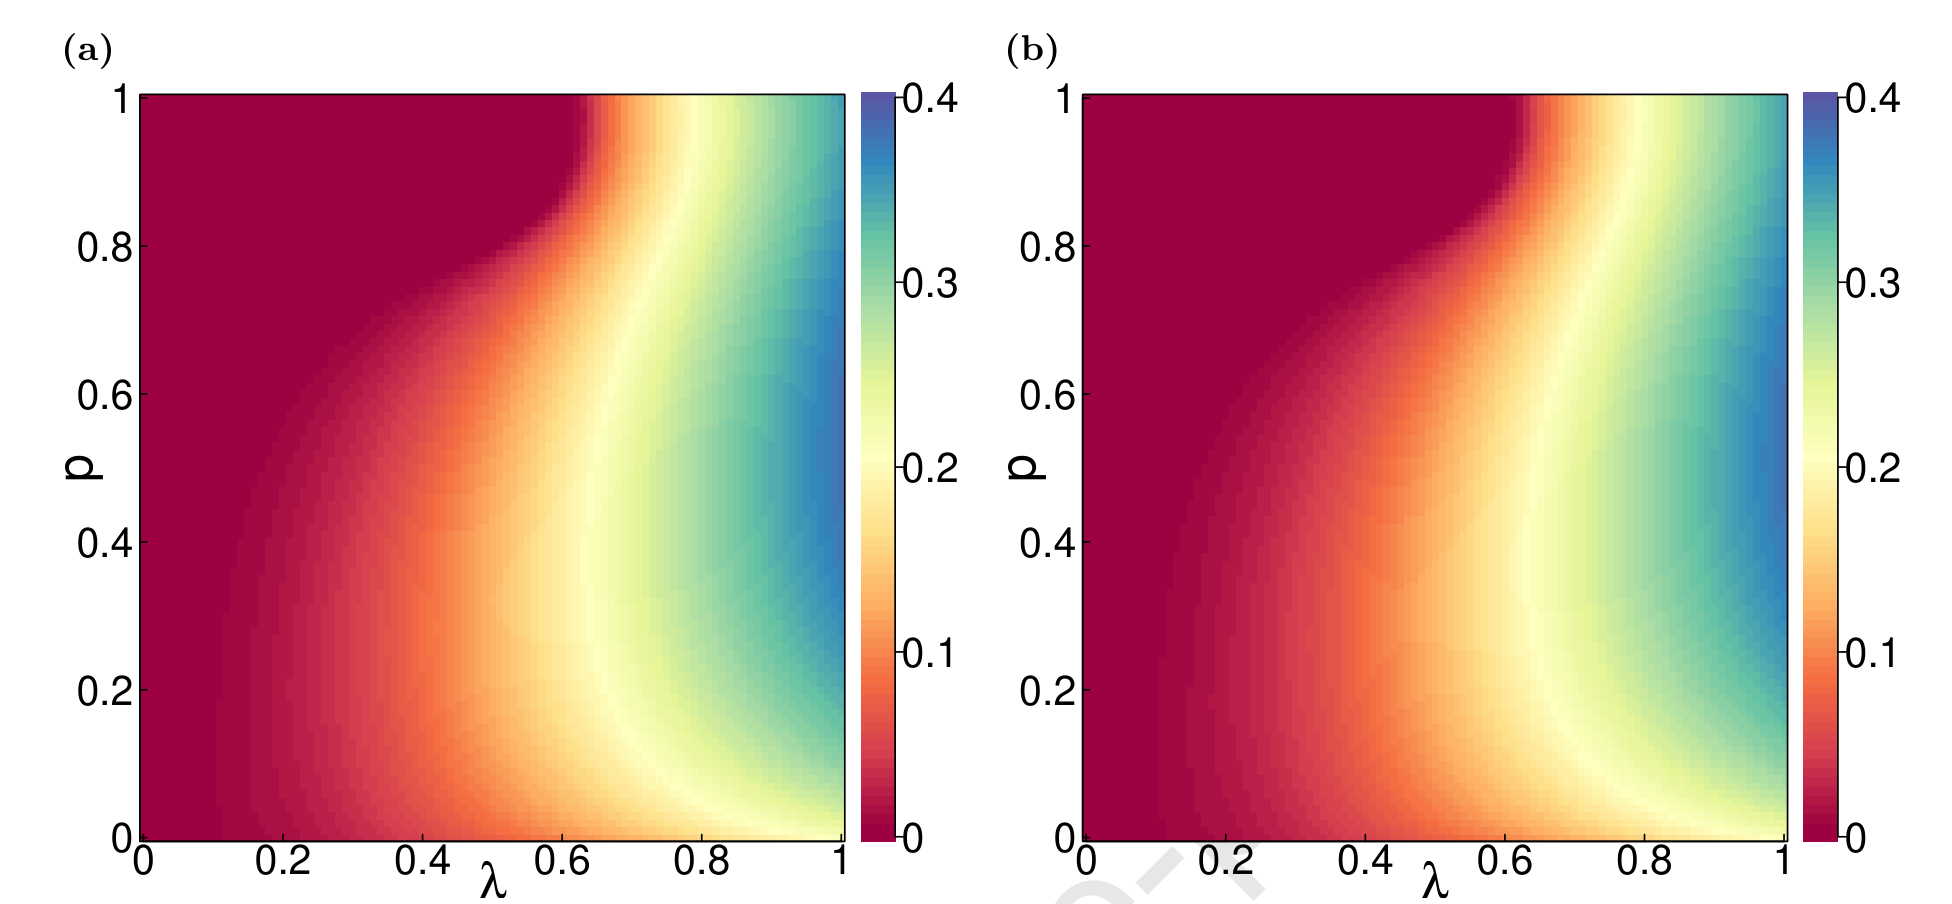
图 4|各层连边概率相同或不同时,总体采纳热图是否分开?
(a)HoMN,六层连边概率同为 0.126。横轴 λ 已乘 1000,纵轴为 p,颜色为 ρA,色标 0 到 0.4。(b)HeMN,六层连边概率不同、平均仍为 0.126,坐标与色标同(a)。来源:原论文 Fig. 4。μ = 0.2,初始采纳比例 0.001。图注没有写明使用哪一种折扣。
两张热图没有明显差别:临界点都随 p 增大而向左,高 λ 一端的颜色格局也相近。作者据此认为,采纳比例和临界点依赖的是整个系统的通勤连接,而不是单独某一层的连边模式。这里的对照是随机图上各层概率是否相同,平均概率都保持 0.126,人口的空间分布也保持为真实分布。它没有把麦德林的真实路线放回人工网,也没有证明任意一种地理结构都无关。
因为图 4 的图注没有标明折扣模型,这张图支持的是两种连边结构下的热图很接近。后文图 6 在常数模型上再次看到两种人工网内部的曲线叠合,作者用这一点支持同一判断。
两种均匀里,哪一种更容易起发?
真实网上,有的地区人很多,有的地区人很少,同一个地区里六个阶层的人数也不相等。作者在常数模型下改了两种人数安排,通勤网仍是原来的真实网。
第一种:每个阶层在 413 个地区上人数相同,该阶层在地区 i 的人数等于该阶层总人数除以 N。阶层总人数保留,空间上被摊匀。
第二种:每个地区内部,当地人数除以 L = 6,分给六个阶层。地区总人数保留,阶层构成被摊匀。
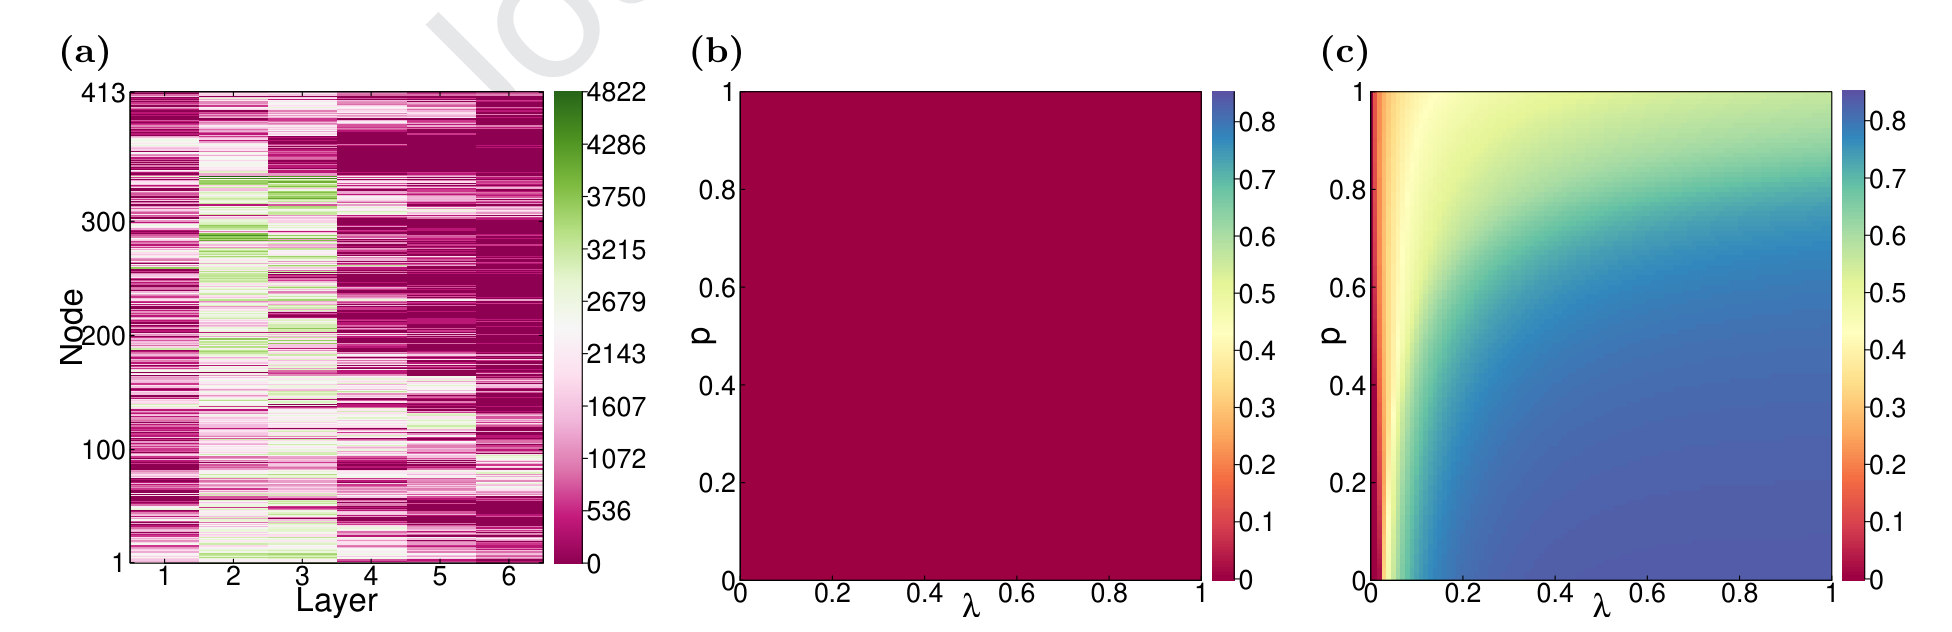
图 5|人口分布怎样改变总体采纳比例?
(a)真实人口分布。横轴为层 1 到 6,纵轴为地区 1 到 413,颜色为该格人数,色标 0 到 4822。(b)第一种安排:每个阶层在地区间摊匀。横轴 λ 已乘 1000,纵轴为 p,颜色为 ρA,色标 0 到 0.8;图面停留在低值一端。(c)第二种安排:每个地区内六个阶层均分当地人数,坐标与色标同(b),随 λ 和 p 升高进入高值。来源:原论文 Fig. 5。常数模型,μ = 0.2,初始采纳比例 0.001。
(c)比(b)更容易起发,采纳比例也更高。促进扩散的是地区内部的阶层人数更均匀,而不是把每个阶层在地图上摊成同样人数。再把(b)与图 1(a) 的真实疏密分布比较,空间上摊匀并不更有利。图 1 的色标只到 0.4,图 5(b)(c) 的色标到 0.8,两张图的颜色深浅不能直接当成同一个绝对比例;在 0 到 0.8 的色标上,(b)仍大体停在低值端。
接触公式里,一个地区当时有多少人会进入说服项。论文报告的是摊平之后的模拟结果,没有再把人数变化和通勤权重拆开做一次单独分解。正文的政策句建议选择社会经济人口更均匀的地区作为最初扩散区域。图 5 的实验改的是整张网上的人数分布,不是只改种子所在的那一个地区。
种子放在不同层,稳态比例变了吗?
最后看初始种子放在哪里。全系统初始采纳比例保持 0.001。一种做法是每一层都设为 0.001,记为 IL 1−6。另一种做法是只在一层放入种子,该层比例设为 0.006。因为全系统比例按六个层平均,0.006 ÷ 6 = 0.001,两种做法的全系统初始比例相同。
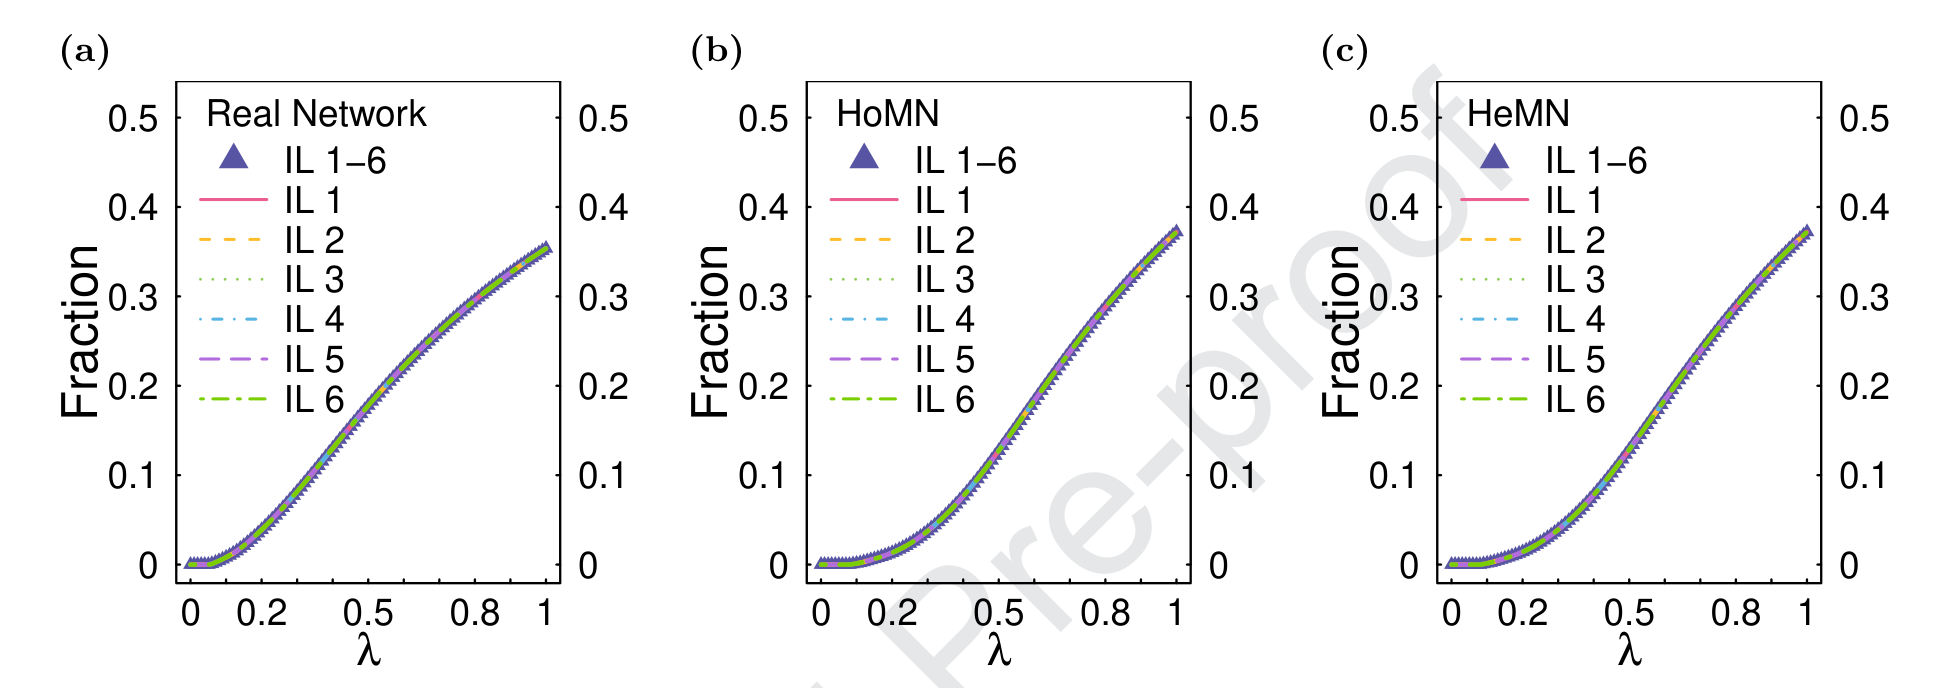
图 6|初始种子所在的层是否改变稳态总体采纳比例?
(a)真实网络。横轴 λ 已乘 1000,纵轴为 ρA,范围 0 到 0.5。IL 1−6 为六层同时给出 0.001 的初始比例;IL 1 到 IL 6 为相应单层的初始比例 0.006。七条曲线叠在一起。(b)HoMN,曲线同样叠合。(c)HeMN,曲线同样叠合。来源:原论文 Fig. 6。常数模型,μ = 0.2,p = 0.4。
在这组设定下,稳态总体采纳比例取决于全系统的初始比例,不取决于种子先放进哪一层。图注没有给出某一 λ 上的精确读数,纵轴范围是 0 到 0.5。这是 p = 0.4、常数模型下的稳态比较,没有报告到达稳态要多少步,也没有在三种折扣模型下重复。HoMN 与 HeMN 各自内部的叠合,被作者用来支持图 4:需要关心的是整网,而不是单独挑一层的连边概率,也不是把初始动员锁死在某一个阶层。
这些结果能说到哪一步?
通勤网来自麦德林的真实流量,采纳过程是模型。图上的比例不是该市居民购买绿色产品的统计。λ、μ 和三种 γ 都是设定;μ 在全部图中为 0.2,时间步没有日历长度。已采纳的人会按 μ 退回,稳态是采纳与退出的平衡,不是累计曾经采纳的人数。
理论白线只在采纳比例接近 0 时线性化,它核对的是起发位置。热图的高度来自模拟。蒙特卡洛与白线在临界位置上的吻合,不等于这三种折扣是唯一真实的说服方式。
ρA、ρα 和 ρi 的分母分别是 413 × 6、413 和 6,都不按人数加权。第 2 层领先,是这条简单平均上的领先。人工网的比较保持平均连边概率 0.126 和真实的人口空间分布,替换掉的是各层是否使用同一连边概率。图 4 没有标明折扣。图 5 和图 6 写明是常数模型,图 6 还固定 p = 0.4。
打破相近阶层之间的障碍、把第 2 层作为早期对象、选择阶层更均匀的地区起步,是作者由这些比较得出的建议。正文没有单独做一次干预实验,去改变 γ、只改一个地区的阶层构成,或只增加某一层的通勤。一个城市、六个既定阶层,也不能直接换成另一套收入分组。
一句话总结
在麦德林这张六阶层通勤网上,模型里先带动生态创新越过临界点的是第 2 层;阶层差把跨层说服打折以后,各层采纳比例的差距会拉大,而同一个地区里六个阶层人数更均匀,比把每个阶层在 413 个地区上摊匀更容易起发。
核心来源
- 期刊预校样首页所印 DOI:10.1016/j.jclepro.2019.119499。引用年份、题目和作者以该 PDF 首页为准;预校样未印卷期与页码。
- 正文图 1–6。总体比例、分层比例和分地区比例的定义分别是正文的式 (14)(15)(16)。图中 λ 均已乘以 1000。
- 通勤多重网络引自 Lotero、Hurtado、Floría 与 Gómez-Gardeñes,2016,Rich do not rise early: Spatio-temporal patterns in the mobility networks of different socio-economic classes,Royal Society Open Science,3(10):150654。调查年份和总人数不在这份预校样正文中。
- 论文致谢写明资助为国家自然科学基金 71690242、91546118 和 11731014。
作者介绍
以下只写 PDF 上的署名机构。
- Weiyu Li:署名南京师范大学数学科学学院,以及波士顿大学聚合物研究中心与物理系。
- Lixin Tian:通讯作者。署名南京师范大学数学科学学院、江苏大学能源发展与环境保护中心,以及南京师范大学能源相互依赖行为与策略研究中心。首页把通讯地址写在南京师范大学的这一研究中心。
- Huanling Liu:署名波士顿大学聚合物研究中心与物理系,以及中国科学院上海应用物理研究所。
- Qi Su:署名波士顿大学聚合物研究中心与物理系。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
μ = 0.2 在全部图里都是每个时间步退出一次的概率,而 PDF 没有规定一个时间步是一次交谈、一个通勤日,还是更长的一轮。若一步被理解成一个工作日,已经采纳的人里约有两成会在下一步退出,这对一次性安装的设备过快,对可逆的日常习惯又需要另测。不同的生态创新被放进同一个 λ 和同一个 μ。把太阳能设备和一次绿色出行共用这条临界曲线之前,先要让时间步对上真实的接触间隔,否则横轴上的 0.001 还不能换成宣传预算。
ρA 的分母是 413 × 6 个地区—阶层格子。图 5(a) 的人数色标从 0 拉到 4822,格子之间差得很远。若政策关心的是人数而不是地区格子,就应按各地区各阶层的人数重新加权。加权以后,第 2 层是否仍然领先、空间摊匀是否仍然更不利,都不能从现在的简单平均直接推出来。这个加权曲线本文没有给。
p 升高时,临界采纳率下降,各层采纳比例的差距却可以变宽。若一座城市只庆祝创新是否起发,就可能错过第 2 层与第 6 层在稳态上被拉得更开。一个直接的后续图,是在固定的 λ 和每一种折扣下,画出第 2 层与第 6 层采纳比例之差随 p 的变化。差变大而临界点下降,这两件事要一起看,才能决定更高的移动概率该不该被当成推广手段。相邻阶层的第一档折扣在三种公式里已经不同,约 0.951、0.8 和 0.691;若要检验模型,优先测的是相邻阶层之间的说服,而不是先测第 1 层与第 6 层。后者在三种折扣里都被设成了 0。