只用一种城市传感器,能把整座城市的人怎么移动说清楚吗?
论文名片|Zhihan Fang,Human Mobility Modeling Based on Heterogeneous Urban Sensing Systems,博士学位论文,罗格斯大学研究生院计算机科学项目,新泽西州新不伦瑞克,2020年5月。学位论文导师为 Desheng Zhang。ProQuest 编号 27742963。这篇学位论文没有印 DOI。
可以想成这样一次出门:早上从住宅小区进地铁,中途换成公交,晚上在公司门口打车。地铁闸机记下进出站,公交车载定位记下车辆走到哪,出租车每隔一段时间上报空车还是载客,手机只在通话或上网时连上附近的基站。任何一套记录都看不见这次出门的全部。
这篇学位论文要在深圳,用已经为收费或运营采集的多套城市传感数据,刻画全市尺度的人类移动性(human mobility),也就是人在城市空间里的日常移动,而不是搬家或户籍迁移。作者把框架称作 urbanSense。它分三层:先采集交通、通信和支付数据;再度量一套系统离全市有多远;然后用多家手机网络估计人口,并把出租、公交、私家车和地铁的出行时间拆成等待与乘车,看异常怎样改变这两段时间。
方向先说在前面。多家系统一起用,确实能露出单套系统看不见的偏差,也能把人口格子划得更细、把出行时间拆开。可是人口“准不准”主要是在对照一张夜间的静态人口图,出行时间里的等待也多半是由记录推出来的上界或最短行程差。模型更接近参照,还不等于已经点清了街上的每一个人。
先说结论
- 深圳这批数据覆盖交通、通信、支付三个领域的 8 套传感系统。三家手机网络的日活跃用户分别为 380 万、250 万和 390 万,论文称这覆盖了全市手机用户,并达到 Worldpop 2015 年人口的 96%。Worldpop 图上标出的全市人口是 1069.83 万。
- 代表性距离用来量一家网络的使用负荷离三网合计有多远,越小越接近。空间上网络 B 最接近全市;功能混合的中心商务区比机场更有代表性。论文概述写,高峰时段的代表性比下午 1 时这类低需求时段低约 50%,但没有印出相减的两个距离。
- 按语境多样性抽样时,抽样比例到 0.6,代表性距离从平均 0.31 降到 0.16。用校正后的单网数据做人口估计,平均绝对百分比误差从 25.8% 降到 15.4%,相对降幅 40.3%,对照是未抽样的单网原始数据,参照人口是 Worldpop。
- 三网小区相交得到 41794 个子区。市中心 36057 个子区的平均面积为 1.1 万平方米,约为单网小区的十分之一,接近 Worldpop 的 100 米格网。相对五个单网或简单合并基线,归一化均方根误差平均低 28%、23%、44%、33% 和 17%。摘要里的 27%,更接近人口在 10 到 10000 的子区上、相对部分基线的增益,不是这五个降幅的平均数。
- 地铁行程里,等待平均占全程 16%。等待超过全程 20% 的行程,在出租车中占 20%,在地铁中占 40%,在公交中占 57%。2016 年热带风暴 Nida 使地面系统的出行时间增加约 40% 到 70%。摘要写延误预测误差比已有方法低 31%,第 5 章开头写预测准确率 86.5%;评估图给出的是各分钟的百分比误差,正文没有把这两个数标到某一条曲线上。
八套系统看见的,并不是同一种移动
urbanSense 的底层是三路已经存在的记录,中间用代表性来检查单套系统的偏差,上层才做人口和出行时间。
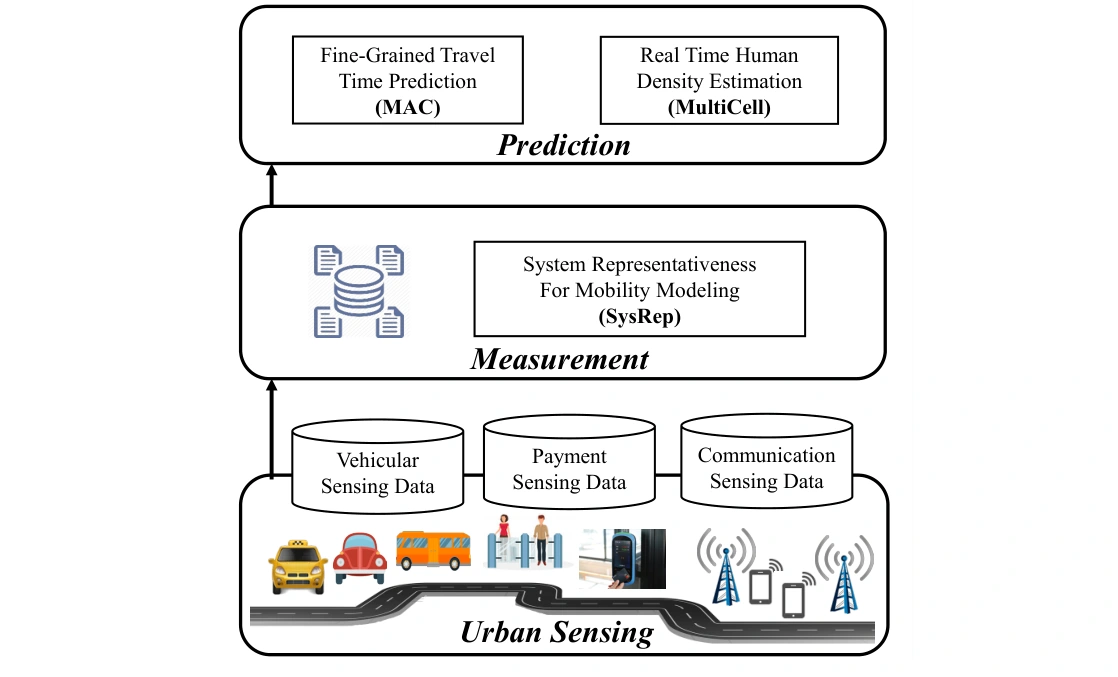
图 1|把多套城市传感器收进同一个移动模型,中间为什么还要先度量偏差?
无字母子图。下层是车辆、支付和通信三类传感数据,中层是系统代表性度量 SysRep,上层把预测分成细粒度出行时间 MAC 和实时人口密度 MultiCell。图说明三层的分工,不提供误差。来源:学位论文 Fig. 2.1。
8 套系统是这样数出来的:出租车、公交、私家车三套车载定位;A、B、C 三家手机网络;公交和地铁两套自动售检票。公交因此出现两次,一次是车辆轨迹,一次是乘客刷卡,两者看见的人并不相同。
通信数据来自深圳三家主要手机网络,论文用 A、B、C 代替运营商名称。网络 A 有 380 万日活跃用户、3595 座基站、每天约 2.10 亿条记录,记录类型包括通话、短信和数据连接。网络 B 有 250 万日活跃用户、2977 座基站、每天约 2.00 亿条记录。网络 C 有 390 万日活跃用户、5174 座基站、每天约 9300 万条记录,而且这篇数据里只有通话。三网每天合计超过 5 亿条。第 4 章写这是三个月的手机数据,没有给出起止日期,并写三网分别有 380 万、250 万、390 万日活跃用户,基站数在一处仍是 3595、2977、5174,另一处写成 3585、2977、5174。
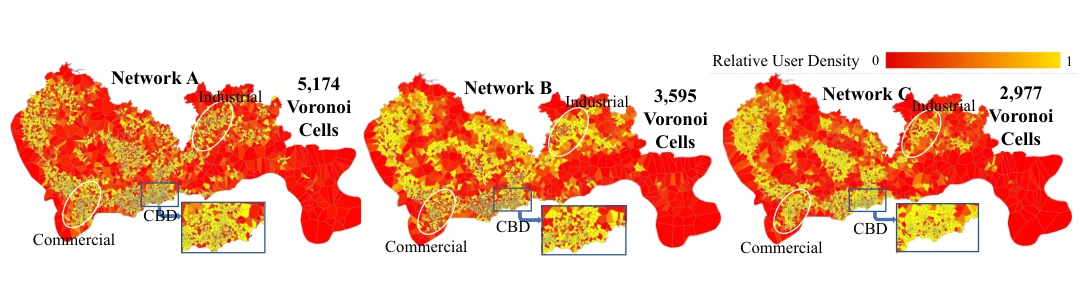
图 2|三家网络的基站和用户,是不是同一张城市地图?
无字母子图,从左到右为网络 A、B、C。颜色从红到黄表示相对用户密度由低到高,蓝框是中心商务区放大。图上印的泰森多边形小区数是 A 5174、B 3595、C 2977。这和第 2 章正文的 3595、2977、5174 对不上。后文引用基站数时会标明出自正文还是这张图。来源:学位论文 Fig. 2.2。
车辆这边,深圳公交有 976 条线路、1.3 万辆车。出租车正文写 1.4 万辆、每 30 秒一条状态,状态里多一位表示是否载客;图 2.3 和第 5 章写成 1.5 万辆。私家车来自按里程计费的车载保险定位,全部车辆超过 29.3 万,其中 1 万辆在深圳。摘要把车辆规模写成 3.7 万辆:若按 1.4 万出租车、1.3 万公交和 1 万深圳私家车相加,正好是 3.7 万。支付这边,第 2 章写深圳地铁自动售检票有 8 条线、215 座车站、每日 400 万用户;公交售检票覆盖 1.3 万辆车,但只能看见刷卡乘客,看不见付现金的人。地铁刷卡同时有进站和出站,公交刷卡只有上车,车站要靠车辆定位来补。
这些记录的粒度本来就不一样。导论用车载定位大约 5 到 15 秒一次、手机连接大约 1 到 10 小时一次,说明两套系统不能直接放进同一个格子;深圳出租车则明确是 30 秒一条。基站覆盖常用泰森多边形(Voronoi partition)近似,地铁站的覆盖更接近乘客愿意走的距离,出租和私家车又常用方格。后面的人口模型要先处理这种格子不一致。
外部参照有四类。Worldpop 提供 100 米格网人口。兴趣点(point of interest,PoI)共 542115 个,先分成居住、办公、教育、交通、休闲 5 类,再细到 17 个小类。OpenStreetMap 上深圳有 72676 条道路、总长 10711 公里;论文说明这个长度高于政府公布的里程,因为开放地图计入支路,并把对向车道分开。异常分成预期和意外:演唱会、考试、消防演练属于预期,事故、设备故障、地铁延误属于意外。意外事件从深圳交警微博按路况或事故关键词抓取,再按关键词分成 1 到 3 级并做地理编码;样例日期在 2016 年。论文没有给出异常事件的总条数。
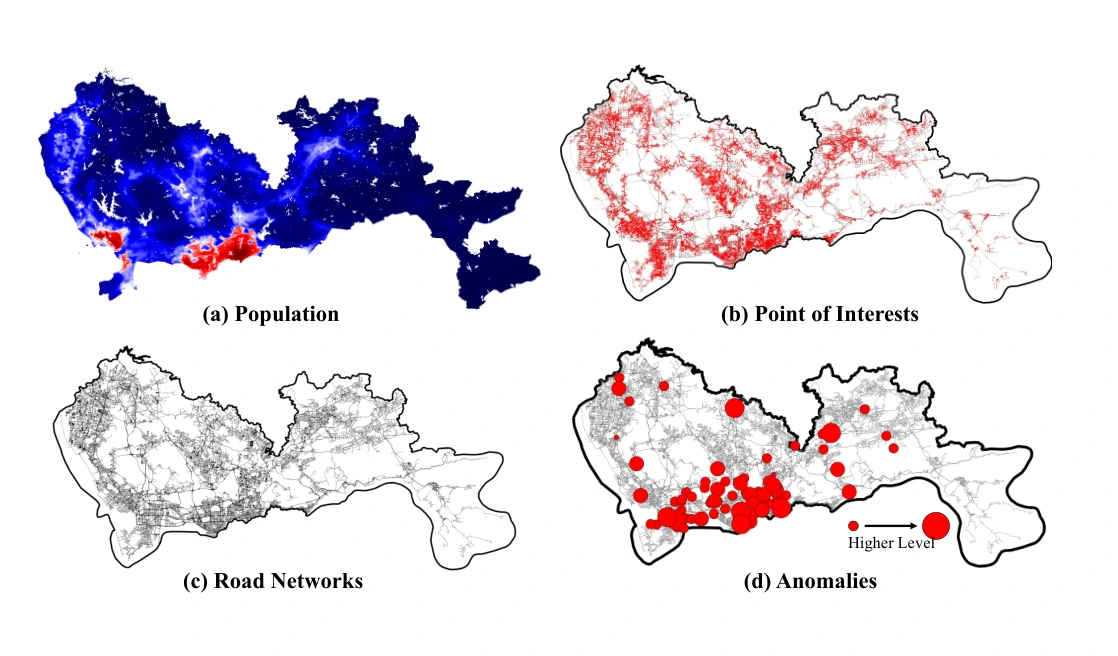
图 3|解释移动之前,城市本身的参照长什么样?
(a)人口,中心商务区更密。(b)兴趣点。(c)道路。(d)异常,圆越大表示等级越高。四张图都是空间参照,不是某一次出行的轨迹。来源:学位论文 Fig. 2.5。
一家手机网络的使用负荷,离全市有多远?
既有研究常常用一家运营商的呼叫详单(call detail records,CDR)代表一座城市的手机用户。深圳三家网络的基站策略和用户群体不同,这个代替会偏。论文用代表性距离(representativeness distance)把偏差写成一个 0 到 1 的数。
做法是:把一家网络的负荷和三网合计负荷都做最小–最大归一化,再寻找缩放系数 α,使两条曲线在同一地区、同一时段上的最大差距尽可能小。这个最小的最大差距就是 θ。用最大差距而不是平均差距,是为了保留每一对时空位置的比较,并给出差的上界。θ 小,表示单网负荷更能按比例贴近三网合计。负荷在这里是通话或上网记录的数量,不是出行次数。
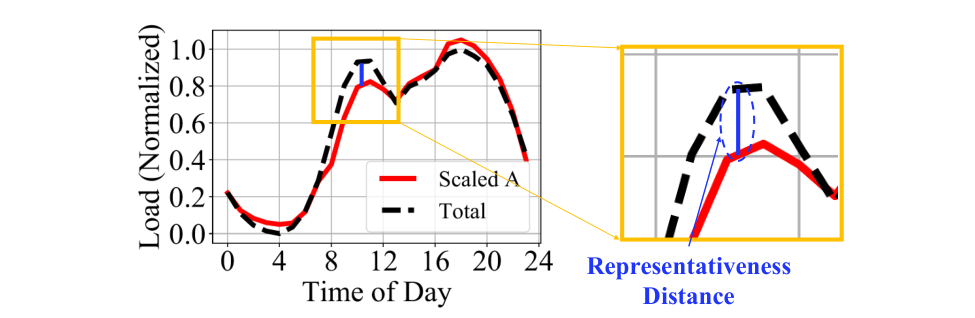
图 4|代表性距离量的是哪一种差距?
无字母子图。左图红线是缩放后的网络 A,黑虚线是三网合计,横轴是一天中的时刻,纵轴是归一化负荷。右图把局部放大,蓝色竖向差距标成代表性距离。这是定义示意,不是 491 个地区的汇总结果。来源:学位论文 Fig. 3.4。
空间单元有两套。单网使用自己的泰森多边形。跨网比较则用与网络无关的普查分区。第 3 章用 491 个行政区,平均面积 4.06 平方千米;第 4 章写 496 个行政区,平均面积 3.973782 平方千米,标准差 6.075980 平方千米。两章的分区数不一样,后文保留各自的分母。时间先切成 10 分钟,一天 144 段。
若 θ 不超过容忍阈值 ε,这家网络在该地区或该时段算有代表性。据此分成三组:每家网络都有代表性的全代表,至少一家有代表性的部分代表,以及没有任何一家有代表性的无代表。
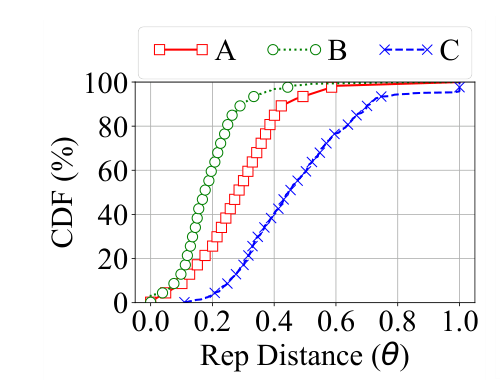
图 5|哪一家网络的负荷更接近三网合计?
无字母子图。横轴是代表性距离 θ,纵轴是 491 个行政区上的累积比例。绿线网络 B 最靠左,红线 A 居中,蓝线 C 最靠右。B 更接近全市负荷;这还不是人口估计误差。来源:学位论文 Fig. 3.5。
图 3.1 用小区数量解释覆盖差异:按正文对图的描述,三网盖满全市所需的小区数不同。图 2.2 印出的小区数是 A 最多、C 最少,图 3.1 的曲线也是 C 更早盖满全市、A 最晚。第 4 章计算平均小区面积时却使用接近正文的基站数,并给出 A、B、C 的平均小区面积 53 万、64 万和 38.5 万平方米,全市面积写为 1991 平方千米。两套基站数不能同时成立。图 3.2 则表明,同一个人口估计模型换三家网络的数据,地区级平均绝对百分比误差的分布并不重合,B 和 A 总体好于 C。
论文把空间差异和三类语境放在一起看。兴趣点多样性用 17 个小类的信息熵,熵高的地区代表性距离更低。人口更密、出行需求更高的地区,距离也更低。出行需求指数是从该地区出发的行程数除以人口,行程来自四套交通系统,这样地区面积和人口规模不会直接当成需求。以 ε 等于 0.2 分组后,兴趣点比例如下。
| 组别 | 居住 | 交通 | 办公 | 休闲 | 教育 |
|---|---|---|---|---|---|
| 全代表 | 0.18 | 0.23 | 0.21 | 0.22 | 0.16 |
| 部分代表 | 0.14 | 0.26 | 0.28 | 0.20 | 0.12 |
| 无代表 | 0.30 | 0.18 | 0.13 | 0.18 | 0.21 |
比例是组内五类兴趣点的份额。全代表组最大的份额是交通 0.23,休闲 0.22 紧随其后;部分代表组最大的是办公 0.28;无代表组最大的是居住 0.30。论文概括为全代表和部分代表更偏交通与办公、无代表更偏居住。表内数字比这句概括更细。
时间上,三家网络都在大约 9–10 时、16–17 时和 20–21 时出现距离高峰。A 和 B 的距离低于 C。
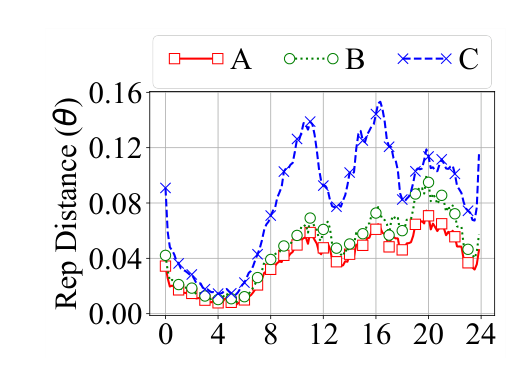
图 6|代表性会不会在通勤时段变差?
无字母子图。横轴是小时,纵轴是代表性距离。蓝线网络 C 的三个高峰明显高于红线 A 和绿线 B。论文概述把高峰相对下午 1 时的差距概括为代表性低约 50%,图上没有印出这两个时刻的距离读数。来源:学位论文 Fig. 3.11。
和时间上的分组相比,空间分组要到更高的 ε 才出现大量全代表地区。论文因此认为空间差异更大,校正主要从空间下手。出租车和公共交通的起讫点分布也更支持这个方向:起讫点熵低的时段,乘客更集中地往返于少数地区,全代表时段的移动熵更高。一周之内,工作日的代表性距离大于周末,高峰又大于非高峰。这些是相关,不是证明兴趣点或通勤造成了运营商的市场份额。
四个地点把这个格局看清楚:机场、火车站、中心商务区和一片居住区。
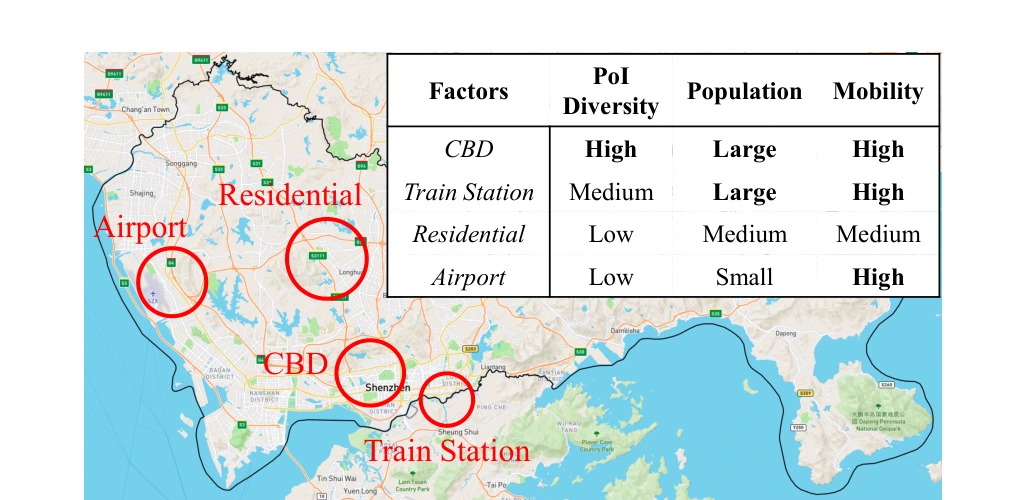
图 7|功能单一的地方,单网为什么更不像全市?
无字母子图。地图标出四个地区,表中用高、中、低和人口规模概括兴趣点多样性、人口与移动。中心商务区三项都高或大,机场的兴趣点多样性低、人口规模小、移动仍高。来源:学位论文 Fig. 3.16。
半径 1 公里内,A、B、C 的基站数是:机场 2、2、1,居住区 25、17、13,火车站 38、30、27,中心商务区 58、56、30。半径 2 公里内分别是 17、20、11,84、55、47,134、109、101,以及 164、178、92。代表性距离最高的是机场,最低的是中心商务区。离中心越远,距离通常下降,因为圈进来的功能更多;中心商务区周围仍是市中心,所以下降不明显。这仍是四个选定地区的案例,不是随机抽样。
只有一家网络的数据时,抽样能不能更像全市?
校正模型 SysRep 的约束很具体:手里只有一家网络,再加上公开的人口、兴趣点和出行,不能调用另外两家网络来改数。目标是在抽样比例 α 下选出一批网格,使这些网格的语境多样性最大,并且每个普查区至少保留一个网格。
多样性被写成五种地区功能的分布:办公、居住、教育、交通、休闲。功能不是只看静态兴趣点。同一网格工作日可以更像办公,周末可以更像休闲。论文用主题模型把网格当成文档、把功能当成主题、把出行矩阵当成词、把人口和兴趣点当成文档的附属信息,主题数设为 5。然后用贪心挑选:每个普查区先放进熵最高的网格,再不断加入让整体熵增加最多的网格,直到记录条数达到 α 乘以全部记录。
评估时的真值是三网合计负荷,论文称它覆盖 100% 的手机用户。对照有两个。Single 使用三家里代表性距离最低的那一家的全部原始数据。均匀抽样在方法段叫 CellSam,图上标为 SysSam。指标仍是 θ,越低越好。
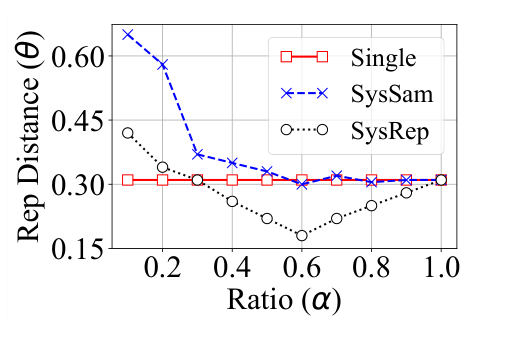
图 8|少用一些记录,会不会比用完整家网络更接近全市?
无字母子图。横轴是抽样比例 α,纵轴是代表性距离。红线 Single 维持在约 0.31。黑线 SysRep 在比例 0.6 附近降到约 0.16,比例继续升高后又回到接近 0.31。蓝线均匀抽样从更高的距离下降到同一水平。来源:学位论文 Fig. 3.21。
正文写,SysRep 把代表性距离从平均 0.31 降到 0.16,而且单网 30% 的样本就能达到和该单网全量数据相近的代表性。图上的形状把这两句分开了:大约 0.3 的比例已经靠近 Single 的 0.31,0.16 出现在 0.6 附近;把一家网络的记录全部用上,距离又回到单网本身的偏差。A、B、C 要让距离低于 0.2,抽样比例分别要到 0.5、0.6 和 0.7。网格细到 100 米时,这个校正最好。
贡献概述另写:60% 的样本平均能使单网代表性提高 45.8%,摘要把同一改进写成 45%,第 2 章还出现过 30%。0.31 到 0.16 是图 3.21 旁边的读数;45.8% 没有在评估段写成由这两个距离相除。这里同时保留概述中的 45.8% 和图上的 0.31、0.16,不把它们算成同一个百分比。
人口估计用来看这个距离有没有用。模型是已有的语境感知人口估计,参照是 Worldpop,指标是平均绝对百分比误差(mean absolute percent error,MAPE),也就是各地区绝对百分比误差的平均。代表性距离越大,MAPE 越高。校正之后,MAPE 从 25.8% 降到 15.4%,相对降幅 40.3%,对照是 Single;图上 SysRep 也位于均匀抽样的左侧。
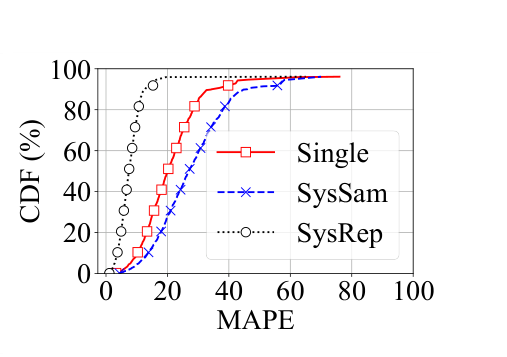
图 9|代表性提高之后,人口估计误差降到多少?
无字母子图。横轴是 MAPE,纵轴是累积比例。点线 SysRep 最靠左,红线 Single 居中,蓝线均匀抽样更靠右。正文给出的整体比较是 25.8% 到 15.4%,图上没有逐条标出每个地区的误差。来源:学位论文 Fig. 3.25。
贡献概述还写,高代表性使人口估计误差低 58.2%。评估段没有给出构成这个百分比的两个误差值。能和公式对上的人口结果,是上面这组 25.8% 与 15.4%。方法段说校正还会用到移动性建模这一项应用,正文给出的误差数字是人口 MAPE。
这一章的负荷真值是三网合计,人口应用的参照才是 Worldpop。两套参照不能互换。数据经过机构审查,运营商把电话号码换成序列号,分析停在基站和聚合结果。论文用这个说明结果不能追溯到个人;本文不讨论任何把序列号对回具体的人的做法。局限也很明确:只有一座城市的三家网络。作者认为中国其他城市使用同样三家运营商,所以结果可能有参考意义,但论文没有做第二座城市的检验。
三家网络叠起来,人口格子能细到什么程度?
单网人口模型默认自家用户能代表全市居民。深圳的数据不支持这一点。496 个行政区里,用户数最多的网络减去最少的网络,差值可以很大。网络 A 在 249 个区占优,B 在 67 个区占优,C 在 180 个区占优,三者相加等于 496。占优地区没有形成一块整齐的城市功能分区。把三家记录直接加总,仍会继承各家基站划出来的地盘。
空间也粗。按第 4 章的基站数,三网在 1991 平方千米里分别约有 3585、2977 和 5174 座塔,平均小区 53 万、64 万和 38.5 万平方米。论文希望的人口粒度是 100 米格网,也就是 1 万平方米。市中心大约占全市面积的 20%,三网在那里有 2578、2057 和 3605 个小区,平均仍有 14 万、18 万和 10 万平方米。单网还覆盖不了全部手机用户。三网一起,论文写覆盖 100% 的手机用户、96% 的人口。
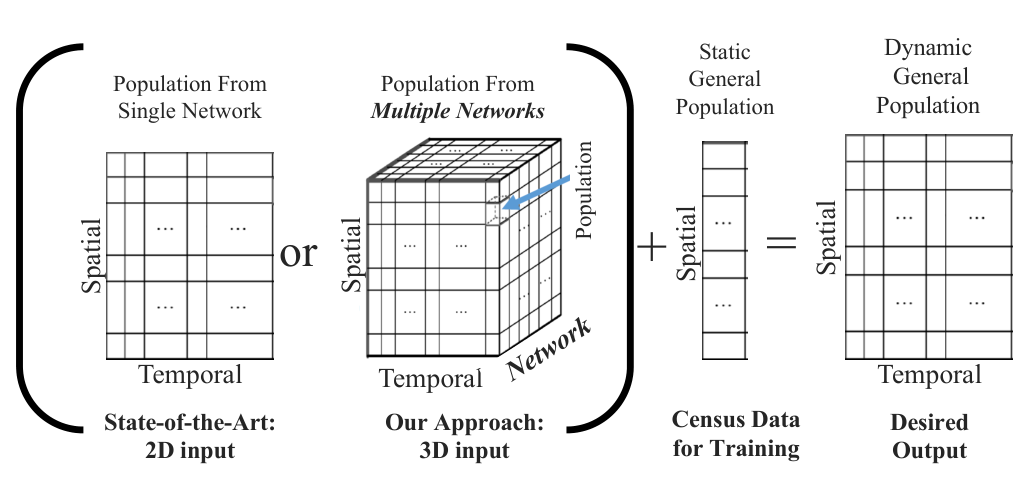
图 10|多一家网络,多出来的是哪一个维度?
无字母子图。左侧是单网的空间×时间矩阵,中间是再加上网络维度的立方体,右侧用静态普查人口换出随时间变化的人口。图解释输入维度,不报告误差。来源:学位论文 Fig. 4.6。
MultiCell 分三步。每家网络先按自己的基站做泰森多边形。再把这些多边形相交,相交小片叫子区(subcell)。用户仍留在原来的小区边界里,只是一个大小区被其他网络切成几块。示意里两网相交产生 15 个子区,图上画出 7 个。
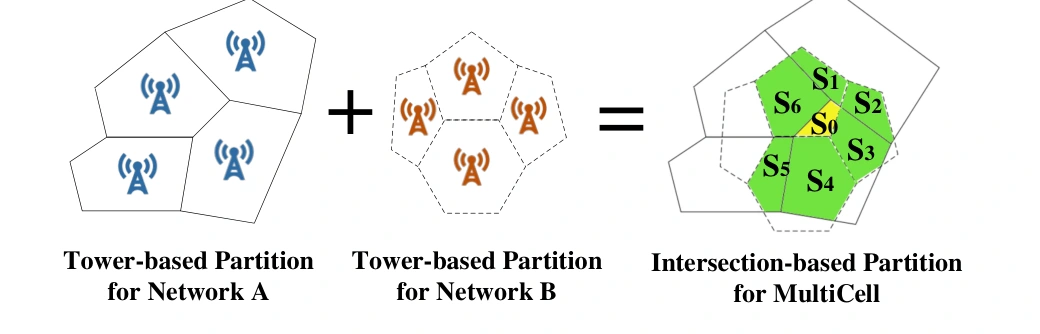
图 11|为什么不把所有基站合成一张新的泰森多边形?
无字母子图。左、中是两家网络各自的小区,右侧绿色小片是相交子区,示意标注 S0 到 S6。它保留原来的覆盖边界。真实深圳使用三家网络,不是图中的两家。来源:学位论文 Fig. 4.8。
若把 11746 座塔合成一个虚拟网络再重划泰森多边形,平均小区面积是 0.166 平方千米,但每座塔的原始覆盖被改掉了。MultiCell 不走这一步。深圳三网实际切出 41794 个子区。市中心 36057 个子区,平均面积 1.1 万平方米,论文写这比单网大约细 10 倍,并接近 1 万平方米的目标。市中心比郊区更碎。
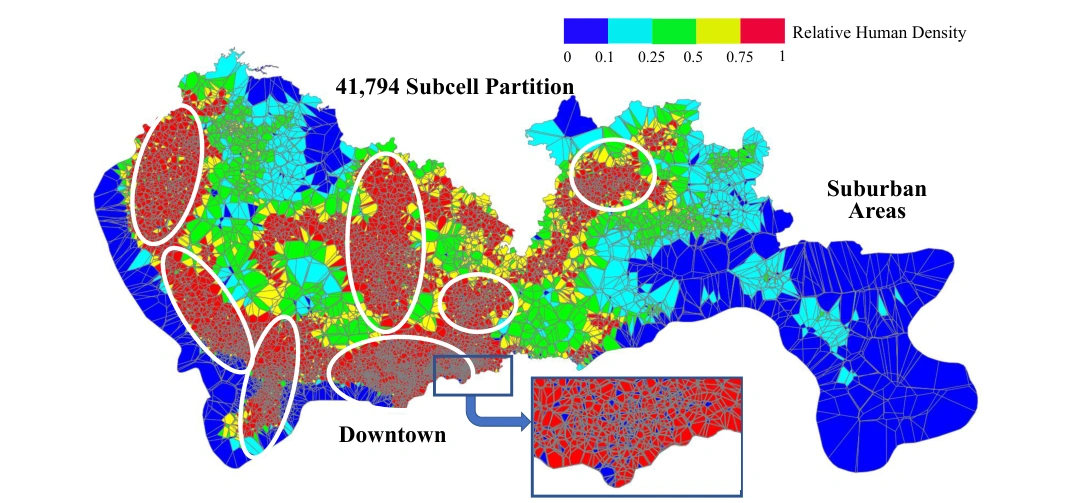
图 12|相交之后,细格子集中在城市的哪一部分?
无字母子图。颜色表示相对人口密度,白圈标出若干商业片区,蓝框放大市中心。图上写明 41794 个子区。郊区仍是较大的蓝色多边形。来源:学位论文 Fig. 4.13。
人口估计也分两段。第一段把小区用户分到子区。兴趣点在小区内并不均匀,所以不用平均摊开,而用高斯滤波,并在 5 分钟这种短时段借用该子区最近一个有用户的时段。第二段把活跃用户数 U 换成一般人口 G,关系是 G 等于 α 乘以 U 的 β 次方。α 和 β 随子区、时段和网络变化。
困难在于,每个小时并没有一份新的人口普查。Worldpop 只有空间、没有一天中的时刻。已有的语境感知模型按兴趣点把地区分成 7 类,用同类地区互相提供训练样本,类别是居住、娱乐、商业、工业、教育、景点和郊区。MultiCell 在此之外让网络互相提供下一时段的人口目标:用另一家网络上一时段估计的人口,更新这一家当前时段的 α 和 β,再用这一家刚到达的用户数算出新人口。同一座城市在同一时刻的总人口被假定相同,各家网络的活跃用户可以不同。因此,后一时段的人口目标来自模型估计,不是新的实地清点。
误差下降,对照的是哪一张人口图?
训练用 2010 年 Worldpop,评估用 2015 年 Worldpop。2015 年图的总人口是 1069.83 万,格子是 100 米。湖泊等不可达格子被标成 −999,只含这类格子的子区被去掉。和静态夜间人口比较时,使用的是晚上 8 时到 12 时的手机记录。
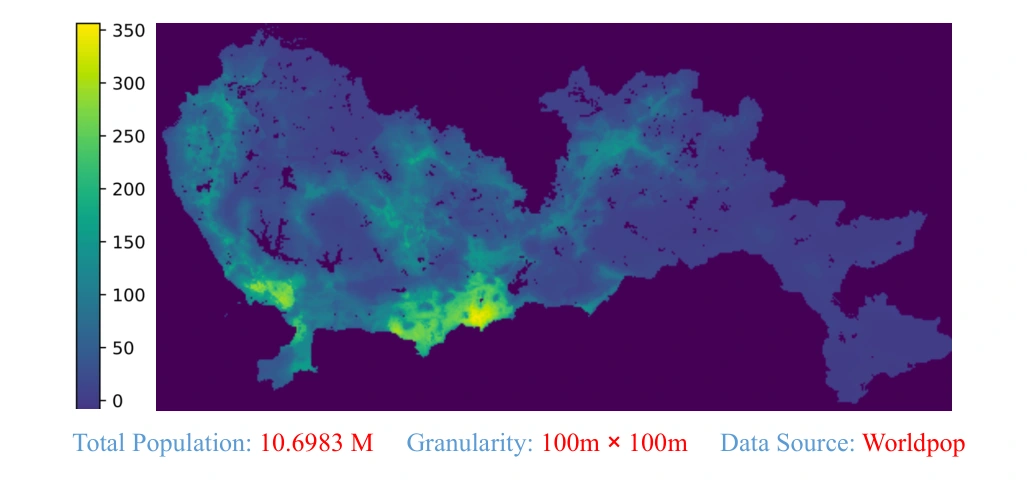
图 13|人口模型的参照,本身是一张什么样的图?
无字母子图。颜色表示 100 米格网人口,图例大约从 0 到 350。图下写明总人口 1069.83 万,来源 Worldpop。这是评估参照,不是 MultiCell 的输出。来源:学位论文 Fig. 4.22。
指标有两个。相关系数越高越好。归一化均方根误差是各子区误差平方均值的平方根,再除以参照人口的均值,越低越好。论文有一处把两个指标都说成越高越准;这句话只适用于相关系数。
五个基线都来自语境感知人口估计。CAPE-A、CAPE-B、CAPE-C 分别只用一家网络。CAPE-V 是改变覆盖范围的虚拟网。CAPE-S 是在对齐后的子区上把三网用户相加的共享网。MultiCell 与共享网使用同样的三网和对齐子区,差别是跨网络更新参数。
正文给出的平均结果是:归一化均方根误差比这五个基线分别低 28%、23%、44%、33% 和 17%,相关系数分别提高 14%、11%、25%、18% 和 9%。提高的百分比没有说明是相对增幅还是百分点。虚拟网因为改了基站覆盖,可以差于单独的 A 或 B。共享网好于单网,因为它看见更多用户并保留原始覆盖,但没有像协同训练那样跟上时间变化。单网里 C 最差,论文归因于拿到的数据质量,后续细项比较不再单列 C。
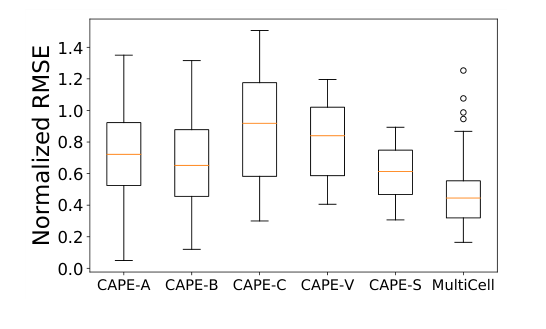
图 14|和单网或简单合并相比,误差箱线落在哪里?
无字母子图。纵轴是归一化均方根误差,越低越好。MultiCell 的箱子低于 CAPE-A、B、C、虚拟网和共享网,同时仍有高误差离群点。箱线没有逐个标出中位数,28% 等降幅来自正文的平均比较。来源:学位论文 Fig. 4.25。
散点图进一步说明偏差的方向。CAPE-A 在原本人口高的子区容易估高,CAPE-B 在这些子区略估低,MultiCell 更均匀地分布在参照两侧,高人口处仍略偏高。2010 与 2015 两张 Worldpop 之间的归一化均方根误差是 0.189599,相关系数是 0.99293。两张图都表示夜间人口,而且非常相似。模型若只是重绘一张稳定的夜间格局,也会得到很高的相关。论文同时指出,呼叫记录让模型有能力表现 10 分钟尺度的变化;这个能力要靠后面的交通客流相关来侧面查看,而不是靠两张静态图互相证明。
人口规模会改变增益。性能增益是基线与 MultiCell 的均方根误差之相对差。人口低于 10 的子区里,MultiCell 持平或更差;人口从 10 到 10000 的子区里,相对 CAPE-A、CAPE-B、虚拟网和共享网的增益是 27.3%、29.1%、28.6% 和 16.9%。摘要和章末说的 27%,靠近这组人口区间上的增益,并不是前面五个整体降幅的平均数。
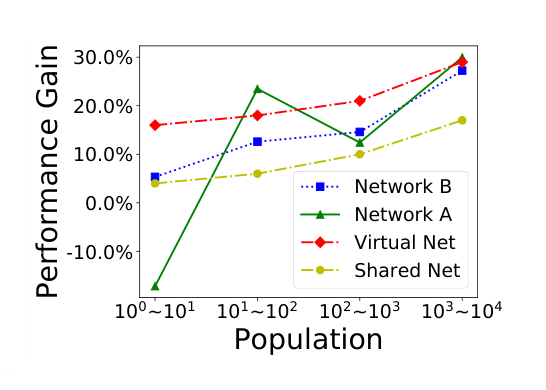
图 15|人少的子区里,多网融合还更准吗?
无字母子图。横轴是子区人口区间,纵轴是性能增益。人口 1 到 10 时,网络 A 的增益为负;人口更高时四条线为正,共享网的增益最低。图中的点不是正文那四个汇总百分比本身。来源:学位论文 Fig. 4.29。
格子变粗、时间变长,与静态 Worldpop 的吻合会更好。区级聚合时论文称估计人口几乎与参照相同,原因是大范围里个体移动的随机性被平均掉。时间从 5 分钟放到 10 分钟、1 小时、6 小时和 24 小时,误差下降,但放到更长之后改善变慢。论文把 10 分钟或 1 小时看成实时用途和误差之间的折中。默认比较仍是 5 分钟、子区尺度。因此,区级“几乎相同”不能当成 5 分钟子区已经点清人口。
实时人数没有直接真值,所以论文再用交通客流做间接检查。出租车是 1.4 万辆、日客流 46 万;公交是 1.3 万辆、976 条线路、日客流 430 万;地铁评估使用 127 座车站、日客流 140 万。论文又写这三套系统每天捕获 1050 万乘次、650 万人次。46 万、430 万和 140 万相加是 616 万,与 650 万不是同一个合计数,这里同时保留分项和论文给出的合计。127 座车站、140 万日客流,也不同于第 2 章的 215 座车站、400 万日用户。地铁站落入 496 个行政区中的 122 个,覆盖 286.216 平方千米。
相关随运营时间起伏,而不是一天都很高。地铁在早晚高峰、系统开行时相关高,非高峰低。出租车凌晨相关低,因为车辆和乘客都少,模型里的一般人口仍然高;白天到前半夜更高。公交从大约 5 时起相关上升,到深圳早高峰结束的 9 时前后转降,晚高峰再升,大约 23 时线路停运后再降。这些是估计人口与客流的相关系数,客流只包括进入交通系统的人。
等车和乘车分开以后,异常打在哪一段?
人口图仍然回答不了一次行程慢在哪里。MAC 把出行时间拆成步行、等待和乘车,并在出租车、公交、私家车和地铁上比较。私家车基本没有等车,主要看乘车。出租车和公交同时看等待与乘车。地铁的站内步行差异被论文视为较小,大站除外;福田站靠近火车站,有 12 个入口,入口之间的步行差不能忽略,入口可由闸机编号区分。
等待并不小。两个大客流地铁站之间,乘车占了大部分时间,等待和步行的波动更大。全部地铁行程里,等待平均占全程 16%。
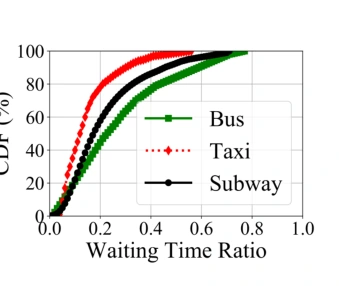
图 16|等待超过全程两成的行程有多少?
无字母子图。横轴是等待占全程的比例,纵轴是行程的累积比例。红线出租车、黑线地铁、绿线公交。正文读出的三个比例是:出租车 20% 的行程、地铁 40% 的行程、公交 57% 的行程,其等待超过全程的 20%。来源:学位论文 Fig. 5.3。
四套系统的需求形状也不一样。图 5.4 和图 5.5 里,公交和地铁有两个通勤高峰,出租车需求在晚间明显上升。论文据此认为,通勤者更常用公共交通或私家车,机场和火车站的访客更多使用出租车。单看一种方式,会把这座城市的出行目的看窄。
地面等待用 50 米格网估计,全市分成 1800×920 个格子。出租车的等待上界,来自先后两辆还能载客的车经过同一地点的时间差,再按排队需求平均;公交则用同一线路前后两辆车的间隔。这是路侧等待的上界,不是每个乘客的秒表时间。地铁把同一对车站上最短的刷卡行程当作没有等待的流畅时间,其余行程多出来的时间记为等待。中间站的步行由经过该站的三条流畅行程相消得到,乘车时间再从总时间里减去等待和两端步行。这里使用的是行程记录之间的时间差,不涉及把匿名编号对回具体的人。
录像用来检查等待推断。一周内记录了 1181 名地铁乘客和 677 名公交乘客。福田地铁站 8:30–9:30、17:30–18:30 和 13:30–14:30 三段图覆盖其中 241 人。推断值相对回归中心的平均均方根误差是 0.829 分钟。福田公交站的图覆盖 138 人。公交案例的精确率是 96.8%,定义是观察到的等待落在估计上界之内;论文没有写明分母是 677 人还是这 138 人。地铁等待更整齐,因为乘客等的是同一班车;公交乘客等的是不同车辆。
日常形态里,地面等待的工作日和周末差别主要在 17 时左右。市中心、机场和火车站等得更久。工作日高峰约 18.9% 的公交不能按时刻表运行。地铁相反:高峰等待更短,因为运营商加开列车、缩短间隔;高峰乘客即使拥挤也会上车,非高峰的工作日乘客更可能等下一班,所以非高峰工作日等待长于周末。地铁站的一周等待模式用 k 均值分成 4 类。地面乘车时间在工作日高峰明显变长,周末高峰移到大约 11 时和 17 时。同一对地铁站之间的乘车时间在工作日和周末几乎不变,周末行程却更长,论文解释为周末出行更分散、距离更远。这是行程长度的分布差异,不是同一批通勤者在周末走得更慢。
异常下的延误定义成有异常时的时间减去无异常时的时间。意外异常对等待和乘车的影响大于预期异常。相对公交和出租车,地铁在预期事件中延误更低,在意外事件中更高,因为停线或改时刻表会改变整条系统。出租车在演唱会这类预期事件中等待增加更多;公交推断假设车辆能装下全部乘客,所以公交等待延误主要来自路况。事故中出租车等待增加更少,论文认为出租车更容易绕行。地面三套系统共用道路,乘车延误的变化相似,其中出租车更稳,公交更不稳,因为公交线路固定,出租车司机也更熟悉绕行。地铁站内或站旁的异常很少改变地铁乘车时间,所以乘车延误的累积图没有单列地铁。
2016 年热带风暴 Nida 是一个极端例子。延误按出行时间的相对差计算。
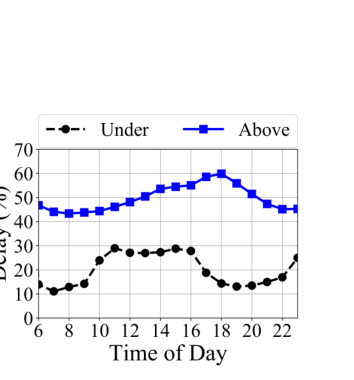
图 17|同一场风暴,地面和地下的延误一样大吗?
无字母子图。横轴从 6 时到 22 时,纵轴是延误百分比。蓝线是地面,黑线是地下。正文写地面系统的出行时间增加约 40% 到 70%,地下也有延误但更低。来源:学位论文 Fig. 5.6。
预测使用两层长短期记忆网络。输入包括异常发生后已经观察到的延误、距异常发生的时间、异常类别和等级,以及地点上的 Worldpop 人口、五类兴趣点和四类道路。类别特征先做嵌入。评估是 5 折交叉验证,每折用 1 折作测试。误差是 MAPE:100 乘以各次绝对百分比误差的平均,分母是测试折里观察到的延误。对照有三组。ARIMA 只看此前若干时段的延误,并按异常等级和类别分组,不使用人口与路网。MLE 在异常区域及周围拟合多元正态,用期望最大化估计。MAC− 取三个不完整长短期记忆模型中最好的一个,三个模型分别缺少空间信息、缺少异常信息,或两者都缺。
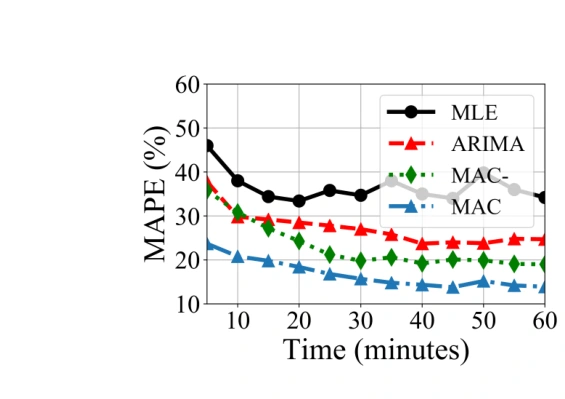
图 18|异常之后,哪一种模型的乘车延误误差更低?
无字母子图。横轴是异常发生后的分钟,纵轴是 MAPE。蓝线 MAC 低于黑线 MLE、红线 ARIMA 和绿线 MAC−。前几分钟四条线都更高,大约 30 分钟后时间序列模型变平。图上没有标出摘要中的 31%。来源:学位论文 Fig. 5.45。
正文写,前 5 分钟最差,原因是异常位置、等级和路况还不确定,而且刚发生时可供模型使用的延误观察很少。半小时后基于时间序列的模型稳定下来。等待延误的曲线形态相似,误差大于乘车。四个系统里,出租车的预测误差最低,地铁最高;意外异常造成的大范围客流变化不容易被少量观察抓住。只比较地面系统时,出租车最好,公交最差,因为更多出租车充当了传感器。私家车只预测乘车时间,所以在地面系统的乘车延误里误差最小。图 5.47 和图 5.48 用箱线表示系统和异常类别的差异,预期异常的误差低于意外异常。
第 5 章开头写延误预测准确率 86.5%。摘要写 MAC 比已有方法降低 31% 的预测误差。评估段定义并作图的指标是 MAPE,没有写明 86.5% 或 31% 对应哪一个系统、哪一分钟、哪一个基线。图 5.45 只能支持 MAC 的曲线低于三个对照,不能单独读出这两个百分比。
讨论里的判断需要跟图放在一起。拆开等待和乘车,才能看见异常打在哪一段。意外异常的影响大于预期异常。讨论还写异常对地下系统的影响大于地面系统;风暴图和等待延误的分位数更细:风暴中地面延误更高,地铁是在意外事件中延误更高、在预期事件中更低。不能把讨论中的一句概括成每一次异常都让地铁比地面更慢。论文同意公开一天的出租车定位、一天的地铁刷卡和一天的公交定位,私家车数据不公开;这是论文中的约定,不是本文确认这些文件已经可以下载。分析使用的是合作方匿名化之后的记录。
这些比较能说到哪一步
单套传感器看见的是自己的用户、自己的格子和自己的计费动作。代表性距离说明,把一家手机网络的负荷缩放之后,仍可能在某些地区和高峰时段离三网合计很远。多样性抽样能在只有一家网络时缩小这个距离,但 0.16 是相对三网合计负荷的距离,而且抽样比例太高时会把单网偏差重新带回来。
MultiCell 的 27% 到 44% 这些降幅,分母是其他人口模型的误差,参照是 2010 年训练、2015 年评估的 Worldpop,主比较使用晚上 8 时到 12 时的手机记录。2010 与 2015 两张夜间图的相关系数已经是 0.99293。交通相关能看到早晚高峰,却不是独立的人数清点。人口低于 10 的子区里,多网模型并不更准。
MAC 的等待时间,地面是上界,地铁是相对最短行程的差。录像检查集中在站点案例,0.829 分钟和 96.8% 都不能换成全市乘客的平均误差。31% 和 86.5% 出现在摘要和章首,评估图没有把它们标成某个坐标点。
全部结果来自深圳。基站数、出租车数量和地铁车站数在不同章节或图注里并不一致,使用任一规模时都要带上它的出处。论文把个人行程预测留作后续工作;这篇里的人口和出行时间都是集体量。
一句话总结
一家城市传感器可以把自己的用户测得很密,但深圳这 8 套系统放在一起才说明:全市的人怎么移动,要先承认每套记录的偏差,再在能核对的参照上把人口格子和出行时间拆开。
核心来源
- Zhihan Fang,Human Mobility Modeling Based on Heterogeneous Urban Sensing Systems,罗格斯大学计算机科学博士学位论文,2020 年 5 月,ProQuest 编号 27742963。学位论文没有印 DOI。本文的数字、图和局限都来自这篇全文。
- 正文图使用 Fig. 2.1、Fig. 2.2、Fig. 2.5、Fig. 3.4、Fig. 3.5、Fig. 3.11、Fig. 3.16、Fig. 3.21、Fig. 3.25、Fig. 4.6、Fig. 4.8、Fig. 4.13、Fig. 4.22、Fig. 4.25、Fig. 4.29、Fig. 5.3、Fig. 5.6 和 Fig. 5.45。其余图按图号在对应证据处说明。
- 学位论文参考文献把代表性校正和出行时间两部分列为作者相关工作:CellRep,The Web Conference,2020;MAC,Proceedings of the ACM on Interactive, Mobile, Wearable and Ubiquitous Technologies,2019。参考文献条目没有印 DOI。本篇解读依据学位论文正文。
作者介绍
- Zhihan Fang:这篇学位论文的作者,罗格斯大学计算机科学博士,2020 年 5 月毕业于新泽西州新不伦瑞克。题名页写明论文在 Desheng Zhang 指导下完成,致谢称 Zhang 为导师和教授,并写 Fang 参加 ARSENAL 研究组。论文没有给出作者毕业后的任职,这里不补充。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一座城市只能购买一家运营商的数据,这篇结果更支持购买“多样网格上的一部分记录”,而不是默认全量记录更像全市。图上的距离在抽样比例 0.6 附近降到 0.16,全量又回到 0.31,说明多出来的记录会把这家网络自己的地盘重新加回来。值得单独检验的是:在一家运营商基站特别偏、另外两家并不互补的城市里,0.31 到 0.16 的下降还会不会出现。深圳的网络 A 与 C 被论文描述为互补、B 更接近全市,这个结构本身可能就是下降的条件。
人口精度还需要一个白天的、而且没有被当作输入的计数。2010 与 2015 年两张夜间 Worldpop 的相关系数是 0.99293,模型只要重绘稳定的夜间格局,晚上 8 时到 12 时的相关就会好看。公交、出租和地铁的相关会随班次起伏,这已经说明模型不是完全静止的;可是客流相关仍然不是留在家里或走在人行道上的人数。下一次评估可以留出某一小时的进站量,并且不把它同时写进特征。
导航若只缩短车上的时间,会漏掉乘客真正站着等的那一段。地铁等待平均占全程 16%,公交有 57% 的行程等待超过全程的 20%,而地铁高峰的等待反而因为加开列车变短。建议所有人躲开高峰,可能把一部分人从较短的高峰等待,推到更长的非高峰等待。把等待和乘车分开报告,并写明异常是预期的活动还是意外的事故,才和这篇论文已经分开的证据相一致。