在圣地亚哥,女性的活动地点为什么更少,也更集中?
论文名片|Laetitia Gauvin、Michele Tizzoni、Simone Piaggesi、Andrew Young、Natalia Adler、Stefaan Verhulst、Leo Ferres、Ciro Cattuto,Gender gaps in urban mobility,Humanities and Social Sciences Communications,2020,7:11。DOI:10.1057/s41599-020-0500-x。收稿日期 2019 年 11 月 14 日,接收日期 2020 年 5 月 12 日。这是一篇把通话详单、人口普查、公交站点和兴趣点放在一起的观察研究。
这不是某两个人的日记。把 2016 年 5 月 1 日到 7 月 30 日的圣地亚哥想成一张大约一公里见方的网格:手机一通话,人所在的格子就被记上一笔。三个月下来,女性用户平均到过 28.48 个格子,男性平均到过 37.05 个。最容易想到的解释有两个。一是女性打电话更少,格子也就被看见得更少。二是她们只是更愿意待在附近。前一个解释经得起直接检查:只保留每天通话更多的人之后,核心地点的差距更大;去掉男性最多一半通话之后,女性的熵仍然更低。后一个解释只覆盖了距离更短这一部分。差距的大小还与收入、就业、生育率、家庭户数和车站一起变化。这些是市镇和网格上的共变;要辨认哪一种生活约束造成了少去的格子,需要别的研究设计。
先说结论
- 在筛过的 418,624 名用户里,三个月的不同网格数女性平均 28.48、男性平均 37.05,男性减女性为 8.57(95% 区间 [8.42, 8.72])。相对女性这 28.48 个格子,男性多出约 30%。只数覆盖 80% 通话的核心格子时,女性 4.79、男性 6.92,差 2.13(95% 区间 [2.09, 2.16]),相对女性均值多出约 45%。
- 女性的移动熵比男性低 0.26(95% 区间 [0.26, 0.27]),平均回转半径短 1.09 公里(95% 区间 [1.07, 1.12])。女性日均通话 4.73 次,男性 5.21 次;只保留日均至少 3 次通话的用户后,核心格子的差距扩大到 2.73(95% 区间 [2.68, 2.79])。
- 已知社会经济分组的有 315,844 人。从最富裕的 ABC1 到最低的 E 组,熵差由 0.19 增到 0.31,回转半径差由 0.83 公里增到 1.36 公里。ABC1 里核心格子仍然差 1.66 个。51 个至少有 1,000 名用户的市镇中,对数 GSE 比与熵的男女比半偏相关为 −0.59。
- 家所在网格里至少有一个 Transantiago 车站时,女性核心格子平均多 0.76 个(95% 区间 [0.51, 1]),男性多 1.39 个(95% 区间 [1.05, 1.72])。有车站的网格再按收入四分位比较,论文给出的 Q4 与 Q1 之间,女性还少 1.53 个核心格子(95% 区间 [1.29, 1.78])。
- 33 类兴趣点里,偏离最大的是出租车、医院和商场,图上的点数分别是 51、131 和 32。女性到访格子周围这三类设施更密。这是格子与设施的距离,不是进门记录。
约 21.5 亿条通话里,最后数的是哪些人?
原始材料是 2016 年 5、6、7 月的匿名通话详单,只有通话,没有短信或上网记录,共 2,148,132,995 条。保留的号码要同时满足四条:名下只有一条线路,三个月里平均每天至少打出一次电话、合计至少 91 次,能判断家所在的格子,并且到过两个以上不同格子。筛完是 418,624 人,其中 51% 为女性。社会经济分组已知的是 315,844 人。后面按收入分组的差值,分母是这 315,844 人。
运营商按开户资料给出女或男。研究默认这个登记性别就是打电话的人,也默认通话所在的格子能代表这个人的移动。论文用智利很高的手机普及同时支撑这两点,依据是 GSMA 2020 的全国数字:2,750 万移动连接,渗透率 153%,独立用户渗透率超过 90%,为拉丁美洲最高。这组数字的分母是全国连接和独立用户。样本里的开户人与实际使用人没有逐条核对。年龄没有进入数据,年龄造成的通话和出行差异也就没有被分开。
地点精确到基站,但坐标只保留到小数点后两位。城区一千三百多个基站因此并成 726 个大约 1 平方公里的格子,后文的地点就是这些格子。家是 91 天里晚上 7 点到次日早上 8 点通话最多的那个格子。少于 3 个不同号码的基站不进入报告。离开运营商系统的是按性别汇总的指标,原始个人记录不公开。
普查用的是智利 2017 年全国人口普查:17,574,003 人和 6,499,355 户。空间分析收在圣地亚哥大都市区。论文写这个都会区近 700 万居民,约占全国人口 40%。相关分析实际进入的是其中至少有 1,000 名手机用户的 51 个市镇;普查提取范围写的是 52 个市镇。地图着色则是国家统计研究所划定的城区,30 个市镇。近 700 万、52、51 和 30 是四套不能互换的空间或人口口径。
少去的是所有格子,还是每天真正反复出现的格子?
一个人的移动在这里用四件东西描述,每件都先在个人层计算,再按性别取平均。
不同地点数,是三个月里至少有过一次拨出或接听的格子数。核心地点数,是把格子按这个人的通话量从多到少累加,直到盖住 80% 通话的那些格子。移动熵写成 S = −Σ pl ln pl,pl 是这个人在格子 l 的通话次数除以本人全部通话。熵高,表示通话在多个格子之间分得更匀;熵低,表示更集中。回转半径是这些格子离开本人访问频率加权中心的典型距离,单位是公里。四件东西都来自通话发生的位置。摘要里说女性把时间在地点之间分得更不平均;正文的计算用的是通话份额,没有另一套停留时钟。
全部格子的男女差是 8.57 个。核心格子的男女差缩小到 2.13 个,但相对差距更大:6.92 相对 4.79,约是 1.45 倍,论文据此说男性的核心地点比女性多出约 45%。回转半径只在正文给出差:女性平均短 1.09 公里。男女各自的平均半径写在补充表里,正文没有列出。熵差是 0.26。女性在自己最常去、次常去的格子上通话占比更高,从第三常去的格子开始,女性对男性的占比比值反过来。
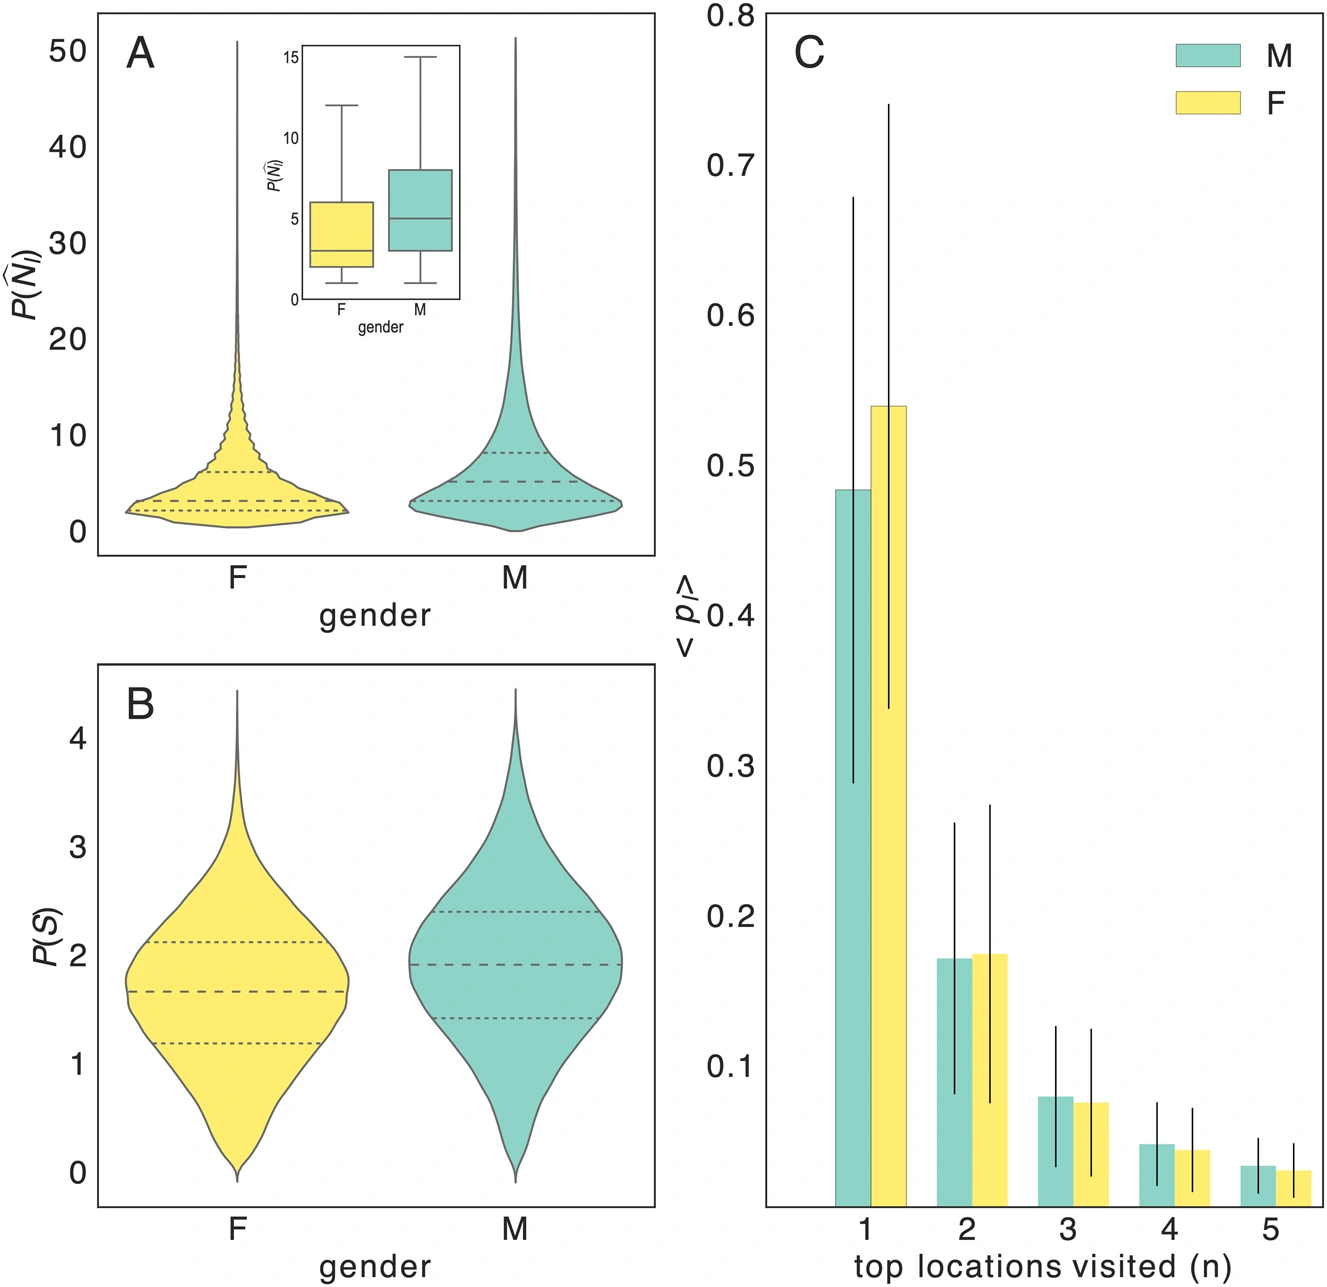
图 1|女性少去的格子,是长尾里的偶尔到访,还是每天的核心地点?
(A)纵轴是核心地点数的分布,黄为女性,青绿为男性。内嵌箱线的须是 95% 参考范围,离群点不画。分布右偏,所以箱线中位低于正文的均值 4.79 和 6.92。(B)纵轴是移动熵。女性的分布整体更低,对应熵差 0.26。(C)横轴是每人前五个最常去的格子,纵轴是这些格子的平均通话占比,误差线是均值的标准差。女性在第 1、2 位更高,从第 3 位起低于男性。来源:原论文 Fig. 1。
打电话更少,能不能解释少去的格子?
同一样本里,女性平均每天 4.73 次通话,男性 5.21 次。论文称这是每天的通话次数,没有再拆成打出和接听。若地点差完全由通话次数推动,男性多出来的格子会在通话被削齐之后缩小。
检查做了两层。第一层只留三个月里平均每天至少 3 次通话的人,其中女性仍占 51%。这一层的人数正文没有给出。核心地点差变成 2.73,95% 区间 [2.68, 2.79],比全样本的 2.13 更大,区间更窄。第二层从男性的通话里去掉最多 50%,再重算所有人的熵。女性的熵仍然显著更低。去掉之后的新熵均值正文没有列出。
时间窗口也换过。把观察切成一段段 9 天分别计算时,同一批人的熵和到访地点数保持稳定,Pearson r = 0.81,p < 10⁻³。这个相关系数衡量的是前后窗口是否像同一个人,不是性别差距。女性与男性在一天 24 小时里的通话分布也很接近,所以熵差不容易被收成“女性只在某几个小时打电话”。逐小时曲线同样在补充图里。
分组越往低收入走,差值怎样变?
社会经济分组来自用户办手机时提交的工资单,按智利市场研究协会 AIM 的标准分成 AB、C1a、C1b、C2、C3、D、E。表 1 把最上面几档合成 ABC1,再单独列出 C2、C3、D、E,从高到低。每一格都是男性均值减女性均值,方括号是 95% 区间。各组有多少人,正文没有列出。
| 分组 | 熵差 | 核心地点差 | 全部地点差 | 回转半径差(公里) |
|---|---|---|---|---|
| ABC1 | 0.19 [0.17, 0.20] | 1.66 [1.53, 1.79] | 7.28 [6.72, 7.82] | 0.83 [0.75, 0.90] |
| C2 | 0.23 [0.22, 0.24] | 2.08 [1.99, 2.18] | 8.54 [8.14, 8.95] | 0.94 [0.88, 1] |
| C3 | 0.28 [0.27, 0.29] | 2.50 [2.40, 2.59] | 10.16 [9.78, 10.53] | 1.15 [1.09, 1.21] |
| D | 0.30 [0.30, 0.31] | 2.53 [2.45, 2.61] | 10.22 [9.87, 10.53] | 1.26 [1.21, 1.32] |
| E | 0.31 [0.29, 0.33] | 2.50 [2.32, 2.66] | 9.82 [9.16, 10.48] | 1.36 [1.25, 1.47] |
从 ABC1 到 E,熵差和回转半径差逐步变大。核心地点差和全部地点差在 D 组最大,分别是 2.53 和 10.22;E 组略回到 2.50 和 9.82。论文用两端比较概括这个趋势:核心地点差从 ABC1 的 1.66 到 E 组的 2.50。最富裕一档并没有变成 0。ABC1 的女性仍然比同档男性少 1.66 个核心格子、少 7.28 个全部格子、短 0.83 公里。
地图上用的收入比是另一套合并。较高收入一侧是 AB、C1a、C1b、C2,较低收入一侧是 C3、D、E。GSE 比等于较低收入居民数除以较高收入居民数。论文把分界大致放在家庭年收入 100 万智利比索,并注明约合 1,500 美元。这是正文给出的近似门槛。C2 在表 1 里单列,在这张地图的高收入分母里又和 ABC1 算在一起。
画到市镇上,差距和哪些普查数字同向?
男女比用的是同一个市镇里、家在该地的女性均值除以男性均值。熵的男女比记为 RS,核心地点的男女比记为 R。比值低于 1,表示女性的平均指标更小。计算时控制了男女通话活跃程度的差别,以及市镇之间性别构成的差别。
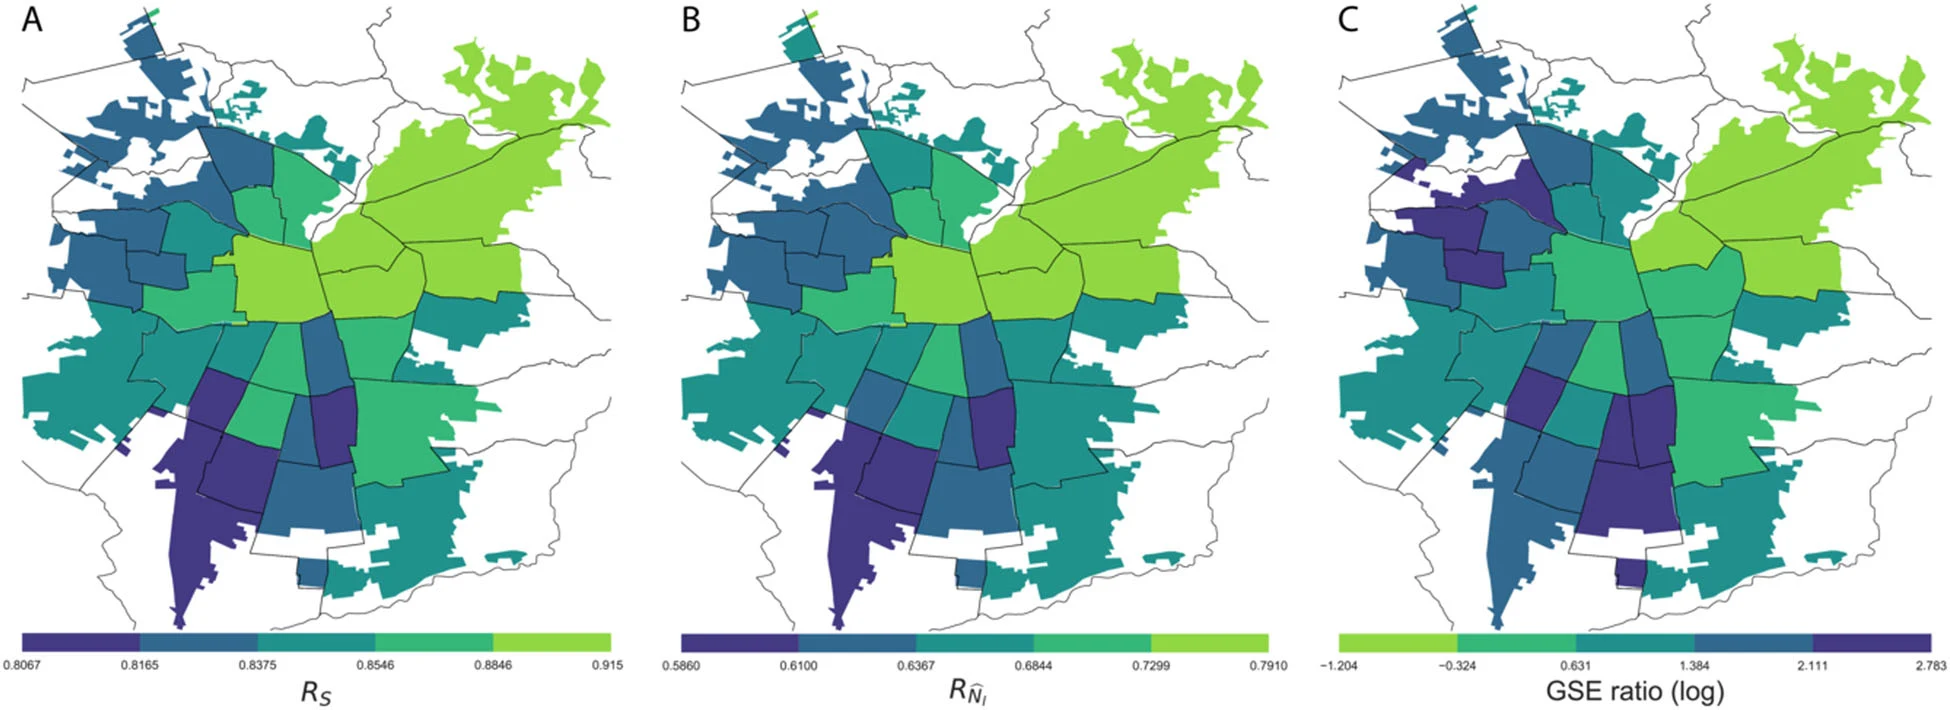
图 2|城区 30 个市镇里,移动上的男女比和收入比是不是同一张格局?
(A)颜色表示熵的男女比 RS。色标大约从 0.81 到 0.915,右端最高刻度是 0.915,整段低于 1。绿色更高,紫色更低。(B)颜色表示核心地点的男女比,色标大约从 0.59 到 0.791,同样全部低于 1。(C)颜色表示 GSE 比的对数,大约从 −1.2 到 2.8;这条色带的方向与前两图相反,比值越高越偏紫。黑线是市镇界,着色范围是统计机构界定的城区。来源:原论文 Fig. 2。
图上的绿色市镇,移动男女比更高,也更接近 1,但色标没有画到 1。论文把 GSE 比较低的较富裕市镇主要写在西北,把东、南外围写成高 GSE 比、居民更穷的一侧。可以确定的是三张图的相对方向:GSE 比高的地方,两个男女比更低。地图段落给出的 −0.59 和 −0.53,与下面这张表里对数 GSE 比那一行相同。表本身写明样本是 51 个市镇,并使用对数后的 GSE 比。
下面每一行都是该普查指标与男女比的半偏 Pearson 相关,样本是 51 个市镇。每一行单独控制通话差异和用户性别分布,各行之间没有再互相控制。括号里的 p 值门槛对应原表的星号:一颗星是 p < 0.05,两颗星是 p < 0.01,三颗星是 p < 0.001。没有括号的系数,原表没有标星号。
| 市镇指标 | 与熵的男女比 | 与核心地点的男女比 |
|---|---|---|
| 对数 GSE 比 | −0.59(p<0.001) | −0.53(p<0.001) |
| 人类发展指数 HDI | 0.42(p<0.01) | 0.37(p<0.01) |
| 初等教育性别比 | 0.00 | −0.05 |
| 中等教育性别比 | 0.24 | 0.34(p<0.05) |
| 高等教育性别比 | −0.08 | −0.10 |
| 就业性别比 | 0.51(p<0.001) | 0.37(p<0.01) |
| 一般生育率 | −0.53(p<0.001) | −0.40(p<0.01) |
| 夫妻户 | 0.55(p<0.001) | 0.50(p<0.001) |
| 扩展家庭户 | −0.61(p<0.001) | −0.57(p<0.001) |
| 核心家庭户 | −0.30 | −0.14 |
| 单亲户 | −0.32(p<0.05) | −0.32(p<0.05) |
| 单身户 | 0.56(p<0.001) | 0.44(p<0.01) |
就业性别比的定义是:女性就业人数除以女性总数,再除以男性就业人数除以男性总数。它和 RS 的相关是 0.51。在 RS 低于 1 的情况下,就业性别比越高,熵的男女比越高,差距越小。一般生育率是出生数除以 15 至 49 岁女性人数再乘 1,000,与 RS 的相关是 −0.53:生育率越高,熵的男女比越低。
教育三行里,有 p 值门槛的只有中等教育性别比与核心地点男女比的 0.34。初等教育、高等教育,以及中等教育与熵的 0.24,原表都没有标星号。三级教育的关联并不一样。
家庭变量在方法里写的是户数。夫妻户是户主与伴侣、没有孩子;扩展家庭户是核心家庭再加其他亲属;核心家庭户是户主、伴侣和子女;单亲户是户主与子女;单身户只有户主。讨论里又把它们说成比例。表下没有写已经除以该市镇总户数。系数描述的是这些户数与男女比的共变。扩展家庭户的 −0.61 和 −0.57 是表中绝对值最大的一档;单身户是 0.56 和 0.44,方向相反。核心家庭户的 −0.30 和 −0.14 没有星号。
论文把扩展家庭和较高生育率读成照护责任可能落在女性身上,并把单亲户设想为多半是单亲母亲。分组定义本身没有按户主性别拆开。另一套检查是把用户随机分进这 51 个市镇、只保持各市镇的性别构成,重复 1,000 次。正文说这套零模型与半偏相关的画面一致,具体零模型系数在补充表里。
HDI 出现在表中,与两个男女比分别为 0.42 和 0.37。方法部分列举普查变量时没有给出它的计算公式,这里只保留系数。
家门口有车站,差距会一起消失吗?
公交使用 Transantiago 的站点坐标,包括有轨电车、公共汽车和地铁。一个网格算有公交,只要其中至少有一个站。比较单位是格子,不是个人:每个点是该格居民的平均核心地点数。有站与无站的差,是两类格子的居民均值之差。格子有没有站并不是被随机安排的,市中心、密度和收入都会跟站点叠在一起。
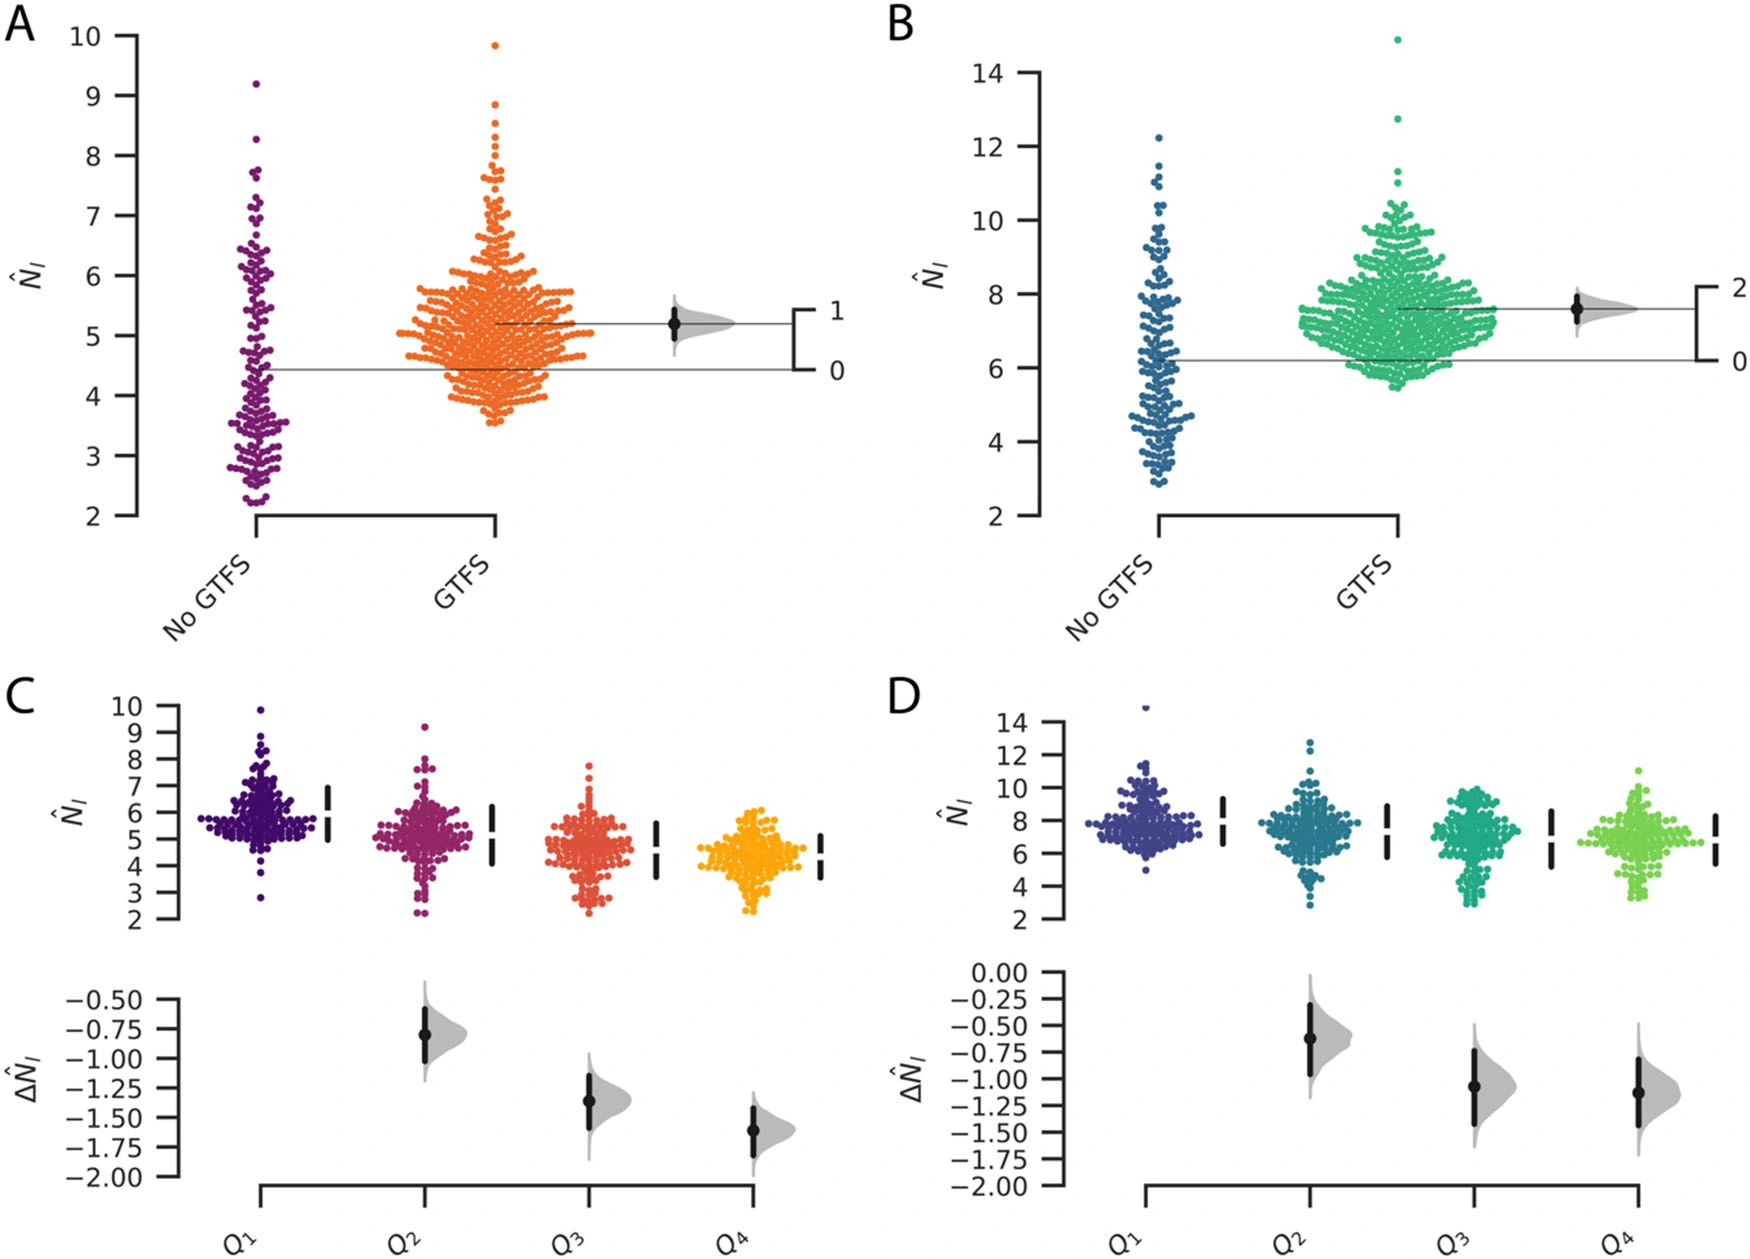
图 3|有车站的格子里,女性和男性的核心地点各多出多少?
(A)女性。紫点是家所在格没有车站,橙点是有车站。右侧是两组均值差的分布。(B)男性。蓝点是没有车站,绿点是有车站,右侧同样是均值差。正文的差是女性多 0.76 个、男性多 1.39 个。(C)只保留有车站的格子,再看女性。从左到右是 Q1 到 Q4,下方是相对 Q1 的差,Q1 自己没有差值分布。(D)同样的四分位,对象换成男性。来源:原论文 Fig. 3。
有车站时,女性核心地点平均增加 0.76,95% 区间 [0.51, 1];男性增加 1.39,95% 区间 [1.05, 1.72]。两个增量的比是 1.39 / 0.76,约 1.8,分母是女性这一组的增量。车站对应着两边都更多的核心格子,男性增加得更多。
下排只留有车站的格子,再按四分位看收入。论文写出的对比是:标成 Q4 的女性比 Q1 平均少 1.53 个核心地点,95% 区间 [1.29, 1.78];男性少不到 1 个,95% 区间 [0.51, 1]。图注说四组是收入从高到低。正文又把 Q4 称为 GSE 比最低的四分位、把 Q1 称为最高四分位。按前面的定义,GSE 比低才是较低收入居民相对较少、也就是更富裕的一端。收入从高到低,和 GSE 比从低到高,会把 Q1 与 Q4 指到相反方向。图上 Q4 的核心地点更少,讨论则把较低收入写成女性在有公交时仍然受到的限制。1.53 这个差可以核对,两种排序标签不能合成一个已经分清的收入梯度。Q2、Q3 的差值正文没有写成数字。有车站和无车站的格子各有多少,正文也没有给出。
私家车用普查另分两组:每 4 名居民多于 1 辆车,以及达不到这条线。有车比例更高的格子,女性和男性的核心地点都更高。只看更可能有车的格子时,男性在不同 GSE 比四分位之间的地点差小于女性。这句是方向。具体差多少画在补充图里,正文没有像公交那样给出 0.76 这种均值差。
女性更常出现在哪类设施旁边?
兴趣点不能证明人进了门,也不能证明人是为了这个设施才来。它只描述到访格子周围有什么。研究先把每一类设施做成一张密度图,再用高斯核在不同距离上平滑,然后对一个人到过的所有格子取平均,最后分别对全部女性和全部男性取平均。性别密度比等于女性这一侧的平均密度除以男性这一侧。大于 1,表示女性到过的格子更靠近该类设施。
设施共 33 类。其中 28 类来自 OpenStreetMap 的 amenity,且在圣地亚哥至少有 50 处。另外加上商场、地铁站、合乘出租车 colectivos,以及两张用来对照的合成层:真实基站位置,和没有空间结构的均匀格网。商场可以少于 50 处,因为它来自商场用地多边形里的基站,不受那条 50 处门槛约束。经纬度被重新标度,使 0.01 度在东西和南北都大约等于 1 公里。横轴是平滑距离的十进对数。log10 d = −2.5 大约是 300 米,图上的竖线放在这里,因为再短就会碰到基站坐标本身的分辨率。
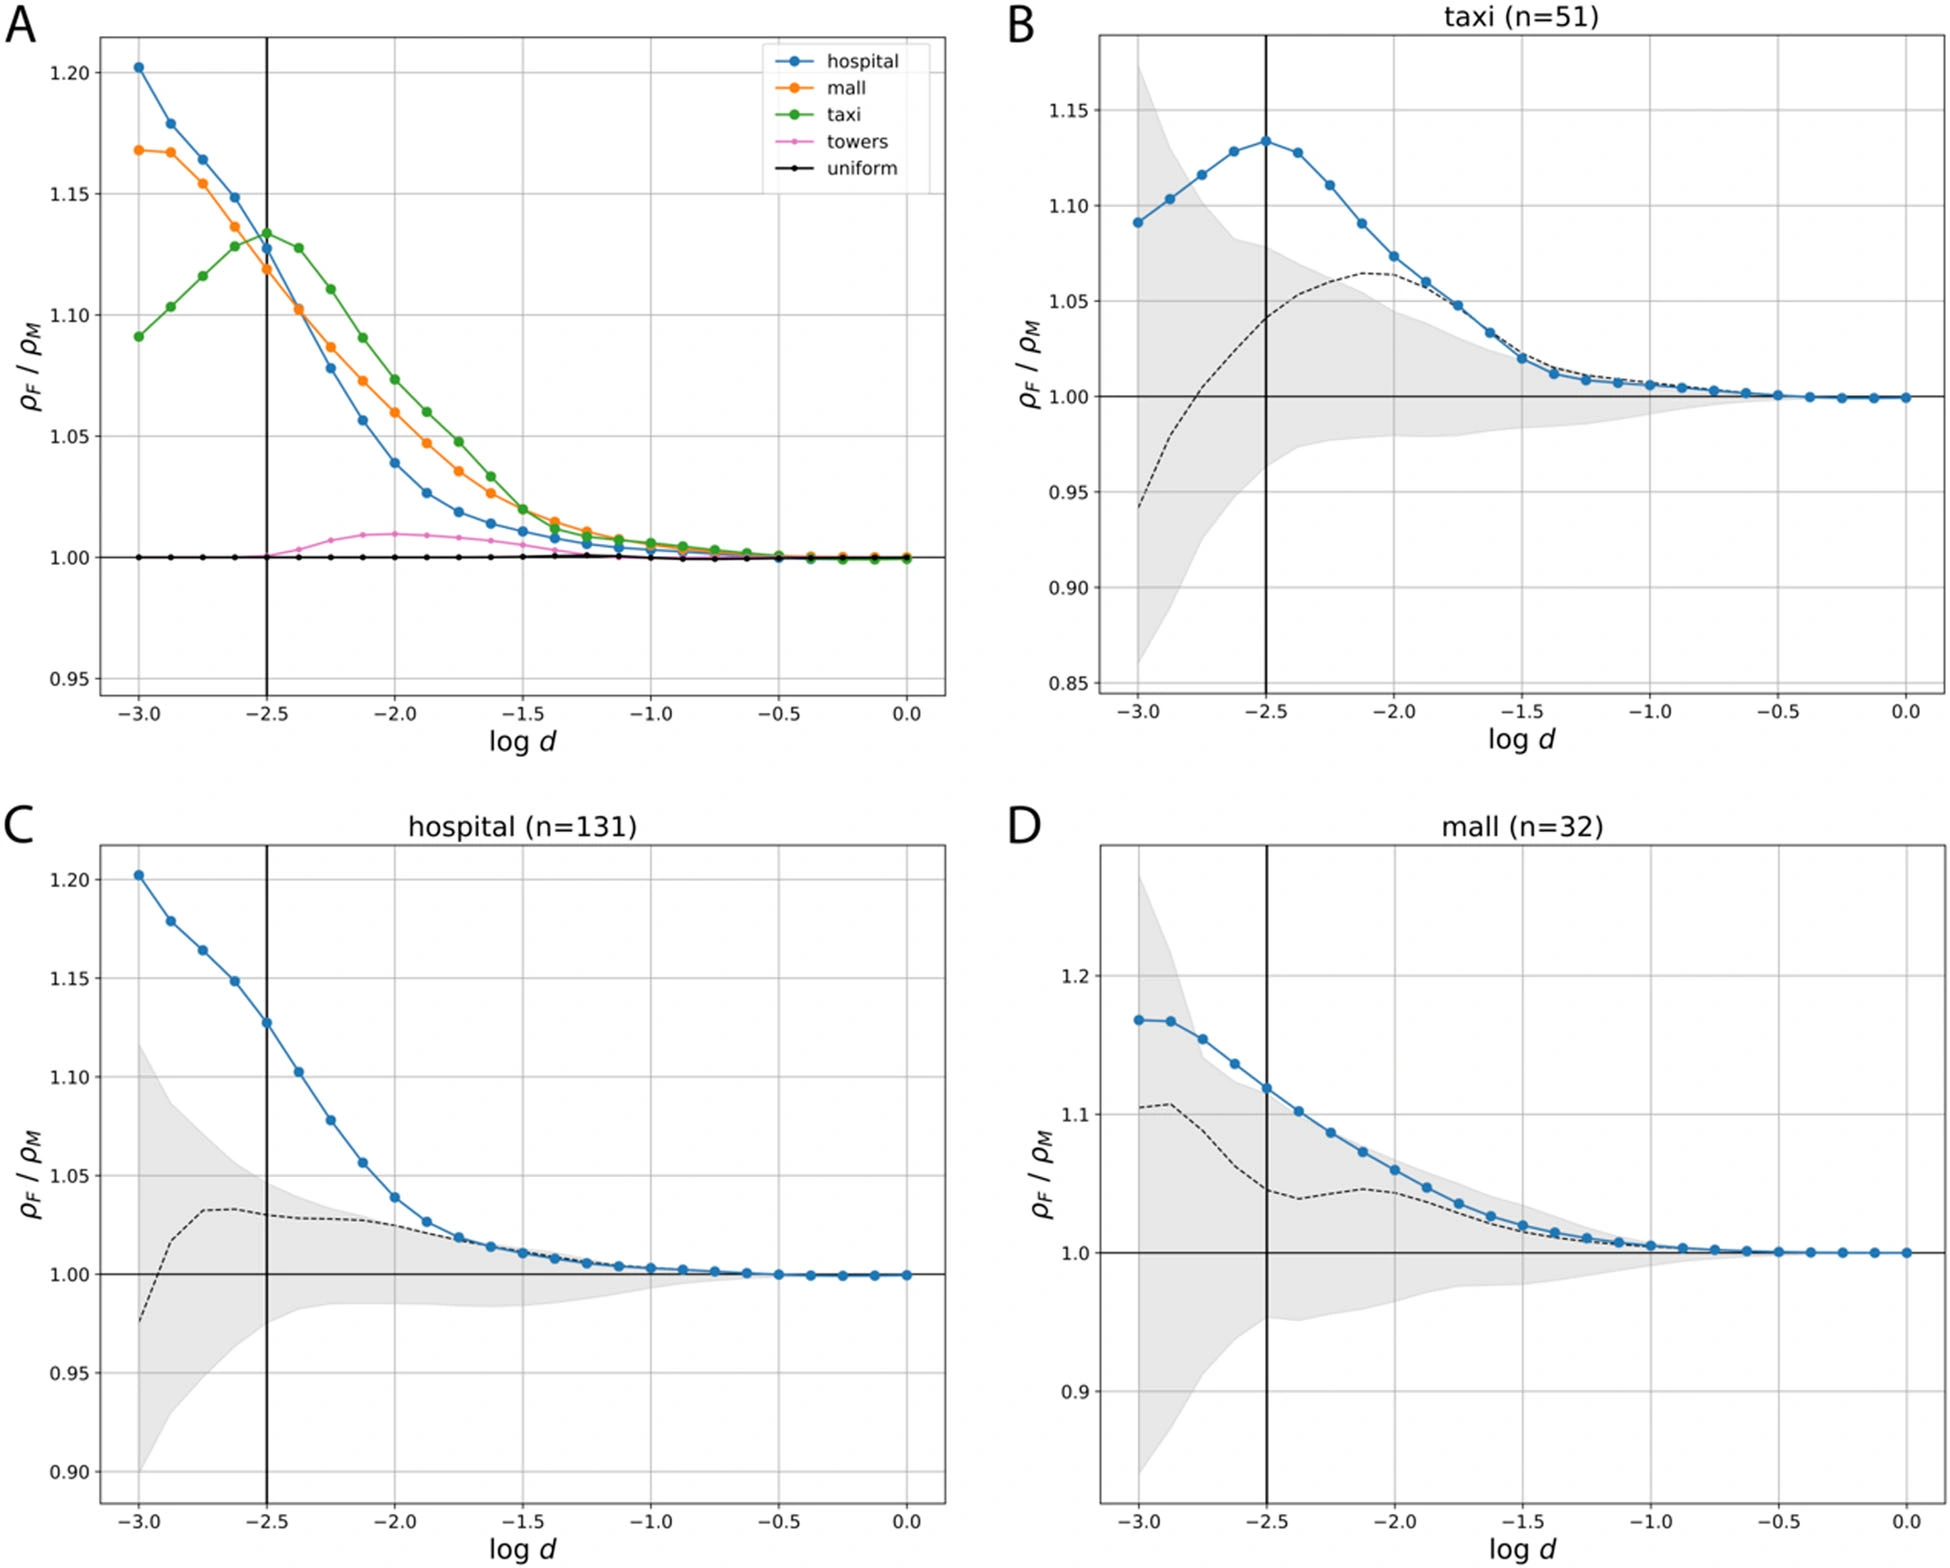
图 4|哪些设施旁边,女性相对男性的密度比离开了 1?
(A)医院、商场、出租车、基站和均匀格网五条线。短距离上前三条明显高于 1,距离拉长后回到 1 附近。基站只有轻微偏离,均匀格网停在 1。竖线在 log10 d = −2.5。(B)出租车,标题中的 n = 51,是这类点的个数。灰带是按到访概率随机抽取同样数量基站、再做 100 次位置扰动后的 95% 区间;虚线是把原始点的经纬度各加减 0.01 度。(C)医院,n = 131,读法与(B)相同。(D)商场,n = 32,读法与(B)相同。三类观察到的曲线在竖线附近留在灰带之外,扰动后的虚线回到灰带并靠近 1。来源:原论文 Fig. 4。
距离很大时,女性和男性的密度都变成盖住全城的一个大包,比值回到 1。这个极限不能用来比较设施。有信息的是中等距离:医院、商场和出租车的比值高于零模型,而且不是把点随便挪一格还能保留的结果。正文还报告,这三类图层彼此只有很弱的空间相关,偏离也不是因为女性在这些格子里打了更多电话;把格子限制到离家 5 公里以外、并且不是工作地点之后,比值仍然偏高。弱相关的具体系数、工作地点的判定步骤,以及其余类型的整条曲线,正文都没有再列数字。讨论建议医院附近的偏离可能对应女性承担更多照护。那是对结果的一种猜测。数据里没有出行目的。
这些关联停在哪里?
通话格子少于真实走过的路。一个人可以在同一个一公里格子里接送、买菜、去诊所,核心地点数仍然是 1。熵描述通话如何分到这些格子,不描述格子内部的停留。女性若更多把几件事连在短距离里完成,这种指标会把她记成移动更少。
登记性别、线路使用人和年龄是三道没有被数据解开的口子。样本在市镇尺度上是否贴近人口、性别比和社会经济结构,作者说对照显示代表性较高,那张对照不在正文。各组 GSE 的人数也没有印在正文,因此表 1 的区间不能换算成全市女性中有多少人属于 E 组。
51 个市镇上的相关,每一行只控制了通话和性别构成。就业、生育、扩展家庭和收入比会彼此重叠。扩展家庭户与熵的男女比,绝对值 0.61,大于生育率那一格的 0.53。这只说明单独看时共变更强。它还没有在去掉收入之后仍成立。有车站的格子多出来的 0.76 和 1.39 个核心地点,来自有站格子与无站格子的居民均值对比。站点并没有被随机修到家门口。
兴趣点比值大于 1,表示到访位置更靠近该类设施。它不统计进门,也不区分是本人就医、陪同,还是只是路过后被一次通话记下来。研究范围是圣地亚哥都会区 2016 年 5 月到 7 月。正文期望类似的性别差别也会出现在其他城市,依据是别的八个城市的出行调查。那次跨城比较用的是调查,不是这份通话数据的重复。
一句话总结
在这批圣地亚哥通话记录里,女性平均到过的格子更少、通话更集中、活动半径更短;差距在低收入分组和市镇里更大,车站和私家车都没有把它抹平,医院、商场和出租车站旁边的到访也更偏女性。这些结果标出共变出现的位置;要辨认单一原因,还需要别的研究设计。
核心来源
- Humanities and Social Sciences Communications 正式页面,核对题目、作者、2020 年卷 7 文章号 11 与 DOI。正文图 1 至图 4、表 1 和表 2 都来自这一版本。
- 论文数据可用性说明:可应要求提供按基站、按性别汇总的平均移动指标及复现文档;其他研究者也可申请在 Telefónica 服务器上运行查询。原始个人计数不能公开,也不能离开运营商监控的服务器。
作者介绍
以下只根据论文上的署名单位和贡献说明。Gauvin 与 Tizzoni 为同等贡献,通讯作者是 Gauvin。
- Laetitia Gauvin:意大利都灵 ISI 基金会。参与设计、执行、分析数据和写作。
- Michele Tizzoni:ISI 基金会。参与设计、执行、分析数据和写作。
- Simone Piaggesi:ISI 基金会,以及博洛尼亚大学数据科学与计算博士项目。参与执行和分析数据。
- Andrew Young:纽约大学治理实验室(The Governance Lab)。参与设计和执行。
- Natalia Adler:署名为纽约的 UNICEF。参与设计、执行和写作。
- Stefaan Verhulst:纽约大学治理实验室(The Governance Lab)。参与设计、执行和写作。
- Leo Ferres:智利 Universidad del Desarrollo 数据科学研究所,以及圣地亚哥 Telefónica 研发部门。参与设计、执行、分析数据和写作。
- Ciro Cattuto:ISI 基金会,以及都灵大学。参与设计、执行、分析数据和写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一座城市只用“平均多去了几个地方”给新公交线打分,男性那 1.39 个核心格子会比女性的 0.76 个更拉动平均分。把增量按核心格子、再按收入四分位拆开,问题会变成谁的日常地点增加了。论文给出了这两个口径,没有评估任何一条具体线路。
图 1 的排序还提示另一件事:女性在自己最常去和次常去的格子上,通话占比高于男性,从第三位开始反过来。只检查两个最常去地点是否可达,覆盖的是女性占比已经更高的那一段。核心地点仍然差 2.13 个,熵差 0.26。若第三位以后的格子更多是陪诊、购物和接送,只保障前两个地点的班次,会漏掉占比开始反转的那一段。论文没有这些格子的出行目的,这只是一个可以用停留目的去检验的问题。