城市变大以后,通勤是更散了,还是更有骨架了?
论文名片|Thomas Louail、Maxime Lenormand、Miguel Picornell、Oliva García Cantú、Ricardo Herranz、Enrique Frias-Martinez、José J. Ramasco、Marc Barthelemy,Uncovering the spatial structure of mobility networks,Nature Communications,2015,6:6007。DOI:10.1038/ncomms7007。2014年9月19日收稿,2014年12月2日接收,2015年1月21日发表。本文依据这一正式版本的正文解读。
早上从一片密集住宅去一个大就业中心,和从一块普通街区去另一块普通街区,在通勤表里落在不同的格子上。若后一种人所占的份额随城市变大而升高,这座城市看起来更散。Louail 等人问的是另一件事:把每个地块的居住人数和就业人数都固定住,再把通勤随机重新摊开,实际城市离这种摊法有多远。
在西班牙 31 个超过 20 万人口的城市区里,两件事同时成立。起终点都不在热点上的通勤者份额随人口上升,居住热点到就业热点的份额下降。与此同时,和保持各网格进出总量的随机分配相比,人口更大的城市偏离得更远。R 的人数份额回答有多少通勤不经过热点;Z 分数回答这张网络离随机重分配有多远。
先说结论
- 每座城市的跨网格通勤被收成四个份额:整合流 I、汇聚流 C、发散流 D、随机流 R。四者都是人数除以该城市起讫矩阵里的通勤人数合计,相加为 1。
- 31 个城市区里,I 随人口下降、R 随人口上升,C 和 D 大体平稳。按四类份额聚类后,平均人口 255,330 的一组,I、R 的城市均值是 0.43 和 0.27;平均人口 2,463,551 的一组是 0.25 和 0.46。表 1 对组内每座城市一视同仁取算术平均,分母是城市个数。
- 零模型做 100 次,每次保持每个网格的总流入和总流出,只把流量随机重分配。I 和 R 的 Z 分数为正且随人口升高,C 和 D 为负且下降。城市越大,越不像这种随机重分配。
- 在 LouBar 热点和 1 km² 方格下,随机流大约贡献总通勤距离的 40%,另外三类各约 20%。这个距离份额大体不随人口变化。人数份额会变,距离份额可以仍然平稳,因为两者的分母不同。
一张完整的通勤表,为什么还是看不清结构?
交通研究里的起讫矩阵(origin–destination matrix,OD 矩阵)记录从地点 i 到地点 j 的人数。它把一座城市在某个空间尺度、某类出行上的流动都收进来,也正因为如此,城市之间很难直接比较:格子一多,表就又大又密。
社区发现和随机块模型按节点的连接方式分组,适合抽出网络的中尺度团块。通勤网络还需要给连边分类。有的流动把主要住宅区和主要就业区接起来,有的从零散住宅汇向就业中心,有的从大住宅区散向较小的活动地点,还有的两端都不在这些高密度地点上。只比较建成区面积、住宅密度、子中心个数,或者人均出行次数,仍然看不到一次通勤同时拥有的起点和终点。
这篇论文要的是一个粗签名:任何加权有向网络都可以先标出两类重要节点,再看流量落在“重要—重要、重要—普通、普通—重要、普通—普通”哪一格。通勤只是他们用来检验这个签名的例子。
四个份额分别除以谁?
对一座城市,把空间分成 n 个单元,Fᵢⱼ 是住在 i、到 j 从事主要日常活动的人数,多数是工作或上学。计算每个格子的居住人数和就业人数时,对角线去掉:住和上班落在同一格的人,在这个尺度上被当成不移动,不进入后面的四类。i 格的居住人数是离开 i 的通勤合计,就业人数是进入 i 的通勤合计。
热点是这些密度的局部高值。正文使用他们此前提出的、基于密度洛伦兹曲线的无参数规则;图注称之为 LouBar。这一版方法部分没有重写阈值公式,只强调后面的四分法不依赖某一种热点定义,同一套规则要用于所有城市。一个格子可以同时是居住热点和就业热点。
设有 m 个居住热点、p 个就业热点。把居住热点放到矩阵上方,就业热点放到左侧,OD 矩阵就分成四块。每一块的人数除以矩阵中的通勤人数合计:
- I,整合流(integrated flows):居住热点到就业热点。
- D,发散流(divergent flows):居住热点到非就业热点。
- C,汇聚流(convergent flows):非居住热点到就业热点。
- R,随机流(random flows):两端都不是热点。
论文把结果写成 2×2 矩阵,左上 I、右上 D、左下 C、右下 R。四个数都在 0 到 1 之间,和为 1。这里的随机流是类别名字,指起点和终点都没落在热点上,不是说通勤者抽签选择目的地。
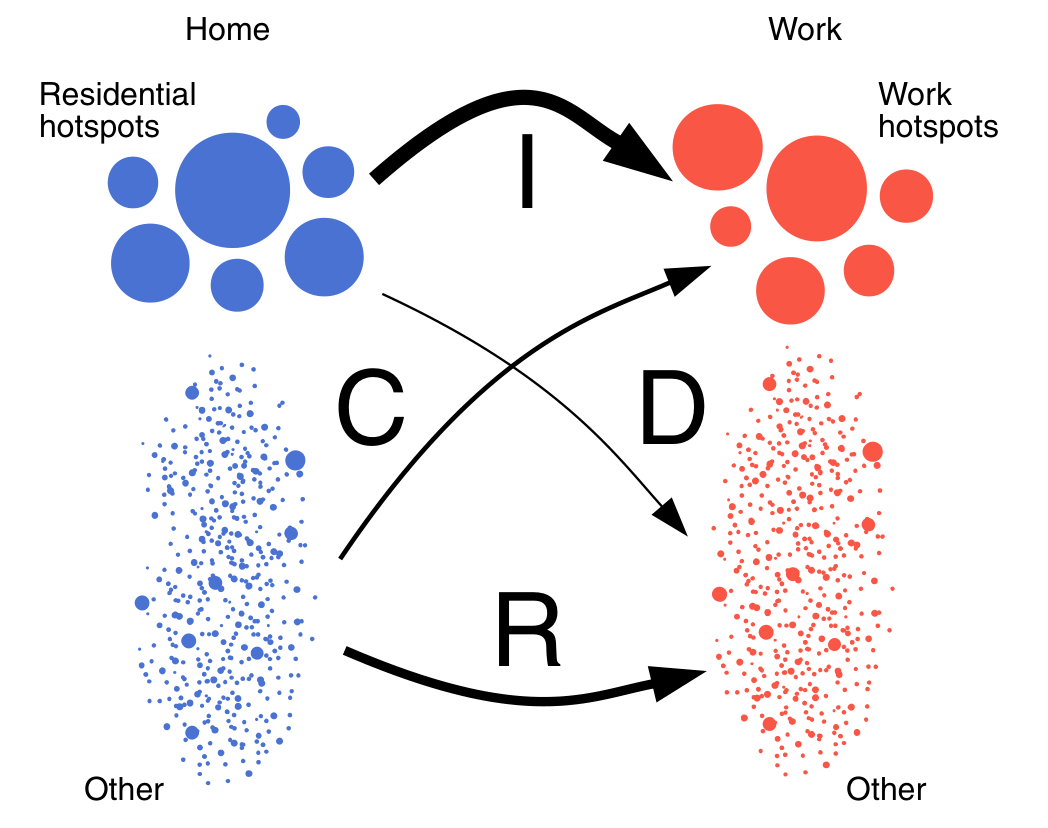
图 1|一张通勤表怎样收成四类流动?
无字母子图。这是方法示意图,圆的大小和点数不是 31 座城市的实测人数。左侧 Home 为居住,蓝色大圆是居住热点,下方细点是其他居住地;右侧 Work 为就业,红色大圆是就业热点,下方细点是其他活动地。I 从居住热点指向就业热点,C 从其他居住地汇向就业热点,D 从居住热点指向其他活动地,R 连接两端的其他地点。来源:原论文 Fig. 1。
家和上班地点是怎样从电话记录里定出来的?
数据是 31 个西班牙城市区的汇总、匿名通话详单,城市区人口都超过 20 万。没有个人记录可供本研究使用。匿名用户平均约占当地总人口的 2%,最高约 5%,各城市区的这个比例差不多。记录覆盖 55 天;识别家和就业地时,只用其中周一到周四共 20 个工作日。结果部分把采集概括为 5 周,并指向方法部分。横轴上的人口 P 是城市人口规模,正文没有在这里写明统计年份和口径;它不是这 2% 电话样本的人数。
家是每个用户在工作日 20:00–07:00 最常出现的基站泰森多边形,就业地是 09:00–17:00 最常出现的多边形。研究假定家和就业地之间存在每日出行。在所考察的日子里,家或就业地的通话活跃天数要超过 40%,用户才保留。随后把用户加总成基站尺度的 OD 矩阵,再用转换矩阵放到边长为 a 的正方形网格上,以便城市之间使用同一套格子。
因此,I、C、D、R 是这批通过规则的电话用户里、跨网格通勤者的份额。它和全人口普查通勤表是否一致,正文引用了他们自己的另一项对照,并写明还需要在其他城市和国家核验。
热点个数本身也随人口变化。正文报告,居住热点和就业热点的数量都随人口次线性增长,就业热点增加得更慢;居住地更分散,活动中心更少。具体散点在补充图里,正文没有给出标度指数。就业热点的次线性增长,和 Louf 与 Barthelemy 用另一套美国就业中心数据看到的方向一致。
人口变大时,哪两类份额在动?
对这 31 个城市区,I 随人口下降,R 上升,C 和 D 几乎不随人口变化。把城市按 I 从高到低排列,区分城市的主要是 I 和 R。正文据此认为,在这些西班牙城市里,人口规模上去以后,居住地和活动地都更分散:热点数量仍在增加,但它们接住的通勤份额变小。这是横截面上的伴随关系。数据没有追踪同一座城市长大的过程,也不能单独分离规划、产业结构或交通供给。
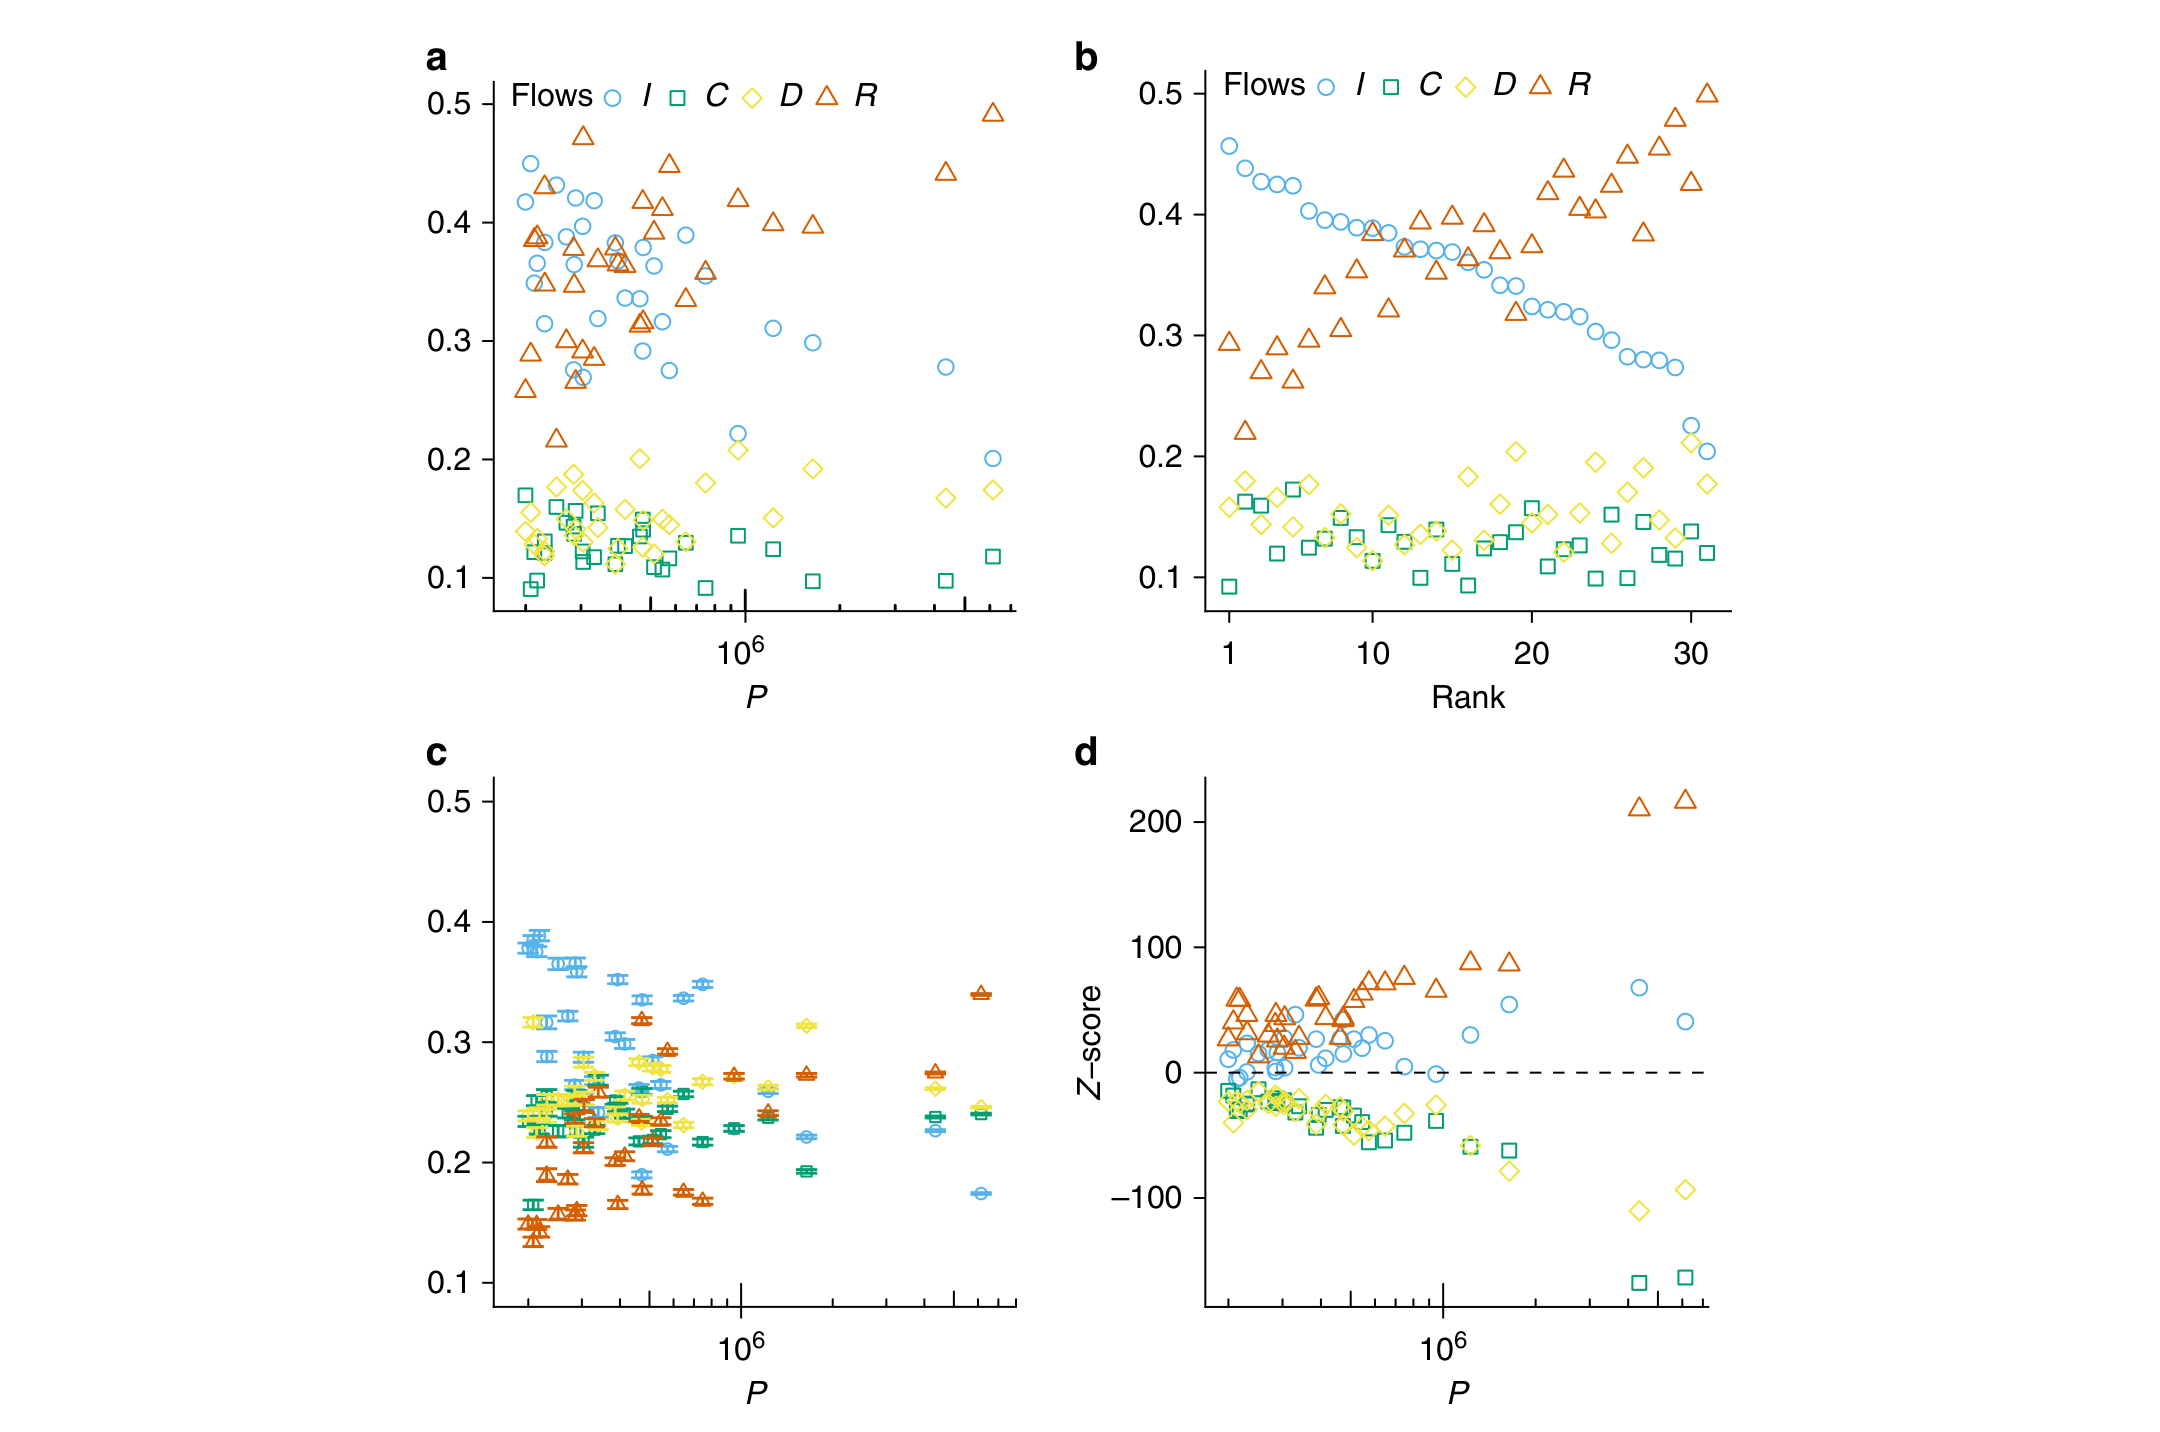
图 2|31 个城市区的四类份额,和随机重分配差多远?
(a)横轴为城市人口 P,轴上标出 10⁶;纵轴为通勤者份额,刻度从 0.1 到 0.5。I 为空心圆,C 为方块,D 为菱形,R 为三角。I 随 P 下降,R 上升,C 和 D 挤在较低的一条带里。每个点是一座城市,图上没有城市名。(b)同一组份额按 I 从高到低排列,横轴是按 I 排出的名次。图 5 城市名前的数字才是人口位次。I 下降时 R 上升,C 和 D 仍然平稳。由定义,每座城市四点之和为 1。(c)零模型 100 次重复的均值和标准差。每个网格的总流入、总流出保持不变,流量在网格之间随机重分配。误差线很窄,说明在这组约束下四类份额的随机期望相当稳定。(d)实测值相对零模型的 Z 分数,虚线为 0。纵轴标出 −100、0、100、200。I 和 R 为正,并随人口升高;最大几座城市的 R 点超过 200。C 和 D 为负,并随人口下降,C 的低点落到 −100 以下。来源:原论文 Fig. 2。
图 2 的主结果使用统一网格。正文说换一种格子边长后,I 下降、R 上升的方向仍在,那组散点是补充图 7,正文没有再列数值。
大城市更散,为什么 Z 分数反而更大?
零模型要回答的是:如果只保留每个格子有多少人离开、有多少人到达,其余连接按随机方式重排,四类份额会是多少。图注写的是保持流入和流出;正文同时说保持每个节点的入度和出度,具体随机化写在补充说明 5。Z 分数用的是这个零模型的均值和标准差。对城市 i 的随机流份额,
Z(Rᵢ) =(实测 Rᵢ − 零模型均值 R*ᵢ)÷ 零模型标准差。
I、C、D 同样计算。I 和 R 的 Z 分数为正且数值大,C 和 D 为负且绝对值大。城市越大,I 和 R 的 Z 分数越高,C 和 D 越低。
把两张图放在一起看:图 2a 里 R 的人数份额随人口升高,图 2d 里 R 的 Z 分数也升高。前一个数说,更多通勤者的两端都不在热点上。后一个数说,这种格局比“只保住各地进出总量的随机重分配”更极端。论文由此写,城市越大,通勤看起来越不随机;这和“城市越大、个人移动越混乱”的直觉相反。对大城市,热点之间以及热点之外的流动构成一条通勤骨架,不能由这种随机重分配产生。作者认为它带着城市结构和历史的痕迹,并可能来自强约束和效率考虑。Z 分数证明的是偏离这个零模型,没有直接测量效率,也没有识别是哪一条历史约束造成的。
热点划得松一点,方向会翻吗?
热点规则确实会改变四个数的高低。密度阈值 ρ* 越低,被算作居住热点和就业热点的格子越多,I 越大,R 越小;C 和 D 变化不大。补充图 8 检验了这种敏感性。正文给出的结论是:无论采用他们测试过的哪一个密度阈值,城市之间的比较方向不变,仍然是人口越大,I 越低、R 越高。阈值改变的是份额的水平,正文没有说它不改变任何城市的排序细节。
谁的通勤更长?
四类流动的平均距离都随人口增加。城市面积也随人口变大,距离变长本身在预期之内。汇聚流 C 的平均距离上升得比其他类型更快,也快过发散流 D,所以 C 和 D 并不对称。对这组西班牙城市,从小居住区到重要活动中心的人,平均走得比其他人更远。作者认为,这可以是居住区向外扩张、活动中心位置相对稳定的一个迹象。这是对距离模式的一种解释,数据里没有直接观察住宅和就业中心是否在时间上这样移动。
和零模型比,各类流动的实测平均距离短于随机重分配产生的平均距离。论文把这一点读成个体流动存在空间组织,并用来强调居住选址里的出行时间预算。时间预算本身没有被测量。
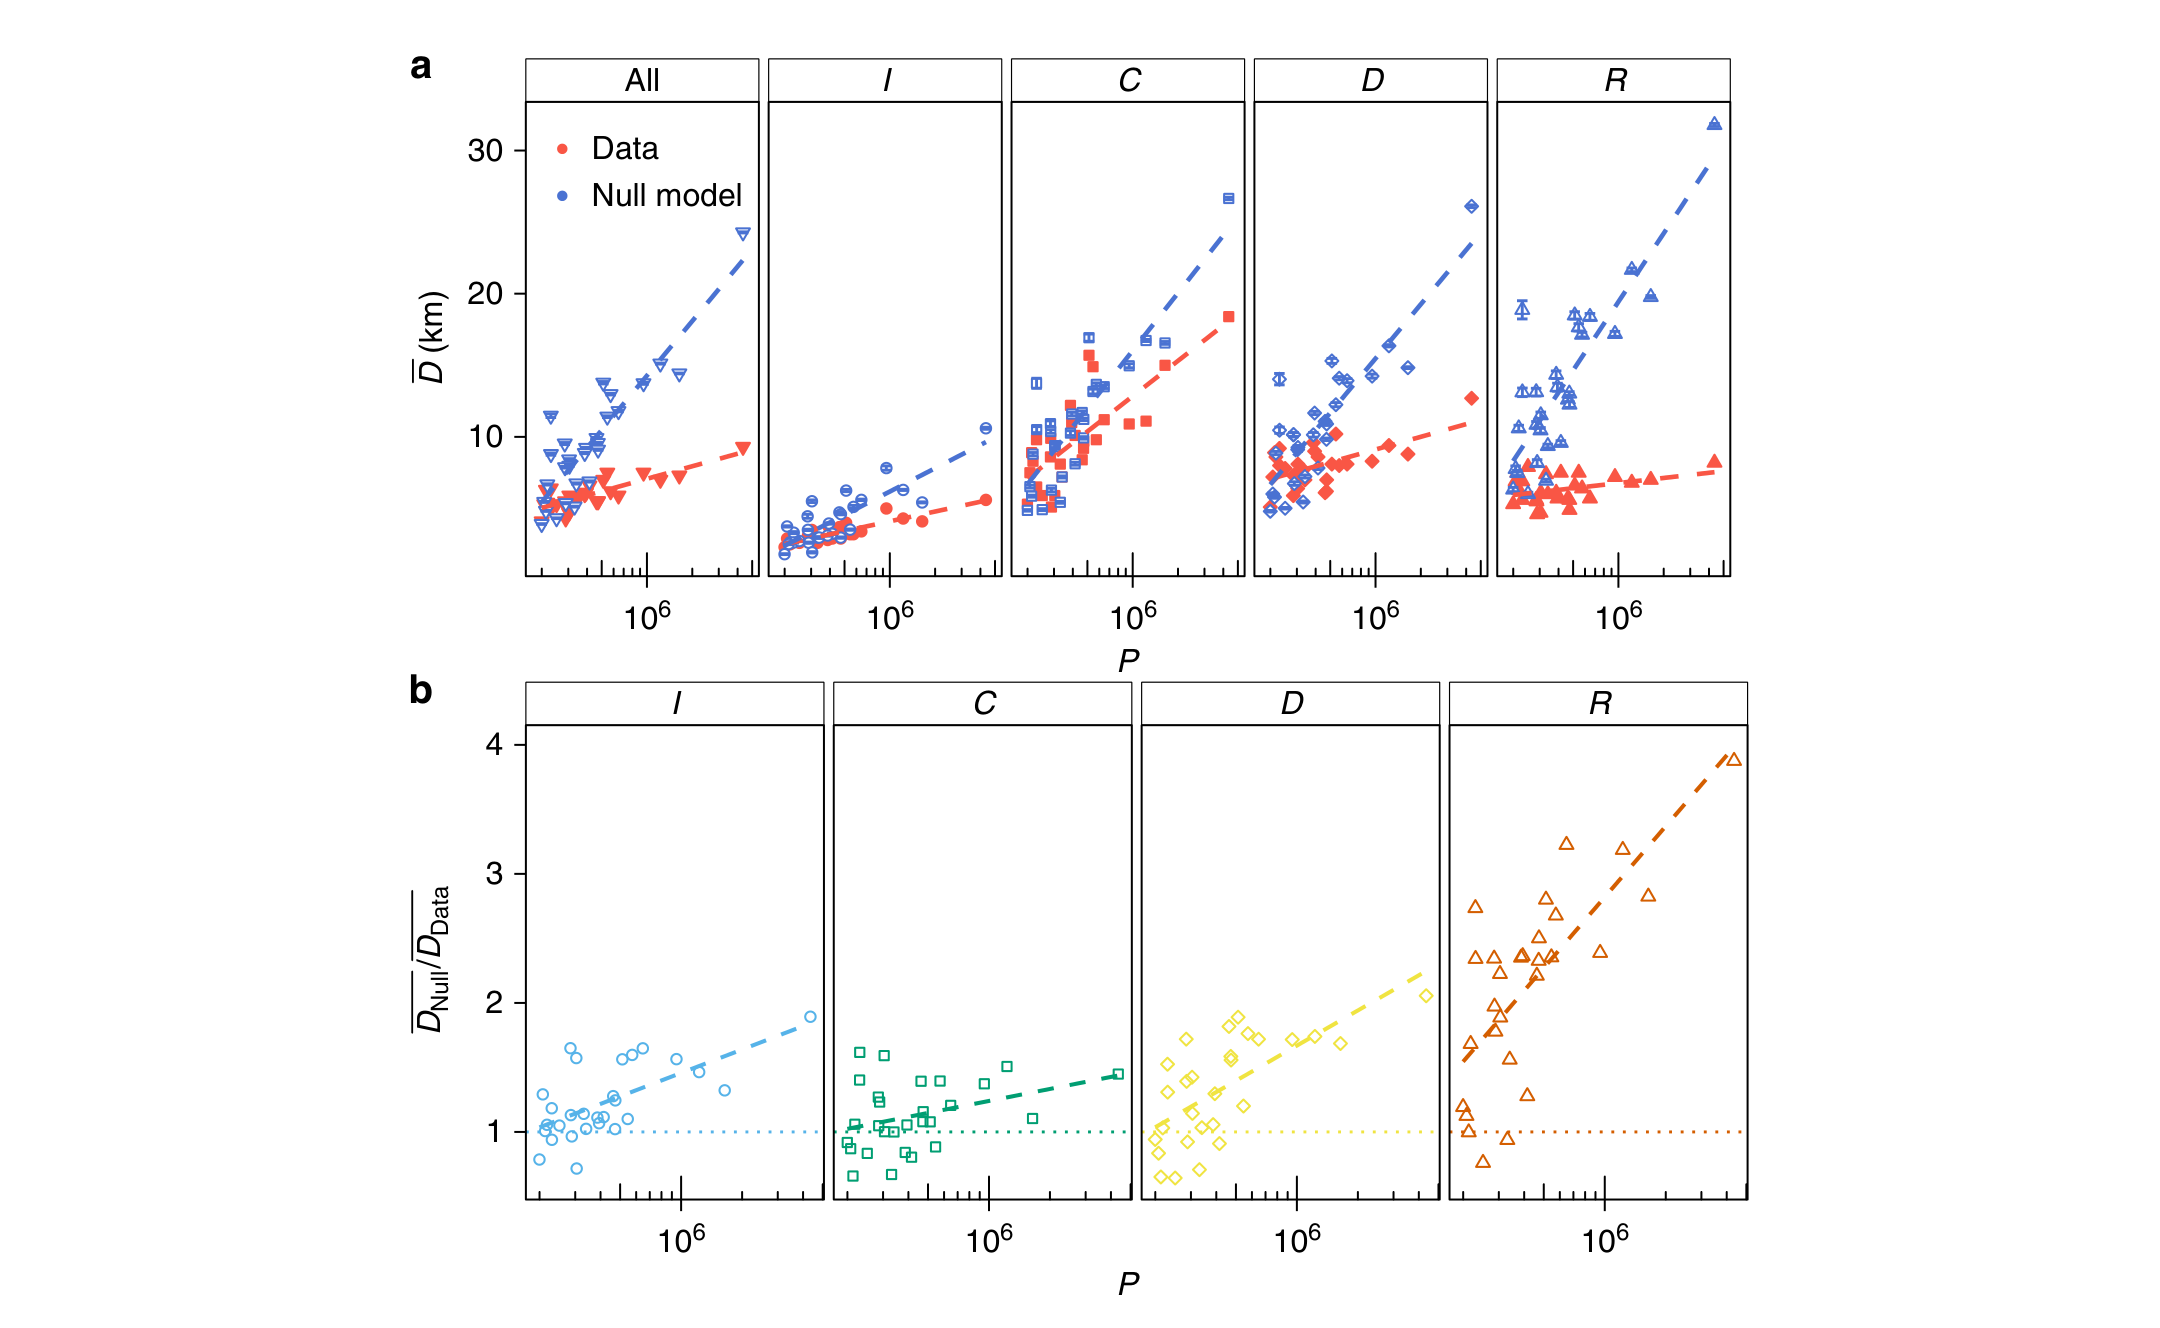
图 3|四类通勤的平均距离如何随人口变化?
(a)五个面板从左到右是全部通勤 All,以及 I、C、D、R。横轴为人口 P,纵轴为平均距离,单位公里,刻度标到 10、20、30。红色为实测,蓝色为零模型。各类蓝点整体高于红点;C 的红点随人口抬升最陡,I 的红点整体更低。All 是所有通勤合在一起的平均距离,不是第五类流动。图注说明热点用 LouBar 划分。(b)四个面板为 I、C、D、R 的距离比:零模型平均距离除以实测平均距离。纵轴刻度从 1 到 4,虚线标出 1。小于 1 表示零模型的平均距离更短。小城市出现低于 1 的点;R 的比值随人口上升得比 D、C、I 更快,最大城市的点接近纵轴上端。来源:原论文 Fig. 3。
图 3b 里小城市的比值可以低于 1。论文认为,在这个较短的尺度上,空间没那么重要。同一张图又显示,R 的比值升得最快,作者据此认为这些非热点间流动仍有明显的空间结构。比值低于 1 的是较小城市区,它们仍然属于人口超过 20 万的样本,不是村镇。正文没有写明距离是直线距离还是沿路距离,也没有在图 3 的图注里重复方格边长。
总距离落在哪一类人身上?
另一套账是距离合计,不是人数。某一类的全部通勤距离,除以这座城市的通勤距离总和,就得到该类对总距离的贡献。用 LouBar、1 km² 方格时,随机流大约占 40%,I、C、D 各约 20%。各类的这个比例随人口变化很小。
因此,从居住中心到活动中心的整合流虽然直观,却不是总通勤距离的最大一块。在这 31 个城市区里,通勤距离的分散是常态。人数账本里的 I 会随人口下降、R 会上升,距离账本里的四类比例却大体保持不变。两套百分比不能互换:一个分母是人数,一个分母是距离。
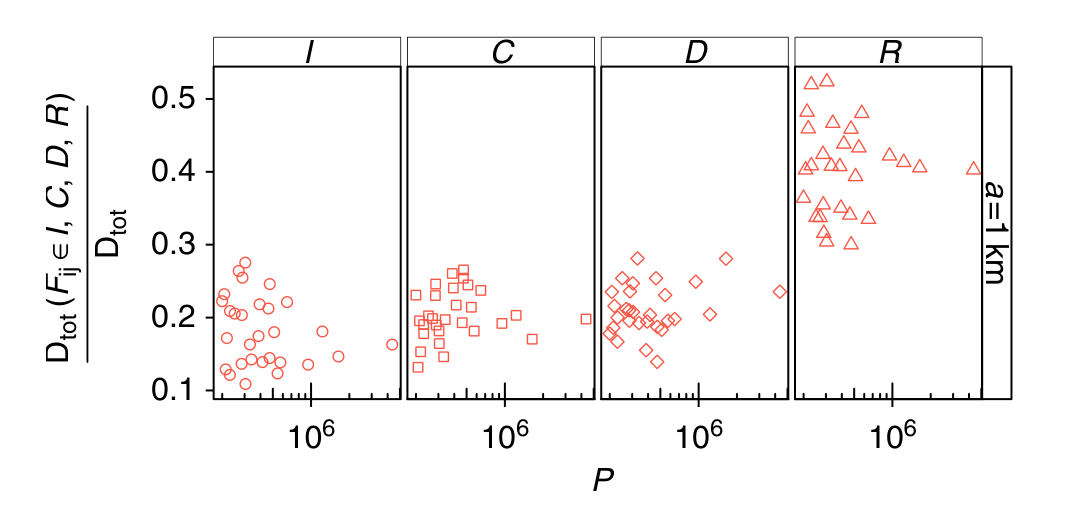
图 4|总通勤距离的四类贡献是否随人口变化?
无字母子图,四个面板从左到右为 I、C、D、R。横轴为人口 P,纵轴是该类距离合计除以总通勤距离,刻度从 0.1 到 0.5。右侧标出方格边长 a=1 km。I、C、D 的点大多在 0.2 上下,R 更高,集中在大约 0.3 到 0.5。四组点沿人口方向都没有明显的斜坡。来源:原论文 Fig. 4。
补充图 10 和 11 给出其他聚合尺度。正文说分散这一判断在那些尺度上仍然成立,没有在正文列出每一档格子的百分比。
31 座城市分成哪几组?
城市之间的距离,定义为两个四维份额之间的欧氏距离。层次聚类得到四个彼此分开的组。表 1 给出每组的平均人口和四个份额的城市均值。平均人口越高的组,R 越高、I 越低;C 大约停在 0.12–0.14,D 大约停在 0.15–0.17。
| 图中颜色 | 表 1 中的城市举例 | 平均人口 | 平均 I | 平均 R | 平均 D | 平均 C |
|---|---|---|---|---|---|---|
| 橙色 | Salamanca、Gijon、Cordoba 等 | 255,330 | 0.43 | 0.27 | 0.16 | 0.14 |
| 深蓝 | La Coruña、Zaragoza、Santander、Elche 等 | 392,970 | 0.37 | 0.36 | 0.15 | 0.13 |
| 绿色 | Cartagena、Palma、Granada 等 | 732,992 | 0.31 | 0.41 | 0.16 | 0.13 |
| 浅蓝 | Murcia、Barcelona、Bilbao、Madrid 等 | 2,463,551 | 0.25 | 0.46 | 0.17 | 0.12 |
四项均值按构造应加总为 1。深蓝组和绿色组因四舍五入加起来是 1.01。这些平均人口是组内城市人口的算术平均,组里可以同时有较大和较小的城市。
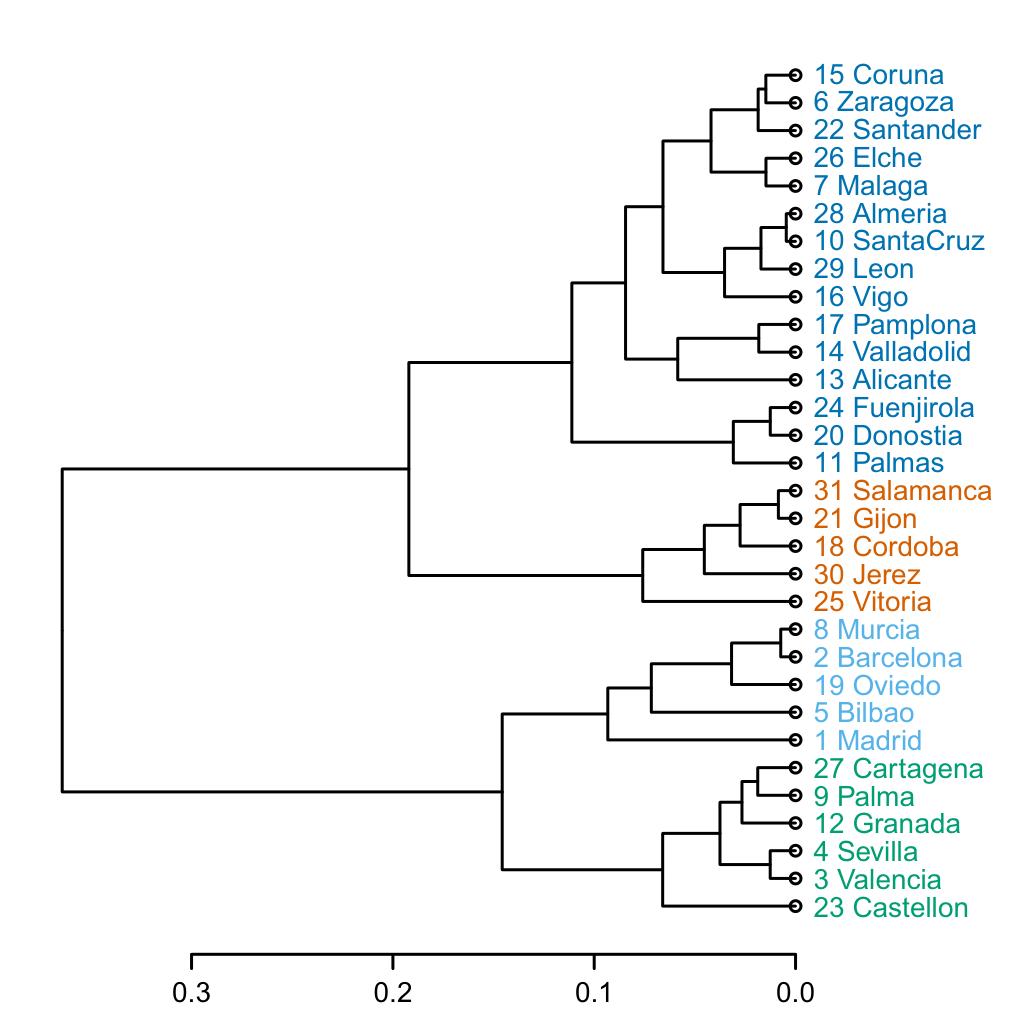
图 5|按四类份额聚类后,人口位次是否成组?
无字母子图。横轴是层次聚类的距离,从 0.3 收到 0.0。城市名前的数字是人口位次,1 为最大。颜色对应表 1 的四组。深蓝 15 座:Coruna、Zaragoza、Santander、Elche、Malaga、Almeria、SantaCruz、Leon、Vigo、Pamplona、Valladolid、Alicante、Fuenjirola、Donostia、Palmas。橙色 5 座:Salamanca、Gijon、Cordoba、Jerez、Vitoria。浅蓝 5 座:Murcia、Barcelona、Oviedo、Bilbao、Madrid。绿色 6 座:Cartagena、Palma、Granada、Sevilla、Valencia、Castellon。图中写作 Fuenjirola、SantaCruz、Coruna。来源:原论文 Fig. 5;组均值见原论文 Table 1。
位次相邻不等于进入同一组。Valencia 和 Sevilla 的人口位次是 3 和 4,图上与 Granada、Palma 同为绿色;Madrid、Barcelona 与人口位次 19 的 Oviedo 同为浅蓝。论文说最大的城市聚在一起,依据是组平均人口和 R 的高低,不是每一座城市都按人口位次单调入组。作者把高 R 解释成大城市里从任意地点到任意地点更容易通勤。这是对聚类结果的解读。他们同时写明,这套分组是否适用于其他城市和国家,还需要进一步研究。
分组对数据误差有一个直接检验。保持每格居住人数不变,随机改派一部分人的就业地,改派比例 f 等于被改派人数除以该城市通勤者总数。每个 f 生成 100 份带噪声的矩阵,用 Jaccard 指数比较新的 k 组划分和原始划分。指数在 0 到 1 之间,越接近 1,两个划分越接近;分子是在两个划分里都属于同一组的城市对数量。对照是把城市在 k 组之间随机重排,重复 1,000 次。直到 20% 的人被改派就业地,正文称平均 Jaccard 指数仍显著高于这个随机重排。具体曲线在补充图 12,正文没有列出各档 f 的指数数值。换一种居住和就业热点定义后,正文也报告聚类仍然稳健,见补充图 13。
这些比较能说到哪一步?
样本是 31 个超过 20 万人口的西班牙城市区,不是西班牙全部居民点,也不是同一城市的多年序列。通勤来自平均约 2%、至多约 5% 的电话用户,家和就业地由时段内最常出现的基站推断,并要求相应时段的活跃天数超过 40%。同一格内的居住和就业被拿掉,所以格子变大时,短距离通勤会从分母里消失,四个份额也会变。
I 下降、R 上升描述的是热点定义之下的人数份额。它支持“热点接住的通勤比例变小”,不能单独证明就业岗位搬迁、住宅郊区化或通勤成本变化的因果方向。零模型只破坏流量在固定进出总量之下的搭配方式。实测网络偏离它,说明存在额外结构;偏离增大,不能写成已经证明效率提高。C 的距离又长、又随人口升得快,是这组城市的观察结果。居住区扩张、就业中心不动,是与之相容的一种历史情景。
讨论里把用途放在城市内部流动的粗粒度对照上:检验合成移动模型是否再现四类份额,以及比较不同模型。流行病在城市内部的传播被列为需要这种移动描述的应用场景。论文没有用这 31 座城市拟合传播过程。
一句话总结
在这 31 个西班牙城市区里,城市越大,不经过热点的通勤者越多,但整张通勤网络也越偏离“只保留各地进出总量”的随机重分配;人数上更散,和结构上更随机,是两笔不同的账。
核心来源
- Nature Communications 正式论文,Louail 等,2015,6:6007,DOI:10.1038/ncomms7007。正文图 1–5 与表 1 都来自这一版本。
- 论文写明补充信息刊登于 Nature Communications 网站。热点数量的标度图、另一种格子边长、阈值敏感性和聚类噪声曲线在补充图中,正文只报告了方向和 20% 改派这一阈值。
作者介绍
以下只采用论文列出的署名机构和贡献说明。
- Thomas Louail:署名于巴黎 CEA-CNRS 理论物理研究所,以及 CNRS、巴黎第一大学和巴黎第七大学的 Géographie-Cités。负责研究设计、数据处理与分析,并撰写论文。
- Maxime Lenormand:署名于帕尔马 IFISC(CSIC-UIB)。负责数据处理与分析。
- Miguel Picornell:署名于马德里 Nommon Solutions and Technologies。负责数据处理。
- Oliva García Cantú:同样署名于 Nommon。负责数据处理。
- Ricardo Herranz:署名于 Nommon。负责研究协调。
- Enrique Frias-Martinez:署名于马德里 Telefonica Research。负责取得并处理数据。
- José J. Ramasco:署名于 IFISC。负责研究协调。
- Marc Barthelemy:署名于 CEA 理论物理研究所,以及 EHESS-CNRS 社会分析与数学中心;通讯作者。负责协调、研究设计,并撰写论文。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若城市规划只盯住 R 的人数份额,大城市会一律被记成更分散,从而漏掉 Z 分数里的另一条信息:在各地居住岗位总量已经被固定之后,大城市规划出来的搭配更特殊。一个可以单独做的监测是,每年同时公布四个份额和相对同一零模型的 Z 分数。R 上升而 Z 分数也上升,更接近这篇论文看到的横截面;R 上升而 Z 分数靠近 0,才更像进出总量不变时的随机化。
另一笔容易漏掉的账是被对角线拿掉的人。1 km 格子里既住又上班的人根本不进入 I、C、D、R。一座短距离混合用地很多的城市,可能因为分母变小而显得热点间流动占比很高。把同一格通勤者占全部已识别家—工作对的比例,和四个份额一起列出,才能判断高 I 来自长距离骨架,还是来自格子把短途吞进了对角线。
聚类也不能反过来当人口标签用。Oviedo 的人口位次是 19,却和 Madrid、Barcelona 同组;Valencia、Sevilla 的位次是 3 和 4,却不在平均人口最高的那一组。若用组平均人口去推断某一座城市的通勤份额,这两类城市都会被放错。更稳妥的用法是先看这座城市自己的四个份额,再问它偏离同人口城市的方向,而不是先看它被分进了哪一个颜色。