人口和距离都相近,为什么通勤人数可以差出一个数量级?
论文名片|Filippo Simini、Marta C. González、Amos Maritan、Albert-László Barabási,A universal model for mobility and migration patterns,Nature,2012,484:96–100。2012年2月26日在线发表,2012年4月5日刊出;2011年8月8日收稿,2012年1月13日接收。DOI:10.1038/nature10856。本文依据这篇 Letter 的正文与图1至图4。
把起点人口、终点人口和两地距离填进同一张表,犹他的一对县和亚拉巴马的一对县看起来很像。2000年美国人口普查记下的通勤却差了一截:犹他这对县是44人,亚拉巴马这对县是6人。44除以6大约是7倍,正文把这个差距概括为一个数量级。
常用的引力模型会把两条流量算成一样,因为它只让流量随两端人口变大、随距离变小。这篇论文换了一个问题:人在选择去哪里时,会不会先被沿途已经存在的机会接住?由此得到的辐射模型只用人口分布来决定流量怎样分配。它抓住了这两对县谁多谁少,也在全美县际通勤、欧洲手机出行、美国跨县迁移、电话量和货运上,给出与引力模型不同的误差方向。
先说结论
- 右上角小表里,引力模型对犹他和亚拉巴马两条流量都给出1人;辐射模型给出66人和2人。普查是44人和6人。模型抓住的是哪一条更大,以及大约差一个数量级,不是逐人相等。
- 左下表的圈内其余人口 s 为 2×10⁶ 和 2×10⁷。亚拉巴马是犹他的10倍。正文据此说,同样半径里,犹他可比较的工作机会大约只有亚拉巴马的十分之一。
- 全美县与县之间的非零通勤大约跨越6个数量级。辐射模型的分箱平均落在图中的误差范围内;两种常用引力形式经常把高流量低估一个数量级或更多。
- 通勤距离分布在大约40千米处有一个峰。引力模型没有这个峰,短距离出行大约高估3个数量级;终点人口较小的一侧,大约高估将近1个数量级。
- 一个县的通勤总流出与人口成正比,图中拟合为 Tᵢ = 0.11 mᵢ。0.11的分母是起点县人口。把家乡人口固定加上35,000人之后,不同规模县的远行概率更能落到同一条曲线上。
引力公式为什么会把这两对县算成一样?
引力模型(gravity model,也常叫重力模型)写的是:单位时间里从地点 i 到地点 j 的人数 Tᵢⱼ,与起点人口 mᵢ 的某个幂、终点人口 nⱼ 的某个幂成正比,再除以一个随距离 rᵢⱼ 增大的阻碍函数。幂次和阻碍函数都靠已有流量来拟合。熵最大化可以推出两端人口的幂都是1,却给不出阻碍函数该是幂函数还是指数函数。实际工作里,幂函数、指数函数和多至9个参数都会出现。
没有先前的流量,这些参数就定不下来。疾病传播恰恰常常需要估计缺少系统交通调查的地区。公式还有两个结构问题:终点人口一直变大时,预测人数可以无限变大,甚至超过起点总共有多少人;它还给每一对地点一个确定人数,解释不了同样条件下人数为什么会波动。
介入机会模型(intervening opportunities)和随机效用模型从决策出发,正文认为它们仍带着随地区改变的可调参数,预测能力至多与引力模型相当。
图1用两对美国县把这个问题摆到地图上。蓝点是起点,绿点是终点,黄色区域是半径 r 里、除掉起点和终点之后的其余人口 s。箭头从蓝点指向绿点。犹他标注的是 Davis County 和 Washington County,亚拉巴马标注的是 Madison County 和 Houston County。
左下表把犹他写成 m = 90,000、n = 240,000、r = 447、s = 2×10⁶,亚拉巴马写成 m = 89,000、n = 280,000、r = 410、s = 2×10⁷。表内没有印刷 r 的单位;同页距离比较和后文坐标都以千米计。正文后文单独给出 Davis County 的人口是238,994,这个数更接近表里的240,000,而不是90,000。所以读这张表时,应直接使用表中的 m、n、r、s,不要把90,000自动当成 Davis County 的人口。
引力模型的参数来自对全部通勤数据拟合方程(1),并采用文献14的分段:r 小于119千米时,[α, β, γ] = [0.30, 0.64, 3.05];r 大于119千米时,为 [0.24, 0.14, 0.29]。因为两对县的 m、n、r 接近,预测流量都是1人。普查却是44人对6人。
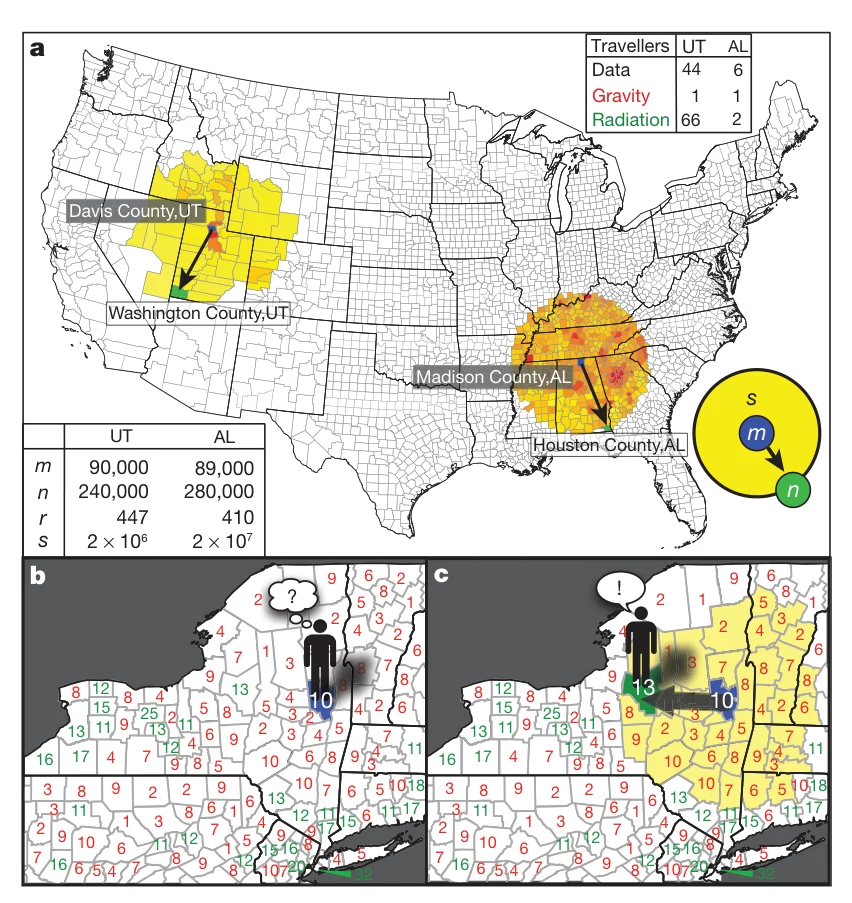
图 1|人口和距离都相近时,流量为什么还可以差一个数量级?
(a)美国地图上的两对县。黄到橙色表示半径内的人口多少,蓝点为起点、绿点为终点;左下表是 m、n、r、s,右上表是普查、引力模型和辐射模型的人数。右下角小圆示意 s 包住 m,n 落在圈外。(b)纽约州一带的示意:每个县里的数字是该县最好的机会得分,绿色表示高于家乡的10,红色表示低于10。(c)同一次抽取里,人会去最近而且得分高于家乡的县;图中选中的是得分13的县,家乡仍是10。来源:原论文 Fig. 1。
上班地点可以怎样选,公式里才不再单留一个距离参数?
通勤每天都在发生,但起点和终点是在更长的时间里由工作地点决定的。模型把选工作写成两步,分析单位是收集通勤数据时使用的县。
第一步,一个人向所有县收集工作机会,包括自己的县。每个县的机会数与常住人口成正比:正文假设每 njobs 名居民对应一个职位空缺。每个机会有一个好处 z,从分布 p(z) 里随机抽取,用来概括收入、工时和条件。县越大,抽到的 z 越多。
第二步,他接受离家乡最近、而且好处高于家乡最好那份机会的工作。离家近优先于好处本身:更近的差一点的工作,可以胜过更远的更好工作。图1b、c用纽约州的县做了一次演示。Saratoga County 家乡的最好得分是10;周围绿色县的得分更高,红色县更低。这次抽签里,最近且超过10的是得分13的 Oneida County。每个潜在通勤者都重新抽一次 z。
机会密度 njobs 和好处分布 p(z) 会从平均流量里消掉。剩下的平均流量是
⟨Tᵢⱼ⟩ = Tᵢ × mᵢ × nⱼ / [(mᵢ + sᵢⱼ)(mᵢ + nⱼ + sᵢⱼ)]。
sᵢⱼ 是以 i 为圆心、半径 rᵢⱼ 的圆里,去掉起点人口和终点人口之后的总人口。Tᵢ 是从 i 出发的通勤总人数。正文设 Tᵢ = mᵢ × (N_c / N),N_c 是全国通勤者总数,N 是全国总人口。图2g的美国通勤拟合是 Tᵢ = 0.11 mᵢ,所以这里的0.11是通勤人数除以起点县人口。它来自普查里的比例,用来把总流出分下去;辐射模型本身没有从这个比例反推出0.11。
N_c 改变的是每条流量的人数尺度,不改变流量在目的地之间怎样分配。正文因此把模型称为无参数。若要预测的是绝对人数,仍然需要各地的 Tᵢ,或者接受 Tᵢ 与人口成正比并另行给出这个比例。
距离没有作为独立旋钮留下。均匀人口密度下,sᵢⱼ 与 mᵢ rᵢⱼ² 成正比,再令 n 与 m 相当,公式会退回引力模型,阻碍函数是 r 的4次方,两端人口的幂次之和为1。人口密度一旦不均匀,同样的 m、n、r 就可以对应很不同的 s。犹他的 s 是2×10⁶,亚拉巴马是2×10⁷,正好差10倍。正文的解释是:犹他周围的人口密度低于美国平均,同样半径内的工作机会大约只有亚拉巴马的十分之一,所以犹他的通勤者要走得更远,才能遇到可比的机会。图1里辐射模型给出66人和2人,方向与44人对6人一致,数值仍有差距。
终点人口变得很大时,正文给出流量趋近 m² / (m + s) 这一量级,并且不超过起点人口 m。这是公式的上界,用来回应引力模型可以预测出比起点人口还多的人。它不是某一次普查里测到的饱和人数。流量在模型里还是随机变量,平均由上面的公式给出,方差的推导放在补充材料第2节,正文没有印出方差公式。
把全美国的县放在一起,误差出在流量的哪一端?
图2先看从纽约县出发、超过10人的全国通勤,以及纽约州内超过1,100人的高强度通勤。箭头颜色从黑到白:黑色对应10人,低于10人的流量为了看清而没有画出,白色对应超过10,000人。上排是2000年普查,中排是用 f(r) = r^γ 拟合的引力模型,下排是辐射模型。
引力模型把纽约县的目的地都放在400千米以内,更远的行程和许多中等距离行程没有出现。在纽约州内部,它把纽约市附近估得过重,把州里其余地方估得过轻。辐射模型在全国和州内都更接近普查箭头的伸展范围。这组地图比较的是超过展示阈值的箭头落在哪里,不是每一条县际流量的百分比误差。
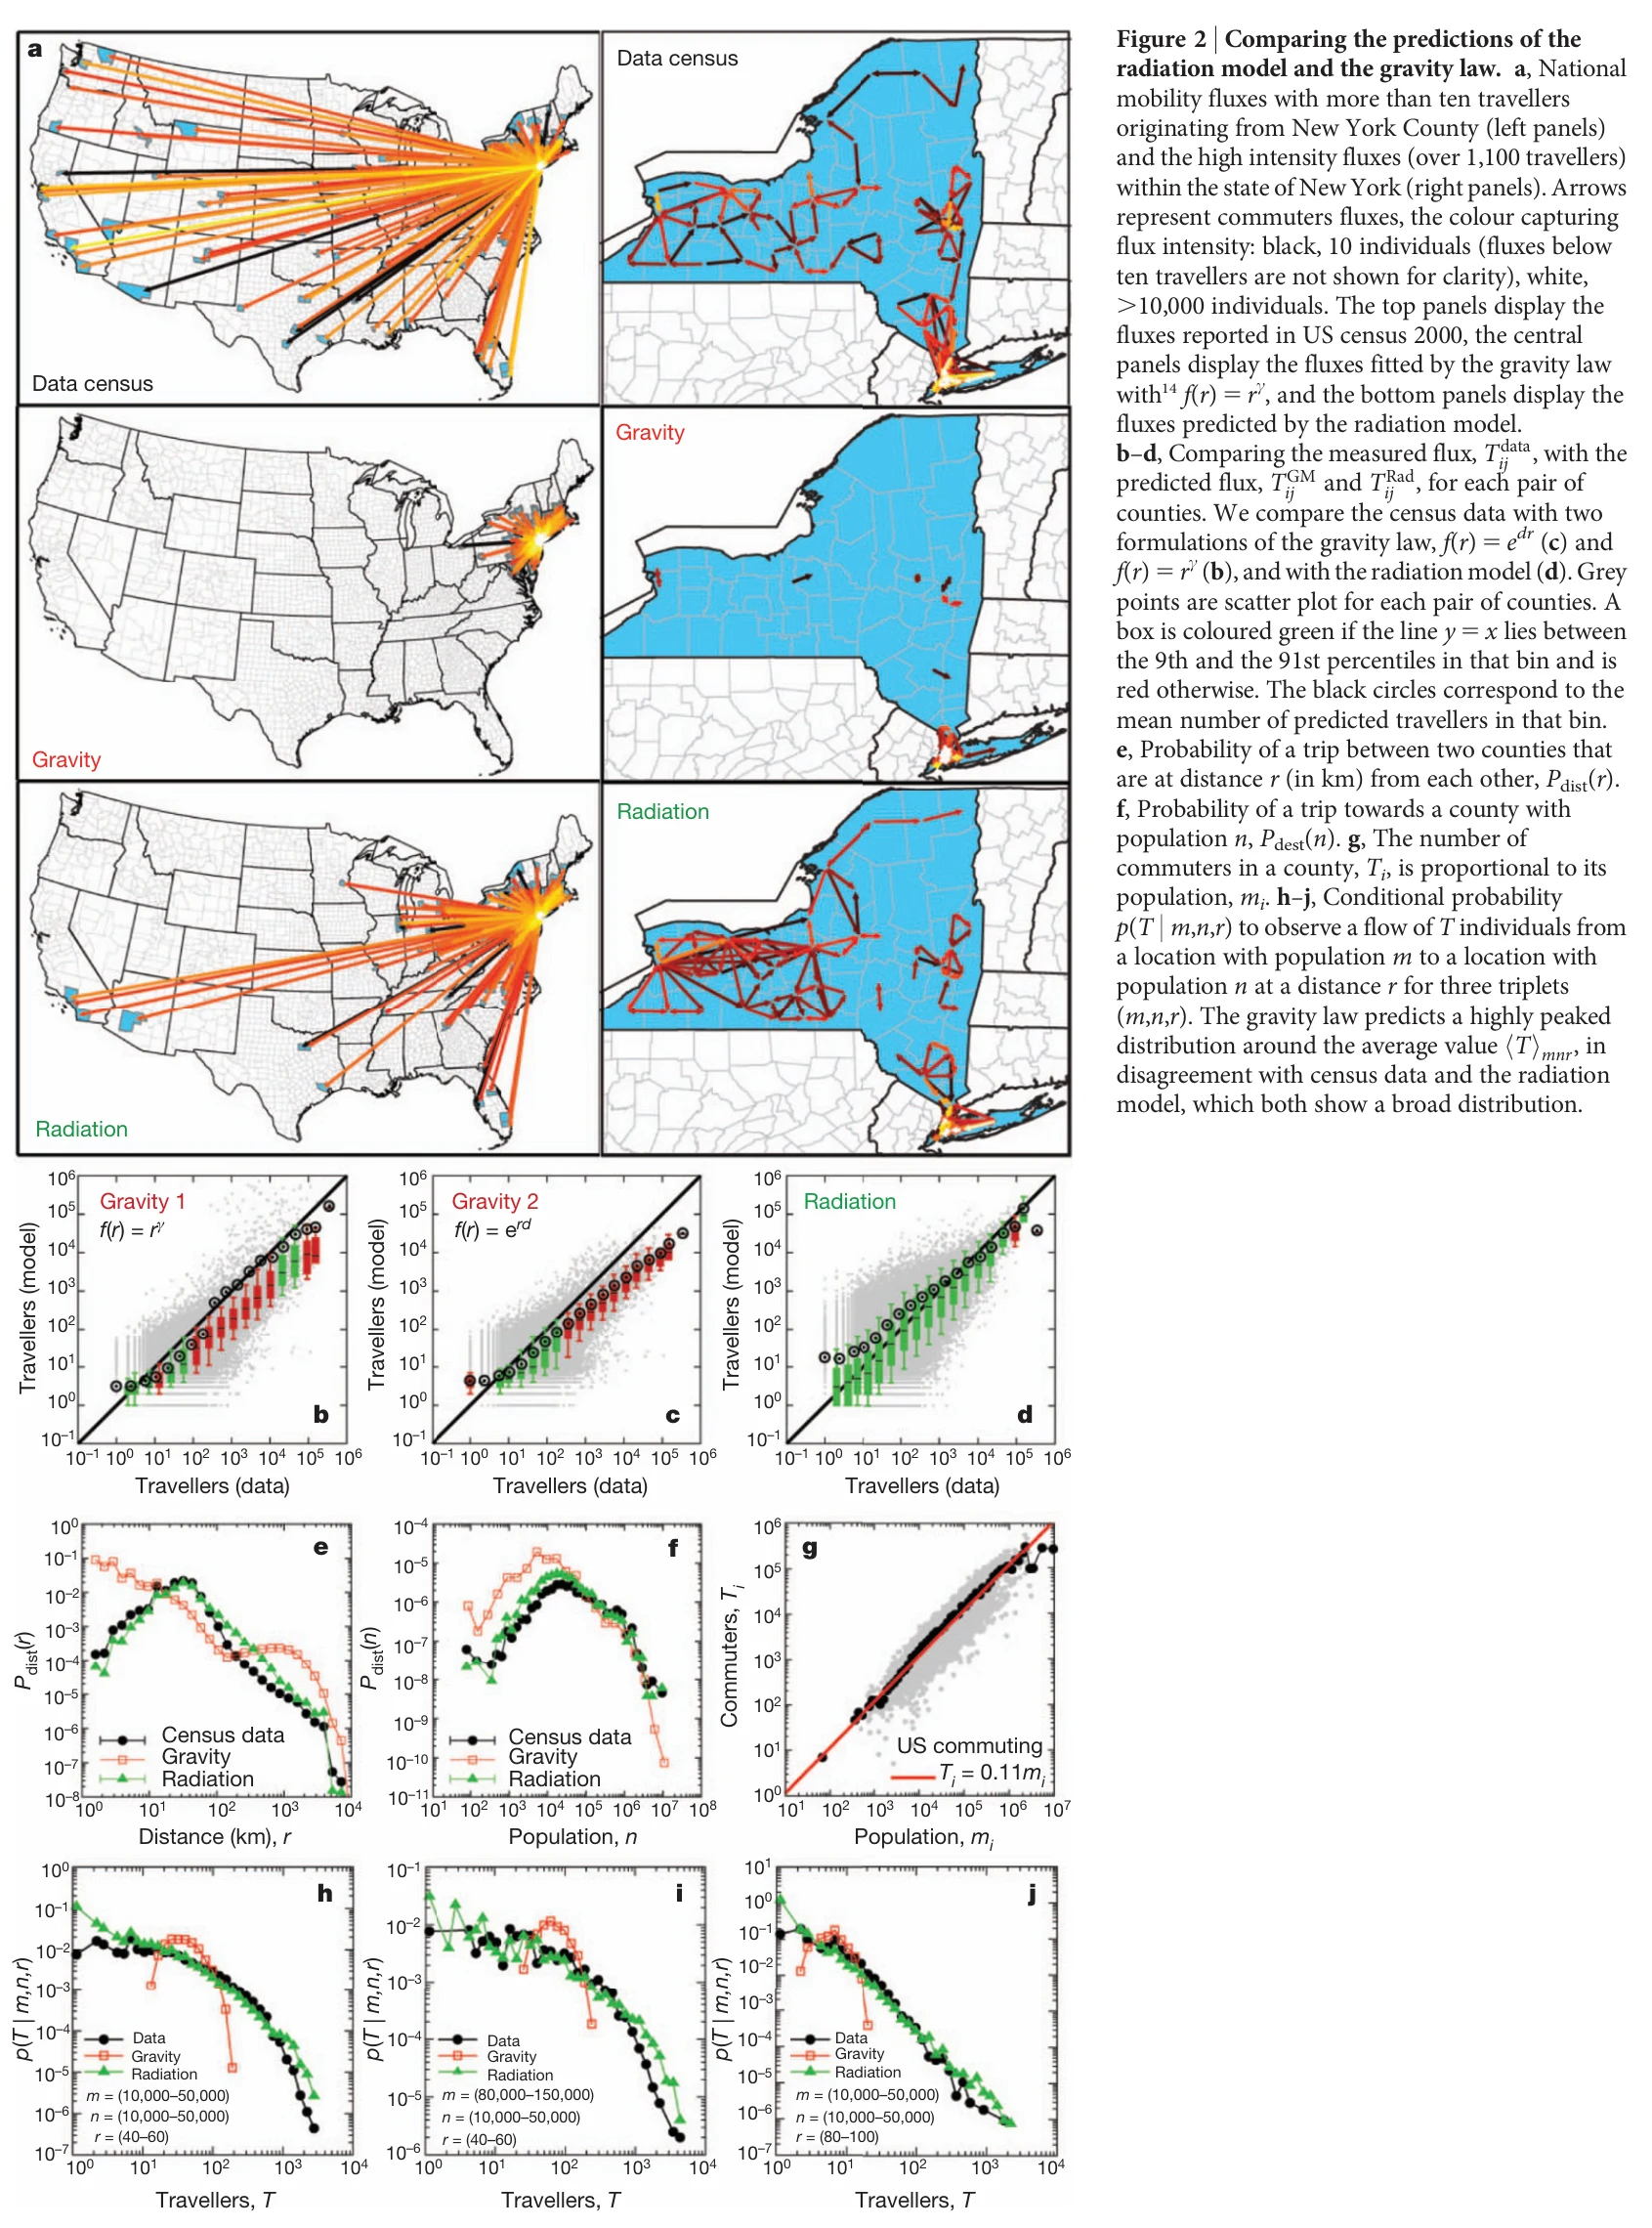
图 2|辐射模型和两种引力形式,谁更接近美国县际通勤?
(a)左列为从纽约县出发、超过10人的全国流量,右列为纽约州内超过1,100人的流量。上、中、下三行依次是2000年普查、幂律阻碍的引力模型、辐射模型;颜色从10人的黑到超过10,000人的白。(b)阻碍函数为 r^γ 的引力模型:横轴是普查人数,纵轴是预测人数,灰点为县对,黑圈为分箱平均。绿箱表示对角线 y = x 落在该箱第9至第91百分位之间,红箱表示没有落在里面。(c)阻碍函数为 e^{δr} 的引力模型,δ 是长度倒数,读法与(b)相同。(d)辐射模型,坐标和绿红箱规则与(b)(c)相同,分箱平均更贴近对角线。(e)相距 r 千米的两县之间发生一次出行的概率 P_dist(r)。黑、红、绿分别是普查、引力模型和辐射模型。(f)前往人口为 n 的县的概率 P_dest(n),颜色同上。(g)各县通勤总人数 Tᵢ 对人口 mᵢ,红线为 Tᵢ = 0.11 mᵢ。(h)在 m 与 n 都为10,000–50,000人、距离40–60千米的县对中,流量 T 的条件概率;黑、红、绿仍是数据、引力模型和辐射模型。(i)起点改为80,000–150,000人,终点和距离区间与(h)相同。(j)m 与 n 回到10,000–50,000人,距离改为80–100千米。来源:原论文 Fig. 2。
接着比的是所有非零县对。横轴是普查流量,纵轴是预测流量,灰点是每一对县,黑圈是该箱里预测人数的平均。绿箱表示完美预测线 y = x 落在这个箱的第9到第91百分位之间,红箱表示落在外面。两种引力形式分别把阻碍函数写成距离的幂,以及 e^{δr}。它们都明显压低了高流量一端,常常低一个数量级或更多。辐射模型的平均在大约6个数量级的流量跨度里仍落在这些误差范围之内。绿箱只说明对角线落在大多数县对的散布里,不说明每一对县都被精确预测。
距离分布 P_dist(r) 是相距 r 千米的两县之间出现一次出行的概率。普查大约在40千米处有一个峰。辐射模型跟着这个峰走。引力模型没有这个峰,于是把短距离出行高估大约3个数量级。前往人口为 n 的县的概率 P_dest(n) 上,引力模型把人口较小的那一端高估将近1个数量级。
图2g说明总流出大体随人口增加,斜率是0.11。这只约束一个人所在的县总共送出多少通勤者,还没有说这些人去哪个县。
最后看条件概率:在起点人口、终点人口和距离都落在同一档时,流量 T 如何分布。三档分别是 m 与 n 都为1万至5万人、距离40至60千米;m 为8万至15万人、n 仍为1万至5万人、距离40至60千米;以及 m 与 n 为1万至5万人、距离80至100千米。引力模型因为给相同的 m、n、r 同一个流量,分布会在平均值附近挤成尖峰。普查和辐射模型都是一条更宽的分布。宽分布说明,人口和距离档位相同的县对,通勤人数仍然可以差很多;辐射模型用周围人口 s 的差别来产生这种散布。
小时出行、跨县搬家、电话和货运,用的是不是同一条式子?
图3把同一公式拿到四类记录上。它们的时间尺度、观测方式和地理范围都不相同,不能合成一个总样本。
西欧某国的匿名手机话单大约覆盖一千万用户,正文没有写出国名。研究取了6个月,在早7点到晚10点之间按小时、以基站精度记录位置,并识别市镇之间的行程。图注写的是14-hourly time intervals;图例从7–8时排到21–22时,可以数出15个小时档。引力模型在这里是把24小时合在一起拟合的结果,图上是空心方块。通勤流量则另有一套定义:按每人通话最多的位置识别家和工作地,正文没有在这里写出划分二者的时间规则;比较时只保留观测流量和辐射模型流量都大于0的市镇对。
美国跨县迁移来自国税局,统计的是2007至2008纳税年度里,从一个县改到另一个县的人数。电话量来自同一类匿名手机数据:4周内4,336,217名用户打出38,649,153次电话,再汇总到市镇对。货运来自美国 Freight Analysis Framework,汇总州和主要都市区之间、各种运输方式的货物;正文图注没有给出这套货运数据的年份,纵轴单位是吨。
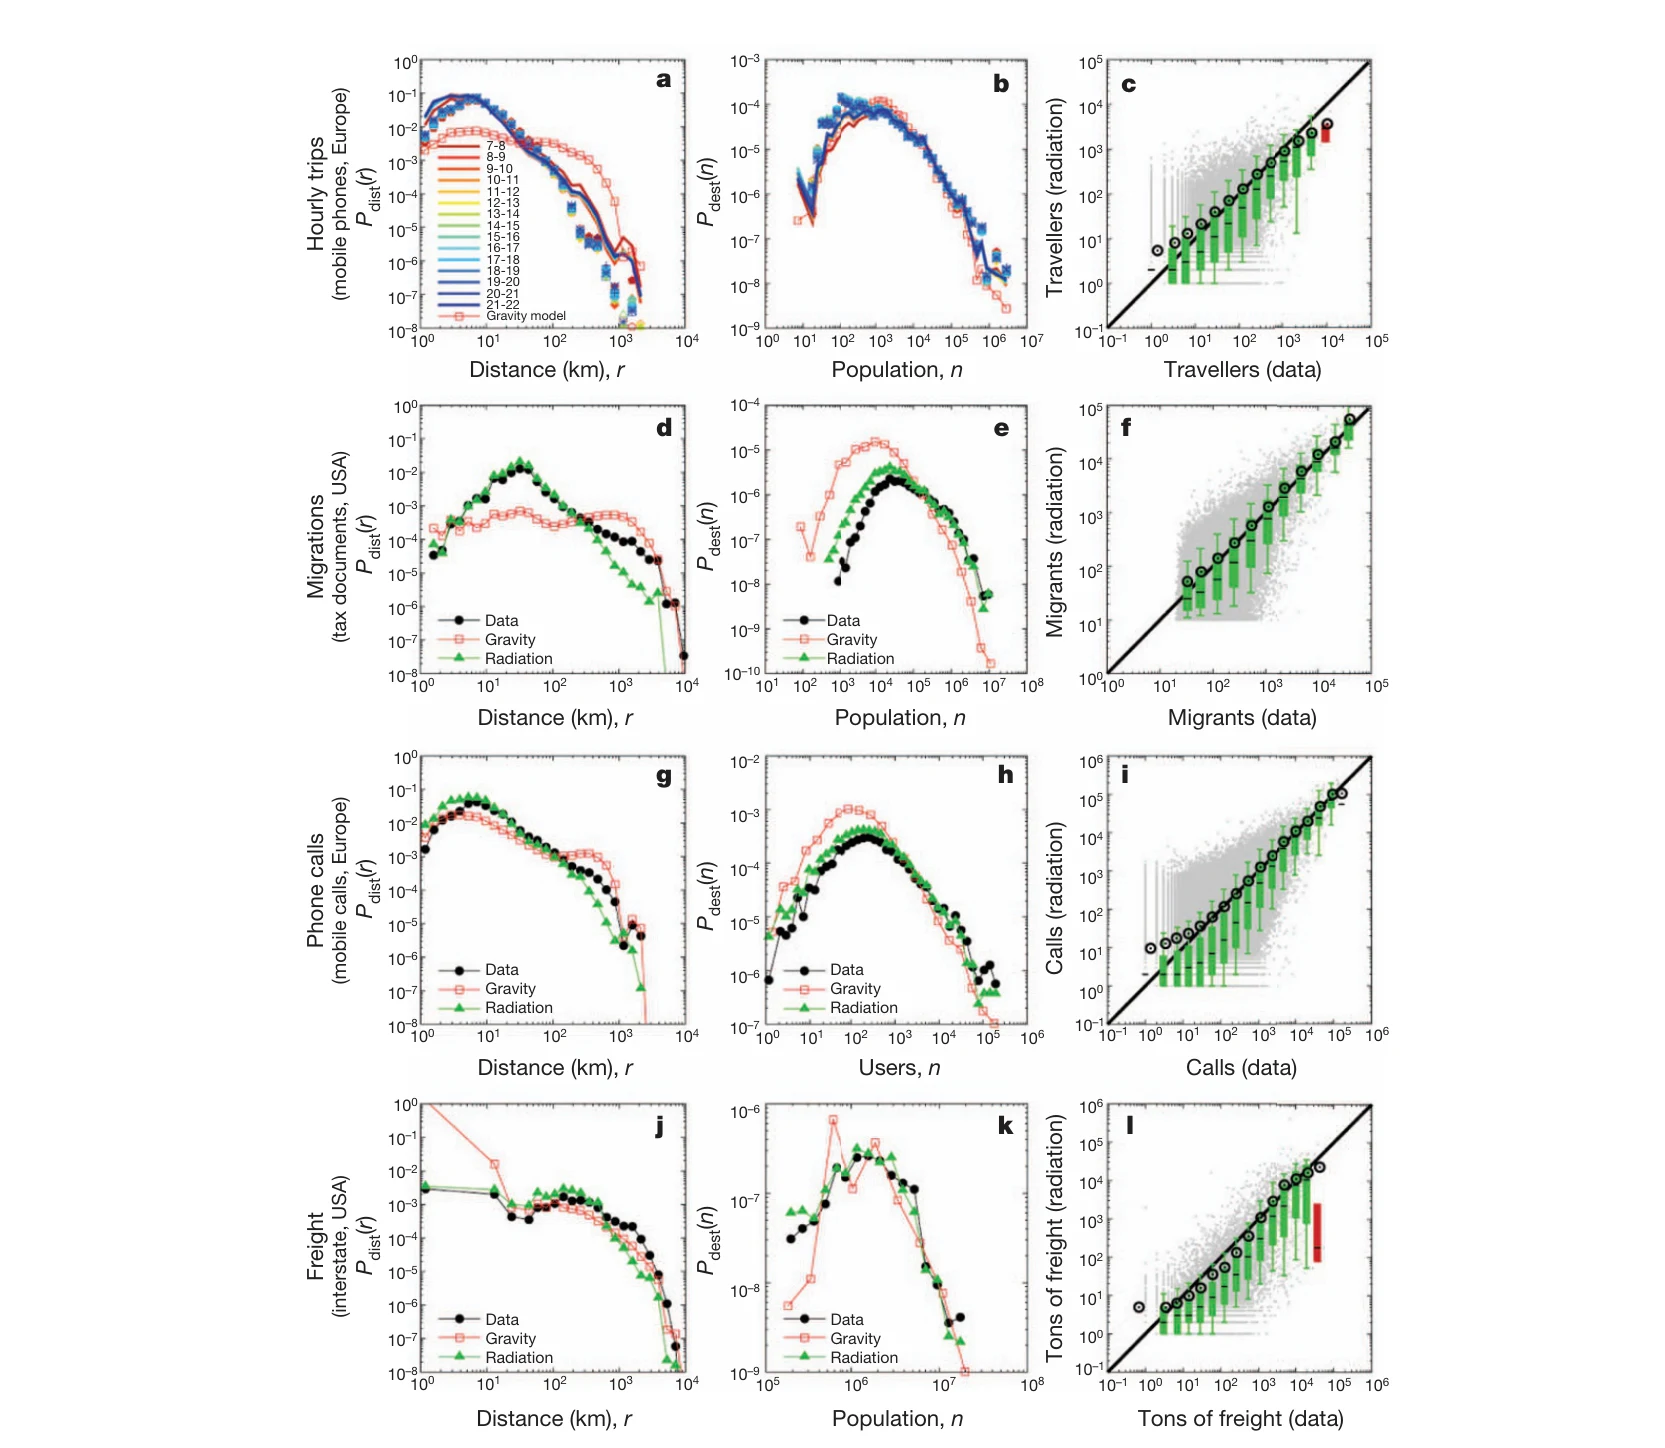
图 3|同一条分配公式,换到出行、迁移、电话和货运还站得住吗?
(a)西欧手机数据中,市镇间行程距离分布 P_dist(r)。图例从7–8时到21–22时共15档,实线为辐射模型,空心方块为24小时合并拟合的引力模型。(b)这些行程前往人口为 n 的市镇的概率 P_dest(n)。(c)由通话最多的位置识别家和工作地之后,市镇对的观测通勤人数与辐射模型预测;只保留两者都大于0的市镇对,对角线表示预测等于观测。(d–f)美国县与县之间、2007–2008纳税年度的迁移人数,依次为距离分布、终点人口分布,以及观测人数对辐射模型预测。(g–i)4周市镇间电话量,距离分布、用户数分布,以及观测通话次数对预测。(j–l)美国州和主要都市区之间的货运吨数,距离分布、终点人口分布,以及观测吨数对预测。黑、红、绿在有这三种图例的面板里分别表示数据、引力模型和辐射模型。来源:原论文 Fig. 3。
正文的判断是:辐射模型能够同时描述小时移动、每日通勤和年度迁移,也能描述通勤、日内出行、通话和贸易这些不同过程;数据来自普查、手机和税单,地理上包括美洲和欧洲。作者认为这种一致有些出人意料,并把它理解成模型里的决策假设以直接或间接的方式和多种流动有关。
这个判断的证据是各面板里辐射模型的曲线或分箱均值比引力模型更靠近数据,而不是一组统一的误差百分比。正文没有为图3报告相关系数、均方误差或“高估多少倍”。电话面板的横轴写的是用户数,货运面板的纵轴是吨,都不能读成通勤人数。模型在这里预测的是流量怎样随人口和周围人口分配;它没有观察货主或打电话的人是否真的在比较工作机会。
不同大小的县,远行概率能落到同一条曲线上吗?
若把起点、终点和圈内人口同时乘上同一个倍数,单次出行从 i 到 j 的概率 Tᵢⱼ / Tᵢ 不变。这是公式的尺度不变性。图4用“从人口为 m 的地点出发,目的地落在圈内人口超过 s 的区域”的概率来检查它。m 的范围是200到2,000,000。
按模型,这个概率是 1 / (1 + s/m),只依赖比值 s/m。图4a按 s 本身来画时,不同 m 的曲线分开。改成横轴 s/m 之后,曲线靠向 y = 1 / (1 + x)。再把家乡人口一律加上 ε = 35,000,横轴改为 s / (m + ε),重合更好。
这35,000人的来历,是在家乡额外增加 ε / njobs 个工作机会,效果相当于把家乡人口从 m 改成 m + ε。作者的解释是家乡优势:人更熟悉本县的就业信息。调整后的概率在 (m + ε) 和 s 同时放大时保持不变。正文说,调整后的模型在所检验的各项指标上更好或至少同样好,对照放在补充图6;正文没有逐项列出这些指标的名称和数值。
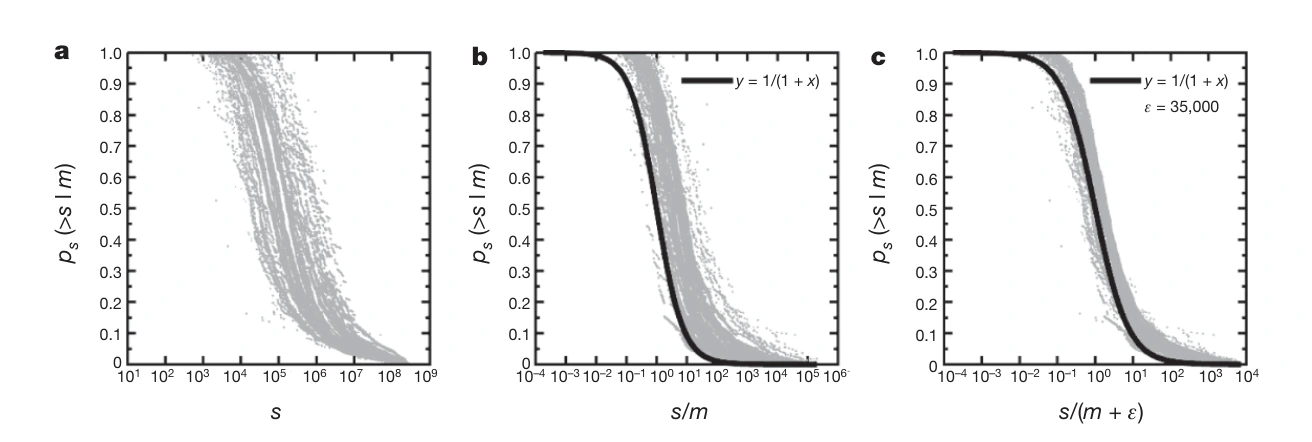
图 4|把圈内人口除以起点人口之后,远行概率会不会重合?
(a)纵轴是从人口 m 的地点出发、目的地落在圈内人口超过 s 的区域的概率,横轴是 s。灰色曲线对应不同的 m,范围从200到2,000,000。(b)横轴改为 s/m,黑线是 y = 1 / (1 + x)。(c)横轴改为 s / (m + ε),ε = 35,000,黑线仍是 y = 1 / (1 + x)。来源:原论文 Fig. 4。
人口分布会怎样改变一个人眼中的通勤地图,正文用补充图8说明。比较的是犹他 Davis County 和佐治亚 Clayton County 的两个人,两县人口分别是238,994和236,517。假如人口均匀,越远的工作越不值得去。实际密度改变了这张图:各县先按到家乡的距离着色,再按成为通勤目的地的可能性被挪近或挪远。这里保留的是正文对那张补图的文字说明,不是补图本身的逐县读数。
尺度重合是群体概率的性质。它说明在这套公式里,一个县是“远”还是“近”,要看沿途人口相当于家乡人口的多少倍。它没有证明每个通勤者都按这个比值做决定。
没有流量调查的地方,它究竟还能预测什么?
公式的空间分配只需要人口:谁在起点,谁在终点,到达终点之前的圆里还有多少人。因此,在没有系统流量调查的地区,它可以直接给出各目的地占起点总流出的比例。绝对人数还要乘上 Tᵢ。美国县际通勤里,这个总流出大约是人口的0.11倍;0.11的分母是图2g里的起点县人口。换一个国家,不能默认仍然是0.11,除非那里也有可比较的总流出比例。
模型假设每个空缺与常住人口成正比,好处是随机数,而且最近的“足够好”胜过更远的“更好”。这些假设使公式变得干净,也划出它不能直接测量的东西:真实职位空缺、工资、通勤时间、路网和行政边界造成的阻碍都没有进入式子。县是普查已经划好的单元,不是模型自己找出来的生活圈。
引力模型在人口接近均匀时会作为特例出现。所以辐射模型并不是在一切地理里都与引力模型冲突;冲突出现在周围人口厚薄不同的地方,图1的两对县就是这种情形。
把同一公式用到电话和货运,检验的是数学形式能不能描述这些流量。正文自己把跨领域的一致称为有些出人意料。拟合接近,说明这种“被沿途机会截住”的分配方式值得当作共同的定量框架,还不足以单独证明每一种流动都由求职过程造成。
一句话总结
两地之间有多少人流动,在这个模型里取决于出发之前要穿过多少人;所以人口和距离都相近的两条通勤,仍然可以差出一个数量级。
核心来源
- Simini, F., González, M. C., Maritan, A. & Barabási, A.-L. A universal model for mobility and migration patterns. Nature 484, 96–100 (2012). DOI:10.1038/nature10856。在线发表于2012年2月26日,纸本日期为2012年4月5日。
- 正文图1至图4,以及正文对补充材料第2、4、7、8节和补充图6、补充图8的文字说明。平均流量公式、0.11的比例、35,000的家乡修正,以及各数据集的样本量,均以正文和图中印出的数字为准。
作者介绍
论文写明四位作者共同设计并完成研究。下面只写署名机构和这篇论文里的分工。
- Filippo Simini:署名东北大学复杂网络研究中心及物理、生物与计算机科学系,帕多瓦大学 G. Galilei 物理系(CNISM 与 INFN),以及布达佩斯技术与经济大学物理研究所。他分析实证数据、做数值计算,并与 Maritan 完成解析推导。
- Marta C. González:署名麻省理工学院土木与环境工程系。文中手机数据引用的2008年个体移动研究,作者包括 González、Hidalgo 与 Barabási。
- Amos Maritan:署名帕多瓦大学 G. Galilei 物理系(CNISM 与 INFN)。他与 Simini 完成解析推导,通讯邮箱为 amos.maritan@pd.infn.it。
- Albert-László Barabási:署名东北大学复杂网络研究中心及物理、生物与计算机科学系,Dana-Farber 癌症研究所癌症系统生物学中心,以及哈佛医学院布列根和妇女医院医学系。他是本稿主笔,通讯邮箱为 alb@neu.edu。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
家乡修正 ε = 35,000 是一个固定人数,而图4里的起点人口从200一直画到2,000,000。35,000除以200等于175,除以2,000,000等于0.0175。对图中最小的那些地点,加上的人数是本地人口的一百多倍;对最大的县,只相当于人口的大约1.75%。曲线变得更重合,在小地方和大地方的含义因此不一样:小地方的横轴几乎变成 s / 35,000,大地方才仍然接近 s / m。若家乡优势其实是“比外地多知道一定比例的职位”,而不是多出固定的35,000个等价居民,小县和大县的修正就应该分开估计。论文展示了固定 ε 能改善重合,没有比较这两种修正。
另一件可以直接从公式问下去的事,是圈内人口变厚之后,远方终点即使同步变大,也不一定接得到更多人。分母里同时有 s 和 n。一个远端城市增加人口,若中间地带增加得更快,分配到远端的比例仍可能下降。这对“把住房建在大中心旁边,还是建在已经很密的中间圈层”会给出不同的通勤方向。图1只比较了现实中的两对县,没有做这种人为改变 s 的政策实验,所以它至多是公式的推论,不能当成已经测到的建设效果。