一块区域的周一和周日,为什么不是同一群人?
论文名片|Etienne Thuillier、Laurent Moalic、Sid Lamrous、Alexandre Caminada,Clustering weekly patterns of human mobility through mobile phone data,IEEE Transactions on Mobile Computing,2018,17(4):817–830,2018年4月印刷出版。DOI:10.1109/TMC.2017.2742953。本文依据该 DOI 的期刊接收稿解读;稿首页写明文章已被接收、尚未终校,正式出版前内容可能变动。
2014年10月,巴黎附近一块约70平方公里的区域里,工作日白天有一大批手机出现在区内、夜里不在;到了周末,这批手机的曲线落下去,另一批只在周末出现的手机升上来。用周一的身份去准备周日的车位和道路,准备的是已经离开的人。
这项研究先给每台手机的每一天贴一个在场标签,再把周一到周日拼成周模式。区域的总人数一周又一周很稳,稳下来的是十几类轮换:有人整周白天离开、周末留在附近,有人工作日进入、周末消失,还有人只在某一个工作日穿过。按大约三分之一的运营商份额把人数放大以后,居民总数和从外部进入的人数接近法国官方对15–64岁人口的统计;白天留在区内还是离开,手机和问卷明显分开。
先说结论
- 三周呼叫详单按周重新匿名。清洗后每周的不同设备数是534,820、527,622和535,271,三周相加为1,597,713。这个和是三套周身份相加,因为同一部手机不能跨周连起来。
- 每天用一组互斥规则贴上六个在场标签或当日缺席。每周抽取10,000台设备,论文写为数据集的1.87%。九次 k-means 合并出12个周模式,平均覆盖8,275/10,000,即82.75%。引言把这一覆盖写成约80%。
- 在10,000台的平均结果里,工作日离开、周末转向区内的居民簇有623.11台;工作日进入、周末缺席的通勤簇有373.11台。五个“只在某一天出现”的簇合计3,946.3台。只在周末出现的簇最大,平均2,381.78台。
- 把第2周全部527,622台设备归入这12个模式后,再乘以10/3。居民调整值为251,460,对照普查中15–64岁的272,900,相对差距为7.86%,论文据此给出92.14%的相符率。区内活动调整值107,617对照172,050,少64,433人;区外活动调整值142,843对照100,850,多41,993人。外部进入者116,543对照120,230,相对差距为3.07%。
详单记下的是基站上的一次事件
研究对象是人类移动性(human mobility),这里具体指人在这块区域进、出、停留和穿过,而不是搬家。材料是呼叫详单(call detail records,CDR):运营商为计费保存的记录。每条至少有国际移动设备识别码(IMEI,一台终端的编号)、时间和小区编号。小区是基站覆盖的范围,城区微小区可以只有约300米宽,乡村宏小区可以宽到约30公里,边界还互相重叠。手机被记到某个小区,只说明它当时位于这块覆盖里。
数据来自2014年10月的三个星期,区域在巴黎附近,约70平方公里,有建筑、住宅、商店、公司、铁路和公路。后文补充它位于巴黎西南,公司和学校多,也有大型文化场所。正文没有写出市镇名,也没有写运营商名称。数据节写这块郊区约有13万居民;后文普查表又给出412,500名居民。两套人口口径并列出,正文没有解释差额。
作者先圈定与研究区重叠的小区,称为 S1;再把整个法兰西岛的小区收成 S2。凡在三周里至少一次出现在 S1 的手机,它在 S1 与 S2 范围内、这三周之内的事件都被留下。因此区外的法兰西岛行程还在数据里,但后面的六个标签只看 S1 内的在场和缺席,49维周向量里没有目的地。
隐私处理把三周拆开,每周用不同的密钥替换 IMEI,所以不能判断下一周的号码是不是同一部手机。事件类型被抹掉。每周记录少于10条的 IMEI 被删除。境外漫游号码只有在来源国的不同 IMEI 超过10个时才保留。处理后,每周子数据集超过1.75亿条 CDR、超过60万个 IMEI。正文随后点名的三周设备数分别是534,820、527,622和535,271。超过60万与这三个数之间没有剔除明细。摘要中的超过8亿条 CDR、超过160万个人,对应的是整份数据和三周设备数之和1,597,713。
两次事件之间,模型把手机继续算在上一个基站上。网络本身会在通话期间大约每3分钟记一次,若没有其他事件则大约每3小时做一次位置更新。事件类型已被删除,读者不能再分辨某一条是电话、短信、切换还是这种定时更新。手机没电、没信号或少于每周10条而被删掉的人,不会进入后文任何一张人数图。
六个标签来自一组有先后顺序的规则
当地需要知道谁在住、谁白天进来、谁只是穿过。作者把每一天硬分成一个标签。规则按顺序执行,前一条成立就停止。模糊分类被留作后续工作,本文没有结果。
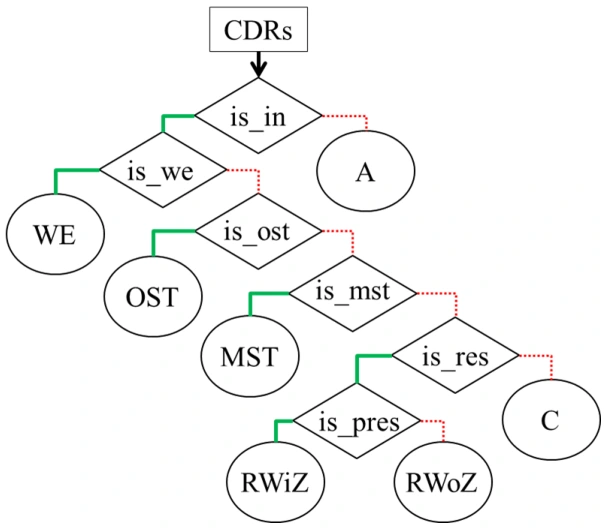
图 1|一天的详单怎样落到唯一一个标签?
流程从 CDR 进入。当天在 S1 至少出现一次才继续,否则为缺席 A。若这台设备只在周末窗口出现,标签为周末 WE;周末窗口写作周五19:00到周一06:00的开区间。若当天第一次到最后一次 S1 事件的跨度不超过1小时,标签为单次短时过境 OST。若一天里有多段停留、每段不超过1小时且彼此相隔超过3小时,标签为多次短时过境 MST。若夜间 [00:00, 06:00) 和 [19:00, 23:59] 没有都在 S1 被探测到,标签为通勤进入者 C。若 S1 内相邻事件的间隔都不超过3小时,标签为区内停留居民 RWiZ,否则为日间离区居民 RWoZ。绿线表示条件成立,红虚线表示不成立。来源:原论文 Fig. 1。
这套名字比规则窄。C 是“没有被前面几条规则截走”的剩余类:白天在区内、停留跨度超过1小时、又缺少至少一个夜间窗口。访客在区内待一个工作日,也会进入 C。RWiZ 与 RWoZ 里的“工作”来自白天是否连续留在 S1,职业并未被观测。WE 排在 OST 之前,所以只在周六出现20分钟的设备会得到 WE,不会得到 OST。
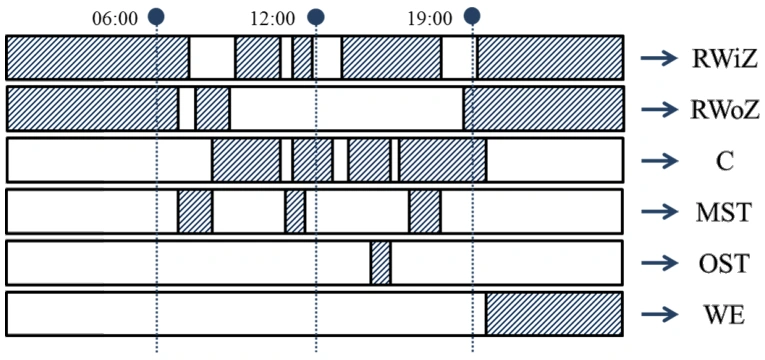
图 2|同一条时间轴上,六种标签各长什么样?
横轴标出06:00、12:00和19:00。阴影是示意的 S1 在场时段,右侧是规则给出的标签。RWiZ 从夜间延续到次日夜间,白天只有短缺口。RWoZ 保住两端夜间,白天有大段空白。C 集中在日间,两端夜间为空。MST 是彼此分开的几小段。OST 只有午后一小段。WE 画在19:00之后。这些横条是分类例子。末行还可以出现在周六或周日的任意时刻。来源:原论文 Fig. 2。
作者把穿过全区所需时间写成大约1小时,OST 的阈值也是1小时。因此“短时过境不超过1小时”首先是规则的定义。阈值换成90分钟,一部分人会离开 OST、进入后面的类别。本文没有报告这个敏感性。
三周的总曲线很稳,同一标签里的人在换
把 RWiZ 与 RWoZ 合成居民,把 OST 与 MST 合成过境,再按21天画出全部被探测设备。
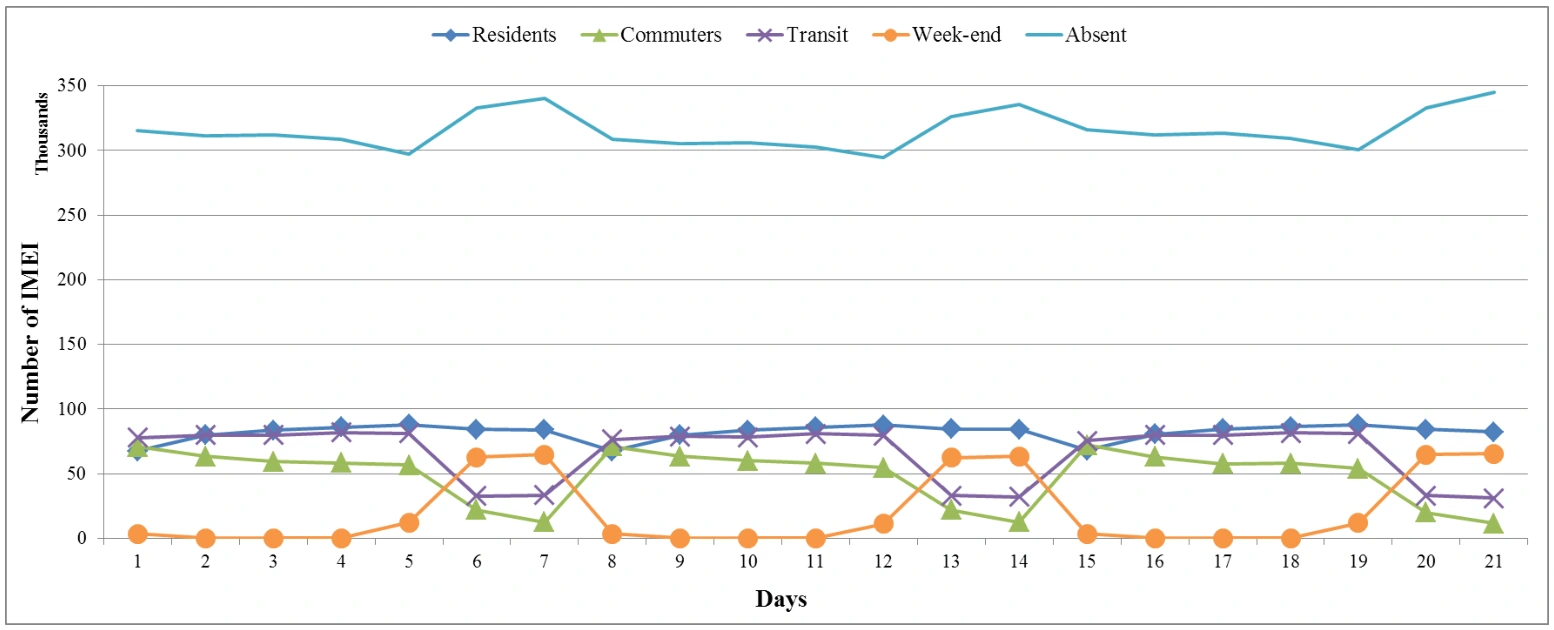
图 3|三周里,每天哪一类人最多?
横轴是21天,纵轴是 IMEI 数,单位为千。蓝色菱形是居民,绿色三角是通勤进入者,紫色星是过境,橙色圆是周末出现者,浅蓝线是当日缺席。缺席曲线全程最高,大致位于30万到34万之间,并在每个周末抬高;另外四条都在10万以下。通勤和过境在周末下降,周末出现者在周末上升、工作日接近底部。来源:原论文 Fig. 3。
三条周曲线的合计变动被写成0.658%。与此同时,三周的不同设备数是534,820、527,622和535,271。最高周比最低周多7,649台,相当于三周均值532,571的1.44%。0.658%描述的是各日标签曲线合计的周际变动;1.44%描述的是每周设备总数的极差。一台设备可以只出现在其中一周,因为另外两周它可能没有进入 S1,也可能没有通过记录数门槛。
正文还写,60%的被探测 IMEI 并不是每天都出现。这句话的分母是设备,统计的是“七天里是否有缺席日”。图3里某一天缺席曲线高达30万,分母是当天这一个标签的设备数。两个60%量级的说法使用的不是同一份分母,正文没有给出60%的计算表。
图3还不能回答“昨天的通勤者是不是今天的通勤者”。某一天的居民人数,是当天被贴上居民标签的设备数。
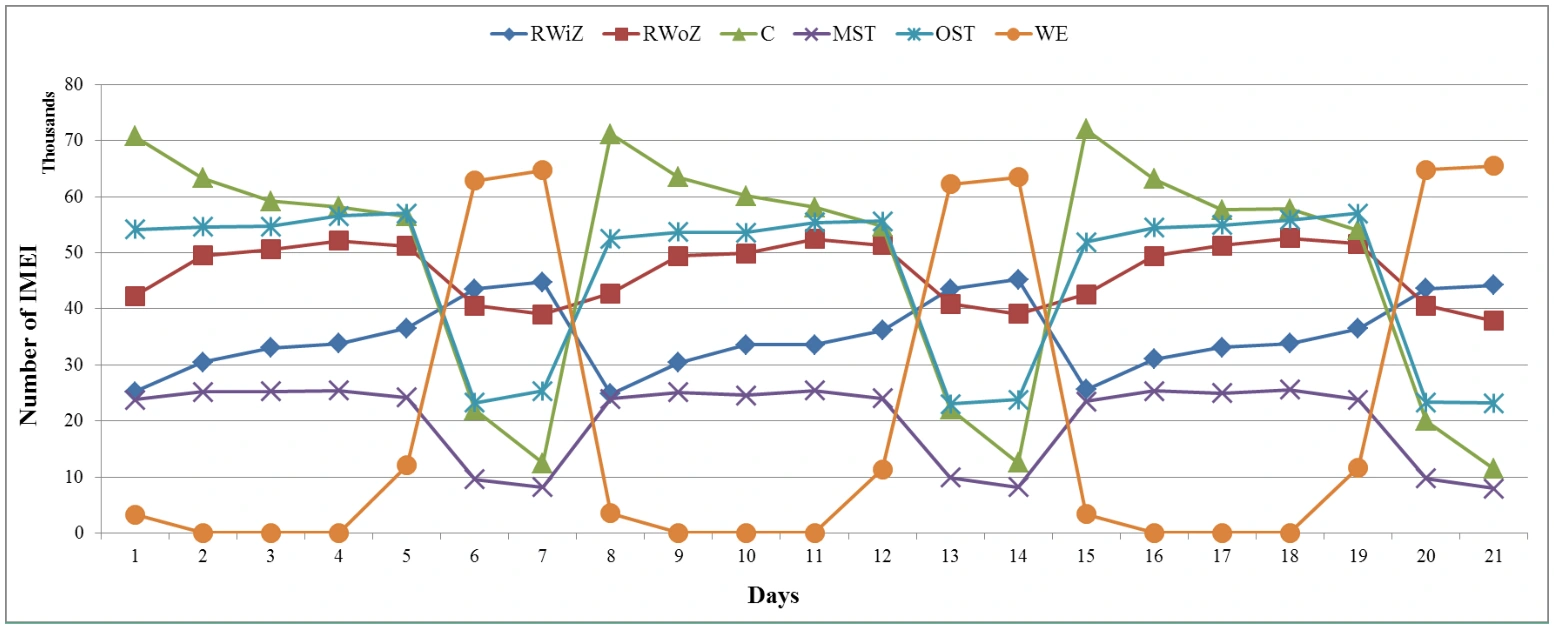
图 4|居民内部和过境内部是否也在重复?
横轴仍是21天,纵轴仍是千台 IMEI,缺席没有画入本图,所以纵轴到80即可。深蓝菱形 RWiZ 在一周内逐渐升高,周末达到高点。红色方块 RWoZ 在工作日较平,周一和周末较低。绿色三角 C 在工作日最高,周末降到图的下部。紫色叉 MST 与浅蓝星 OST 也在周末下降,OST 的工作日水平高于 MST。橙色圆 WE 在三个周末升到大约6万以上,工作日中间接近0。来源:原论文 Fig. 4。
正文的读法是:工作日这块区域同时承担通行和工作,这批力量周末不在;周末吸引的人与居民合计几乎处于同一量级,其中可以有游客,也可以有工作日在外、周末回来的学生。这些是曲线形状允许的解释。详单没有职业、居住登记或出行目的,不能把橙色圆点逐一分成游客和学生。
七天拼成一个向量后,一万台样本还像全区吗
既有研究常把若干工作日合成一种日模式,或把周末合成另一类。图3和图4显示,周一到周五已经有起伏,周末则换成另一批设备。本文因此保留每一天。
一台设备的一天写成七维 vector-day:六个标签加上缺席,当天只有一个1,其余为0,七个数之和为1。一周七天连成49维 vector-week,全部分量之和为7。
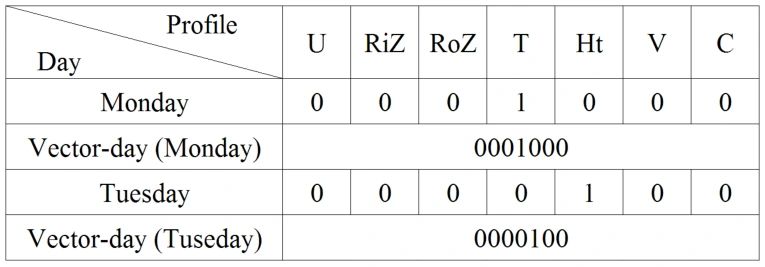
图 5|一天怎样变成七位0/1?
图中列名是缩写 U、RiZ、RoZ、T、Ht、V、C,正文没有再给缩写对照表。示例周一在第四列记1,七位串为0001000;周二在第五列记1,七位串为0000100。它展示的是“每天恰好一个1”。来源:原论文 Fig. 5。
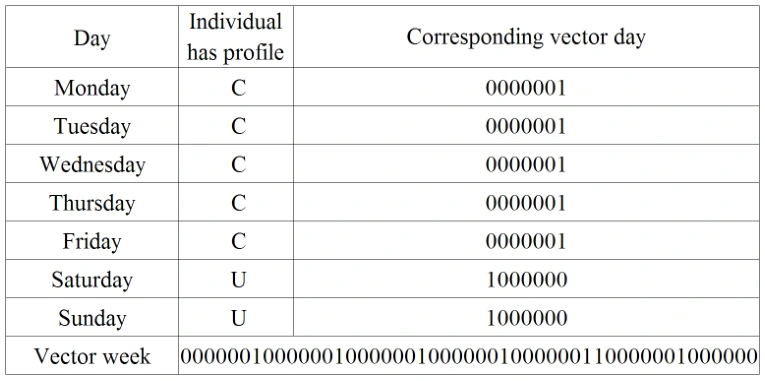
图 6|整周怎样变成49位?
示例中周一到周五的身份是 C,对应0000001;周六和周日是 U,对应1000000。正文说这个例子表示工作日通勤、周末缺席,因此这里的 U 与后文的 A 都指当天不在 S1。最底行把七天连成一条49位串。来源:原论文 Fig. 6。
直接对五十多万台设备做聚类会把样本里的偶然组合也学进去。作者每个星期随机抽10,000台,并写这是全部数据的1.87%。按第一周534,820台计算,10,000/534,820 = 1.87%;按三周平均532,571台计算为1.88%。三次抽样彼此独立,因为三周不能追踪同一部手机。
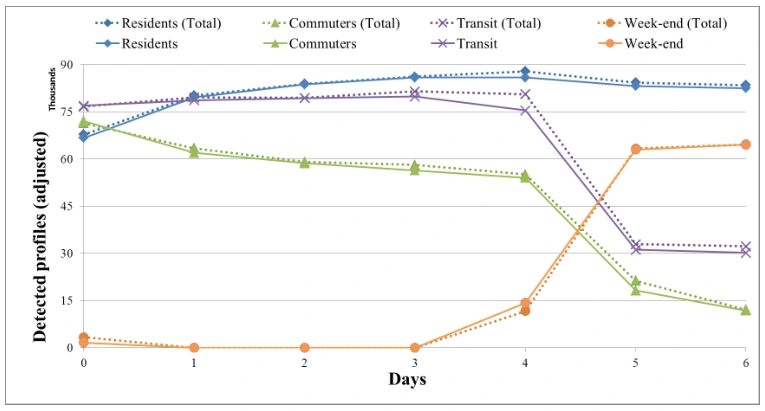
图 7|一万台样本放大后,是否还贴近全部设备?
横轴是0到6,对应抽样所用的一周;纵轴是调整后的探测标签数,单位为千。虚线是三周全量的日均人数。实线是三个一万台子集的人数,乘以“一周平均设备数 / 10,000”。居民、通勤、过境、周末四组都画了,缺席没有画。实线与虚线几乎重合:居民维持在八万上下,通勤和过境在周末降到大约1万到3万,周末出现者升到6万以上。正文计算,每天估错的标签平均占数据集的1.46%。换几批随机子集后,代表性与后面的聚类结论仍然相近;那些重复实验没有另附数据表。来源:原论文 Fig. 7。
轮廓系数指向大约60类,解释却停在更少的类
49维向量没有已知的分组个数。作者先用250台设备,把 k-means 的类数 k 从2试到250。每台设备有一个轮廓系数:
s(i) = (b(i) − a(i)) / max(a(i), b(i))
a(i) 是它到自己这一类的差异,b(i) 是它到次近类的差异。s(i) 接近1,表示它更靠近自己的类。平均轮廓系数是全部设备的 s(i) 再平均。
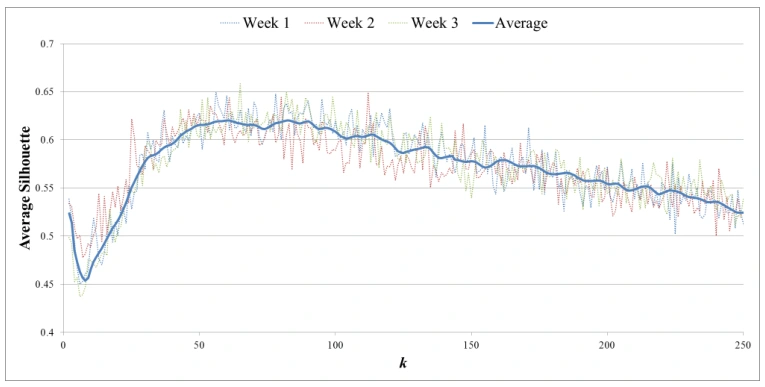
图 8|类数从2增到250时,分组质量怎样变化?
横轴是 k,纵轴是平均轮廓系数,图上大约从0.40到0.70。三条虚线是三个星期的子集,实线是三者平均。k 很小时平均曲线下降,随后升高;正文判断最好的位置在 k 约为60,也就是横轴上限250的大约三分之一附近。k 再增大,平均曲线缓慢下降。来源:原论文 Fig. 8。
k 增大时,每台设备更容易独占一个很贴身的小类,单看轮廓系数会变好,类别却多到无法解释区域。作者因此没有采用轮廓系数最高的 k,而是在20、50、70三档上各做一次,用来避开单次运行的局部结果。这是可解释性选择。图8的高峰数值没有印在正文里。
距离用汉明距离:49个位置里有多少个0/1不同。个体向量保持0/1。类中心先取成员49维向量的平均数,分量可以落在0到1之间,这样才能看见一类内部的少数派。计算距离之前,再把中心的每一天恢复成0/1:当天七个分量里最大的那个改为1,其余改为0。
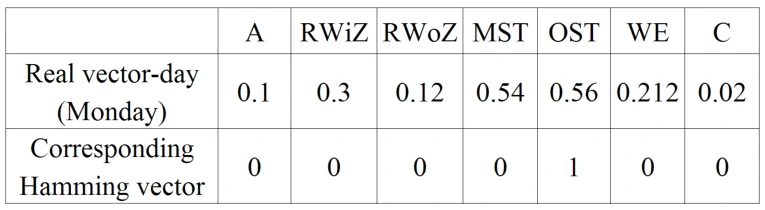
图 9|小数中心怎样变回汉明距离能用的0/1?
列是 A、RWiZ、RWoZ、MST、OST、WE、C。示例是一个周一:七个小数为0.1、0.3、0.12、0.54、0.56、0.212、0.02,最大项 OST 改为1,其余为0。这七个数相加为1.852,而真正的一日标签向量应相加为1,类中心因为是0/1向量的平均,一天之内也应相加为1。因此表中小数是在演示“取最大项”的规则,不能当作某个真实簇的周一构成。来源:原论文 Fig. 9。
每一档 k、每一个星期保留平均轮廓系数最好的一次运行,再只留下人数超过样本1%的簇,也就是10,000台里超过100台。若 k−1 个簇都刚好占1%,最后一个簇最少会留下:k=20时为81%,k=50时为51%,k=70时为31%。实际保留高得多。
| k | 轮廓系数的定性评价 | 保留簇的平均个数 | 保留设备 | 未进入保留簇的设备 |
|---|---|---|---|---|
| 20 | 弱 | 13.7 | 96.4% | 3.6% |
| 50 | 中等 | 16.7 | 86.44% | 13.56% |
| 70 | 好 | 16.7 | 82.34% | 17.66% |
三档保留率平均为88.39%,正文概括为将近88%。k 增大后,保留下来的设备比例下降,与图8里“类太多、整体质量回落”的判断同向。九次实验平均每次留下15.7个簇,合计141个。
十二个周模式里,谁整周重复,谁只来一天
九次实验里反复出现相似的簇。作者把两个簇的七天、各标签标准差求和,再取平均;平均值低于0.05就把它们连起来。0.05是经验阈值,正文没有做阈值扫描。每个连通集团再平均成一个主簇,得到12个。
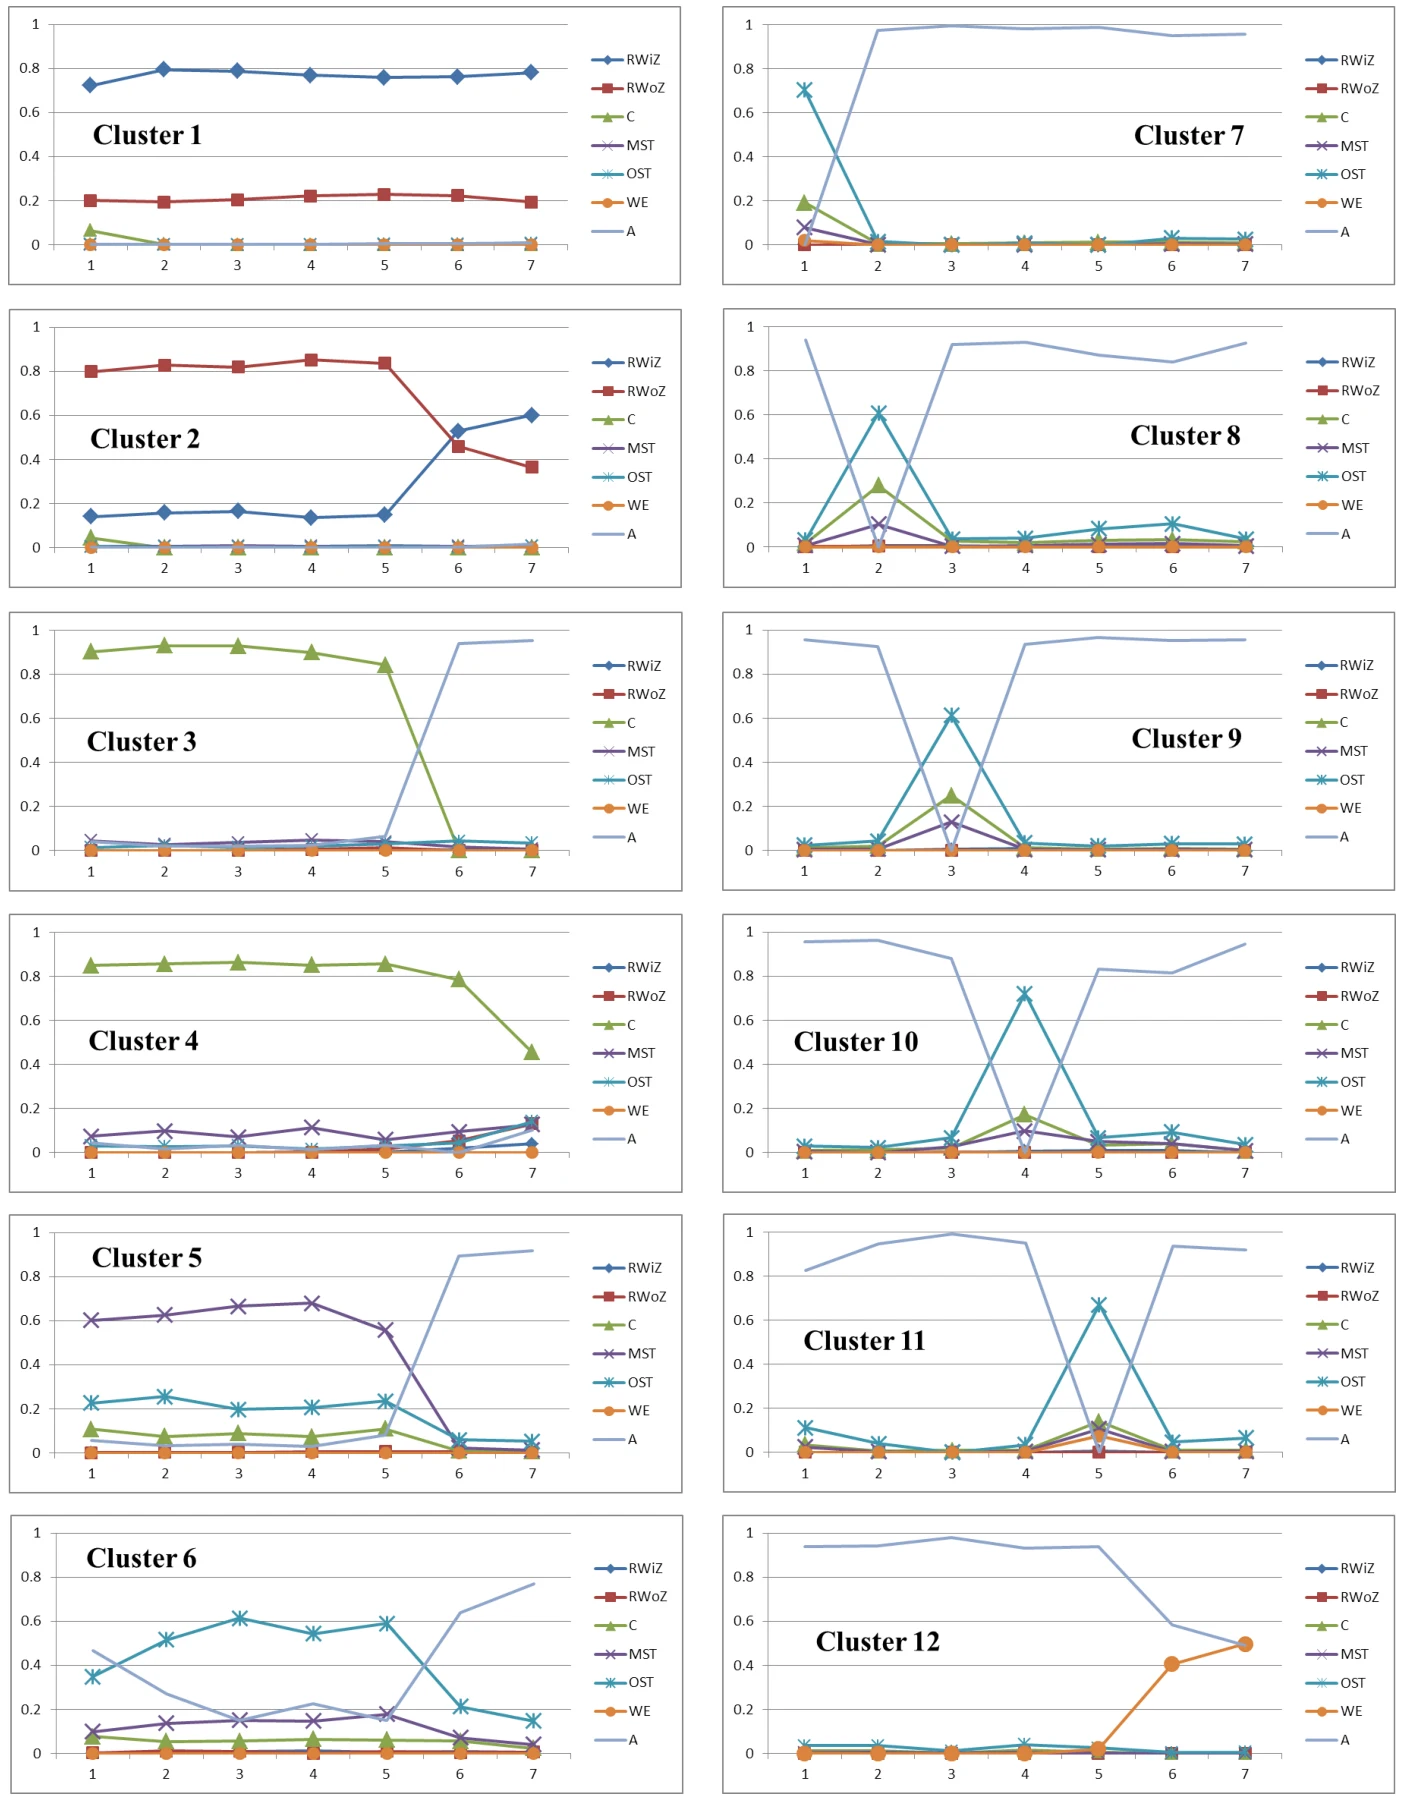
图 10|十二个主簇各自如何度过周一到周日?
这张图没有子图字母,十二个面板按簇号排列。每个面板横轴1到7表示周一到周日,纵轴0到1是该簇内部当天各标签的比例,同一天七条曲线相加为1。颜色与图4一致:深蓝菱形 RWiZ,红色方块 RWoZ,绿色三角 C,紫色叉 MST,浅蓝星 OST,橙色圆 WE,灰色线为缺席 A。
簇1整周以 RWiZ 为主,大约在0.75上下,RWoZ 大约在0.2。簇2工作日以 RWoZ 为主,大约在0.8以上,周末 RWoZ 下降、RWiZ 升到0.6附近。簇3工作日 C 接近0.9,周末转为缺席。簇4的 C 一直较高,周末才降到大约0.5,周日出现更多其他标签。簇5工作日 MST 大约0.6,并混有 OST,周末转为缺席。簇6工作日 OST 大约0.5到0.6,周末缺席上升,但 OST 仍留有一截。簇7到簇11都是六天缺席、一天出现尖峰:尖峰分别落在第1、2、3、4、5天,尖峰当天以 OST 最高,同时能看到 C 和 MST。簇12前五天几乎全部缺席,周六、周日转为 WE,周日略高。来源:原论文 Fig. 10。
下表是九次实验里每个主簇的平均人数,分母都是当次的10,000台。出现率是九次实验中该形态被并入主簇的比例。簇2、3、5、6、12每次都出现;簇7只出现在55.6%的实验里,也就是九次中的五次。
| 主簇 | 平均人数 / 10,000 | 九次实验中的出现率 | 论文给出的类型 |
|---|---|---|---|
| 1 | 400.25 | 88.9% | 居民 |
| 2 | 623.11 | 100% | 居民 |
| 3 | 373.11 | 100% | 通勤进入 |
| 4 | 164.57 | 77.8% | 每天都在通勤 |
| 5 | 225.88 | 100% | 每天过境 |
| 6 | 160.66 | 100% | 每天过境 |
| 7 | 744.2 | 55.6% | 单日穿过 |
| 8 | 665 | 66.7% | 单日穿过 |
| 9 | 889.62 | 88.9% | 单日穿过 |
| 10 | 794.66 | 77.8% | 单日穿过 |
| 11 | 852.83 | 77.8% | 单日穿过 |
| 12 | 2,381.78 | 100% | 周末来访者 |
十二个平均数相加为8,275.67,正文取8,275台,占10,000的82.75%。簇7到簇11相加为3,946.31,占样本的39.5%;正文概括为将近三分之一。簇12单独占23.8%,是样本里最大的一类。
正文对几个簇给了更细的比例。簇2在工作日几乎83%是 RWoZ、15%是 RWiZ;周末转向区内。作者据此说,工作日去区外的居民里,将近60%周末留在附近。簇1则大部分时间都是 RWiZ,这一比例为该簇的76%。簇9有889台,约占样本的9%,尖峰在周三:61%为 OST,25%为 C,13%为 MST。61%与13%相加,74%的停留短于1小时,25%被规则视为全天在区内。作者把这组人解释为过路运输、周三下午活动、参观企业或学校的人,并因为区域内有文化场所而加上游客。详单不能区分这些目的,74%与25%只说明周三这一天的标签构成。
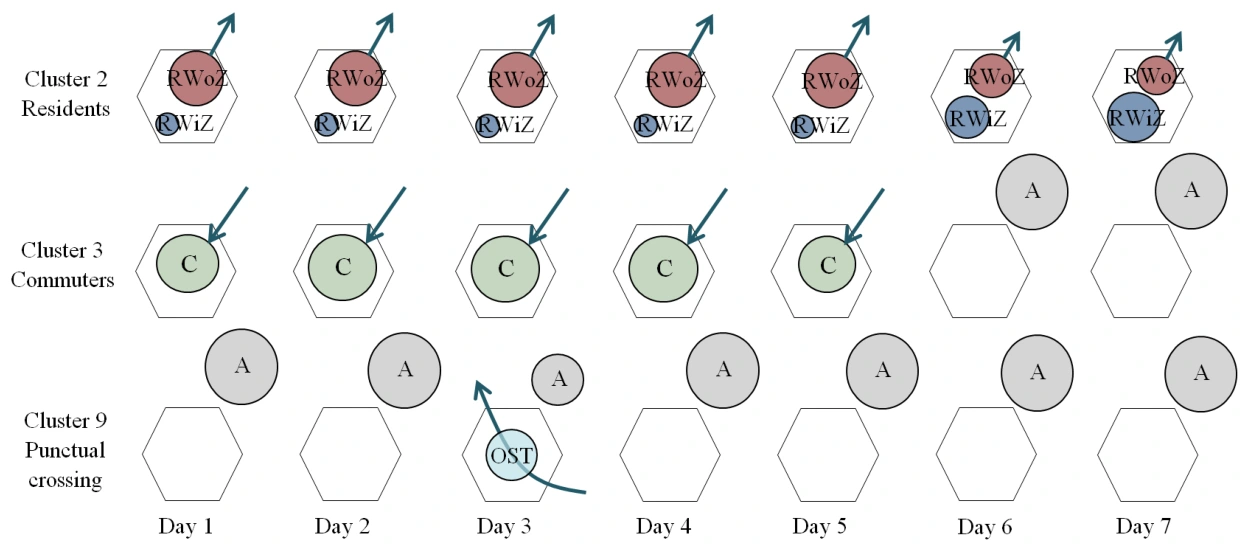
图 11|居民外出、通勤进入和单日穿过,在七天里如何交替?
三行对应簇2、簇3和簇9,列是第1天到第7天。六边形表示区域,圆的大小表示该簇当天的标签比例,箭头表示方向。簇2工作日以红色 RWoZ 为主、箭头向外,蓝色 RWiZ 较小;周末蓝色变大、红色变小,箭头仍向外。簇3前五天是绿色 C、箭头向内,周末变成灰色缺席,六边形空着。簇9只在第3天画出穿过区域的 OST 箭头,旁边有一个较小的缺席圆,其余六天都是缺席。这张图是三个簇的示意图。簇9周三实际还有25%的 C 和13%的 MST,图中没有按这三个比例并列画圆。来源:原论文 Fig. 11。
正文有一处把这张动态图写成 Figure 12,图注编号是 Fig. 11。后面的类别嵌套图才是 Fig. 12。这里按图注编号。
乘以10/3之后,哪一个数靠近普查
验证使用法国国家统计与经济研究所 INSEE 的三套面对面调查:人口普查、职业流动和学生流动。正文没有给出三套资料的调查年份,因此不能判断它们与2014年10月相差多久。普查给出居民总数、15–64岁人数、劳动力,以及非劳动力中的非学生。两套流动调查把“在区内活动的人”分成:住在本区并在本区活动、住在本区但到外区活动、住在外区但到本区活动。论文把就业者和学生都算作活动人口。
| 来源 | 区内活动 | 到区外活动 | 从区外进入 |
|---|---|---|---|
| 职业流动 | 98,550 | 85,950 | 101,915 |
| 学生流动 | 27,115 | 14,900 | 18,315 |
| 非劳动力且非学生、留在区内 | 46,385 | ||
| 论文加总 | 172,050 | 100,850 | 120,230 |
172,050 = 98,550 + 27,115 + 46,385,被当作 RWiZ。100,850 = 85,950 + 14,900,被当作 RWoZ。120,230 = 101,915 + 18,315,被当作 C。普查另有居民412,500、15–64岁272,900、劳动力207,650、非劳动力且非学生46,385。207,650与46,385相加是254,035,比272,900少18,865;区内与区外的就业者98,550 + 85,950 = 184,500,也少于劳动力207,650。正文没有解释这两处差额。数据节还把非劳动力写成包含学生,表头则写成非劳动力且非学生。后文的加总采用表中的46,385,学生另走流动调查。
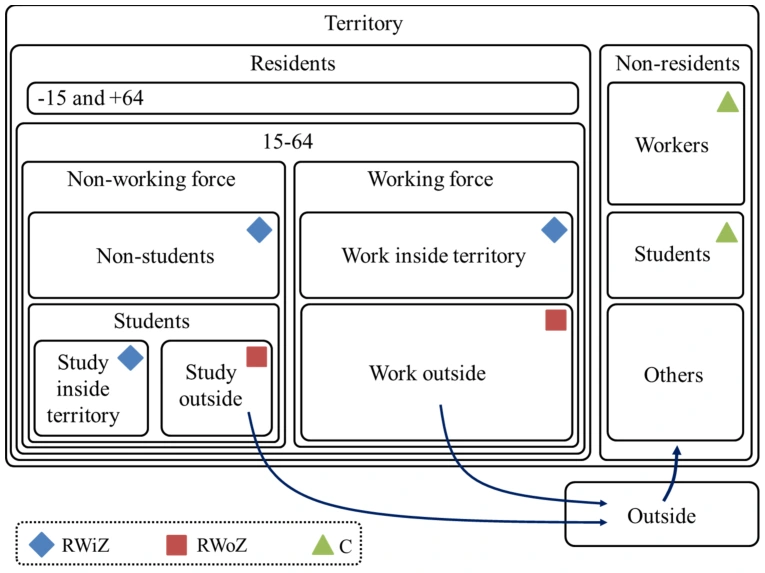
图 12|官方类别怎样被加进 RWiZ、RWoZ 和 C?
大框是区域及其居民,右侧是非居民。15岁以下和64岁以上单独放在15–64岁框外。蓝菱形 RWiZ 来自非学生的非劳动力、区内就业和区内就学。红方块 RWoZ 来自区外就业和区外就学,箭头指向区域外。绿三角 C 来自区外的就业者和学生,箭头指向区内。右侧的 Others 没有标进三类。这是类别如何加总的示意图,框的面积不表示人数。来源:原论文 Fig. 12。
手机侧改用第2周的全部527,622台设备,每台分进12个主簇之一。正文说第1周和第3周结果相近,但只印出第2周。某个标签的人数,是“该簇里这个标签的平均比例”乘以“该簇的实际人数”,并且只用该标签明显存在的簇。RWiZ 取簇1和簇2:比例约0.8时得到19,993人,约0.2时得到12,292人,合计32,285。
| 标签 | 来源簇与人数 | 合计 |
|---|---|---|
| RWiZ | 簇1为19,993,簇2为12,292 | 32,285 |
| RWoZ | 簇1为5,898,簇2为37,164 | 43,153 |
| C | 簇3为23,897,簇4为11,066;簇7至11的平均为13,148 | 常客合计34,963 |
| OST | 簇5为11,400,簇6为2,669;簇7至11的平均为31,618 | 常客合计14,069 |
| MST | 簇5为2,043,簇6为9,748;簇7至11的平均为4,330 | 常客合计11,791 |
| WE | 簇12为62,882 | 62,882 |
RWiZ、C、OST、MST 的分项都能加出表中的合计。RWoZ 的5,898与37,164相加是43,062,比印出的43,153少91,正文没有说明。簇7至11的数字是五个单日簇的平均值,不是五天相加。
这些人数只属于提供数据的那一家运营商。作者按法国当时三家主要运营商、大约三分之一的常用份额来放大,并把图3估计出的居民81,912除以普查15–64岁人数272,900,得到0.300,用来支持“这一家约占三分之一”。81,912的逐日读法没有另附计算。真正被放大的居民数是簇内合计75,438,也就是32,285 + 43,153;75,438 / 272,900 = 0.276。放大系数用的是10/3,约3.333,而不是272,900 / 81,912。
| 标签 | 放大前 | 乘以10/3后的印出值 | INSEE对照 | 相符率 |
|---|---|---|---|---|
| 居民 | 75,438 | 251,460 | 272,900 | 92.14% |
| RWiZ | 32,285 | 107,617 | 172,050 | 62.55% |
| RWoZ | 43,153 | 142,843 | 100,850 | 58.36% |
| C | 34,963 | 116,543 | 120,230 | 96.93% |
75,438 × 10/3 = 251,460,32,285 × 10/3四舍五入为107,617,34,963 × 10/3四舍五入为116,543。43,153 × 10/3应四舍五入为143,843,表中却印142,843。107,617与142,843相加是250,460,比居民调整值251,460少1,000。这1,000人的差额没有解释。
四行相符率都等于 1 − |手机调整值 − INSEE| / INSEE,分母是 INSEE。居民、RWiZ 和 C 的手机值较小,所以相符率就等于手机值除以 INSEE:251,460 / 272,900 = 92.14%,107,617 / 172,050 = 62.55%,116,543 / 120,230 = 96.93%。RWoZ 的手机值更大,142,843 / 100,850 = 1.416,也就是调查值的1.42倍;相符率不是这个比值,而是 1 − 41,993 / 100,850 = 58.36%。正文没有写出公式,四行数字与上述算法一致。它不是相关系数。
绝对差额也直接来自这两列:RWiZ 少64,433人,正文说大约少6.4万人;RWoZ 多41,993人,正文说大约多4.2万人。作者的解释是,问卷里的工作地常常是所属单位,出租车司机、运输人员、出差者和管理者人在区外,手机会把他们记到区外。引用的 INSEE 定义支持“申报工作地可以是单位所在地”。手机数据本身没有这些人的职业,所以职业名单是对差额的解释,差额本身才是本次算出来的结果。正文另说,动态信息里人们的说法和实际做法之间误差可高达30%。本次两列的相对差额是64,433 / 172,050 = 37.45%,以及41,993 / 100,850 = 41.64%。30%不是表中的一行。
普查没有单列的人,正好是手机多出来的动态
居民总数和外部进入者对得较近之后,作者把过境和周末出现者当作新区指标。下表仍分两套簇:簇3、4、5、6、12是反复出现的模式,簇7到11是单日模式的平均值。放大仍是乘以10/3。
| 标签 | 反复出现的簇,放大前 | 放大后 | 五个单日簇的平均,放大前 | 放大后 |
|---|---|---|---|---|
| C | 34,963 | 116,542 | 13,148 | 43,827 |
| OST | 14,069 | 46,897 | 31,618 | 105,393 |
| MST | 11,791 | 39,303 | 4,330 | 14,433 |
| WE | 62,882 | 209,607 |
通勤者这一行的放大值在前一张表是116,543,这里是116,542,差1,与四舍五入的取整位置一致。其余各行与乘以10/3后的四舍五入相符。
正文说,每天大约有47,000名 OST 和39,000名 MST,对应的是反复出现的簇放大后的46,897和39,303,分母是第2周设备按10/3放大后的这一类人,不是527,622本身。只在周末出现的调整值是209,607,正文写成将近21万人,并说这占当时在场人口的33%。五个单日簇的 C、OST、MST 放大值相加为43,827 + 105,393 + 14,433 = 163,653,正文写成将近16.4万人,并说这约占白天在场者的20%;其中停留短于1小时的约105,000人占12%,对应 OST 的105,393。33%、20%和12%的分母都没有印出来,也不能由现有的表唯一反推。
单日簇使用的是五天的平均值。若五个簇是五批不同的人,把平均值当成“只来一天的总人数”会少算;正文确实是按平均列来写16.4万和10.5万的。
对照停在份额、年龄和区域边界上
手机调整值与普查接近,说明在“15–64岁居民有多少”和“从外区进来活动的人有多少”这两项上,三分之一份额没有把数量级带偏。它还不说明每个标签都是同一种人。
IMEI 是终端。一人多机、一机多人、无手机的人,都不会按人口自动校正。放大时特意使用15–64岁,是因为作者认为这个年龄段更可能拥有手机,也是流动调查里的活动人口。15岁以下、64岁以上没有进入81,912 / 272,900的分母。若周末文化参观里有大量这两个年龄段的人,209,607这个放大值使用的仍是同一套三分之一系数。
13万与412,500同时出现,而且没有地图或市镇名单。若普查区大于 S1,居民相符率92.14%比较的就是两个不同的范围。小区宽度可到数十公里,住在边界附近的人可能因为覆盖重叠而被记入或记出 S1。
三周互相匿名,所以图3的重复证明的是区域每一周接收到相似的人群结构。它没有证明同一部手机下一周仍走同一个主簇。第2周的全量分类也没有印出每个主簇的人数,只印出按比例折算的标签人数,因此不能把10,000台样本里的23.8%直接乘到527,622上,当作周末簇的全区人数。
问卷是一天的申报,手机是2014年10月的三周。调查年份缺失时,两部分差额里有多少来自年份,无法分开。作者还打算比较模糊分类、样本大小和相似阈值,并换第二个区域。这些都写在后续工作里,本文没有结果。
一句话总结
这块区域一周又一周很稳定,稳定的是几类人轮流出现:工作日进出的人周末离开,另一批人周末才来,还有将近四成样本只在某一个工作日穿过;把单一运营商按大约三分之一放大后,居民总数和外部进入人数接近15–64岁普查,白天留在区内还是离开则与问卷分开。
核心来源
Etienne Thuillier、Laurent Moalic、Sid Lamrous、Alexandre Caminada,Clustering weekly patterns of human mobility through mobile phone data,IEEE Transactions on Mobile Computing,2018,17(4):817–830。DOI:10.1109/TMC.2017.2742953。
Etienne Thuillier 是论文第一作者。接收稿所附简介写明,他2013年在贝尔福-蒙贝利亚尔技术大学(UTBM)获得计算机科学工程师文凭,当时正在 UTBM 的 OPERA 团队攻读计算机科学博士,研究方向是智能交通服务以及人类与城市移动性。
Laurent Moalic 2003年在 UTBM 获得计算机科学工程师文凭,2013年在弗朗什-孔泰大学获得计算机科学博士学位。2004年起在 UTBM 交通实验室任研究工程师,工作涉及运筹、组合优化和人类移动性建模。简介写明他当时担任法国国家研究署项目 Norm-Atis 的团队负责人,项目内容是先进交通信息服务的新标准。
Sid Lamrous 是 UTBM 计算机科学副教授。1996年至1999年在贡皮埃涅技术大学获得系统控制研究生文凭和计算机科学博士学位,2011年至2013年负责三年的工程教育。简介写明,此前十年他从事组合优化算法和移动性的随机建模。
Alexandre Caminada 是 UTBM 计算机科学教授。他拥有巴黎第十二大学/巴黎第八大学人工智能研究型硕士、巴黎 ESIEA 计算机科学文凭,以及蒙彼利埃第二大学电信软件工程博士学位。1993年至2004年在法国国家电信研究中心 CNET 负责无线优化研究单元,2004年任 UTBM 教授。研究方向是移动和无线系统的资源优化与网络性能建模。
四位作者在论文署名中的单位都是勃艮第-弗朗什-孔泰大学、UTBM、OPERA 团队,地址为法国贝尔福。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若市政部门只用簇3来建工作日停车,这批设备在图10里周末已经转为缺席;周末在场的大头是簇12。两个簇在样本中的平均规模是373.11与2,381.78,相差约6.4倍。把它们合成一个“日均出行量”,会把周末真正在场的人平均掉。
OST 的1小时既是分类阈值,也是作者所说的过区时间。簇9里74%短于1小时,是这条规则的直接后果。若政策关心的是停留90分钟的到访者,这批人会在流程的下一步进入 C,单日穿过的10.5万就会改写。本文没有留下阈值对照。
81,912 / 272,900用来支持三分之一份额,分子来自图3的居民估计,分母把15岁以下和64岁以上留在外面。周末文化场所若主要接待这两个年龄段,209,607与“当时在场人口的33%”就会把儿童和老人的到访按劳动年龄人口的手机拥有率去放大。要检验这一点,需要运营商用户的年龄结构,或至少需要普查区与 S1 的地图叠加。接收稿没有这两份材料。
三周换了三套匿名键,所以簇9的周三尖峰在下一周是否仍由同一批设备组成,数据设计上就不能回答。图3证明的是这块区域每周接收到相似的结构。若交通模型把12个主簇当成同一批人的固定周程序,它使用的稳定性比这篇论文实际识别到的更强。可做的检验是在匿名政策允许时保留跨周的假名,看同一假名落入同一主簇的比例;这个比例在现有结果里不存在。