把每小时走过的人算进去,纽约的步行路等级和最危险路口还停在曼哈顿吗?
论文名片|Andres Sevtsuk、Rounaq Basu、Liu Liu、Abdulaziz Alhassan、Justin Kollar,Spatial distribution of foot traffic in New York City and applications for urban planning,Nature Cities,2026年2月6日在线发表。DOI:10.1038/s44284-025-00383-y。正式文章,2025年7月21日收稿,2025年12月12日接收。
工作日傍晚五点到六点,皇后区阿斯托里亚、31街与23大道,靠近迪特马斯林荫道地铁站。论文估计这里每小时有 1024 人在走,并认为这个量级已经对得上全球走廊的门槛。相邻的 23 大道和 31 街,在纽约市 2020 年步行机动性规划里仍被标成基线或社区连接路。路口人行道宽度倒是常常达到邻里走廊要求的 15 英尺。
同一套人流若拿去读事故,排序也会改。2012 到 2023 年,行人受伤人数最高的路口集中在曼哈顿中城、时代广场一带。把三个工作日高峰小时的估计人流放进分母之后,下城和中城退出风险最高的那一批,上曼哈顿、布朗克斯、布鲁克林、皇后区和史泰登岛更靠前。
这项研究先给纽约全城高峰时段的步行流量一个路段级估计,再把它当作基线,回看街道分级和路口风险。它支持的是:官方走廊类型并没有按实测或估计人流来划,只按受伤人数排序也会把高流量路口说得比每人风险更危险。它没有证明某一条街的等级造成了事故,也没有给出应该先改哪一个路口的施工清单。
先说结论
- 随机森林用 2018–2019 年、每小时至少 30 人的路段计数做校准。工作日训练集的 R² 为 0.954–0.963,测试集降到 0.662–0.736;周末早高峰测试集只有 39 段,R² 为 0.400。平均绝对百分比误差是各段误差的平均,训练段大约 15%–19%,留出测试段大约 41%–52%。
- 工作日早高峰,就业地与地铁站这一类起讫对预测的置换重要度约 48%。这是打乱该类流量后预测变化的相对大小,不是早高峰 48% 的行人走在这条起讫上。午间和傍晚转向就业地与设施;周末则由设施之间、设施与地铁站更突出。
- 工作日三个高峰,曼哈顿路段的中位数和最大值都最高。59 个社区区里,中城在工作日傍晚平均每段 1697 人,论文称这是其他社区区的两倍以上。外区被点名的较高社区区大约每段 186–263 人,低于正文列出的下曼哈顿 576–740,也远低于中城。
- 工作日傍晚,全球走廊中位数大约每小时 1500 人。按“超过上一档第 75 百分位”计数,区域走廊 26 段、邻里走廊 200 段、社区连接路 684 段、基线 2901 段可能被划低。论文同时写明,这组对照没有纳入历史、旅游、土地用途和机构因素。
- 人数最高的 100 个路口与按暴露校正后的 100 个路口不是同一批。校正用的分母是典型工作日三个高峰小时的估计人流之和,分子是 11 年受伤人数。这是相对排序,不是每人每年的事故概率。
全城步行为什么不能只靠通勤表和几个路口?
纽约市交通局的全市出行调查显示,步行约占出行的 41%,小汽车约占 28%。论文引用的是这项调查,不是本次模型算出来的分担率。美国社区调查的通勤表又只覆盖上班出行。论文据此引用全美家庭出行调查的说法:通勤不到全部出行的三分之一,所以大多数步行根本不在通勤表里。全市每个路段都派人去数,也不现实。
既有步行模型大致分三条路。一类用土地利用、密度和街道类型直接回归某个点的人数,不追踪一次出行从哪里到哪里。一类用智能体把每个人走出来,适合机场、车站或几个街区,很难铺到整座城市。一类在网络上用图方法累加经过每条路段的出行,城市网络分析、sDNA 和 MoPed 都属于这一类。纽约步行研究(NYC Walks)走第三条:先有可通行的人行网络,再估计高峰时段哪些出行会经过每一段。
网络来自纽约市交通局的 LION 人行道图层。原始数据缺公园里的步道,也有拓扑错误。作者用了大约 6 个月做自动和人工清理,并对照 2019 年航空影像。清理后的网络有 315,577 段,是人行道、人行横道和步道的中心线。模型只让人走这些设施,不包含未标记的乱穿马路。作者也说明,残留的拓扑错误仍可能影响结果。
有限的计数,怎样被铺到 31 万段人行网络上?
计数来自纽约市交通局交通信息管理系统,取 2018 和 2019 年、新冠疫情前的记录。原始记录按 15 分钟汇总,再加总到三个高峰小时:早 8:00–9:00、午 12:30–13:30、晚 17:00–18:00。工作日和周末各做一遍,一共六个时段。计数包含步行和使用轮椅等辅助器具的人,不包含自行车、滑板和其他个人机动装置。2019 年 9 月和 11 月占校准所用计数的 61%。正文没有给出这 61% 的分子和总次数。
在作者称为 1011 段校准计数的集合里,842 段在人行横道上,占 83.3%;其余 169 段、占 16.7% 在路段中部。因此校准更靠路口。正文说路段中部和横道的拟合表现相当,并指向补充表 2。
生成出行时,模型使用 10 类起讫点对。起点和终点包括住所、就业地、地铁出入口、学校、公园和零售等设施。每个起点只在网络距离 800 米(半英里)内寻找目的地。多个目的地同时存在时,用赫夫模型(Huff model)分配概率:更近、权重更大的目的地分到更多出行。表注给出的距离衰减是逆指数,系数为 0.001,绕行上限是最短路的 1.15 倍。800 米决定谁能进入候选,0.001 决定半径内距离增加时权重下降多快。这个系数是模型设定,不是从纽约行人问卷里估计出来的偏好。
路径分配找出不超过最短路 1.15 倍的全部路径,并给它们相等概率。较短路段会反复出现在多条路径里,所以累加后更高。作者没有使用纽约本地的步行选路系数,路径代价只含网络距离,不含人行道宽度、底层店铺、车流、照明或绿荫。目的地更容易步行到达的起点,人均会产生更多相应出行。这一步用 k 近邻可达性修正起点权重。模型本身不单独做方式选择;步行总量是在后面的校准里,被观测人数拉向实测。
扩展数据表 3 列出权重。编号从 1 跳到 3,印出的是 9 行,没有第 2 行。图 1 的类别里有住所与地铁,表中却没有这一行的空间单元和权重,这里不补。已印出的对应关系是:住所到学校、公园、就业地和设施时,起点权重为街区临街人口;学校用学生容量,公园用 100 米网格的面积,就业地用雇员数,设施用个数。就业地到地铁时,起点是雇员数,地铁出入口的权重是线路数除以出入口数。设施到设施、公园到地铁、设施到地铁也按表中的个数或面积。地铁权重没有用发车频率。
住所用 2020 年人口普查街区,插值到临街中心点。就业地和设施用 InfoGroup 2019 年商业数据。学校来自纽约市教育局,公园来自公园与游憩局,地铁出入口来自大都会运输署。计数、人口、商业和影像不是同一周的快照。
初步流量估计出来之后,随机森林把估计值校准到观测人数。数据按 80% 训练、20% 测试划分,再做 20 折随机交叉验证,报告 20 个模型的平均预测。只保留每小时至少 30 名行人的路段。下表的 n 是路段数,不是行人数。MAE 是平均绝对误差,单位为每小时人数;论文表注写作 mean average error。MAPE 是平均绝对百分比误差,0.182 表示 18.2%,而且是各段百分比误差的平均,不是每一段都落在这个范围里。
| 时段 | 工作日训练 ρ / R² / MAE / MAPE / n | 工作日测试 ρ / R² / MAE / MAPE / n | 周末训练 ρ / R² / MAE / MAPE / n | 周末测试 ρ / R² / MAE / MAPE / n |
|---|---|---|---|---|
| 早高峰 | 0.977 / 0.954 / 82.5 / 0.182 / 1010 | 0.814 / 0.662 / 203.3 / 0.500 / 252 | 0.957 / 0.916 / 34.7 / 0.160 / 158 | 0.632 / 0.400 / 90.3 / 0.425 / 39 |
| 午高峰 | 0.981 / 0.963 / 123.7 / 0.152 / 346 | 0.848 / 0.719 / 317.8 / 0.410 / 86 | 0.978 / 0.957 / 87.2 / 0.190 / 454 | 0.669 / 0.669 / 222.2 / 0.524 / 113 |
| 晚高峰 | 0.980 / 0.961 / 121.1 / 0.187 / 1051 | 0.858 / 0.736 / 302.8 / 0.510 / 263 | 0.967 / 0.935 / 170.6 / 0.183 / 172 | 0.769 / 0.591 / 440.1 / 0.468 / 43 |
工作日训练集 R² 都超过 0.95。正文把工作日训练 MAPE 概括为 18%–19%,表中午高峰实际是 15.2%,早、晚为 18.2% 和 18.7%。测试集 MAPE 为 41.0%–51.0%(工作日)和 42.5%–52.4%(周末)。正文所说的训练相关系数 0.977–0.981、测试 0.814–0.858,对应的是工作日;周末训练最低到 0.957,周末测试最低到 0.632。最弱的一格是周末早高峰测试:39 段,R² 为 0.400。
工作日晚高峰进入上表的训练加测试共 1051+263=1314 段。相对全网 315,577 段,大约 0.4%。模型把这少数路段上的关系推广到其余路段。推广误差不能从训练集 R² 直接读出来。
扩展数据表 1 的样本量与上表训练集完全一致,所以下面的分位数描述的是训练集、且每小时至少 30 人的路段,不含那 20% 测试段,也不是全城路段。
| 观测计数 | 最小值 | 第10百分位 | 中位数 | 第90百分位 | 最大值 | 段数 |
|---|---|---|---|---|---|---|
| 工作日早 | 31 | 60 | 281 | 1307 | 5774 | 1010 |
| 工作日午 | 31 | 92 | 830 | 2108 | 4007 | 346 |
| 工作日晚 | 31 | 63 | 332 | 1960 | 7921 | 1051 |
| 周末早 | 32 | 63 | 212 | 488 | 882 | 158 |
| 周末午 | 31 | 64 | 305 | 1418 | 4052 | 454 |
| 周末晚 | 32 | 214 | 904 | 2245 | 5348 | 172 |
工作日晚高峰的观测中位数是每小时 332 人,最大值是 7921 人。高流量尾部很长。后面会看到,模型给出的全城最高估计低于这个观测最大值。
早高峰的预测,主要被哪一类出行带动?
校准之后,作者用置换重要度看每一类起讫流量对路段预测的相对影响。做法是打乱某一类变量,看预测变化多大。条越长,这类流量对当前时段的预测越关键。横轴从 0 到 1。它不回答这类出行占全部步行人次的比例,也不回答一个人早上是否从家里出发。
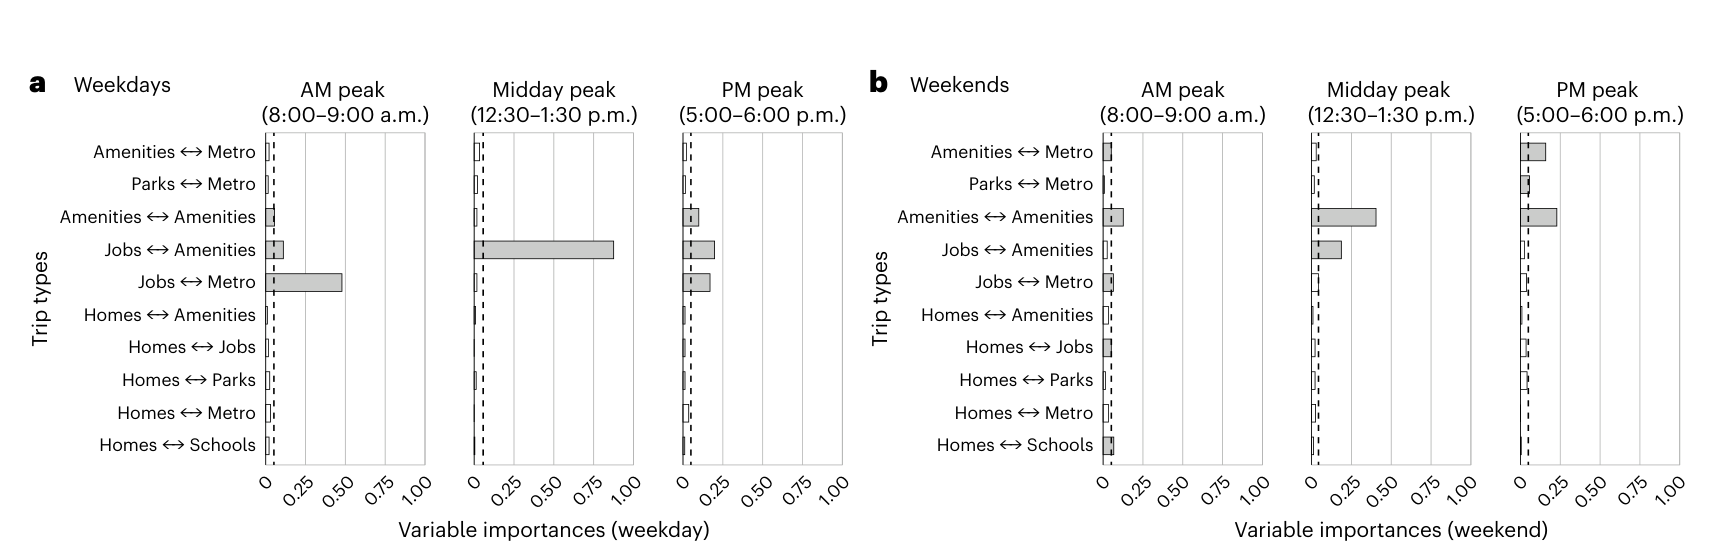
图 1|不同高峰里,哪一类起讫最影响路段人流预测?
(a)工作日。早高峰最长的是就业地与地铁站,正文给出的重要度约 48%;就业地与设施只有一条短条,住所相关的类别都接近零。(b)周末。午间较长的是设施之间,其次是设施与地铁、就业地与设施;晚高峰最长的是设施之间,设施与地铁也可见。纵轴 10 类起讫在两幅图中相同。来源:原论文 Fig. 1。
这个图形和通勤直觉需要分开读。早高峰住所到就业地、住所到地铁的条很短,只能说明打乱这两类流量对校准后的路段预测影响小。模型在校准前仍然会生成从住所出发的出行。周末午间,就业地与设施仍有一条可见的条,论文据此认为就业中心周围的店铺在非工作日也有步行活动。图上没有给出除 48% 以外的精确百分数,其余类别只按长短比较。
中城远高于其他社区区,外区的高流量在哪里?
校准模型把估计扩展到全部网络段。下图是工作日早高峰的全城分布。颜色按每小时估计人数分段,从不足 500 人到 3000–3500 人。白框是网络缺失的区域。右侧放大图用青色标实测、白色标模型估计,比例尺为 0–200 英尺。
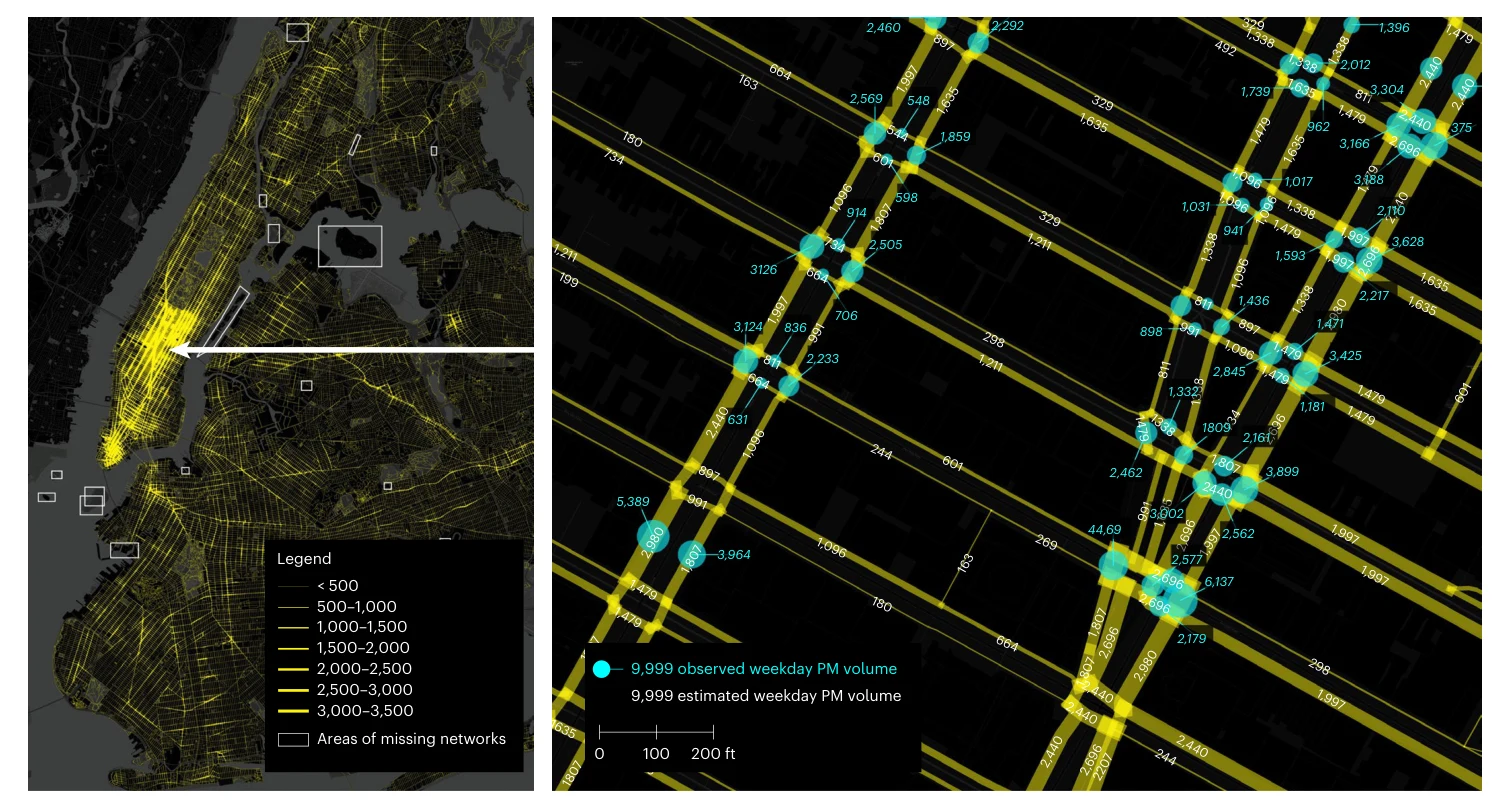
图 2|早高峰的人流集中在哪里,放大以后估计和实测差多远?
(左)全城工作日早高峰估计。曼哈顿中南部最亮,外区呈线状而不是成片高亮;白框标出缺失网络。(右)放大后的路段。青色数字为实测,白色数字为估计,图例文字写的是 weekday PM,图题写的是早高峰。图例中的 9,999 是占位数字,不是某个路口的流量。来源:原论文 Fig. 2。
图题把整张图和放大图都称为工作日早高峰,并说明蓝字是 2018 或 2019 年早高峰实测。放大图图例却把实测和估计都写成 weekday PM。两套时间不能同时成立。读这张图时,全城颜色按图题视为早高峰;放大图上的单个数字不在这里引用,避免把早高峰和晚高峰的人数混成同一组事实。
扩展数据表 2 给出的是各区路段估计值的分布,不是区总人数,也不是区平均人数。中位数描述的是该区一条典型路段,最大值描述最忙的一段。
| 区 | 工作日早中位 / 最大 | 工作日午中位 / 最大 | 工作日晚中位 / 最大 | 周末早中位 / 最大 | 周末午中位 / 最大 | 周末晚中位 / 最大 |
|---|---|---|---|---|---|---|
| 布朗克斯 | 130 / 1289 | 104 / 1525 | 134 / 1941 | 128 / 423 | 124 / 1373 | 204 / 1696 |
| 布鲁克林 | 123 / 1506 | 106 / 1630 | 128 / 1738 | 126 / 397 | 124 / 1308 | 206 / 1789 |
| 皇后区 | 109 / 1722 | 84 / 1844 | 93 / 1808 | 130 / 369 | 111 / 1521 | 212 / 1660 |
| 曼哈顿 | 210 / 2890 | 269 / 2802 | 264 / 3398 | 133 / 469 | 192 / 1875 | 225 / 2498 |
| 史泰登岛 | 107 / 286 | 83 / 936 | 81 / 402 | 135 / 197 | 111 / 739 | 222 / 444 |
| 全市 | 124 / 2890 | 86 / 2802 | 118 / 3398 | 130 / 469 | 121 / 1875 | 212 / 2498 |
工作日三个高峰,曼哈顿的中位数和最大值都是五区最高。工作日晚高峰,曼哈顿中位数为每小时 264 人,第 90 百分位为 1291 人,最大值为 3398 人;全市中位数只有 118 人。皇后区同一时段的中位数是 93 人,最大值仍有 1808 人。外区的典型路段低于曼哈顿,外区最忙的路段可以进入曼哈顿的高流量区间,只是还达不到曼哈顿的极端最大值。
周末早高峰的中位数挤在 126–135 人,史泰登岛 135 人,曼哈顿 133 人。周末晚高峰的中位数也很接近:布朗克斯 204、布鲁克林 206、皇后区 212、史泰登岛 222、曼哈顿 225。曼哈顿在这一时段的优势主要在尾部,第 90 百分位为 1098 人,最大值为 2498 人;史泰登岛的第 90 百分位只有 230 人,最大值为 444 人。论文写周末傍晚仍由曼哈顿主导。从表上看,这句话更符合高分位和最大值,中位数本身已经接近。
社区区尺度把路段再平均一次。下图是工作日 17:00–18:00、59 个社区区的平均每段人数。颜色越深越高。这是区内所有人行道、人行横道和步道段的平均,论文没有给出每个区的段数,所以 1697 不能换成该区总人数。
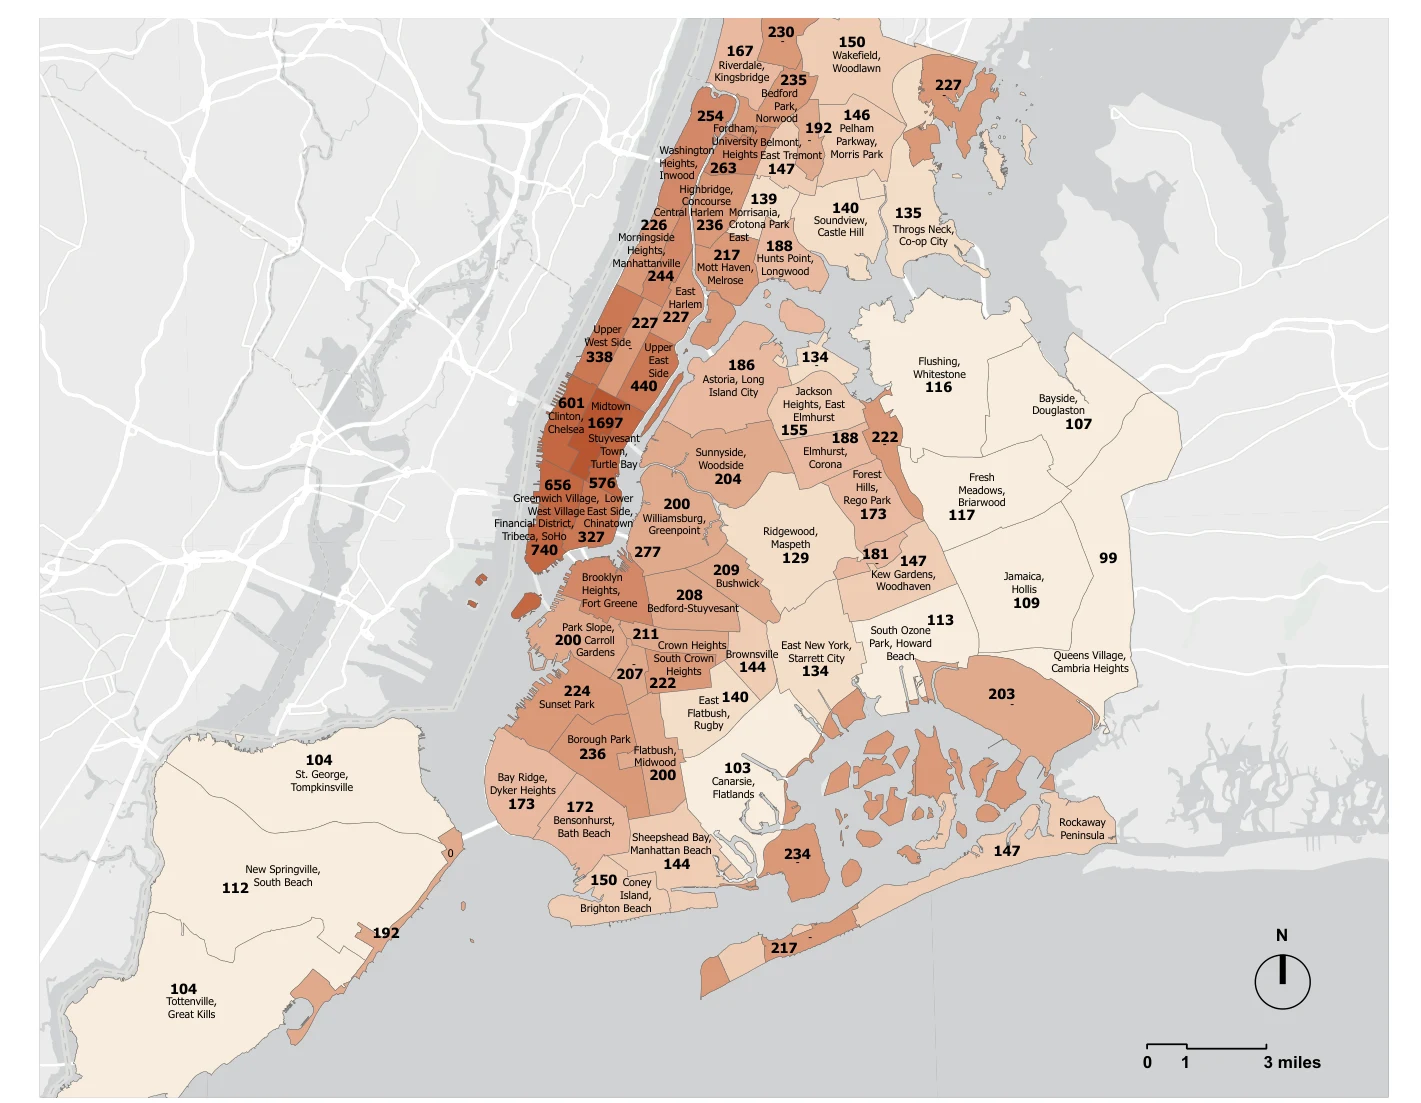
图 3|哪个社区区的典型路段最忙?
原图没有子图字母。每个社区区标一个工作日傍晚的平均每段人数,颜色由浅到深表示由低到高。中城为 1697,明显深于其他区;下曼哈顿若干区在 576–740;外区多数在 200 以下,布朗克斯、布鲁克林和皇后区有若干区超过 180。史泰登岛整体更浅。比例尺 0–3 英里。来源:原论文 Extended Data Fig. 1。
正文点名的工作日晚高峰平均值是:中城 1697;金融区 740,格林尼治村 656,切尔西 601,斯泰弗森特镇 576。外区相对高的是布朗克斯大学高地 263、海布里奇 236,布鲁克林高地 227、日落公园 224、博罗公园 234,皇后区桑尼赛德 204、阿斯托里亚 186。1697 大于 740 的两倍。外区这些 186–263 的区低于正文列出的下曼哈顿社区区,也远低于中城。地图上还有颜色更浅的曼哈顿社区区,正文没有逐一给出区名和数字,这里不另引。
下图把四个流量更普通的地点放大到路段,时间是工作日傍晚 17:00–18:00。白字是模型估计,蓝字是 2018 或 2019 年同一小时、有计数的路段上的实测。
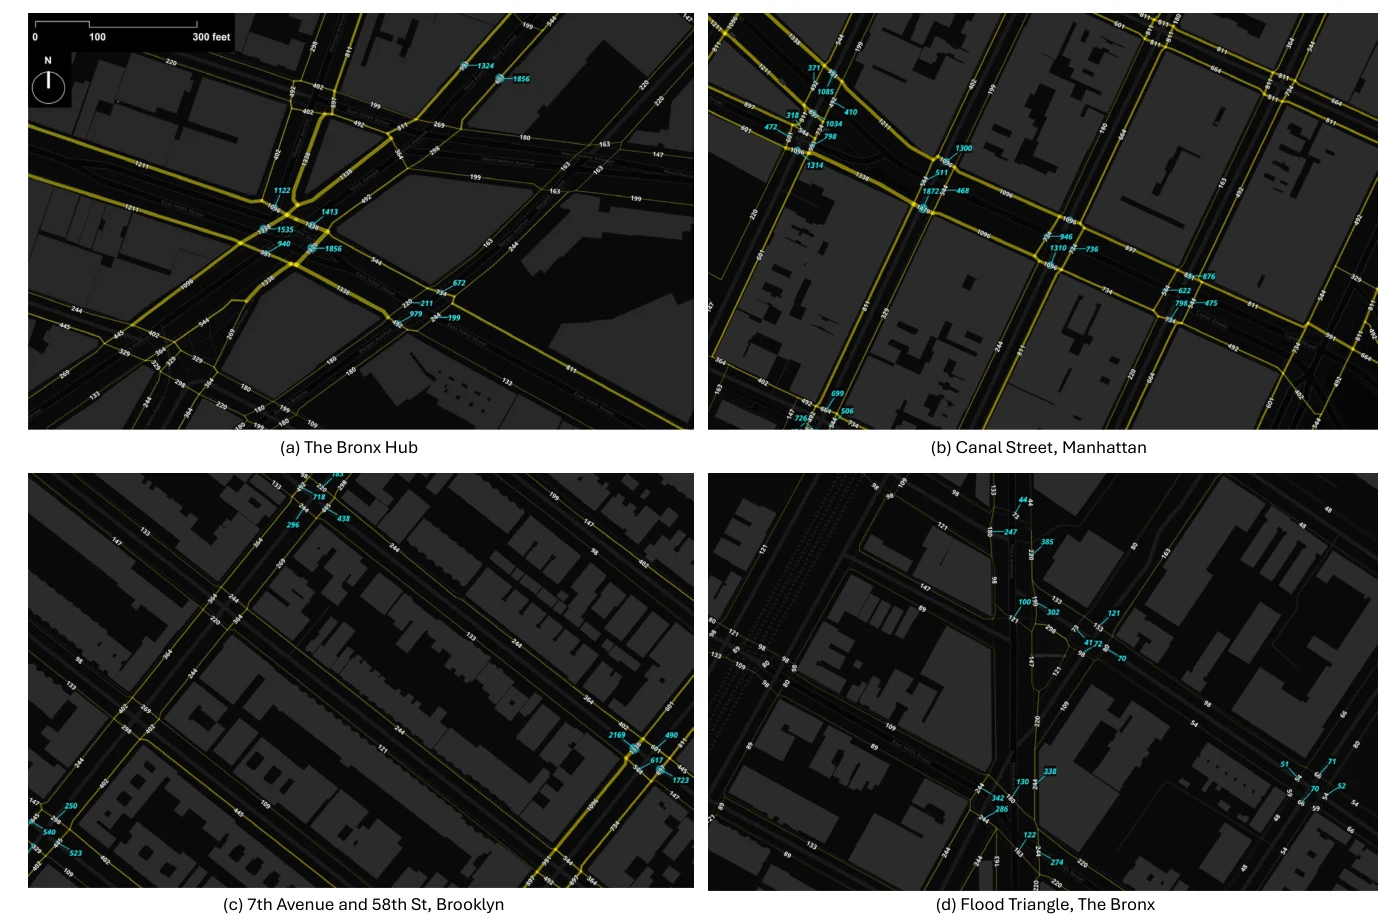
图 4|离开中城以后,估计和实测还在同一量级吗?
(a)布朗克斯枢纽。(b)曼哈顿坚尼街。(c)布鲁克林第七大道与 58 街。(d)布朗克斯洪水三角地带。黄线是人行网络,蓝字只出现在当年有计数的路段上,不能把没有蓝字读成实测为零。(a)带 0–300 英尺比例尺。来源:原论文 Extended Data Fig. 2。
这四张图说明模型不是只在中城画一张亮图。有实测的路段上,估计与计数大体同量级,也有对得不紧的路段。因为蓝字只覆盖被数过的段,这张图不能用来计算全市误差;全市误差仍以表 1 的训练段和测试段为准。
作者还用两个最大值说明模型压低了极端高流量:扩展数据表 1 里,工作日晚高峰观测最大值为每小时 7921 人;扩展数据表 2 里,模型全城最大值为 3398 人。前者是训练集中最忙的一段,后者是全城估计的最高一段,不一定是同一段。这个比较支持“极端值被拉低”,不能写成那一段的预测误差就是 7921 减 3398。作者认为原因是训练样本更强调全市常见路段,而不是极端路段。
走廊等级是按人流划的吗?
纽约市交通局 2020 年步行机动性规划把街道分成五类,并称分类基于预期步行流量和沿线土地利用。论文指出,这套分类并没有使用实测或估计的行人数量。五类的规划定义是:
- 全球走廊:人很多,目的地吸引来自世界各地的人。
- 区域走廊:人流集中,目的地或大型吸引点覆盖整个区域。
- 邻里走廊:人数较小但稳定,如社区商业、大学校或大公园。
- 社区连接路:行人互相经过或三五成群,连接附近的小公园、学校。
- 全市基线:人流低、很少与人相遇,通常是没有明显步行吸引点的居住街道。
论文后文也把社区连接路写成社区走廊。分类会影响人行道上留给步行的比例、净空和街道家具。所以等级不只是地图颜色。作者也写明,真正划等级时还应考虑历史、旅游、土地利用和机构因素,而下面的对照只看人流。
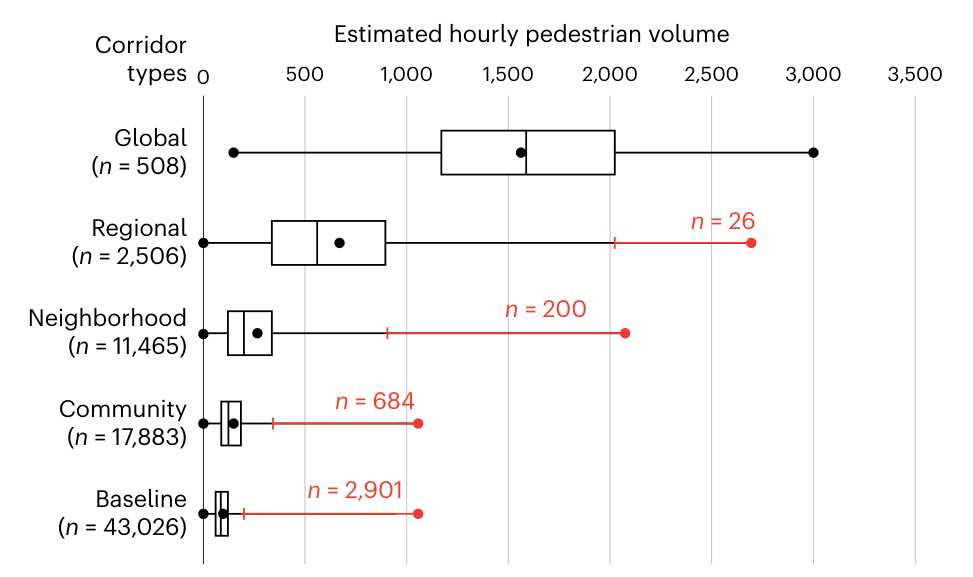
图 5|五类走廊的傍晚人流重叠有多大?
原图没有子图字母。横轴是工作日晚高峰的估计小时人流。箱体两端是第 25 和第 75 百分位,箱内竖线是中位数,箱内点是均值,两端须线是第 10 和第 90 百分位,不是置信区间。红线标出超过上一档第 75 百分位的路段,红字是段数。全球走廊 n=508,区域 2506,邻里 11465,社区 17883,基线 43026。来源:原论文 Fig. 3。
全球走廊的中位数大约每小时 1500 人,箱体位于其余四类右侧,右端须线也明显更长。图上没有标出各类第 90 百分位的精确人数。其余四类的箱体都靠近原点,彼此重叠。红线给出的可能划低的段数是:区域走廊 26 段,超过全球走廊的第 75 百分位;邻里 200 段,社区 684 段,基线 2901 段。四项合计 3811 段。相对各类自身段数,分别是 26/2506(约 1.0%)、200/11465(约 1.7%)、684/17883(约 3.8%)和 2901/43026(约 6.7%)。
图中五类 n 合计 75,388 段,少于全网 315,577 段。论文没有说明差额来自未分类路段,还是走廊分类用了另一套切分。75,388 不能当作全城人行道段数。红线比较的是“比上一档的第 75 百分位更高”,不是“比上一档的中位数更高”。一条基线路段超过社区连接路的高分位,仍可能远低于全球走廊的中位数。
下图左边是五类的空间分布,线的粗细表示估计人流。右边更严:只标工作日 17:00–18:00 人流高于再上一档、也就是高出两个等级的第 75 百分位的路段。31 街与 23 大道在两幅图上都被圈出。
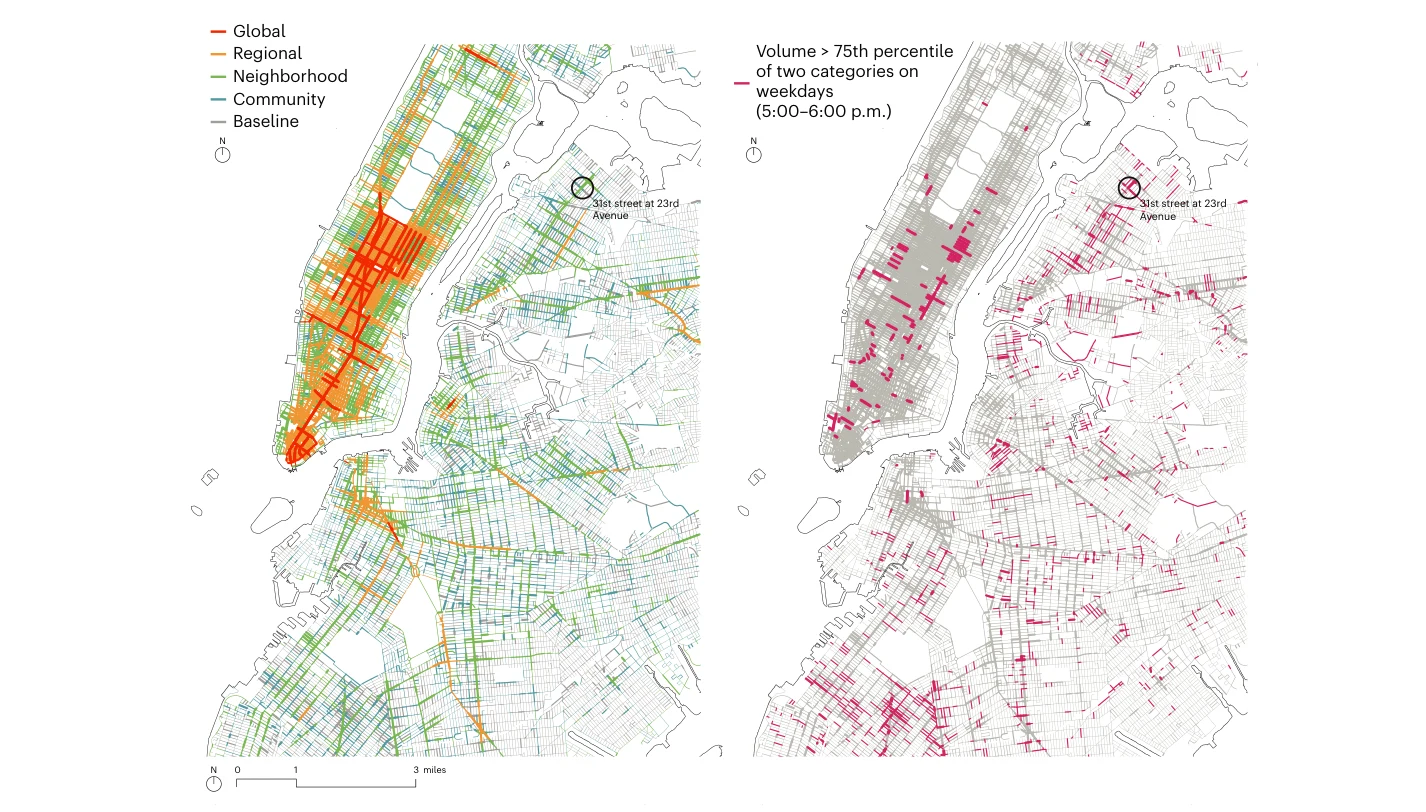
图 6|划低的路段集中在曼哈顿,还是外区?
(左)五类走廊。橙红色的全球和区域走廊集中在曼哈顿,外区以绿、青、灰为主。(右)高出两个等级第 75 百分位的路段,品红色,工作日晚高峰。两图都圈出皇后区 31 街与 23 大道。比例尺 0–3 英里。原图没有 a、b 字母。来源:原论文 Fig. 4。
左边的格局是曼哈顿高等级更密。右边的品红线段在布鲁克林和皇后区更醒目,曼哈顿并没有整片被标成低估。论文据此认为,按预测人流,曼哈顿有些路段的等级可能偏高,外区有些路段可能偏低。这是等级与人流的错位,不是已经审计过的投资金额差异。
论文接着写道,全城被低估的街道大约 5256 英里(8459 公里),其中基线走廊 3067 英里(4936 公里),社区走廊 1280 英里(2060 公里)。这句话紧跟在高出两档的地图之后,但没有逐项对应图 5 的 26、200、684、2901 段。英里数和段数不宜直接相除。最明显的低估位于布鲁克林和皇后区。
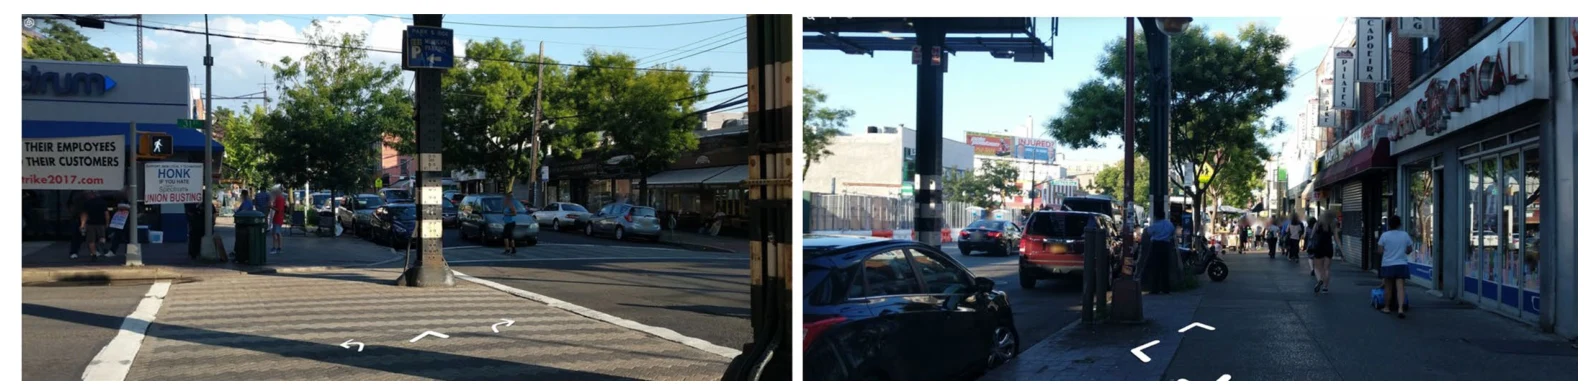
图 7|1024 人的路口,街上实际长什么样?
原图没有子图字母,是同一路口附近的两张街景。(左)宽人行横道、街角店铺和行道树。(右)沿街商业、停靠车辆和人行道上的行人。照片本身没有人数。每小时 1024 人、基线或社区连接路的等级、以及约 15 英尺的邻里走廊宽度,都来自正文对这个路口的说明。来源:原论文 Extended Data Fig. 3。
1024 低于全球走廊大约 1500 人的中位数。论文说它符合全球走廊门槛,但没有给出门槛的切分公式。可以确定的是:模型把这里放进高人流,规划等级仍是基线或社区连接路,而路面宽度已经达到邻里走廊的 15 英尺标准。旁边人流同样高的路段也未被升档。
受伤最多的路口,每人风险也最高吗?
第二个用途是事故。愿景零死亡计划从 2014 年开始强调行人和骑行者。公开地图通常按受伤和死亡人数标出路口。论文使用纽约市警察局经开放数据发布的机动车碰撞记录,取 2012–2023 年涉及行人受伤的事故。
人流估计在人行道和人行横道上,事故点落在道路中心线节点上。作者先把节点周围所有人行横道的估计人流加到该节点,再把节点 50 米内的行人受伤事故连到这个节点。左图是这 11 年里行人受伤人数最高的 100 个路口。右图把人数除以工作日早、午、晚三个高峰小时的估计人流之和,表示成每 1000 名行人的受伤数。
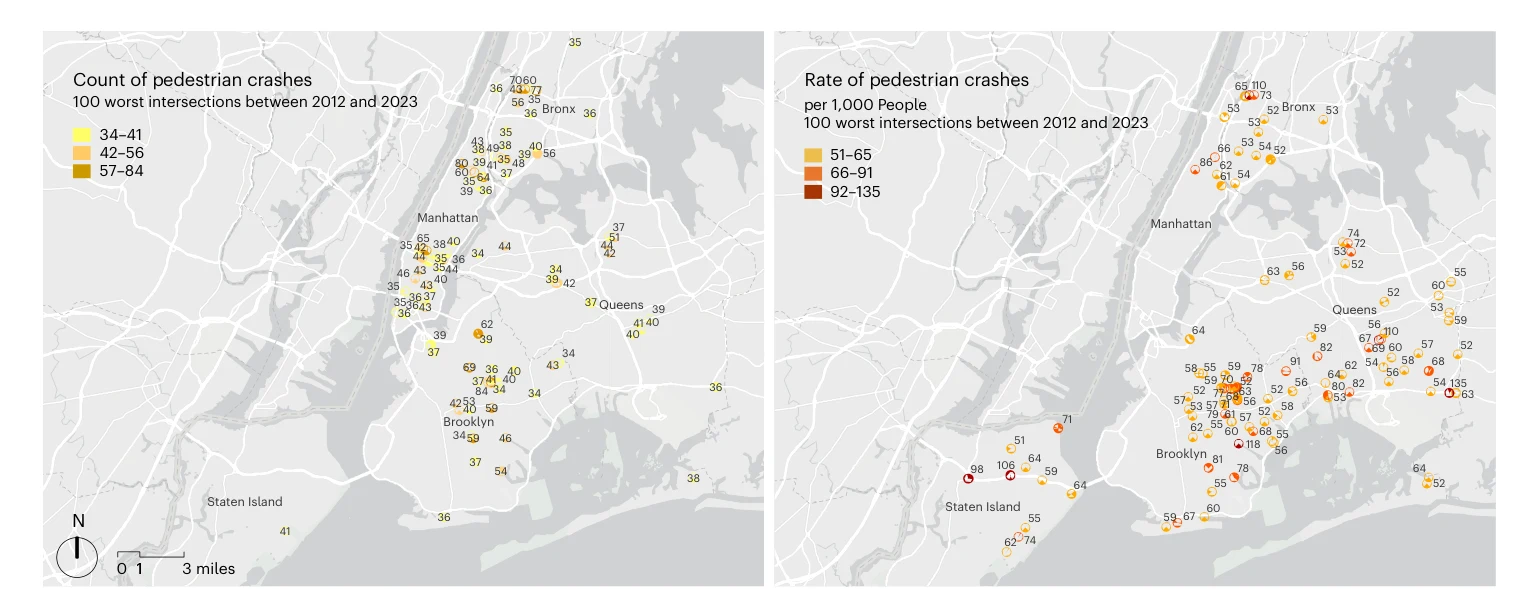
图 8|按人数和按每人风险,最靠前的路口还是同一批吗?
(左)2012–2023 年行人受伤人数最高的 100 个路口。图例三档为 34–41、42–56、57–84 人。点在曼哈顿、布朗克斯和布鲁克林更密,史泰登岛只有一个点。(右)同一批比较改用暴露校正后的 100 个路口。图例为每 1000 人 51–65、66–91、92–135。下城和中城的高人数点退出,外区和上曼哈顿更突出。比例尺 0–3 英里。原图没有 a、b 字母。来源:原论文 Fig. 5。
右图的“每 1000 人”有固定口径:分子是 11 年的受伤人数,分母是一个典型工作日三个高峰小时的估计人数之和,再乘以 1000。它不是每年每 1000 名行人的概率,也不是全天、全周或全年的暴露。一个三小时估计人流为 1000 人、11 年里有 100 名行人受伤的路口,会落在每 1000 人 100 的位置。换一套全日人流,排序可能改变。
人数图里,时代广场和中城很突出,史泰登岛只有 1 个路口进入前 100。风险图里,下城和中城不再出现在这 100 个里;上曼哈顿、布朗克斯、布鲁克林部分地区、皇后区和史泰登岛更靠前。论文的解释是:高人流可以积累很多受伤人数,每人面对的风险仍可能低于人少、人数却差不多的路口。这个解释依赖估计人流当暴露。若某路口的人流被低估,它的风险率会被抬高。
事故分析只用已经发生并被记录的碰撞,不含险些发生的冲突。因此它回答的是记录在案的受伤如何随暴露重新排序,不是街道上全部危险的清单。
估计能用到哪一步?
这套估计适合做全城高峰人流的基线,也适合和街道、地址尺度的其他数据叠在一起。它还不适合直接宣布某条街应升到哪一档,或某个路口的改造会减少多少事故。
出行生成缺少几类明显的人流来源。地铁站只用线路数和出入口数,没有用逐小时班次。公交站没有进入起讫点。宾州车站、中央车站、扬基体育场、康尼岛等特殊吸引点也没有单列。休闲、没有明确目的地的散步不会被生成;校准用的实测人数里却可能含有这类步行。作者认为,这类缺口会让模型既低估极端高流量,也漏掉一部分非目的性步行。
施工封闭没有进入网络。工作日早、晚高峰绝对百分比误差超过 100% 的路段,常常和施工挡路有关:人被挤到旁边的路段,模型仍按畅通网络分配。航空影像看不清这些临时封闭。
校准对着的是路段总人数,不是分方向人数,也不是住所到学校、住所到地铁这种分类型的实测。随机森林给出的是树的分段规则,不能写成一条可带到另一座城市的公式。作者明确提醒,不要把纽约校准后的模型文件直接用到其他城市或其他数据集上。即便仍在纽约,疫情后的在家办公也会改变日波动和季节波动,需要用新计数重做校准。
走廊对照忽略了规划名义上还要考虑的历史、旅游和土地用途。事故对照用的是高峰小时估计,不是受伤发生那一小时的实测人流。相关的空间重叠不能写成等级导致事故,也不能写成降低人流就会降低受伤人数。
一句话总结
纽约全城高峰步行可以被估计到路段,但官方走廊等级并没有按这套人流来划;把受伤人数除以高峰人流之后,最需要优先查看的路口也会从中城人数高地移向外区和上曼哈顿。
核心来源
- Nature Cities 正式文章,核对题目、作者、2026年2月6日在线发表日期与数据说明。正文图 1–5,扩展数据图 1–3,表 1 与扩展数据表 1–3。
- 作者写明,人行网络、分出行类型的流量、六个时段的校准人流,以及 pckl 格式的校准模型,随补充数据发布。补充表 1–2 和补充图 1–8 在正文中被引用,用于计数点位置、月份、高峰曲线和路口与路段中部的分别拟合。
作者介绍
机构与分工以论文署名和作者贡献说明为准。
- Andres Sevtsuk:署名麻省理工学院城市研究与规划系,通讯作者。提出研究问题,与 Basu 共同设计实现,并主笔。麻省理工学院在论文发表当天的新闻中称他为该系副教授。
- Rounaq Basu:署名佐治亚理工学院城市与区域规划学院。与 Sevtsuk 共同设计实现,完成模型校准,并参与写作。
- Liu Liu:署名麻省理工学院城市研究与规划系。绘制人流图,并把估计人流与实测计数做视觉对照。
- Abdulaziz Alhassan:署名麻省理工学院城市研究与规划系。用 Python 实现模型并估计行人流量。
- Justin Kollar:署名麻省理工学院城市研究与规划系。用人流估计分析交通事故、绘制相关图,并参与写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若极端高流量被系统性压低,中城那些人数很多的路口,风险率会被抬高,因为分母变小了。在这种偏误下,中城仍然退出风险最高的 100 个路口。这说明“中城按人数靠前、按每人风险不一定靠前”不太像是低估人流制造出来的;低估人流会把证据往相反方向推。要确认这一点,需要同一批路口在 2018–2019 年高峰小时的实测人流,而不是再比较全市最大值 7921 和 3398。这两个最大值不一定落在同一段上。
另一个可以马上做的检查,是把图 5 的 3811 段拆开。31 街与 23 大道这种高人流紧挨地铁出入口,模型自己的搜索半径就是 800 米。地铁口前的一个高峰小时,和一整条零售街上持续的高人流,需要的设施不一样:前者可能是过街时间和站口排队,后者才是规划里全球走廊的净空和街道家具。论文的红字只统计超过上一档第 75 百分位的段数,英里数又跟在另一套、高出两档的定义后面。若两种定义各自同时报告段数和长度,并分开地铁口邻近路段与连续商业路段,升档名单会短很多,也更接近能施工的项目。