少数远行,能否由地点的层级和人们的选择一起生成?
论文名片|Tao Jia、Bin Jiang、Kenneth Carling、Magnus Bolin、Yifang Ban,An empirical study on human mobility and its agent-based modeling,Journal of Statistical Mechanics: Theory and Experiment,2012:P11024,2012年11月28日发表。DOI:10.1088/1742-5468/2012/11/P11024。研究结合瑞典志愿者GPS记录、地点聚类和主体仿真。
去附近商店、去市区办事、偶尔去另一座城市,涉及的空间范围并不相同。城市、片区、街区又嵌套在一起,而每个层级里总有少数地方吸引更多活动。若人们偏向这些地方,会不会自然产生大量短途与少数远途?
这篇论文把这个想法做成了模型:从实际GPS轨迹提取活动位置,构造三层地点网络,再比较等概率选邻居与偏向热门地点两种规则。后一种规则生成的距离分布更接近实测重尾。不过,复现一种分布说明这套机制可行,不能证明它就是人们出行的唯一原因。
先说结论:
- 258位志愿者的记录表现出日常往返与少数远行共存,活动范围差异明显。
- 相邻活动位置之间,直线距离与道路最短距离的总体分布相近,两者都更适合用带指数截断的幂律描述。
- 在同一层级网络上,偏向活动次数更多地点的主体,比等概率选邻居的主体更容易生成近似幂律的距离尾部。
- 加入随机跳向底层地点的概率后,模型可调出约1.55—2.05的指数;这扩大了模型表现范围,并非新增了一项真实行为测量。
数据中的人,究竟被观察了多久?
研究在瑞典Borlänge地区通过四个大型体育协会招募志愿者,使用89台GPS记录仪,在三个地点、四个批次采集数据。总采集期是2011年3月29日至5月15日;每位志愿者通常把设备放在私家车里约一周。这里不能把总采集期写成每个人连续被跟踪一个月,也不能把样本当作随机抽取的全体居民。
数据包含258份志愿者记录文件。剔除5402条GPS信号丢失导致的无效记录后,论文报告262,021条移动记录。设备每5秒或30秒记录位置、时间和速度,标称位置精度约5米;这是设备说明书的指标,实际环境中的误差仍可能变化。
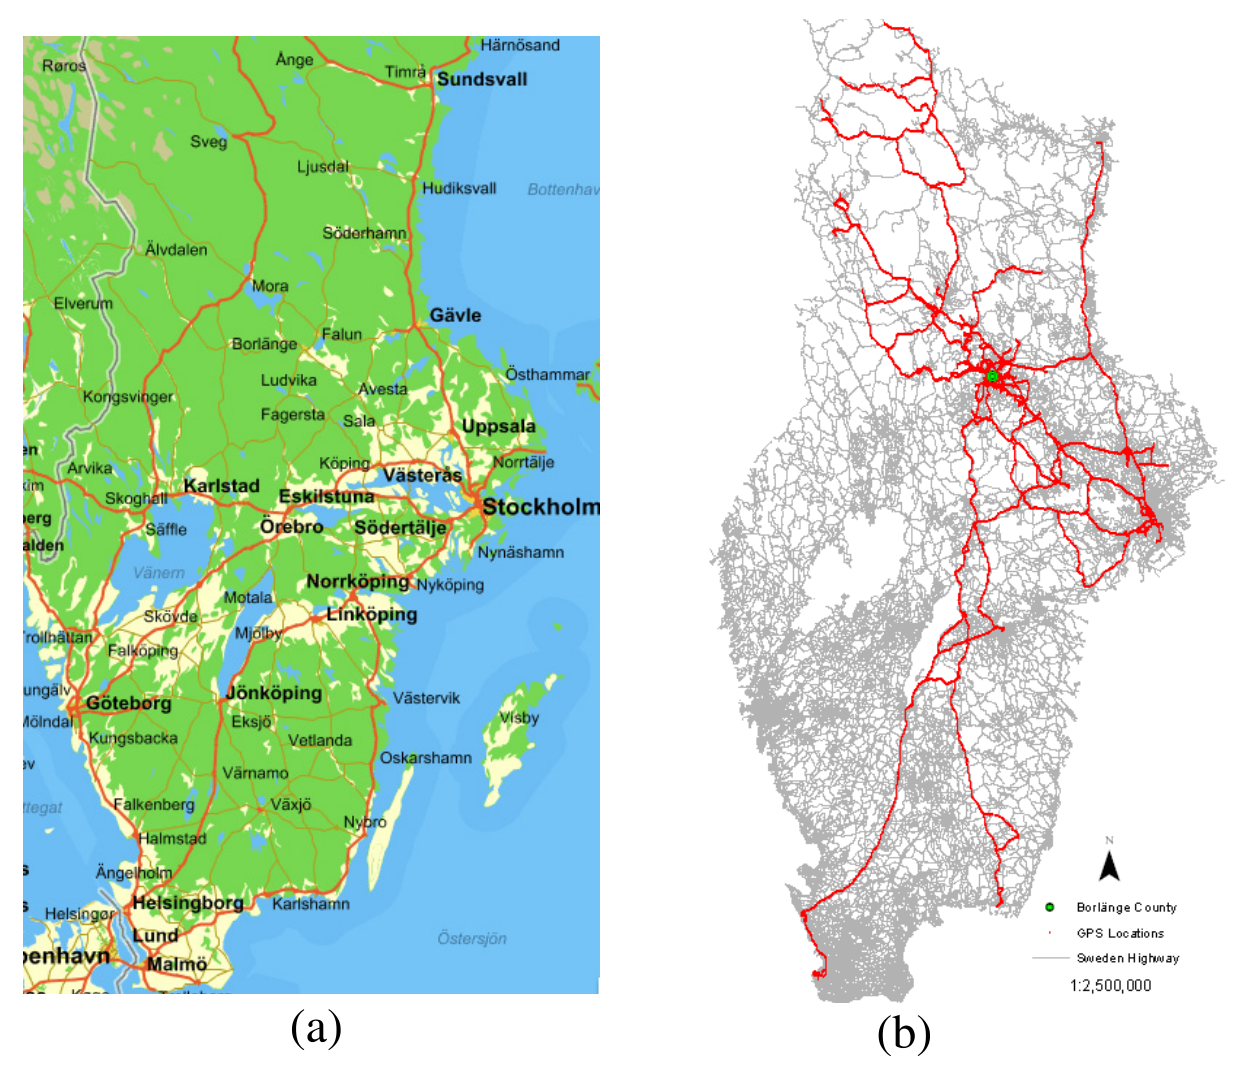
图 1|一个地方招募的志愿者,轨迹能延伸到多大范围?
(a)地图显示移动涉及的瑞典区域。(b)红色GPS位置叠加在灰色道路网络上,绿色点标示Borlänge,轨迹覆盖范围明显超出招募地区。覆盖广并不等于样本代表全国。来源:原论文 Fig. 1。
哪些GPS点,可以被当作活动目的地?
频繁采样会沿道路留下大量点,但每个点不是一个目的地。论文用 purposive location 表示从轨迹变化中识别出的活动位置,并把它视为兴趣点POI的代理。这里的“活动位置”是算法标签,没有逐次询问志愿者究竟去购物、工作还是接人。
识别有两条规则。第一,相邻记录间隔较长,同时距离小于速度阈值乘以间隔,认为可能在附近完成活动、期间无法接收GPS。第二,连续轨迹反复急转并聚集,认为可能围绕某处活动。时间阈值取550秒,夹角阈值取90°;附录伪代码还将第一条的速度阈值设为10米/秒,并用200米的距离条件处理曲折点聚合。
这些参数会影响哪些点被识别。尤其10米/秒不是静止阈值,长时间间隔也可能来自设备关闭或交通过程;弯曲道路则可能触发角度规则。因此15,423个提取位置应理解为活动位置代理,不能直接当作已验证的停留或真实出行目的。
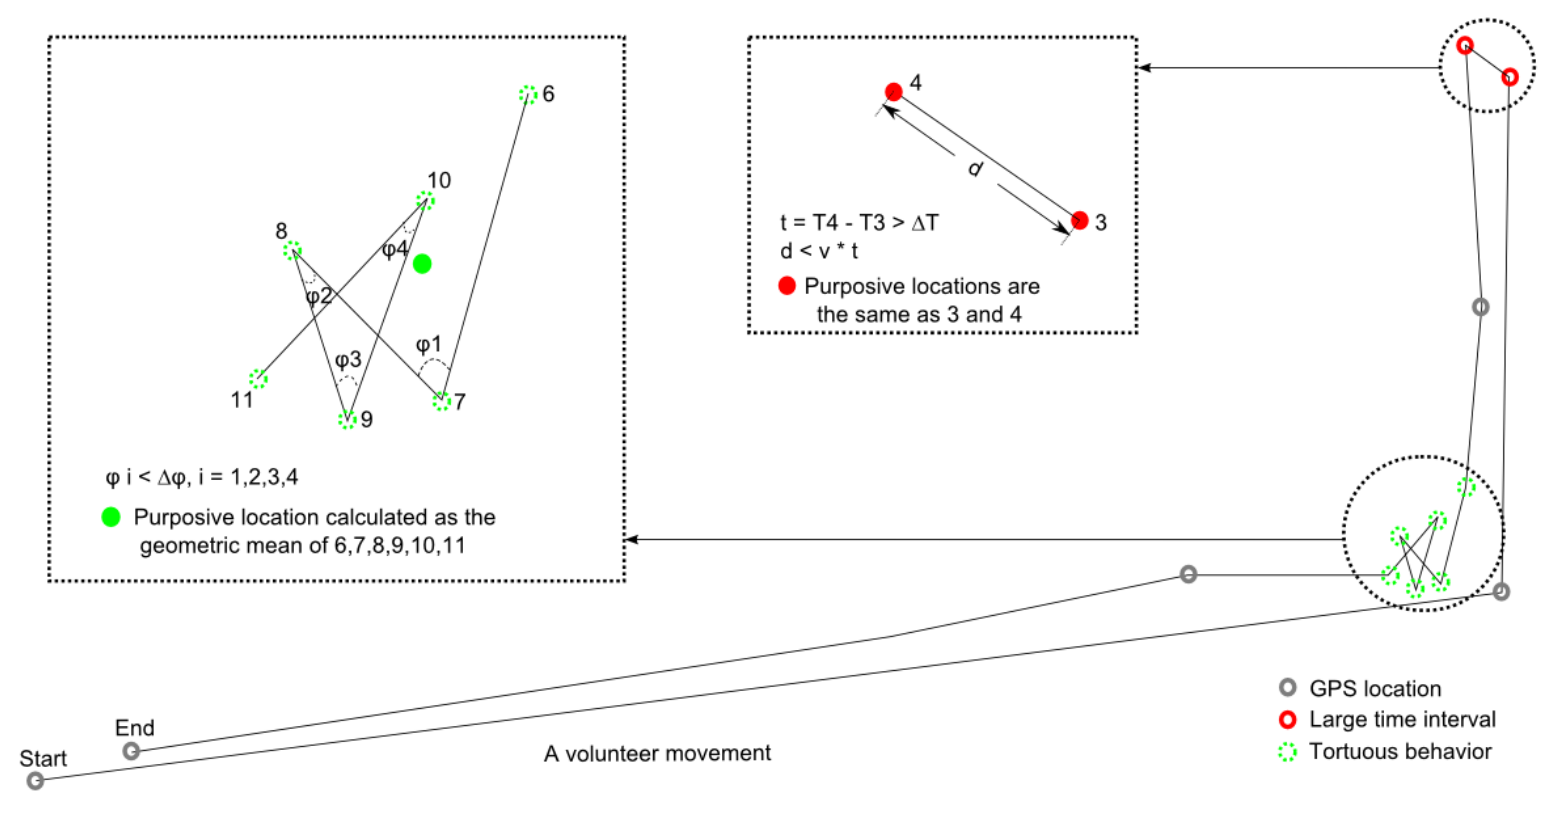
图 2|轨迹的哪些变化,被算法解释为一次活动?
该图无字母子图。灰点是普通GPS点;右上红圈表示时间间隔较长、空间距离满足条件的一对点;左侧放大图展示绿色曲折点群,绿实点表示由点群得到的代表位置。两条规则都是从轨迹推断活动,不直接测量动机。来源:原论文 Fig. 2。
550秒来自全部GPS相邻时间间隔的算术平均值。论文用头尾划分思想选择这个阈值:大量短间隔和少量长间隔构成偏斜分布,平均值可以把二者分开。但阈值合理与否仍需独立活动标签或敏感性分析支持,直线拟合看起来很好并不足以替代这些检验。
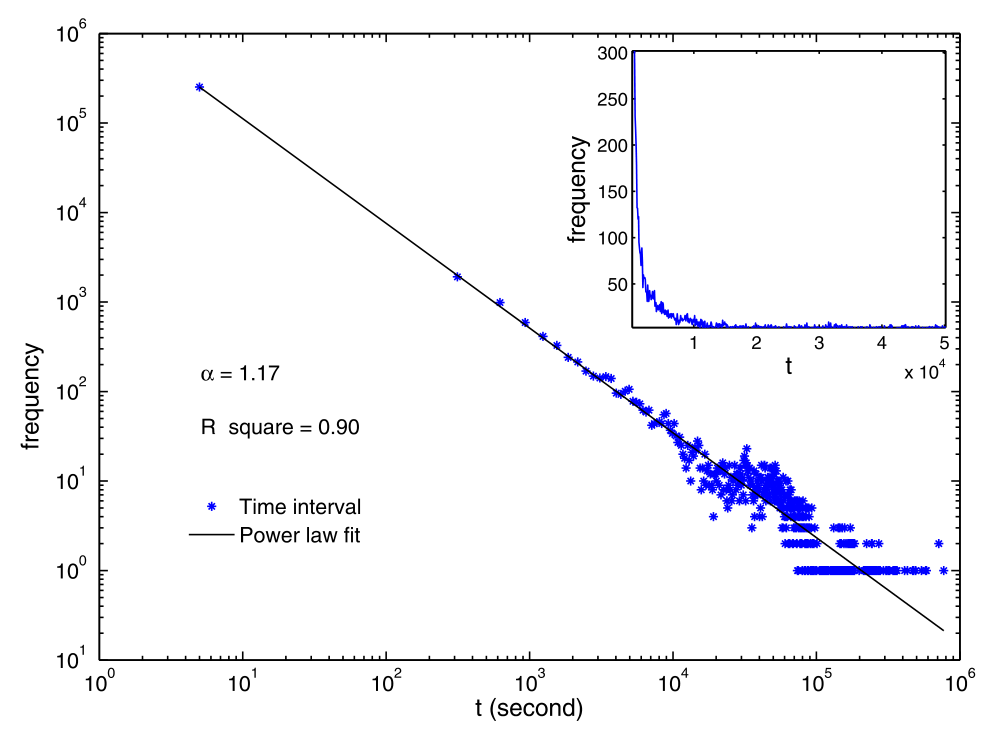
图 3|时间间隔为什么需要单独检查?
该图无字母子图。横轴为相邻记录间隔秒数,纵轴为频数,主图是双对数坐标,插图保留线性坐标视角。蓝点呈长尾,黑线给出幂律式近似,图中标注α=1.17、R²=0.90;它主要服务于阈值选择,不能仅凭R²断言唯一分布。来源:原论文 Fig. 3。
日常规律与少数远行,会不会相互矛盾?
一位匿名用户的离家距离随时间反复变化:白天离家、夜间回家,同时夹杂一次更远的行程。全样本的回转半径也存在明显差异。回转半径是位置围绕个人轨迹中心分散程度的均方根,衡量活动范围,不是累计行驶里程。
论文对回转半径尾部拟合得到指数1.93、拟合优度检验P=0.11,所选区间覆盖约63%的样本。63%是拟合区间内数据的比例,不能叫作解释了63%的行为差异;P=0.11也意味着按本文检验未拒绝所选幂律假设,不是证明假设有89%或11%的正确概率。
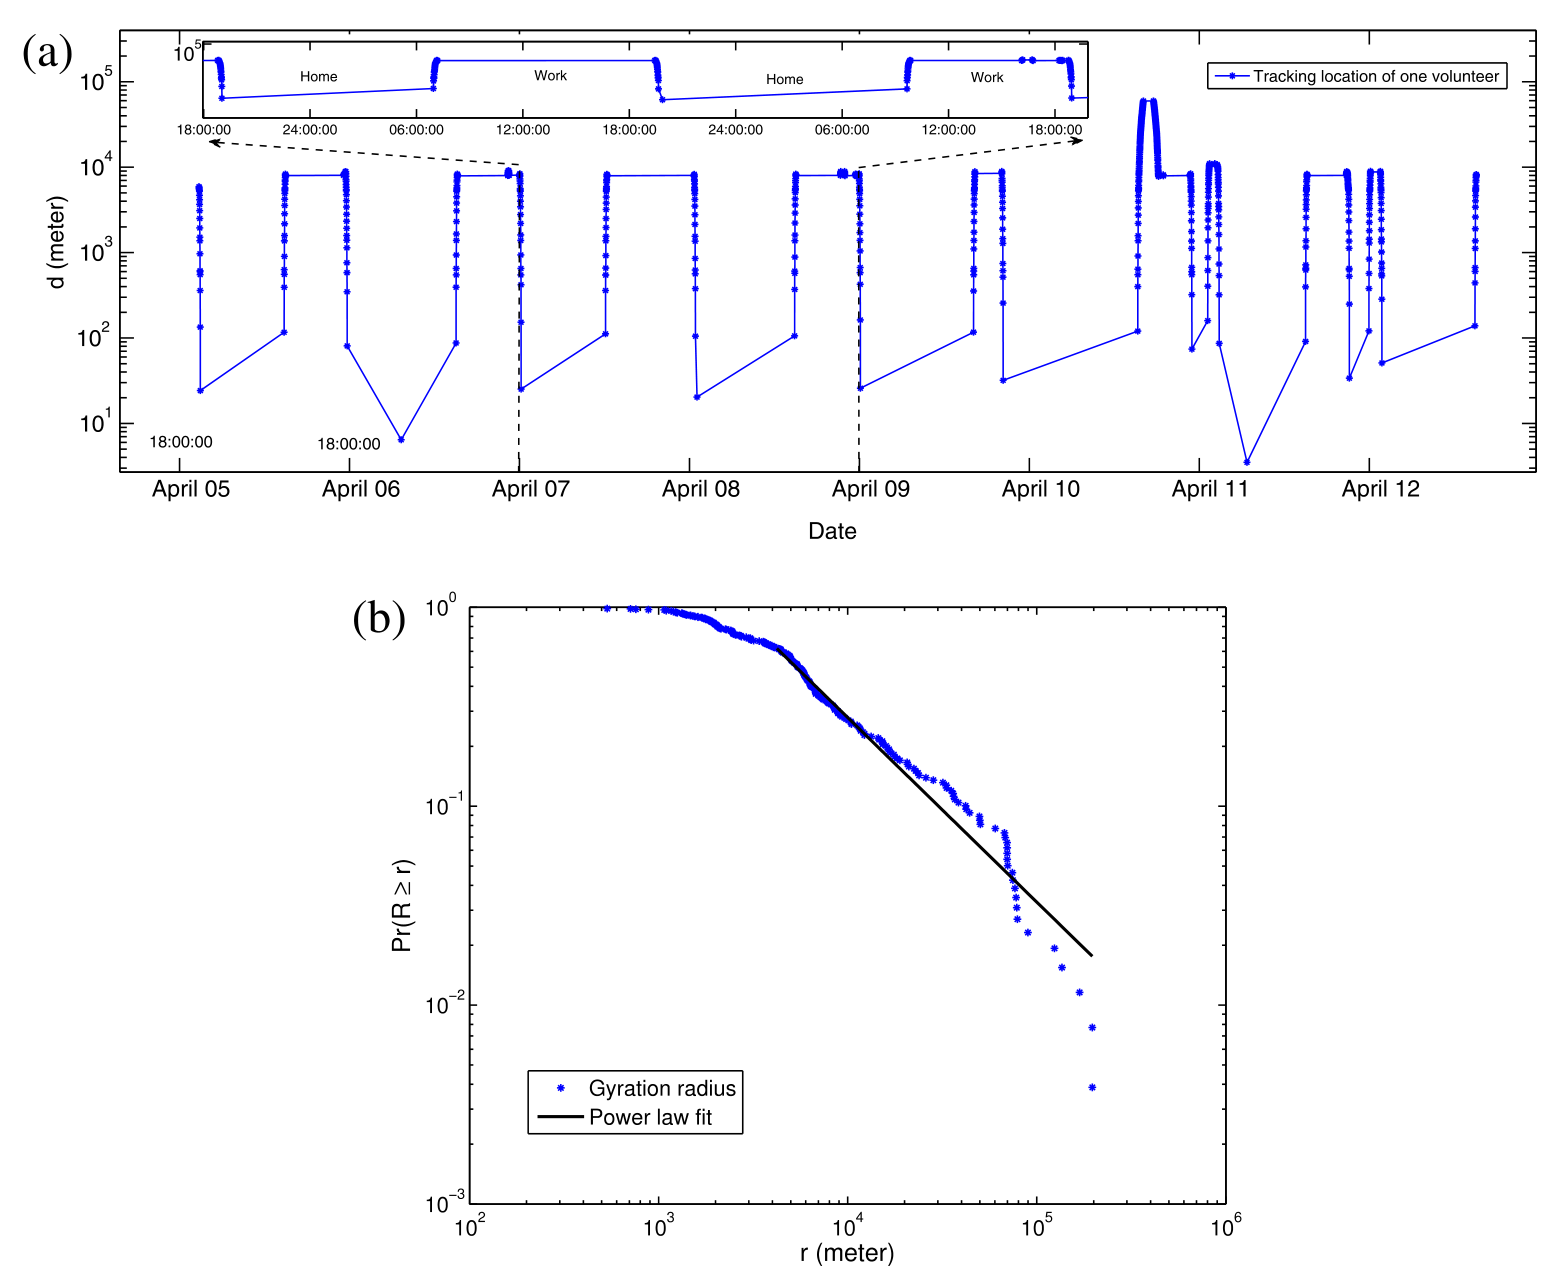
图 4|一个人的稳定往返,与人群活动范围的差异怎样共存?
(a)横轴为日期,纵轴为离家距离米数的对数刻度;插图放大重复的家与工作地之间往返,主图保留远行事件。(b)横轴为回转半径米数,纵轴为达到或超过该半径的比例,蓝点为数据,黑线为尾部幂律拟合。来源:原论文 Fig. 4。
每日提取活动位置数的尾部被指数分布较好近似,λ=0.13,检验P=0.45。论文据1/λ给出每天约7次的量级。这个数依赖活动位置定义,也不能仅凭次数分布的指数近似,就断言事件发生是独立泊松过程;泊松计数与指数等待时间属于不同的统计对象。
活动时长则出现两段尾部,参数分别约为1.51和2.85,分界在710分钟、即约12小时附近。论文推测较长时段可能包含长途旅行或设备关闭,因此这不是全天候直接观测到的真实停留时长分布。
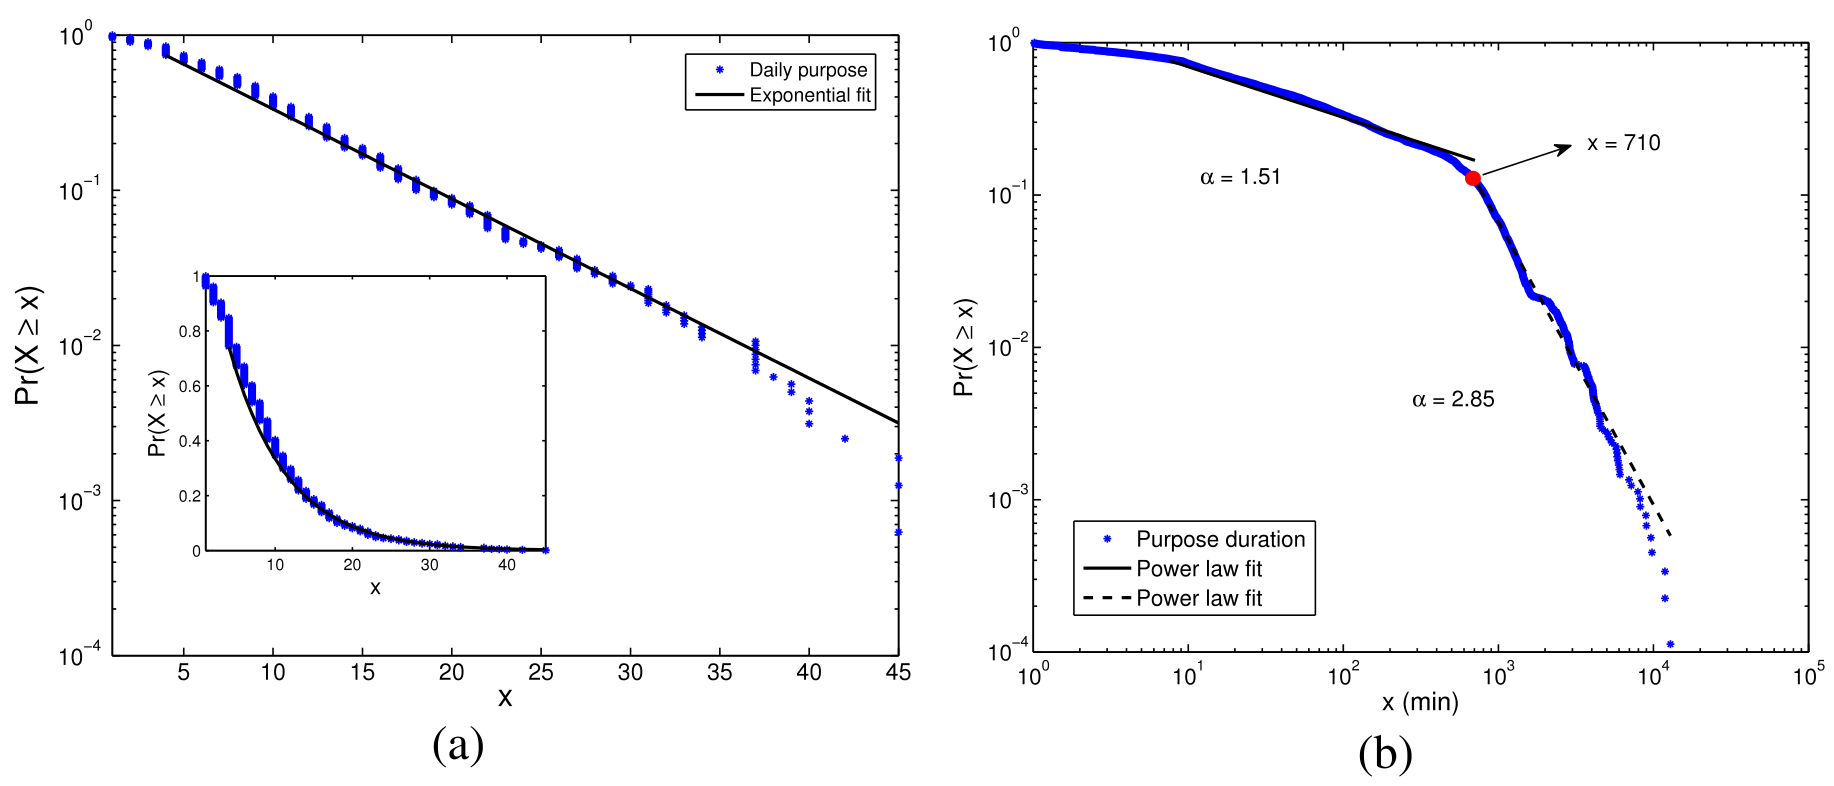
图 5|每天活动次数和每次持续多久,是否属于同一种分布?
(a)横轴为每日活动位置数,纵轴为达到该次数的尾部比例,半对数图上与指数线较接近,插图展示线性坐标。(b)横轴为分钟,纵轴为时长尾部比例;约710分钟处出现转折,两条黑线对应论文报告的两段幂律参数。图中画的是累计尾部,不能把参数直接当作直线斜率。来源:原论文 Fig. 5。
直线距离,会不会把道路绕行遗漏掉?
论文将相邻活动位置之间的一段移动称为flight,这里的术语不特指航空。它比较两种长度:air fly是端点直线距离;street fly是沿街道网络的最短路径距离,也不一定等于实际开过的路线。
在含780,512条街道的路网上,研究使用A*搜索,得到15,107对距离。两种总体分布接近:直线距离的拟合形式为 x⁻¹·⁹³exp(−0.000004x),道路最短距离为 x⁻¹·⁹⁴exp(−0.000005x),x以米计。指数截断意味着极远距离的尾部受到更强抑制,不能把它写成无限尺度的纯幂律。
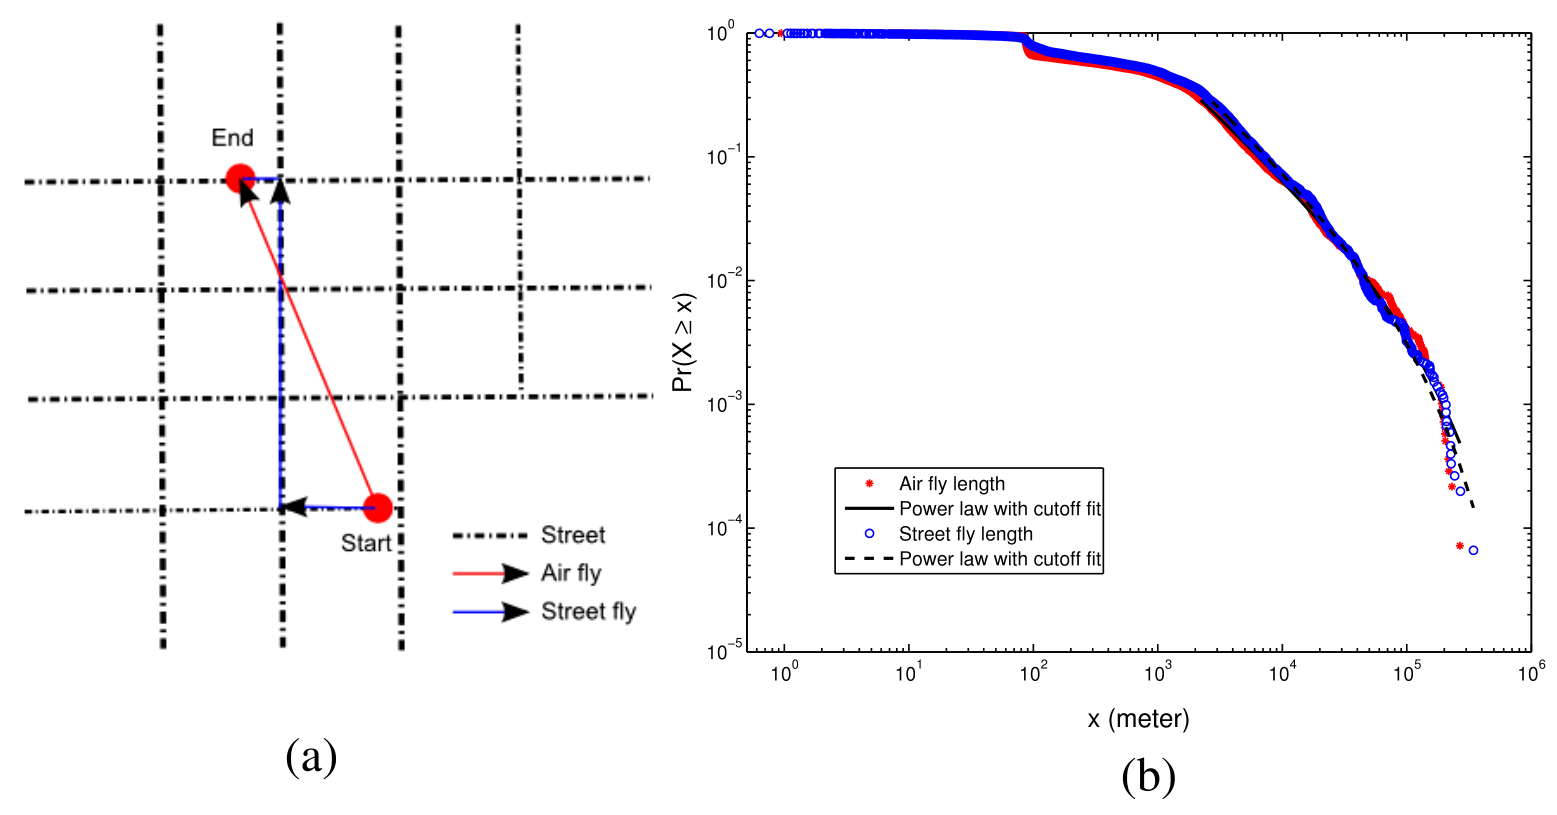
图 6|用直线还是道路最短路径,会改变总体尾部形状吗?
(a)红色直线连接起终点,蓝色路径沿虚线道路网到达同一终点。(b)横轴为米数,纵轴为长度达到或超过x的比例;红点对应直线距离,蓝圈对应道路最短距离,黑线表示带截断幂律拟合。两条总体曲线相近,不保证每一对端点绕行都很小。来源:原论文 Fig. 6。
正文表1以纯幂律为参照,比较指数、对数正态、拉伸指数及截断幂律。两种距离的四项VTS均为负,截断幂律分别达到−8708.7和−10500.1,是表中最突出的结果;表列p四舍五入为0。表中数值用于模型比较,不能解释为准确率或真实概率恰好为零。这个比较支持采用截断形式,但没有消除观测时间、样本与目的地提取规则的影响。
热门活动位置,是否也形成了层层嵌套的空间结构?
把所有人的活动位置放在一起,论文利用基于三角不规则网TIN的熵变化进行层级聚类,得到高、中、低三层。它们被解释为近似城市或镇、城市片区、街区等尺度,但这种对应是地理解释,不是逐层验证的行政边界。
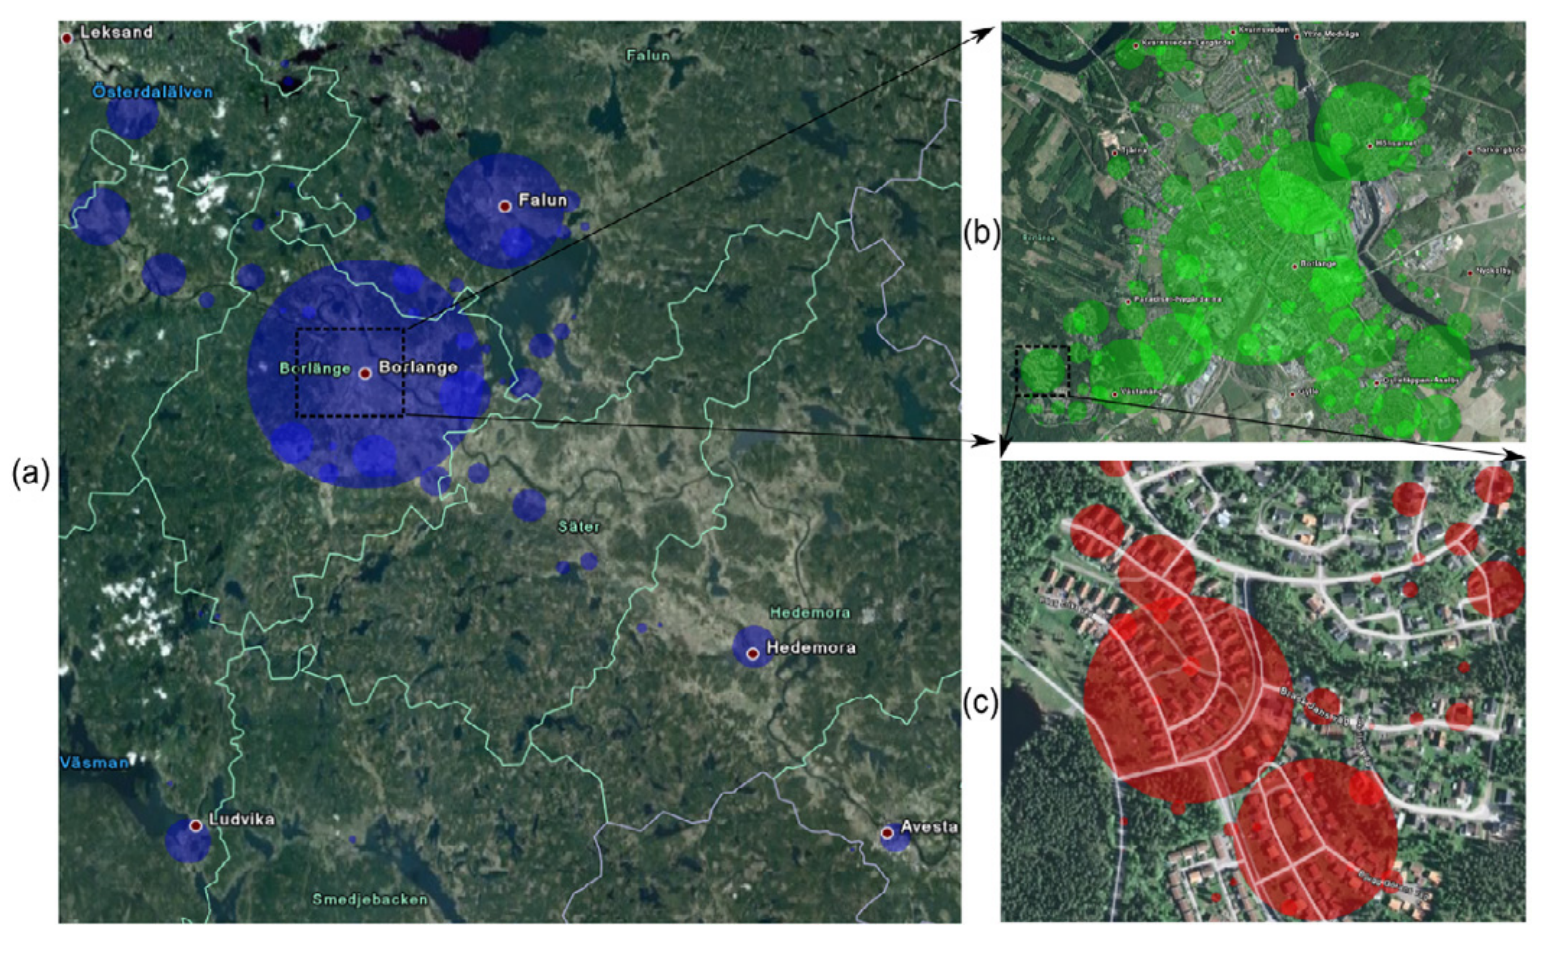
图 7|同一批活动位置,能否在不同空间尺度上形成大小不一的聚集?
(a)蓝色为高层聚类。(b)绿色为中层聚类。(c)红色为低层聚类。连线与虚框保留逐层放大的对应关系;圆半径随活动位置次数增加,不能直接把圆面积读作人口或吸引力。来源:原论文 Fig. 7。
每层聚类都有两种规模:活动次数,以及涉及多少位不同志愿者。一个人可以在同一聚类中贡献多次活动,因此两种分母不同。表2给出活动次数尾部指数从1.89到2.26,参与者人数尾部指数从2.18到2.76;检验P介于0.05与0.90。高P表示未见足够证据拒绝拟合,并不是机制已被证实。
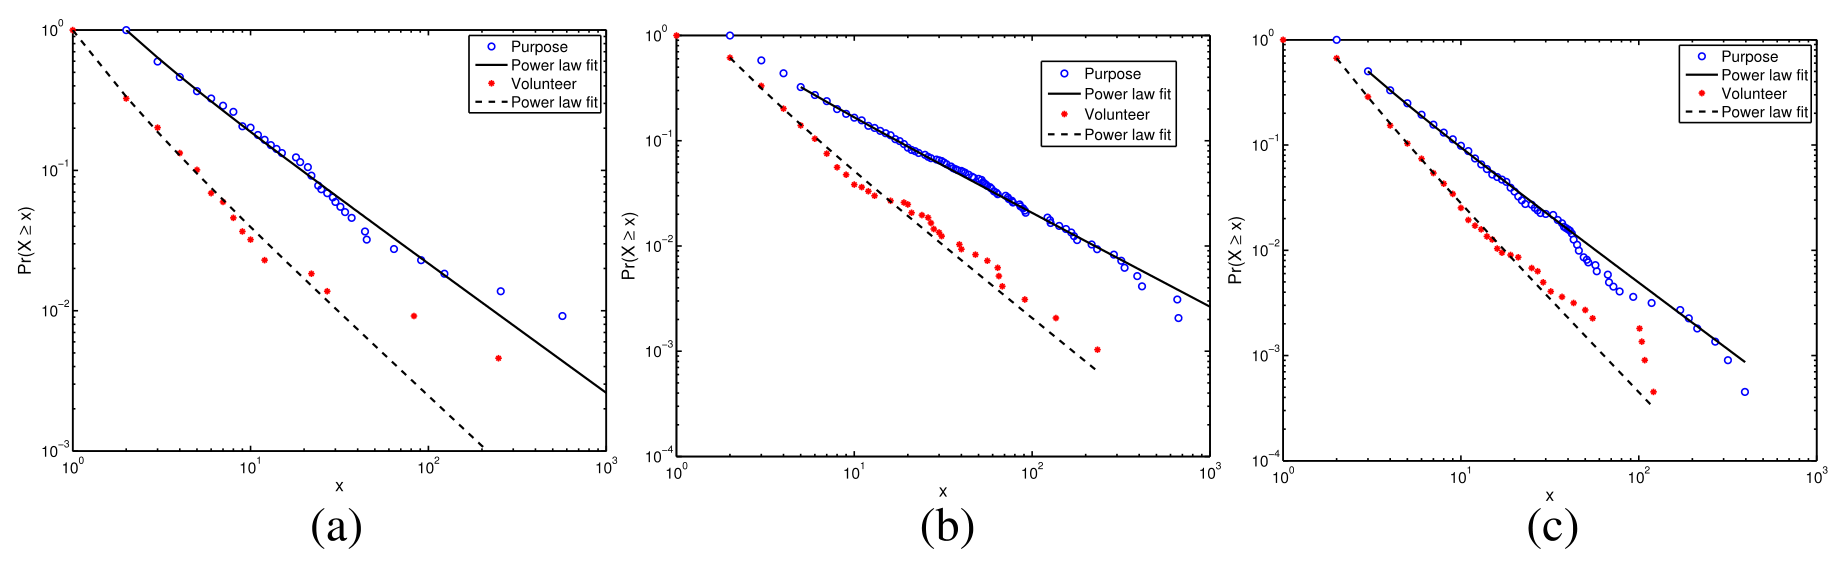
图 8|少数大聚类与大量小聚类,是否在每个层级都存在?
(a、b、c)依次为高、中、低层;横轴x是聚类规模,纵轴为达到或超过该规模的比例。蓝圈按活动次数计,红点按不同志愿者数计,两类黑线为对应幂律拟合。两种曲线都表现大小差异,但不能混成同一份人数分布。来源:原论文 Fig. 8。
| 层级 | 活动次数指数 / P | 志愿者人数指数 / P |
|---|---|---|
| 高 | 1.92 / 0.19 | 2.18 / 0.90 |
| 中 | 1.89 / 0.89 | 2.37 / 0.05 |
| 低 | 2.26 / 0.40 | 2.76 / 0.32 |
表|原论文表2的两种聚类规模口径。中层人数P恰为本文采用的0.05阈值,应保留其边界性。
同样的地点网络,为什么选择规则会改变距离分布?
主体模型(agent-based model,ABM)让许多模拟个体按局部规则移动。在这篇模型里,同父节点的兄弟聚类、父子聚类以及所有高层聚类之间可以连接。这里的边表示可选的层级转换关系,并非实际道路几何的完整复制。
每一步有两种规则可比较。均匀主体从相邻节点中等概率选一个;偏好主体选择邻居j的概率,正比于该邻居的活动次数sj。所谓热门,是这批样本里被提取到的活动次数较多,不是另行测量的商店品质或每个人的心理喜爱。
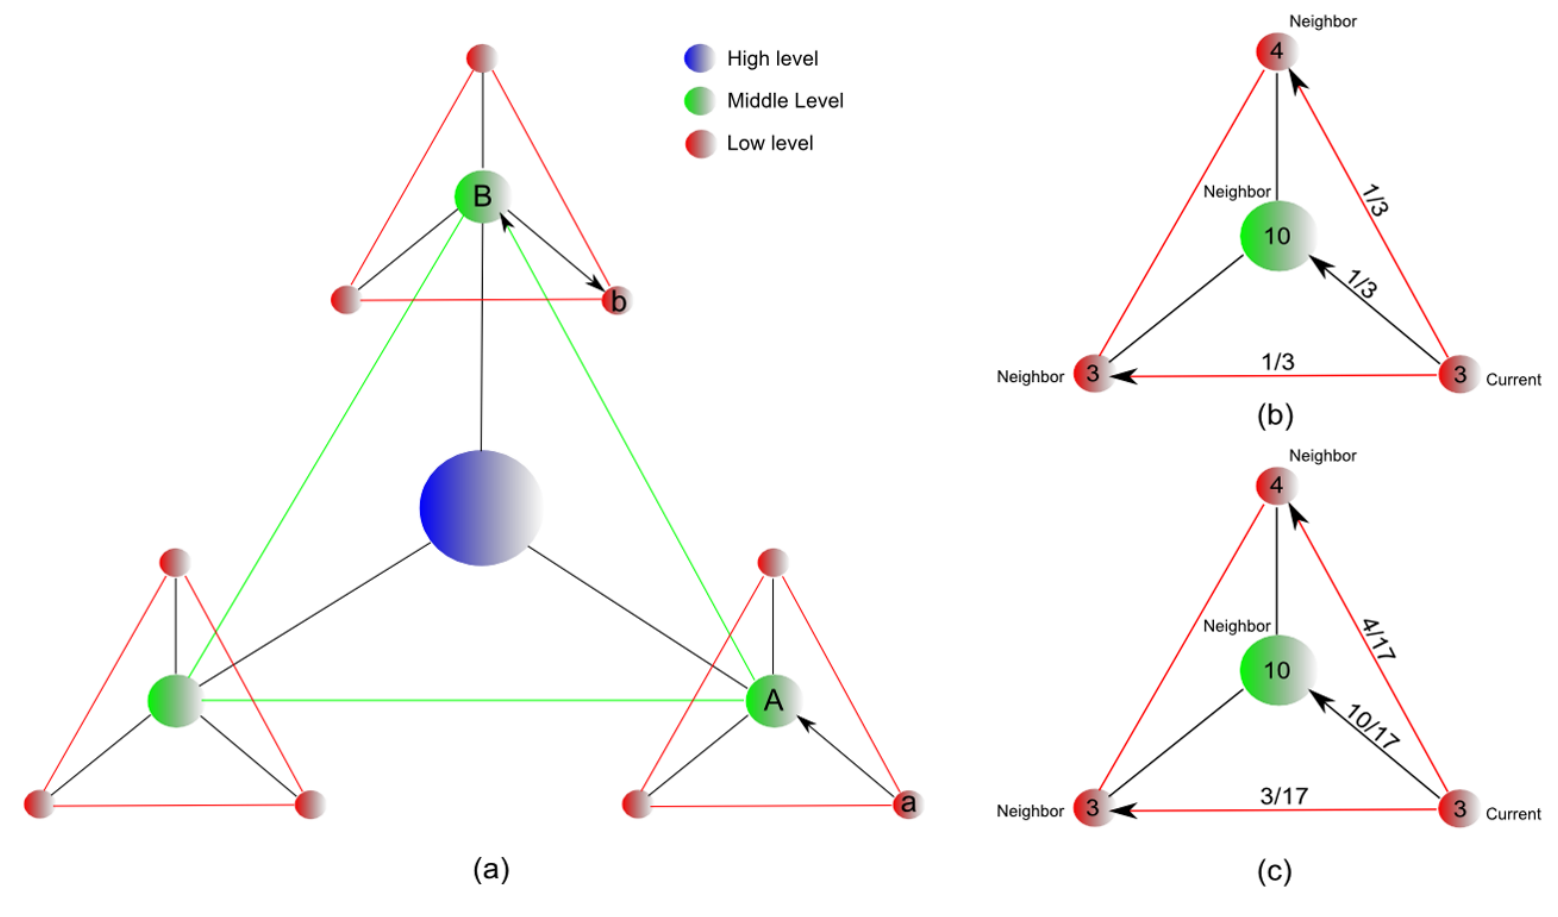
图 9|地点层级与热门偏好,在模型中分别怎样起作用?
(a)蓝、绿、红节点依次表示高、中、低层,跨片区移动需通过层级网络连接。(b)三个候选邻居权重为4、10、3,均匀规则各取1/3。(c)偏好规则按权重选择,概率变为4/17、10/17、3/17。来源:原论文 Fig. 9。
论文进一步推导,在无向图长期平稳分布下,均匀游走对每条有向边的使用概率相同,约为1/(2m),m为无向边数;偏好游走的边使用概率则正比于两端活动次数的乘积si×sj。于是大聚类之间的连接更频繁地被使用。这是模型的数学性质,不能直接宣称真实居民就是按该乘积做决策。
仿真用258个主体,每个走60步;60来自15,423个活动位置除以258人的量级,不是60天。均匀规则没有显示同样的幂律式尾部,偏好规则则拟合出约2.02的指数,接近实测直线距离截断形式的1.93参数。
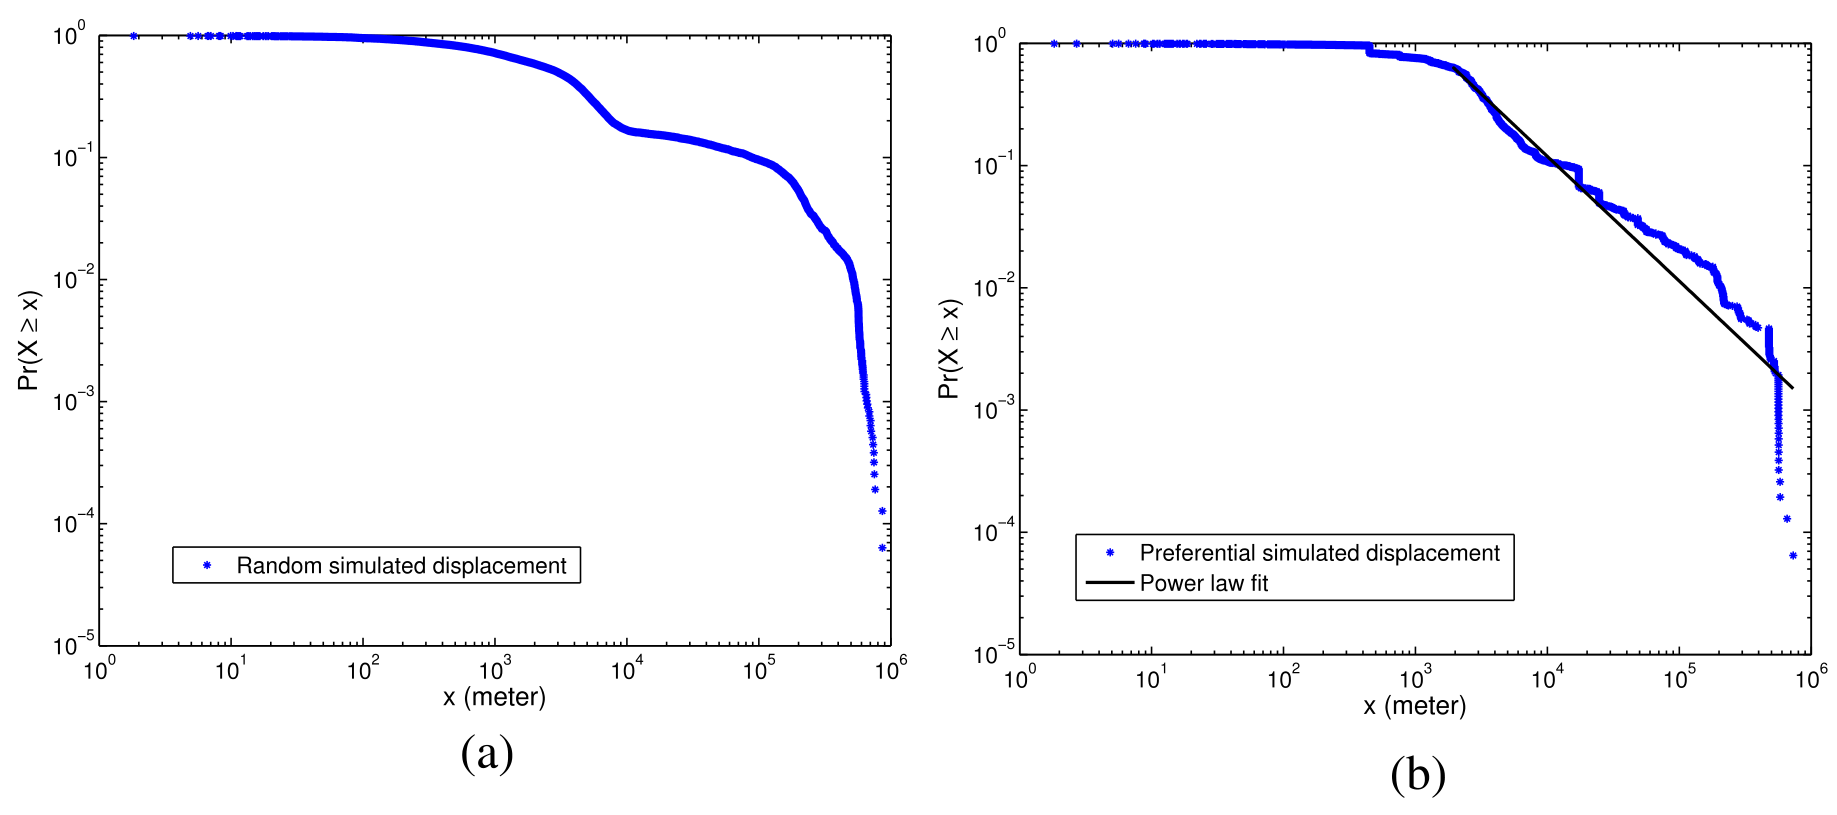
图 10|只改变选择规则,模拟距离尾部会怎样变化?
(a)均匀主体生成的距离尾部呈明显弯曲。(b)偏好主体在一定区间更接近幂律拟合。横轴都是位移米数,纵轴都是达到该长度的比例;二者使用相同258主体、60步设置。比较支持热门偏好在这套网络中起作用,没有单独证明空间层级不可替代。来源:原论文 Fig. 10。
随机改计划,为什么反而会增加远途?
模型增加跳跃因子JF:以一定概率跳过原有相邻节点选择,直接去一个随机底层聚类。JF越大,主体越常突破附近层级关系,较长位移更常出现,拟合指数下降。
论文报告α≈1.55×JF⁻⁰·⁰⁸⁴,R²≈0.98,模拟指数范围约1.55—2.05。这一经验式适用于测试的正JF范围,JF=0应回到原模型,不能代入负幂公式得到无限指数。JF=1时完全按随机底层目标选择,也不是沿原网络每个邻居等概率移动。
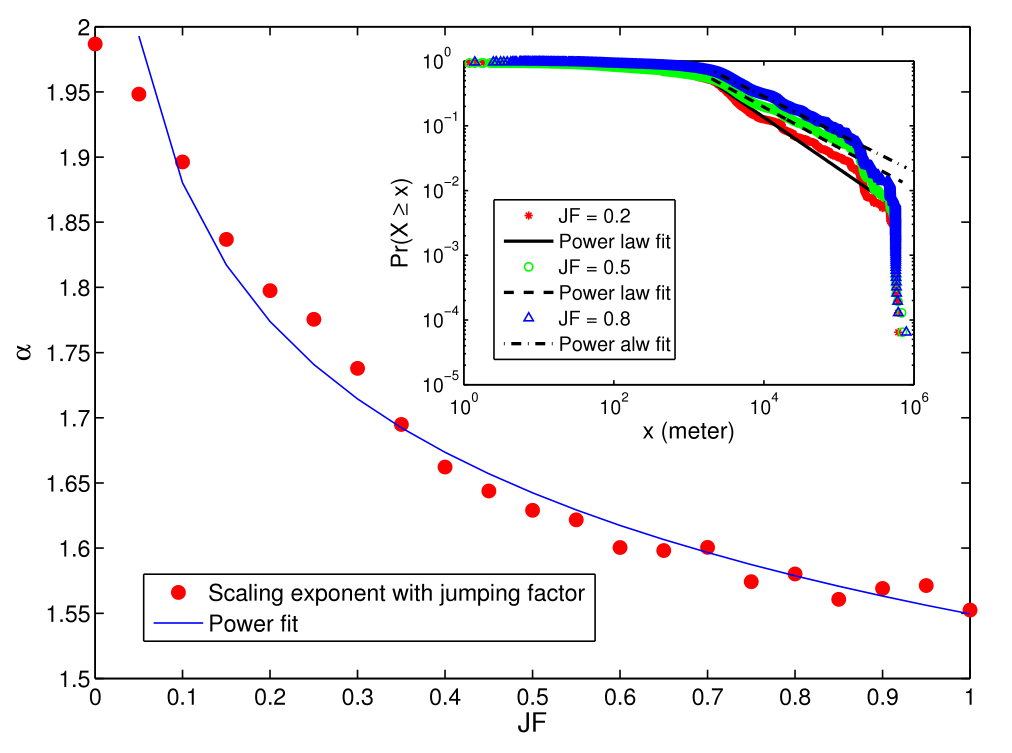
图 11|更多随机远跳,是否会把尾部变得更重?
该图无字母子图。主图横轴为JF,纵轴为拟合指数α,红点随JF增加而下降,蓝线为经验拟合。插图比较JF=0.2、0.5、0.8的距离累计尾部与拟合线,指数降低表示相对更重的长距离尾部。它展示模型的可调性,并未测出志愿者的真实JF。来源:原论文 Fig. 11。
附录还扫描主体数50—300、步数50—1000,共120个组合,得到指数约1.95—2.05。它说明原设置附近的指数对模拟规模变化较稳定,不能替代随机种子重复的置信区间、跨城市外部检验或对其他统计量的校准。
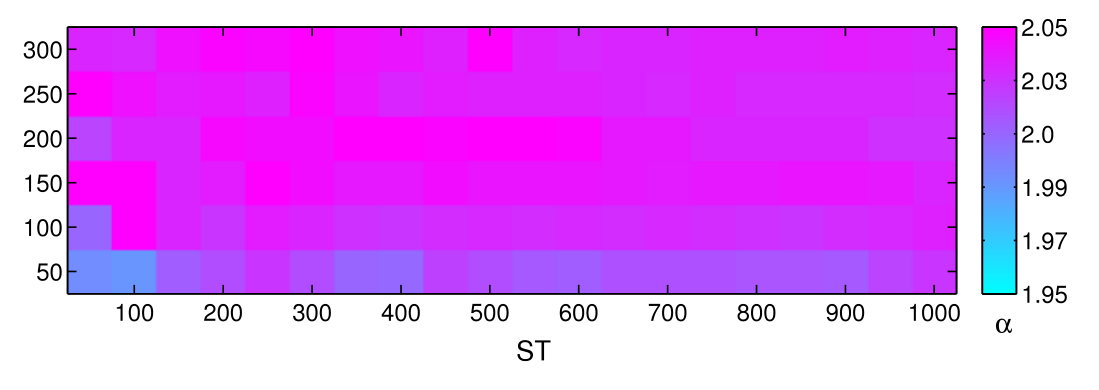
图 12|模拟人数或步数变化,指数会不会大幅漂移?
该图无字母子图。横轴ST为步数,纵向数值为主体数SN,颜色表示指数α;大部分组合集中于约2附近。它检验模拟规模稳定性,不是实测预测精度。来源:原论文 Fig. A.1。
这套解释还缺哪一步?
关键优势是把观测到的空间聚类结构和明确选择规则结合起来,展示了重尾距离可以由二者共同生成。主要边界也在这里:网络、节点权重都来自同一批活动数据,模型又以该批数据的距离尾部检验,因而这是一种机制复现,尚非独立城市的前瞻预测。
同一网络上的均匀与偏好比较较直接,但论文未提供完整的“保留偏好、打乱层级结构”对照。因此可以说偏好在所建网络中改变了结果,却不能把重尾唯一归因于层级。活动位置阈值、短期车辆观测、志愿者招募方式,以及真实活动标签的缺乏,也会共同影响结论推广。
一句话总结
地点大小与层级不均、主体又偏向活动更多的地方,足以在这套模型中生成近似实测的重尾距离;这提供了一种可检验解释,并未完成对真实出行机制的唯一识别。
核心来源
- 原论文与出版信息。正文Figs. 1—11、Tables 1—2以及附录A.1—A.3共同构成本文依据。
- 附录包含活动位置提取伪代码、基于2500个合成样本的幂律拟合优度检验,以及Fig. A.1的模拟规模扫描。图1—11对应原图同编号,图12对应附图A.1。
作者介绍
Tao Jia:论文署名为瑞典皇家理工学院地理信息学部门和耶夫勒大学地理信息测绘部门。
Bin Jiang:论文署名为瑞典耶夫勒大学地理信息测绘部门。
Kenneth Carling:论文署名为瑞典达拉纳大学技术与商业研究学院。
Magnus Bolin:论文署名同为达拉纳大学技术与商业研究学院。
Yifang Ban:论文署名为瑞典皇家理工学院地理信息学部门。以上均按原论文机构信息介绍。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
要检验空间层级是否必要,可以保留每个聚类的活动权重和节点度数,打乱父子关系或空间位置,再运行相同的偏好规则。若打乱后尾部仍差不多,说明热门地点权重可能已经解释主要现象;若尾部明显变化,才更有理由把层级或几何关系列为关键因素。
另一个检验是用一部分志愿者建聚类和权重,再用未参与建模者的出行验证。若仍能复现不同距离段的比例,模型才开始超越对原样本自身结构的重述,也更接近可以迁移到新一批人的出行模型。

