去过很多地方的人,下一小时的位置一定更难猜吗?
论文名片|Chaoming Song、Zehui Qu、Nicholas Blumm、Albert-László Barabási,Limits of Predictability in Human Mobility,Science,2010,327(5968):1018–1021,2010年2月19日发表。DOI:10.1126/science.1177170。这是一项手机基站记录的观察分析,结合熵估计与信息论上界推导。
一个人每天在住处与附近办公室之间往返,另一个人经常跨越数十乃至数百公里。直觉上,前者的位置更容易猜中。但远行者如果总在固定时间去固定地点,他的活动范围虽然大,时间表仍可能很规律。
这篇论文最著名的数字是93%。准确含义是:在研究选定的用户、基站尺度和逐小时位置任务中,根据历史轨迹估计的潜在预测上限集中在约93%。论文没有训练一个已经达到93%准确率的预测器,也没有证明所有人、所有精度的位置都能预测到这个水平。
先说结论:
- 只看去过多少地点,会高估位置的不确定性;地点访问频率和访问顺序都包含规律。
- 在最终45,000位用户中,理论上限的分布集中于约93%;活动半径超过约10公里后,上限与活动半径的关系较弱。
- 只允许答案落在最常去的两个地点,最多覆盖约60%的位置时刻,不能解释全部潜在规律。
- 这一结果依赖缺失数据修正、有限样本熵估计和信息论假设;它给出潜力与边界,而非一次实际预测竞赛的成绩。
手机记录看到了什么,又漏掉了什么?
主数据D1来自匿名化运营商记录,覆盖2007年约4—6月的14周、约1000万用户。补材说明,发出或收到通话、短信时会记录路由基站位置。研究从中选择50,000位访问过超过两个基站、平均通话频率至少每小时0.5次的用户。高频用户筛选提高了记录密度,也限定了样本代表性。
基站平均接收区域约3平方公里。研究对象是基站附近的位置,不是街道门牌,更不是精确室内坐标。每位用户的14周记录被分成2352个小时格;一小时内若有多次记录,随机选一条;若没有记录,就标成未知符号“?”。因此任务是推测逐小时位置,连续多小时待在同一地点也计入规律,不能直接等同于预测下一次真正换地点的目的地。
即使通话频率较高,记录仍然很稀疏:未知小时比例q的分布在约0.7附近达到峰值。通话往往成串发生,平均每小时0.5次并不保证每两个小时都有一次位置更新。
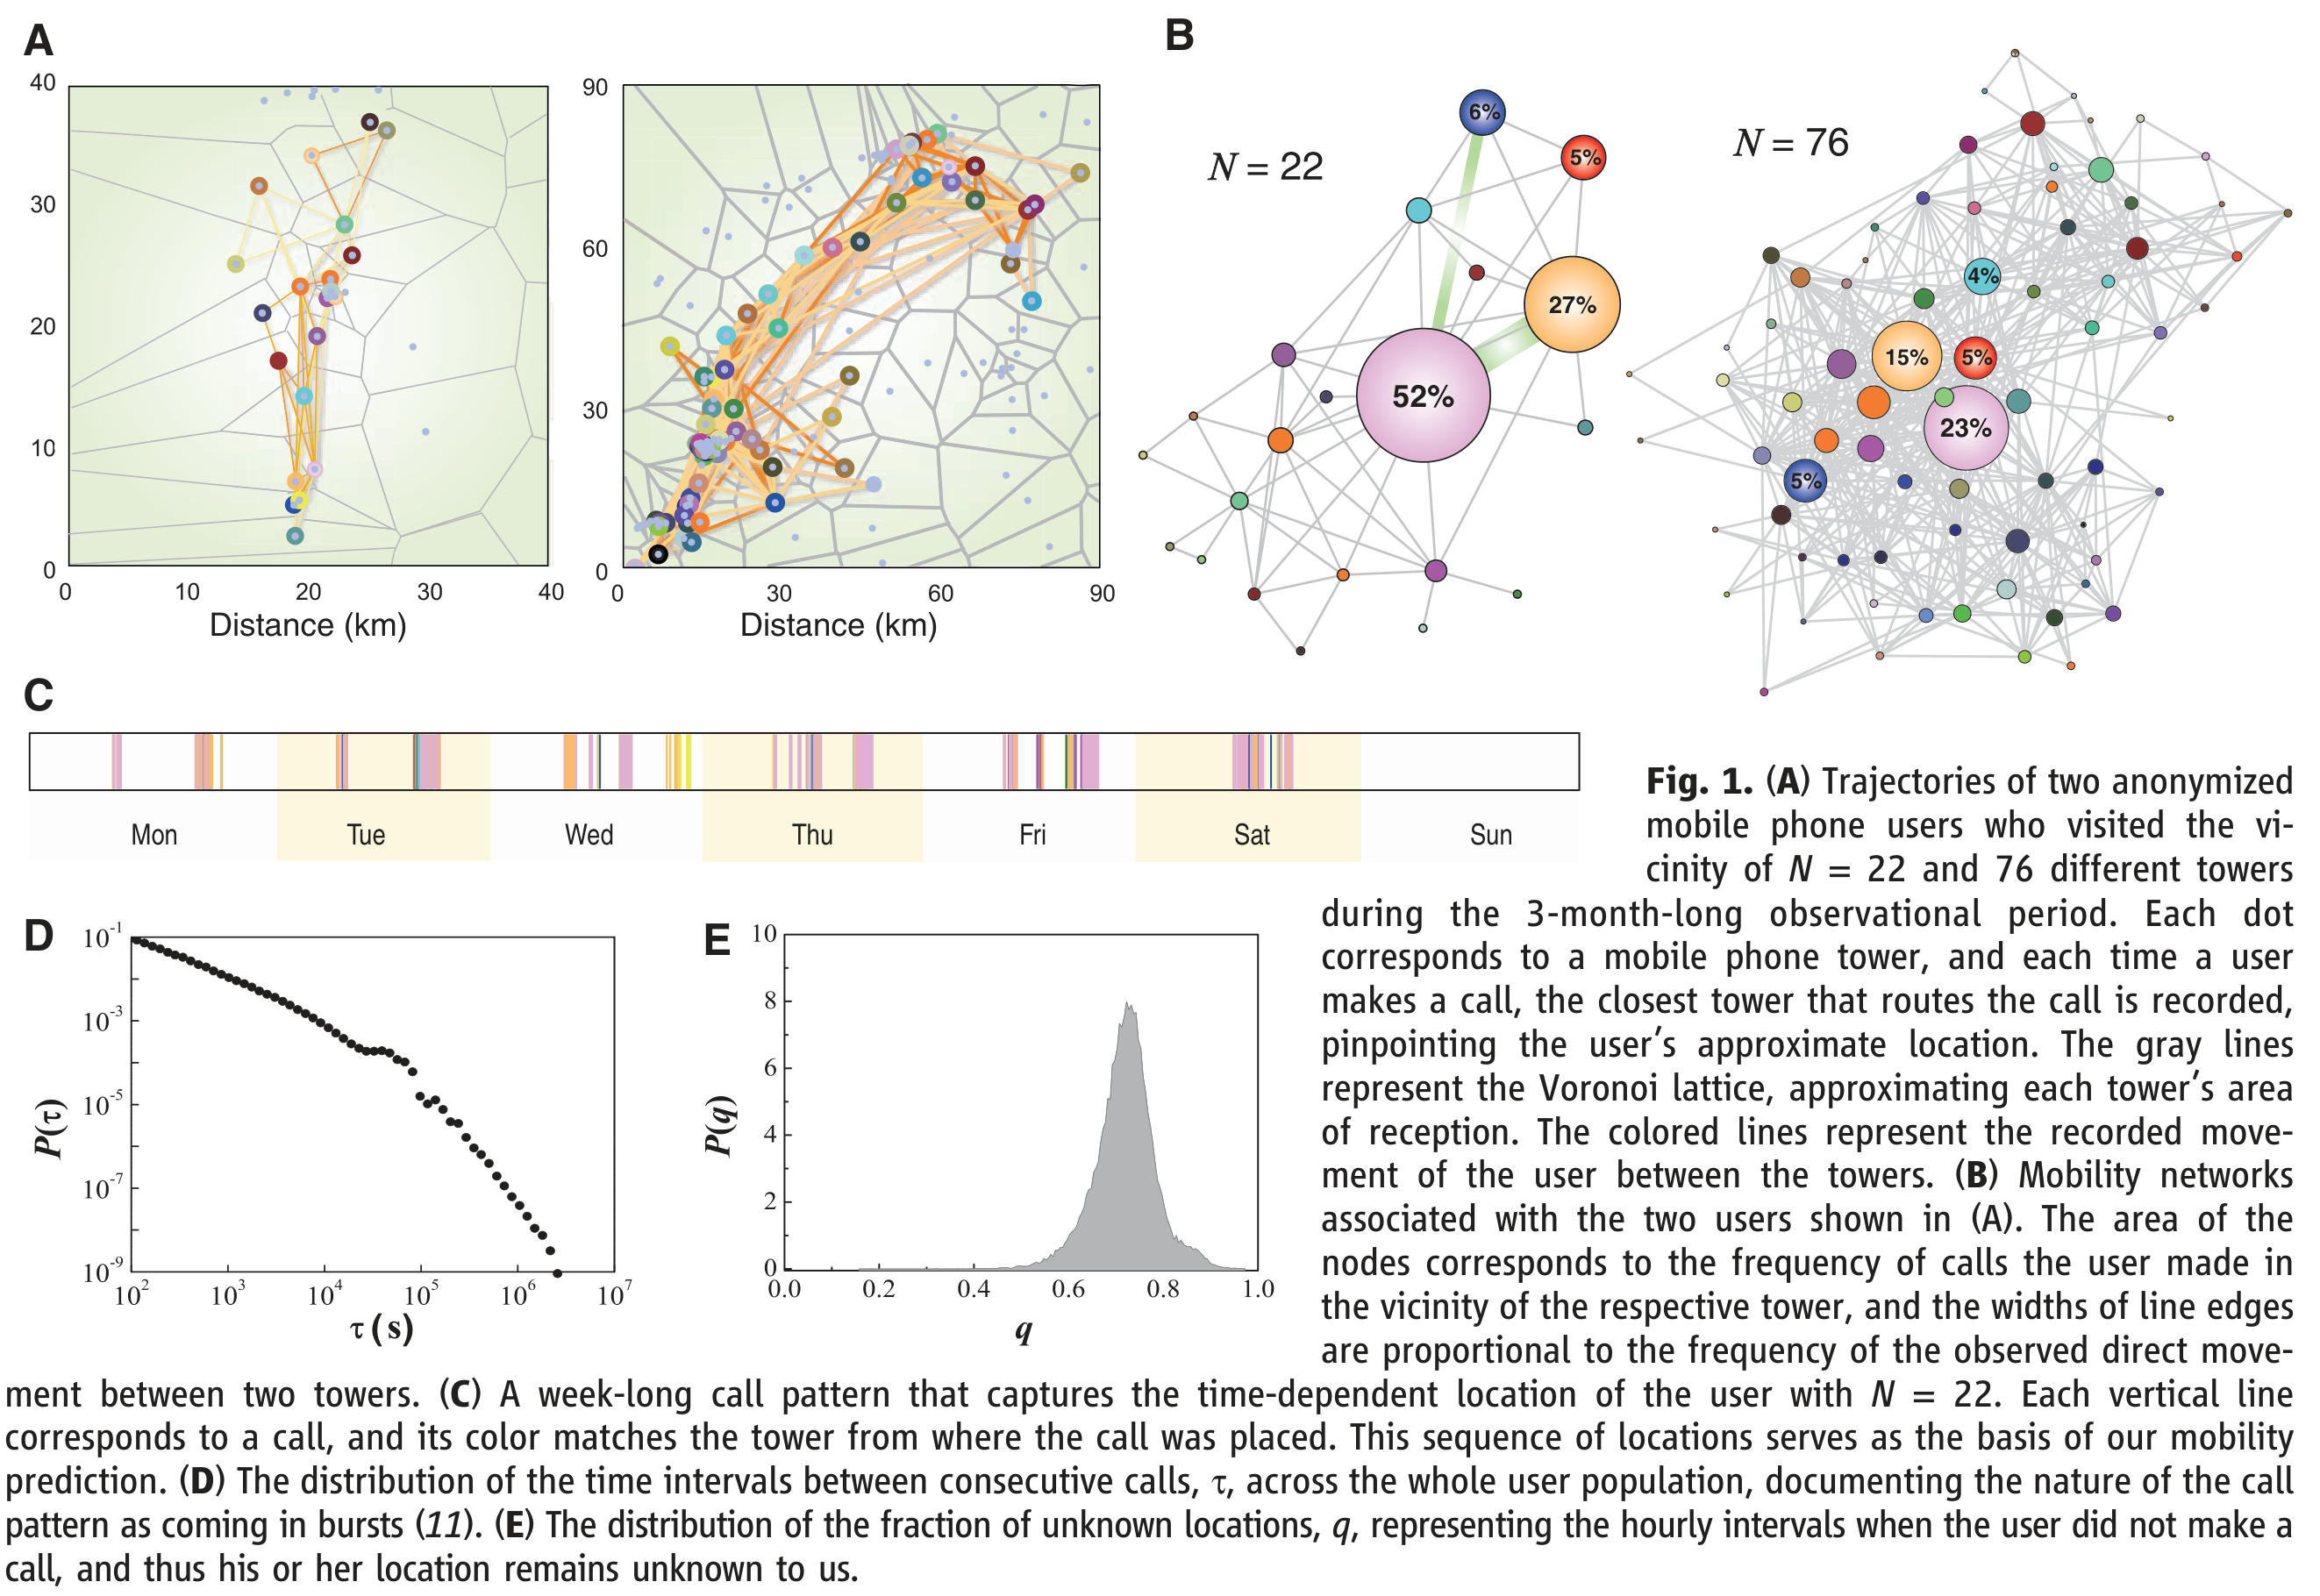
图 1|活动范围和访问网络不同,位置记录为何仍可能同样规律?
(A)两位匿名用户分别访问22与76个基站,坐标为公里,灰线近似表示基站接收区域,彩色连接表示记录到的地点转换。两人的空间活动范围明显不同。
(B)对应移动网络中,节点大小表示该基站附近的通话频率,边宽表示观察到的直接转换频率;少数大节点体现访问集中,不能把通话份额无条件等同于真实停留时间。
(C)22基站用户一周的通话时间序列,每条竖线是一条通话记录,颜色对应地点;空白时段说明没有观测,而非用户没有移动。
(D)相邻通话间隔τ的分布跨越多个时间尺度,显示通话成串出现。(E)未知小时比例q主要集中在约0.7,暴露了熵估计必须处理的缺失问题。来源:原论文 Fig. 1。
没有记录的七成小时,怎样进入分析?
若把未知符号当成一个真实地点,轨迹结构会受到扭曲。研究使用基于Lempel–Ziv压缩思想的熵估计:已经反复出现过的序列较容易压缩,新的、不规则序列较难压缩,因而可以据此估计每步新增的不确定性。
缺失修正还多做了一步:从已经有缺失的序列里,再随机删去部分已知位置,让q继续增加;计算原序列与随机打乱序列的熵比值的对数,再利用其近似线性关系,向q=0外推。这里重建的是总体熵的估计,没有恢复每一个未知小时的真实位置。
独立数据D2包含1000位自愿参加持续定位服务的用户,其中100位有连续8天逐小时记录。研究从这些完整轨迹中人为删除位置,再检查估计能否接近完整记录的熵;同时在D1中选择q<0.35的较密集用户,考察更长序列。补材表明,时间序列越长,方法能容忍的缺失比例通常越高,约20天后接近其算法阈值0.825。因此最终分析保留q<0.8的45,000人,排除缺失最多的5000人。
这并不等于任意丢失80%数据都能可靠恢复。验证包含随机删除,而真实漏记取决于通话行为,可能与时间、地点或活动相关;D2完整验证窗口也只有8天。低熵、短序列与高缺失的组合,会增加估计偏差。
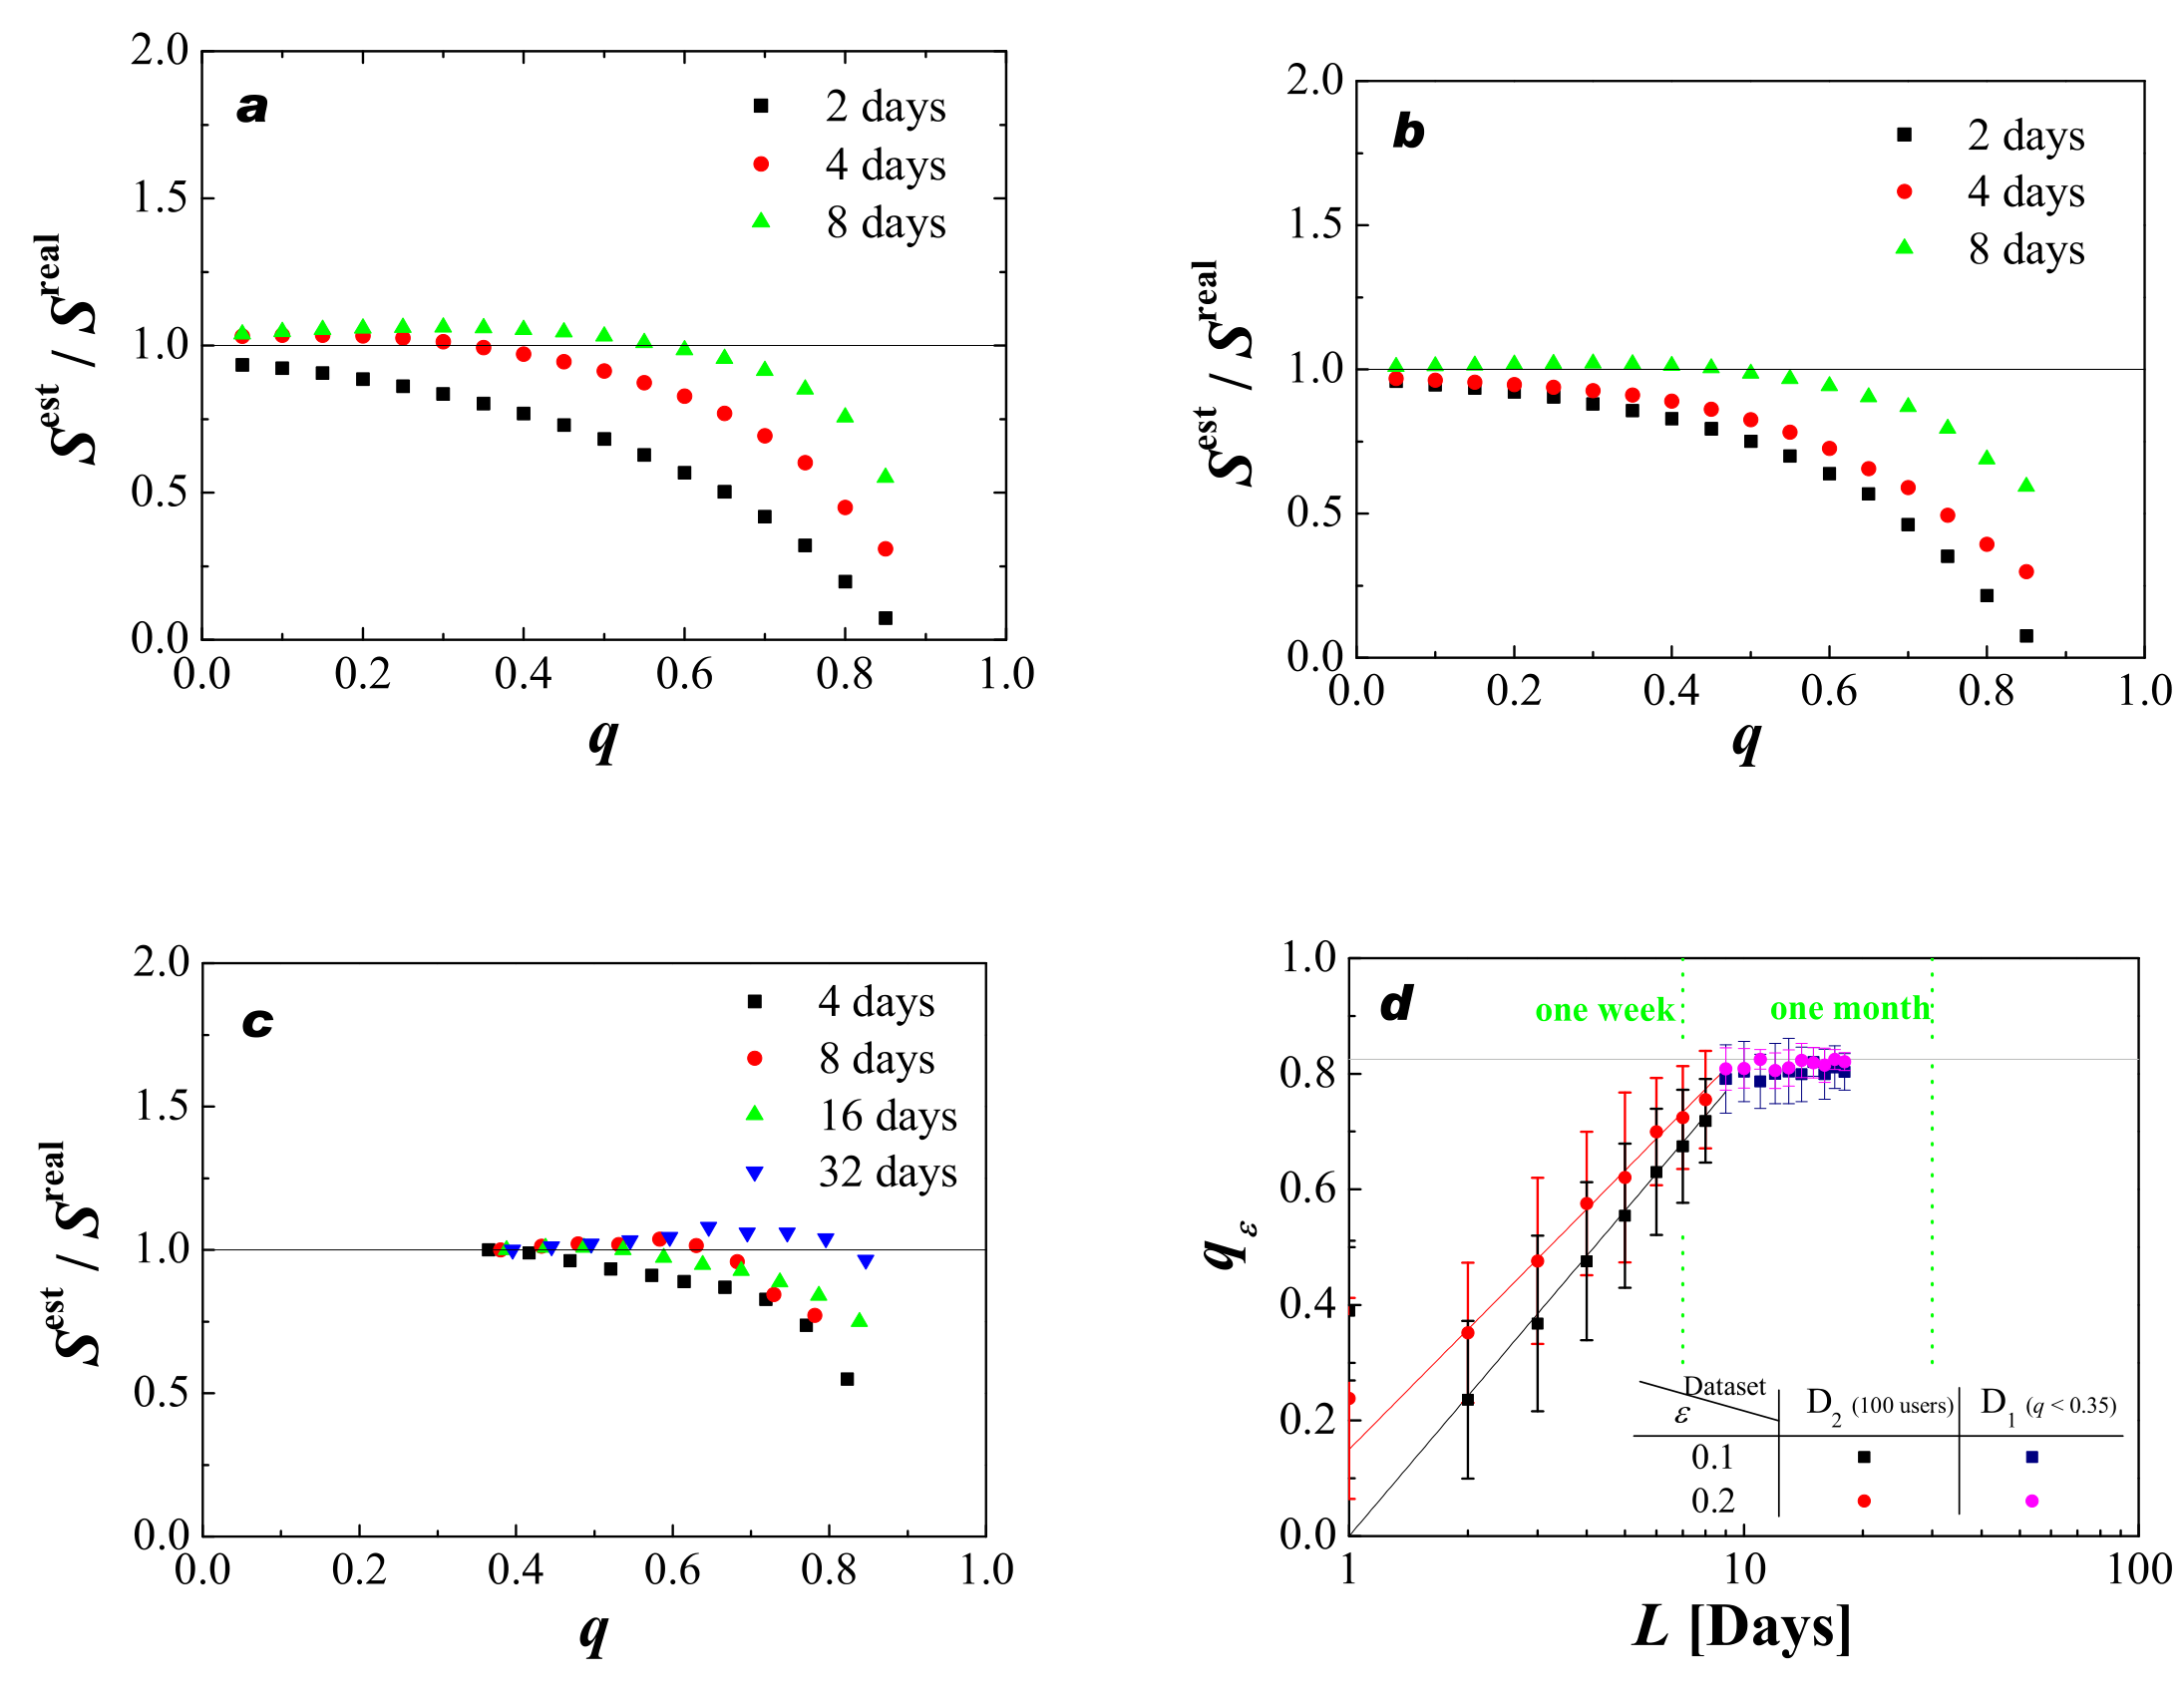
图 2|缺失比例相同,记录越长是否越容易估计?
(a、b)两位D2用户分别取2、4、8天记录,横轴为人工缺失比例q,纵轴为估计熵除以完整记录熵;接近1表示估计接近参照值,短记录和高缺失时偏离更大。
(c)D1一位原本q=0.3的用户,比较4、8、16、32天记录,较长记录在更大q下仍较接近1。
(d)横轴为序列天数,纵轴为满足给定误差条件时能容忍的最大q;颜色与符号区分D1、D2及10%、20%的相对误差阈值。接近0.825的平台属于本估计流程的适用性检验,不是人的行为参数。来源:补充材料 Fig. S6。
93%是怎样算出来的?
研究为每个人建立三个不同的参照:随机熵Srand只知道他访问过N个地点,并假定每处等概率,因此为log₂N;无时间关联熵Sunc保留各地点访问频率,却忽略顺序;实际熵率S进一步考虑序列中的时空重复结构。理论上有S≤Sunc≤Srand。
最终样本的随机熵分布在约6比特附近达峰,相当于等概率从64个地点中选择。实际熵率的峰值却约为0.8比特。2⁰·⁸约为1.74,是等效不确定性的表达,不能解读为用户现实中只去过不到两个地方。
要从熵转成预测问题,还需要地点数N。Fano不等式给出一个约束:将S与N代入 S=H(Πmax)+(1−Πmax)log₂(N−1),可以求出预测成功率的上界Πmax。H是二元熵函数,衡量“猜中/猜错”的不确定性。熵越低,一般容许越高的预测成功率。
这里的上界是依据历史位置序列的信息量推导的约束。知道全部条件概率时,总选最可能的下一位置是一个理想决策;有限数据中能否学到这些概率,以及Fano上界是否紧,则是另外的问题。论文没有给出留出未来时段的93%实测成绩。
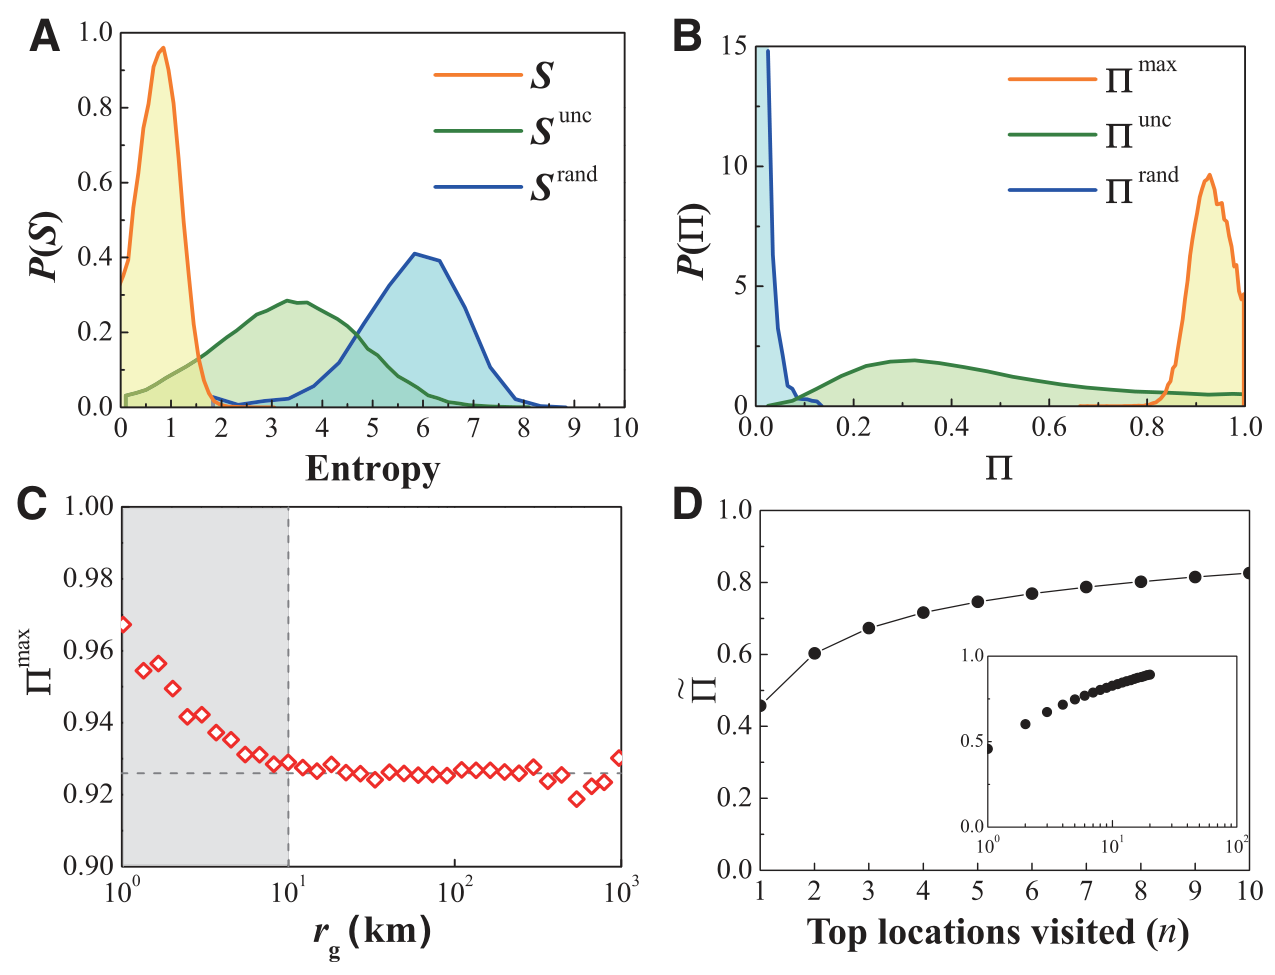
图 3|时间顺序提供的信息,是否只是最常去几个地点的另一种说法?
(A)橙、绿、蓝色分别为实际熵率、无时间关联熵、随机熵的分布;保留更多序列结构后,不确定性明显降低。
(B)对应的理论可预测性分布中,橙色Πmax集中在约0.93;绿色频率参照较宽,峰值约0.3,蓝色等概率参照集中于较低值。这些是按各熵值转换的界限,不是三个实际预测算法的成绩。
(C)横轴为回转半径rg,纵轴为Πmax。回转半径衡量记录位置围绕个人轨迹中心分散的程度,并非累计路程;超过约10公里后,曲线接近0.93的平台。
(D)横轴为允许考虑的前n个常访地点,纵轴为这些地点合计覆盖的时间份额。前两处约为0.6,前十处仍未覆盖全部;插图显示需纳入更多地点才接近完整覆盖。来源:原论文 Fig. 2。
图3D尤其需要限定条件。前n个地点的覆盖率,是“答案只准从这些地点中选”这一预测器的最高覆盖可能;它不是所有预测器的全局上界。两个最常访地点在论文中常被解释为家和工作地,但仅凭基站频率不能保证每个用户都具有这两个功能标签。
远行者是否也有稳定的时间表?
研究把一周分成168个小时格,在每格寻找跨周最常出现的位置。例如,周一上午8—9点最常出现于某基站,就把它当作这个时段的典型地点。规律性R是实际位置与该典型地点一致的比例。
全样本R约为0.7,夜间可接近0.9;中午及傍晚转移时段降低。论文推导R≤Π≤Πmax:只按周内时间格做典型地点判断,忽略了更丰富的历史序列,因此可作为理想可预测性的下界参照。但这个样本内规律统计没有提供独立测试集准确率。
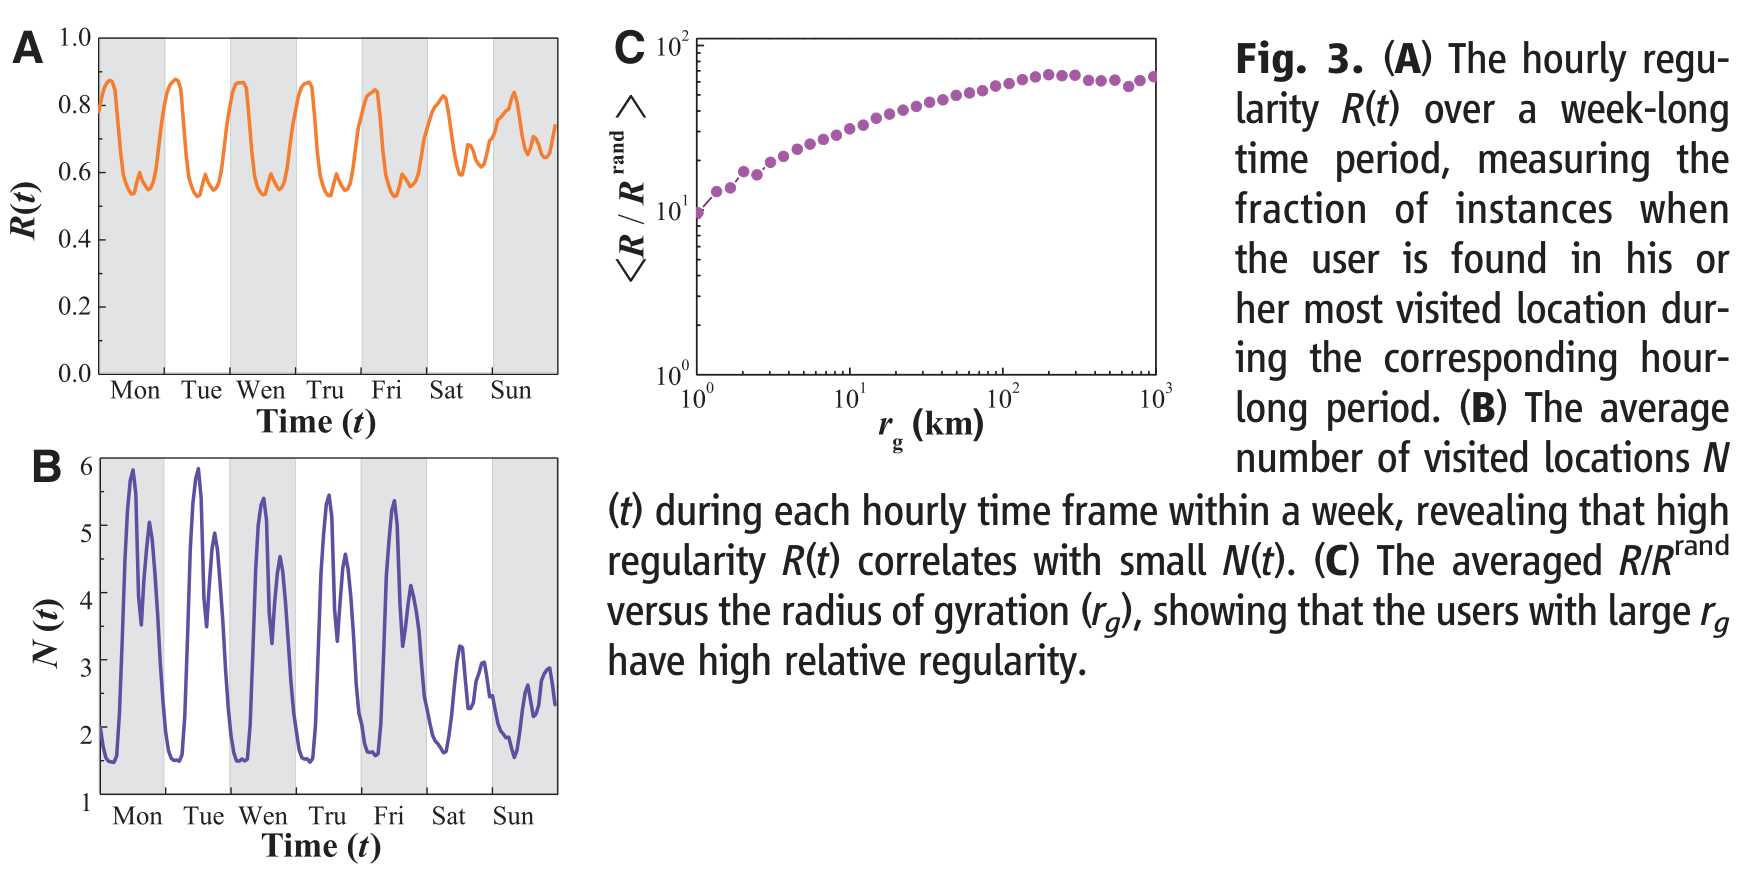
图 4|活动范围大,是否意味着缺少固定节奏?
(A)横轴为一周的小时,纵轴为规律性R(t),反复出现的日内峰谷说明典型时段有典型位置。
(B)对应小时的平均访问地点数N(t),在规律性低的时段较高,符合转换时段有更多位置可能的情形。
(C)横轴为回转半径rg,纵轴为相对等概率基线的规律性R/Rrand,Rrand=1/N。远行用户的相对优势更大;由于基线本身随N变化,不能把它误读成绝对规律性一定随距离升高。来源:原论文 Fig. 3。
周末也未普遍失去规律。补图S8中,65%的用户周末R高于工作日;只有工作日R已超过0.8的高规律群体,其周末平均趋势有所下降,这群人约占19%。这说明固定工作日程不是唯一可能来源,但并未识别出个人偏好、家庭责任、服务时间等因素各自的因果贡献。
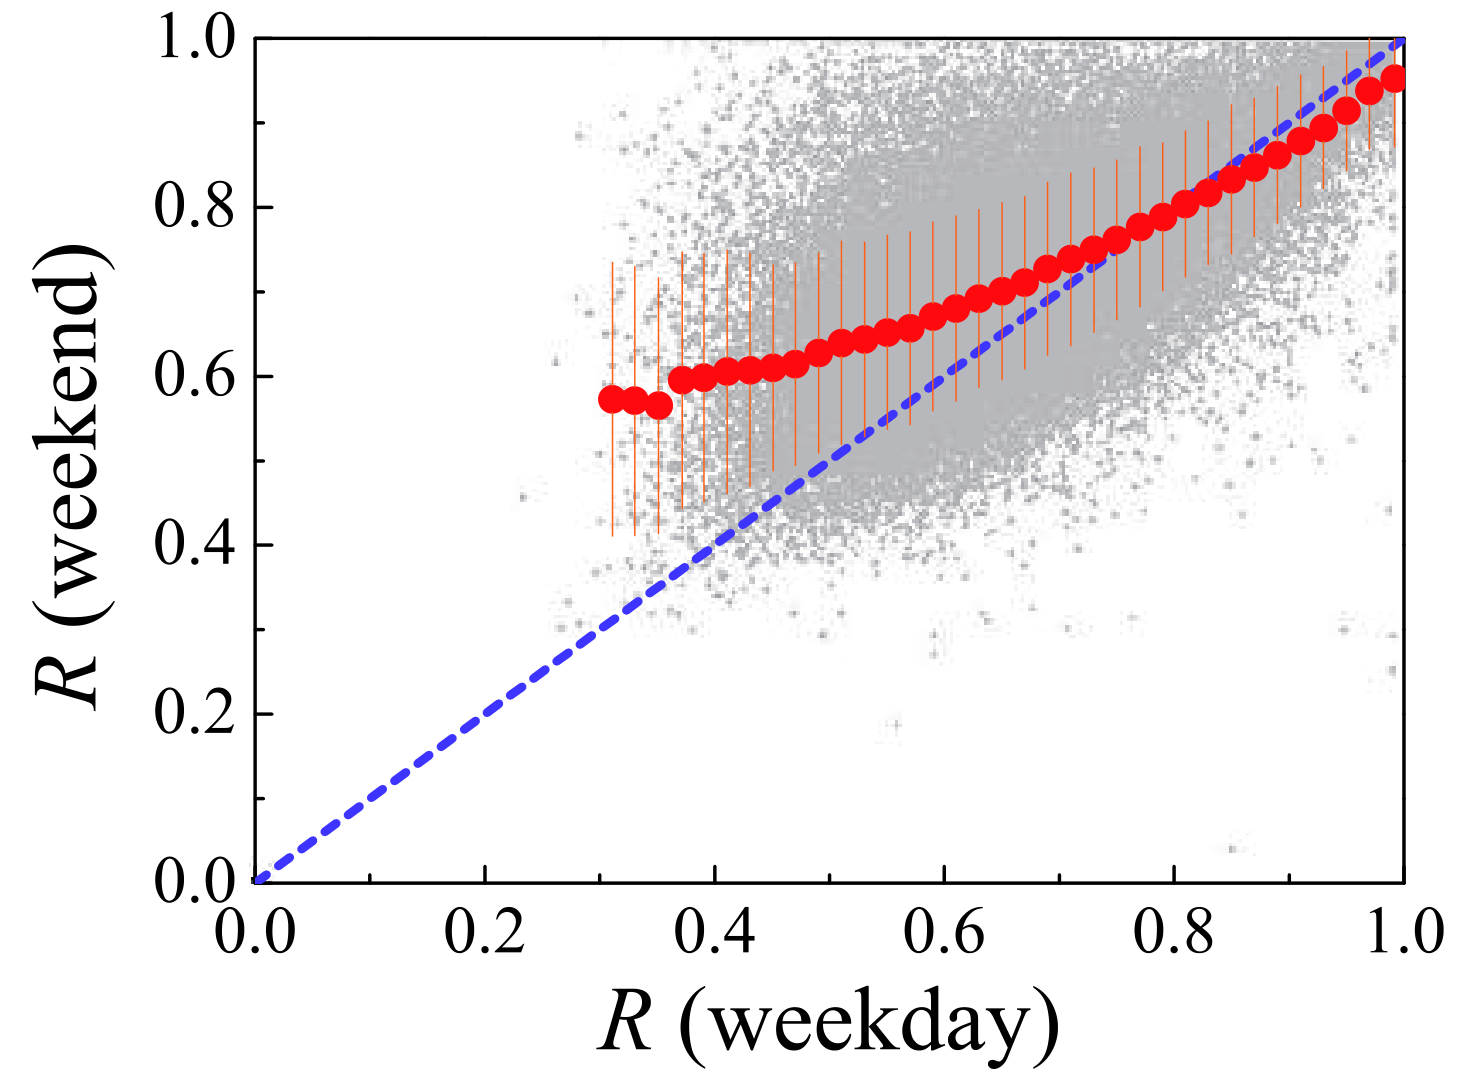
图 5|周末一定比工作日更难形成规律吗?
该图无字母子图。横轴为工作日R,纵轴为周末R;灰点表示45,000位用户,红点为平均趋势,蓝色虚线表示二者相等。大量点在虚线上方,提醒我们不能把规律完全归结为工作约束。来源:补充材料 Fig. S8。
相近的上限,是否说明不同人群完全一样?
年龄、性别比较中,论文未见明显的Πmax差别;女性R略高的表面差异,在按访问地点数N的关系归一化后消失。补材中R约按N⁻¹⁄⁴下降,远慢于等概率基线1/N。这支持规律性并非简单由地点数量决定,却不等于人口属性在所有任务上都不起作用。
收入与语言的比较尤其需要谨慎:研究依据最常用基站所属省份赋予平均收入和区域语言,并未拿到每个用户的真实收入、语言偏好。区域层面上限相近,不能推出个人层面一定没有差异。
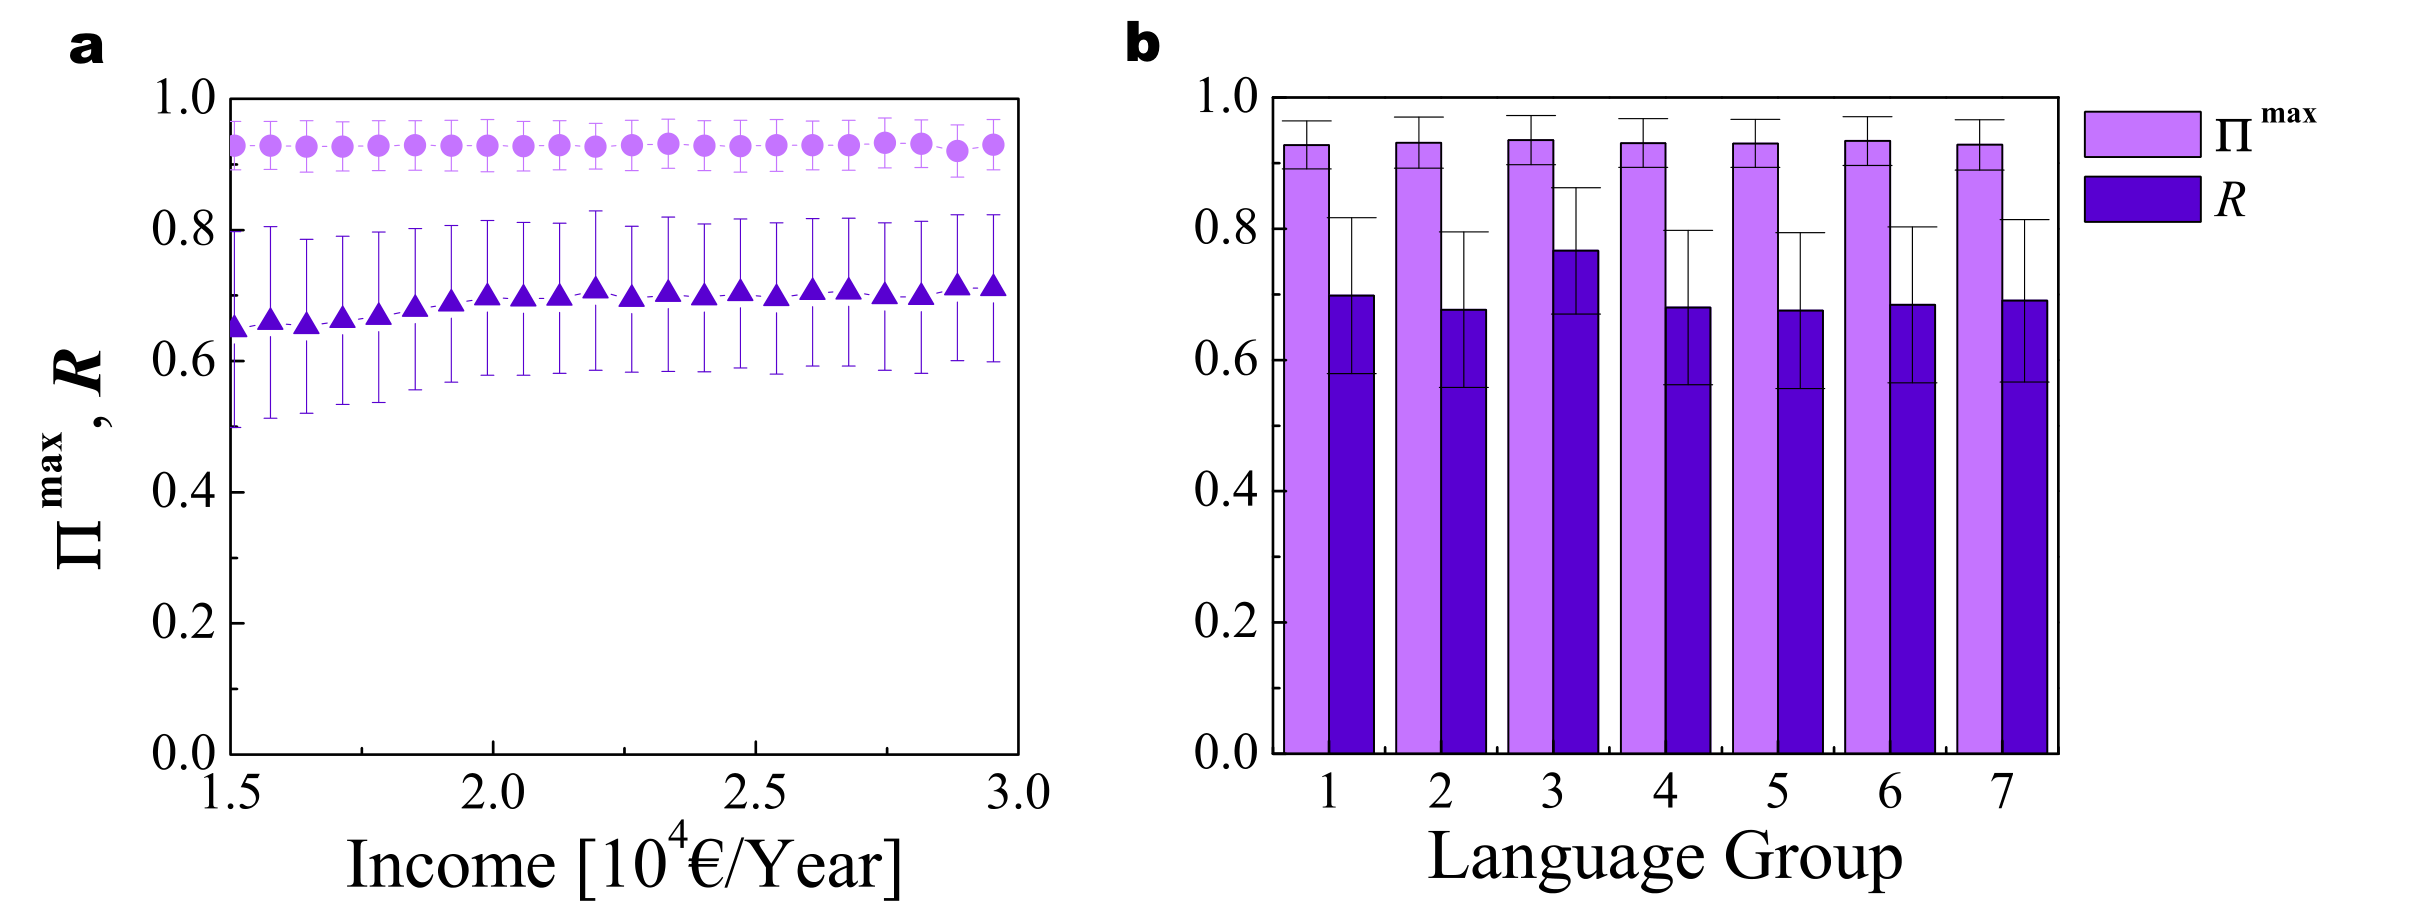
图 6|地区背景不同,理论上限是否明显变化?
(a)横轴为省级平均年收入,单位为万欧元/年;浅紫圆点是Πmax,深紫三角是R,上限变化较小而R存在一定变化。(b)横轴为七个区域语言分组,浅紫与深紫柱分别表示Πmax和R。这里比较的是赋予用户的区域属性。来源:补充材料 Fig. S12。
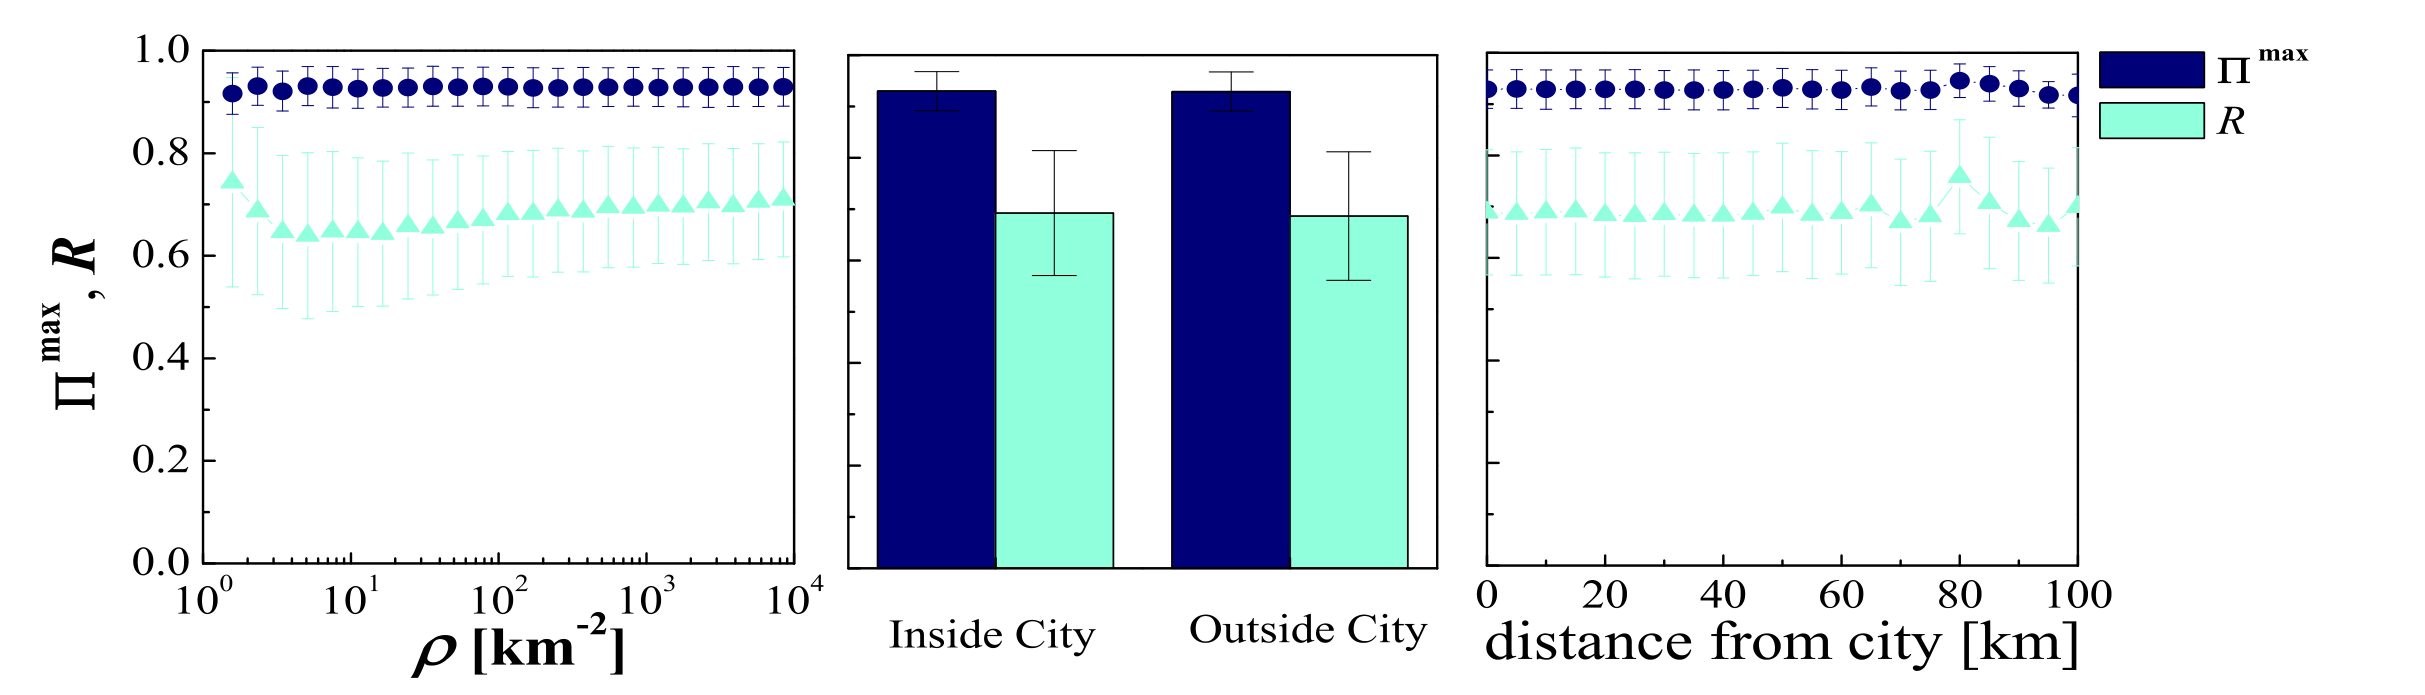
图 7|城市密度和远离都市的程度,会改变同一个上限吗?
原图三个面板未印字母,图注按(a—c)引用。(a,左)横轴为人口密度,覆盖约四个数量级;深蓝Πmax相对稳定,浅绿R有较多变化。(b,中)比较四个最大都市内部与外部。(c,右)横轴为距离这四个都市的公里数,上限同样变化较小。位置对应的密度来自邮编社区信息;结果不能直接外推到任意国家或更精细定位。来源:补充材料 Fig. S13。
这项研究没有宣称什么?
93%属于经过筛选的高频用户、约三个月的历史窗口、小时级与基站级的位置表征。新地点增加、生活变化、空间分辨率提高,以及改成只预测地点转换,都可能改变问题本身。
熵率估计通常依赖序列足够长且统计规律在研究窗口内相对稳定;现实轨迹会有节假日、搬家等非平稳变化。信息论不等式本身与有限样本熵估计是两层问题:估计存在误差时,数值上界也随之受影响。
因此,这篇论文支持“丰富的历史序列包含很强的移动规律”,没有提供一种读出个人动机的方法,也没有证明剩余7%就是不可改变的自由意志份额。地点预测是明确数据口径下的统计任务,不能代替对整个人类行为的判断。
一句话总结
活动范围相差很大的人,也可能具有相近的逐小时位置规律;93%刻画的是特定记录尺度下由熵估计得到的潜在上限,而非已经实现的追踪准确率。
核心来源
- 原论文与DOI,作者实验室公开全文。
- 原始补充材料的佛蒙特大学学术存档:S1—S7、Figs. S1—S13、熵修正与Fano不等式推导。本文图1、3、4对应正文Fig. 1、2、3,其余对应所标补图。
作者介绍
Chaoming Song:论文署名为美国东北大学复杂网络研究中心及物理、生物、计算机科学相关院系,并列哈佛医学院医学系和丹娜—法伯癌症研究所癌症系统生物学中心。
Zehui Qu:署名包含上述东北大学、哈佛医学院与丹娜—法伯机构,另列成都电子科技大学计算机科学与工程学院。
Nicholas Blumm:论文署名包含东北大学复杂网络研究中心及相关院系、哈佛医学院医学系与丹娜—法伯癌症系统生物学中心。
Albert-László Barabási:为本文通信作者,署名同列东北大学复杂网络研究中心、哈佛医学院医学系与丹娜—法伯癌症系统生物学中心。以上均为论文发表时身份。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
出行预测若只报一个总体准确率,很容易把“持续留在同一地点”与“真正猜中下一次移动”混在一起。一个总说用户还在家的算法,可能在夜间很好看,在真正需要交通服务的转换时段却很差。
更有用的评估可以同时报告逐小时位置、发生转换时的目的地、首次访问新地点三个任务,并保持同样的训练与未来测试划分。若一个模型只在第一个任务接近理论上界,就说明它很好地利用了停留规律;只有后两个任务也有可靠表现时,才能进一步讨论它对交通需求变化的价值。

