一个人生活在家和公司之间,平均中心为什么可能落在从不去的地方?
论文名片|Rohit Sahasrabuddhe、Renaud Lambiotte、Laura Alessandretti,From centre to centres: polycentric structures in individual mobility,2021,arXiv:2108.08113v1,预印本。原文与版本。
一个人工作日在城东上班、晚上回城西居住,周末还常去另一处熟悉的社区。把所有停留位置求平均,得到的中心可能落在两片生活区之间的一条河里。这个点在计算上完全正确,却未必是他生活中有意义的地方。
常用的回转半径能告诉我们位置总体分散多远,但没有告诉我们,这种分散是围绕一个中心连续展开,还是由几个相距较远的小活动区组成。这篇预印本把个人活动空间从一个圆推广到多个中心,并研究怎样决定需要多少个中心。
先说结论
- 接近的回转半径可以对应截然不同的生活结构。中心之间的距离与各中心周围的活动范围,需要分开描述。
- 在两个经过筛选的GPS样本中,方法分别将42.8%和22.3%的人识别为多中心;这不是全体居民的普查比例。
- 对丹麦学生样本中的242名多中心用户,随机留出位置记录后,多中心模型在230人上显著优于传统单中心模型。但中心数量预先利用了全量数据,不能把它称作完全独立的未来预测。
- 多中心比例与性别、年龄和国家存在统计关联;就业差异是作者提出的解释之一,论文没有直接检验它的因果作用。
为什么一个圆会遗漏活动空间的结构?
活动空间(activity space)指人在一段时期内活动所涉及的空间范围。论文中的位置有停留时间权重:某地停留越久,对中心与尺度的影响越大。中心是所有位置的加权平均,回转半径(radius of gyration,r_g)是各位置到这个中心距离的加权均方根。
这个指标是一种空间离散程度,不是实际行驶里程,也不是包含全部活动的边界半径;即使把它画成圆,圆外仍可能有活动点。一段长距离、低频停留也可能拉动中心与回转半径。
图1中的丹麦实例显示,平均中心有时远离常去地点;另三人的回转半径约8.7—8.9公里,方法识别的中心数却依次为1、2、3。我们可以说总体离散尺度接近,不能据此说他们具有同样的活动空间组织。图采用对数方位投影,1、10、100公里的同心刻度也不能按普通地图中的线性比例尺理解。
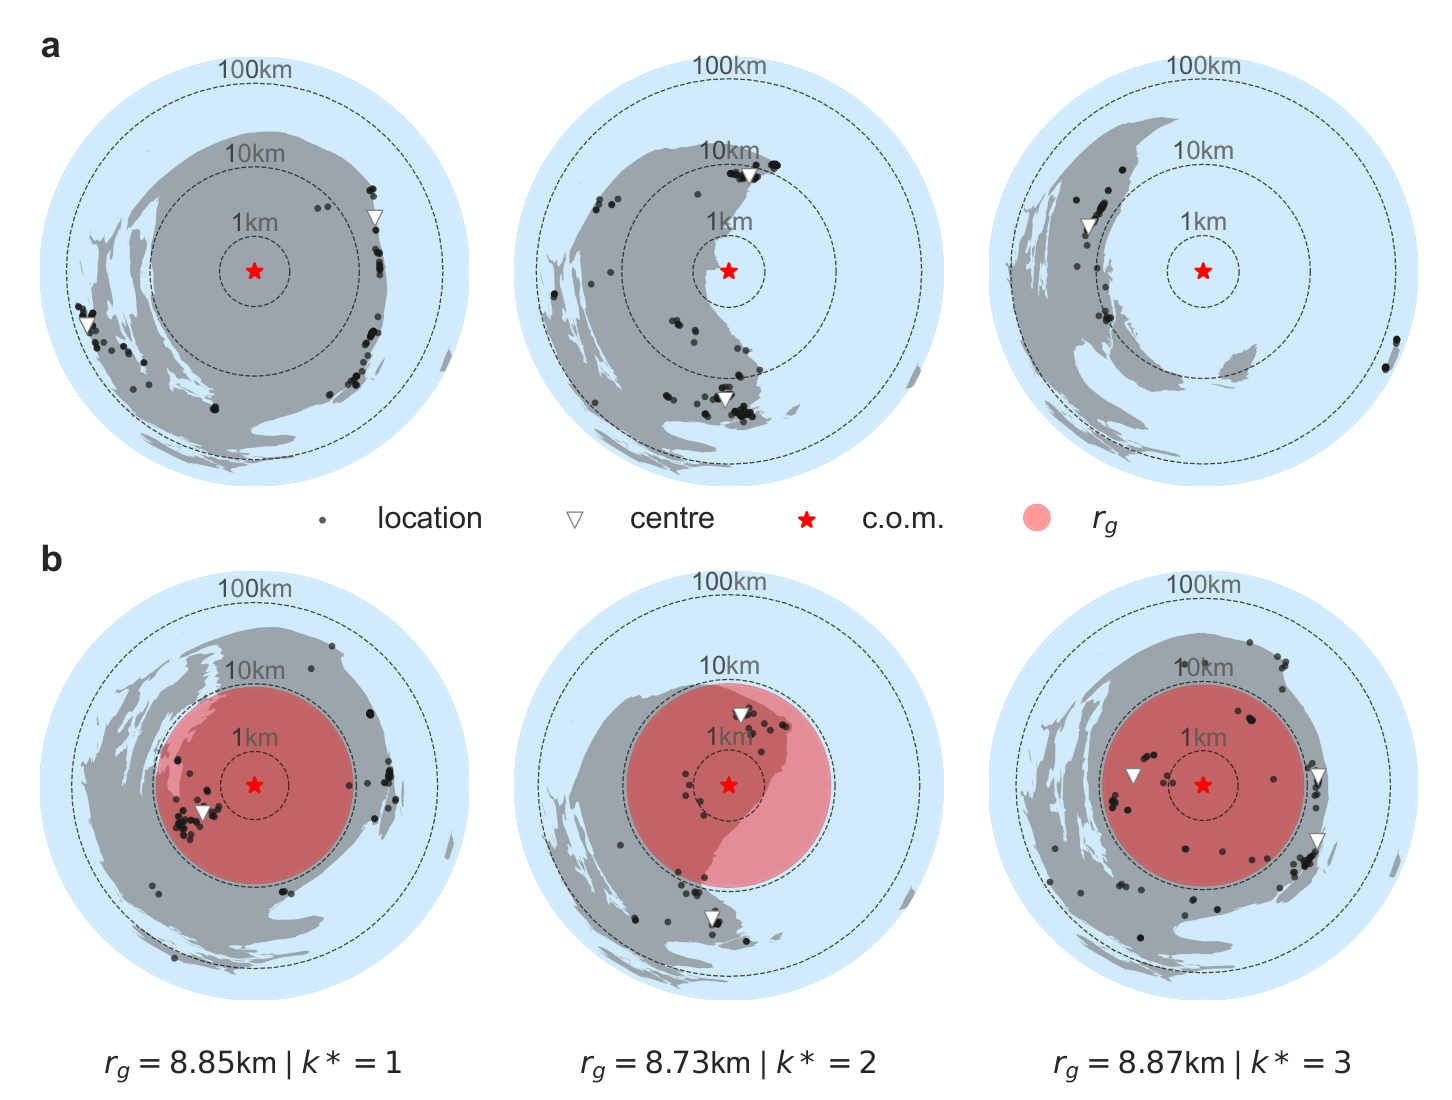
图1|相似的回转半径,是否代表相似的生活范围?
(a)三个个体的黑点为停留地点,红星是平均中心,白色三角为方法识别的中心;平均点可能偏离实际活动区。(b)三个个体的红圆对应接近的回转半径,中心数却不同,说明一个尺度无法辨别多片活动区。全部实例来自D1丹麦学生样本。来源:原论文 Fig.1。
多放几个中心,怎样避免只是把旅行点都圈进去?
把每个位置归给最近的中心,再计算位置到相应中心的加权距离,是一个自然推广。普通 k-means 通过反复分配位置、更新加权平均中心,寻找较小的加权平方距离。预印本的广义公式还写了平方根,它不改变这个量最小化时的解,但数值本身不应与未经开方的平方损失混为一谈。
普通平均仍可能被远处的少量停留牵引。作者采用截尾 k-means(trimmed k-means):每次更新一个中心时,只让靠近该中心、累计覆盖该簇90%停留权重的位置参与平均。这里保留的是时间权重的90%,不是简单保留90%的地点数;被截去的点也不等于已判定为定位错误。
算法重复初始化50次,降低初始中心选择的影响。截尾后,中心不再保证最小化原始全部点的平方损失,因此需要一个符合活动空间目标的新评分。
论文的覆盖评分(cover score)衡量:以同样的名义面积预算,中心附近能覆盖多少已观测停留时间?如果设置k个等半径圆,为与单中心比较,每个圆的最大半径为 r_g/√k,使圆面积的总和仍是 πr_g²。重叠圆按面积总和计预算,不能把它直接称作地图上去重后的土地面积。
从半径0开始一起扩大这些圆,纵轴记录圆内的停留时间比例,横轴记录已使用的面积预算比例。曲线越早升高,表示更多时间集中在中心附近;曲线下的面积就是覆盖评分。符合这一预算定义的横轴是 k r²/r_g²。预印本有一处面积公式漏写k,作者公开实现使用了这个因子,不能照漏项公式计算后仍期待终点为1。
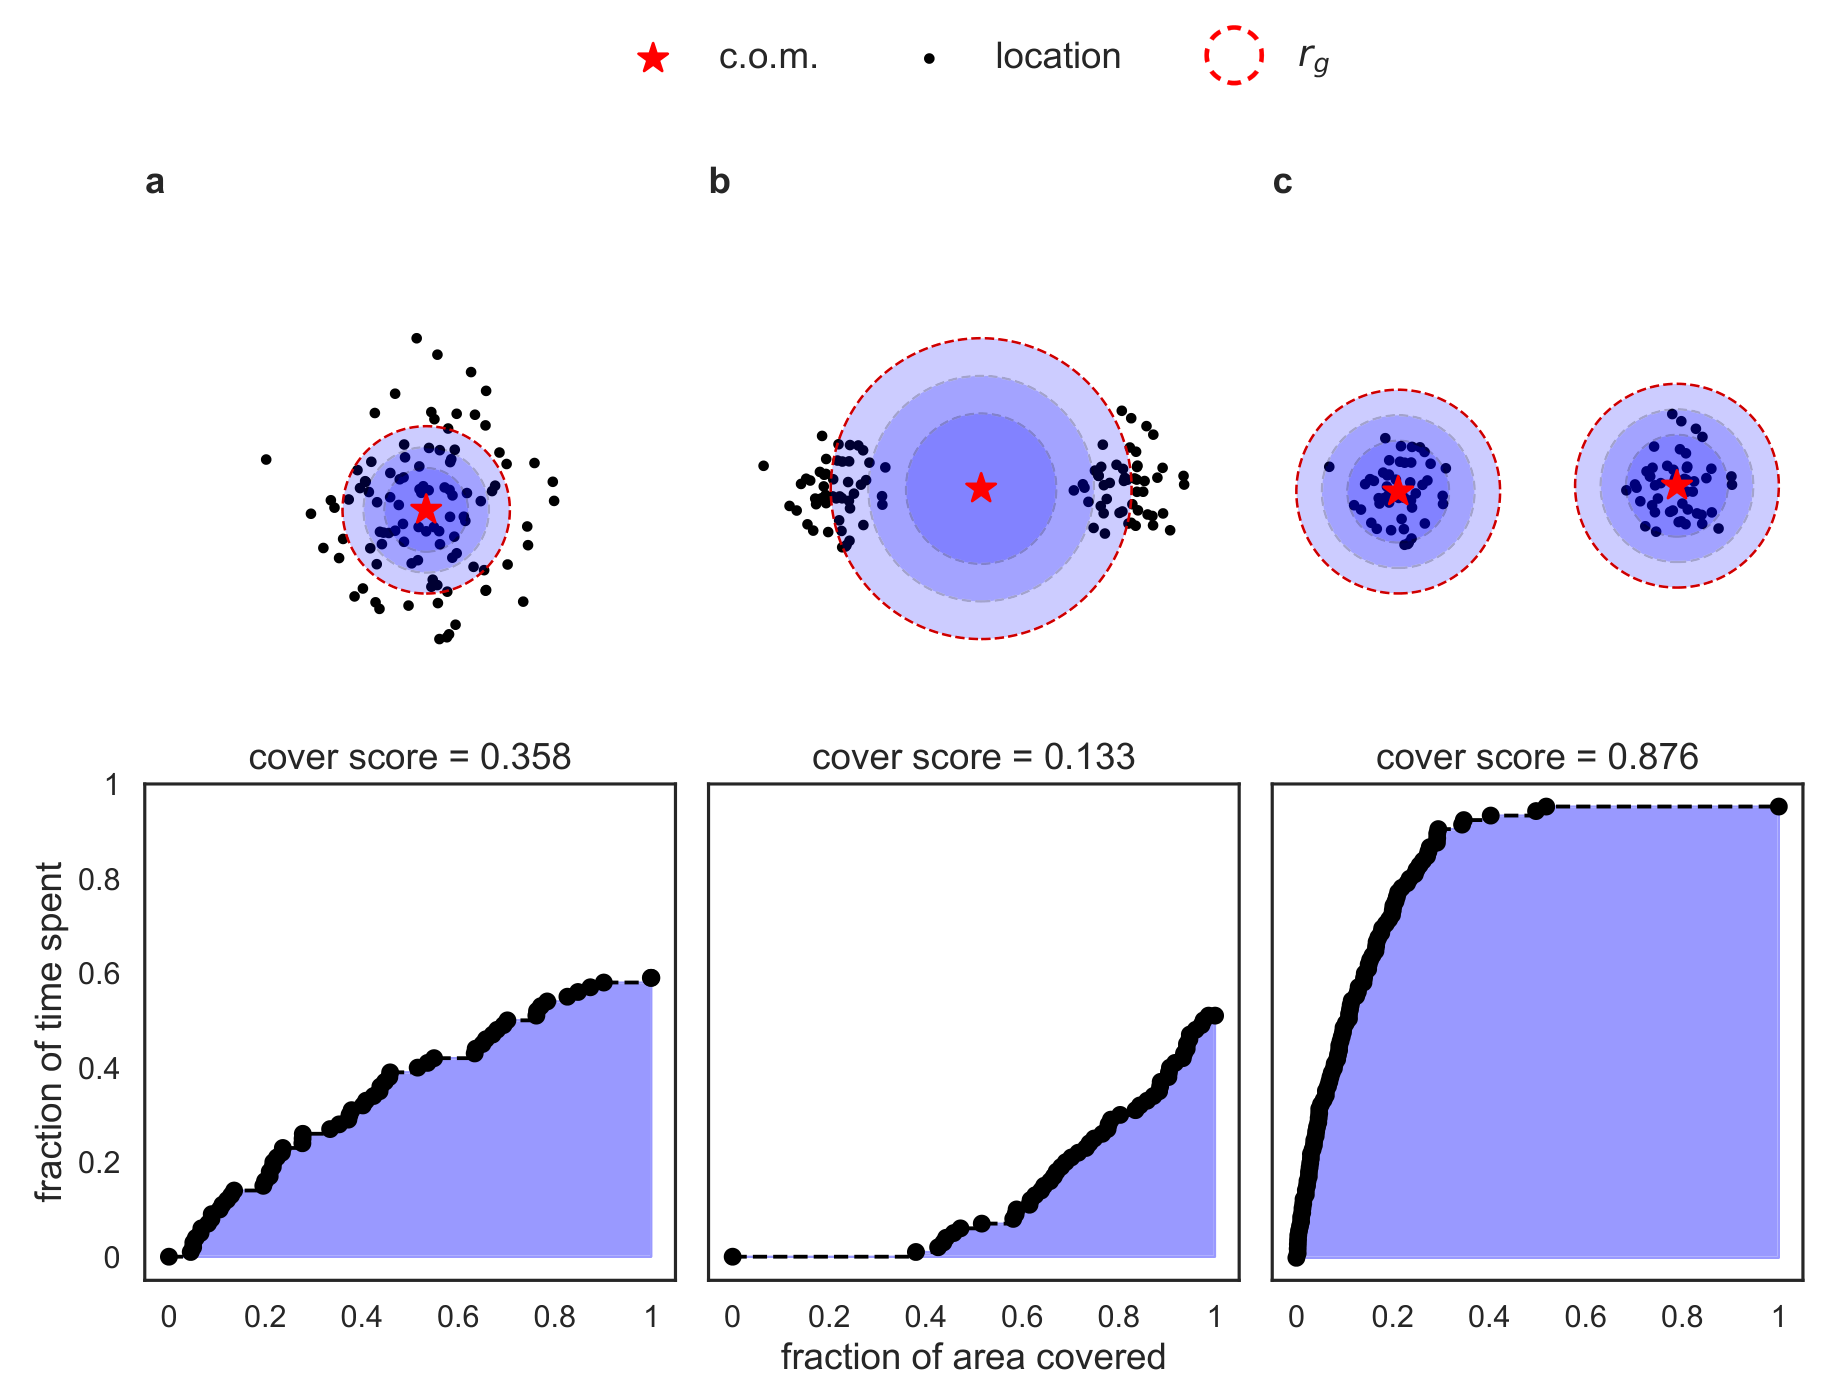
图2|多个圆比一个圆更好,应该怎样公平比较?
(a)单个高斯点云的单中心描述,覆盖评分0.358。(b)两个分开的点云仍只用一个中心,较大范围先圈住中间空白,评分仅0.133。(c)相同双峰数据用两个中心,按相同面积预算缩小每个圆,评分升至0.876。上排是点与逐渐扩大的圆,下排是覆盖时间比例对面积预算比例,蓝色面积为评分;这些是合成数据示例。来源:原论文 Fig.2。
中心越多评分越高,就一定应该选择更多吗?
复杂模型通常更容易贴合数据,所以不能只取最高分。研究以原始位置的边界框为范围,均匀随机生成100份参考位置集,同时保留原来的停留权重。每个候选k都有真实评分减参考平均评分的差值,即 gap;只有增加中心带来的差值超过较小k的最好结果,并留出参考分布一个标准差的余量,才接受这个更大的k。搜索的上限设为6。
这是一项相对随机位置基线的模型选择规则,不是中心数已被外部事实认证,也不是经过多重检验校正的普遍显著性结论。上限6意味着结果落在6的人,不能被解释成绝不可能需要更多中心。
补充材料还提醒,覆盖评分不保证随k单调增加。新中心若放在停留很少的区域,会分走其他圆的面积预算,反而可能降低覆盖表现。因此,更多中心、更多地点和更大的活动范围,不能当作同一个概念。
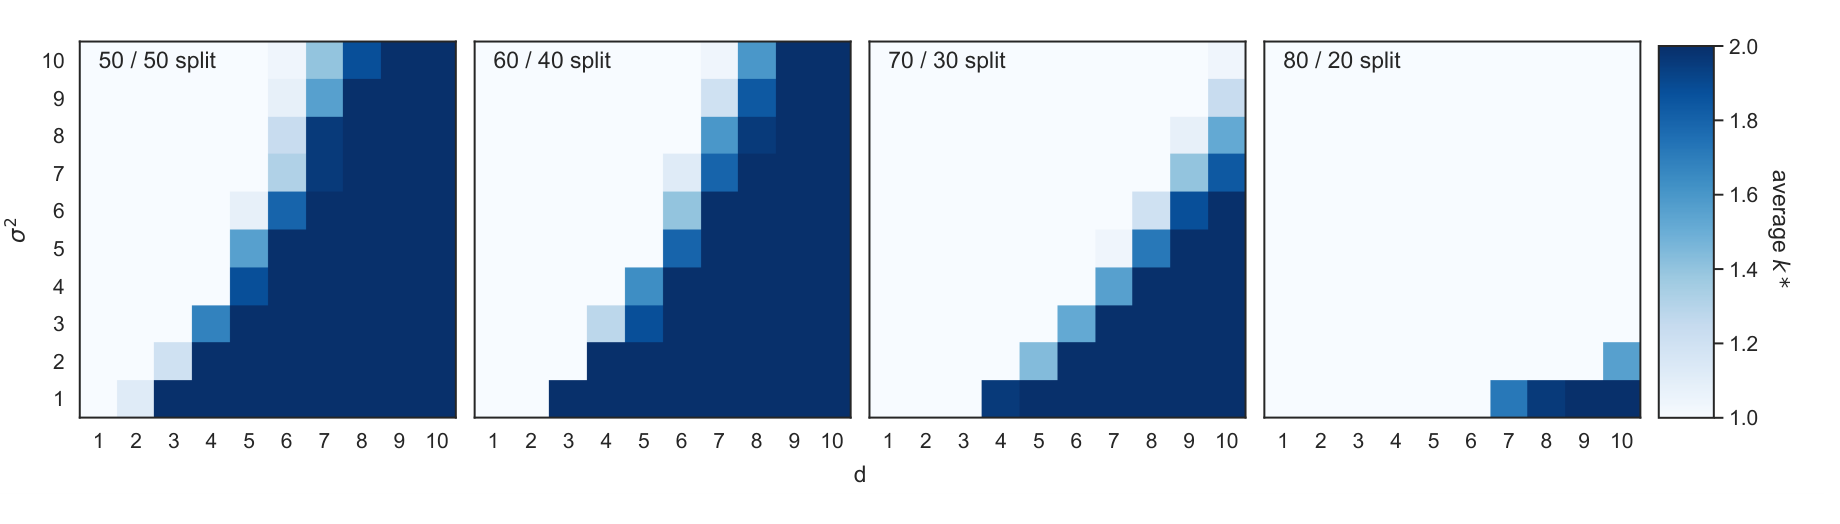
补图S4|两个真实点云,什么时候能识别成两个中心?
四幅从左到右分别给两个高斯点云分配50/50、60/40、70/30、80/20个位置。横轴为中心间距d,纵轴为每个高斯沿坐标轴的方差σ²;颜色为25次随机生成结果的平均识别中心数。距离大、簇内更紧时更容易识别两个中心,权重越不平衡越可能只保留一个。少数活动区被忽略可能符合稳健性的目标,也可能遗漏有实际意义的次要生活锚点。来源:原论文补充 Fig.S4。
两个样本具体保留了谁的移动?
D1原始实验在2013—2015年对851名丹麦技术大学学生每5分钟采集GPS,年龄通常19—21岁。此次分析只取2014年1—5月151天,并限定在Sjælland和Hovedstaden两个行政区域,排除长达7天及以上的停留记录后,保留在目标区域累计已知停留时间超过68天的566人。68天是累计覆盖时间,不是连续68天完全没有缺测。
D2来自一家全球智能手机及电子产品公司的应用位置记录,采集于2017—2019年。分析选取日本、英国和德国用户,要求平均每日位置覆盖超过75%,每人使用最初180天,最终有48,534人,其中日本35,608、英国7,029、德国5,897。两个样本合计49,100人;它们不是同一年、同样招募方式的可直接对照群体。
两组数据都先用 Infostop 检测停留,参数为空间尺度30米、最短10分钟;地点权重以已记录停留时间归一化。短暂路过、途中活动和未被记录时段不会自动变成完整活动范围。D1的区域截取也会影响中心数,不能把丹麦学生与D2之间的差别全归因于国家生活方式。
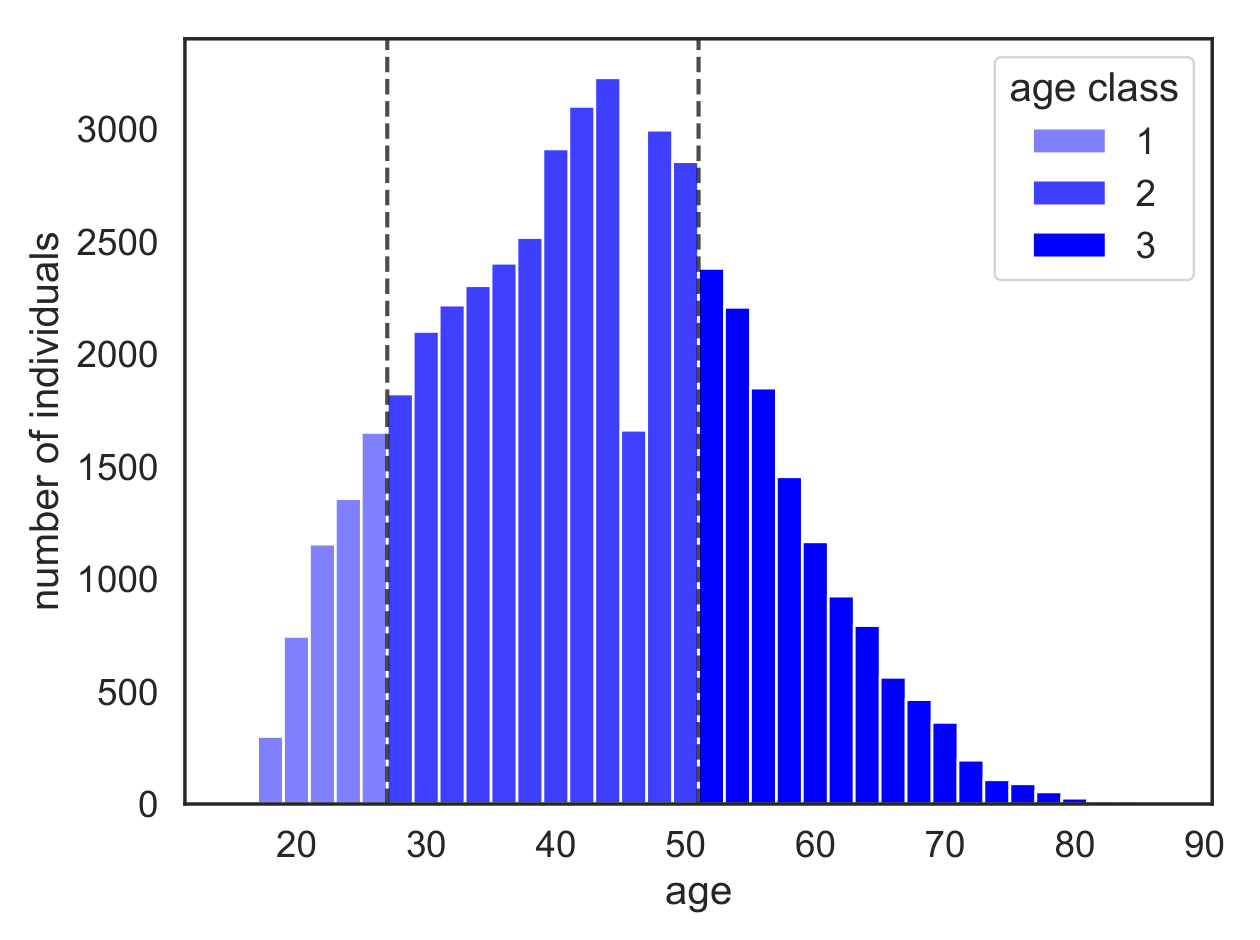
补图S1|多中心比例描述的是怎样的年龄样本?
横轴为年龄,纵轴为用户数,颜色将样本分为18—26、27—50与51岁以上三档。中年用户较多,人数分布不是三国居民的人口普查权重。补表S1、S2还显示D2中男性30,558人、女性17,976人,城市地区35,281人,乡镇与农村合计13,253人。来源:原论文补充 Fig.S1及Tables S1—S2。
原始轨迹因隐私限制不公开。预印本的数据可用性段落对衍生数据仍留有待发表标识,不能把它当作已提供可下载完整数据集的承诺;论文公开了算法代码。
实际用户中,有多少人需要多中心?
D1的566人中,324人被识别为单中心;187、43、12人分别需要2、3、4个中心,共242人、42.8%为多中心。D2的48,534人中,单中心37,706人,2至6个中心依次为8,634、1,206、555、287、146人,多中心共10,828人、22.3%。这些比例来自补表S3,依赖前面的筛选、地点检测和模型选择规则。
在D2中,截尾中心的覆盖评分严格高于普通k-means者有43,921人,占90.5%;只看10,828名多中心者,有8,516人、78.6%出现这种改善。这说明稳健中心在论文定义的覆盖目标下常有优势,不意味着每名用户的中心都更接近经过实地标注的家或工作地。
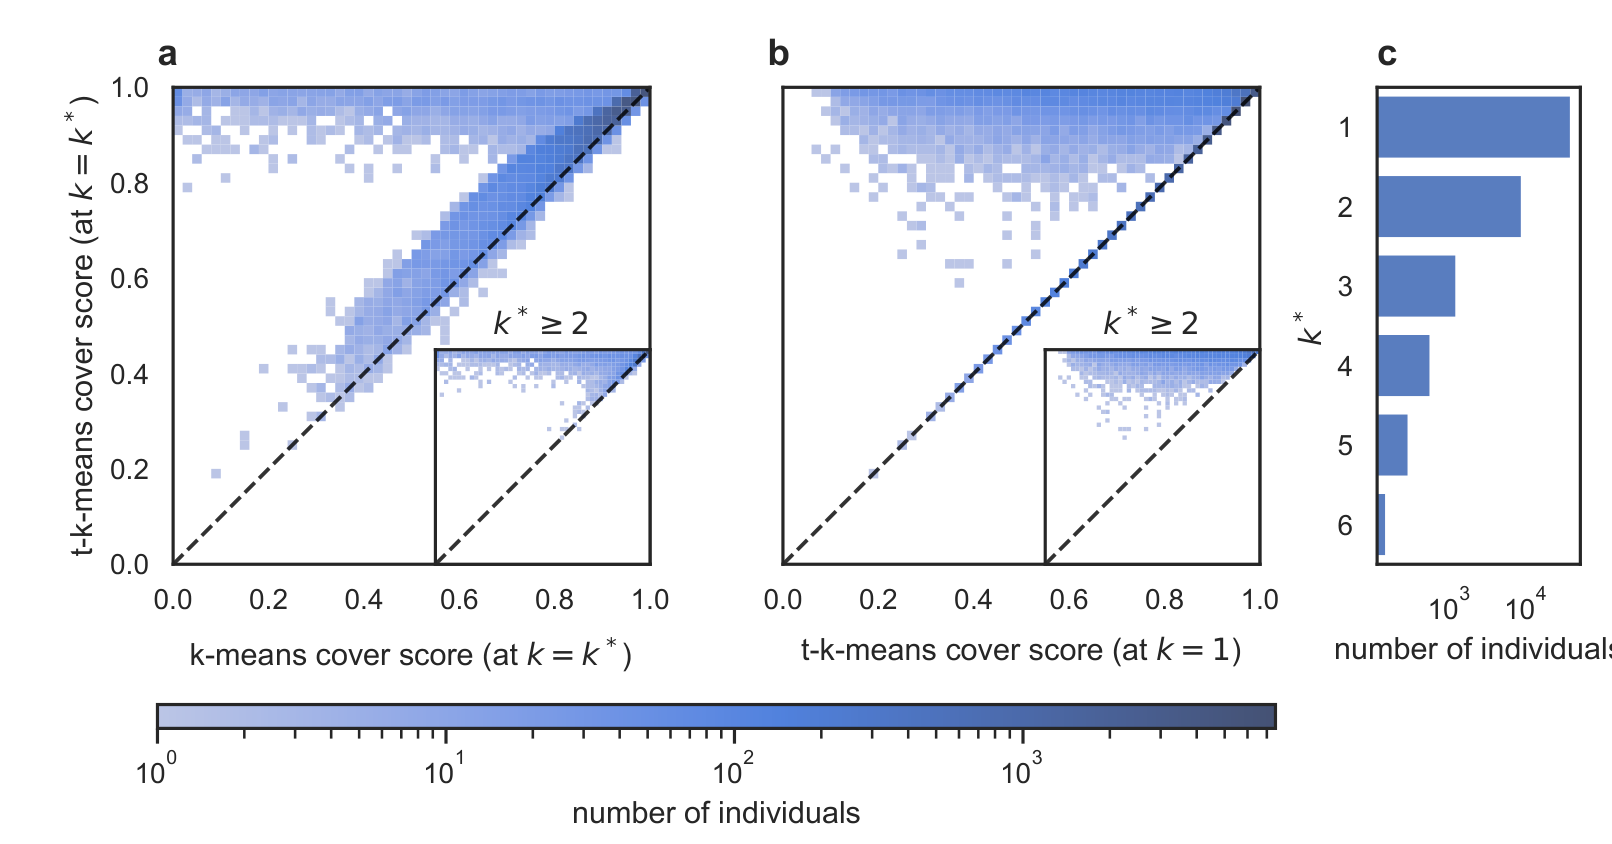
图3|在真实数据里,多中心描述改善了什么?
(a)横轴普通k-means、纵轴截尾k-means的覆盖评分,均使用选定k;对角线上方表示截尾法评分更高,插图只看多中心用户。(b)横轴截尾单中心、纵轴可变中心数描述的评分,比较多中心带来的覆盖改善,插图仍为多中心用户。(c)最优中心数的用户人数分布,显示多数仍为单中心。颜色条表示二维格中的人数,横向人数轴有对数刻度。来源:原论文 Fig.3,D2。
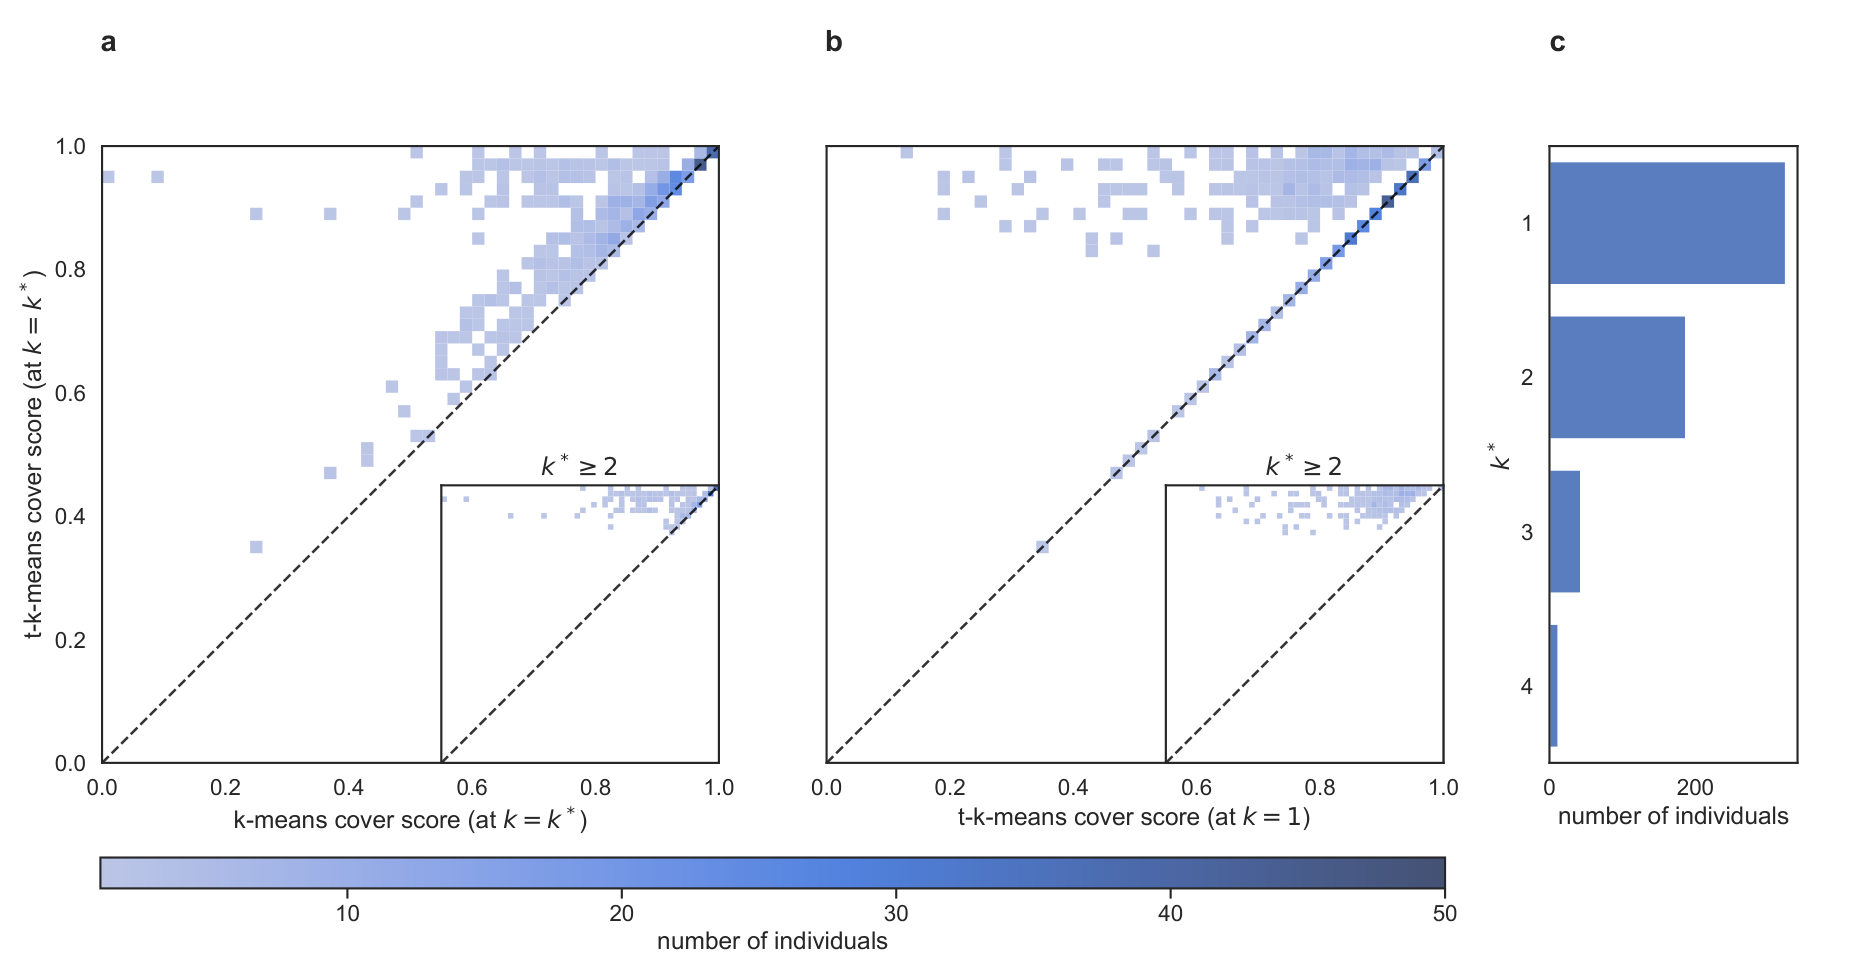
补图S2|学生样本中是否也能观察到评分改善?
(a)截尾法与普通k-means的覆盖评分对比。(b)可变中心数与截尾单中心的评分对比。(c)中心数人数分布,范围1—4。前两个面板均保留只看多中心者的插图;它们支持方法在D1也有相近表现,但两个样本并非同一人群的重复实验。来源:原论文补充 Fig.S2。
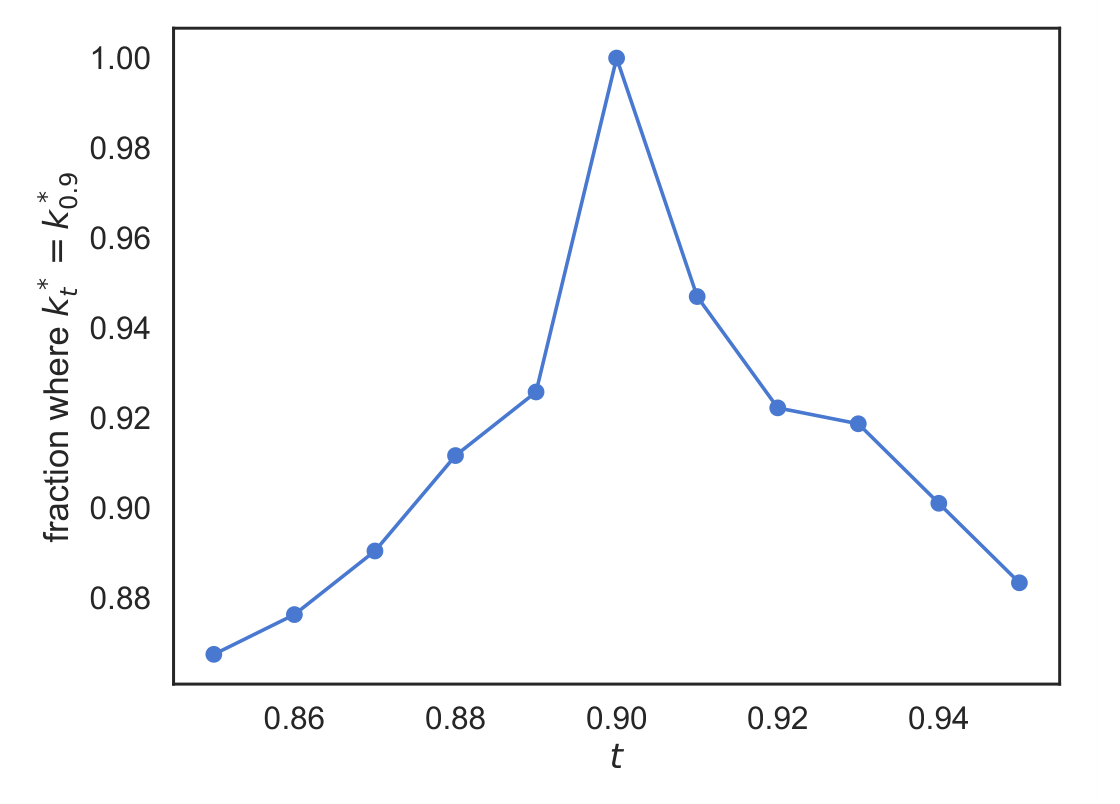
补图S3|把保留的停留权重稍作调整,会改变多少人的中心数?
横轴为截尾保留比例t,纵轴为D1中结果与t=0.9时中心数一致的用户比例。t从0.85到0.95变化时,大部分用户保持一致,但两端仍约有一成多人改变;中心标签并非完全不受参数影响。来源:原论文补充 Fig.S3。
留出一部分位置后,多中心还成立吗?
只在训练记录上覆盖得好,可能只是模型记住了散点。论文用D1给每个人随机划分80%记录训练、20%测试,并重复20次:单中心预测用一个对称二维高斯,可变中心模型用多个高斯的混合,分量权重是该中心对应的停留时间比例,各分量方差设为 r_g²/k。
测试比较的是留下来的位置在模型下有多大概率,即对数似然,不是下一站猜对率,更不是未来疫情预测表现。242名多中心用户中,230人可变中心模型显著更好,1人传统模型更好,11人差别不显著;324名单中心用户中,只有1人传统模型显著更好,其余323人无显著差别。显著性门槛是Welch检验p<0.01。
训练和测试的拟合差别只有37/566人达到该门槛,其中25人训练较好、12人测试较好。多数没有显著差异,是对随机留出表现的一项支持,不能证明不存在任何过拟合。更关键的是,中心数k预先在全量记录上选定,然后才用于训练集拟合;部分模型选择信息已经用到测试数据。随机记录切分也不能模拟生活习惯随时间改变之后的未来外推。
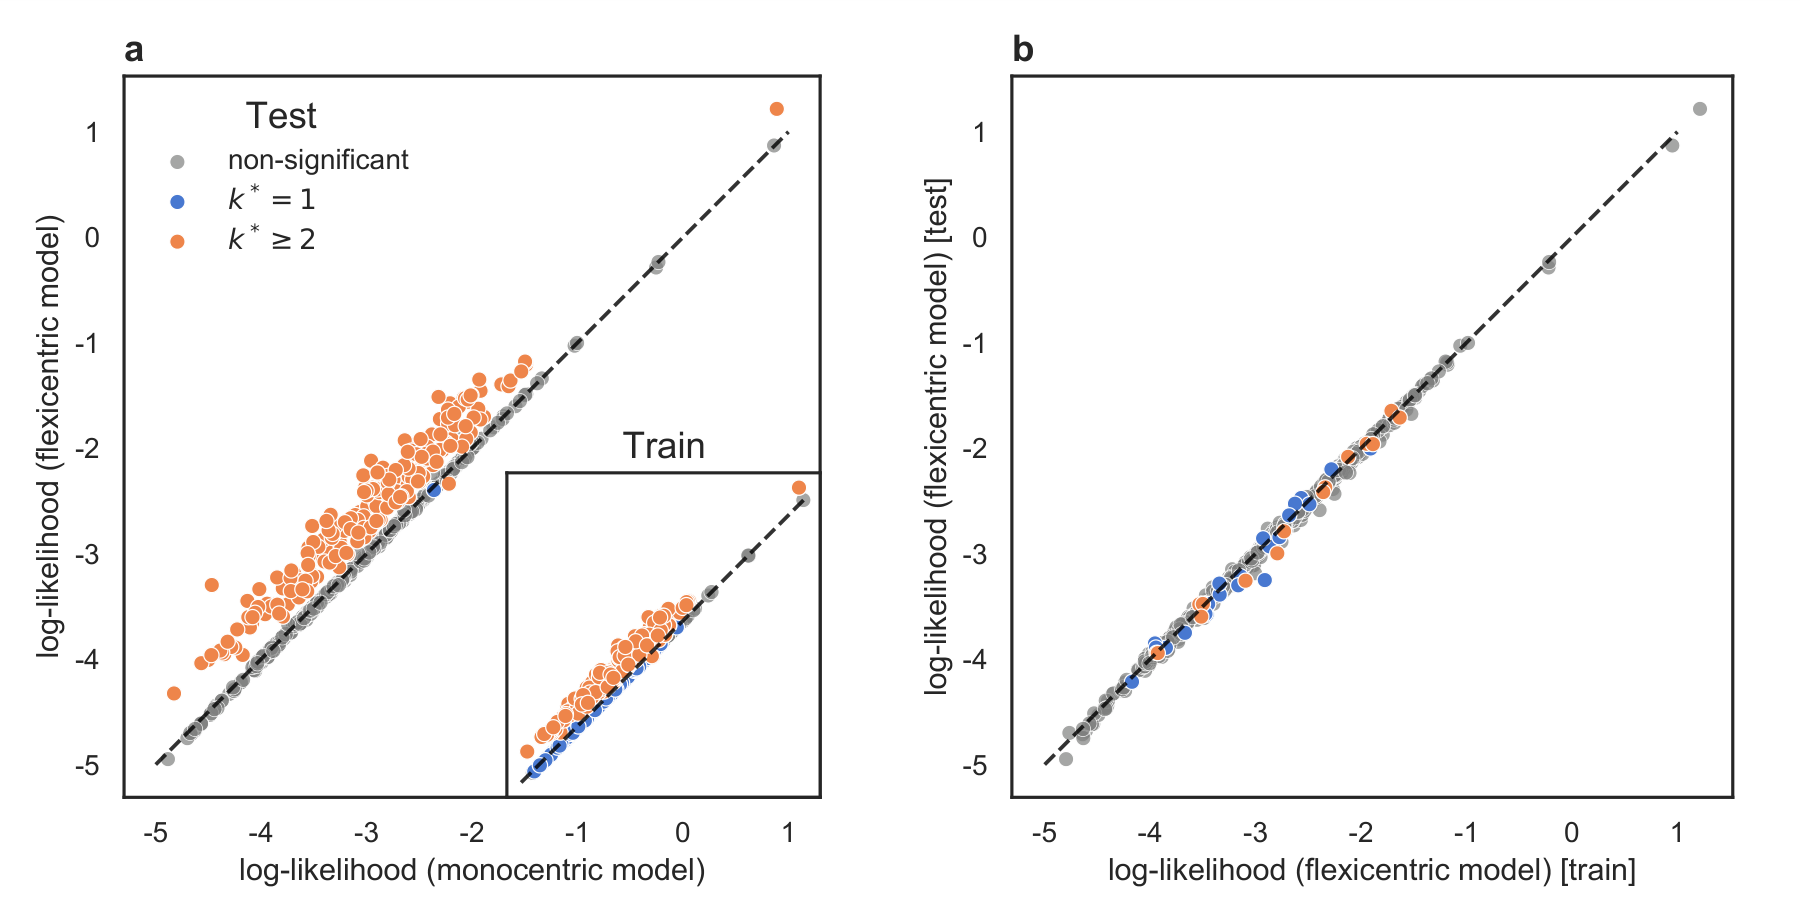
图4|更复杂的空间描述,能否解释未用于拟合中心的位置?
(a)横轴传统单中心、纵轴可变中心模型的对数似然,主图为测试集、插图为训练集;橙色是显著差异的多中心用户,蓝色为单中心,灰色不显著。(b)同一可变中心模型的测试与训练对数似然,接近对角线说明两者接近。这项验证仍受全量数据选k与随机切分的限制。来源:原论文 Fig.4。
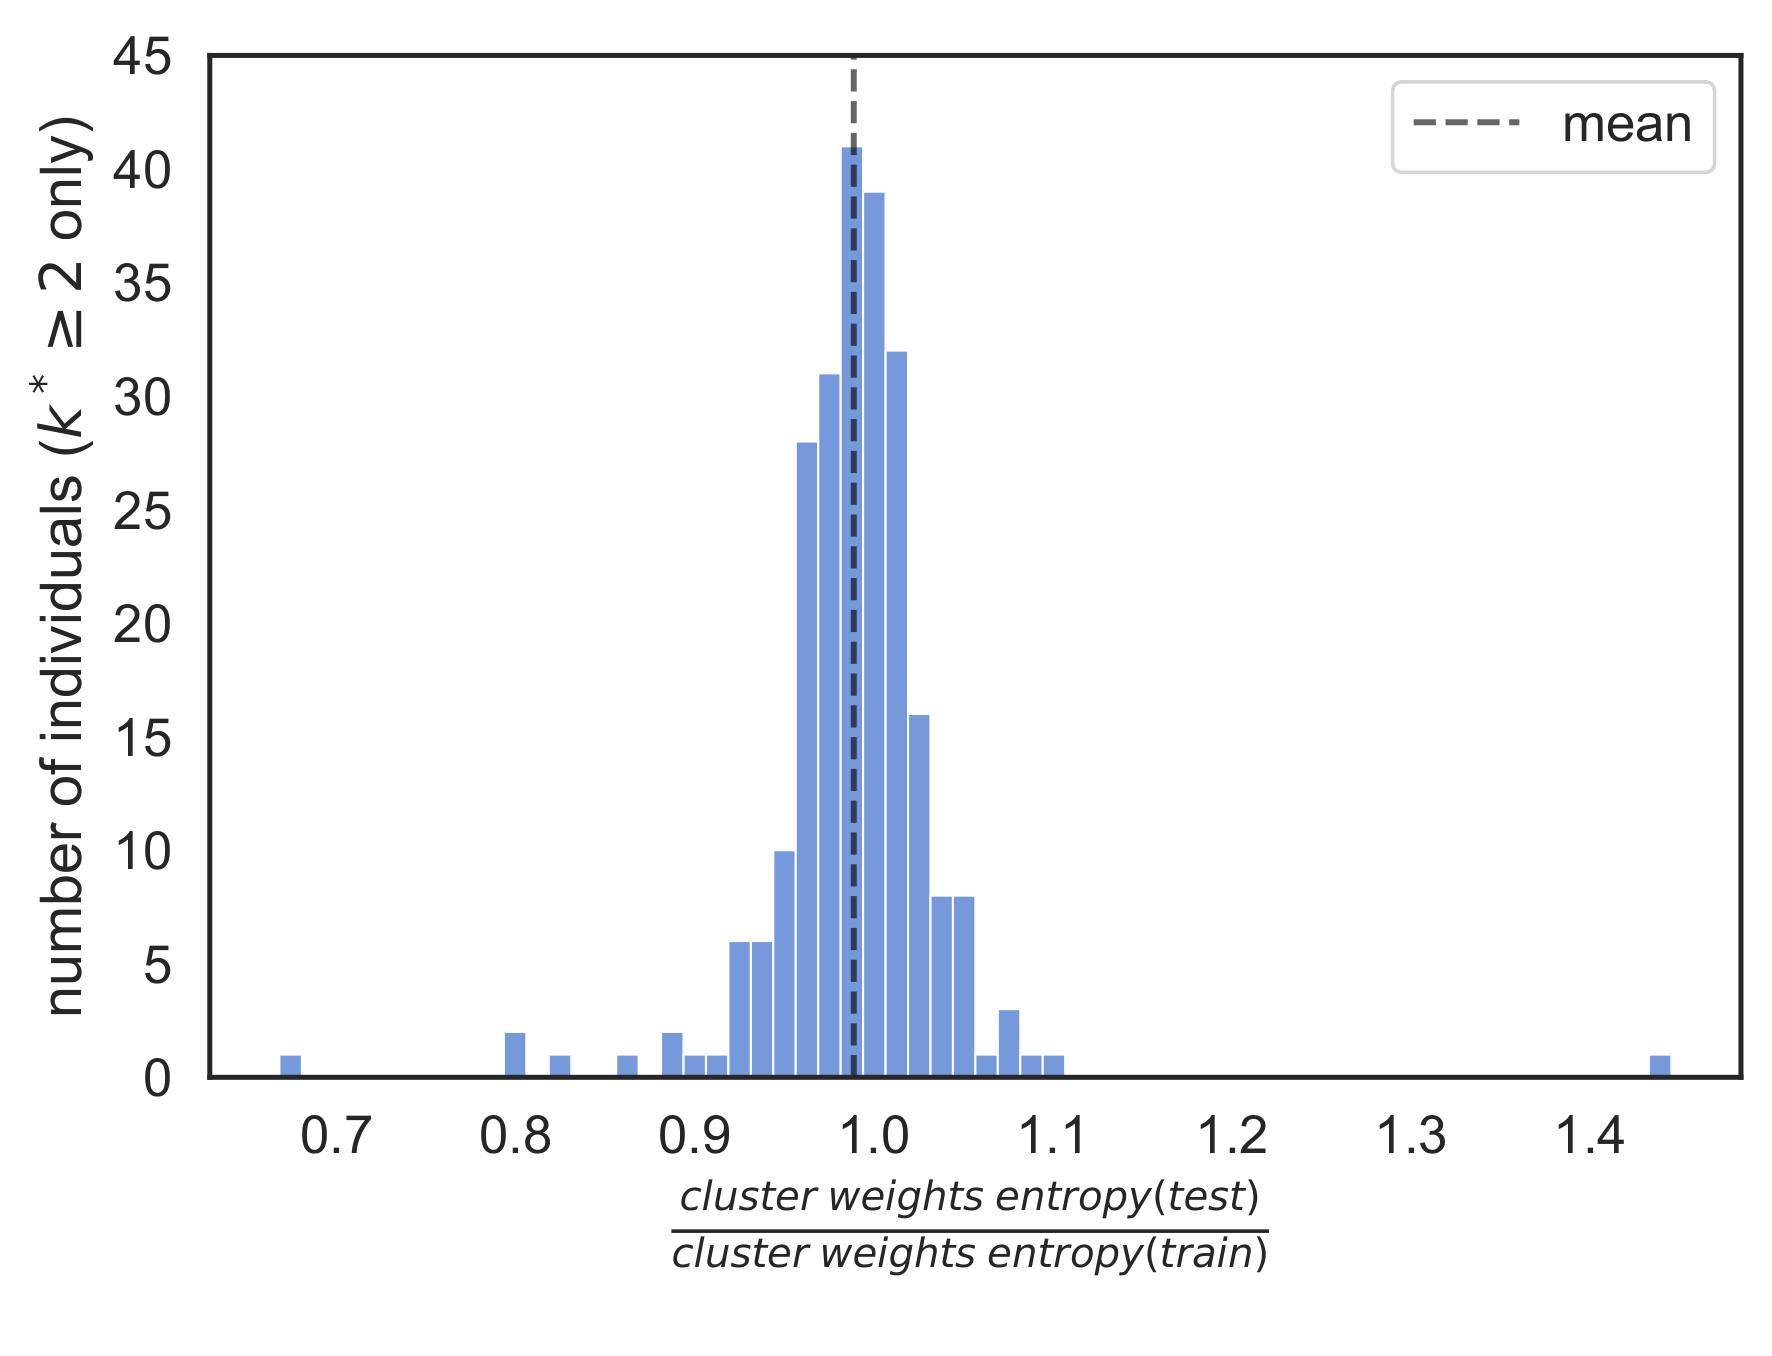
补图S5|不同中心之间的时间分配,在训练与测试记录中相近吗?
横轴是测试与训练的中心权重香农熵之比,纵轴为多中心用户数,分布主要靠近1,论文报告平均0.99±0.05。它衡量时间在各中心之间的分配是否相似,不是中心位置的准确率,也不能替代完全留出的时间段验证。来源:原论文补充 Fig.S5。
性别差别是否意味着某类人天生更喜欢多中心生活?
D2中男性多中心比例为24.2%、女性为19.1%,相差5.1个百分点;三国分别比较时,男性比例也更高。可是,这只描述选择进入应用样本并满足覆盖条件的人。工作安排、照护责任、职业和家庭结构都可能同时影响中心数,不能把相关性直接写成人的固有偏好。
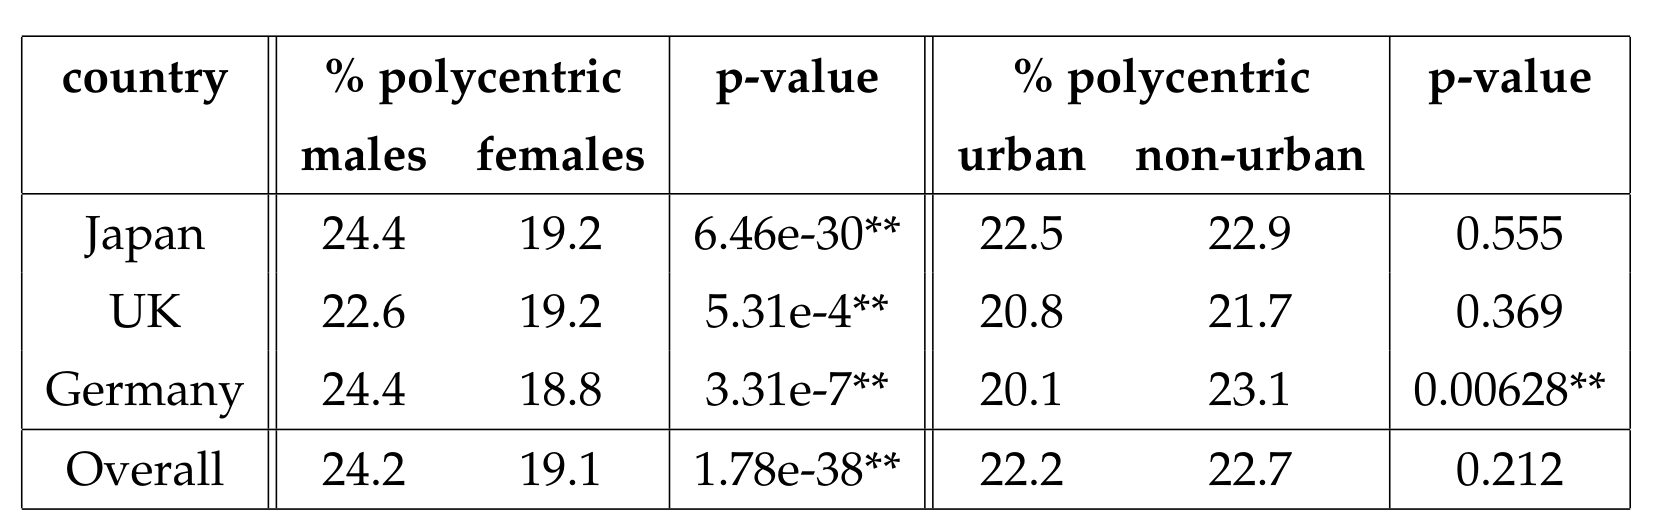
表1|性别差别与居住地区差别,是同一种结果吗?
左半表比较三国及总体的男女多中心比例,Fisher精确检验在p<0.01标准下均显著。右半表比较城市与非城市:总体22.2%与22.7%,p=0.212;德国20.1%与23.1%、p=0.00628却有显著差异。因此不能将总体未显著简化为所有国家完全没有城市化关联。来源:原论文 Table 1。
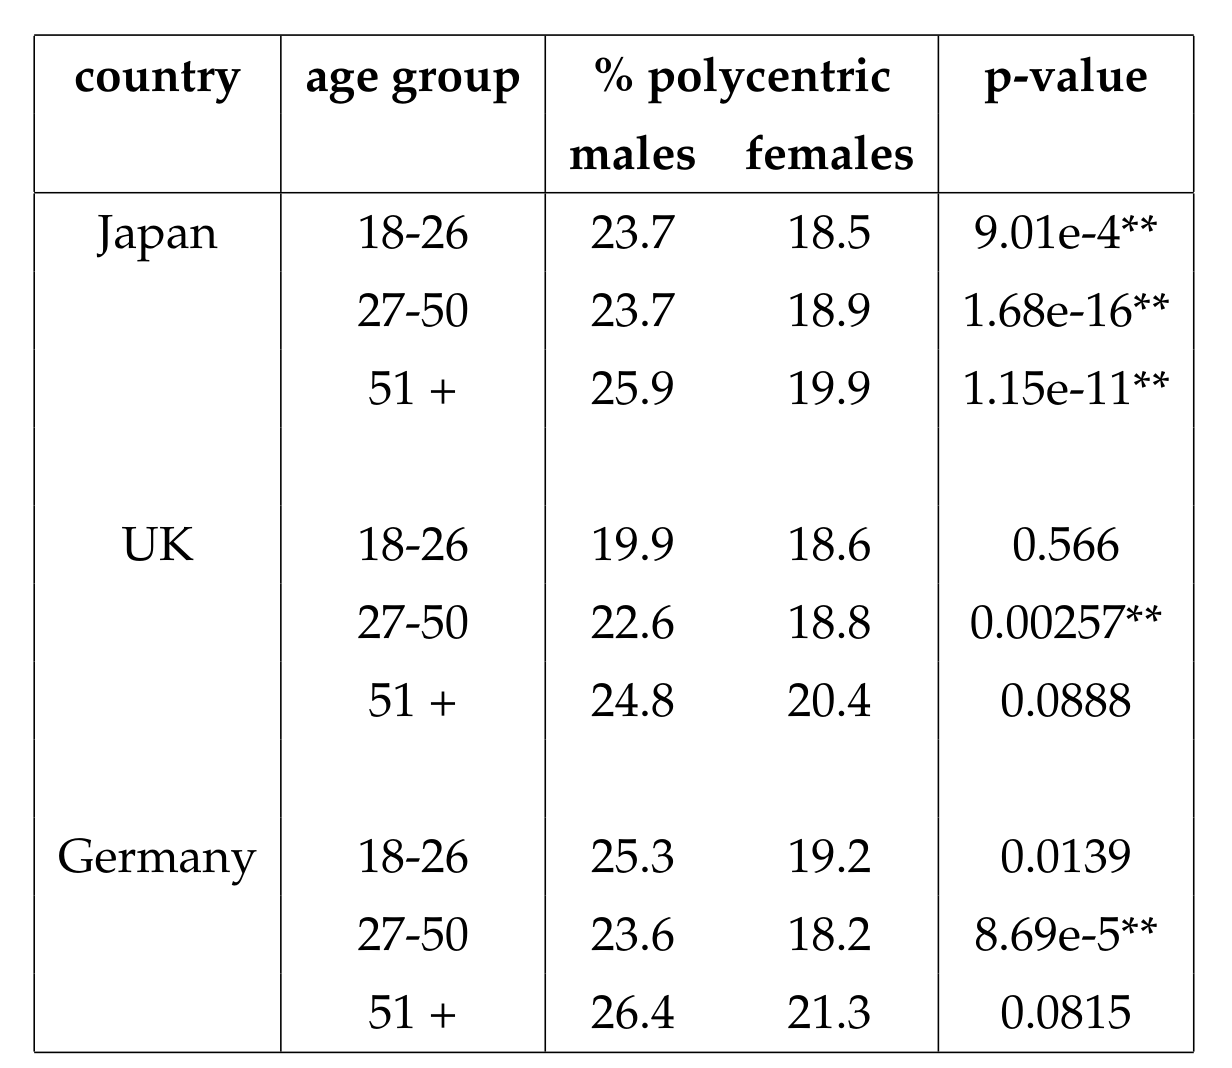
表2|按年龄分组,男女差别还存在吗?
每行给定国家与年龄组,比较男女多中心比例及p值。日本三组均达到论文的p<0.01门槛;英国和德国只有27—50岁组达到。德国年轻组p=0.0139没有达到本论文0.01门槛,不能换用0.05后仍声称沿用同一判据。来源:原论文 Table 2。
就业使工作地与住宅形成两个中心,是作者提出的可能解释。但当前分层没有直接控制就业或照护,也没有证明男女差别由它们造成。总体城市化差别未显著,同样不等于两种环境的活动空间完全一致;中心数之外,还有中心间距、停留权重和通达条件等多个维度。
一句话总结
一个平均点与一个回转半径能够概括总体分散程度,而识别多个活动中心可以进一步区分几片生活区域;这种更丰富的描述仍需要与真实地点身份、未来预测和因果解释分开验证。
核心来源
- Sahasrabuddhe R., Lambiotte R., Alessandretti L. (2021). From centre to centres: polycentric structures in individual mobility,arXiv:2108.08113v1,预印本。本文依据该版本正文、方法及随文补充材料;全部主图与两张正文表保留完整结构。
- 作者公开的算法实现,用于核对覆盖评分的面积归一化。代码和文稿的默认重复数量存在区别,使用时应固定版本,不能把当前仓库视为论文全部实验的自动复现。
作者介绍
Rohit Sahasrabuddhe 在本文署名为印度浦那印度科学教育与研究学院作者;贡献声明记载其执行分析与代码实现。
Renaud Lambiotte 署名为英国牛津大学数学研究所与伦敦Turing Institute作者。Laura Alessandretti 署名为丹麦技术大学作者,是通讯作者。三人共同设计研究、分析结果并写作;以上按预印本署名介绍。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一个总是往返两片生活区的人,与在同一片生活区内四处活动的人,即使回转半径相同,对交通服务的需求也可能不同。前者或许更需要可靠的中心间连接,后者更需要中心周围的短距离通达。要把这种直觉变成规划依据,还应把中心位置与路线、出行时间和活动目的结合,不能只凭中心数决定建设什么交通设施。
截尾也带来一个值得反问的问题:少量但必要的就医、照护或跨城探亲,可能恰好是被稳健算法弱化的活动。若研究目标是概括日常规律,这样做有价值;若目标是衡量一个人能否获得关键服务,被弱化的那部分反而不能忽略。中心表示需要随应用问题解释,而不是永远追求对低频活动最不敏感。
更严格的验证可以先用早期月份独立确定中心数量和位置,再完全留出之后的月份,比较地点密度、交通需求与生活变化。一个人在换工作、搬家或承担新照护责任后中心怎样出现与消失,可能比静态地贴上单中心或多中心标签更有解释力。

