手机知道你在哪里,为什么还猜不准下一站?
论文名片|Trinh Minh Tri Do、Daniel Gatica-Perez,Contextual Conditional Models for Smartphone-based Human Mobility Prediction,UbiComp 2012,163—172页。DOI:10.1145/2370216.2370242,作者机构公开全文。
下班离开办公室,手机可能猜你回家;周五同一时刻,你却去吃饭。午后到了某个地方,停半小时还是待一下午,又取决于地点、时间和个人习惯。知道得越多,按理应当猜得越准,但这篇论文发现:直接把所有情境变量一起用,反而可能降低预测质量。
原因很现实。一个人可能常去办公室,却很少在“周五、下午三点、办公室、某种访问频率”的完整组合下离开。情境描述越细,同类历史越少。论文的办法是让多个简单模型分别学习一部分规律,再把它们的概率判断组合起来。
先说结论
- 153人参加17个月采集活动,但个人贡献平均约一年、范围3—17个月。质量筛选后,下一地点任务使用约30,000次可信转移,停留时长任务使用约41,000次可信访问。
- 下一地点平均准确率从基线41.1%提高到64.0%;最好的单模型“地点+时刻”为60.4%,全部情境直接联合约52.0%。64%针对这批筛选记录,不是所有人的全部出行。
- 时长预测的平均相对误差降至0.355,好于最优一般+个人单模型0.376,也好于直接平均多个模型输出的0.375。相对误差不能换成“64.5%准确率”。
- 数据缺失、地点提取和观测数量决定了能预测什么;“记录了更久”和“积累了更多有效历史”并不完全相同。
预测之前,先决定什么算一次访问
从2009年10月起,研究者在一个未具名欧洲国家向参与者配发Nokia N95。GPS与WiFi估计位置,其他传感与日志记录情境,并按活动状态动态调整采样以节电。它比只靠基站更细,但现实里手机会没电、关闭记录或缺少定位。
只有约74%的用户日有至少一条位置记录;这些活跃日中,也只有约62%的10分钟时段有位置点。这已经说明,采集17个月不等于获得每个人连续完整的17个月轨迹。
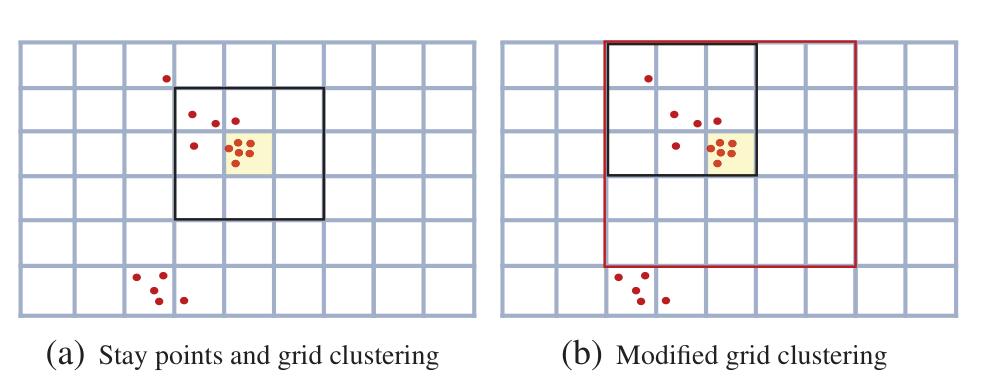
图 1|坐标相近的停留,怎样合并为同一个地点?
(a)原网格聚类以高密度单元为中心放置区域,可能漏掉边缘点;(b)改进方法在候选区域中选择覆盖更多停留点的方案。图示用3×3单元解释,实际采用50米单元、5×5组合,形成约250×250米的停留区域。来源:原论文 Fig. 1。
作者把至少停留20分钟的区段识别为访问,地点用符号ID表示,移动中的位置可标为空。这个任务不包含所有短暂停靠,也不要求预测精确经纬度。去过同一个符号地点的多次访问构成学习历史。
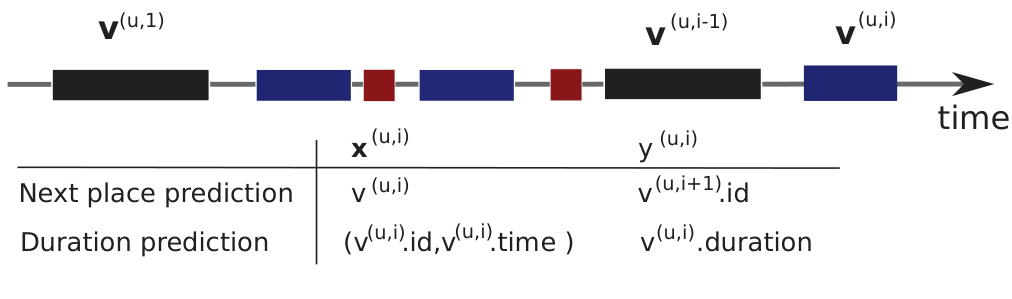
图 2|猜下一站,与猜待多久,需要的信息一样吗?
完整时间轴无字母面板,颜色表示地点ID,图下分别列下一地点与停留时长的输入和输出。下一站任务在离开当前地点时使用可知情境;时长任务以到达时的情境预测本次停留,不能借用尚未知晓的离开时间。来源:原论文 Fig. 2。
下一站可以是曾访问过的地点,也可以是NewPlace类别;这个类别表示某个新地点,并不告诉你新地点具体在哪里。时长任务若使用到达后前10分钟的蓝牙和通话信息,预测就要延迟10分钟,不能称为到门口立刻完成的预判。
数据越丰富,为什么单个模型反而变差?
情境包括当前地点、时刻、星期、工作日/周末、到访频率和该地点平均停留类别。时长任务还加入最初10分钟附近蓝牙设备数量,以及是否打电话或发短信。不同变量的作用并不相同,更多变量组合也需要更多重复样本。
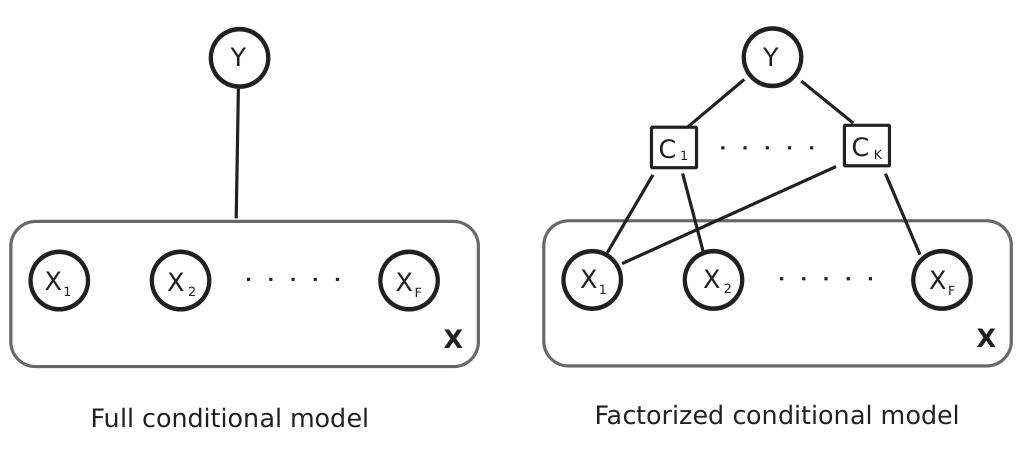
图 3|让一个模型记住全部情境,还是让多个模型各管一部分?
左侧完整条件模型同时使用全部输入,右侧把输入拆成不同子集,各自产生对结果Y的判断;原图未标a/b字母。子集允许重叠,不要求它们互相独立。来源:原论文 Fig. 3。
论文用归一化的概率乘积组合这些判断:每个模型的分布按学习到的权重参与,而不是直接平均“回家”“去商店”这些最终答案。也可以理解为把各模型的对数概率加权相加。共享权重从其他用户资料学习,具体个人模型则只用该用户此前的访问更新。
对下一站,作者比较等权历史计数与偏重近期的估计。近期权重按同类情境发生的倒序次数1/j衰减,不是简单规定只记最近几天。平滑避免稀少样本把某个候选概率直接压为零,近期加权则允许搬家、换工作等习惯变化逐渐进入模型。
可信记录怎样筛,64%又是怎样算的?
可信转移要求从离开上一地点到到达下一地点之间,每10分钟有位置记录,减少漏掉中间长停留的风险;可信访问要求到达前和离开后各15分钟附近有记录,用来确认起止。WiFi异常和定位误差仍可能存在,筛选并非绝对真值认证。
处理后约98,000次访问,平均每个活跃用户日2.5次;筛选后每人每天只有约0.6次可信转移、0.8次可信访问。经常缺记录的人、短暂停靠和少去地点,可能被更强地排除。因此,结果评估的是可观察且通过筛选的行为子集。
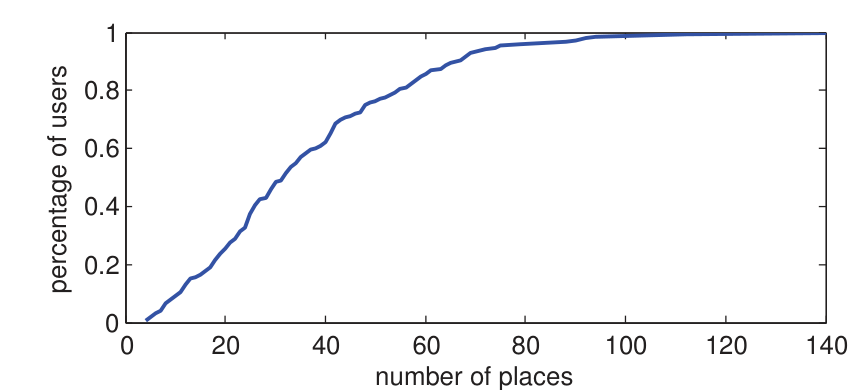
图 5|学习空间有多大,是否每个人都一样?
整图无字母面板,横轴发现的地点数量,纵轴用户累计比例。每人平均约37个地点,许多人在20—80之间;不能把平均值当成每个人固定的候选数。来源:原论文 Fig. 5。
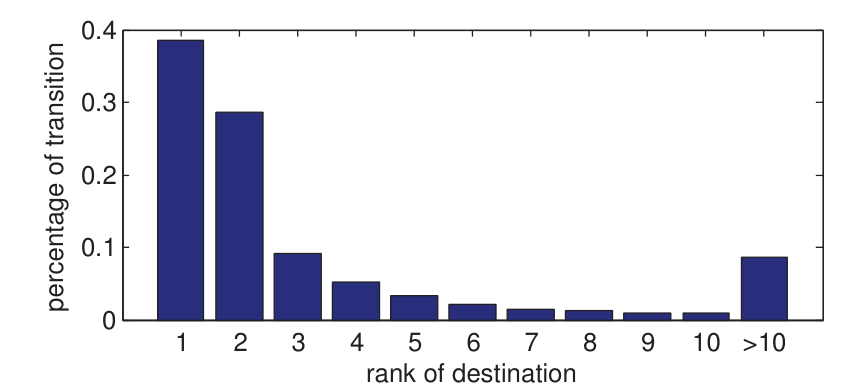
图 6|反复去的少数地点,能解释全部转移吗?
整图无字母面板,横轴按访问频率排列的目的地名次,纵轴可信转移比例。前几名占大部分,但前十之外仍约有10%。少数高频地点易学,不代表偶发目的地可以忽略。来源:原论文 Fig. 6。
评估采用留一用户:组合权重用其余152人学习,目标用户的个人模型按历史逐步更新,每次预测未来记录。基线通常猜截至当时最常去的地点;若与当前地点相同,则猜第二常去地点。
| 下一地点方法 | 平均准确率 |
|---|---|
| 基线 | 41.1% |
| 地点,近期加权 | 59.0% |
| 地点+时刻,近期加权 | 60.4% |
| 全部情境联合 | 52.0% |
| 多模型概率组合 | 64.0% |
组合比最优单模型提高3.6个百分点,比基线提高22.9个百分点。这是不同参照下的差异,不能把它混写成统一的“提升百分之多少”。
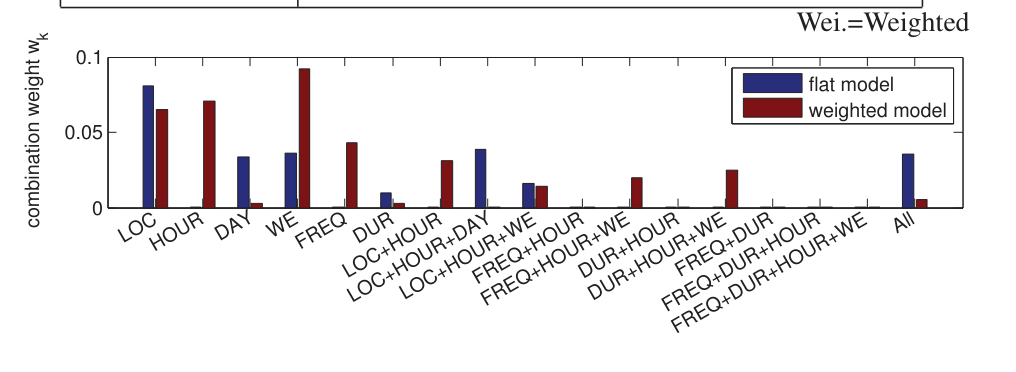
图 7|哪些简单规律参与了最终决定?
整图无字母面板,横轴不同情境子集,纵轴学习权重;两种颜色区分等权历史与近期加权模型。地点、时刻及组合等贡献不同,但权重不能直接当成某变量的因果重要性。来源:原论文 Fig. 7。
用得越久,就一定越懂这个人吗?
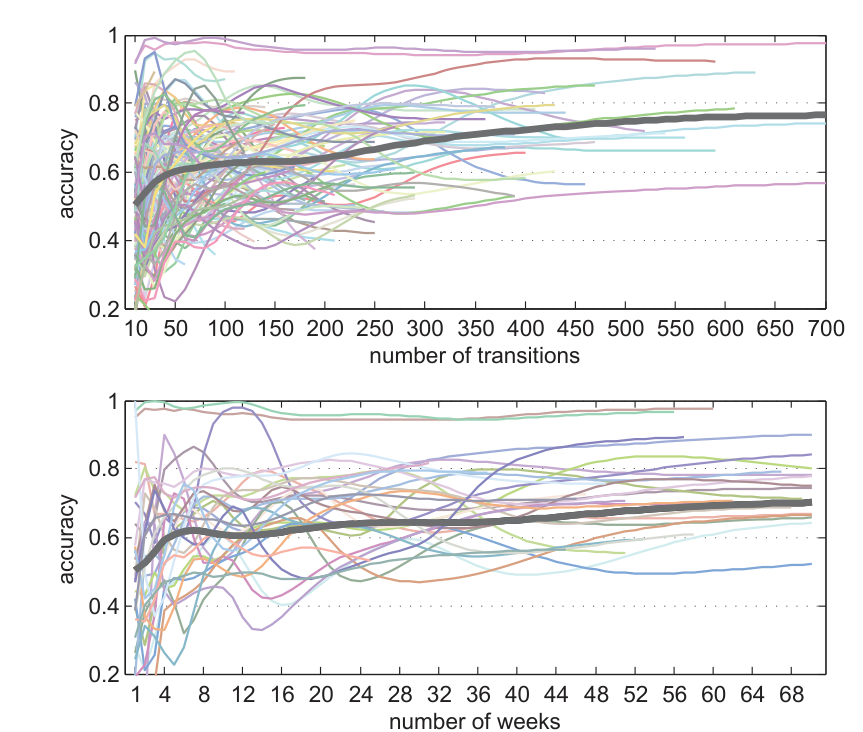
图 8|进步来自时间流逝,还是来自有效例子积累?
上面板横轴此前可信转移次数,下面板横轴记录周数;粗线汇总,细线单个用户。原图无a/b标记,曲线经过平滑,下图为至少贡献半年且有300次可信转移的用户。整体趋势改善,但个人曲线会回落,且并非所有用户都达到相同高度。来源:原论文 Fig. 8。
观测数量与准确率的联系比单纯记录时长更清楚。一次长期关机、一次习惯变化,都可能让“用了半年”的手机仍不熟悉某些情境。平滑的汇总曲线也不能保证某个具体人的下一站越来越好猜。
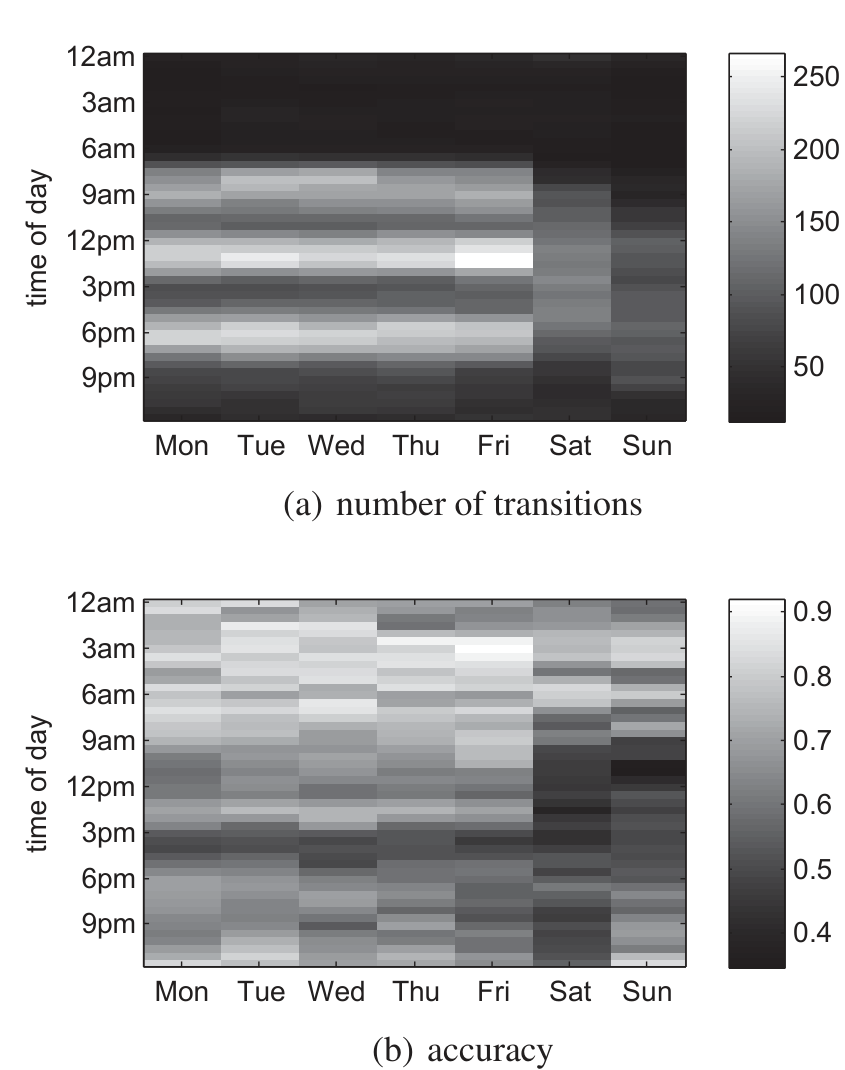
图 9|最热闹的时候,是否也是最容易预测的时候?
(a)每周30分钟时段内可信转移数;(b)相应准确率。横轴星期、纵轴时刻,两幅使用不同色阶。夜间转移少但可能容易预测,周末白天更难;活动量与可预测性不能混为一谈。来源:原论文 Fig. 9。
这些解释与工作、午餐、周日返家等日常规律相容,但论文没有给每次访问核实活动目的,不宜把热图直接变成每个用户的具体生活标签。
预测待多久,为什么不能只取平均值?
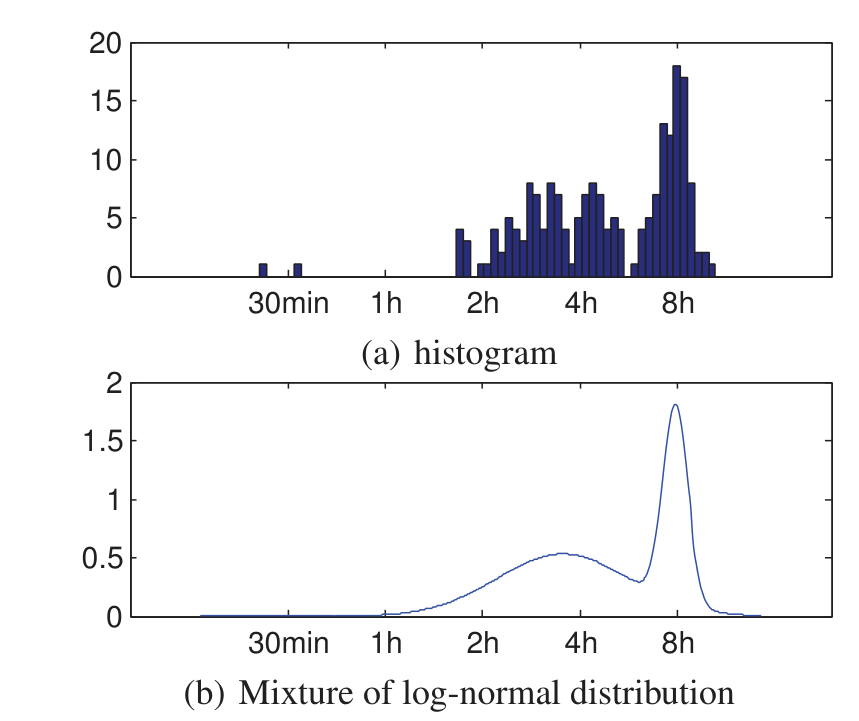
图 4|同一个办公室,也可能有两种不同的一天。
(a)某用户工作地点停留时长直方图;(b)混合对数正态分布拟合。约4小时和8小时的双峰可能对应中途外出午餐或整天停留,但这一解释不是逐次活动真值。来源:原论文 Fig. 4。
作者以最多两个分量表示时长分布,也从过去离开时刻推算潜在停留:同样到办公室,下午到与早上到,可能仍在接近的时间离开。一般人群规律为个人历史稀少的情境提供先验,随着同类观察增加再更多依赖个人模型。原文相关混合公式排版并不十分清晰,复现时应另行核对,不能照字面抄成未经归一化的概率。
最终输出不必是最常见时长,而是使预期相对损失最小的时长。误差定义为:
|预测时长 − 实际时长| / max(预测时长, 实际时长)
例如预测1小时、实际2小时,误差0.5。分母不是始终实际值,也不是分钟差。因此,这项指标与分类准确率回答的是不同问题。
| 时长预测方法 | 平均相对误差,越低越好 |
|---|---|
| 固定输出中位数2.3小时 | 0.590 |
| 最优一般人群模型 | 0.441 |
| 最优个人单模型 | 0.420 |
| 一般+个人的最优单模型 | 0.376 |
| 组合最终时长输出 | 0.375 |
| 组合完整概率分布 | 0.355 |
最后两行的差别很有启发:保留“可能半天,也可能全天”的完整分布,再进行组合,比过早压成一个最终时长更有用。但这仍是当前样本和损失定义下的结果,不保证所有任务都应采用相同组合。
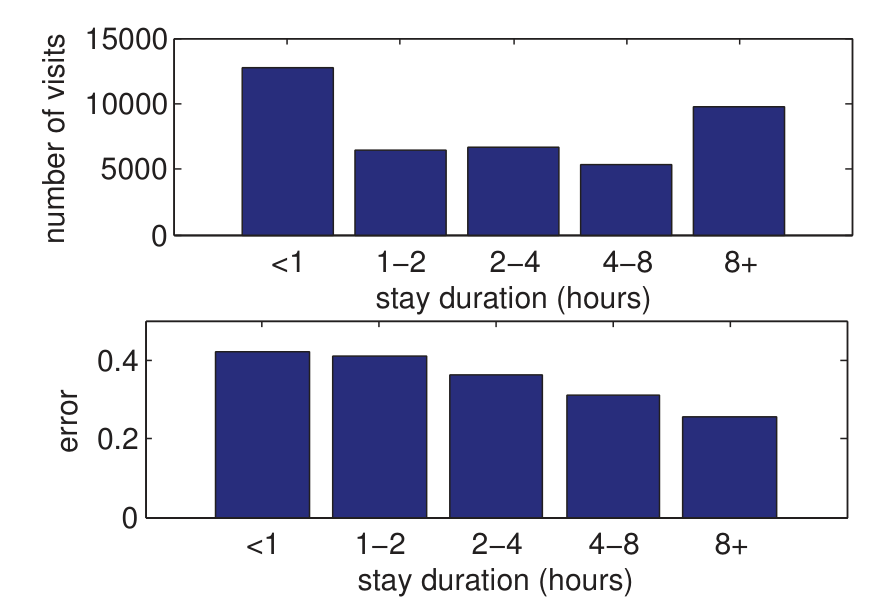
图 10|哪些访问更容易预测,换指标后答案会变吗?
上面板为五类实际时长的访问数量,下面板为平均相对误差,类别为小于1小时、1—2、2—4、4—8和超过8小时,原图没有字母标记。短访问与长访问都常见,但短访问相对误差约0.420,长访问约0.254。来源:原论文 Fig. 10。
若把连续时长转成这五类,整体分类准确率约56%;短于1小时类别约63%,超过8小时约77%(原文表5)。短访问可能分钟误差不大却相对误差高,也可能仍落在正确类别。因此,不能只挑最有利的指标宣称模型更准。
手机上的预测应用,边界在哪里?
训练组合权重较贵,但可预先完成;实际使用时更新个人计数、计算低维时长分布,计算量较小。论文讨论了36个时长预测器与约500段数值近似,但没有给出完整的实际手机能耗或运行时实测,不宜把复杂度分析直接写成已经验证的全天低功耗产品。
数据还来自早期智能手机、以学生与职业人士为主的153人,样本和感知技术都有时代边界。符号地点减少直接暴露坐标,但行为序列仍可能敏感,不能把“没有经纬度”等同于完整隐私保证。
它最持久的启发,是把情境丰富与数据稀疏之间的矛盾处理得很具体:细模型各自学一部分,先保留不确定性,再组合判断,同时承认观察不足时就是难以预测。新增更多传感器之前,先问现有情境是否有足够、可靠、可用于当时预测的历史,往往更重要。
一句话总结
移动预测的关键不只是收集更多情境,而是把有限历史中的不同规律和不确定性组合好,并明确预测发生的时刻与被评估的行为范围。
核心来源
- Do, T. M. T. & Gatica-Perez, D.(2012). Contextual Conditional Models for Smartphone-based Human Mobility Prediction. UbiComp 2012, 163—172。论文DOI,作者机构全文。本文全部图、实验、方法及数值据原论文,主图保留完整面板组合。
作者介绍
按论文发表时署名介绍,不推断当前任职或职称。
- Trinh Minh Tri Do:瑞士Idiap Research Institute署名作者,本文第一作者。
- Daniel Gatica-Perez:瑞士Idiap Research Institute与洛桑联邦理工学院(EPFL)署名作者。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
实际应用可以不必每次都猜一个确定目的地,而是在候选分布过于分散时保持沉默。对用户而言,少数高可靠提醒可能比每次都给出一个错误答案更有价值。评价时可同时报告愿意预测的记录比例和这些预测的准确率,避免把拒绝困难样本带来的改善藏起来。
还可以单独评估习惯突变:搬家、换工作或假期之后,近期权重需要多少有效观察才能恢复?这比只看17个月平均准确率,更接近用户真正会察觉模型失灵的时刻。