预测人明天在哪里,简单的历史记忆能有多接近上限?
论文名片|Xin Lu、Erik Wetter、Nita Bharti、Andrew J. Tatem、Linus Bengtsson,Approaching the Limit of Predictability in Human Mobility,Scientific Reports,2013,3:2923,2013 年 10 月 11 日发表。DOI。
假设一个人最近每天最后一次通话都发生在同一个区,你预测明天仍在那里,很可能猜对。若他偶尔换区,却常沿着固定顺序来回,记住昨天在哪里,也许就能进一步提高准确率。
这篇论文问得更具体:从轨迹信息推算出的最大可预测性,只是一个抽象上限,还是简单算法就能靠近?研究用科特迪瓦手机数据比较熵推算的潜在能力与逐日马尔可夫预测,并发现数据平稳性决定了如何理解两者的差距。
先记住四点:
- 从 50 万匿名订户的原始样本中,主要可预测性分析筛选出 208,288 名观测充分、至少跨过两个行政区的用户。
- 目标是预测一天最后一次被观测到的分区,不是全天连续位置、精确地址或下一次真实出行目的地。
- 理论估计平均可预测性约 88%;一阶马尔可夫模型在平稳组约 87%,更高阶没有稳定带来更高准确率。
- 非平稳组实际准确率可到约 95%,并不表示突破信息论,而是提醒我们有限数据估计、平稳条件与具体评分任务必须对齐。
手机记录先告诉了我们哪些位置?
Orange 提供 2011 年 12 月 1 日至 2012 年 4 月 28 日约 150 天的记录,从约 500 万原始用户中随机抽取 50 万匿名订户。通信位置被聚合为基站所在的 subprefecture,本文称为分区。全国有 255 个分区,其中 237 个至少有一座基站。
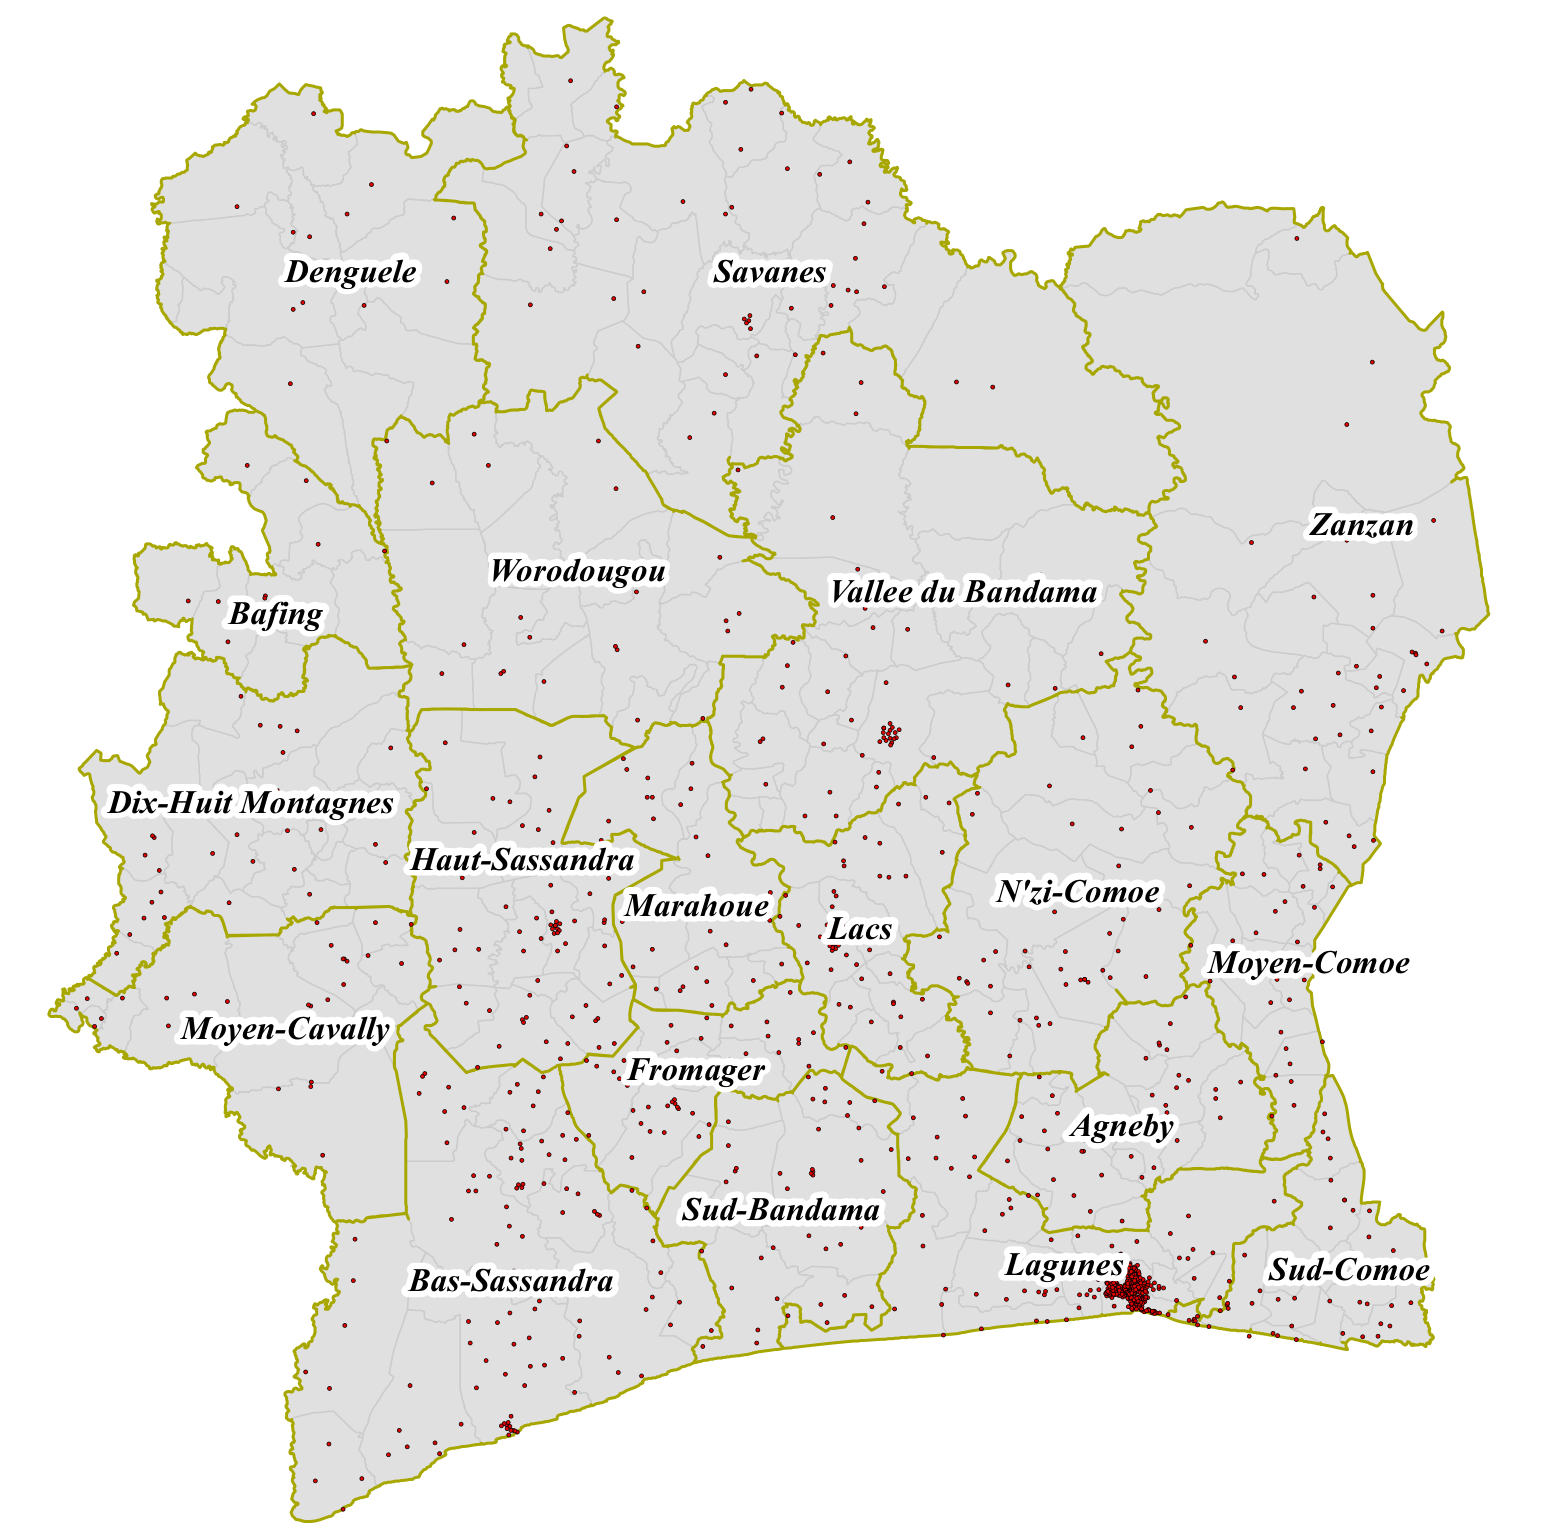
图 1|研究能在怎样的地理尺度看见人?
图中粗边界标示区域、浅色细边界标示更小的分区,红点为基站。南部 Lagunes、包括 Abidjan 的地方基站更密,说明位置记录和人口分布在空间上并不均匀。原图无子图字母。来源:原论文 Fig. 1。
每天取最后一次观测到的分区组成序列;没有通信定位的日子记为 unknown。这里“最后观测”不等于睡觉地点,也不保证此后没有移动。用户在同一分区内部的大量移动还会被视为位置不变。
为了避免大量缺失或完全不跨区者让预测显得过于容易,主要分析要求观测超过 120 天、至少去过两个分区,留下 208,288 人。这是经过活跃度和移动条件筛选的订户,不是 50 万人的全部预测成绩,更不是全国随机人口样本。
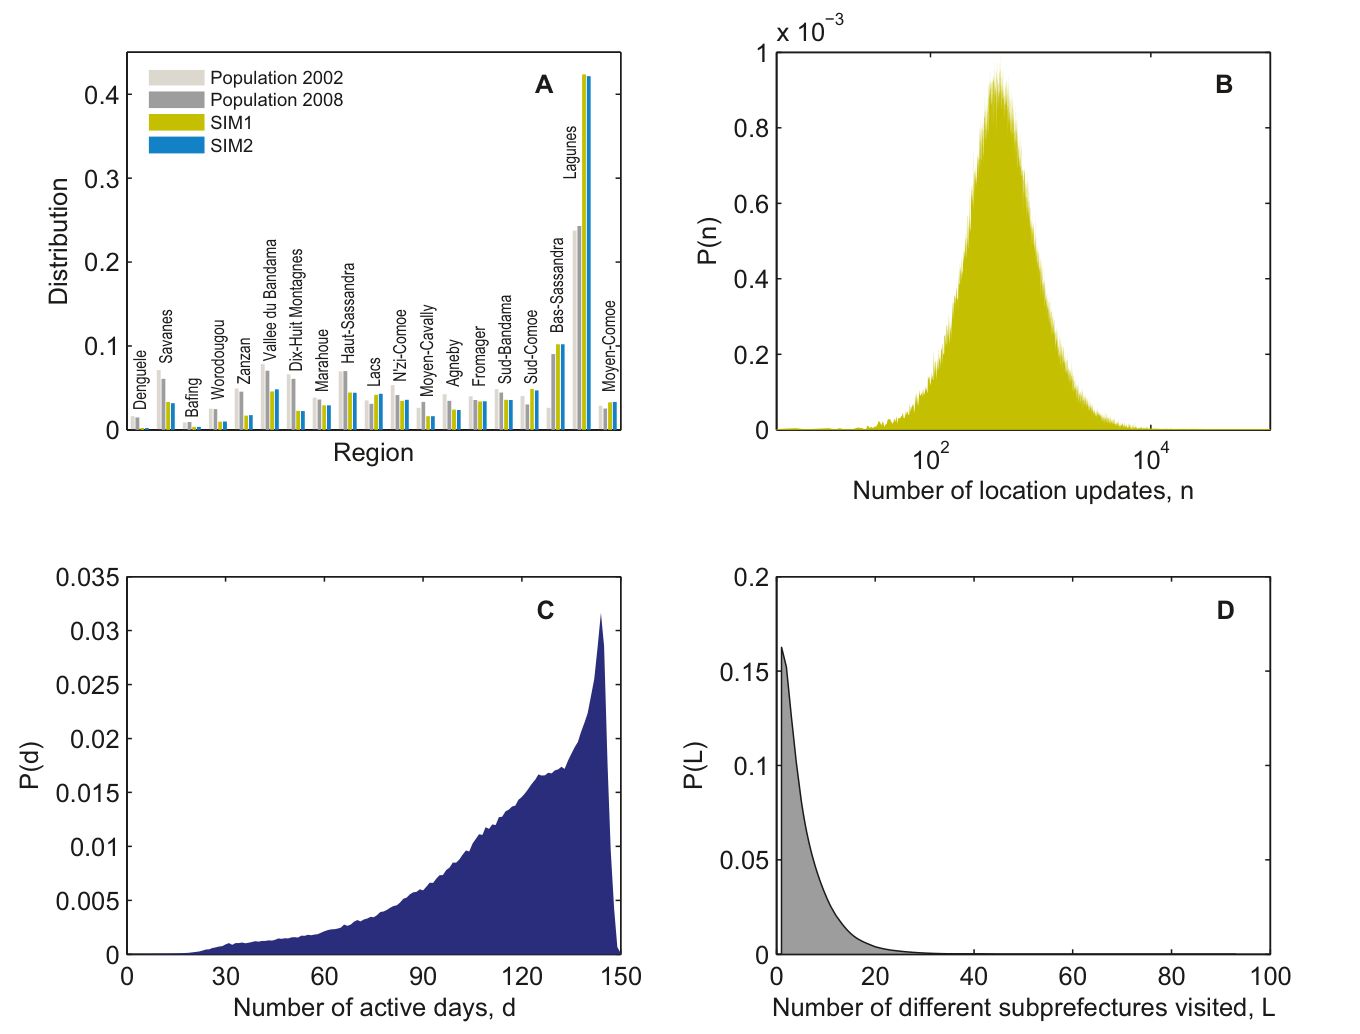
图 2|位置规律以前,先看数据覆盖是否均匀。
(A)各地区人口占比与订户占比。SIM1 按首次观测地、SIM2 按最常观测地归属;Lagunes 的样本占比明显高于人口占比。
(B)每人通信定位更新数分布,横轴对数,观测次数很不相同。
(C)每人的活跃日数,即至少有一次记录的天数。
(D)观察期内去过的不同分区数,多数人涉及的分区很少。来源:原论文 Fig. 2。
Lagunes 约占全国人口 25%,却是样本中约 43% 订户最常出现的地区。约 81.3% 用户有 100–2,000 次更新,原始样本约 16% 只在一个分区被记录。拥有手机、选择运营商、通信频率和地方人口密度共同影响谁更容易被观察。
集体流动在变化,个人还能保持规律吗?
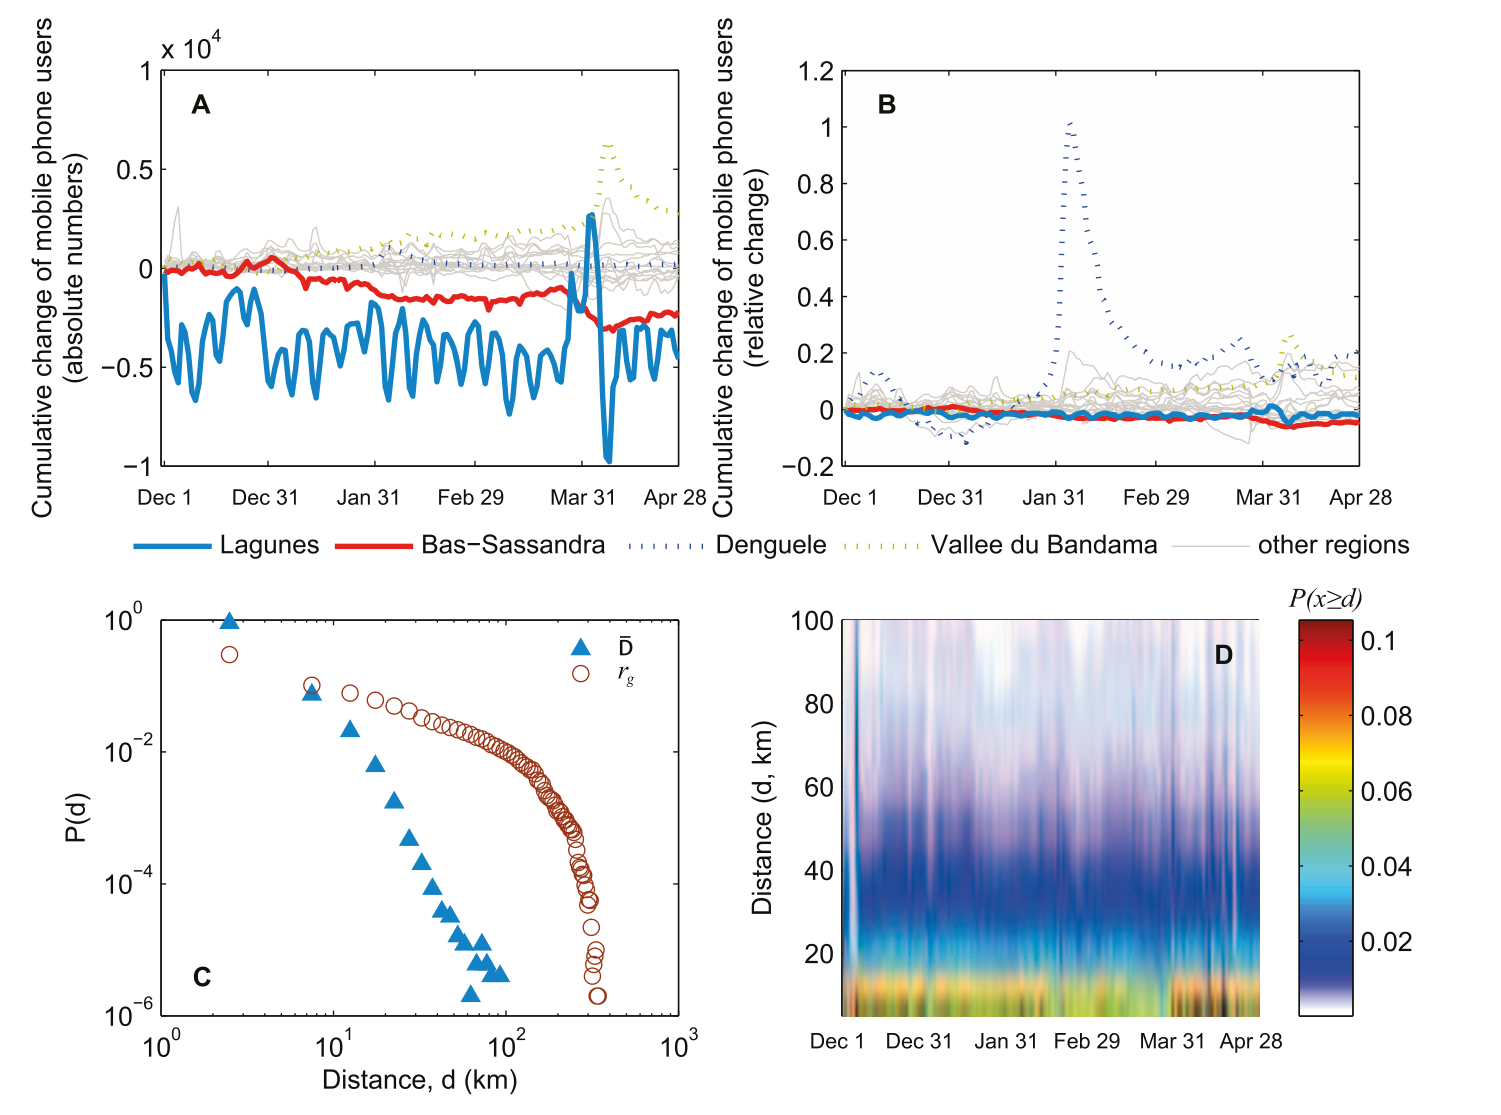
图 3|同一观察期内,流动规模和距离怎样变化?
(A)不同地区订户数相对起点的累计绝对变化,Lagunes 的周内波动较突出。
(B)将变化除以起始规模后比较,Denguele 的相对变化显著,但不等于它的绝对流量最大。
(C)距离指标与回转半径的分布,横轴公里、双对数,显示群体中少数人活动范围很大。
(D)每天平均移动距离的累计概率,横轴日期、纵轴距离,色条表示超过距离阈值的比例。来源:原论文 Fig. 3。
这些图说明研究期不是完全静止的背景:部分地区有周周期,三月底四月初还有明显变化。作者提出节庆等可能解释,但没有将其中某一变化因果归于复活节或内战后恢复。
距离由分区中心近似,区内短距离移动被忽略,所以不能把图中的低移动理解成不出门。回转半径衡量围绕个人活动中心的分散程度,也不等于累计走过的距离。
熵怎样从“经常在哪”变成“最多能猜准多少”?
熵(entropy)度量轨迹的不确定性。论文比较三种信息:随机熵只知道去过多少地点并设等概率;无时间相关熵知道各地点出现频率;序列熵还考虑访问顺序。
若经常只去一个主地点,知道频率就能减少许多不确定性;若“从 A 后常去 B”这样的顺序稳定,序列又提供额外信息。通过 Fano 不等式,论文把熵与地点数换算为理论可预测性的界限估计。它是给定数据表达和统计条件下的潜在正确率,不是一个已经训练好的预测器。
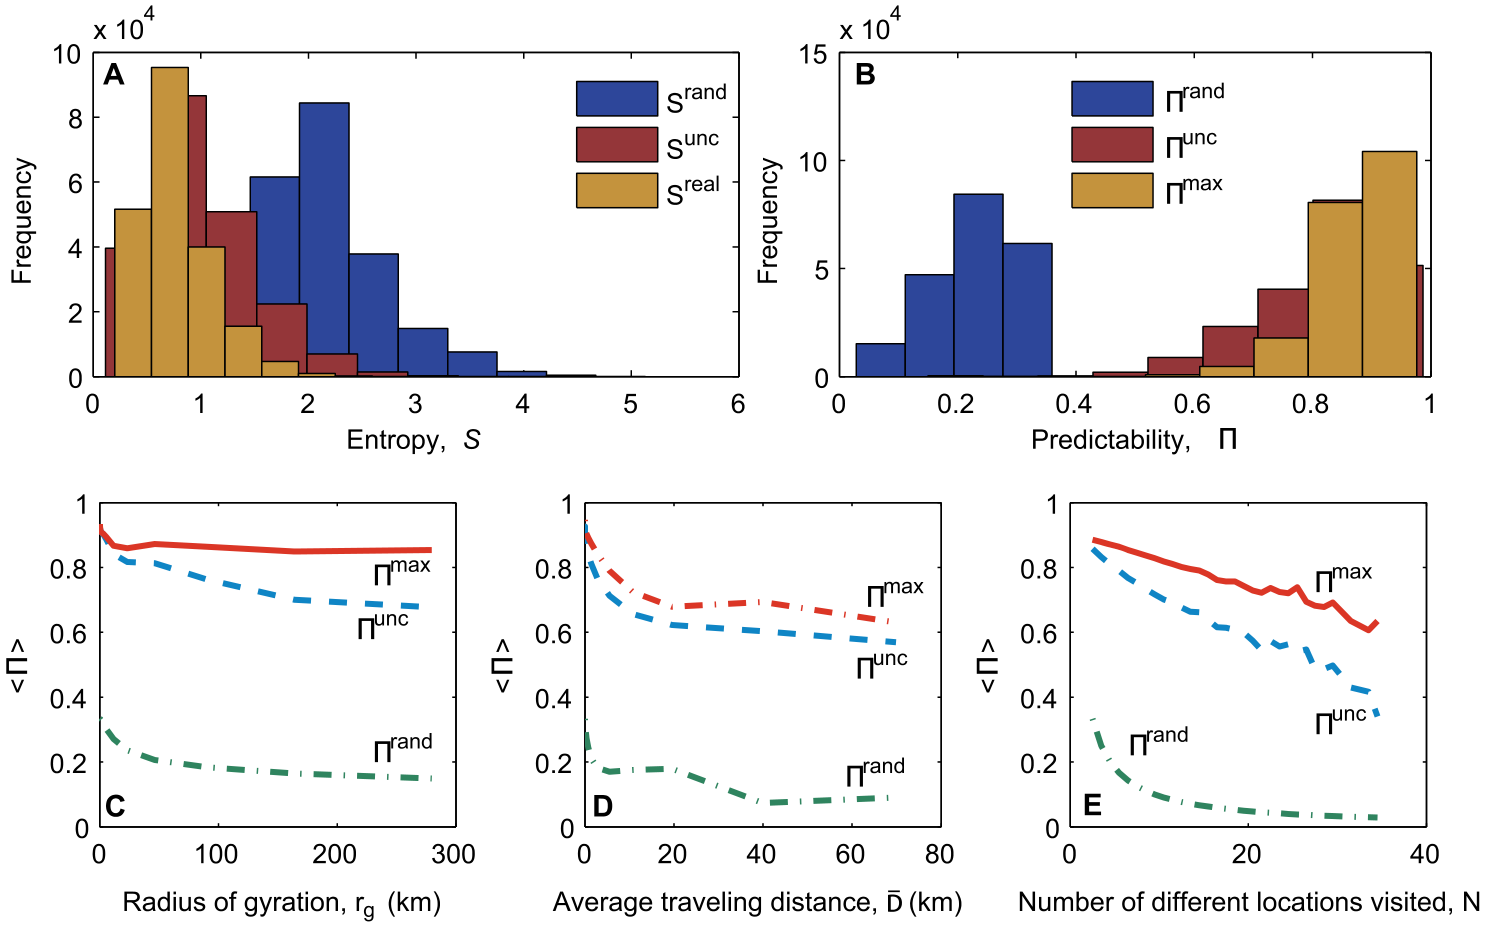
图 4|哪些信息降低了不确定性,谁又更难预测?
(A)三种熵的分布:加入频率,再加入顺序,分布向较低熵移动。
(B)对应的潜在可预测性分布。蓝、红、黄分别为随机、频率、最大可预测性,更多信息对应更高潜在能力。
(C)可预测性随回转半径变化,红色最大可预测性在较宽范围内较稳定。
(D)换成平均移动距离后,最大可预测性仍有下降,不能把(C)扩展成所有移动尺度指标都无关。
(E)不同分区数越多,平均潜在可预测性越低。来源:原论文 Fig. 4。
三种熵的中位数约为 2.0、0.91、0.71 比特。转换成“等概率有效选择数”约为 4、1.88、1.64,是一种信息量解释,并非说某个人只剩 1.64 个真实地点。
全体平均的潜在可预测性约从 35%,增加到频率信息下的 84%,再到序列信息下的 88%。这与补充材料所报中位数并非同一统计量,不能混用。高分很大一部分来自反复出现在少数地点,而不是算法学会了每一次罕见旅行。
回转半径约 20–300 公里范围内,最大可预测性仍约 85%;但使用平均移动距离时会下降,去过更多分区的人也明显更难预测。结论应保留具体指标和分组,不能说移动多远都完全一样可预测。
补充材料 S1 把每天一次改为每 12 小时、每 8 小时一次,并保留已知位置超过 80% 的序列。频率与顺序仍明显提高潜在预测能力,最大可预测性的中位数约 0.89–0.90。它支持在这些采样方案下的稳健性,不能推广成所有采样率、GPS 精度和短时运动都无影响。
一个简单马尔可夫模型,实际怎样预测?
马尔可夫链(Markov chain,MC)根据最近 n 个观测地点,估计下一地点概率。MC(1) 看最近一个地点,MC(7) 看最近七个;MC(0) 不看顺序,只预测历史最常出现的位置。
每到一天,模型只用此前历史更新转移概率与频率,选择概率最大的地点;高阶历史组合若未出现过,就退回低阶。评分是正确预测数除以已做预测数,当天不活跃的用户不参与评分。它是按时间向前更新的已观测日预测,不能把缺失日当作也被猜对。
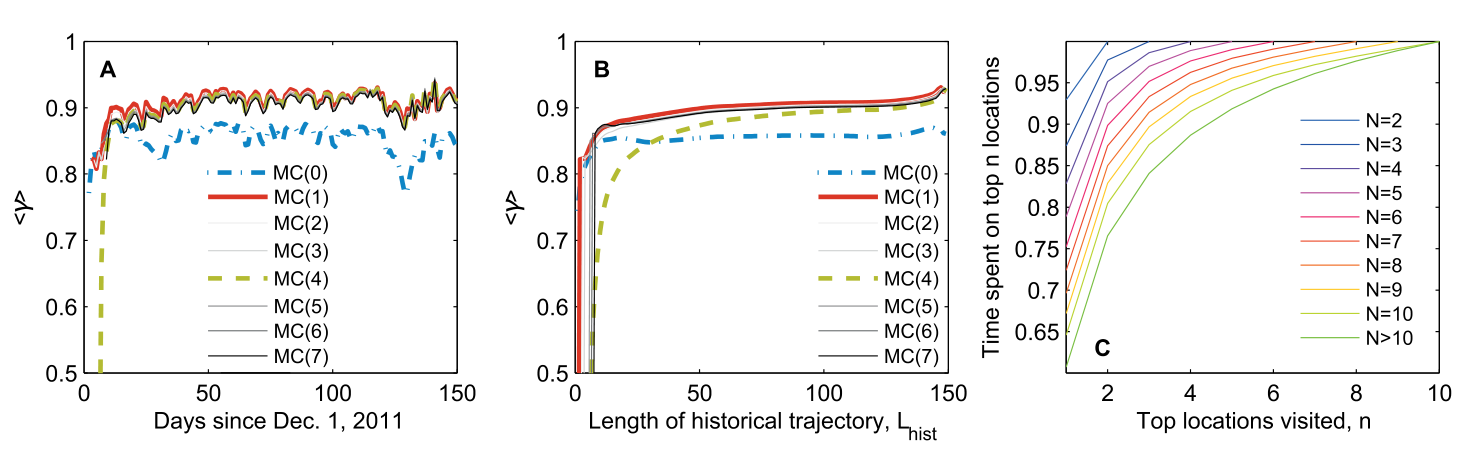
图 5|记住顺序有用,记得更长又是否更好?
(A)逐日平均准确率,蓝色点划线为 MC(0),红线为 MC(1),其他线为更高阶模型;顺序模型整体高于仅靠频率。
(B)按可用历史长度比较,历史越长,顺序模型总体提高;MC(0) 约 15 个历史点后已较稳定。
(C)不同总访问地点数群体在前 n 个最常地点出现的比例,揭示少数主地点带来的高预测基线。来源:原论文 Fig. 5。
总体上,MC(0) 约 85%,顺序模型约 91%;历史超过 100 个点后,顺序模型平均准确率高于 90%。某次后期波动中,MC(0) 从约 88% 降至 77%,顺序模型约从 92% 降至 87%,说明转移信息在该例中比固定主地点更有适应性。
MC(2) 到 MC(7) 没有持续胜过 MC(1),MC(4) 在一些历史长度下反而较差。高阶模型需要更多重复历史组合,短序列中未必获得足够信息。这里的结果限于本文的日尺度、分区定位与算法集合,不意味着任何复杂模型都不可能改善预测。
图 5C 给出一个必要的参照:即使某人去过四个分区,他在最常出现的那个分区也可占接近 80%。高准确率应与这种强基线比较,而非与四选一随机猜测相比后直接称为复杂智能。
实测 95% 超过理论 88%,发生了什么?
不能把不同条件下的数值直接理解为突破上限。Fano 不等式给的是在相应真实熵与过程条件下的约束;论文拿到的却是最长约 150 个日点的有限序列估计,过程本身可能还在改变。
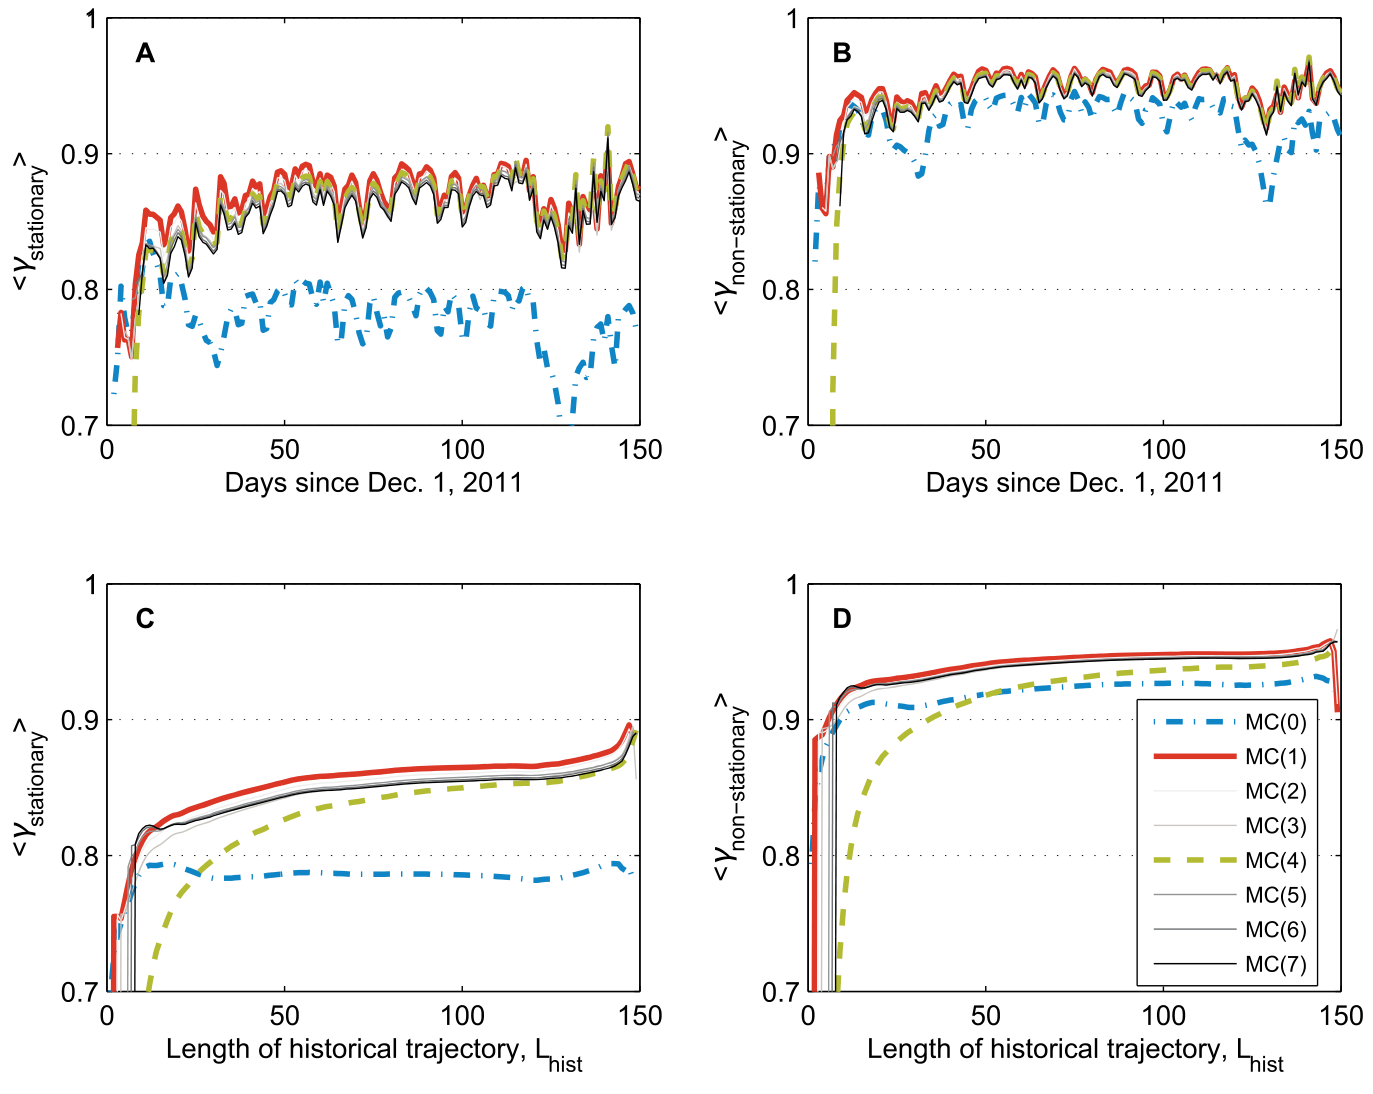
图 6|先检查序列稳定性,再比较算法与界限。
(A、B)分别为平稳组、非平稳组随日历时间变化的准确率。
(C、D)分别为上述两组随历史观测点数变化的准确率;非平稳组在约 50 个历史点后可接近 95%,平稳组约 87%。线型与图 5 相同。来源:原论文 Fig. 6。
论文使用 Geweke 诊断,将序列早期与后半段比较,显著性水平为 0.05;前段分别取总长度的 20%、30%、40%、50%,全部通过才归为平稳,最终约 49% 通过。补充图 S2 说明这一分组对检查窗口有依赖。
这种诊断提供有限样本下的稳定性筛查,不是证明所有行为统计永久不变。对通过筛查的序列,实际约 87% 接近总体理论估计 88%;未通过组却可以达到约 95%,提示把有限非平稳序列的熵估计当成同一预测任务的硬上限会有问题。
因此,这篇论文的启发不是“非平稳的人一定更容易预测”,而是预测器如何利用最近历史,与熵怎样在有限、变化中的序列上估计,是两件需要对齐的事。观察到高于估计界限的分数,不推翻信息论,也不能由此保证现实中突然迁移者都更好预测。
个体层面,熵与实际错误是否对应?
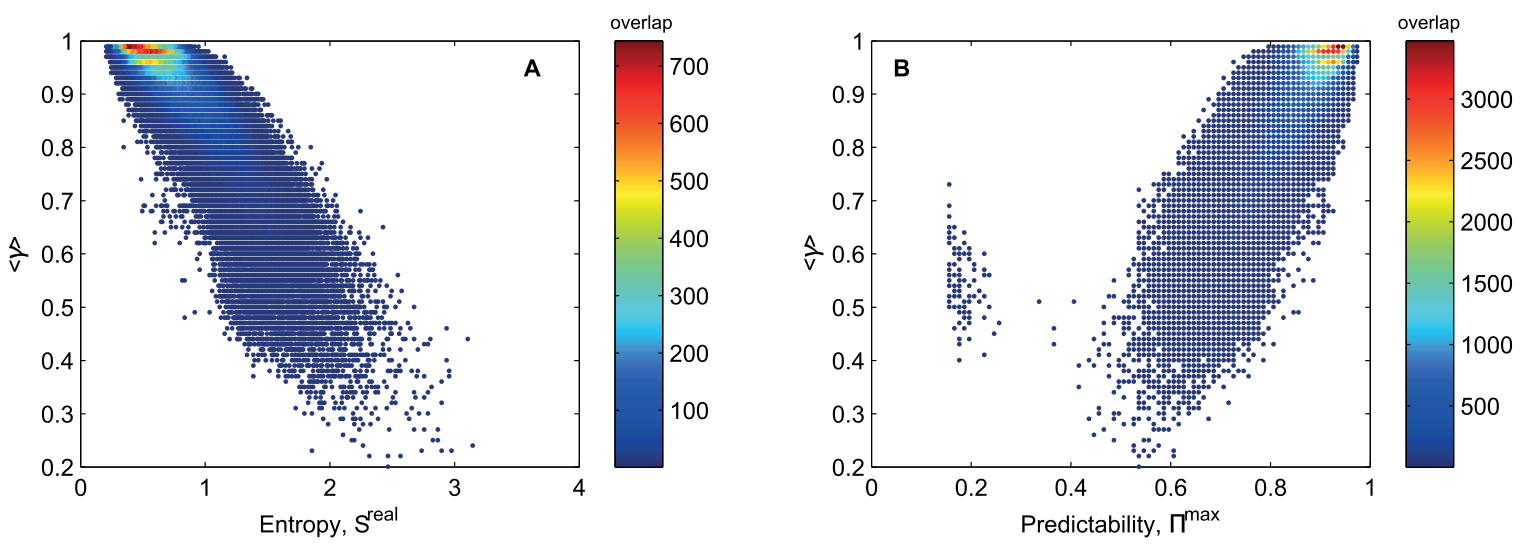
图 7|理论指标能否区分谁更难预测?
(A)横轴序列熵、纵轴个人 MC(1) 准确率,熵越高通常准确率越低,颜色为重叠样本数。
(B)横轴理论最大可预测性、纵轴实际准确率,二者总体正相关;分箱后的色条表示样本密度,不是置信度。来源:原论文 Fig. 7。
个人准确率只按有观测的日子汇总。其与熵的相关系数约 −0.849,与最大可预测性约 0.802,说明理论指标对实际难度有解释力。但散点仍有明显宽度,不能把某人的理论估计直接当作他的必然命中率。
这也是本文最实用的结论:先量化轨迹包含多少稳定信息,再用透明的频率和一阶转移基线检验可达到多少。对于这种粗空间、日尺度记录,简单方法已能利用大量重复行为。
这项结果能推广到怎样的任务?
它支持在观测充分的订户群体中,以历史位置预测次日最后观测分区。它没有验证连续定位、实时导航、区内活动或罕见目的地的准确率,也没有用这些预测开展实际疫情或交通干预评估。
末次通信时间不同、区内移动被压缩、缺失日不评分、活跃用户筛选和手机覆盖差异,都会影响任务难度。若将空间细化、预测时间缩短,或转向没有足够历史的人,不能直接沿用 87%–95%。
更高阶没有获益,也只是在本文比较下成立。是否需要神经网络、贝叶斯模型或额外语义特征,应由同一任务、同一时间划分和同样基线上的新增证据决定。
一句话总结
在人们反复出现的日尺度分区记录里,一阶历史转移已能接近熵推算的可预测性;读懂这个结论,必须同时保留观察尺度、活跃日分母与平稳性条件。
核心来源
- Scientific Reports 原文:图 1–7、日序列定义、MC(0)–MC(7)、平稳性检查与个体相关。本文七张主图均保留完整原组合。
- 官方补充材料:S1 采样率敏感性及 S2 Geweke 诊断比例。
作者介绍
按论文发表时期的署名机构介绍,不推断作者当前职务。
- Xin Lu:国防科技大学信息系统与管理学院、Flowminder Foundation、卡罗琳斯卡学院公共卫生科学系及斯德哥尔摩大学社会学系;本文通讯作者。
- Erik Wetter:Flowminder Foundation、斯德哥尔摩经济学院管理与组织系。
- Nita Bharti:宾夕法尼亚州立大学生物学系、传染病动力学中心及 Huck 生命科学研究所。
- Andrew J. Tatem:南安普顿大学地理与环境系、美国国立卫生研究院 Fogarty International Center。
- Linus Bengtsson:Flowminder Foundation、卡罗琳斯卡学院公共卫生科学系。
延伸思考:把不移动的日子猜对,是否足以服务真实需求?
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果大部分日子留在同一分区,一个总正确率很高的模型,仍可能错过最值得关注的跨区日。对于灾害或运力安排,后者往往比普通停留日更重要。
可以把评分拆成“是否跨区”和“跨区后到哪里”,分别报告常规日、首次到访地与突变时期的表现,再与昨天位置不变、历史最常位置和一阶转移比较。同时把不活跃日明确列为未观察,而非自动补成停留。这样才能知道接近总体上限的算法,是否也接近具体应用真正关心的目标。