住区再密、公交再多,通勤就更坐公交吗?
论文名片|Chuan Ding、Xinyu Cao、Bin Yu、Yang Ju,Non-linear associations between zonal built environment attributes and transit commuting mode choice accounting for spatial heterogeneity,Transportation Research Part A,2021,148:22–35,2021年4月6日在线发表。DOI:10.1016/j.tra.2021.03.021。观察性研究:2010年南京居民出行调查,分区建成环境,贝叶斯半参数多层二元 logit。
把南京中心城区想成一张被分成许多交通分析区的地图。某个区容积率不高,公交站也稀。规划上若把容积率从不到 1 抬到 1 附近,或者把公交站从很少补到每平方公里好几个,通勤里选择公交的人会不会按同样的步子变多?常见算法默认会:建成环境每增加一单位,选择公交的对数发生比就增加一个固定的数,而且每个区共用这个数。
这篇论文在南京数据里放开这两条默认。居住地的建成环境与公交通勤有关,但关系随指标的取值弯折,弯折的形状各不相同;同一指标的关联还会随交通分析区变化。密度对应更高的公交效用,边际增量随容积率升高而变小。用地混合在中等水平附近达到高点。公交供给要越过一个较低的平台,曲线才明显上升。这些都是控制个人特征之后的统计关联,平滑曲线画的是效用上的贡献,论文没有把它识别成某个人因为拆迁或加站而改了通勤方式。
先说结论
- 最终样本是 3758 名从家去上班的通勤者。其中 17% 通勤使用公交。六个居住地建成环境指标与这个选择的关系都呈非线性或门槛形态,而且形态彼此不同。
- 若强迫关系是一条直线,容积率、用地混合熵和公交线网密度的平均斜率,95% 后验区间都跨过 0。六个指标的分区随机斜率标准差则都在 0.05 水平显著:全市平均斜率盖住了分区之间的差别。
- 允许平滑之后,模型的 WAIC 从 3317.6 降到 3168.2。容积率在 0–1 一段上升较快,1–4.3 仍为正但更平,超过 4.3 后边际关联减弱。用地混合熵在 0.60 附近由正转负。交叉口密度超过约 12 个/km² 后为负。
- 公交线网密度约在 2 km/km² 以内、公交站密度约在 5 个/km² 以内,平滑曲线几乎不动;越过之后转为上升。到中央商务区的直线距离在约 8 km 以内为正,更远则边际关联减弱。
- 线性模型里,分区随机截距的标准差为 0.48。组内相关为 0.066,也就是 0.48² / (0.48² + π²/3):个人变量和建成环境都进入模型之后,交通分析区之间仍占选择变异的 6.6%。
这条曲线,量的是谁的哪一次通勤?
数据来自南京市交通规划部门 2010 年的居民出行调查。抽户在各交通分析区按人口规模分配户数。调查招募了 2867 户、5507 名受访者,记录家庭、个人和出行日记。进入模型的是从家出发去上班、去掉缺失值、并且年满 18 岁的 3758 名通勤者。5507 里包含非通勤者,论文没有单列因年龄、缺失和非通勤各自去掉多少人,所以 3758 不能当成 5507 的通勤比例。
研究范围是南京中心城区:面积 261 km²,人口超过 260 万,划分成 198 个交通分析区。建成环境用 2009 与 2010 年的用地,来源是南京市规划局和百度兴趣点,在 ArcGIS 10.2 里算到交通分析区。模型里的供给是居住地的公交站和公交线网,十项建成环境指标里没有单独的地铁站距离。论文用 2019 年已有 10 条地铁、174 座车站来描述这座城市后来的公交系统;出行行为本身是 2010 年的记录。
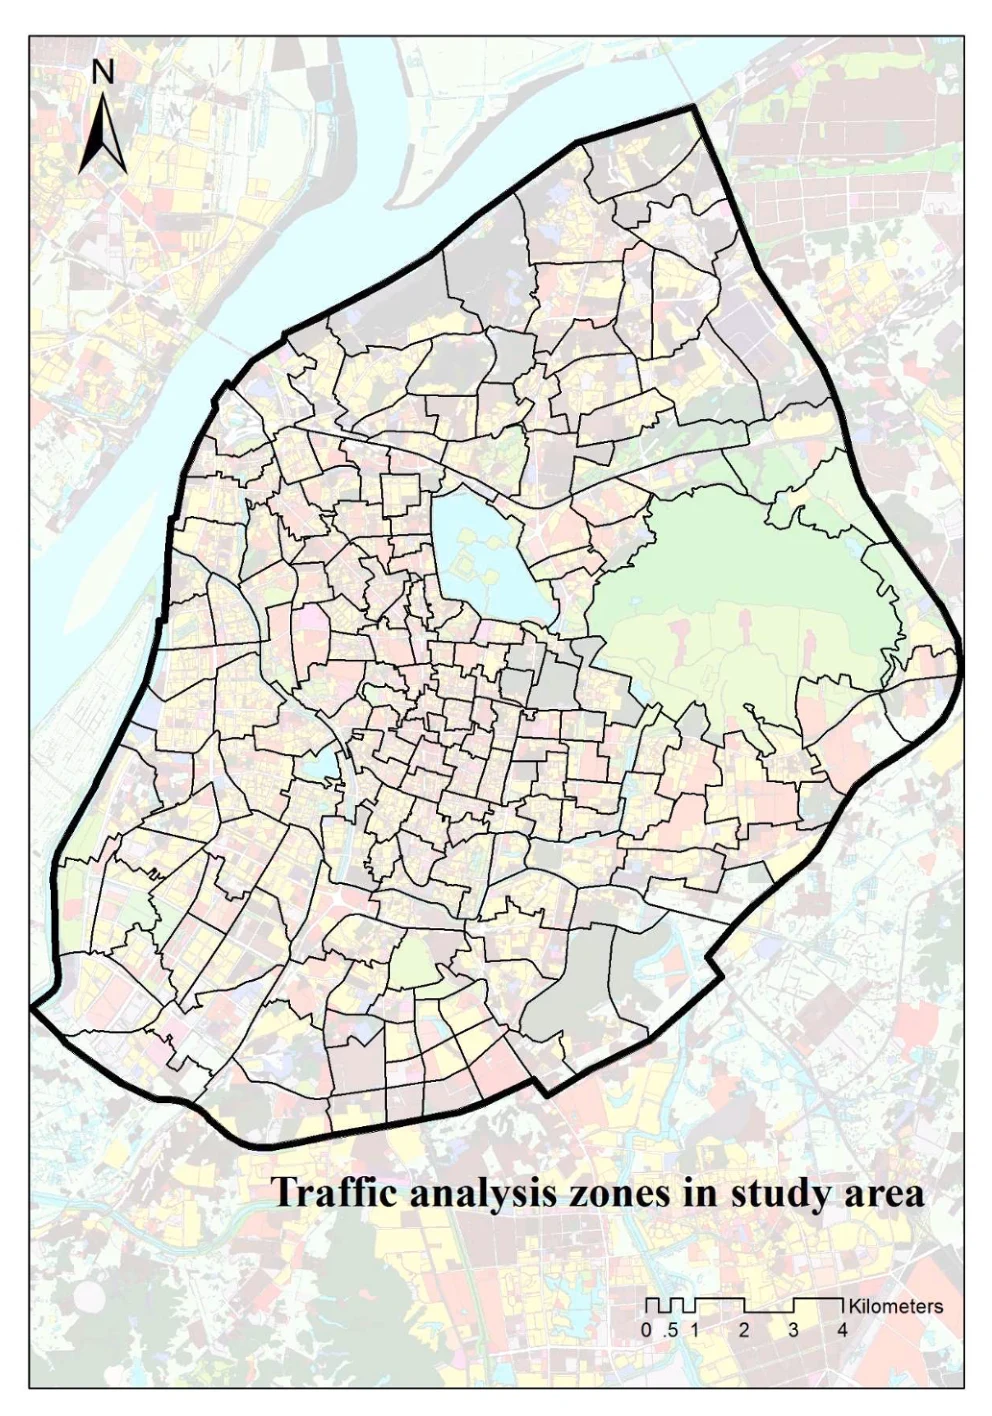
图 3|公交通勤的居住地样本落在哪一块城市?
图中没有子图字母。粗黑线以内是中心城区研究范围,细线是交通分析区;左上为指北针,右下比例尺以千米计,底图能看到河流和成片绿地。这张图回答样本住在哪里,没有标出各区的公交分担率,也不能从色块读出容积率或公交站密度。来源:原论文 Fig. 3。
表 1 的均值和标准差是最终样本的统计。个人变量显然按 3758 人计算。分区变量和个人变量列在同一张表里,论文没有另给 198 个区各算一次的未加权平均,因此下面的分区均值应按样本中通勤者所在区的取值来读。
在这 3758 人里,17% 通勤使用公交,21% 的家庭至少有一辆小汽车,78% 在早高峰 7:00–9:00 出发,平均通勤时间约 30 分钟。通勤时间和小汽车、自行车保有量没有放进模型。作者认为它们与建成环境和方式选择相互决定,放进去会压低建成环境的系数;作为替代,模型使用家庭成员中持有驾照的人数除以家庭人口,样本均值为 0.27。
个人变量里,男性占 51%。年龄按哑变量分组:30 岁以下 18%,30–60 岁 61%,60 岁以上 22%,三者的样本均值加总为 1.01,是四舍五入留下的差额。家庭人口以 3 人为最多,占 67%;少于 3 人占 18%,多于 3 人占 15%。家庭年总收入低于 2 万元的占 12%,2 万至 10 万元的占 75%,10 万元及以上的占 13%。表 2 把正好 10 万元放进高收入组,并把 30–60 岁、3 人家庭、2 万至 10 万元设为对照。公务人员占 40%,本科及以上占 50%。
建成环境先算了 10 个指标,再因共线性保留 6 个。保留变量的方差膨胀因子都低于 5。容积率定义为建筑面积除以交通分析区土地面积,样本均值 1.43,标准差 0.89。用地混合是居住、服务、零售和其他用地的熵:各类用地比例乘以其自然对数、求和、取负,再除以类型数的自然对数,均值 0.61,标准差 0.09。交叉口密度均值 5.36 个/km²。公交站密度均值 7.17 个/km²。公交线网密度是有公交线路的街道长度除以分区面积,均值 3.33 km/km²。到中央商务区的距离是居住分区到中心的直线距离,均值 4.05 km,标准差 2.01 km。
测了但没有进入最终模型的还有:建筑密度均值 0.34,道路密度 5.86 km/km²,平均道路宽度 27.65 m,公交线路覆盖率 10.51。后文的门槛不包括这四项。
为什么平均斜率会把门槛抹平?
土地使用和出行研究常用 5D 描述建成环境:密度、多样性、设计、到公交的距离、到市中心的距离。已有通勤研究对这几项的结论并不一致,有的城市密度或交叉口密度与方式选择有关,有的城市同一指标跨过 0。作者认为,预先规定直线、对数直线或二次曲线,可能把有效区间里的关联和区间外的平台平均成一个接近 0 的斜率。
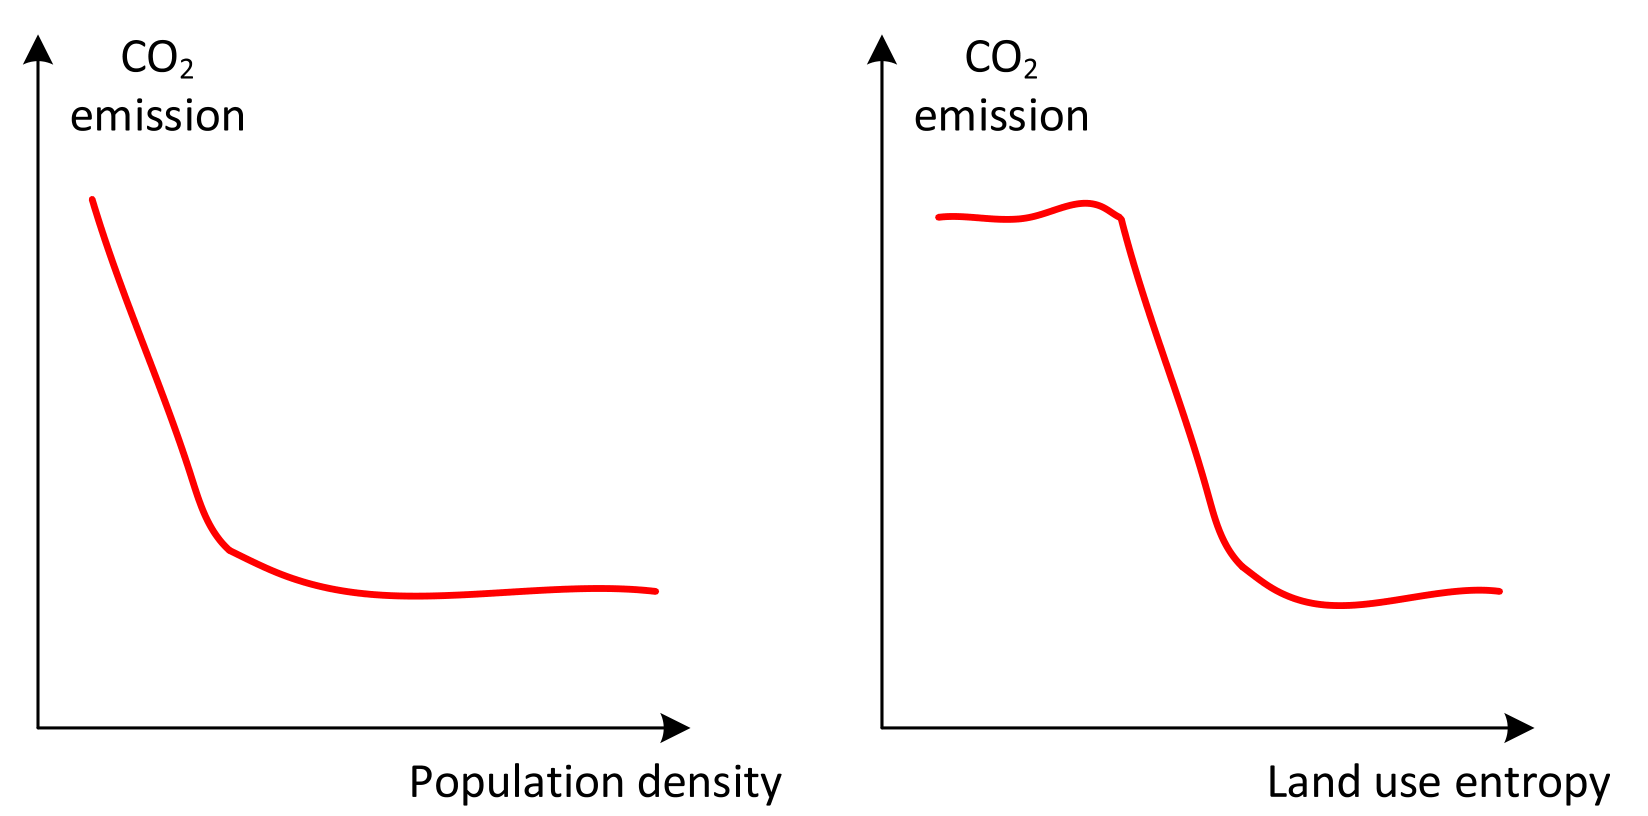
图 1|直线假设会把哪种门槛平均掉?
这张图没有子图字母,也没有刻度,画的是既有研究里的形状,不是南京 3758 人的估计。左图:人口密度升高时,出行相关二氧化碳排放先下降,随后走平,对应上限门槛。右图:用地混合熵只在中间一段对应更低的排放,两端边际变化很小。正文给出的文献数字是另一项明尼阿波利斯研究:人口密度超过每英亩 10 人之后,对出行碳排放的边际关联变得很弱;用地混合指标在 0.4–0.7 之外,边际关联也很小。来源:原论文 Fig. 1。
机器学习能画出不规则曲线,但作者指出三类缺口:通常不检验系数是否可与 0 区分,容易把噪声学成弯折,也很少处理同一交通分析区居民的相关性,以及建成环境关联在分区之间的变化。半参数模型用样条的局部平滑代替预先指定的直线;多层结构则让截距和斜率随交通分析区变化。
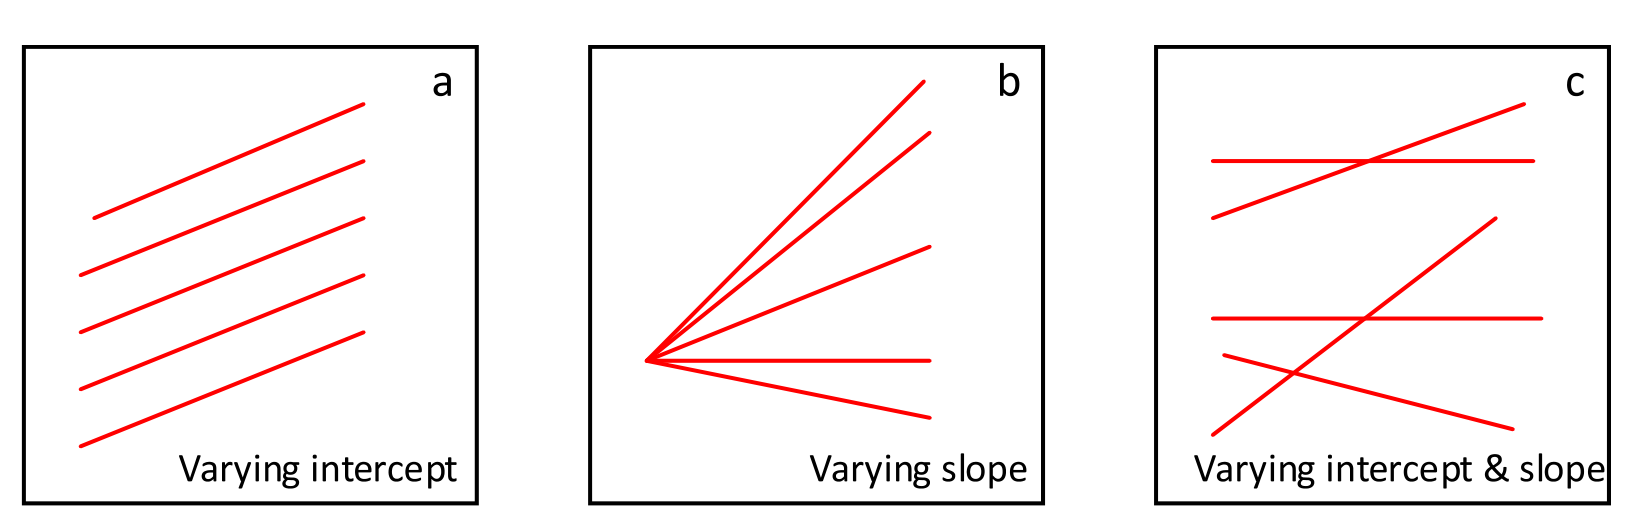
图 2|分区之间,允许差在截距、斜率,还是两者都差?
(a)变截距:各区的基线不同,建成环境的斜率平行。(b)变斜率:基线相同,斜率的方向和陡峭程度随区变化。(c)截距和斜率同时变化。本文采用(c)。这样既承认同区居民更相似,也允许某个区的容积率或公交供给与公交通勤的关联不同于全市平均。来源:原论文 Fig. 2。
具体到效用:一个人住在某个交通分析区、选择某种方式,效用分成个人变量的固定部分、建成环境的平滑函数,以及随区变化的随机截距和随机斜率。随机效应来自均值为 0 的多元正态分布,模型估计的是这组效应的标准差,不是把 198 个区的斜率逐个报出来。误差若取 logistic 分布,方差为 π²/3,就得到多层混合 logit。公交相对于其他方式的概率,是该效用的指数除以全部方式效用指数之和。
本文把方式收成两类:通勤选择公交,或其他方式。作者写明,方式本来不止两种,但半参数多层混合多项 logit 当时还没有做出,所以步行、骑车和小汽车被放进同一个对照。交叉口密度升高之后公交效用下降,可以被理解成非机动方式在分流,也可以被理解成混合交通里的公交车更慢;模型本身没有分开这些方式,不能在两者之间裁决。
建成环境的固定部分写成薄板回归样条:一条平滑曲线由一组基函数叠加而成。作者选用它,是因为有效自由度可以在估计中确定,而不必事先规定二次或三次。每个建成环境变量因此有两个标准差。sd 是该变量的斜率在交通分析区之间的离散程度。sds 是构成平滑曲线的系数有多分散,作者用它提示固定效应的弯折是否容易看见。二者都不是公交分担率的标准差。
估计用贝叶斯方法,先验是无信息先验,程序语言为 R。论文比较过惩罚最大似然,选择贝叶斯是为了直接得到参数的后验分布和区间。拟合用广泛适用信息准则 WAIC,同一批数据上数值越小越好。显著性按论文的规则读:95% 区间不含 0,记为 0.05 水平;只在 90% 区间不含 0 时,记为 0.1 水平。
把关系压成直线时,全市平均还剩下什么?
线性多层模型的 WAIC 是 3317.6。个人变量里,30 岁以下相对于 30–60 岁的系数为 0.94,95% 区间 0.71 至 1.18。家庭驾照人数占比的系数为 −0.49,95% 区间 −0.85 至 −0.14;这是该比例增加 1 个单位的对数发生比,而样本均值只有 0.27,所以 −0.49 不是两个典型家庭之间的差。家庭人口多于 3 人相对于 3 人的系数为 0.33,95% 区间 0.07 至 0.59。早高峰出发相对于其他时间的系数为 0.34,95% 区间 0.11 至 0.58;样本中 78% 的人属于早高峰,对照是其余 22%。年收入 10 万元及以上相对于 2 万至 10 万元的系数为 −0.31,只在 0.1 水平显著,95% 区间 −0.65 至 0.02 仍跨过 0。男性、60 岁以上、公务人员、本科及以上、3 人以下家庭和年收入 2 万元以下的 95% 区间都跨过 0。
这些系数都在对数发生比上。论文没有把它们换算成公交概率的百分点。样本里选择公交的基线是 3758 人中的 17%。
建成环境的平均斜率里,到中央商务区的直线距离每增加 1 km,系数为 0.21,95% 区间 0.10 至 0.32。交叉口密度每增加 1 个/km² 的系数为 −0.02,公交站密度每增加 1 个/km² 的系数为 0.04,二者都只在 0.1 水平显著,95% 区间分别是 −0.05 至 0.05 和 −0.02 至 0.09。容积率每增加 1 的平均斜率为 0.19,95% 区间 −0.15 至 0.53。用地混合熵每增加 1 的平均斜率为 −0.06,标准误达到 1.01;熵的样本标准差只有 0.09,增加 1 已经远出数据范围。公交线网密度每增加 1 km/km² 的平均斜率为 0.06,95% 区间 −0.11 至 0.22。
平均斜率跨过 0,只说明全市共用的那一个数不稳定。六个变量的分区斜率标准差都在 0.05 水平显著:容积率 0.14,用地混合 0.83,交叉口密度 0.02,公交站密度 0.04,公交线网密度 0.07,到中心的距离 0.05。用地混合的 0.83 看起来比交叉口密度的 0.02 大,是因为熵和每平方公里交叉口个数的尺度不同,不能据此说混合的空间差异更大。
随机截距的标准差为 0.48,95% 区间 0.02 至 1.12。组内相关 0.066 的分母,是这个分区方差加上 logistic 误差方差 π²/3。6.6% 是控制个人变量和建成环境之后、剩余变异里属于交通分析区的份额。作者沿用既有研究的经验界线:组内相关超过 0.03 时,多层模型比把所有人当成独立样本更合适。
直线模型还有一个方向上的问题。到中心的距离若永远按 0.21 累加,住得最远的人会得到过高的公交效用。作者因此转入不预先规定形状的平滑。
放开直线之后,六个指标弯在不同的地方
半参数模型的 WAIC 为 3168.2,低于 3317.6。个人系数几乎不动:30 岁以下为 0.95,驾照占比为 −0.50,多于 3 人为 0.32,早高峰为 0.33,10 万元及以上为 −0.31 且仍是 0.1 水平。建成环境改由平滑函数承担,所以表 3 不再报告它们的单一斜率。
分区随机斜率的标准差依然都在 0.05 水平显著,后验均值分别为容积率 0.17、用地混合 0.74、交叉口密度 0.03、公交站密度 0.04、公交线网密度 0.08、到中心距离 0.04。平滑系数的离散程度 sds 也都不含 0 的 95% 区间:容积率 2.21、用地混合 2.08、交叉口密度 1.91,高于公交站密度 1.43、公交线网密度 1.30 和到中心距离 1.39。作者据此预期前三个的弯折更明显。这些区间很宽,例如容积率 sds 的 95% 区间是 0.06 至 7.24,所以“弯折显著”和“弯折幅度可以被精确估计”不是同一句话。随机截距标准差为 0.45。
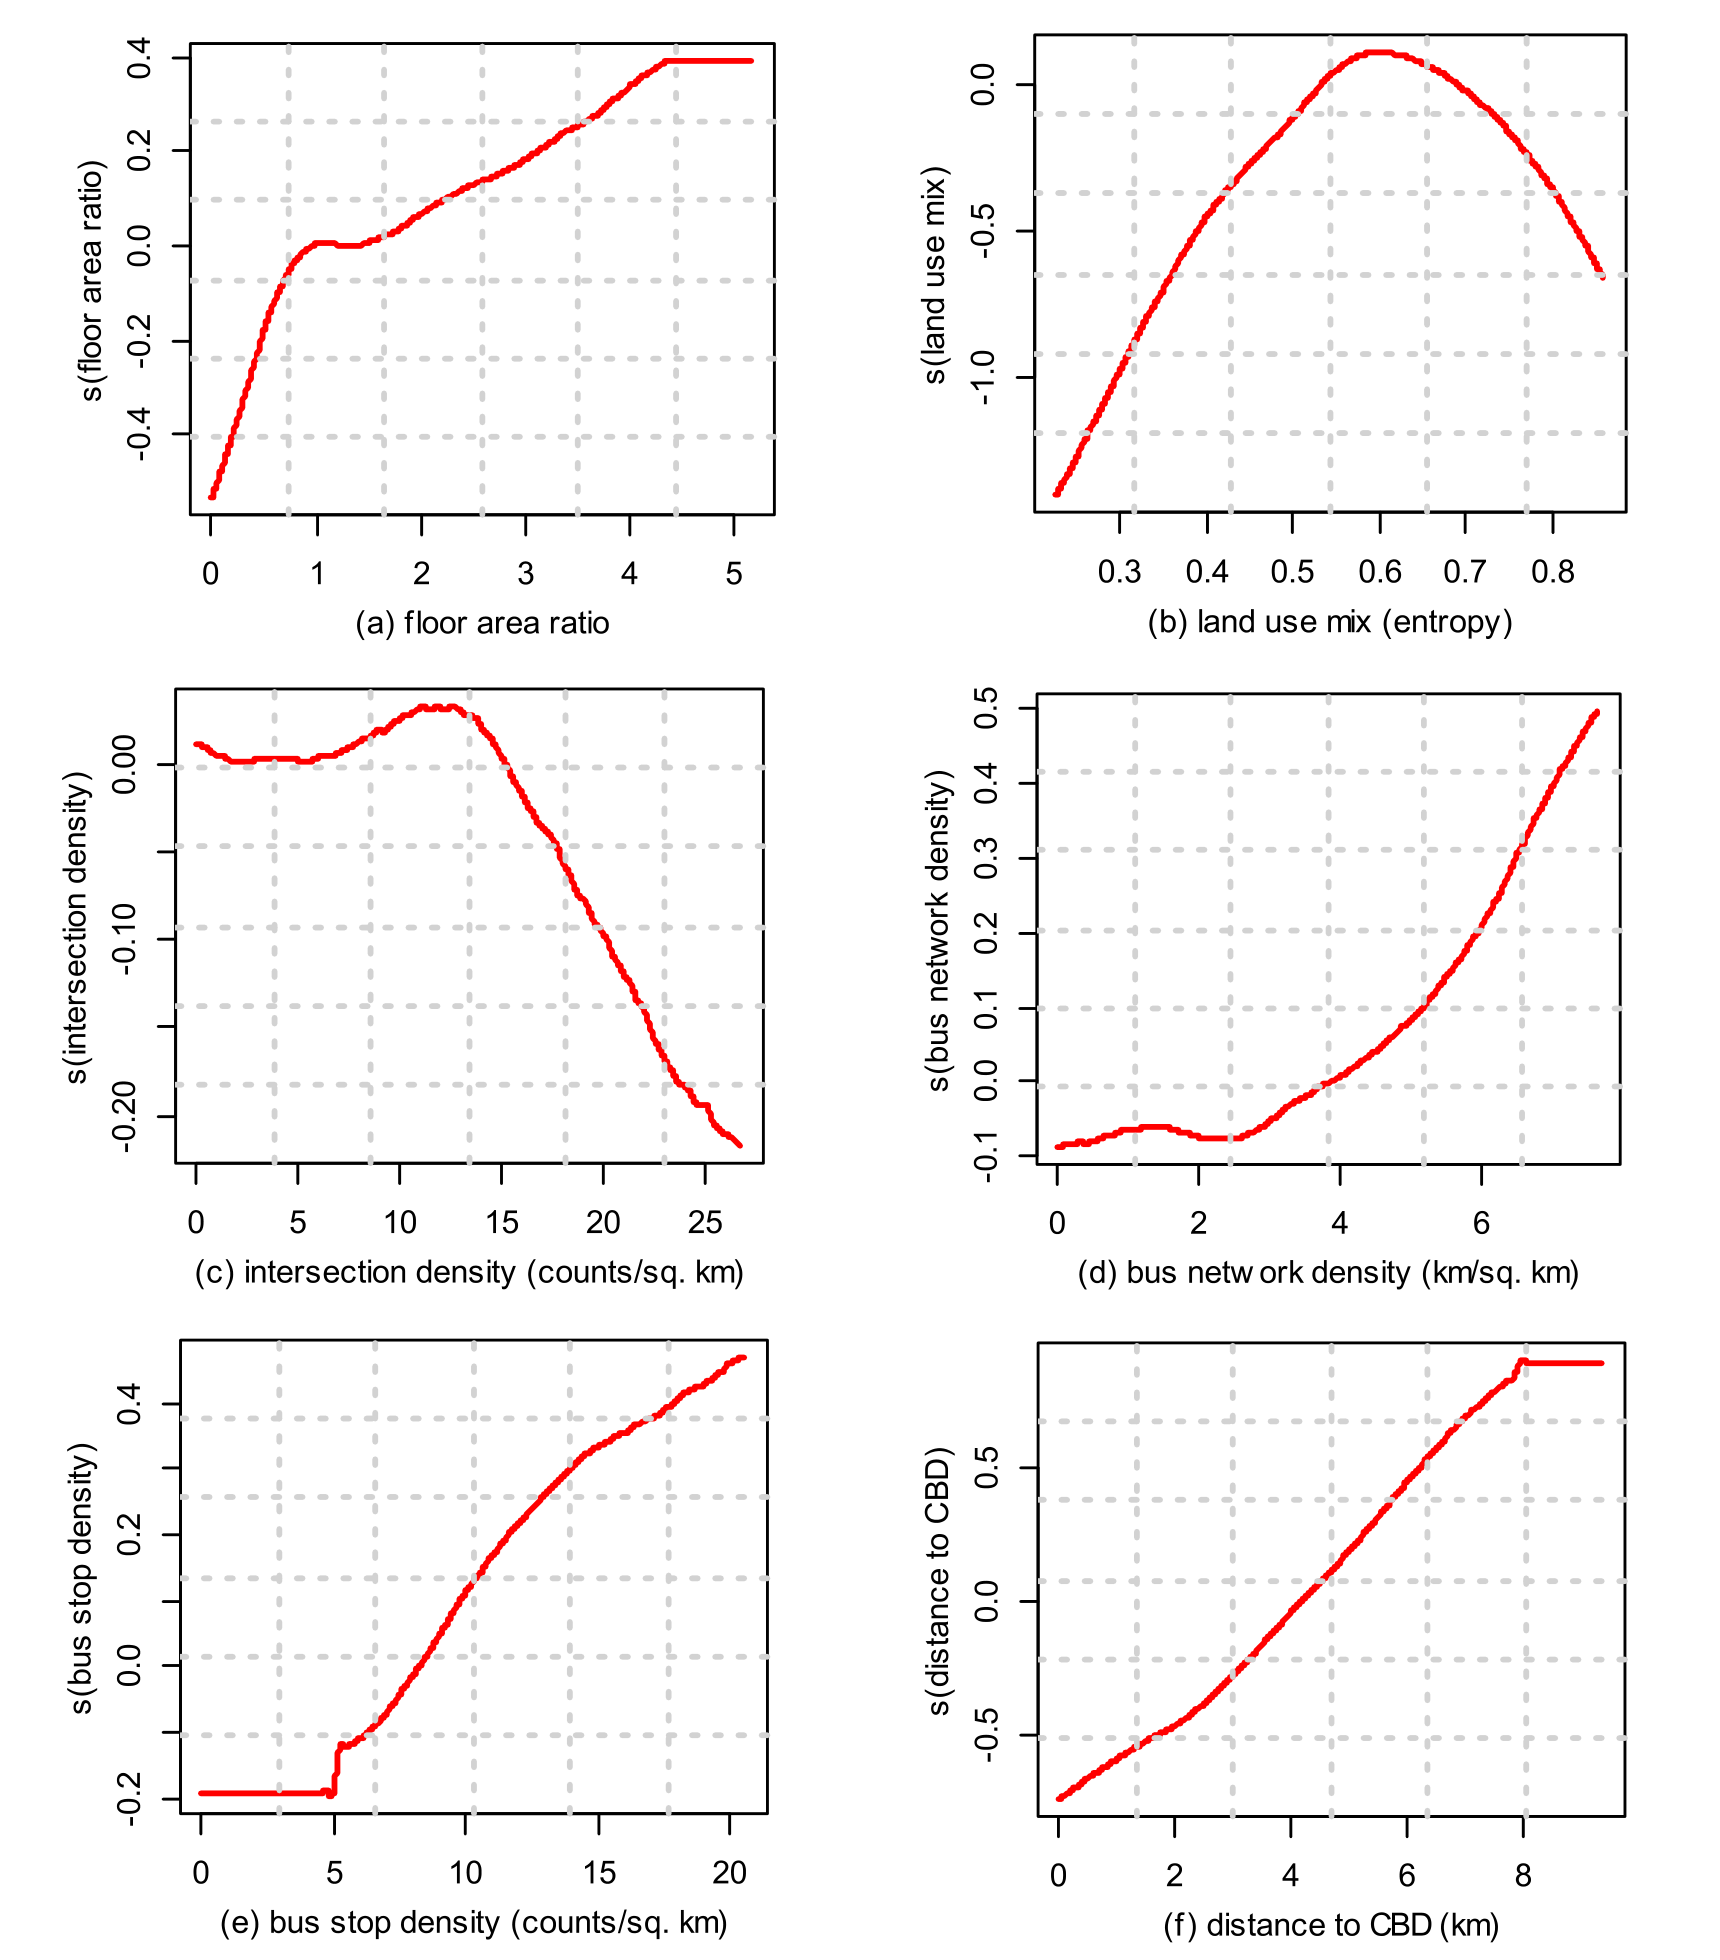
图 4|六个居住地指标与公交通勤效用的关系弯在哪里?
纵轴是各指标的平滑函数,因模型可识别性被居中到 0,读数是相对平均水平的效用贡献,不是选择公交的概率。图中是一条后验平滑曲线,没有画出置信带,也没有标出每个交通分析区的局部斜率。横轴单位见各面板。来源:原论文 Fig. 4。
(a)容积率从 0 到约 1 上升较快,1 到 4.3 仍上升但更平,超过 4.3 后边际贡献减弱,曲线在 4 以上接近走平。样本均值 1.43 落在较平的那段,不在最陡的 0–1。
(b)用地混合熵呈倒 V 形,约 0.60 达到高点;低于 0.60 时为正,高于 0.60 时为负。样本均值 0.61、标准差 0.09,平均通勤者所在的区就在这个高点附近。作者对右半段的解释是:混合提高职住平衡,步行和自行车会与公交竞争。北京的一项研究被用来支持这一方向,南京模型本身没有单独估计步行和自行车。
(c)交叉口密度在约 12 个/km² 以内与公交效用的关联很弱,超过之后转为负向。样本均值 5.36 个/km²,低于这个门槛。负向与一些元分析里“交叉口越密、公交越多”的平均结论不同。作者给出的机制是混合交通中公交车更慢,以及密路网更利于非机动方式。
(d)公交线网密度在约 2 km/km² 以内几乎不动,超过之后上升。作者用方格线网解释这个数:2 km/km² 大约对应线路间距 1 km,多数居民步行约 500 m 能碰到一条线,但单条线能到达的目的地有限。这是对密度数值的几何说明,不是南京线路间距的实测。样本均值 3.33 km/km²,已经位于上升的一侧。
(e)公交站密度在约 5 个/km² 以内几乎不动,超过之后上升。样本均值 7.17 个/km²,同样位于上升的一侧。
(f)到中央商务区的直线距离在约 8 km 以内上升,超过 8 km 后边际贡献减弱。样本均值 4.05 km。作者写,中心城区边界平均大约距中心 12 km,因此大约在这段距离的上三分位之后,距离不再带来额外关联。这是作者对 0–12 km 范围的粗略说法,论文没有报告样本距离的分位数。
把线性模型和这六条曲线放在一起,容积率、用地混合和线网密度的全市平均斜率不稳定,是因为正的一段和变平或转负的一段被合成了一个数。公交站密度和到中心的距离在线性模型里已经能看到平均方向,平滑曲线则补上它们从哪一个取值开始起变化。
这些拐点可以指导到哪一步?
作者把结果收成规划语言:低密度居住区提高容积率,与更高的公交通勤效用相对应,继续加到已经较高的容积率,边际关联变小。中等程度的用地混合对应曲线高点。公交站和线路要超过上述平台才对应更高的公交效用。到中心的距离在 8 km 内为正,作者据此写的是扩大公交服务覆盖,而不是鼓励城市继续向外摊。
证据等级也写在同一处。这是 2010 年的截面相关。人可以选择搬到已经符合自己出行习惯的区,论文没有处理居住自选择。模型处理了同一交通分析区内部的聚集,以及斜率在区之间的随机变异,没有处理相邻区之间的空间依赖,也没有处理分区边界怎样划会改变指标。随机斜率的标准差说明差异存在,论文没有给出哪些区为正、哪些区为负。
二元 logit 把公交以外的方式合在一起。因此容积率曲线上升,表示相对这组混合对照的公交效用上升;它没有说明小汽车出行减少了多少公里,也没有说明减少的是步行还是开车。曲线居中到 0,不能把纵轴上 0.2 的刻度直接换成 20 个百分点。
作者还写明,门槛能否用到规模和发展阶段不同的城市,需要另做研究。南京在文中被看作中国发展程度较高的城市,对欠发达地区只有类推意义。数据比论文发表早约十年,此后的地铁、共享单车和网约车不在这 3758 人的选择集合里。用地来自规划部门,作者认为这比只用兴趣点近似用地更准确;兴趣点仍参与了指标计算,论文没有单独报告两者不一致时的敏感度。
一句话总结
在 2010 年南京中心城区 3758 名通勤者中,居住地建成环境与是否选择公交通勤的关联随指标取值弯折,也随交通分析区变化:容积率的正关联会减弱,用地混合在熵约 0.60 转向,公交线网大约要过 2 km/km²、公交站大约要过 5 个/km²,曲线才明显上升。
核心来源
Ding C., Cao X., Yu B., Ju Y. Non-linear associations between zonal built environment attributes and transit commuting mode choice accounting for spatial heterogeneity. Transportation Research Part A, 2021, 148: 22–35. https://doi.org/10.1016/j.tra.2021.03.021
丁川(Chuan Ding),论文署名为北京航空航天大学交通科学与工程学院,以及北京航空航天大学大数据科学与脑机智能高精尖创新中心。贡献说明中负责资助、构想、方法、形式分析、初稿和修改,联系邮箱为 cding@buaa.edu.cn。北航教师主页将其研究方向写为建成环境与交通出行,并列出 2018–2024 年在该校任副教授。
Xinyu Cao,论文署名为美国明尼苏达大学双城分校休伯特公共事务学院,通讯作者,联系邮箱为 cao@umn.edu。贡献说明中负责构想、方法、形式分析和修改。学院公布的履历写明他自 2017 年起任该学院教授,研究集中在土地利用与出行。
于滨(Bin Yu),论文署名为与丁川相同的北航交通学院及上述高精尖创新中心。贡献说明中负责构想、数据整理和可视化,联系邮箱为 yubinyb@buaa.edu.cn。北航教师主页的于滨自 2016 年起在该学院工作,研究方向包括城市公共交通与交通大数据。
Yang Ju,论文署名为美国加州大学伯克利分校城市与区域发展研究所。贡献说明中负责构想和数据整理,联系邮箱为 yangju90@berkeley.edu。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
样本容积率均值 1.43,已经落在论文所说更平的 1–4.3 段。若一个区只是从 1.5 附近再提高零点几个容积率,按图 4(a)的形状,对应的效用增量会小于从不到 1 提高到 1 附近的那段。这只说明同一条平滑曲线的斜率在变,论文没有做“加容积率、再观察同一批人”的前后比较。
用地混合的样本均值 0.61,几乎贴在 0.60 的高点上,标准差只有 0.09。中心城区多数通勤者所在的区,位于曲线顶部一小段,而不是位于很单一或极混合的两端。此时再把“提高混合”一律理解成“提高公交”,读的是高点右侧;作者把右侧下降解释为步行和自行车分流,但分流没有在这个二元模型里被单独计次。
公交站和线网的样本均值已经高于 5 个/km² 和 2 km/km²。曲线在门槛以下的平台,主要由低于均值的那些区支撑。全市平均的正斜率,不能回答一个站密度仍低于 5 个/km² 的区,再增加一两个站会怎样。论文也没有列出这些低供给区的名单。随机斜率显著只证明区与区的关联有离散,规划若要知道自己那个区在分布的哪一侧,还需要论文没有给出的分区斜率。