两辆车进入通信范围之后,这次接触通常维持多久,下次还要再等多久?
论文名片|Yong Li、Depeng Jin、Lieguang Zeng、Sheng Chen,Revealing Patterns of Opportunistic Contact Durations and Intervals for Large Scale Urban Vehicular Mobility,IEEE International Conference on Communications (ICC) 2013,Ad-hoc and Sensor Networking Symposium,第1646–1650页。这是对北京、上海运营出租车轨迹的观测,以及接触时间分布的分段拟合。
想象路口上两辆出租车先后驶进大约一百米。这不是论文记录的某一次超车,只是用来看清它要测量的两个时间:车与车之间出现一次可以传数据的机会,随即又错开。机会接触(opportunistic contact)指的就是这种事:两车进入设定的通信范围,连接才临时出现;城市道路上往往没有一条一直保持的端到端路径。车辆延迟容忍网络(vehicular delay tolerant network,VDTN)因此要靠一次次相遇把数据往后送。能送多少,取决于两件事:这次接触维持多久,以及同一对车下一次再进入范围还要等多久。
人类移动研究里,接触能维持多久常被写成幂律(power law):很长的接触少,下降却比指数慢。车辆网络里一项上海出租车研究则把两次接触之间的间隔,写成大时间尺度上的指数分布。作者担心,把人类移动的模型直接拿去评估车辆转发,会因为两种移动差得远而得出误导性的结果。
这篇论文用2010年5月北京约27,000辆运营出租车的整月轨迹,对照2007年2月上海2,019辆出租车。接触时长的主体呈指数衰减,超过各城市的特征时间之后才变成幂律尾。接触间隔另分成三段,尾部才回到指数。时长和间隔各有自己的时间尺度。
先说结论
- 接触时长有一个特征时间:北京约100秒,上海约50秒。到这个时间为止的部分,至少占全部接触时长分布的80%,呈指数;更长的尾部在双对数图上接近直线,按幂律衰减。这与人类移动研究里接触时长整体服从幂律的报告不同。时长曲线印在作者另一篇快报里,本文没有重刊。
- 作者在两座城市、以及整月和单日两种汇总尺度上,都报告了这个先指数、后幂律的二分。本文没有给出幂律指数,也没有给出恰好对应80%的秒数。
- 接触间隔按 [0, 100) 秒、[100, 3000) 秒、[3000, 60000) 秒三段拟合。首段是复合函数 y = b·e^(x^a),中段是幂律,尾段是指数。表I里18个调整后R²的最低一格是97.92%;作者写三段的平均值都超过98%。
- 样本是所有车辆对上的逐次接触,合在一起做成汇总分布。几何上进入通信范围,就算一次潜在接触。本文没有统计实际传成的数据量,也没有比较每一对车各自的分布。
口袋里的手机相遇,为什么解释不了车?
车载网络里,内容常常要在没有持续连通的道路上传播。两车只有进入通信范围才能交换数据。接触时长(contact duration)是这一次机会持续的秒数,直接限制一次相遇能传多少。接触间隔(contact interval)是同一对车离开范围之后,到下一次再进入范围的等待。间隔从上次接触结束起算,不把正在接触的那段时长算进去。
已有人类移动测量把接触时长拟合成幂律,并用帕累托分布来描述。那些结果来自人携带设备的接触。本文的样本是出租车。车辆方面,有工作用交通仿真生成900秒的数据,考察通信范围和车辆比例对接触时长的影响;另有工作用1,600辆公交车、16天的记录,按接触角度给接触分类。作者认为,仿真片段和这条公交记录都还不足以刻画高速大城市里很短的接触。
接触间隔也已有一个大型实证:上海2,019辆运营出租车,间隔在很大的时间范围内呈指数分布。作者认为,约2,000辆车、并且载客时1分钟才上报一次,仍可能不够支撑接触时长的统计。他们的做法是保留这条上海轨迹,同时新采集北京约27,000辆车的一个月记录,把时长和间隔放在同一套处理里看。
两座城市的上报,各是什么节拍?
上海轨迹来自 SG 项目,2,019辆运营出租车覆盖2007年2月整月,中间没有中断。有乘客时每1分钟经 GPRS 上报一次位置,空车时每15秒上报一次,以便实时调度。作者指出,出租车多数时间并非空车,两种节拍混在同一条轨迹里,可能扭曲车辆实际怎么移动。
北京轨迹来自约27,000辆装有 GPS 的运营出租车,时间是2010年5月整月;数据一节写为27,000辆参与出租车。移动中的车每15秒上报一次。每条记录包含车辆标识、经纬度、时间戳、瞬时速度和航向。作者在文中称,北京轨迹是可得的最大车辆轨迹数据。这是这篇论文里的判断。
| 轨迹 | 车辆数 | 时段 | 上报节拍 | 本文用它看什么 |
|---|---|---|---|---|
| 北京 | 约27,000辆运营出租车 | 2010年5月整月 | 移动中每15秒 | 新采集的大规模轨迹 |
| 上海 | 2,019辆运营出租车 | 2007年2月整月 | 载客每1分钟,空车每15秒 | 已有轨迹,整月无中断 |
表中的数量是出租车辆数。接触次数、车辆对数量,以及有过接触的车辆比例,全文都没有给出。
作者选择出租车,是因为他们认为出租车对路网、信号控制和城市规划更敏感,空间和时间覆盖也宽于公交车和私家车。这是选择数据的理由。私家车和公交车的接触分布,本文没有测量。北京的15秒节拍写明针对移动中的车;车辆停下时怎样上报,文中没有说明。
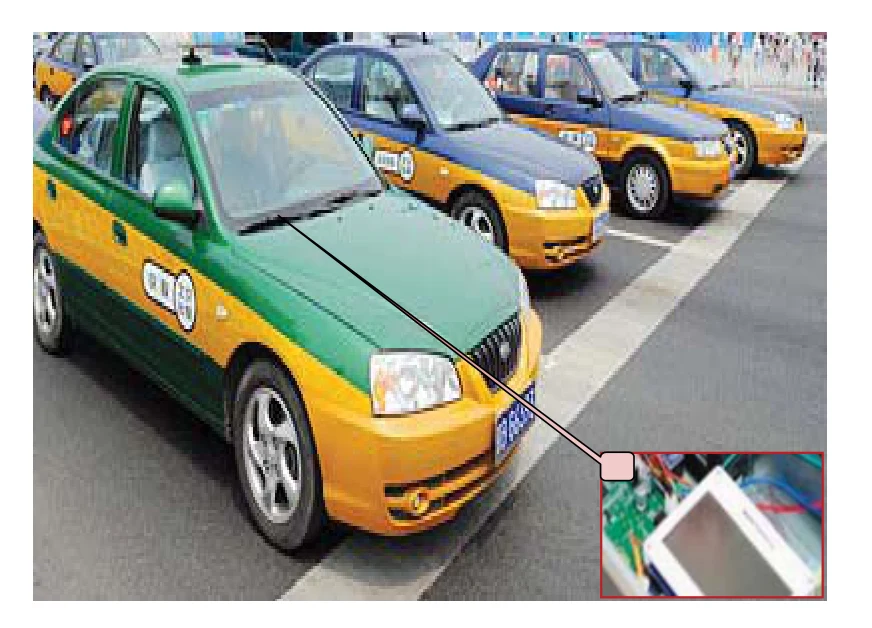
图 1|北京轨迹记的是哪一类车上的位置?
这张图没有子图字母。画面是一排运营出租车,引线从车顶设备连到右下角的电路与屏幕局部。它对应论文对采集系统的示意:位置由车上的接收和上报设备记下来,再汇入数据集。来源:原论文 Fig. 1。
进入范围的那一秒,记录里常常是空的
任意两车只要距离不大于设定的通信范围 R,定义里就认为它们可以通信。接触时长从距离刚好等于 R 的时刻起算,到随后第一次重新大于 R 为止。接触间隔从它们离开范围的时刻起算,到下一次距离再次不大于 R 为止。前者是一次接触有多长,后者是两次接触之间的空白有多长。
GPS 按离散时间到达。北京移动中的车每15秒一条,接触的开始和结束可能落在两条记录中间。作者因此在接触附近取点,至少包括接触之中、之前、之后各一点,用线性插值(linear interpolation)估计起止时刻;通常做三组估计再取平均。具体取点写在他们的另一篇快报里。插值假定接触附近两车距离近似按直线变化,例如在直路上一辆超过另一辆。弯道、路口减速是否仍然接近直线,本文没有分开检验。
提取时考虑了50、100、200、300米四种范围。后面的间隔图和表给出100、200、300米;50米的拟合数字没有列出。
他们看的是互补累积分布(complementary cumulative distribution function,CCDF):时长或间隔大于横轴时间的样本,占全部样本的比例。这里的一个样本,是某一对车上的一次接触时长,或一次接触间隔。所有不同车辆对的样本合在一起,叫做汇总分布。一对车如果反复相遇,就会贡献多个样本。后文说的分布都是这个汇总。每辆车单独一条曲线,或每对车各自的平均值,本文没有再分开报告。
距离进入范围,只表示几何上存在传数据的机会。干扰和信号丢失仍可能让传输失败。本文不讨论怎样保证传成,只讨论这些潜在机会的时间分布。
大多数接触为什么在一两分钟里就结束?
两座城市的接触时长 CCDF 画在双对数坐标上,图不在这篇会议论文里。作者写明,不同实验条件下的曲线见他们另一篇快报的图2至图4,并在本文给出从那些图读到的形状:尾部几乎是不同负斜率的直线,北京的转折大约在100秒,上海大约在50秒;整月和单日两种尺度上都有这个膝点。他们把膝点叫做特征时间(characteristic time)。
膝点之后,车辆接触时长的尾部同样呈现幂律,这一点与人类移动研究里已经报告的尾部相同。新的部分在膝点之前:CCDF 呈指数,并且这一段至少占整个接触时长分布的80%。分母是全部接触时长样本。80%是作者给出的下限。文中没有把它写成某个城市精确到小数的百分数,也没有把它写成80%的出租车。
因此时长分布被写成二分:特征时间以内是指数,超过之后是衰减的幂律尾。作者用指数和幂律去贴合经验数据,并认为这个形状在不同城市、不同汇总时间上都出现。贴合的调整后R²没有印在本文;“至少80%”不能改写成某个拟合优度。
作者推断,车辆通常比人移动得快,所以接触时长掉得更快。日志里虽然有瞬时速度,本文没有报告速度分布,也没有把时长对速度做回归。另一句推断是:两座城市的特征时间不同,可能反映路网和街道结构不同。两种说法都是对形状的解释,本文没有单独检验。
他们据此认为,按幂律长接触来设计的转发可能过于悲观,因为车辆接触的主体掉得更快。本文没有实现或比较任何转发协议,这个判断停留在分布形状的推论。
上海的时长特征时间约50秒,而载客时的上报间隔是60秒。北京的特征时间约100秒,移动中的上报间隔是15秒。两城秒数可以并排看,采样节拍的差别也摆在这里;作者没有把采样差别从路网差别里分离出去。
下一次再进入范围,为什么不能画成一条指数?
间隔的汇总 CCDF 印在本文图2和图3,同样是双对数坐标。作者把每条经验曲线分成三段:[0, 100) 秒、[100, 3000) 秒、[3000, 60000) 秒。100秒是1分40秒,3000秒是50分钟,60000秒是16小时40分钟。时长的特征时间约50秒或100秒;间隔用的是这另一组切点。
第一段用复合函数 y = b·e^(x^a) 来拟合。图的纵轴是接触间隔的 CCDF,横轴是时间;a 和 b 的数值没有给出。普通指数的指数部分是时间的一次项,这里的指数上还有 x 的 a 次方。中段用幂律,尾段用指数。中段和尾段之间有一个膝点,作者也把它叫做特征时间:在这个间隔特征时间之前呈幂律,之后是指数尾。这句话里的“之前”对应中段;最前面的100秒已经单独用复合函数去拟合,文中没有把这一段叫做幂律。
此前在上海轨迹上,接触间隔被概括成一条指数分布。那项工作用时间窗判断接触。本文认为窗太大会造出虚假接触,窗太小会漏掉真实机会,因此改用线性插值。北京和上海两条轨迹在这套处理下都呈三段。本文没有在同一批接触上并列时间窗和插值。上海这2,019辆车的轨迹,在本文的处理下同样呈三段;车队规模和提取方法是一起变化的,本文没有把二者拆开。
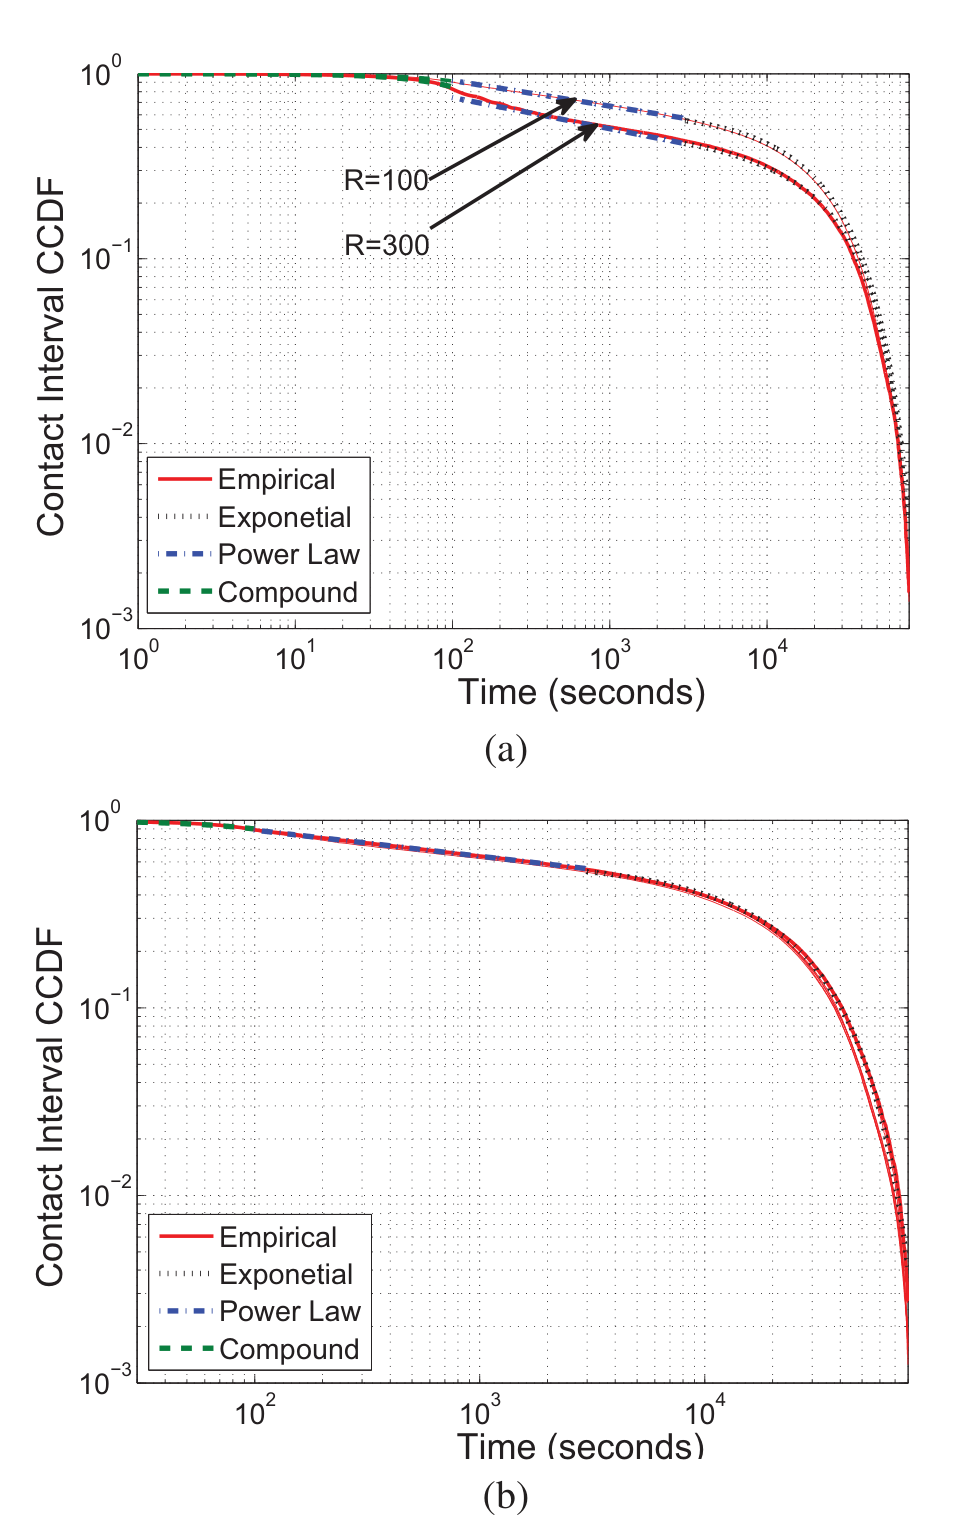
图 2|北京出租车的接触间隔,是一条指数曲线吗?
(a)2010年5月整月、全部车辆对的间隔 CCDF。横轴是时间,标出的刻度从10^0到10^4秒,轴向右还有一段;纵轴从10^0到10^-3。红实线是经验分布,点线是指数,蓝点划线是幂律,绿虚线是复合函数。图例里的指数一词印成 Exponetial。R=100米和 R=300米各有一条红线,箭头标在中段,两条线全程都很靠近,右端一起陡降。文中尾段拟合到60000秒,这个上界超过最后一个标出的10^4秒刻度。(b)通信范围200米、一周内每一天的间隔 CCDF。标出的时间刻度从10^2秒起,100秒以前的首段不在这张子图的刻度里。各日没有分开的图例,曲线叠成一束,读不出星期几更高或更低。来源:原论文 Fig. 2。
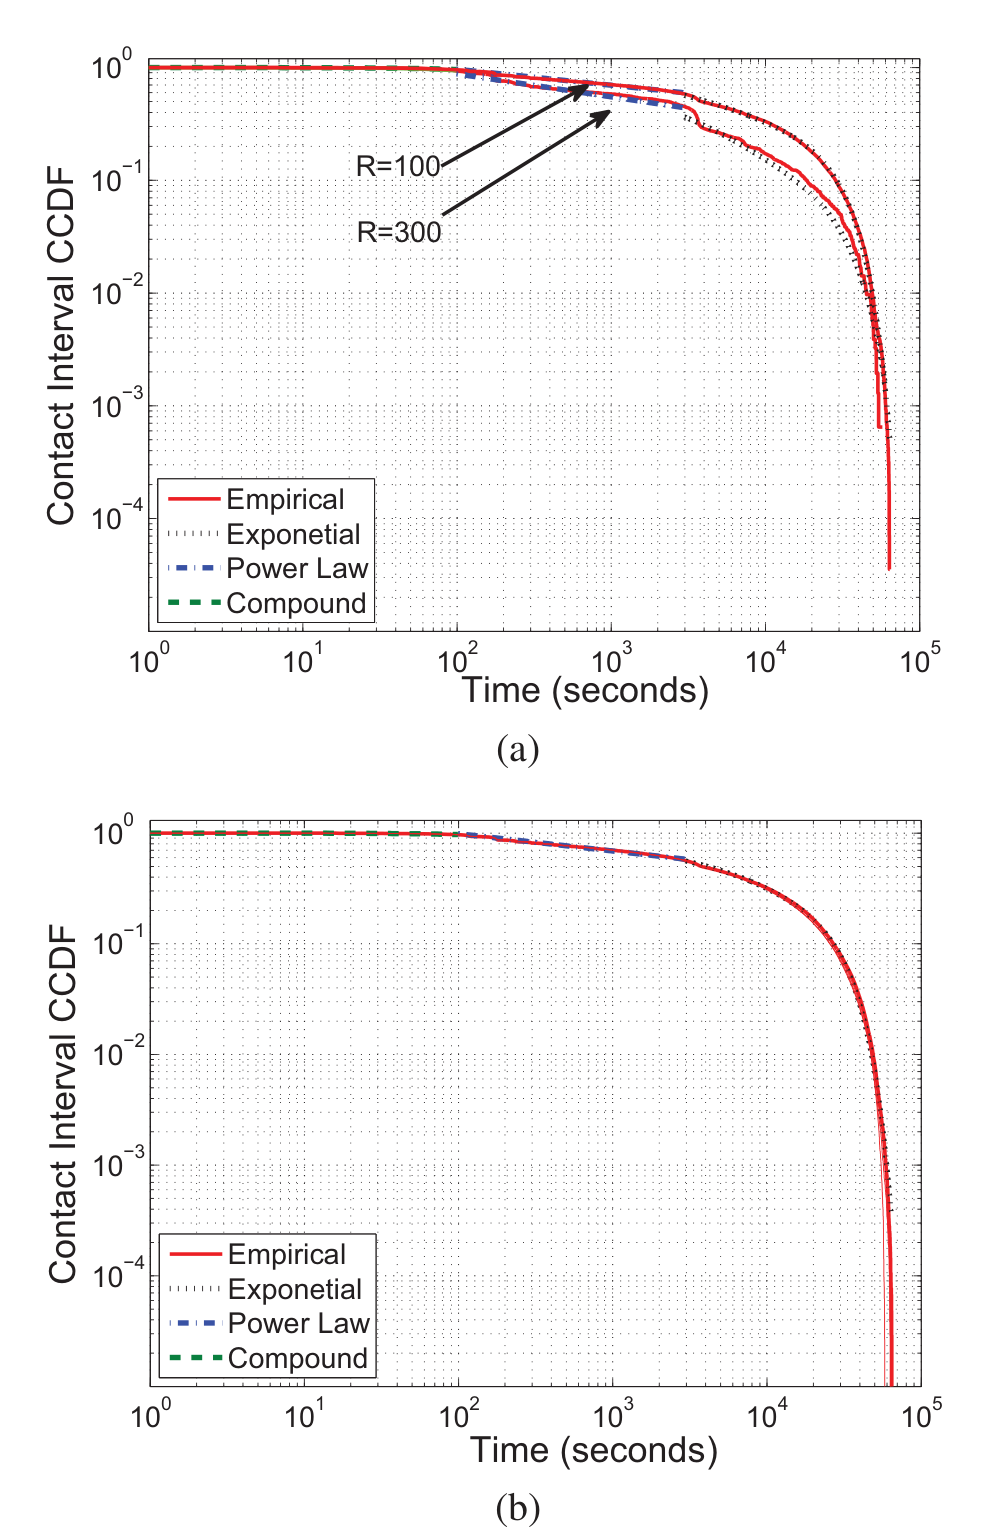
图 3|同一套三段划分,上海轨迹上还在吗?
(a)2007年2月整月的间隔 CCDF。时间刻度从10^0到10^5秒,纵轴向下标到10^-4。线型与图2相同。R=100米和 R=300米的红线在长间隔一侧分开:箭头把100米指到位置更高的那条,把300米指到下降更早的那条。纵轴更高,表示间隔长于该时间的样本占比更大。论文没有给出两条线的百分点差。(b)200米、一周内每一天。时间刻度从10^0到10^5秒。各日同样叠在一起,四条拟合线大部分贴着红线。上海纵轴比北京多向下一个数量级,这是坐标画到哪里,不能单独当成上海极长间隔更多的检验。来源:原论文 Fig. 3。
图2(a)里两条范围的红线几乎重合,图3(a)的长间隔一侧才明显分开。范围从100米增到300米会不会稳定地缩短等待,本文没有给出差值或统计检验。按日的子图把一周各日叠在一起,图上分不出某一天,也没有检验其他星期的工作日和周末。
表里的百分比,贴的是哪条曲线?
作者用调整后的R²衡量三段函数对图2、图3里经验曲线的贴合,数值在表I。这个百分比的分母是该段曲线的变异:越接近100%,所选函数越贴着这一段经验 CCDF。接触样本占全部样本的比例,对应的是前面时长分布里的“至少80%”,分母是全部接触时长样本。R²和80%各有各的分母。
表的行序按拟合函数排列:指数段对应间隔的尾段 [3000, 60000) 秒,幂律段对应中段 [100, 3000) 秒,复合函数段对应首段 [0, 100) 秒。每个城市、每种范围只有一格,一周中的各日没有分开的R²。R=200米只出现在按日的子图里。
| 轨迹与区段 | R = 100米 | R = 200米 | R = 300米 |
|---|---|---|---|
| 北京,指数段(尾) | 99.61% | 99.99% | 99.99% |
| 北京,幂律段(中) | 99.32% | 99.69% | 99.46% |
| 北京,复合函数段(首) | 99.29% | 99.41% | 99.68% |
| 上海,指数段(尾) | 97.92% | 99.66% | 99.54% |
| 上海,幂律段(中) | 98.04% | 98.78% | 98.38% |
| 上海,复合函数段(首) | 99.81% | 99.95% | 99.88% |
18格里最低的是上海尾段、100米的97.92%。作者写,三段的平均调整后R²都超过98%,没有列出平均的算法。因此“超过98%”说的是平均,表内仍然有一格低于98%。50米范围不在这张表里。
分段界线先划定,再在每一段里计算R²。高贴合说明在这些界线上,对应函数跟得上经验曲线。它没有证明100秒、3000秒、60000秒是唯一合理的切点,也没有给出一个未分段的指数模型与三段模型的正式比较。产生这种形状的道路、速度和区域因素,作者明确留给后续研究。
这些形状能用到哪一步?
能从这两条轨迹里读到的,是出租车汇总样本上的时间形状:时长在约50秒或100秒以前以指数为主,并且这一头至少占时长分布的80%;间隔则在100秒、50分钟和16小时40分钟三档上换函数。两座城市、整月和单日都进入了这个描述。
对象是2007年2月的上海出租车和2010年5月的北京出租车,年份、季节和上报节拍都不同。作者用出租车对路网更敏感来解释选样。私家车和公交车是否服从同一分布,本文没有测量。北京15秒记录针对移动中的车;车辆停下时怎样上报,文中没有说明,静止并排是否进入接触样本也就无法从本文确认。作者写明上海出租车多数时候并非空车,因而多数位置更接近60秒一条。这个节拍和上海约50秒的时长特征时间处在同一量级。
分布由全部车辆对的逐次样本合成。反复相遇的车对会贡献更多点,接触频繁的车对因此可能拉动汇总曲线。各车对的样本份额,文中没有给出。作者把分对分布、分时段和分区域的差别列为尚待研究的问题。进入100米或300米,记的是几何上的潜在机会。链路上传成多少字节,本文没有测量。线性插值依赖接触附近距离近似直线变化。转发协议是否因此该改,本文没有做实验。
一句话总结
城市出租车的接触时长里,至少有80%的样本落在各自城市的特征时间以内,这一段呈指数;同一对车再进入通信范围的等待,则按100秒、50分钟和16小时40分钟分成三段,尾部才是指数。
核心来源
本文:Yong Li、Depeng Jin、Lieguang Zeng、Sheng Chen,Revealing Patterns of Opportunistic Contact Durations and Intervals for Large Scale Urban Vehicular Mobility,IEEE ICC 2013,Ad-hoc and Sensor Networking Symposium,第1646–1650页。
接触时长的 CCDF 和线性插值的具体取点,作者指向 Y. Li、D. Jin、Z. Wang、L. Zeng、S. Chen,Exponential and Power Law Distribution of Contact Duration in Urban Vehicular Ad Hoc Networks,IEEE Signal Processing Letters,2013,20(1),第110–113页。这篇快报的作者名单里有 Zhaocheng Wang。ICC 论文只在致谢里写到 Professor Zhaocheng Wang 对本文工作有贡献;会议论文的署名作者是前面四位。
接触间隔被概括为指数分布的对照,来自 H. Zhu 等,Impact of traffic influxes: Revealing exponential inter-contact time in urban VANETs,IEEE Transactions on Parallel and Distributed Systems,2011,22(8),第1258–1266页,使用的是上海2,019辆出租车。人类移动中接触时长的幂律,作者引用 W. Wang、V. Srinivasan、M. Motani 在 MobiCom 2007 的接触探测研究,以及 A. Chaintreau 等人2005年剑桥大学计算机实验室技术报告 UCAM-CL-TR-617。本文没有重分析那些人类轨迹。
Yong Li(李勇)是本文第一作者,署名为清华大学电子工程系、清华信息科学与技术国家实验室(TNLIST)。院系主页与本文使用同一邮箱,并写明他2012年在清华大学获得电子工程博士学位,现为该系教授,研究包括移动计算与机会网络。
Depeng Jin 的署名单位与 Yong Li 相同。2014年9月合作发表的 IEEE Transactions on Mobile Computing 论文在作者介绍中写明,他1995年和1999年在清华大学获得电子工程学士和博士学位,当时是电子工程系副教授、系副主任,研究通信与高速网络。
Lieguang Zeng 同样署名为清华大学电子工程系和 TNLIST。同一篇作者介绍写明,他1970年从清华大学毕业后留在电子工程系,当时为教授,研究方向同样是通信与高速网络。
Sheng Chen 在本文中署名为南安普顿大学电子与计算机科学系,以及吉达的阿卜杜勒阿齐兹国王大学。邻近论文的作者介绍写明,他自1999年起在南安普顿任教,研究方向包括自适应信号处理与无线通信,2008年当选 IEEE 会士。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若转发协议按幂律去期待一次很长的接触,它会把希望放在时长分布最右边的那一截。本文的文字结论是,至少80%的时长样本已经落在指数段里,北京这段大约到100秒,上海大约到50秒。把一条大消息拆成能在这段指数主体里传完的小块,还是继续等少见的长接触,会改变缓冲和重传的安排。轨迹里没有链路速率,这个说法不能换算成字节;要检验它,得在同一批接触上重放不同的消息长度。作者只指出基于幂律的方案可能过于悲观,没有做这次重放。
三段间隔也容易被讲成三种城市行为:100秒以内是还行驶在同一股车流里,100秒到50分钟是在附近道路上再次交会,50分钟到16小时40分钟混入了一天的作息。这是可以用数据否决的猜测。出租车若在车站或路口停成一排,时长会变长、间隔会变短,来源是静止靠近;“车开得更快,所以接触更短”覆盖不了这一情形。北京的15秒上报写的是移动中的车,静止段怎样进入样本,本文没有说明。要把速度写成机制,至少要把行驶中的超越和停车时的并排分开计数。本文没有这张表。
两城特征时间相差约50秒,作者提到可能与路网有关。另一条同样具体的可能是采样:上海载客时60秒一条,特征时间却约50秒,膝点落在主导采样间隔附近;北京15秒一条,100秒的膝点下面有更多位置点。若把上海空车的15秒记录和载客的60秒记录拆开,50秒这个膝点还在不在,就能看出它有多少来自城市结构,有多少来自上报节拍。这也是本文没有做的比较。汇总曲线本身不指向某一辆车下一次会遇见谁;分对、分区域的分布,作者已经写明尚待研究。