把绕远的公交改顺,出租车上的人就会下来吗?
论文名片|Yanchi Liu、Chuanren Liu、Nicholas Jing Yuan、Lian Duan、Yanjie Fu、Hui Xiong、Songhua Xu、Junjie Wu,Intelligent bus routing with heterogeneous human mobility patterns,Knowledge and Information Systems,2017,50:383–415,2016年4月27日在线发表。DOI:10.1007/s10115-016-0948-6。页眉作 Knowl Inf Syst (2017) 50:383–415。文末说明,初步版本曾被 ICDM 2014 接收。
小红门到前门,出租车可以走近路。若公交绕行、一路停靠,乘客会留在出租车上。较早的夜班公交研究常把出租车行程直接当成未来的公交需求,等于假设只要有一班车,出租车乘客就会上来。
这篇论文把问题收窄到起讫点对(origin–destination pair,OD 对):给定起点区域、终点区域和出发时段,在已经发生的公交加出租车行程里,有多大比例会落在公交上。比例随公交的距离、时间、票价和停站变化。作者再用这个比例,在预算内挑选线路,使预测的公交乘客数尽量高。预测乘客数来自同一套选择模型,开通之后有没有人真正改乘,不在这组实验的清点范围内。
先说结论
- 实验用的是北京 2012 年 8 月至 11 月的数据:29,964 辆出租车、1,900 万次载客行程,以及约 1,000 万次公交行程。城区线路网在合并同名或同地车站后是 1,250 个区域、3,855 条相邻连边。
- 按空间距离和兴趣点功能加权的逻辑回归,在全部 OD 对的十折交叉验证里 AUC 为 0.82;不按时段、也不加权的逻辑回归是 0.67。这里的分母是交叉验证的 ROC 曲线下面积,正文没有单独写明每一条样本是一次行程还是一个 OD 对。
- 2012 年 9 月 21 日起 8 条公交线改道,受影响的 86 个 OD 对上,同一模型在改道后的 AUC 降到 0.76。这是用改道前拟合、改道后检验,仍是选择概率的预测。
- 天空线找出 651 个线路问题较突出的 OD 对,每个时段大约 100 个。把出租车路线当作公交路线的上界后,图中多数 OD 对的公交概率差贴近 0.05;正文概括为平均提高 5%。客流增量集中在少数 OD 对。
- 在潜力最高的前 100 个 OD 对上,逻辑回归版改线给出的平均预测增量是每个 OD 对 732.5 次公交行程,最短距离线路是 450.2 次。两个数都是这 100 个 OD 对的平均数,先跨时段相加,再相对各自的历史公交行程。样本期没有被除成日均,也没有乘成全市总增量。
公交只能停在站上,出租车几乎能停在任何地方
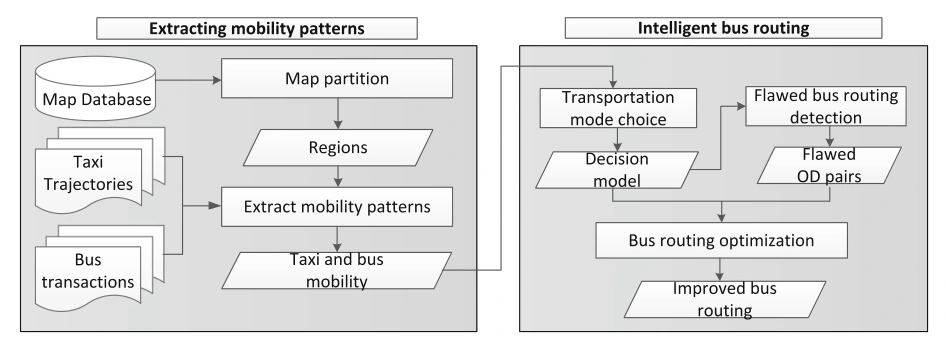
图 1|从轨迹到改线,论文把工作分成哪两段?
无字母子图。左侧用地图、出租车轨迹和公交刷卡抽出区域间的出行;右侧用方式选择模型找出线路有问题的 OD 对,再在约束下改线。框架图本身不带客流数字。来源:原论文 Fig. 1。
公交有固定站,出租车的上下车点散落在路上。两边的轨迹要对到同一套区域,改线才知道“这一片的出租车需求”可能被哪一个车站接住。作者假定车站位置大体合理:一个人若从出租车换成公交,首先会去最近的车站。这个假定把步行越过河流、高速或封闭街区的情况留在区域划分之外。
同名车站,或名称不同但实际在同一地点的车站,先合并。明光桥北和明光桥南就是例子:向北的车停北站,向南的车停南站,论文把它们收成明光桥一个点。
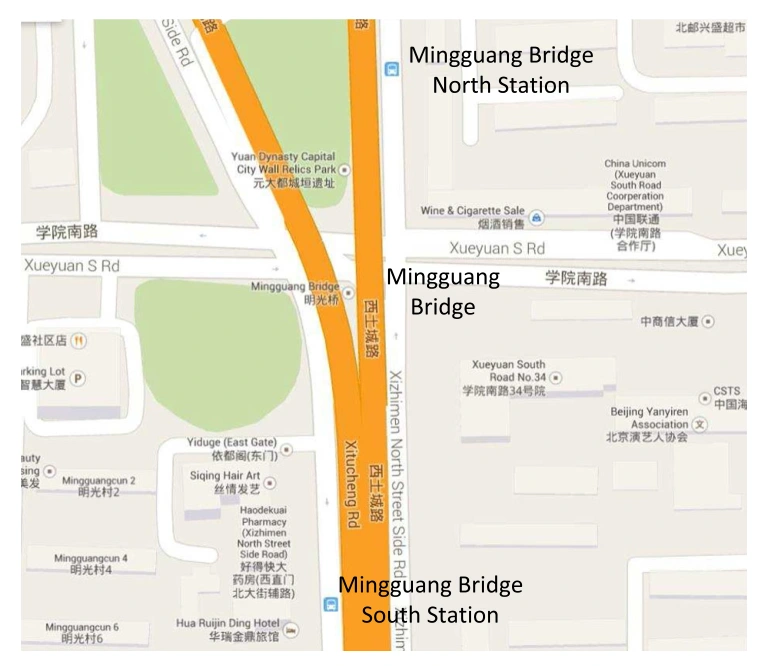
图 2|路两侧的站,为什么要收成一个区域?
无字母子图。图中标出明光桥北站、明光桥和明光桥南站。向北与向南的停靠被合成一个代表明光桥的节点,后面的区域划分才不会把桥的两侧算成互不相关的需求。来源:原论文 Fig. 2。
合并后的车站作为种子,用 Voronoi 图把城区切成互不重叠的区域:每个地点划给直线距离最近的车站。出租车的上下车点落入所在区域。城区原始数据有 2,427 个车站、1,058 条线路;合并后得到 1,250 个车站,也就是 1,250 个区域。路网有 196,307 个路段,用来连接相邻区域,得到 3,855 条不经过其他区域的连边。连边上没有“这是哪一路车”的信息,线路是后面要重新排的。
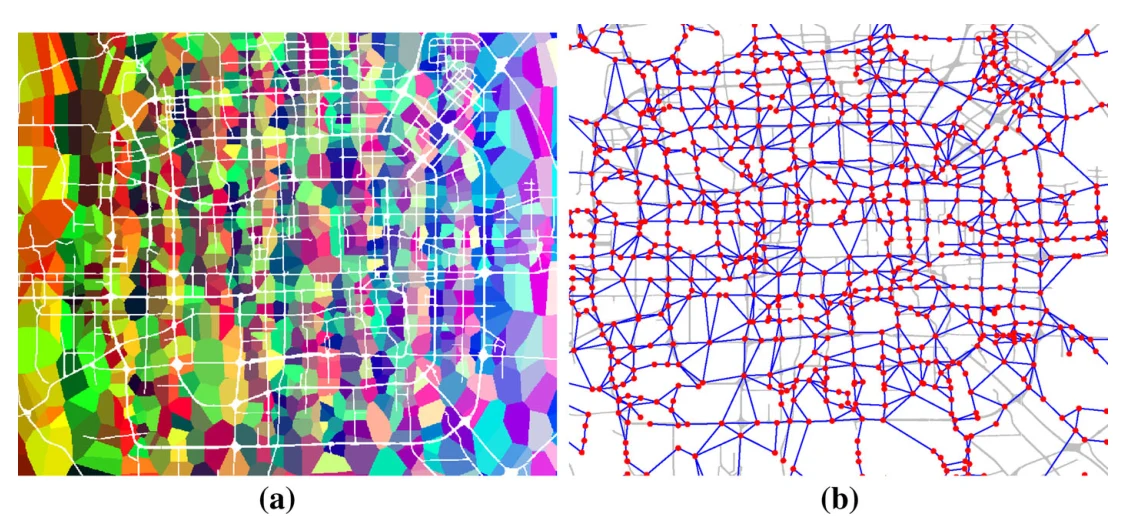
图 3|1,250 个车站把北京切成了什么样的服务区?
(a)按到车站的距离划分的城区,颜色区分相邻区域。(b)红点为车站节点,蓝线为相邻车站之间的直接连边。这是后面所有 OD 对和改线共用的底图;颜色不表示客流。来源:原论文 Fig. 3。
一次出行被记成一条转移:起点、终点、方式(0 为出租车,1 为公交)、出发与到达时间、行程距离、票价、停站数。出租车距离是轨迹上连续 GPS 点的道路距离之和,公交距离是连续停靠站的道路距离之和。
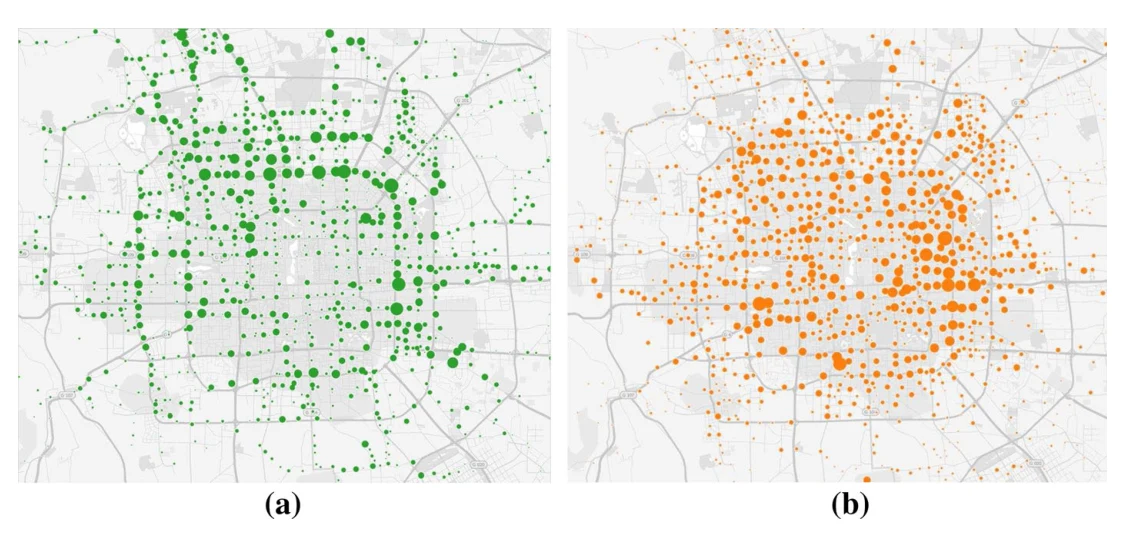
图 4|两种方式的起点,挤在城市的同一批地方吗?
点的大小对应该处起点行程数。(a)公交起点。(b)出租车起点。公交在西南一带也有成片起点,出租车更挤在中心城区。后文挑选的问题 OD 对,会回到这张对比上:有的方向出租车很多、公交很少。来源:原论文 Fig. 4。
行程规模以表 4 为准。出租车:29,964 辆,有效天数 114 天,其中工作日 77 天、周末 37 天,时间写为 2012 年 8 月至 11 月;载客 GPS 点 3.33 亿个,载客行程 1,900 万次,总里程 1.56 亿公里。公交刷卡:车站数 7,810,持卡人 701,250,行程 1,000 万次,时间同为 8 月至 11 月。7,810 是刷卡数据里的车站数,和城区线路使用的 2,427 个车站不是同一个口径。
贡献段另写“约 3 万辆出租车”和“2012 年 8 月至 10 月”。实验设置和表 4 使用的是 29,964 辆与 8 月至 11 月。全文按后一组数字理解样本。
另有一条脚注:用随机抽样恢复公交行程,以便和出租车行程对齐,并引用北京市交通委页面称公交与出租车行程之比约为 3.5∶1。表 4 里实际进入分析的是约 1,000 万次公交和 1,900 万次出租车载客。两者并排写在论文里。按表 4 相加,公交占公交加出租车行程的 10/(10+19),约 34%。后文箱线图的中位 OD 对比这个全市行程份额高,因为那是 OD 对之间的分布,出租车行程可以集中在少数对上。
方式选择被明确写成 OD 对上的群体行为。模型学习的是这一对区域、这一时段的公交比例。持卡人的下一次目的地不在模型里。
通勤高峰和周末,一天里的份额各是什么形状?
工作日和周末(文中周末含中国的公共假期)去的地方不同,一天里的方式偏好也不同。作者先把一天切成 48 个半小时,再按公交与出租车各自的人数、以及速度相对全天平均的起伏,并成 7 个时段。同一时段里,出行的含义被看作相近。23 时到次日 5 时公交很少,研究只覆盖 5 时到 23 时的日间线路。
| 时段 | 日期类型 | 时钟时间 |
|---|---|---|
| 1 | 工作日 | 5:00–10:30 |
| 2 | 工作日 | 10:30–16:00 |
| 3 | 工作日 | 16:00–19:30 |
| 4 | 工作日 | 19:30–23:00 |
| 5 | 周末 | 5:00–12:30 |
| 6 | 周末 | 12:30–19:30 |
| 7 | 周末 | 19:30–23:00 |
时段在成本里还有一个时间权重 STime。正文只给出时段 1 的例子:STime¹ = 5 × 5.5 小时,即每周 5 个工作日、每天 5.5 小时。其余时段没有逐个写出算式。
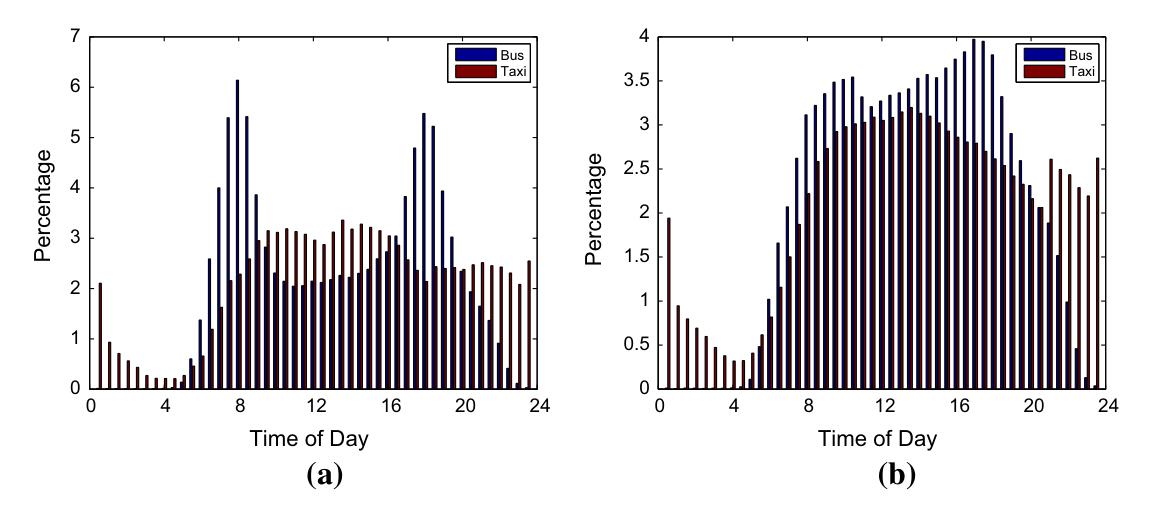
图 5|早晚高峰的公交柱,在各自的全天行程里占多大一块?
纵轴百分比按公交、出租车分开计算,横轴为时刻。(a)工作日,纵轴画到 7。公交在 8 时前后越过 6 的刻度,傍晚另有一簇高柱;出租车全天较平。(b)周末,纵轴画到 4。公交从上午铺到下午,最高处接近纵轴顶端。柱高是该方式当天行程在这个半小时的份额,公交与出租车分开归一化。来源:原论文 Fig. 5。
速度用来把出租车观测换算成公交在连边上的行驶时间。表 3 是各时段的平均速度,单位 km/h。λ 是公交平均速度除以同一时段的出租车平均速度。
| 时段 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
| 公交 | 21.66 | 21.97 | 20.75 | 24.25 | 22.79 | 21.43 | 24.04 |
| 出租车 | 31.95 | 32.65 | 27.08 | 37.34 | 37.25 | 31.54 | 38.65 |
| λ | 0.68 | 0.67 | 0.77 | 0.65 | 0.61 | 0.68 | 0.62 |
连边上的公交速度写成 λ 乘以该连边的出租车速度。行驶时间等于距离除以这个公交速度。论文把停站耗时看作已经包含在 λ 里,因此额外停站时间常数取 0 分钟。距离不随时段变化,时间会变。
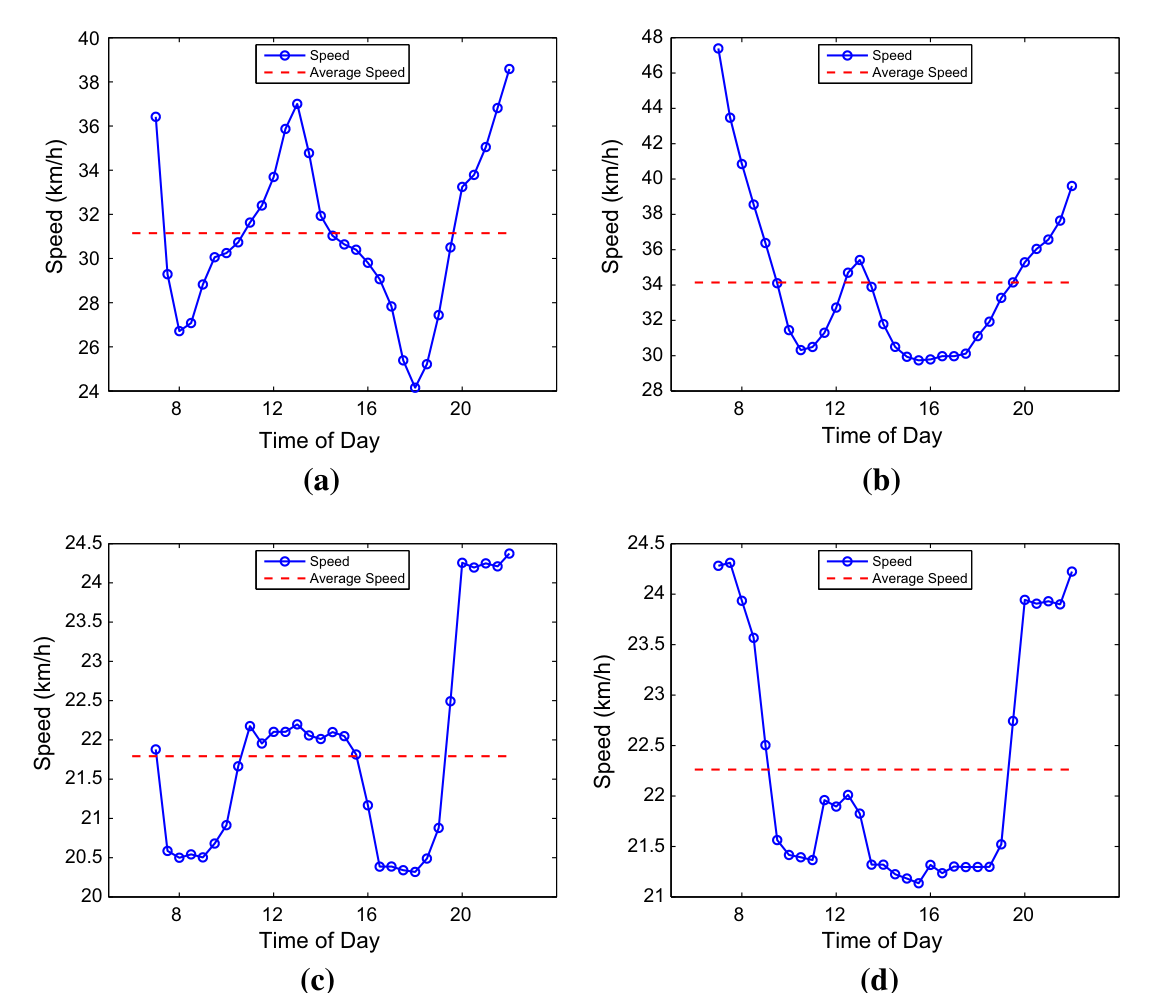
图 6|速度在一天里怎么掉下去,又在什么时候回到平均线以上?
蓝线为速度,红虚线为图中的平均速度。纵轴都是 km/h。(a)工作日出租车,傍晚低点贴着 24 的刻度,夜间升到 38 以上。(b)周末出租车,早晨接近 48,午后降到 30 附近,红虚线横在纵轴中部。(c)工作日公交,纵轴从 20 画到 24.5,傍晚接近 20.5,20 时以后升过 24。(d)周末公交,午前从 24 以上掉到 21 出头,晚间再升回 24 附近。虚线是各面板自己的平均速度。表 3 给出的是时段平均,两套速度并列使用。来源:原论文 Fig. 6。
每个 OD 对、每个时段、每种方式分别汇总六项:行程量、平均行程时间、平均距离、平均速度、平均票价、平均停站数。出租车停站数记为 0。公交行程量 BVol 与出租车行程量 TVol 相加,得到该对、该时段的总行程 Vol。后面的选择概率,分母就是这个 Vol。
绕路、多停、票价一高,公交份额就往下走
作者假定舒适、安全这一类感受在改线前后不变,只把和线路有关的量放进特征。一个 OD 对在时段 c 的特征向量是七个数:出租车距离、公交距离与出租车距离之比、出租车时间、公交时间与出租车时间之比、出租车票价、公交票价与出租车票价之比、公交停站数除以出租车距离。
出租车距离被当作这条 OD 对的道路距离基线,理由是熟练司机选出的路通常较短。比值大于 1,表示公交比出租车更远或更久。停站用每公里个数,而不是停站总数,以免长途天然停得更多。
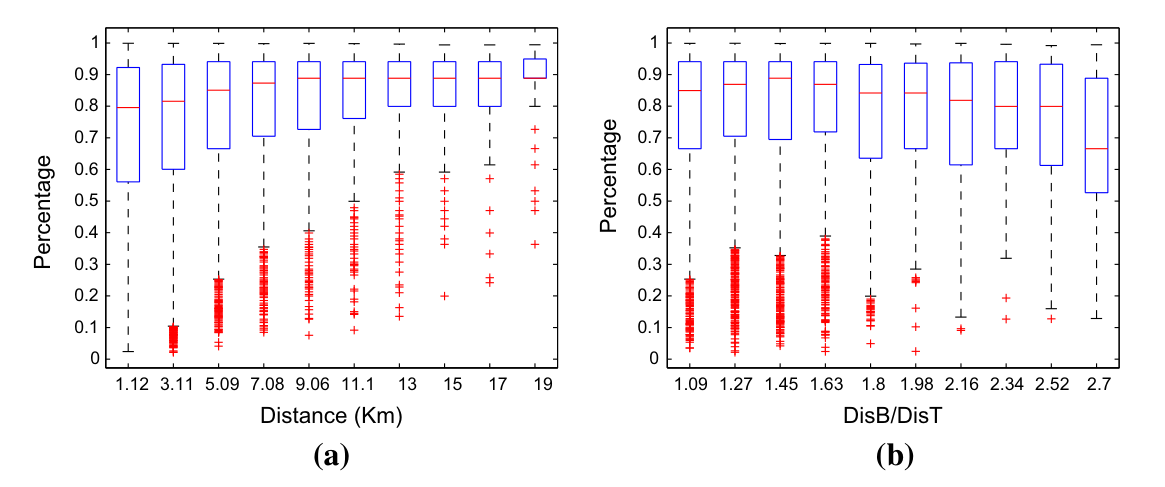
图 7|路更长时,OD 对的公交占比往哪边走?
纵轴是公交占比,箱线概括一批 OD 对,红色加号是低占比离群点。(a)横轴为出租车距离,刻度从 1.12 km 到 19 km。箱体位于纵轴上部,随距离右移略升。(b)横轴为公交距离除以出租车距离,刻度从 1.09 到 2.7。比值变大时箱体下移。正文的概括是:距离变长,公交占比上升;公交相对绕得更远,公交占比下降。来源:原论文 Fig. 7。
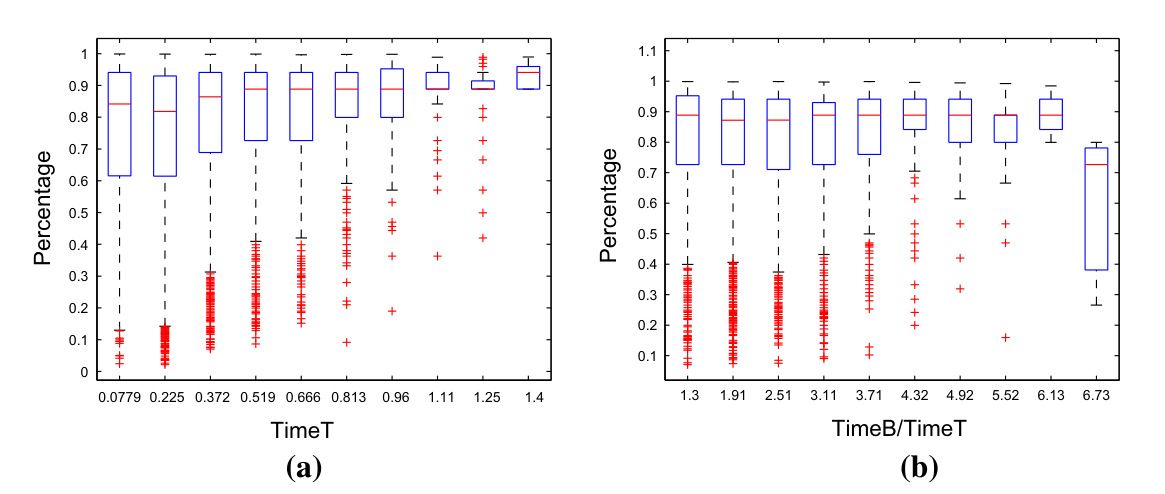
图 8|出租车更久,或者公交比出租车更久,占比怎么变?
(a)横轴 TimeT 从 0.0779 到 1.4,图上没有单位。箱体位于纵轴上部,向右略升。(b)横轴为公交时间除以出租车时间,从 1.3 到 6.73。最右一箱明显低于前面各箱,下须伸到纵轴中部以下。正文概括为时间变长则公交占比上升,公交相对更慢则占比下降。来源:原论文 Fig. 8。
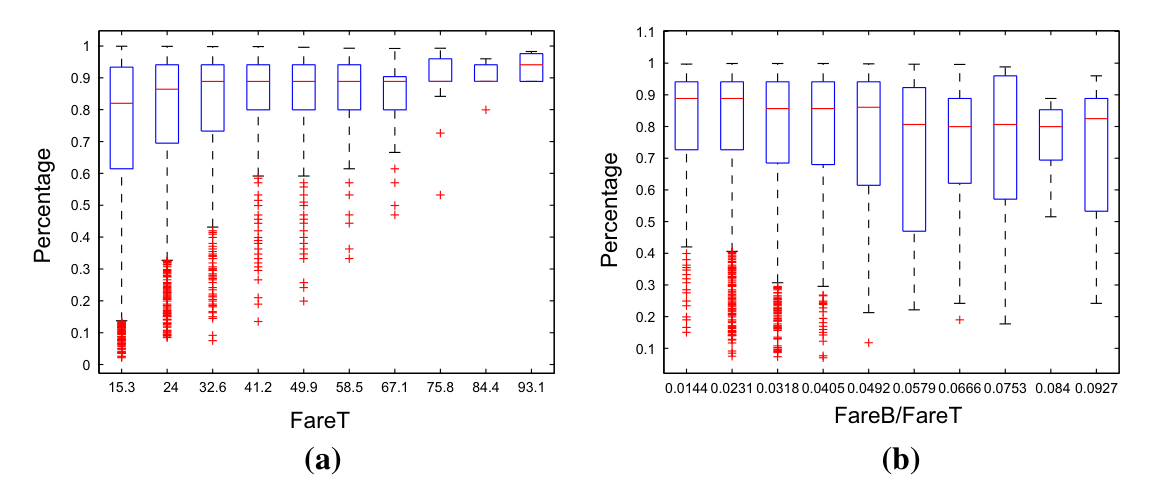
图 9|出租车票价升高时,公交占比为什么跟着升高?
(a)横轴 FareT 从 15.3 到 93.1,图上没有单位。箱体保持在纵轴上部。正文的解释是长距离上出租车比公交贵得多。(b)横轴为公交票价除以出租车票价,刻度从 0.0144 到 0.0927。比值增大时低占比离群点仍在,正文概括为选择公交的人减少。来源:原论文 Fig. 9。
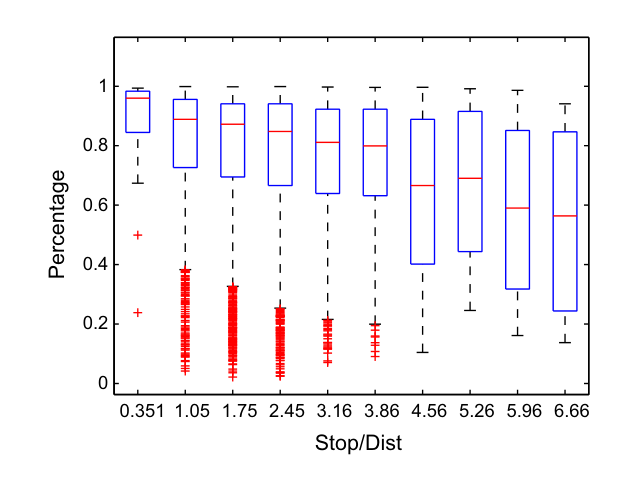
图 10|每公里多停几站,箱体从什么位置开始明显下移?
无字母子图。横轴是公交停站数除以出租车距离,刻度从 0.351 到 6.66。左端箱体靠近纵轴顶部,中位红线向右持续下移,红色低值点集中在左侧几箱。正文写:每公里停站增加,公交占比下降得很快。来源:原论文 Fig. 10。
这四张图描述的是现有线路上、OD 对之间的占比。它们说明七个特征的方向,还没有证明把某一条线改短之后,同一批人会按箱线的斜率改乘。
相邻、功能相近的起终点,可以互相借用选择习惯
选择概率写成逻辑函数:p = 1 / (1 + exp(−z)),z 是特征向量和一组系数的内积。每个 OD 对、每个时段各有自己的系数。估计某一对的系数时,用上全部 OD 对的历史占比,但距离近、功能近的对权重大。
权重是两段指数的乘积。空间距离 α 等于“两个起点的直线距离”与“两个终点的直线距离”的平均。功能距离 β 用兴趣点(point of interest,POI)数量向量的余弦距离,同样对起点、终点取平均。余弦距离 = 1 − 两个向量夹角的余弦。2012 年北京兴趣点分成 10 类,例如居住 29,246、工作 71,915、教育 15,489、餐饮 36,723、购物 56,520。权重随 α、β 增大而下降,下降快慢由带宽 hα、hβ 控制。正文没有给出北京实验里这两个带宽的数值。
另有一个把逻辑函数换成线性函数的版本,为的是后面求解更快。线性输出可以落在 0 到 1 之外,使用时要记住它是计算上的近似。
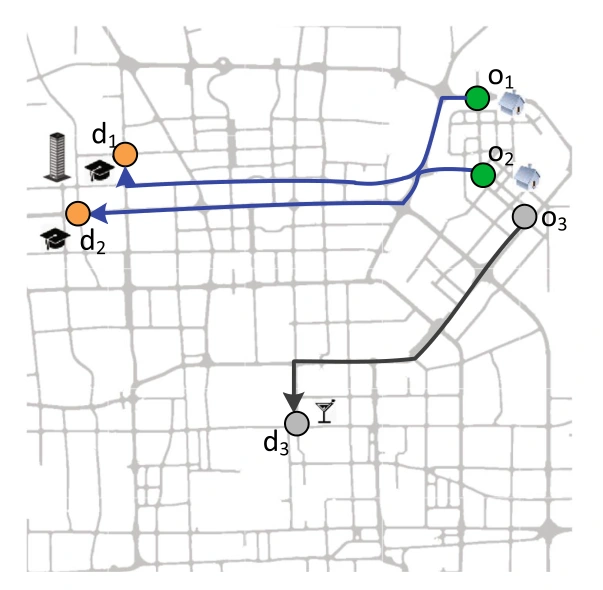
图 11|为什么给大学附近的 OD 对更高的权重?
无字母子图,是示意图。o1、o2 通向标有大学符号的 d1、d2,o3 通向标有酒杯的 d3。学习 (o1, d1) 时,(o2, d2) 的权重大于 (o3, d3)。图中的房屋、学位帽和酒杯表示作者假定的功能差异,不是从兴趣点统计里读出的客流。来源:原论文 Fig. 11。
模型分得清公交和出租车,换一批真实改过的线呢?
比较对象有五个。LoR 把全天当成一个时段做逻辑回归。TLoR 分时段做逻辑回归。TLiSVM 分时段做线性支持向量机。SFWLiR 是空间–功能加权的线性回归,SFWLoR 是加权逻辑回归。ROC 的阈值从 0 到 1、每隔 0.01 取一次。敏感度 = 真阳性 /(真阳性 + 假阴性),特异度 = 真阴性 /(真阴性 + 假阳性)。每个时段单独做十折交叉验证,再把各时段平均,作为图 15a 的总结果。
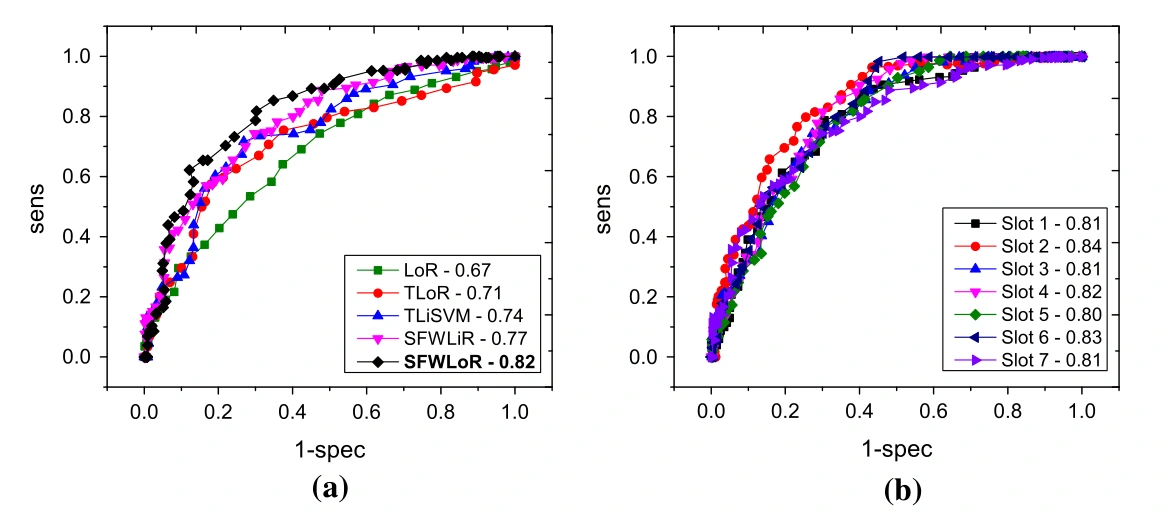
图 15|加权之后,曲线下面积比全市一个模型高多少?
纵轴为敏感度,横轴为 1 − 特异度,图例数字是 AUC。(a)LoR 0.67,TLoR 0.71,TLiSVM 0.74,SFWLiR 0.77,SFWLoR 0.82。(b)SFWLoR 在七个时段的 AUC:时段 1 至 7 依次为 0.81、0.84、0.81、0.82、0.80、0.83、0.81。作者写工作日(时段 1–4)好于周末(时段 5–7)。列出的七个数里,最高是工作日时段 2 的 0.84,最低是周末时段 5 的 0.80;周末时段 6 为 0.83,高于时段 1 和时段 3。来源:原论文 Fig. 15。
交叉验证打乱的是同一时期的 OD 对。更接近“线路变了以后还准不准”的一次检验来自真实改道:2012 年 9 月 21 日起,城区 8 条公交线调整,日期落在 8 月至 11 月的样本中间。改道前的数据训练,改道后的数据测试,并选出 86 个受影响的 OD 对。
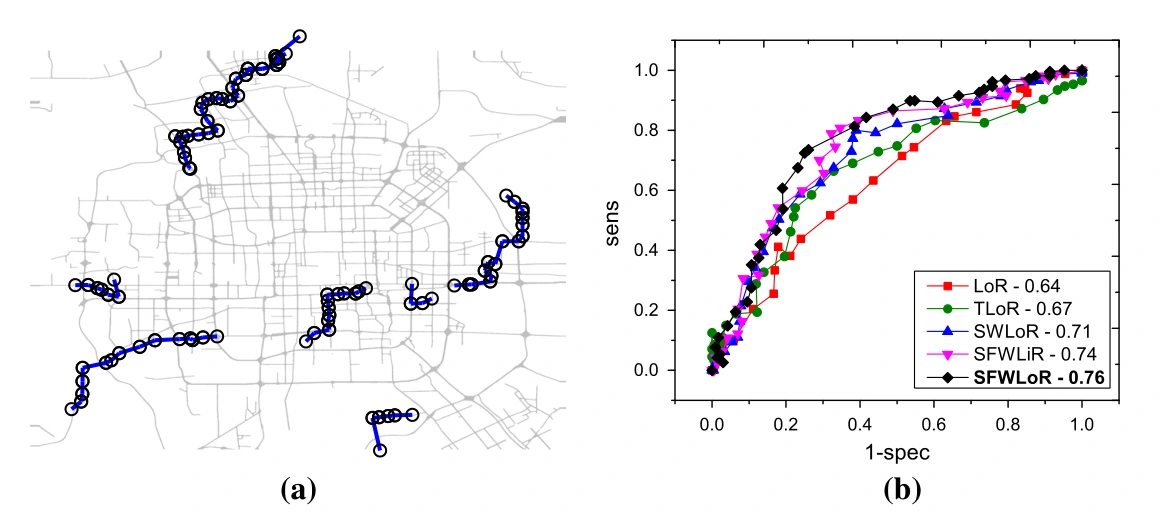
图 16|线路已经被人改过之后,AUC 还剩多少?
(a)8 条改道线路在城区的位置,蓝圈沿道路串成若干走廊。(b)86 个 OD 对上的 ROC。图例为 LoR 0.64、TLoR 0.67、SWLoR 0.71、SFWLiR 0.74、SFWLoR 0.76。正文的基线名单是 LoR、TLoR、TLiSVM、SFWLiR、SFWLoR,没有定义 SWLoR;图 15a 的蓝三角对应 TLiSVM。0.76 属于这 86 个对的改道后检验。全部 OD 对上的 0.82 来自十折交叉验证。来源:原论文 Fig. 16。
0.82 和 0.76 都表示概率排序有区分度。它们还不等于新设计的线路会按预测比例获得乘客。9 月 21 日的改道是公交公司已经实施的调整,不是后文优化器输出的那一组线。
人多、又绕、又慢、又多停的起终点,先被挑出来
全局重排被放在一边。作者给出的理由有两条:带多种约束的线网设计是非线性、非凸、多目标的 NP 难问题;大改也会动到已经合适的线路。因此只处理问题突出的 OD 对。
三项比值被用来表示线路问题:公交距离 / 出租车距离、公交时间 / 出租车时间、公交停站数 / 出租车距离。三项都大,表示又绕、又慢、又停得多。票价比被留在选择模型里,不进入这一步的筛选。
筛选分两步。先留下行程数高于平均的 OD 对,让每个比值都来自较多行程。再在其中找天空线(skyline):一个对留在天空线上,意味着没有另一个对在这三项上都大于等于它、并且至少一项严格更大。每个时段单独做,再合并。合计 651 个,每个时段大约 100 个。
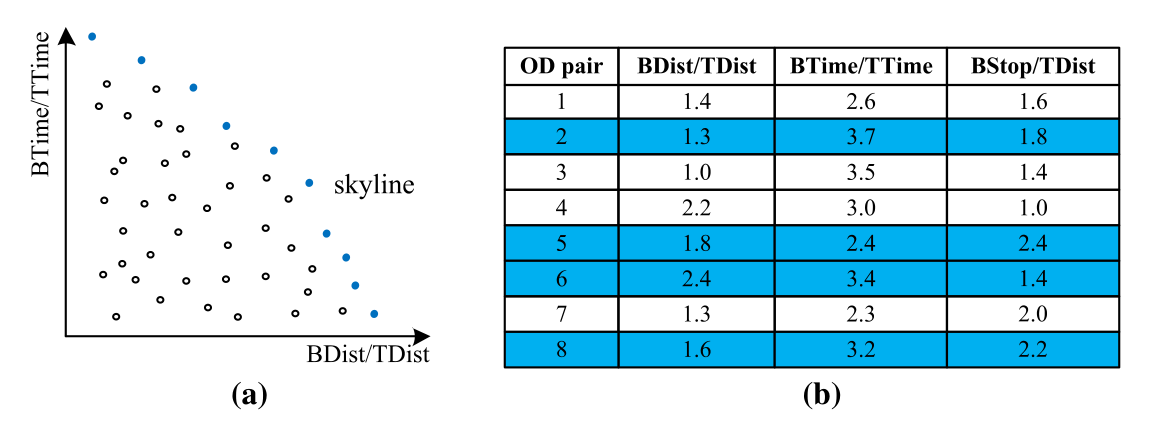
图 12|怎样从一堆 OD 对里留下三项都“更差”的那些?
这是方法示意,表中的小数不是北京实测。(a)横轴为距离比,纵轴为时间比,蓝点为二维天空线。(b)八个假想 OD 对。蓝底的 2、5、6、8 被标成天空线;1 被 8 在三项上全面超过,3、4、7 也被天空线上的点压过。点 2 的时间比 3.7 大于点 8 的 3.2,所以 8 不能把它排除。来源:原论文 Fig. 12。
出租车司机的路线被当作公交线路的上界。把这条路线代进选择模型,得到公交概率的一个高值,再算可能增加的公交行程:
ΔBVol = 各时段的 Vol ×(出租车路线上的预测概率 − 当前公交概率)之和。
Vol 是该时段公交加出租车的行程数,当前公交概率来自历史转移。增量按这个差,在七个时段上相加。潜力从高到低排列,取前 K 个进入改线。
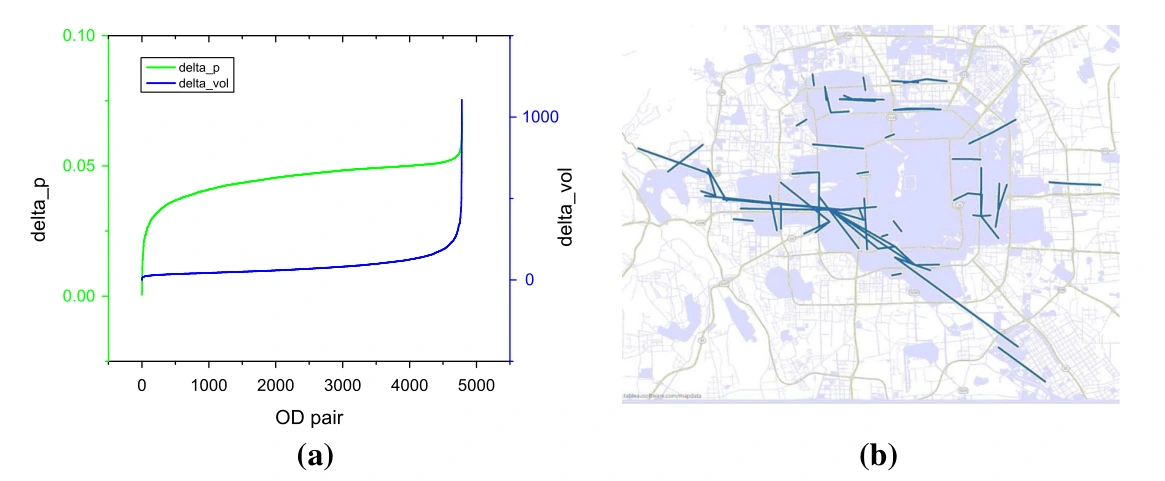
图 17|若每条线都改到出租车那么直接,概率和客流会怎么涨?
(a)横轴为 OD 对,画到约 5,000。绿线是公交概率差,纵轴 0 到 0.10,大部分位置贴近 0.05,右端再抬一点。蓝线是公交行程增量,右轴到 1,000 以上,前几千个对几乎贴着 0,右端才陡升。正文据此写:全部 OD 对的公交概率平均提高 5%,行程增量符合齐夫定律,大部分增量落在少数 OD 对。横轴约 5,000 是作图范围,651 是天空线对的个数。(b)前 100 个问题 OD 对的分布。作者对照图 4 后写,这些对反映西南方向的公交需求:出租车行程多、公交行程少。来源:原论文 Fig. 17。
图 17a 的纵轴是概率差。贴近 0.05 表示预测概率比当前概率高大约 0.05,对应正文的 5% increase。客流增量看蓝线,再在表 6 里按各 OD 对的历史行程计算。
预算有限时,优化的是预测上车人数
一条线路是车站序列。若从零设计新线,目标会把沿途每一对前后车站的预测公交行程都加进去。本文改的是已有线网,目标收成:把有问题的那一对 OD 的预测公交行程尽量做大。历史公交行程是常数,最大化“预测公交行程减历史公交行程”和最大化预测公交行程,选出的线路相同。
多个 OD 对一起改时,总目标是各对、各时段的 Vol × 预测概率之和。成本是投入运营的线路长度和行驶时间,写成不超过给定预算。发车间隔在本文全部取 15 分钟,作者说明自己不优化时刻表。某一时段内的发车次数,由该时段的 STime 除以 15 分钟得到。共享路段在严格成本里只计一次;文中也给出把各线长度直接相加的松弛算法。表 6 那一组北京实验没有写出当时使用的总里程上限和总时间上限。
新线路的公交距离、时间和停站数,由经过的连边相加。出租车一侧的距离、时间和票价仍用历史值。公交票价比也留在特征里。这样,每换一条路,七个特征里和公交有关的几项会变,预测概率跟着变。
逻辑概率使目标非线性、非凸,梯度搜索只能保证局部优。线性概率把问题收成线性规划,决策变量可以先放松到 0 与 1 之间,再逐次删掉概率最小的边,直到每对 OD 只剩一条路。整数规划用分支定界。论文报告,只优化最差的那些对时,北京实例的规模可以被分支定界解完。
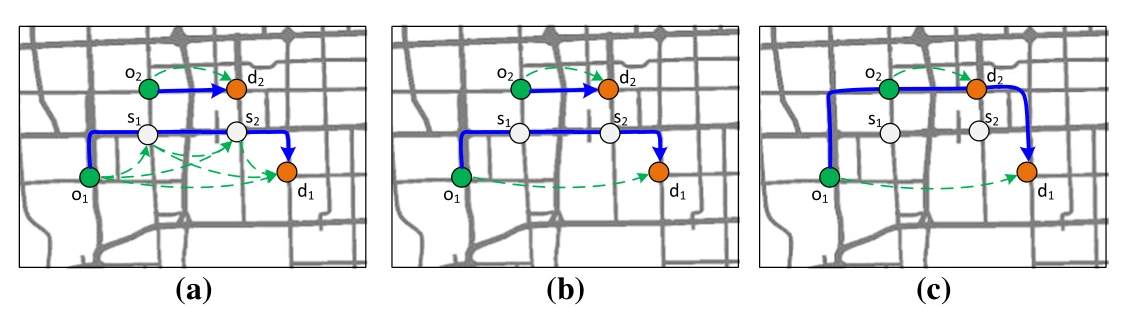
图 13|改一条线时,到底在为哪些 OD 对累计乘客?
蓝实线是公交路线,绿虚线是 OD 需求。示意,没有客流数字。(a)新线要同时照顾沿途六对需求。(b)只重修有问题的对时,各自优化 (o1, d1) 和 (o2, d2),得到两条线。(c)预算不够两条线时,合成一条仍能串起这两对的线。来源:原论文 Fig. 13。
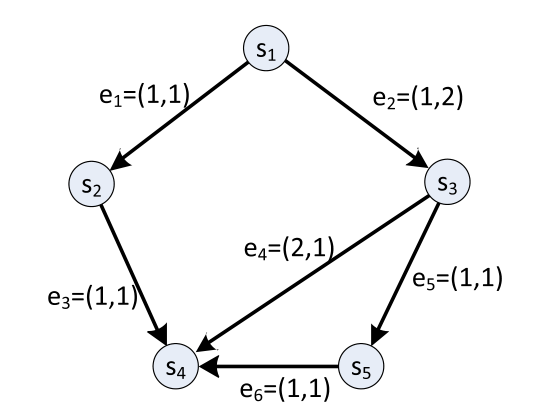
图 14|一个五站小网络里,哪一条候选会因为超时被丢掉?
无字母子图。边旁的 (EDist, ETime) 是示例数字。从 s1 到 s4,在距离和不超过 3、时间和不超过 3 时,走 s5 的那条路时间为 4,被排除。剩下两条路比较预测概率。图中的 1、2、10 是为了演示特征怎么从边上加总,不是北京的公里或分钟。来源:原论文 Fig. 14。
对照方法有三个。最短距离只最小化公交距离,最短时间只最小化公交时间,MRT 最大化线路上的出租车行程,沿用既有夜班公交和公交规划里的做法。本文的 MCR 最大化预测公交行程。MCR-LiR 用线性选择模型,MCR-LoR 用逻辑选择模型。五个方法都在同一批问题 OD 对上找路,再用选择模型把新路翻译成公交概率,乘上 Vol,减去历史公交行程,得到 ΔBVol。表 6 的每一列都是这 K 个 OD 对的平均值。
| K | 方法 | 距离 km | 时间 h | 停站 | 票价 元 | 预测概率 | 平均 ΔBVol |
|---|---|---|---|---|---|---|---|
| 100 | 最短距离 | 3.65 | 0.26 | 3.72 | 0.44 | 0.83 | 450.2 |
| 100 | 最短时间 | 3.83 | 0.24 | 4.01 | 0.45 | 0.83 | 469.6 |
| 100 | MRT | 3.72 | 0.27 | 3.98 | 0.45 | 0.83 | 511.3 |
| 100 | MCR-LiR | 3.67 | 0.26 | 3.83 | 0.44 | 0.84 | 669.8 |
| 100 | MCR-LoR | 3.43 | 0.25 | 3.66 | 0.44 | 0.86 | 732.5 |
| 200 | 最短距离 | 4.25 | 0.31 | 4.55 | 0.48 | 0.81 | 248.3 |
| 200 | 最短时间 | 4.31 | 0.29 | 4.53 | 0.49 | 0.81 | 303.2 |
| 200 | MRT | 3.72 | 0.31 | 4.38 | 0.49 | 0.82 | 354.6 |
| 200 | MCR-LiR | 4.40 | 0.33 | 4.35 | 0.49 | 0.85 | 428.1 |
| 200 | MCR-LoR | 4.54 | 0.34 | 4.42 | 0.49 | 0.86 | 483.7 |
| 500 | 最短距离 | 4.33 | 0.32 | 4.77 | 0.48 | 0.79 | 191.1 |
| 500 | 最短时间 | 4.52 | 0.30 | 4.76 | 0.49 | 0.81 | 231.8 |
| 500 | MRT | 3.72 | 0.32 | 4.73 | 0.49 | 0.82 | 278.6 |
| 500 | MCR-LiR | 4.55 | 0.34 | 4.66 | 0.49 | 0.84 | 321.3 |
| 500 | MCR-LoR | 4.59 | 0.34 | 4.73 | 0.49 | 0.85 | 350.5 |
前 100 个对上,MCR-LoR 的平均增量 732.5 比最短距离的 450.2 多 282.3,预测概率是 0.86 对 0.83。K 增到 200 和 500 时,五种方法的平均增量都下降,因为排序靠后的对本身潜力更小。每一档里 MCR-LoR 仍然最高,其次是 MCR-LiR,然后是 MRT。最短时间的增量高于最短距离,作者据此认为时间比距离更影响选择。
MRT 的平均距离在三档 K 上都是 3.72 km,按表面数字记录。它追的是线路覆盖的出租车行程。作者指出,商业区出租车很多,换成公交的比例可以很低,所以“出租车上的人最多”不会自动变成“改乘公交的人最多”。
票价列只有 0.44–0.49 元。表头单位是元。论文没有说明新线路的这个平均数如何从刷卡金额得到,和读者熟悉的北京公交票价也不在一个量级。
K 变大以后平均增量变小,优化器并没有变差。前 100 个对是按潜力从高到低截出来的。
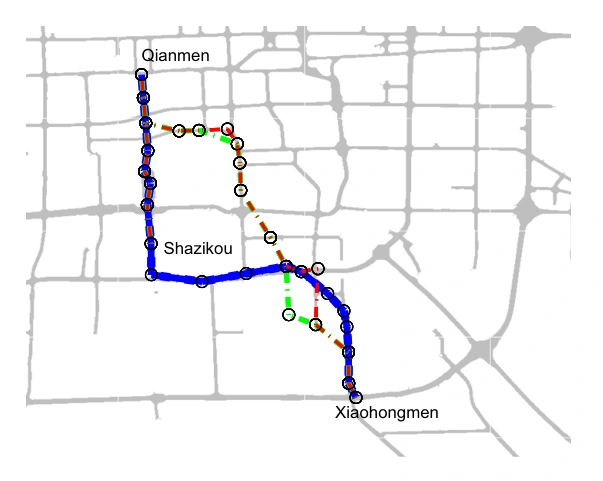
图 18|小红门、沙子口到前门,四种方法画出了几条线?
无字母子图。前文指定绿色为最短距离,红色为最短时间,黑色为 MRT,蓝色为 MCR。最短距离和最短时间各走出两条相近的线;MRT 和 MCR 合成一条,把沙子口和前门的竖向走廊与小红门方向接在一起。作者写,这条共用走廊和北京公交集团 2013 年 3 月新开的 93 路有相同子路径。图中没有标出重合站数或重合里程。来源:原论文 Fig. 18。
计算在 MATLAB 2013b 与 C# 中完成,机器为 3.40 GHz 的 Intel Core i7、16 GB 内存。最短距离、最短时间和 MRT 不预测公交需求,因此最快。MCR-LoR 最慢。作者建议大规模时用 MCR-LiR;因为改线通常离线计算,MCR-LoR 仍可用于更细的方案。
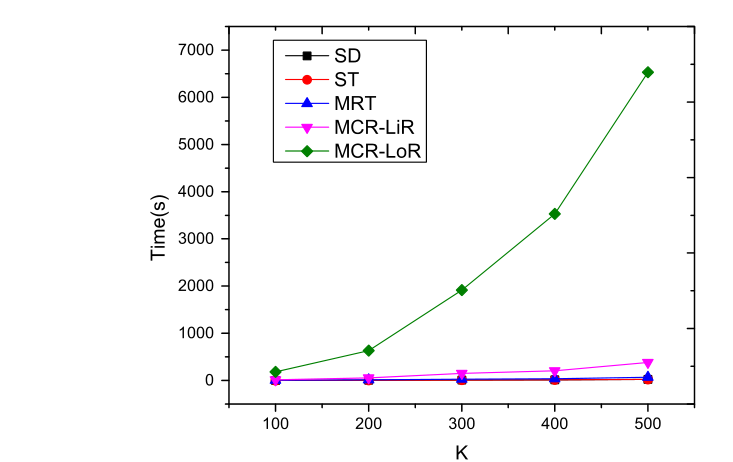
图 19|K 从 100 增到 500,谁的计算时间升到了小时量级?
无字母子图。横轴 K 取 100、200、300、400、500,纵轴为秒,刻度到 7,000。MCR-LoR 在 K=500 时落在 6,000 与 7,000 之间。MCR-LiR 缓慢上升,仍远低于 1,000 秒刻度。最短距离、最短时间和 MRT 贴在底部。正文没有另给精确秒数。来源:原论文 Fig. 19。
这些增量还停在模型里
表 6 的 ΔBVol 用的是选出线路之后、再代回选择模型得到的概率。优化目标和评分用的是同一类概率。一条线若在距离比、时间比和停站上更接近模型喜欢的方向,增量就会变大。这支持“在这个模型里,MCR 比最短距离、最短时间、MRT 转换出更多预测乘客”。它还没有支持“按这条线开班后,北京会新增这么多公交乘客”。
9 月 21 日的 86 个 OD 对检验的是:已知线路已经变化时,模型还能不能排序方式。93 路的相同子路径是事后的地理对照,没有客流差。
私家车没有进入 Vol。作者写,若把其他私人交通也算进来,公交的效果可能更大。那是推断。数据里的私人交通只有出租车,出租车乘客已经为便捷付了费,和开车的人不是同一群样本。
乘客在车站的等车时间也没有进入选择特征。发车间隔固定为 15 分钟,只出现在运营成本里。连边时间用 λ 把出租车速度换成公交速度,停站常数又取 0。模型里的“更快”,主要是车上时间和绕路,不包含等来的那一班。
区域按到车站的直线距离划分。最近车站若走不过去,问题可能出在过街和步行,改行驶路线消不掉它。作者在结论里把车站选址留作后续:线路和车站可以一起调,也可以把地铁和公共自行车放进同一张需求里。
舒适和安全被假定不变。票价特征在新线路上如何重新计算,正文没有展开。带宽和表 6 的预算上限也没有数值。这些空白留在模型的适用边界上:现有结果回答的是,在公交与出租车、固定车站、固定 15 分钟间隔和这套特征之下,哪些 OD 对的预测转换最大。
一句话总结
在这套北京公交与出租车数据里,把绕路、耗时和停站改轻,选择模型会给出更高的公交概率,而且预测增量集中在少数 OD 对;前 100 个对上,逻辑回归改线的平均增量是每个 OD 对 732.5 次样本期行程,这个数来自模型,不是开线之后数出来的上车人数。
核心来源
- Knowledge and Information Systems 论文页面,DOI:10.1007/s10115-016-0948-6。期刊标注 2017 年,50 卷,383–415 页;2016 年 4 月 27 日在线发表。
- 本文依据上述正式版全文。页眉、摘要、表 4 与表 6 的数字都从该 PDF 核对。文末注明初步版本为 ICDM 2014 论文 Exploiting heterogeneous human mobility patterns for intelligent bus routing。
- 兴趣点、路网、刷卡和出租车轨迹由作者在实验设置中说明;PDF 未附带可重复计算的补充数据表。通讯作者邮箱为文中所载 hxiong@rutgers.edu。
作者介绍
以下均来自论文署名与文末作者简介,身份是论文发表时的写法。
- Yanchi Liu:文末称他当时是罗格斯大学管理科学与信息系统系博士生;2005 年在中国民航大学获工学学士,2012 年在北京科技大学获博士学位。研究兴趣包括数据挖掘、移动计算和城市计算。正文署名单位是罗格斯大学。
- Chuanren Liu:文末称他获中国科学技术大学学士、北京航空航天大学硕士和罗格斯大学博士,当时是德雷塞尔大学决策科学与管理信息系统系助理教授,研究方向为数据挖掘、知识发现和商业分析。
- Nicholas Jing Yuan:文末称他是微软亚洲研究院研究员;2007 年在中国科学技术大学获数学学士,2012 年获计算机科学博士。研究兴趣包括时空数据挖掘、行为挖掘和计算社会科学。
- Lian Duan:文末称他当时是霍夫斯特拉大学信息系统与商业分析系助理教授;2012 年在艾奥瓦大学获管理科学博士,2007 年在中国科学院获计算机科学博士。研究兴趣包括相关分析、社区发现、商业分析和地理空间分析。
- Yanjie Fu:文末称他 2008 年在中国科学技术大学获学士,2011 年在中国科学院获硕士,当时是罗格斯大学管理科学与信息系统系博士候选人。研究兴趣包括数据挖掘、城市计算和移动分析。
- Hui Xiong:通讯作者。文末称他当时是罗格斯大学管理科学与信息系统系教授、副主任,以及罗格斯信息保障中心主任;中国科学技术大学学士,新加坡国立大学硕士,明尼苏达大学博士。研究方向是数据与知识工程。文末并记载 ACM 杰出科学家与 IEEE 高级会员身份。
- Songhua Xu:文末称他当时是新泽西理工学院信息系统系助理教授,计算机科学的博士、哲学硕士和理学硕士均来自耶鲁大学。主要研究信息检索、搜索、数据挖掘和面向生物医学的智能系统。
- Junjie Wu:文末称他 2008 年在清华大学获管理科学与工程博士,当时是北京航空航天大学信息系统系教授、社会计算研究中心主任,以及城市运行应急保障模拟技术北京市重点实验室副主任。研究方向是数据挖掘和复杂网络。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
选择模型的行程时间来自连边行驶时间,等车被放在 15 分钟的发车间隔里,只参与车队成本。一条车上只需 15 分钟、却要在站上等 15 分钟的线,和一条车上 20 分钟、到站就有车的线,在乘客特征里几乎只比较车上时间。若把等待的一半间隔加进 BTime,表 6 里“时间比距离更重要”的排序可能改变,MCR 与最短时间的差距也会重算。这需要新的选择模型,而不是把现有 ΔBVol 按比例放大。
另一个可检验的缺口是预算。表 6 没有写出总里程和总时间的上限。若上限很松,MCR-LoR 多出来的 282.3 次平均增量,可能只是它比最短距离更接近出租车路线;若上限很紧,同样的模型会被迫像图 13c 那样合并走廊,增量会从 732.5 往下掉。把 K=100 的五条方法放进同一组由松到紧的预算,才能看出 732.5 是模型偏好,还是在真实车队约束下仍能留下的转换。