人走多远,为什么不能用一条全球曲线说完?
论文名片|Moritz U. G. Kraemer、Adam Sadilek、Qian Zhang、Nahema A. Marchal、Gaurav Tuli、Emily L. Cohn、Yulin Hswen、T. Alex Perkins、David L. Smith、Robert C. Reiner Jr、John S. Brownstein,Mapping global variation in human mobility,Nature Human Behaviour,2020,4:800–810,2020年5月18日在线发表。DOI:10.1038/s41562-020-0875-0。本文依据这一正式版解读。
2016 年 7、8 月,南北半球的移动一起变多。若这只是有人飞去另一个半球,跨半球流量最多占 7%,撑不起这种同步。距离上的差别更大:按社会发展水平分组后,一半移动所落的距离大约相差 4 倍。低社会人口指数国家里,50% 的移动短于 2.5 公里;高社会人口指数国家里,50% 的移动短于 12 公里。
这项研究用同一套手机定位的聚合结果,描述 2016 年移动在季节、距离和国界上如何不同。带指数截断的幂律可以概括较长行程的衰减,但它开始成立的平均距离,在低社会人口指数国家约为 5.36 公里,在高社会人口指数国家约为 50.95 公里。组平均幂指数则从 2.54 降到 1.80。这些是同一年、同一网格上的分布差异,还没有把收入、冲突或边境政策识别成原因。
先说结论
- 有足够数据的 5×5 公里格住着 29 亿人,约占 2016 年世界人口的 40%。定位记录来自超过 3 亿名打开位置历史的手机用户,分析用的是格子之间的聚合流量。
- 全球 61% 的流量留在同一个 5×5 公里格内,国家之间的范围是 23%–93%。低社会人口指数组一半移动短于 2.5 公里,高社会人口指数组一半移动短于 12 公里。
- 202 个有足够数据的国家里,幂指数的组均值从低到高依次为 2.54、2.22、2.12、2.17 和 1.80。幂律开始适用的平均距离相应为 5.36、30.40、44.85、44.35 和 50.95 公里。
- 把约 7,001 万个地点对合成一条全球曲线时,幂指数为 1.87。这是另一次拟合,不能拿来代替上面的国家组均值。55% 的国家里幂律拟合优于对数正态和指数分布,36% 的国家里对数正态更好。
- 国际流量占全部出行量的 2.2%。叙利亚的国际流量占该国流量的 22%。离陆地边境更近时,跨境所占的份额上升。
这 3 亿用户,量到的是格子里的谁?
数据来自 2016 年自愿打开 Google 位置历史的手机。设备按固定间隔上传时间戳和位置,位置可由卫星定位、无线网络和基站共同推断。机器学习再把这些点切成行程:一段停留足够久的地点,到下一段停留地点。机场经停也会留在多段国际行程里。研究者看不到个人轨迹,进入模型的是差分隐私和 k-匿名处理之后的聚合流量。
空间单元是统一的 5×5 公里格。一个时段里从格子 a 到格子 b 的相对流量,等于该流量除以全图最大流量。因此原始数值是相对全局最大值的份额。讨论部分认为,这种归一化可以在国家内部比较,不宜直接比较不同地区的绝对流量。距离分布后来又在每个国家内部做成累积概率,比的是形状。幂律描述的是移动如何随距离分配,论文据此认为它不受各国手机普及率整体高低的影响。
报告摘要写明,用户数不足 100 的地点被排除。方法给出的隐私预算为 ε=0.66,并使用拉普拉斯机制加噪。发布出来的流量因而带有噪声,很小的流量也可能因为隐私门槛没有进入数据。2016 年保留下来的唯一地点对为 70,010,784 个。
有足够数据的格子住着 29 亿人,约是 2016 年总人口的 40%,并覆盖全球陆地表面的 29% 以上。人口超过 1,000 人的格子中,65% 有移动数据;人口超过 10,000 人的格子中,这一比例升到 78%。摘要里的“地球有人居住表面的 65%”与后一个人口门槛的格子覆盖率对应,和 29 亿人所占的人口份额不是同一个分母。
覆盖随发展和城乡位置变化。低收入地区的数据更集中在城市和主要道路附近;文中举例的新加坡、香港、德国、意大利、法国和比利时则几乎连乡村都有数据。乍得、中非共和国和刚果民主共和国只有约 30% 的有人居住区域被覆盖。83% 的国家里,全部城市区域都有数据;城市数据占比低于 10% 的国家只占 2.6%,为南苏丹、布隆迪、埃塞俄比亚和厄立特里亚。城乡差距最大的名单里同时出现土库曼斯坦、尼日尔、蒙古、马里、圭亚那、几内亚比绍,以及加拿大和澳大利亚。
论文用社会人口指数(sociodemographic index,SDI)给国家分组。它把人均收入、受教育程度和总和生育率合成一个 0 到 1 的发展指标,0 对应样本中最低收入、最低教育程度和最高生育率。正文有时把低 SDI 直接称为低收入环境。表 1 按五组给出覆盖、格内出行概率和平均幂指数。后两列人口门槛的占比,原文写为按总格数加权。
| SDI 组 | 有数据的格占比 | 人口大于 1,000 的格 | 人口大于 10,000 的格 | 5×5 公里格内出行概率 | 平均幂指数 |
|---|---|---|---|---|---|
| 低 | 0.15 | 0.30 | 0.30 | 0.65 | 2.54 |
| 中低 | 0.27 | 0.45 | 0.76 | 0.72 | 2.22 |
| 中 | 0.40 | 0.59 | 0.71 | 0.65 | 2.12 |
| 中高 | 0.47 | 0.84 | 0.97 | 0.60 | 2.17 |
| 高 | 0.69 | 0.98 | 1.00 | 0.53 | 1.80 |
格内概率在中低组最高,为 0.72,到高组降到 0.53。高组有数据的格子已占 0.69,人口过万的格子则全部有数据。低组两项人口门槛都只有 0.30。因此后面的距离比较,是在覆盖程度很不相同的国家之间进行的。
2016 年蜂窝签约数相对全球人口的区间为 99–110,可以超过每人一个号码。按 SDI 分组,低组为 63.1%(95% 区间 54–72),中低组 87.5%(77–97),中组 118.5%(108–129),中高组 129.9(118–142),高组 122.14(116–128)。论文另写 2017–2018 年 Android 占智能手机的 77.32%,用来说明这套系统的覆盖潜力;这不是 2016 年样本内的实测份额。低收入地区的手机更可能属于出行更多、走得更远的人。作者因此认为,低 SDI 与高 SDI 之间已经看到的距离差异偏保守。这是方向性的判断,文中没有给出修正后的数值。
同一年里,移动何时变多?
周流量在一年内大约变化 1.5 倍,高峰在第 28 到 36 周,也就是北半球夏季的 7、8 月,1 月最低。为了照顾 Android 设备规模从 2015 年的 18 亿台到 2017 年的 22 亿台,周数据按每周 0.03% 调整,纵轴再改成相对全年均值的偏离。复活节、五一、朝觐和美国感恩节都标在这条曲线上。北纬 30° 到 50° 之间集中了几乎 50% 的移动,感恩节所在周末的出行频率比前几周高 10%。
跨南北纬的流量最多为 7%。7、8 月的同步因而不能由跨半球旅行解释。挪威和加拿大的夏季出行频率是冬季的 2.25 倍。东经 80° 到 120°、从新德里到越南一带,6 月至 9 月季风期间人口移动最多减少 25%。
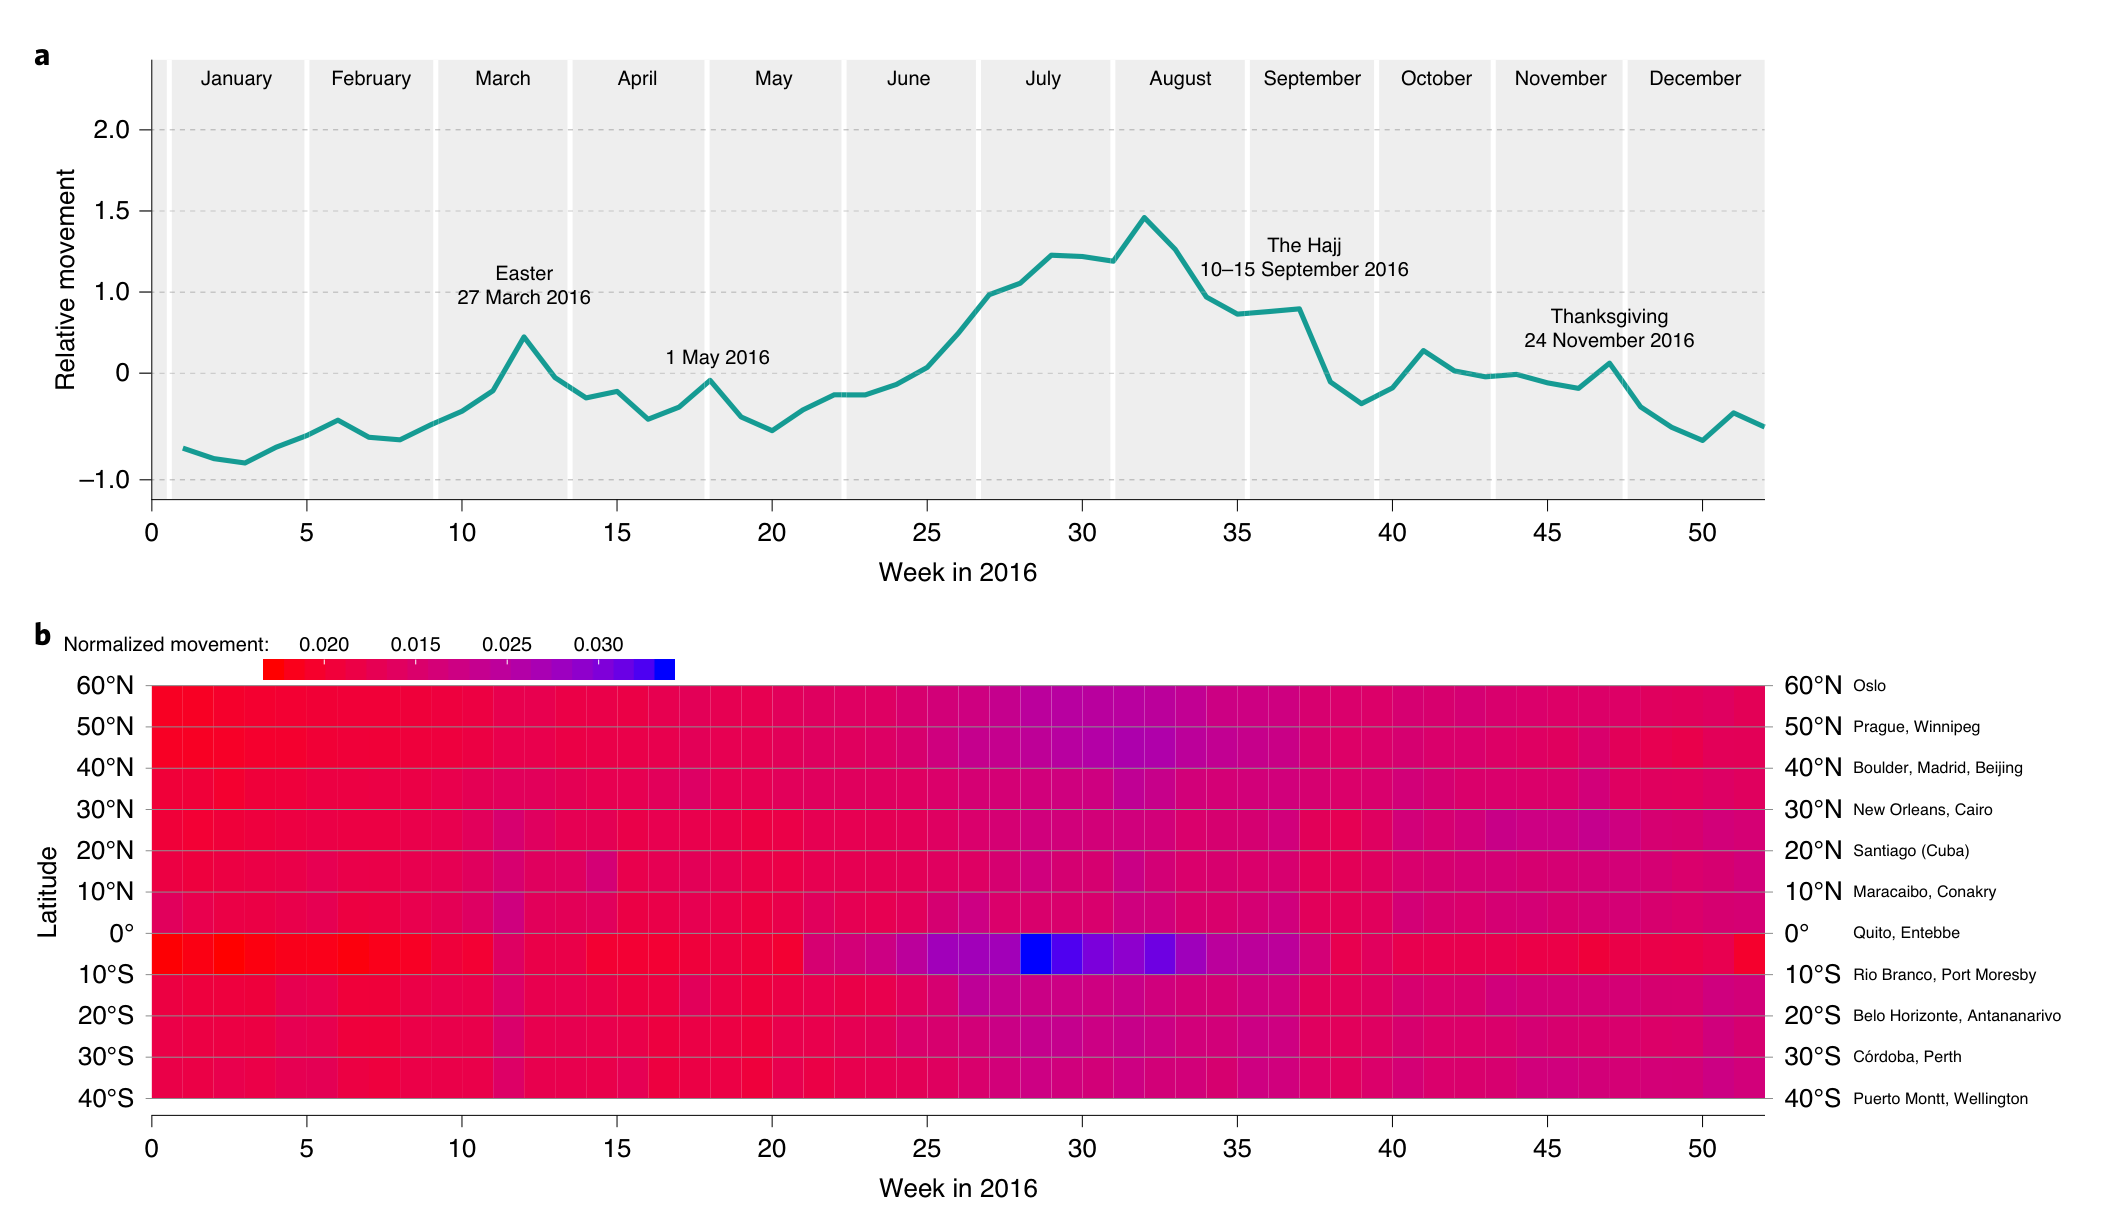
图 1|2016 年的移动在哪几周、哪几条纬带变多?
(a)横轴为 2016 年周次,纵轴为相对均值的偏离,0 是研究时段的平均水平。曲线在第 28–36 周达到全年高位,1 月处于低位;复活节、5 月 1 日、9 月 10–15 日朝觐和 11 月 24 日感恩节标在对应周附近。(b)每一行是一个纬带,颜色按该行归一,各行相加为 1。暖色表示该周占这一纬带全年移动的份额较低,冷色表示较高,色标大约从 0.015 到 0.030。因此不能用颜色深浅比较 60°N 和 10°S 的绝对流量。10°S 附近在第 28–36 周出现一段明显的冷色高份额;右侧城市只是纬带的参照地名。来源:原论文 Fig. 1。
平均 170 公里,能代表大多数行程吗?
把本地和跨国移动放在一起,全球平均行程距离为 170 公里,中位数为 11.97 公里。超过 1,900 公里的地点对在 70 万个以上,记录到的最大距离为 19,000 公里。同时,长于 60 公里的行程只占全部记录流量的 10%。平均数被很长的地点对拉高,中位数仍停留在十几公里。低人口地区的平均距离约为 200 公里,大约是其他纬度的两倍,文中的例子是阿拉斯加和俄罗斯东部。
另一个口径是出不出所在的格子。全球 61% 的流量留在同一个 5×5 公里格,国家范围 23%–93%。五组的格内概率分别是:低 0.65、中低 0.72、中 0.65、中高 0.60、高 0.53。高 SDI 与低 SDI 相差 0.12。论文把这 0.12 写成高 SDI 人群跨出格子的可能性高 12%。若改用跨格概率 0.47 与 0.35 计算相对增幅,会得到另一个比例;这里保留概率本身和论文的 0.12 口径。
格内份额 61% 与中位距离 11.97 公里并不是自动相容的两个读数。前者是流量是否留在格内,后者是行程距离的均值和中位数。正文没有说明二者是否使用同一种加权。阅读时把它们当成两个并列的摘要。
在地点对超过 5,000 的国家中,短距离移动概率沿医疗可及性与质量指数(Healthcare Access and Quality Index,HAQI)和连续 SDI 变化。HAQI 依据有效医疗下本可避免的死亡构造。论文给出的 Spearman 秩相关为:对 HAQI,ρ=0.50(95% 区间 0.20–0.62);对 SDI,ρ=0.44(95% 区间 0.19–0.61);两者 P 值都小于 0.001。按秩相关的通常定义,正值表示两个变量同向排序。这与同一句里“短距离概率沿 HAQI 下降”的方向并不一致。分组均值本身是清楚的:高 SDI 的格内概率 0.53,低于低 SDI 的 0.65,也低于中低组的 0.72。短距离概率因而呈倒 U 形,停留在格内的峰值出现在中低组,而不是最低 SDI 组。新加坡、荷兰、德国和比利时的移动以中等距离为主。
只看国内移动时,叙利亚用户留在 5 公里格内的概率为 0.8,高于大多数中等 SDI 国家的 0.65。2016 年处于武装冲突中的阿富汗、利比亚、叙利亚和也门,5 公里以内的短距离频率与其他低收入国家相近,但 95% 的移动发生在 10 公里以下;低收入国家的对应范围是 100 公里以下。10 公里对 100 公里,正是论文所说的“在短 10 倍的距离上进入平台”。这是 2016 年国家之间的截面对照。论文据此说冲突提高了停留在短距离的倾向;数据里没有同一国家冲突前后的比较。
发展差异主要体现在 20 公里以内。中低与高收入组在超过 90% 的移动之后,距离曲线趋于接近。低收入组是例外:90% 的移动发生在 20 公里以下,其他收入组的对应距离是 100 公里。作者推测各国内部仍有出行选择相近的富裕人群,并写明这一点还需要更多工作。
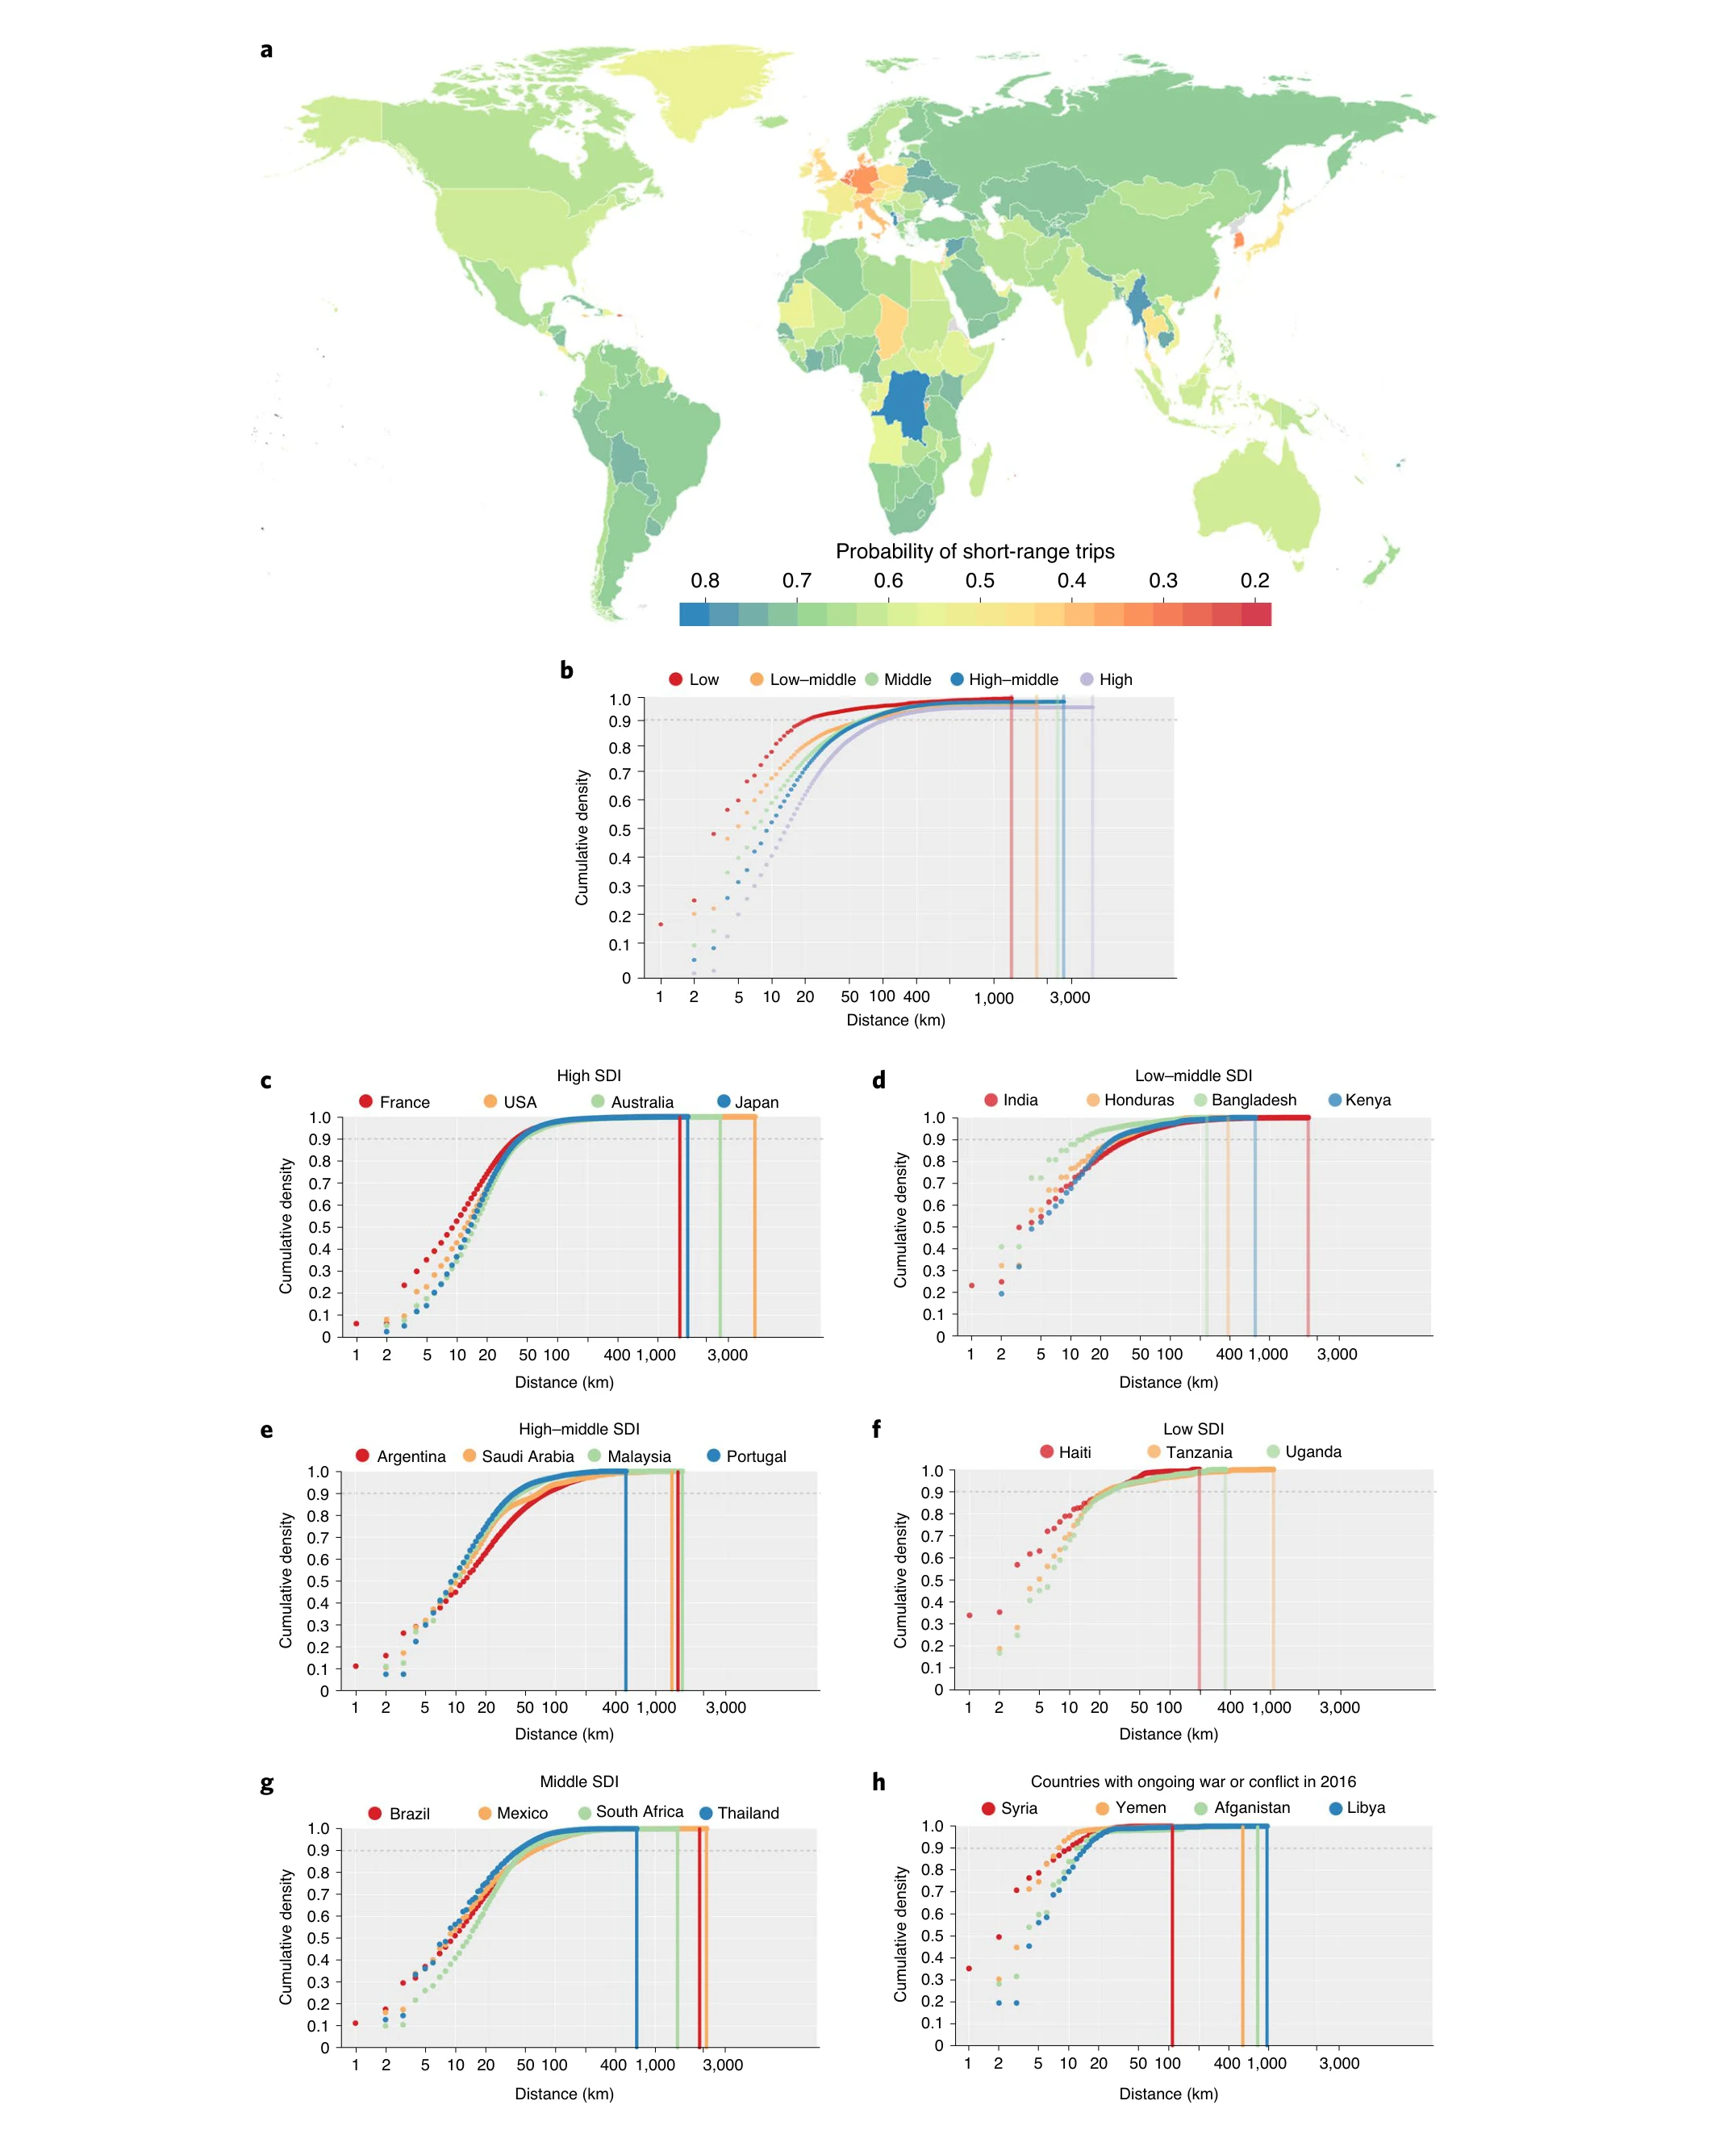
图 2|短距离占多少,不同发展组和冲突国家的累积曲线差在哪里?
(a)至少有 100 个含移动信息格子的国家。颜色是短距离行程概率,蓝色约 0.8,红色约 0.2;暖色表示跨出 5 公里的频率更高。灰色为无数据。(b)五组 SDI 的累积概率,横轴为对数距离。曲线越早升到 1,移动越集中在近处。竖线是组内的远处参照,水平虚线对应图注中的 90% 移动。(c)高 SDI:法国、美国、澳大利亚、日本。(d)中低 SDI:印度、洪都拉斯、孟加拉国、肯尼亚。(e)中高 SDI:阿根廷、沙特阿拉伯、马来西亚、葡萄牙。(f)低 SDI:海地、坦桑尼亚、乌干达。(g)中等 SDI:巴西、墨西哥、南非、泰国。(h)2016 年处于战争或冲突中的国家:叙利亚、也门、阿富汗、利比亚。各小图的竖线是该国记录到的最远距离,横轴刻度并不表示每一公里都有同样多的行程。来源:原论文 Fig. 2。
距离规律从第几公里才开始像幂律?
行程距离 x 在超过下限 x_min 之后,用带指数截断的幂律描述:p(x) 正比于 x 的 −α 次方,再乘以 e 的 −λx 次方。α 越大,距离拉长时概率掉得越快;λ 让极远距离不再按同一幂律无限延伸。估计时先确定 x_min,丢掉更短的样本,再用最大似然估计 α,并以 1,000 次有放回抽样给出不确定性。拟合优度用 Kolmogorov–Smirnov 距离,也就是经验累积分布与拟合分布之间的最大差距。
把全部约 7,001 万个地点对放在一次拟合里,α=1.87(95% 区间 1.85–1.89),对应的中位 x_min=12.04 公里(95% 区间 11.10–12.50)。随后在 202 个有足够数据的国家分别估计。低、中低、中、中高、高 SDI 的平均 α 为 2.54、2.22、2.12、2.17、1.80。低 SDI 相对高 SDI 高出约 41%,论文概括为低收入环境中的下降快 40%。高 SDI 的 1.80 接近既有美国手机数据的 1.75 和钞票扩散研究的 1.59。德国和英国的 α 都是 2.6,分别对应 x_min=27 公里和 54 公里,高于高 SDI 组均值,与高收入地区卫星定位研究的量级一致。马耳他、卢森堡和爱沙尼亚的衰减很平,留尼汪和毛里求斯下降很快;正文没有给出这五个地区的具体指数。
幂律并不是每个国家的最佳近似。与对数正态、指数分布比较后,55% 的国家里幂律最好,36% 的国家里对数正态最好。只有 2.45% 的国家里,幂律既不是最好也不是第二好。作者仍继续使用幂律结果。因此“多数国家里幂律更合适”是这三种候选之间的相对结论。
x_min 的组均值为:低 5.36 公里,中低 30.40 公里,中 44.85 公里,中高 44.35 公里,高 50.95 公里。低组到高组大约差 10 倍,低组到中低组大约跳了 6 倍。按世界银行地区汇总的均值又是另一套分组:撒哈拉以南非洲 9.98 公里,东南亚、东亚与大洋洲 22.29 公里,南亚 26.91 公里,中欧与东欧 34.22 公里,北非 45.62 公里,拉丁美洲 49.37 公里,高收入地区 63.67 公里。最后这个 63.67 公里是地区分组均值,不是表 1 里高 SDI 的 50.95 公里。
因为高收入地区的 x_min 更远,大多数行程其实落在幂律之外。中等到高收入环境里,大约只有最高的 15% 数据遵循幂律;低收入环境里大约为 40%。全球共同规律描述的是越过各自 x_min 之后的长尾。
为解释国家之间的 x_min,作者拟合只有交互项的对数线性模型:log(x_min) 随 HAQI 与 SDI 五分位的交互变化,没有单独的主效应。残差随 HAQI 有异方差迹象,Breusch–Pagan 检验 P=0.064;改用 1/HAQI 加权后 P=0.917。加权模型 R²=0.456,图注写为 0.46;未加权为 0.389。图中的置信带在没有观测的 HAQI 区间最宽。最低 SDI 五分位的 HAQI 都低于 50,不能把这条曲线外推到 HAQI=90 仍停留在低 SDI 的国家。
像素尺度上,夜光单独解释中位出行距离变异的 32%,与表 2 国家模型的 32.1% 对应。表中的“解释的偏差”是各变量单独放入时的份额,最后一行才是合在一起。
| 预测变量 | 全球模型解释的偏差(%) | 国家模型解释的偏差(%) |
|---|---|---|
| 夜间灯光 | 24.3 | 32.1 |
| 人口数量 | 4.9 | 12.7 |
| 可达性 | 4.45 | 11.2 |
| 海拔 | 1.49 | 8.71 |
| 气温 | 1.19 | 8.49 |
| 以上变量同时纳入 | 26.1 | 33 |
五项一起只比夜光单独略高:全球模型从 24.3% 到 26.1%,国家模型从 32.1% 到 33%。这些变量共享大量信息,不能把五份单独的百分比相加。
拟合好坏也随国家大小和数据量变化。汤加、厄立特里亚、科摩罗和利比里亚等小而低收入的国家,拟合大约降到一半。面积小于 750 平方公里、与纽约市相近的国家,拟合进一步变差,而且这一下降不依赖发展水平。把国家面积、移动地点对数量和 SDI 放进广义可加模型后,调整 R²=0.67,解释的偏差为 69%。在本文的 5×5 公里和国家汇总尺度上,城镇化没有提高对移动的预测。只保留低与中低 SDI 时,调整 R²=0.82,解释的偏差为 84.8%;其余收入组为 0.57 和 59.8%,国家面积不再显著。
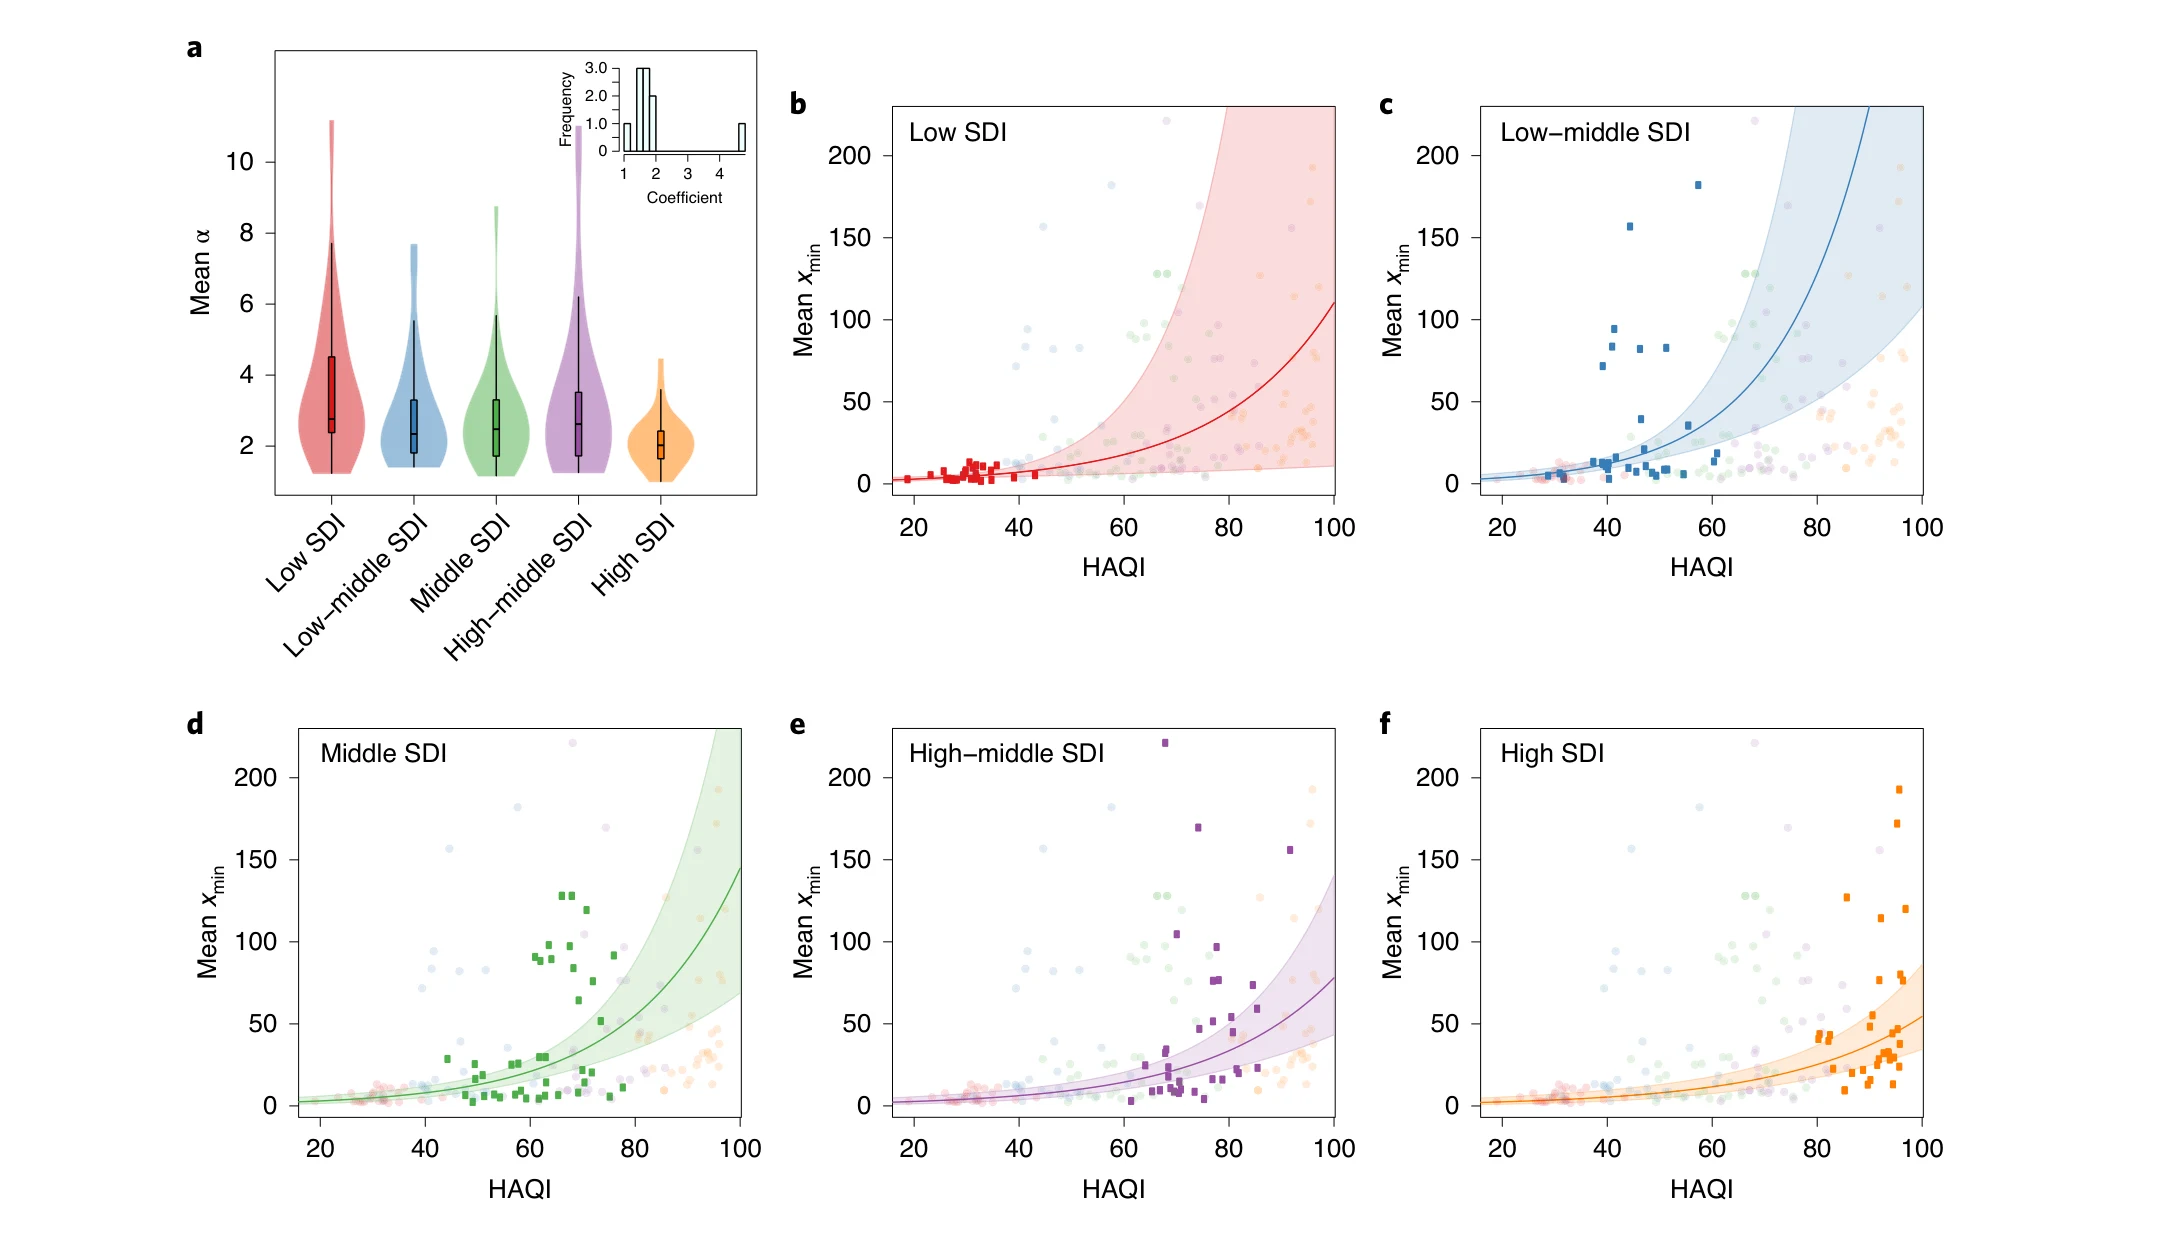
图 3|幂指数和幂律开始的距离,怎样随发展指标变化?
(a)纵轴是国家层面的平均幂指数。五组从左到右为低、中低、中、中高、高 SDI,黑色横条为均值,粗线为 25% 与 75% 分位,浅色范围表示 95% 分布。高 SDI 的中心最低,低 SDI 与中高 SDI 都有伸向 10 附近的长尾。右上角插图是先前研究的幂指数,正文说明共 8 项,细目在补充表 4;正文点名的对照是 1.75 和 1.59。(b–f)横轴 HAQI,纵轴平均 x_min,依次为低、中低、中、中高、高 SDI。曲线和色带来自按 SDI 分组、允许异方差的回归,图注 R²=0.46。低 SDI 的点主要在 HAQI 50 以下;色带在缺少国家的区间迅速变宽。来源:原论文 Fig. 3。
出国很少,离边境近就会不一样吗?
国际移动只占全部出行量的 2.2%。低 SDI 国家为 1.1%(正文所印 95% 区间 0.16–0.5),高 SDI 国家为 4.4%。4.4 与 1.1 正好相差 4 倍,论文称为 four times lower。若把 0.16–0.5 和 1.1 读成同一个百分数单位,区间并不包含 1.1;正文没有再解释这个区间的单位。地点对超过 100 的国家里,叙利亚的国际流量占该国全部流量的 22%,是图中最高值。埃塞俄比亚、乍得、刚果民主共和国被描述为有大量向外流动,乌兹别克斯坦被描述为向外的劳务流动;这四国除叙利亚外,正文没有给出对应百分比。
在 2,698 个国家对上,移动主要发生在彼此接近、国内生产总值也相近的国家之间。国家越小,国际出行占该国全部移动的份额越高,Pearson 相关系数 −0.39(95% 区间 −0.51 至 −0.26,P<0.001)。墨西哥与美国是最繁忙的边境之一,2016 年净流量为零,也就是流入等于流出。圣诞节前后数周进入墨西哥的国际流量比周平均最多高 6%,年初再返回美国。
法国出境、瑞士入境的边境显示,离边境越近,国际行程比例越高。正文给出 Loess 拟合 R²=0.59,以及边境 30 公里内流量的 Pearson 相关系数 0.54(95% 区间 0.47–0.59,P<0.001)。同一比较中,离边境最近的 20 座城市,其居民的国际出行可能性是 30 公里外的 83 倍。图注把这张距离散点放在(c),正文在引用拟合时写的是 Fig. 4b。
把所有陆地边境按距离切开:边境 20 公里内,国内出行相对国际出行的倾向平均高 28%;20–40 公里处升到 39%,再远则相对稳定。20 公里带内,跨境概率高于国内停留的边境包括梵蒂冈与意大利(+15%)、东帝汶与印度尼西亚(+4%)、直布罗陀与西班牙(+2%)。最受限的直接边境包括土耳其与亚美尼亚(−218%)、摩洛哥与阿尔及利亚(−184%)、以色列与加沙(−225%)。方法部分说,这里比较的是国内与跨境移动的累积加权比。正文没有把这些百分比还原成可复算的概率公式,所以+15% 与 −218% 都按论文报告的对照保留,不另换算成 0 到 1 的概率差。
双边流量偏向地理位置近、经济体量相近的国家。陆地边境本身的可渗透程度却没有明显的社会发展梯度。这与航空网络里相似经济水平之间更易成行的格局不同。全国 2.2% 的国际份额,因此不能直接当成每个边境城市的跨境概率。
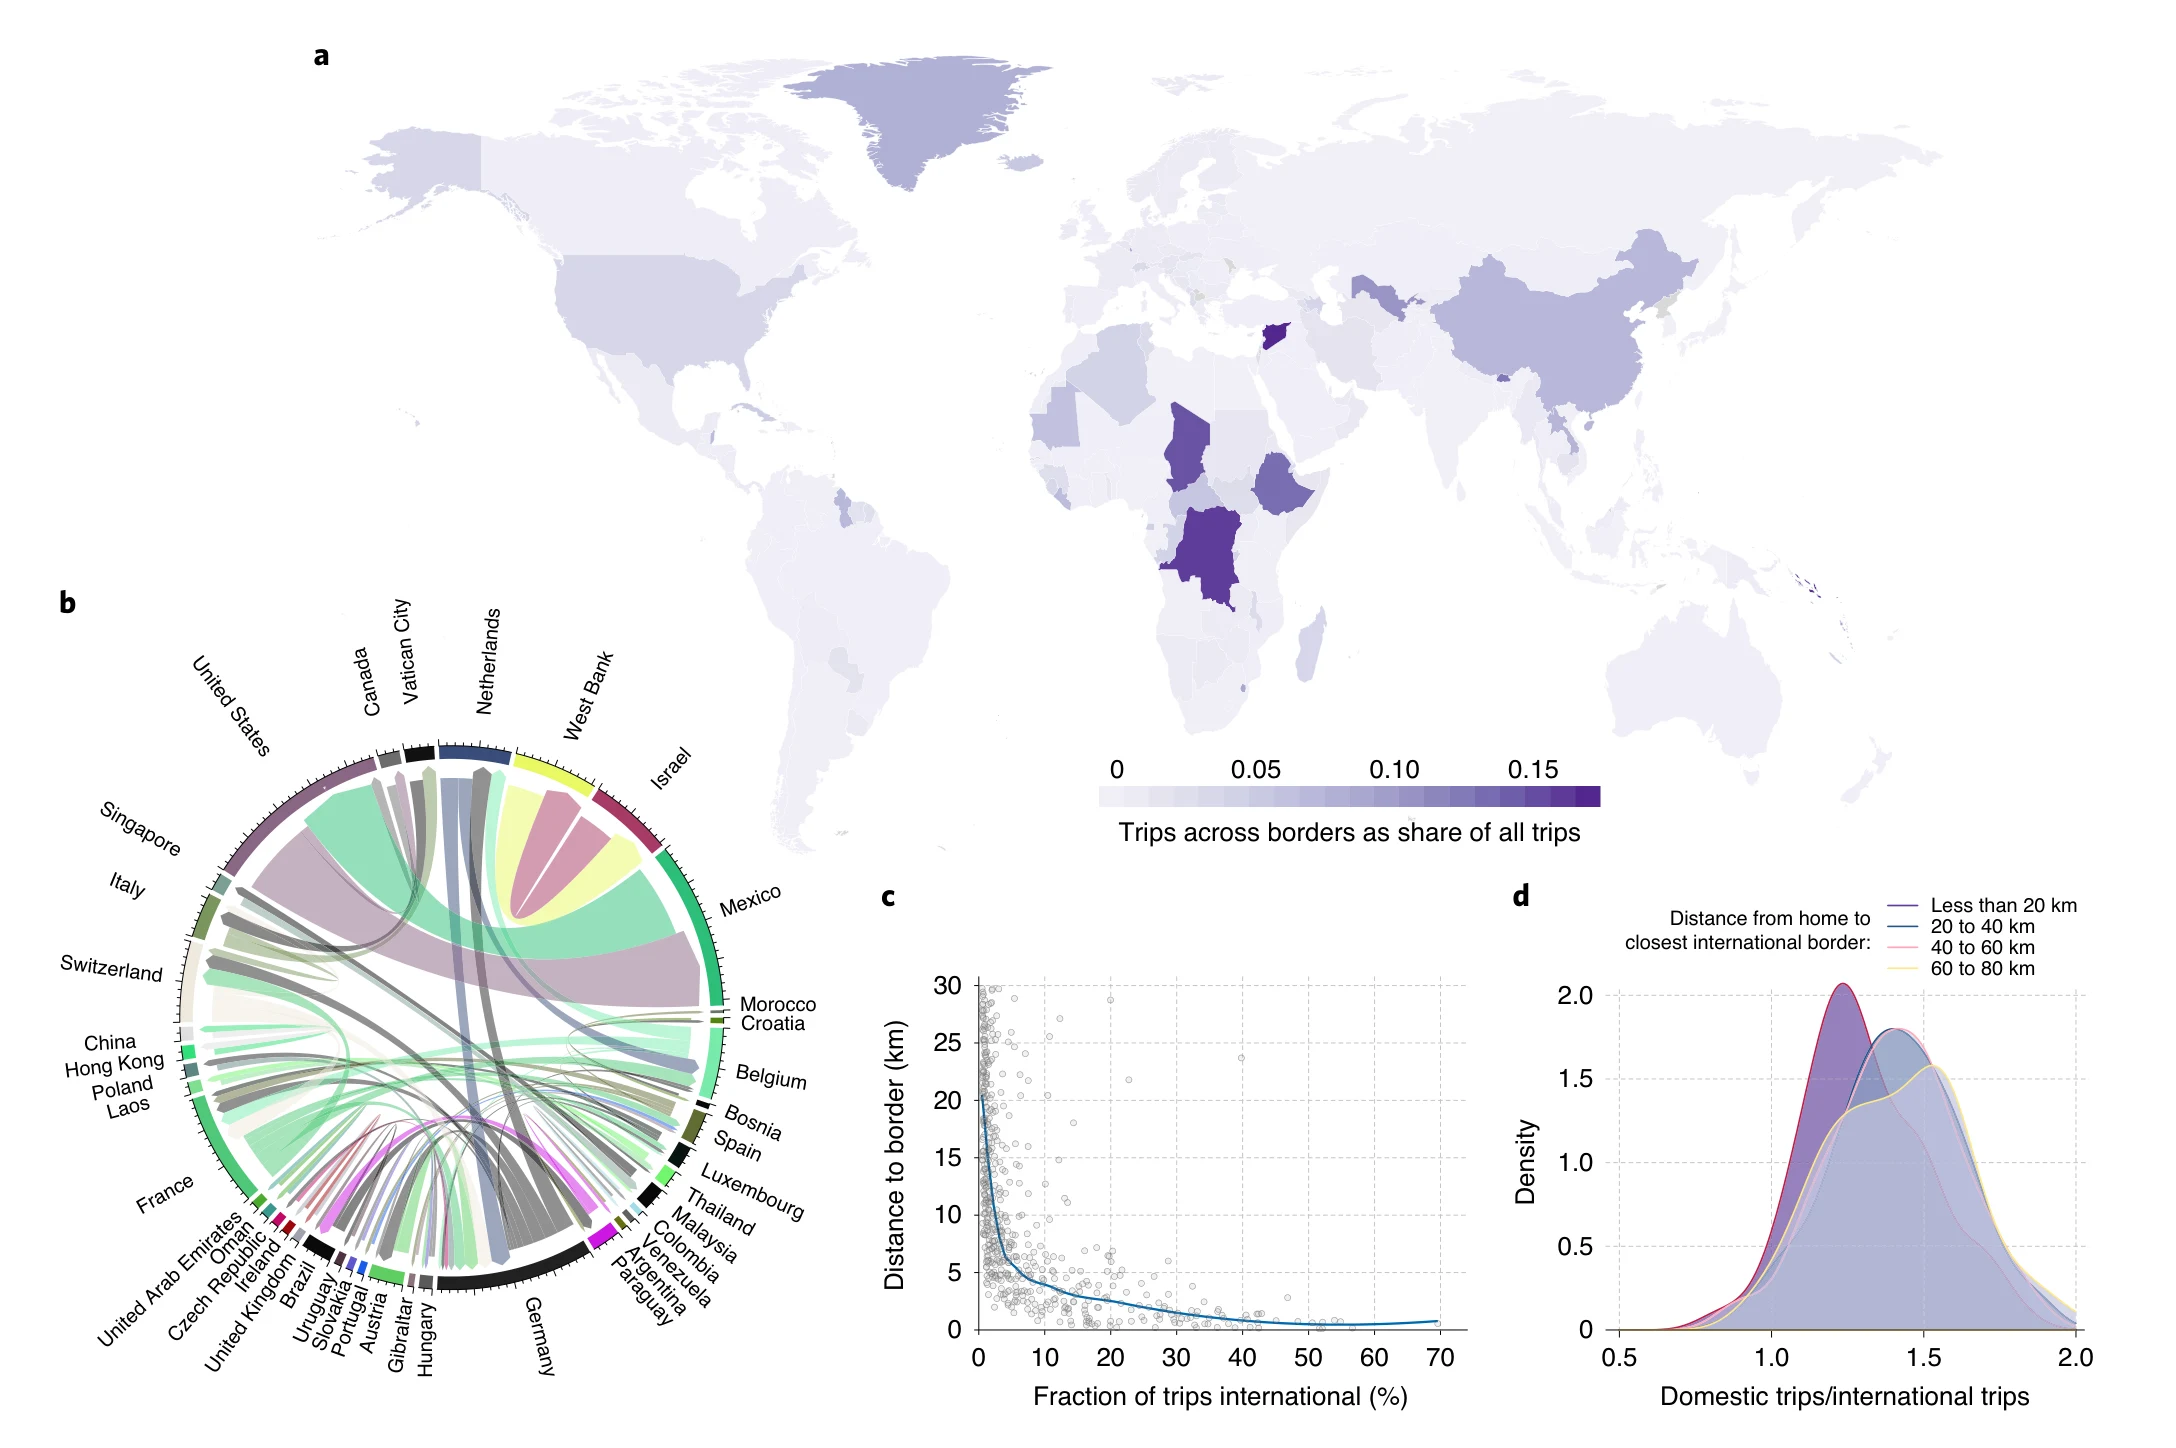
图 4|国际出行占多少,离边境多近时份额会变?
(a)地点对超过 100 的国家。颜色是国际流量除以该国全部流量,色标约从 0 到 0.15 以上;叙利亚为 22%,无数据为灰色。(b)记录流量最高的 10% 国家对,弧线有方向,并不包含全部 2,698 个国家对。(c)法国出境、瑞士入境。横轴是国际行程占全部行程的百分比,纵轴是到边境的距离,范围到 30 公里;点限于人口超过 1,000 且位于边境 30 公里内的地点。近边境处国际行程比例更高。(d)国内行程与国际行程之比的密度,按距最近国际边境不足 20 公里、20–40、40–60、60–80 公里分层。密度峰大多在比值 1 以上,表示这些距离带里国内行程总体多于国际行程;峰的位置不能代替正文的 28% 与 39%。来源:原论文 Fig. 4。
这些差异能支持到哪一步
样本是打开位置历史的手机用户,报告摘要写为被动收集、按周覆盖 2016 年。超过 3 亿是这套数据中的用户规模;29 亿是有数据格子里的常住人口。二者不能相加,也不能理解成 29 亿人各自贡献了一条轨迹。
低 SDI 国家的城市和道路附近更容易留下数据,乡村和高收入大国的地广人稀地区也会拉开城乡覆盖差。作者把数据汇总到国家,并用尺度不变的距离分布减轻城乡偏差。汇总同时抹掉了国内的城市与乡村差异。讨论明确写到,归一化之后的信息适合国家内部比较,不适合跨地区比较绝对流量。
只有 2016 年。国际流量在冲突或灾害年份可能明显不同。幂律、对数正态和指数分布的比较也只针对这一年的距离分布。拟合优度随国家面积、观测数量和 SDI 变化,小国即使发展水平较高,5 公里网格上的幂律仍然可能变差。
冲突国家更短的距离平台、叙利亚 22% 的国际流量,以及边境两侧的正负百分比,都是同年的空间对照。它们指出哪里的分布不同,还没有分离冲突、政策和原有交通网络。HAQI 与 SDI 本身高度相关,用它们解释 x_min 时,单个面板不能外推到该组没有出现过的指数区间。
作者在讨论中认为,可以跨国比较的移动分布有助于理解远距离和近距离上的后续过程。本文给出的是移动本身的分布、覆盖和拟合。标准 R 包完成分析,没有另写定制代码。242 个国家和地区的汇总可通过论文给出的链接获取;更细的聚合数据需要联系通讯作者,并经 Google 许可。
一句话总结
2016 年这套 5 公里聚合定位说明,大多数流量很短,较长行程的衰减速度和幂律开始的距离随社会发展水平改变,而少量国际流量又集中在位置接近、并受具体边境约束的国家之间。
核心来源
- Nature Human Behaviour 正式版,核对题目、作者、2020 年 5 月 18 日在线发表、卷 4 第 800–810 页,以及正文图 1–4、表 1–2。收稿日期 2019 年 4 月 13 日,接收日 2020 年 3 月 30 日。
- 论文数据可用性说明:242 个国家和地区的移动汇总见于作者给出的 https://bit.ly/2L7FXxc。聚合数据需向通讯作者申请并经 Google 审核。超过 50,000 个地点对的 74 个国家,其幂律拟合图由作者放在 https://goo.gl/uATMpF。
- 通讯邮箱见论文首页:moritz.kraemer@zoo.ox.ac.uk、bcreiner@uw.edu、john.brownstein@childrens.harvard.edu。
作者介绍
以下身份、同等贡献和分工均来自论文署名与作者贡献说明。
- Moritz U. G. Kraemer:共同第一作者,并与 Reiner、Brownstein 共同指导。署名哈佛医学院、波士顿儿童医院计算流行病学实验室和牛津大学动物学系,为通讯作者。参与研究构思、数据分析,并撰写初稿。
- Adam Sadilek:共同第一作者,署名 Google。参与研究构思和数据分析。
- Qian Zhang:共同第一作者,署名华盛顿大学健康指标与评估研究所。参与数据分析。
- Nahema A. Marchal:署名牛津大学互联网研究所。与全体作者一起参加后续修改。
- Gaurav Tuli:署名波士顿儿童医院计算流行病学实验室。
- Emily L. Cohn:署名波士顿儿童医院计算流行病学实验室。
- Yulin Hswen:署名波士顿儿童医院计算流行病学实验室,以及加州大学旧金山分校流行病学与生物统计学系。
- T. Alex Perkins:署名圣母大学生物科学系和 Eck 全球健康研究所。参与数据分析。
- David L. Smith:署名华盛顿大学健康指标与评估研究所和健康指标科学系。
- Robert C. Reiner Jr:署名上述华盛顿大学两个单位,为共同指导者和通讯作者。参与研究构思和数据分析。
- John S. Brownstein:署名哈佛医学院和波士顿儿童医院,为共同指导者和通讯作者。参与研究构思。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若要把这条距离规律用于交通或服务布局,应先按 x_min 把行程切开。中高收入环境里大约只有最高的 15% 数据落在幂律段,低收入环境里大约为 40%。界内的大多数移动更适合用格内份额和 20 公里以内的累积曲线描述,界外才用 α。只引用全球 α=1.87,会把高 SDI 组均值 1.80 和低 SDI 组均值 2.54 合成一个并不存在的“典型国家”。
第二个可检验的问题是手机样本的方向。论文认为低收入地区的设备更属于走得远的人,所以现有差距偏保守。要核验这一点,需要在同一批 5 公里格里比较有智能手机和没有智能手机的居民,而不是继续比较国家均值。2016 年单年也留着一个时间缺口:墨西哥方向在圣诞节前后相对周均最多增加 6%,说明国际流量会在几周内转向;一组国家的幂指数是否同样稳定,要用另一个独立年份重估 x_min 和 α。
第三个尺度问题出在边境。全国国际流量只占 2.2%,但 20 公里带内已经同时出现跨境高于国内的边境,和论文报告为大幅负值的受限边境。把国家总值赋给边境城市,会把梵蒂冈—意大利和以色列—加沙写成同一种渗透性。更有信息量的比较是把到边境的距离固定住,再看开放边境与紧张边境的国内/国际比值是否仍分离。