只换家、只换工作,和两边一起换,日常出行会收成同一种样子吗?
论文名片|Chenggong Li、Pu Wang、Dazhi Zhao、Shengnan Li,How job-housing relocations reshape mobility? Evidence from smartphone positioning data,Travel Behaviour and Society,2026,45:101363,2026年7月27日在线发表。DOI:10.1016/j.tbs.2026.101363。观察研究:用两年手机定位比较职住迁移类型与日常移动变化的关联。
设想 2023 年夏天到 2024 年夏天,长沙有三个人。一个人房子没动,单位从原来的园区换到了另一处;一个人单位没动,家搬过了一条可以走一刻钟的距离;还有一个人房子和单位一起换了。很容易顺着这个画面往下想:锚点一变,人就该出门更多、跑得更远。
同一年里,家和单位都留在原处的人,出行次数和活动范围也在变。只把搬家前后的自己比一遍,会把这座城市当年的整体变化算到搬家头上。论文要分开的,是三类迁移者从 2023 到 2024 年的变化,比未迁移者的变化多出来还是少下去的那一截。
方向先说清楚。相对未迁移者,三类迁移都更接近把一天里的行程合并:日出行次数的增幅更小,单次停留没那么快变短,两边一起换的人最明显。活动范围并没有一起放大。回转半径只在两边一起换的人身上相对下降;只换家或只换工作的人,平均直线出行距离相对变长,两边一起换的人相对变短。两边一起换,也不是两次单边变化相加。这些是加权之后的组间差异,搬家本身不是随机分配的。
先说结论
- 能识别出居住地和工作地的通勤者有 196,899 人。家和单位都没有跨出 1.5 公里的未迁移者占 156,057 人;只搬家 13,785 人,只换工作 19,777 人,两边都换 7,280 人。
- 四组的日出行次数中位数都在上升、平均停留都在下降。相对未迁移者,迁移者的次数增幅更低、停留降幅更小;两边都换的系数最大。这是变化量的差别,不是迁移者的出行次数比前一年更少。
- 回转半径只有两边都换的人显著低于未迁移者。希普斯定律指数的下降出现在只搬家和两边都换的人身上,只换工作与未迁移者没有可靠差别。平均出行距离则分成两路:只换一边的人相对变长,两边都换的人相对变短。
- 两边都换的效应不等于两次单边效应之和。居住地和工作地周边建成环境的前后变化,只解释了大多数系数里较小的一块;只搬家者的出行距离是例外,环境变化能对上其中约 42.52%。
同一年所有人的出行都在变,比较对象为什么是没搬家的人?
出行生命历程(mobility biographies)把居住地、工作地看成生命历程里的关键事件,习惯中断假说(habit-discontinuity hypothesis)则认为原来的情境一旦断开,日常路线就更容易被重新安排。既有调查也确实看到过搬家之后通勤方式、次数和活动范围的变化。那些研究多半只看搬家的人自己,或者把换家和换工作拆开,样本往往是几百到几千份问卷。
手机定位可以同时跟上很多人的家和单位,但两年之间城市也在变。若未迁移者的出行次数同样上升,迁移者次数上升就不再能单独写成搬家的后果。所以参照组必须是同一窗口里家和单位都没跨过阈值的人。
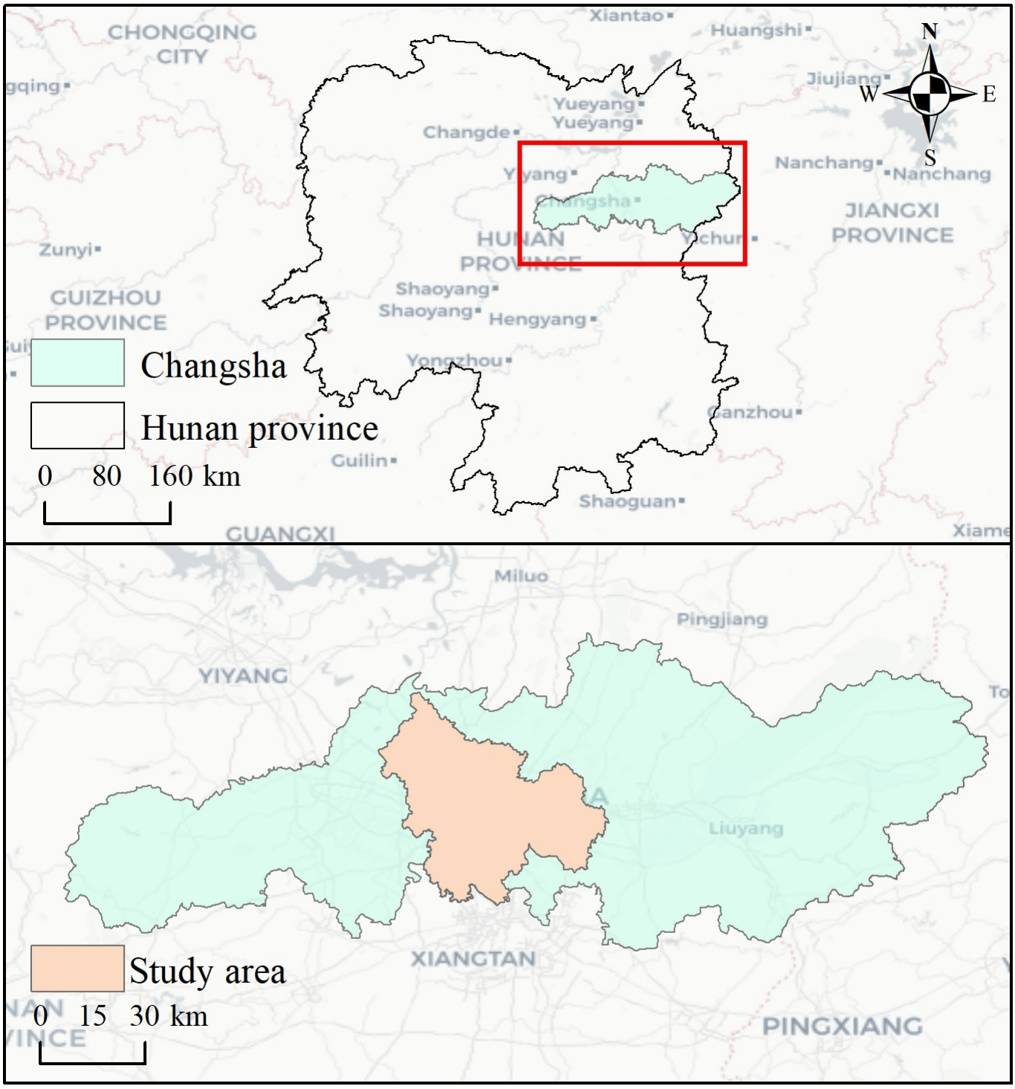
图 2|研究区卡在长沙的哪一片?
上图把长沙标在湖南省内,红框标出下图的范围,比例尺 0–160 公里。下图浅橙色是研究区,外围仍属长沙市域,比例尺 0–30 公里。研究区覆盖长沙全部兴趣点的 75.88%。作者引用市政府资料,写明长沙 2024 年末人口达到 1,000 万;这个人口数不是从手机样本推出来的。来源:原论文 Fig. 2。
数据是装有软件开发工具包、并取得用户明确同意的手机定位,精度大约 30–50 米,附有脱敏后的性别、年龄段、收入档、教育档、是否有车、家里是否有孩子。观察窗是 2023 年和 2024 年各自的 5 月 1 日到 6 月 30 日。速度超过 120 公里/小时的点被标成异常。一天里至少 12 个小时窗有记录,才算有效日;每个两年窗口里有效日超过 30 天的人算活跃用户。这样留下 1,253,930 名活跃用户。
停留点沿用 TimeGeo 的规则:连续点待在 50 米半径内、并且超过 5 分钟。每人每年还要去掉离家长途日。若某天离开推断居住地的最远停留超过该年两个月里日最大距离的第 95 百分位、并且也超过 100 公里,这一整天的停留都删掉。剩下的停留才进入后面的计算。正文没有逐项列出从 1,253,930 人筛到最终通勤者的每一步人数。
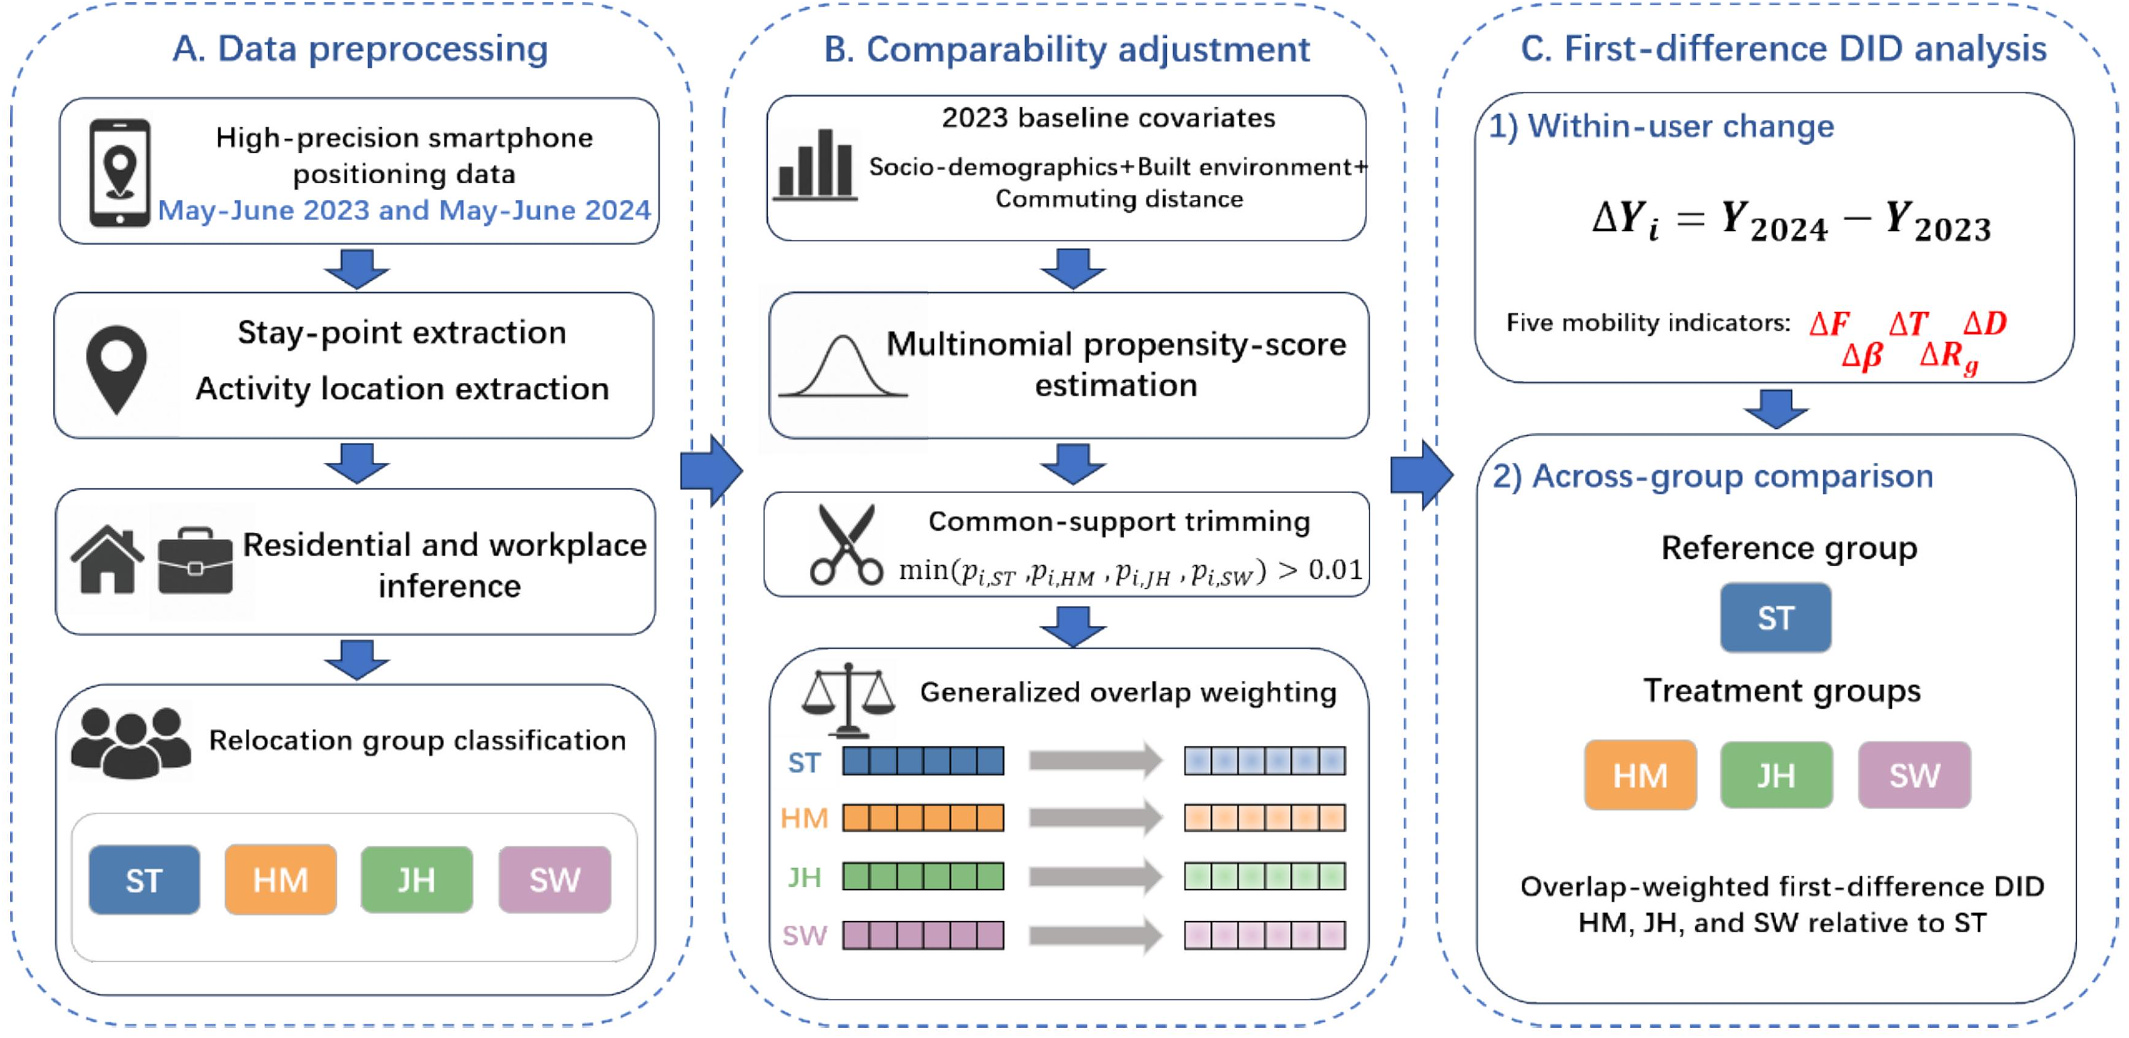
图 1|整条比较是怎样串起来的?
(A)数据预处理使用 2023 与 2024 年 5–6 月的高精度定位,提取停留点和活动地点,推断居住地与工作地,再分成未迁移者 ST、只搬家者 HM、只换工作者 JH、职住双迁者 SW。(B)用 2023 年的社会人口、建成环境和通勤距离估计四类倾向得分,去掉四类得分最小值不超过 0.01 的人,再做广义重叠加权。(C)先算每个人 2024 年减 2023 年的指标变化,再把三个迁移组与 ST 比较。五个指标是出行次数、停留时长、出行距离、希普指数和回转半径。来源:原论文 Fig. 1。
定位点怎样变成家、单位,以及一次迁移?
活动地点用 DBSCAN 把相邻停留并到一起,邻域半径 100 米,至少 3 个点。家和单位不是“出现最多的点”这么简单,因为有人上夜班。
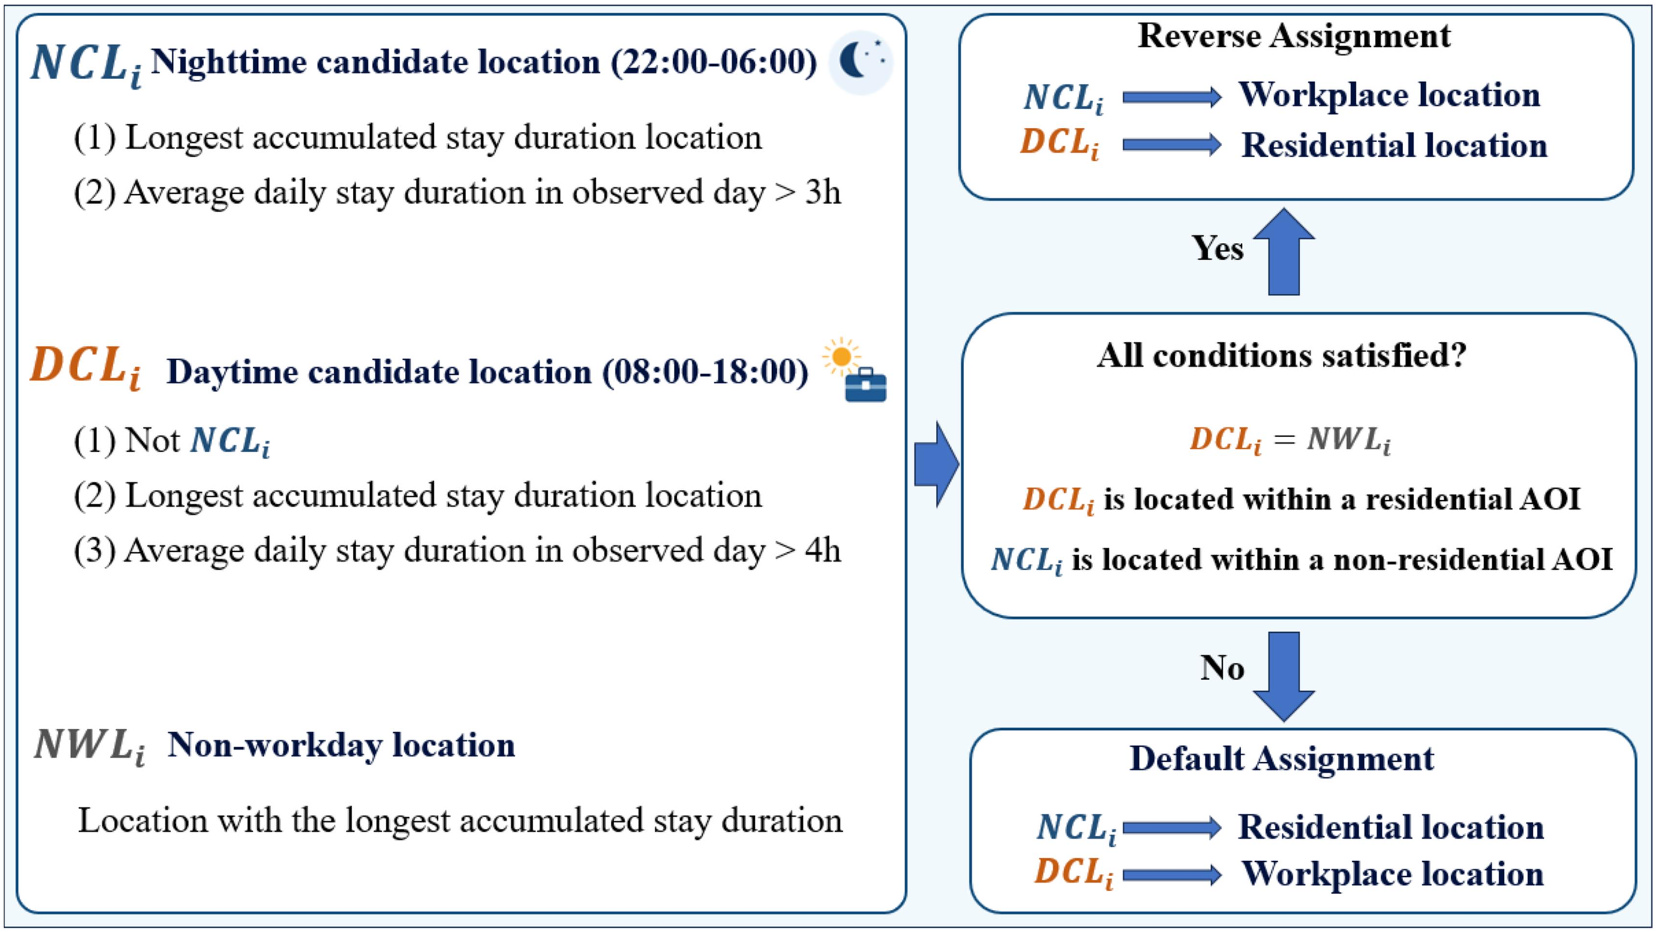
图 3|夜班的人会不会被把家和单位标反?
左侧先定三个候选位置。夜间候选位置 NCL 是工作日 22:00–06:00 累计停留最久、且在被观测到的日子里日均超过 3 小时的地点。白天候选位置 DCL 不能是 NCL,取工作日 08:00–18:00 累计最久、日均超过 4 小时的地点。非工作日位置 NWL 是周六、周日和假日停留最久的地点。右侧默认把 NCL 当家、DCL 当单位。只有三件事同时成立才对调:DCL 与 NWL 是同一地点,DCL 落在居住类兴趣面内,NCL 落在非居住类兴趣面内。对调之后,DCL 是家,NCL 是单位。来源:原论文 Fig. 3。
迁移看的是两年推断坐标之间的直线距离,超过 1.5 公里记一次搬迁。1.5 公里对应规划里常说的 15 分钟生活圈:按大约 1.6 米/秒的步行速度,15 分钟大约是 1.5 公里。没超过这个距离的家或单位,在本文里仍算没搬。因此搬到隔壁小区、但直线距离不到 1.5 公里的人,会留在未迁移者里。
四类人是两件事情的组合。未迁移者(stayers,ST)家和单位都没超过 1.5 公里,回归里作为参照组。只搬家者(home movers,HM)只换居住地。只换工作者(job hoppers,JH)只换工作地。职住双迁者(job-and-residence switchers,SW)两处都换。正文把归不进这个 2×2 的特殊情形放到附录,这里不转述未见的分类。
按这个规则识别出 196,899 名通勤者:
| 组别 | 人数 | 占 196,899 人 |
|---|---|---|
| 未迁移者 ST | 156,057 | 79.3% |
| 只搬家者 HM | 13,785 | 7.0% |
| 只换工作者 JH | 19,777 | 10.0% |
| 职住双迁者 SW | 7,280 | 3.7% |
一年窗口里未迁移者占将近八成,和观察期不长是相符的。这 196,899 人已经是能稳定标出家和单位的通勤者,不是前面的 1,253,930 名活跃用户,更不是长沙全部人口。样本里女性 119,682 人(60.8%),数据商标记为有车的 27,381 人(13.9%)。有车这一档不能当成全市汽车保有率。
五个指标各看日常移动的哪一面?
五个指标都在个人—年份上计算,随后进入模型的是 2024 减 2023。
回转半径(radius of gyration,Rg)是到活动重心的典型距离,具体是各访问地点离重心的均方根距离,单位在描述统计里用米。它大,表示活动铺得开,不等于通勤这一条路变长。
日均出行次数 F 是平均每天多少次出行。平均停留时长 T 是每次停留平均多久,描述统计里用分钟。次数下降而停留变长,被作者称为行程合并(trip consolidation):一天里的外出被收成更少、停得更久的几段。
希普斯定律指数 β 来自 S(t) = k t^β。S(t) 是累计到的不同地点数,t 按小时计。β 低,表示新地点积累得更慢。它不等于地点总数,也不等于这些地点离得有多远。
平均出行距离 D 是相邻停留点之间的直线距离再取平均,不是沿路里程,也不是家到单位的通勤距离。通勤距离只作为 2023 年的基线协变量,用来帮助各组更可比。
除 β 直接用水平值的年度变化外,其余四个指标的回归结果都是 Δlog(1+指标)。对数拉开尺度,也避免把米、分钟和次数放在一张图上时无法比较。系数因此不是“少了 0.02 次”或“短了 0.12 米”。
四组人本来就不住在同一张地图上,直接比变化会偏在哪里?
2023 年的家到单位通勤距离,中位数已经不同:未迁移者 3.120 公里,只搬家者 4.090 公里,只换工作者 4.796 公里,双迁者 2.456 公里。只换工作者一开始通勤最长,双迁者最短。若忽略这组差别,后面只换工作者出行距离上升,可能只是他们本来就跑远路。
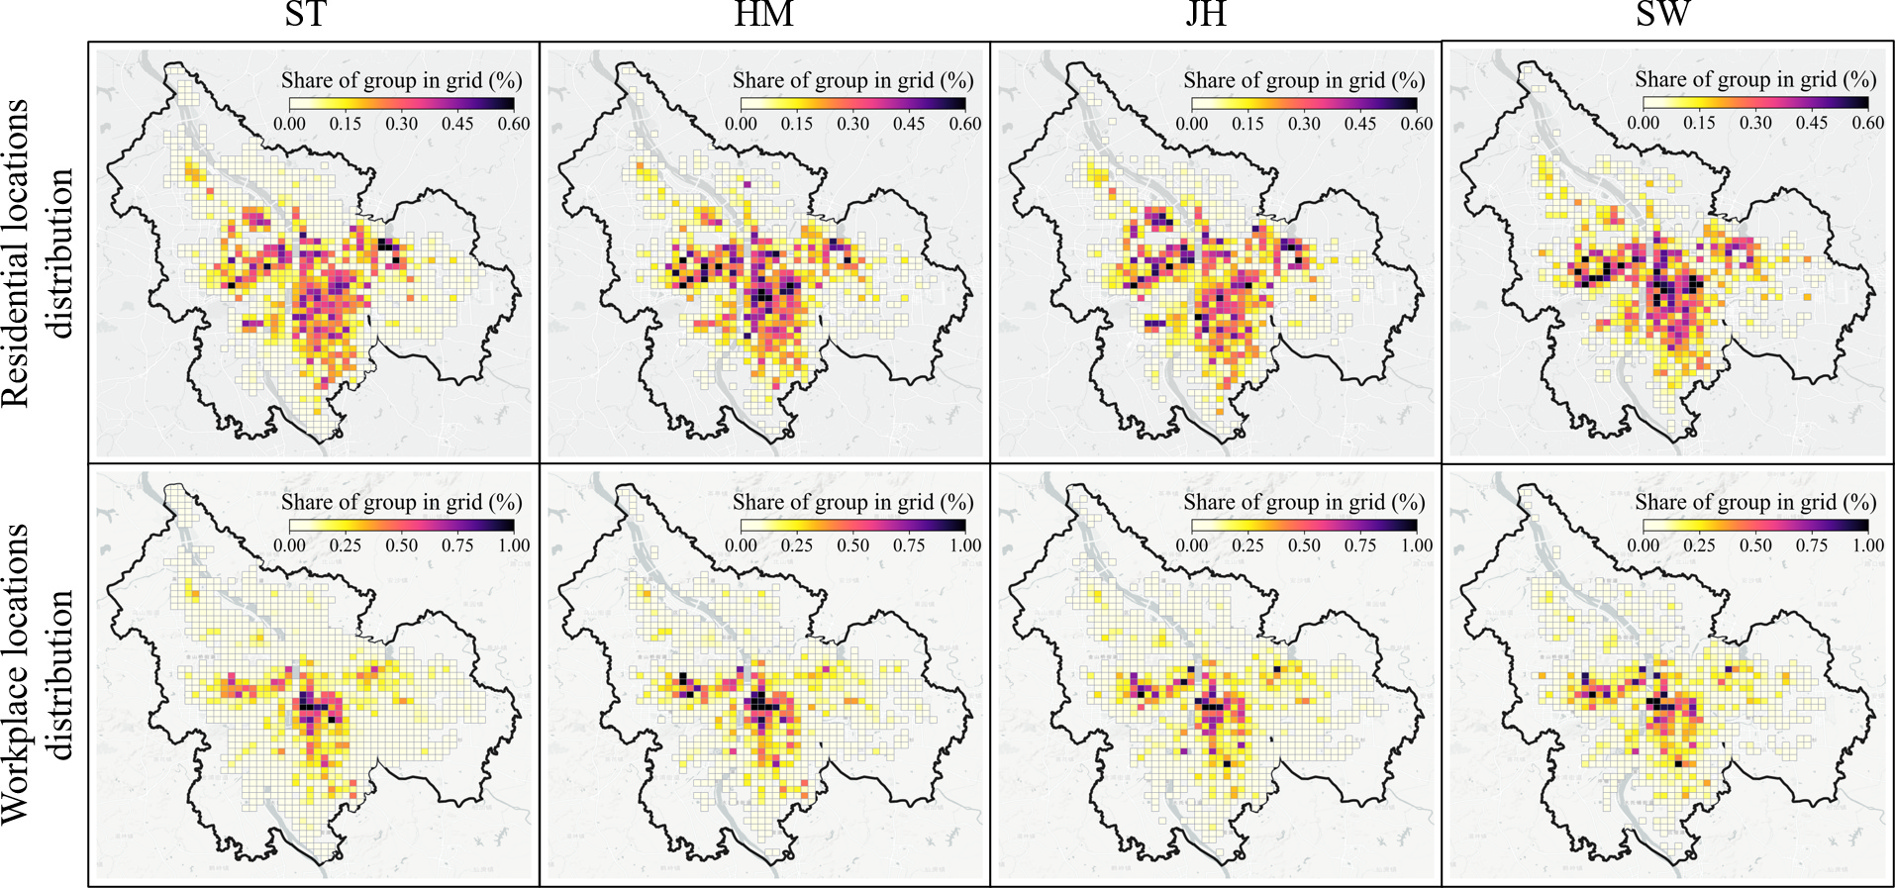
图 5|搬家之前,家和单位在城市里怎么铺?
八幅图都是 1 公里网格。颜色是该组自己的人数份额,不是绝对人数,所以组小人少不会只因为样本小而发白。同一行共用一把色标:上排居住地是 0–0.60%,下排工作地是 0–1.00%。上排从左到右是 ST、HM、JH、SW 的家,四组都铺得比较散。下排是对应的单位,明显更挤在中心一带。双迁者的家和工作地图与未迁移者差得最大。来源:原论文 Fig. 5。
这个“差多少”用相对 ST 的詹森–香农散度来量化。居住地:SW 0.058,HM 0.038,JH 0.020。工作地:SW 0.061,HM 0.026,JH 0.040。散度不是人数,也不是平均搬家距离。它只说明双迁者的家和单位分布最不像未迁移者,所以后面不能把四组直接放在一起比均值。
加权用的是 2023 年基线,分成四块:社会人口(性别、年龄段、收入档、教育档、是否有车、是否有孩子),居住地 500 米内的建成环境,工作地 500 米内的建成环境,以及通勤距离。建成环境包括到市中心的距离、到最近公交站点的距离、用地比例和土地利用的香农指数。香农指数高,表示 500 米圈子里的用地更混杂。收入和教育在正文里只有低、中、高三档,没有给出金额或学历界限。
只搬家者里,高收入档占 7,019/13,785(50.9%),未迁移者是 67,413/156,057(43.2%)。双迁者里男性占 3,347/7,280(46.0%),未迁移者是 60,666/156,057(38.9%)。这些差别说明迁移组和参照组本来就不是同一类人。
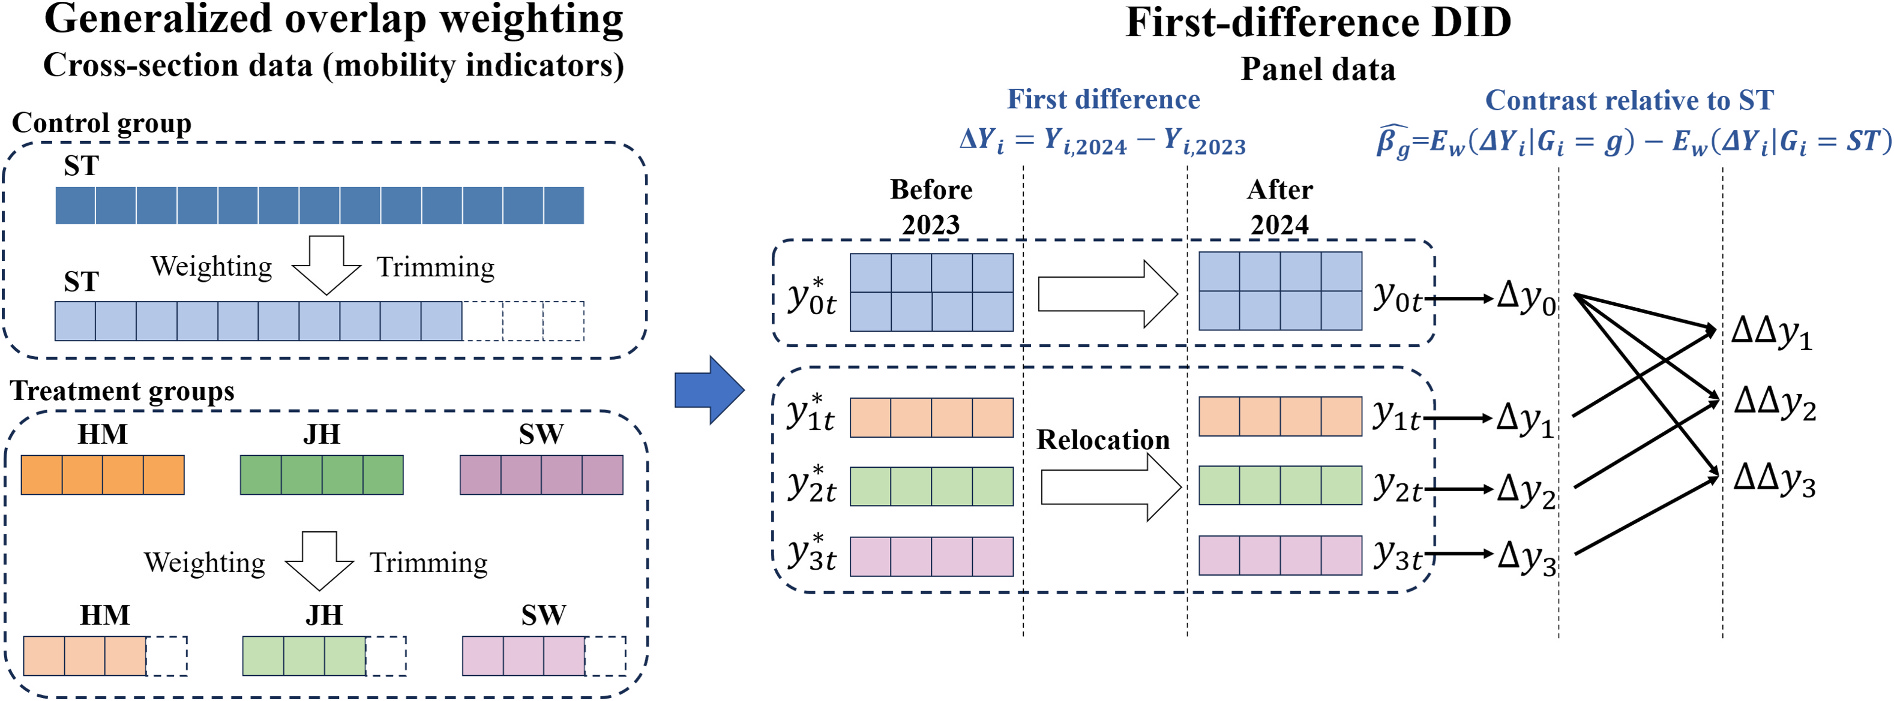
图 4|加权和差分各去掉哪一种不可比?
左半边是广义重叠加权。ST 是对照,HM、JH、SW 是三个处理组。每个人先有四个组别的预测概率,权重按这四个概率的调和平均来压低极端概率;虚线格子表示共同支撑之外、被修剪掉的部分。右半边是一阶差分:同一人 2024 年减 2023 年,再把三个处理组的变化均值减去 ST 的变化均值。图中的公式把这个差写成加权期望之差。来源:原论文 Fig. 4。
倾向得分是给定基线特征后,落入某一组的条件概率。四组都要有人,作者用广义重叠加权(generalized overlap weights,GOW):权重等于四个倾向得分调和平均,再除以这个人实际所在组的得分。极端概率的人权重下降。另外要求四个得分的最小值大于 0.01,否则删去。
修剪后保留 196,402 人,比 196,899 人少 497 人。加权后的有效样本量是:ST 147,820.8(名义 155,668),HM 13,010.1(13,741),JH 18,050.4(19,731),SW 6,966.0(7,262)。有效样本量没有缩成名义人数的一个零头,权重还算平稳。
回归写成一阶差分。结果变量是 ΔY = Y₂₀₂₄ − Y₂₀₂₃。模型里放三个互斥的组别指示,ST 省略:
ΔY = α + β_HM·HM + β_JH·JH + β_SW·SW + ε
β_HM、β_JH、β_SW 是加权之后,该组年度变化均值减去未迁移者年度变化均值。两期差分会吸收不随时间改变的个人差异,也会吸收两年共同的时间冲击。它吸收不了随时间变化的遗漏因素,也不能把搬家变成随机实验。标准误是异方差稳健的 HC1。
次数都在增加,为什么论文仍说迁移者把行程合并了?
先看各组自己的中位数,再看组间的变化差。表中百分比是中位数的变化,和四舍五入后的中位数相除不一定逐位相等。星号来自组内的配对 Wilcoxon 检验。
| 指标 | ST | HM | JH | SW |
|---|---|---|---|---|
| 回转半径 Rg(米) | 8,875 → 9,990(+12.6%) | 11,152 → 12,665(+13.6%) | 9,294 → 10,258(+10.4%) | 10,014 → 10,018(0.00%,组内不显著) |
| 停留时长 T(分钟) | 204 → 190(−6.6%) | 189 → 177(−6.6%) | 200 → 189(−5.4%) | 209 → 206(−1.0%) |
| 日出行次数 F(次/日) | 4.9 → 5.3(+9.7%) | 5.2 → 5.6(+7.8%) | 4.9 → 5.3(+7.6%) | 4.7 → 4.8(+2.0%) |
| 希普指数 β | 0.65 → 0.65(+1.0%) | 0.67 → 0.67(+0.7%) | 0.66 → 0.67(+1.5%) | 0.65 → 0.65(−0.20%,组内不显著) |
| 平均出行距离 D(米) | 2,742 → 2,769(约 +1.0%,无星号) | 3,411 → 3,485(+2.2%) | 3,170 → 3,259(+2.8%) | 2,718 → 2,753(约 +1.3%,无星号) |
β 的中位数印到小数点后两位,所以 +1.0% 或 −0.20% 仍可能显示成 0.65→0.65。除 SW 的回转半径和希普指数,以及 ST、SW 的平均出行距离外,组内变化都标了显著。四组放在一起的 Kruskal–Wallis 检验,五个指标都显著。秩检验的效应却不大:两两比较里,秩双列相关绝对值最大只有 0.076(出现在次数上),距离是 0.037,回转半径是 0.043。十九万人的样本里,很小的分布位移也会显著。
描述统计和后面的回归不是同一个问题。组内检验问的是这一组自己有没有变;回归问的是变化幅度比未迁移者高还是低。四组次数中位数都上升,ST 从 4.9 次升到 5.3 次,SW 只从 4.7 次升到 4.8 次。相对来说,SW 少增加了出行。停留时长四组都在缩短,SW 只缩短约 1.0%,ST 缩短 6.6%。相对来说,SW 的停留更抗跌。论文说的行程合并,指的是这种相对变化。
秩检验还给出分组字母。次数上 ST、HM 与 JH、SW 分成三档,SW 的增幅最小。回转半径上只有 SW 单独一档,其余三组没有被分开,和“三组中位数都上升大约一成、SW 几乎不动”一致。距离上 HM 与 JH 的变化更大,ST 与 SW 共享同一档。停留时长的字母更碎:SW 单独一档,JH 与 ST 分开,HM 和这两档都有重叠。β 上 ST 与 JH 较高,HM 与 SW 较低。
相对没迁移的人,三类变化差多少?
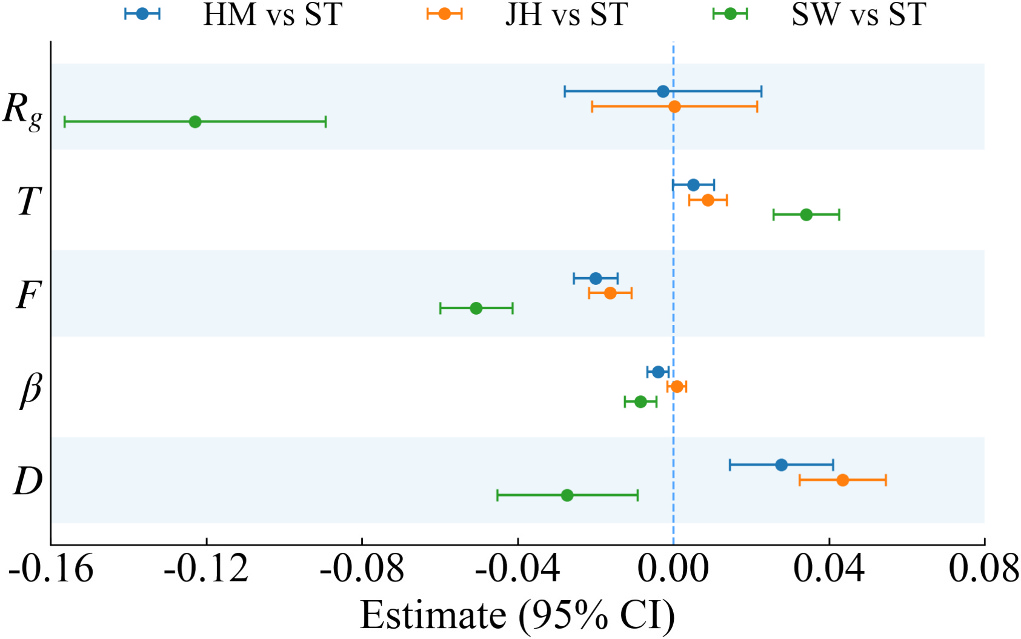
图 6|哪几个系数离开了 0?
全图一个面板。纵轴自上而下是 Rg、T、F、β、D。横轴是 2024 减 2023 的系数和 95% 置信区间,虚线是 0。蓝色是 HM 相对 ST,橙色是 JH 相对 ST,绿色是 SW 相对 ST。绿点在 Rg、F、D 上明显偏负,在 T 上偏正;蓝点和橙点在 D 上偏正,在 Rg 上贴着虚线。β 的三组点都挤在 0 附近,要配合下表的标准误才分得清谁显著。来源:原论文 Fig. 6。
主回归就是修剪后的 196,402 人,使用上面的权重。下表系数对应 Fig. 6,括号是 HC1 标准误。交互项 δ = β_SW − β_HM − β_JH,图上没有画。
| 指标 | HM | JH | SW | 交互 δ |
|---|---|---|---|---|
| Rg | −0.0027(0.0129) | 0.0003(0.0108) | −0.1230(0.0171) | −0.1205(0.0235) |
| T | 0.0051(0.0027) | 0.0089(0.0025) | 0.0341(0.0043) | 0.0201(0.0056) |
| F | −0.0200(0.0028) | −0.0163(0.0028) | −0.0507(0.0047) | −0.0144(0.0061) |
| β | −0.0040(0.0014) | 0.0008(0.0013) | −0.0085(0.0021) | −0.0053(0.0027) |
| D | 0.0277(0.0068) | 0.0435(0.0057) | −0.0273(0.0092) | −0.0984(0.0125) |
星号口径按原文:Rg 的 SW 与交互,T 的 JH、SW 与交互,F 的三个组别,β 的 SW,以及 D 的 HM、JH 与交互,均为 p < 0.001。D 的 SW、β 的 HM 为 p < 0.01。F 的交互为 0.01 ≤ p < 0.05。T 的 HM、β 的交互只到边际显著(0.05 ≤ p < 0.1)。HM 的 Rg、JH 的 Rg 和 β,区间跨过 0。
次数上,三个迁移组的对数变化都低于未迁移者,SW 的 −0.0507 大约是 HM −0.0200 的 2.5 倍、JH −0.0163 的 3.1 倍。停留上,JH 与 SW 显著为正,HM 的 0.0051 只是边际显著;SW 相对两个单边系数的倍数更大。作者把这种模式概括成双迁的行程合并大约是单边迁移的两倍。次数上这个概括接近系数之比,停留上双迁更突出,因为单边组的停留系数本身很小。
回转半径上,HM 与 JH 和未迁移者几乎没有差别,SW 为 −0.1230。这和中位数对得上:ST、HM、JH 的中位数都上升约 10%–14%,SW 的中位数停在 1 万米出头。−0.1230 是 log(1+Rg) 的变化差。Rg 的中位数大约是 9–12 公里;若取值 1 万米,log(1+Rg) 大约是 9。这只是为了看清 0.12 在对数尺度上的位置,不是论文另报的统计量,更不是“半径缩短了 0.123 米”。
β 的系数是水平值之差,量级只有千分之几,对照的基线中位数大约 0.65。HM 与 SW 显著为负,JH 的 0.0008 不显著。只换工作的人,新地点积累速度并没有相对放慢。
距离上,HM 为 0.0277,JH 为 0.0435,SW 为 −0.0273。只换一边,平均直线出行距离的对数变化更高;两边一起换,则更低。SW 的中位数只从 2,718 米升到 2,753 米,组内并不显著,ST 的中位数变化大约 +1.0%、同样没有星号。组内“自己没明显变”和组间“变化均值更低”可以同时成立,因为一个看中位数和配对秩,一个看加权后的对数变化均值。
两边一起换,为什么不是只搬家再加上只换工作?
交互项问的是:SW 的系数,和 HM 与 JH 两个系数之和相比,还有没有剩差。δ 显著为负的有回转半径(−0.1205)、次数(−0.0144)和距离(−0.0984)。停留的 δ 为 0.0201,显著为正。β 的 δ 为 −0.0053,只到边际显著。
停留上,双迁的正系数大于两个单边系数之和,合并得比“加总”更强。次数上,双迁的负系数也比两个单边之和更负,同样是合并得更强。距离和回转半径相反:两个单边距离系数都为正,加起来大约是 +0.071,双迁却是 −0.0273。若双迁只是一次搬家叠一次换工作,平均出行距离应继续变长;估计到的方向是变短。回转半径的两个单边系数接近 0,双迁的下降几乎全部落在交互里,而不是某一边单独贡献的。
作者因此说,多数指标上双迁效应小于两个单边效应之和,停留时长是例外。完整的两两 Wald 检验在附录里,正文没有逐对列出 HM 与 JH 的每一个 p 值。从主表能直接读到的是:次数和停留上两个单边组的系数接近,距离上只换工作的正系数更大。
搬到离市中心和公交更远的地方,能解释这些差异吗?
迁移会改写一个人身边的建成环境。作者在两年上都测量了居住地和工作地周边,再把前后差放进同一套加权回归。若系数因此明显变小,就说明原效应里有一块跟着环境暴露走。
加权后的平均变化里,未迁移者接近 0,这符合“位置没怎么动”。只搬家者的居住地到市中心平均远了 936 米,到最近公交站点远了 35 米,500 米内香农指数下降 0.059。居住用地占比只上升 0.023 个百分点,未迁移者是上升 0.083 个百分点;双迁者的居住用地占比则下降 1.899 个百分点。只换工作者的变化主要在单位一侧:工作地到市中心平均远了 509 米,到最近站点远了 15 米,500 米内商业和工业用地占比下降 0.943 个百分点,香农指数下降 0.031。双迁者两边都在变,居住地到市中心远了 457 米,工作地远了 354 米,单位周边商业和工业用地占比下降 1.569 个百分点。
这些是环境暴露的平均变化,还不是它们对出行系数的解释份额。解释份额等于环境变化所对应的那一块,除以该组的总效应。下表的破折号是原文就没有给出的格子,对应总效应不显著或只有边际显著。份额所除的总效应,是在建成环境样本上重估的,和主回归接近,但不是同一套数字。例如距离的 HM 总效应在这张表里是 0.0248,主回归是 0.0277。正文没有单独写出这个样本的人数。
| 指标 | HM 的解释份额 | JH 的解释份额 | SW 的解释份额 |
|---|---|---|---|
| Rg | — | — | −3.94% |
| T | — | 10.31% | 0.76% |
| F | 0.58% | 7.66% | 1.79% |
| β | 3.49% | — | 2.4% |
| D | 42.52% | 3.68% | −16.24% |
大多数显著系数里,环境份额只有几个百分点。只换工作者的停留时长超过 10%(10.31%),系数从 0.0098 降到调整后的 0.0088,方向不变。真正大的一块是只搬家者的出行距离:42.52%。调整后系数从 0.0248 降到 0.0143,仍然为正,并且仍显著。居住地离市中心和公交更远,可以对上这个距离变长的一部分,对不上全部。
双迁者的距离份额是 −16.24%。负号表示测到的环境变化与总效应方向相反:总效应是 −0.0313,扣掉环境之后变成 −0.0363,相对变短的那一截还略大。双迁者的家和单位平均都离市中心更远,但他们相对未迁移者的平均出行距离在缩短。用“搬远了所以路程变长”解释双迁,和这张表的方向对不上。
这些关联能说到哪一步?
比较的是重叠较好的那部分人,不是把长沙每一个通勤者都外推一遍。权重改善的是观测到的基线特征。出行态度、为什么搬家、家庭谈判和岗位约束没有直接测量。居住自选择(residential self-selection)仍可能留在残差里:愿意两边一起换的人,也许本来就把日常安排收得更紧。
只有两年,而且每人只有一个搬家前窗口和一个搬家后窗口。正文没有每个人的搬家月份,所以系数是两个夏天之间的变化差,不是搬家后第几周的反应。作者用 2023 年 5 月对 6 月做了安慰剂变化,组别仍按 2023 到 2024 的迁移来定,并在 5 个指标乘 3 个组别共 15 次检验上控制错误发现率。安慰剂系数写在附录里,正文没有列出,这里不能把安慰剂说成已经通过或没有通过。
出行方式也没有进入指标。定位的时间分辨率不够把步行、公交和驾车分开。D 变长可以是同一种方式走得更远,也可以是方式换了;这两件事在本文里是同一条直线距离。
作者还明确说,结果不要直接搬到别的城市。城市形态、公交、职住是否邻近、用地混合和就业的空间分布,都会改写距离和半径的方向。框架可以换城市重做,数值不能当成长沙以外的效应。
一句话总结
相对同一年里家和单位都留在 1.5 公里内的人,只换一边的人平均直线出行距离更长,两边一起换的人则把新增的出行次数、活动范围和单次距离收得更紧;后者并不是前两者相加。
核心来源
- Travel Behaviour and Society 正式发表页,核对题目、作者、卷期和在线日期。正文依据该刊 2026 年第 45 卷文章 101363;收稿日期 2026 年 1 月 24 日,接受日 2026 年 7 月 21 日,2026 年 7 月 27 日在线发表。
- 文中图 1–6 与全部样本、系数均来自这篇正式发表版的正文和表 1–9。广义重叠加权的平衡诊断、安慰剂系数、家和单位识别的验证,以及部分两两检验,写在在线附录中,正文未列出具体数值。
- 通讯作者 Pu Wang 的单位与研究方向,核对自中南大学教师主页,电子邮箱与论文一致。
作者介绍
四位作者在论文中的署名单位都是中南大学交通运输工程学院。下面只写论文中的贡献,以及能从学校页面核对的身份。
- Chenggong Li:撰写初稿,并负责可视化、验证、方法、形式分析与数据整理。
- Pu Wang(王璞):通讯作者,中南大学交通运输工程学院教授、博士生导师,研究交通大数据、居民出行、交通地理与交通政策。文中负责概念、方法、资源、监督和审阅。论文致谢写明其研究得到湖南省教育厅科研项目 24A0016 支持。
- Dazhi Zhao:参与方法,并审阅文稿。
- Shengnan Li:参与数据整理,并审阅文稿。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个更新项目只把住房向外挪、工作地不动,更接近本文的只搬家者:居住地到市中心的平均变化是远了 936 米,相对未迁移者的平均直线出行距离变长,回转半径却没有可靠地一起变大。若产业园和配套住房一起搬,更接近双迁者:距离系数的符号会翻过来。把“只搬家的距离变长”和“只换工作的距离变长”加在一起,大约是 +0.071;双迁的主回归系数是 −0.0273。用两次单边评估相加,去预报一个职住同步搬迁项目的出行距离,方向就会反。
另一个容易读反的算法是只追踪搬家者自己。未迁移者的日出行次数中位数从 4.9 次升到 5.3 次,只搬家者从 5.2 次升到 5.6 次。只看搬家者的前后差,会把城市当年的上升算成搬家使人更爱出门。和未迁移者一比,次数的相对变化是负的。监测看板若只有迁移家庭的前后两列,就会稳定地得到这个误读。
双迁者也不像一组特别年轻、没有孩子、所以日子本来就收得紧的人。30–40 岁占 3,278/7,280(45.0%),未迁移者是 66,640/156,057(42.7%);有孩子的比例是 5,248/7,280(72.1%),未迁移者是 114,705/156,057(73.5%)。年龄和孩子这两项差得有限。他们更突出的是男性比例更高、2023 年通勤中位数更短。短通勤加上两边都能换,也许意味着这组人有能力把家和单位重新捆到更近的一组地点上。本文没有搬家原因,这个读法仍要单独检验;它至少说明,双迁者的行程合并很难直接写成“因为他们更年轻”。