为了更复杂的工作地,谁会把通勤走得更远?
论文名片|Ollin D. Langle-Chimal、Steffen Knoblauch、Marta C. González,The WorkReach model for urban work location choices through economic complexity and informality,Nature Communications,2026,Article in Press(2025年9月26日收稿,2026年9月21日接收)。DOI:10.1038/s41467-026-78293-3。本文依据该 DOI 下可引用的 Article in Press 版本;正式排版替换后,页码可能变动,DOI 不变。
早上出门,有人在住处附近就找到班上,有人穿过大半个城区,去行业更杂、更难被别处替代的片区。两个人都在选工作地。只按距离衰减或沿途机会数量来预测流量,会把这两类选择写成同一种空间摩擦。
WorkReach 把这次选择写成一个效用比较:距离拉低效用,目的地的经济复杂度抬高效用,居住地的非正式就业则改变工人愿意为远处机会多走多少路。模型用在旧金山湾区、洛杉矶、墨西哥城和里约热内卢。四座城市里,更复杂的工作地都更容易被选中;非正式就业把距离权衡推向相反方向。美国两城几乎一离开起点就进入看机会的区间,墨西哥城和里约先有一段明显更长的就近区间。流量重叠能追平常用模型,优势在系数可以读成权衡,而不在预测分数全面更高。把可达性从路有多近,改成整组工作选择的期望效用之后,高非正式住区在三座城市里更吃亏,四座城市的综合指标都更低。
先说结论
- 工作地经济复杂度的系数四城都为正:湾区 2.462、洛杉矶 0.482、墨西哥城 4.220、里约热内卢 6.603。距离系数都为负,墨西哥城 −21.881,洛杉矶 −9.601。这些系数对应各城市内部缩放到 0–1 的全距,不能当成每公里或原始指数每增加 1 点的效用。
- 居住地非正式就业的系数,墨西哥城为 10.250,里约为 4.267,湾区为 −14.735,洛杉矶为 −8.702。按城市中位数把起点非正式率和终点复杂度分成四组后,拉美两城通勤中位数最长的是高非正式到高复杂度,美国两城最长的是低非正式到高复杂度;四城最短的都是高非正式到低复杂度。这是主模型的符号。后文换成部门关联后,拉美两城的非正式就业系数会变号。
- 行为从先就近转到看机会的距离阈值,湾区和洛杉矶都是 0.006 km,墨西哥城 16.201 km,里约 24.955 km。
- 图 4 上 WorkReach 的共同通勤部分(CPC)标为 0.39、0.41、0.49、0.61;正文给出的三位小数是 0.389、0.413、0.486、0.614。湾区这一档高于同图另外三个模型,里约低于同图另外三个模型的 0.64。按起点分区的五折交叉验证里,各模型训练与测试的 CPC 之差不超过 0.001。
- 距离加权可达性的中位数,高非正式起点在美国两城更高,在拉美两城更低。消费者剩余可达性的中位数在湾区、洛杉矶和里约是高非正式组更低;墨西哥城两组为 3.86 与 3.90,几乎并列。把两项做成城市内 z 分数再平均,高非正式组的中位数在四城都更低。
这四座城市的上班流量,数的是什么?
研究对象是居住地到工作地的通勤流量,分析单位是空间单元之间的起讫点对(origin–destination pair,OD 对)。论文比较四座人口规模相近、劳动市场结构不同的城市区域:墨西哥城和里约热内卢取城市本身,洛杉矶也取城市本身,旧金山湾区则是跨县的多城市区域。这样选,是为了让人口规模和空间单元数量大致可比,不是为了把四座城市收成同一种行政边界。
居住地的非正式就业率没有全球统一字段,四城各用一套代理。墨西哥城用 2020 年人口与住房普查的城市基本地理统计区(AGEB):在经济活跃人口中,计算没有医疗保险的比例,并扣掉随家人参保、本人并不工作的未成年人。墨西哥 2022 年职业与就业调查(ENOE)里,正式就业者有医疗保险的比例是 99.95%,非正式就业者是 11.18%,所以这项保险代理和官方的正式、非正式划分高度重合,但仍然不是工卡或合同本身。里约沿用圣保罗研究的口径,用 2010 年人口普查、公开分辨率最高的统计与规划区(AEP):无正式登记的雇员,或不缴纳社会保障的自雇者,记为非正式。这份居住地指标比后面的出行数据早十多年。美国两城把美国社区调查(ACS)五年估计里有、雇主—家庭动态纵向数据(LEHD)工资单里没有的劳动力视为非正式,因为 LEHD 只覆盖缴纳失业保险的正式岗位;空间单元是人口普查街区组。加州是美国估计过非正式就业规模的州之一,这个代理仍然更接近登记缺口,而不是拉美统计机构的非正式就业定义。
工作地的经济复杂度用就业版经济复杂度指数(ECIemp)。每个小区在 17 个两位北美行业分类(NAICS)部门上的就业,先算显示性比较优势:本区该部门就业占本区就业的比重,高于全市同一比重,就记为在该部门专业化。反复比较各区的部门多样性和各部门的稀有程度,得到小区的 ECIemp 和部门的产品复杂度(PCIemp)。农业和其他服务被排除,留下论文认为能放进产品空间解释的部门。墨西哥城的就业来自经济单位名录(DENUE),里约来自年度社会信息报告(RAIS),两者都只给出企业规模区间,论文在区间内抽一个均匀随机整数,开口的最高档封顶为 500 人。美国两城用 Replica 的合成就业记录。拉美的 ECIemp 因此建立在正式登记的单位上:一个高复杂度工作地,连非专业岗位也更可能带有社会保障;它度量的是工作地的生产结构,不是该地工人的工资。
出行数据也分两套。墨西哥城和里约用同一家商业定位服务 2023 年 3–5 月与 2024 年 3–5 月的匿名定位,只保留两年推断的家和单位都一致的用户。停留要落在 20 米内并持续至少 5 分钟,再用 20 米邻域的密度聚类。家是周末或工作日 19:00–08:00 最常去、且至少出现在 14 个不同日期的聚类;单位是工作日 09:00–18:00 最常去、至少 8 个不同日期、并且离家至少 50 米的聚类。各行政区再用观测到的家与普查人口之比,把流量按渗透率放大。湾区和洛杉矶用 Replica 2023 年春季的合成工作日通勤。四城都去掉没有流入或流出的地点,也不保留同一小区内部的通勤。
空间网格并不相同。湾区和洛杉矶用 Uber H3 的 7 级六边形,墨西哥城用更细的 8 级,因为城区直径更小;里约的 AEP 已经比六边形粗,继续合并会减少小区并带来普查值重分配,所以保留原多边形。一块普查区盖住多个六边形时,论文把这些六边形并成一个单元,不把原区拆开。
| 项目 | 湾区 | 洛杉矶 | 墨西哥城 | 里约热内卢 |
|---|---|---|---|---|
| OD 对 | 457,652 | 365,420 | 628,056 | 39,402 |
| 小区数 | 677 | 605 | 793 | 199 |
| 小区面积中位数 / 均值(km²) | 5.41 / 27.18 | 5.77 / 16.56 | 0.85 / 0.98 | 2.93 / 6.03 |
| 研究区面积(km²) | 18,402.05 | 10,020.90 | 776.94 | 1,199.24 |
| 单条 OD 流量范围 | 1–40,119 | 1–21,036 | 1–3,243 | 6–9,780 |
| 观测流量合计 | 1,936,002 | 2,388,812 | 473,078 | 357,005 |
| OD 距离中位数(km) | 11.92 | 10.39 | 4.12 | 4.08 |
| 区域直径(km) | 283.22 | 145.42 | 52.62 | 73.65 |
| 人口范围 | 39–100,177 | 5–297,978 | 9–38,381 | 3,361–65,846 |
| 研究区人口合计 | 7,432,481 | 10,088,110 | 8,995,924 | 6,289,038 |
OD 对数恰好等于小区数乘以小区数减 1。筛选掉没有进出的地点之后,剩下的是去掉自环的完全图:每一对不同小区之间至少有一条观测通勤。流量合计远小于居住人口合计,尤其是两座拉美城市。这些人次是识别出稳定家和单位之后、再按渗透率调整的通勤记录,加上美国城市的合成工作日通勤,不能当成就业人口或全部出行次数。表 1 的 OD 距离中位数是小区对之间的距离中位数;后面图 1e 的中位数才是通勤人次的距离中位数。距离用半正矢公式算球面直线距离,不是沿路时间或费用。
复杂的行业会扎堆,通勤距离会跟着分开吗?
部门是否扎堆,决定经济复杂度在城市内部有没有空间差异。17 个部门的共位关系在区域内更像,跨区域只保留粗结构。湾区与洛杉矶的部门邻近矩阵相关系数 r = 0.85,墨西哥城与里约 r = 0.86,跨区域为 0.68–0.71。每对城市在 136 个不重复部门对上计算皮尔逊相关,自由度 134,双尾检验都给出 p < 0.001,没有做多重比较校正。正文明确点出的部门差异是:湾区信息业的 PCIemp 高于平均,对应其技术经济。
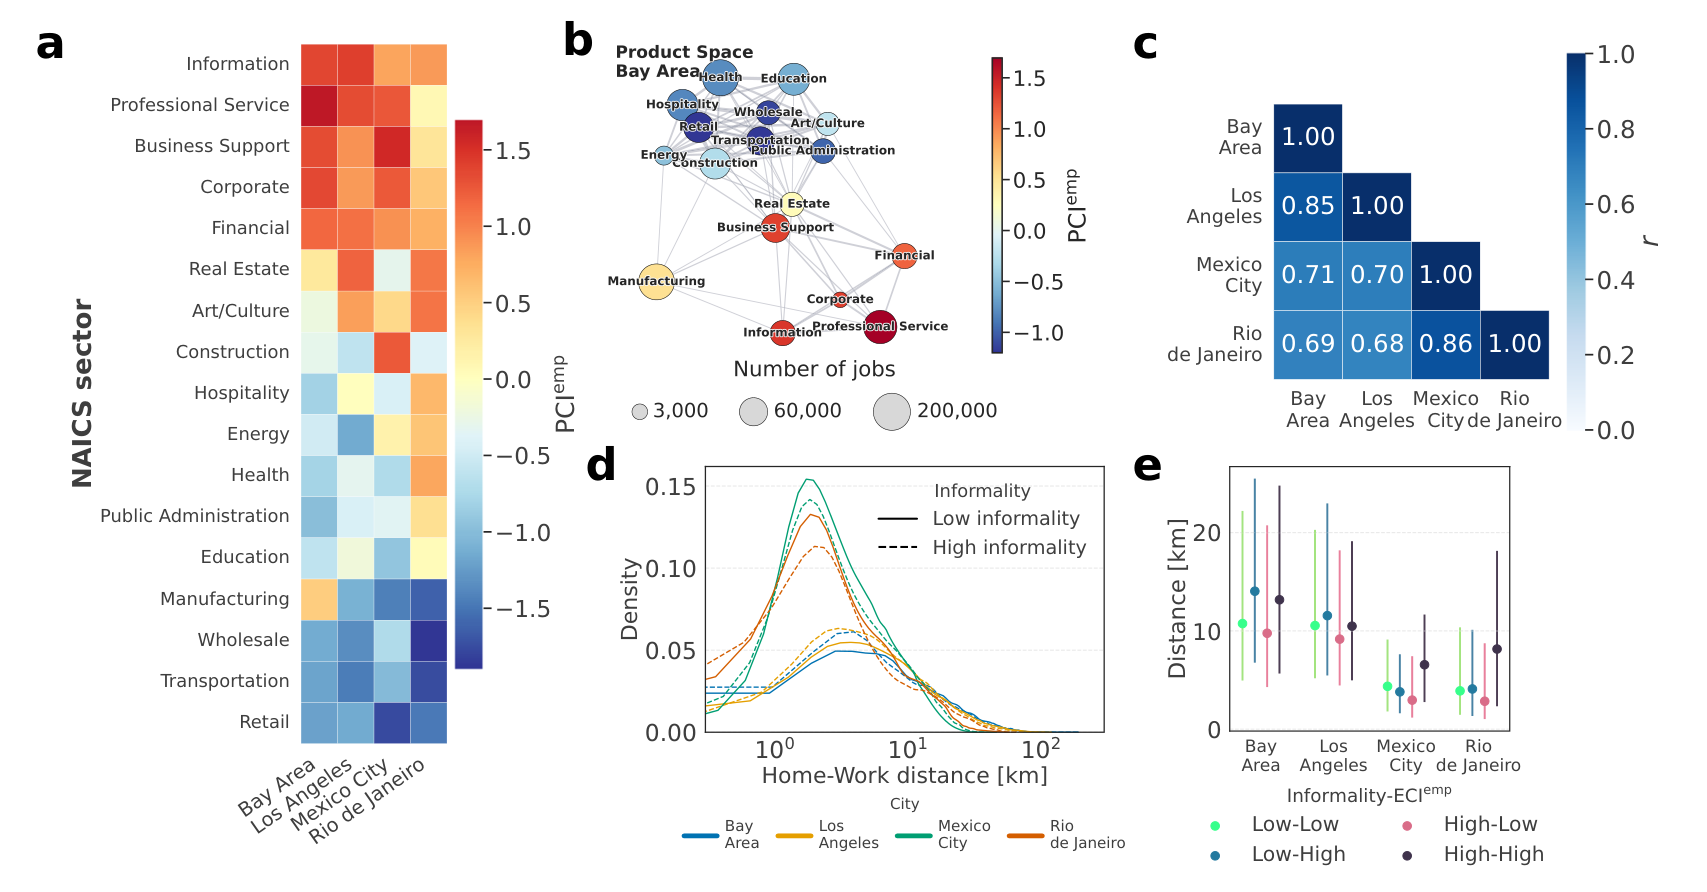
图 1|四座城市的行业复杂度,和通勤距离怎样叠在一起?
(a)17 个 NAICS 部门、四座城市的 PCIemp 热图,颜色是部门复杂度,各城单独配色。(b)只画湾区的产品空间:点的大小是就业规模,颜色是 PCIemp,连线是部门在各小区间共同出现的程度;高复杂度部门彼此靠近,低复杂度部门也彼此靠近。(c)四城部门共位矩阵的相关,格内数字即 r = 0.85、0.86 和 0.68–0.71 这一组;色标是相关系数,不是流量。(d)按起点非正式就业高低分成的家—单位距离分布,横轴为公里的对数,纵轴为密度;实线是低非正式,虚线是高非正式。美国两城的右尾更长,与表 1 里 11.92 km、10.39 km 的 OD 距离中位数、以及 283.22 km、145.42 km 的直径相一致;拉美两城的分布更集中在短距离。(e)把起点非正式率和终点 ECIemp 都按该城市中位数切开,四点是四组通勤距离的中位数,竖线是四分位距,单位是单次通勤。四城的高非正式—低复杂度组都最短;最长组在墨西哥城和里约是高非正式—高复杂度,在湾区和洛杉矶是低非正式—高复杂度。图上没有印出各组中位数的公里数。来源:原论文 Fig. 1。
图 1e 的分母是通勤人次,顺序为低—低、低—高、高—低、高—高。起点没有非正式率或终点没有 ECIemp 的人次被排除。
| 城市 | 低—低 | 低—高 | 高—低 | 高—高 | 排除人次 |
|---|---|---|---|---|---|
| 湾区 | 484,303 | 485,515 | 486,136 | 479,247 | 801 |
| 洛杉矶 | 608,916 | 586,164 | 585,396 | 606,555 | 1,781 |
| 墨西哥城 | 99,106 | 136,756 | 137,151 | 97,846 | 2,219 |
| 里约热内卢 | 73,290 | 105,975 | 105,418 | 71,682 | 640 |
四组加排除人次,分别等于表 1 的流量合计 1,936,002、2,388,812、473,078 和 357,005。最长的那一组不是人数最多的那一组。墨西哥城低—高有 136,756 人次,高—低有 137,151 人次,高—高只有 97,846 人次。中位数描述的是距离,不是这组人占多数。
非正式住区离复杂工作地有多远?
图 1 把人按高低两组切开,还没回答这些高低组在地图上是否分成两块。同一小区的非正式率与 ECIemp 在墨西哥城和里约呈中等负相关,正文记为 r ~ −0.4:非正式率高的小区,自身的经济复杂度也倾向更低。美国两城这项相关接近 r ~ 0,非正式就业没有系统性地位于低复杂度小区。四城两项指标都有显著空间自相关,拉美更明显;Moran’s I 的数值在补充表,正文没有列出。
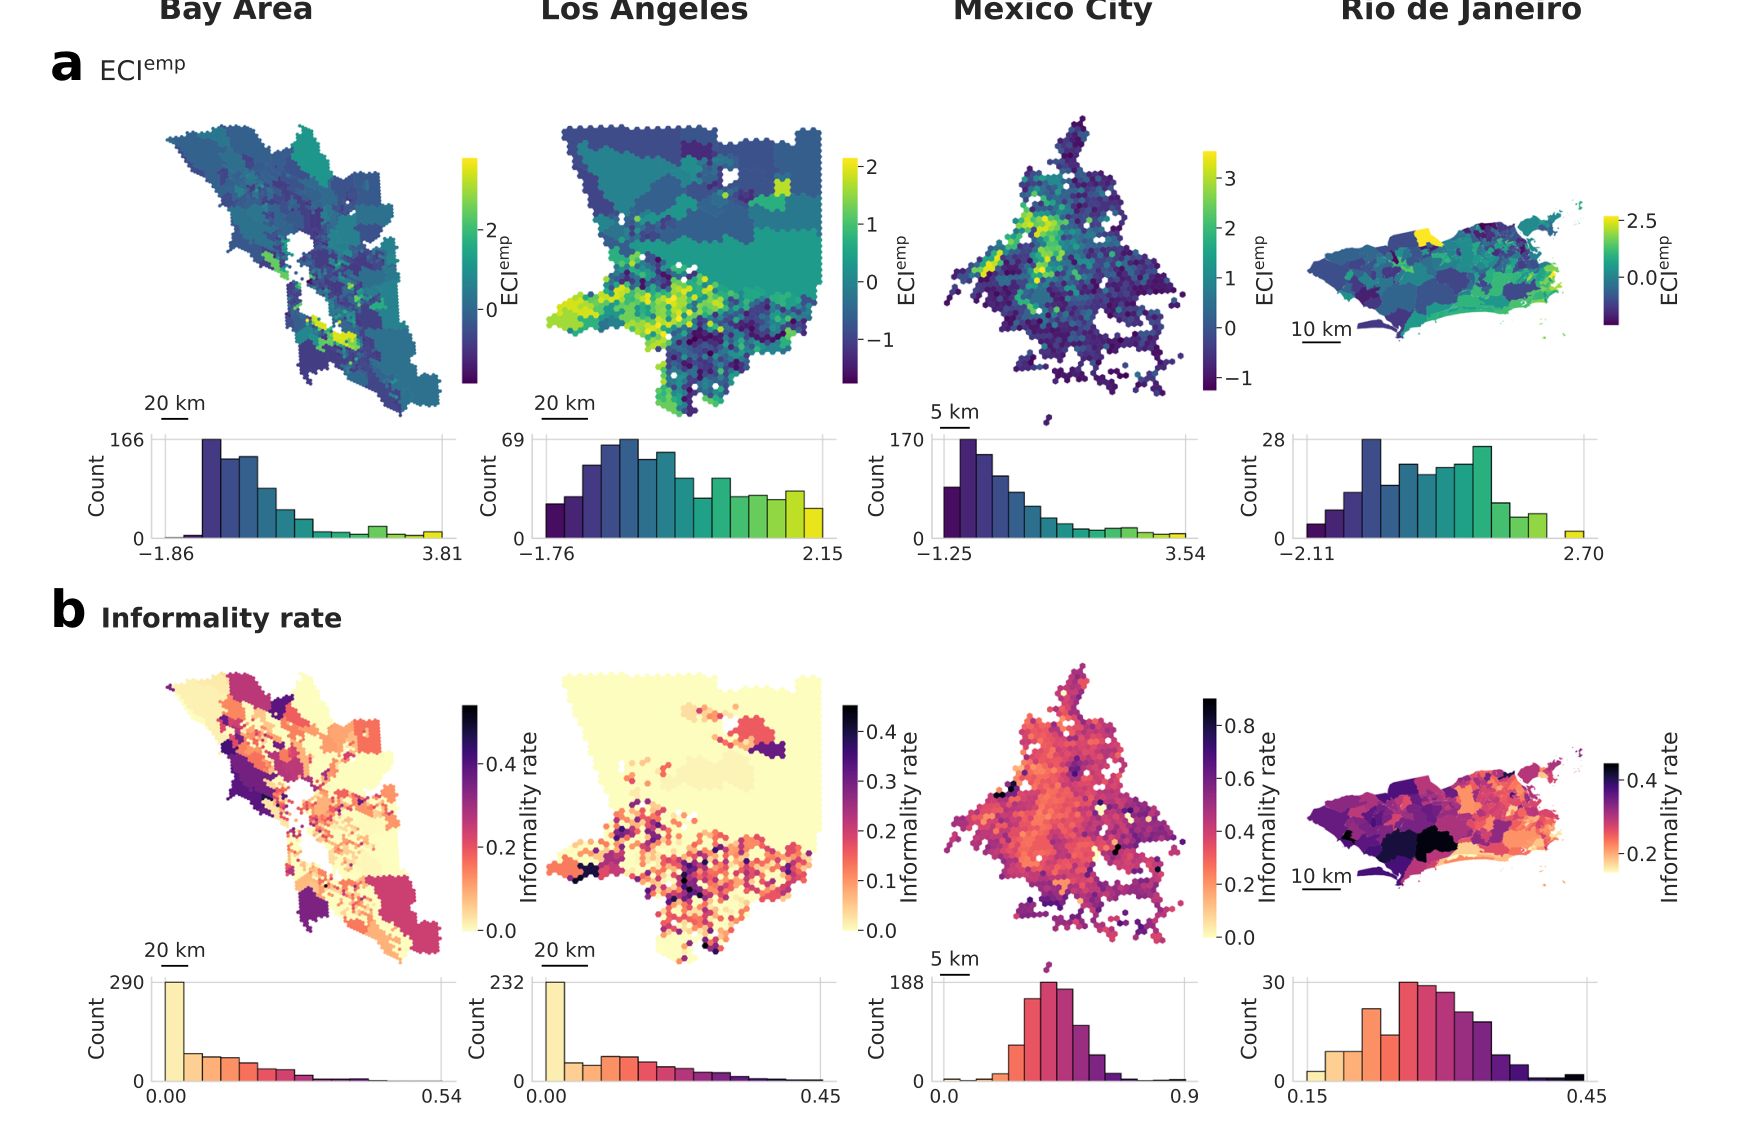
图 2|复杂度高的小区和非正式率高的小区,是同一批地方吗?
(a)四城 ECIemp 的分区图,下面是该城指数的直方图。(b)非正式率的分区图和直方图。湾区、洛杉矶是合并后的 H3 七级六边形,墨西哥城是 H3 八级,里约是 AEP。每张图都覆盖研究区全境。颜色按城市单独拉伸,一块深色在湾区不等于同一块深色在墨西哥城。直方图给出各城自身的分布形态,不能把横轴两端拿来跨城比高低。来源:原论文 Fig. 2。
负相关加上地图上的成片分布,是拉美两城更强的经济社会分隔:高非正式住区离高复杂度就业中心更远。美国两城更接近混杂。这仍是同一时点的空间格局。它说明两类小区常常不重叠,不能单独证明居民因为非正式就业而搬离了复杂产业区。
三个因素怎样进入同一次选择?
图 1e 留下的问题是,近处和远处是不是同一套权重。WorkReach 用多项 logit:居住在 i 的人选择工作地 j 的概率,随效用 Vᵢⱼ 上升,所有候选工作地的概率加总为 1。效用写成
Vᵢⱼ = βdist × dᵢⱼ + wᵢⱼ × (βECI × ECIⱼ + βinf × Infᵢ)
过渡权重是缩放距离上的逻辑函数:
wᵢⱼ = 1 / (1 + exp(−k × (dᵢⱼ − τ)))
dᵢⱼ、目的地 ECIemp 和起点非正式率都先在城市内部缩放到 0–1。距离远小于阈值时,wᵢⱼ 接近 0,效用主要惩罚距离;远大于阈值时,wᵢⱼ 接近 1,复杂度与非正式率才完全进入。起点非正式率本身不随工作地改变,单独放进 logit 无法识别,所以必须乘上随距离变化的 wᵢⱼ。论文同时估计五个参数,使观测流量的对数似然最大。估计前会去掉流量少于 5 的 OD 对,以及总流出少于 10 的起点;正文没有另报筛掉之后的样本量。图 4 使用的 OD 对数仍与表 1 相同。
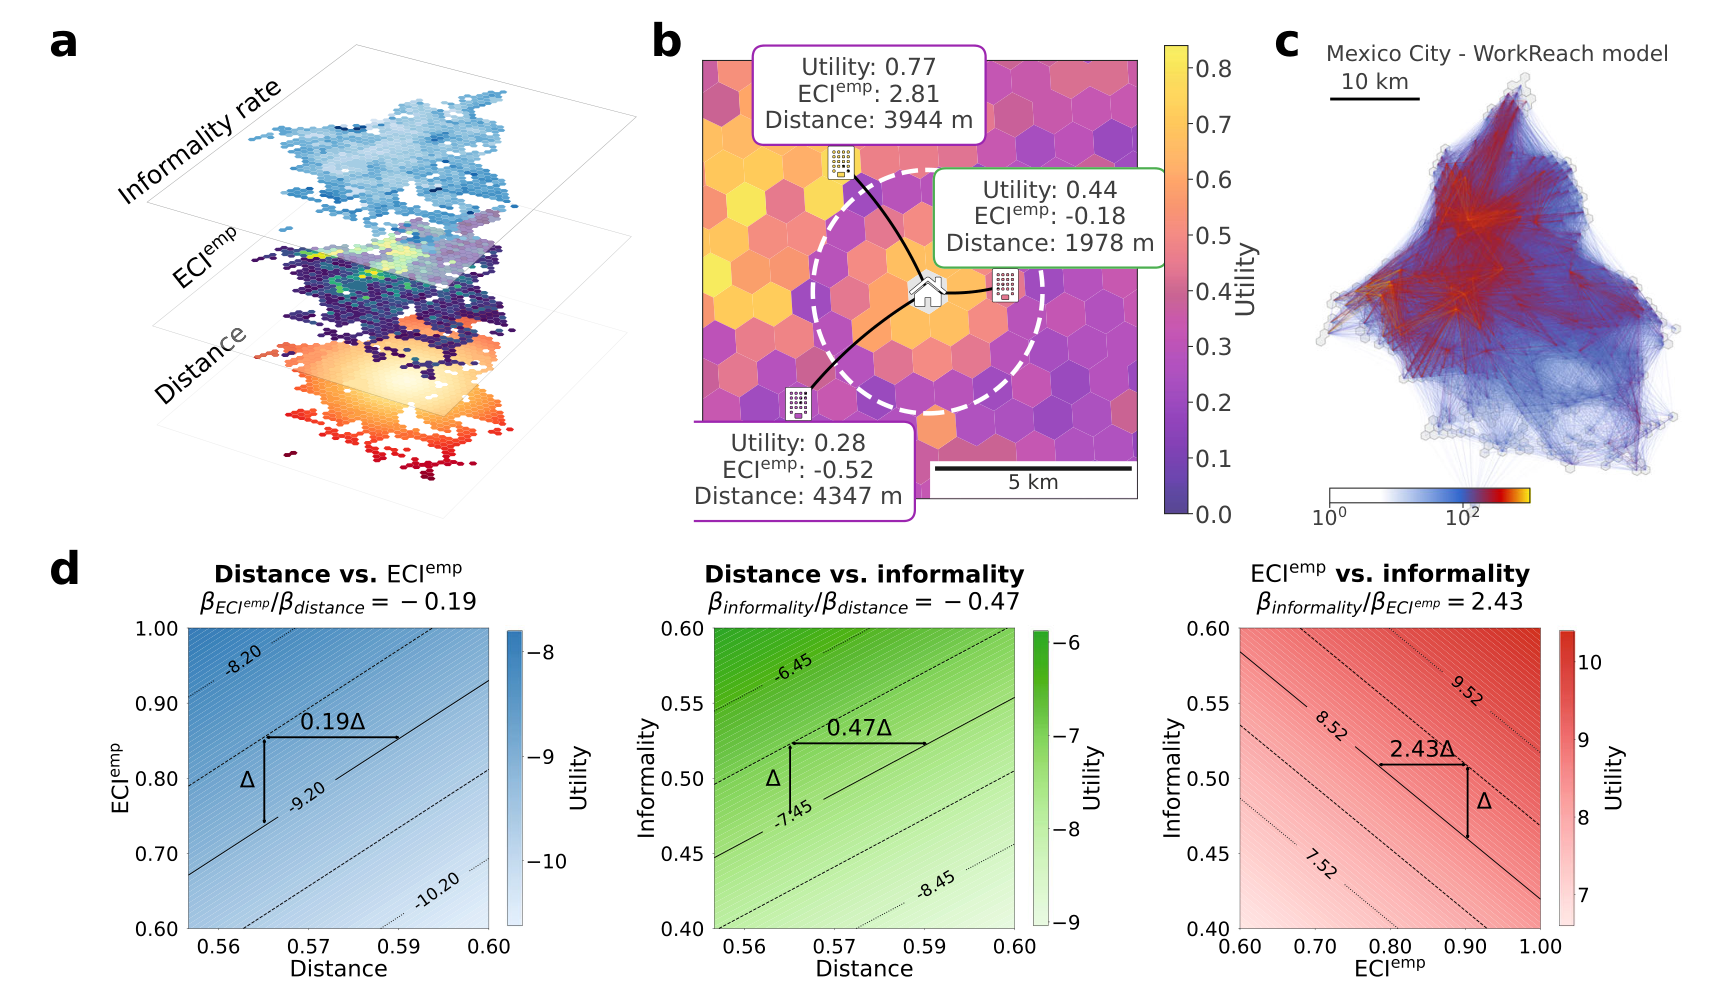
图 3|效用在近处和远处各看什么?
(a)一个起点上的三类输入:通勤距离、目的地 ECIemp、起点非正式率,画成示意散点。(b)墨西哥城 H3 八级六边形上的效用示意图。白色虚线圆是阈值 τ,圆内更靠距离,圆外由 wᵢⱼ 把复杂度和非正式率放进来。图中三处标注是示意值:效用 0.77、ECIemp 2.81、距离 3944 米;效用 0.44、ECIemp −0.18、距离 1978 米;效用 0.28、ECIemp −0.52、距离 4347 米。论文写明这是在说明效用如何拼起来,不是拟合结果。(c)墨西哥城的预测通勤网,边的颜色表示期望流量,色标从 10⁰ 到 10²。(d)在 wᵢⱼ = 1 的远距离区间里,保持效用不变的三条权衡:距离对 ECIemp、距离对非正式率、ECIemp 对非正式率。图上斜率 −0.19、−0.47 和 2.43,对应表 2 里墨西哥城边际替代率 −0.193、−0.468 和 2.429 的两位小数。来源:原论文 Fig. 3。
五个系数、三种边际替代率和三种直接弹性如下。95% 区间来自按起点重抽目的地份额的多项分布自助法,家的人口保持观测值;区间贴着点估计,例如湾区 βdist 为 −21.292,区间 [−21.298, −21.279]。这是流量份额的抽样波动,不是实验识别出的偏好区间。
| 量 | 湾区 | 洛杉矶 | 墨西哥城 | 里约热内卢 |
|---|---|---|---|---|
| βdist | −21.292 | −9.601 | −21.881 | −16.447 |
| βECI | 2.462 | 0.482 | 4.220 | 6.603 |
| βinf | −14.735 | −8.702 | 10.250 | 4.267 |
| τ(km) | 0.006 | 0.006 | 16.201 | 24.955 |
| k | 128.764 | 32.413 | 10.824 | 9.654 |
| MRS,ECI / 距离 | −0.116 | −0.050 | −0.193 | −0.401 |
| MRS,非正式 / 距离 | 0.692 | 0.906 | −0.468 | −0.259 |
| MRS,非正式 / ECI | −5.985 | −18.056 | 2.429 | 0.646 |
| 距离弹性 | −5.177 | −3.238 | −3.682 | −2.616 |
| ECI 弹性 | 0.804 | 0.215 | 0.477 | 0.979 |
| 非正式弹性 | −2.305 | −1.917 | 2.222 | 0.666 |
距离系数四城都为负,墨西哥城的绝对值最大。复杂度系数四城都为正,里约最大、洛杉矶最小。非正式率系数的符号就是区域分界:拉美为正,美国为负。这项系数乘在随距离上升的权重上:拉美的正号表示起点非正式率越高,远处工作地的效用越高;再与四城都为正的复杂度系数合在一起,才对应高非正式起点接受前往高复杂度地点的长距离。美国的负号表示更高的非正式率会压低远处工作地的效用。论文把美国的负号和两种城市形态放在一起理解:非正式就业与高复杂度小区在空间上更混杂,低非正式住户也更可能住在远离就业中心的住宅区。这是与系数方向一致的解释,不是把系数识别成某一种原因。
阈值的公里数是论文换算后的读数;效用里的距离仍是 0–1 缩放值。0.006 km 意味着美国两城的复杂度和非正式率几乎随距离马上起作用,湾区的陡度 k = 128.764,过渡很陡。墨西哥城要到 16.201 km、里约要到 24.955 km,就近区间才明显结束,陡度也更缓,分别是 10.824 和 9.654。
边际替代率是两项边际效用之比,远距离、过渡权重接近 1 时,近似变成两个 β 之比。墨西哥城的 ECI 对距离为 −0.193:ECIemp 增加 Δ,要保持效用不变,可承受的缩放距离增加约 0.193Δ。负号来自负的距离系数和正的复杂度系数,读出来是愿意为更高复杂度走更远。里约 −0.401 的绝对值最大,洛杉矶 −0.050 最小。0.193 与 0.050 相比约为 3.9 倍,摘要据此说墨西哥城工人愿意为复杂度多交换将近四倍的距离。比较的是缩放后的替代率。墨西哥城直径 52.62 km,洛杉矶 145.42 km,城市内 0–1 的同一步长对应的地面距离不同,不能把 3.9 倍换成一个通用的公里规则。
非正式率对距离的替代率,美国为正(湾区 0.692,洛杉矶 0.906),拉美为负(墨西哥城 −0.468,里约 −0.259)。结合 βinf 的符号,美国是更高的起点非正式率加强距离的负效用;拉美是更高的非正式率减轻前往高复杂度地点的距离成本。
弹性是某个工作地属性变化 1% 时,选择它的概率大约变化百分之几,其他条件不变,并对全部 OD 对做不加权平均。复杂度和非正式率的弹性,针对的是已经乘上 wᵢⱼ 的项。墨西哥城的距离弹性为 −3.682:一个工作地若比另一个其他方面相同的工作地远 1%,被选概率大约低 3.682%。湾区的 ECI 弹性为 0.804,论文据此说工作地经济复杂度降低 1%,选择该地的概率大约降低 0.804%。距离弹性的绝对值在四城都大于 ECI 弹性。弹性是模型在观测流量上的局部敏感度,一项属性变化还会把概率分给其他工作地。
预测人次写成起点总量乘以选择概率,再四舍五入。基准模型则明确把每个起点的预测流出约束到观测流出。正文没有公布 WorkReach 预测流量的加总,读图 4 时应使用论文报告的 r 和 CPC,不要自行假定两套矩阵的总人次相同。
流量对得上,系数就可靠了吗?
预测用来检查这套效用能不能再现流量,同时对照三个单边约束到观测流出的模型:幂律距离衰减的引力模型(4 个参数)、扩展辐射模型(1 个自由参数,调节沿途机会的衰减),以及贝叶斯机器科学家给出的一种似然形式的类引力公式(6 个参数)。四个模型都通过最小化观测流量的负对数似然来估计。
重叠用两个数。皮尔逊 r 看预测与观测是否同增同减。共同通勤部分 CPC 是两套矩阵重合的比例:分子是每个 OD 对上较小值之和的两倍,分母是两套流量全部元素之和。CPC 为 1 表示两套矩阵相同,为 0 表示没有重合。它可以理解成流量被分到观测目的地的重合份额,不是逐人判断通勤有没有猜对。
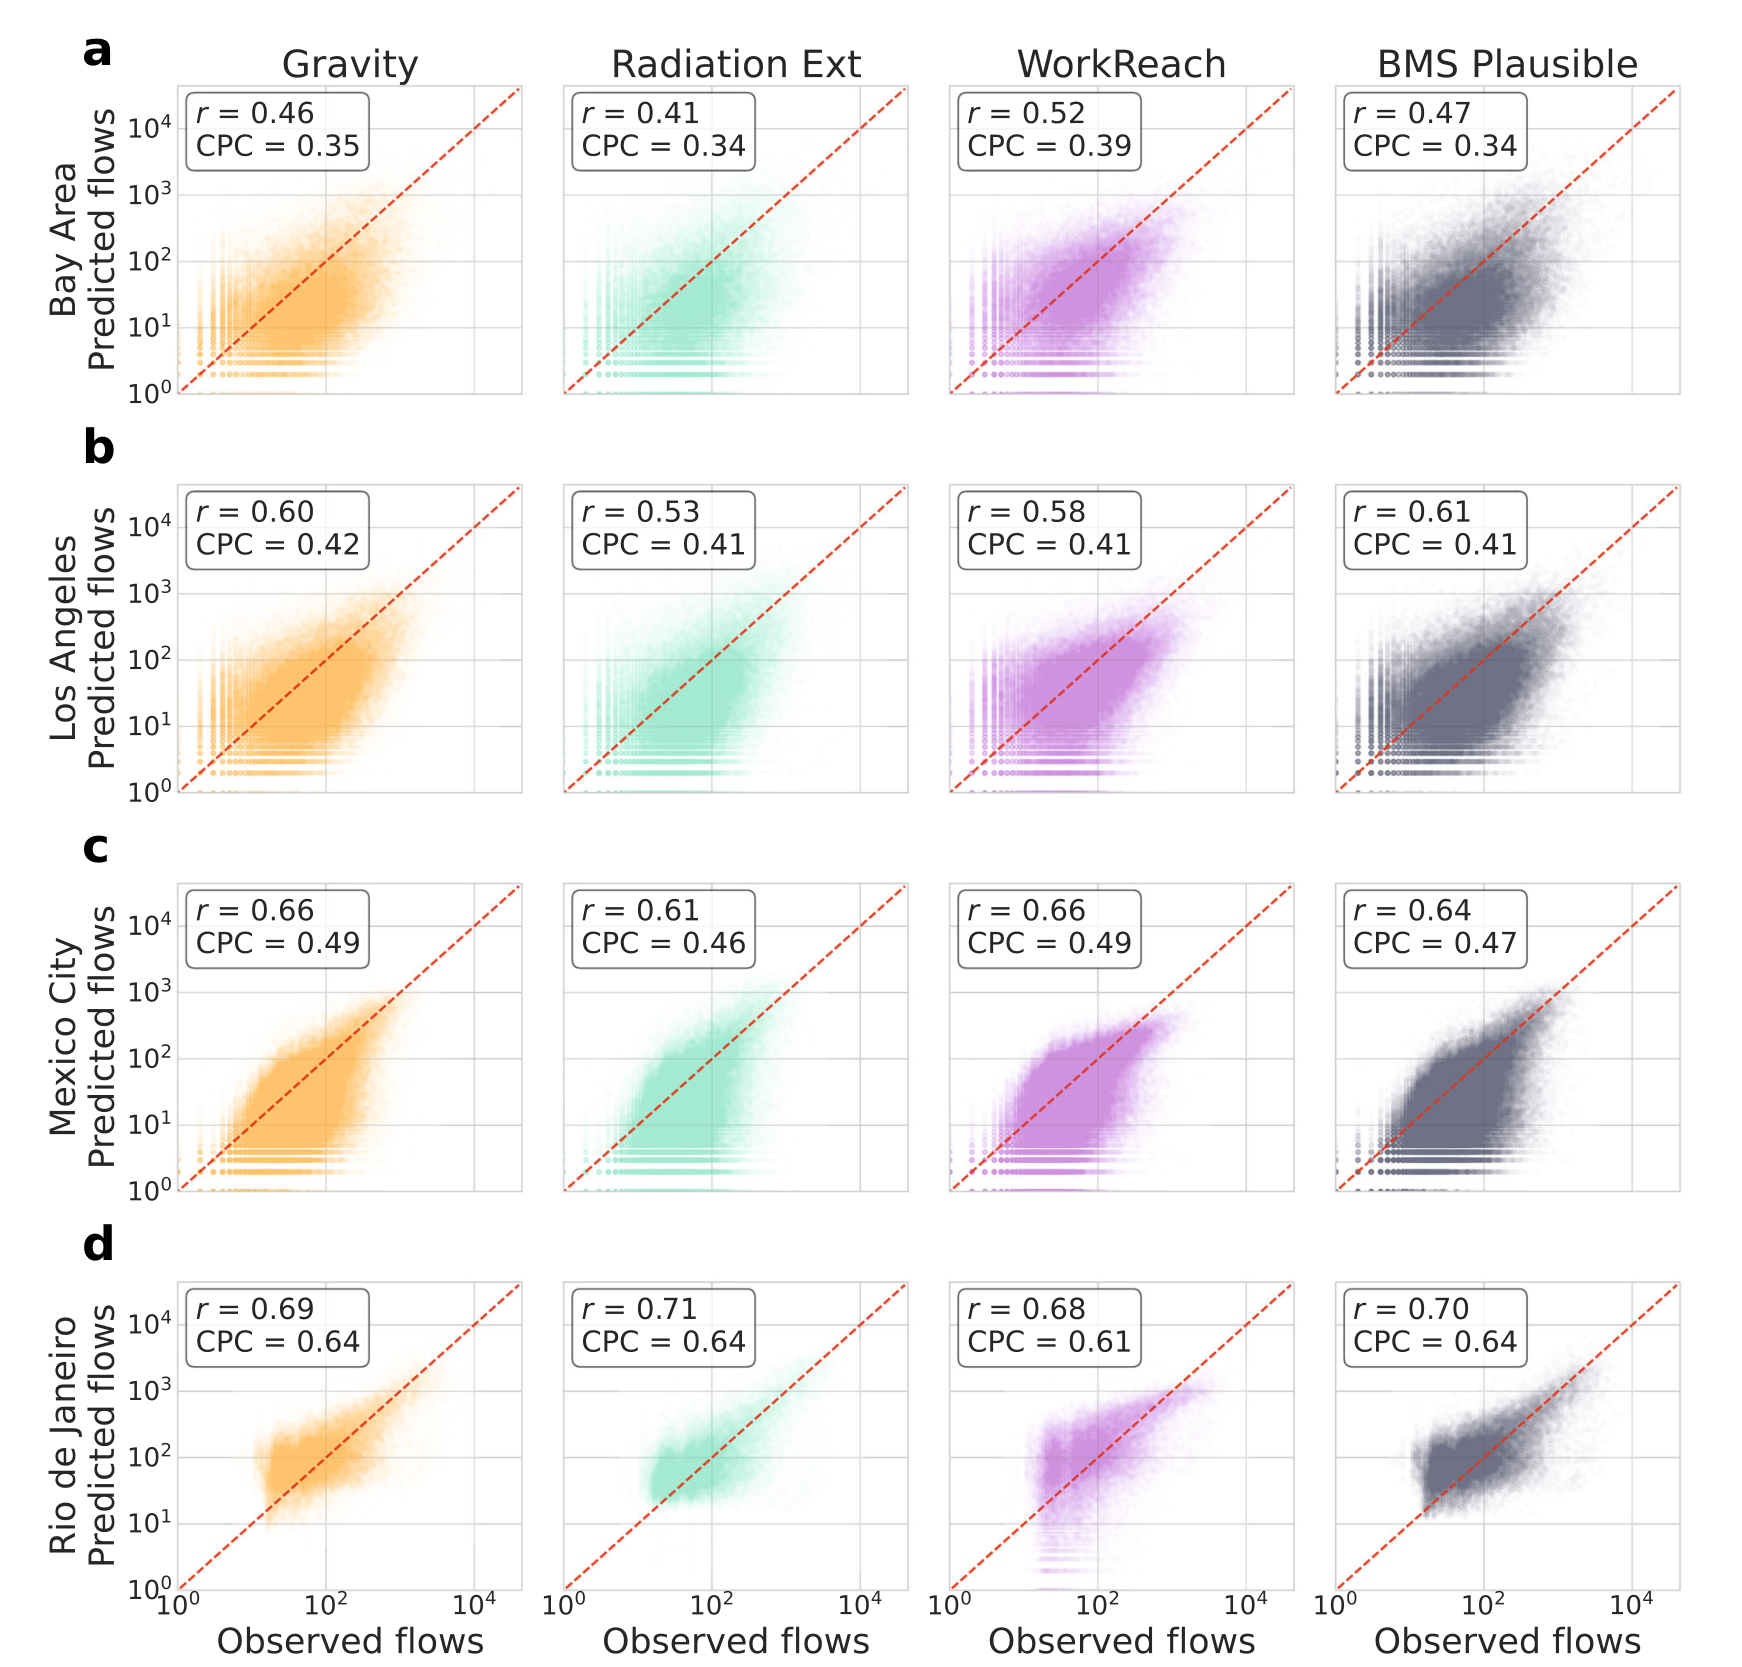
图 4|四套模型把观测流量重放出来时,重合有多高?
(a)湾区,(b)洛杉矶,(c)墨西哥城,(d)里约热内卢。每行从左到右是引力、扩展辐射、WorkReach、BMS。横轴是观测流量,纵轴是预测流量,都用对数坐标;红色虚线是预测等于观测。格内 r 与 CPC 是图上印出的两位小数。每个点是一条保留的 OD 对,四城分别是 457,652、365,420、628,056 和 39,402 对。来源:原论文 Fig. 4。
| 城市 | 引力 r / CPC | 扩展辐射 r / CPC | WorkReach r / CPC | BMS r / CPC |
|---|---|---|---|---|
| 湾区 | 0.46 / 0.35 | 0.41 / 0.34 | 0.52 / 0.39 | 0.47 / 0.34 |
| 洛杉矶 | 0.60 / 0.42 | 0.53 / 0.41 | 0.58 / 0.41 | 0.61 / 0.41 |
| 墨西哥城 | 0.66 / 0.49 | 0.61 / 0.46 | 0.66 / 0.49 | 0.64 / 0.47 |
| 里约热内卢 | 0.69 / 0.64 | 0.71 / 0.64 | 0.68 / 0.61 | 0.70 / 0.64 |
湾区 WorkReach 的 CPC 最高。洛杉矶三个模型的 CPC 都在 0.41–0.42,BMS 的 r 为 0.61,高于 WorkReach 的 0.58。墨西哥城 WorkReach 与引力的 r、CPC 都是 0.66 和 0.49。里约 WorkReach 的 r 为 0.68、CPC 为 0.61,低于引力、扩展辐射和 BMS 的 CPC 0.64。正文的三位小数 0.389、0.413、0.486、0.614 与图上的 0.39、0.41、0.49、0.61 是同一组 CPC。按起点做五折交叉验证,训练和测试的 CPC 差不超过 0.001,这个差距写在正文里,折分图在补充材料。
重合接近基准模型,说明加入复杂度和非正式率之后,流量没有变差到不能用。它没有证明效用就是工人的决策过程,也没有证明这组系数唯一。
论文还用部门关联替换 ECIemp。关联度量家里的部门构成和目的地部门构成有多像。只换关联时,CPC 为湾区 0.391、洛杉矶 0.425、墨西哥城 0.495、里约 0.652;两项都放进效用时为 0.399、0.428、0.497、0.655。对照的 WorkReach CPC 就是 0.389、0.413、0.486、0.614。关联的系数在四城都为负:通勤更偏向部门结构和家附近不一样的工作地。它一进入模型,βinf 在四城都变成负的,墨西哥城从 10.250 变为 −4.620,里约从 4.267 变为 −1.133。正文说复杂度和关联同时保留时拟合仍显著提高,检验量在补充表。工资或收入代理替换复杂度后,没有稳定的全面改进;拉美的收入代理又是顺着通勤流量汇总的,看起来更好要单独警惕。论文仍把 ECIemp 留在主模型里,因为它只属于目的地,不随起点改变,也便于讨论针对工作地的产业政策。主文的非正式就业故事因此依赖没有放入部门关联的那一套效用。
正文还按复杂度和非正式率分层检查了 CPC,大多数层还比较高,最高非正式率层下降,湾区和墨西哥城更明显。各层的具体 CPC 在补充图里,这里不补写没看到的格子。
近,等于更值得去吗?
流量重合回答不了住在哪里的人觉得选择集好不好。论文算两种起点可达性。距离加权可达性是预测流量加权的距离倒数平均,距离下限取 0.1 km,以免除以零;它高,表示模型分配到的通勤更短。消费者剩余可达性是选择集的对数和,也就是随机效用框架里的期望最大效用:把每个工作地的效用取指数、加总后再取对数。效用的绝对水平可以平移,甚至为负,所以论文再把两种指标在城市内部做成 z 分数,用两者的平均作为综合指标。
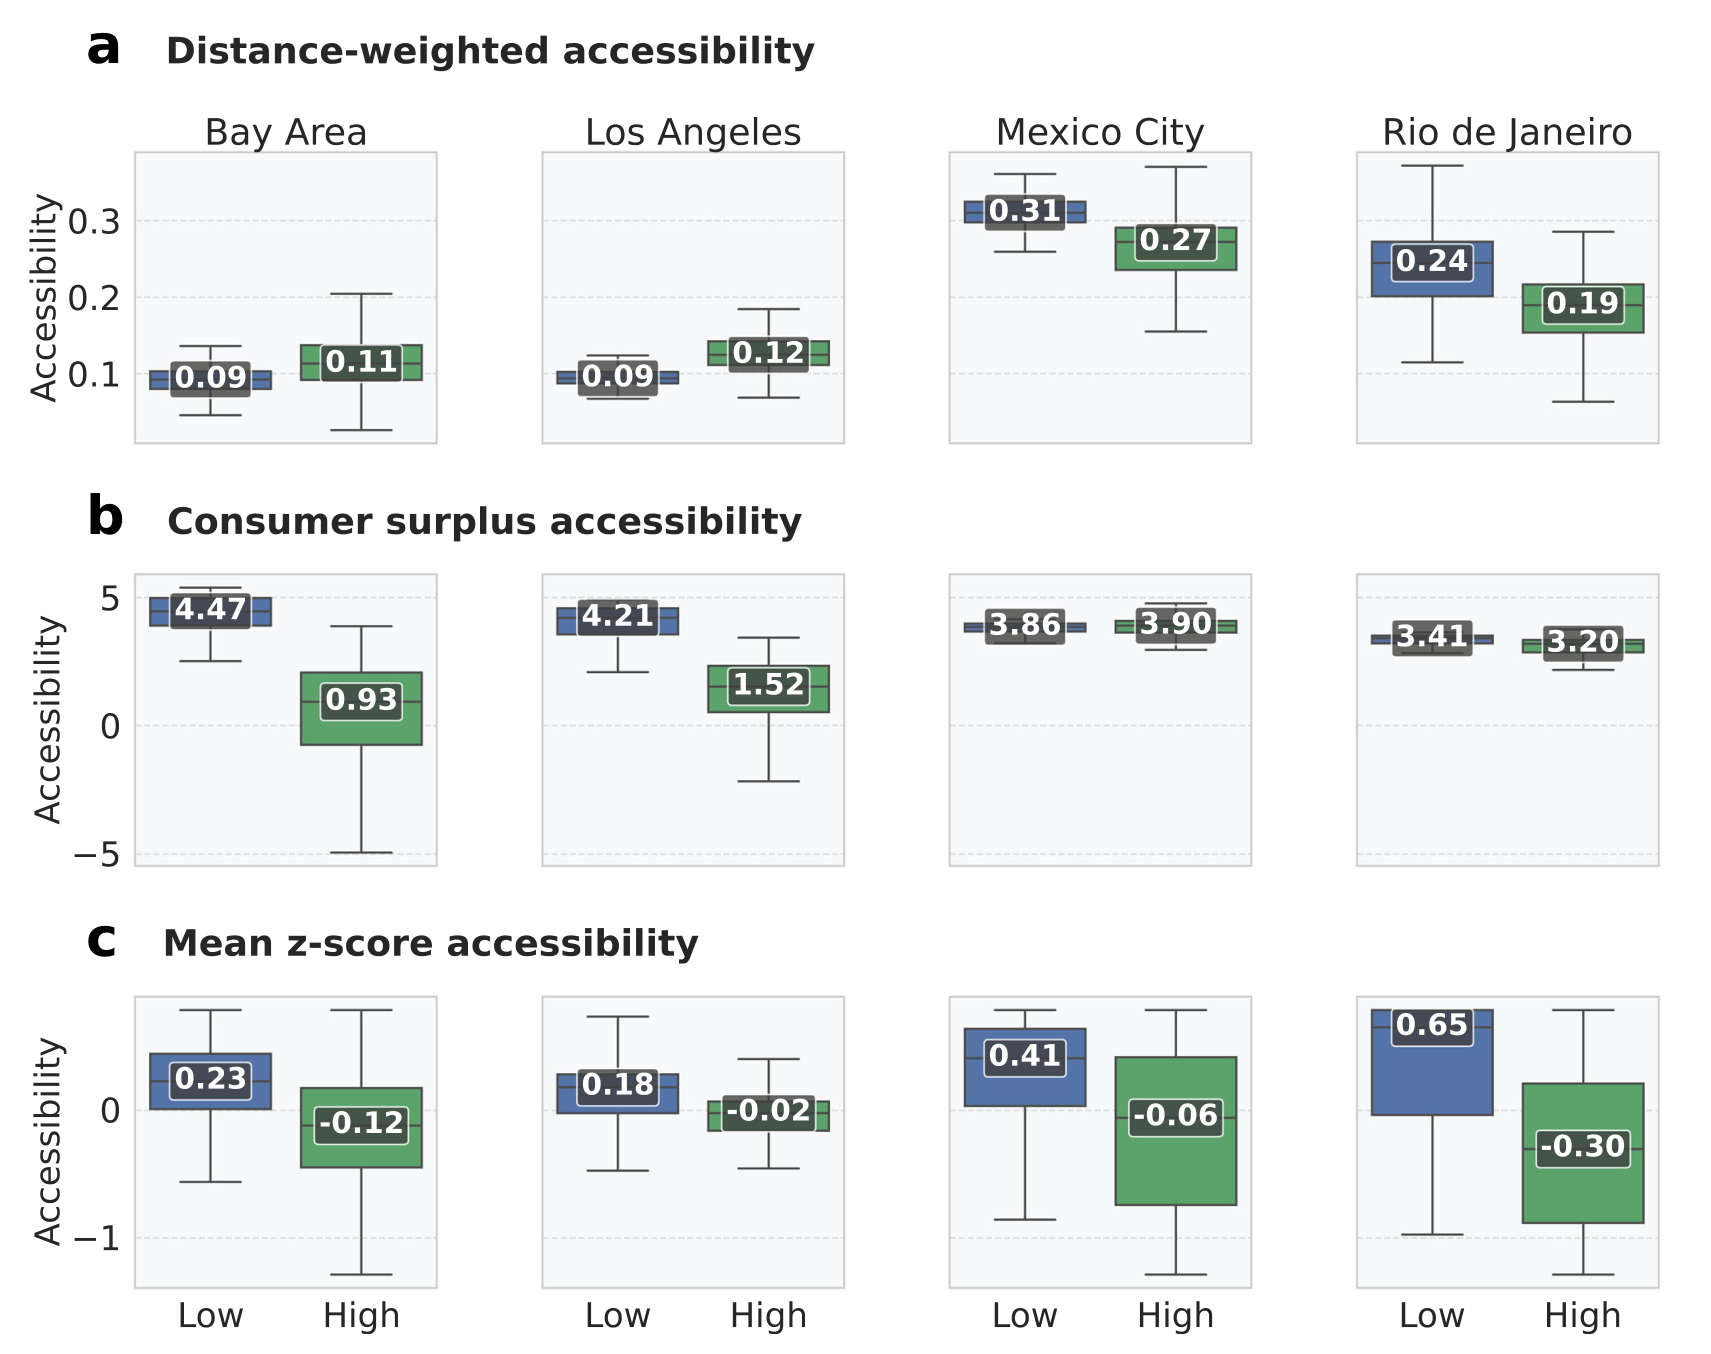
图 5|高非正式住区是离岗位更近,还是整组选择的期望效用更低?
起点按该城非正式率中位数分成低、高。箱线的分析单位是起点小区:湾区 339 与 338,洛杉矶 303 与 302,墨西哥城 397 与 396,里约 100 与 99,加总分别等于 677、605、793、199 个小区。箱子是 25 到 75 分位,中线是中位数,须延伸到 1.5 倍四分位距以内的最远点,离群点不画。格内数字是中位数。(a)距离加权可达性:湾区低 0.09、高 0.11,洛杉矶 0.09 与 0.12,墨西哥城 0.31 与 0.27,里约 0.24 与 0.19。美国两城高非正式组更高,拉美两城更低。(b)消费者剩余:湾区 4.47 与 0.93,洛杉矶 4.21 与 1.52,墨西哥城 3.86 与 3.90,里约 3.41 与 3.20。除墨西哥城两组几乎相同且高非正式组略高以外,高非正式组更低。(c)两项 z 分数的平均:湾区 0.23 与 −0.12,洛杉矶 0.18 与 −0.02,墨西哥城 0.41 与 −0.06,里约 0.65 与 −0.30。四城都是高非正式组的中位数更低。来源:原论文 Fig. 5。
美国两城的距离指标给高非正式住区一点近距离优势,消费者剩余把这个优势反转,湾区从 4.47 降到 0.93。墨西哥城的正 βinf 会抵消一部分距离惩罚,所以两组消费者剩余几乎并列;距离指标本身仍然是低非正式组更高。综合指标不再保留这种抵消,四城的高非正式中位数都更低。箱线比较的是小区,不是个人效用,也不能把中位数之差写成政策造成的损失。
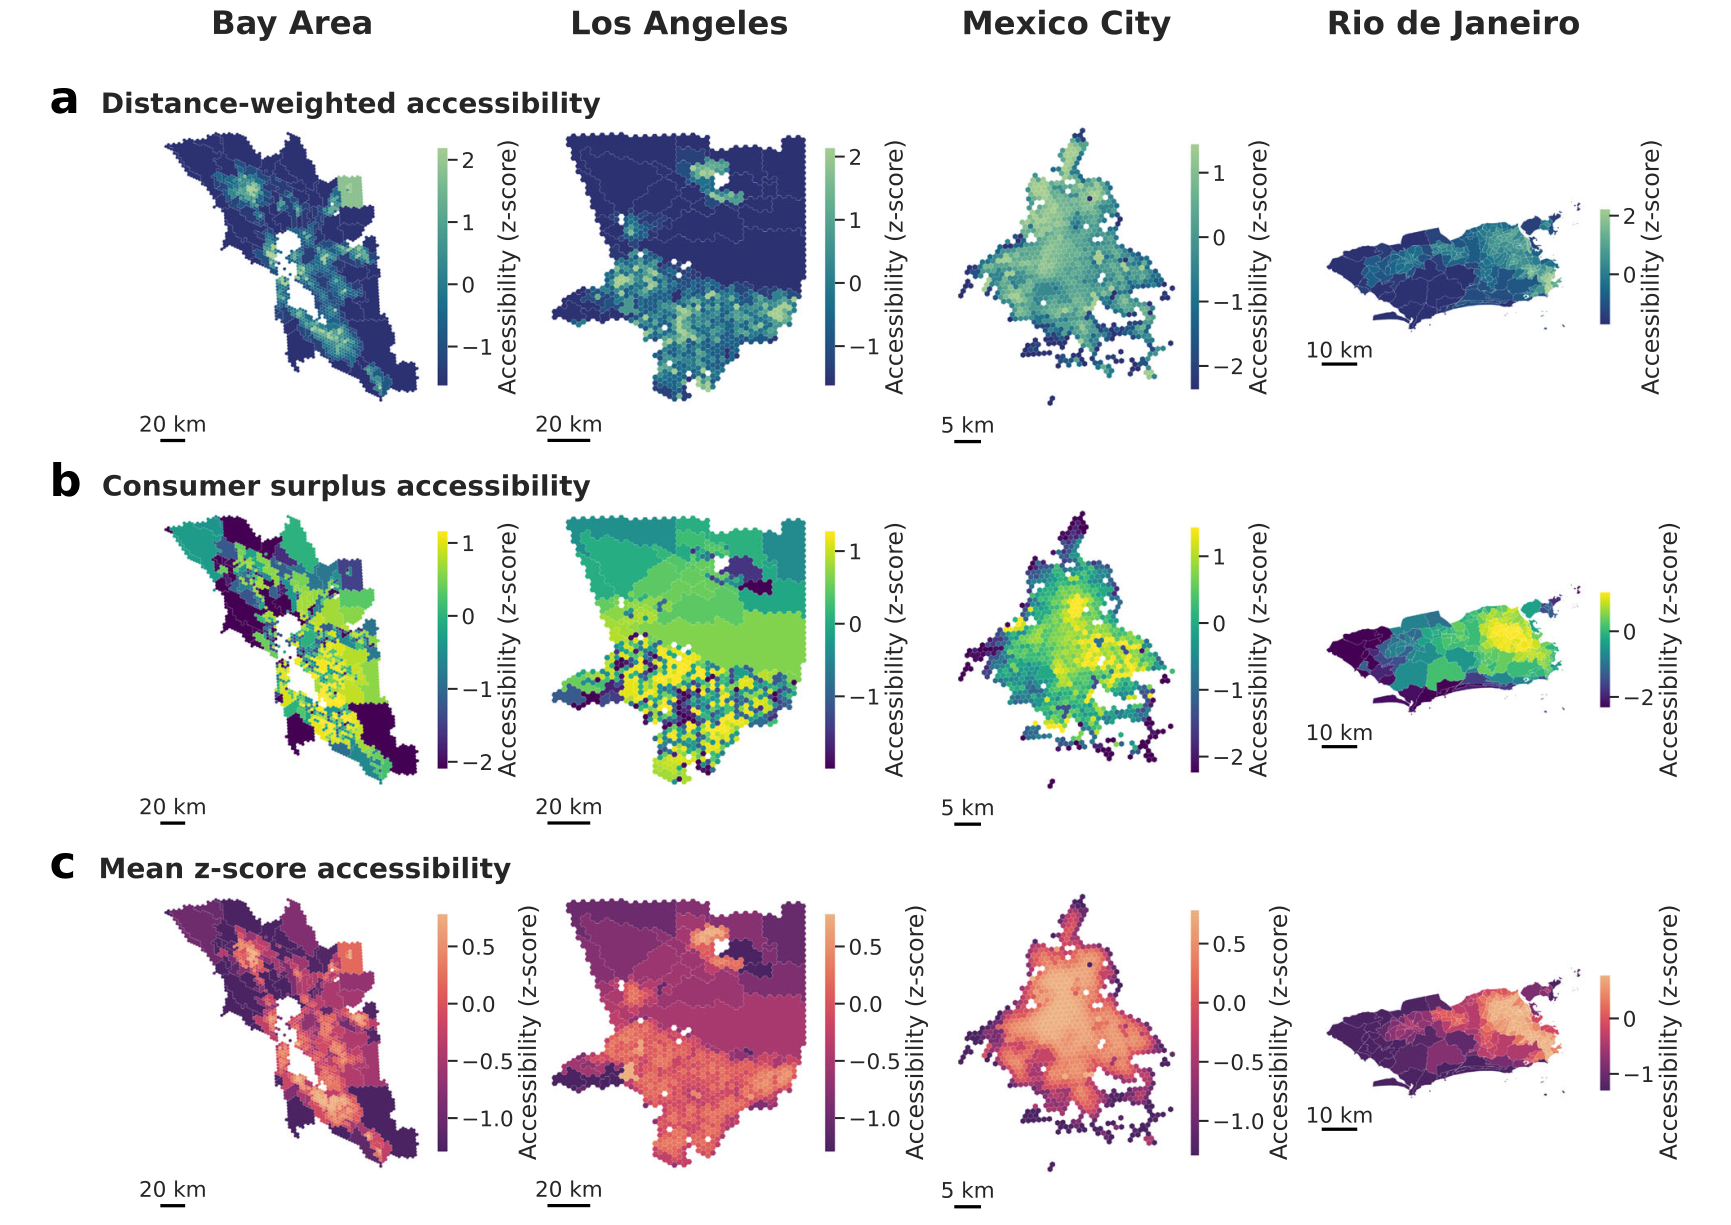
图 6|两种可达性在地图上差在哪里?
(a)距离加权可达性的城市内 z 分数。(b)消费者剩余的 z 分数;和(a)不一致的地方,来自目的地 ECIemp 和起点非正式率,而不只是距离。(c)两者 z 分数的平均。网格与图 2 相同,每张图覆盖整个研究区,色标按面板自己的范围绘制。z 分数可以跨城比较定义,颜色深浅不能直接跨城相减。论文指出边缘小区整体更低,里约西侧在综合指标上尤其偏低。来源:原论文 Fig. 6。
补充相关图不在这里展开。正文对那张图的概括是:距离加权可达性与非正式率在美国正相关、在拉美负相关;消费者剩余与非正式率除墨西哥城外为负;综合指标在四城都随非正式率下降。
这些结果停在哪一层证据?
系数是横截面流量里的系统性关联。居住地被当作给定,模型只分配工作地;论文引用美国和拉美岗位变换通常比搬家频繁,作为这个简化的理由。它没有观测一次复杂度变化之后通勤是否跟着变,也没有把搬家和工作地选择放进同一个决策。ECIemp 是小区—部门网络压成的一个指数,不能拆成某一条集聚机制在吸引通勤。
四城的非正式就业不是同一个测量,里约的居住地口径停在 2010 年,出行则是 2023–2024 年。拉美就业人数在规模区间里随机取整,美国就业和通勤都依赖合成数据。定位数据用昼夜时间识别家和单位,同一小区内部的工作被去掉。这些系数可以在城市之间比较符号和分组,不能把替代率写成通用的公里换算。部门关联一旦进入,拉美非正式率系数的符号就反过来,所以高非正式住区愿意远赴复杂工作地,是主模型规格下的结果。
讨论里的政策方向建立在这些关联上:拉美两城既要改善外围高非正式住区与高 ECIemp 中心的联系,也要提高本地正式岗位和本地复杂度,避免只是把长通勤转给工人;美国两城的距离障碍对非正式就业者更低,论文因此更强调技能和制度性障碍。高 ECIemp 但弱势群体难以到达的地方,被看成公共交通的候选;物理上容易到达但 ECIemp 低的地方,被看成本地产业发展的候选。这些是把系数和地图合在一起的建议,不是干预实验的效果。
一句话总结
四座城市的工人都会偏向更复杂的工作地,但非正式就业只在墨西哥城和里约与更远的高复杂度通勤连在一起;只按距离评价可达性,会把美国高非正式住区的近距离优势,看成他们同样拥有更好的工作选择。
核心来源
- Nature Communications 论文页面,Article in Press,DOI:10.1038/s41467-026-78293-3。正文图 1–6 与表 1、表 2 都出自这一版本。
- 补充材料由期刊页面提供。正文引用了其中的交叉验证、部门关联、工资代理和公平性分层;上面的 CPC 与系数变化是正文已经写出的数字。
- WorkReach 代码与汇总数据,存档于 Zenodo:10.5281/zenodo.21924441。公开的是汇总通勤、小区 ECIemp 和非正式率。墨西哥城和里约的原始定位受商业许可限制,湾区和洛杉矶的 Replica 数据依加州大学伯克利分校与 Replica 的协议使用。
- 家和单位识别代码见 gc-lbs,存档于 Zenodo:10.5281/zenodo.21924437。
作者介绍
三位作者的单位和分工以论文署名、通讯邮箱和作者贡献说明为准。
- Ollin D. Langle-Chimal:加州大学伯克利分校土木与环境工程系。与 González 共同构思研究并设计方法,完成分析并撰写文稿。通讯作者,ollin@berkeley.edu。
- Steffen Knoblauch:海德堡大学交叉科学计算中心,以及海德堡大学海德堡地理信息研究所。负责里约热内卢出行数据的收集、分析和校验,并参与修改文稿。
- Marta C. González:加州大学伯克利分校土木与环境工程系,以及城市与区域规划系。共同构思研究、设计方法并解释结果,参与修改文稿。通讯作者,martag@berkeley.edu。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个城市只用距离加权可达性排队修路,湾区高非正式小区的中位数是 0.11,低非正式小区是 0.09,高非正式组看起来略占优势;同一批小区的消费者剩余中位数却从 4.47 降到 0.93。只缩短距离的项目,会优先帮助已经显得更近的一组,而近处岗位若复杂度更低,期望效用的差距还在。墨西哥城相反:距离指标已经是低非正式组更高,0.31 对 0.27,消费者剩余却是 3.86 对 3.90。同样一条投资规则,会在两座城市指向不同的小区。真正拿去排序之前,还要先固定效用里有没有部门关联,因为这项一加进去,墨西哥城的非正式就业系数就从 10.250 变成 −4.620,里约从 4.267 变成 −1.133。主模型里的正号,经不起这一次规格变化。