把住宅区和就业中心拆开之后,通勤预测还守得住距离衰减吗?
论文名片|Minwei Zhao、Dailuo Zhang、Zhecheng Shi、Cai Wu,Theory-informed and interpretable graph learning for urban commuting flows,Sustainable Cities and Society,2026,148:107575,2026年6月13日在线发表。DOI:10.1016/j.scs.2026.107575。收稿 2026年3月21日,修回 2026年5月19日,接受 2026年6月6日。
设想要估计一片新住宅区的人会去哪些就业中心上班。引力模型用三样东西作答:起点有多少潜在通勤者,终点有多强的吸引力,两地有多远。图神经网络可以不先选定幂函数或指数函数,让相邻地区互相传递信息,直接拟合整张通勤表。许多图网络仍把起点和终点送进同一个编码器。住宅区向外发出通勤的能力,和就业中心把通勤吸进来的能力,就共用一套参数。表可以拟合得更紧,远距离区对也可能被写出不该有的大流量。
这篇论文把这两件事放进同一个模型。PIG-GNN(Physics-Informed Gravity Graph Neural Network,物理信息引力图神经网络)用两座塔分开起点的产出和终点的吸引,再在训练损失里对距离衰减指数、齐夫位序指数和流量分布加软惩罚。在英格兰家到工作地通勤上,它在一组可部署基线里得到最低的均方根误差,并保住预测流量的双峰。使用了观测进出总量的双重约束引力模型,决定系数和重叠指标仍略高。换到全目的出行,点误差继续领先,重叠指标则让给随机森林。
先说结论
- 主实验是英格兰 6,856 个中层统计区(Middle Layer Super Output Area,MSOA)之间的家到工作地通勤。去掉区内自环后保留 298,681 条正流量边。五折分层交叉验证中,PIG-GNN 的均方根误差 RMSE 为 0.297±0.002,决定系数 R² 为 0.394±0.014,共同通勤者份额 CPC 为 0.791±0.004。平均绝对误差 MAE 为 0.187±0.009,与不含图结构的多层感知机并列。指标在论文全程保留的 log(1+流量) 尺度上计算,0.297 是对数误差,不是 0.297 人次。
- 这套通勤的距离衰减很缓。表 2 给出距离衰减指数 β = 0.258、齐夫指数 α = 0.539,行程距离中位数 14.15 公里、均值 41.54 公里。模型不把 β 固定成 0.258,只惩罚落在 [0.2, 3] 和 [0.5, 3] 之外的 β 与 α。
- 从多层感知机逐块加到完整模型,RMSE 从 0.317±0.005 降到 0.297±0.002,CPC 在加入物理损失后从 0.784±0.007 升到 0.791±0.004。只加邻接 GATv2 时 MAE 为 0.169±0.003,低于完整模型的 0.187±0.009。物理约束抬高的是决定系数和重叠,MAE 没有继续下降。
- 把工作年龄人口乘以 1.2,预测流量平均变化 +22.01%;把兴趣点密度乘以 1.2,平均变化 +0.53%。这是训练好的模型对输入缩放的响应,论文把它写成与引力角色一致的诊断,并写明它不是人口或岗位变化的因果效应。
- 图 12 把预测对数流量分成两簇:市内高流量簇均值 6.05,图上 n = 11,697;城际低流量簇均值 1.32,图上 n = 703,418;分隔阈值是预测对数 5.0。高流量簇相对完美预测线成一条偏高的横带。全目的 ALLOD 上 PIG-GNN 的 RMSE 最低,CPC 为 0.6076±0.0070,低于随机森林的 0.6748±0.0010。
一条边,是两个统计区之间的通勤人数
分析单位是起讫点对,也就是从一个 MSOA 到另一个 MSOA 的通勤流量,不是一个人的一日轨迹,也不是区内移动。节点是英格兰 6,856 个 MSOA。论文写,含区内自环时有 |E| = 305,107 条有记录的有向边,相对 6,856² = 47,004,736 个可能区对,稀疏度约为 99.4%。自环被删掉,占这些边的 2.11%;表 2 和表 A.10 使用的边数是 298,681。305,107 − 298,681 = 6,426,6,426 / 305,107 = 2.11%。主实验只监督这些正流量边。零流量区对没有进入主损失,附录另做了抽 10% 零流量边的试验。
起点特征是 16–64 岁工作年龄人口,当作产出(production)的代理。终点特征是兴趣点密度,当作吸引(attraction)的代理。二者都先做 log(1+x),再按全部 MSOA 标准化。流量同样保持在 log(1+y)。方法部分写,MSOA 质心之间的距离用 Haversine 公式计算大圆距离,并记为 log(1+d)。图 5 的距离矩阵也标成 geodesic。局限部分则写当前实现使用欧氏距离;距离分箱附录按质心间欧氏距离、以公里切成五组。三处用词不一致,下面不把它们收成同一种距离。
论文没有写这套家到工作地数据的年份和原始发布机构,只说数据可应要求提供。表 A.10 给出 H2W 的流量均值 1.73、标准差 2.00、最大值 74。这些是表中的流量统计,分母是 298,681 条边。
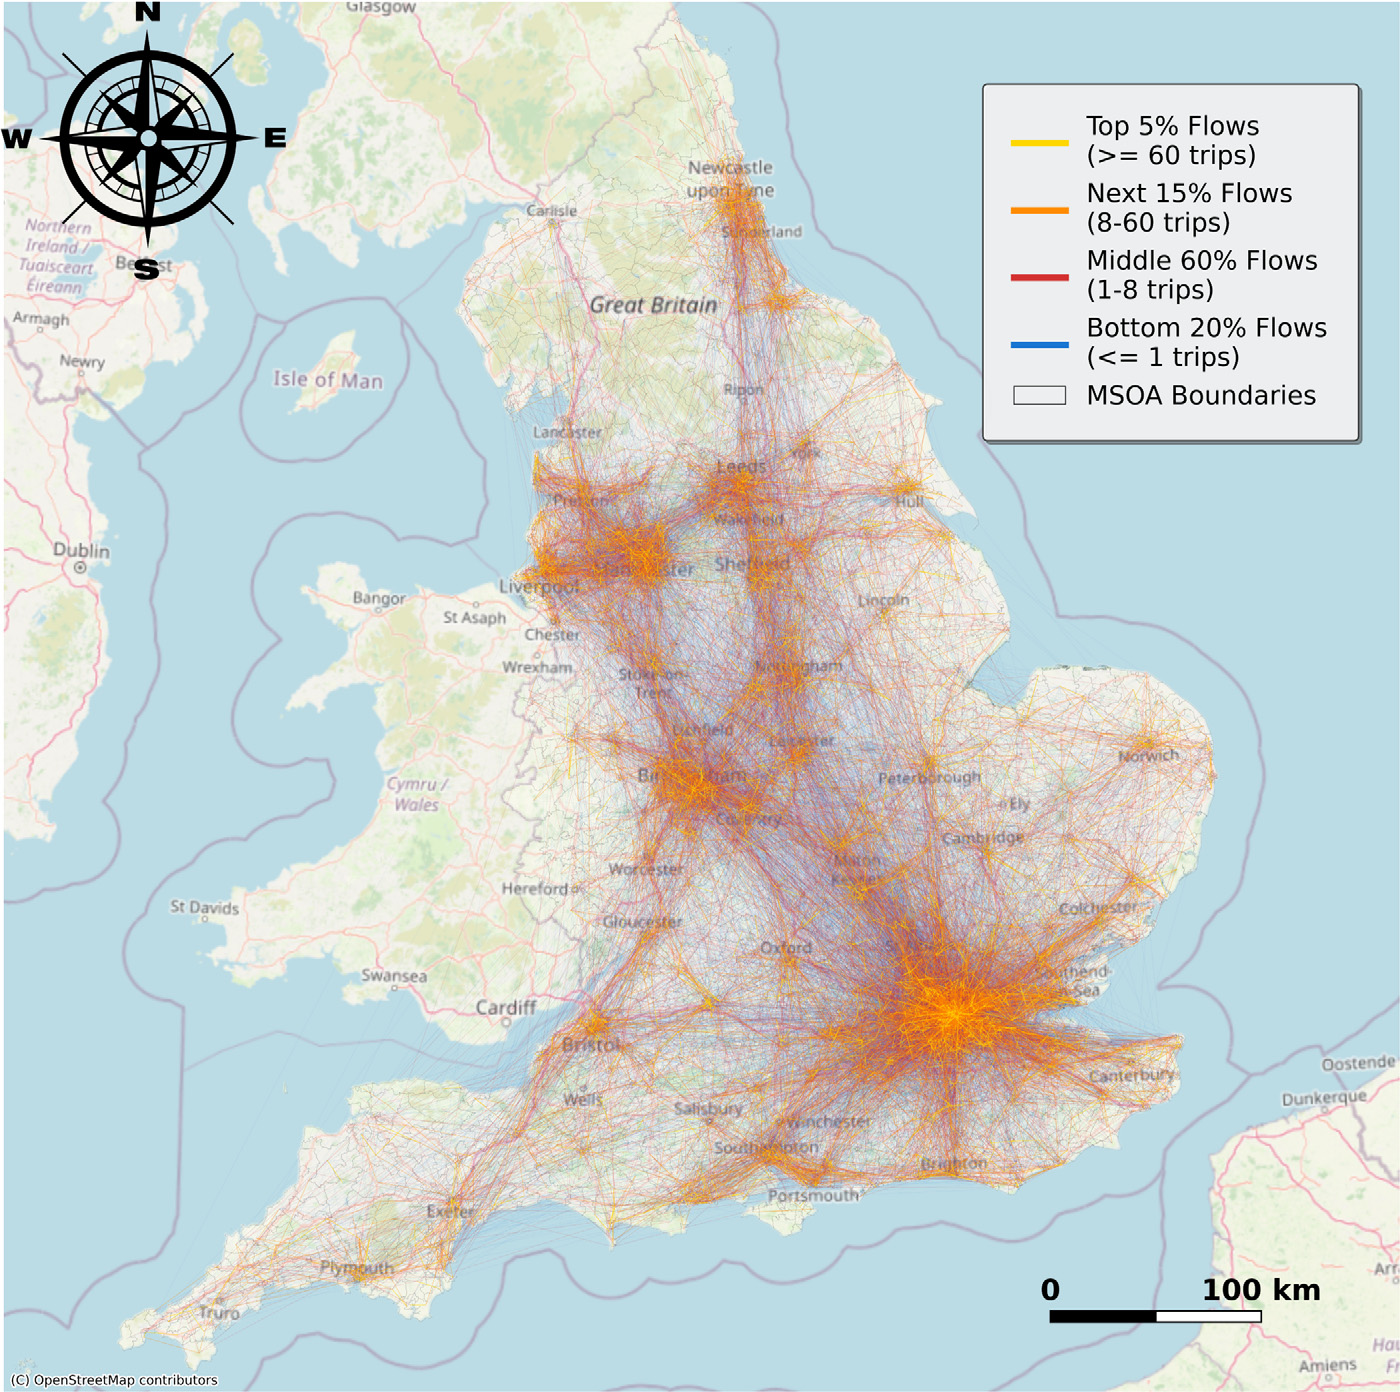
图 2|家到工作地的大流量集中在哪几座城市之间?
无字母子图。底图是英格兰,灰线为 MSOA 边界,比例尺 100 公里。连线按流量分层:最高 5% 为不少于 60 人次,黄色;其后 15% 为 8–60 人次,橙色;中间 60% 为 1–8 人次,红色;最低 20% 为不超过 1 人次,蓝色。四档占比相加为 100%。最粗的联系集中在伦敦、曼彻斯特、伯明翰一带。这张图展示观测流量的空间骨架,还没有模型预测。来源:原论文 Fig. 2。
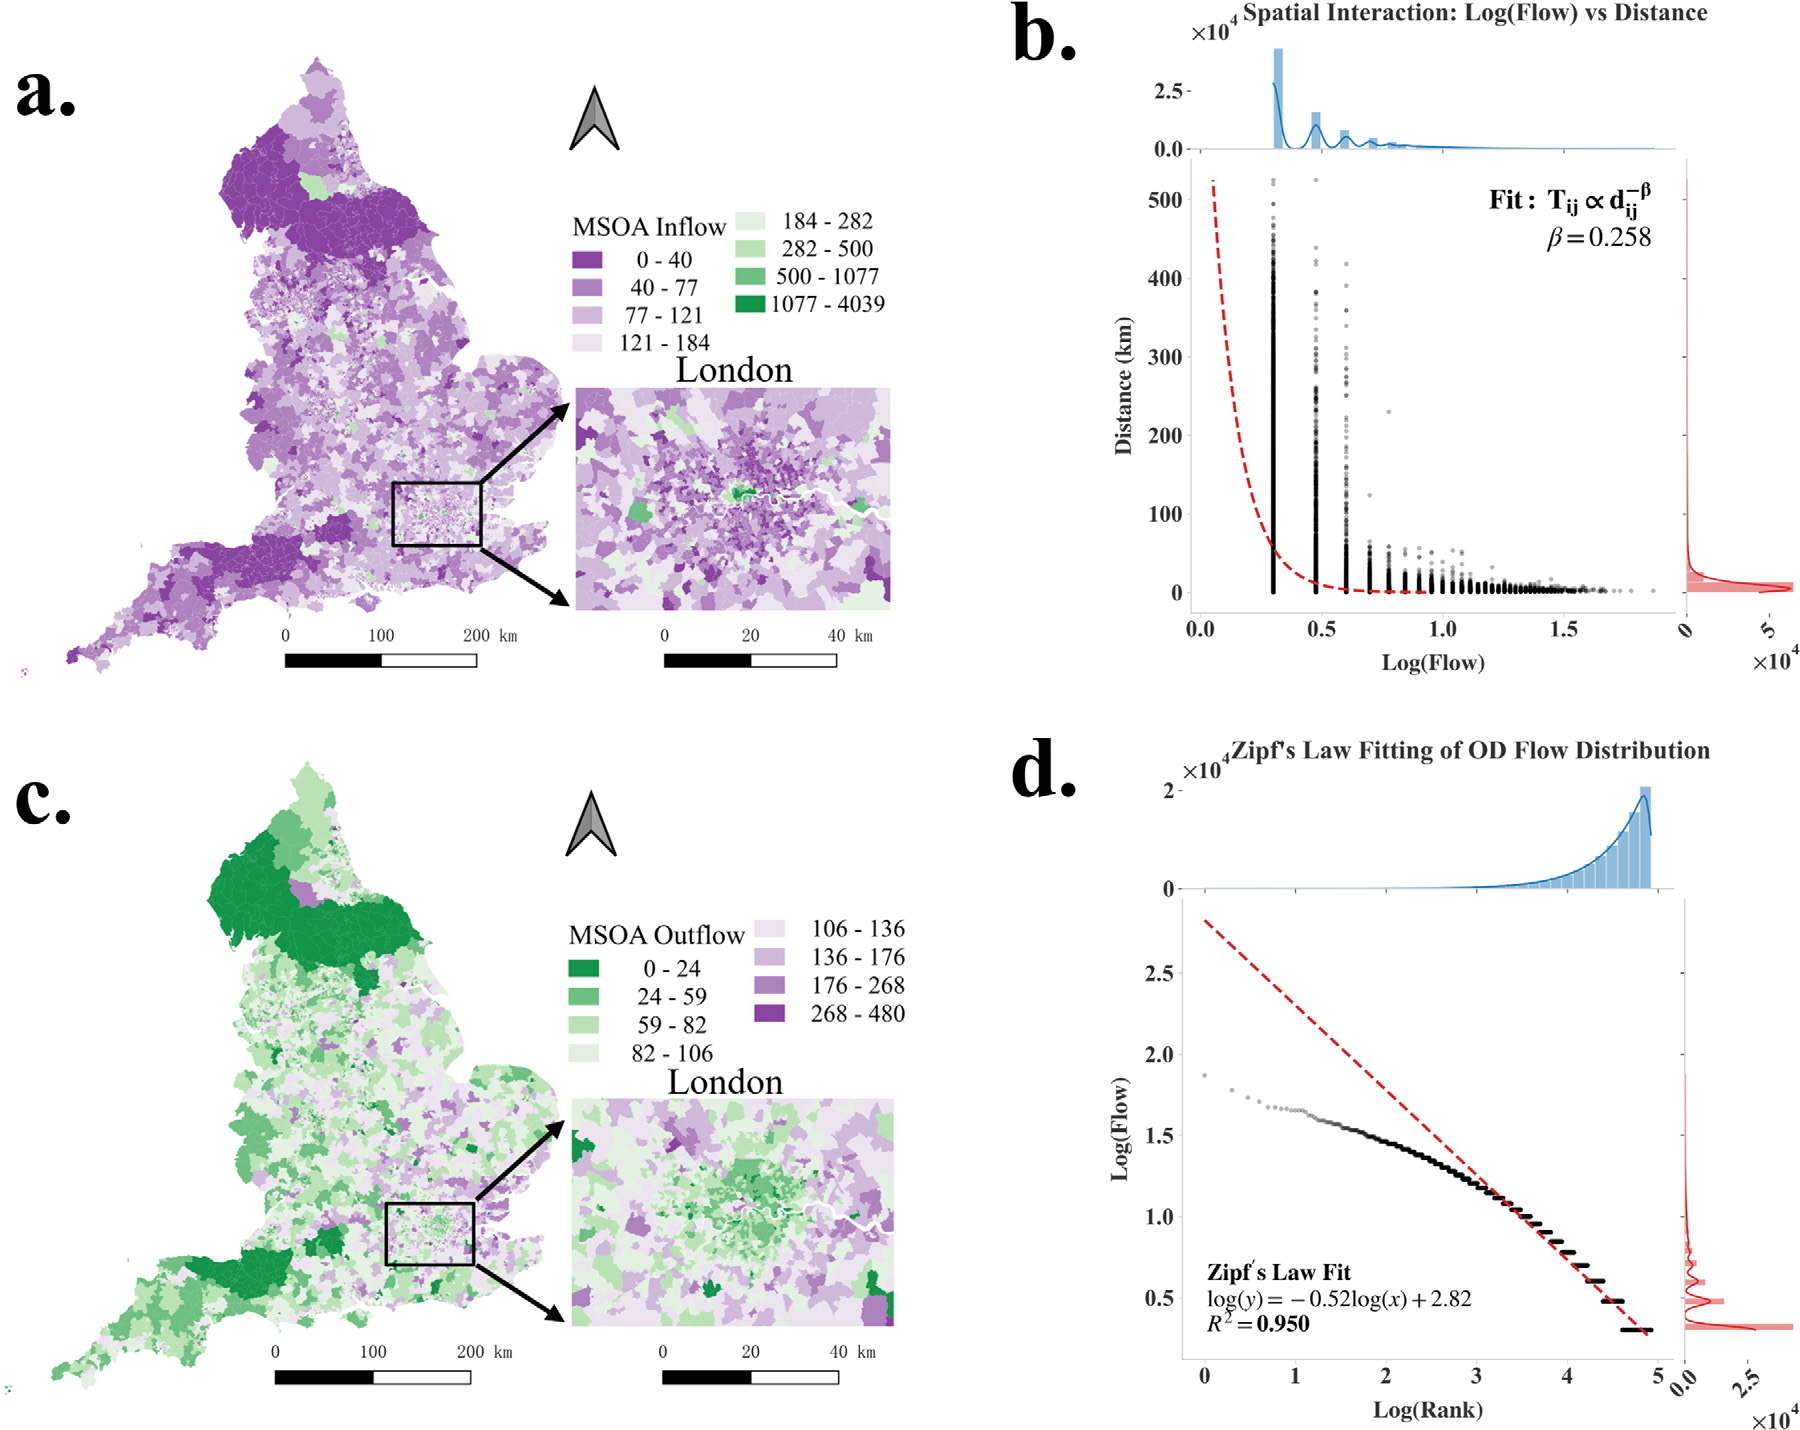
图 3|流入、流出、距离和位序,各自呈现什么形状?
(a)各 MSOA 的流入,伦敦另有放大图,颜色越深流入越高。(b)距离(公里)对 log(流量)。图中拟合写着 Tᵢⱼ 正比于 dᵢⱼ 的 −β 次方,β = 0.258,与表 2 相同。大量边堆在短距离,少量边可以延伸到数百公里。(c)各 MSOA 的流出,同样带伦敦放大图。流出比流入铺得更散,符合居住地发车、就业中心汇集的不对称。(d)齐夫位序:横轴 log(位次),纵轴 log(流量)。图上拟合式为 log(y) = −0.52 log(x) + 2.82,R² = 0.950。最大的那些流量落在直线下方,中后段更贴近直线。表 2 另给齐夫指数 0.539。0.52 与 0.539 都来自论文,对应图上显示的拟合和表中的指数,不把它们当成同一个四舍五入。来源:原论文 Fig. 3。
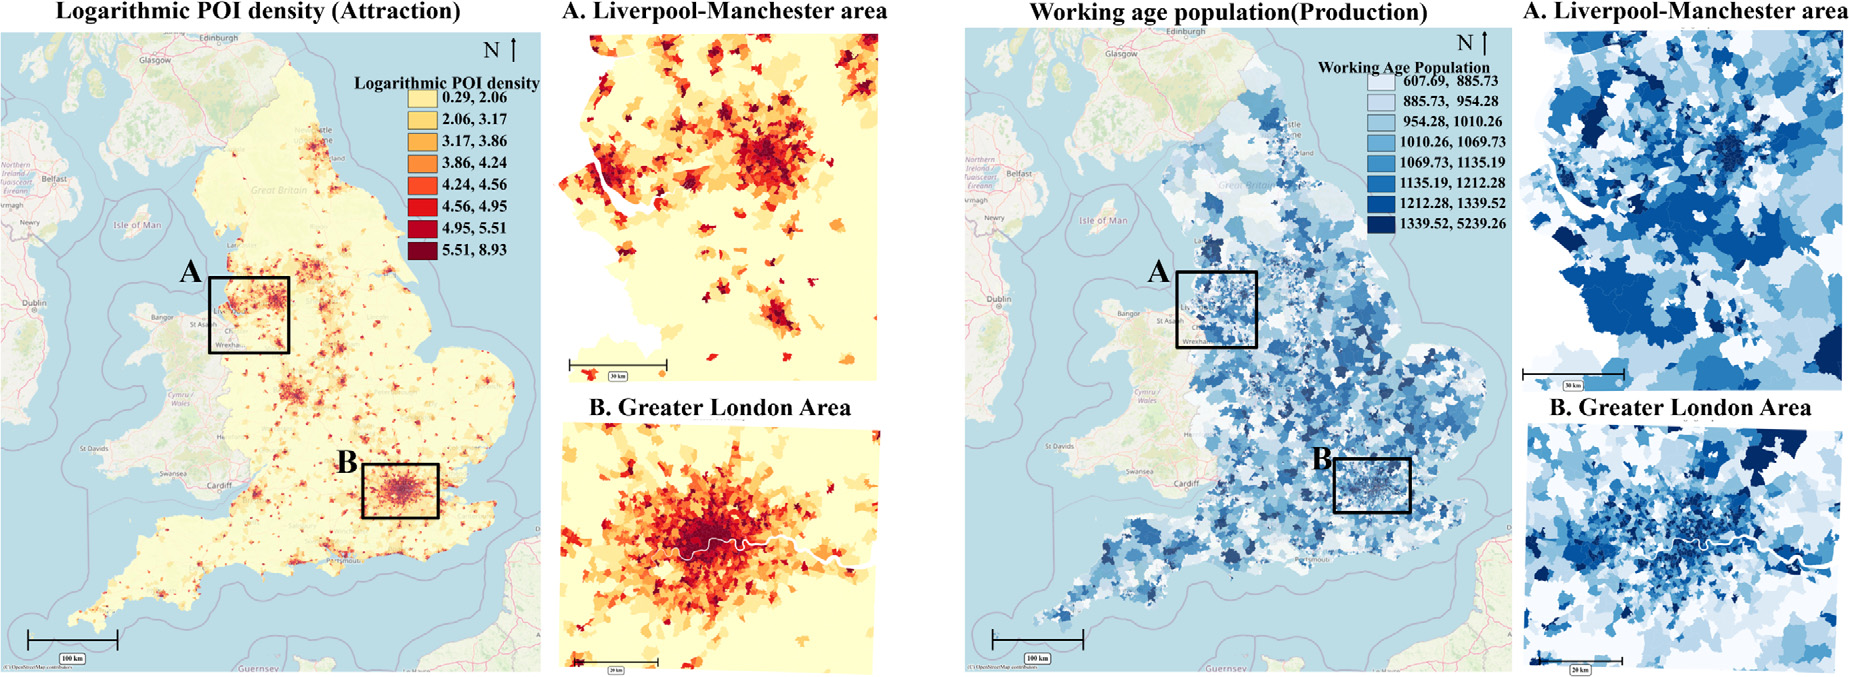
图 4|两座塔各自吃进什么样的地图?
图注把工作年龄人口称为(a)、对数兴趣点密度称为(b)。图面从左到右是兴趣点密度,再是工作年龄人口。左右两幅里的 A、B 是利物浦–曼彻斯特和大都伦敦的放大,不是图注的(a)(b)。颜色越深数值越高。兴趣点在市中心收成更尖的簇,工作年龄人口在主要城市连成更宽的片。两张图都是节点输入的空间分布,还没有变成流量预测。来源:原论文 Fig. 4。
作者写明这两项代理很粗。工作年龄人口不等于真正通勤的劳动力,兴趣点密度把商业、服务、居住混在一起。更细的就业地块和岗位行业没有进入主实验。附录用更丰富的公开变量重跑了一次,见后文,那次训练轮数也不同。
为什么要两张图、两座塔?
邻接告诉模型哪些区共用边界。它不告诉模型哪些区之间真有人通勤,也不告诉流量有多大。所以论文建了两张图。空间邻接图的边是共边的 MSOA,取平面邻接,不设距离阈值,也不用 k 近邻作为默认。OD 交互图只保留观测到的正流量有向边,边属性是 log(1+流量) 和 log(1+距离)。自环已删。
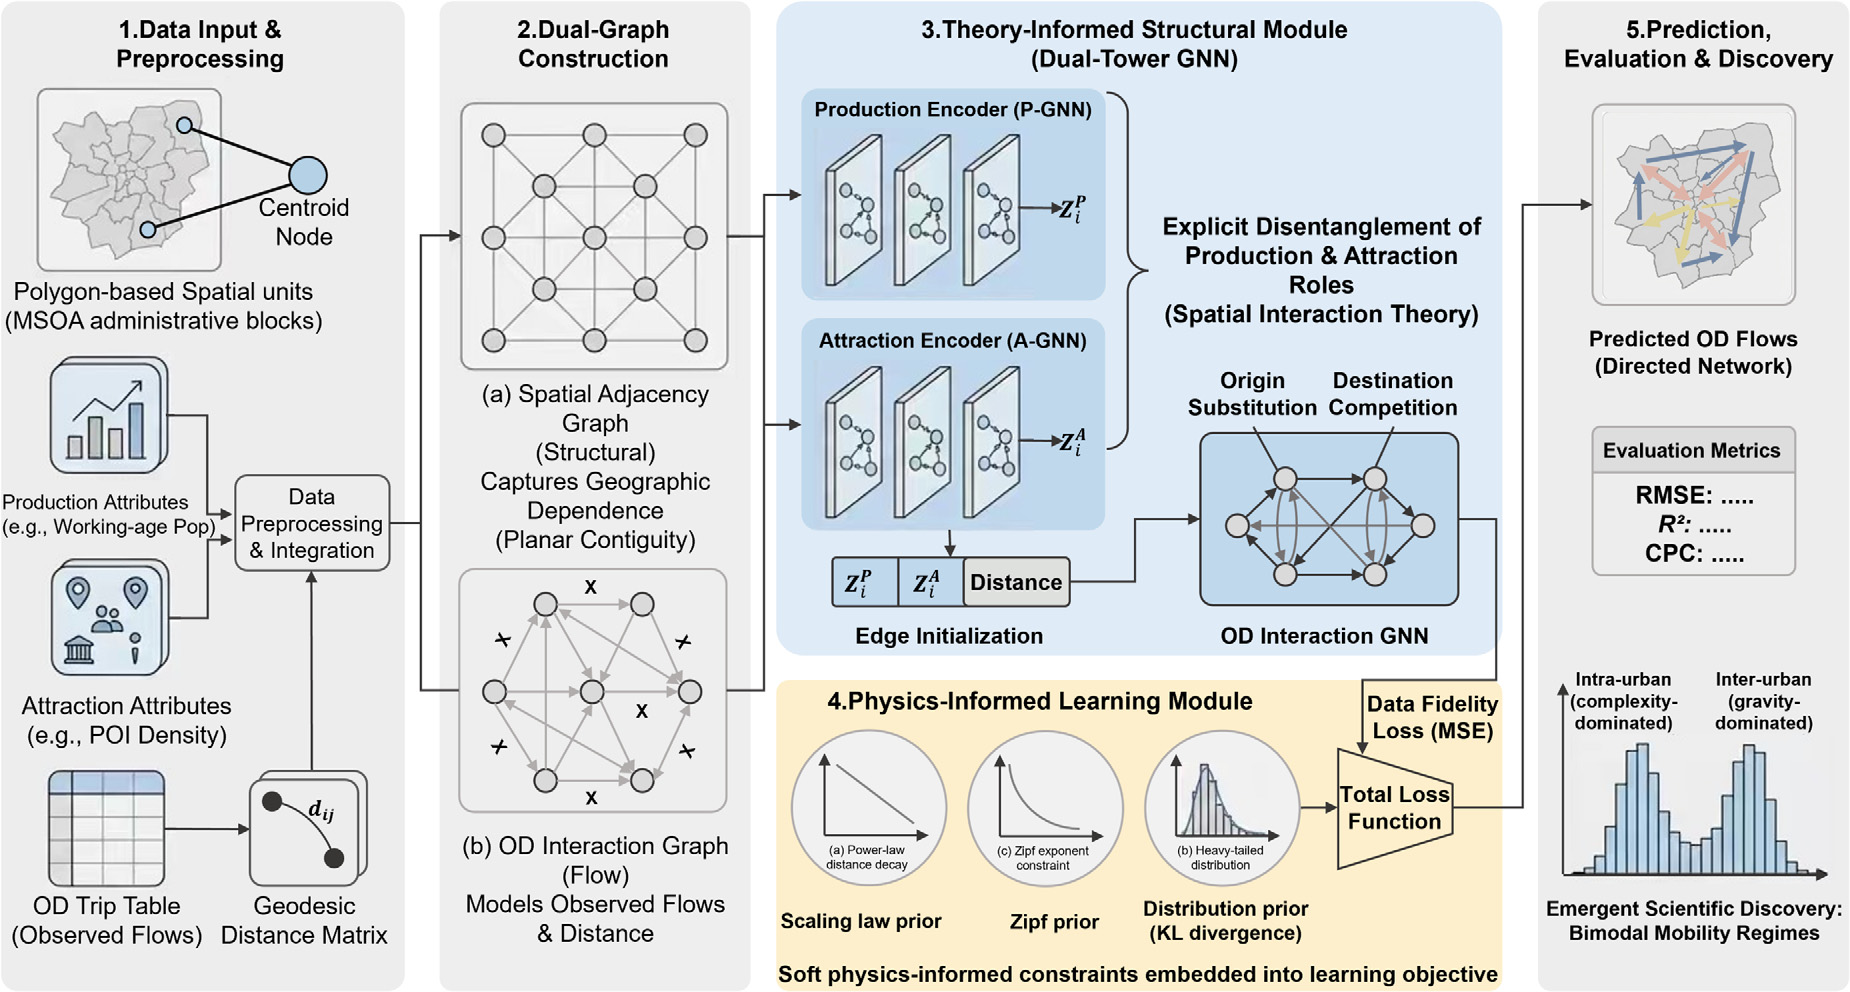
图 1|从通勤表到软约束,整条流水线分哪几步?
示意图,按 1 至 5 排列,其中第 2 步内部有字母。(a)空间邻接图,共边,用来传递地理依赖。(b)OD 交互图,只含观测流量和距离。第 3 步把产出编码器 P-GNN 和吸引编码器 A-GNN 分开,得到两套嵌入,再和距离一起初始化边,并在 OD 图上做交互。第 4 步把幂律斜率、齐夫位序和分布的 KL 散度写成软惩罚,与数据均方误差合成总损失。第 5 步的 RMSE、R²、CPC 方框是占位符,不是表 3 的结果;右下双峰直方图也是示意,实测双峰在图 12。来源:原论文 Fig. 1。
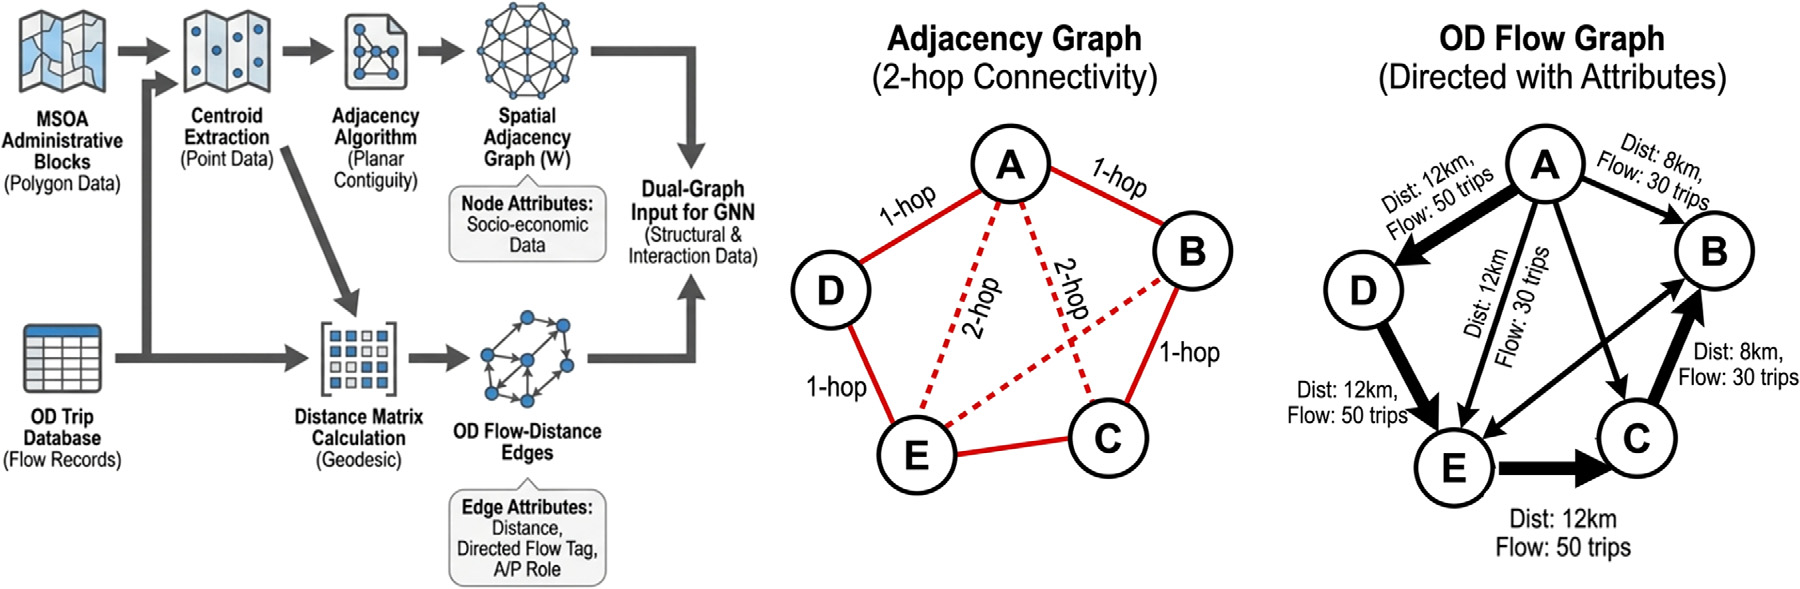
图 5|邻接图和 OD 图具体长什么样?
无字母子图,从左到右三块。左块从 MSOA 多边形提取质心、按共边生成邻接,并从 OD 表计算测地距离矩阵。中块是邻接示意图:实线为 1 跳共边,虚线为 2 跳。右块是带方向的 OD 示意图,边上标有距离和流量。右块里的 8 公里、12 公里、30 人次、50 人次是示意数字,不是英格兰某条边的实测值。来源:原论文 Fig. 5。
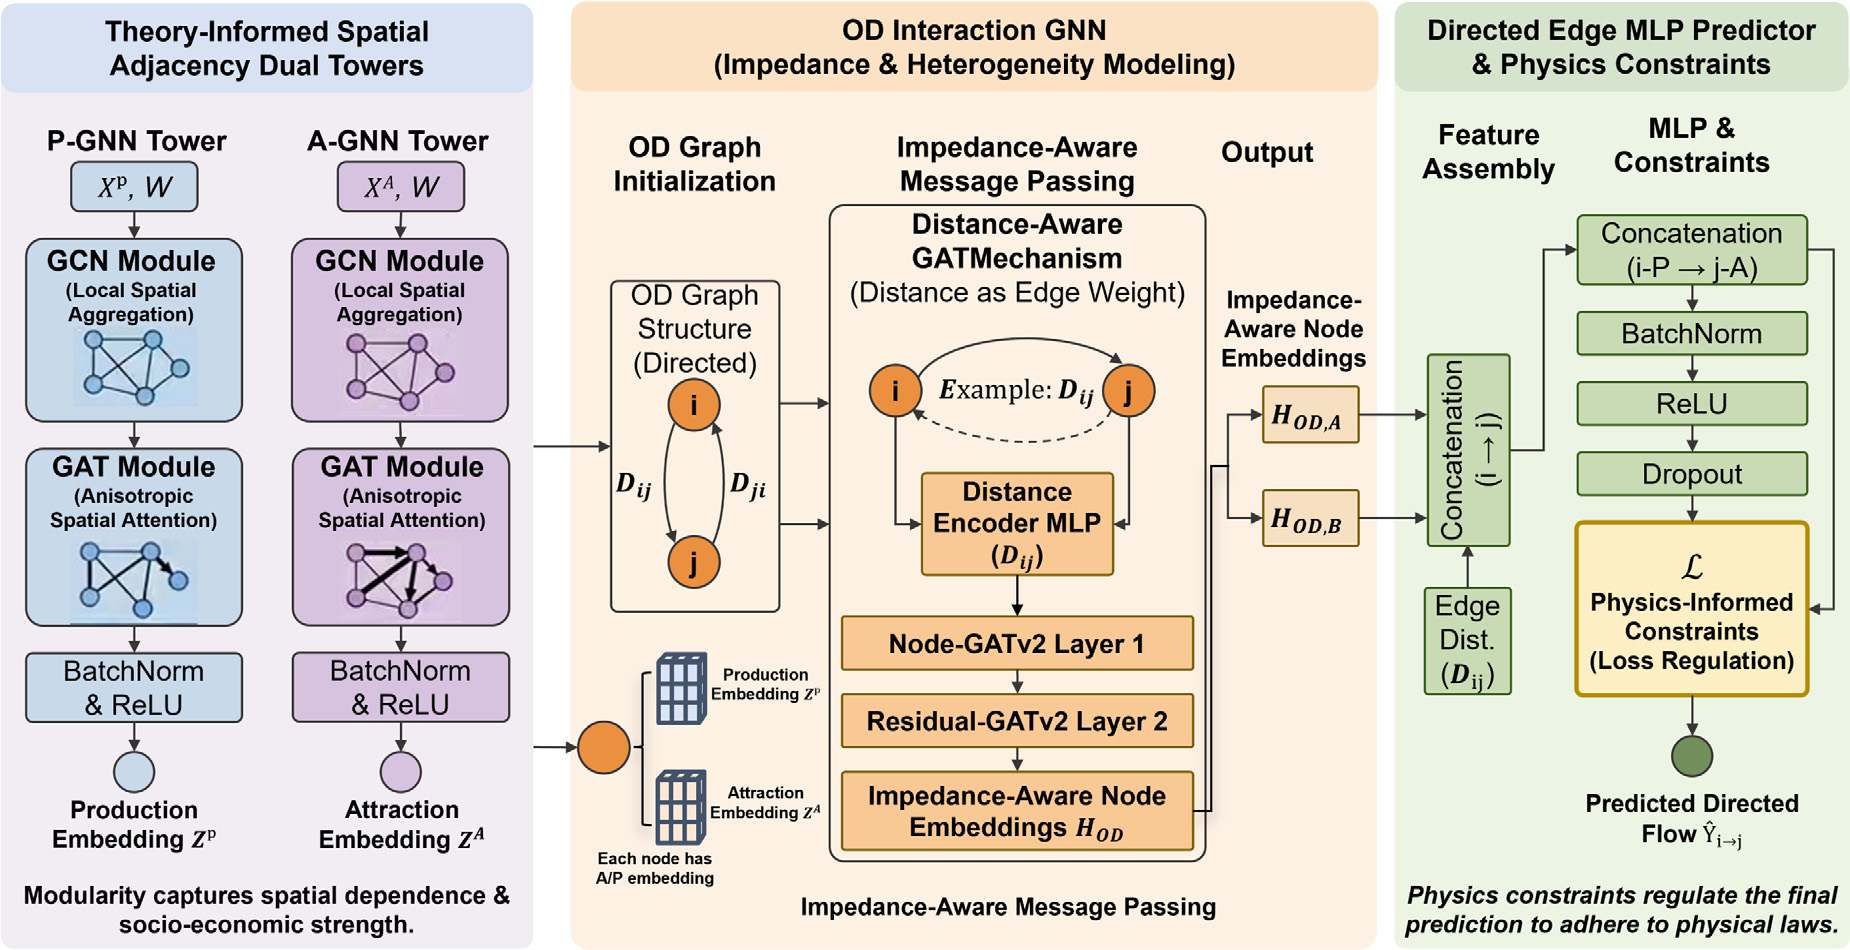
图 6|两座塔、边上的注意力和最后的多层感知机怎样接在一起?
无字母子图,三列。左列:P-GNN 读工作年龄人口,A-GNN 读兴趣点密度,二者都在同一张邻接矩阵上做多层 GATv2,参数不共享,各自输出嵌入。中列:每条观测边用来自起点的产出嵌入、终点的吸引嵌入和距离初始化,再在共享起点或共享终点的边之间做两层注意力。共享终点的边被用来表示目的地竞争,共享起点的边被用来表示目的地替代。右列:多层感知机读产出嵌入、吸引嵌入、更新后的边嵌入和再次送入的距离,输出预测流量;斜率、齐夫和 KL 约束加在损失上。来源:原论文 Fig. 6。
预测式要解决的比较是:在已经知道起点总的产出角色、终点的吸引角色和距离之后,这条边的 log(1+流量) 是多少。距离被送进两次,一次进边的初始表示,一次直接进最后的感知机。模型因此可以偏离一条僵硬的幂律,同时仍看得到距离。
主损失不预测 6,856 × 6,856 的全矩阵。计算量从全部区对降到约 30 万条边,也意味着模型没有在主实验里学习“哪些区对流量为零”。
软惩罚的区间从哪些流动系统里来?
作者先整理已发表的距离衰减指数。表 1 里列出的 β 大约从 0.80 到 2.71:Liu 等 2014 年中国 370 城签到为 0.80,Yao 与 Lin 2016 年华南出租车为 2.71。表中的 N 量纲不统一,Gonzalez 等 2008 年一行写 100,000 用户、六个月手机记录,N 栏为 16 M。这些 N 不能当成同一分母下的人数。正文同时写,城市内部出行的 β 可以低到大约 0.2–1.5,跨区域可以到大约 1.5–2.7。先验下界 0.2 来自这段叙述,低于表 1 里最小的 0.80。
只靠文献区间还看不到位序和分布差多少。作者又在八套 OD 数据上估计 β、α、与理论分布的 KL 散度,以及距离衰减的单调性。单调性在 0 到 1 之间,越高表示流量随距离下降越整齐。
| 数据集 | N | 距离中位数(公里) | 距离均值(公里) | β | KL | 单调性 | α |
|---|---|---|---|---|---|---|---|
| H2W(英格兰) | 298,681 | 14.15 | 41.54 | 0.258 | 0.033 | 0.697 | 0.539 |
| ALLOD(英格兰) | 2,383,725 | 28.99 | 46.64 | 1.173 | 0.125 | 0.811 | 1.395 |
| 深圳共享单车 | 26,870,820 | 1.34 | 1.84 | 1.672 | 0.033 | 0.909 | 1.796 |
| 成都滴滴出租 | 6,980,323 | 5.39 | 6.56 | 1.635 | 1.212 | 0.600 | 2.556 |
| Boston | 126,847 | 13.25 | 16.77 | 0.547 | 0.046 | 0.735 | 1.090 |
| Los Angeles | 116,902 | 19.10 | 23.52 | 0.489 | 0.065 | 0.769 | 0.790 |
| 联通县域迁移 | 8,173,881 | 773.31 | 890.80 | 1.824 | 1.537 | 0.773 | 1.715 |
| 百度城市迁移 | 12,569 | 1,516.30 | 1,696.82 | 2.503 | 0.604 | 0.867 | 2.819 |
N 是表 2 用于这些统计的记录数。共享单车超过两千六百万,更接近行程条数;百度迁移只有 12,569。不能把每一行的 N 都理解成行政区个数。H2W 的 β = 0.258 是八行里最低的,紧贴后来使用的下界 0.2;α = 0.539 也紧贴下界 0.5。成都滴滴的单调性最低,为 0.600,KL 却高达 1.212,说明短距离数据也可以明显偏离理论形状。
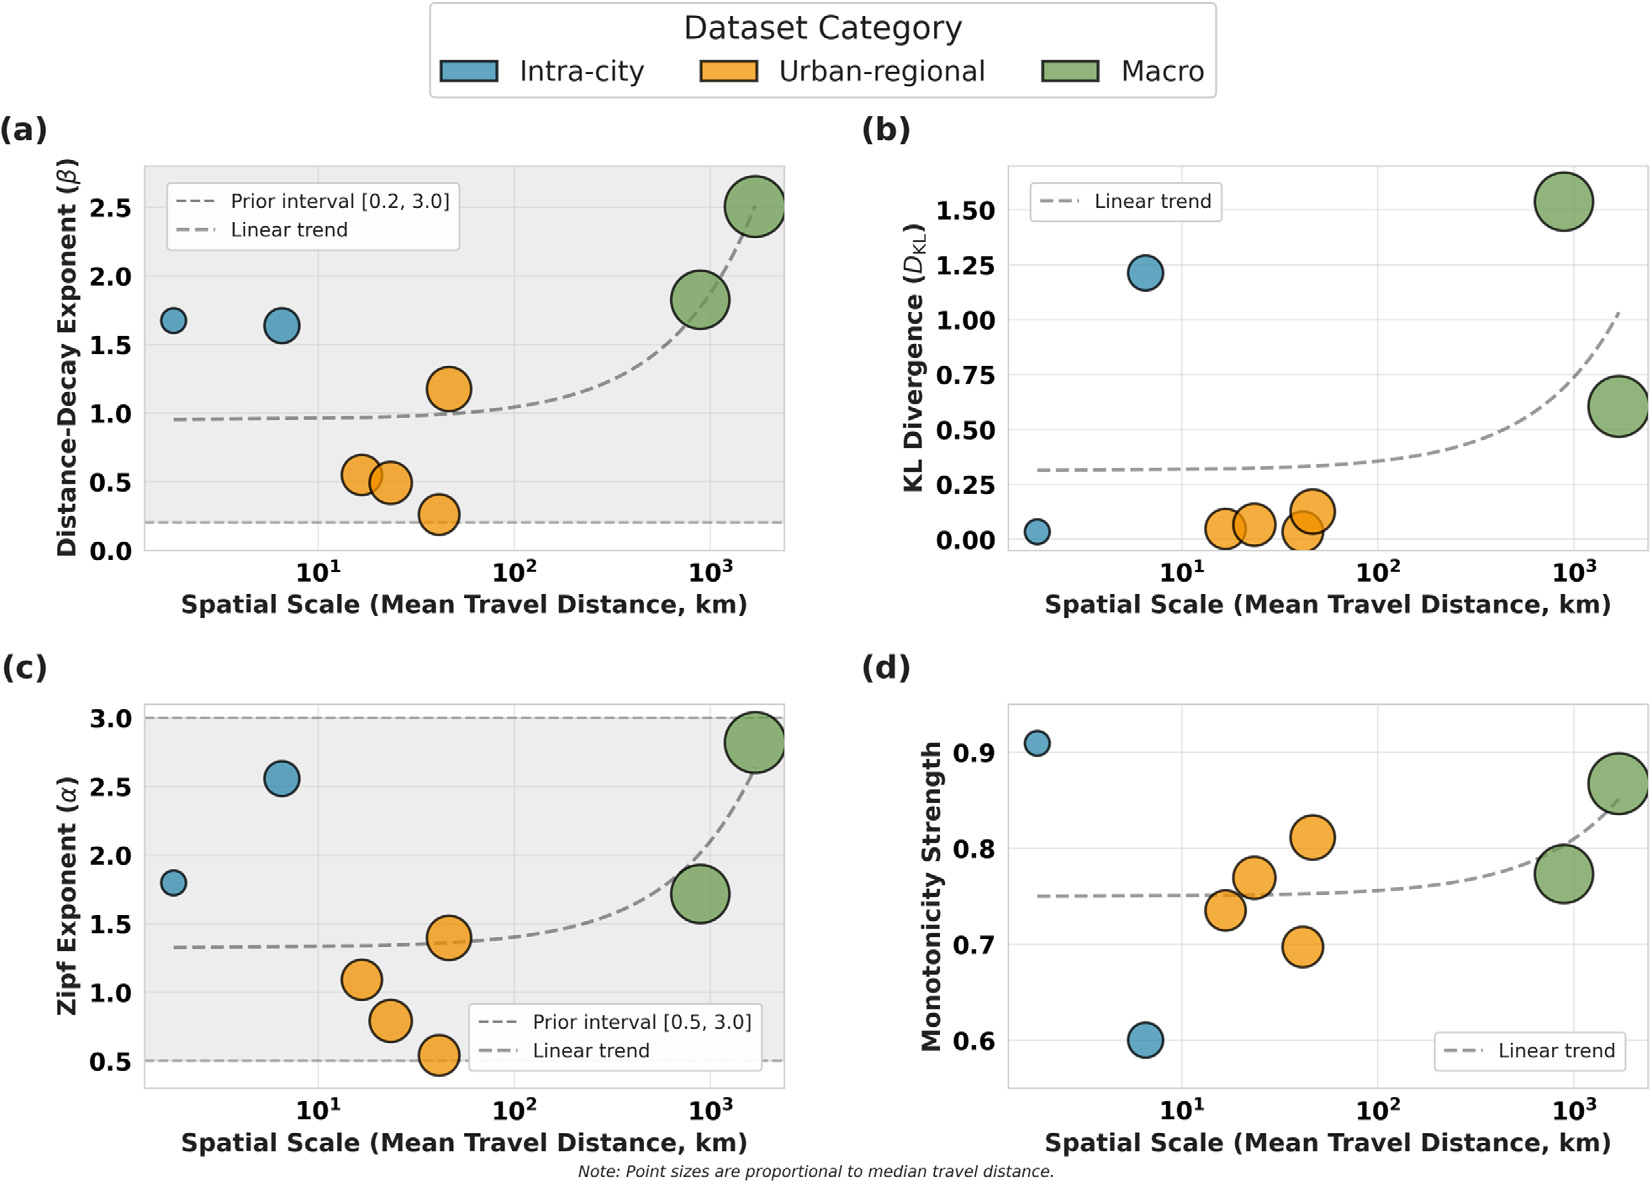
图 7|衰减和位序会随出行距离一起变陡吗?
(a)距离衰减指数 β 对平均出行距离,蓝色为市内,橙色为城市—区域,绿色为宏观尺度;虚线标出先验区间 [0.2, 3.0]。(b)KL 散度对平均距离。(c)齐夫指数 α,先验区间 [0.5, 3.0]。(d)距离衰减的单调性。点的大小表示数据规模。宏观、长距离的点更靠上,β 和 α 更大;短距离的点更分散。每个点是一整套数据的一个指数,不是一条通勤边。来源:原论文 Fig. 7。
训练时的总损失是四项之和:数据均方误差,加上斜率、齐夫、分布三项,各项乘自己的权重 λ。斜率项在距离箱内对 log(预测) 和 log(距离) 做回归,再按箱内边数加权,得到一个全局 β。齐夫项对 log(预测) 和 log(位次) 回归得到 α,位次用可微排序回传梯度。两项都只在越界时惩罚,惩罚等于超出量的平方;β 的允许区间是 [0.2, 3],α 是 [0.5, 3]。分布项用当前的 β 和 α 现造一条理论流量分布,再算预测分布相对它的 KL。附录写的分布惩罚是 KL 低于下界时的平方。图 10 把这条下界画在 0.05。区间内的指数和足够大的 KL 不被这项惩罚。因此软约束挡的是“衰减太弱、太陡,或位序太出格”,不是把每一条边钉在 T = 人口 × 岗位 / 距离的 β 次方上。
权重会随损失比例变化:某一项的 λ 等于其基准权重,乘以数据损失,再除以该项损失加一个很小的数。数据拟合很差时,约束权重变大;约束已经满足时,权重变小。图模型的 λ 在 {0, 0.1, 0.3, 1, 3, 10} 里随机搜索。论文给出搜索范围,没有单列一组最终胜出的学习率、隐藏维和 λ。
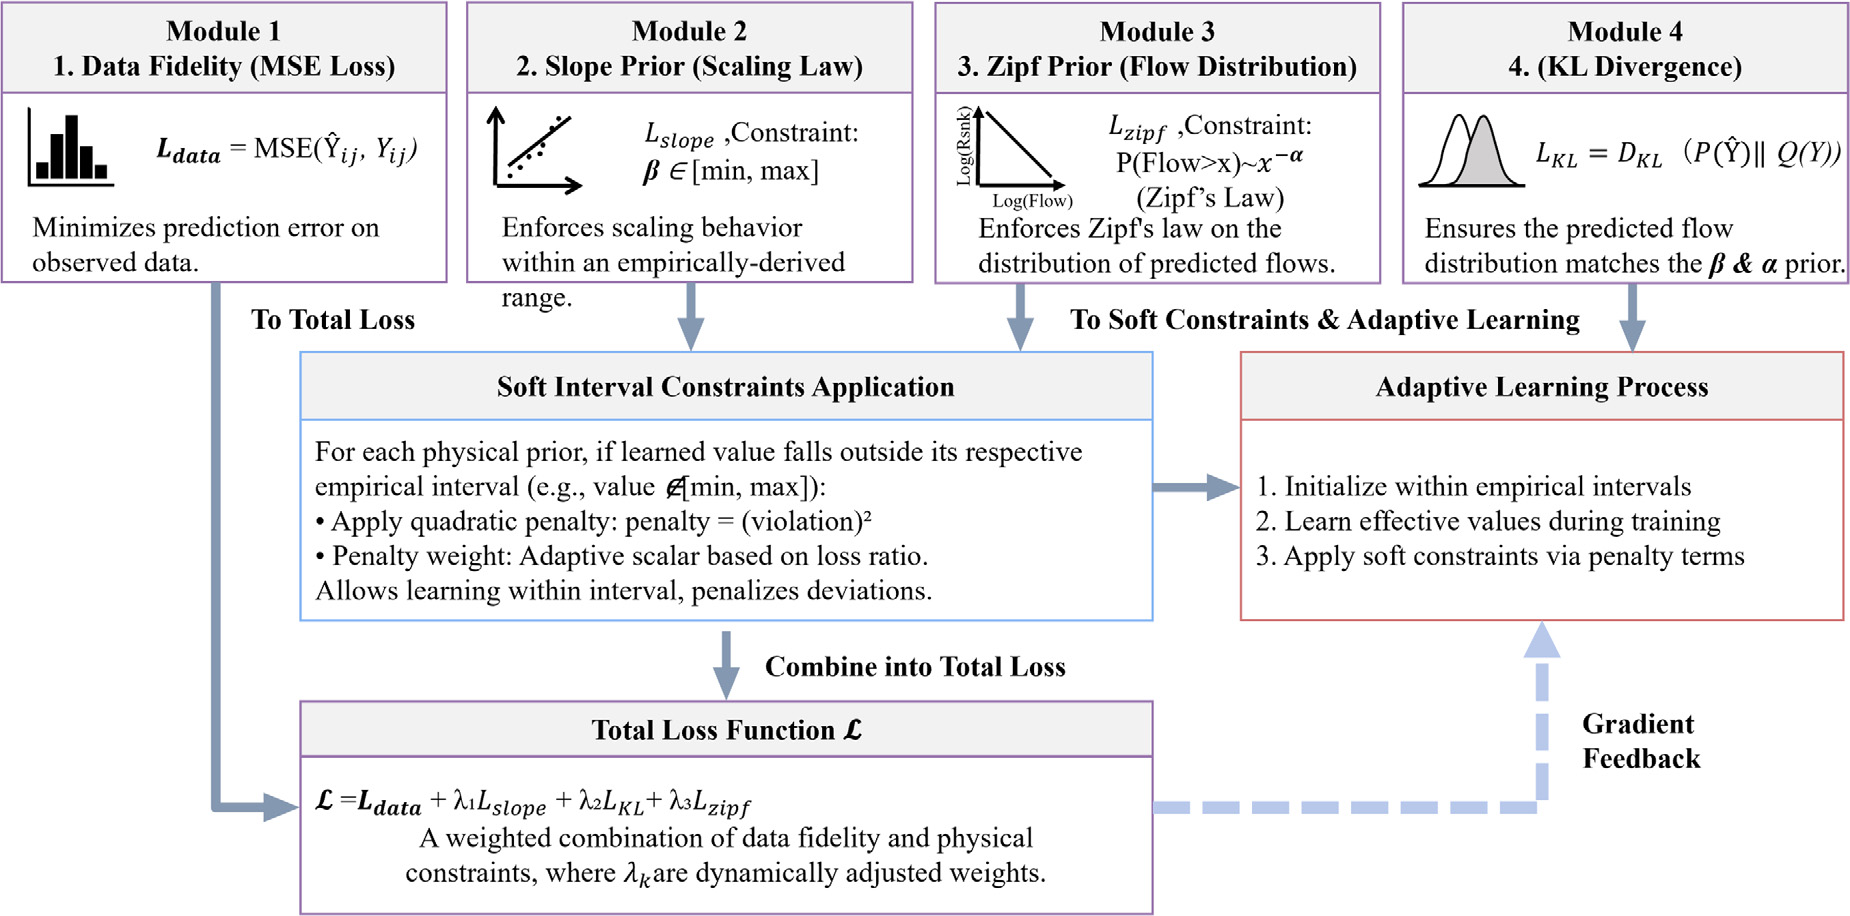
图 8|四项损失怎样合成一个总损失?
无字母子图。从左到右四个模块:数据均方误差、斜率先验、齐夫先验、KL 分布先验。中间方框把越界写成平方惩罚,并用数据损失与约束损失之比调节权重。右侧三步是:在经验区间内初始化 β 和 α,联合优化,再对越界施加软惩罚。这是损失结构图,没有报告某一次训练的最终 β。来源:原论文 Fig. 8。
八套数据里包含 H2W 自己。宽区间 [0.2, 3] 把 H2W 的 0.258 包在里面,并没有把拟合好的 0.258 写进公式。后面的窄区间敏感性会看到:把允许带的中心挪离 0.25 附近,CPC 会掉下去。
和谁比时,误差真的更低?
外层是按距离十分位、以及起点和终点强度分位分层的五折交叉验证,用来保住长尾,并减少同一强度的边整组漏到测试集。每一折内部再用三折随机搜索和早停选超参数,图模型 20 次试验。表 3 的数字是五折的均值 ± 标准差。所有基线使用同一套输入、同一种 log(1+y) 目标和同一套划分。
双重约束引力模型强制预测的起点流出、终点流入等于观测边际。这些边际在许多前瞻情景里未知。作者因此把它标成上界参照,加粗最优值时不把它算进去。
| 模型 | RMSE ↓ | MAE ↓ | R² ↑ | CPC ↑ |
|---|---|---|---|---|
| 无约束引力 | 0.343±0.002 | 0.233±0.000 | 0.284±0.002 | 0.754±0.001 |
| 引力 PPML | 0.347±0.034 | 0.250±0.036 | 0.245±0.044 | 0.756±0.021 |
| 门槛引力 | 0.323±0.004 | 0.225±0.002 | 0.287±0.011 | 0.770±0.002 |
| 双重约束引力(上界) | 0.304±0.002 | 0.235±0.002 | 0.435±0.005 | 0.792±0.002 |
| 辐射模型 | 0.342±0.002 | 0.233±0.000 | 0.284±0.002 | 0.754±0.001 |
| 随机森林 | 0.336±0.002 | 0.215±0.001 | 0.310±0.003 | 0.769±0.002 |
| XGBoost | 0.334±0.002 | 0.216±0.001 | 0.317±0.002 | 0.767±0.002 |
| MLP | 0.317±0.005 | 0.187±0.006 | 0.310±0.018 | 0.778±0.003 |
| 混合密度网络 | 0.361±0.006 | 0.219±0.007 | 0.204±0.023 | 0.748±0.008 |
| 双塔 GCN | 0.322±0.042 | 0.190±0.042 | 0.323±0.046 | 0.780±0.028 |
| GMEL | 0.323±0.029 | 0.218±0.031 | 0.333±0.031 | 0.779±0.018 |
| Sat2Flow | 0.320±0.008 | 0.196±0.015 | 0.300±0.027 | 0.774±0.008 |
| Gravityformer | 0.315±0.038 | 0.196±0.040 | 0.365±0.072 | 0.781±0.027 |
| GravityGNN | 0.319±0.037 | 0.209±0.040 | 0.351±0.056 | 0.778±0.024 |
| TransFlower | 0.303±0.002 | 0.204±0.004 | 0.373±0.007 | 0.783±0.004 |
| GAGNN | 0.305±0.002 | 0.188±0.003 | 0.361±0.002 | 0.785±0.003 |
| PIG-GNN | 0.297±0.002 | 0.187±0.009 | 0.394±0.014 | 0.791±0.004 |
在可部署模型里,PIG-GNN 的 RMSE 最低。相对无约束引力,(0.343 − 0.297) / 0.343 = 13.4%,分母是无约束引力的 RMSE。相对次低的 TransFlower 0.303,(0.303 − 0.297) / 0.303 = 2.0%。R² 从无约束引力的 0.284 到 0.394,相差 0.110,这是对数流量方差被多解释的比例,不是人次误差下降了 11 个百分点。CPC 从 0.754 到 0.791,相差 0.037。双重约束引力的 R² 为 0.435,CPC 为 0.792,分别比 PIG-GNN 高 0.041 和 0.001,代价是用了测试时点上未知的边际总量。MAE 上 PIG-GNN 与 MLP 都是 0.187,GAGNN 为 0.188。辐射模型和无约束引力在这张表上几乎重合,RMSE 0.342 对 0.343。
流动研究里,CPC 通常是每条边取预测与观测的较小值,求和后乘 2,再除以预测总量与观测总量之和,越接近 1 表示重叠越多。本文表注只说明越高越好,没有写出公式,所以上面不把这个代数式说成论文给出的定义。
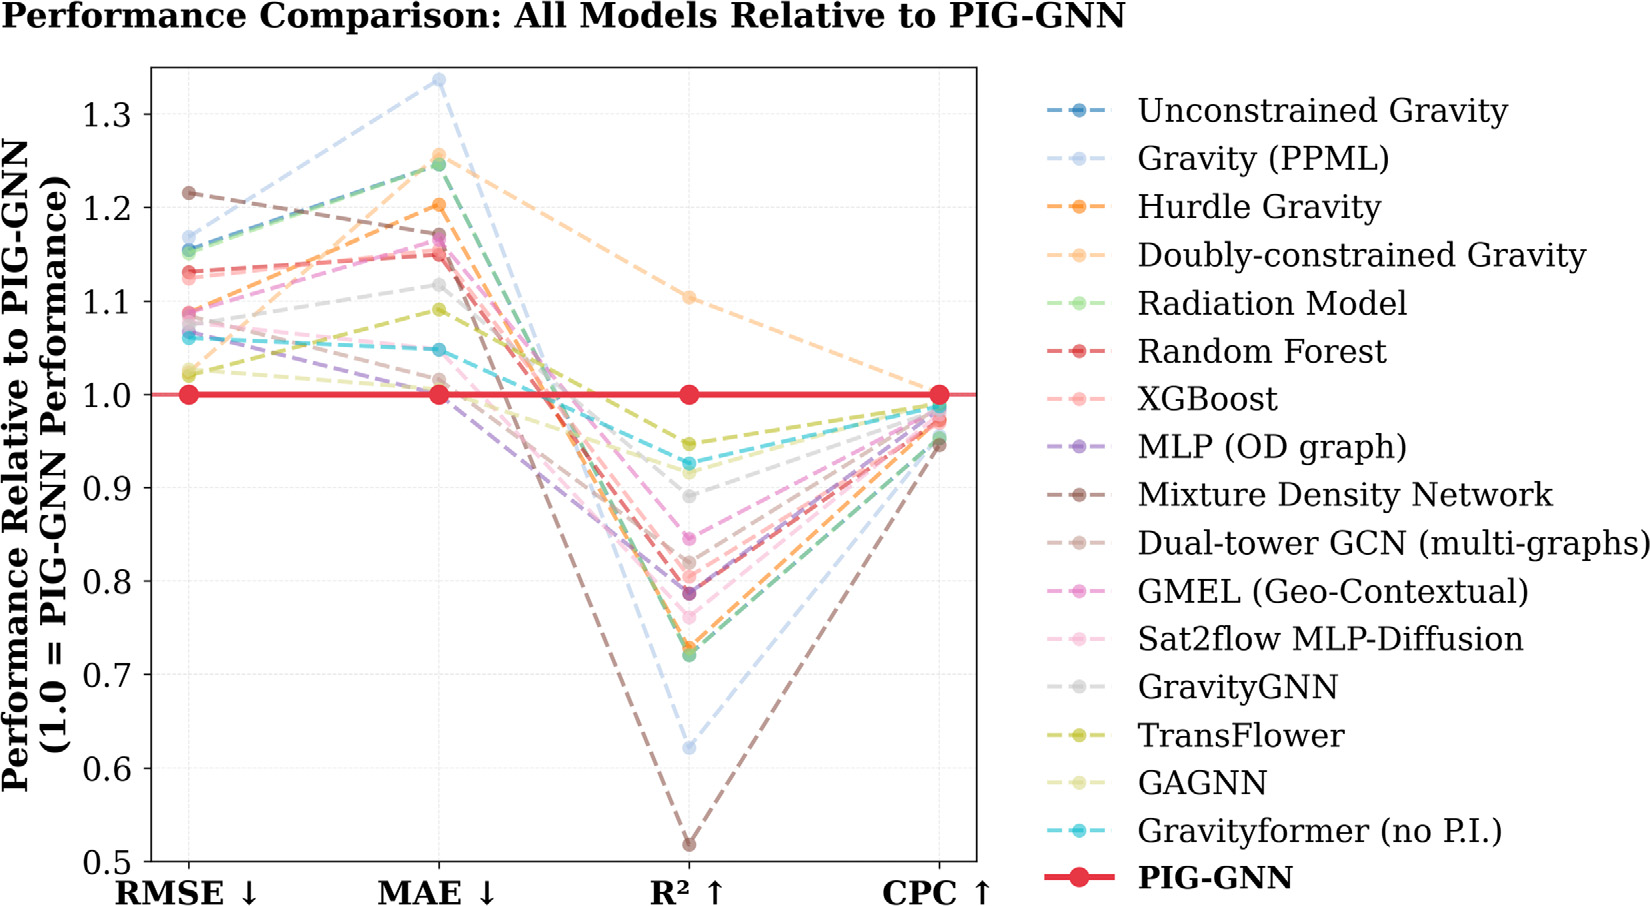
图 9|把所有模型除以 PIG-GNN 之后,四项指标还在同一侧吗?
无字母子图。横轴为 RMSE、MAE、R²、CPC,纵轴为该模型指标除以 PIG-GNN,红线等于 1。RMSE 和 MAE 高于 1 表示误差更大;R² 和 CPC 高于 1 才表示更好。四条轴不能共用“线越高越好”。来源:原论文 Fig. 9。
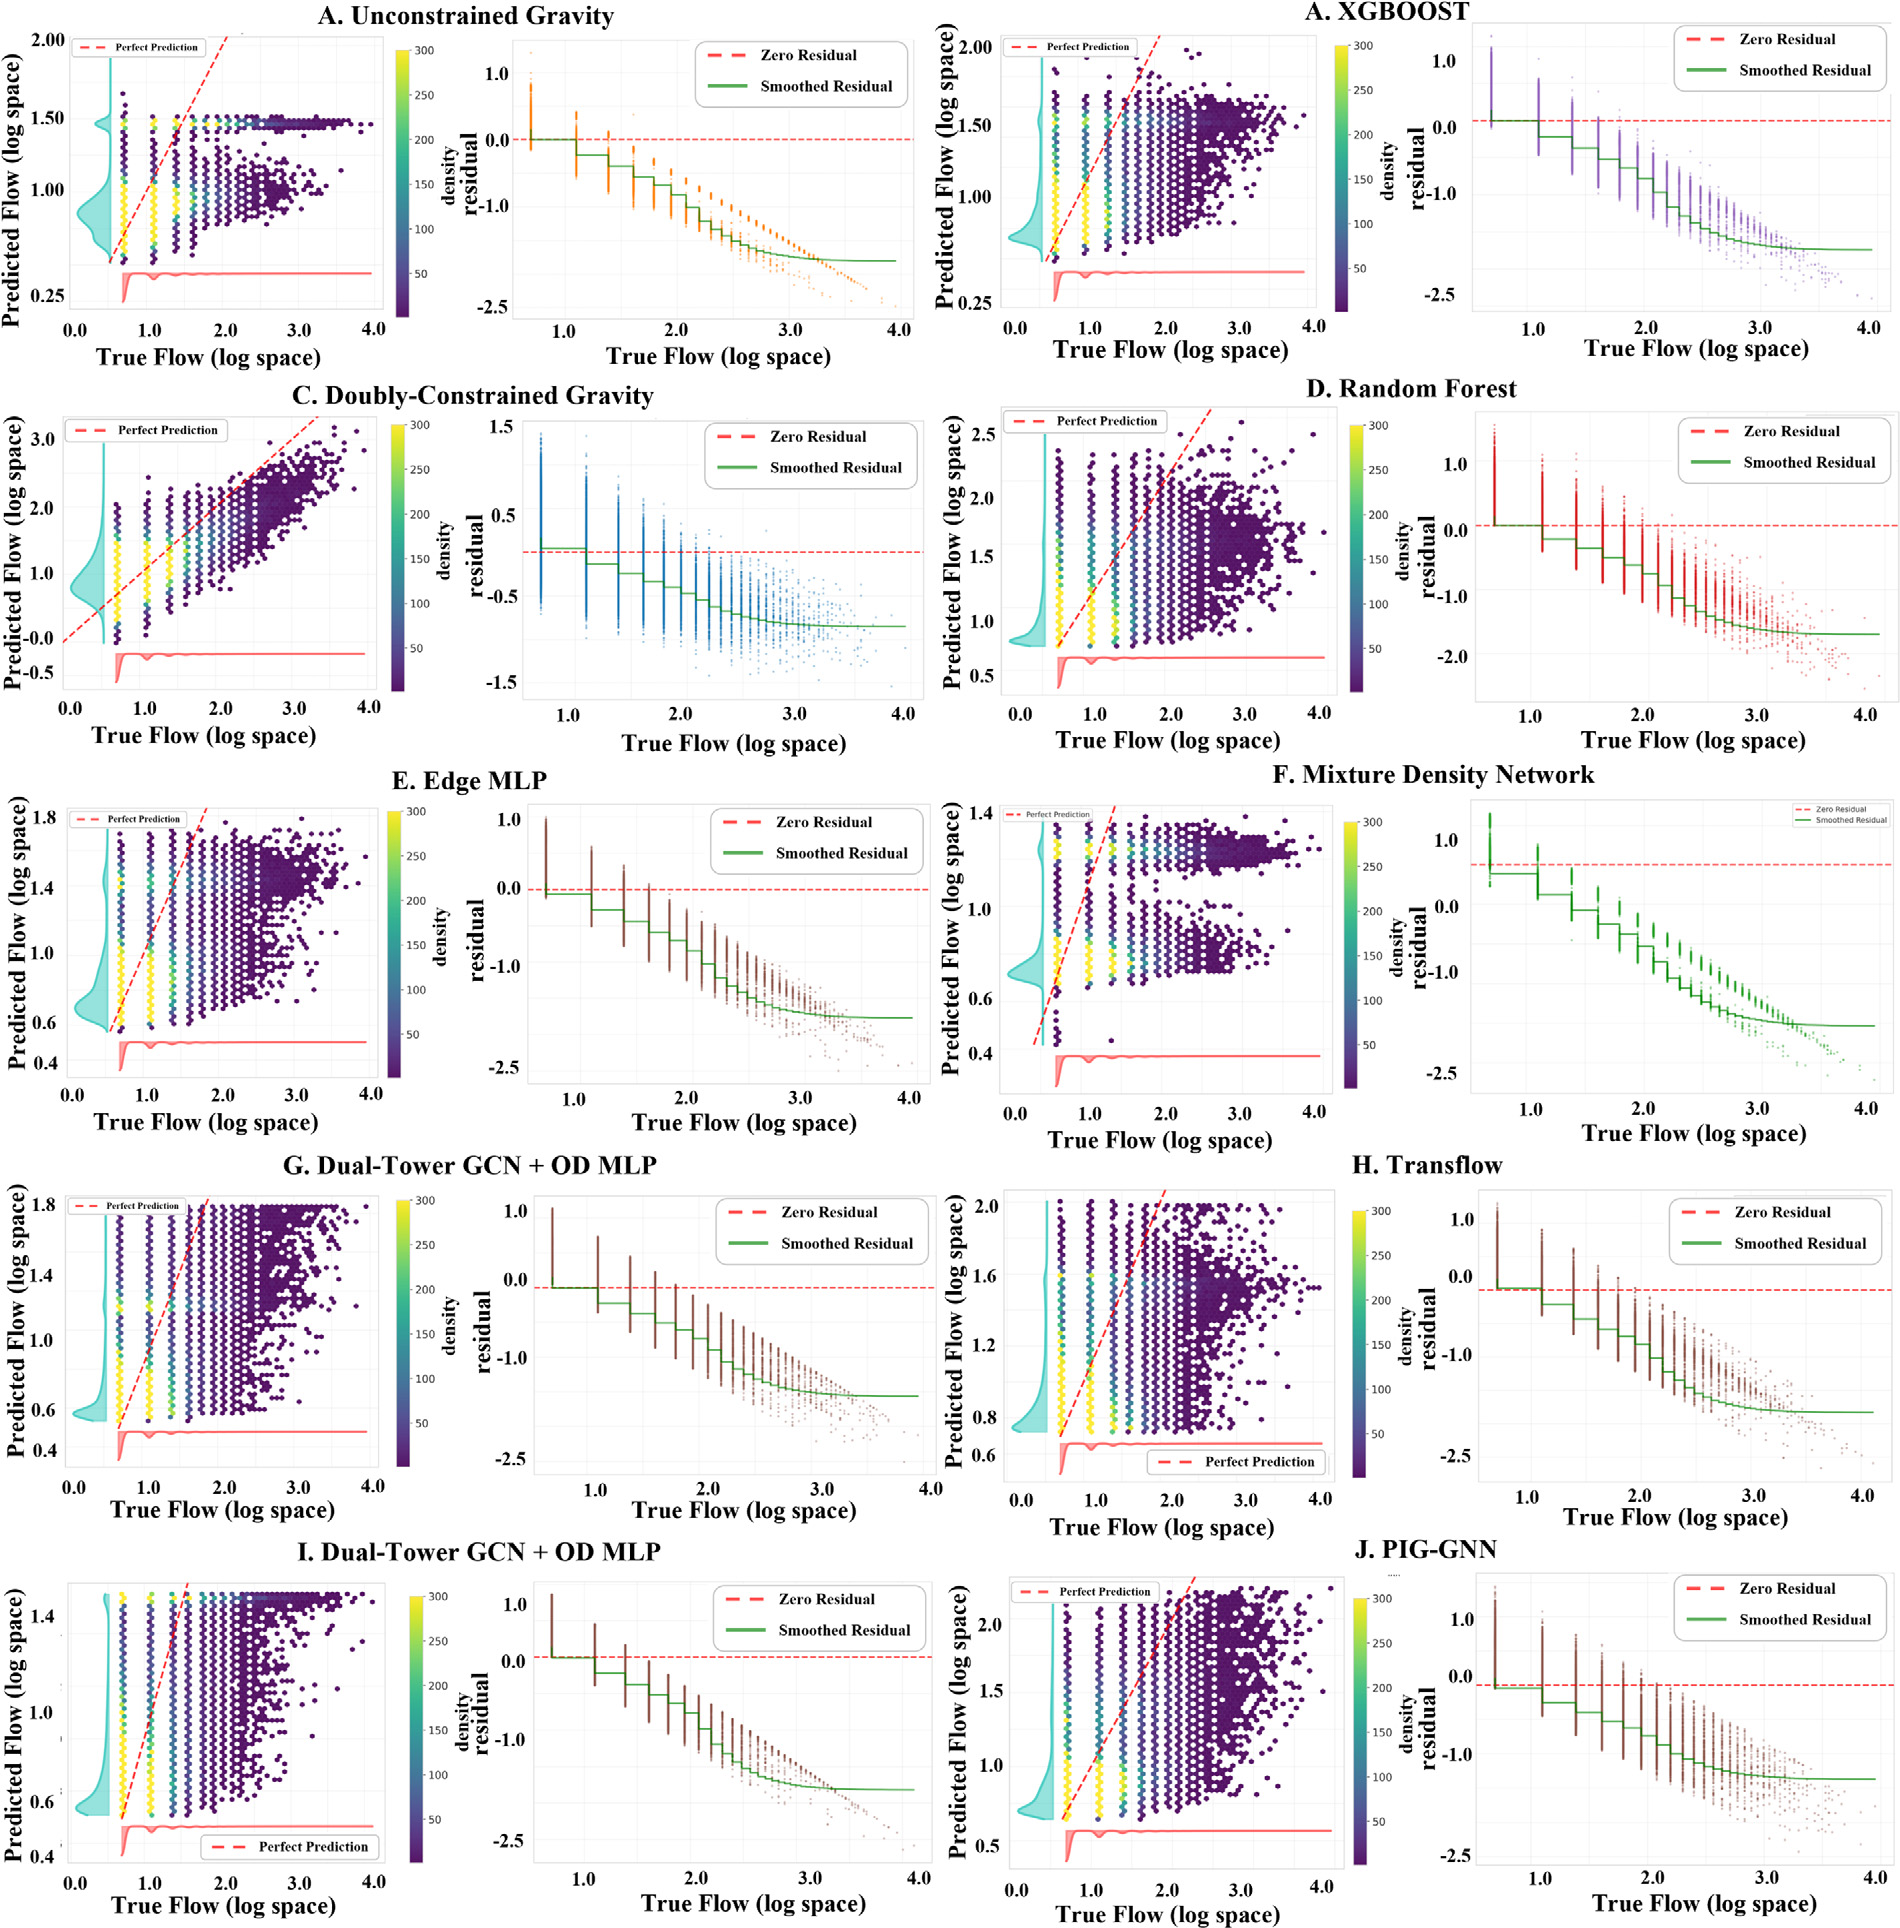
图 11|大流量是被低估,还是被抬高?
每组左侧是对数空间的预测对观测,颜色表示点密度,红色虚线为完美预测;右侧按真实对数流量看残差,红色为零残差,绿色为平滑残差。横轴大约到 4,与 log(1+流量)、最大流量 74 的量级相符:自然对数 log(75) 约为 4.32。印出的子图字母是 A 无约束引力、A XGBoost、C 双重约束引力、D 随机森林、E 边 MLP、F 混合密度网络、G 双塔 GCN + OD MLP、H Transflow、I 双塔 GCN + OD MLP、J PIG-GNN。字母跳过 B,第一行两幅都标成 A,G 和 I 的标题相同。无约束引力在大流量处压到对角线下方,右侧残差随流量变负。双重约束引力更贴对角线,因为它使用了观测边际。J 的云更集中在对角线附近,大流量处的负残差较轻。来源:原论文 Fig. 11。
距离再分组之后,优势并不在每一段都落在同一个指标上。附录按质心间欧氏距离的五分位切测试集,五折均值如下。0–15.4 公里三段里,PIG-GNN 的 RMSE、MAE、R²、CPC 都是同表最优。
| 距离组 | 引力 RMSE | 随机森林 RMSE | PIG-GNN RMSE | 引力 CPC | 随机森林 CPC | PIG-GNN CPC |
|---|---|---|---|---|---|---|
| 0–1.8 公里 | 0.5646±0.0021 | 0.5518±0.0026 | 0.4988±0.0028 | 0.6513±0.0016 | 0.6644±0.0017 | 0.6988±0.0029 |
| 1.8–6.2 公里 | 0.3405±0.0007 | 0.3352±0.0012 | 0.3098±0.0011 | 0.7449±0.0003 | 0.7525±0.0004 | 0.7764±0.0004 |
| 6.2–15.4 公里 | 0.2419±0.0007 | 0.2330±0.0008 | 0.2225±0.0015 | 0.8087±0.0004 | 0.8302±0.0005 | 0.8442±0.0008 |
| 15.4–50.9 公里 | 0.1672±0.0016 | 0.1545±0.0017 | 0.1560±0.0022 | 0.8759±0.0008 | 0.9048±0.0010 | 0.9067±0.0018 |
| 50.9–561.2 公里 | 0.1400±0.0015 | 0.1201±0.0009 | 0.1228±0.0011 | 0.9223±0.0010 | 0.9322±0.0005 | 0.9363±0.0009 |
两个较长距离组里,随机森林的 RMSE 和 R² 略好:15.4–50.9 公里 R² 为 0.1098±0.0071,PIG-GNN 为 0.0920±0.0123;50.9–561.2 公里随机森林 R² 为 0.0433±0.0007,PIG-GNN 为 −0.0003±0.0031。同一最长组里 PIG-GNN 的 MAE 为 0.0583±0.0012,低于随机森林的 0.0633±0.0005,CPC 仍最高。R² 约等于 0,表示这一组里对数流量的差异几乎没有被解释;CPC 仍可以到 0.936,因为两边流量都小、重叠比例高。最短一组即使是最优的 PIG-GNN,R² 也只有 0.2925±0.0062。短距离大流量并没有被校准到可以忽略残差的程度。
拆掉一块之后,哪一项指标在动?
表 4 是从 MLP 往上加模块,不是从完整模型上逐个拆除后的独立重训。同一行的四个数字必须一起看。
| 变体 | RMSE | MAE | R² | CPC |
|---|---|---|---|---|
| MLP | 0.317±0.005 | 0.187±0.006 | 0.310±0.018 | 0.778±0.003 |
| + 邻接 GCN | 0.307±0.013 | 0.179±0.012 | 0.353±0.055 | 0.787±0.014 |
| + 邻接 GATv2 | 0.306±0.010 | 0.169±0.003 | 0.359±0.034 | 0.790±0.005 |
| + 双塔 | 0.301±0.010 | 0.199±0.016 | 0.378±0.041 | 0.783±0.010 |
| + OD 消息传递 | 0.300±0.007 | 0.202±0.007 | 0.384±0.025 | 0.784±0.007 |
| + 物理损失(完整模型) | 0.297±0.002 | 0.187±0.009 | 0.394±0.014 | 0.791±0.004 |
加上双塔后,RMSE 从 0.306 降到 0.301,R² 从 0.359 升到 0.378,MAE 从 0.169 升到 0.199,CPC 从 0.790 降到 0.783。加上 OD 消息传递,RMSE 和 R² 再改善一点,MAE 升到 0.202。加上物理损失后,RMSE 降到 0.297,R² 升到 0.394,CPC 从 0.784 回到 0.791,MAE 回到 0.187,仍高于邻接 GATv2 那一行的 0.169。正文写去掉物理损失会使距离衰减变平、CPC 从 0.791 降到 0.784。这句话对应最后一步的 CPC。它不表示完整模型在 MAE 上优于前面每一行。
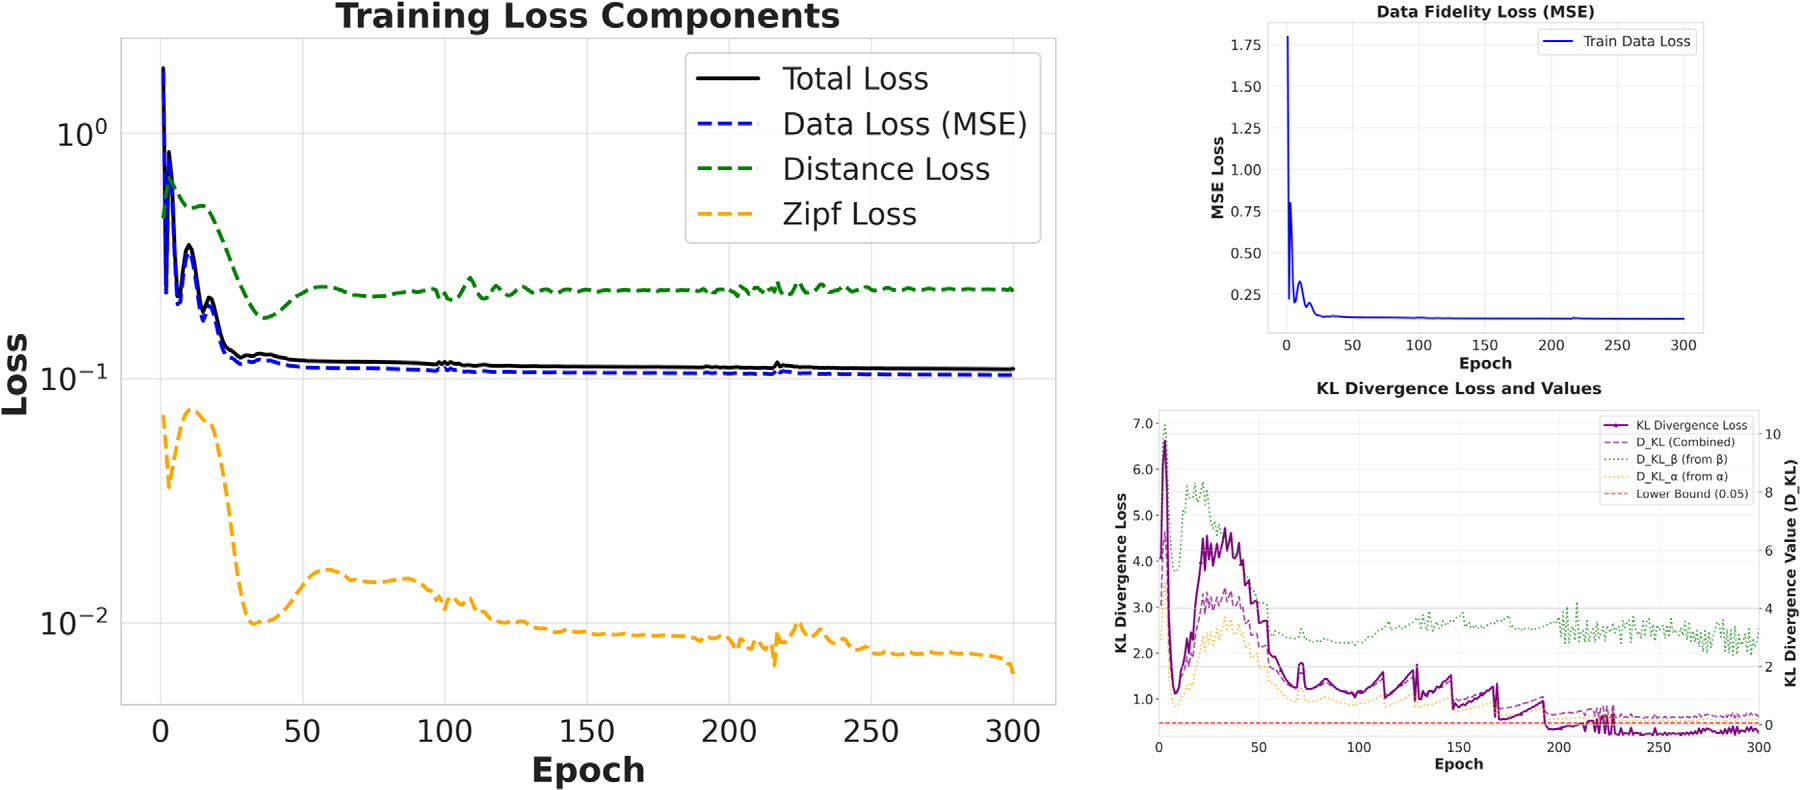
图 10|训练到后来,哪一项损失还停在高处?
无字母子图。左图约 300 个 epoch:总损失和数据损失降到 0.1 附近,齐夫损失降到大约 0.01,距离损失停在更高的一条线上。右上是训练数据的均方误差,几十个 epoch 内从 1.75 附近落到 0.1 附近。右下是 KL:组合项下降,红色虚线为下界 0.05;由 β 构成的那一项在右轴上保持更高。图注还写了自适应权重和 β、α 的轨迹。印出的这张图本身是损失曲线,没有单独的权重面板,也没有 β、α 数值曲线。来源:原论文 Fig. 10。
邻接定义几乎不改变这次重跑的误差。表 A.16 声明它只比较邻域定义,不替换表 3。共边、4 近邻、6 近邻、8 近邻和半径图的 RMSE 依次为 0.3025±0.0027、0.3027±0.0038、0.3029±0.0039、0.3026±0.0029、0.3033±0.0028,CPC 都在 0.790 到 0.791 附近。差出现在小数点后第三位。
把软区间收成中心 ±0.03 的窄带,并用一折、400 个 epoch、固定 λ 重跑,模型对中心位置是平滑敏感,不是一越界就崩溃。无物理损失的参照是 RMSE 0.2974、CPC 0.7936。β 中心放在 0.30 时 CPC 为 0.7973;α 中心放在 0.50 时 CPC 为 0.7996、MAE 为 0.1797。β 中心放到 3.00 时 RMSE 升到 0.3080,CPC 仍有 0.7848。α 中心放到 3.00 时 RMSE 为 0.3074,CPC 为 0.7866。这组数字和表 3 的五折 0.297±0.002 不是同一次训练。
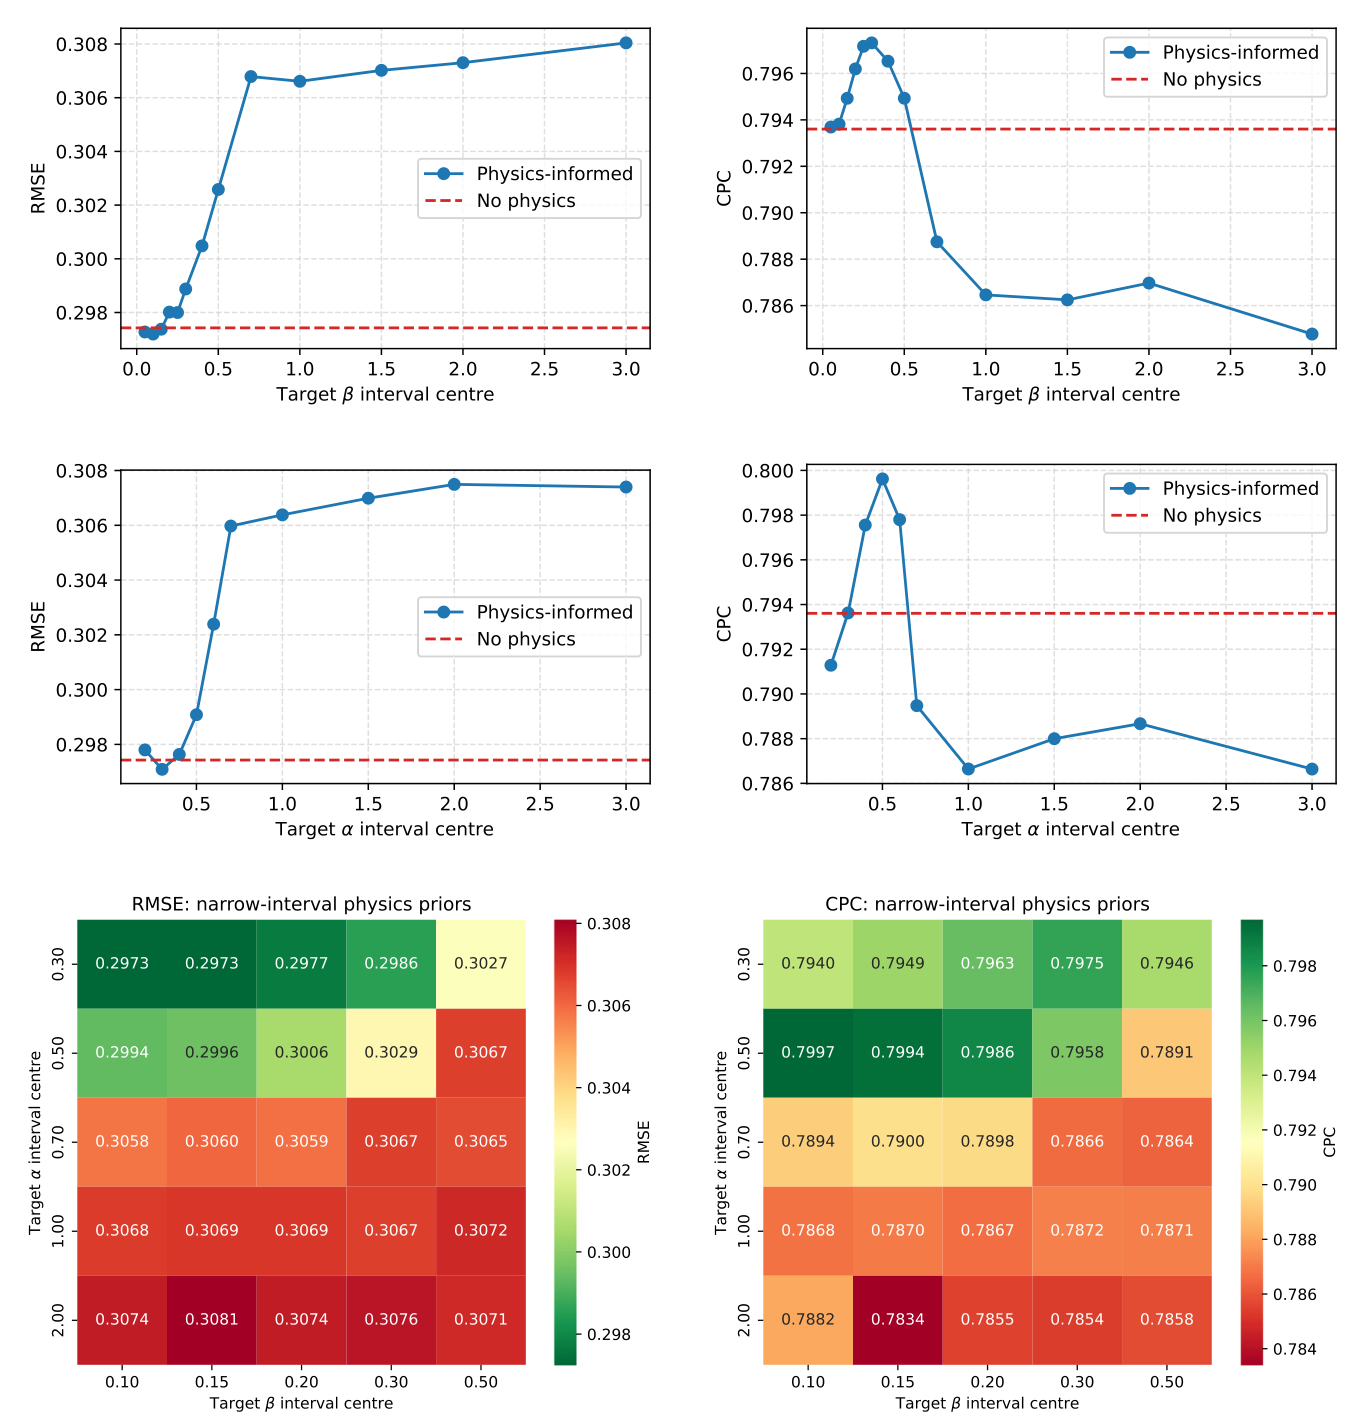
图 A.14|把先验区间的中心挪开,RMSE 和 CPC 怎样走?
无字母子图,三行。上行为 β 中心从近 0 扫到 3,左 RMSE、右 CPC,红色虚线是无物理损失。中行对 α 做同样的扫描。下行为 β、α 中心的联合热图,格内是 RMSE 或 CPC。RMSE 在低到中等的指数处较低,中心超过大约 0.5 之后升上 0.306 一带并走平。CPC 在 β 约 0.25–0.30、α 约 0.5 附近最高,中心到 1 以上后落到无物理损失的虚线下方。来源:原论文 Fig. A.14。
更细的产出和吸引变量会再降低误差,但那是 800 个 epoch 的另一次设定。同一架构下,只有工作年龄人口和兴趣点密度时 RMSE 为 0.2941±0.0004、CPC 为 0.7966±0.0008。五类产出加五类吸引(人口密度、全职比例、通勤方式、兴趣点、交通兴趣点、夜间灯光)时 RMSE 为 0.2812±0.0011、CPC 为 0.8080±0.0008。(0.2941 − 0.2812) / 0.2941 = 4.4%,分母是这次实验自己的粗代理 RMSE。它低于表 3 的 0.297,因为训练设定不同,不能直接宣布主实验的误差又降了 0.016。
人口乘 1.2,预测流量大约多两成;兴趣点几乎不动
反事实表把产出乘子和吸引乘子分别设成 0.8、1.2 或 1.5,看预测流量的平均变化。对数变化是变化量在对数上的均值,百分比是另一列,二者不是简单的指数换算。标准差是这些变化的离散程度,不是均值的标准误。
| 情景 | 产出乘子 | 吸引乘子 | 对数变化 | 百分比变化 | 变化的标准差 |
|---|---|---|---|---|---|
| 基线 | 1.0 | 1.0 | 0 | 0 | 0 |
| 产出 +20% | 1.2 | 1.0 | 0.1878 | +22.01% | 0.0253 |
| 产出 +50% | 1.5 | 1.0 | 0.4857 | +57.27% | 0.0370 |
| 产出 −20% | 0.8 | 1.0 | −0.1557 | −17.88% | 0.0396 |
| 吸引 +20% | 1.0 | 1.2 | 0.0032 | +0.53% | 0.0146 |
| 吸引 +50% | 1.0 | 1.5 | 0.0178 | +2.53% | 0.0374 |
| 吸引 −20% | 1.0 | 0.8 | 0.0012 | +0.04% | 0.0111 |
| 两边 +20% | 1.2 | 1.2 | 0.1836 | +21.56% | 0.0201 |
| 两边 −20% | 0.8 | 0.8 | −0.1678 | −19.54% | 0.0232 |
| 产出增、吸引减 | 1.2 | 0.8 | 0.1936 | +22.69% | 0.0282 |
| 产出减、吸引增 | 0.8 | 1.2 | −0.1376 | −15.50% | 0.0546 |
产出 +20% 对应 +22.01%,产出 +50% 对应 +57.27%,比线性的 20% 和 50% 更高。吸引 +50% 只有 +2.53%。吸引 −20% 的平均变化是 +0.04%,方向没有变成下降。两边同时 +20% 为 +21.56%,接近只加产出的 22.01%。产出增加同时吸引下降,变化为 +22.69%,略高于只加产出。论文据此说产出主导流量规模,吸引的直接效应弱,并提醒兴趣点密度本身是粗糙代理。
作者把这张表限制成局部单调性检查。0.8 到 1.5 的缩放可能进入训练没见过的输入区。它回答的是:两座塔是否顺着产出、吸引的方向响应。它不回答:某个区的工作年龄人口真的增加 20% 之后,通勤人数会增加 22%。
双峰在预测里很清楚,高的那一簇却抬过了对角线
图 12 在测试集的预测对数流量上看到两个峰。大峰在 1.32 附近,图例写成城际,n = 703,418。小峰在 6.05 附近,图例写成市内,n = 11,697。二者之和为 715,115,约为 298,681 条正流量边的 2.39 倍。因此这两个 n 是图中簇的计数,不能当成数据集的 OD 条数。论文没有解释多出来的倍数。
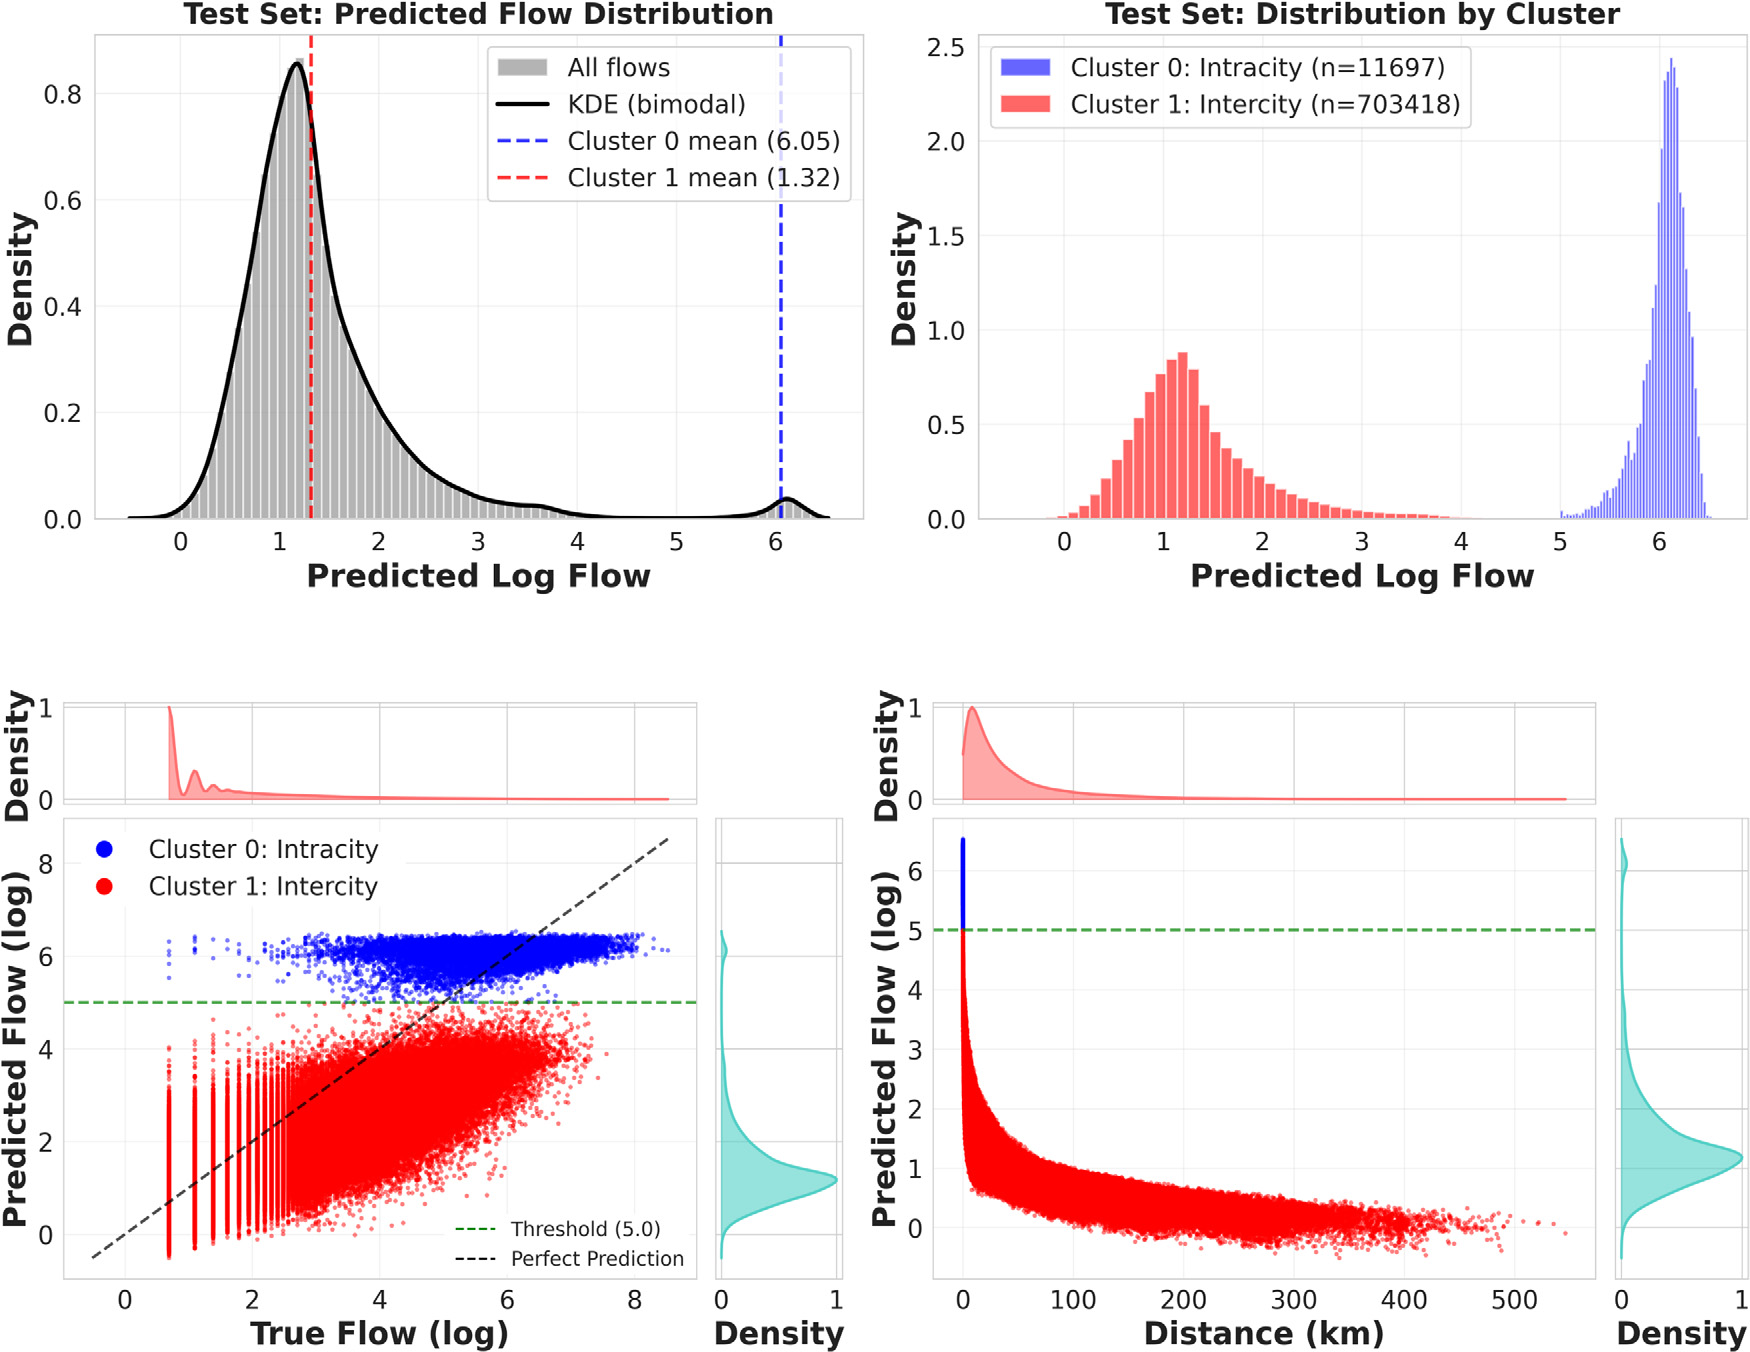
图 12|两个峰分别落在多远的距离上,预测有没有贴住观测?
无字母子图,四块。(左上)全部预测对数流量的直方图和双峰核密度;红色虚线为簇 1 均值 1.32,蓝色虚线为簇 0 均值 6.05。(右上)两簇分开画:蓝色市内 n = 11,697,红色城际 n = 703,418。(左下)预测对数流量对真实对数流量。蓝色市内点聚成一条大约在 6 的横带,绿色阈值线在 5.0;红色城际点沿对角线散开,也有一批落在对角线下方。黑色虚线为完美预测。(右下)预测对数流量对距离(公里)。红色点随距离下降,蓝色点挤在很短的距离上、并高于阈值 5.0。来源:原论文 Fig. 12。
若主实验的目标确实是 log(1+流量),表 A.10 的最大流量 74 对应自然对数约 4.32、常用对数约 1.88。图 12 却把高簇均值标成 6.05、阈值标成 5.0。高簇因此落在“由最大观测流量换算的对数”之上。这和左下图的横带一致:市内高簇是一批被抬高的预测,不只是一条贴住观测的短途云。低簇更靠近对角线,距离衰减也更陡。论文把低簇读成城际、重力式的长连接,把高簇读成市内、距离约束更弱的短连接。图的颜色和距离面板支持“短而高、长而低”的分开;高簇相对对角线的偏离同时说明,这种分开包含系统性高估。
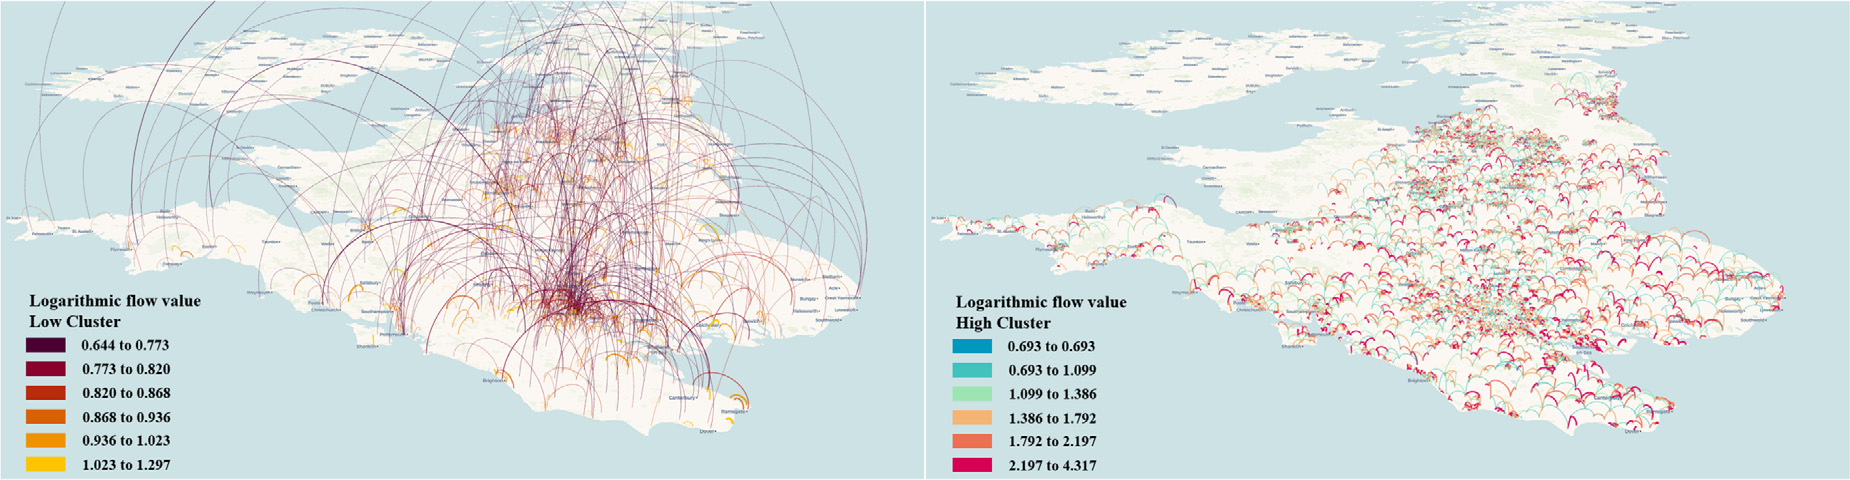
图 13|抽出来看,低流量是长线,高流量是短线吗?
无字母子图。左图抽取 1,000 条低流量记录,线更长,跨城分布。右图抽取 5,000 条高流量记录,线短而密,聚在城市内部。1,000 和 5,000 是可视化抽样,不是两簇的全部 n。来源:原论文 Fig. 13。
论文还比较了谁保住这道双峰。引力和辐射模型容易把大流量压向低峰,也就是峰塌缩。随机森林和 XGBoost 的总体 R² 大约 0.31,散点却被抹成单峰,见图 11。图模型更容易留下两个团。PIG-GNN 的额外说法是:软约束和双塔让这道分裂更可解释。图 12 本身显示高簇被抬高,所以“可解释的双峰”仍然是预测分布上的结构,不是每条市内通勤都被准确定量。
换一套出行目的、换两座城市,排序还在吗?
ALLOD 与 H2W 使用同一批 6,856 个 MSOA 和同一套输入,但包含全部出行目的。边数 2,383,725,是 298,681 的 7.98 倍。流量均值 17.14 对 1.73,约为 9.89 倍;标准差 82.79 对 2.00,约为 41.33 倍;最大值 6,905 对 74,为 93.31 倍。表 A.10 的距离均值为 37,419.11 对 42,259.64,表头没有写单位;表 2 则以公里给出 H2W 的中位数 14.15 和均值 41.54。两处距离数字的口径不同。
同一五折协议下,PIG-GNN 的 RMSE 为 0.6006±0.0079,MAE 为 0.4388±0.0048,R² 为 0.7431±0.0069,CPC 为 0.6076±0.0070。次优的可部署 RMSE 来自 XGBoost:0.6412±0.0002。论文计算的相对变化是 RMSE 降低 6.3%、MAE 降低 5.5%、R² 相对提高 5.1%,分母分别是 XGBoost 的 0.6412、0.4645 和 0.7073。CPC 的第一名是随机森林 0.6748±0.0010,其后 XGBoost 0.6717±0.0010。PIG-GNN 的 0.6076 低了大约 0.067。双重约束引力因为约 240 万条边上的迭代配平太慢,没有进入这张表。点误差领先和重叠领先在 ALLOD 上分开了。
零流量只在附录里以抽样方式进入。每个折的训练和测试追加 10% 随机零流量区对。只看这些零边时,真实值全是 0,R² 和 CPC 没有信息。PIG-GNN 的 RMSE 为 0.3519±0.0154,引力模型为 0.7657±0.0007。非零边上 PIG-GNN 的 RMSE 为 0.3131±0.0016,引力为 0.3384±0.0014。模型可以在抽到的零边上给出更小的预测,同时没有把主任务换成完整的零膨胀模型。
跨城试验改用 500 米网格,产出和吸引换成居住人口、工作地人口和兴趣点,所以绝对误差不能与英格兰的 0.297 比较。西安被描述为内陆、单中心、带城墙核心;论文没有给出西安的网格数和边数。五折结果里 PIG-GNN 的 RMSE 为 0.4744±0.0033,R² 为 0.4019±0.0084,CPC 为 0.4597±0.0095。同表 RMSE 次低的是随机森林 0.4970±0.0019,(0.4970 − 0.4744) / 0.4970 = 4.5%。拟合的 β = 0.425(R² = 0.822),α = 0.582(R² = 0.900),都落在 [0.2, 3] 和 [0.5, 3] 里。
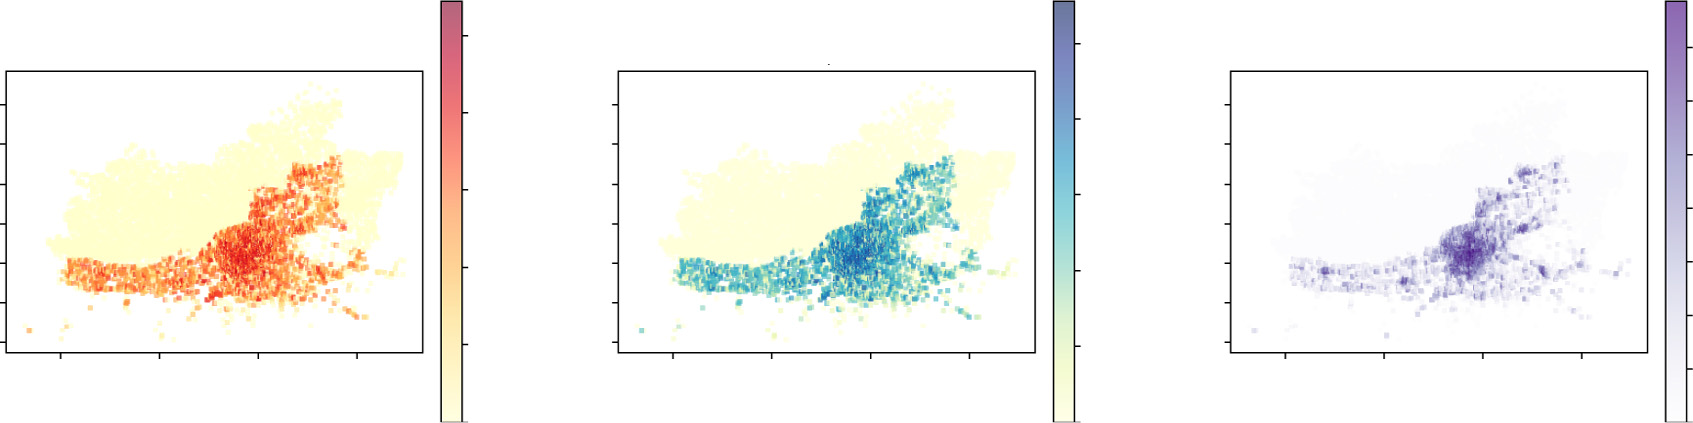
图 A.15|西安 500 米网格上的三项输入分别铺在哪里?
无字母子图,从左到右:对数居住人口、对数工作地人口、对数兴趣点数量。颜色越深越高。三张图都是输入地图,不是预测误差。来源:原论文 Fig. A.15。
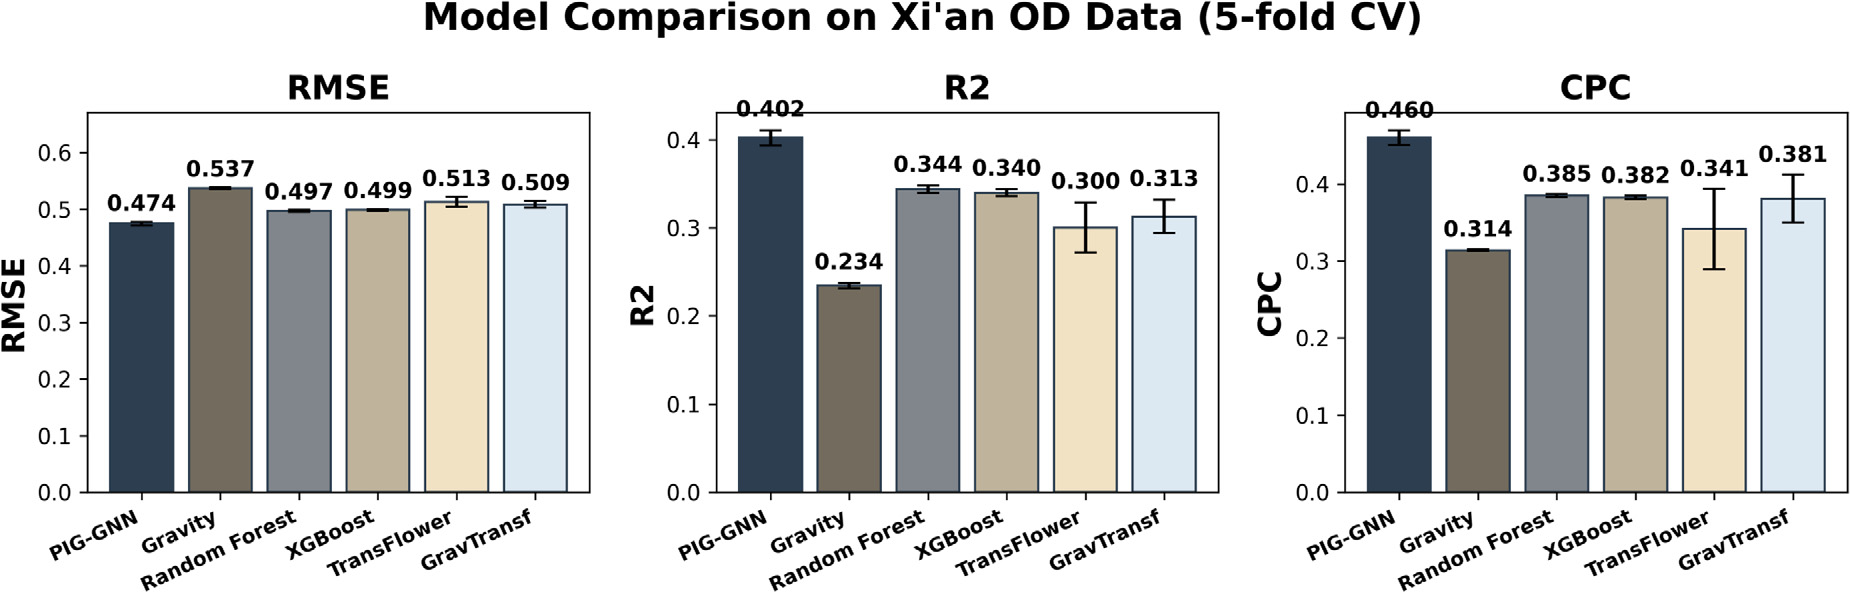
图 A.16|西安上六个模型的 RMSE、R² 和 CPC 谁高谁低?
无字母子图,三幅柱状图,误差线为五折标准差。从左到右依次是 PIG-GNN、引力、随机森林、XGBoost、TransFlower、GravTransf。PIG-GNN 的 RMSE 最低,R² 和 CPC 最高。柱上数字与表 A.17 一致到显示精度,例如 PIG-GNN 的 RMSE 约为 0.474、CPC 约为 0.460。来源:原论文 Fig. A.16。
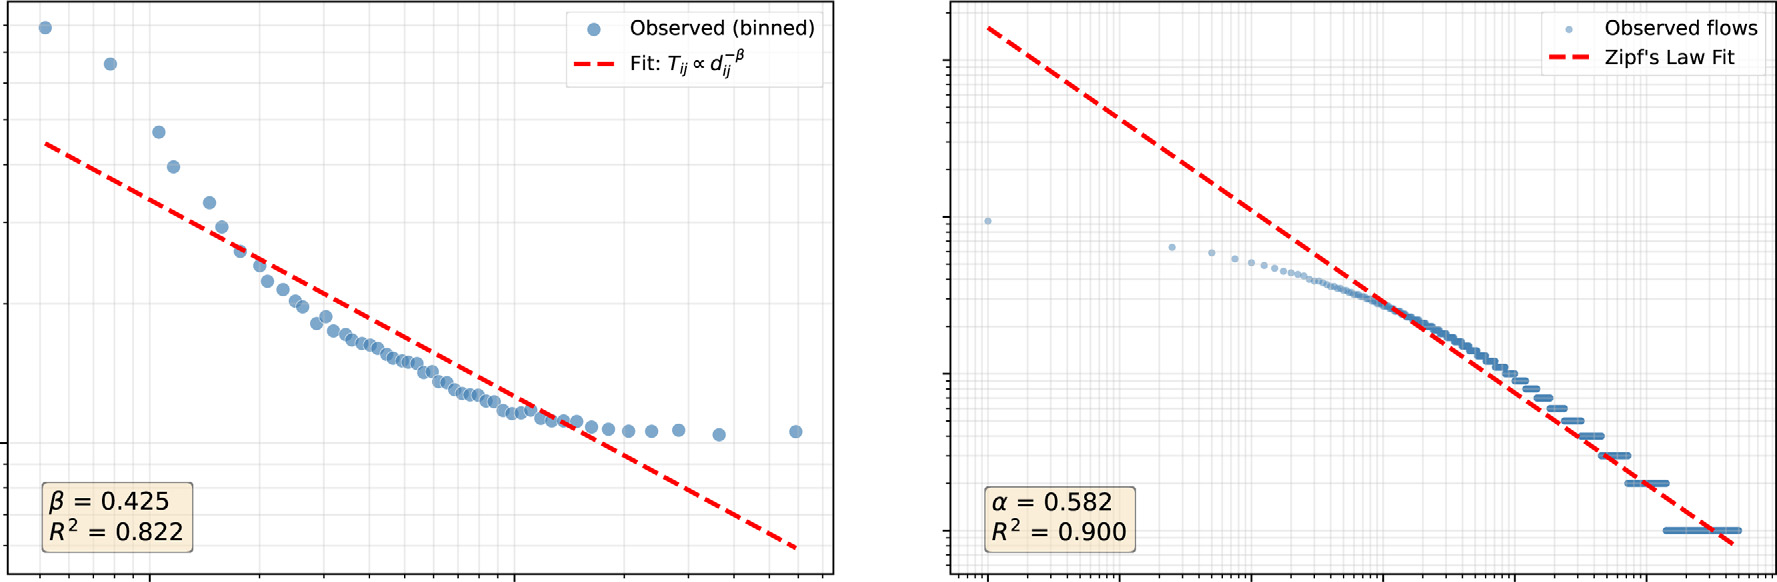
图 A.17|西安的距离衰减和位序还落在先验区间里吗?
无字母子图。左为分箱平均流量对距离,拟合 β = 0.425,R² = 0.822。右为流量对位次,α = 0.582,R² = 0.900。两条拟合都在论文使用的区间内。来源:原论文 Fig. A.17。
广州被描述为沿海、多中心、处在珠江三角洲。网格 9,768 个,OD 边约 123K。PIG-GNN 的 RMSE 为 0.9089±0.0040,R² 为 0.4004±0.0067,CPC 为 0.6511±0.0045。RMSE 次低的是 GravTransf 0.9316±0.0025,(0.9316 − 0.9089) / 0.9316 = 2.4%。CPC 只比 GravTransf 的 0.6496±0.0016 高 0.0015,而 PIG-GNN 自己的五折标准差是 0.0045。R² 从 0.3700±0.0053 到 0.4004,差距比 CPC 清楚。广州的 β = 0.327(R² = 0.828),α = 1.066(R² = 0.824)。
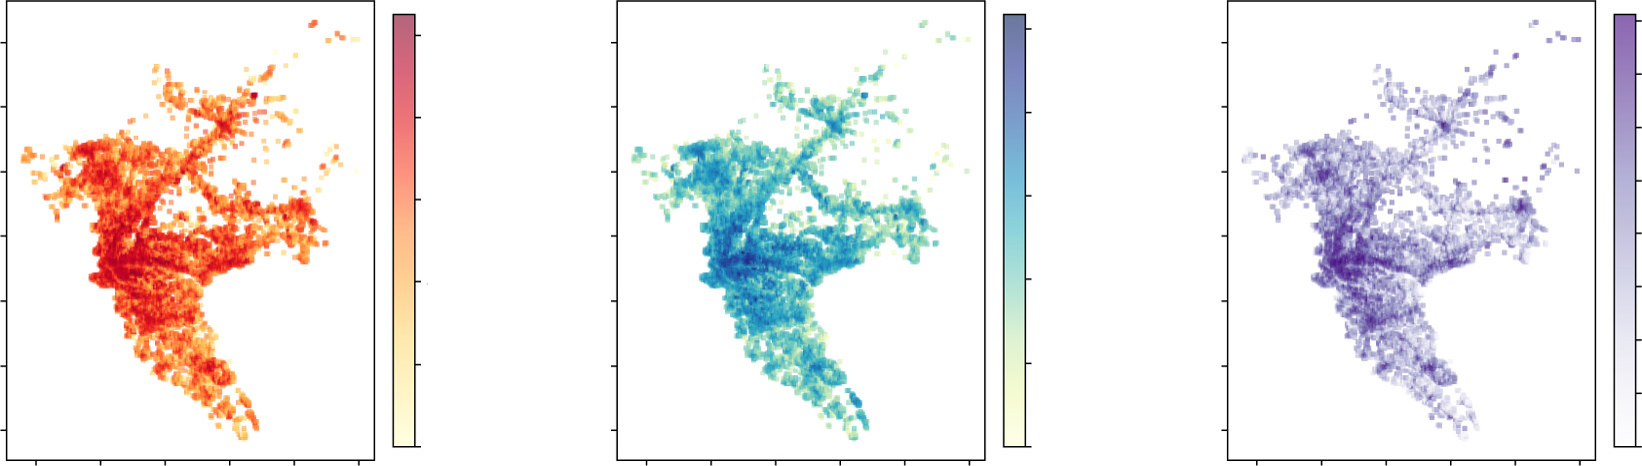
图 A.18|广州 500 米网格的居住、工作和兴趣点怎样分布?
无字母子图,从左到右仍是对数居住人口、对数工作地人口、对数兴趣点。形态比西安更铺开。来源:原论文 Fig. A.18。
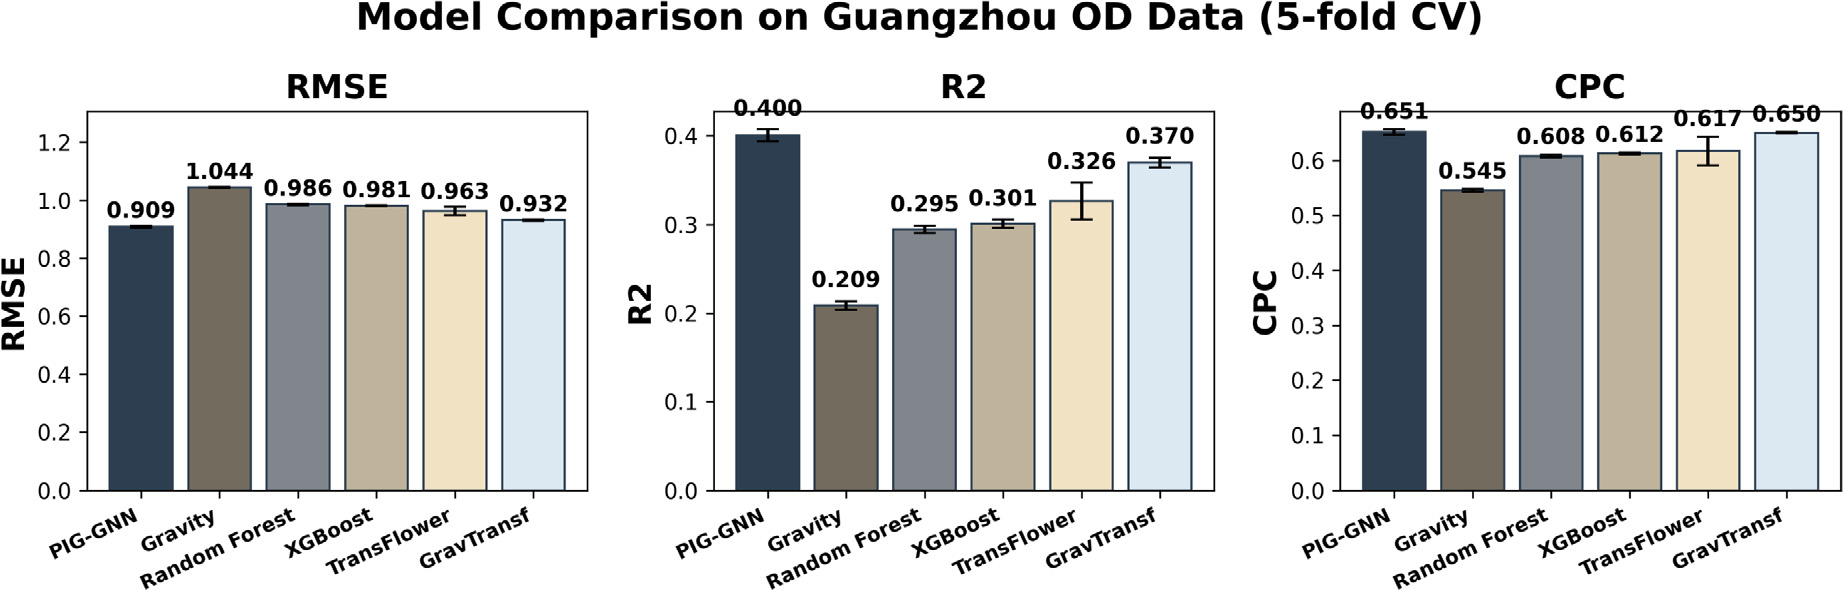
图 A.19|广州上谁的柱更矮、谁的柱更高?
无字母子图,模型顺序与图 A.16 相同。PIG-GNN 的 RMSE 约为 0.909,低于引力的 1.044;CPC 约为 0.651,与 GravTransf 的 0.650 几乎贴在一起。来源:原论文 Fig. A.19。
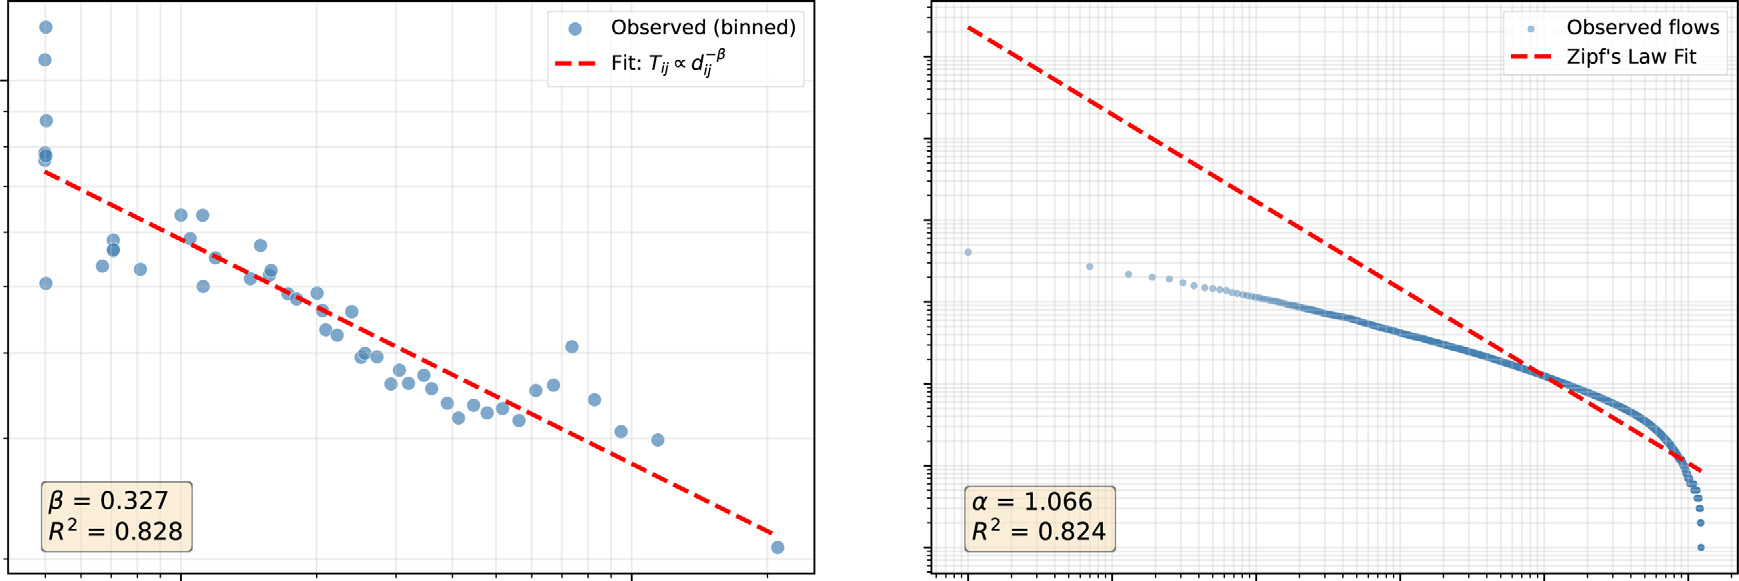
图 A.20|广州的两条标度律斜率是多少?
无字母子图。左为 β = 0.327,R² = 0.828。右为 α = 1.066,R² = 0.824。α 高于西安的 0.582,仍低于先验上界 3。来源:原论文 Fig. A.20。
这些比较停在哪里
主基准仍是英格兰。ALLOD 是同一国家、同一套区划上的全目的检验;西安和广州换了网格、代理和城市形态,只适合比各自内部的模型排序,以及指数有没有留在先验区间里。
产出和吸引在主实验里是粗代理。更细变量能把另一次训练的 RMSE 从 0.2941 降到 0.2812,说明输入本身还有空间,也说明主结果绑在工作年龄人口和兴趣点密度上。
距离在方法正文和图 5 里是测地距离,在局限和距离分箱里被写成欧氏距离。模型没有使用路网、出行时间或多方式可达性。静态属性也看不到走廊在高峰是否拥堵。
主任务只监督正流量边。10% 零流量抽样说明模型可以输出更接近 0 的预测,完整的“先决定有没有边、再决定流量多大”还没有做。
软惩罚在区间内为零。单条边可以偏离幂律。图 12 的高簇均值 6.05 已经说明,宏观区间约束没有阻止一批预测被抬高。
反事实和规划含义都是诊断。论文写明模型是预测模型。住宅扩张、就业集中或走廊投资会同时改变人口、岗位和出行时间,这些联合变化没有被识别。
计算附录把各模型归一到 250 个 epoch 做相对比较:PIG-GNN 约 678K 参数、每 epoch 0.139 秒;引力 Transformer 约 836K 参数、每 epoch 2.237 秒。这是他们机器上的归一估计。环境写的是 Linux、两路 AMD EPYC 7542、八块 RTX 4090。归一时间不能当成部署一句通勤查询的延迟。
一句话总结
把起点的产出和终点的吸引拆开,并用很宽的区间软约束记住距离衰减和位序之后,英格兰家到工作地通勤的对数流量误差低于一组可部署基线,预测里的双峰还在;重叠是否最好、短途大流量是否被校准,取决于比的是哪一个指标、哪一段距离。
核心来源
- Sustainable Cities and Society 论文页,卷 148,文章编号 107575。正文与附录 A.1–A.13 在同一篇正式版 PDF 中,共 27 页。
- 数据声明为可应要求提供。论文没有给出代码仓库,也没有写明家到工作地数据的年份和原始发布机构。
- 正文图 1–13,附录图 A.14–A.20,表 1–5 与附录表 A.6–A.18。主结果来自表 3、表 4、表 5;距离分组来自表 A.14;全目的出行来自表 A.10 与表 A.11;跨城来自表 A.17 与表 A.18。
作者介绍
四位作者的论文署名单位都是香港科技大学(广州)城市治理与设计学域。以下只据论文的贡献说明和通讯信息,不补充论文未列出的职务。
- Minwei Zhao:撰写与修改、可视化、验证、方法、调查、形式分析、数据整理和构想。
- Dailuo Zhang:撰写与修改、可视化、验证、形式分析和数据整理。
- Zhecheng Shi:修改和可视化。
- Cai Wu:通讯作者,邮箱 caiwu@hkust-gz.edu.cn。贡献包括修改、可视化、指导、方法、基金和构想。致谢写到香港科技大学(广州)城市形态工作室成员参与了讨论。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若把表 5 的 +22.01% 写成“住宅区人口增加两成,通勤就增加两成”,中间缺了三样论文没有操纵的东西:就业是否同步增加、路网时间是否变化、谁搬进来。可以做的检验是找一批人口已经变化、岗位和出行时间也有前后观测的统计区,看模型只改工作年龄人口时的 +22% 与后来观测到的流量变化差多少。吸引通道在兴趣点乘 1.5 时只有 +2.53%,如果真实就业中心扩容带来的流量远大于这个数,缺的就是岗位代理,附录里换上夜间灯光和通勤方式后 RMSE 从 0.2941 降到 0.2812,已经提示输入还能动。
图 12 的阈值 5.0 把少数高预测和多数低预测切开,高的那一簇均值 6.05,又高于由最大流量 74 换算的对数。拿这道切分去决定“市内修换乘、城际修走廊”,会把模型抬高的那些边当成市内需求。更稳的用法是先只保留观测流量也高于某个分位、并且距离短于表 2 中位数 14.15 公里的边,再看模型是否把它们分进高簇。若高簇里混进大量观测流量很小的短边,双峰就是预测尺度上的分离,不能直接变成两类工程清单。ALLOD 上 RMSE 最优而 CPC 低于随机森林 0.067,也说明全目的出行里“典型对数误差更小”和“流量重叠更多”会选出不同的模型。规划若关心走廊上的总人次有没有对上,应先看 CPC 和分距离的 R²,而不是只看一个全样本 RMSE。