两座城市明年还有没有人来往,看的是城市条件,还是去年已经形成的网络?
论文名片|Bin Zhang、Hui Li、Jian Yin,Uncovering the endogenous dynamics of intercity population mobility: Evidence from urban networks in China,Sustainable Cities and Society,2026,149:107727,2026年7月22日在线发表。DOI:10.1016/j.scs.2026.107727。2026年3月2日收稿,6月16日修回,7月21日接收。这是一项城市网络观察研究,用时序指数随机图模型考察联系如何形成。
设想杭州和上海之间今年有来有往,南京又和这两座城市都有联系。到了明年,这几条线多半还在。一种常见解释是,人每年重新比较工资、医院和空气,城市条件决定下一程。另一种可能是,双向来往、共同伙伴,以及去年已经存在的联系,会让网络沿着已有结构继续长。这篇论文把两种解释放进同一个模型。材料是 2019–2023 年高德实际迁徙指数在 296 个中国城市之间的相对强度,分母是城市对,不是个人。
方向先说清楚:互惠、传递性和上一年联系是否延续,在放入城市属性和地理距离之后仍然显著。经济更强的城市更可能处在联系的接收端。创新在全时段模型里的接收效应是负的,而且换一年、换一个社区,属性系数的符号会变。模型比较的是一条有向联系会不会出现,论文没有把它写成流动人数的因果效应。
先说结论
- 296 个城市、2019–2023 年的高德实际迁徙指数里,高强度联系从区域中心向外展开。京津冀、长三角、珠三角和成渝是活跃区。2022 年指数和被画出的线路下降,2023 年指数达到这段时期的高位。指数不代表流动人数。
- 广州、深圳、杭州、上海和成都的加权入度、加权出度在整个时段都高;呼和浩特、西宁、海口、拉萨和乌鲁木齐偏低。2023 年加权度前五城占各城市加权度合计的 14.88%,入度前五占 14.24%,出度前五占 14.53%。杭州、成都、北京的入度与出度之差超过 1000 个指数单位,方向是净流入。
- 网络社区 2019 年有 10 个,2020–2023 年保持 9 个。长三角所在的社区 C 从 38 个城市增至 41 个。讨论写道,京津冀和山东半岛由两个社区并成一个。
- 全时段模型 4 中,互惠系数 3.4715,传递性 1.9698,稳定性 2.5934,均在 0.1% 水平显著。延迟互惠在加入稳定性之后变为 −1.0563,同样在 0.1% 水平显著。经济的接收效应为正、发送效应为负。创新的接收效应为 −1.3719。
- 六个主要社区里,距离系数都为负,稳定性都为正。公共服务、创新和经济的方向随社区改变。只估计 2023 年这一张静态网络时,经济的发送效应和创新的接收效应与全时段模型改号。
这张指数量的是相对强弱
论文把人口流动(population mobility)定义为个人跨越地理空间、周期性反复发生的移动。文献综述里的迁移(migration)指以定居为目的的搬迁,日常移动则包括通勤和商务出行。两种行为的动机不同,作者认为都可以用推拉理论来理解:人比较不同地方的效用,并流向更能满足需要的地方。真正进入计算的,却是一个不区分目的的指数。
数据来自高德平台的实际迁徙指数。平台利用手机用户位置,记录出发城市、到达城市、流动强度和时间。论文写明,数据经过匿名化,不代表实际流动人数,只反映城市之间的相对差异。作者收集 2019–2023 年的日度城际记录,去掉缺失和异常后按年汇总。年均气温来自中国气象数据网,社会经济指标来自《中国城市统计年鉴》。汇总方式是加总还是取平均,正文没有写明,所以后文的指数单位不能再换成人数。
网络是有向加权图。296 个城市是节点,从城市 i 到城市 j 的边权 Eij 是这一方向的流动强度。一座城市的加权入度,是其他城市流向它的指数之和;加权出度,是它流向其他城市的指数之和;加权度是两者相加。后文“超过 1000”的差,分母是这一套指数,不是净迁入人口。
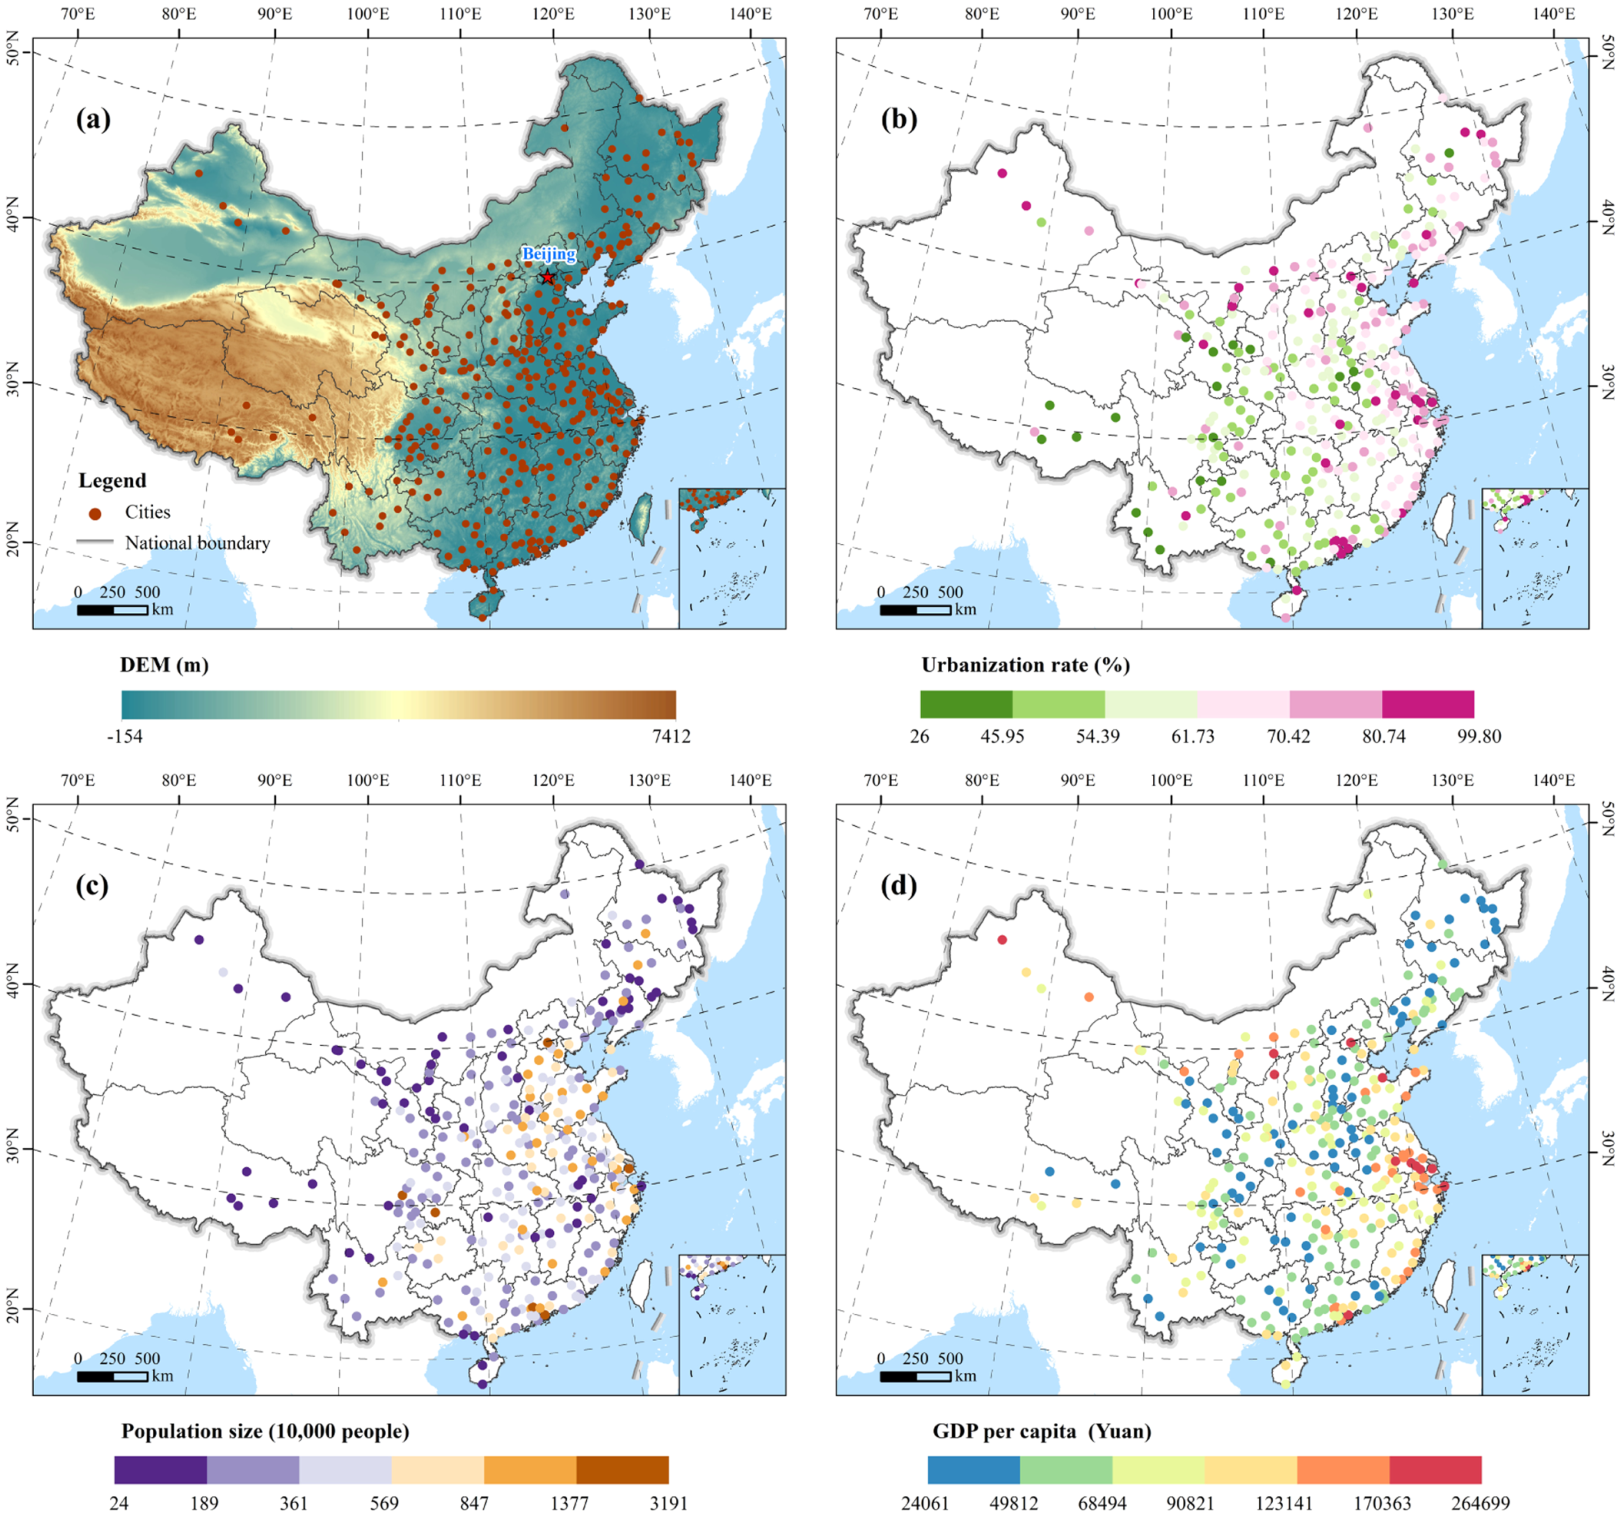
图 1|样本里的 296 座城市,在 2023 年的条件有多不齐?
(a)橙点是研究城市,底图为海拔,图例范围从 −154 米到 7412 米,并标出北京。(b)城镇化率,色标从 26% 到 99.80%,东部点更偏粉红。(c)人口规模,单位是万人,色标从 24 到 3191。(d)人均 GDP,单位是元,色标从 24061 到 264699。东部城市在城镇化、人口和人均 GDP 上整体更高,中西部城镇化程度较低。这是城市条件的底图,还不是流动网络。地图依据标准地图 GS(2024)0650。来源:原论文 Fig. 1。
作者用这张差异说明:东部更容易吸引和留住人口,人口若继续堆在核心城市,外围缺少人手,核心则面临资源和环境压力。图 1 支持的是 2023 年城市属性的空间不均。它不能单独证明流动已经造成了这种不均,因为人口规模和人均 GDP 本身也是长期累积的结果。
高强度联系先在城市群里变密
为了看见空间格局,作者用自然断点法给指数分级,只画出指数大于 100.905 的线路。图例的三档是 100.905–531.911、531.912–867.916 和 867.917–19275.042。低于 100.905 的联系不出现在图上,所以地图上的空白不等于两城之间完全没有记录。
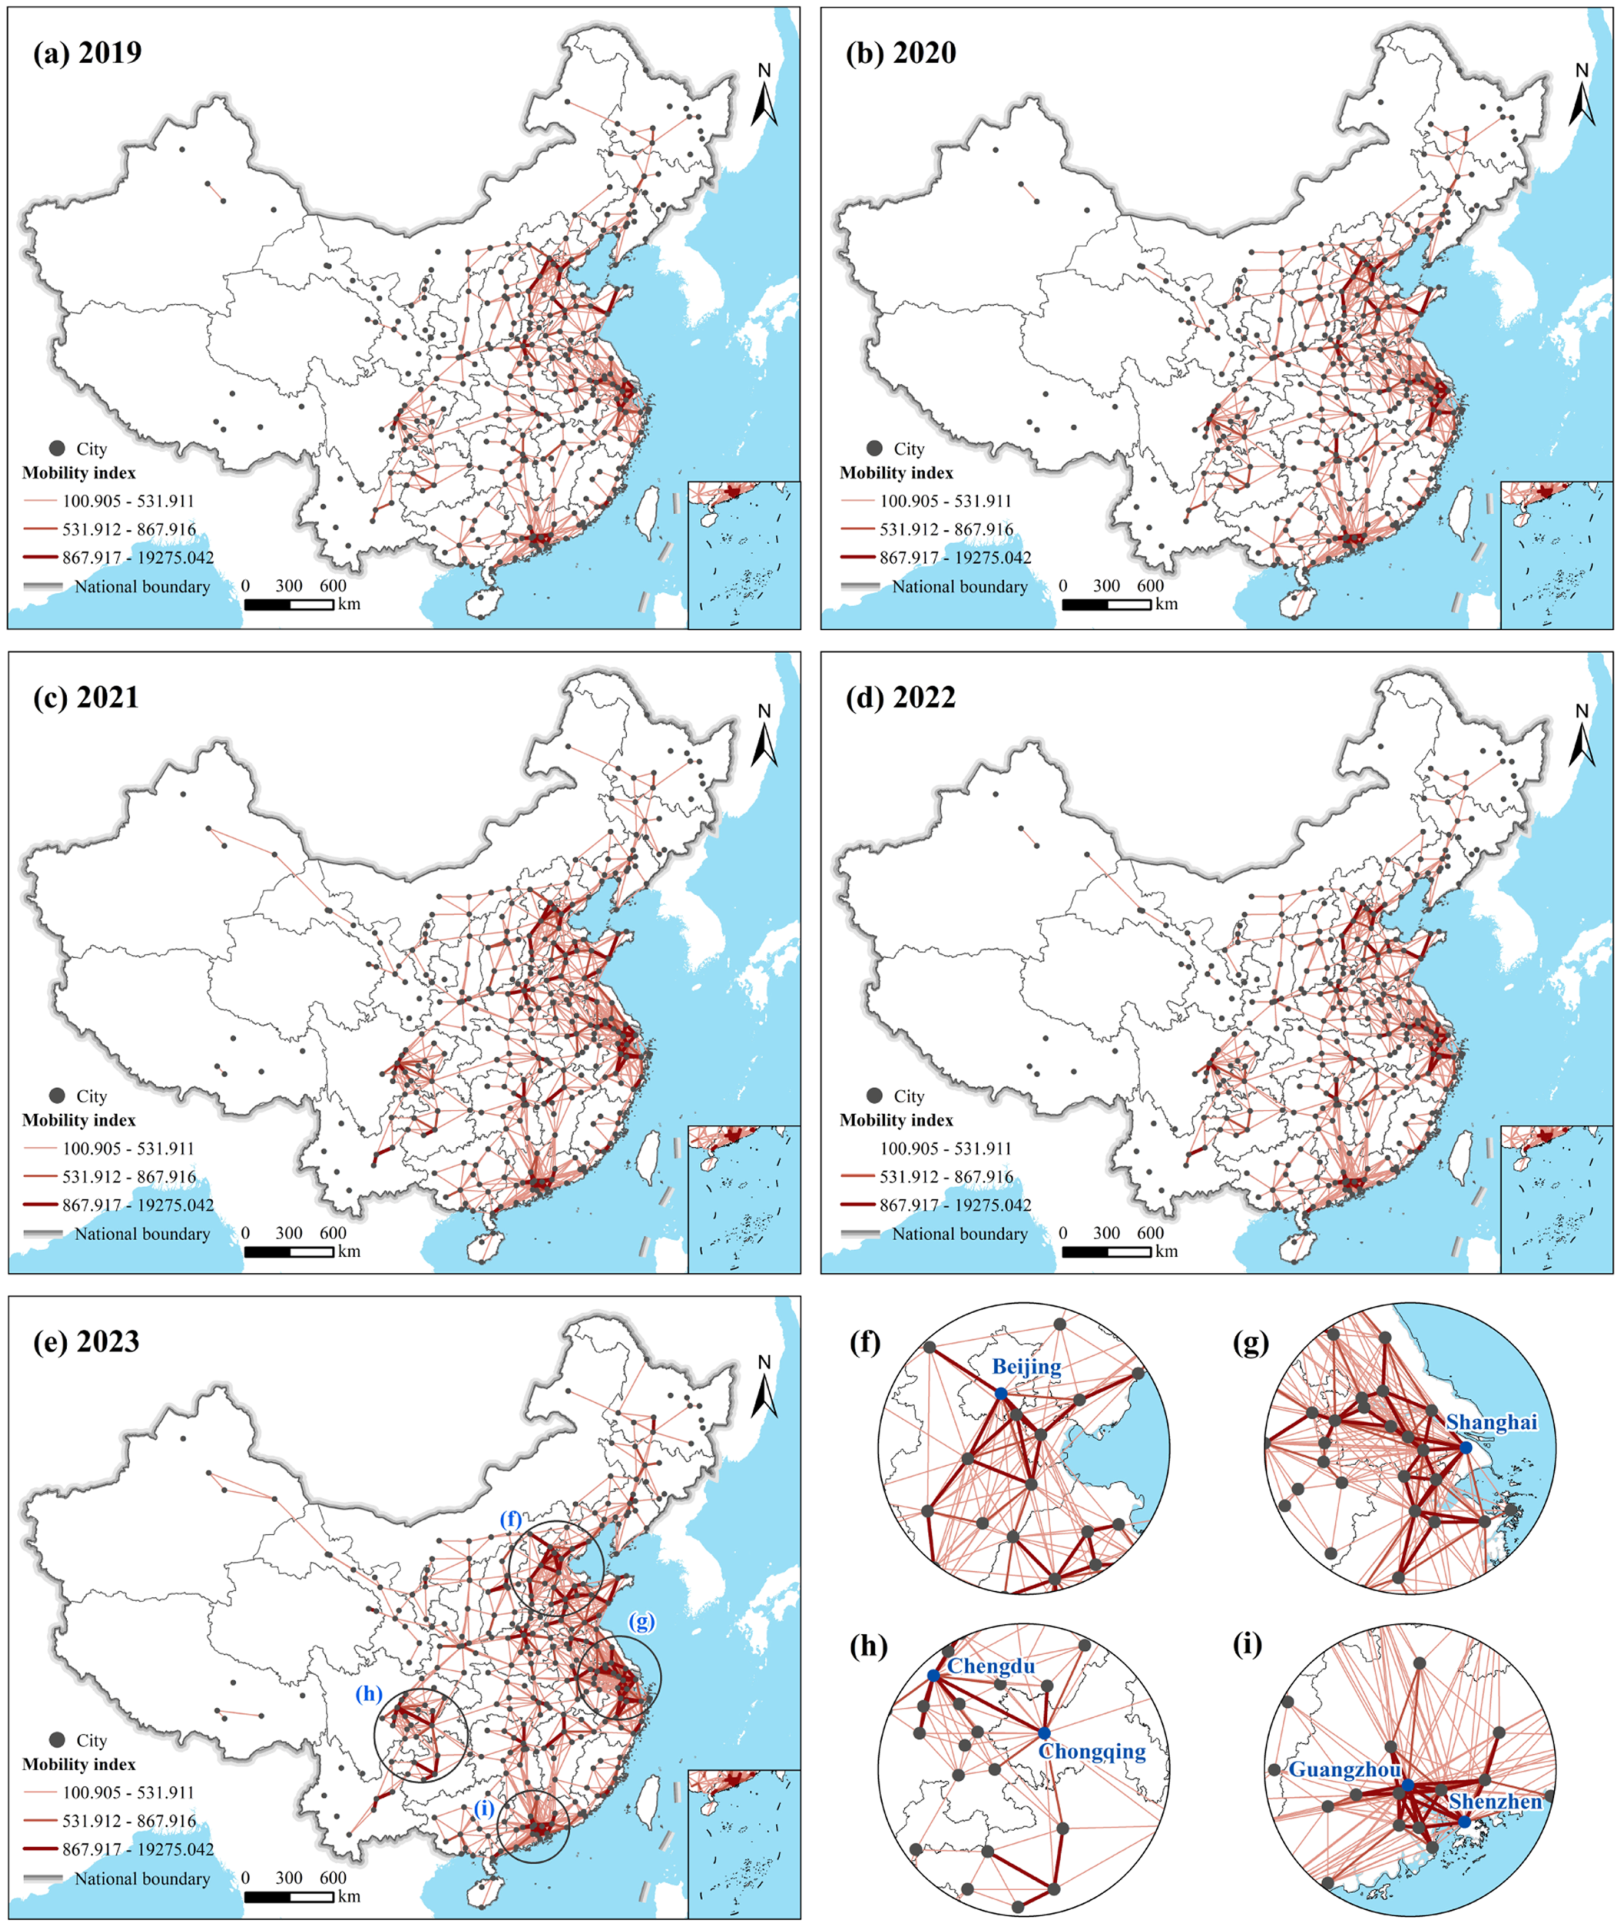
图 4|强联系在五年里怎样铺开,又挤在哪几个城市群?
(a–e)分别是 2019、2020、2021、2022 和 2023 年指数高于 100.905 的线路,颜色越深强度越高,灰点是城市。(f)京津冀,标出北京。(g)长三角,标出上海。(h)成渝,标出成都和重庆。(i)珠三角,标出广州和深圳。强联系从区域中心向外辐射。2019 年东部沿海核心城市是主要目的地,西部城市更多表现为向外的流。2020 和 2021 年指数上升,流动更多收在城市群内部。2022 年指数和线路减少。2023 年指数达到新高,东部网络更均衡。来源:原论文 Fig. 4。
正文把 2022 年的下降放在疫情防控加强、流动成本上升的背景下,并认为依赖服务业和国际贸易的城市受影响更大,长距离联系弱于短距离联系。模型里没有疫情强度或防控政策变量。图 4 能支持的是这五年可视化强联系的起伏,以及四个城市群内部的密集来往。它不能把 2022 年的减少数量分解成疫情效应。
少数城市占住两端
省会和直辖市承担政治、经济、文化中心的角色,作者因此单独看它们的中心性。图中同时列入深圳。加权入度和加权出度最高的一直是广州、深圳、杭州、上海和成都。呼和浩特、西宁、海口、拉萨和乌鲁木齐偏低,在网络里更靠近边缘。正文把加权度的上升读成交通改善和区域协调带来的多中心化。图上能直接看到的是颜色随年份变深,交通投资本身没有被测量。
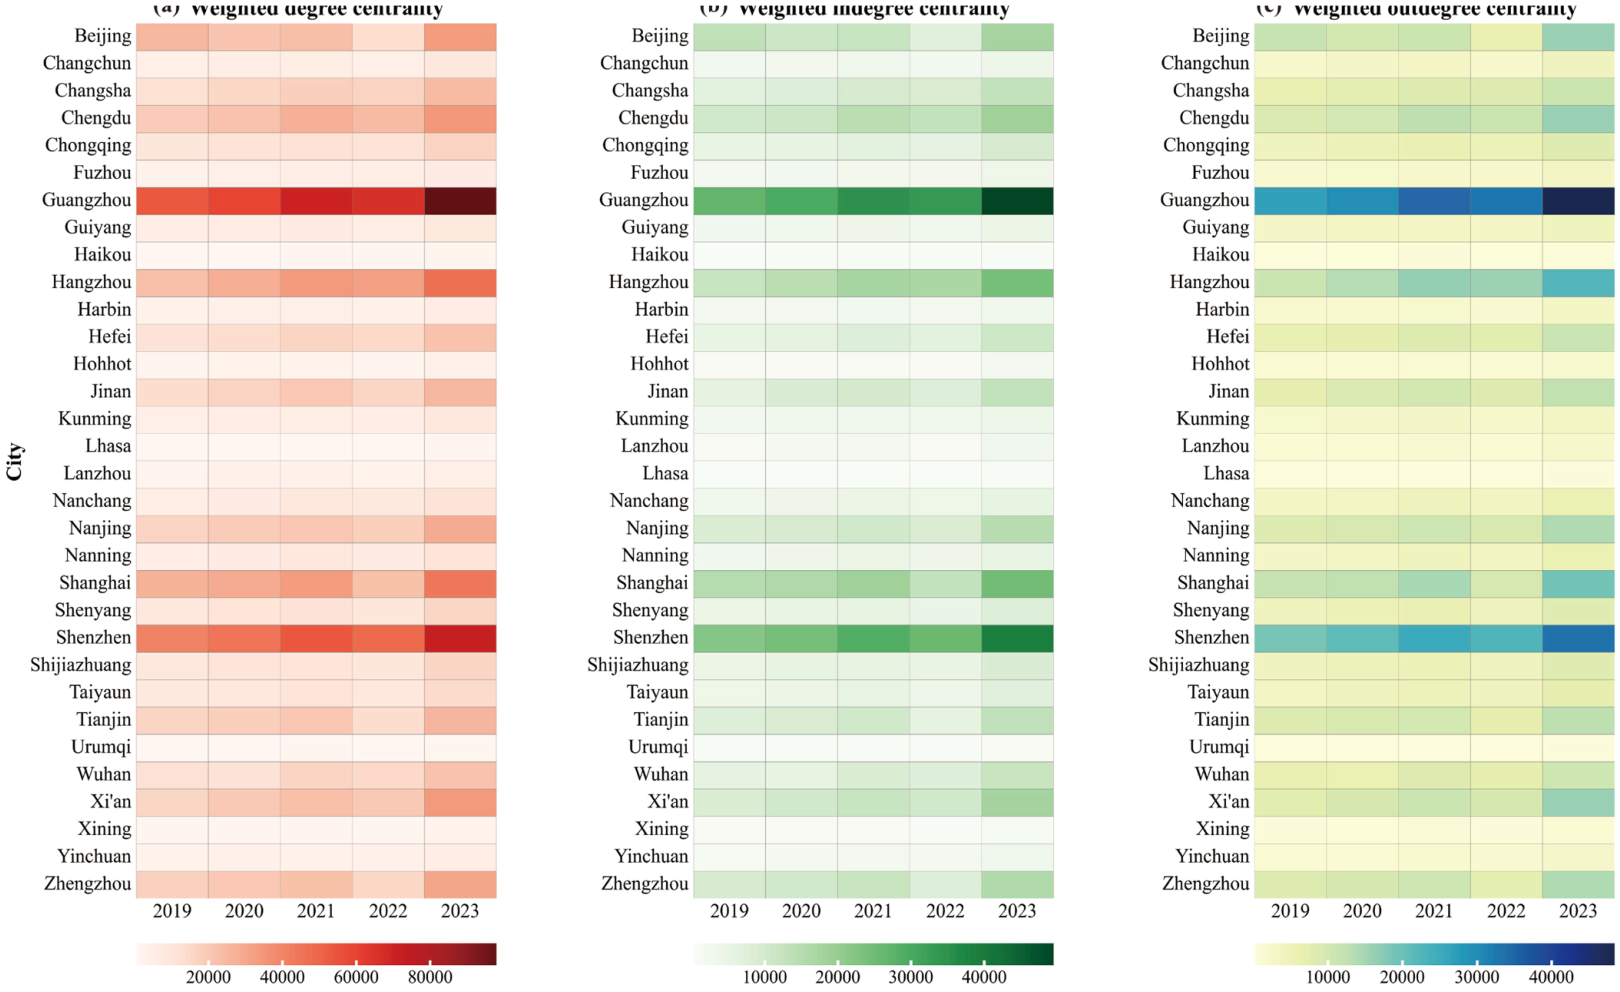
图 5|哪些城市的流入和流出同时很大?
(a)加权度,色标最高刻度为 80000。(b)加权入度,色标最高刻度为 40000。(c)加权出度,色标同样刻到 40000。三列年份都是 2019 到 2023。格子里没有印出具体数字。广州、深圳、杭州、上海、成都在(b)(c)中持续处于深色一端;深色只说明达到色标上端,附录曲线显示部分城市的加权度高于 90000。来源:原论文 Fig. 5。
全部 296 个城市的分布放在附录。横轴是按相应中心性从高到低的排序,纵轴是中心性数值,坐标是线性的。曲线开头很陡,然后贴近横轴。2023 年的曲线在大部分排序位置上高于其他年份。加权度图的纵轴标到 90000,最左端的 2023 年曲线超过这根刻度;加权入度和加权出度的纵轴标到 50000。总加权度更高,是因为它把入度和出度加在一起。插图放大排序靠前的大约 120 个城市,方便看头部以下的差距。
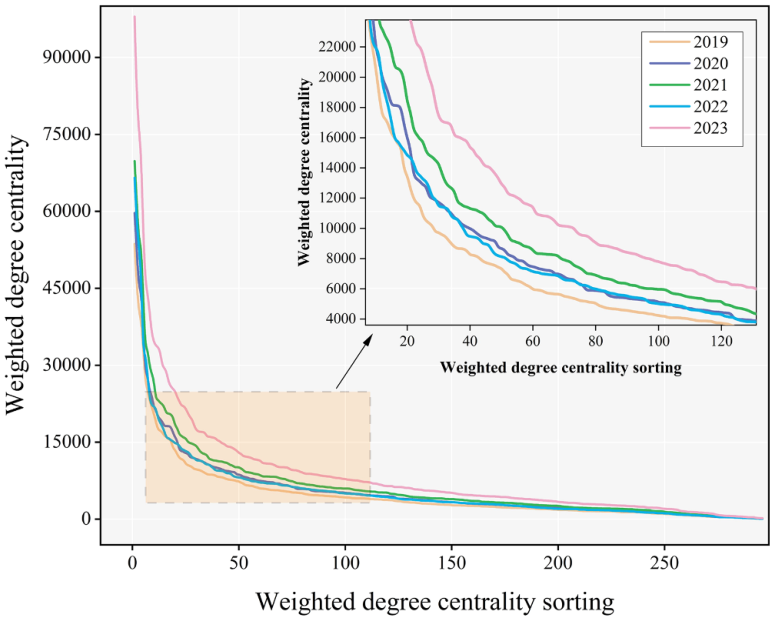
图 A1|全部城市的加权度有多集中?
横轴为加权度排序,纵轴为加权度。五条线是 2019–2023 年。浅色方框及箭头所指插图,放大排序前段。少数城市极高,多数城市很低。图上没有对数坐标,也没有拟合直线。来源:原论文 Appendix A1。
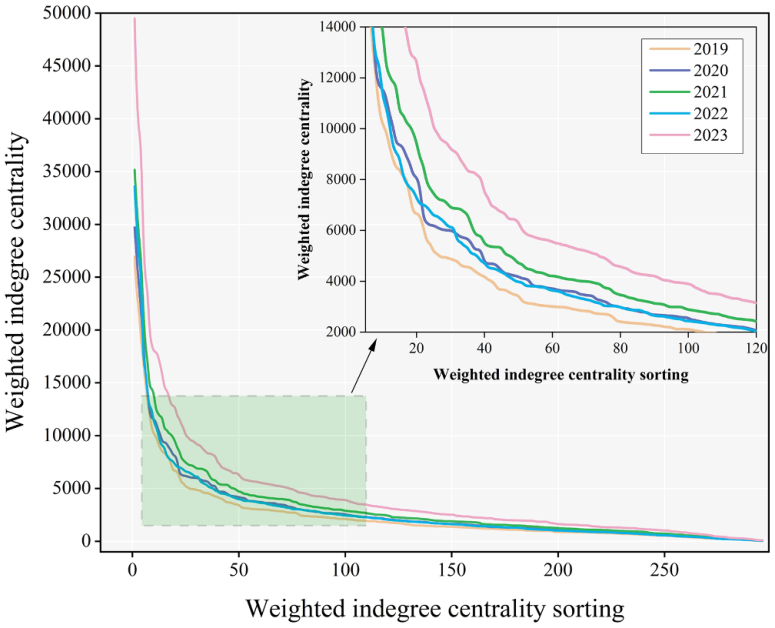
图 A2|流入强度是否同样集中在少数城市?
横轴为加权入度排序,纵轴为加权入度,年份与图 A1 相同。形状仍是陡降后的长尾,2023 年整体更高。来源:原论文 Appendix A2。
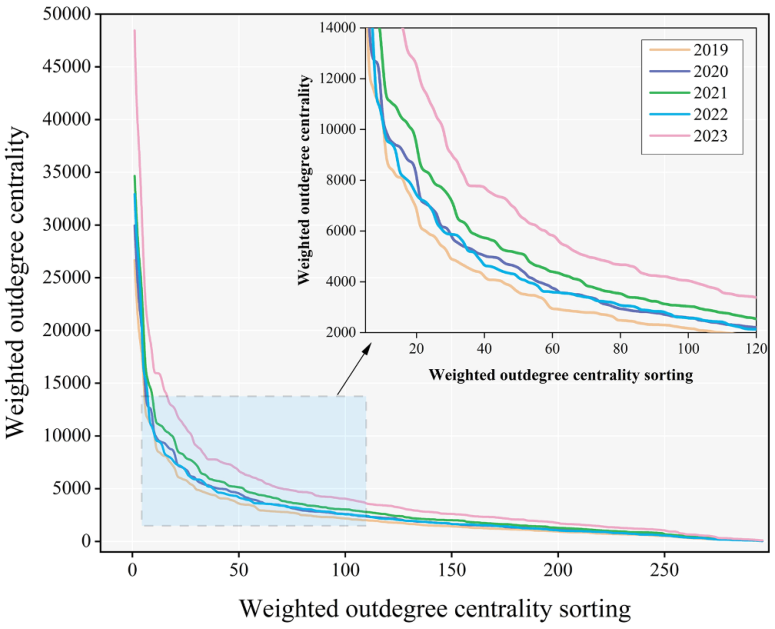
图 A3|流出强度是否也由少数城市主导?
横轴为加权出度排序,纵轴为加权出度。与入度图一样,头部城市高出长尾一个数量级以上。来源:原论文 Appendix A3。
正文据此称网络具有无标度特征:少数枢纽主导流动,大多数节点的流动水平较低。方法部分把度分布写成 p(k) 正比于 k 的 −r 次方,r 是幂律指数。正文和附录都没有给出 r、拟合区间或检验。附录是线性坐标上的排序图。这里的“无标度”应读成高度不均,而不是一次已经完成的幂律估计。
可以核对的份额在正文里。加权度前五城合计,2023 年占各城市加权度全国合计的 14.88%。同一句把较早的份额印成 2009 年的 15.03%。全文数据和附录曲线都是 2019–2023 年,没有 2009 年的分析,所以 15.03% 对不上一个可核对的年份。2023 年加权入度前五占入度合计的 14.24%,加权出度前五占出度合计的 14.53%。这句百分比没有逐一点名前五城。
入度和出度也不对称。杭州、成都和北京的入度与出度之差超过 1000 个指数单位,方向是净流入。讨论把省会概括为显著的人口净获得,把中小城市和边境城市概括为持续净流出。结果部分给出数值的是上述三座城市;图 5 没有为每一座城市印出净值。
强联系会分成哪几团?
社区检测要找出内部联系更密的一组节点。作者用模块度:把实际边权与按出入强度随机期望的边权比较,只把分到同一社区的城市对计入。正文没有写出所用算法的名称。
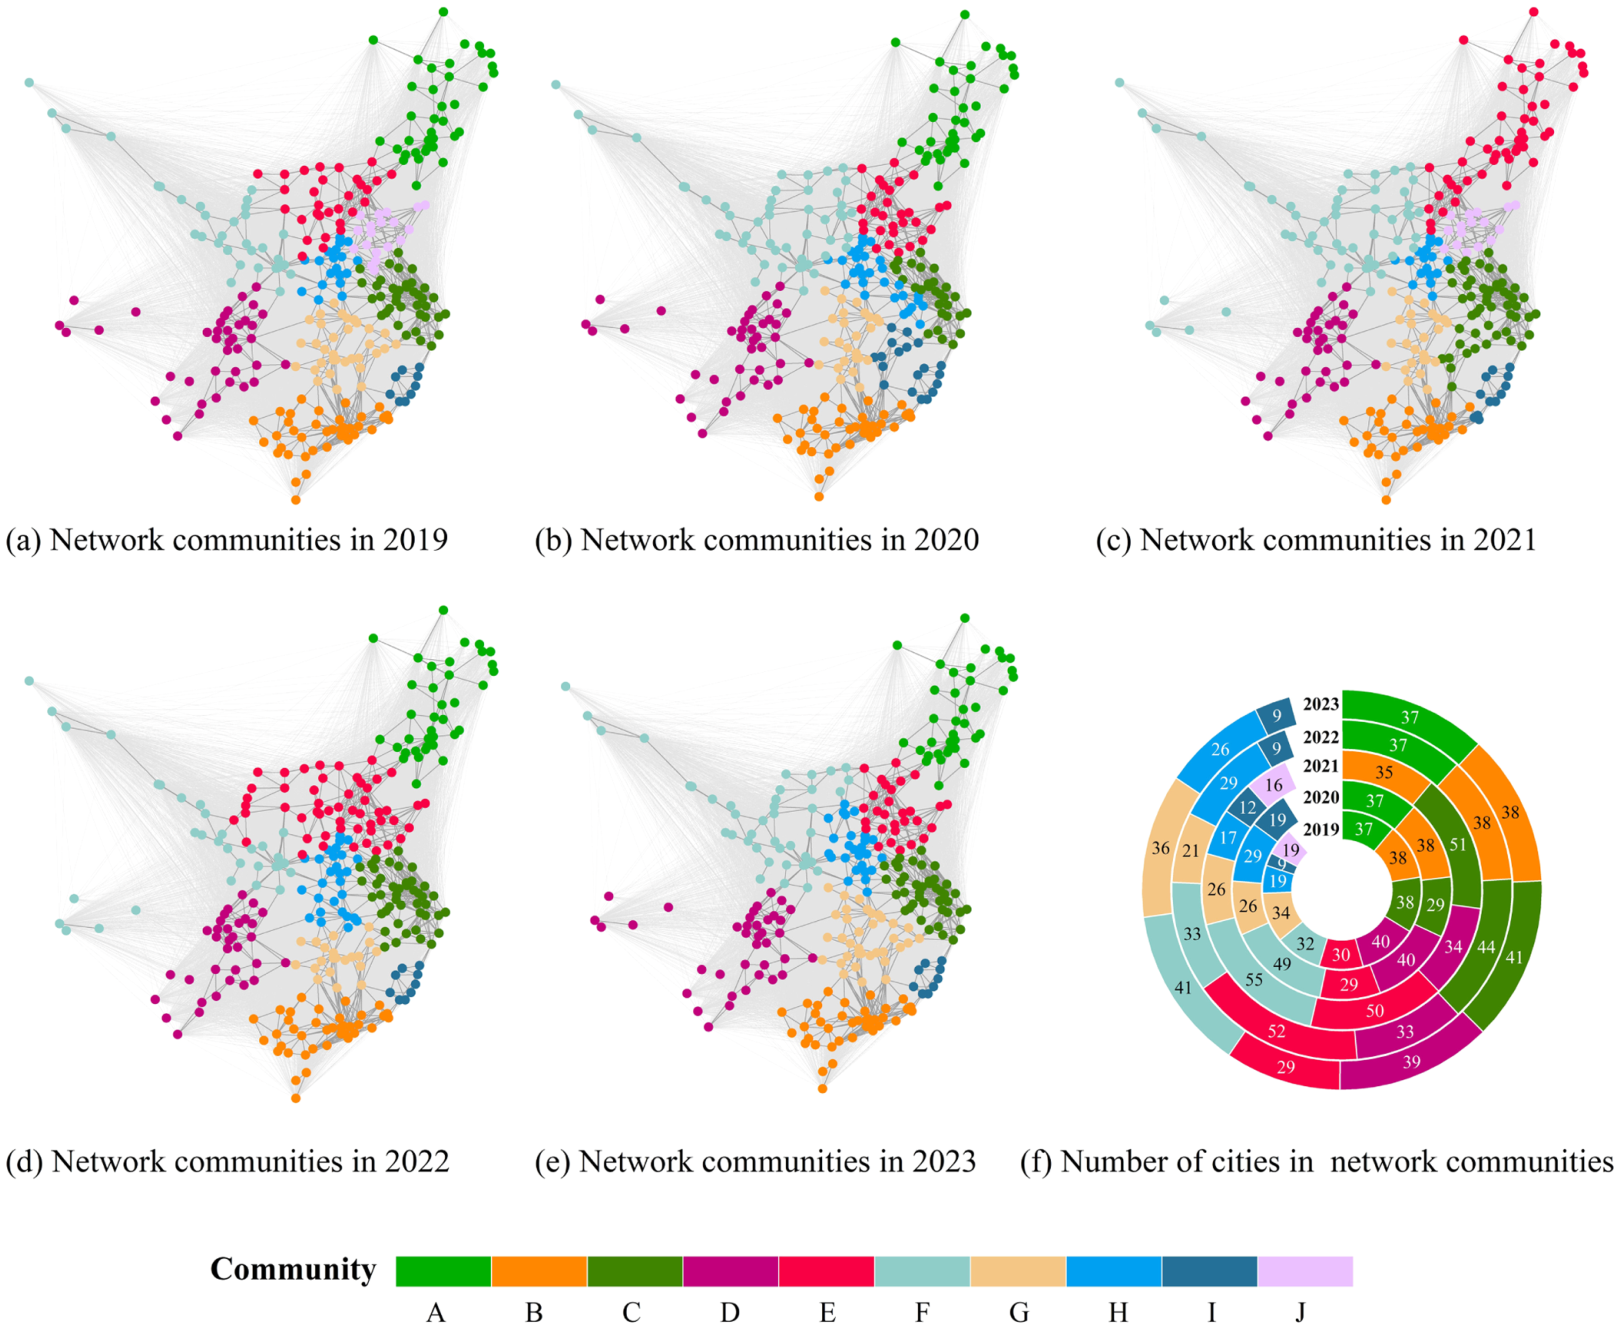
图 6|流动联系分成几团,每团有多少城市?
(a–e)依次是 2019 到 2023 年的网络布局。同色节点属于同一社区,连线是城市之间的流动联系。这是网络图,点的左右位置不是地理经纬度。(f)按社区颜色和年份标出城市个数。图例 A 到 J 对应十种颜色。来源:原论文 Fig. 6。
2019 年有 10 个社区,2020–2023 年稳定在 9 个。社区 C 从 2019 年的 38 个城市增至 2023 年的 41 个,样本一共 296 个城市。正文说社区 C 主要是长三角城市群:经济、技术和创新条件使它更能吸引人口,并对周边产生经济溢出,城市之间的流动因此更紧。社区 G 主要是长江中游城市群,交通网络发达,对邻城的溢出加强了区域内流动,于是形成单独的一团。
讨论补充了最明显的合并:京津冀和山东半岛从两个社区变成一个。环状图里其余格子的城市数,正文没有逐一列出,这里也不把图上的小号数字逐格改写成一份完整清单。异质性回归后面只用 2023 年的六个主要社区 A–F。社区 C 在正文中对应长三角。社区 G 有地理说明,但没有进入这六组回归。A、B、D、E、F 的地理范围,正文没有逐一命名。
把网络自己的结构放进同一条式子
城市对之间的联系并不独立。两条城市互有来往时,一个方向的存在会改变另一个方向的概率;两座城市若有共同伙伴,它们直接相连的概率也会变。普通回归把观测当成彼此独立,会漏掉这种依赖。时序指数随机图模型(temporal exponential random graph model,TERGM)把当前网络写成过去网络的条件概率:概率与一组网络统计量的指数成正比,再除以配分项,使各个可能网络可以比较。多期模型把各期条件概率相乘。
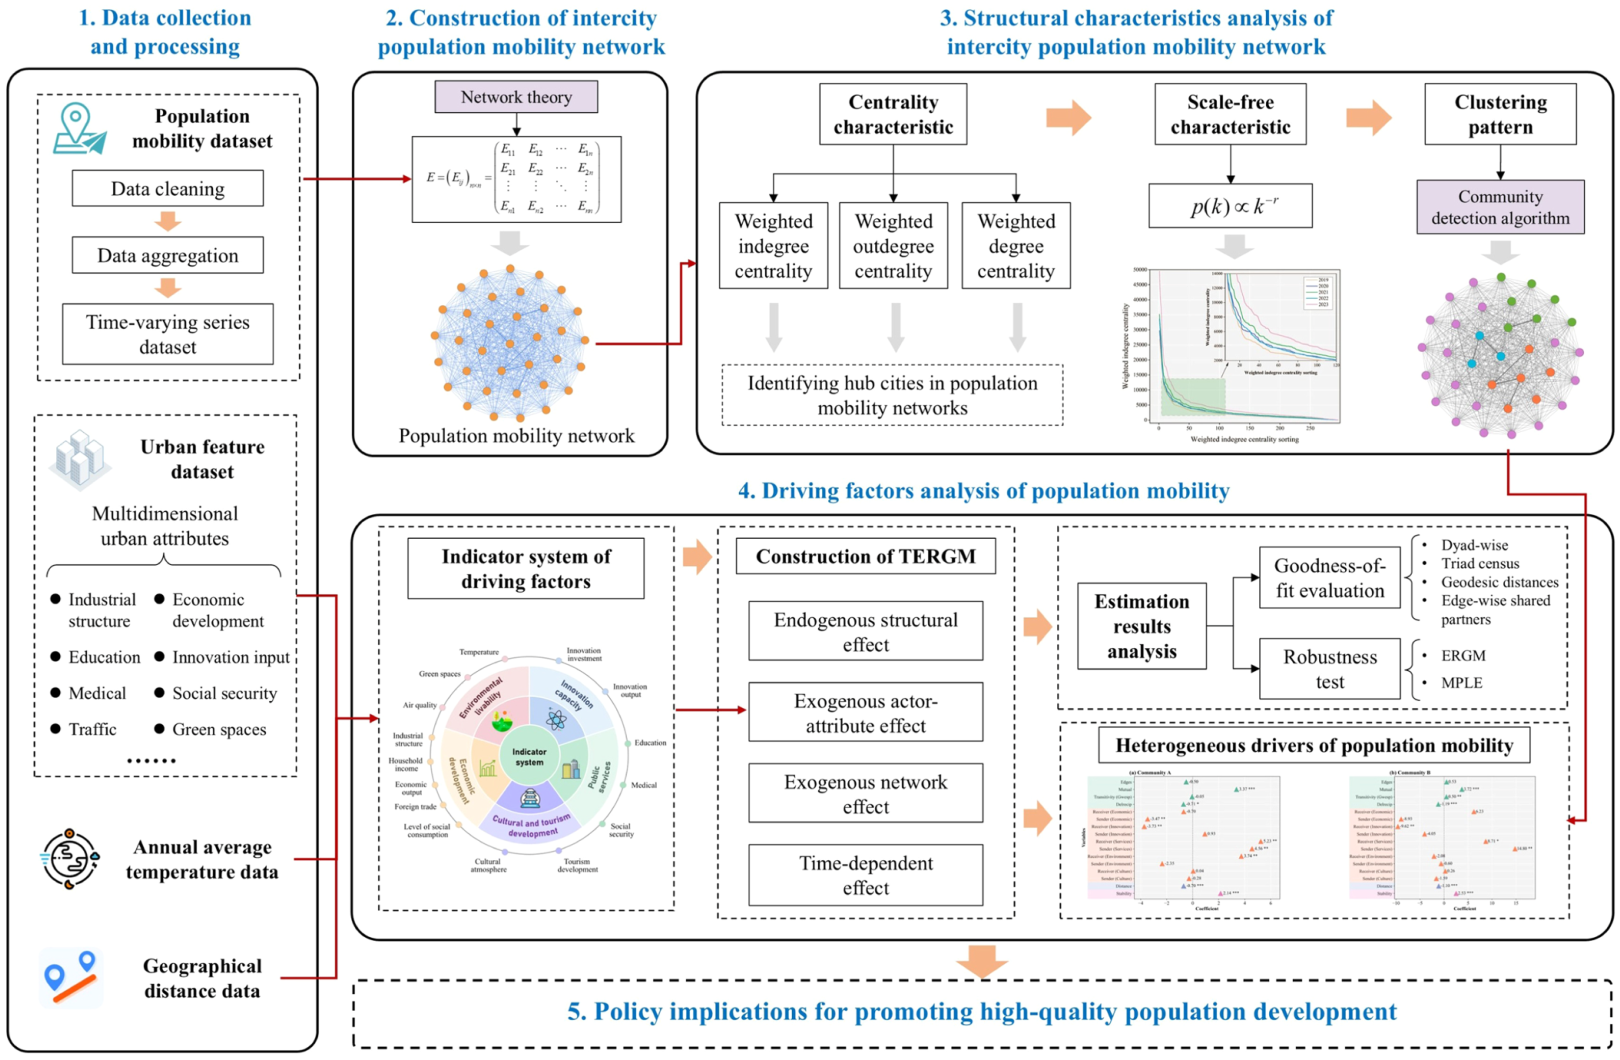
图 2|整篇论文的步骤怎样接在一起?
无字母子图。这是示意图,不是结果。左上方把迁徙指数清洗、汇总成多年网络;左下方是城市属性、气温和地理距离。中间用加权入度、出度和加权度找枢纽,用排序分布看不均,用社区算法看成团。下方把内生结构、城市属性、外部距离网络和时间依赖放进 TERGM,再做拟合、稳健性和分社区估计。来源:原论文 Fig. 2。
内生结构有四项。边(Edges)是形成联系的基线倾向,稀疏网络里通常为负。互惠(Mutual)看双向联系是否更可能出现。延迟互惠(Delrecip)看第 t 期的单向流动,是否提高第 t+1 期出现反向流动的可能。传递性用几何加权边共享伙伴(Gwesp)表示:有共同伙伴的城市更容易直接相连。
外部网络项是城市之间的地理距离(Distance)。时间依赖项是稳定性(Stability):第 t+1 期的联系是否与第 t 期一致,正系数表示格局会延续。
城市属性分成五维,每维再分成发送效应和接收效应。发送效应看属性如何影响一条边从这座城市发出,接收效应看它如何影响一条边指向这座城市。
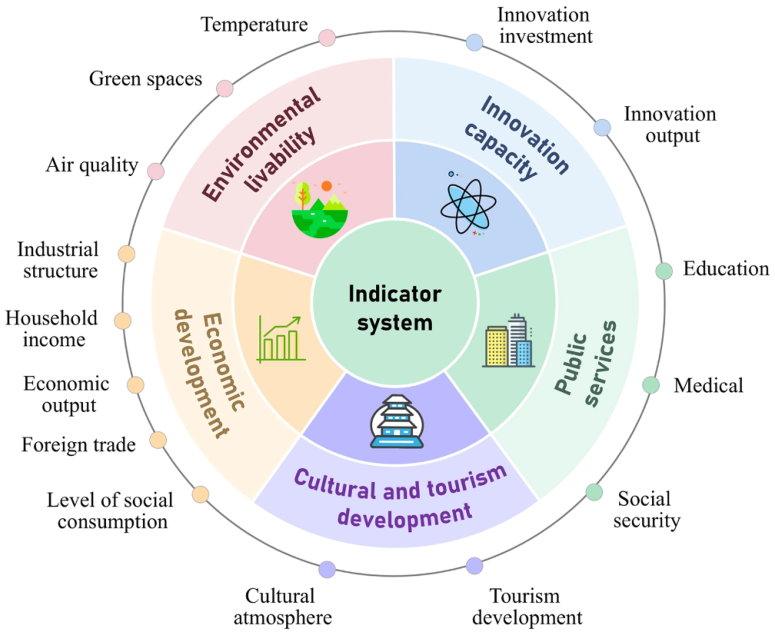
图 3|五维城市属性各自包含什么?
无字母子图。经济包括产业结构、经济产出、居民收入、社会消费和外贸。创新包括创新投入和产出。公共服务包括教育、医疗、社会保障和交通。环境宜居包括气温、绿地和空气质量。文化与旅游包括文化氛围和旅游发展。外圈是进入综合分的具体指标。来源:原论文 Fig. 3。
具体指标是:第二产业、第三产业占 GDP 的比重,人均 GDP,在岗职工平均工资,社会消费品零售总额,货物进出口额;科学技术财政支出和专利授权数;公共教育支出、医院数、参加城镇基本养老保险、基本医疗保险和失业保险的人数,以及城市铺装道路面积;年均气温、建成区绿化覆盖率、PM2.5 年均浓度;博物馆数、公共图书馆藏量、旅游收入和旅游人数。五维综合分用熵权法按指标的变异程度赋权。计算步骤引用另一篇论文,本文没有展开。PM2.5 浓度越高空气越差,气温也没有单一的“越高越好”。本文没有写明这些指标在合成前是否反向。因此环境综合分越高,不能直接读成空气越好。后文对“环境质量更有吸引力”的解释,沿用的是作者对接收正系数的读法。
模型 1 到 4 依次加入内生结构、城市属性、距离和稳定性,估计方法是马尔可夫链蒙特卡洛最大似然。作者用 AIC、BIC 和对数似然选择解释模型,数值更低的 AIC、BIC 以及更高的对数似然表示拟合更好。表 4 为模型 2、3、4 列出的观测数都是 349280。296 个城市之间的有向城市对为 296×295 = 87320,349280 正好等于 87320×4,与 2019–2023 年中四次年度转移所覆盖的全部城市对数量相同。模型 1 没有报告观测数、AIC、BIC 和对数似然。
| 模型 | 观测数 | AIC | BIC | 对数似然 |
|---|---|---|---|---|
| 模型 2 | 349280 | 41555.0182 | 41725.1527 | −20763.5091 |
| 模型 3 | 349280 | 35655.1588 | 35837.4457 | −17812.5794 |
| 模型 4 | 349280 | 20876.4472 | 21070.8866 | −10422.2236 |
模型 4 在已列出的模型里 AIC、BIC 最低,对数似然最高,作者用它解释机制。从模型 3 到模型 4,AIC 从 35655.1588 降到 20876.4472。改善来自加入稳定性,说明“上一年的联系还在不在”对拟合贡献很大。这仍是模型拟合的改善,不是稳定性单独解释了百分之多少的流动人数。
模型 4 的系数如下。括号里是标准误,显著性沿用表注:5%、1% 和 0.1%。没有星号的系数记为未标显著。
| 变量 | 系数(标准误) | 显著性 |
|---|---|---|
| 边 Edges | −3.0387(0.1683) | 0.1% |
| 互惠 Mutual | 3.4715(0.0851) | 0.1% |
| 传递性 Gwesp | 1.9698(0.1536) | 0.1% |
| 延迟互惠 Delrecip | −1.0563(0.0686) | 0.1% |
| 经济,接收 | 1.1286(0.3990) | 1% |
| 经济,发送 | −1.3254(0.4249) | 1% |
| 创新,接收 | −1.3719(0.3995) | 0.1% |
| 创新,发送 | −0.6359(0.4470) | 未标显著 |
| 公共服务,接收 | 2.4202(0.4727) | 0.1% |
| 公共服务,发送 | 1.2716(0.5268) | 5% |
| 环境宜居,接收 | 0.9255(0.2380) | 0.1% |
| 环境宜居,发送 | −0.4511(0.2443) | 未标显著 |
| 文化旅游,接收 | 0.8092(0.3101) | 1% |
| 文化旅游,发送 | 0.6812(0.3413) | 5% |
| 地理距离 | −0.0032(0.0001) | 0.1% |
| 稳定性 | 2.5934(0.0238) | 0.1% |
互惠和传递性显著为正:双向联系,以及有共同伙伴的城市之间的直接联系,更可能出现。稳定性 2.5934 表示下一期倾向于延续上一期的格局。延迟互惠需要和前面的模型一起看。模型 1 里它是 3.8108(标准误 0.0218),模型 3 在已经放入属性和距离后仍为 2.6737(0.0298),都显著为正。只有模型 4 加入稳定性后,它才变成 −1.0563。条件于“同一条联系是否简单地留到下一年”,额外的延迟互惠统计量是负的。作者在结果段落里强调的是互惠和传递性,没有解释这个符号变化。
经济的接收效应为正、发送效应为负。在其他统计量保持不变时,经济综合分更高的城市更可能成为联系的指向端,更不可能成为发出端。作者据此说经济发展仍然是人口流动的关键因素,发达城市吸引流入的能力更强。创新的接收效应和发送效应在模型 4 里都是负的,只有接收效应在 0.1% 水平显著。模型 2 和模型 3 的创新接收效应同样为负,分别是 −1.2663 和 −2.6968,都在 0.1% 水平显著。创新的发送效应则不稳定:模型 2 为 1.6902 且显著,加入距离后变为不显著的 0.5551,模型 4 变为不显著的 −0.6359。
摘要和结论把创新能力写成日益重要的决定因素。模型 4 的全国接收系数并不表现为“创新综合分越高,越可能收到一条联系”。公共服务在模型 4 里接收和发送都为正,接收效应更大、也更显著。它的发送效应同样不稳定:模型 2 为 −2.9306 且显著,模型 3 为不显著的 −0.2592,模型 4 才变成 1.2716。环境宜居只有接收效应显著为正。文化旅游的接收和发送都为正,接收效应的显著性和系数都更大,分别是 0.8092 和 0.6812。
距离系数是 −0.0032。表 1 写明,该参数为负表示距离阻碍人口流动。结果段落有一句写成 “exerts a positive influence”,紧接着又说距离抑制流动。与系数和表 1 一致的读法是:地理距离越大,这条有向联系越不容易出现。论文没有给出距离的单位,−0.0032 不能换算成每公里减少多少联系。
还有一层必须放在系数旁边。拟合诊断使用的是边共享伙伴、二元组共享伙伴、测地距离、度和三元组,以及 ROC、PR 曲线。这些是二值网络的诊断。观测数又等于四个年度的全部有向城市对。因此模型判断的是一对城市之间有没有一条被计入的联系。正文没有写出把迁徙指数变成“有或无”的阈值。图 4 的 100.905 是地图只绘制强线路的下限,不能直接当成模型阈值。系数也就不能读成指数本身增加了多少。
模拟网络像不像观测网络
作者用模型 4 的参数做 1000 次模拟,比较模拟网络和观测网络的结构。论文把箱线称为模拟结果的 95% 置信区间,黑线是观测网络,并认为关键结构大体落在区间内或靠近区间。
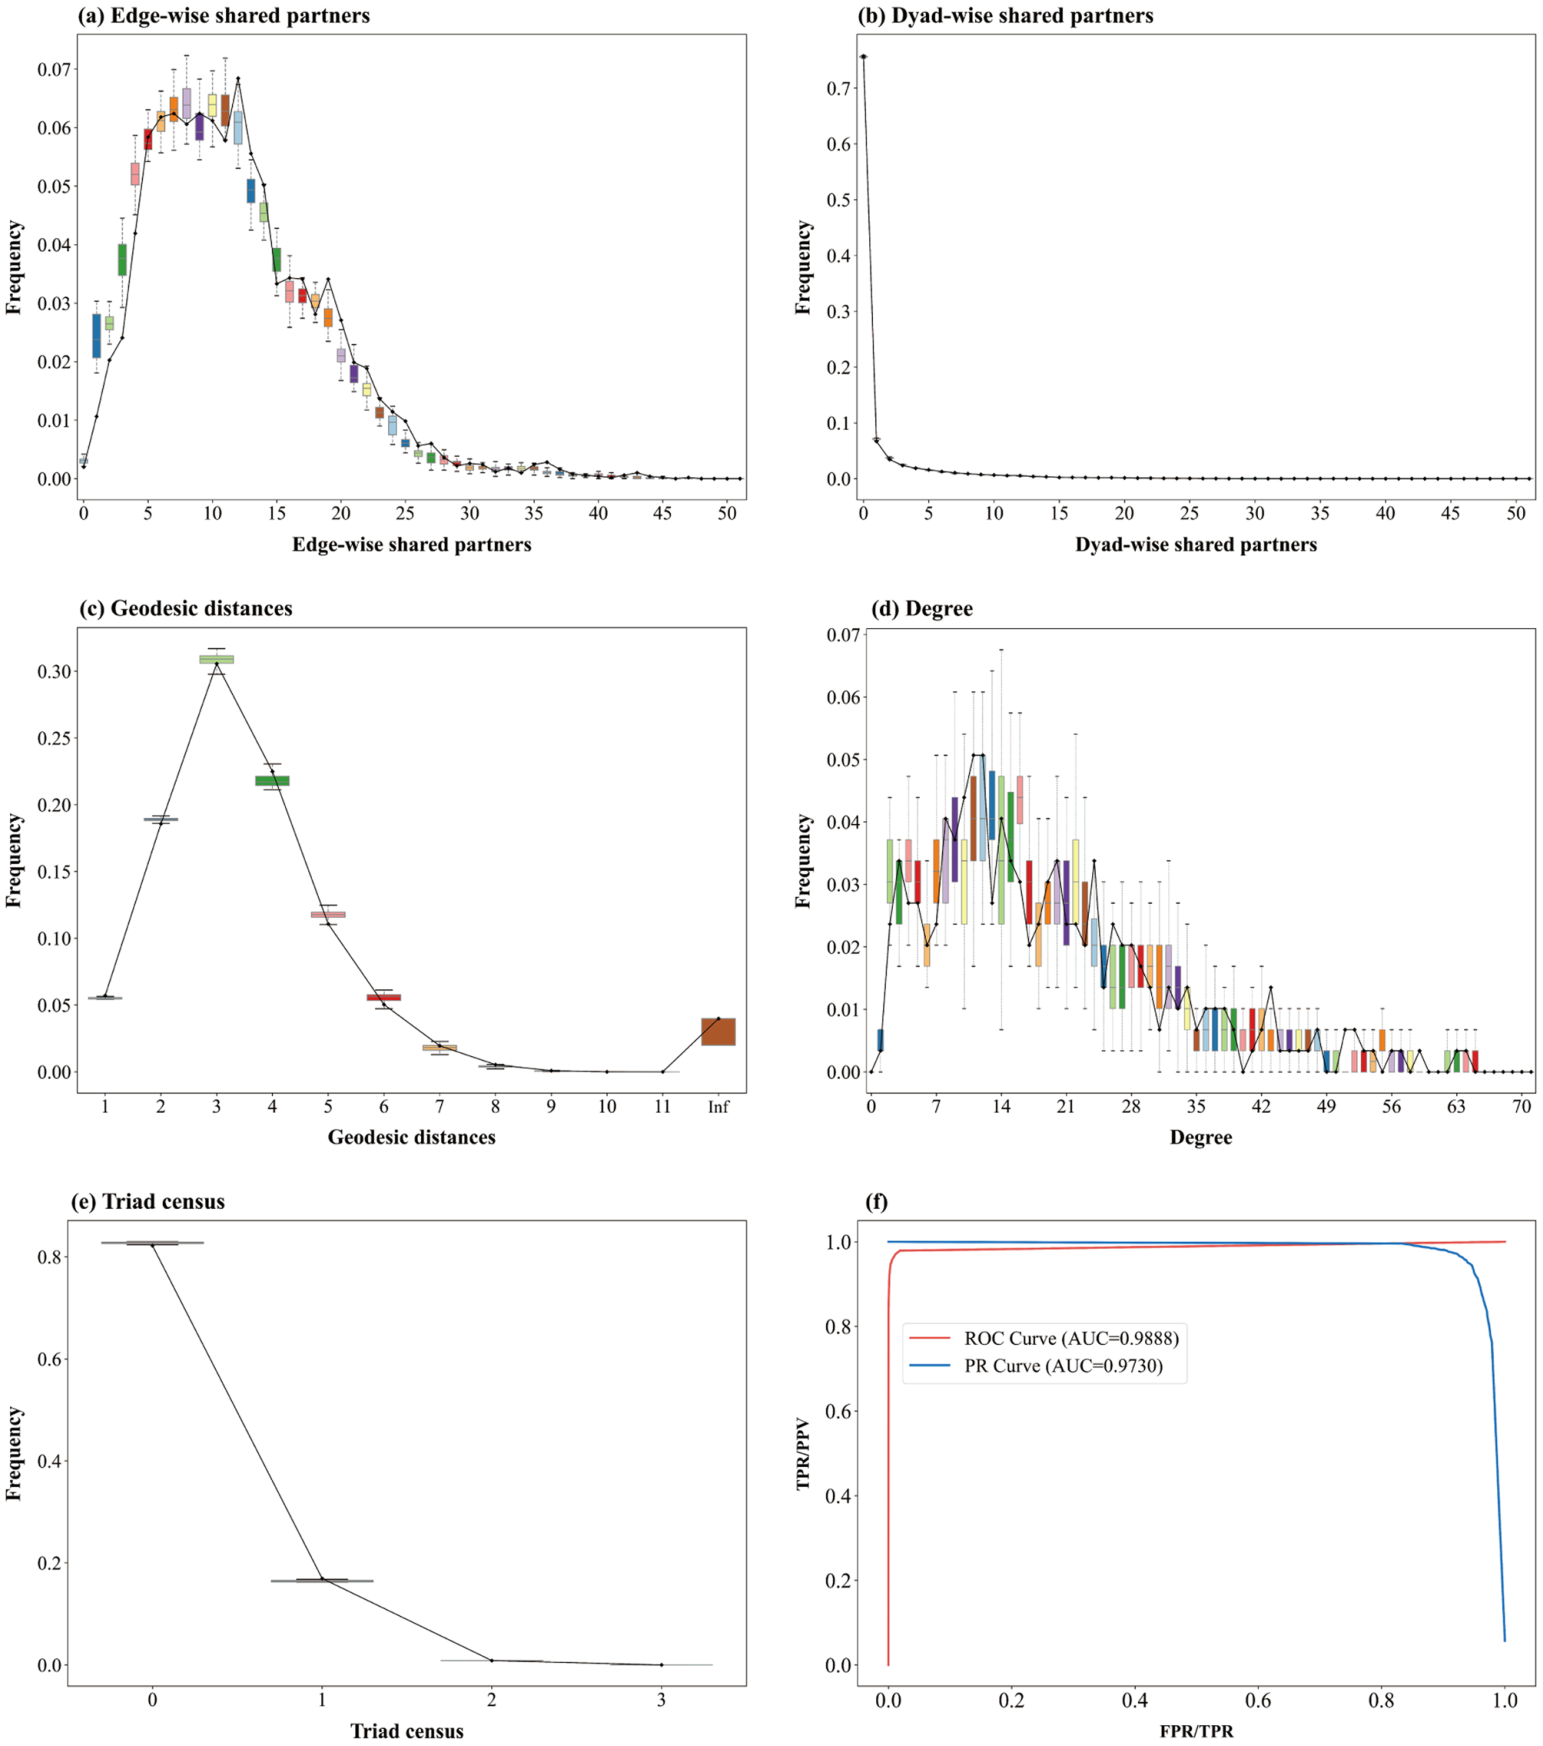
图 7|模型 4 能否复现观测网络的形状?
(a)边共享伙伴的频数,横轴为伙伴数,纵轴为频率。(b)二元组共享伙伴,大量二元组的共享伙伴为 0,随后迅速下降。(c)测地距离,频率在较短距离上形成峰值,横轴末端的 Inf 表示不连通。(d)度分布。(e)三元组普查,低阶三元组的频率更高。(f)红线为 ROC,图例 AUC 为 0.9888;蓝线为 PR,图例 AUC 为 0.9730。箱线是模拟分布,黑线是观测值。来源:原论文 Fig. 7。
正文说 ROC 统计量接近 1,与图例中的 0.9888 相符。PR 的 AUC 为 0.9730,说明模型在区分有联系和无联系时,精确率并没有在提高召回的过程中很快塌掉。高 AUC 表示模型给实际存在的联系打出了更高的分数。它不能证明这组统计量是唯一机制,也不能恢复每条边的指数大小。测地距离等面板里,黑线与箱线在个别位置有可见偏离,所以“拟合较好”是整体判断。
换一年或换一种估计,属性系数会改号
稳健性有两步。模型 5 只用 2023 年网络做静态指数随机图,观测数 87302。296×295 = 87320,比全部有向城市对少 18 对,论文没有解释这 18 对为何不在样本中。模型 6 仍是时序模型,但把估计换成自助最大伪似然。表注把方括号称为 5% 置信区间,★ 表示区间不含 0。
结构项更稳。模型 5 的互惠为 3.4351,传递性为 1.2048,距离为 −0.0081,都在 0.1% 水平显著。单一年份没有延迟互惠和稳定性。模型 6 的互惠为 3.3953,区间 [2.7296, 3.4877];传递性为 1.6690,区间 [1.0449, 1.8984];延迟互惠为 −0.9413,区间 [−1.0111, −0.2470];距离为 −0.0033,区间 [−0.0057, −0.0023];稳定性为 2.5527,区间 [2.3507, 2.9747]。这些区间都不含 0,方向与模型 4 相同。
城市属性没有同样稳。模型 4 里经济发送效应为 −1.3254,模型 5 变为 0.7778,在 5% 水平显著,符号相反。创新接收效应从模型 4 的 −1.3719 变为模型 5 的 1.3575,后者在 0.1% 水平显著。环境接收效应从 0.9255 变为不显著的 −0.1560。文化旅游的发送效应从 0.6812 变为不显著的 −0.1051。模型 6 里,经济接收仍为正,创新接收仍为负,经济发送仍为负;公共服务和文化旅游的区间都跨过 0。作者写明,模型 6 除公共服务和文化旅游的系数差异外,与模型 4 接近。因此,可以把互惠、传递性、距离和稳定性看成更稳定的结果。公共服务、文化旅游,以及创新、经济发送效应的符号,取决于使用全时段模型、2023 年静态模型,还是自助区间。
六个社区的驱动方向一样吗?
异质性分析以 2023 年的社区结构为准,分别估计 A–F 六个主要社区。各社区单独拟合,系数大小不能当成全国模型的倍数。
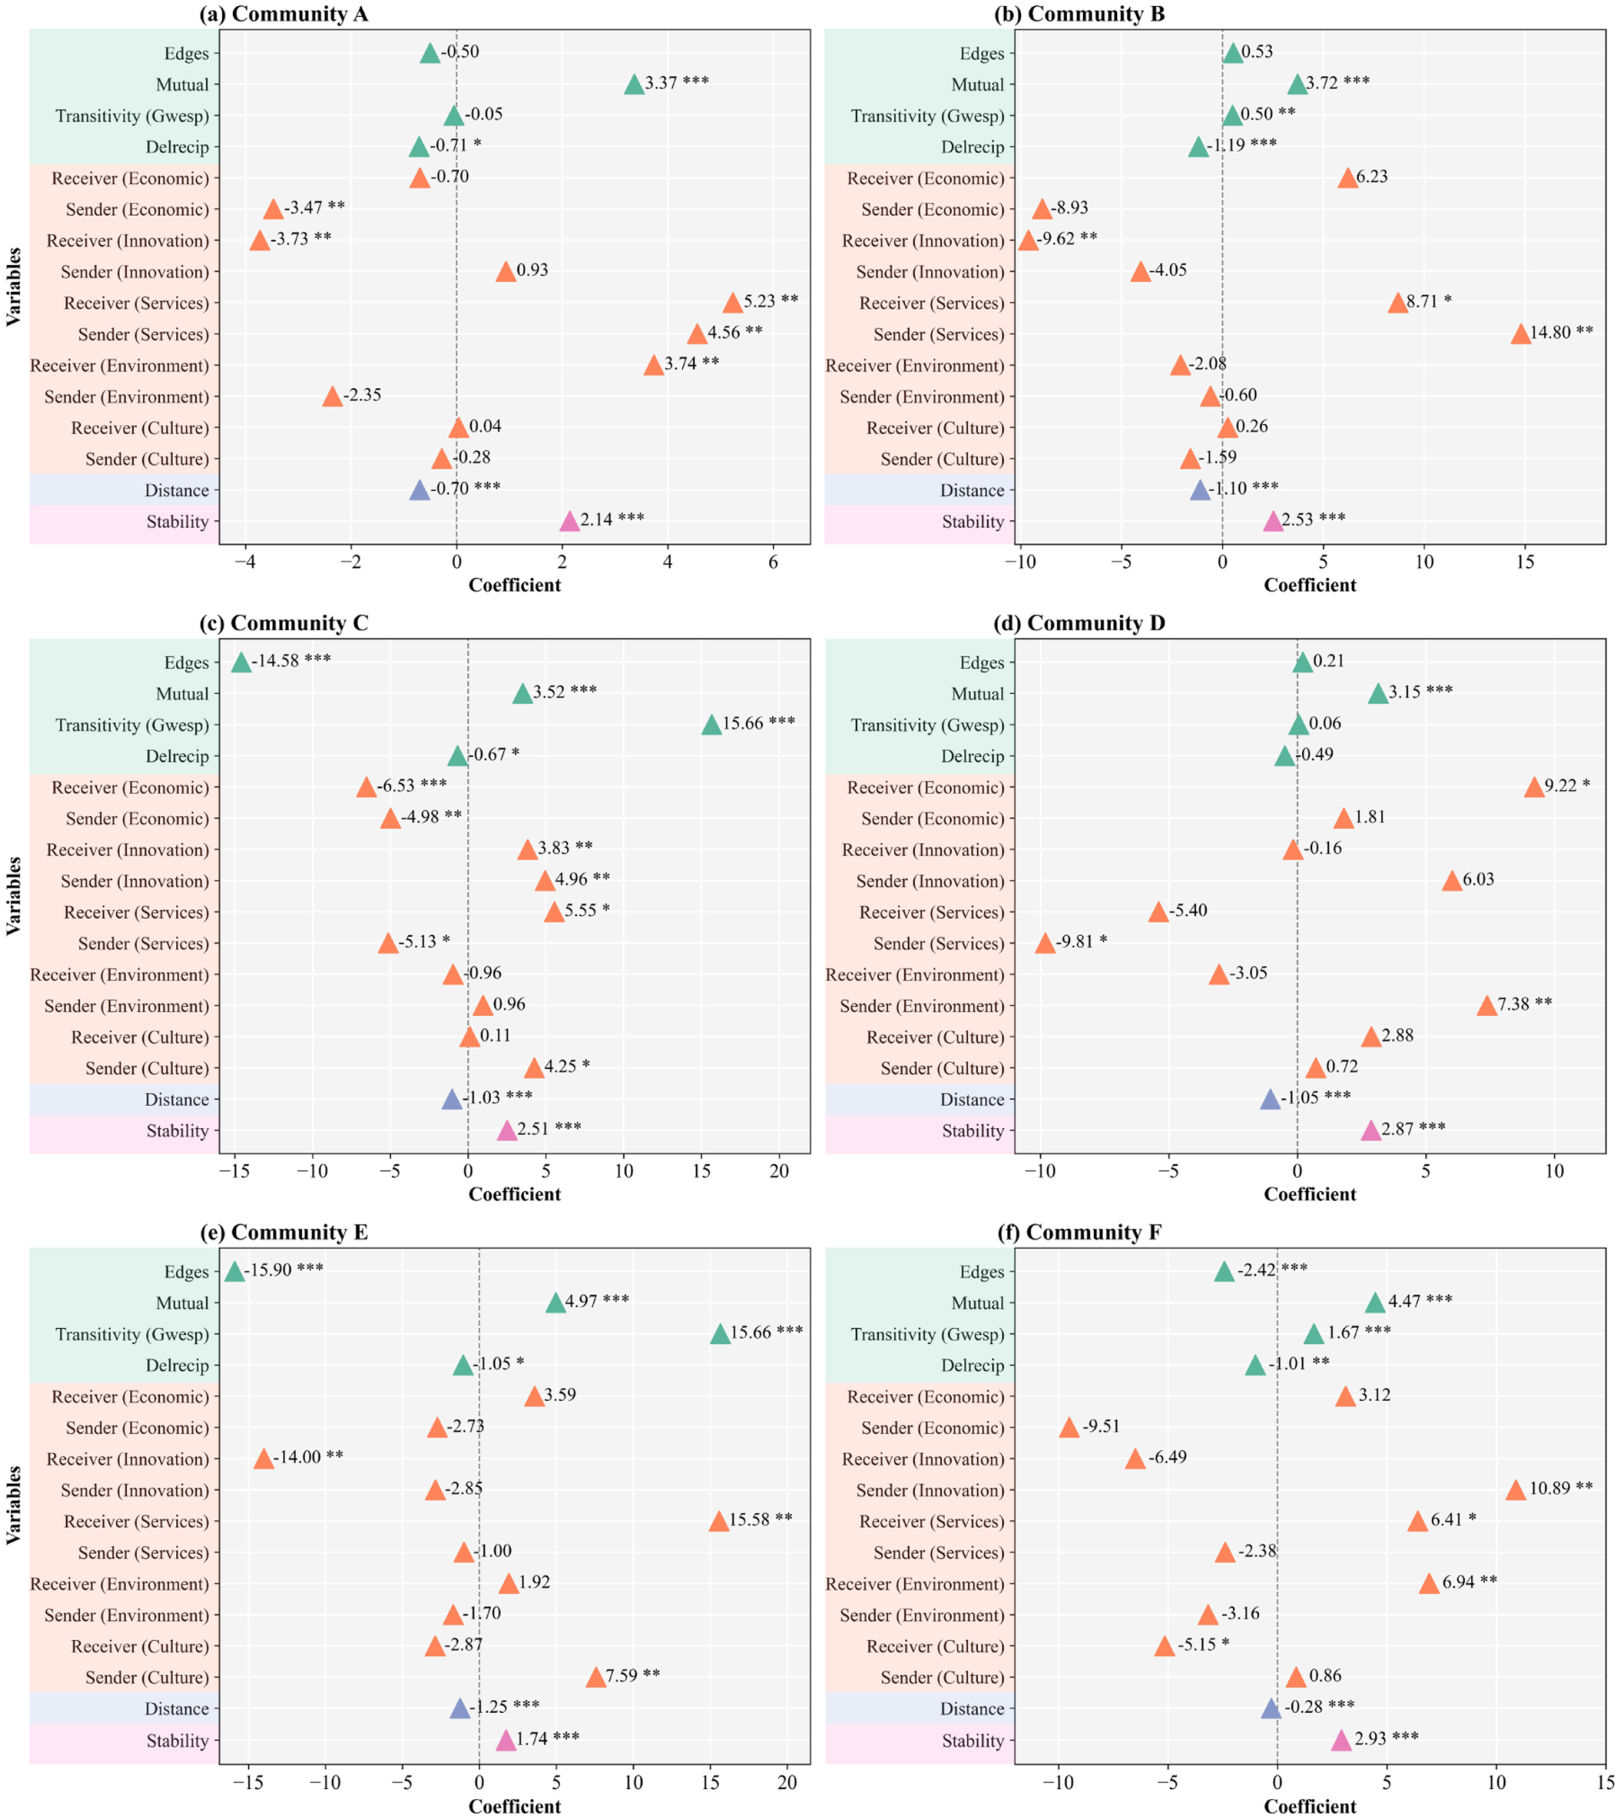
图 8|同一项因素,在不同社区里指向同一边吗?
(a–f)依次是社区 A 到 F。每一行是一个变量,横轴是系数,竖线为零。三角点是估计值,星号表示显著性。绿色行是内生结构,橙色行是城市属性的接收或发送效应,蓝色是距离,粉色是稳定性。距离都在零线左侧,稳定性都在零线右侧。来源:原论文 Fig. 8。
正文给出的社区差异是:
- 社区 A 的互惠系数为 3.366,在 0.1% 水平显著。公共服务的发送和接收都显著为正。环境宜居对发送效应有正向影响。
- 社区 B 的互惠和传递性显著为正,公共服务对发送和接收都有明显的正向影响。
- 社区 C 的互惠和传递性显著为正。公共服务对接收为正、对发送为负。创新对发送和接收都为正。正文把社区 C 对应长三角。
- 社区 D 的互惠为正。经济发展的系数为 9.2244,通过 1% 显著性检验;图 8(d)把约 9.22 的正系数标在接收效应上。公共服务对发送效应为负。
- 社区 E 的边、互惠和传递性分别为 −15.8983、4.9693 和 15.6592,正文写明三项都通过 1% 显著性检验。图 8(e)对这三项标出三颗星。公共服务对接收效应显著为正。
- 社区 F 的互惠和传递性为正。公共服务和环境宜居对接收效应显著为正。
六个社区的距离都抑制联系,稳定性系数都为正。全国模型里创新接收为负,长三角所在的社区 C 却报告创新的发送和接收都为正。同一个指标的方向已经随空间范围改变。图 8 能支持这种异质性。它不能在缺少地名的情况下,把 A、B、D、E、F 改写成具体城市群。
讨论还把 2019–2023 年的起伏放回疫情语境:2022 年流动强度明显下降,跨区域联系弱于近距离联系,而整体网络结构相对稳定,这与稳定性系数相符。长距离变短、近距离成团,是作者对格局的解读。TERGM 没有放入疫情变量,所以稳定性系数不能单独鉴定为疫情冲击的大小。
结论可以说到哪里
指数记录相对强度。它不区分出行目的和人群,也不能换成搬家人数。模型进一步把强度收成联系的有无,阈值未写明,所以系数解释的是被计入的有向城市对。
互惠、传递性、地理距离的负向关联,以及加入时间后的稳定性,在主模型和自助法里方向一致。经济接收效应在全时段模型、2023 年模型和自助区间里都为正。创新接收效应在全时段设定里为负,只在 2023 年静态模型里变为正。公共服务和文化旅游在模型 4 里显著,自助区间跨过 0,发送效应还随模型逐步加入变量而改号。
无标度的证据是排序曲线和前五城份额,不是一个报告出来的幂律指数。讨论里提到的小世界特征,本文没有给出平均路径长度或集聚系数。社区算法的名称、熵权的反向处理、距离单位,正文都没有写全。作者也说明,大数据仍难分辨流动类型,制度因素如人才政策尚未进入模型,TERGM 不能还原个人如何做决定。
一句话总结
2019–2023 年这 296 座城市之间,一条城际联系会不会出现,既跟着经济、公共服务和距离走,也跟着互惠、三角结构和上一年已经存在的边走;创新并不是全国统一的流入磁铁,不同社区的驱动方向也不相同。
核心来源
- Zhang, B., Li, H., & Yin, J. (2026). Uncovering the endogenous dynamics of intercity population mobility: Evidence from urban networks in China. Sustainable Cities and Society, 149, 107727. https://doi.org/10.1016/j.scs.2026.107727
- 城际流动强度使用高德实际迁徙指数,https://report.amap.com/migrate/page.do。论文写明数据匿名,不代表实际流动人数,且数据需向作者申请。
- 城市年均气温来自中国气象数据网,https://data.cma.cn/;社会经济指标来自《中国城市统计年鉴》。
- 资助为国家社会科学基金重点项目 21ARK003。
- 文中图 1–8 与附录三图分别来自原文 Fig. 1–8 和 Appendix A1–A3。
作者介绍
以下只写论文署名机构和贡献声明,不补充论文以外的头衔。
- Bin Zhang:吉林大学东北亚研究学院。负责初稿、可视化、形式化分析和数据整理。
- Hui Li:吉林大学东北亚研究院,通讯作者,论文所列地址为长春市前进大街 2699 号。负责审阅修改、获取资助和概念设计。
- Jian Yin:贵州财经大学中国西部现代化研究中心。负责验证、方法和概念设计。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
稳定性系数很大,而 2022 年被画出的强线路又明显变少。若模型记录的是联系还在不在,地图记录的是指数高不高,同一次限制就可能把许多线路的强度压过 100.905,同时留下城市对本身。只看网络还连着,会低估出行量的下降;只看最粗的那几条线消失了,会把一条暂时变弱的走廊当成关系已经解除。下一步值得把“边还在不在”和“指数下降了多少”分成两张表,看 2022 年消失的是长距离弱联系,还是枢纽之间的强联系。
社区 C 的创新发送和接收都为正,全国模型的创新接收却为负。把专利和科技支出当成各地通用的流入杠杆,会和这组分社区结果冲突。也可能是经济、公共服务已经吸走了创新指标里的共同部分,剩下的创新综合分不再提供额外的接收优势。要分辨这两种可能,需要换一种创新指标,或在同一社区里比较“只放经济”和“经济加创新”的接收系数。在做完这一步之前,全国负系数还不能被写成创新阻碍人口进入。
互惠同样可能混有不同的出行。相邻大城市之间的周末往返,会在年度指数里留下双向边;以定居为目的的搬迁,未必在下一年形成反向边。模型 4 在控制稳定性之后,延迟互惠为负,至少提醒:今年的单向联系,并不自动在明年换来回访。若政策把互惠系数直接当成两城居民互相落户的证据,就需要先按停留时间或出行目的拆开指数。拆开之后互惠仍在,才更接近作者想讨论的城市合作;拆开之后只剩短途往返,这个系数描述的就是循环出行。