白天遇见的收入混合,是住在哪决定的,还是走到哪决定的?
论文名片|Zhuangyuan Fan、Becky P. Y. Loo、Fabio Duarte、Carlo Ratti、Esteban Moro,Latent patterns of urban mixing in mobility analysis across five global cities,Nature Cities,2026,accepted。页眉写明预印本上传于 10/04/2026。作者给出的汇总数据仓库为 github.com/brookefzy/social-mixing-5-city。同一研究于 2026 年 7 月 22 日在 Nature Cities 开放获取发表,题目为 Hidden patterns of urban mixing across five global cities,页面为 nature.com/articles/s44284-026-00477-1。下面的图表和数字按接受稿核对。研究类型是五城出行调查的观察比较,辅以回归和图神经网络预测。
早上离开家,中午在办公区吃饭,傍晚去超市。这一天能不能遇到不同收入的人,要看停留点上还有谁。手机轨迹通常只留下位置。收入、年龄和家里有没有孩子,往往靠小区中位数、学校或房屋类型来猜。紧凑的香港里,不同收入的人可以住得很近;芝加哥的居住隔离则常常连片。同一个住址标签,在两座城市里的误差不会一样。
波士顿、芝加哥、香港、伦敦和圣保罗的官方出行调查把记录倒过来:受访者自己报告家庭收入、年龄、性别和家户构成,并写下工作日行程。同一批行程,用自报收入和用住址收入中位数,算出的白天混合并不相同。人走到哪里,又比住在哪里更能留下混合上的差别。混合指数接近,仍然可以对应两套互不重叠的去处。
先说结论
- 同一批行程改用住址的收入中位数后,白天社会混合平均低 16%。芝加哥用自报收入得到的白天混合,比用普查区估计高 12%;论文把该市夜间社会混合写在大约 58%。
- 17 岁以上的人里,波士顿、芝加哥和圣保罗的低收入组白天混合低于中间收入组,香港和伦敦的组间差距较小。12–17 岁低于 18–24 岁。65–74 岁相对 55–64 岁,在业或学习组高 0.75%,对照的非在业组高 0.83%。21–45 岁有照料责任的女性,混合降幅在五城介于 1.0% 到 6.5%,男性介于 0.5% 到 2.3%。
- 在解释白天混合的回归里,目的地场所暴露占模型预测力的 50% 到 69%。社会人口因素在芝加哥占 12.5%,在波士顿占 8.9%,在其余三城低于 5%。家在主要车站 20 公里以内时,目的地暴露占 50% 到 79%;住得更远时,社会人口因素最高约占 76%。
- 模型 1 中,公交出行比例的系数从圣保罗的 0.107 到波士顿的 0.337,五城都为正。加入场所暴露后,波士顿、芝加哥和圣保罗的系数明显变小,香港从 0.140 降到 0.127,伦敦从 0.167 降到 0.128。这是控制变量后的关联。
- 活动空间嵌入对场所暴露向量的预测,远强于居住空间和人口属性。只用一个收入组训练再迁到其他收入组,活动空间的准确率损失 2% 到 7%,居住空间损失 12% 到 19%。混合水平可以接近,到访结构仍然按收入分开。
手机轨迹为什么会把人的收入看偏?
人类移动性(human mobility)在这里指人在城市里的日常移动,包括通勤、购物和办事,不是户口或居住地迁移。经验社会混合(experienced social mixing)指一个人在移动过程中遇到的人有多多样。论文关心的多样性按家庭收入分成四组,地点上的共处被当作混合。共处是身体出现在同一地点。交谈、同行或握手只是之后可能发生的事,调查日记记不到。
过去十年的隔离研究多用手机或交通卡的精细轨迹,收入和年龄却从估计的家、出租屋、学校或长者住所来推。这种代理在美国城市里已经很常见。到了香港这类高密度城市,不同收入和族裔的人住得很近,用地又混杂,手机点很难稳定地认出学校或保障性住房。作者因此改用官方出行调查:空间和时间没有手机轨迹那么细,但收入、年龄、性别、就业、车辆和行程是同一个人自己报告的。
官方调查也有不回答和少报。专业机构提供了扩展系数,用来把样本加权到人口。加权能改善受访者代表性。它不能自动保证每一段行程上的暴露都被等精度测量。作者说主要结论在加权和不加权、以及考虑停留时间之后仍然成立;那些对照表在补充材料里。
五座城市各访问了谁?
城市范围故意不切成市中心一小块。波士顿用马萨诸塞州内的都会统计区,芝加哥用伊利诺伊州内的都会统计区,伦敦用大伦敦,圣保罗用都会区,香港用整个特别行政区。调查发表于 2011 年至 2018 年,采集年份更早,而且彼此错开:波士顿 2009–2011 年,香港 2010–2011 年,伦敦 2012–2014 年滚动调查,芝加哥 2017–2018 年,圣保罗 2017 年。跨城差别因此同时包含城市形态和年份。
五份调查都有个人和家庭编号、家的位置、以当地货币计的家庭收入、年龄、性别、就业、出行目的、起止时间、距离、交通方式和扩展系数。原始地点单位不同:波士顿是普查街区,芝加哥是普查区,香港是小街块,伦敦和圣保罗有坐标。伦敦把一次出行里的停留叫 stage,香港用行程段(leg)。计算统一到行程段,再投到六边形。
| 城市 | 调查 | 采集年 | 户数 | 受访人数 | 同年人口(百万) | 加权后人数(百万) |
|---|---|---|---|---|---|---|
| 波士顿 | Massachusetts Travel Survey | 2009–2011 | 10,785 | 26,770 | 4.24 | 4.03 |
| 芝加哥 | My Daily Travel | 2017–2018 | 12,391 | 30,683 | 5.17 | 6.67 |
| 香港 | Travel Characteristics Survey | 2010–2011 | 35,401 | 101,385 | 6.88 | 6.31 |
| 伦敦 | London Travel Diary | 2012–2014 | 24,248 | 57,640 | 8.6 | 8.95 |
| 圣保罗 | São Paulo Travel Diary | 2017 | 31,847 | 86,318 | 21 | 16.7 |
表 2 的受访人数相加是 302,796,与方法部分的原始人数一致。其中 209,817 人至少报告了一次出行。299,955 人有家庭收入,占全部受访者的 99.06%。摘要里的“超过 20 万居民”和讨论里的“超过 20 万份出行日记”,对应的是至少有一次出行的这一层,不是后面每张图的回归样本。
正文写,相对调查当年的本地人口,覆盖率在 0.29% 到 0.53%。用表 2 的受访人数除以表中人口,五城大约从圣保罗的 0.41% 到香港的 1.47%,对不上这个区间。覆盖率的分子没有单独给出,这里不把两套数字合成一个覆盖率。加权后的人数以百万计,接近表中人口,说明扩展系数的目标是把样本扩到人口规模。
采集方式也不同。波士顿用电话招募,邮件或电话回收日记。芝加哥以网页为主,可用手机应用记录。香港是自填问卷,需要时可以面访。伦敦是入户面访。圣保罗用平板,在道路、车站、机场和地铁站等地点访问,并分开市内与对外出行。比较的是这些调查能够对齐的收入、行程和地点,不是同一种抽样过程。
家的位置被对到当地较小的普查式单元,用来核对人口和收入:波士顿 1,471 个普查区,芝加哥 2,014 个,伦敦 1,141 个中层超输出区,香港 289 个三级规划单元,圣保罗 517 个研究区。单元面积中位数从香港约 2.1 平方公里到波士顿约 7 平方公里。
兴趣点来自 OpenStreetMap,原始标签 2,688 个。作者先用 ChatGPT 的 4o 接口归类,再人工核对,分析中保留 18 类,去掉住宿、农业、建造、工业、公用设施和“其他”。稳健性另用 SafeGraph、香港地理数据、Digimap 和 Google Places,正文只说主要结果方向一致。车站也来自 OpenStreetMap,2024 年 3 月下载,共 82,362 个公交站和 1,624 个火车站。车站开通年同样借助 4o 接口检索地方交通部门、百科和报道;63 个在调查期间或之后才启用的火车站被剔除。公交站找不到开通年,全部保留。家到车站的路网距离用 OSRM 计算。1 公里以内的火车站或 800 米以内的公交站,算作可到达。
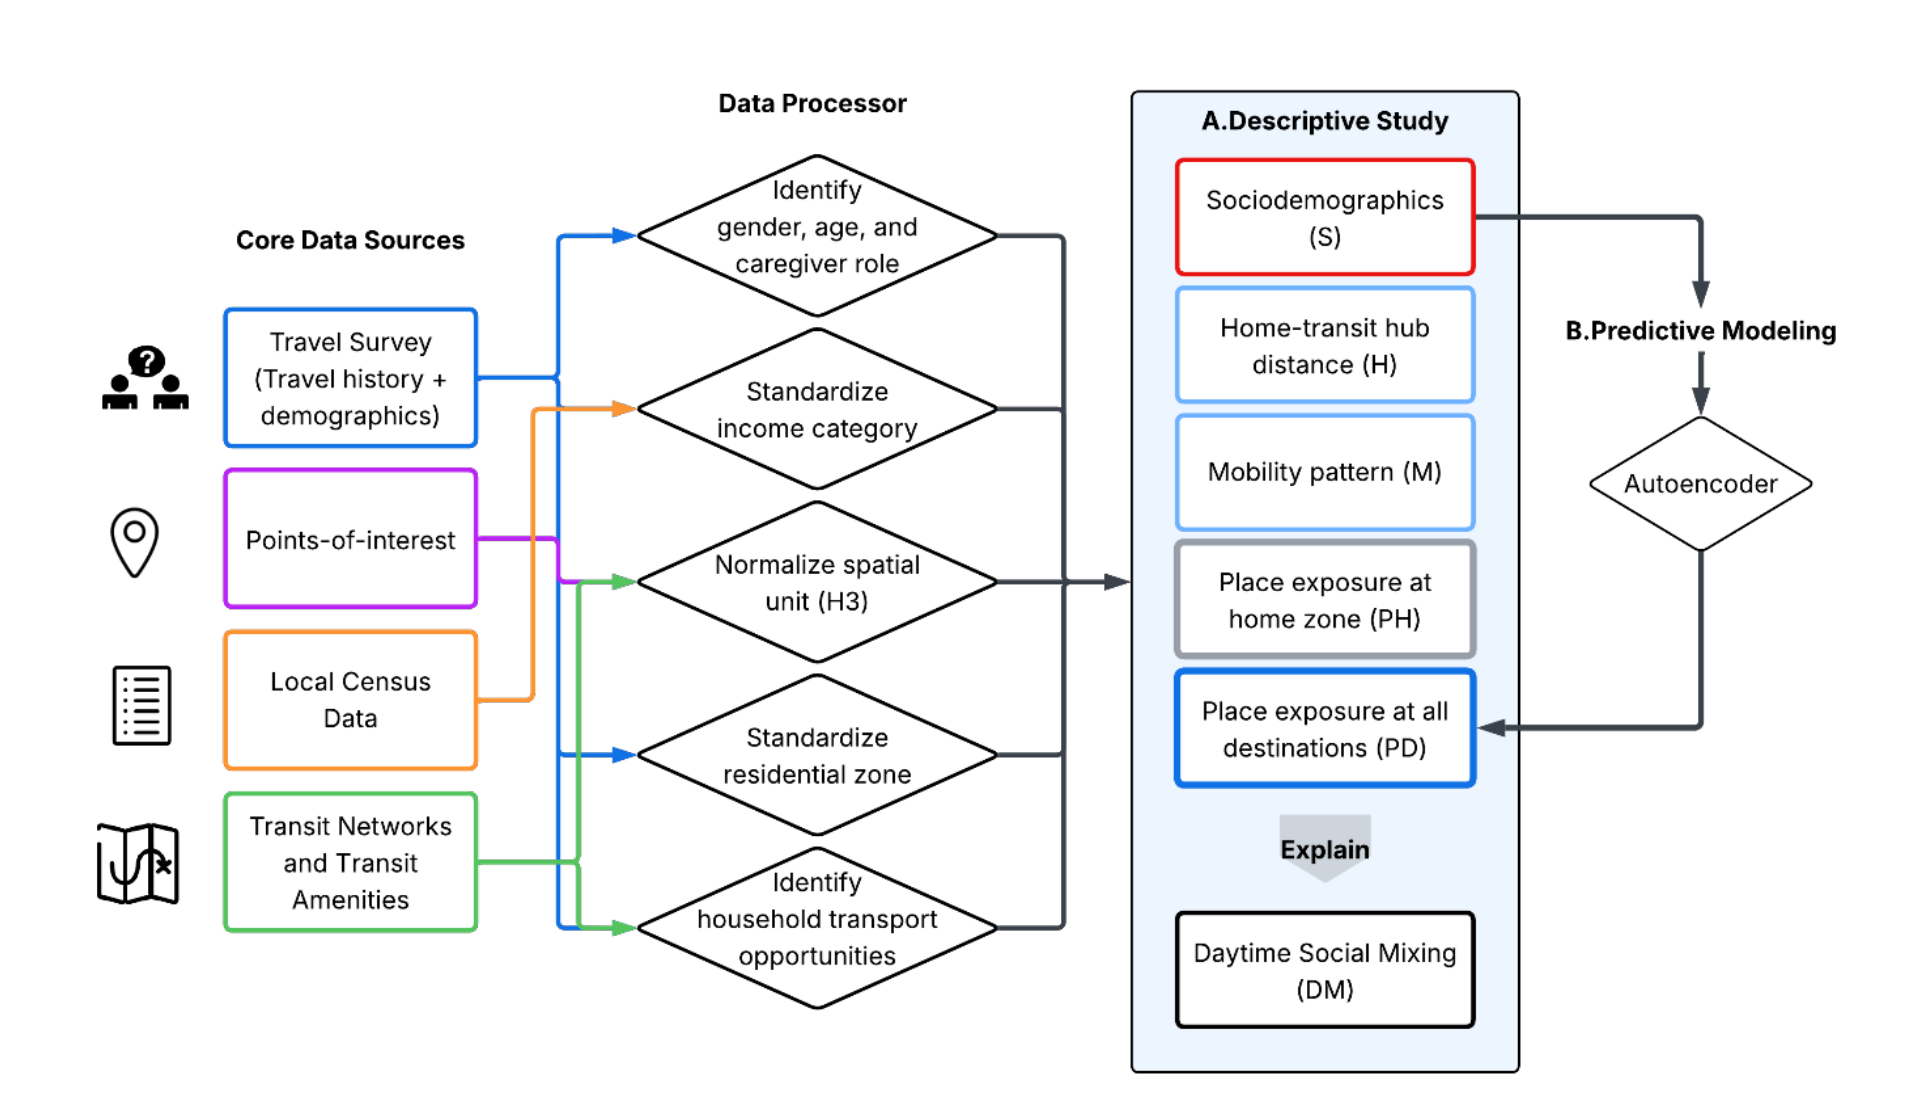
图 E1|从调查、兴趣点、普查和交通网,到白天混合和场所暴露,数据怎样汇合?
左侧四类输入是出行调查、兴趣点、当地普查和交通网络。中间把性别、年龄和照料角色辨认出来,把收入分成组,把地点收成 H3 六边形,把居住区对齐,并计算家里的交通机会。右侧描述部分用这些变量解释白天混合:社会人口背景 S、家到枢纽的距离 H、出行方式 M、家附近的场所暴露 PH、全部目的地的场所暴露 PD。预测部分把 S、PH 和 PD 送进自编码器。这张图是流程示意,没有样本量和拟合数字。来源:原论文 Fig. E1。
白天混合怎么从停留点算出来?
白天社会混合(daytime mixing,记作 DM)改自 Moro 等人 2021 年的收入隔离测量。它问的是:不计返家行程,一个人当天停留过的地点上,四组收入的人是否接近一样多。
每座城市先按自报家庭收入排序,分成低、中低、中高、高四组。加上扩展系数后,四组比例大体接近。地点统一用 H3 六边形。主分析是第 8 级,平均边长约 0.53 公里,作者将它比作美国普查区的尺度。设 τiα 是个人 i 在地点 α 的停留占本人当天全部停留的比例,ταq 是地点 α 的全部停留中收入组 q 所占的比例。个人 i 对组 q 的相对暴露是各地点这两项的乘积之和:τiq = Σα τiα ταq。四组的 τ_iq 因此是停留加权后的遇到比例。
正文把公式(1)印成 DM_i = (2/3) Σ_q |τ_iq − 1/4|。四组完全均匀时,每一项偏差都是 0,这个印刷公式得 0。只遇到一个组时,绝对偏差之和是 1.5,乘以 2/3 正好是 1。2/3 的作用,是把这个最大偏差缩放到 1。紧接着的句子却写:DM = 1 表示全天均匀遇到各组,DM = 0 表示只遇到和自己同一收入组。图 1 也把更高的百分比标成 Mixed。后文的 16%、年龄曲线和大约 58% 的夜间混合,都按越高越混合来写。Moro 等人的原指标把 1 留给只接触一个组。阅读下面的图时,沿用本文图和结论的方向:百分比越高,四组越接近各占四分之一。若把印刷公式的 0 和 1 直接套进这些百分比,方向是反的。
作者还换过停留定义、五分组、加权、估计的相遇时间,以及 H3 第 4 到第 10 级和各城原有普查边界。正文给出的机械关系是:六边形越大,同一格里算作共处的人越多,每个人的混合水平会上升。跨城比较因此先要把格子对齐。换格子以后主要发现是否保持,正文说见补充图,这里不补写未见的数值。
换成住址收入以后,混合低了多少?
对照很具体。行程不变,只把每个人的收入组从自报家庭收入换成家所在普查单元的收入中位数,再重算 DM。这检验的是代理变量会不会系统性压低混合,不是两种收入谁更真实。
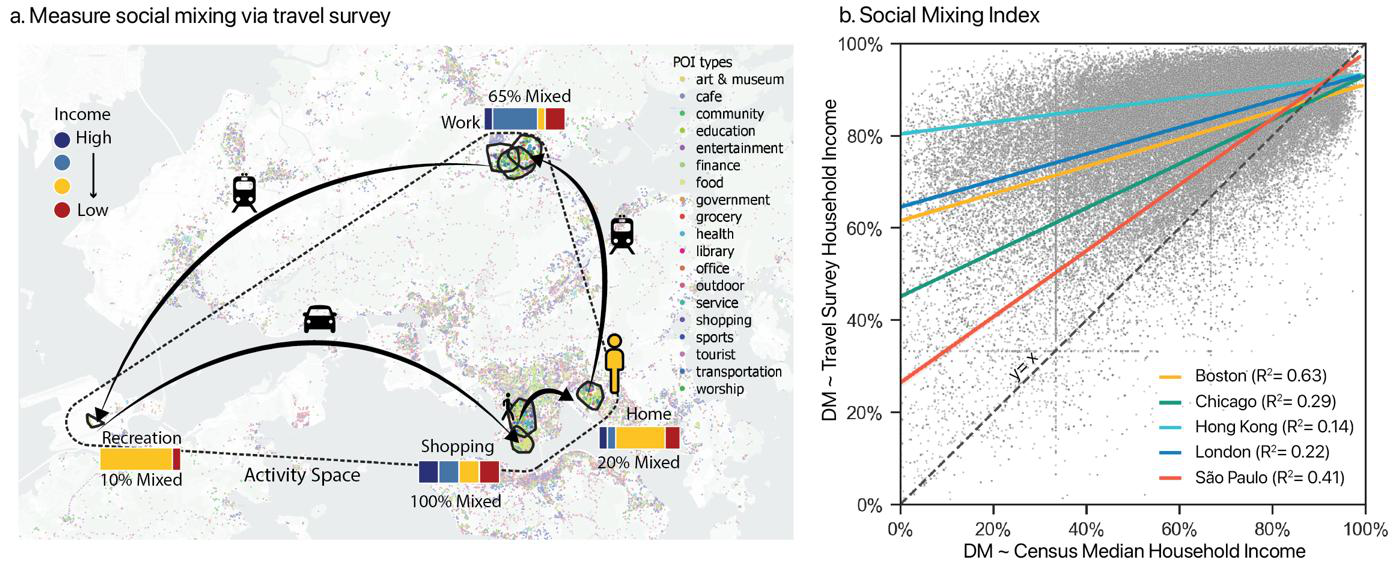
图 1|自报收入和住址收入中位数,给出的白天混合差在哪里?
(a)示意一个人离开家之后的活动空间:休闲、购物、工作和家被标上不同的混合百分比,颜色区分高、中、低收入,右侧是兴趣点类别。10%、65%、20% 和 100% 是这张示意图上的标注,不是五城的统计结果。(b)每个点是一名受访者。横轴是用普查区家庭收入中位数算出的白天混合,纵轴是用出行调查自报收入算出的白天混合,虚线是 y = x。五条实线是分城市的普通最小二乘拟合。图例给出波士顿 R² = 0.63,芝加哥 R² = 0.29,香港 R² = 0.14,伦敦 R² = 0.22,圣保罗 R² = 0.41。线在虚线上方,表示同样的行程下,自报收入算出的混合更高,低混合一端抬得更明显,高端才靠近 100%。散点很多,香港的 R² 只有 0.14,两种算法即使平均方向一致,也不能互相替换。来源:原论文 Fig. 1。
图 1b 只包括 11 岁以上、调查日至少出行一次的人:波士顿 7,626,芝加哥 18,258,香港 33,289,伦敦 30,381,圣保罗 46,957,按图注相加为 136,511。论文写,换成住址收入后 DM 平均下降 16%。芝加哥的自报结果比普查区估计高 12%,同时把这座以居住隔离著称的城市的夜间社会混合放在大约 58%。16% 是这次替换的平均降幅,12% 是芝加哥单独的高低差,58% 是夜间混合的水平。三个数的分母不是同一件事。正文没有列出逐城的 16% 分子。
夜间混合在图 1 里没有单独的五城面板。图题提到白天和夜间,面板 b 画的仍是两种白天混合。58% 不能读成“58% 的芝加哥人被隔离”,也不能当成五城的夜间平均值。
年龄、工作和照料责任,会把混合拉开吗?
收入之外,调查能直接给出年龄、性别和家户构成。手机研究常用到访学校来猜年龄或育儿,这里不用那一层代理。
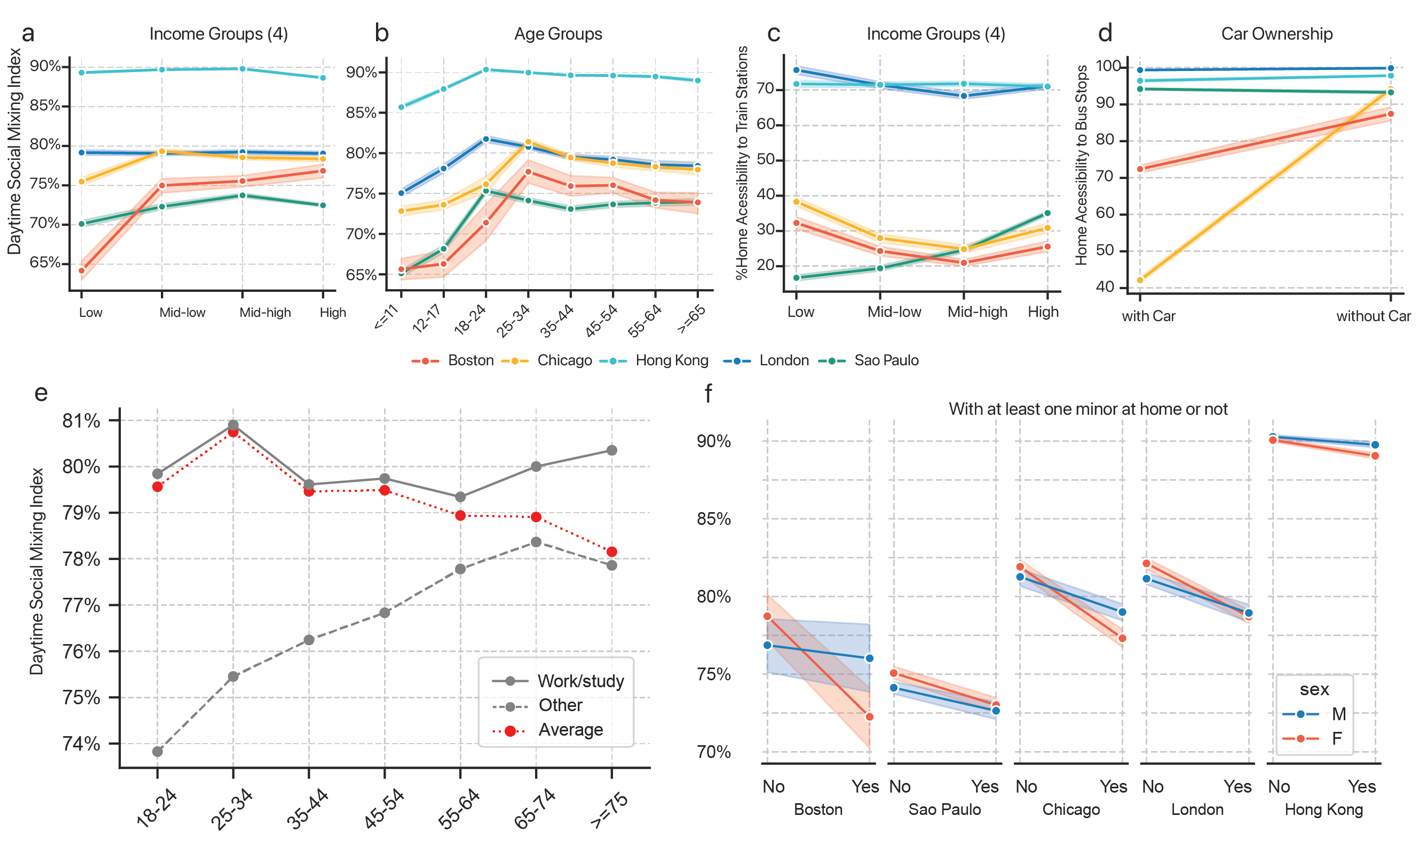
图 2|收入、年龄、车站、车辆和照料责任,各自对应怎样的白天混合?
(a)17 岁以上,纵轴是白天混合,横轴是四个收入组。实心点是组均值,色带是 95% 置信区间。波士顿 n = 5,894,芝加哥 n = 15,738,圣保罗 n = 40,896,低收入组低于中间组;香港 n = 51,619,伦敦 n = 30,277,组间差距较小。香港整体最高且平,圣保罗整体更低。香港这个 51,619 大于图 1 的 33,289,图注只写了年龄大于 17 岁,没有再写“至少出行一次”。两张图不能当成子集关系。(b)按年龄和城市看 DM。12–17 岁低于 18–24 岁。芝加哥和波士顿的高点在 25–34 岁,其余三城更早,在 18–24 岁。图中还有 11 岁及以下和 85 岁及以上,样本数没有单独给出。(c)家里能够到达火车站的比例,按收入组。香港和伦敦各收入组都高而且接近。芝加哥和波士顿是低收入与高收入两端较高、中间较低。圣保罗随收入上升。(d)家里能够到达公交站的比例,按有没有车。芝加哥和波士顿有车的家庭更低;香港、伦敦和圣保罗几乎不随有车与否变化。(e)五城合并,按年龄和工作状态。红色点划线是平均,随年龄先升后缓降,65–74 岁相对 55–64 岁回升。实线是在业或学习,虚线是其他人。纵轴大约只跨 74% 到 81%,回升发生在已经较高的区间里。(f)21–45 岁,横轴是家里有没有至少一名未成年人,蓝线为男性,红线为女性,色带仍是 95% 置信区间。五城“有”的一侧都低于“没有”。样本为波士顿 2,064,芝加哥 8,365,香港 25,594,伦敦 15,394,圣保罗 20,227,相加 71,644。来源:原论文 Fig. 2。
论文把 65–74 岁相对 55–64 岁的回升,当作“第二青春”或“第三年龄”的数据支持。摘要写的是 66 岁以上高于临近职业生涯晚期的 55–65 岁;图上的操作分组是 65–74 岁对 55–64 岁。在业或学习组上升 0.75%,对照的非在业组上升 0.83%。在业或学习包括全职、兼职、学生和家务,家务不在对照组里。两组在年轻时差距更大,在业或学习的人平均混合更高。分城市、换一种混合算法之后,作者说五城都是退休年龄组维持在相近的高位或继续上升。0.75% 和 0.83% 是五城合并后的小幅上升,不是从隔离跳到充分混合,也不是每个人退休后都会多遇见其他收入组。
照料者的操作定义是:本人大于 21 岁,家中至少有一名 18 岁以下、而且比本人至少小 18 岁的成员。21–65 岁的参与者有 195,710 人,其中 35.6% 被标为可能的父母,加权后为 38.1%。再按家中成年人数,5.9% 被标为单亲,加权后为 9.6%。父母里当天至少出行一次的占 66%,加权后为 67.8%。没有出行的人进不了白天混合。图 2f 的降幅是 21–45 岁出行者里,有未成年人和没有未成年人的差别。
论文写,就报告的性别而言,男性和女性的混合水平相当。差别出现在照料责任上:有照料责任的女性,混合降幅跨城市为 1.0% 到 6.5%;男性为 0.5% 到 2.3%。逐城检验在补充表里。作者认为这可能和职业早期的流动约束、家庭责任有关,并把它放到常被称作漏斗式流失的性别差距旁边。这句话需要别的研究才能和结构性障碍分开。图 2f 本身只支持:在这五个城市的 21–45 岁样本里,有未成年人的一侧混合更低,女性的降幅范围更宽。
走到的地方,比身份更能解释混合吗?
描述之后,回归把个人的白天混合放到五组变量上。分析单位是个人。
社会人口背景 S 包括收入、年龄、性别、照料责任、就业、车辆和家附近的公交可达性。家到枢纽的距离 H 是家所在区域到主要交通枢纽的路网距离。枢纽按 Roth 等人的做法,用清晨 6 点到 11 点的加权到达量排序。单中心只取到达量最高的一个六边形;多中心取累计至少占到达量 60% 的前若干站。这样波士顿和圣保罗不必被当成同一种市中心。
目的地场所暴露 PD 是一个人当天各目的地在步行 T 分钟范围内、按类别计数的兴趣点,再对目的地取平均。主分析 T = 15,另测 5 分钟和 10 分钟。家附近的场所暴露 PH 用同一套类别,范围换成家周围的步行等时圈。出行方式 M 是公交或私人交通占行程的比例。模型写成 DM = {S} + {H} + {PD} + {PH} + {M}。
相对重要性用 LMG 分解。它把这个回归已经具有的预测力分成各组的份额,份额加总为 100%。它不是每一组单独回归的 R²,也不能把份额读成因果贡献。
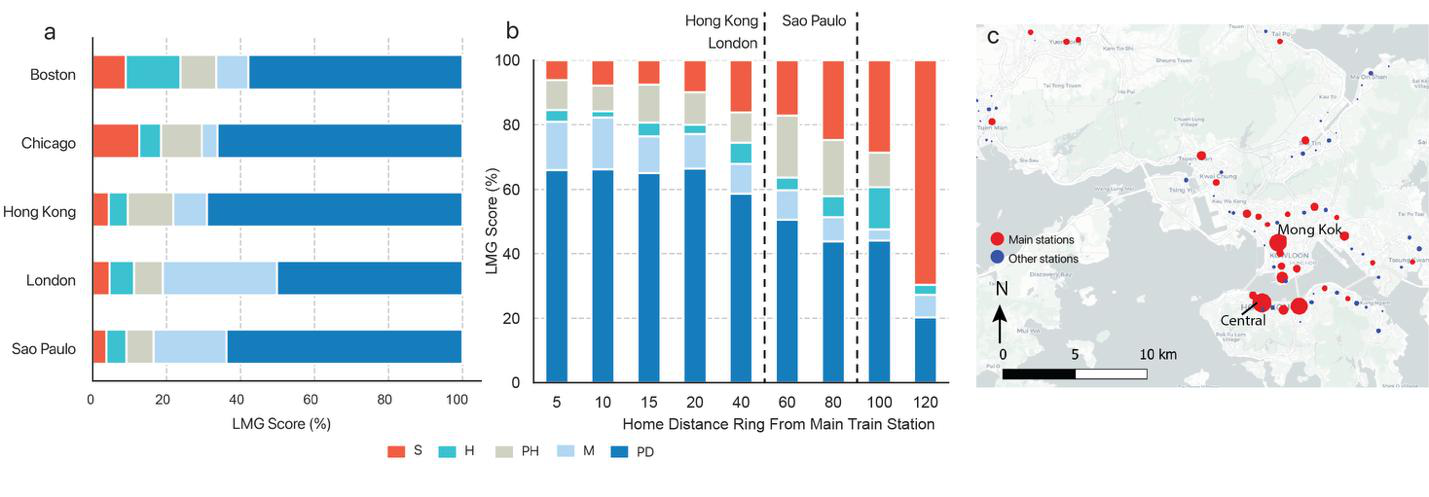
图 3|目的地、身份、家和车站距离,各解释白天混合的哪一截?
(a)五座城市的 LMG 份额。红色 S 是社会人口,青色 H 是到枢纽的距离,灰色 PH 是家附近的场所暴露,浅蓝 M 是出行方式,深蓝 PD 是目的地场所暴露。五城都是深蓝最长。正文给出的范围是 PD 占预测力的 50% 到 69%;S 在芝加哥为 12.5%,波士顿为 8.9%,香港、伦敦和圣保罗低于 5%。(b)把五城的人按家到最近主要车站的距离环重新平均。横轴从 5 公里到 120 公里。20 公里以内,PD 占 50% 到 79%。更远的环里 S 变长,最高约 76%。虚线标出城市尺度,近处标了香港、伦敦和圣保罗。这是五城平均,单城见补充图。(c)香港车站示意。圆的大小是清晨 6 点到 11 点的加权进站量,红色是主要站,蓝色是其他站,比例尺 0 到 10 公里。它说明枢纽如何从客流里挑出来,不直接给出混合数字。来源:原论文 Fig. 3。
住在枢纽 20 公里以内的人,混合更跟着当天的目的地走。住得远,收入、年龄和工作等身份变量的份额升高。作者同时提醒自我选择:住在车站附近的人,可能本来就和住得远的人不同。距离上的相关,不能写成新修一条铁路就会提高混合。
回归样本又是一套人数。表 1 为波士顿 7,623,芝加哥 18,257,香港 42,736,伦敦 30,382,圣保罗 46,957,相加 145,955。前四城与图 1 只差几人,香港的 42,736 则既不同于图 1 的 33,289,也不同于图 2a 的 51,619。后面的系数只描述表 1 这 145,955 人。
公交带来的混合,有多少跟着目的地走?
图 2c 和 2d 先说明车站机会本身就不均匀。香港和伦敦各收入组到火车站的比例都高。芝加哥和波士顿两端收入组更高。圣保罗收入越高,到火车站的比例越高。有车的芝加哥和波士顿家庭更少住在公交站附近;香港、伦敦和圣保罗的公交站可达性几乎不随家中有没有车变化。
控制 S 和 H 之后,公交行程比例在五城都和更高的 DM 同向。作者把模型 1 概括为:公交行程比例增加 1%,白天混合增加 0.1% 到 0.3%。表上的模型 1 系数确实从 0.107 到 0.337。私人交通的系数更小,符号则有正有负,不能概括成五城开车都会降低混合。
| 城市 | 样本 | 公交,模型 1 | 公交,模型 2 | 私人交通,模型 1 | 私人交通,模型 2 | R²,模型 1 | R²,模型 2 |
|---|---|---|---|---|---|---|---|
| 波士顿 | 7,623 | 0.337(0.016) | 0.091(0.013) | −0.022(0.007) | 0.027(0.006) | 0.3448 | 0.5677 |
| 芝加哥 | 18,257 | 0.142(0.012) | 0.044(0.011) | 0.031(0.000) | 0.064(0.000) | 0.1077 | 0.3001 |
| 香港 | 42,736 | 0.140(0.005) | 0.127(0.005) | 0.076(0.000) | 0.075(0.000) | 0.0724 | 0.2877 |
| 伦敦 | 30,382 | 0.167(0.004) | 0.128(0.004) | −0.066(0.000) | −0.049(0.000) | 0.1428 | 0.2208 |
| 圣保罗 | 46,957 | 0.107(0.002) | 0.060(0.002) | 0.008(0.000) | −0.003(0.000) | 0.1122 | 0.2899 |
模型 1 含 S、H 和出行方式,不含场所暴露。模型 2 加入 PD 和 PH。括号是稳健标准误,系数都标了 p < 0.001。芝加哥、香港、伦敦和圣保罗的私人交通标准误在表中印成 0.000,只说明它小于 0.0005。表注把家附近的场所暴露写成 PD+HD,控制行和公式用的是 PH;这里按 PH 理解。
加入场所暴露后,波士顿的公交系数从 0.337 降到 0.091,芝加哥从 0.142 降到 0.044,圣保罗从 0.107 降到 0.060。香港只从 0.140 降到 0.127,伦敦从 0.167 降到 0.128。作者据此认为,在波士顿、芝加哥和圣保罗,公交与混合的关系有相当一部分来自公交送到了兴趣点更密、类别更多的地方;香港和伦敦的公交系数下降更少,因为设施在更大范围里已经比较密。与此同时,R² 仍然上升:波士顿从 0.3448 到 0.5677,芝加哥从 0.1077 到 0.3001,香港从 0.0724 到 0.2877,圣保罗从 0.1122 到 0.2899,伦敦从 0.1428 到 0.2208。香港的公交系数几乎不动,模型却多解释了一大截,说明场所暴露抓住的是公交系数没有吃掉的那部分差别。伦敦的 R² 上升幅度较小。这些都是横截面回归。系数变小表示统计上的共变被场所变量分走,不是一次开通公交的实验效应。
混合水平接近,是不是去了同一类地方?
PD 能解释混合,可 PD 本身是城市设施分布和人的移动叠在一起的结果。下一步换成预测场所暴露向量:每个维度是一类兴趣点在目的地步行范围内的数量,一共 18 维。调查并不知道人进的是哪一家店,只知道停留点周围 15 分钟步行范围内有哪些兴趣点。5 分钟和 10 分钟用来做稳健性。
作者先为每座城市建兴趣点网络。结果部分写超过 10 万个兴趣点和 1,270 万条边;方法部分给出 107,750 个兴趣点,并再次写 1,270 万条边。主网络把 15 分钟步行或公交能到达的兴趣点连起来,边权为 1 或 0。节点平均度从波士顿 33.6 到伦敦 230.9。同一段又写各城网络大约有 870 万到 3,970 万条边。1,270 万和 870 万到 3,970 万对不上同一次相加,这里并列保留,不合成一个边数。图神经网络把路网和兴趣点关系压成 32 维向量。两层网络先学习预测兴趣点自身的类别,再把这些向量交给后面的暴露模型。
居住空间嵌入是家周围 15 分钟步行等时圈内兴趣点向量的平均。活动空间嵌入是当天所有到访地点的凸包里,兴趣点向量的平均。凸包是包住全天轨迹的多边形,比停留点清单更大。人口嵌入包括年龄、性别和工作状态等。三个编码器的结果拼成潜变量 z,解码器做成 Ŷ = W_d z + b_d,输出 18 维场所暴露。训练和测试按 75% 与 25% 随机划分,重复 10 次取平均,每次都让各收入组的比例保持均衡。消融时把居住、活动或人口中的一路设为 0,看重构损失怎样变。
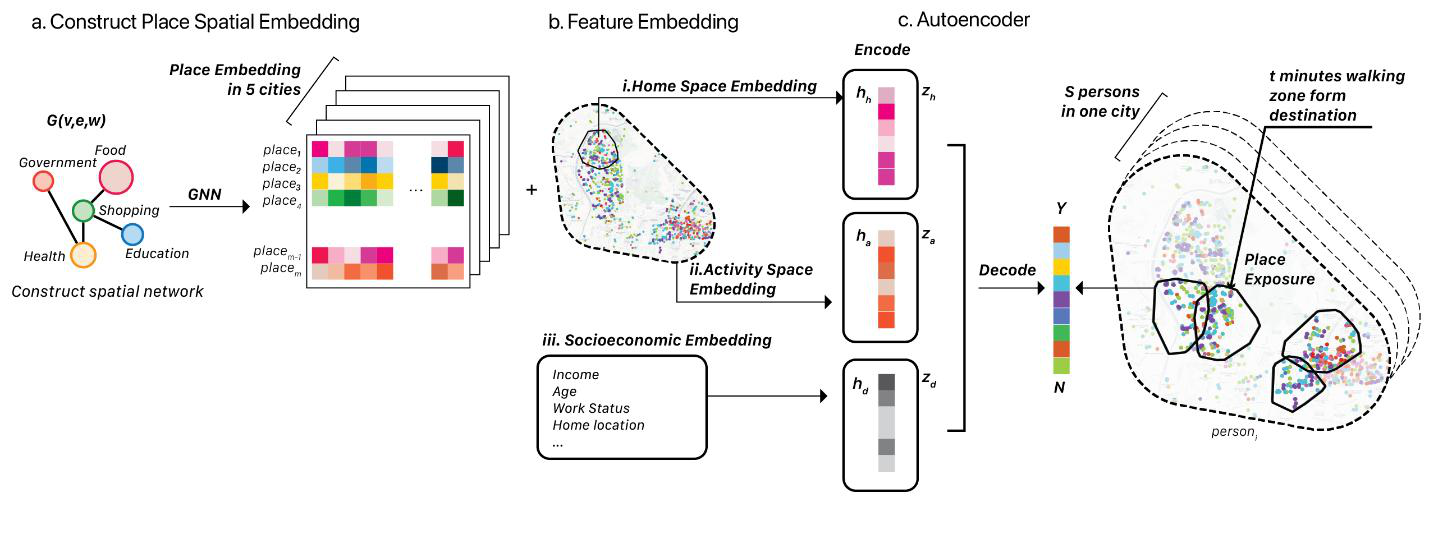
图 4|场所网络、三类嵌入和自编码器,各自放进什么、预测什么?
(a)用距离和出行时间把兴趣点连成网络,图神经网络把每座城市的兴趣点编成向量。五城各有自己的地点,嵌入维度是 32。(b)家周围 15 分钟步行圈里的兴趣点平均成居住空间嵌入;全天到访地点凸包里的兴趣点平均成活动空间嵌入;年龄、工作和性别等进入社会经济嵌入。(c)三段嵌入拼成 z,再解码成 N 维场所暴露。右侧示意一个人的活动范围和目的地周围 t 分钟步行圈。这是结构图,没有 R²。来源:原论文 Fig. 4。
活动空间嵌入和停留点上的类别计数在几何上相关,因为凸包盖住了这些停留点。作者强调两者不是一回事:预测目标是各停留点上、按类别计的潜在遭遇;输入是更大范围里的空间拓扑。模型因此不是把停留清单机械加总。这个区分是否站得住,要看换一组人之后预测会不会掉,而不是只看总体 R² 高不高。
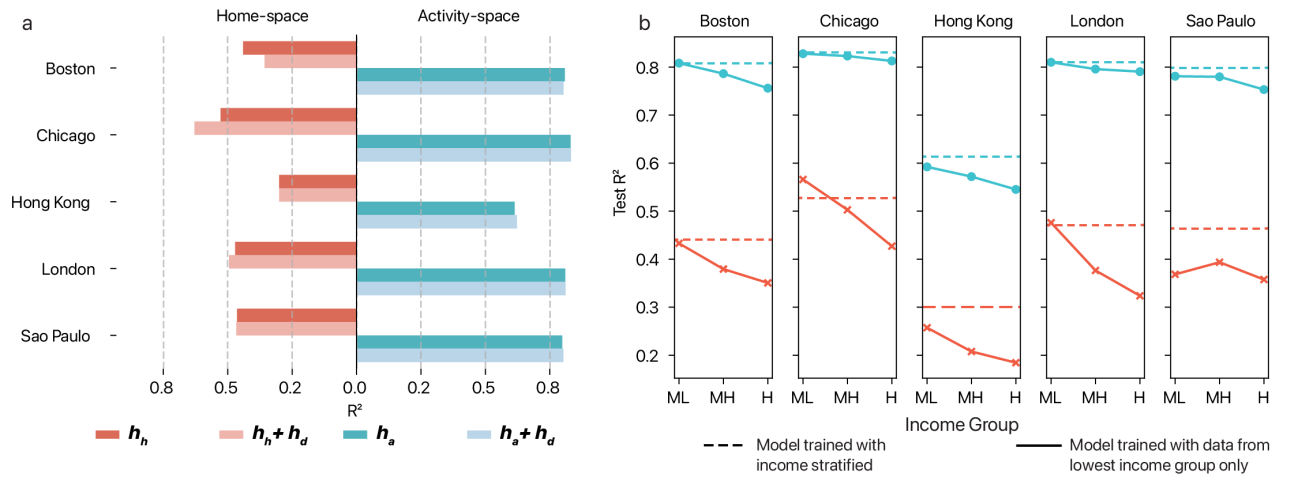
图 5|活动空间能否预测场所暴露,而且换一个收入组还成立吗?
(a)横轴是场所暴露向量里各类别 R² 的平均,左侧是居住空间,右侧是活动空间,左右都是越高越好。深色是单独使用该嵌入,浅色是再拼上人口属性。活动空间大约解释 60% 到 80% 的方差,正文同时又写五城平均 59%。这两个数不能互相推出,这里都保留。居住空间为 25% 到 45%,人口属性单独低于 10%。加上人口属性只有边际改进。平均 59% 低于所写区间的下沿,可能是措辞或计算口径不一致;没有补充图时,不能改写成一个确定的平均 R²。(b)虚线是按收入分层随机划分、75% 训练和 25% 测试的参照。实线只用最低收入组训练,再预测中低、中高和高收入组。青色是活动空间,红色是居住空间。活动空间下降较缓,准确率损失 2% 到 7%;居住空间损失 12% 到 19%。收入组离训练集越远,表现越差。香港的活动空间参照线低于波士顿、芝加哥、伦敦和圣保罗。来源:原论文 Fig. 5。
图 5b 的逻辑是:如果移动结构与收入无关,用一个收入组训练的模型应能预测其他组。准确率随收入距离下降,说明到访结构按收入分层。伦敦和香港的总体混合在图 2a 里已经比较平,迁移测试仍然掉点。因此,社会人口变量对个人混合的直接解释份额可以很小,不同收入组去的地方却仍然不同。相似的混合水平可以是两套平行的城市经验,而不是同一批场所里的共同遭遇。
这里的预测对象是场所暴露向量,不是 DM 本身。DM 的 50% 到 69% 来自前面的 LMG。把两步连起来,才得到论文的推断:移动比身份、居住环境和车站距离更能塑造经验混合。推断依赖这两套模型的并列,不是活动空间嵌入直接回归出了 DM。
这些结果能说到哪一步?
五城都看到目的地和活动空间的主导作用,收入梯度却不一样。香港和伦敦的低收入组与高收入组,白天混合差距较小。作者把它联系到更密的设施连接、更同质的公交使用,以及不同收入在枢纽和公共空间共处的机会。波士顿和芝加哥的车站更靠近低收入、少车的一侧。圣保罗的高收入组既更靠近火车站,也更有车,交通机会更不均。这是城市之间的描述,不是把交通系统指定为唯一原因。
边界跟在结果旁边,这里收拢。第一,扩展系数针对的是居民代表性。行程层面的暴露精度是另一件事。不回答和少报只能部分被加权缓解。第二,日记记录共处,不记录交谈。按出行目的再分,会更接近潜在互动,本文没有做到。第三,调查是工作日的横截面,各城年份从 2009 年到 2018 年,跨过不同的经济和基建阶段。周末、季节、疫情之后的行为,以及网约车和共享单车,都不在这些日记里。第四,住在车站附近可能是自我选择。第五,六边形变大就会机械抬高混合。第六,自编码器的高拟合说明凸包里的空间结构能够预测停留点周围的类别计数,同时迁移测试说明这种关系按收入分层。拟合不是机制证明,也不是唯一真实机制。第七,五座城市覆盖了不同大陆和收入背景,圣保罗已经在样本中。作者仍认为需要更多城市,尤其是更多发展中城市,才能检验这些关系是否普遍。
印刷公式与“1 表示均匀”的句子方向相反。这个读法上的冲突不影响图里“越高越混合”的比较,但任何复现都应先确认自己实现的是隔离指数还是它的补数。
一句话总结
在这五座城市的工作日日记里,白天遇到的收入混合更多跟着人走到的地方走,而不是跟着住址标签、身份或离车站多远走;不同收入的人仍可以混合水平接近、去处却彼此分开。
核心来源
Fan, Z., Loo, B. P. Y., Duarte, F., Ratti, C., & Moro, E. (2026). Latent patterns of urban mixing in mobility analysis across five global cities. Nature Cities, accepted. 预印本页眉日期 10/04/2026。
正式发表版:Fan 等,Hidden patterns of urban mixing across five global cities,Nature Cities,2026 年 7 月 22 日。https://www.nature.com/articles/s44284-026-00477-1
汇总数据仓库(作者写明论文接受后共享):https://github.com/brookefzy/social-mixing-5-city
白天混合所改写的测量:Moro, E., Calacci, D., Dong, X., & Pentland, A. (2021). Mobility patterns are associated with experienced income segregation in large US cities. Nature Communications, 12, 4633.
作者介绍
范庄媛(Zhuangyuan Fan)署名于香港大学地理系。她承担数据、分析、验证、可视化和初稿。论文致谢写明其博士阶段由香港研究生奖学金支持;香港大学学术库收录的 2025 年地理系博士论文署名为范庄媛,导师是卢佩莹。通讯信息称她为 Dr Zhuangyuan Fan,并由她维护上述数据仓库。
卢佩莹(Becky P. Y. Loo)是通讯作者,香港大学地理系教授,并任职于辽宁师范大学海洋可持续发展研究院。论文中她负责问题构思、数据、指导和写作。她的研究集中在公共交通、步行性与城市形态。
Fabio Duarte 署名于麻省理工学院 Senseable City Lab,参与数据、指导和修改。
Carlo Ratti 署名于麻省理工学院 Senseable City Lab 与米兰理工大学 ABC 系,参与数据、指导和修改。
Esteban Moro 署名于东北大学网络科学研究所与物理系,以及麻省理工学院媒体实验室。本文的白天混合改自他与合作者 2021 年的测量;文中他负责方法和指导。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
只公布一个城市平均混合指数,会把两套平行经验读成已经相遇。图 5 的迁移损失说明,最低收入组的活动空间嵌入,不能原样套到高收入组。伦敦和香港在图 2a 里收入组差距已经较小,迁移后仍然掉点。一个公交系统若只报告全网平均混合,这两座城市最容易被看成收入不再影响去处。考评至少要同时看:混合水平是否接近,以及一个收入组的活动空间能否预测另一个组的场所暴露。
家到主要车站 20 公里这条分界,也不适合直接写成选址公式。20 公里以内,目的地暴露占 50% 到 79%;更远时身份因素升到大约 76%。住得近的人可能本来就更常出门,工作地也不同。作者已经把这种自我选择标出来。要检验新车站,需要同一批人在开通前后的出行日记。再比较一次现在住得近和住得远的人,重复的仍是这条横截面。
21–45 岁、家中有未成年人的女性,混合降幅范围比男性更宽。若城市只统计通勤高峰的轨道客流,护送孩子的行程不会进入这个高峰。论文把家务放进在业或学习组之后,65–74 岁相对 55–64 岁也只上升 0.75% 和 0.83%,而且是在大约 74% 到 81% 的高位上。用这个回升支持延后退休或老年票价,超出了这两个数能承担的范围。
格子大小会改写混合。六边形变大,同格里的人变多,指数上升。别的城市若用行政区代替边长约 0.53 公里的 H3 第 8 级,再和这五城比“谁更融合”,比进去的会有一块格子面积。复现时应连同 15 分钟步行圈、四分组和返家行程的剔除一起复现,并先声明 0 和 1 哪一端表示均匀。