假期结束后,哪些人的出行改变了城市的联系?
论文名片|Hao Jiang、Qian Li、Xian Zhou、Yanqiu Chen、Shuwen Yi、Hai Wang、Zheng Lu,A collective human mobility analysis method based on data usage detail records,International Journal of Geographical Information Science,2017,31:2359–2381,2017年8月30日在线发表。DOI:10.1080/13658816.2017.1370715。
想象两个片区,春节期间各自内部活动,节后却有许多人跨区往返。地图上的行政边界没有动,但从出行联系看,它们可能已经更像一个整体。如果能找到这类联系结构的变化,能否反过来定位参与变化的人群?
这篇论文把手机数据使用记录变成基站之间的网络,比较春节与工作日的网络社区,再从变化的联系中寻找用户。它展示了一条从城市结构返回个体记录的分析路径。这里的社区是联系紧密的基站群,不是居民小区;找出的用户也不是已经核实的异常人员。
- 相比把一个人到过的全部地点两两连线,保留相邻访问地点之间的联系,更能区分访问顺序带来的差别。
- 社区变化可以转成节点之间“原先同组、后来不同组”的关系变化,避免把社区颜色或编号的改变误当成真实变化。
- 在按已知活动条件筛选的1.2万名用户评估集中,方法报告94.1%的精确率与86.7%的召回率;这两个分数不能直接推广到全市任意用户。
- 检测依赖社区尺度。地图与道路、地形相符提供解释线索,但不能单凭空间吻合确认出行目的或因果关系。
手机留下的是上网事件,不是连续行走轨迹
原始数据来自中国移动,覆盖贵州安顺六个行政区县,时间为2013年2月8日至28日,共21天。原论文表1列出275,465,112条记录、1,233,026名用户和3980个基站。这是原始数据规模,后面的检测分数来自一个小得多、经过筛选的评估集。
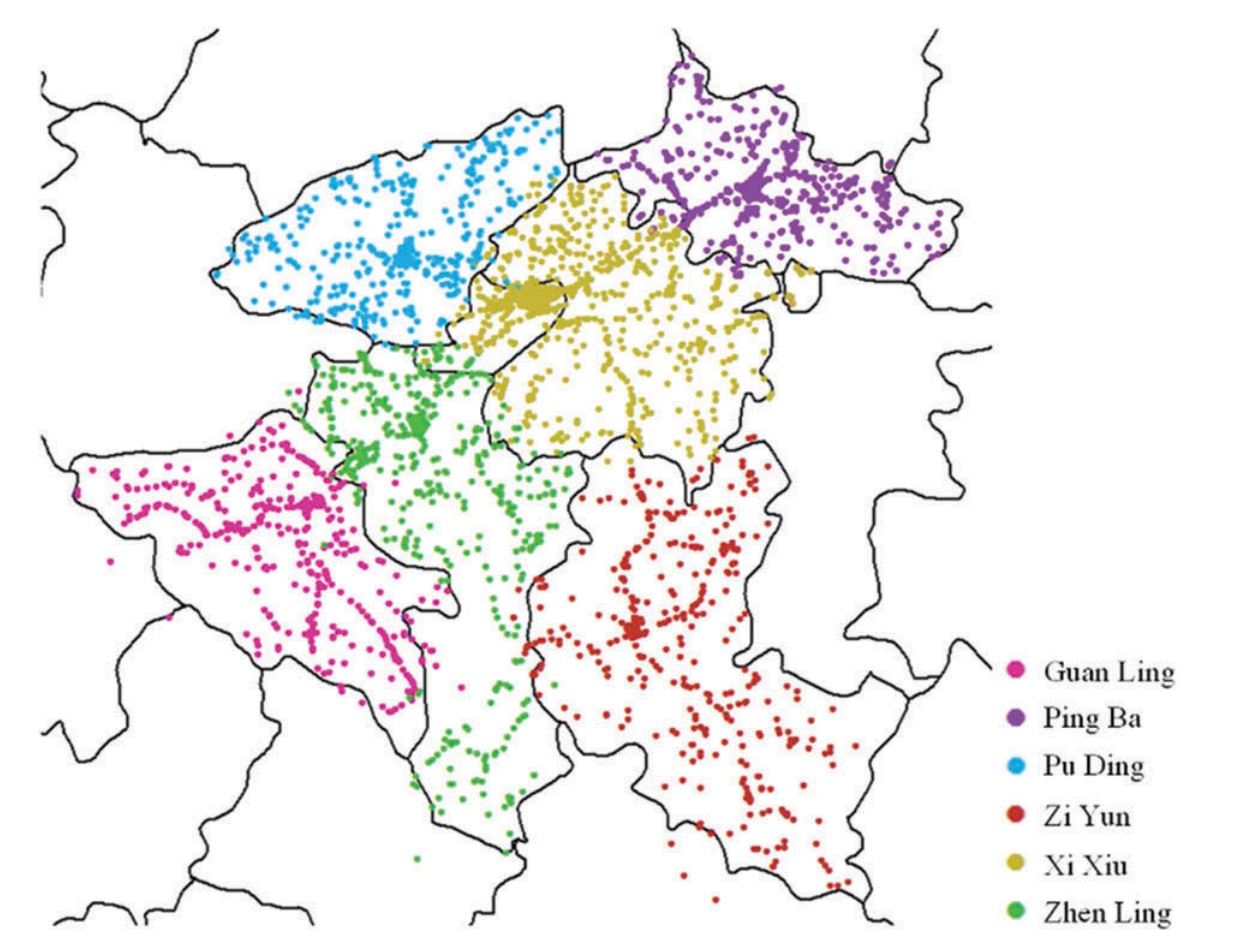
图 1|观测覆盖了怎样的空间?原图用点表示基站在安顺各区县的分布。点位密度并不均匀,因此同样一次基站切换,在不同地方未必代表相同距离;点的多少也不能直接当成人口密度。来源:原论文 Fig. 1。
数据使用详单(data usage detail records,UDR)记录用户何时开始通过某个基站使用数据服务。表2包含匿名用户标识、开始时间和基站经纬度。按时间排列同一用户的记录,就得到基站访问序列。序列只在发生被记录的数据使用时更新,不能还原每一分钟的位置,也不是通话详单。
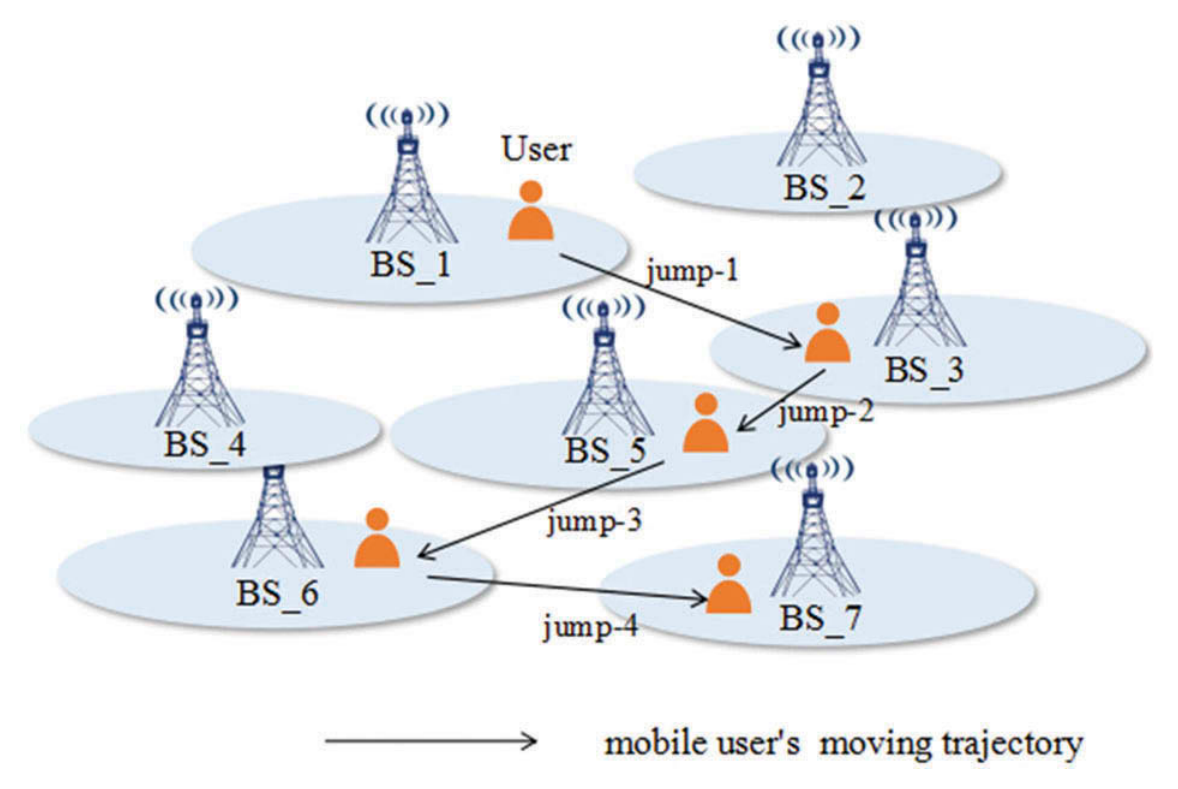
图 2|怎样从基站记录近似一条轨迹?图中用户依次通过BS_1、BS_3、BS_5、BS_6、BS_7,箭头连接相邻观测位置;未访问的基站不进入这条序列。箭头是观测之间的跳转,不是逐米测得的行走路线。来源:原论文 Fig. 2。
论文引用既有研究给出约300—500米的定位精度,但没有在这批记录上独立验证这个误差范围。手机即使没移动,也可能因网络切换连接不同基站。研究用相邻记录推算速度,删除超过120千米/小时的异常记录,并排除只访问一个基站的用户。这个处理可以降低部分跳点影响,也可能排除真实高速出行;只连过一个基站更不等于真实生活中完全静止。
研究比较两个等长窗口:H是2月9—12日的春节假期,W是2月18—21日的工作日。这里观察到的是两个特定四天窗口的差异,不能独立识别假期制度的因果效果。
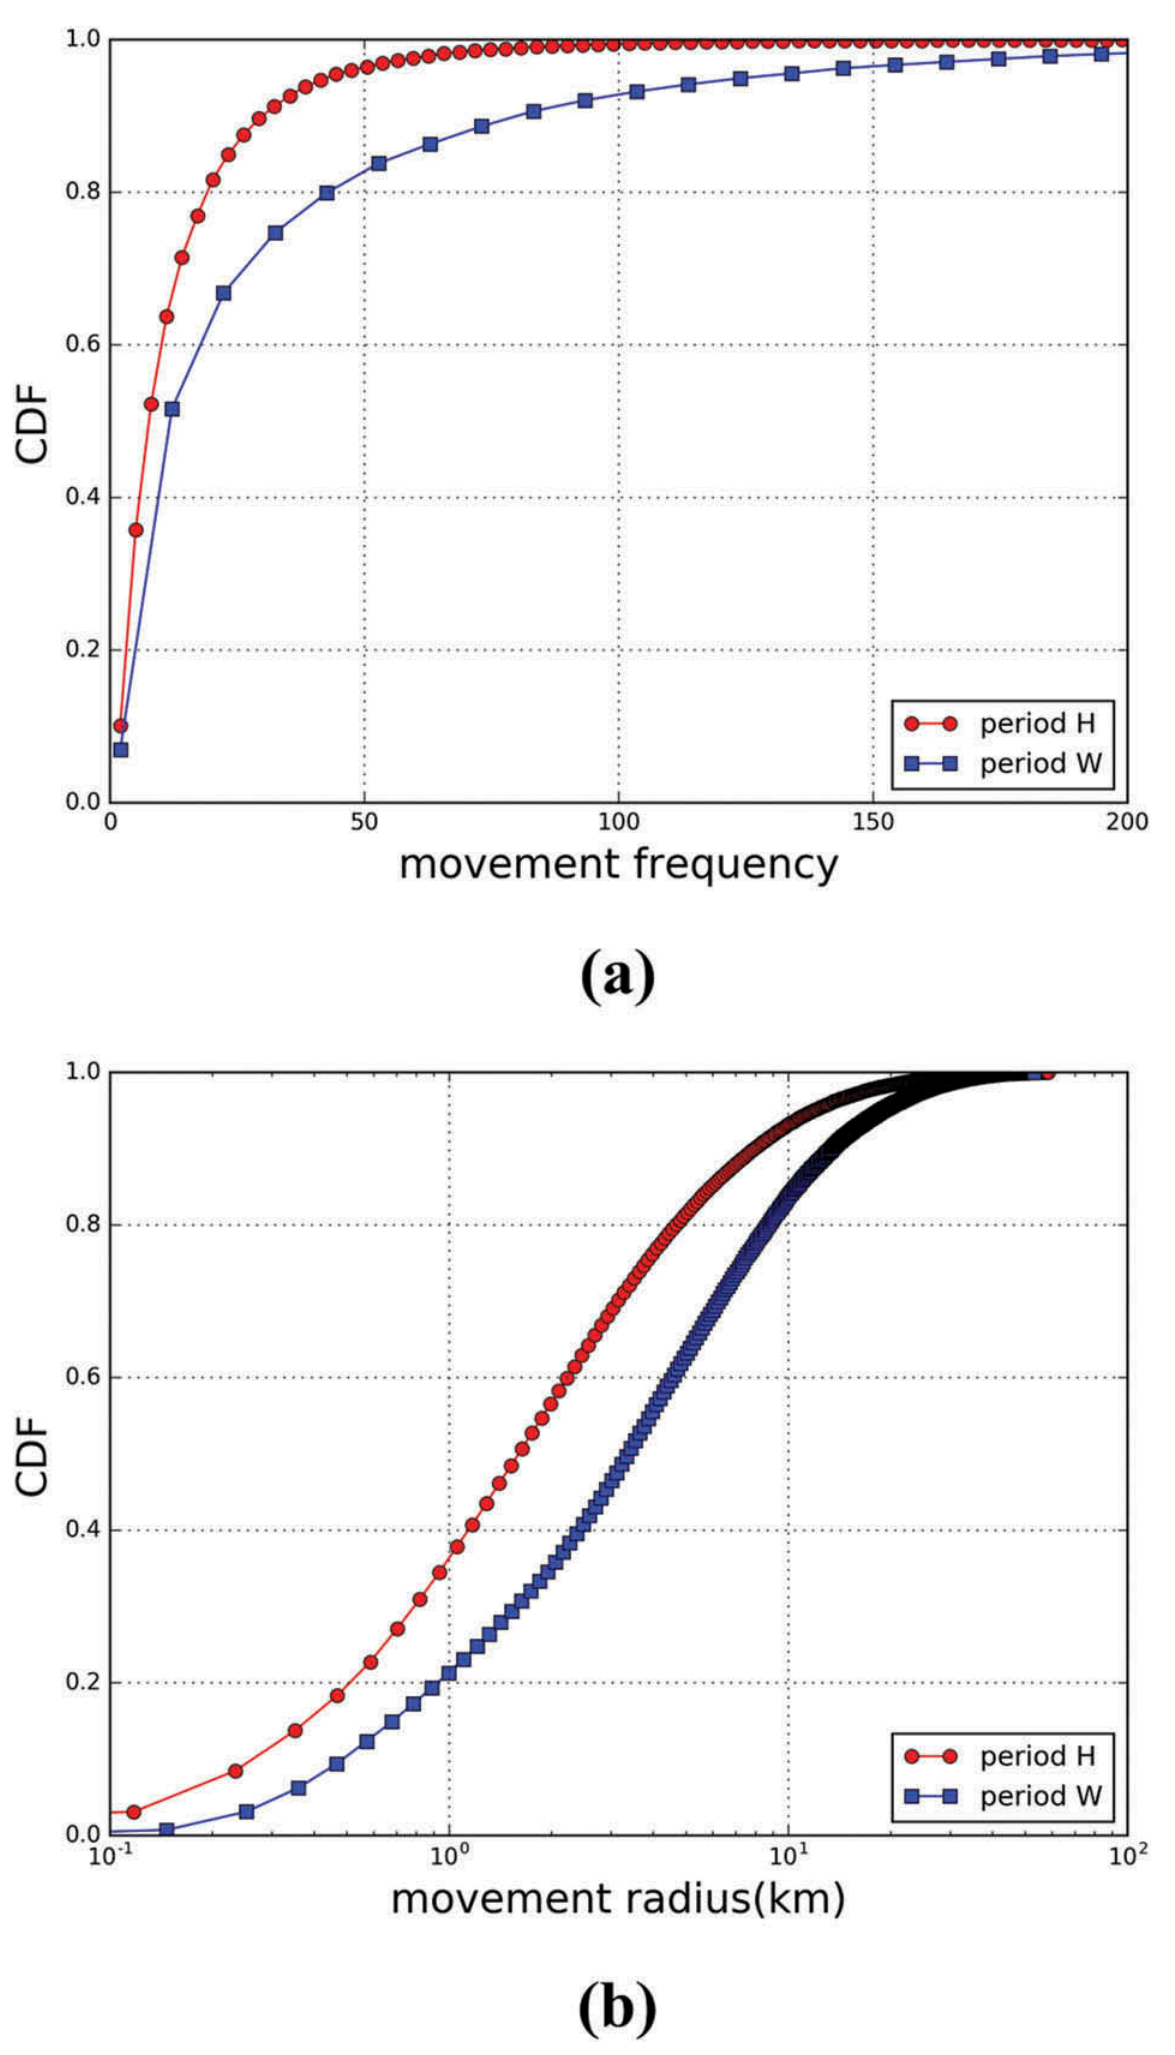
图 3|工作日是否确实表现出更多移动?(a)横轴为四天窗口内的移动频次,纵轴为累计比例;H中超过85%的用户低于25次,W中为69.6%。(b)横轴为移动半径,纵轴仍为累计比例;半径不超过5千米的比例,H为81.3%,W为62.8%。半径刻画活动位置的空间分散程度,不是累计行程长度。这组统计支持本样本工作日活动更频繁、范围更大。来源:原论文 Fig. 3。
不过,方法评估并没有把全部123万名用户直接交给算法盲测。每个行政区县筛出2000人,共1.2万人、201万条记录;再用25千米×25千米网格定义活动范围。H中每个人只在一个网格内活动;W中设有900名在关岭与镇宁之间移动的跨区用户,以及600名在关岭、镇宁内部跨网格移动的用户,其余四个区县的用户仍在原网格内活动。两类目标人群合计1500人,占评估集12.5%。
这些轨迹来自真实记录,但评估集按预先知道的轨迹条件筛选。它检验的是算法能否找回这1500人,而不是没有预筛选时,能多可靠地发现城市中所有行为变化。
为什么不把一个人去过的地点全部连起来?
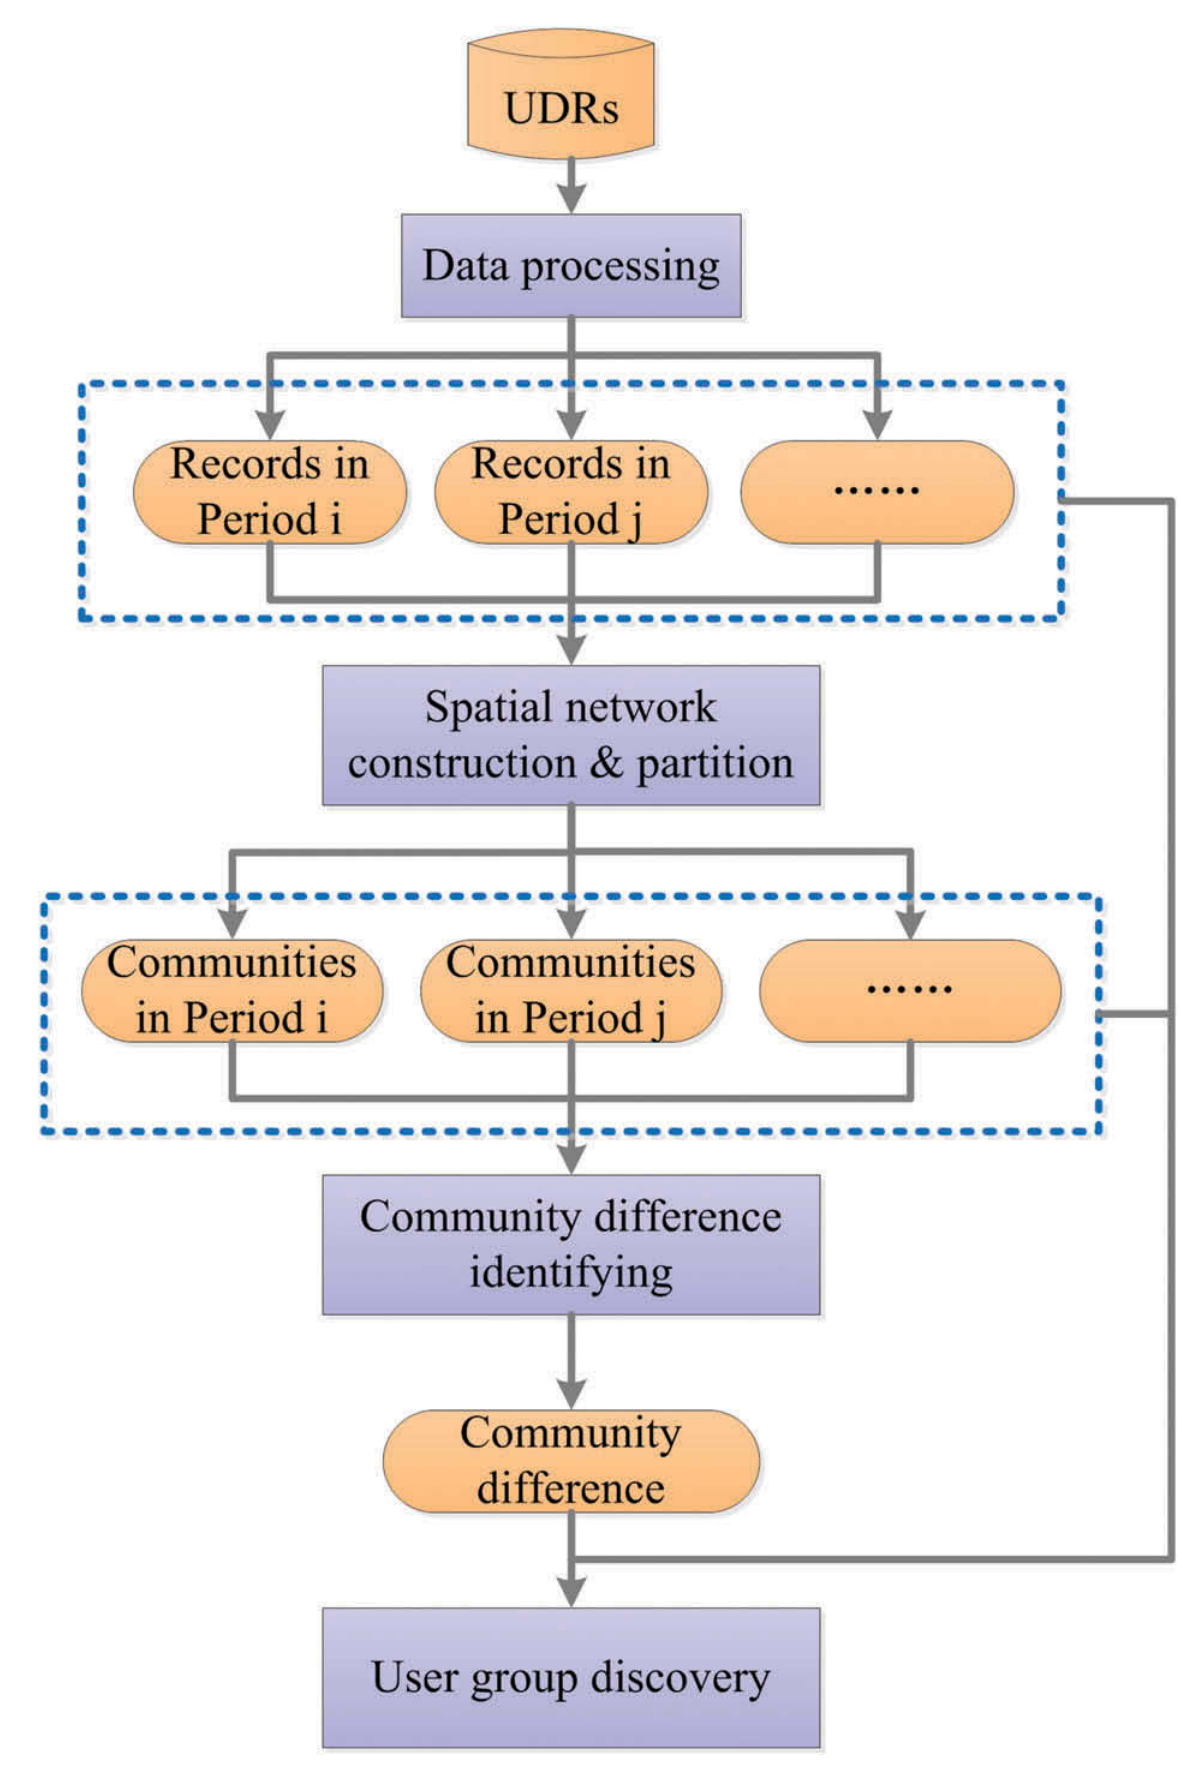
图 4|从轨迹到变化人群需要哪几步?流程图依次连接两个时期的空间网络、社区发现、社区差异识别和用户群体发现。最终用户标签来自网络差异与用户贡献边的对应关系,而非另外训练的个体分类器。来源:原论文 Fig. 4。
构建网络时,一种做法把同一人到过的地点全部两两相连,得到协作网络(collaboration network);另一种只连接时间上相邻的访问地点,得到交互网络(interaction network)。两者对顺序的敏感性不同。
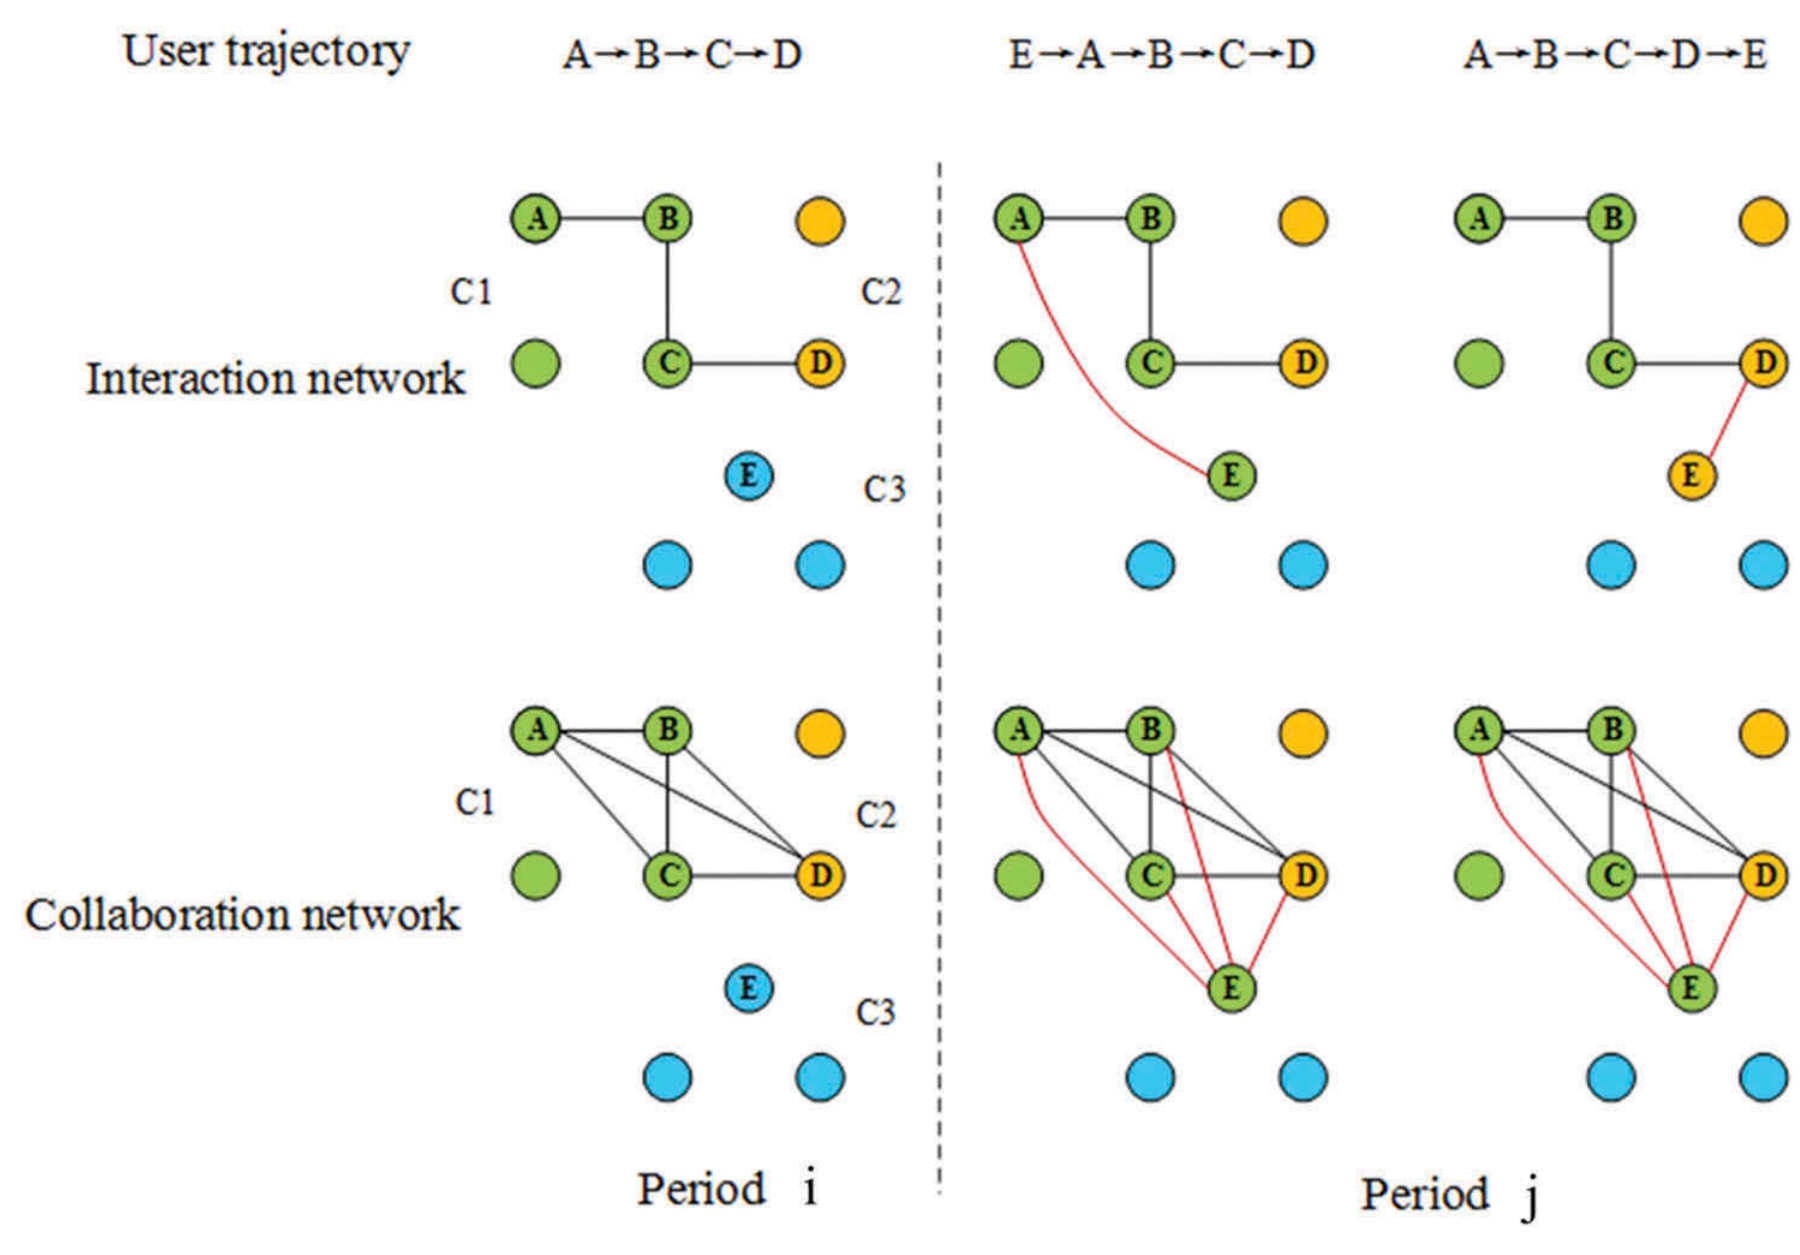
图 5|同样多访问一个地点,网络为什么会不同?图中第一行给出原有A→B→C→D,以及加入E后的两种顺序;第二行是交互网络,第三行是协作网络。不同颜色表示原有社区,黑线表示原有联系,红线表示新增联系。E→A→B→C→D新增E—A;A→B→C→D→E新增D—E,因此E会接向不同社区。协作网络在两种顺序下都会把E与A、B、C、D连接,难以区分这两种变化。原文相应段落第二种情况把边写成E—A,与图示及轨迹不符,这里按图中的D—E理解。来源:原论文 Fig. 5。
研究选择交互网络,以基站为节点,以经过相邻基站对的用户数为权重。式1对每个用户使用0或1的指示量,再求和:一个用户是否贡献过这条边,而不是他在这条边上出现多少次。一个人在同一路径反复留下100条记录,不等于给边贡献100份权重。
虽然访问序列有先后,这里后续社区计算采用无向加权网络的形式;它保留了哪些地点相邻访问的信息,不能据此声称完整保留出行方向。
社区不只有一种尺度,比较也不能只看颜色
社区发现采用马尔可夫稳定性(Markov stability):让随机游走者沿加权边移动,寻找在给定扩散时间内仍较容易把游走者留在内部的基站群。短时间更容易看见局部联系,长时间则允许游走者跨越更多节点,通常得到较大的社区。
这里的马尔可夫时间是算法的分辨率参数,不是手机记录中的一天或一小时。稳定性比较的是实际留在同一组的概率与按稳态独立抽样时的基线;不能把稳定性值当成预测正确率。
两个时期的社区可能只是颜色、编号换了。为了排除这种假变化,研究把每个划分转成“是否同一社区”的矩阵:节点i与j同组记1,不同组记0。分别得到X、Y,再计算逐项异或M:同组关系发生改变记1,否则记0。
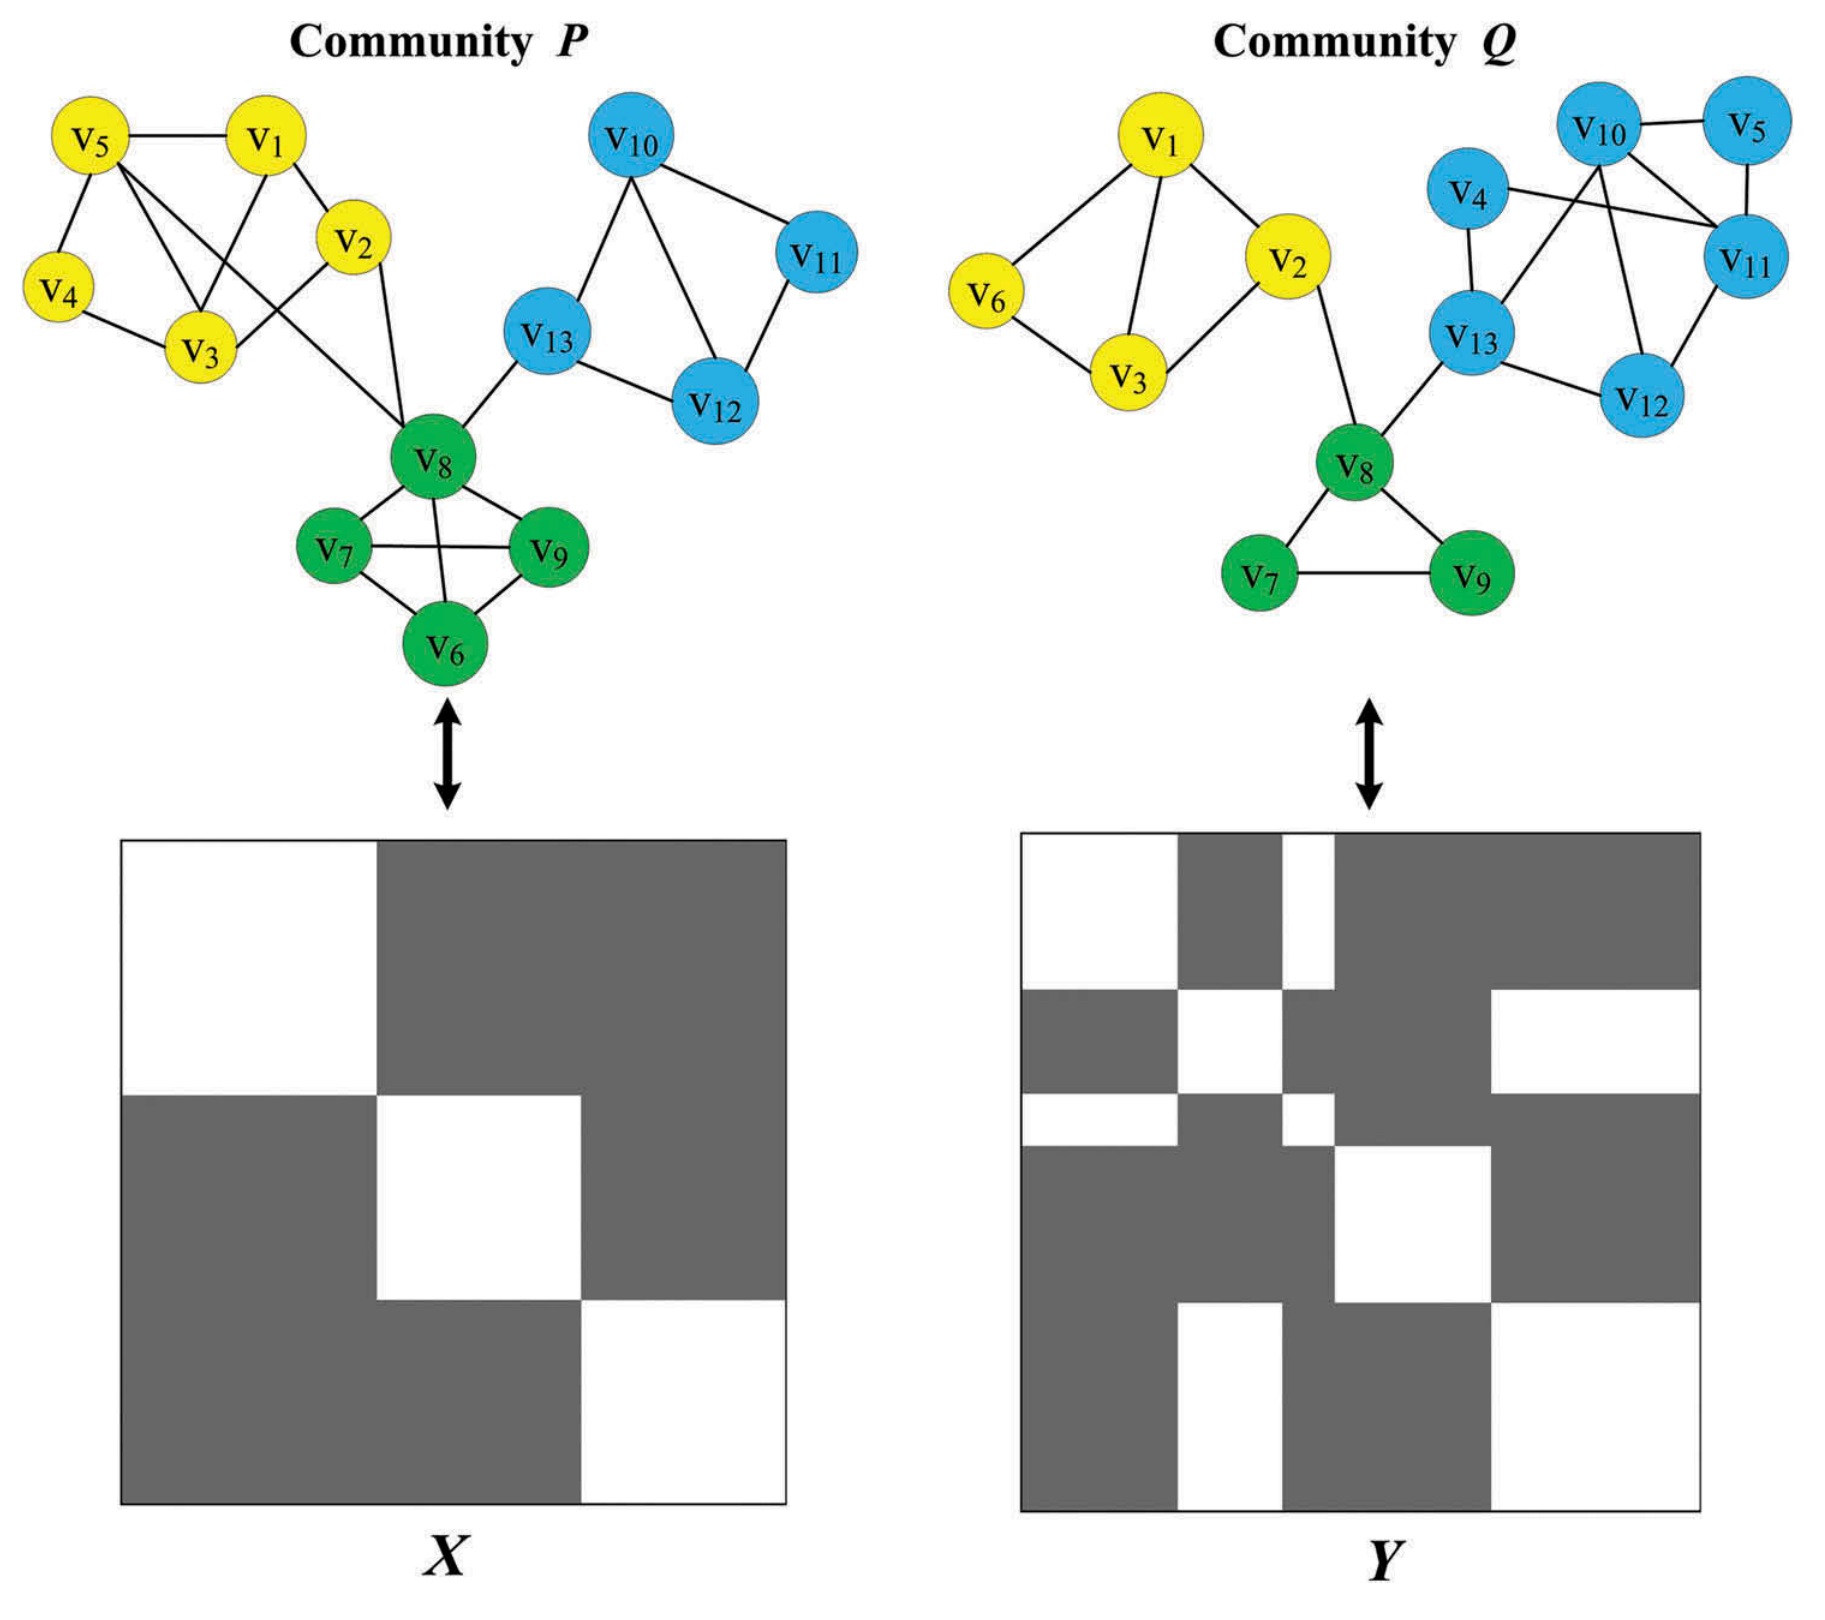
图 6|社区划分怎样变成可比较的关系矩阵?图中两套网络社区分别对应各自的相似矩阵,白色为同组关系1,灰色为0。社区编号即使互换,只要成员关系不变,矩阵就不会改变。来源:原论文 Fig. 6。
对某个节点,把M对应一行的1加起来,就得到它改变了多少个同社区伙伴。若节点原属于P组、后来属于Q组,这个数量等于“P组人数+Q组人数−2×两组交集人数”。因此,关系变化大可以来自原组拆分,也可以来自新组合并,并不要求该基站本身移动。
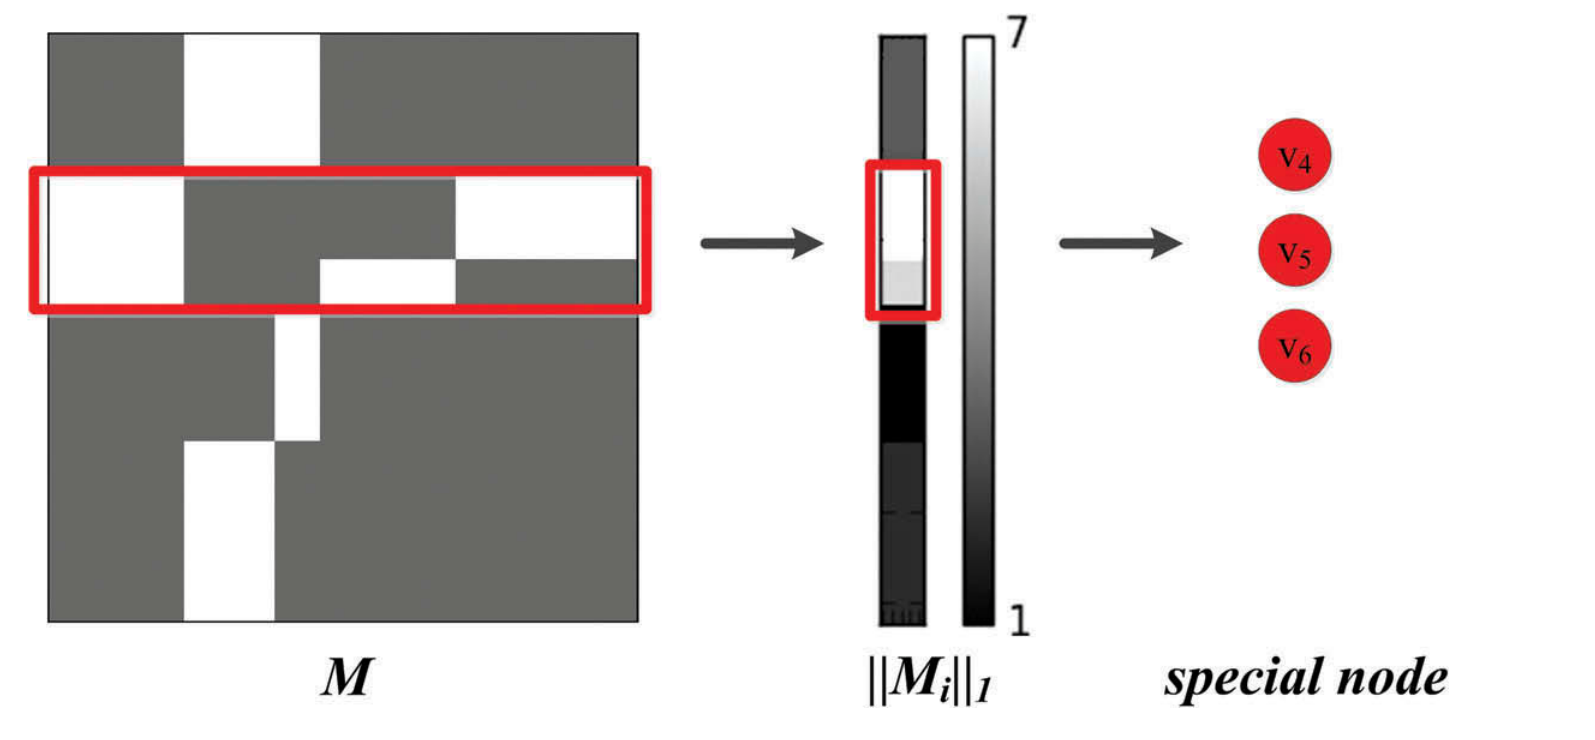
图 7|如何定位局部社区差异?示意图把两次划分及对应矩阵进行比较,再以异或矩阵的行和识别变化节点。图中的关系变化定位到了具体节点,而不只是给全图一个相似度分数。来源:原论文 Fig. 7。
实际判定还需要阈值γ。论文先讨论两组交集占各组的比例,实际实现则将行和与“(1−γ)×两次划分平均社区规模之和”比较。平均规模不是该节点所在社区的实际规模,因此两种判据不能直接视为严格等价。论文也没有明确报告γ的具体取值,这限制了结果的完全复现。
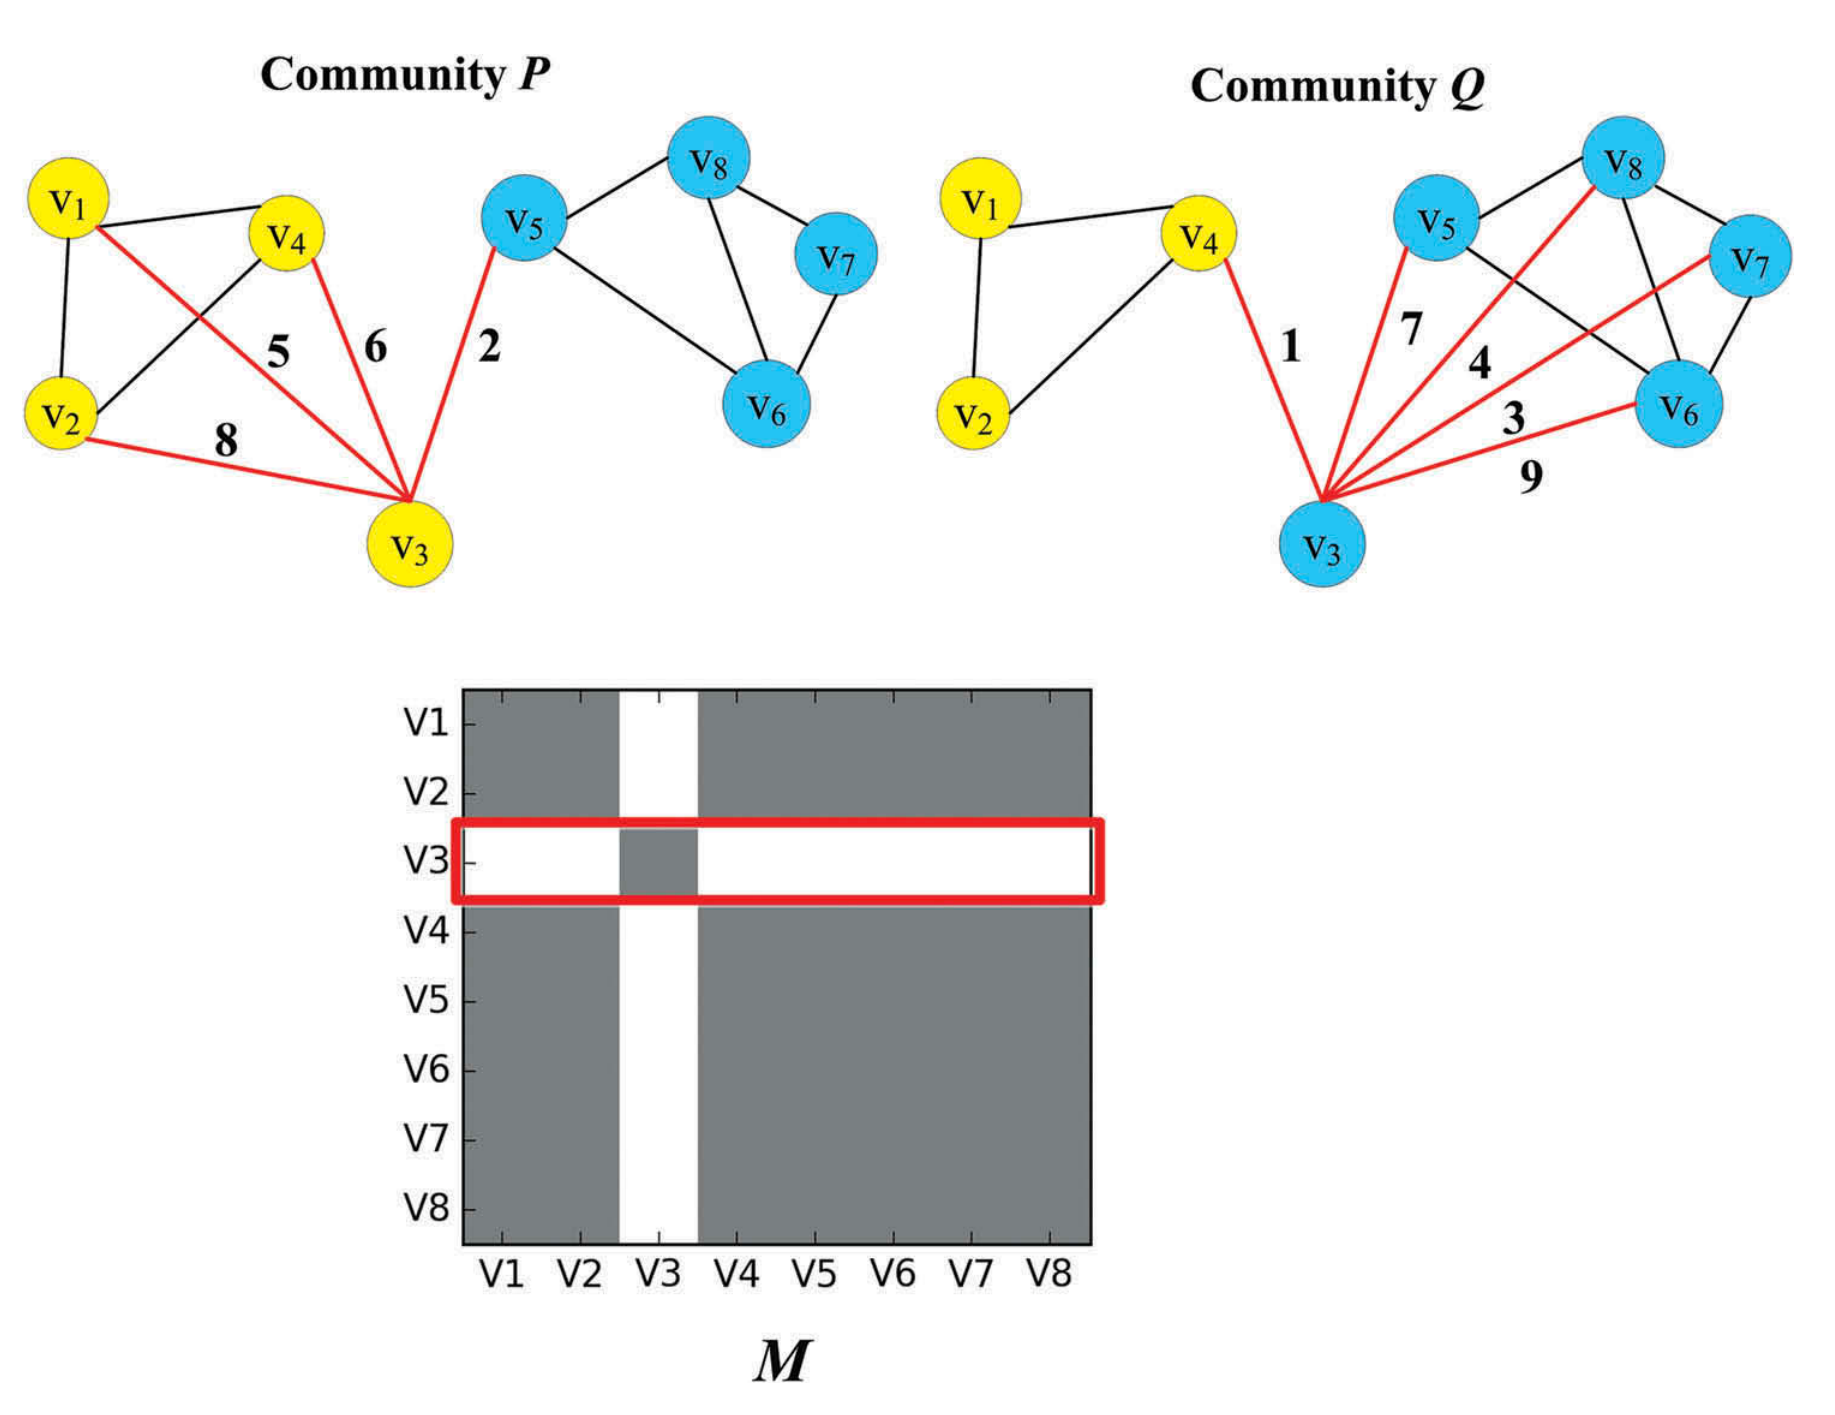
图 8|变化节点怎样连接回用户?两幅网络用颜色标出社区、数字标出边权;v3的联系改变后归属不同。红线标出与社区变化有关的联系,矩阵中的红框对应变化节点的行。异或矩阵表达的是共同归属关系的变化,只有再与实际用户经过的边相交,才能回到用户记录。来源:原论文 Fig. 8。
方法把相关差异边组成集合E_differ;只要某个用户贡献的边集合与之有交集,就把该用户识别为活动模式变化者。这个映射很直接,也带来边界:一个行为稳定的人可能恰好使用了被其他人共同改变的联系,因此参与某条差异边不等于已经证明他独立改变了行为,更不等于证明他造成了社区变化。
地图确实变了,但检测分数要看尺度和分母
原论文表3显示,评估集构造出的H网络有1898个节点、9980条边,W网络有1882个节点、13,150条边。W的联系更丰富;两个时期节点数不完全相同,而关系矩阵比较需要对齐节点,论文没有充分交代共同节点或缺失节点的具体处理。
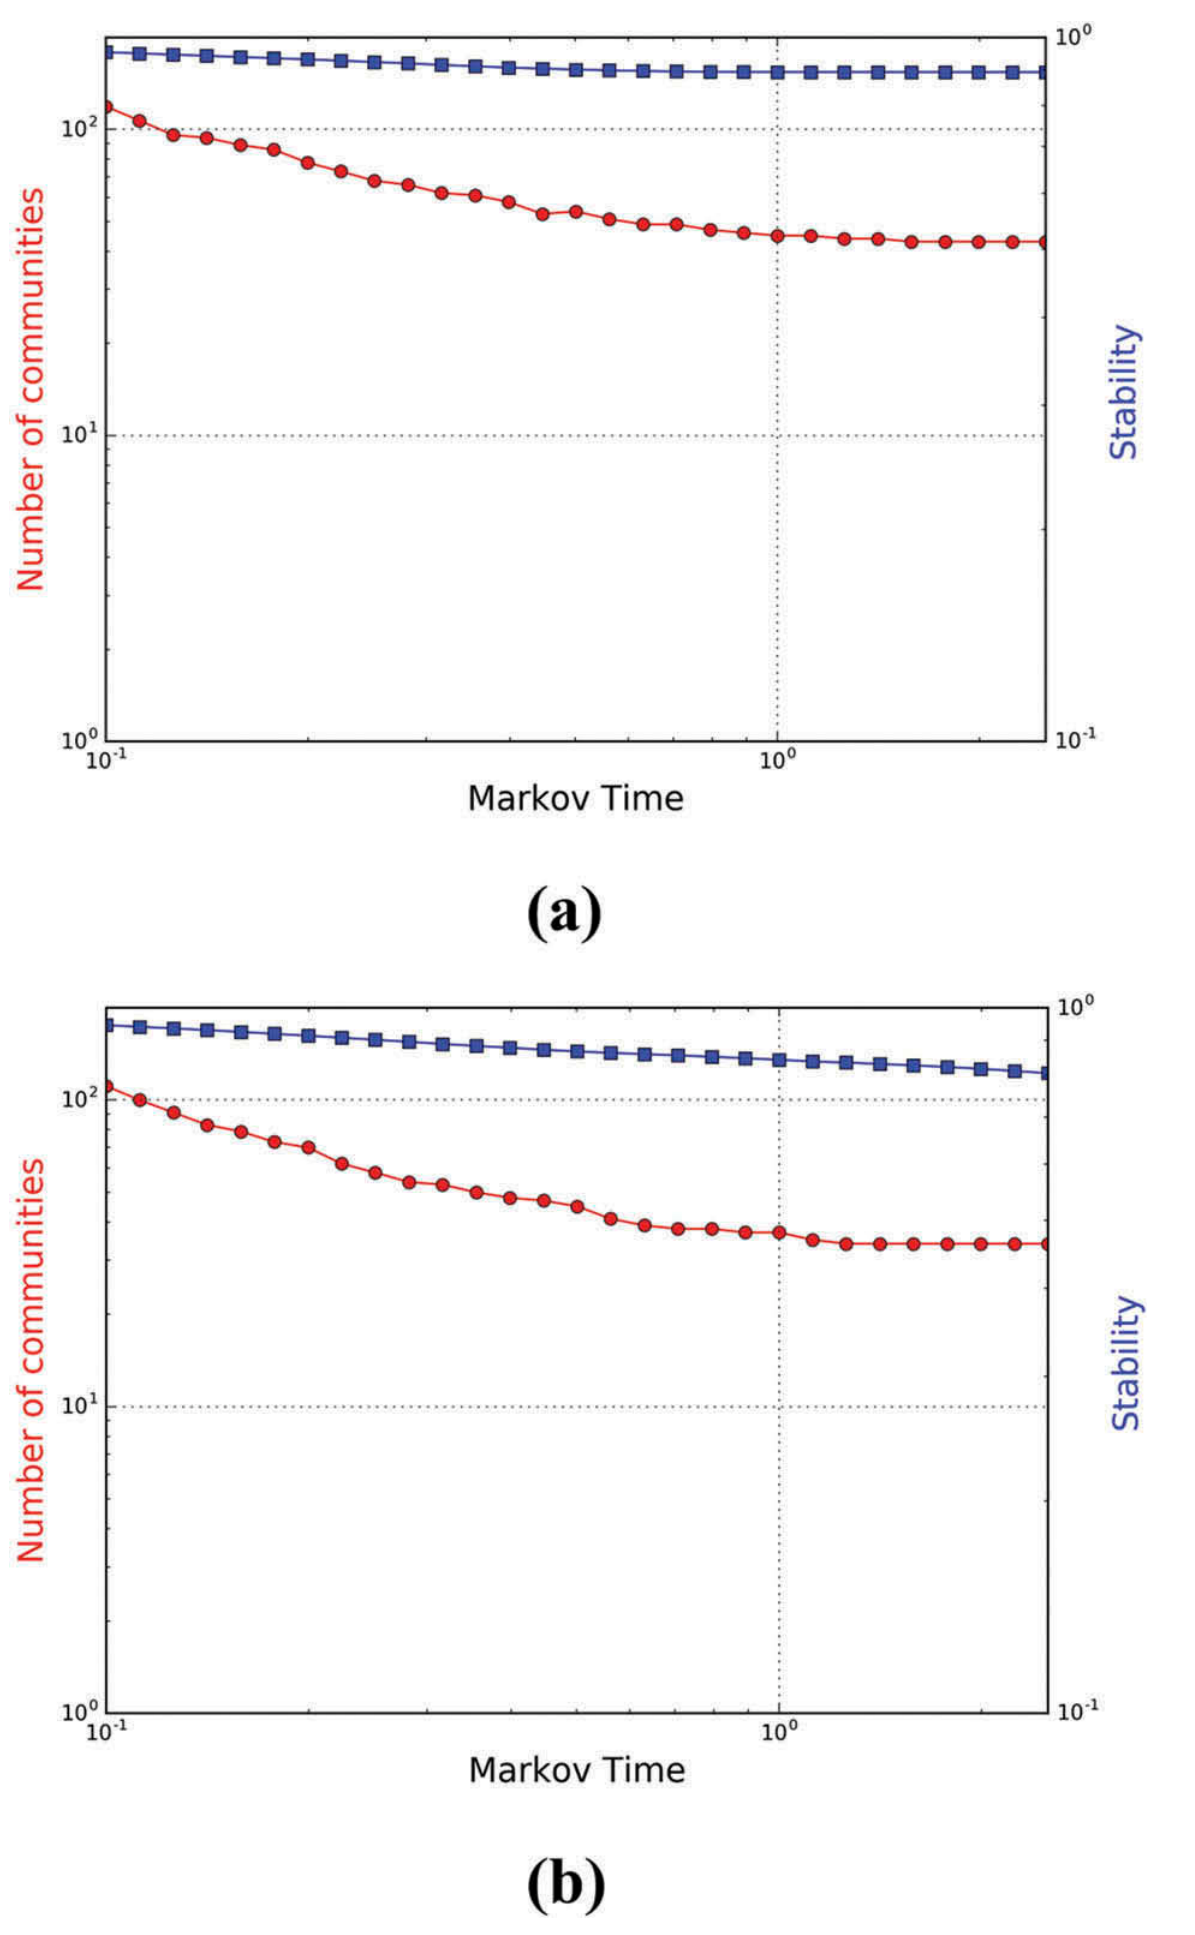
图 9|社区数量怎样随扩散尺度变化?(a)H,(b)W。横轴是马尔可夫时间;红色曲线对应左轴社区数量,蓝色曲线对应右轴稳定性,需分别读数。时间增加时社区数减少,显示算法在逐步合并局部结构;这不是经过一天后实际社区自然消失。来源:原论文 Fig. 9。
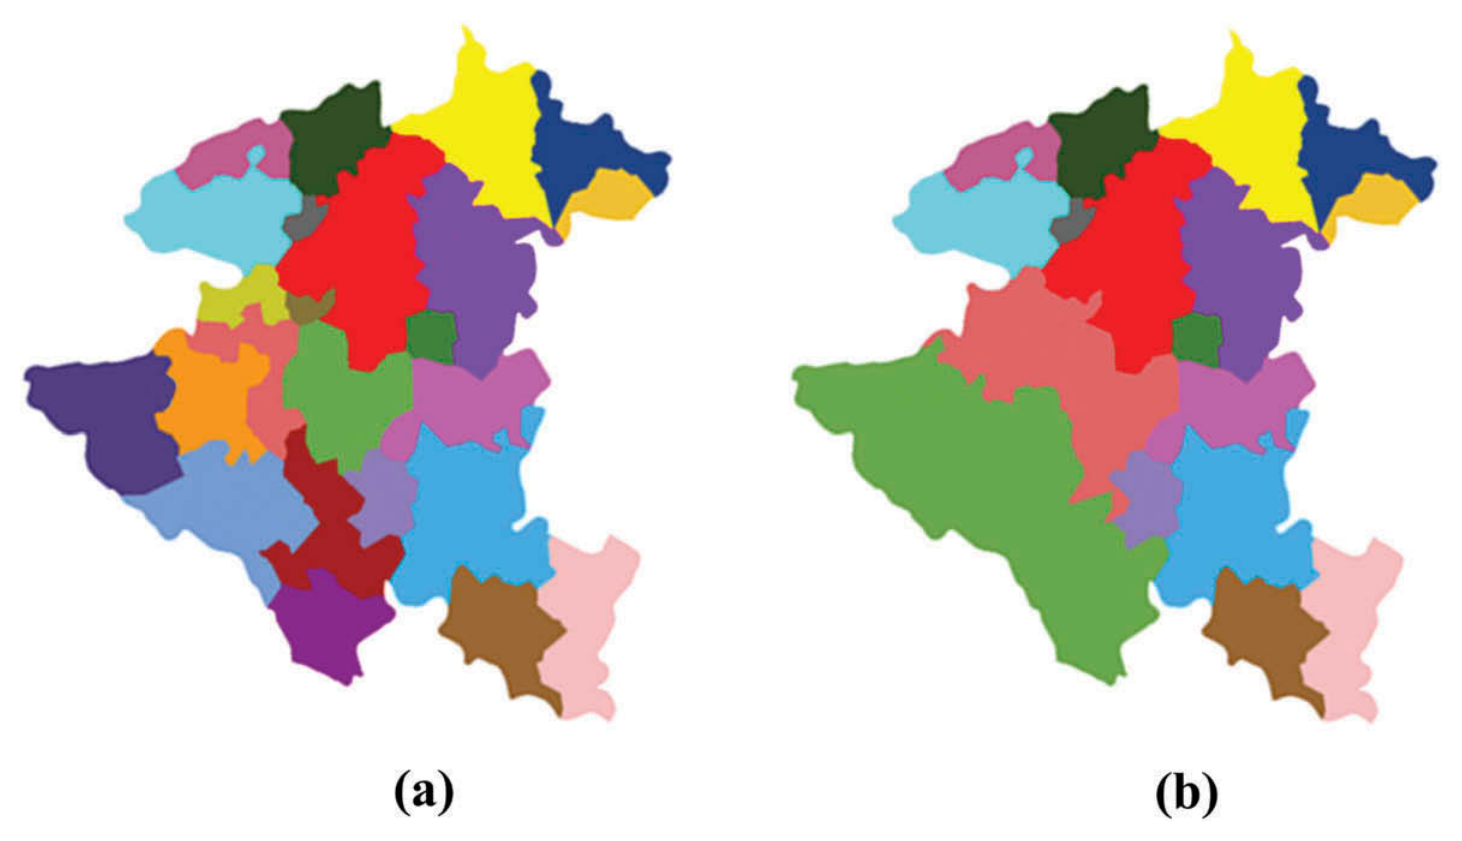
图 10|春节与工作日的联系区域有什么区别?(a)H中关岭、镇宁一带被分成较多小社区;(b)W中部分区域合并成较大的社区。每种颜色代表算法识别的联系群,颜色不表示流量高低,也不是行政区划。来源:原论文 Fig. 10。
为检验变化定位是否抓住主要差别,研究用归一化互信息(normalized mutual information,NMI)衡量两次社区划分的一致程度,0表示独立,1表示完全一致。去掉识别出的社区差异部分后,剩下的划分应当更相似。
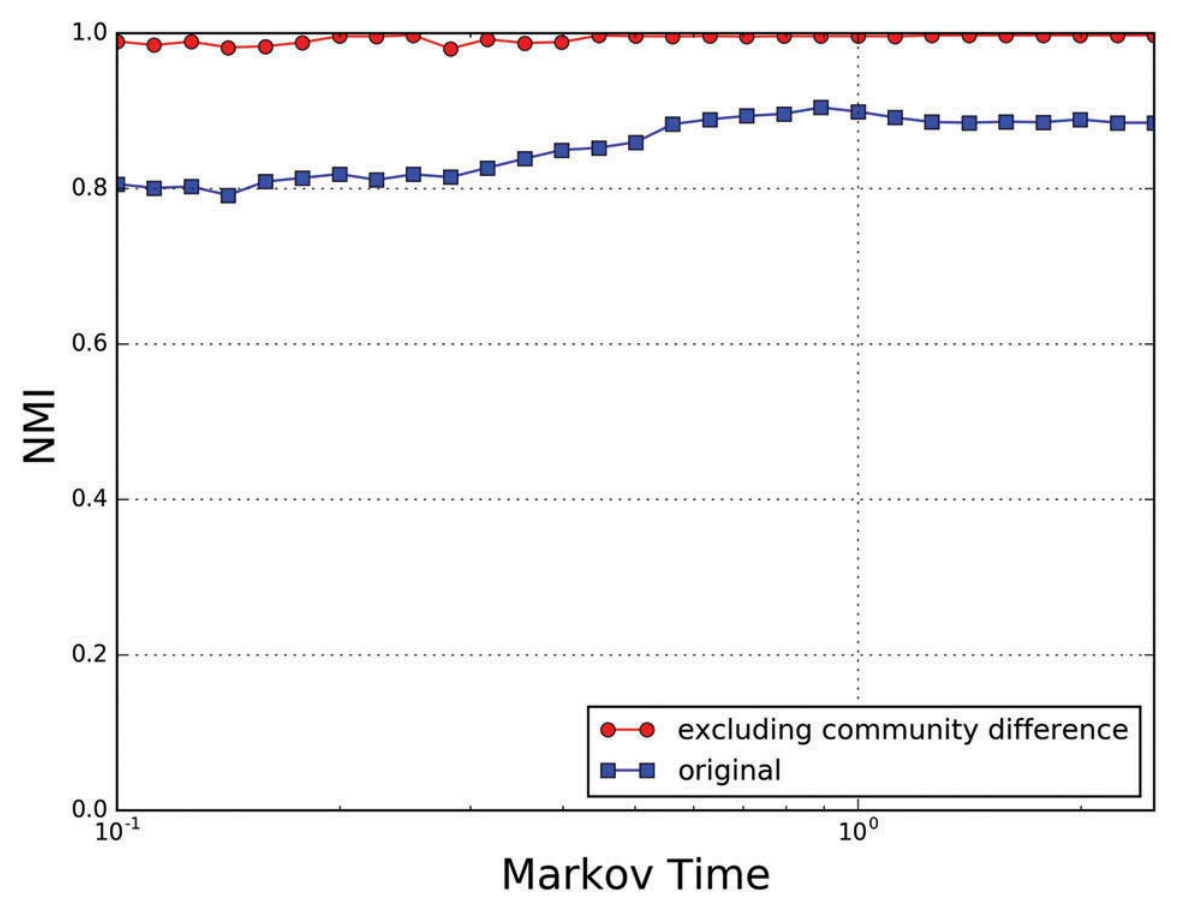
图 11|去掉差异部分后,其余结构是否更一致?横轴为马尔可夫时间,纵轴为NMI;蓝线是原划分对比,红线是排除识别出的社区差异后的对比。红线接近1,说明定位出的差异涵盖了主要结构变化。但按差异识别结果再删差异,本身就会提高一致性,这不是独立的用户识别准确率测试。来源:原论文 Fig. 11。
用户层面的检验有已知目标集合:900名跨区者、600名区内跨网格者。精确率是算法检出的用户中,有多少属于这1500人;召回率是1500人中,有多少被检出。
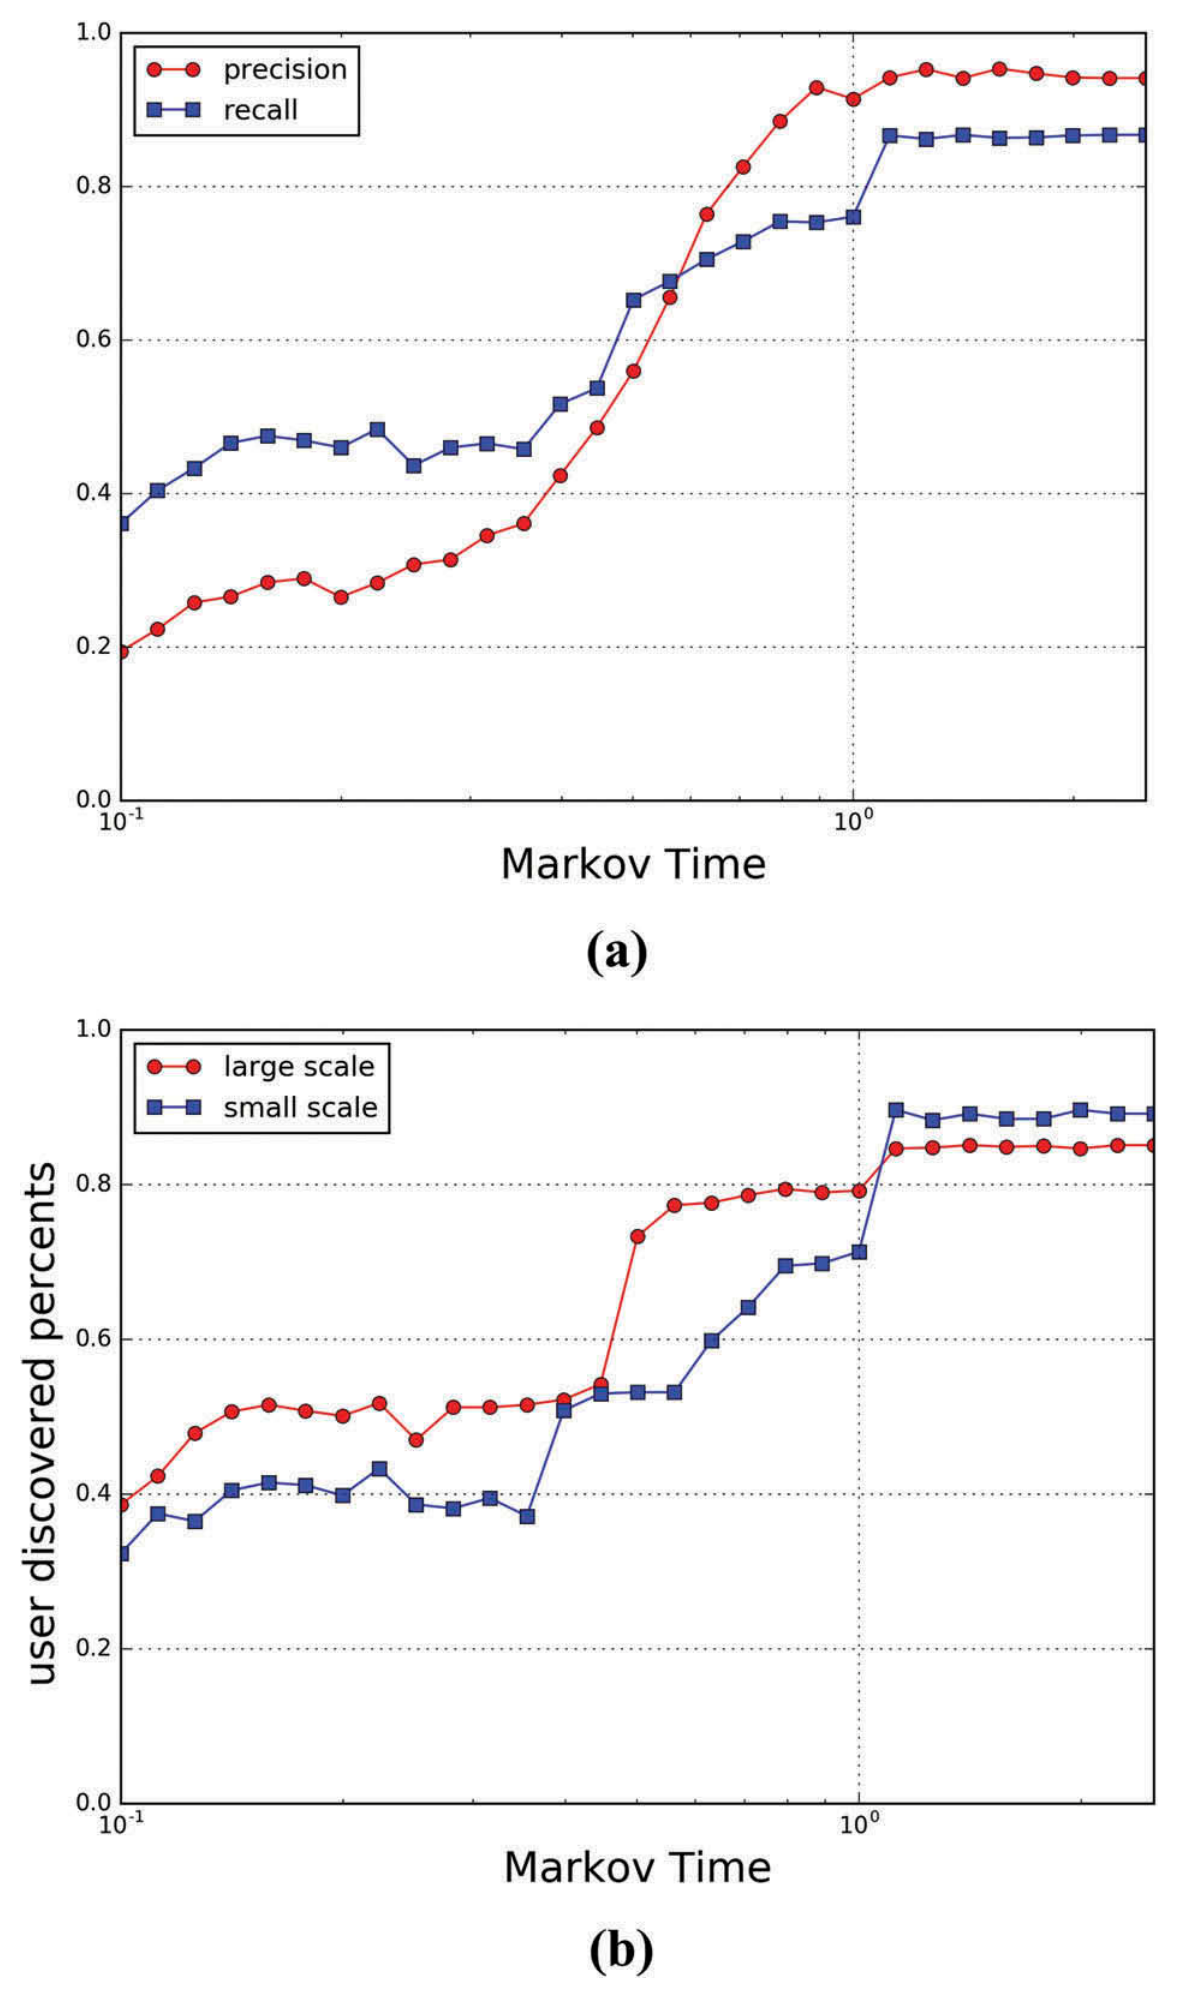
图 12|能找回多少目标用户,误报又有多少?(a)横轴为马尔可夫时间,红线精确率、蓝线召回率;较粗且稳定的尺度区间,论文报告两者为94.1%和86.7%,细尺度时明显较低。(b)红线表示900名大尺度变化用户中的发现比例,蓝线表示600名小尺度变化用户中的发现比例,报告值分别为85.1%和89.1%。这不是全体用户94.1%的整体准确率。来源:原论文 Fig. 12。
小尺度目标的发现比例略高,不能据此推出小尺度任务普遍更容易:两组样本的筛选条件、所处区域和网络联系都不同。900×85.1%与600×89.1%加权后约为86.7%,与整体召回口径一致;目标以外的10,500人也来自特定筛选条件,不能代表任意未筛选人群中的误报水平。
另一个检验把检出人群在W中的边权贡献,替换成他们在H中的贡献,再重新划分社区。如果检出者确实与主要差异相关,两张图应当更接近。
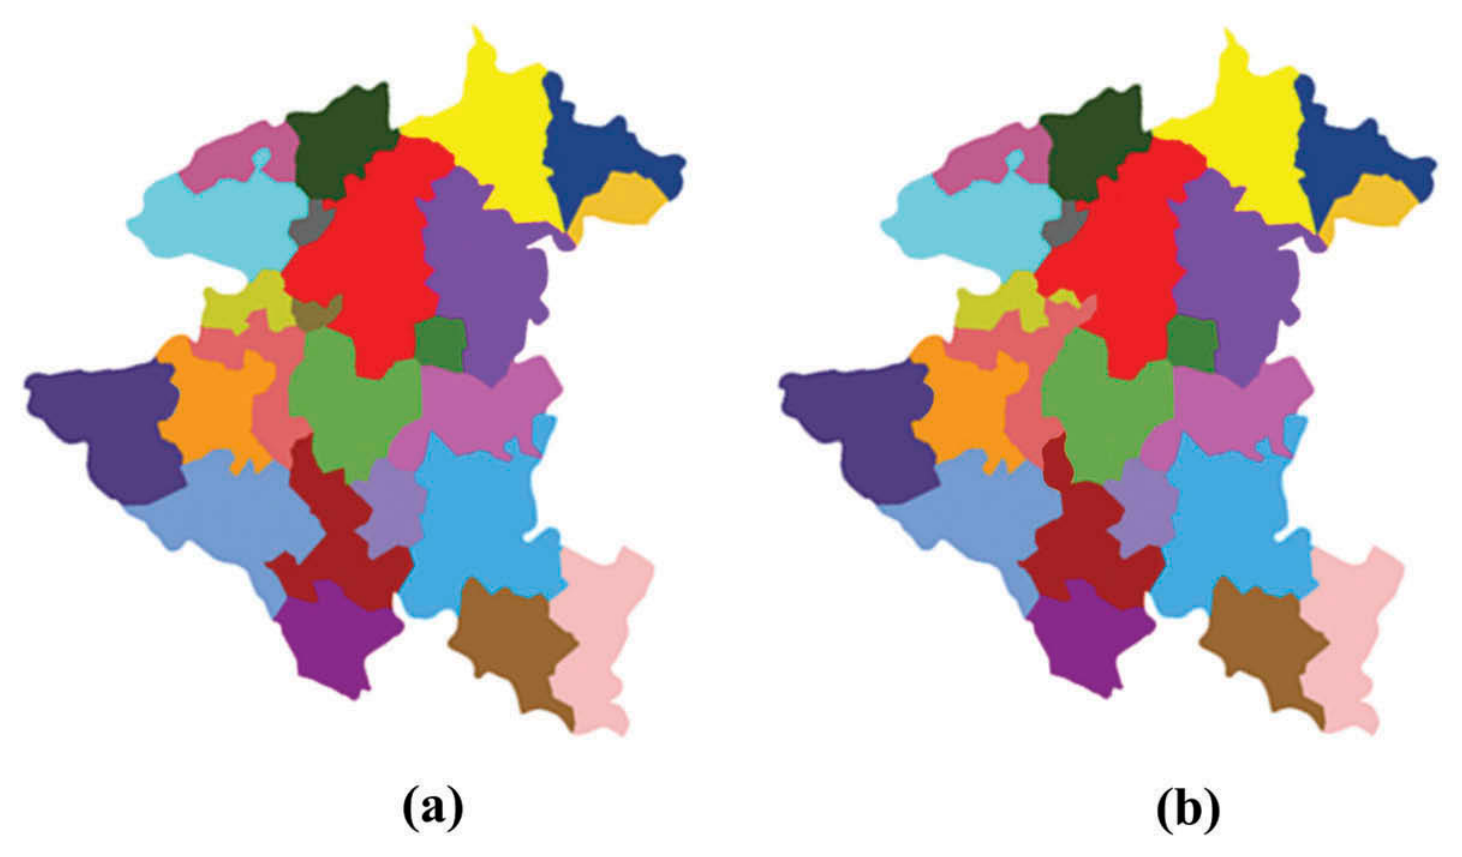
图 13|把检出人群的贡献换回假期状态,会发生什么?(a)H的社区结构;(b)替换相关贡献后重新计算的W结构。论文报告两者NMI从原来的0.885升至0.984,增加0.099。这是对构造网络的替换检验,支持这些记录与结构变化有关,不能理解为真实实施交通干预后的效果。来源:原论文 Fig. 13。
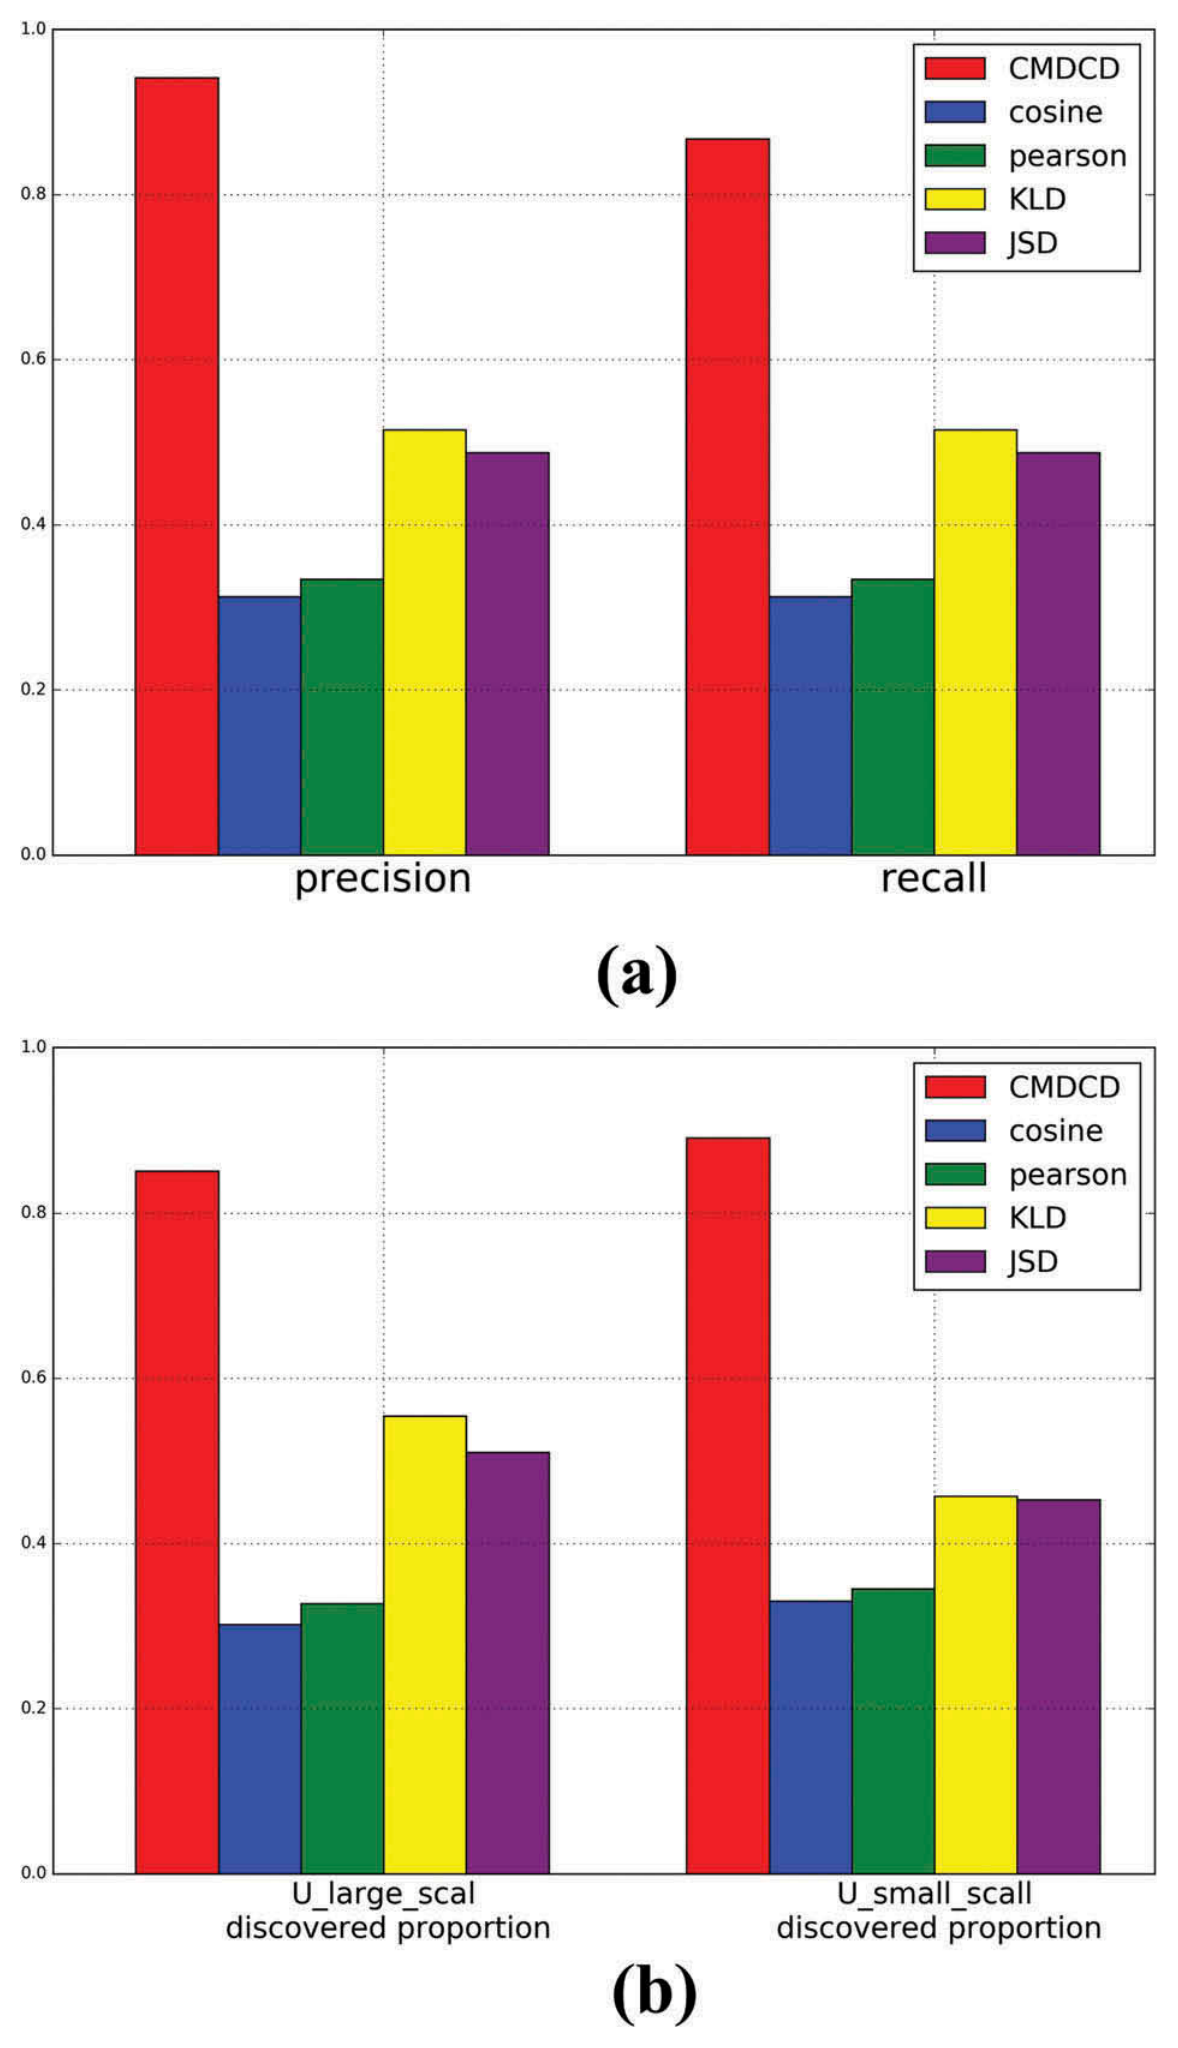
图 14|相较直接比较相似性的方法,表现怎样?(a)比较精确率与召回率;(b)比较两类目标人群各自的发现比例。红柱是CMDCD,其他颜色依图例为余弦、Pearson、KLD、JSD。CMDCD在这份评估集上各指标更高;其他方法的柱高是图示结果,不宜凭读图补出精确小数。论文没有充分展开所有基线的特征构造与阈值选择,因此不能把这次排序直接外推为所有数据上的普遍优势。来源:原论文 Fig. 14。
道路和山地能帮助解释边界,却没有替代出行目的调查
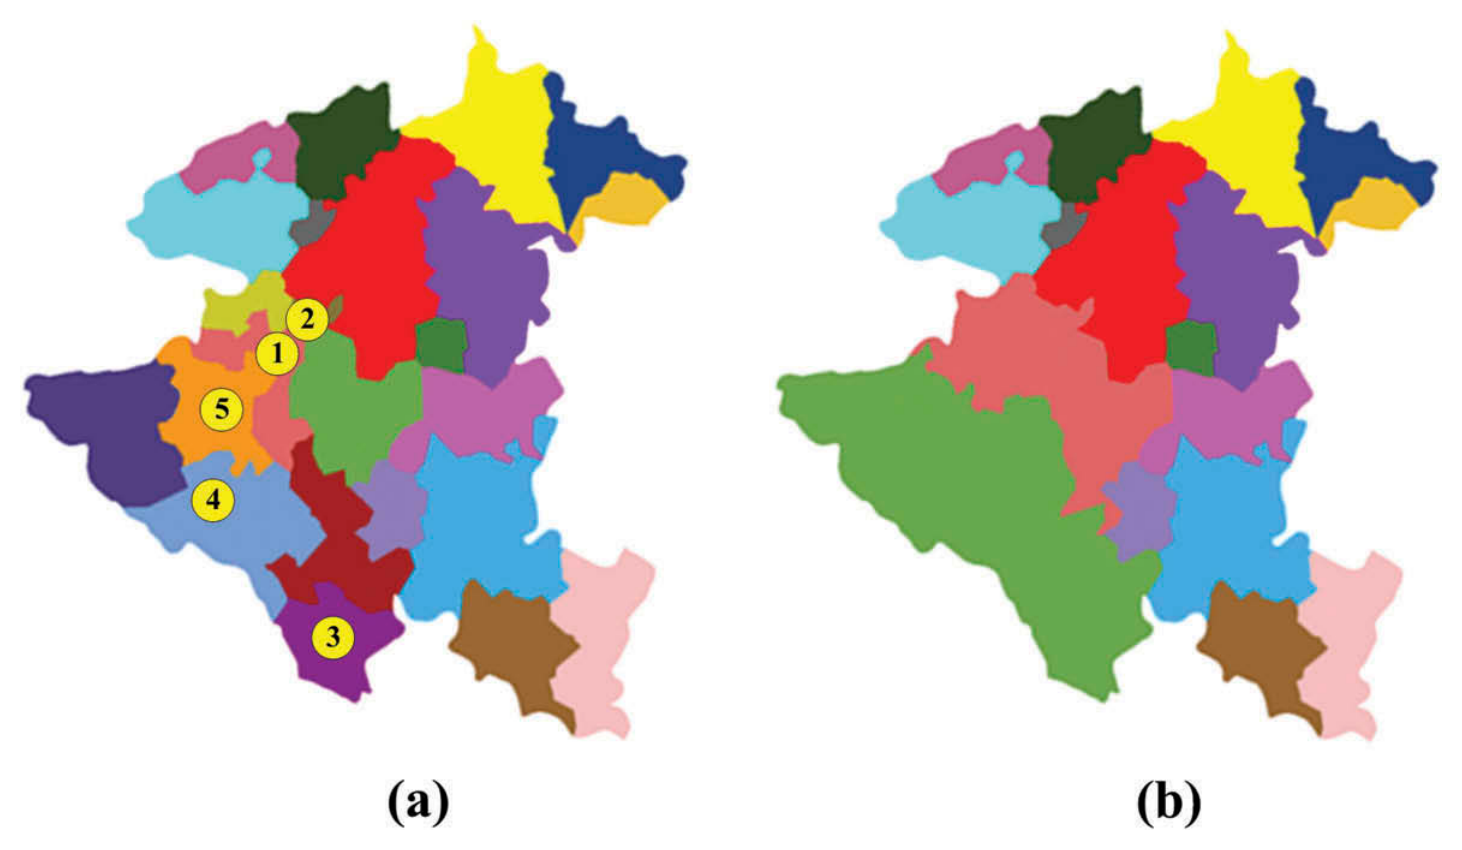
图 15|哪些地理条件与社区变化相吻合?(a)H中的①至⑤标记用于对照黄果树镇及景区周边、道路联系与山地区域;(b)W中部分地区合并。作者把①②的联系与景区及附近G60联系起来,把①③分隔与山地、缺少直达道路联系起来,并用S210和S50解释③与④⑤在工作日形成更强联系。编号与颜色提供空间解释线索,不是直接测得的旅行目的标签。来源:原论文 Fig. 15。
同属一个行政区的地方未必形成同一出行社区,跨越原有小社区的道路联系也可能让较远地区归入同组。这是网络方法相较只看行政边界的价值。但上网记录没有告诉我们某人是否是游客、去哪里工作,也没有道路开通前后的对照。旅游、道路与地形在这里主要是事后解释,不能写成各因素效应已被单独估计。
方法最有用的场景,是先把海量记录压成联系结构,定位哪部分结构改变,再回到相关用户作进一步分析。真正用于城市监测,还需要未经目标条件预筛选的用户数据、多个时期与城市的外部验证,以及阈值、分区随机性和节点对齐的明确方案。当前结果尚未提供这些保证。
一句话总结
城市联系结构的变化可以帮助定位相关移动人群,但检出结果的可靠性取决于记录口径、社区尺度与评估集,不能把经过筛选的高分直接当成全城实时识别能力。
核心来源
- 原论文及DOI页面:本文的数据、式1—8、表1—3、Fig. 1—15及方法讨论。图均为原论文完整主图。
作者介绍
- Hao Jiang:原论文署名武汉大学电子信息学院及武汉大学地球空间信息技术协同创新中心,为论文通讯作者。
- Qian Li:原论文署名武汉大学电子信息学院。
- Xian Zhou:原论文署名武汉大学电子信息学院。
- Yanqiu Chen:原论文署名武汉大学电子信息学院。
- Shuwen Yi:原论文署名武汉大学电子信息学院。
- Hai Wang:原论文署名武汉大学电子信息学院。
- Zheng Lu:原论文署名武汉大学电子信息学院。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一条跨区联系一直存在,只是新增通勤者让它变强,那么原来每天走这条路的人也可能进入差异边对应的用户集合。与其只输出一个是否变化的标签,更有解释力的下一步,是把“本人路径是否改变”和“本人使用的路径是否处在集体变化中”分开。前者需要对比个人两个时期的序列,后者需要对比整体网络;两项一致时,才更有理由把用户解释为自身活动发生变化。
还可以用保持各人访问频次、但打乱跨地点连接的空模型,检验社区变化究竟超过了多少由记录总量上升就能产生的变化。工作日上网事件更多时,网络边自然可能增多;若不控制观测强度,行为变化与记录变密就可能混在一起。这样的对照能把结构检测进一步推进到对变化来源的辨析。

