同一个人不再照常乘地铁,是改了时间、换了目的地,还是没刷这张卡?
论文名片|Tianli Tang、Mo Jia、Yiwen Zhang、Haohan Hu、Mingyang Pei、Yuting Chen、Xiaoxia Wang,Why metro passengers change travel behavior: Individual-level insights from interpretable machine learning,Cities,2025,167:106352,2025年8月7日在线发表。DOI。
一个人通常早上乘地铁上班,傍晚原路回来。某天晚了很久才进站,另一天在不同车站出站,假日则不再出现熟悉的回程记录。这几天都可能让客流偏离常态,却不是同一种改变。
这篇论文把智能卡记录整理成个人每日出行日志,按常见模式和三类偏离建立标签,再用XGBoost分类、用SHAP解释模型依赖哪些特征。它提供了一套拆解客流变化的框架,但刷卡数据能观察的是系统内行为,模型解释也不等于已经找到了每个人改变计划的真实原因。
先说结论
- 在经过高频使用筛选的上海地铁样本中,假日信息更倾向将模型判断推向预期地铁出行缺失,并远离常规模式。
- 当日出行次数较多,往往与起讫站变化有关,而不是单纯时间偏移;闭环与非闭环日志也表现出不同模型关联。
- 各周出行次数波动越大,模型越倾向判断为出行缺失。天气预警在这一个月的模型中贡献较小,不能推出极端天气不会影响地铁出行。
- 研究是对已发生日志的分类与关联解释。标签依赖全月常见模式,输入包括当日出行次数,尚不能据此声称已实现提前一天可靠预测,更不能把SHAP值当作因果效应。
千万张卡的原库,最终分析的是哪些乘客?
数据时间为2015年4月1—30日,其中25、26日缺失,实际讨论28个有数据的日期。论文报告原库超过2,700万条交易记录和1,000万个独立卡ID;为识别足够稳定的个人模式,排除少于56条刷卡记录的卡,相当于至少28趟有进出站记录的地铁出行,并清理缺配对及工作人员代刷等异常后,保留58,923个ID、7,993,016条记录。
因此,摘要的大规模原库不能作为所有分析的最终乘客分母。卡ID也是识别代理,不是经过逐人验证的自然人身份;一次进站加一次出站才对应一趟旅程,刷卡记录数与出行次数不能直接互换。低频乘客已在筛选中被大量排除,后文所谓相对低频仍主要是在这个保留样本内部比较。
表2示例显示,同一张卡早上进站时票价为0、随后出站结算,傍晚再形成一组进出站。这些记录提供车站与时间,不提供实际列车、换乘路径、职业或出行目的。表3将日期匹配到当日最高最低温、湿度、气压、风级与预警等信息,不能由这些城市日尺度数值还原每个人所遇到的局地天气。
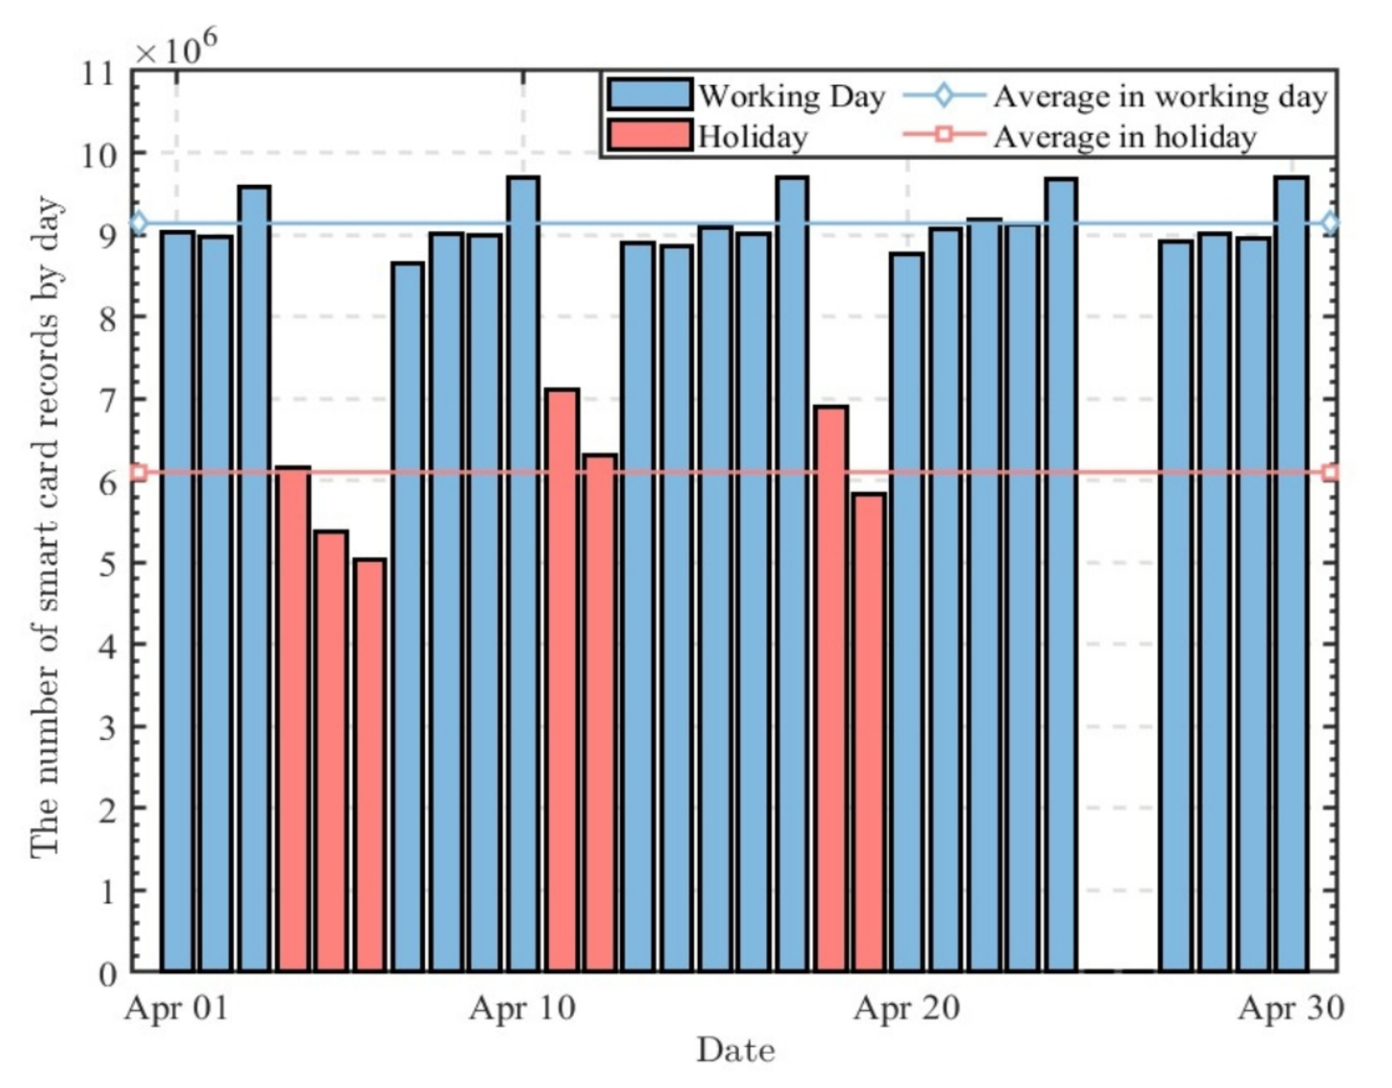
图4|假日和工作日的记录呈现怎样的相对变化?
横轴为4月日期,蓝色为工作日、红色为假日,横线为两类日期均值;25、26日留空。图示假日记录通常较少。原图纵轴记录数尺度与正文原库总量并未统一说明,本文不据此反算总客流;这张图用于理解日期差别与缺测,不能将空白日认定为停运或无人出行。来源:原论文 Fig.4。
假日变量合并周末和法定假日。样本只覆盖清明节相关日期及少数周末,没有足够证据分别识别国庆长假、普通周末和临时放假的效果。城市规模的描述也不能替代这个2015年4月样本的实际覆盖。
四个标签,各自能说到哪一步?
模型的一条样本是某卡某天的完整地铁日志,而不是一条刷卡记录。研究以整个观测期里最常见的起讫点与时间模式作为常规参照,区分:
| 标签 | 论文中的判据 | 解释时需要保留的边界 |
|---|---|---|
| Y0 常规 | 日志符合常见起讫点,时间在规定范围内 | 常见不等于已经验证的通勤目的 |
| Y1 时间改变 | 起讫点不变,出发时间明显提前或推迟 | 主分析门槛为90分钟,不是几分钟的晚点 |
| Y2 路线改变 | 至少一次出行的起点或终点改变,不论时间是否同时变化 | 测到的是起讫站变化,不是同一OD内改走另一条换乘线路 |
| Y3 取消 | 依据历史模式预期的一次地铁出行没有出现 | 不能区分取消活动、改乘其他交通工具、换卡或离开观察系统 |
90分钟的门槛对应操作性定义,附录再比较60与120分钟。正文示意的等号边界与文字描述并不完全一致,因此不把正好90分钟的单个例子当作精确编码标准。更关键的是,判断通常会不会有某趟行程,是由常见模式推定,不是读到了乘客真正提交的出行计划。
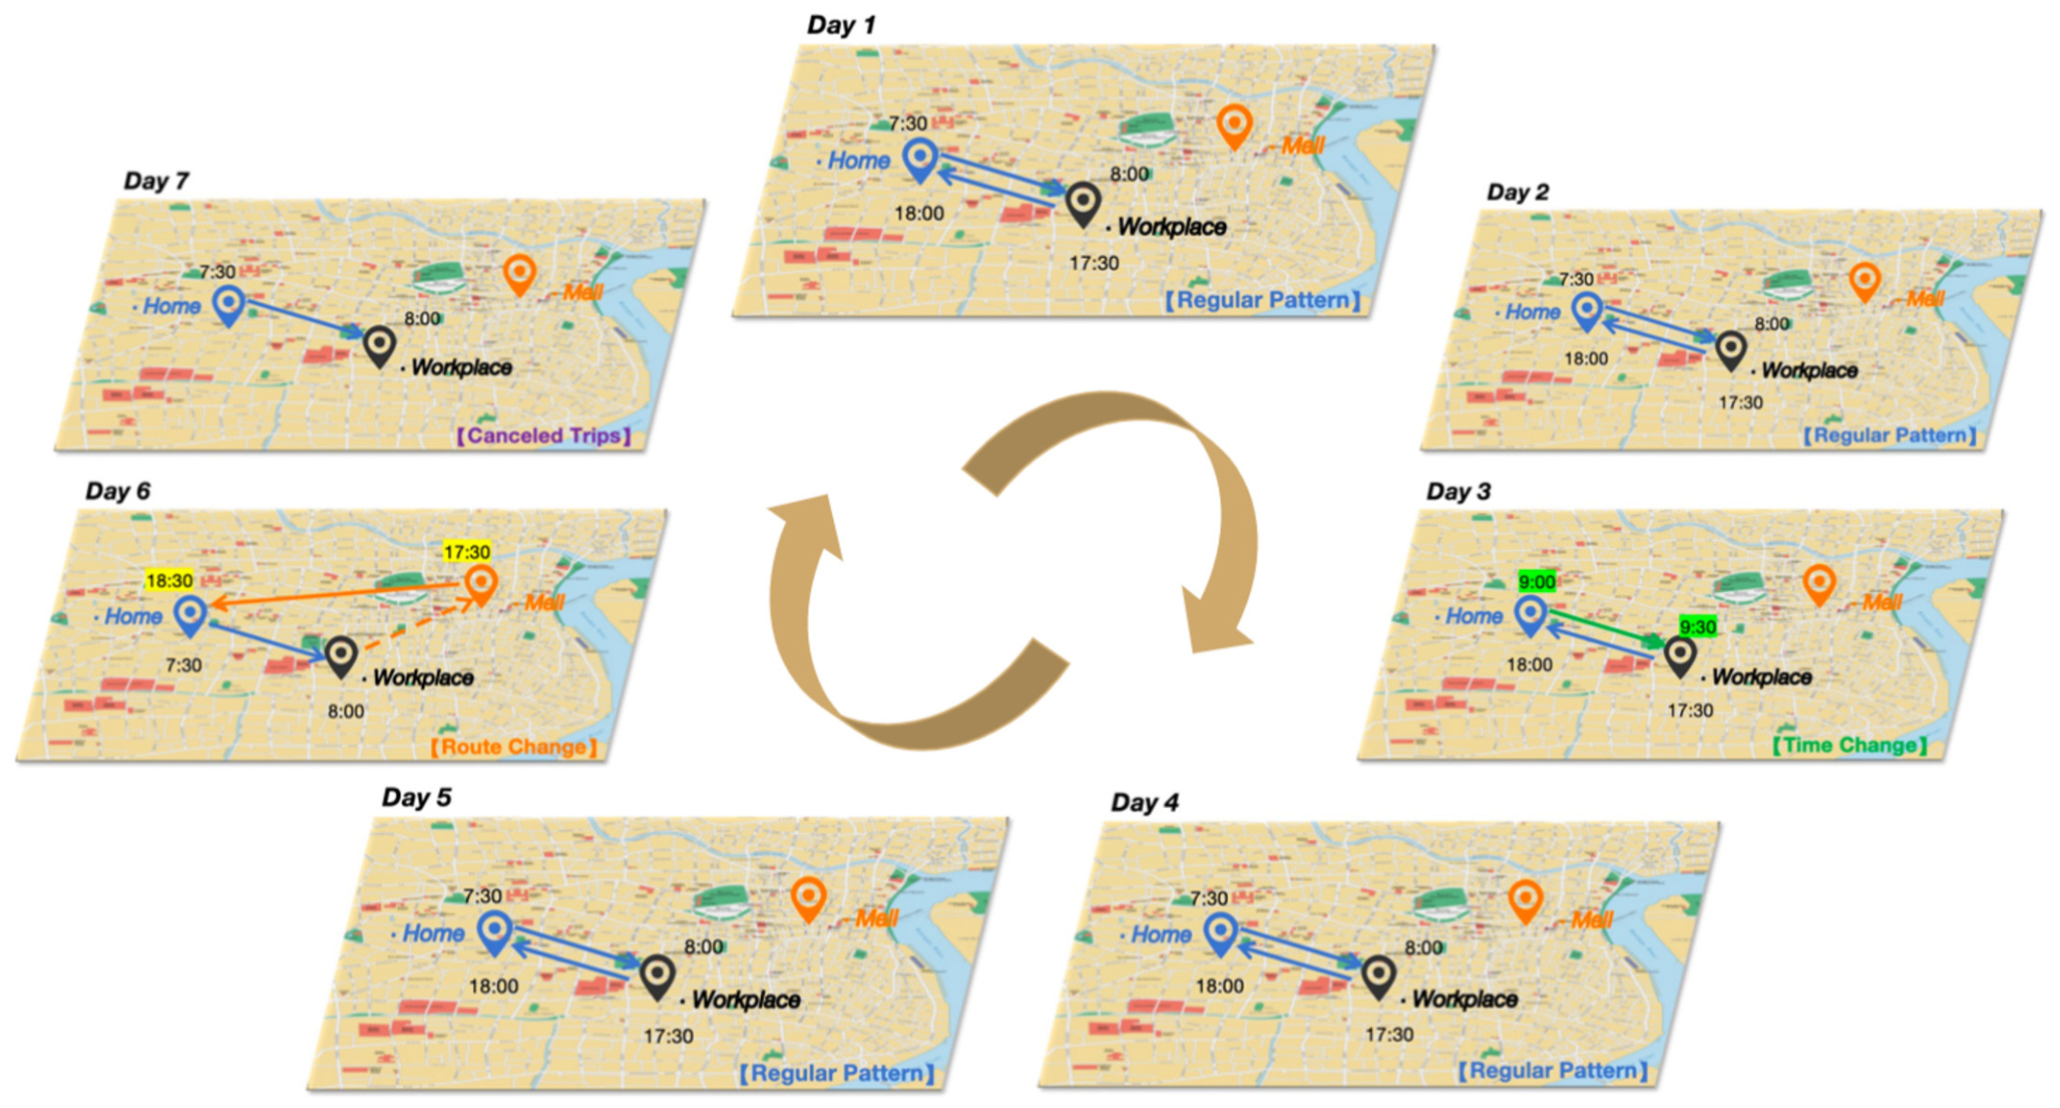
图1|同样偏离常态,为什么需要分成不同类型?
七天示意中,第1、2、4、5天遵循重复日志,第3天展示时间偏移,第6天改变目的地,第7天缺少原本预期的回程。地图是说明标签的假想乘客案例,不能当作真实乘客被确认的家与工作地。整组日序列保持原始排布。来源:原论文 Fig.1。
模型知道哪些事情,又不知道哪些事情?
表1把特征分为个人使用历史与外部环境。使用历史包括日均次数、周均次数、各周次数的标准差std_week、当日实际次数trips,以及日末目的地是否等于首趟起点的loop。loop=1表示地铁日志闭环,不保证乘客整天的全部活动链闭合。
外部特征为假日、天气与预警。论文按特征组介绍,而SHAP图将多类天气预警拆成不同列,所以图中行数多于文中概述的12组。所谓个人特征在这里主要是使用记录,不是年龄、收入或职业。把某些点解释成销售人员、刚搬家者或时间紧张的上班族,都属于作者的可能解释,未得到身份标签验证。
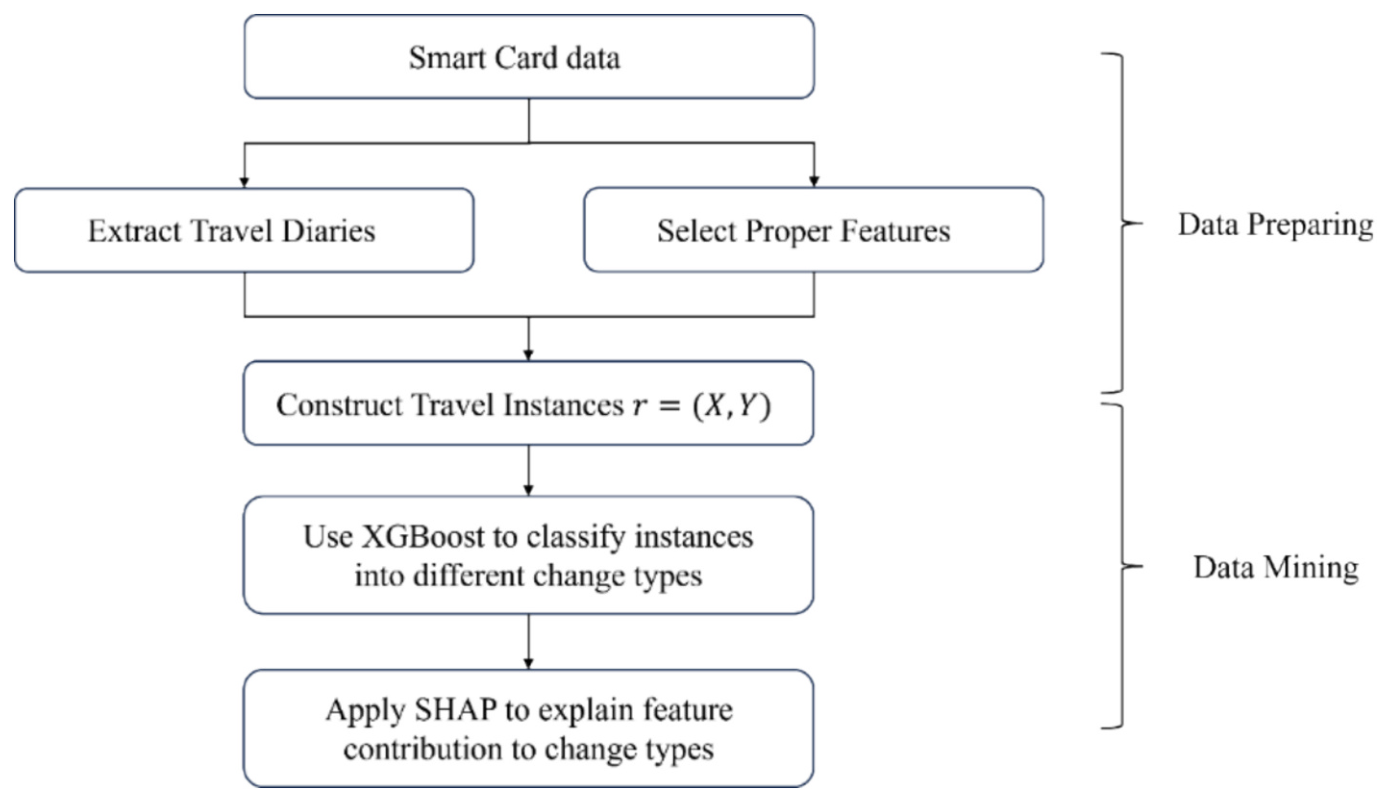
图2|从刷卡日志到解释,哪些步骤依赖预先定义?
原图自上而下为提取日志与特征、构造带标签样本、XGBoost分类、SHAP归因。标签在进入分类器之前已经按规则生成,因此模型成功模仿标签,并不独立证明这些规则还原了真实计划或原因。来源:原论文 Fig.2。
XGBoost把许多树的判断加在一起,输出四类分数并进行分类。表4报告树深7、很小的学习率与正则化等训练选择;网格搜索与早停是拟合策略,不是跨城市有效性的证明。日均与周均等变量可能相关,SHAP如何分配它们的贡献也会受到特征依赖影响。
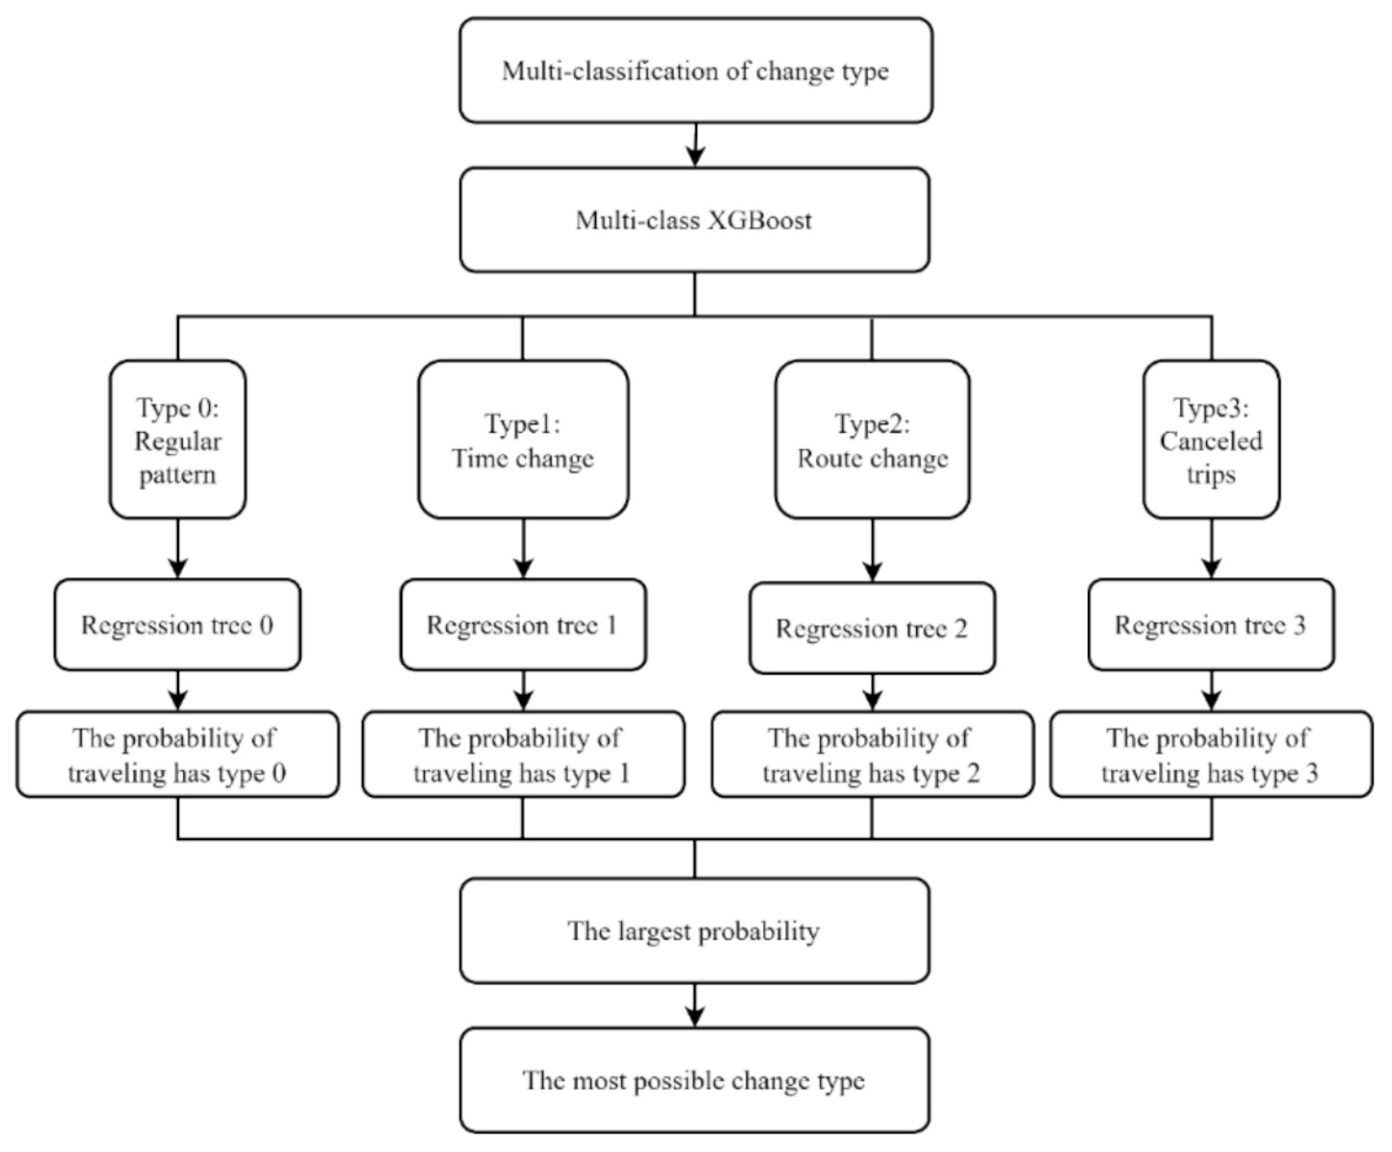
图3|模型怎样从特征选择一个变化类型?
完整流程图为四类建立树模型输出,最后选取最大预测概率对应的类别。它说明分类机制,不说明模型已知乘客心理,也不说明当天发生之前这些输入已经可得。来源:原论文 Fig.3。
当日trips和loop只有当天日志形成后才完整可知,常规模式与周统计又利用整个观测期。因此当前任务主要是回顾性辨认变化。若要提前一天预报,就必须只使用当时之前可得的数据,重新构造标签、特征与验证,而不能直接沿用目前的分数作为前瞻预测证据。
时间改变较少,分类成绩应该怎样读?
原始四类标签并不均衡,Y1远少于其他类型。论文用随机过采样增加Y1,使其数量达到其他三类数量的平均值。增加的是训练中被重复使用的记录,不是新增乘客或新增时间改变事件。
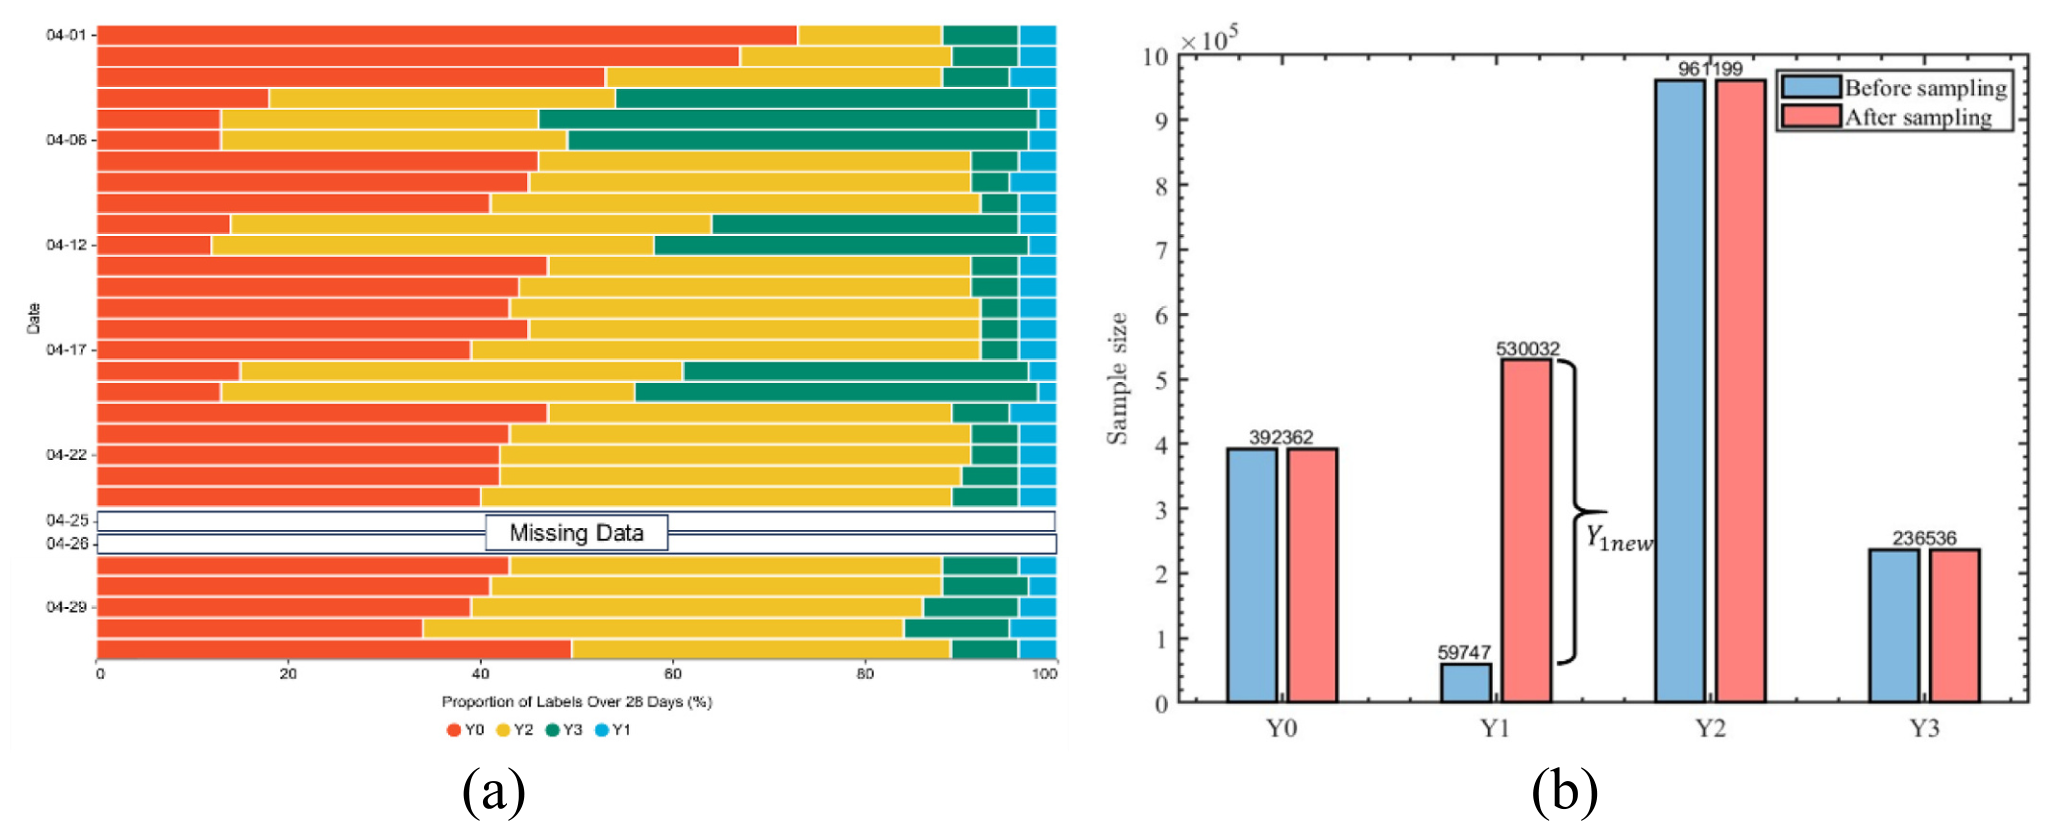
图5|模型是否在原始类别比例上学习?
(a)各日期四类日志的比例及缺失日期,颜色对应Y0—Y3。(b)重采样前后各类数量,Y1被扩充,其他类作为参照。模型输出的概率受抽样后类别构成影响,未经原始分布校准,不能直接当成真实系统中发生概率。来源:原论文 Fig.5。
图6的AUC依次约为Y0 0.75、Y1 0.90、Y2 0.81、Y3 0.85。AUC衡量分数区分目标类与其他类的能力,不等于多分类准确率。混淆矩阵对角线上,真实Y0和Y3被分对的比例都只有约0.45,Y1约0.75、Y2约0.67。排序表现尚可,并不意味着每种日志都已可靠识别。
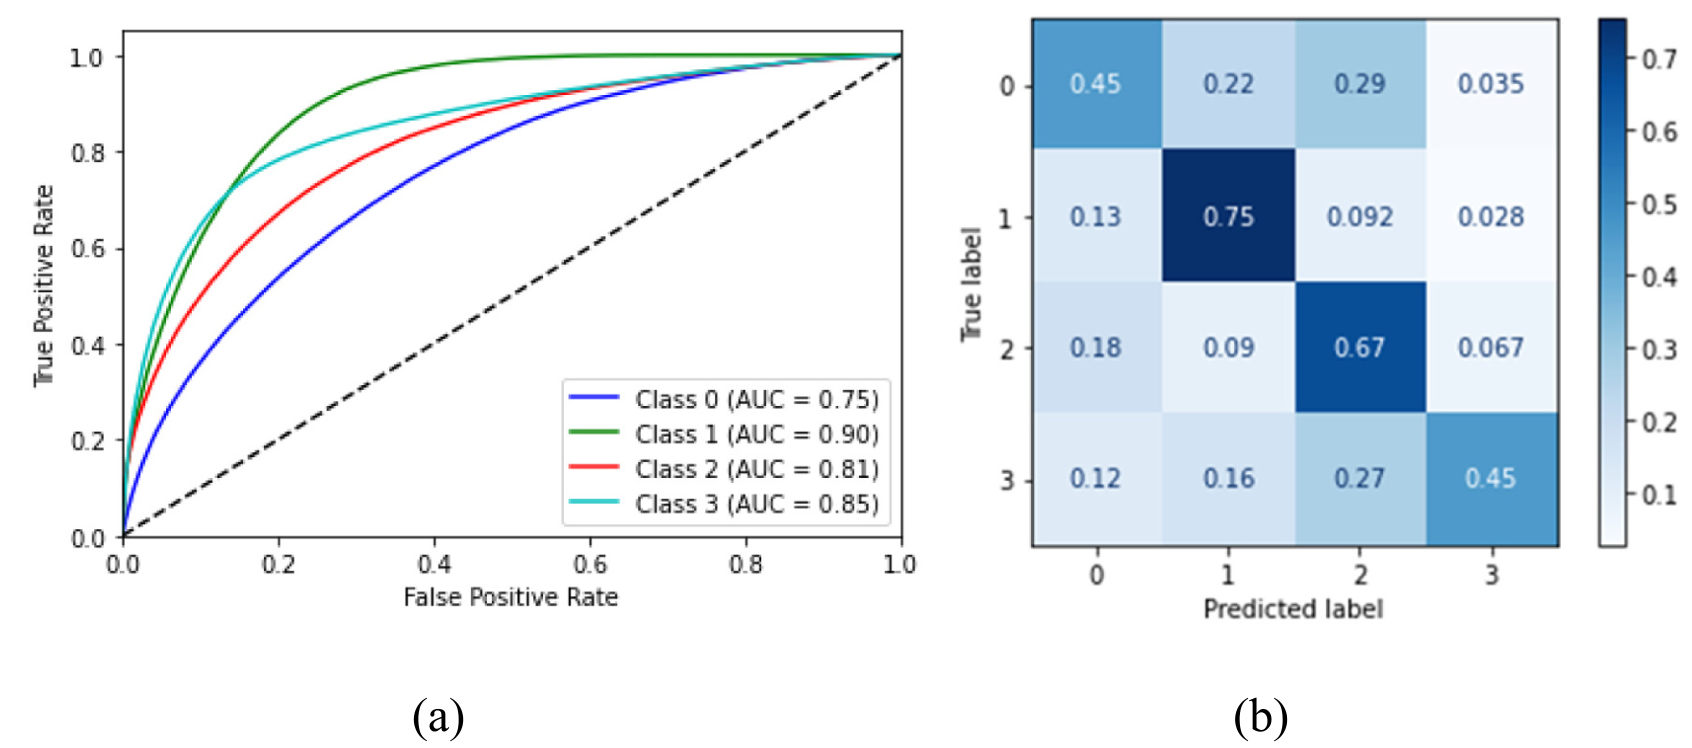
图6|较高AUC是否意味着每类乘客都能被准确判别?
(a)四类ROC曲线及AUC,黑虚线为无区分参照,最低值为0.75。(b)行是真实标签、列是预测标签的归一化混淆矩阵;Y3约27%被分成Y2,Y0也与其他类混淆。矩阵并未提供原始类别分母,不能从它直接得出总体准确率。来源:原论文 Fig.6。
公开代码示例另采用每类抽取3万条后随机7:3拆分,并以测试部分做早停;这与正文所述全量Y1过采样流程不能直接视为完全相同的最终实验。它也没有按乘客或未来日期隔离。故图6尚不足以证明对陌生乘客、未来月份或新城市的外推能力,论文数据不公开时更不能声称已经复现其全部指标。
假日为什么更像缺少原来的行程,而不只是晚一点出门?
SHAP把一次模型输出相对背景值的变化分配给各特征。图中横轴正值表示把模型输出推向该目标类,负值表示远离;颜色从蓝到红表示特征值由低到高。它解释的是模型怎样利用信息,单位不是百分点,不能用SHAP=1解释为概率增加100%。
Y0图中,假日为高值的红点主要位于负侧,较大的周次数波动也偏负;当日次数高时,很多点远离常规模式。数据允许我们说模型在这些条件下较少选择常规标签,但还不能确认某个人究竟因休假、照护或临时安排改变了行程。
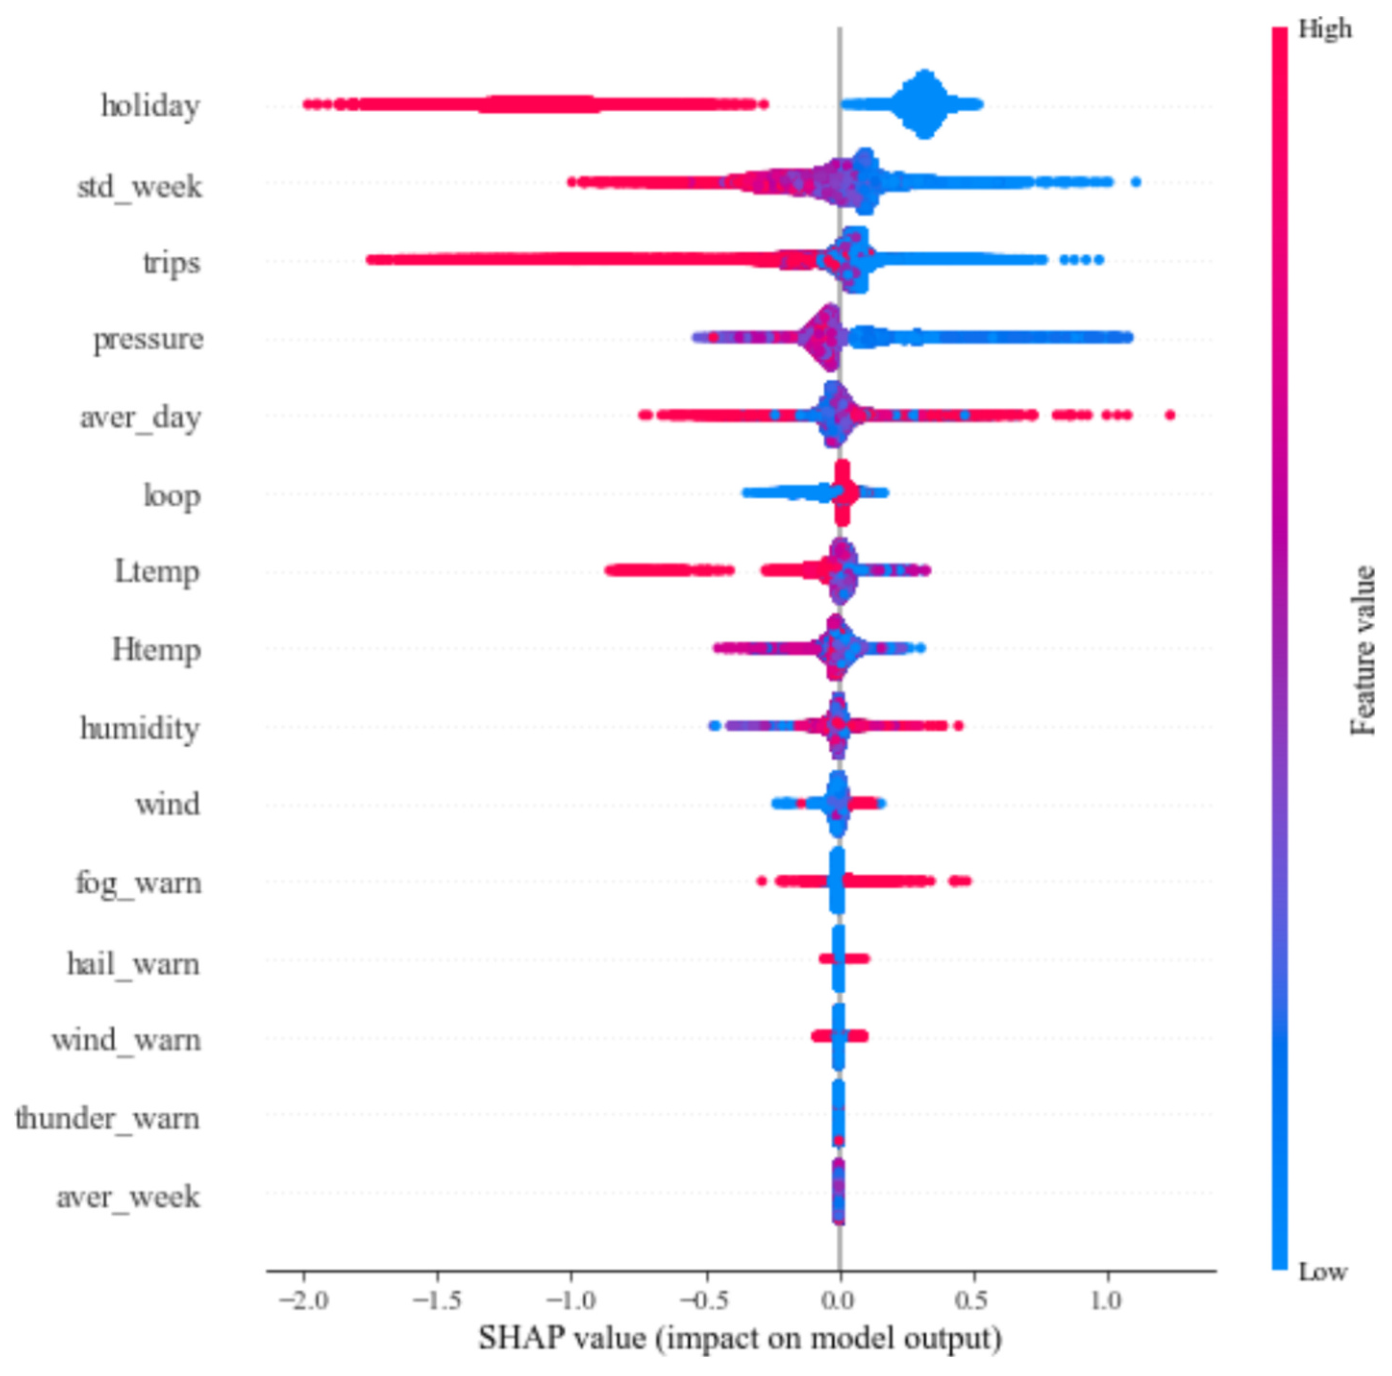
图7|哪些特征让模型更少判断为常规?
纵轴按平均绝对SHAP排序,holiday最高,其后是std_week和trips;红色假日点大多在负侧。每个点是一条日志的归因,不是一名乘客的因果效应,也不是显著性检验结果。来源:原论文 Fig.7。
在Y3中,假日高值与周波动高值主要推动取消标签。取消仍是预期地铁行程缺失:假日不必上班、改变活动与改用其他方式,都可能造成同样观测。论文未对这些替代机制逐个区分。
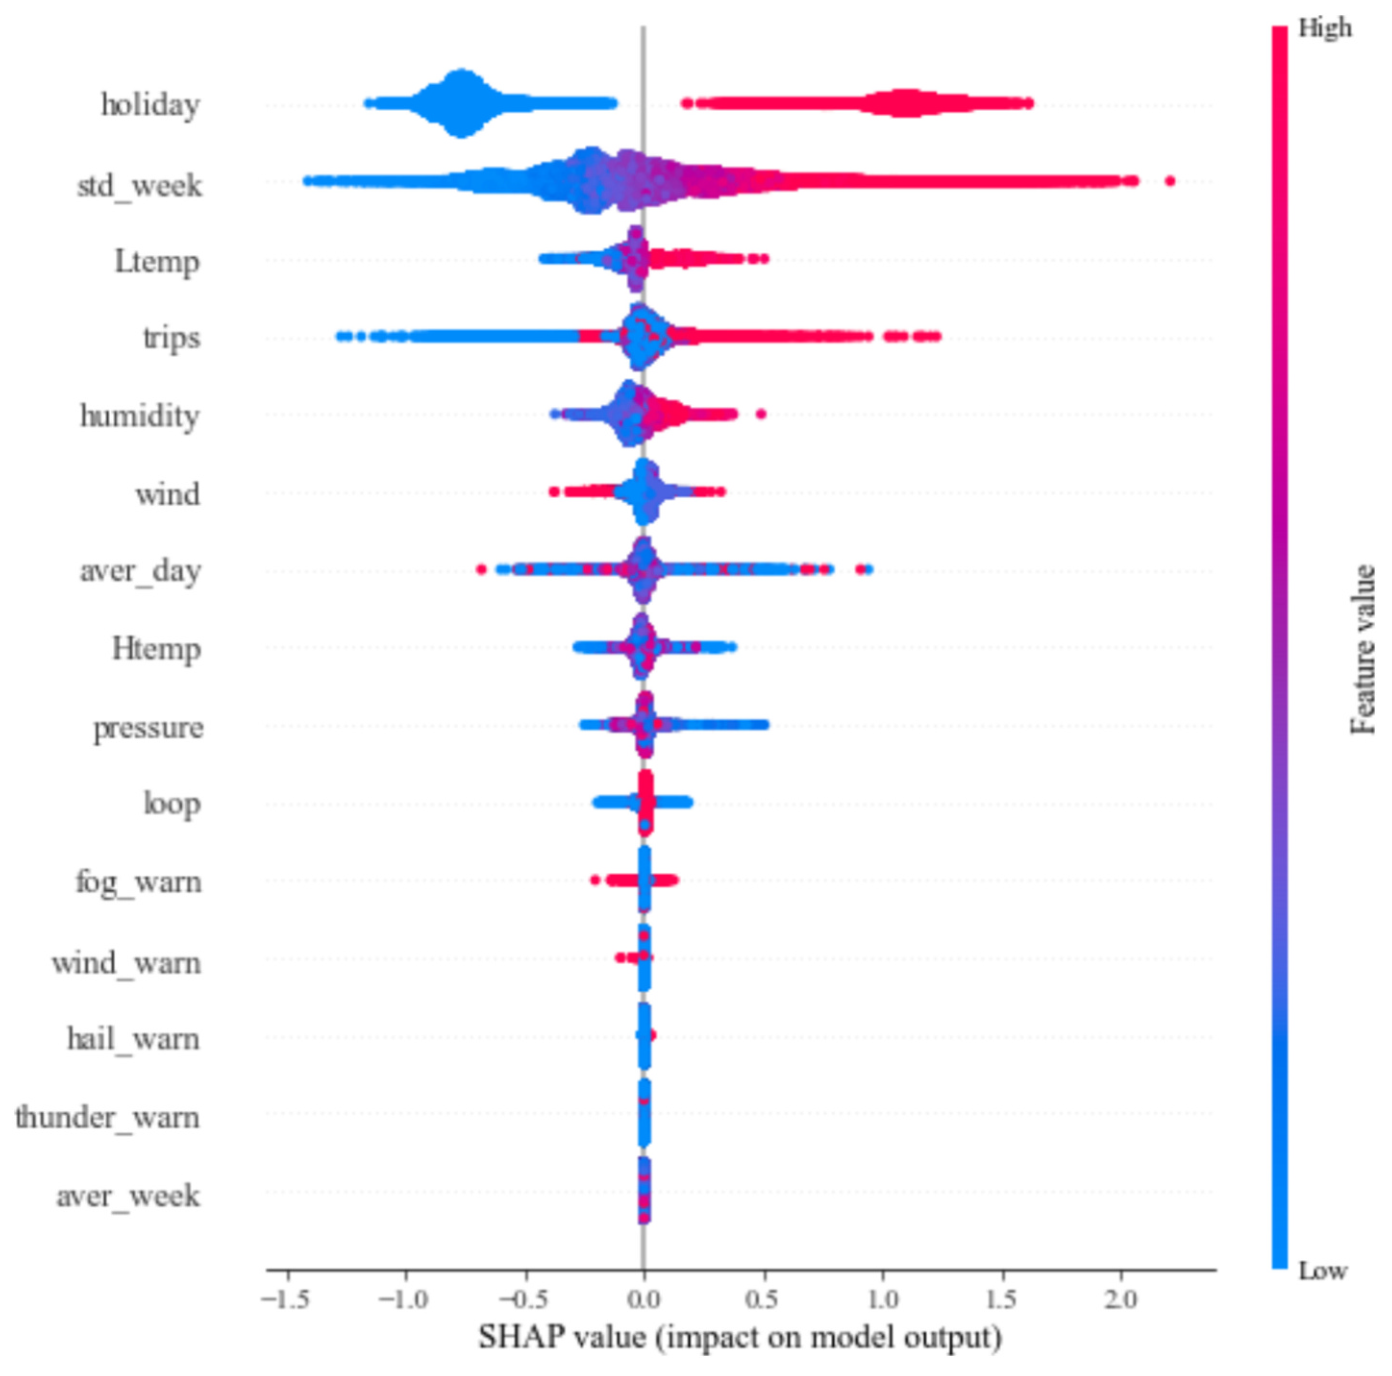
图10|什么样的日志更容易被判为预期行程缺失?
holiday与std_week位居前列,高值多在正侧;天气预警多数靠近零。这里的取消是定义生成的标签,不是经过乘客确认的取消计划。来源:原论文 Fig.10。
部分依赖图(partial dependence plot,PDP)尝试把某一变量设成不同值,再对模型输出平均。假日从0换到1时,Y3曲线约由0.10升到0.60,Y0约由0.33降到0.09。它是模型在处理后的样本中的响应,不是对真实乘客随机放假后测得的增幅。
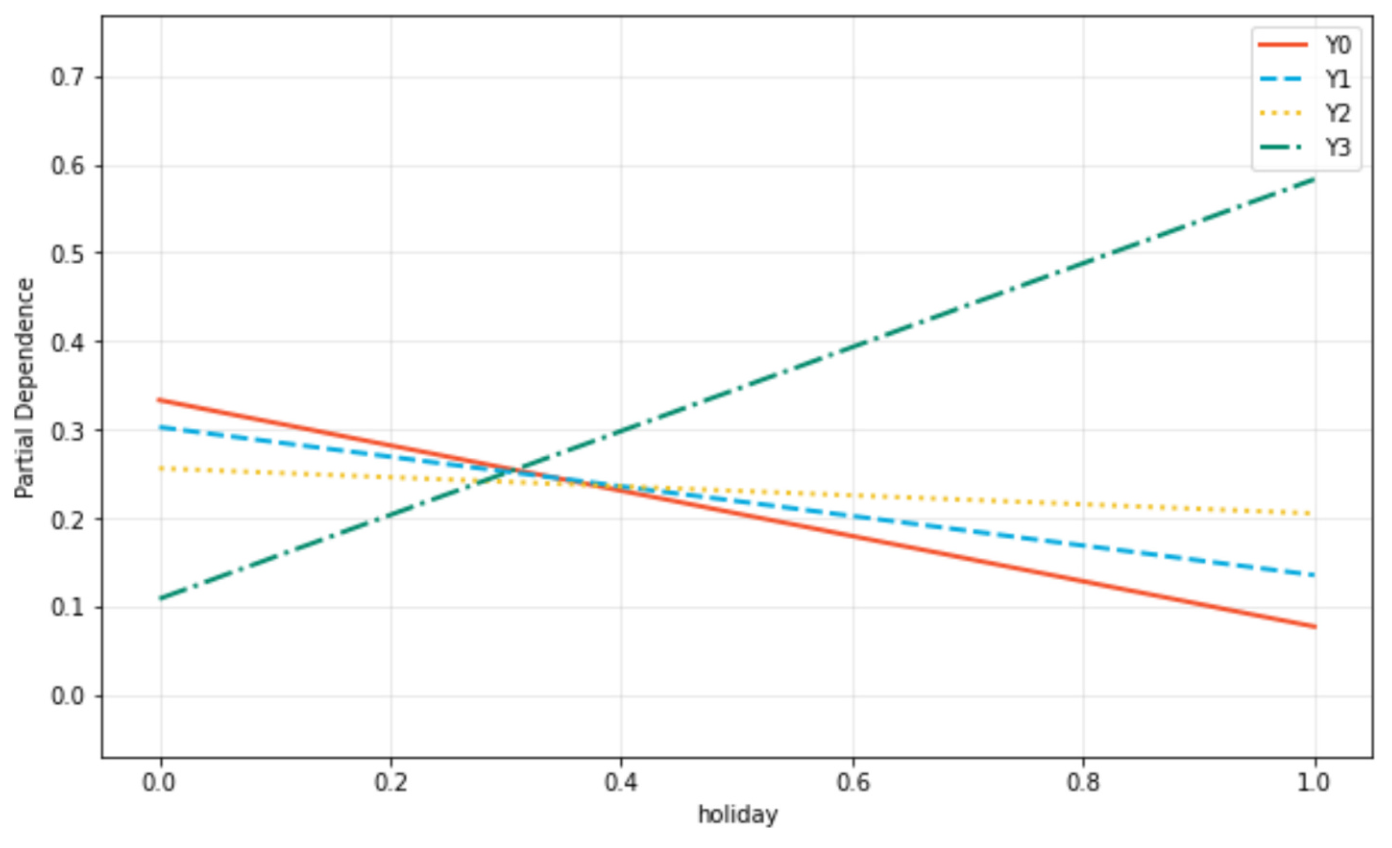
图11|固定其他输入,模型如何响应假日指示?
横轴holiday只有0与1具有真实二元含义,四条线为四类平均预测响应;中间直线是两个端点之间的连接,不能解释成0.4个假日。Y3上升,其他类下降,数值受类别重采样和相关特征组合影响。来源:原论文 Fig.11。
次数多的人,是更爱换路线,还是更难只改变时间?
Y1中trips是最重要特征,较高次数的红点多数在负侧;Y2中较高次数则更多位于正侧。loop也有对照:非闭环日志更易与起讫点变化相联系,闭环日志相对更易与时间改变相联系。
但trips是当日已经发生的次数,标签又依据同一天日志与常规模式的差别生成,这里面既可能有行为关系,也有定义与共同测量形成的联系。多次出行增加出现不同起讫点的机会,并不自动证明这名乘客更熟悉网络或认知上更愿意探索。
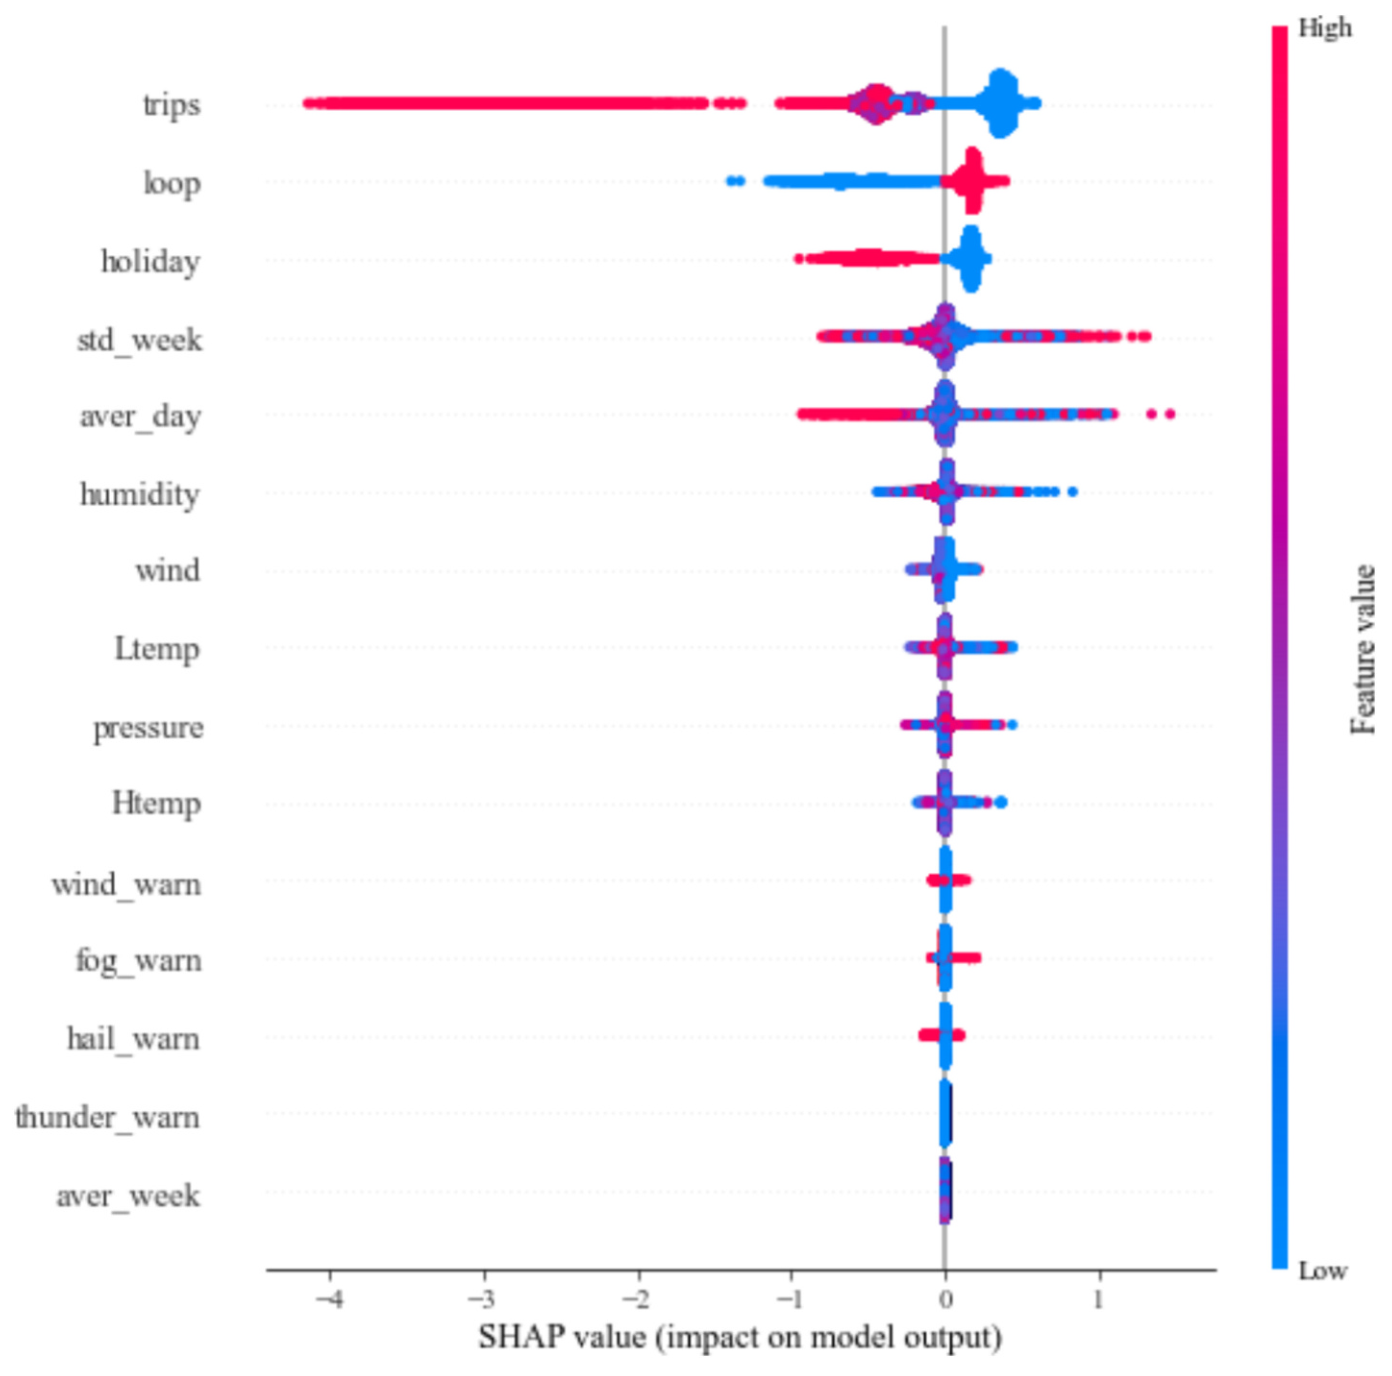
图8|哪些日志更不像单纯时间改变?
trips、loop和holiday排序较高;当日次数较高多推动模型远离Y1,非闭环的低loop点也多为负。SHAP范围表示模型输出尺度,不是提前或推迟了多少分钟。来源:原论文 Fig.8。
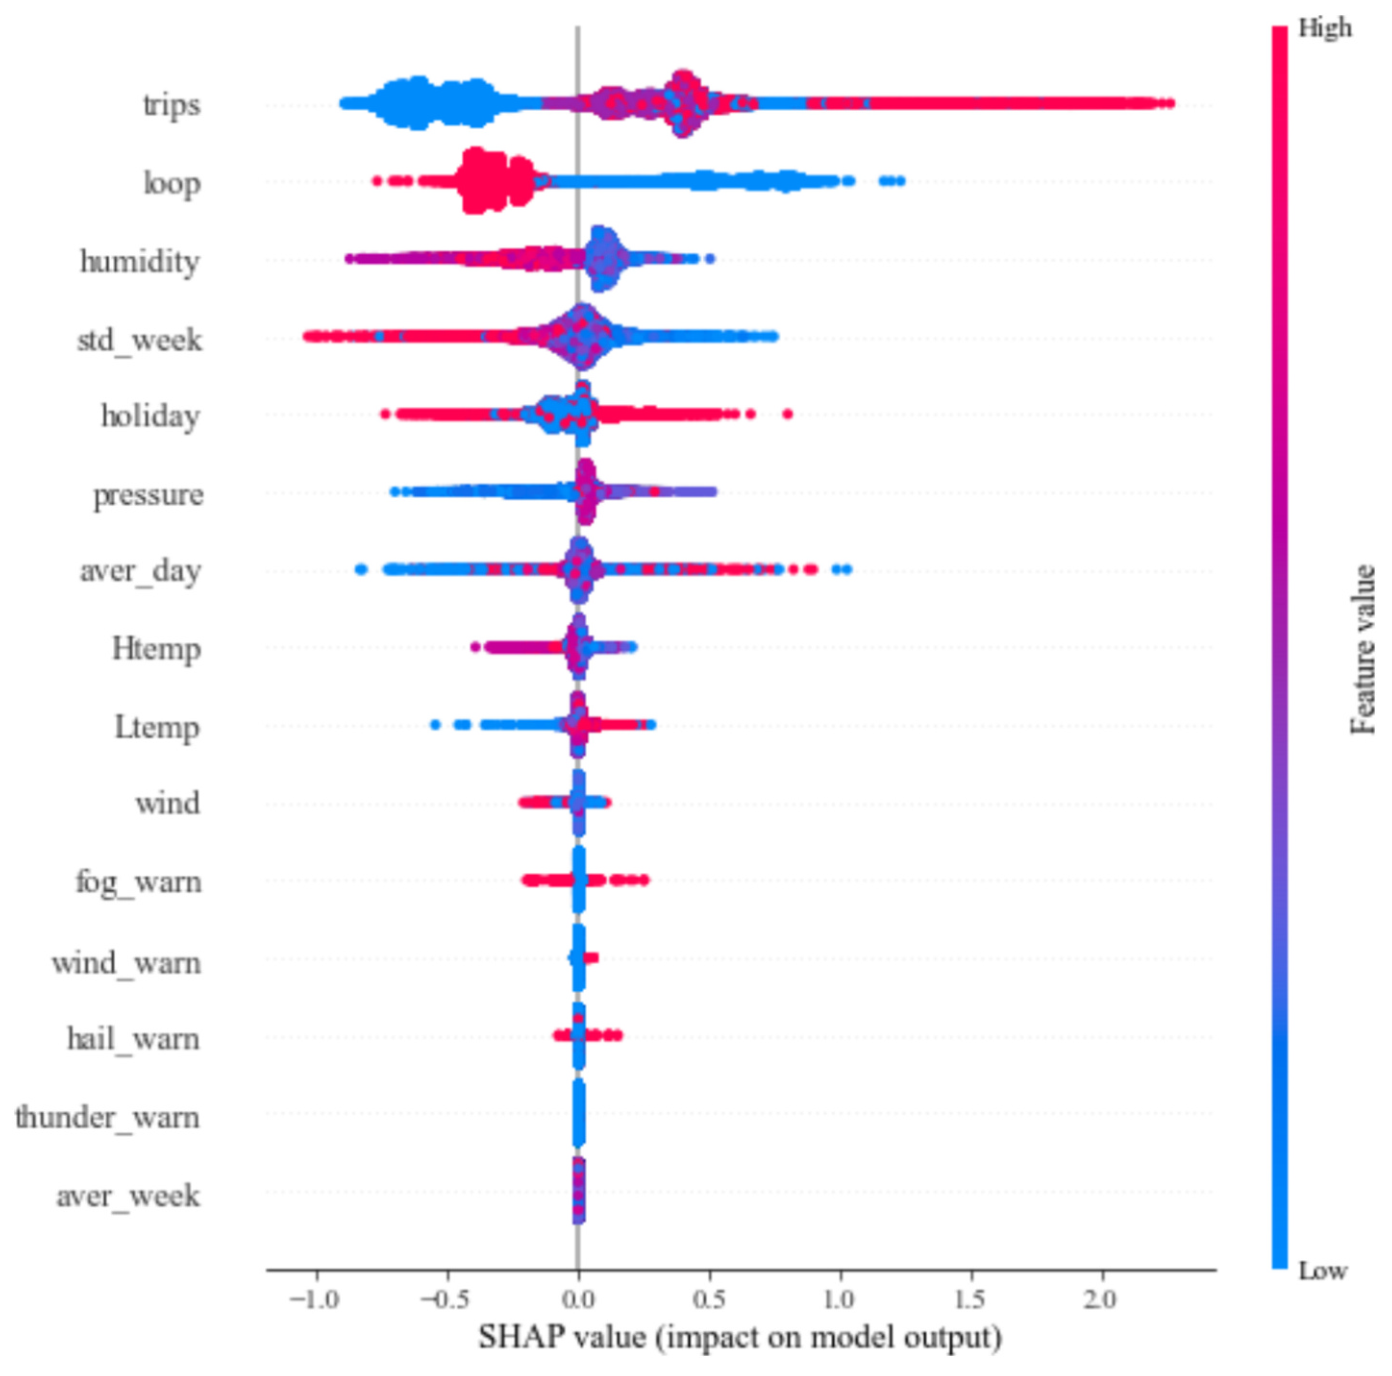
图9|当日次数与闭环,对起讫站变化的判断有何关联?
高trips红点多偏正,闭环红点多偏负、非闭环蓝点多偏正。模型没有观测同一进出站之间实际走哪条线路,因此图中route change仍须按起讫点变化理解。来源:原论文 Fig.9。
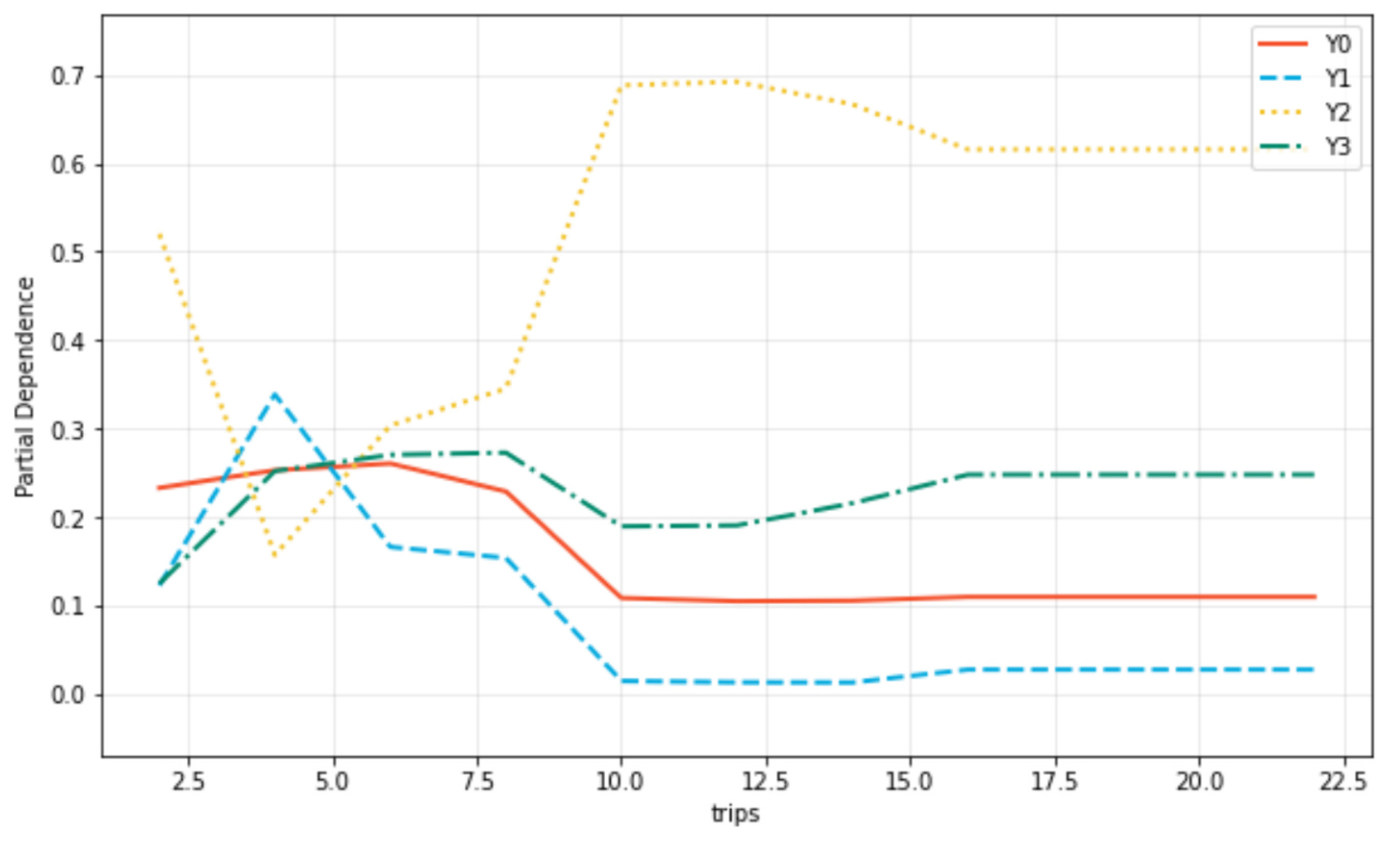
图12|次数与变化类型的关联,是一条直线吗?
横轴为当日出行次数,四线为PDP响应。Y2呈低次数较高、约4次较低、较高次数重新升高的非单调形态;Y1在约4次附近较高,之后下降。图形没有给出各高次数区间的样本支持与不确定性,不能把4次或10次当成适用于所有乘客的精确干预门槛。来源:原论文 Fig.12。
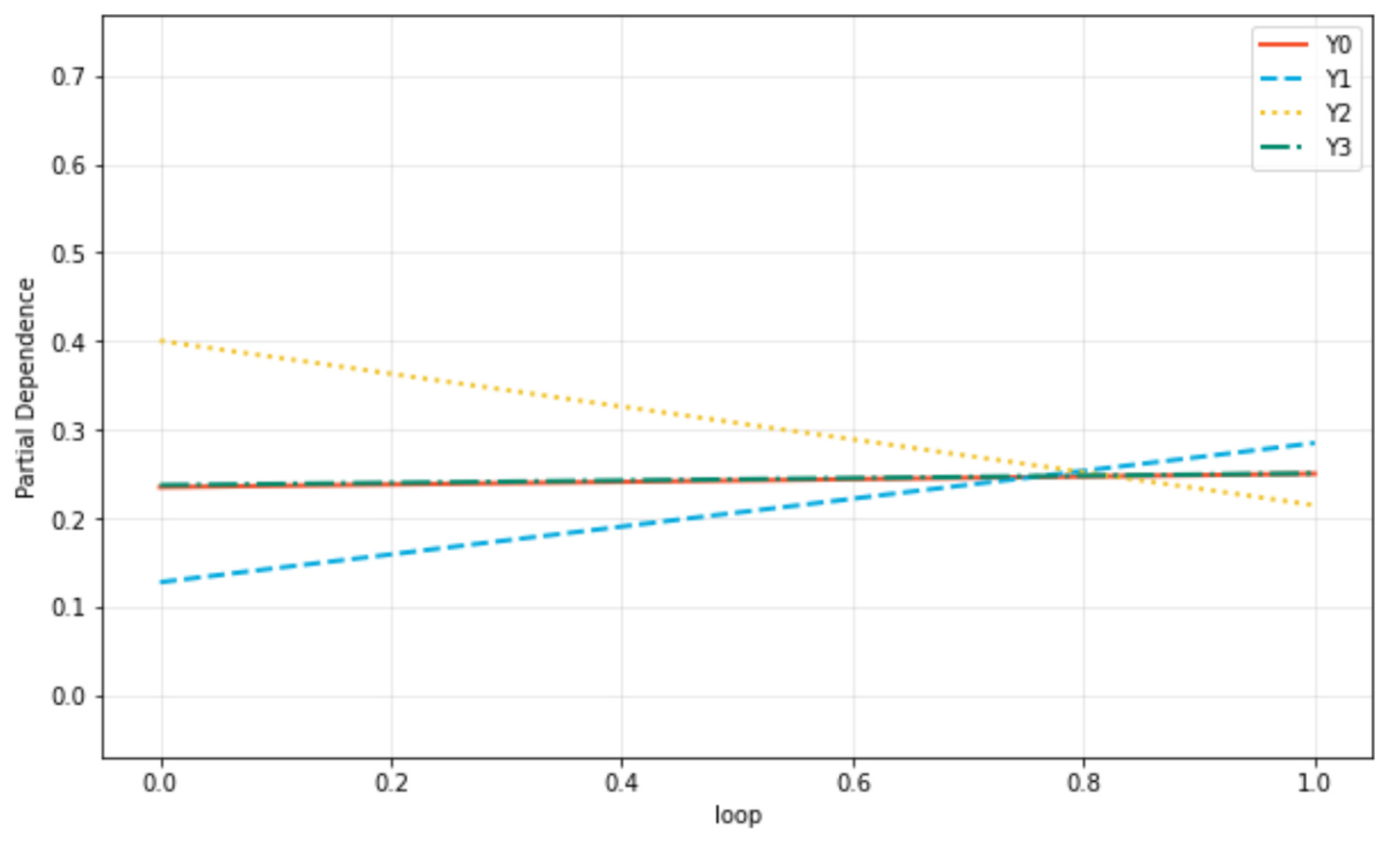
图14|回到起点的日志,更可能发生怎样的偏离?
loop从0到1,Y1约由0.12升至0.29,Y2约由0.40降至0.21,Y0和Y3变化较小。只有0与1对应实际类别,中间位置是可视化连接;这些是模型平均输出,不是闭环造成时间偏移的因果作用。来源:原论文 Fig.14。
周出行波动与天气,哪些结论更依赖这一个月?
std_week是各周出行总次数的标准差,不是当天次数的标准差。PDP显示它越大,模型越倾向选择Y3,曲线约由0.14升至0.57后趋平。每月周数很少,月底两天缺失也会影响周覆盖;没有长期重复观察,不能把这一指标直接当作稳定的人格或全年不规律程度。
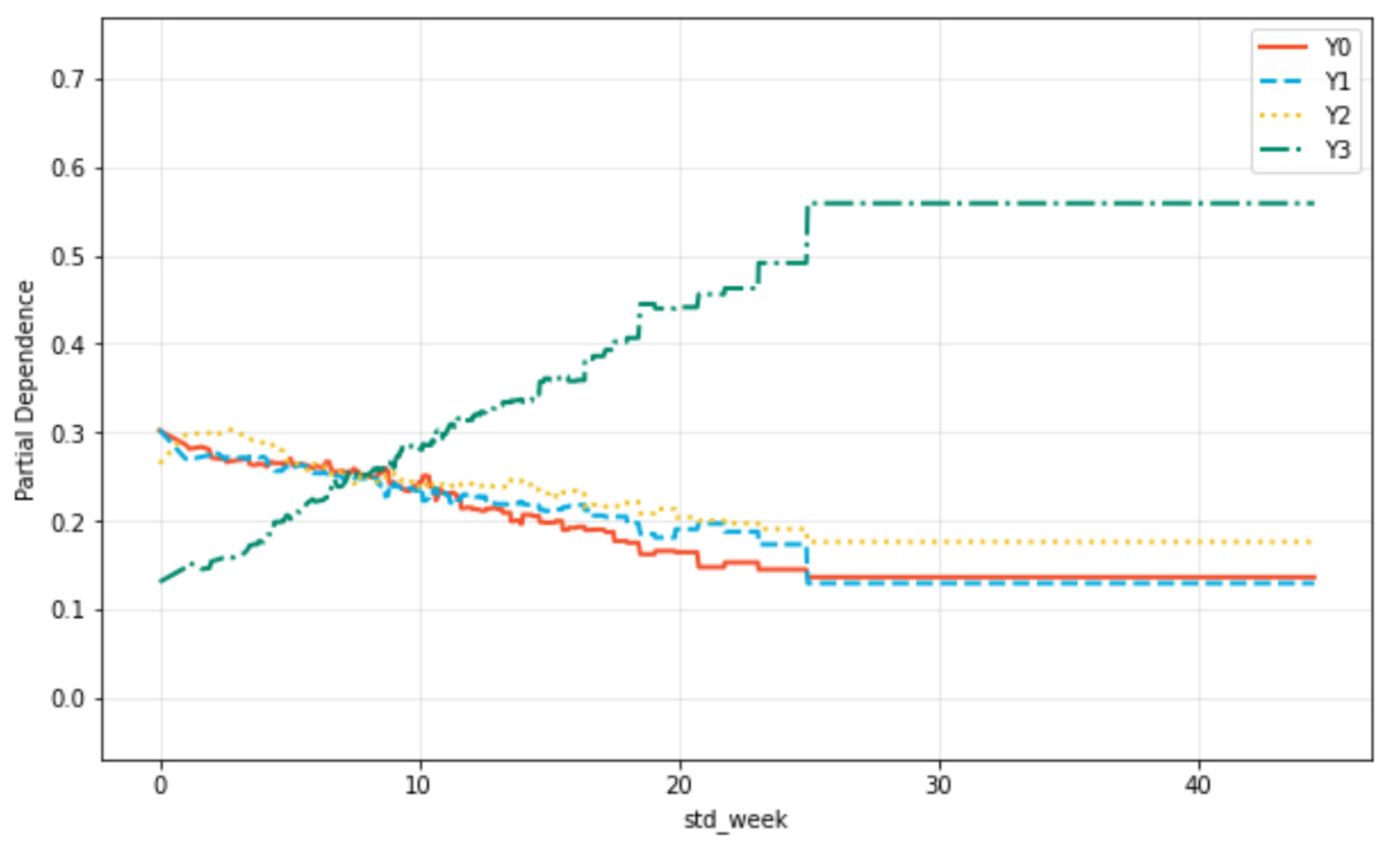
图13|不同周使用量差别较大,模型更倾向哪一类?
横轴std_week,纵轴为四类PDP响应;绿色Y3随波动升高,其他三类总体下降。它展示当前模型的非线性描述,不能证明减少周波动就会让取消概率按曲线下降。来源:原论文 Fig.13。
天气预警行在几张SHAP图中接近零,这是这个样本中的较小预测贡献。城市级天气按日期共享,数万张卡并不等于数万个独立天气事件;这一个月没有覆盖台风、洪水等极端扰动。低重要性可能受到天气范围、记录尺度、变量相关与筛选影响,不能据此宣称地铁出行天然不受天气影响。
时间门槛改成一小时或两小时,解释会翻转吗?
附录B把时间改变门槛改为60与120分钟,比较四类SHAP排序和方向。主要特征仍相近,部分前列排序移动一两位,没有明显出现从极低排名跃到最前列的特征。这支持解释对这一有限门槛变化有一定稳定性。
它没有证明每名乘客标签保持不变,也没有给出各门槛对应的独立未来预测误差。附录A是变量与公式符号表,帮助区分日次数、类别和样本等记号,不是额外的行为验证。
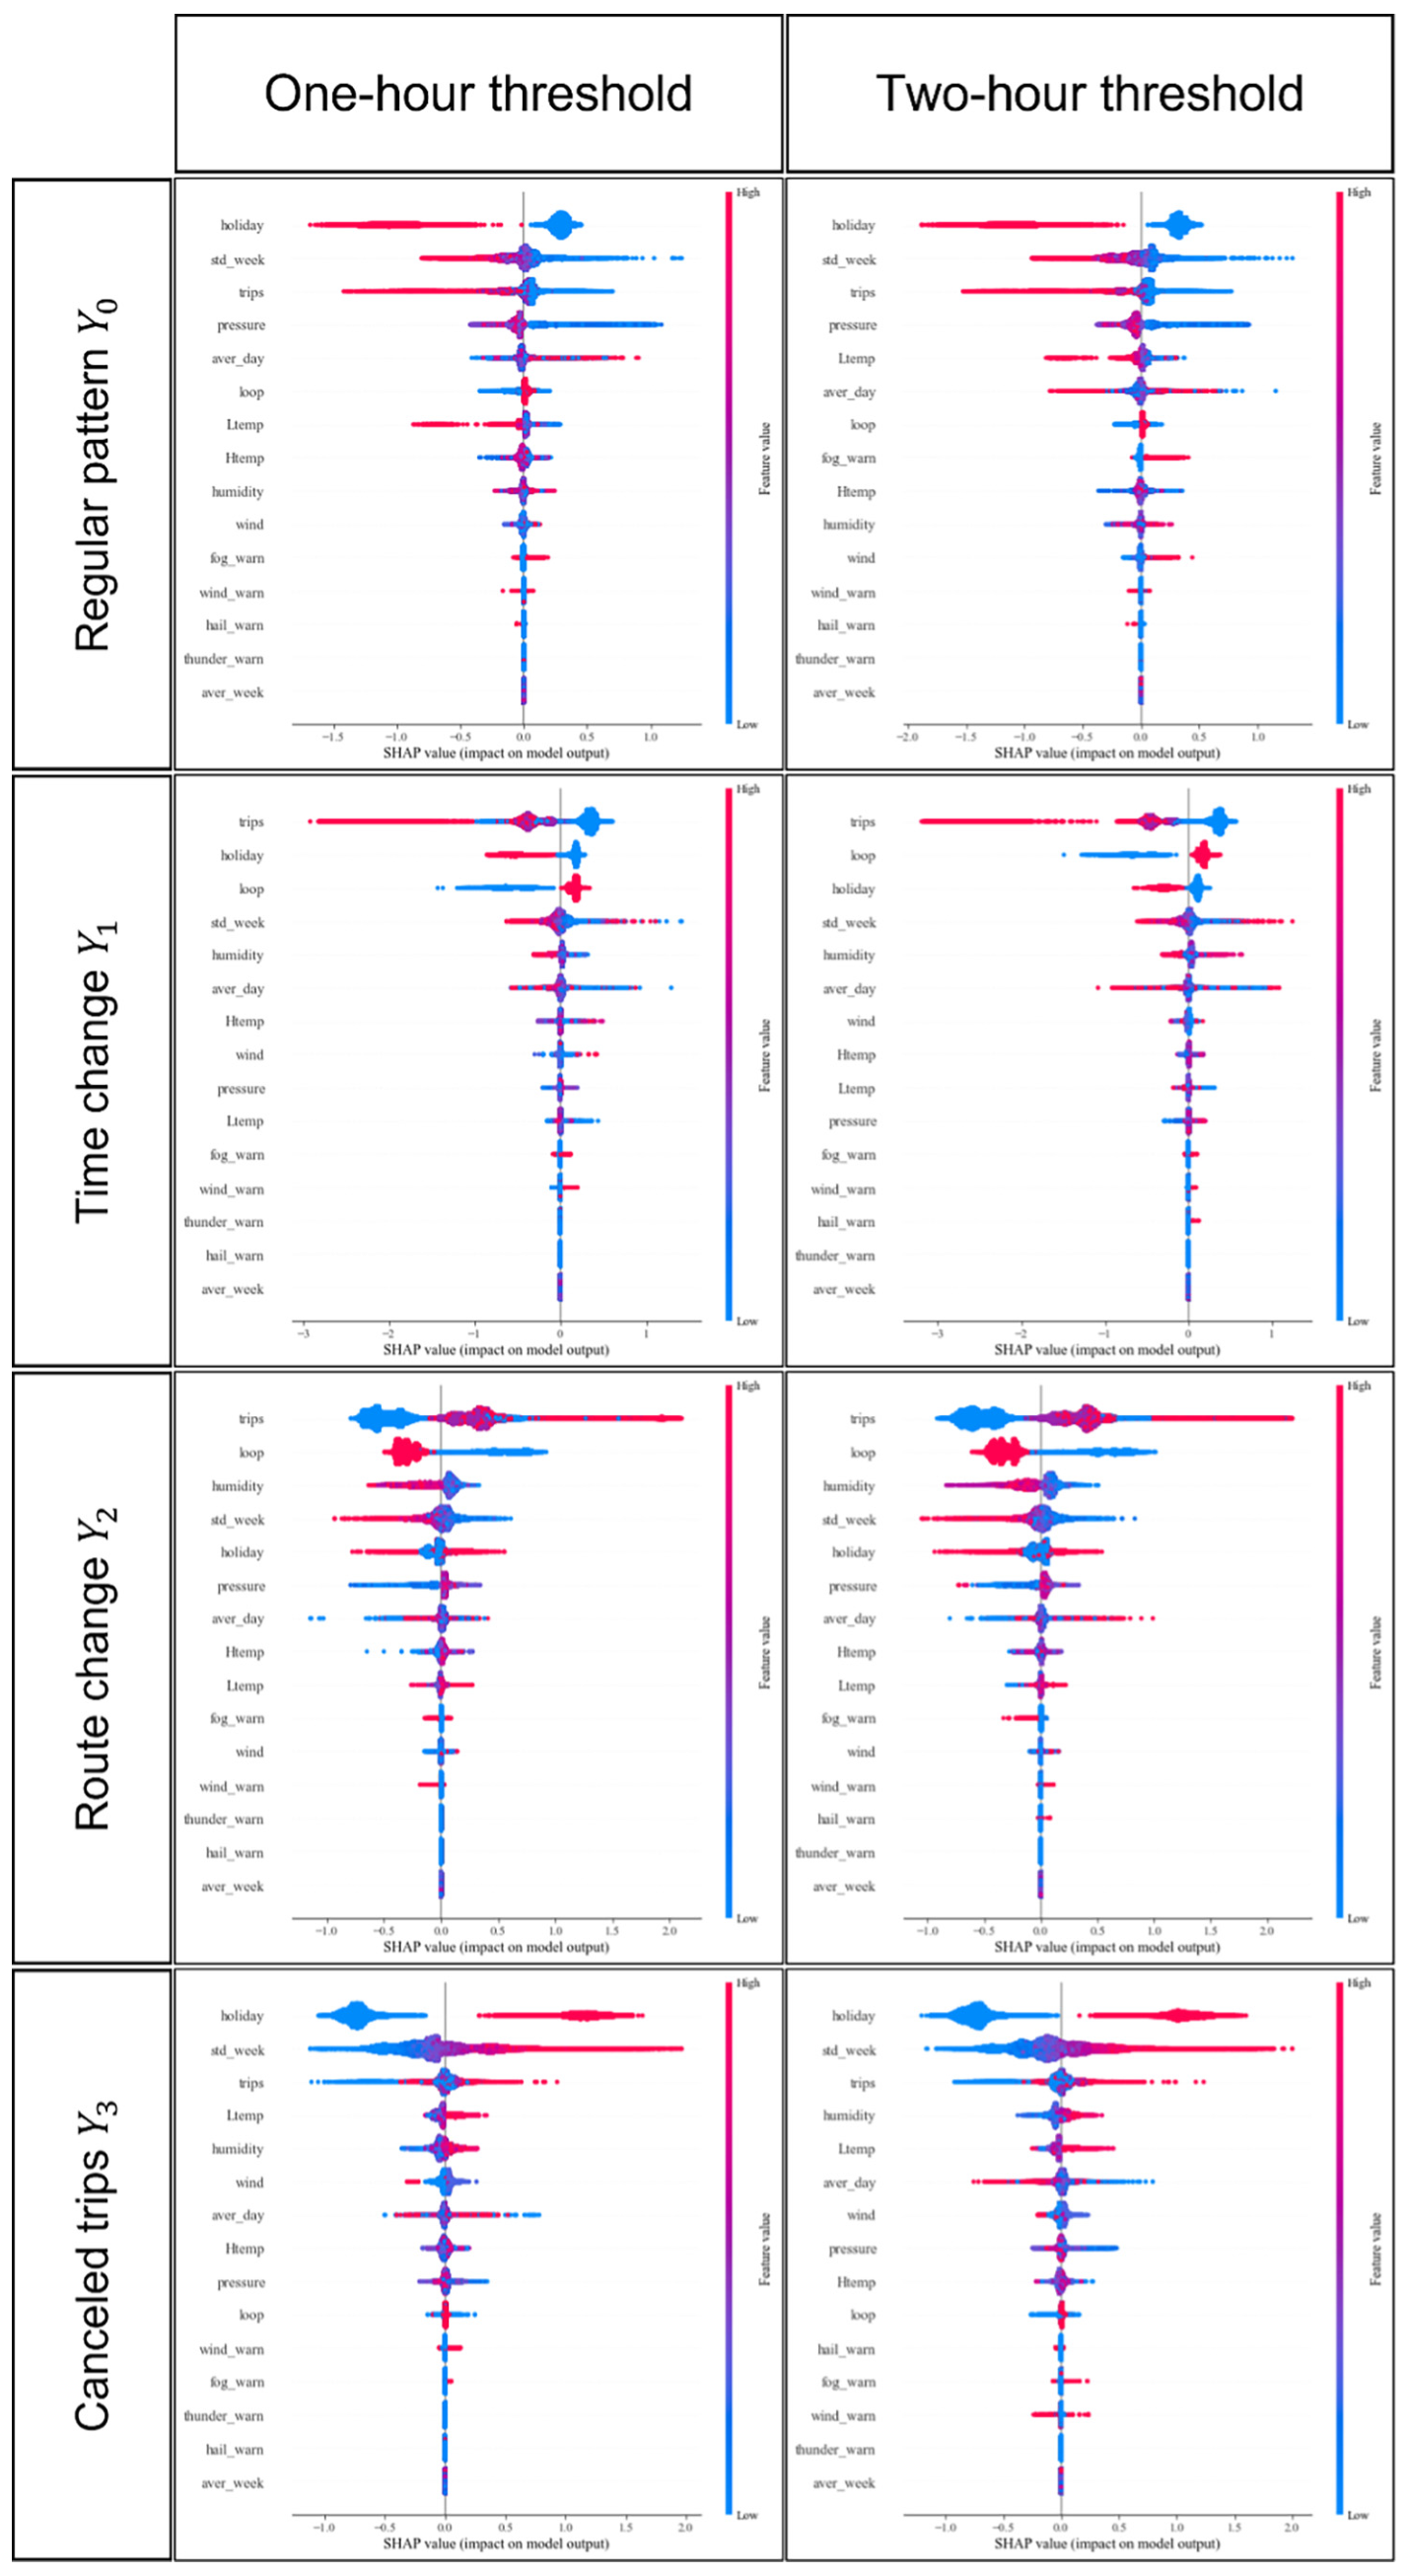
附图B1|换时间门槛后,模型依赖的特征是否大致相同?
两列分别为1小时和2小时,四行依次为Y0、Y1、Y2、Y3;每个面板都是相应类别的SHAP分布,保留整张8面板原图。与主分析比较,主要贡献特征大体相似。稳定的是这组模型解释的总体特征,不能据此推出因果关系、所有阈值或所有城市都稳健。来源:原论文 Fig.B1。
能怎样使用这套框架?
将常规、时间偏移、起讫点改变和预期记录缺失分开,能帮助运营者更仔细地提出问题:某天客流减少,究竟更多发生在常见通勤时段,还是同时出现了不同目的地的新需求?但真正调整运力还需要把个体标签映射到车站、断面与时间需求,并评估增加列车、区间车或信息服务的成本和效果。
论文提出节假日响应、差异化服务等建议,未实施并评估这些措施。标题中的为什么,需要保留统计解释与实际动机的距离:年龄、职业、土地利用、真实活动目的、其他交通方式和突发事件均未被直接观察;一个月的回顾分类,也不等于服务优化已经取得可测收益。
一句话总结
智能卡可以把偏离常态的地铁日志分成几种有用类型,并揭示模型依赖的日期与使用特征,但解释这些标签不等于识别真实取消、换乘路线或行为改变的因果原因。
核心来源
- Tang T. et al. (2025). Why metro passengers change travel behavior: Individual-level insights from interpretable machine learning,Cities 167:106352。正文20页,全部14张主图、附图B1及附录A—B为依据。
- 作者公开代码,用于核对示例中的分类、标签和评估方式;公开示例参数与正文存在差别,本文没有将其冒充完整实验复现。原始智能卡数据受隐私限制不公开。
作者介绍
Tianli Tang 同时署名广东工业大学土木与交通工程学院、东南大学交通学院;Mo Jia 署名东南大学交通学院。两人为共同第一作者。
Yiwen Zhang 与 Haohan Hu 均署名东南大学交通学院,参与方法、分析和写作等工作。Mingyang Pei 署名华南理工大学土木与交通学院,参与方法、验证与分析等工作。
Yuting Chen 署名华东交通大学交通运输工程学院;Xiaoxia Wang 署名广东工业大学土木与交通工程学院,为通讯作者。以上按原文署名和贡献说明介绍,未将英文人名擅自还原为未经核实的汉字。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一套标签能否用于提前调度,需要先完成时间方向的改变:只用过去的记录估计常规模式与周波动,预测未来一天,再让实际发生的日志作为检验。按日期留出、按乘客留出和跨城市留出,分别回答未来是否有效、对新用户是否有效、对新网络是否有效,不能由一次随机拆分替代。
另一个关键检验,是在获得授权的小样本中结合出行日记或多模式票务,区分取消活动与改用其他方式。若许多Y3只是乘客换乘公交、骑行或步行,那么运营者应关注替代服务衔接,而不只是减少列车。改变观测范围,可能改变同一个标签对应的管理含义。
最后,可以将行为分类价值与预测分数分开评估。即使一个分类器尚不能准确识别每条日志,它提出的分类问题仍可能有用;但用于个性化干预或资源分配之前,应展示误判主要落在哪些乘客与时段,以及错误会怎样影响服务。这样才知道解释模型提供的是可操作的信息,还是仅仅把既定标签重新说了一遍。
