把马赛克变成清晰人脸,为什么仍然不知道那个人是谁?
论文名片|Sachit Menon、Alexandru Damian、Shijia Hu、Nikhil Ravi、Cynthia Rudin,PULSE: Self-Supervised Photo Upsampling via Latent Space Exploration of Generative Models。本文解读arXiv:2003.03808v3,2020年7月20日修订版本,含偏差分析、模型卡与补充材料。
一张只有16×16像素的人脸,被放大成毛发与皮肤都清晰可见的照片。直觉上,我们可能以为计算机把原来藏着的细节找了回来。可如果同一张小图能够变成好几张不同的人脸,每张缩回去又都和原输入相近,哪一张才是原来的人?
PULSE把这种歧义放到了方法的中心:它寻找看起来真实、又能缩回输入图像的高清候选。清晰是输出的一种视觉性质,并不意味着这些细节原本就存在于输入里。
先说结论
- 方法不直接学习一条低清到高清的确定映射,而是在预训练生成器的潜在空间寻找高清人脸,要求其缩小后与输入相符。
- 16×16输入可生成1024×1024输出,即两个边长各放大64倍;这不是恢复了4,096倍的真实信息。同一输入可以对应多张不同候选。
- 128×128条件下,40名评分者的平均视觉质量评分为PULSE 3.60、FSRGAN 2.92、FSRNet 2.77,原始高清图为3.74;评价目标是视觉可信度,不是人物身份恢复。
- 补充材料中的PSNR和SSIM反而低于若干对照,模型又继承生成器的人群覆盖偏差。论文模型卡明确限定其为生成虚构人脸的概念验证,不适合身份识别。
小图丢掉的信息,为什么会变成一张模糊的平均脸?
单图像超分辨率(single-image super-resolution)试图由一张低分辨率图生成更高分辨率图。问题在于,缩小会把许多细节混在一起:不同毛发、皮肤纹理乃至面部结构都可能留下相近的小图。
若学习目标是让输出像素尽量接近训练集里的高清真值,在平方误差的理想情形下,最优输出是所有可能高清候选的条件加权平均。不同候选的细节互相抵消,就会形成平滑或模糊。论文的推导解释的是特定像素损失下的平均效应,并不意味着一切监督方法都只能输出模糊图。
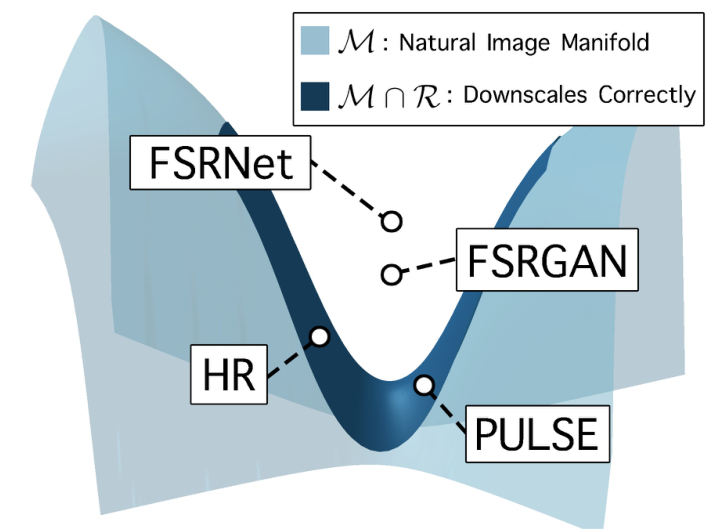
图 2|平均意义上接近真值,为什么未必像一张真实照片?
这幅示意图没有子图字母。浅色区域M表示自然图像集合,深色交集表示还能正确缩小的候选集合。FSRNet示意点趋向候选的像素平均,FSRGAN用对抗目标将其拉向更像真实照片的区域;PULSE则沿生成模型近似的图像集合寻找解。图表达方法思路,不是直接测得的几何结构,也不是对每种模型输出的普遍保证。来源:原论文 Fig. 2。
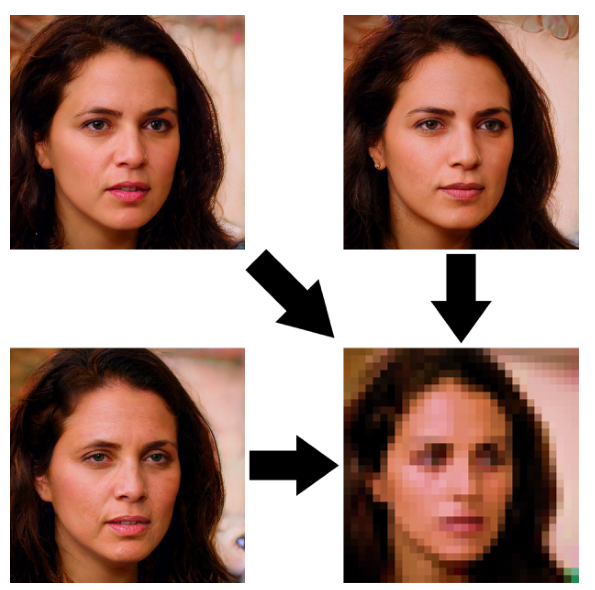
图 3|能正确缩小,是否就锁定了唯一的人脸?
原图没有字母。三个清晰候选分别位于左上、右上和左下,箭头指向右下同一张低清图。不同候选都有相近的缩小结果,说明降采样一致性不能消除高清解的多义性。来源:原论文 Fig. 3。
不往小图上补像素,而是在高清世界里找候选
PULSE使用已训练的StyleGAN人脸生成器,生成器在FFHQ数据上学习高清人脸分布。给它一个潜在向量z,便得到高清图G(z)。将这张图用降采样算子DS缩小,再与低清输入比较,差距就是降采样损失(downscaling loss)。
需要满足的关系可以写成:DS(G(z)) ≈ 低清输入。优化时改变z,保持生成器本身的权重不变。这里的自监督,是利用输入低清图本身约束候选;它不需要成对的低清—高清训练样本,但仍依赖已用高清图像训练好的生成模型。
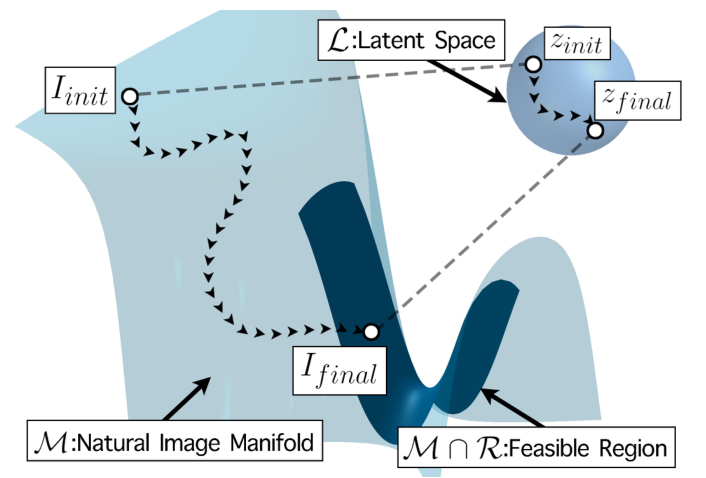
图 4|优化的变量到底是什么?
单幅示意图右上为潜在空间L,搜索从z_init走向z_final;左侧的图像则从I_init移动到既像自然图像、又满足缩小条件的可行区域。虚线连接潜在向量与生成图像。这一思路依赖生成器对真实人脸集合的近似,不能保证任意低清人脸都能找到合格候选。来源:原论文 Fig. 4。
搜索也不能毫无限制。在高维标准高斯分布中,大部分概率质量位于半径约为维数平方根的薄壳附近。仅用负对数先验惩罚向量长度,会把搜索拉向原点,未必落在训练时典型的输入区域。方法因此把搜索限制在球面,并用投影梯度更新。
补充材料进一步交代,实际StyleGAN实现涉及18层、每层512维输入。完全共用一个向量表达力不足,18个向量自由变化又容易远离生成器熟悉的输入。于是方法允许它们略有不同,用基于向量夹角的geodesic cross loss限制层间差异。还可以优化早期5—7层的噪声输入以调整脸形,后期细节噪声则受到限制。这些都是表达能力与视觉质量之间的折中,不是严格的真实性认证。
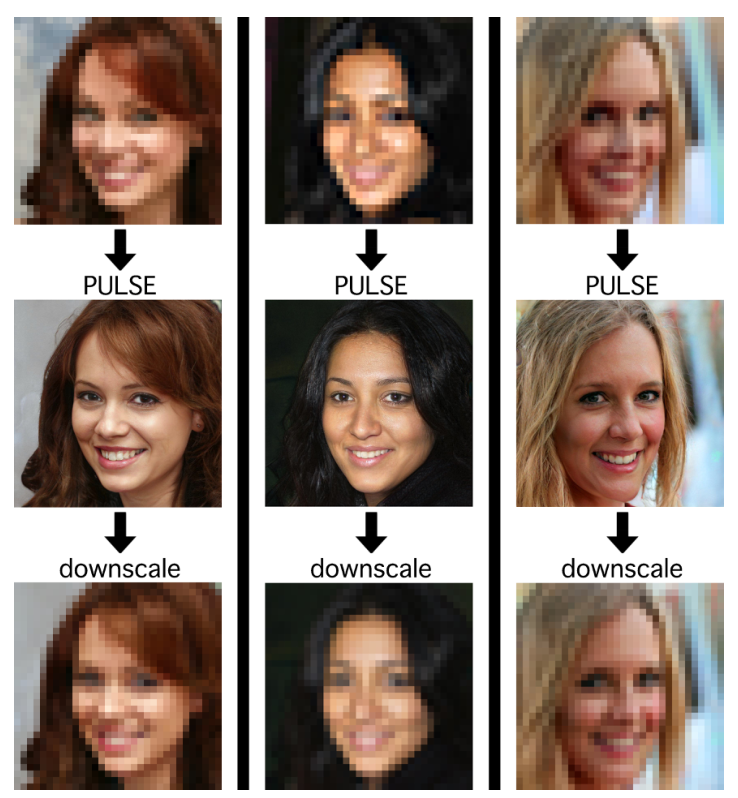
图 1|高清候选有没有违背输入中的粗略轮廓?
原图没有子图字母。三个案例各占一列,上行为输入,中行为PULSE生成的高清图,下行为该高清图再次缩小的结果;边长放大32倍。上下相似说明粗分辨率约束得到满足,中间的细节则来自生成模型可表达的候选。来源:原论文 Fig. 1。
看着更真,具体是和谁比出来的?
实验在CelebA HQ人脸数据上评价,以FFHQ预训练StyleGAN为PULSE生成器。对照包括最近邻、双三次插值(bicubic)、FSRNet和FSRGAN;作者为使监督对照在该测试分布上表现更好,将其训练在CelebA HQ,而非强求所有模型使用同一训练分布。
每次搜索使用100步球面梯度下降,学习率0.4。论文报告单张图在一张NVIDIA V100 GPU上约5秒;这描述的是其2020年实现和实验配置,不能直接当作任意设备上的速度承诺。
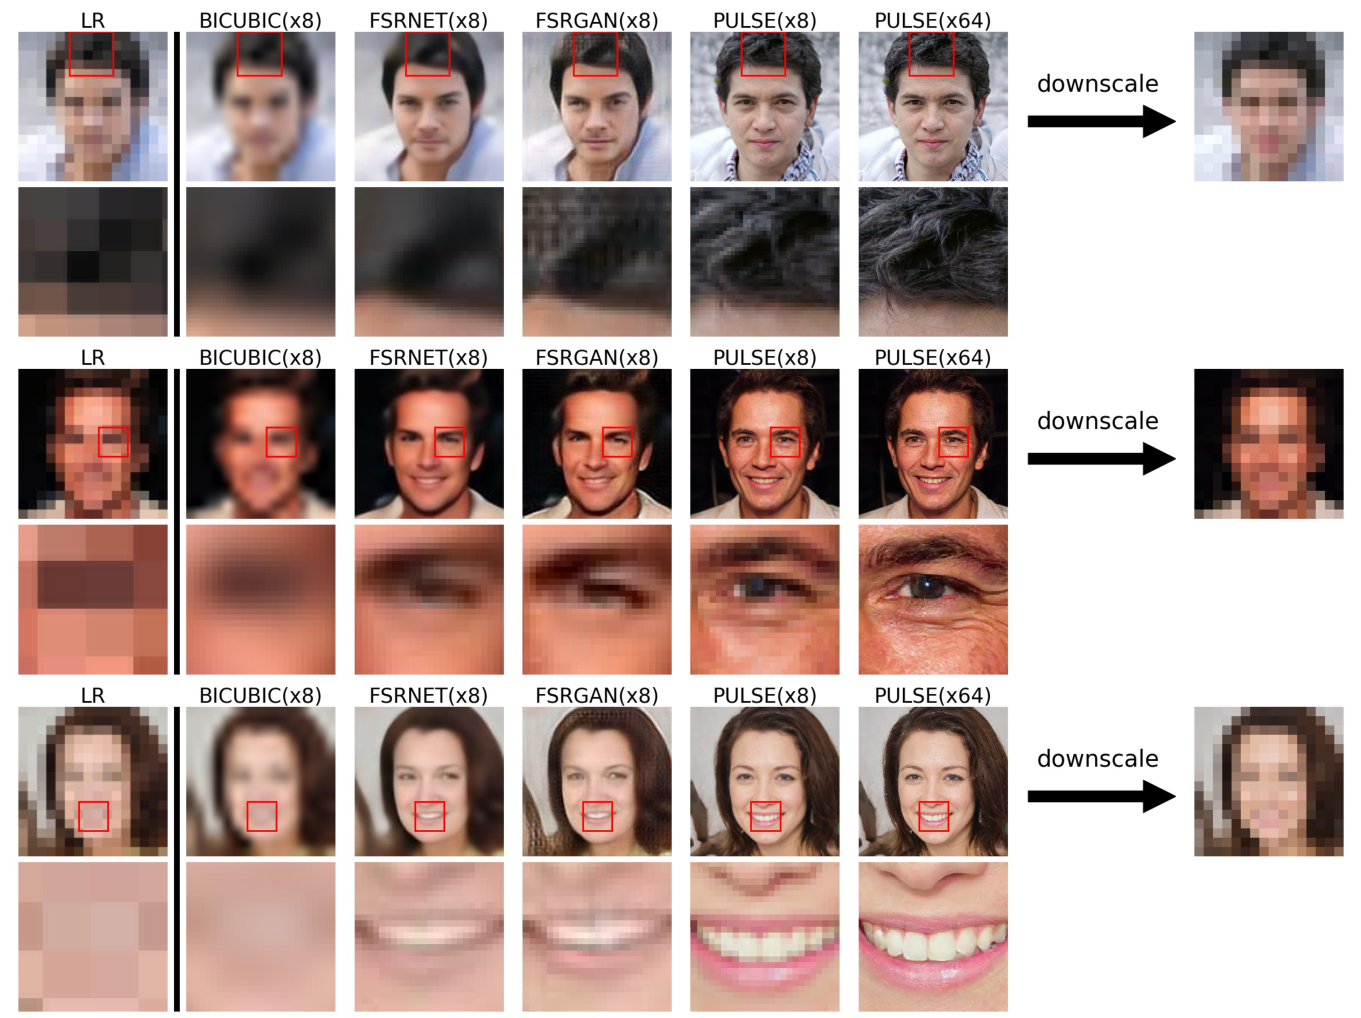
图 5|更清楚的细节,是怎样出现在输出里的?
原图没有字母。三个案例从上至下排列,每组从左至右为低清输入、bicubic×8、FSRNet×8、FSRGAN×8、PULSE×8、PULSE×64,随后为PULSE输出缩小后的对照;红框和下排放大区域对应头发、眼部、牙齿等细节。PULSE的局部纹理更丰富,第一例还为匹配输入中的深色像素生成杂乱头发。这展示候选构造能力,没有证明新头发或牙齿就是原图的真实细节。来源:原论文 Fig. 5。
主观评价采用平均意见分(mean opinion score,MOS),40名评分者在看过1分与5分的示例后,对240张图作1—5分评价。由于已有对照的最大输出为128×128,这项公平分辨率对比使用16×16到128×128,即边长8倍。
| 条件 | 最近邻 | Bicubic | FSRNet | FSRGAN | PULSE | 原始高清图 |
|---|---|---|---|---|---|---|
| MOS,越高越好 | 1.01 | 1.34 | 2.77 | 2.92 | 3.60 | 3.74 |
来源:原论文表1。论文报告15组两两比较的Mann–Whitney U检验均p<10⁻⁵。这些分数支持该实验中的视觉偏好,不能读成身份辨认率,也不是所有图像领域的通用质量排名。
另一个指标是自然图像质量评价器NIQE,无需高清参照,数值越低越好。16×16到1024×1024时,原始高清图、最近邻、bicubic、PULSE分别为3.90、12.48、7.06、2.47(表2)。FSRNet和FSRGAN输出分辨率不足,未参与这项高分辨率比较。PULSE比真实高清图得分还低,恰好说明此指标不是逐像素真值误差,也不能证明生成图比原图包含更多真实信息。
补充材料则报告另一面:在×8条件下,PULSE的PSNR为22.01、SSIM为0.55,而FSRNet分别为25.93和0.74;bicubic也有23.40和0.63。作者没有以这些指标为优化目标,但它们清楚表明,视觉逼真与贴近原始高清真值是不同任务,不能只展示有利的那一组指标。
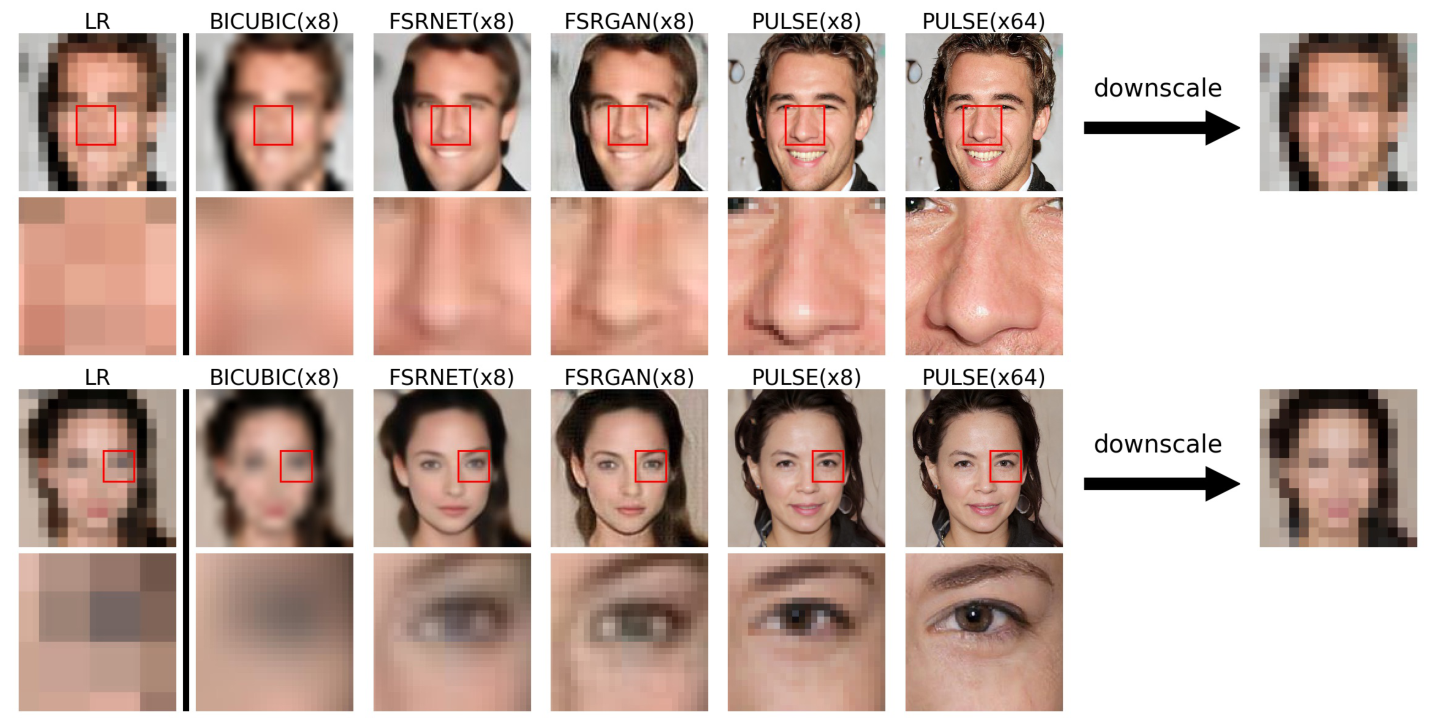
补图 1|主图中的视觉差异是否也出现在其他例子?
原图无字母,上下两组分别展示鼻子与眼睛。列顺序沿用主图5,从低清、bicubic、FSRNet、FSRGAN到两种放大倍率的PULSE,右侧为缩小回验。局部更加锐利并不等于与未展示的真实高清细节相同。来源:补充材料 Fig. 1。
换成噪声或运动模糊,方法还成立吗?
论文还给低清输入加上高斯噪声、运动模糊或椒盐噪声,搜索时仍以双三次降采样作近似。由于生成器偏向可识别的高清人脸,输出往往不再保留噪声。但此时目标已不再是逐点重现受损输入,而是找到靠近其未受损版本的合理候选。
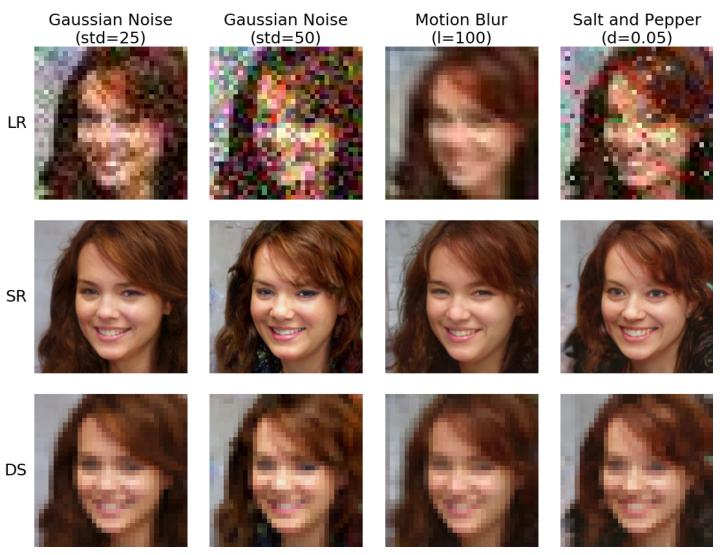
图 6|输入被损坏以后,缩小结果会追随噪声吗?
原图没有字母。四列依次为高斯噪声标准差25、标准差50、长度100且方向随机的运动模糊,以及密度0.05的椒盐噪声;三行依次是受损低清输入LR、生成高清SR、再缩小DS。DS更像一张干净的小脸,提示生成先验有去噪作用;它也说明在未知退化时,不能再无条件宣称缩小结果精确等于受损输入。来源:原论文 Fig. 6。
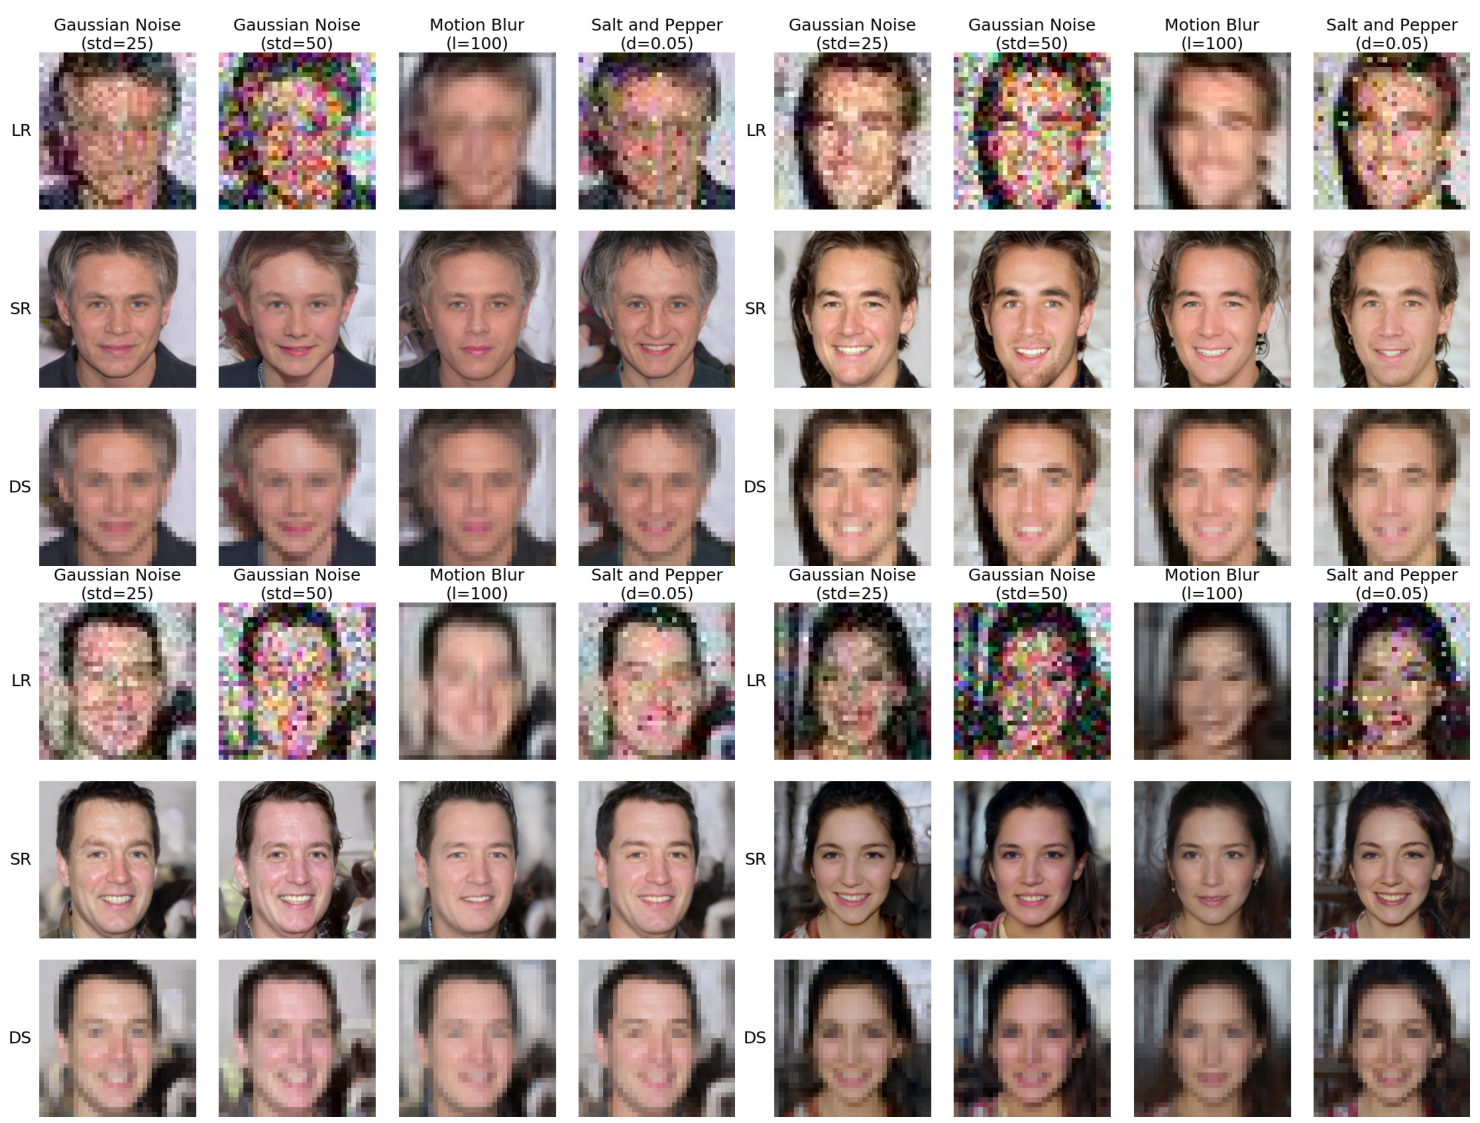
补图 2|这一现象是否只出现在一个人脸上?
原图无字母,四个案例按2×2排布。每个案例仍用四列退化条件与LR、SR、DS三行,条件与主图6相同。更多案例支持视觉上的稳健现象,论文没有由此给出所有真实噪声、失焦或压缩条件下的性能保证。来源:补充材料 Fig. 2。
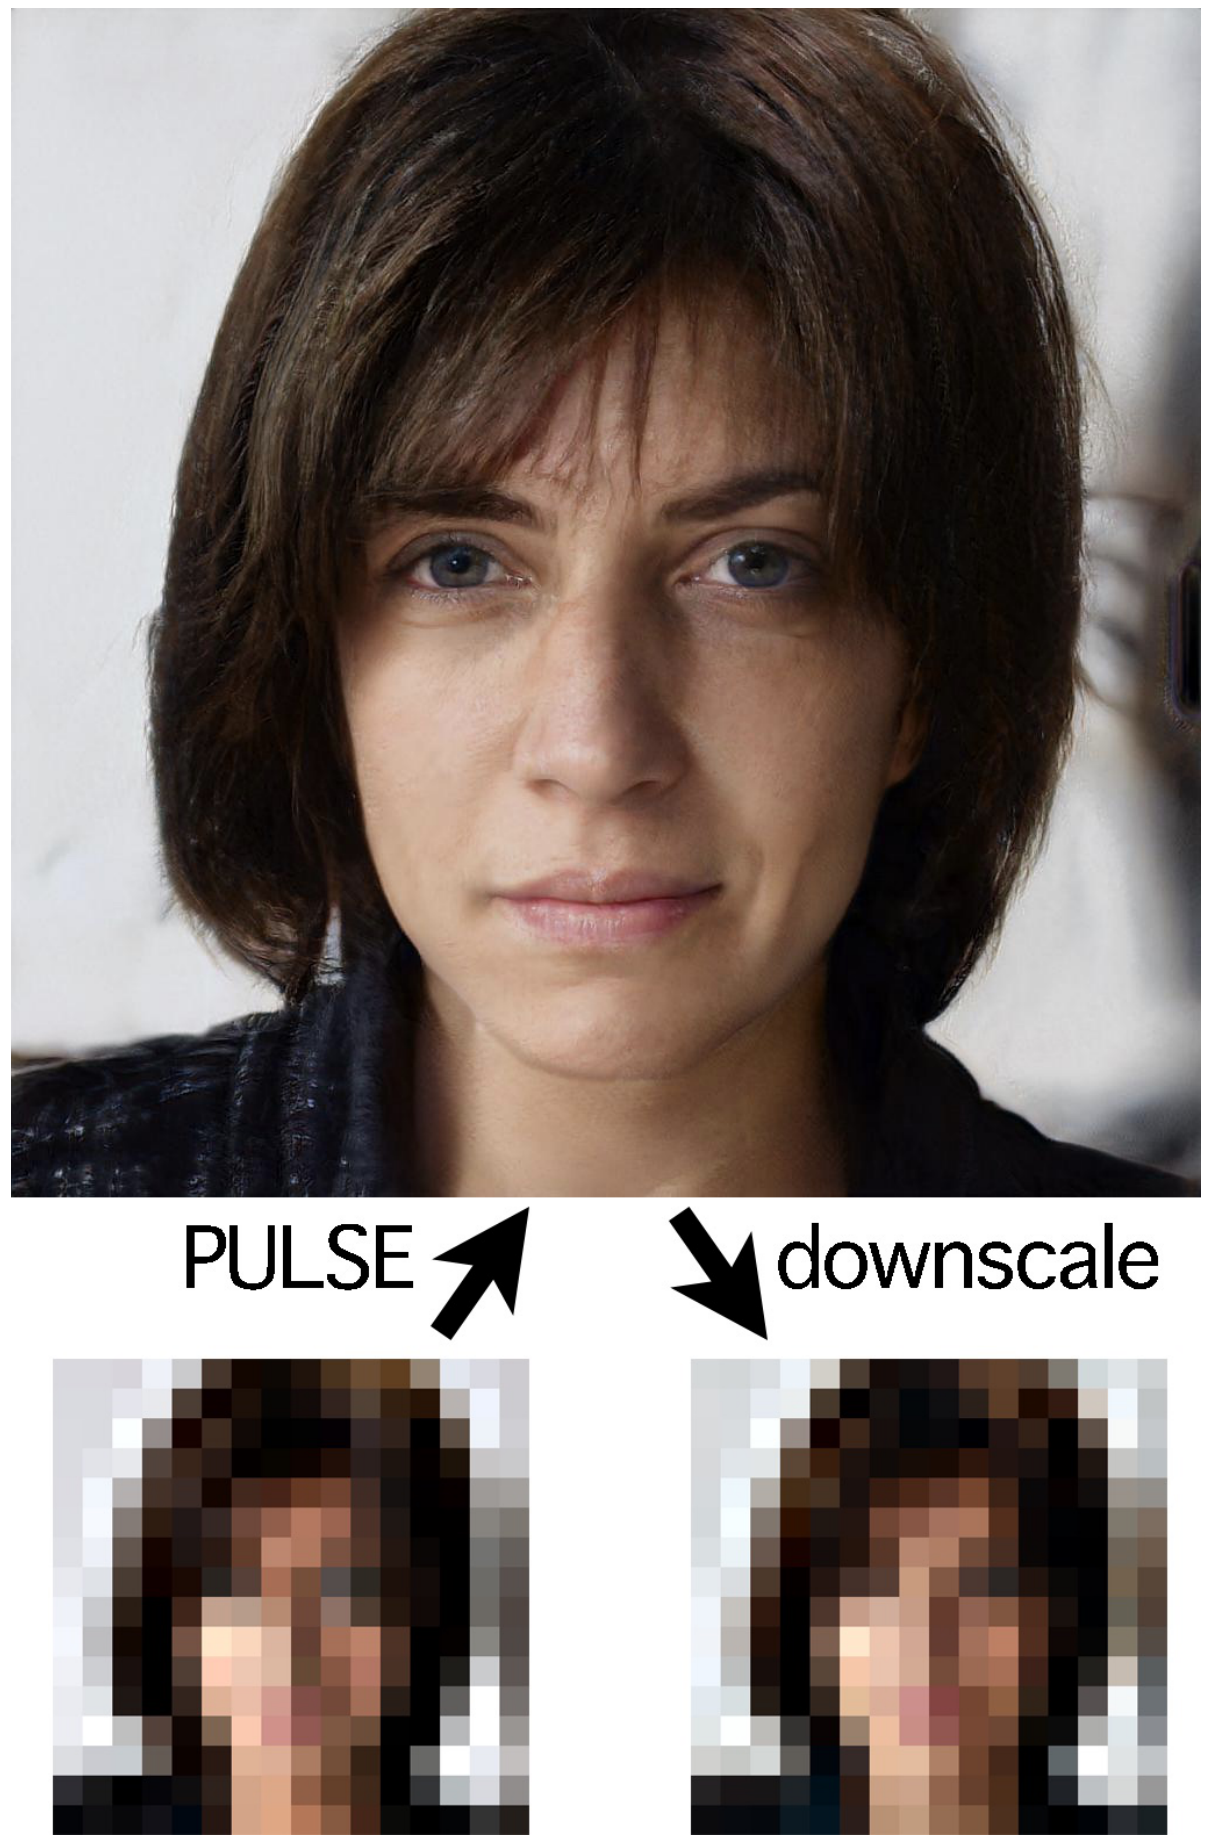
补图 3|高分辨率输出与小图回验怎样并置?
无字母,顶部为1024×1024候选,左下为16×16输入,右下为候选缩小图,箭头标示生成与降采样方向。来源:补充材料 Fig. 3。
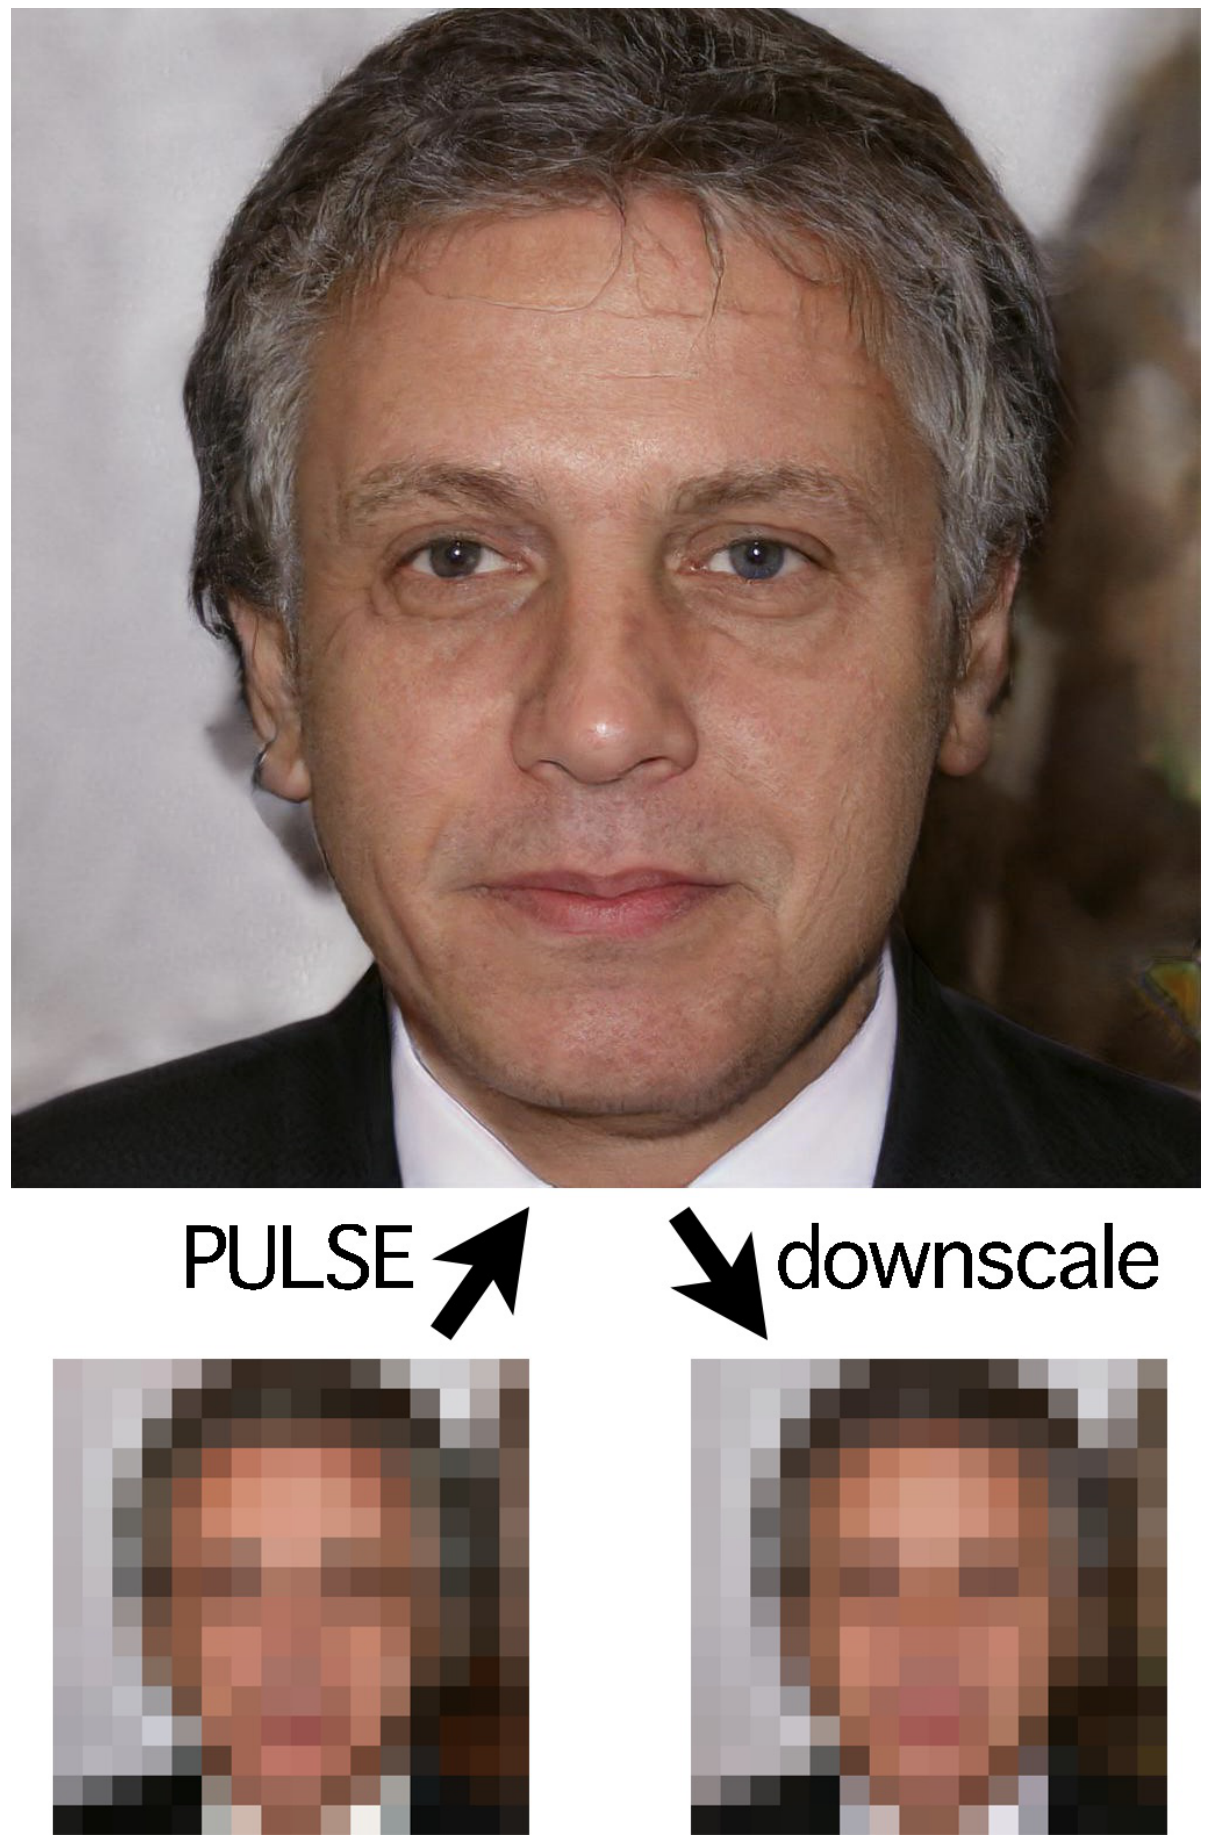
补图 4|另一个样本中,皮肤与头发细节从何而来?
无字母,版式与补图3相同。顶部丰富的纹理由生成模型构造,底部两张小图接近只是约束检验,不是高清真值核对。来源:补充材料 Fig. 4。
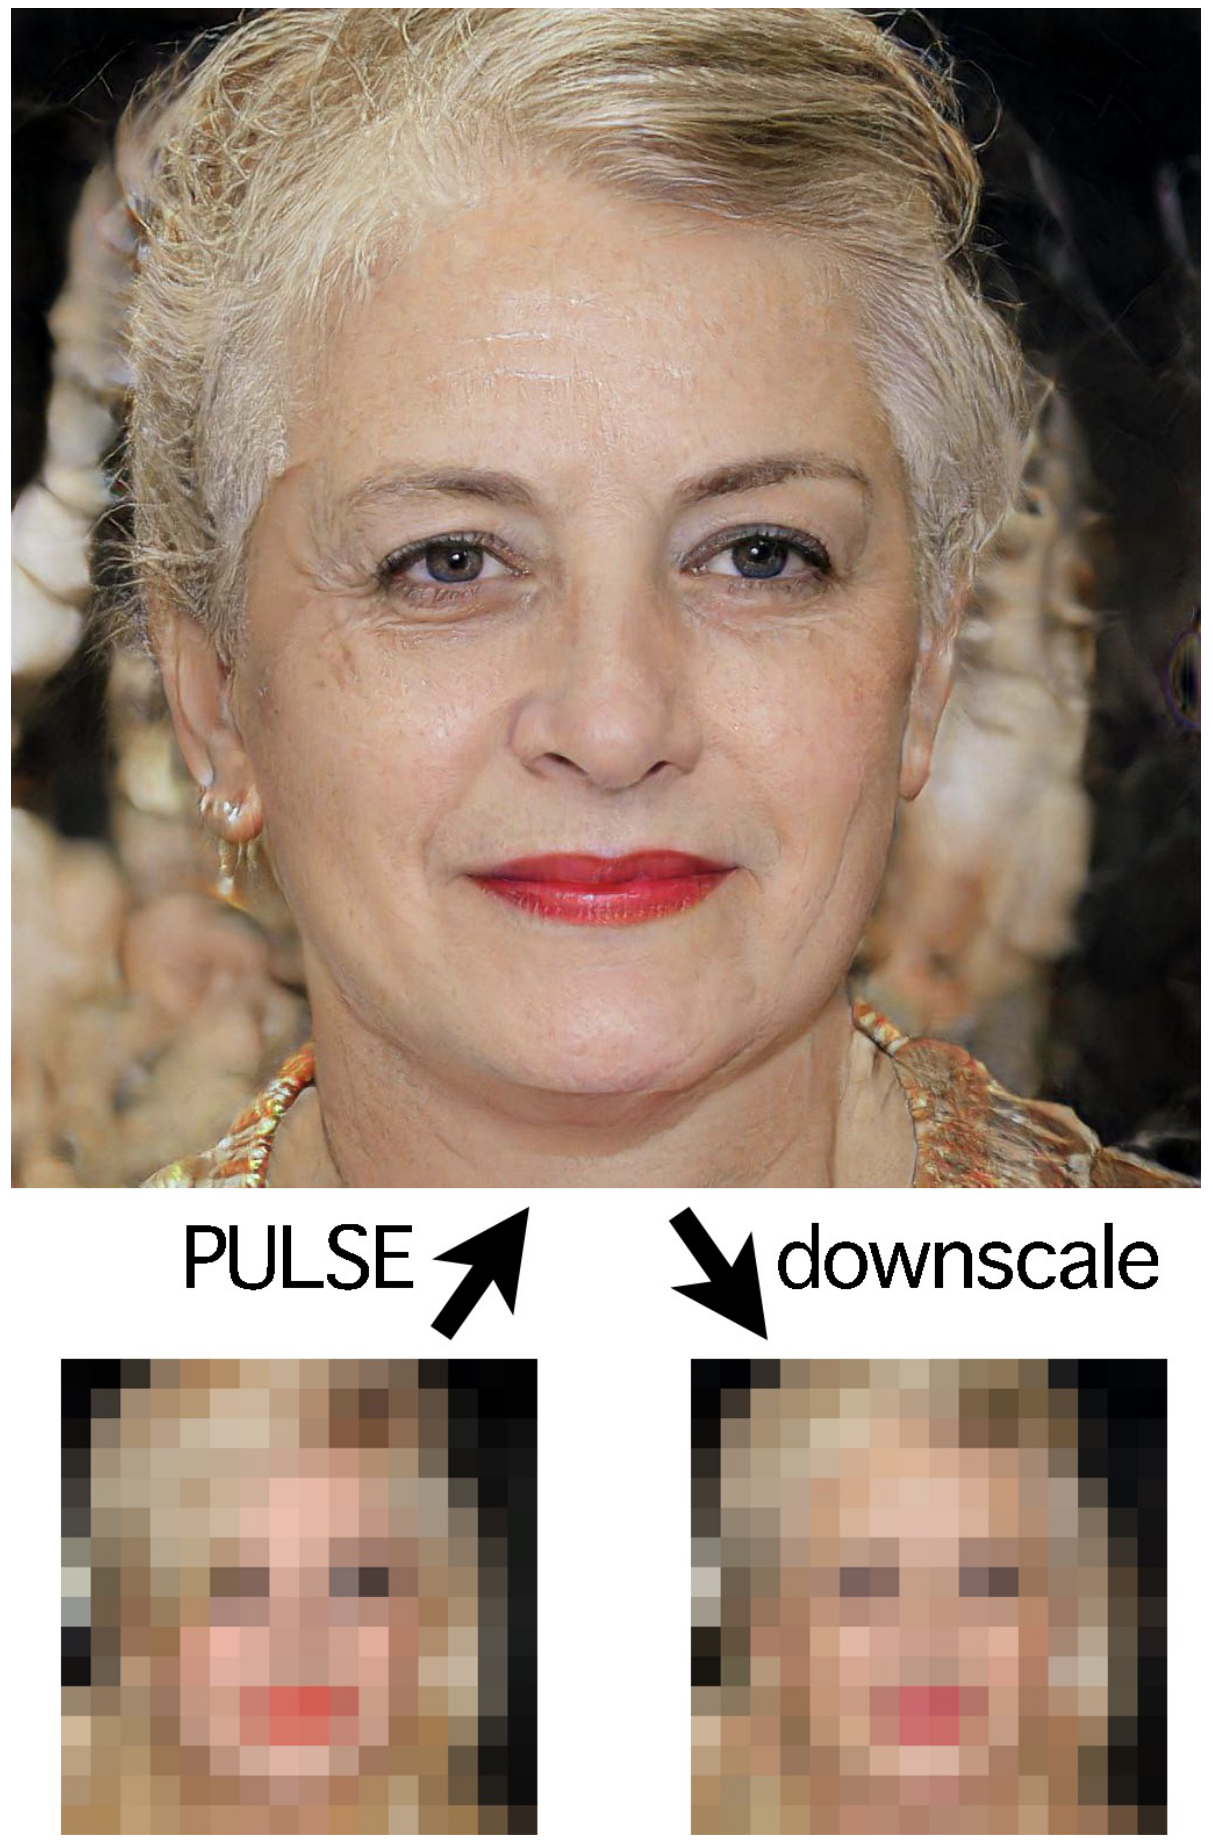
补图 5|更换发型和外观,是否仍能形成可回验候选?
无字母,顶部为候选、左下为输入、右下为缩小结果。它补充另一个外观样本,没有增加人物身份正确性的证据。来源:补充材料 Fig. 5。
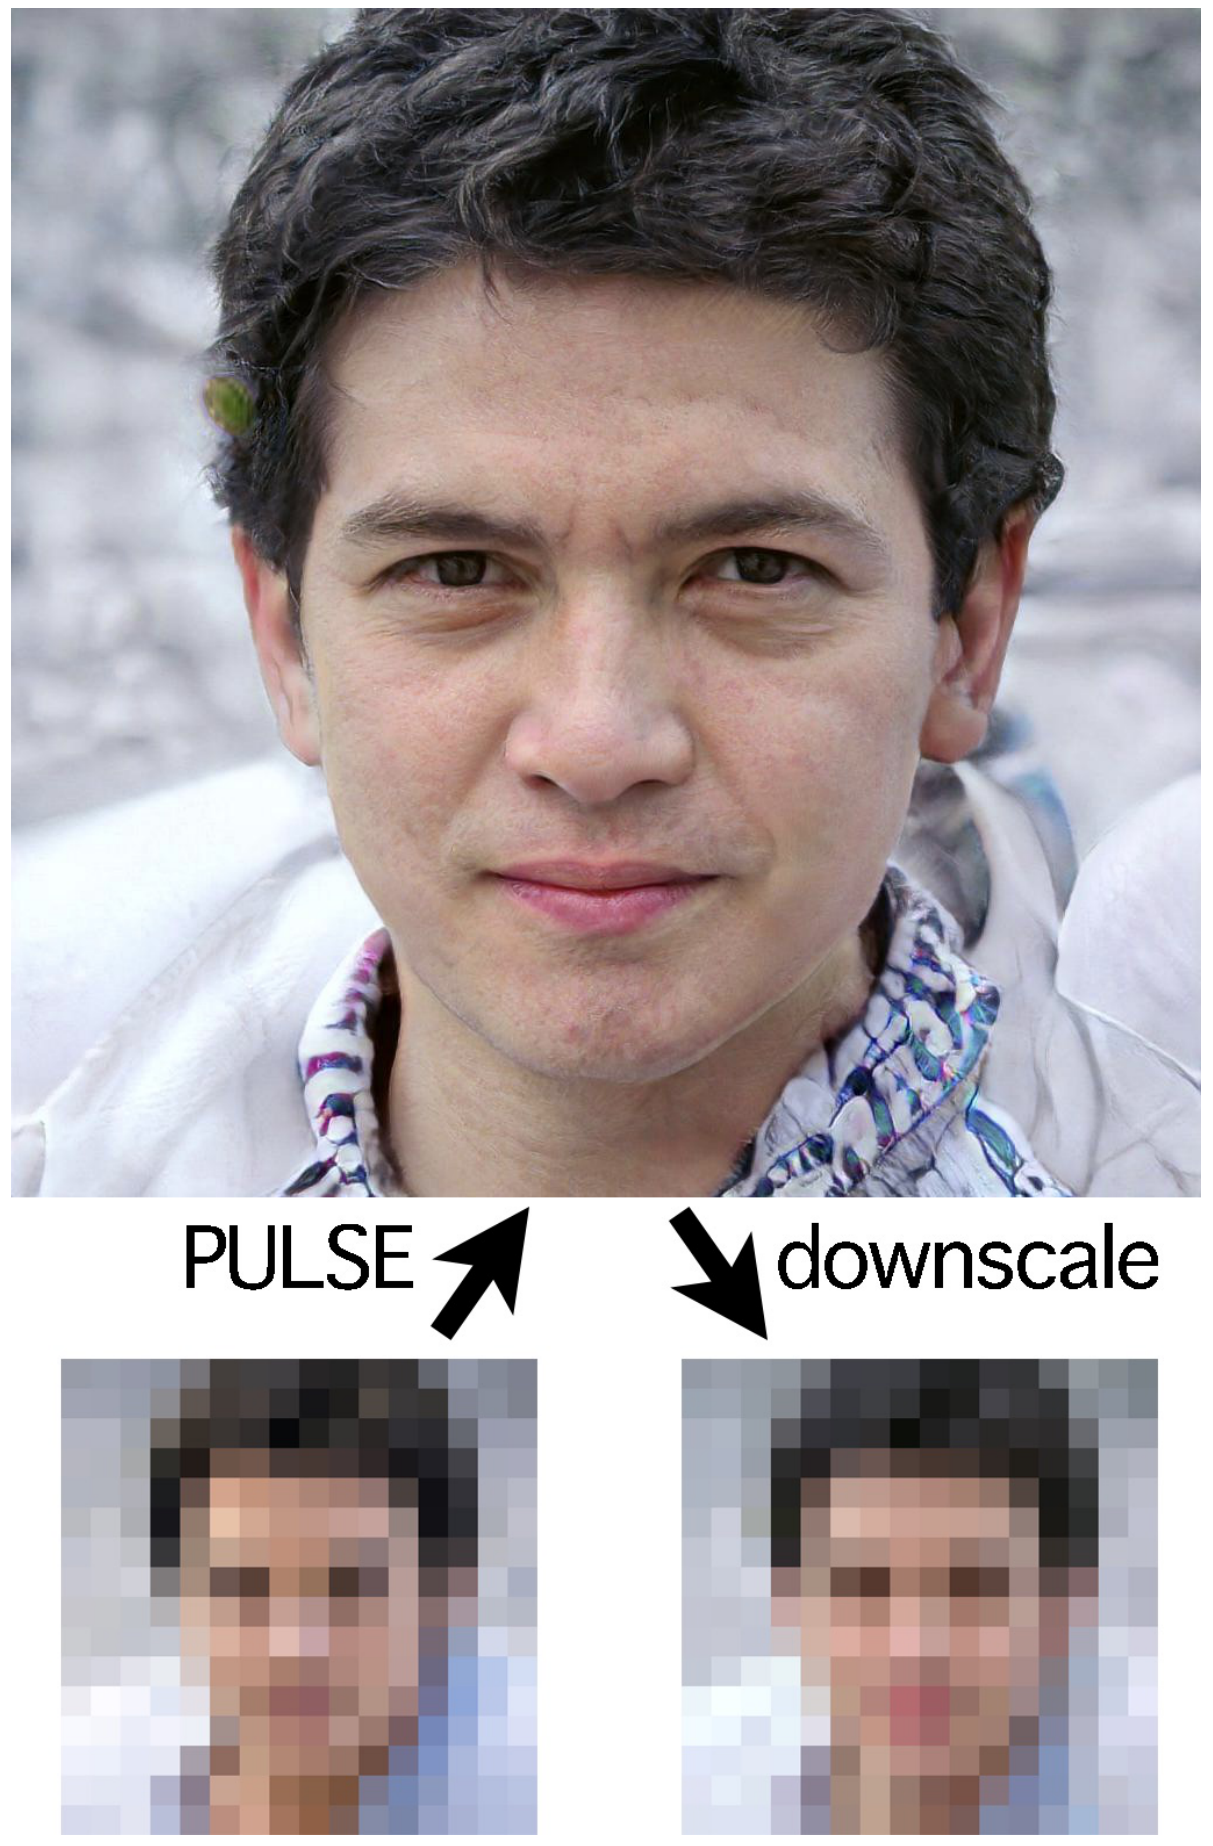
补图 6|单张清晰照片为什么不足以证明恢复成功?
无字母,仍为高清候选与两张小图对照。纹理清楚和回验相近可以同时成立,但原始高清身份仍不由小图唯一决定。来源:补充材料 Fig. 6。
如果候选空间本身有偏差,搜索会不会把偏差带出来?
候选由StyleGAN提供,搜索能力受生成器覆盖限制。如果某些外观在人脸生成分布中较少出现,输出未必均等表达不同人群。论文检查了球面半径、优化收敛和随机初始化等可能来源,但这些检验没有完全分离各机制;作者认为生成器本身的分布偏差是重要原因。
表3在FairFace上按第三方标注的群体各抽取100张图,每图运行5次,使用64倍降采样,报告找到满足缩小条件候选的频率:Black 79.2%、East Asian 87.0%、Indian 87.4%、Latino/Hispanic 90.2%、Middle Eastern 87.0%、Southeast Asian 87.4%、White 83.4%;Female与Male两类分别为91.4%与88.6%。这些是原数据集的分类标签,不是研究者测量的生物学类别。
成功率只回答找没找到合格图,不回答生成脸是否保持输入人物的外观,也不回答多次输出是否足够多样。原实现还曾在搜索未达到阈值时照样返回图像,后续分析要求显式识别失败。因此,看见一张输出不等于满足约束,更不等于识别成功。
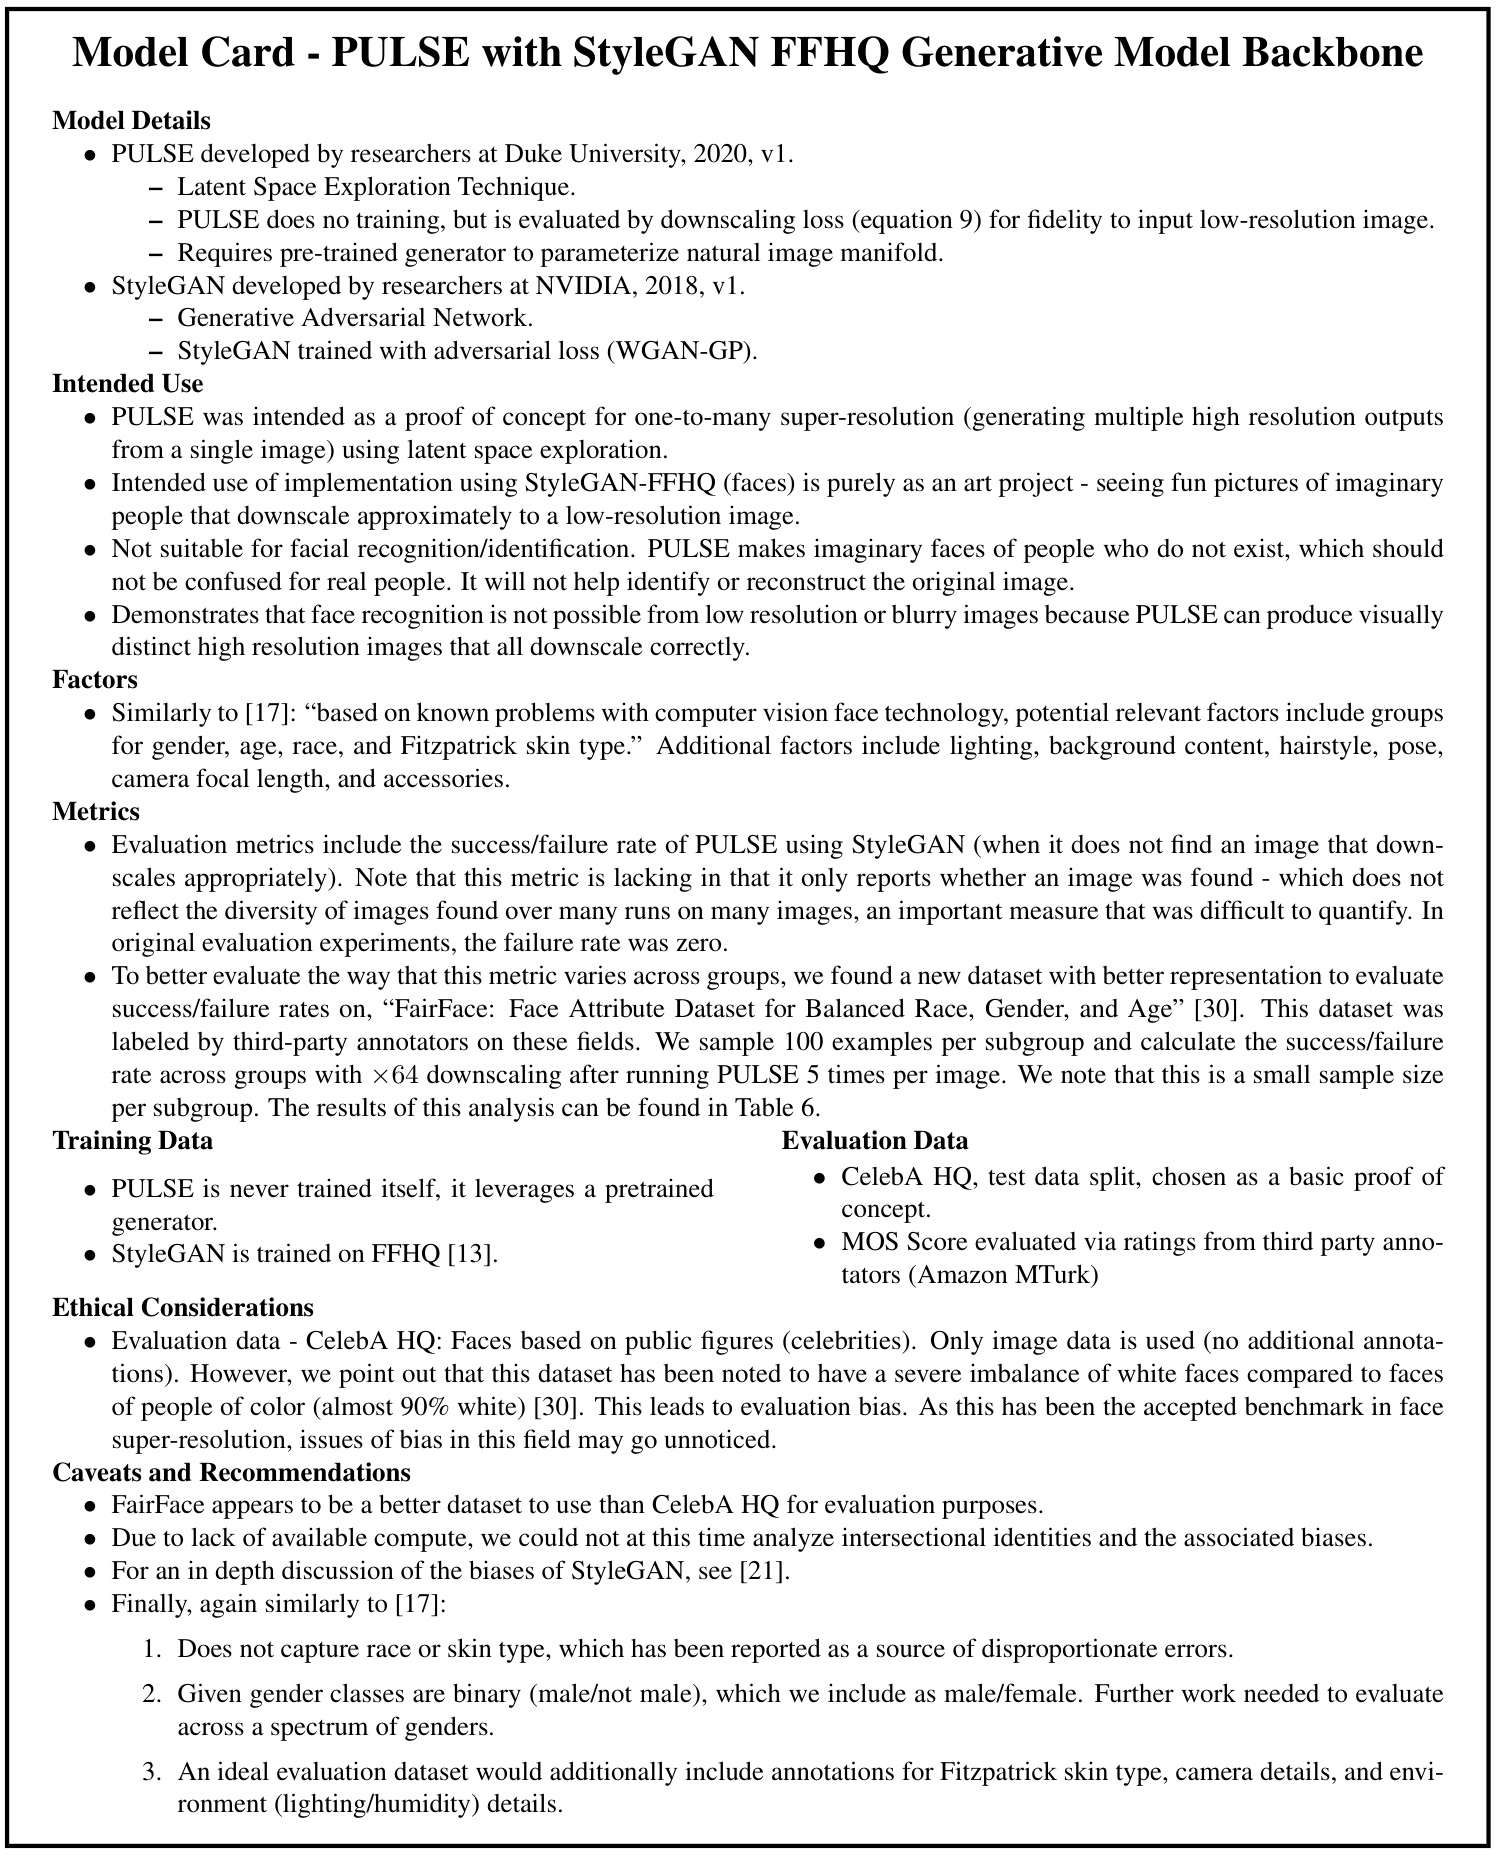
模型卡|开发者认为哪些使用边界必须随模型一起交付?
整张卡片无面板字母,依次包含模型细节、预期用途、影响因素、评价指标、训练与评价数据、伦理考量及建议。正文将它指称为Figure 8。卡片明确说,这一人脸实现生成的是虚构人物图像,不适合人脸识别或恢复原始身份;它还列出人群覆盖、二元性别标签与交叉群体评价不足。来源:原论文模型卡。
这项结果能延伸到医学或遥感图像吗?
论文引言提到医学、天文、显微与卫星图像作为超分辨率的潜在场景,但本文主要实证验证的是人脸。换领域需要相应生成器、可用的退化模型,以及针对真实任务的验证。人脸上视觉评分较高,并没有证明生成的医学纹理适合诊断或生成的地物适合测量。
在理想模型下,真实高清图应位于可行集合;实际生成器只近似这个集合,并可能遗漏某些人脸。球面约束与降采样损失降低了某些不合理输出,却不能给出普遍的真实细节保证。未知成像退化、训练分布外输入、生成覆盖与优化失败都可能影响结果。
一句话总结
PULSE能够生成与低清输入相容的清晰候选,但细节看起来真实,并不等于细节来自原来那张照片。
核心来源
- Menon, S., Damian, A., Hu, S., Ravi, N., & Rudin, C.(2020). PULSE: Self-Supervised Photo Upsampling via Latent Space Exploration of Generative Models。arXiv v3全文、模型卡及补充材料。本文主图、模型卡、六张补图和各表数值均据该版本。
作者介绍
以下按主论文署名顺序,身份限于该版本原文可核实的信息。
- Sachit Menon:杜克大学署名作者,与Alexandru Damian共同第一作者。
- Alexandru Damian:杜克大学署名作者,与Sachit Menon共同第一作者。
- Shijia Hu:杜克大学署名作者,参与本文研究。
- Nikhil Ravi:杜克大学署名作者,参与本文研究。
- Cynthia Rudin:杜克大学署名作者,参与本文研究。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果工具只展示一张最漂亮的候选,读者很容易把模型的不确定性误认为确定的细节。更合适的界面可以同时显示几张彼此不同、都满足低清约束的候选,让用户直接看见信息缺失造成的歧义;同时保留原始输入与降采样回验。
但多个候选也不能自动形成统计置信区间。随机初始化后的搜索结果,未必按真实高清图的条件概率采样。若要把候选集合用于判断,应进一步验证它是否覆盖真实可能性、不同人群是否具有相近覆盖,以及候选间的差异是否足以反映不确定性。