不公开任何人的行程,还能模拟一座城市的活动吗?
论文名片|Darakhshan J. Mir、Sibren Isaacman、Ramón Cáceres、Margaret Martonosi、Rebecca N. Wright,DP-WHERE: Differentially Private Modeling of Human Mobility,2013 IEEE International Conference on Big Data,580–588。原论文 DOI。
假设公交规划团队想知道下午五点人口集中在哪里,却不该拿到每个人的手机记录。删掉姓名仍未必够:住处、工作地和出现时间的组合,本身就可能暴露一个人。另一条路是只提供一个能生成虚拟居民的城市模型,但模型要像真实城市,又不能把某位真实用户的特殊习惯原样留下来。
DP-WHERE 在已有 WHERE 模型中加入差分隐私。它保护的是由真实记录估计出的统计分布,再从这些分布抽取合成手机记录。论文的核心发现是:在纽约都市区的这组实验中,形式化隐私机制与有用的群体移动统计可以并存;这种可用性不等于能重建每个人的完整生活。
先说结论
- 隐私单位是一名用户的全部记录,而非单条通话。移除一名用户后,机制产生各类输出的概率不能变化得太大;ε是这个变化的界限参数,不是泄露概率。
- 模型对六类统计分配隐私预算,包括住处、工作地、通勤距离、每天记录次数、活动时刻与逐小时空间分布。后续合成过程只使用已加噪的统计,不再查询原始数据。
- 实验用2011年纽约地区91天、逾25万部手机、超过10亿条记录,生成1万个虚拟用户的30天记录。新隐私版本在本文没有另做洛杉矶实验,洛杉矶属于前作 WHERE 的验证背景。
- 在通勤网格0.01°、ε=0.23时,平均空间分布误差为3.4066英里,无隐私 WHERE 为3.2150英里;但合成记录的日活动范围中位数为1.9英里,真实记录为3.2英里。保留总体形态不代表每项统计完全相同。
先分清:要生成的是通话记录,还是完整行程?
输入是通话详单(Call Detail Records,CDR),本文把语音通话和短信统一称为calls。一行记录含匿名用户号、日期、时刻、位置,以及从该用户记录中推断的住处和工作地。没有通信事件的时段,不等于人没有移动;基站位置也不是连续GPS轨迹。
WHERE先统计住在哪里、工作在哪里、通勤多远、一天出现多少次通信记录、何时通信,以及每小时各地通信活动的空间分布。生成虚拟居民时,依次抽取住处、通勤距离和工作地,再抽取记录次数与时刻,最后为各次记录分配住处或工作地。
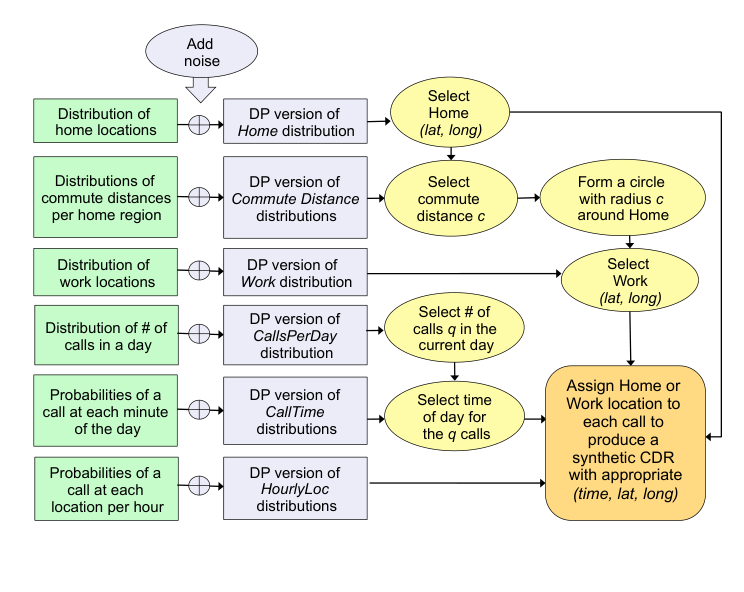
图 1|隐私处理插在生成过程的哪一步?
本图无字母子图。左侧绿色框是原始统计,中间灰框是加入噪声后的分布;黄色节点据此抽取合成的住处、通勤距离、工作地及通信次数和时刻,右下生成合成CDR。橙色节点明确把位置分配到合成住处或工作地。箭头表达抽样依赖,不是某个人真实走过的路径。来源:原论文 Fig. 1。
这个限制十分重要。该版本并没有为每位居民生成购物、上学、休闲及沿途道路的完整活动链。即使城市人口图相似,也不能直接拿这些记录评价每一种出行目的或道路级拥堵。
删掉名字之后,还需要保护什么?
差分隐私(differential privacy)不要求攻击者缺乏外部知识,而是约束模型在相邻数据库上的输出。本文把相邻数据库定义为相差一名用户的全部CDR,因而是用户级保护:某人打了很多次电话,也不能只把其中一条当作受保护单位。
用不涉及实际个人的例子理解:数据中包含或不包含虚拟人物甲时,对于同一个可能发布的结果,出现概率之比受到e的ε次方约束。ε越小,允许的差异越小;它不是识别率,也不意味着已有公开信息和群体规律会消失。
要实现这个约束,必须先限制单个用户的影响。论文预处理会剔除任一小时记录数超过120的用户,而非只把多余几条记录删掉。随后根据统计量的全局敏感度(global sensitivity,即一个用户变化最多能改变多少统计量)决定拉普拉斯噪声的尺度。这里的120和后续预算构成机制条件,不能从流程中任意省略。
加了噪声的城市,还能保留什么结构?
住处和工作地按网格统计人数,通勤距离则在较粗的通勤网格内构造分布。每天通信次数的均值与标准差组成另一张统计表。噪声可能产生负数或破坏累积分布的单调性,模型还要用不访问原数据的后处理,把结果整理成合法的概率分布。
累积分布函数(cumulative distribution function,CDF)表示排在某个索引之前的累计比例。以下索引只是在统计表中的位置,并不是沿地图行走的路程。
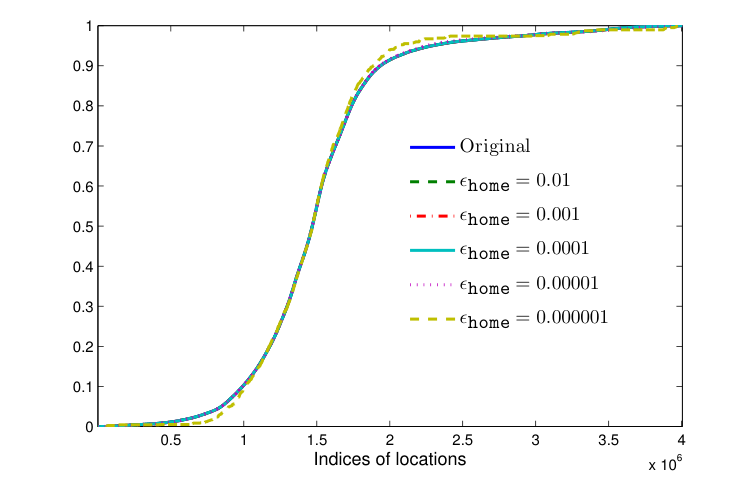
图 2|住处统计加噪后,总体形状改变多少?
本图无字母子图。横轴是网格位置的索引,纵轴是累计比例;蓝实线为原分布,其他线对应不同εhome。图示尺度下,大多数曲线接近;极小预算时差异更明显。曲线相近不能证明每个稀疏网格都估得准,更不能代替隐私证明。来源:原论文 Fig. 2。
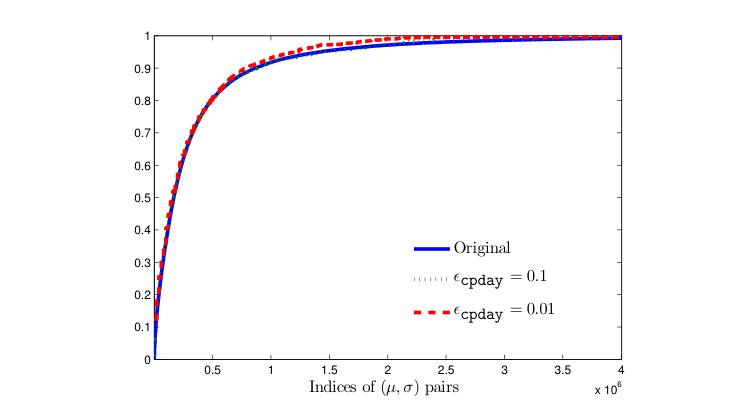
图 3|不同通信频率的人群,还保留在模型里吗?
本图无字母子图。横轴是每日记录次数均值μ与标准差σ的组合索引,纵轴为累计比例。蓝线为原分布,绿、红线分别为εcpday=0.1、0.01;低预算曲线仍保留主要形状,但存在偏移。这个统计描述记录习惯,不是人一天出门多少次。来源:原论文 Fig. 3。
时刻也不能随便生成,否则模型可能在深夜制造白天的人口结构。DP-WHERE根据每人的24小时通信分布做带隐私机制的两类聚类,由各类中心产生时刻分布,再按加噪后的类规模抽取用户类别。
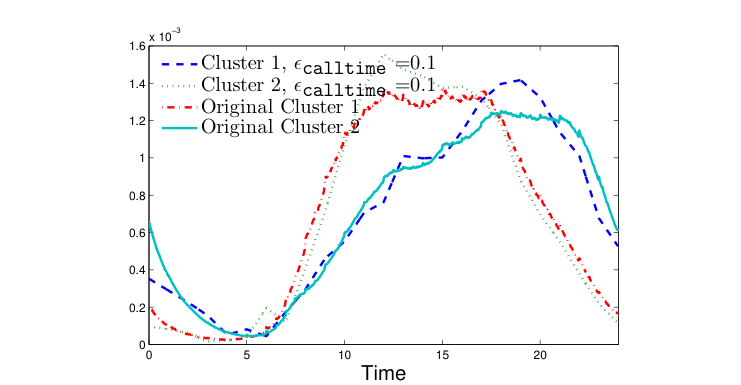
图 4|两类作息是否会被噪声混成一条曲线?
本图无字母子图。横轴是一天中的时间,纵轴是通信时刻的概率。红、青线为原来的两类,蓝虚线、绿点线为εcalltime=0.1下的私有版本。两类高峰与昼夜差异大体保留,但峰值和局部波动并非完全一致。类别是统计聚类,不是经访谈确认的职业身份。来源:原论文 Fig. 4。
逐小时空间统计比住处计数更难:同一个用户可能在多天贡献很多记录。模型把地理索引相邻的一组计数合并、对组总量加噪,再平均分回组内,以减轻每个小格单独加噪的影响。这也引入平滑,局部热点可能被淡化。
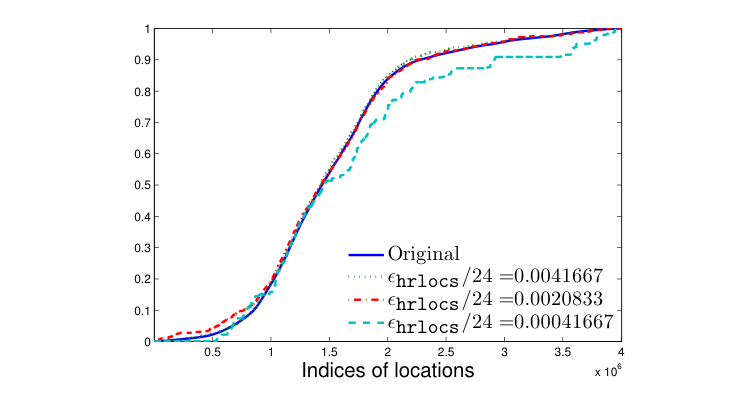
图 5|最需要保护的空间细节,是否仍能提供总体信息?
本图无字母子图。展示17—18时的空间累计分布:横轴是位置索引,纵轴是累计比例;蓝线为原分布,其余三线是不同逐小时预算下的结果。图例预算要乘24才对应全部小时的εhrlocs,不能拿某一小时的数直接当整套模型预算。来源:原论文 Fig. 5。
六类统计都保护,预算会不会重复计算?
论文给出的总预算为:εhome + εwork + εcommute + εcpday + εcalltime + εhrlocs。对同一批人的多次私有统计,需要做预算组合;一个环节保护得好,不能补偿另一个环节未经保护地泄露原始信息。
相反,从同一套已经私有化的分布生成更多虚拟用户,属于后处理。只要不再次查询原始库,就不因多生成一些合成记录而另花隐私预算。模型因此可以发布带噪分布,而不必发布真实个人记录。
这项形式结论依赖各个机制按规定实现。复现时尤其需要核对指数分布的率与尺度参数化,以及聚类的预算和停止条件;原文相应公式、伪代码与文字叙述有不一致之处,不能把照抄伪代码视作已经完成隐私审计。
怎样检验一座合成城市是否仍然有用?
实验输入来自2011年4月1日至6月30日,按纽约市中心50英里内的账单邮编抽样。生成区域覆盖北纬40—42度、西经73—75度,超过14,000平方英里;底层网格边长0.001°,另比较三种通勤网格。
第一项指标是地球移动距离(Earth Mover’s Distance,EMD):把一张空间概率分布搬成另一张,需要付出多少搬运代价。作者用全部人口质量在相距一英里的两点之间移动作为校准,把误差转换成英里。它是总体分布差异,不是每个人定位错了多少英里。
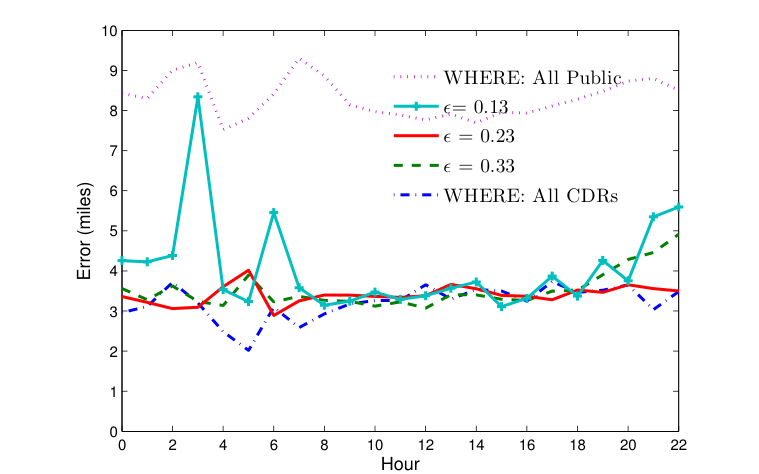
图 6|形式化隐私让空间统计损失多少?
本图无字母子图。横轴是小时,纵轴是EMD误差,单位英里。蓝点划线是用原始CDR的WHERE,紫点线是仅用公开数据的WHERE;青、红、绿线为总ε分别0.13、0.23、0.33的DP-WHERE,通勤网格固定0.01°。私有模型总体接近CDR基线,明显好于公开数据基线;凌晨等稀疏通信时段的波动更大。来源:原论文 Fig. 6。
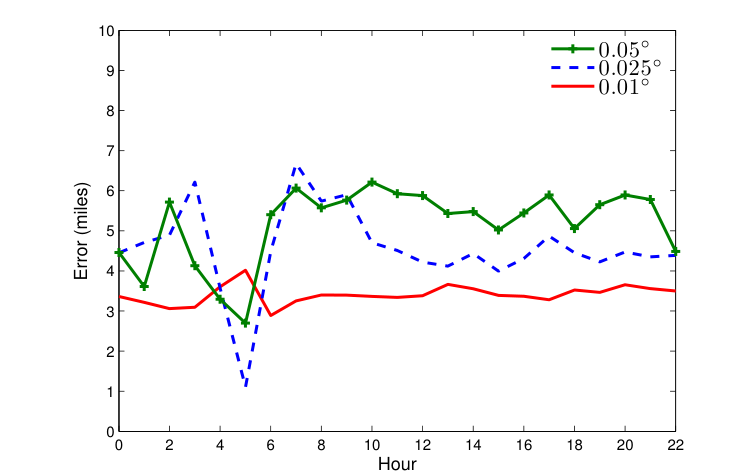
图 7|粗一点的网格是否必然更可靠?
本图无字母子图。横轴仍为小时、纵轴仍为EMD英里;总ε固定0.23,红、蓝、绿分别表示0.01°、0.025°、0.05°通勤网格。这个实验里更粗的通勤分区通常更差,说明合并空间不能自动保证更高效用。来源:原论文 Fig. 7。
表1给出24小时平均EMD,以下保留其全部组合,单位均为英里:
| 模型 | 0.01° | 0.025° | 0.05° |
|---|---|---|---|
| WHERE | 3.2150 | 3.3396 | 3.0871 |
| ε=0.33 | 3.5316 | 3.1655 | 4.5687 |
| ε=0.23 | 3.4066 | 4.5577 | 5.1691 |
| ε=0.13 | 5.3391 | 5.3194 | 5.2754 |
各组合相对WHERE的绝对差约0.17—2.2英里。个别加噪结果甚至略低于基线,例如0.025°、ε=0.33这一格;因此不能把表读成每一次加噪必然变差,或ε越大每项指标必然更好。论文没有给出这张表的重复实验不确定区间,不能把小幅反转当作已确立的优势。
人口图相似,是否就保住了个人一天的活动范围?
第二项指标是日活动范围,即一人当天所有记录点中相距最远两点的距离。它补充人口分布指标,但仍只看被通信采样到的地点,而且是在比较两组分布,不是在逐人还原真实轨迹。
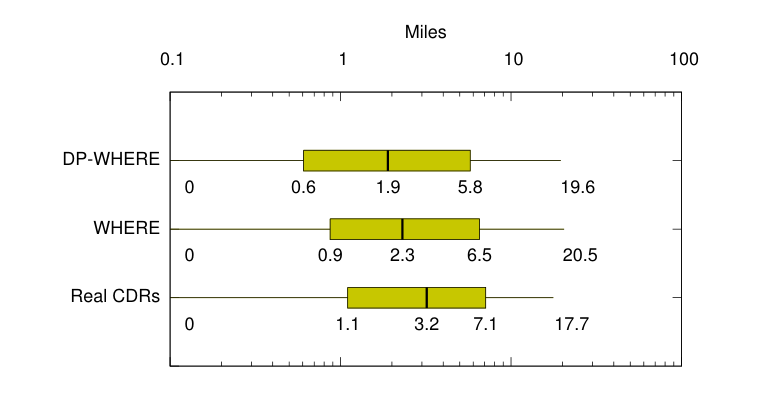
图 8|模型生成的人,会不会比真实记录中的人走得更少?
本图无字母子图。横轴是英里对数刻度,三行依次为DP-WHERE、WHERE、真实CDR;箱体为25%、50%、75%分位,须端为2%和98%分位。中位数依次1.9、2.3、3.2英里;DP-WHERE的上四分位为5.8英里,真实为7.1英里。左端的零另以数字标注,不能对零取对数。来源:原论文 Fig. 8。
结果保留了主要分布形态,也显示合成记录在中部偏向较短活动范围。它支持这套简化模型可用于某些群体尺度研究,不能支持个体轨迹、交通方式和稀有活动都已准确再现。
哪些边界不能被一条隐私参数掩盖?
代表性首先受通信采样、运营商覆盖和邮编抽样影响。住处与工作地来自推断,模型又把生成位置限制到这两个锚点。差分隐私保护输出机制,不会自动修正这些测量和建模误差,也不等于原始数据库可以不再保护。
此外,ε属于一套明确的机制与发布过程,不是一个可从本文照搬到所有城市的万能设置。本文只有这一组纽约数据的私有模型效用实验;更细地区、其他年份与不同采样率下的表现,需要重新检验。
一句话总结
DP-WHERE表明,先对城市统计分布做有预算的隐私处理,再生成虚拟居民,可以保留有用的群体规律;代价和适用范围必须用实际指标说明,不能靠匿名或合成两个词来担保。
核心来源
- Mir, D. J., Isaacman, S., Cáceres, R., Martonosi, M., & Wright, R. N.(2013). DP-WHERE: Differentially Private Modeling of Human Mobility. IEEE Big Data, 580–588。DOI。图1—8及表中数字均来自该论文。
- 普林斯顿大学的论文书目信息。WHERE是原论文引用的既有模型,本文不把其洛杉矶验证算作DP-WHERE新实验。
作者介绍
- Darakhshan J. Mir:本文第一作者,论文发表时署名Rutgers University。
- Sibren Isaacman:论文作者,署名Loyola University Maryland。
- Ramón Cáceres:论文作者,署名AT&T Labs。
- Margaret Martonosi:论文作者,署名Princeton University。
- Rebecca N. Wright:论文作者,署名Rutgers University。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
城市级平均误差相近,仍可能隐藏服务对象的差别。对于公交规划,同样的总体EMD,可能对应市中心大多数人的轻微错分,也可能对应远郊少数人的明显偏移。一个值得增加的检验是分别报告低密度区域、深夜与通勤高峰的表现,看总体拟合是否由高采样区域主导。
这个检验还需要一份发布账本。对已发布模型多换几个随机种子,只能帮助看见模型自身的不稳定,不会自动证明真实少数人得到了代表;若再把从原始库计算的新分组误差公开发布,则应另核算其隐私预算。这样才能同时回答两件事:没有多透露谁的信息,以及合成城市究竟对谁有用。