酷热夜里,小区的用电高峰怎样变化?
论文名片|Bo Li、Ruotao Yu、Kaiye Gan、Guangchun Ruan、Shangwei Liu、Mingxia Yang、Daiyu Xie、Wei Dai、Haiwang Zhong,A Large-Scale Residential Load Dataset in a Southern Province of China,Scientific Data 12,450(2025)。原论文 · DOI:10.1038/s41597-025-04766-7。
想象持续高温的一天,居民下班回家开空调,电网迎来晚间高峰。若恰好有一段电表数据消失,把前后普通日的数值填进去,曲线可能变得平滑,却也可能把最需要知道的极端需求抹掉。研究天气与用电,既需要足够密的记录,也要知道记录缺在什么时候。
这篇论文开放广西10个城市、23个住宅小区的变压器侧负荷记录,并配套天气、节假日与极端事件信息。它的价值是让小区负荷与外部环境可以一起研究;它没有通过实验分离天气的因果影响,也没有提供八万多户家庭各自的电器使用日志。
先说结论
- 原始采集覆盖423个变压器电表,2022年1月至2023年11月按小时记录;表2合计88,309户。论文概述用超过80,000户描述覆盖规模,但公开的是变压器聚合负荷。
- 曲线呈现夏季较高需求、清晨低谷与晚间上升。温度与负荷并非简单直线关系:示例中约18—25°C较平缓,高温侧上升更明显。
- 缺失值不能一概当零。作者保留原始数据,并展示利用前后相近时段填补的办法,但极端事件中的断测可能携带重要信息。
- 指标定义、城市代码、异常剔除和填补窗口都影响复用。尤其不能把相关系数解释为天气造成的需求增量,或把归一化负荷热图当成独立的波动性测量。
八万多户的规模,为什么仍然看不见单个家庭?
当地电力部门的分层计量系统可以覆盖住户、楼栋与变压器,但本文公开的是变压器级数据。若干变压器服务一个住宅小区,小区内相近的曲线可进一步合并为小区负荷。住宅覆盖户数因此说明服务规模,分析单位则是电表、小区或更高层的聚合记录。
表2按城市列出电表数量、户数及容量信息,总计423个变压器与88,309户,分布不均。不同城市或小区总负荷高低,还受户数、接入范围和容量差异影响,不能直接改写为当地每户更节约或更浪费。
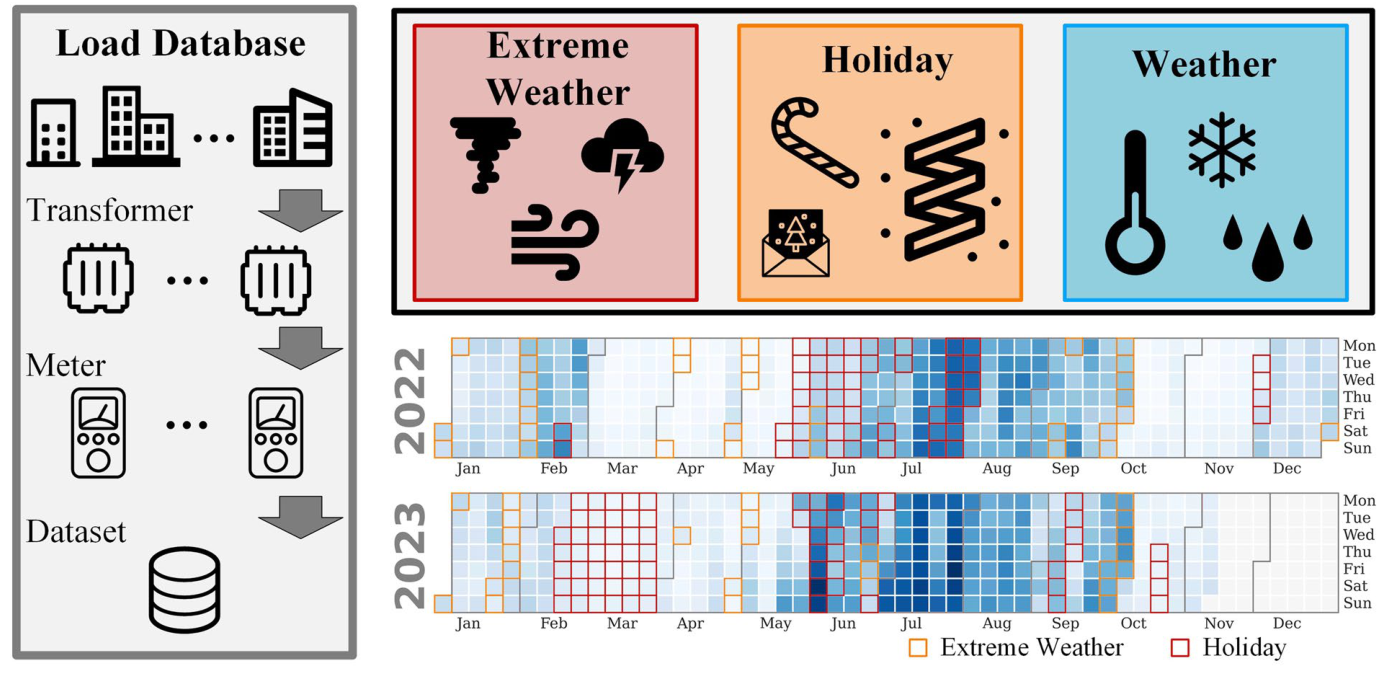
图 1|把电表曲线和日历连起来,需要哪些信息?
原图没有子图字母。左侧表示建筑、变压器、电表到负荷数据库的记录链;右上为极端天气、节假日与气象资料,右下为2022、2023年的日历式展示,以边框标示事件和假日。日历色块是数据组织示意,不能据此分开节假日与天气各自的因果贡献。来源:原论文 Fig. 1。
气象资料主要来自NOAA,包括温度、露点、风、降水与站点气压等日尺度信息;论文另介绍ERA5逐小时地表净太阳辐射数据。把每天的天气并到小时负荷上,不会凭空变成逐小时独立的天气测量。数据库时间采用UTC+8,连接资料时必须保持同一时区。
公开数据使用SQLite3,论文列出七类表:变压器原始记录、变压器元信息、天气、气象站元信息、媒体收集的极端事件、计算得到的极端指标及节假日。原始库与经过清理填补的分析结果也要分开,不能把后来补出的数值再称为直接实测。
电表不见了一段记录,应该补上,还是先保留这个事实?
数据先做身份处理,将电表编号随机化,隐藏小区名与具体电表位置;城市、小区分组关系仍可用于聚合。这个设计减少具体设施暴露,不等于公开了逐户身份,也不构成任意外部信息下的形式化隐私保证。
清理时,作者剔除超过额定容量等被判作异常的负荷记录,以及超出合理范围的天气值。这里必须检查功率、能量和视在容量的单位:图上负荷标为kW,元信息容量标为kVA,两者不能在忽略功率因数的情况下随意当作同一物理量。
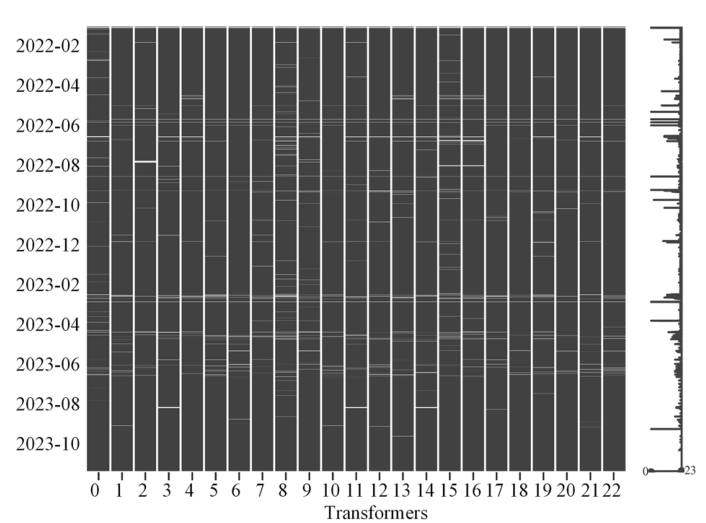
图 2|缺失是随机散落,还是集中发生?
单幅矩阵图横轴为图示电表,纵轴为日期,白色表示缺失;右侧小图概括完整性变化。它用于展示缺失发生的位置和时间,不能只看整体深色就断言每个事件期间都完整。论文关于完整率统计的段落提及200个电表,而此图横轴显示约23列;这些展示口径不能直接拿来替代423个原始电表的总体计数。来源:原论文 Fig. 2。
作者提出对缺失超过30%的电表整列排除。对剩余缺口,论文称负荷用前后周相近时刻的均值、天气用前后日均值补齐。若一周前后作息相似,这比跨长缺口画直线更容易保留日内节律;若缺口恰在台风或酷热日,就可能把异常压回普通水平。
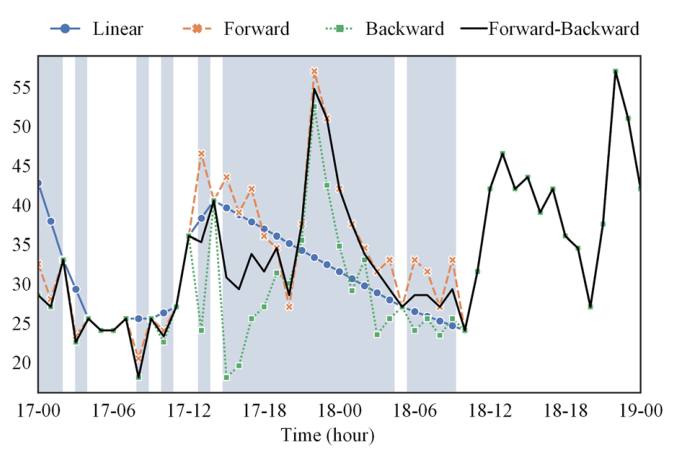
图 3|填补后曲线像样,是否就证明填对了?
单幅图展示2022年6月三天的功率,横轴为时刻、纵轴kW,阴影为缺失时段。蓝、橙、绿线分别为线性、前向、后向方案,黑线是前后结合。长缺口处不同方法的峰谷差异明显。由于缺失处没有同时展示独立真值,图不能给出填补误差排名。来源:原论文 Fig. 3。
复现还要锁定实现版本。作者公开脚本中,前后填补使用按行偏移24的操作;对逐小时序列,这对应一天,而论文文字描述的是前后周。这个差别会改变结果,使用者应明确选择窗口,核对输入频率,并记录代码版本,不能假定文字与脚本完全等价。作者负荷填补代码。
缺失本身也可能与极端天气有关,例如设施故障或通信中断。研究异常需求时,最好保留缺失标记、填补标记与原始曲线,另做不填补或不同窗口下的敏感性检验。
季节和作息,能否在小区负荷里读出来?
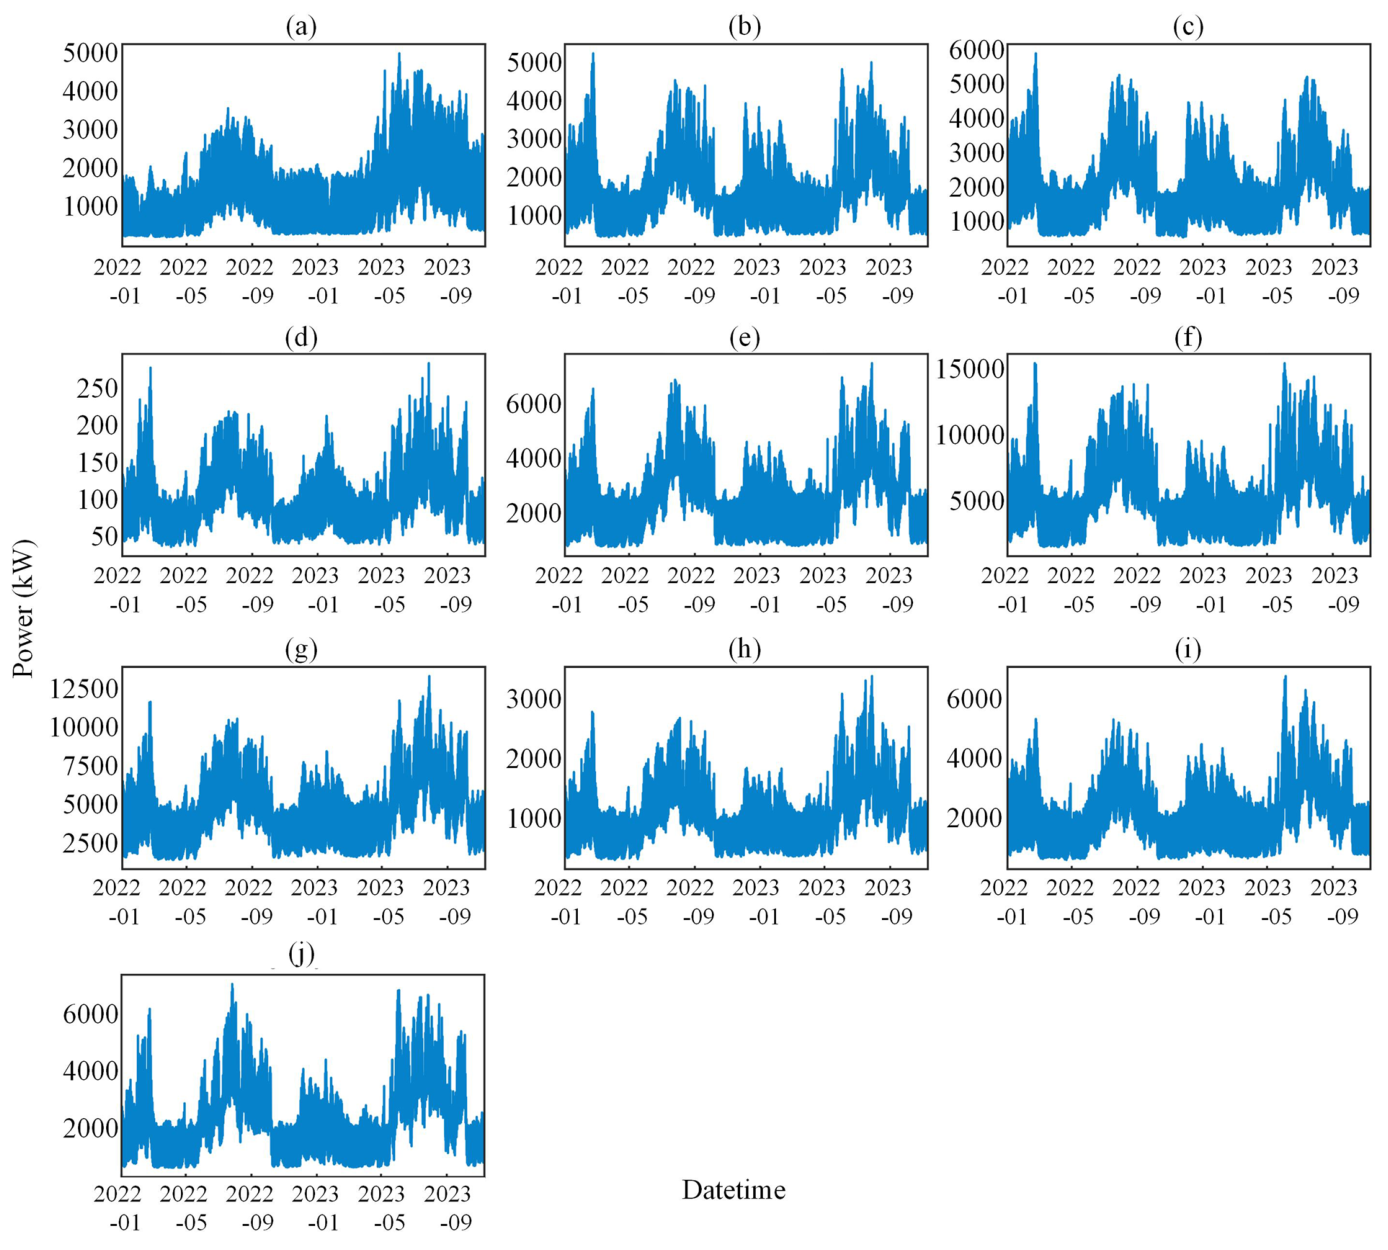
图 4|哪些时间段容易出现更高负荷?
(a)C0、(b)C1、(c)C2、(d)C3、(e)C4、(f)C5、(g)C6、(h)C7、(i)C8、(j)C9。横轴为2022—2023年日期,纵轴为功率kW,不同面板纵轴范围不同。多数样本在夏季出现高负荷,部分也有冬季高点;不能仅凭高度比较各城户均需求。来源:原论文 Fig. 4。
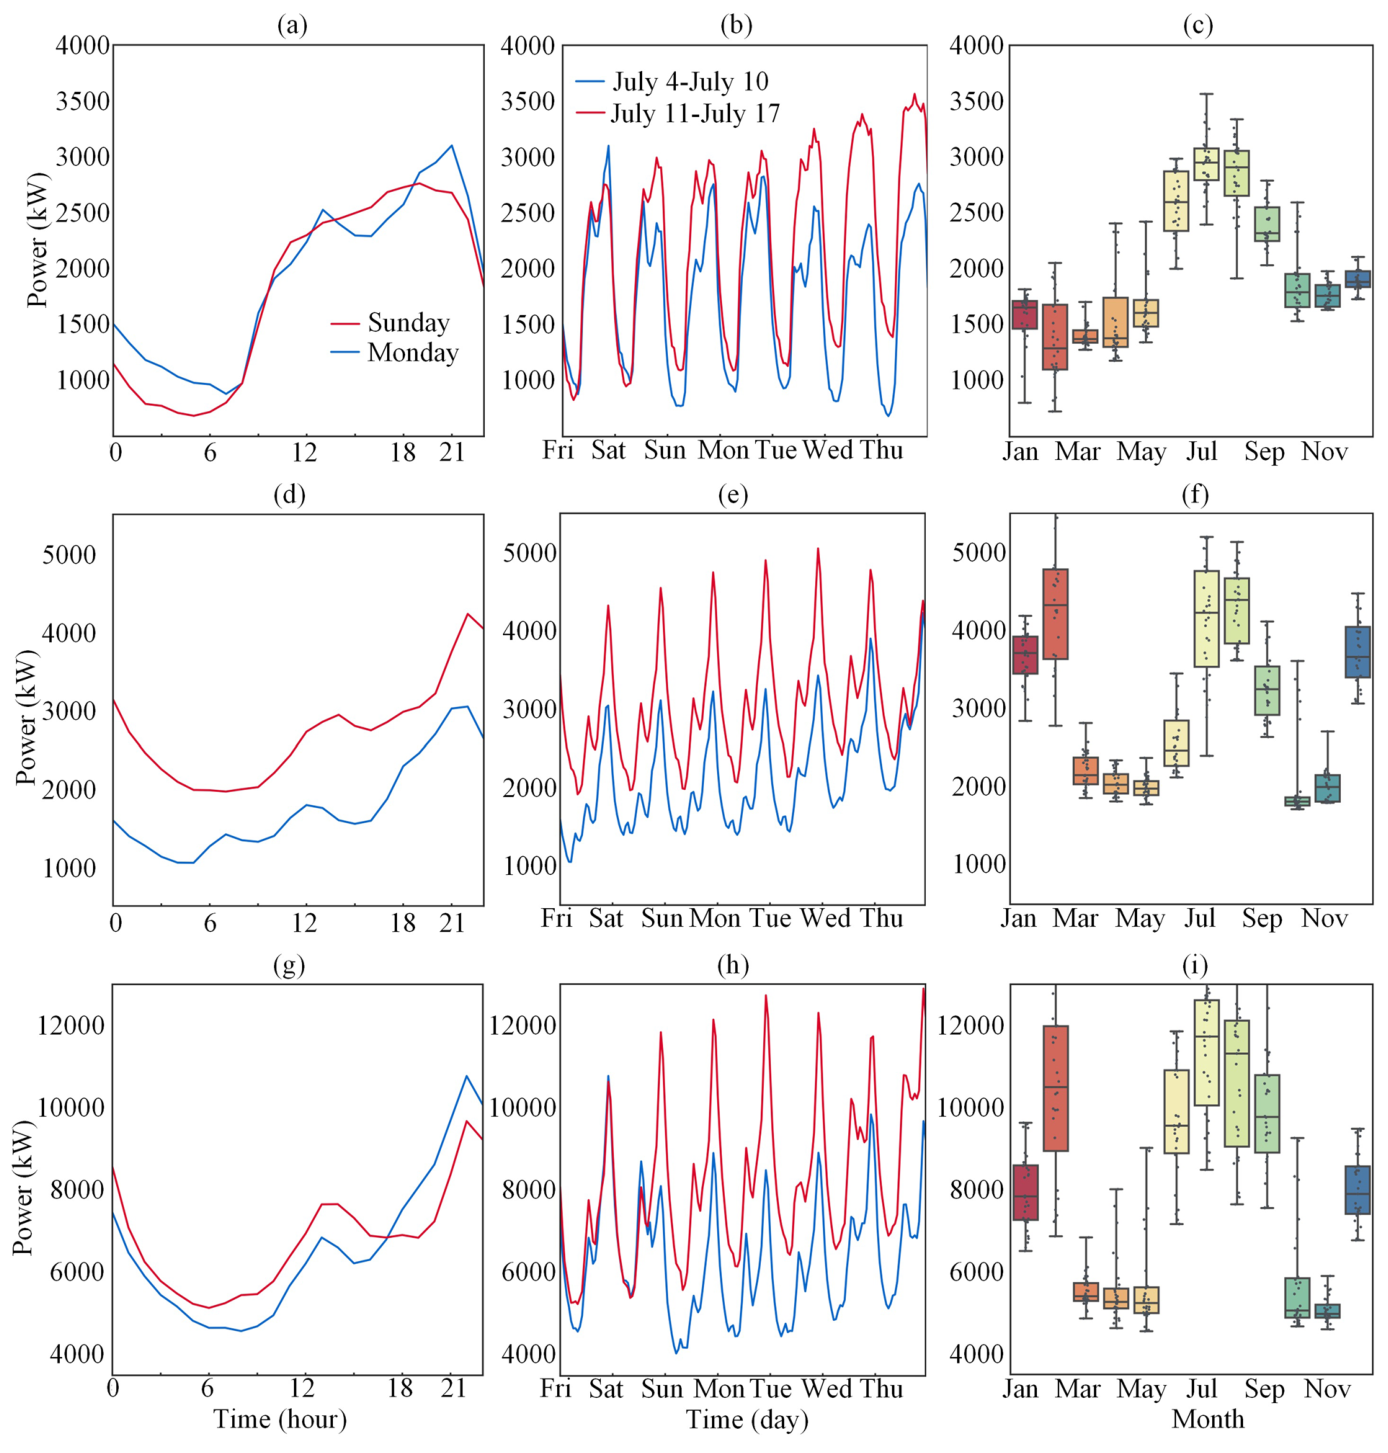
图 5|季节变化之外,一天怎样起伏?
(a、b、c)为C0,(d、e、f)为C2,(g、h、i)为C5。第一列a、d、g比较周日红线与周一蓝线的日内曲线;第二列b、e、h比较两段7月周序列;第三列c、f、i按月份展示日峰值分布。清晨通常较低,白天到晚间升高;工作日与周末的方向并不在三个案例中完全一致,不应概括为所有小区工作日都更耗电。来源:原论文 Fig. 5。
这些模式与居民活动和温控需求相容,但数据没有逐台电器功率,也没有室内设定温度与居住行为记录。所以,空调、做饭和照明是合理的解释方向,不能从聚合曲线单独计算各自贡献。
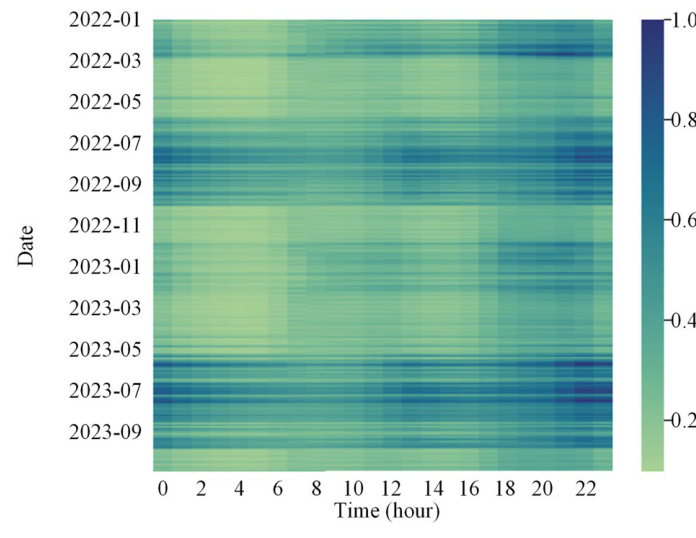
图 6|较高相对负荷通常落在什么季节和时刻?
单幅热图横轴为小时、纵轴为日期,较深颜色表示较高的指标值,夏季与部分傍晚时段更突出。原论文称其为Diversity Factor,但作者当前公开示例将每小时所有电表总负荷除以整个样本期的最大总负荷,形成0—1附近的归一化负荷。因此,深色直接表示相对负荷较高,不能据此单独判定随机波动或住户差异更大。来源:原论文 Fig. 6;定义据作者指标代码与同版本主程序。
这一区分很实用:曲线水平高,和曲线变化幅度大,是两个问题。若要估计波动,还需另行定义逐小时变化、方差或相对离散程度,不能只凭指标名称替代分子分母。
温度上升时,负荷为什么不是一直按同一个斜率增加?
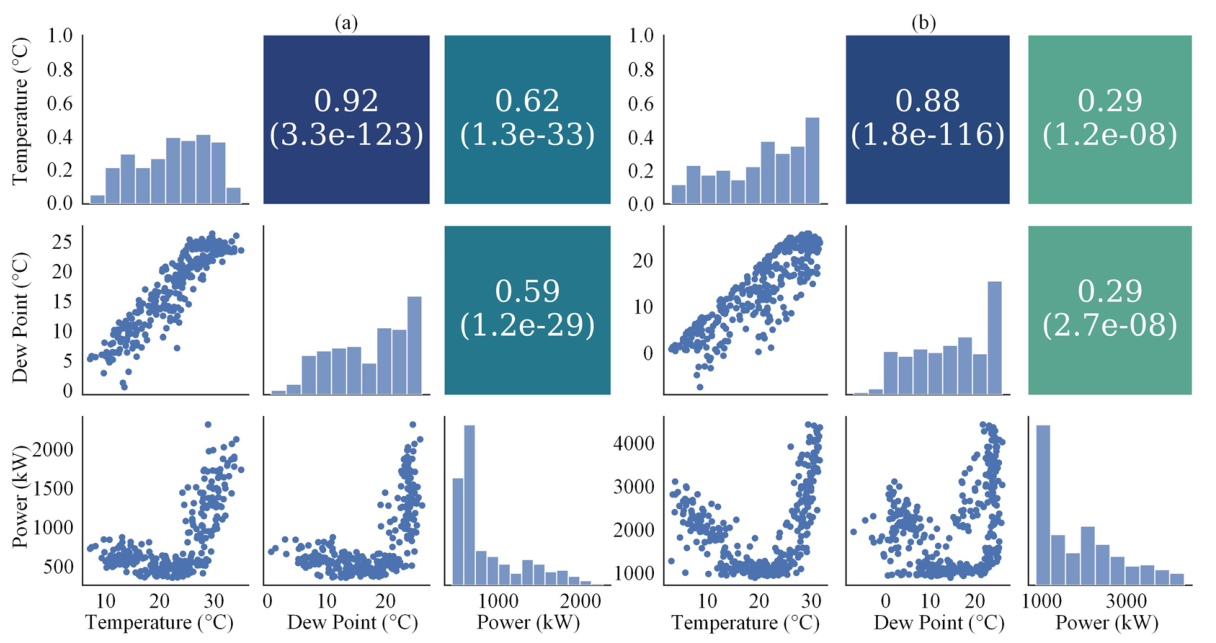
图 7|线性相关能否概括冷热两端的需求?
(a)C0;(b)C2。每组上三角给Pearson相关系数及括号中的p值,下三角为散点,对角线为各变量分布。实际面板变量为温度、露点与功率,并非直接展示相对湿度。C0温度—功率相关约0.62,露点—功率约0.59;C2两者约0.29。散点显示温度舒适区附近负荷较平缓、较热时上升,冷端也可能上升;相关系数只提供整体线性概括。来源:原论文 Fig. 7。
论文在示例中把约18—25°C描述为较平缓区间,超过25°C后负荷上升更明显。这是样本中的描述,不是适用于每栋住宅的恒定空调启动阈值。温度与露点也高度相关,若同时作为解释变量,需要处理它们之间的信息重叠。
城市名称的对应亦需谨慎:表2把C0列为百色,气象验证段落却把C0称作沿海BH。这里沿用图中的C0与C2编码讨论曲线,不依据矛盾称谓推断特定沿海城市的机制。要作城市间的气候差异归因,应先以原始元信息核清代码与站点对应。
极端日与普通日比较,能读出哪些变化?
极端信息包含媒体记录与按天气值计算的标签。表3列出高低温、湿度、热指数、风寒与风暴等级的阈值。比如热指数的32—41°C区间被标为Extreme Caution,表示结合环境条件定义的热感相关指标,不是空气温度本身。不同标签可能重叠,不宜当作互斥事件相加。
表4汇总负荷均值与分布,表5汇总天气,表6汇总媒体收集事件的年度占比。表6的百分比不能脱离其事件或日期统计口径直接改称居民受灾概率。补充表1列出太阳辐射、建筑、室内设定与用户行为的外部资料来源,属于后续研究可补充的变量清单,不是本文已经收集完整的住户调查。
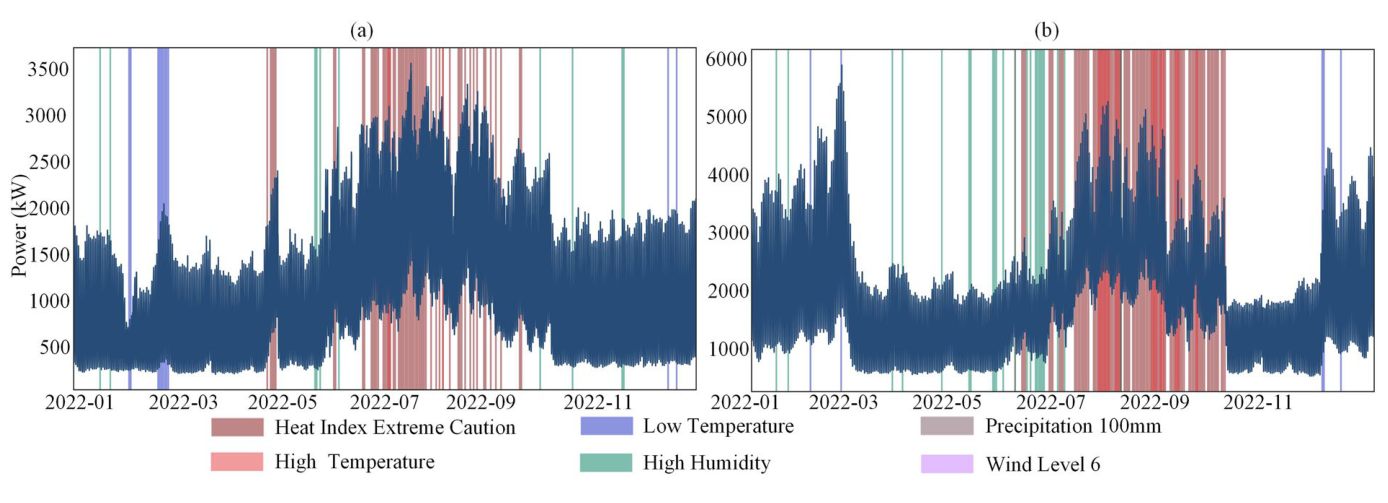
图 8|较高负荷与哪些事件标签同时出现?
(a)C0;(b)C2。横轴为日期,纵轴kW,背景颜色标示热指数、高温、低温、高湿、降水100毫米与相应风力事件。高温相关标签集中期常伴高负荷,但多种标签、季节和日历共同变化,叠置图本身不能识别其中一种天气的净影响。来源:原论文 Fig. 8。
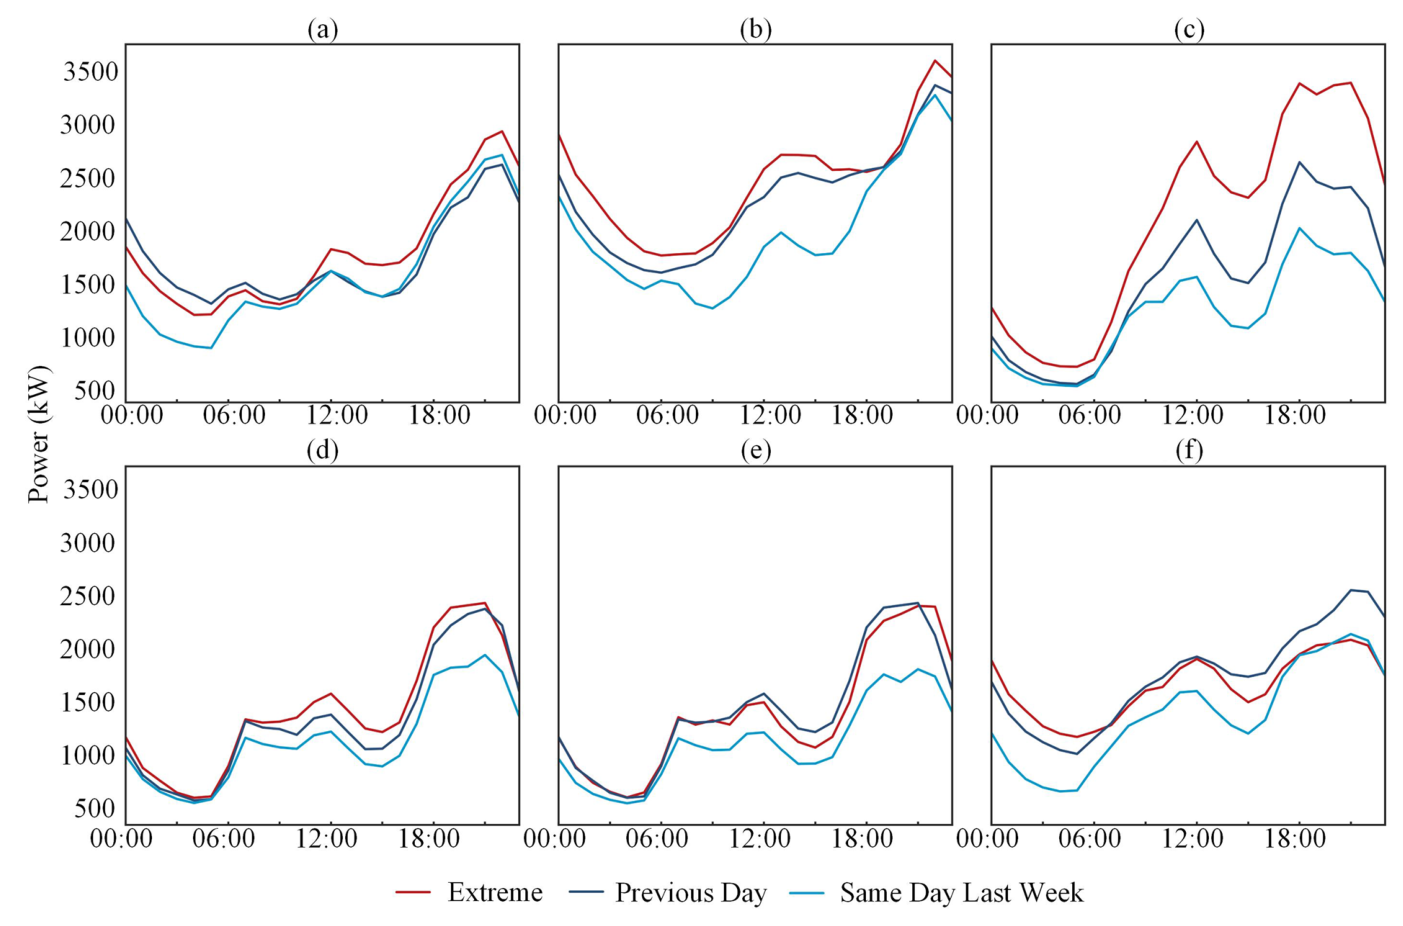
图 9|同一城市的异常日,日内形状怎样不同?
C2的(a)热指数Extreme Caution,(b)高温,(c)低温,(d)高湿,(e)5级风,(f)降水达到100毫米。红线是极端日,深蓝是前一天,浅蓝是上周同日,横轴为时刻、纵轴kW。高低温案例可见较高的部分时段需求,风雨案例差异更复杂;对照日的温度、节假日与居民活动未被随机控制,因此这些差值不能直接写成天气造成的额外用电。来源:原论文 Fig. 9。
这套数据可以怎样帮助规划,又需要补什么验证?
它适合研究相近气候与住宅环境下的小区负荷节律,检验天气特征是否改善预测,也可为储能与分时电价情景分析提供需求基底。论文没有实施电价干预,没有计算某种储能方案的最优容量,也没有用两年不到的记录识别长期气候变化效应;这些是应用方向。
数据复用有三个优先事项。其一,区分423个采集电表、清理后的有效电表与聚合小区的计数;其二,核对负荷、容量、气象单位及城市站点关系,尤其作者仓库已更正两台电表额定容量为630 kVA而非200 kVA;其三,按时间先后划分训练与测试,填补时避免用测试之后的信息帮助预测过去。
如果研究极端风险,还应专门检查峰值保留情况和事件期间的缺失。平均曲线合乎常识,只能说明数据具有可解释的结构,不能替代外部计量校准、事件覆盖完整性或真正的预测误差检验。
一句话总结
小区电表让天气与居民用电可以被共同观察,但峰值、缺失和聚合口径同样属于证据,不能为了画出平滑曲线而忽略。
核心来源
- Li, B. et al.(2025). A Large-Scale Residential Load Dataset in a Southern Province of China. Scientific Data 12, 450。原论文及补充材料。本文九幅图来自原论文。
- 原始数据版本v1。
- 作者代码及额定容量修正说明,实现细节核对固定于提交09478b0db25bdf25b3ecca1ffcfd7466b7a0fe61。
作者介绍
以下机构和贡献据论文发表时署名与作者贡献说明。
- Bo Li:广西大学电气工程学院、清华大学电机系;共同第一作者,参与概念、方法、可视化与写作。
- Ruotao Yu:广西大学电气工程学院;共同第一作者,参与概念、方法、可视化与写作。
- Kaiye Gan:广西大学电气工程学院,为本文合作者。
- Guangchun Ruan:MIT信息与决策系统实验室;参与正式分析与调查。
- Shangwei Liu:普林斯顿大学公共与国际事务学院;参与调查。
- Mingxia Yang:广西大学电气工程学院;参与可视化与写作。
- Daiyu Xie:广西电网电力调度控制中心;参与调查。
- Wei Dai:广西大学电气工程学院;通讯作者,参与调查与项目支持。
- Haiwang Zhong:清华大学电机系;通讯作者,参与分析与研究指导。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
预测系统也许应把数据是否可靠作为另一项输出:既预测下一小时需求,也估计当前电表覆盖、填补比例和天气站缺失状况。这样,当极端事件恰好使观测变差时,调度者能看见模型信心下降,而不只是看见一条依旧平滑的预测线。
还可以做一次有目的的遮挡实验:在真实可见的极端时段人工隐藏部分数据,比较普通周填补、前后日填补与不填补模型对峰值的误差。若一种方法在平均误差上最好、却持续压低最高需求,就需要按电网规划目标重新选择,而不是仅凭整体拟合决定。