五十万条村际联系里,格子卷积怎样靠近图模型?
论文名片|Sheng Wu、Linbaizhi Wang、Peixiao Wang、Hengcai Zhang、Shifen Cheng、Xin Fu、Junhao Guo、Feng Lu,Predicting citywide human mobility with a graph-prior-enhanced euclidean convolutional network,Sustainable Cities and Society,2026,149:107720。通讯作者为 Peixiao Wang。2025年12月6日收稿,2026年5月2日收到修改稿,2026年7月17日录用,2026年7月18日在线发表。DOI:10.1016/j.scs.2026.107720。本文依据这一正式版解读,研究类型是城市尺度 OD 流量的预测方法比较。
早高峰里,交通管理常常要知道的是下一刻钟有多少人从某一个村去另一个村,而不只是一个区一共进来多少人。把所有村对村的流量排成一张表,卷积会把表上挨着的格子当成邻居。编号相邻的两行,地理上却可能隔着海。图模型可以把流量曲线长得像的起讫点对连起来,可是厦门的村级单元两两组合有 506,944 个节点,福州有 10,010,896 个。节点一多,邻接矩阵就先把计算撑满。
这项研究提出图先验增强的欧几里得卷积网络(Graph-Prior-Enhanced Euclidean Convolutional Network,GPECN)。它先按流量曲线的结构相似程度连接 OD 对,再把这些连接种进规则格子,让普通卷积去模仿图上的邻居聚合。在筛过的高流量 OD 对上,它的误差与最强的图基线处于同一量级,单次推断比注意力图模型少花数倍时间,同时仍慢于普通卷积。下面的岛内外例子来自论文后文的误差讨论,用来说明这种流量长什么样,并不是一次真实的调度案例。
先说结论
- 实验对象是高流量子集:厦门 506,944 个村级 OD 对里取日总流量最高的 2,589 对(占 0.511%),福州 10,010,896 对里取 4,342 对(占 0.0434%)。厦门流量小于 5 的记录有 48,413,073 条,分母是全部 52,663,430 条出行记录,合 91.9%,论文写作大约 92%。福州只说分布类似,没有给出流量小于 5 的条数。
- 只在真实流量大于 0 的项上计算误差。厦门单步 RMSE,GPECN 为 3.18±0.18,ST-GDN 为 3.15±0.27,配对 t 检验 p=0.59;相对 ConvLSTM 的 4.98±0.84,绝对差 1.80,相当于后者的 36.1%,p=4.80×10⁻⁶。福州单步 RMSE,GPECN 为 2.82±0.10,低于 ST-GDN 的 2.96±0.13,绝对差 0.14,相当于后者的 4.7%,p=5.05×10⁻³。
- 计时只在厦门、2,589 个节点、batch size=8 上报告。GPECN 单次推断 96.58 毫秒,ST-GDN 为 263.95 毫秒(约 2.73 倍),ASTGCN 为 485.64 毫秒(约 5.03 倍),ConvLSTM 为 12.27 毫秒(GPECN 约为它的 7.87 倍)。
- 把 Wasserstein 距离换成余弦距离后,厦门单步 RMSE 从 3.18 升到 4.55。图先验半径取 7 时,厦门 2,589 个节点里有 2,366 个、福州 4,342 个里有 3,775 个,其全部图邻居仍落在这个半径内。
- 预测误差与流量波动一起变大。图中 MAE 对真实流量标准差的 R²,厦门为 0.8940,福州为 0.8560。这个 R² 的两列数是误差和标准差,分母不是流量本身的方差。
要预测的是每一对村之间的流量
人类移动性(human mobility)在这里指人在城市空间中的移动强度。论文把任务收成空间交互强度,也就是时间上的 OD 矩阵预测:研究单元 i 和 j 之间,在某个时间窗里有多强的出行。一个区的总流入、总流出是另一类问题。总流入把许多来源加在一起,看不出人从哪来;OD 流量保留每一对起讫点。
数据覆盖 2023 年 4 月 1 日至 6 月 30 日,共 91 天,采样间隔 15 分钟,每天 96 个时间窗。厦门有 712 个村级行政单元,福州有 3,164 个。712×712=506,944,3,164×3,164=10,010,896,与正文给出的 OD 对数量一致,所以统计的是村级单元的全部两两组合,包含同一个单元内部的那一条。厦门记录 52,663,430 条 OD 出行,福州记录 75,394,526 条。
把厦门的记录摊到全部格子上:分母是 506,944 个 OD 对 × 91 天 × 96 个时间窗,共 4,428,662,784 个时空位置,平均每个位置 0.0119 条记录。福州同样计算,平均每个位置 0.000862 条。这是全表平均,包含大量空格子,用来说明矩阵有多稀,不能当成一个人一天走多少次。
论文没有写明这些记录来自手机信令、公交刷卡还是其他传感器,只在文末写数据可向作者索取。训练时段、测试时段、学习率和训练轮数也没有列出。后面的误差因此是在作者选定的高流量 OD 对上、于真实流量大于 0 的位置计算的预测误差,读者无法从正文复核它对应哪一段未来日期。
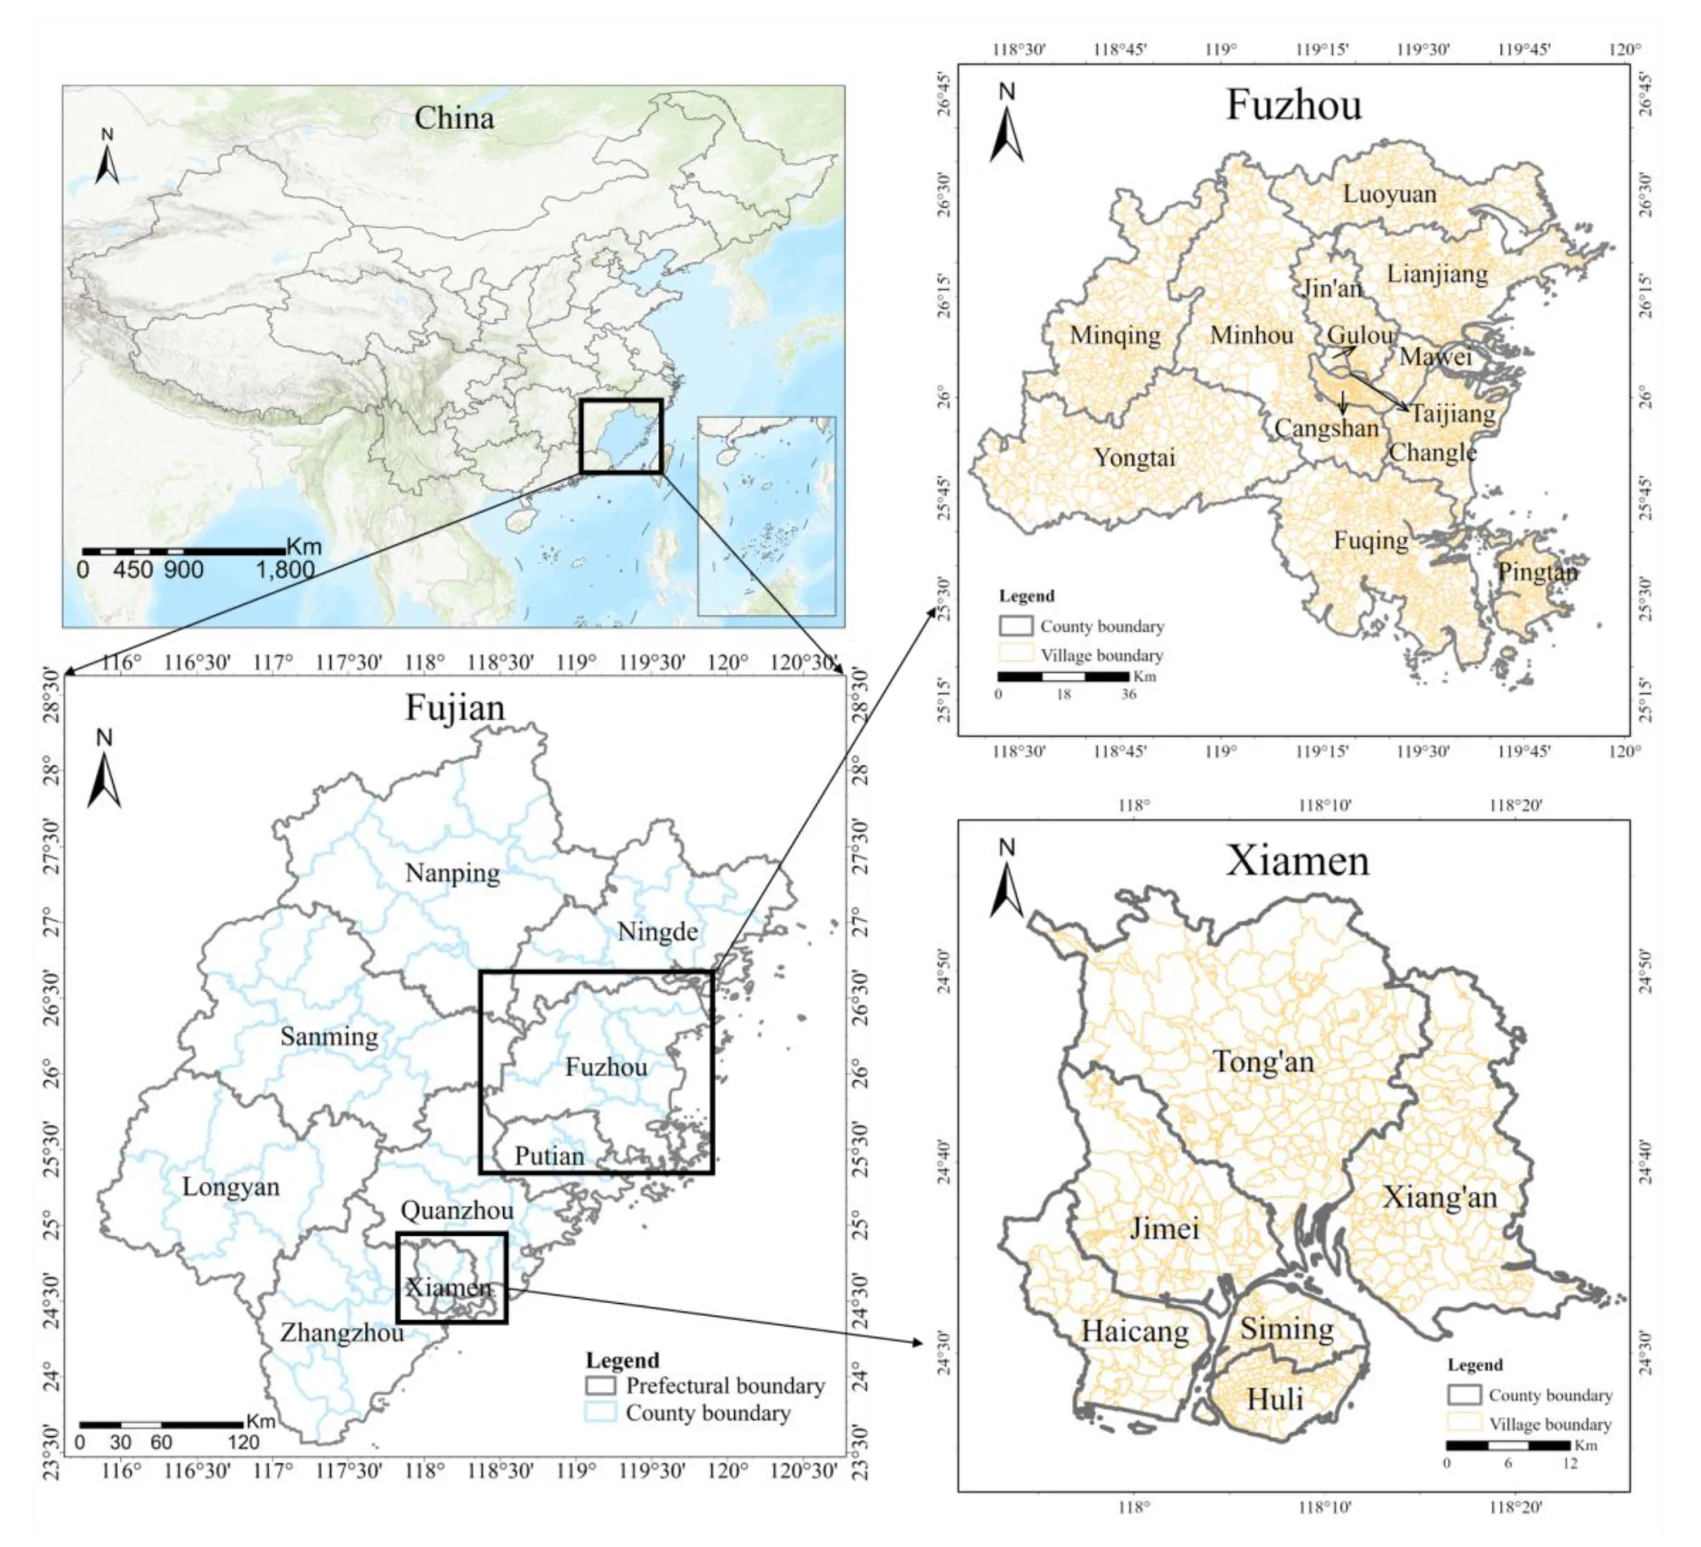
图 8|两个案例城市分到哪一层行政单元?
无字母子图。左上为中国位置,左下为福建及福州、厦门的框选范围;右上为福州,右下为厦门。黄线是村界,灰线是区县界。厦门标出思明、湖里、集美、海沧、同安、翔安六个区,福州标出鼓楼、台江、仓山、晋安、马尾、长乐、福清、闽侯、连江、罗源、闽清、永泰、平潭等十三个区县。比例尺分别约为厦门 12 公里、福州 36 公里、福建 120 公里。这张图给出分区,不包含流量。来源:原论文 Fig. 8。
表上的邻居,常常不是地图上的邻居
OD 矩阵把起点编成行、终点编成列。二维或三维卷积默认相邻像素强相关,所以它跑得快,也默认“格子挨着”有地理含义。对一个区的流入流出,格子往往还能对应地面上的邻接。对 OD 流量,矩阵里左右相邻的格子只是编号相邻的两条出行对,地理上可以很远。城市再按村切开以后,空格子变多,这种错位更严重。
图模型把每条 OD 对当成一个节点,用邻接矩阵写出谁和谁相关,精度通常更高。节点数随单元数平方增长,邻接矩阵的存储和乘法会先成为瓶颈。GPECN 要保留的是图里“谁与谁相似”这件先验,计算则仍走规则格子上的卷积。
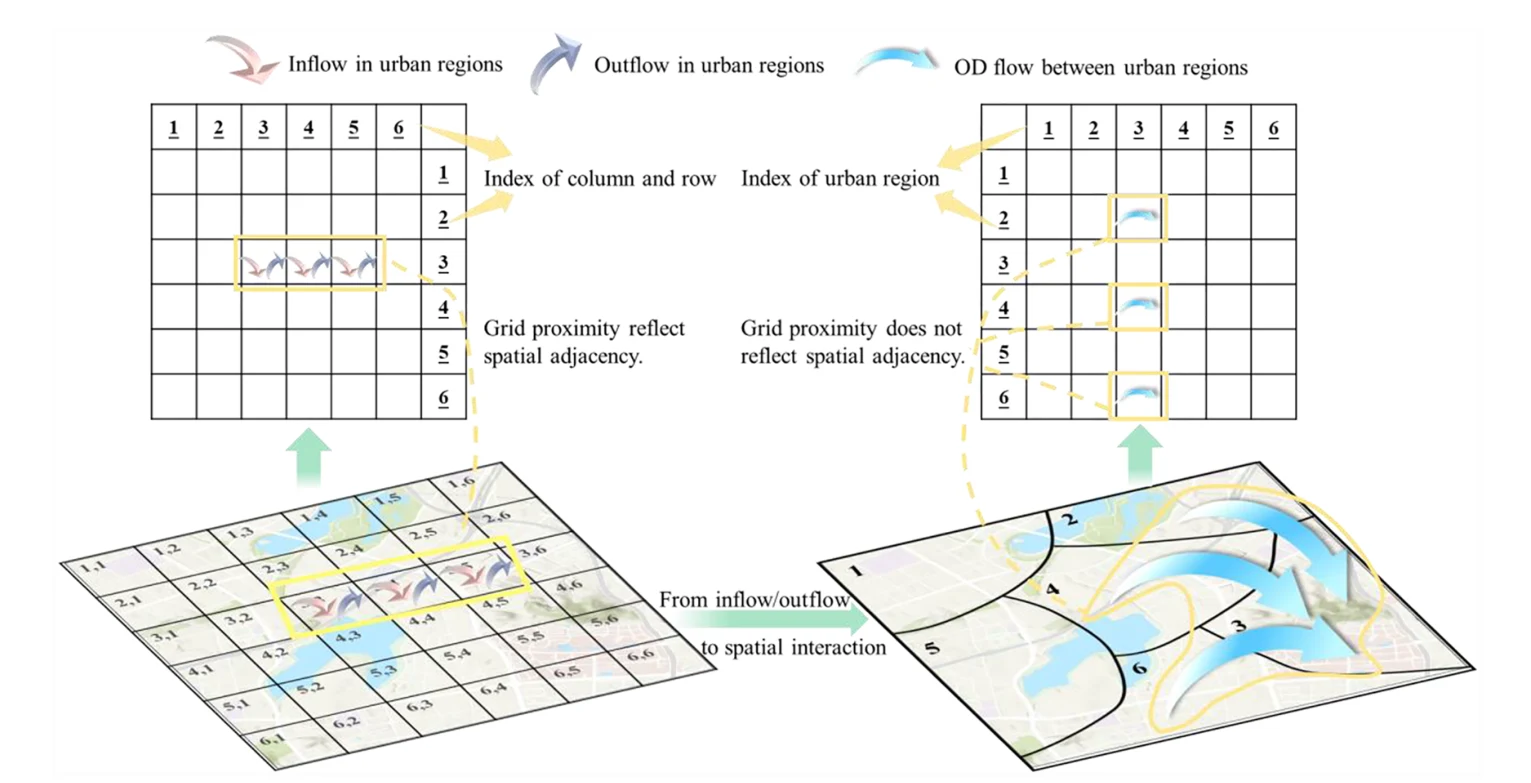
图 1|为什么同一张格子表,在 OD 任务里会读错邻居?
无字母子图。左侧是分区流入、流出:地面格子与矩阵行列可以按同一套编号对齐,格子邻近还能反映空间邻近。右侧是分区之间的 OD 流:一条流量要同时占用起点编号和终点编号,矩阵里上下相邻的格子不一定是地面上相邻的两次出行。图中的箭头和编号是示意图。来源:原论文 Fig. 1。
基线也按这个分野来选。欧几里得结构一侧是 ConvLSTM 和 ST-3DMDDN;非欧几里得结构一侧是 ASTGCN、ST-VGCN 和 ST-GDN。五者都在同一批筛过的 OD 对上比较。论文认为非欧几里得模型里,能给邻居自适应分配权重的图注意力方法通常更准。GPECN 本身仍是格子卷积,它用权重去模仿这种聚合,并没有在预测时真正做一次图注意力。
相似,按一天里的曲线形状来算
虚拟图的节点是 OD 对。边不用道路距离,而用两条流量曲线有多像。作者先把 N 条 OD 对、T 个时间窗的矩阵,整理成“天数 D × 每天时间窗 Q”的曲面,这里 D×Q=T,Q=96。对每一个钟点,取该 OD 对在 D 天里这个钟点的流量向量,计算它的 L2 范数,再除以全天各钟点范数之和,得到一条和为 1 的日内概率分布。这一步压低绝对流量的影响,让比较更多落在一天之中哪里高、哪里低。
搬运代价是余弦距离:OD 对 i 在钟点 h 的“跨天向量”,与 OD 对 j 在钟点 l 的“跨天向量”之间的余弦距离。Wasserstein 距离(Wasserstein distance,把一个分布搬成另一个分布的最小总代价)就在这个代价表上,寻找把 i 的日内概率搬到 j 的日内概率的最省方案。代价低,两条曲线的形状更接近。全部 OD 对两两算完以后,每个节点只保留 K 个最近邻。厦门的 K 取 2,福州取 3。K 是启发式设定,换城市要重选。
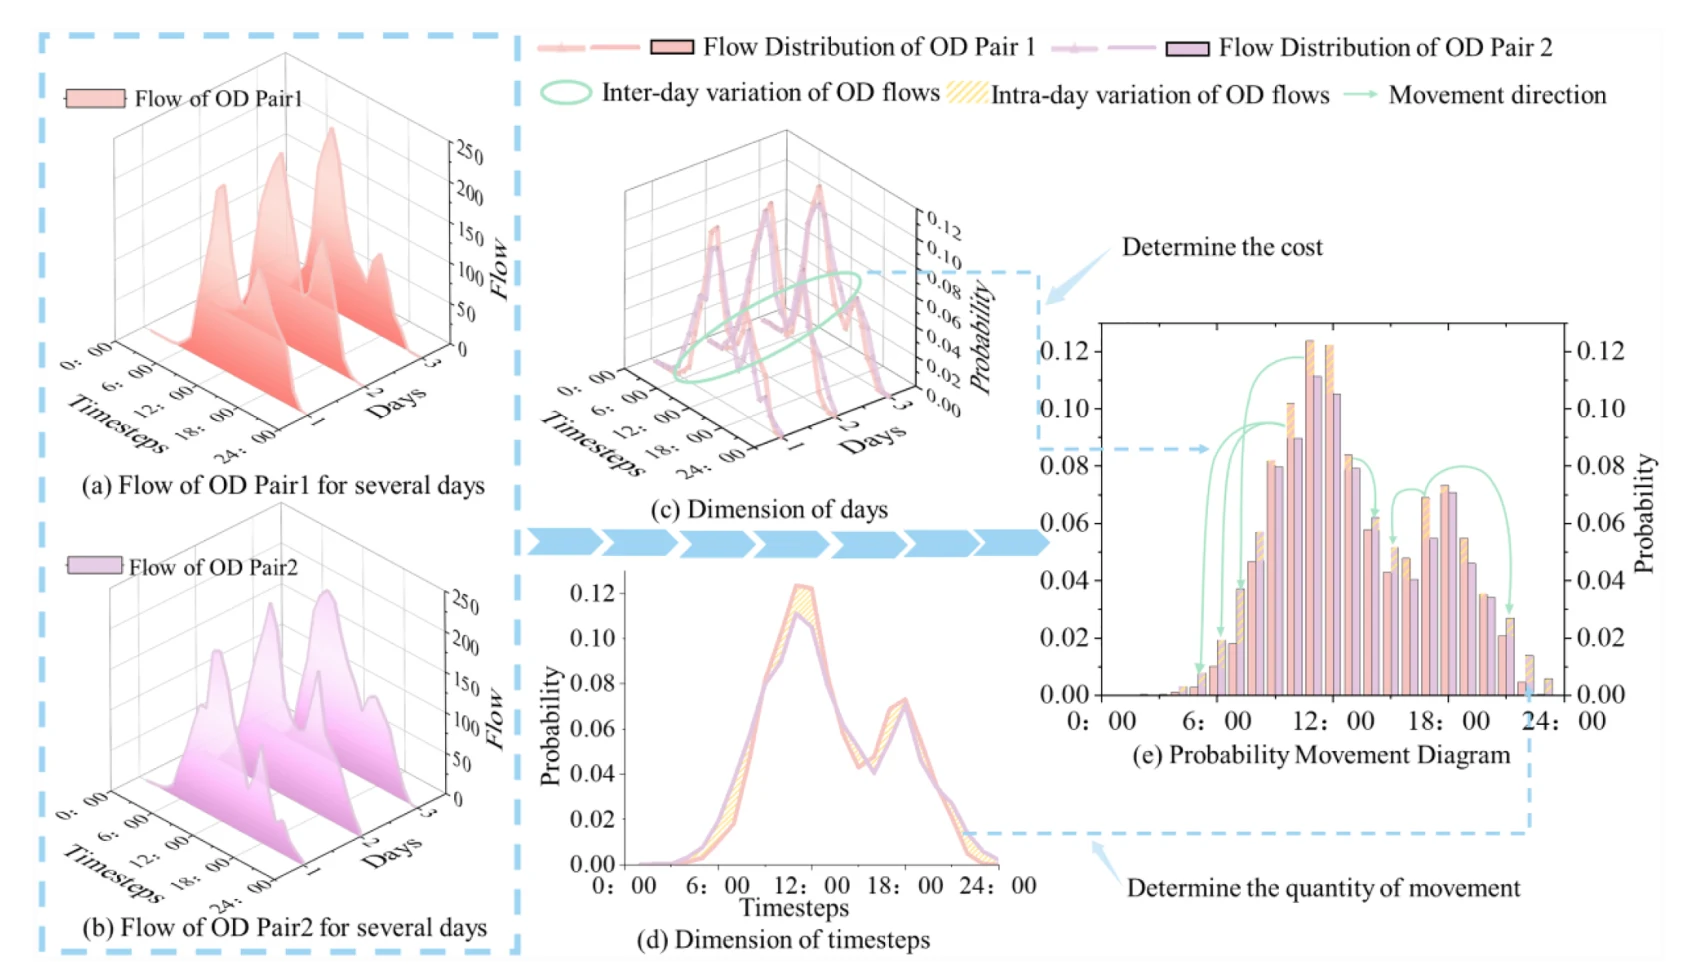
图 3|两条 OD 曲线的相似,拆成了哪两种时间差?
(a、b)两条示例 OD 对在若干天上的流量曲面,纵轴是流量,两个水平轴是一天内的时间窗和日期;峰的位置不同。(c)按日期看两条分布,绿圈标出日与日之间的差异,文中把它当作搬运代价的来源。(d)按钟点看日内概率,阴影标出一天内部的起伏,文中把它当作需要搬运的概率质量。(e)把两条概率画成柱,绿线连接被配对的钟点,用来同时看“搬多少”和“搬去哪一个钟点有多贵”。图中曲线是方法示意,不是厦门某条真实 OD 的标注样本。来源:原论文 Fig. 3。
邻接矩阵 A 在后文的相似度树里按“数值大表示更该连在一起”来使用,而 Wasserstein 距离本身是越小越近。正文写明 K 近邻来自这个距离,没有再给出把距离换成边权的显式公式。因此图上的边应理解为结构近邻,不宜把 A 的具体数字读成相关系数或道路阻抗。
近邻怎样种进一张规则格子
直接在这张虚拟图上做图卷积,节点一多就会回到效率问题。作者改用离线映射:先长出一棵相似度树,再从格子中心向外填。树的第一层是邻接矩阵里最相似的那一对节点中的一个。把它的邻居按相反顺序放到下一层,再对下一层重复,直到节点都进树。给定 A 以后,这个过程是确定的。
填格子时,根节点占中心。它的子节点按顺时针、从正北开始,放进周围八个一阶格子。某一节点的八个一阶位置都满了,就把格子向外扩一圈,改填十六个二阶位置。因为每个空格优先留给虚拟图上的邻居,格子上的相邻关系里就留着原来的图邻居。八个一阶位置是这张二维格子的容量上限,作者把它列为局限:更密的邻居关系需要以后改到三维格子。
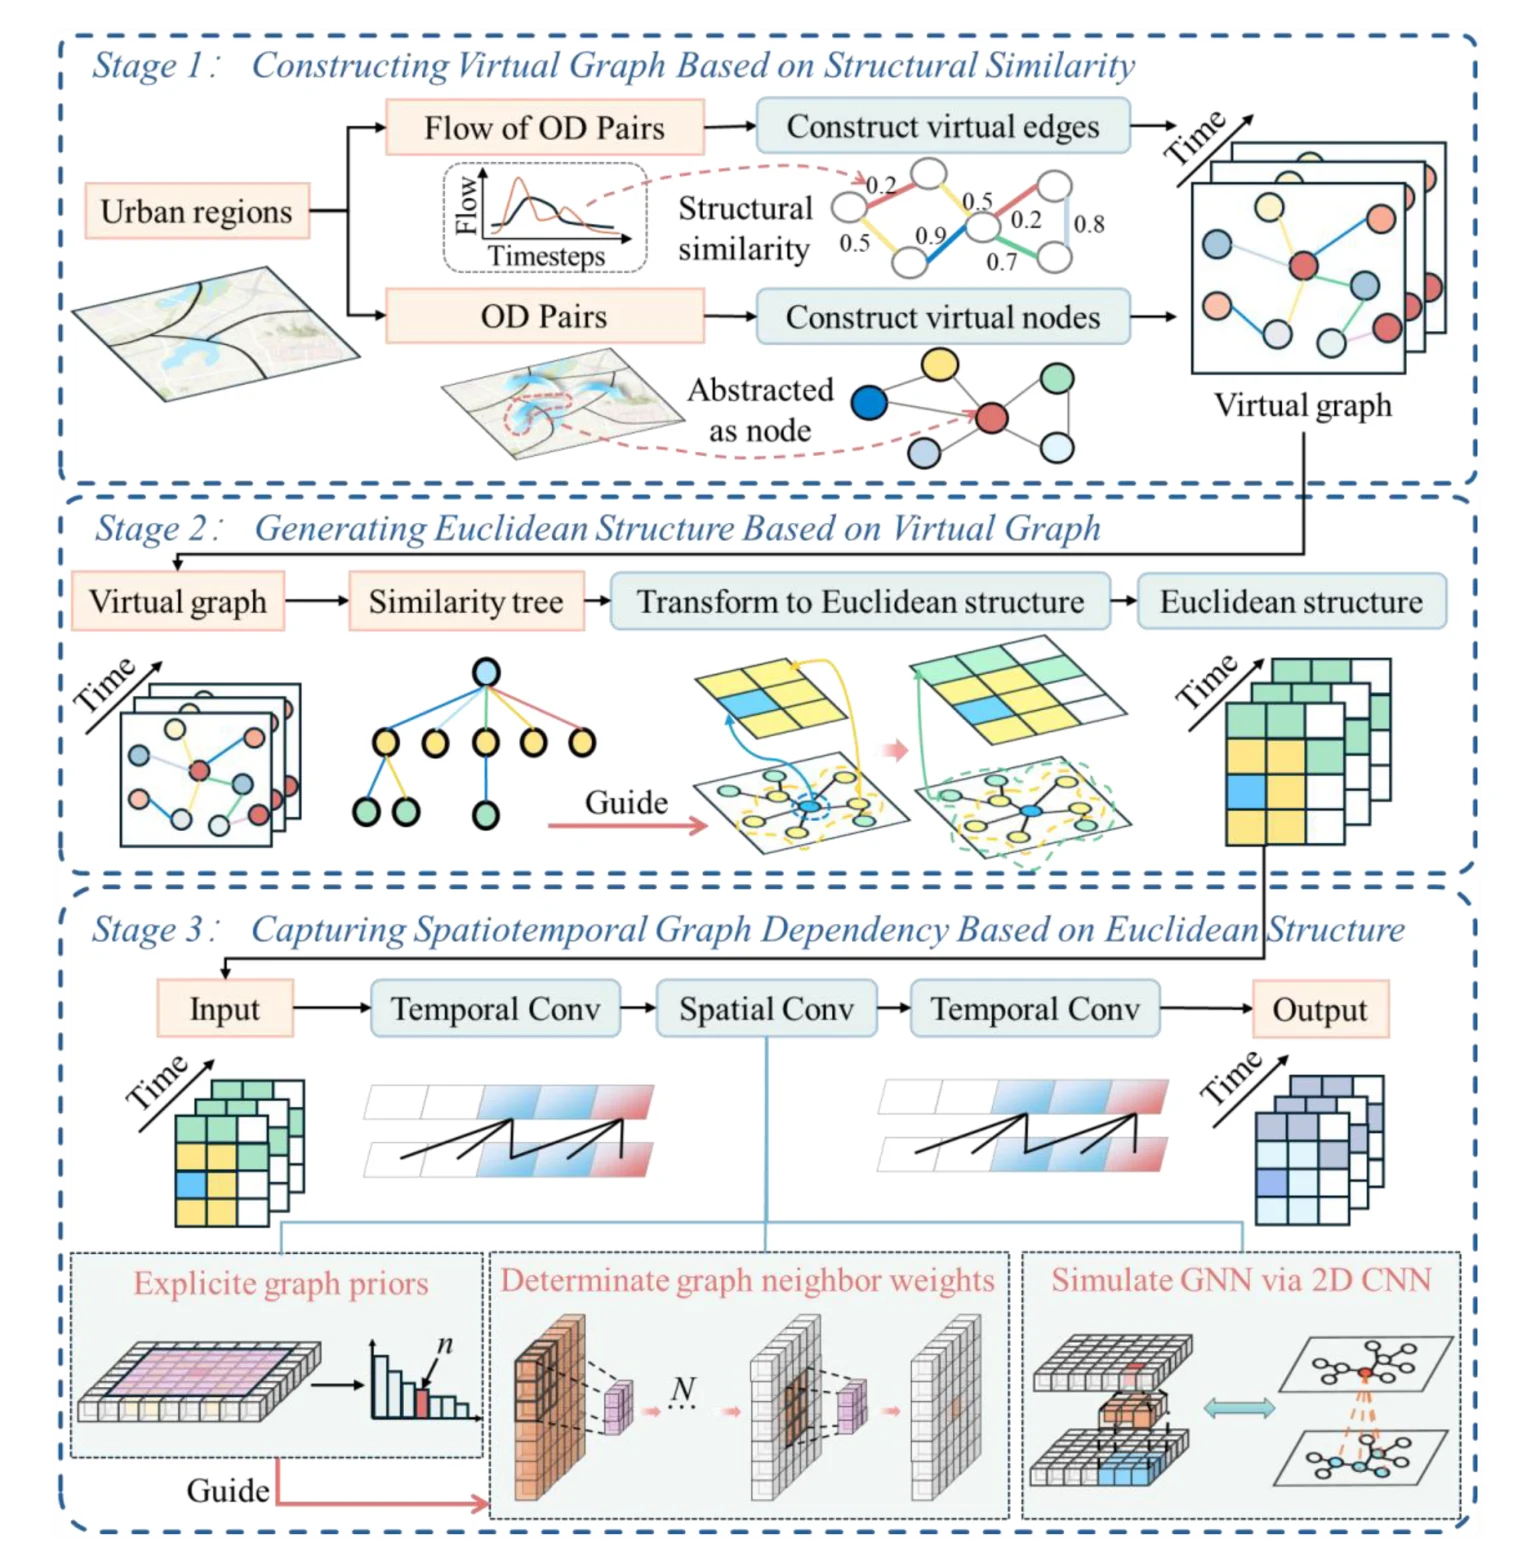
图 2|从流量表到卷积输出,中间固定了哪三步?
无字母子图,自上而下三阶段。阶段一只把 OD 对收成节点,并用结构相似度连边。阶段二把虚拟图收成相似度树,再填进带颜色的规则格子。阶段三在格子上做时间卷积和空间卷积;底部三块分别是显式写出图先验、确定邻居权重、用二维卷积模拟图聚合。图中的小数和颜色是流程示意。来源:原论文 Fig. 2。
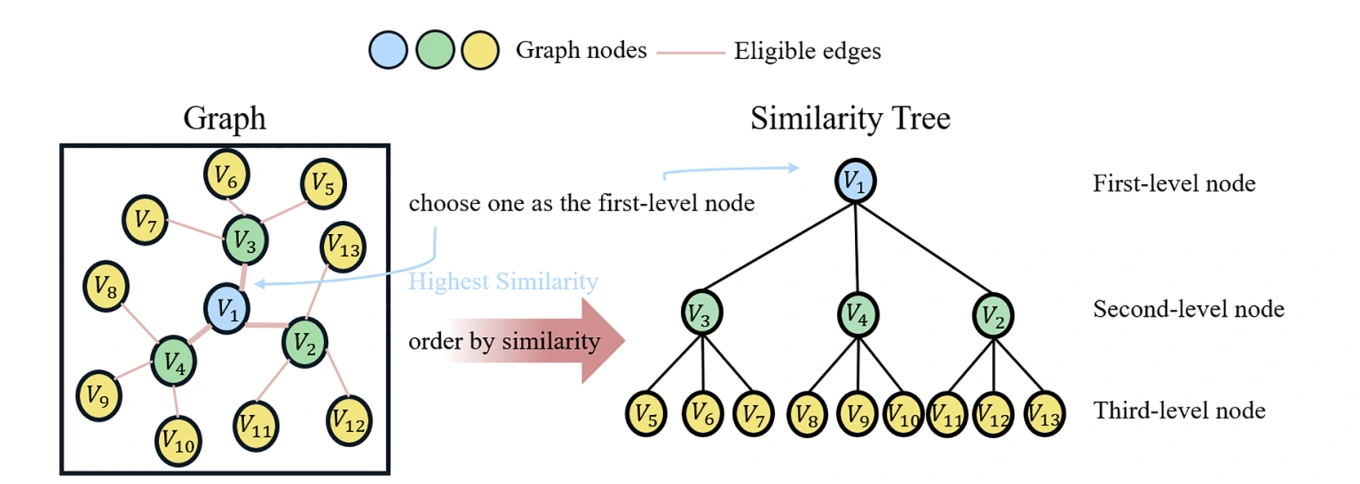
图 4|相似度树按什么顺序收节点?
无字母子图。左侧虚拟图里,蓝节点与周围节点的连线被标成最高相似度;右侧把其中一个节点当作第一层,按相似度顺序展开第二层、第三层。粉线是可以进入树的边。这是映射优先级,还不是最终的欧几里得坐标。来源:原论文 Fig. 4。
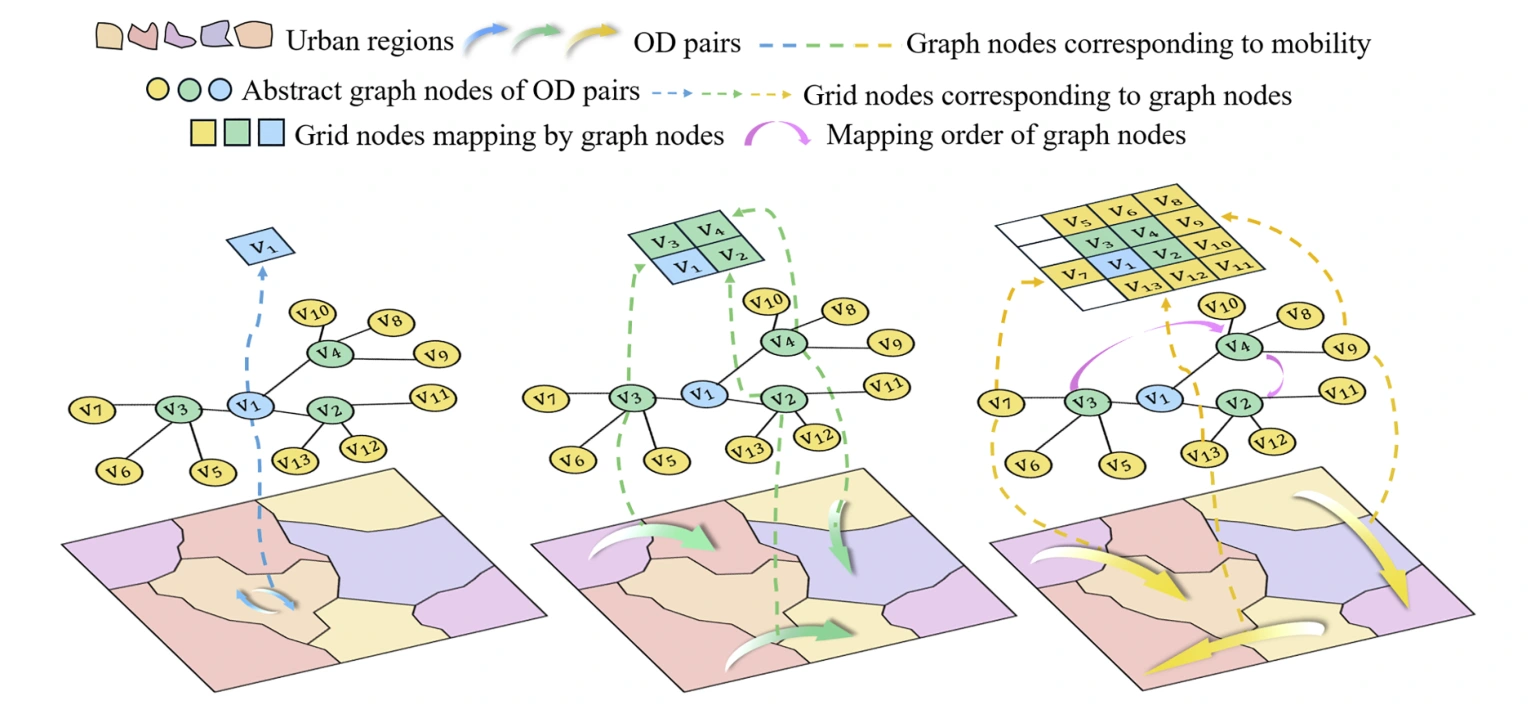
图 5|树上的节点按什么规则落到格子里?
无字母子图,从左到右。左:选一个节点作为生长起点。中:它的图邻居被收成一组待填位置。右:这些邻居按顺时针落入中心周围的格子,格子满了再向外扩。地面上的色块只表示城市分区示意,箭头不代表实测人流。来源:原论文 Fig. 5。
卷积要看多远,由最远邻居的直方图决定
格子里虽然藏着图邻居,卷积核仍只看见自己的窗口。窗口太小,最远的那个图邻居会落在外面;窗口太大,空格子和无关节点会把计算拉高。作者对每个目标节点量它到最远图邻居的格子距离,画频数直方图,取直方图开始稳住的那个距离作为图先验半径。厦门和福州都把这个半径设为 7。
半径 7、空间核为 3×3 时,前向次数与半径是对齐的。公式(6)写的是 F=⌊2×PR/(k−1)⌋,PR 为半径,k 为核的边长。k=3 时分母是 2,2×7/2=7,消融表里的完整模型也记为 F=7。直观地说,3×3 的核每做一次,感受野半径增加 1;要做到半径 7,就要重复 7 次,而不是一次用一个很大的核。
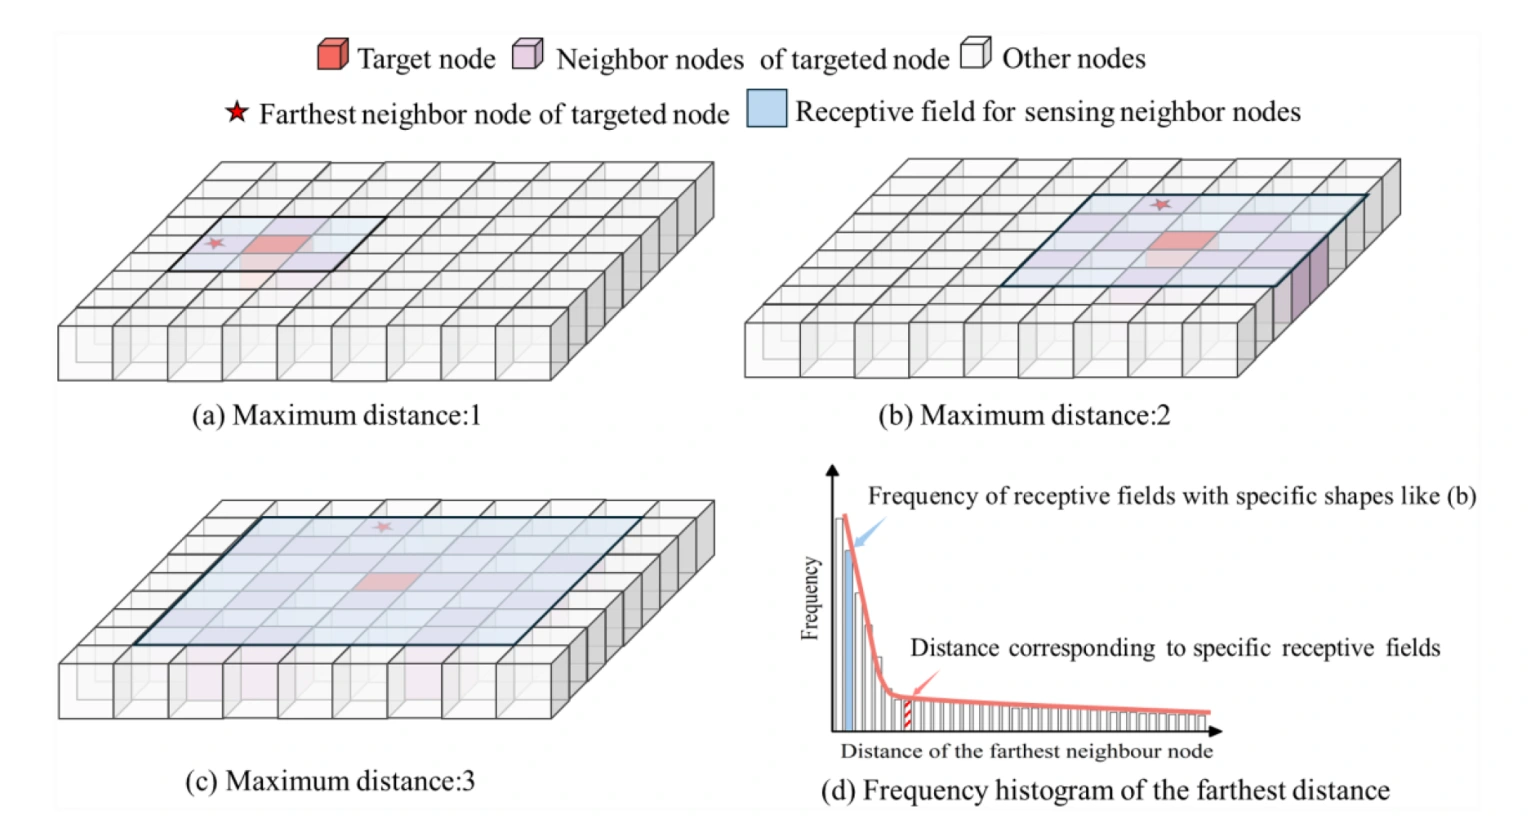
图 6|感受野要盖住最远的图邻居,半径该怎么取?
(a、b、c)同一个目标格子在最远邻居距离为 1、2、3 时,蓝色感受野必须扩大才能罩住星标邻居;紫格是该目标的图邻居。(d)示意最远邻居距离的频数:前段高、后段变平。正文用真实数据上“变平的位置”定半径,这张小直方图本身没有给出厦门或福州的频数。来源:原论文 Fig. 6。
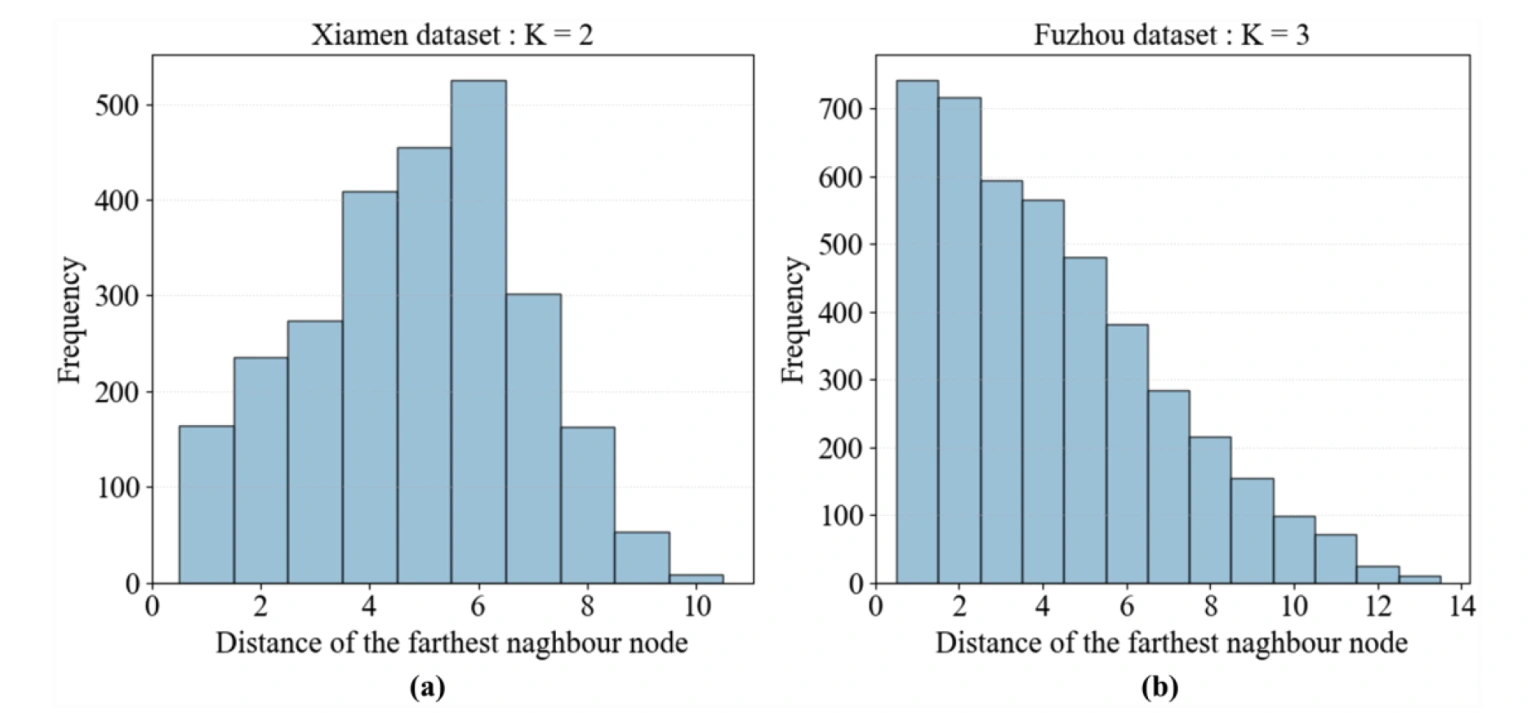
图 13|两个城市的最远邻居距离,停在哪里?
(a)厦门,K=2。横轴为最远邻居的格子距离,大约 0 到 10;纵轴为节点频数。中等距离的柱最高,距离 7 之后明显变矮。正文据此把半径设为 7,并写出此时有 2,366 个目标节点的全部邻居都被罩住,分母是进入实验的 2,589 个节点,占 91.4%。(b)福州,K=3。近距离的柱最高,横轴延伸到大约 14。半径同样取 7,正文写出 3,775 个节点的空间关系得以保留,分母是 4,342,占 86.9%。柱高没有逐柱标注,这里只采用正文给出的覆盖节点数。来源:原论文 Fig. 13。
网络的数据流可以从图上看清。输入是历史 O 个时间窗的格子张量。先做 1×3 的时间卷积,再重复 3×3 的空间卷积;空间卷积的输出被映射成图邻居上的权重,用来模仿图卷积把邻居信息加到目标节点。空间部分走完 F 次之后,再做一次时间卷积得到未来 Z 步。损失是预测流量和真实流量的均方误差,分母写成 OD 对数量 N 乘预测步数 Z。
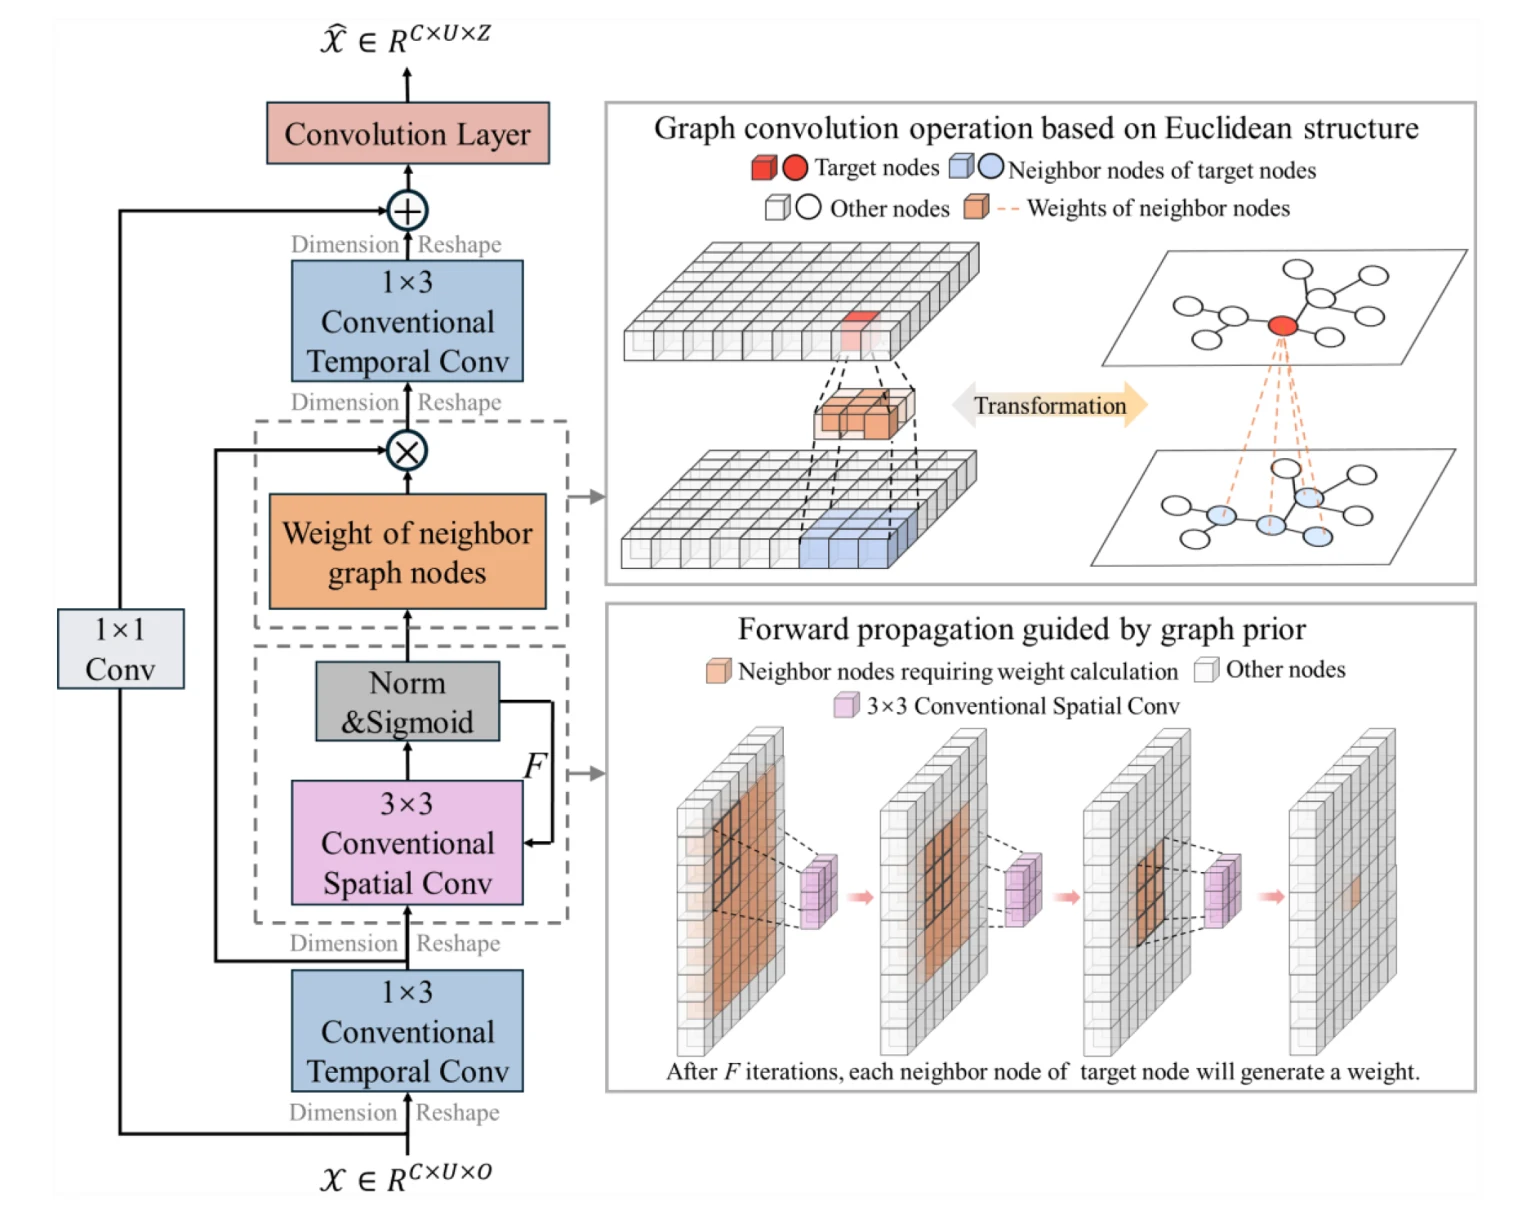
图 7|小卷积核重复几次,怎样模仿图上的加权求和?
无字母子图。左侧堆叠 1×3 时间卷积、3×3 空间卷积、归一化与 Sigmoid,以及一条 1×1 卷积;F 标在空间卷积的重复上。右上把格子里的目标节点、邻居节点和权重,对应到一张小图的边权。右下用连续三次 3×3 示意感受野向外扩,并写明 F 次之后每个图邻居都会得到一个权重。来源:原论文 Fig. 7。
超参数只在厦门画出曲线,福州沿用同一套隐藏维度和输入长度,K 单独改为 3。隐藏维度在 512 以前误差下降更清楚,超过 512 以后增益变小,因此取 512。输入长度取 10 个时间窗。若一个时间窗就是 15 分钟采样,10 步大约是 150 分钟的历史;论文没有另给分钟换算。K 太大会把邻居抹平,太小会漏掉相似的 OD 对,所以两端城市的最优 K 不必相同。
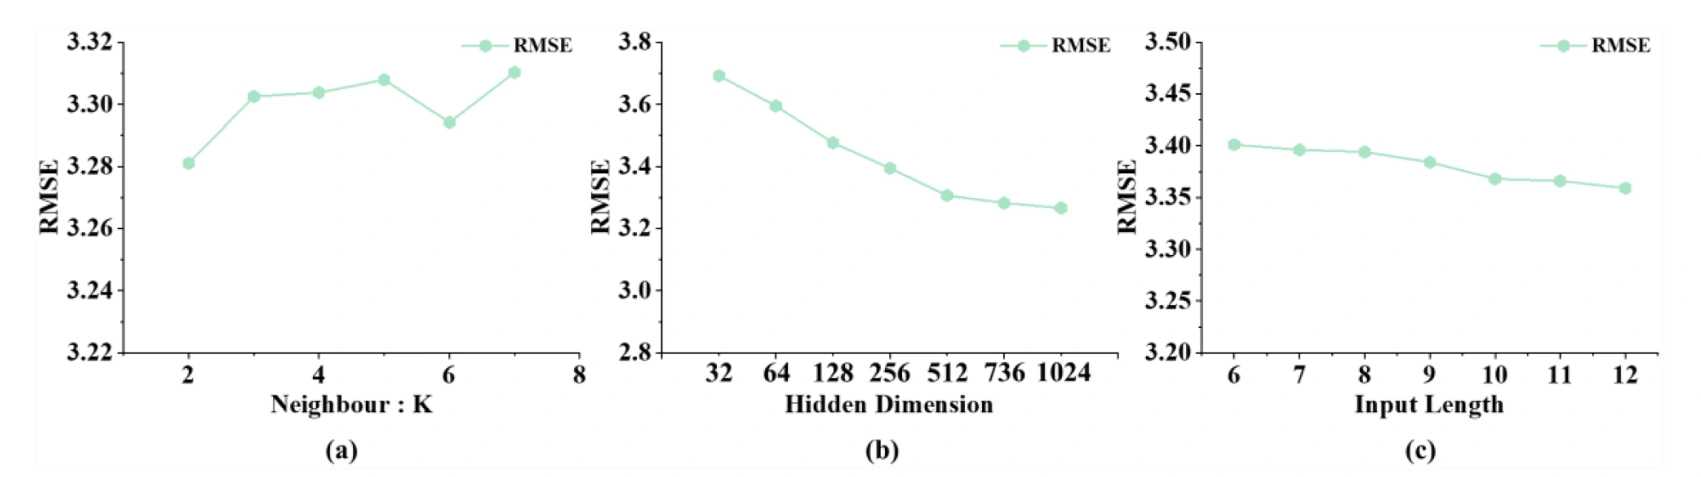
图 10|厦门的三个旋钮,各停在哪里?
(a)邻居数 K 从 2 到 7,纵轴 RMSE 的刻度在 3.22 到 3.32 之间,K=2 处于最低处,与正文选择一致;K 再增大,曲线有升有降。(b)隐藏维度从 32 到 1,024,整体下降,512 之后更平。(c)输入长度从 6 到 12,RMSE 缓缓下降,正文仍取 10。曲线上没有逐点数字,不能把眼睛读到的高度写成精确 RMSE。福州没有单独的这一组图。来源:原论文 Fig. 10。
空格子太多,比较前先切掉长尾
图 9 把稀疏画出来了。左图是厦门某一时刻的 OD 矩阵,正文关联到 8 点;大于 5、小于 5 和空值三种颜色里,空值和小流量占住大部分面积。右图按流量从高到低排列。插图的横轴延伸到大约 50 万,也就是全部 OD 对的量级,并标着“看前 10%”和“低流量占 90%”。主图把横轴放大到大约 5,000,另用一根线标出最终选中的 2,589 对。2,589/506,944=0.511%。图里标出的前 10% 若按全部 OD 对计算,大约是 5.1 万对,和这 2,589 对实验对象是两个数量。实验正文写的是:按日总流量从高到低排序,厦门取前 2,589 对,福州取前 4,342 对。
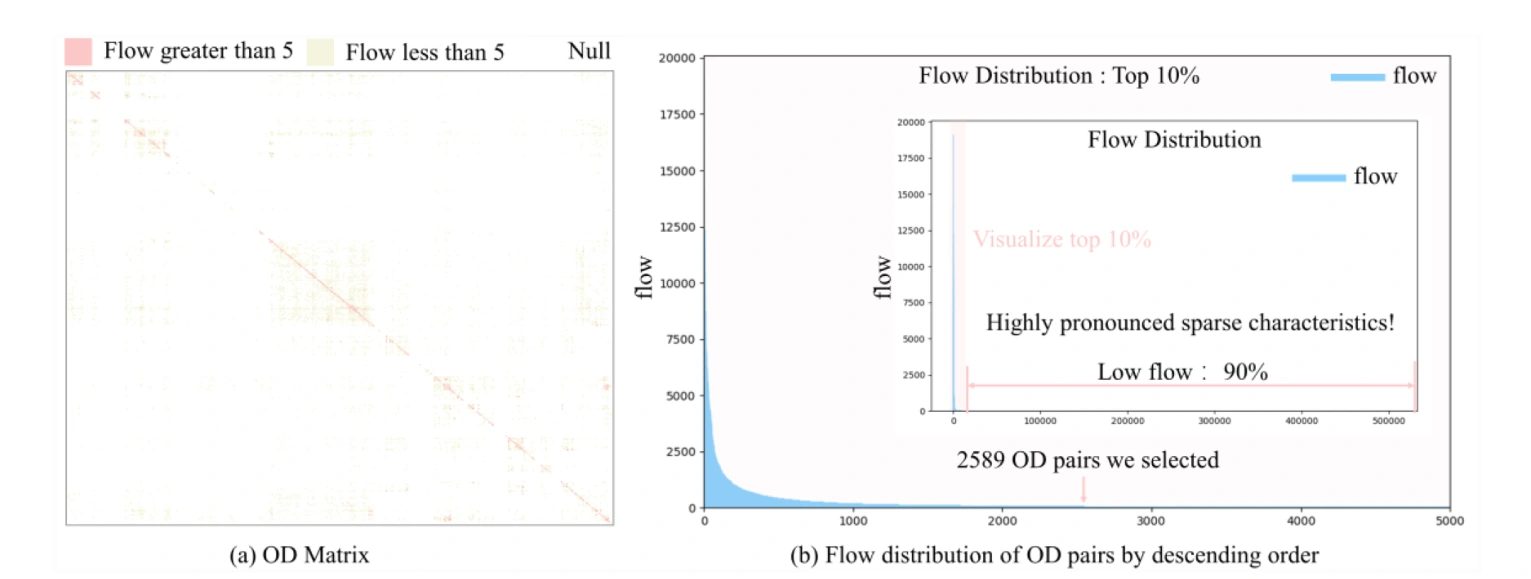
图 9|高流量实验对象在整张表的哪个位置?
(a)一张 OD 矩阵。粉色为流量大于 5,浅色为小于 5,空白为空值;非空值稀疏,对角一带相对密一些。正文把这类图联系到厦门 8 点,没有给出这一小时的总流量。(b)OD 对按流量降序排列。插图覆盖到大约 50 万对,标出前 10% 与 90% 低流量;主图放大到大约 5,000 对,并标出选中的 2,589 对。纵轴是流量,上限刻度到 20,000。来源:原论文 Fig. 9。
评价还有第二道筛子。RMSE 和 MAE 的公式都带条件:只在真实流量 x 大于 0 时把该项算进误差,分母仍写成 N×Z。正文同时说,低流量条目会把评价指标压得过低,所以比较时只用持续有观测的 OD 对。表 1 和表 2 就是在两市筛过的高流量集合上作出的。“持续有观测”没有再给一个独立的流量阈值。误差与 OD 流量同量纲。论文把原始记录称为 OD trips,没有声明 1 个流量单位等于 1 人次还是 1 条定位记录。
表 1、表 2 的 ± 按表题是方差,不是标准差。重复实验次数没有写出,所以这组方差不能换算成标准误。单步结果如下,斜线左侧为 RMSE,右侧为 MAE。
| 模型 | 厦门单步 | 福州单步 |
|---|---|---|
| ConvLSTM | 4.98±0.84 / 3.04±0.43 | 4.18±0.62 / 2.11±0.31 |
| ST-3DMDDN | 4.83±0.91 / 3.07±0.36 | 4.16±0.56 / 2.13±0.26 |
| ST-VGCN | 3.82±0.62 / 1.96±0.17 | 3.54±0.42 / 1.75±0.09 |
| ASTGCN | 3.64±0.53 / 1.71±0.08 | 3.36±0.31 / 1.64±0.12 |
| ST-GDN | 3.15±0.27 / 1.49±0.12 | 2.96±0.13 / 1.34±0.11 |
| GPECN | 3.18±0.18 / 1.43±0.10 | 2.82±0.10 / 1.32±0.08 |
厦门单步上,GPECN 的 RMSE 比 ST-GDN 高 0.03。0.03 相对 ST-GDN 的 3.15 是 0.95%。MAE 则从 1.49 降到 1.43,绝对差 0.06,相当于 1.49 的 4.0%。相对 ConvLSTM,RMSE 从 4.98 降到 3.18,降幅 1.80,相当于 4.98 的 36.1%;MAE 从 3.04 降到 1.43,降幅 1.61,相当于 3.04 的 53.0%。福州单步上,GPECN 的 RMSE 和 MAE 都低于表中五个基线:相对 ST-GDN,RMSE 低 0.14,相当于 2.96 的 4.7%;MAE 从 1.34 到 1.32,绝对差 0.02,相当于 1.5%。相对 ConvLSTM,福州 RMSE 从 4.18 到 2.82,相当于低 32.5%。
作者用第一步做配对 t 检验,因为第一步还没有把后面各步的误差叠进去。表 3 的 t 与“GPECN 减去对照”的误差方向一致:对照更差时 t 为负。厦门相对 ST-GDN 的 t=0.57、p=0.59,单步 RMSE 的差别没有达到 p<0.05。其余对照在两市的 p 都小于 0.05,例如厦门相对 ConvLSTM 的 t=−9.65、p=4.80×10⁻⁶,福州相对 ST-GDN 的 t=−3.68、p=5.05×10⁻³。检验次数未知,p 值只能按正文已给出的结果阅读。
预测长度还有 3、5、7 步。若一步等于 15 分钟,则大约是 45、75 和 105 分钟。论文没有对这三档再做显著性检验。厦门 RMSE,GPECN 与 ST-GDN 分别是 3 步 4.04±0.39 对 4.13±0.42,5 步 4.80±0.67 对 4.92±0.65,7 步 5.47±0.80 对 5.50±0.84。7 步的绝对差只剩 0.03,相当于 ST-GDN 的 0.55%。福州四档的 RMSE 都是 GPECN 更低,7 步为 4.20±0.21 对 ST-GDN 的 4.31±0.26,绝对差 0.11,相当于 2.6%。步数变长以后,两边的误差都上升,GPECN 的优势没有在长时距上放大。
时间省在图模型那边,没有省过普通卷积
效率只测了厦门。表 4 的单位是毫秒,batch size=8。± 在这张表的表题里没有写成方差或标准差,与表 1 的写法不同。单次推断指一次前向,单次优化指一次前向加一次反向。
| 模型 | 单次推断 | 单次优化 |
|---|---|---|
| ConvLSTM | 12.27±2.01 | 41.23±2.53 |
| ST-3DMDDN | 61.23±8.21 | 84.13±9.52 |
| ST-VGCN | 116.70±10.46 | 341.23±23.80 |
| ASTGCN | 485.64±32.11 | 702.70±47.19 |
| ST-GDN | 263.95±24.53 | 473.27±38.19 |
| GPECN | 96.58±9.28 | 248.02±16.48 |
以表内均值做除法:ASTGCN 的推断时间是 GPECN 的 5.03 倍,优化时间是 2.83 倍;ST-GDN 分别是 2.73 倍和 1.91 倍;ST-VGCN 分别是 1.21 倍和 1.38 倍。正文概括为,相对使用图注意力的非欧几里得模型,计算时间大约降到 1/2 至 1/4。这个区间盖住了 ST-GDN 的推断时间,也盖住了 ASTGCN 的优化时间;ASTGCN 的推断倍数更高,ST-VGCN 的推断倍数更低。ConvLSTM 的推断时间只有 GPECN 的 1/7.87,优化时间只有 1/6.02。表 5 的显著性与这组方向一致:相对两个卷积基线 t 为正,相对三个图模型 t 为负,p 都远小于 0.05。GPECN 显著快于图基线,也显著慢于 ConvLSTM 和 ST-3DMDDN。
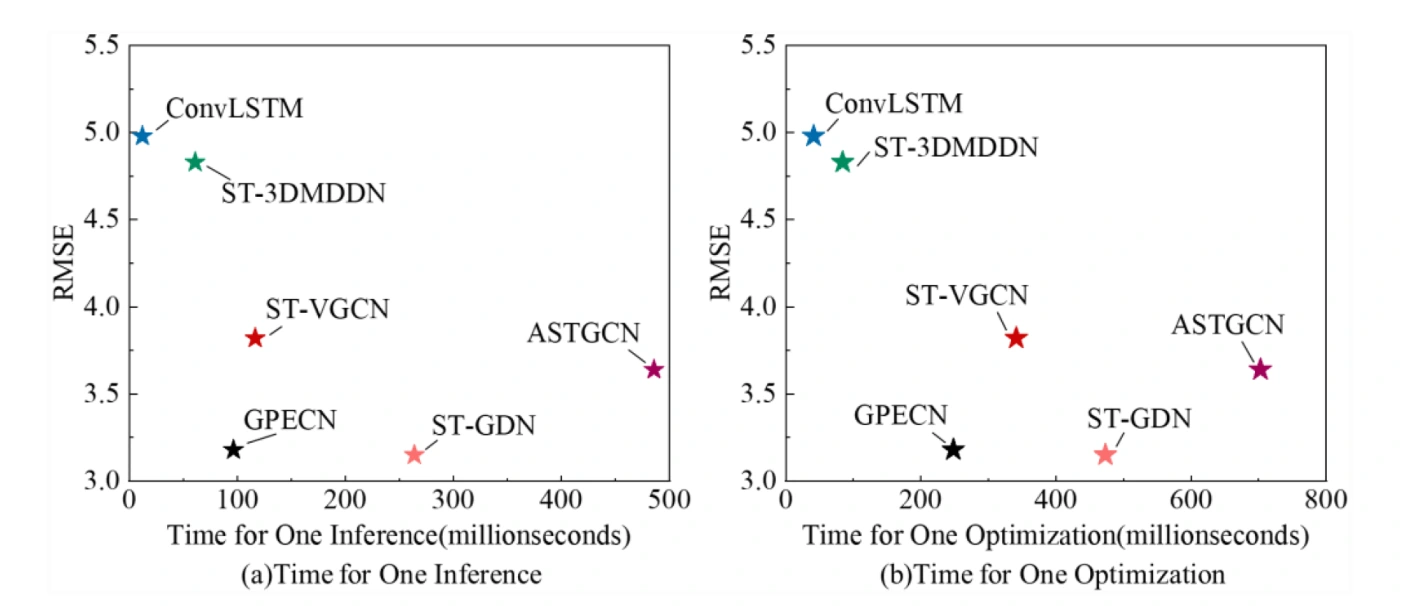
图 11|同一张图上,误差和时间各让出多少?
(a)横轴为单次推断时间,纵轴为 RMSE。(b)横轴改为单次优化时间。GPECN 在图模型的左下方:RMSE 与 ST-GDN 接近,时间更短。ConvLSTM 更靠近纵轴,RMSE 更高。横轴印着 millionseconds,点的位置却与表 4 的毫秒一致,例如 GPECN 约在 97、ASTGCN 约在 486。按百万秒阅读会和表 4 冲突,这里按毫秒理解。作者说 GPECN 最接近原点。两轴没有归一化,换一种单位比例,谁离原点更近会变。来源:原论文 Fig. 11。
作者又用合成数据看节点数变大以后的分叉。特征维为 64,每个节点连 4 个邻居,batch size 仍为 8,任务是单步预测。节点少时,格网模型和图模型的时间接近。正文写节点数超过 2,048 以后图模型代价急剧上升,到 8,192 个节点时图卷积无法完成。这组合成计时与厦门 2,589 个节点的表 4 不是同一次实验。
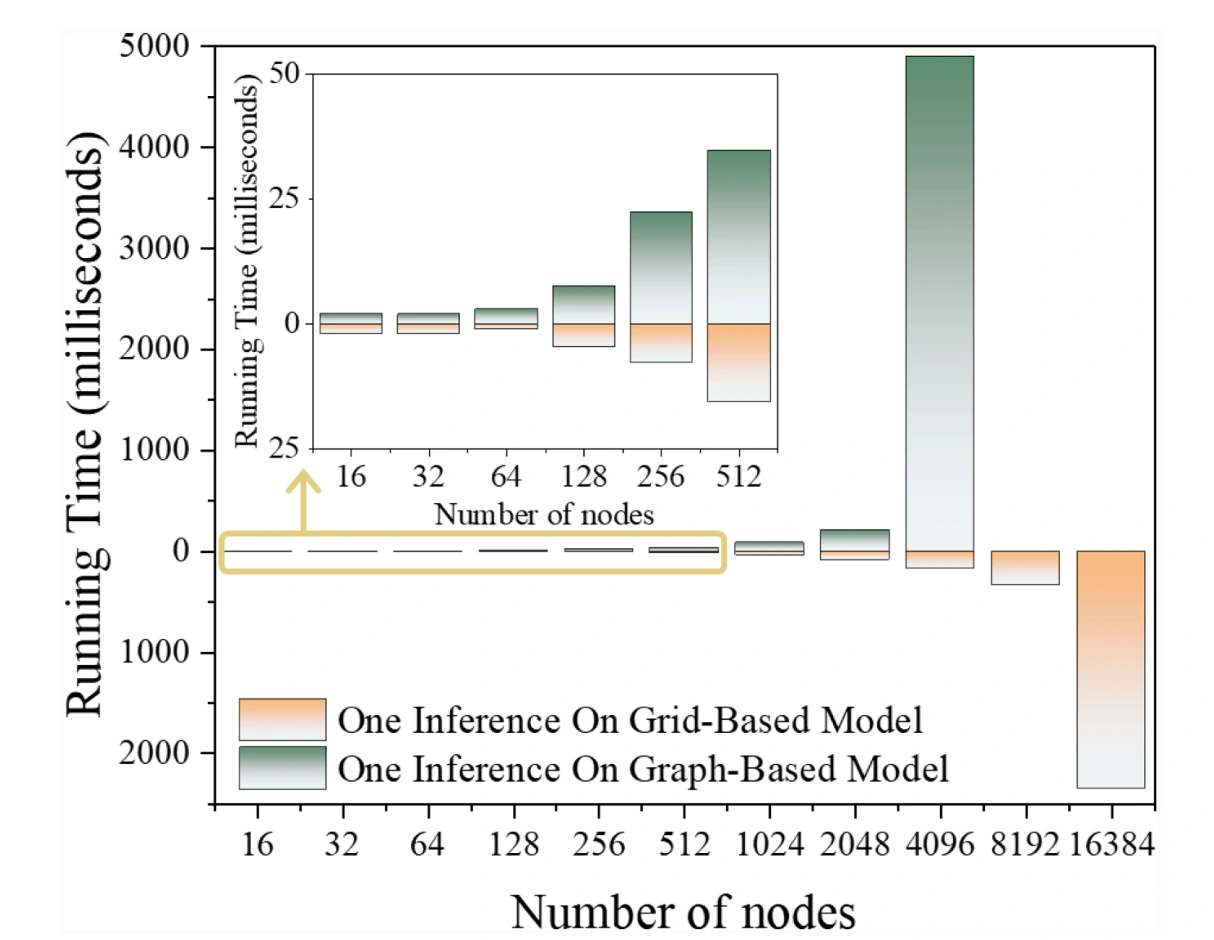
图 12|节点从 16 增到 16,384,两类模型在哪里分开?
无字母子图。主图横轴是节点数,纵轴是单次推断的毫秒数,上限刻度 5,000。橙色为格网模型,绿色为图模型。小节点的差别放大在左上角插图,插图纵轴大约从 −25 到 50,节点只到 512。主图里,图模型在 4,096 个节点时柱顶到达 5,000 的上沿;8,192 和 16,384 没有绿色柱。这两档的橙色柱画到零线以下,论文没有解释负的运行时间,因此不能从柱高读出格网模型在 8,192 以上的毫秒数。来源:原论文 Fig. 12。
误差留在波动大的方向上
空间图用 2023 年 6 月 19 日 8:15 这一个时刻,把 OD 对归到厦门 6 个区和福州 13 个区县,颜色是平均绝对误差,色标从 0 到 2.5。时间图各随机抽一条 OD 对,按小时把流量加总,画出 6 月 19 日至 25 日这一周。论文没有给出这两条 OD 的起点和终点编号,所以曲线高度只说明该条样本,不能当成全市总量。
正文的读法是:多数区对之间可以跟上,区内流量、厦门思明到海沧、福州闽侯到晋安相对较差,作者把原因归到流量波动大。福州的预测误差整体低于厦门,作者认为厦门岛外到岛内的地理结构影响了精度。这是对图 14 的解释,不是一次把“是否跨海”当作变量的对照实验。时间上,模型跟上了一天之中的早高峰和晚高峰,也维持到一周;高峰和午后骤降的时段,残差更明显。
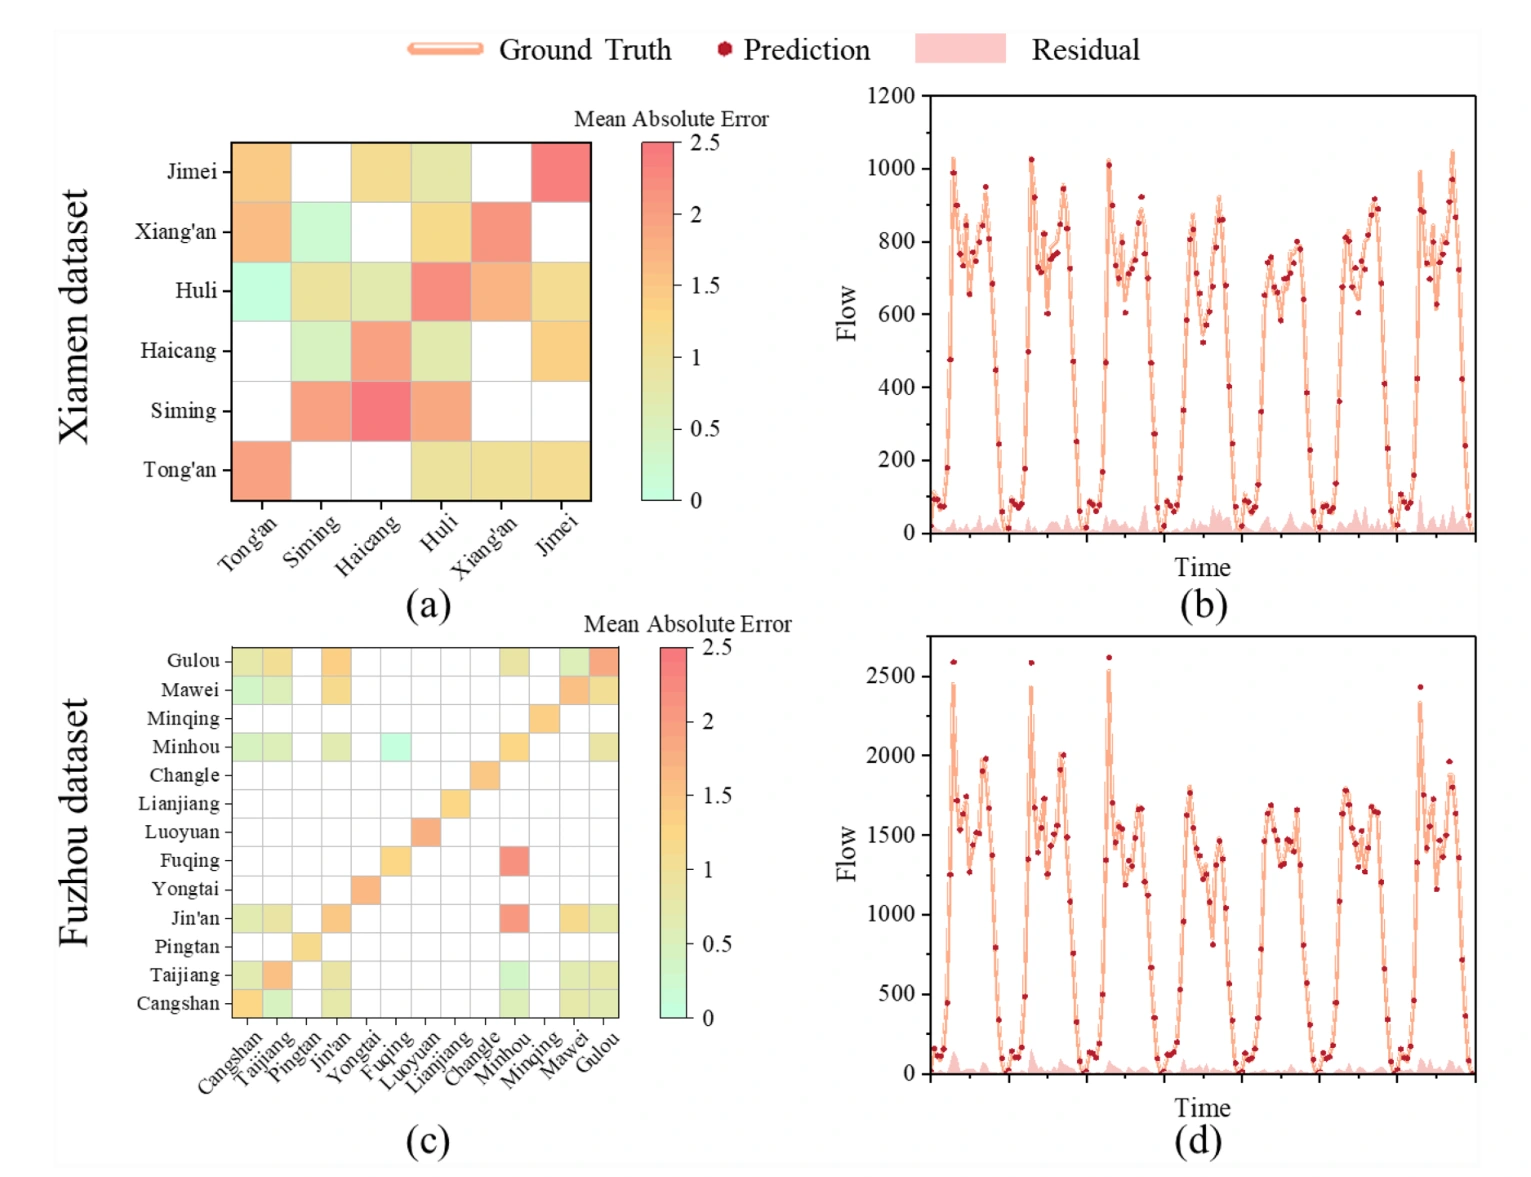
图 14|误差在区县之间、以及在一周之内怎样分布?
(a)厦门六个区之间的平均绝对误差,色标 0 到 2.5。(c)福州十三个区县的同样色标。两张热力图的行、列都是区县,格子是归并后的区对误差,不是村级 OD 本身。(b、d)各一条随机 OD 对在 6 月 19 日至 25 日的小时流量。橙线为真实值,红点为预测,粉色带为残差。厦门这条样本的纵轴上限约 1,200,福州约 2,500,上限是坐标范围。早、晚高流量反复出现,低谷接近横轴。来源:原论文 Fig. 14。
图 15 把这个解释量化到散点。横轴是真实流量的标准差,纵轴是 MAE。厦门 R²=0.8940,福州 R²=0.8560,与正文一致。点在低波动处堆在一起,波动变大后偏离拟合线的点增多。作者写,模型能解释大部分流量变化,波动大的地方更不可靠,并推测与密集区域的数据不平衡有关。图上的 R² 计算的是 MAE 和标准差这两列数的线性相关。要把它说成“解释了 89.4% 的流量”,还需要一次以流量为因变量的回归,正文没有给出那次回归。
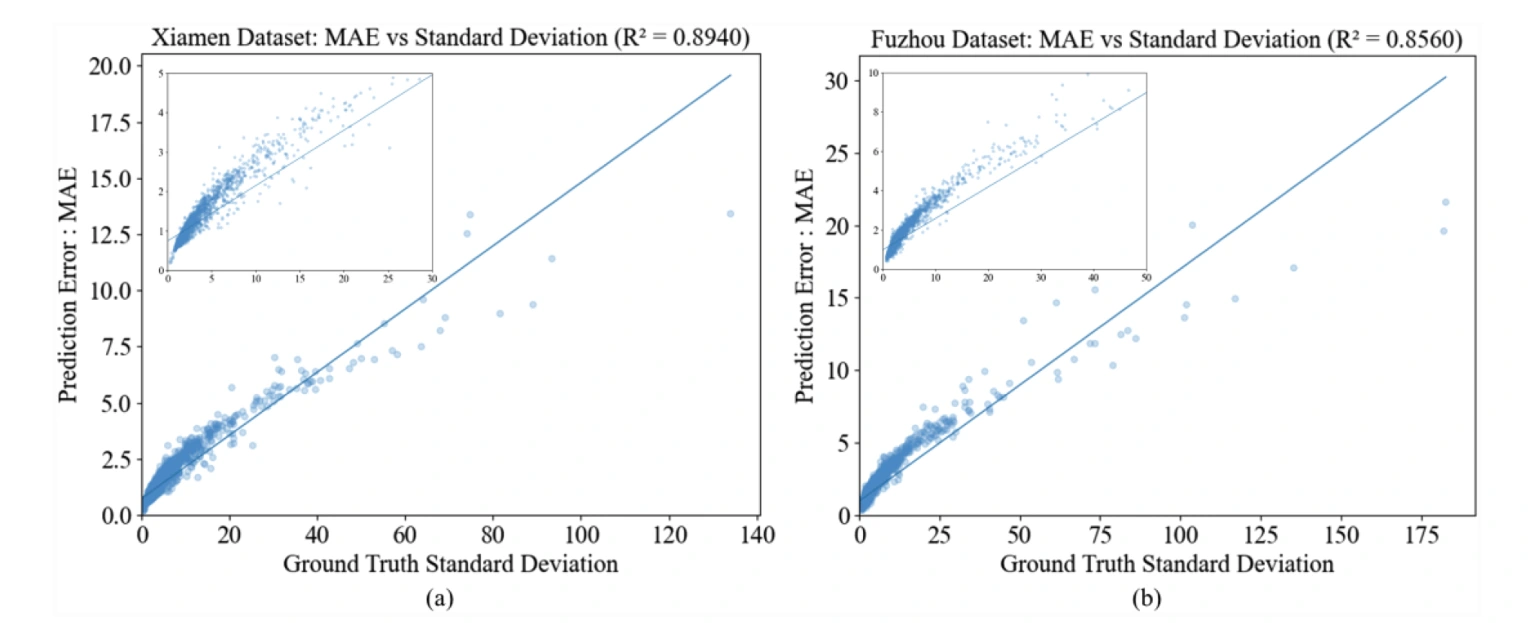
图 15|流量越不稳定的地方,绝对误差是否更大?
(a)厦门,标题给出 R²=0.8940。横轴为真实值标准差,到大约 140;纵轴为 MAE,到 20。插图放大低值区。(b)福州,R²=0.8560,横轴到大约 175,纵轴到 30,同样有低值插图。蓝线是散点的拟合线。高标准差一侧点数变少、偏离变大。来源:原论文 Fig. 15。
拿掉一块以后,变差的是精度还是时间
消融只用厦门的单步预测。表 6 的完整模型与表 1、表 4 的 GPECN 均值一致:RMSE 3.18,MAE 1.43,优化 248.02±16.48 毫秒,推断 96.58±9.28 毫秒。
把建图用的 Wasserstein 距离换成余弦距离之后,RMSE 升到 4.55,MAE 升到 2.29。相对完整模型,RMSE 增加 1.37,相当于 3.18 的 43.1%。推断时间几乎没变,是 98.70 毫秒。这一行说明结构对齐的代价主要买的是精度。
去掉欧几里得映射、改为在原虚拟图上直接做图注意力时,RMSE 为 3.66,MAE 为 1.95,优化时间 692.57 毫秒,推断 261.91 毫秒。优化时间是完整模型的 2.79 倍,RMSE 也高 0.48,相当于 3.18 的 15.1%。在这张表里,格子映射同时缩短了时间和误差,而不是只拿精度去换速度。它比较的是作者实现的这一版图注意力,不能推广成所有图模型都比 GPECN 更慢且更差;表 1 里的 ST-GDN 单步 RMSE 仍然略低。
前向次数 F=1、4、7、10 的 RMSE 分别是 3.70、3.39、3.18、3.16,推断时间分别是 18.04、56.56、96.58、138.22 毫秒。从 F=7 到 F=10,RMSE 只降 0.02,相当于 3.18 的 0.63%,推断时间变为 1.43 倍。半径已经罩住大多数邻居以后,再加次数,买到的误差下降很小。
把 OD 对从 2,589 增到 5,178 以后,RMSE 降到 1.83,MAE 降到 0.82,优化时间升到 779.11 毫秒。5,178 仍只是 506,944 的 1.02%。作者写明,这一子集里零值比例高,看起来更好的误差有一部分来自稀疏,而不是模型真的更会预测小流量。结合“只在 x>0 时把误差加进分子、分母仍写 N×Z”的公式,零值越多,平均误差越容易被摊薄。因此 1.83 不能用来声称长尾 OD 已经被预测准。
这些数字能说到哪一步
GPECN 支持的结论是:在两个城市、2023 年 4 月至 6 月、村级单元、并且只保留日总流量最高的那一小段 OD 对时,把结构相似邻居种进格子,可以让卷积的单步误差接近 ST-GDN,并使 2,589 个节点上的单次推断明显短于 ASTGCN 和 ST-GDN。它同时表明,这种速度仍长于 ConvLSTM,厦门单步 RMSE 也没有显著低于 ST-GDN。
作者自己列出三件还没做到的事。二维格子的一阶邻域最多放八个邻居。模型只用历史 OD,没有处理突发事件带来的非平稳。3×3 的核在更大的城市上可能要把 F 加得很多,作者建议以后用空洞卷积减少次数。除此以外,正文没有报告跨城市训练,也没有报告相似图是只用预测之前的日期估计,还是用了全部 91 天的曲线。映射被写成离线、给定 A 以后确定;若 A 含有待预测时段的形状,邻居定义就已经看见了未来的曲线形态。
预测误差也还不是出行机制。模型没有使用票价、路网或土地利用,图 15 里的相关不能单独说明人为什么在波动大的 OD 上更难被预测。区县热力图是村级结果再聚合后的展示,格内颜色不能回推某一个村的误差。
一句话总结
在厦门 2,589 条和福州 4,342 条高流量村级 OD 对上,GPECN 把结构相似邻居放进规则格子,在真实流量大于 0 的位置得到与最强图基线同一量级的误差,推断时间短于这些图基线、长于普通卷积。全部村级组合摊开以后,厦门平均每个时空位置 0.0119 条记录,福州 0.000862 条;这张全表和个人出行选择都不在上述误差的分母里。
核心来源
- Sustainable Cities and Society 正式版,卷 149,文章编号 107720。题目、作者、单位、收稿与在线日期以 PDF 文首为准;正式题中 euclidean 为小写。
- 正文图 1 至图 15,表 1 至表 6。文中没有列出补充材料或附录编号。数据声明为向作者索取,没有公开数据集入口,也没有写采集渠道。
- 福州大学数字中国研究院(福建)的发表新闻,用于核对题目写法,以及吴升、王林柏芝、王培晓三个人的中文姓名和该页给出的身份。
作者介绍
- Sheng Wu:署名福州大学数字中国研究院(福建)。贡献包括初稿、方法、数据整理和概念构思。学院新闻称他为教授,并担任王林柏芝的指导教师。
- Linbaizhi Wang:同一学院。学院新闻称王林柏芝为硕士研究生。贡献包括初稿、方法、形式分析、数据整理和概念构思。
- Peixiao Wang:通讯作者。署名中国科学院地理科学与资源研究所、论文所写的地理信息科学与技术国家重点实验室,以及中国科学院大学资源与环境学院,邮箱 wpx@lreis.ac.cn。学院新闻称其为助理研究员。贡献包括写作、可视化、指导、项目管理、方法和概念构思。
- Hengcai Zhang:同一地理所与中国科学院大学。贡献包括写作、方法和概念构思。
- Shifen Cheng:同一地理所与中国科学院大学。贡献包括写作和方法。
- Xin Fu:署名济南大学水利与环境学院。贡献包括写作和经费获取。论文没有给出可核对的中文姓名,这里保留署名。
- Junhao Guo:署名福州大学数字中国研究院(福建)。贡献包括审阅、软件和方法。
- Feng Lu:署名地理所与中国科学院大学。贡献包括审阅、项目管理和方法。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
相似图若用整段 91 天的曲线来连接 OD 对,待预测那几天的峰谷会先进入邻居定义。2023 年 4 月 5 日清明、5 月 1 日劳动节都落在样本期内,论文没有按节假日分开报 RMSE。一个与表 3 同口径的检验是:只用节前的时间窗估计 Wasserstein 近邻和半径 7 的覆盖率,再预测节假日的 15 分钟流量,分母仍限于真实流量大于 0 的记录。若覆盖率从厦门的 2,366/2,589 明显下降,或与 ST-GDN 的 RMSE 差不再落在 p=0.59 那种波动里,现在的“精度相当”就主要属于平稳周,而不是假期周。
另一个可以单独报数的切分是跨海。图 14 和作者解释都指向思明—海沧、以及厦门岛外到岛内更难,但表 1 的 3.18 是 2,589 条混在一起的单步 RMSE。若把这 2,589 条按起终点是否分处岛内外拆开,各自仍只在 x>0 的位置上计算 RMSE,才能看出 0.03 那种与 ST-GDN 的差距是来自少数跨海 OD,还是全市高流量 OD 都如此。在拆开之前,岛内外结构还是一张热力图上的阅读,不是已经测得的效应量。全量 506,944 对也还没有进入这张成绩单:扩到 5,178 对时 RMSE 降到 1.83,作者已经提醒零值会把误差摊薄。城市级产品若要覆盖长尾,需要先固定零值是否进入分母,再按流量分位报告误差,而不是沿用 1.83。