同一个街道,上班的人住得近,不等于住在这里的人上班也近?
论文名片|Yixi Liu、Jichang Dong、Zhou He、Yan Song、Xiuting Li,Measuring urban bilateral job-housing balance based on big data: A case study of multiple cities in China,Cities,2026,173:106960,2026年3月14日在线发表。DOI:10.1016/j.cities.2026.106960。本文依据这一正式发表版解读。
设想一条北京的街道。白天进来上班的人,有的住在附近,有的从很远的地方来。夜里留在这里的居民,第二天又可能去另一个就业集中的地方。只数这条街上有多少岗位、多少住房,两拨人仍可能在对向绕路。
这项研究用2021年10月的手机数据,在北京、上海、西安、武汉、沈阳、深圳、厦门的653个街道上,把职住关系拆成上班一侧和居住一侧。直线距离短于5公里的通勤,在公式里把距离记为0。七座城市由此分成四类。同一类设施或人口比例,与两侧指标的关联并不相同。这些是街道之间的统计关联。论文没有追踪同一个人搬家或换工作,也没有检验某项政策已经缩短了通勤。
先说结论
- 新指标按通勤人数和街道间直线距离计算。示意图里,10名上班者有5人通勤0公里、3人6公里、2人10公里,印出的就业侧平衡比是0.2875;按人数算,0公里通勤占5/10。
- 北京、上海、西安的高就业侧平衡比总体偏外围,高居住侧平衡比集中在中心。武汉、沈阳、深圳、厦门两侧的高值区更分散,空间格局也更接近。
- 层次聚类把七座城市分成四类:就业主导且总体较平衡的北京,两侧接近的上海、深圳、厦门,居住主导且总体较平衡的西安、武汉,以及总体偏低的沈阳。分类用的是各市街道几何平均的中位数,以及就业侧高于居住侧的街道比例。
- 653个街道放在一起时,离中心更远、第三产业企业占比更高,与两侧指标都为正关联。按城市类型分开以后,北京的距离梯度不再显著,交通、教育和收入的方向也随类型改变。
- 指标只含直线距离和流量。通勤时间、方式、拥堵、可靠性和费用都没有进入公式。回归系数也不是已经证实的因果效应。
岗位数除以住房数,为什么还是不知道谁在绕路?
职住平衡(job-housing balance)通常指一个范围内岗位数量和住房数量的匹配。常见的职住比,是研究范围内岗位数除以居住人数。空间错位指数比较的是各单元人口份额和就业份额的差。自足率则分两侧:基于工作地的自足率,分母是该区上班者总数,分子是住在本地的上班者;基于居住地的自足率,分母是该区居民总数,分子是在本地工作的居民。后两个比例已经分了上班和居住,仍然不看这些人走出多远,也不区分是向外通勤还是向内通勤。
论文把5公里写成幸福通勤(happy commuting)的距离门槛,依据是作者引用的Dora等2000年世界卫生组织相关论述:成年人可接受的通勤距离小于5公里。这是一个外部标准,不是从这七座城市的数据里估计出来的拐点。论文还转引了两组成果,它们都不是653个街道自己算出来的:澳大利亚统计局资料中,2016年住在5公里以内的通勤者不到25%,2021年能步行或骑车上班的人口只有3.2%,工作日通勤人口超过900万;中国住建部门监测实验室、中国城市规划设计研究院和百度地图2023年的报告则写,45个主要城市2022年能被算作幸福通勤者的比例只有50%,比2021年低1个百分点,比2020年低3个百分点。
作者认为,要比较多座城市,并判断失衡来自上班一侧还是居住一侧,就得同时用上通勤方向、人数和这个5公里门槛。
七座城市的通勤,记的是哪一段时间和哪些街道?
七座城市被选为各自城市群的核心:京津冀的北京、长三角的上海、关中平原的西安、长江中游的武汉、辽中南的沈阳、珠三角的深圳、海峡西岸的厦门。样本因此集中在城镇化程度高、交通机动化程度高的核心城市,不能直接当成全国城市的随机样本。
通勤来自2021年10月在各市停留超过10天的手机定位,经中国房地产指数系统(CREIS)获取。CREIS由中指控股建立,手机数据合作方是中国联通,兴趣点合作方是高德地图。工作人口取工作日白天9:00–12:00和13:00–18:00,居住人口取21:00至次日7:00。数据里包含通勤方向、通勤人数和人口特征。兴趣点包括公交与地铁站、学校、公园、医院和商业设施。
分析单位是街道(sub-district,论文也称jiedao)。论文写,七座城市653个街道上有近15万套多源数据。因缺数据,沈阳Xinmin City街道、上海Caojing街道和Chenjia街道没有进入讨论。设备活跃程度和职住一致性做过筛选,论文没有给出具体阈值;筛选后每个保留街道都有非零记录。作者没有再删掉人数很少的外围街道,理由是那样做会让指标归一化偏向中心。
后文回归的街道数可以加总核对:北京232,上海、深圳、厦门合计212,西安、武汉合计127,沈阳82。四组合计正好653。212已经去掉上海那两个缺数据街道,82也已经去掉沈阳那个缺数据街道。近15万套是多源记录的规模,分母不是15万名通勤者,论文也没有给出每座城市的通勤人数。
街道之间的距离用欧氏距离,也就是地图上的直线距离,不是沿路里程,也不是花费的时间。作者在结论里写明,研究关注的是正式就业者,出租车司机、自由职业者等没有纳入,住房价格、面积和配套也没有进入指标。被排除的人数没有报告。
0.2875为什么和“十个人里有五个住得很近”是两个数?
对在街道i上班的人,就业侧平衡比(Job-Balance Ratio,JBR)写成:
JBRᵢ = 1 −(∑ⱼ 人数ᵢⱼ × 距离ᵢⱼ)÷(上班总人数ᵢ × 平均距离ᵢ)
人数ᵢⱼ是在i上班、住在j的人数。距离ᵢⱼ是两个街道的直线距离。上班总人数ᵢ是在i上班的人。平均距离ᵢ是论文所称、在i上班者的平均通勤距离。直线距离小于5公里时,公式里的距离ᵢⱼ记为0。
对住在街道j的人,居住侧平衡比(Residence-Balance Ratio,RBR)用同一结构,只是把视角换成居住地:分子累加的是住在这里、去各个街道上班的人数和距离,分母是这里的居民总数乘以他们的平均通勤距离。小于5公里同样记为0。
两个比值都希望落在0到1之间,数值高表示论文定义下的职住更平衡。极端情形是:上班者全部住在本街道,分母会变成0,作者规定此时JBR记为1;上班者全部以同样的远距离住在别处,比值记为0。居住侧同理。因为同一街道的上班人数和居住人数本来就不同,JBR和RBR一般不相等。
图1把这套算法做成了一个可手算的例子。
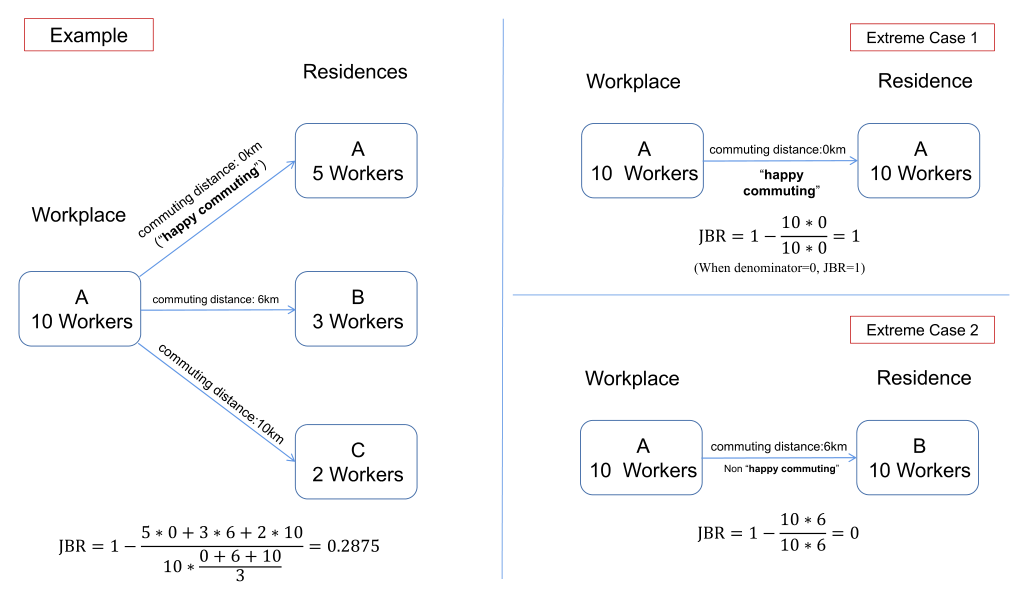
图 1|10名上班者分住三处时,就业侧平衡比如何落到0.2875?
(示例)工作地A有10名上班者:5人住在A,直线距离0公里,标成幸福通勤;3人住在B,6公里;2人住在C,10公里。图中公式是1减去(5×0+3×6+2×10),再除以10乘以(0+6+10)÷3,结果0.2875。分子是38人·公里。分母用的是10人乘这三段距离的不加人数权重的平均,三段平均是16/3公里,分母为160/3,38÷(160/3)=0.7125,1−0.7125=0.2875。(极端情形1)10名上班者全部以0公里留在居住地A。分母为0时,图注规定JBR记为1。(极端情形2)10人全部通勤6公里,1−(10×6)÷(10×6)=0。来源:原论文 Fig. 1。
同一张示例里,0公里通勤的人数占比是5/10。印出来的JBR是0.2875。后文3.4节又把JBR说成住在5公里以内的上班者比例,RBR说成在5公里以内工作的居民比例。按图1的印出公式,这两个说法对不上:人数比例是0.5,平衡比是0.2875。
差别来自分母里的平均距离。图1对0、6、10公里三条连线各算一次,再除以3,没有按5人、3人、2人加权。若改用按人数加权的平均距离,38人·公里除以10人等于3.8公里,分子38再除以10×3.8仍是1,JBR会变成0。正文把平均距离写成在该街道上班者的平均通勤距离,这句话更接近按人加权。论文没有说明653个街道实际编码时用的是哪一种平均。因此,后文地图和回归使用的是作者算出的JBR、RBR;不能把它们直接读成5公里以内的人数占比,除非平均距离的算法与图1不同、且另外满足人数比例的条件。论文没有给出这张对照。
居住侧的示例用另一组人数,避免把两个指标看成同一个数。
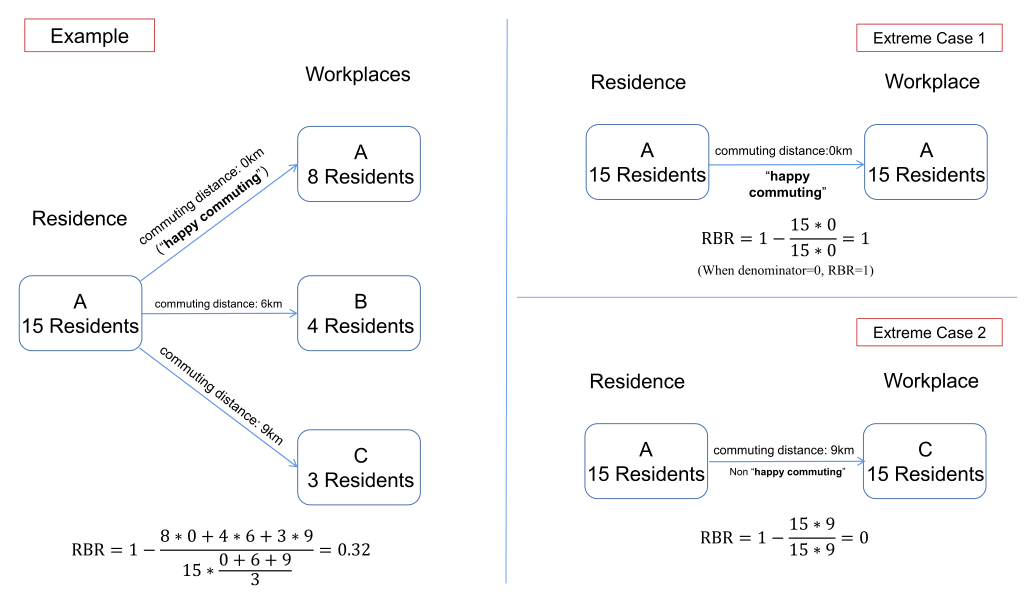
图 2|15名居民分去三处上班时,居住侧平衡比如何落到0.32?
(示例)居住地A有15名居民:8人在A上班,0公里;4人在B上班,6公里;3人在C上班,9公里。图中结果是1−(8×0+4×6+3×9)÷[15×(0+6+9)÷3]=0.32。分子51人·公里,分母15×5=75,51/75=0.68。(极端情形1)15名居民全部以0公里在本地上班,分母为0时RBR记为1。(极端情形2)15人全部通勤9公里,RBR记为0。来源:原论文 Fig. 2。
这里0公里通勤的居民是8/15,约0.533,印出的RBR是0.32。分母同样是三段距离的不加人数权重的平均。
还要守住距离本身的含义。5公里是街道之间的直线距离门槛,不是路上用时,也不是5公里骑行一定比公交更愉快。4.9公里和同街道的0公里在分子里都会变成0;5.1公里则按实际直线距离进入分子。作者也写明,JBR和RBR目前只处理距离和流量,不包含出行时间、方式、拥堵、到达可靠性和费用。它们补充既有指标,不能替代那些维度。
中心和外围,两侧地图为什么对不上?
把653个街道的两个比值画出来,看的是空间位置,不是城市只剩一个平均数。绿色图是JBR,橙红色图是RBR,颜色越深比值越高。图例按城市分别分段,所以同一深浅不能跨城市直接比大小。论文没有在正文列出每座城市的JBR或RBR均值。
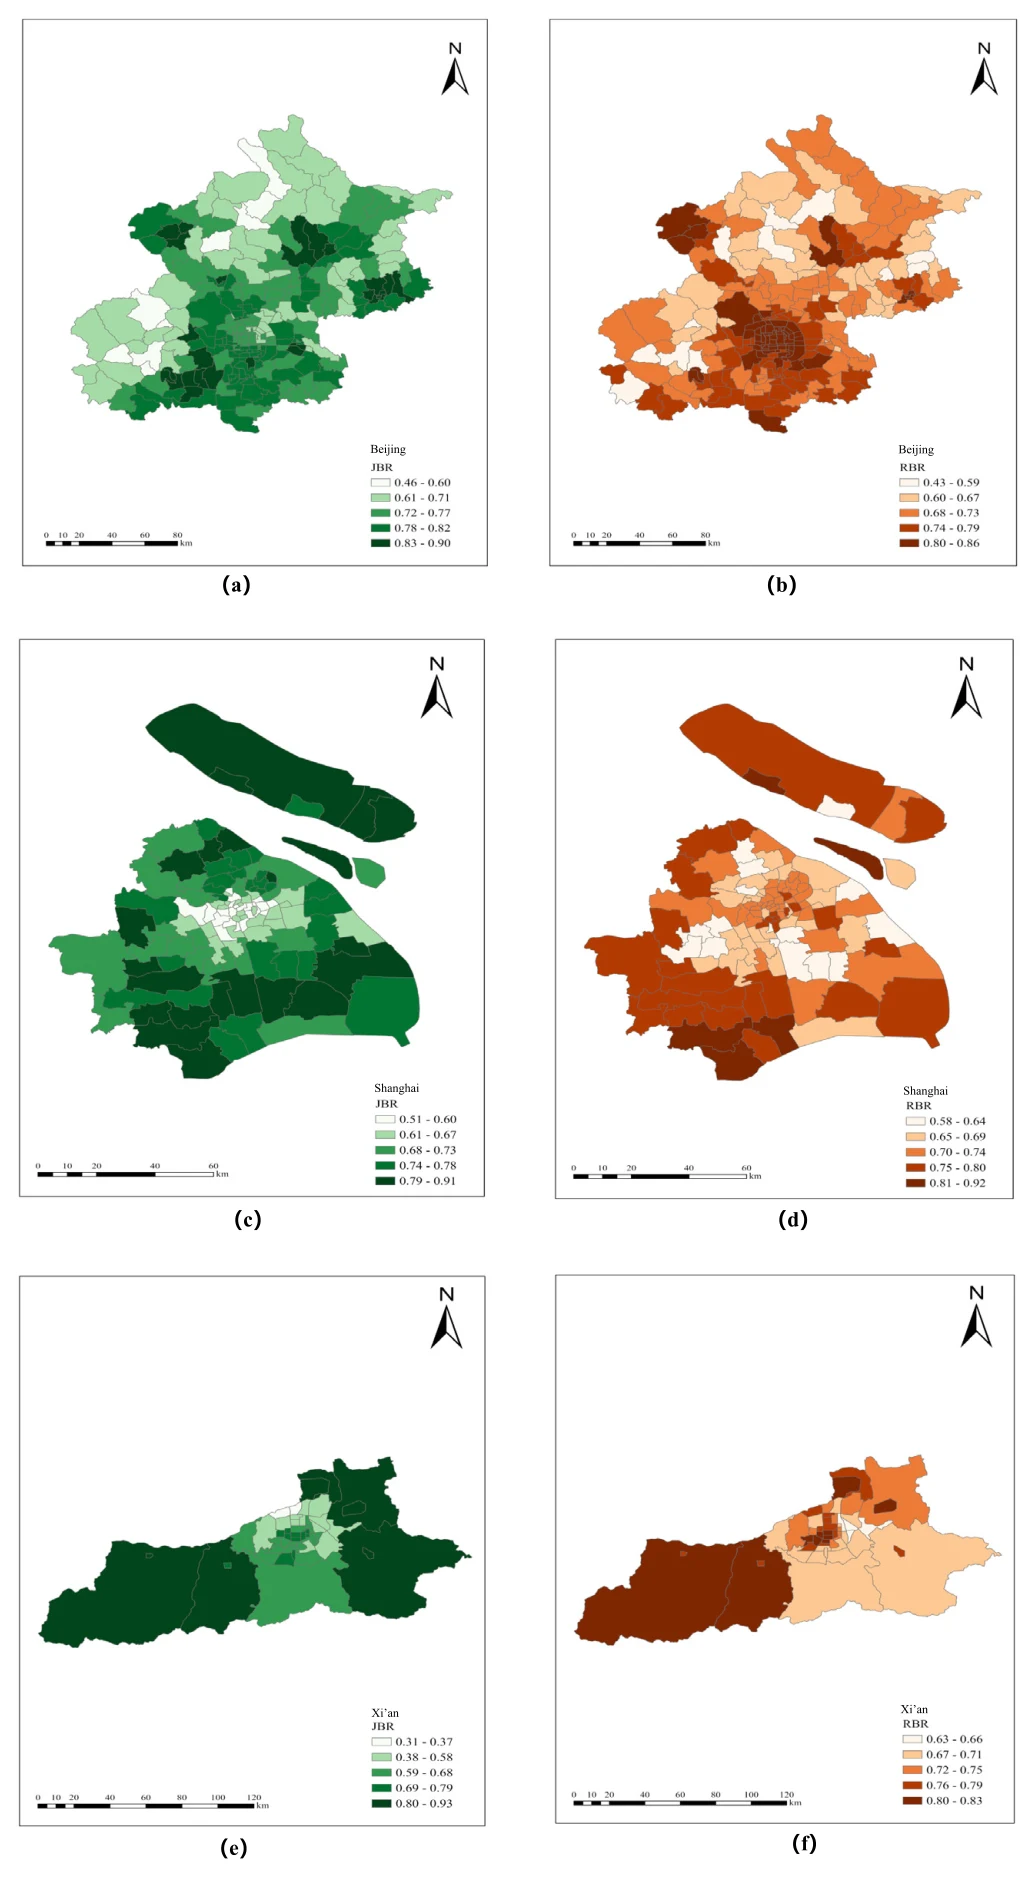
图 3|北京、上海、西安的高就业侧平衡比和高居住侧平衡比,是否落在城市的同一圈层?
(a)北京各街道JBR,绿色越深越高,深色更多出现在外围。(b)北京各街道RBR,深色更集中在中心一带。(c)上海JBR,外围深色更多。(d)上海RBR,中心一侧更深。(e)西安JBR,大片外围为深绿色。(f)西安RBR,深色偏向中心,外围更浅。三座城市都配有指北针和公里比例尺。来源:原论文 Fig. 3。
正文对这三座城市的概括是同一句:JBR较高的街道总体在外围,RBR较高的街道集中在中心。这和一种熟悉的流向相容:住在中心的人更容易在附近工作,而中心岗位上的上班者有更多人住得远。地图本身只有两侧比值的高低,没有画出从哪条街道到哪条街道的流量,所以不能单独证明潮汐通勤的方向和人数。
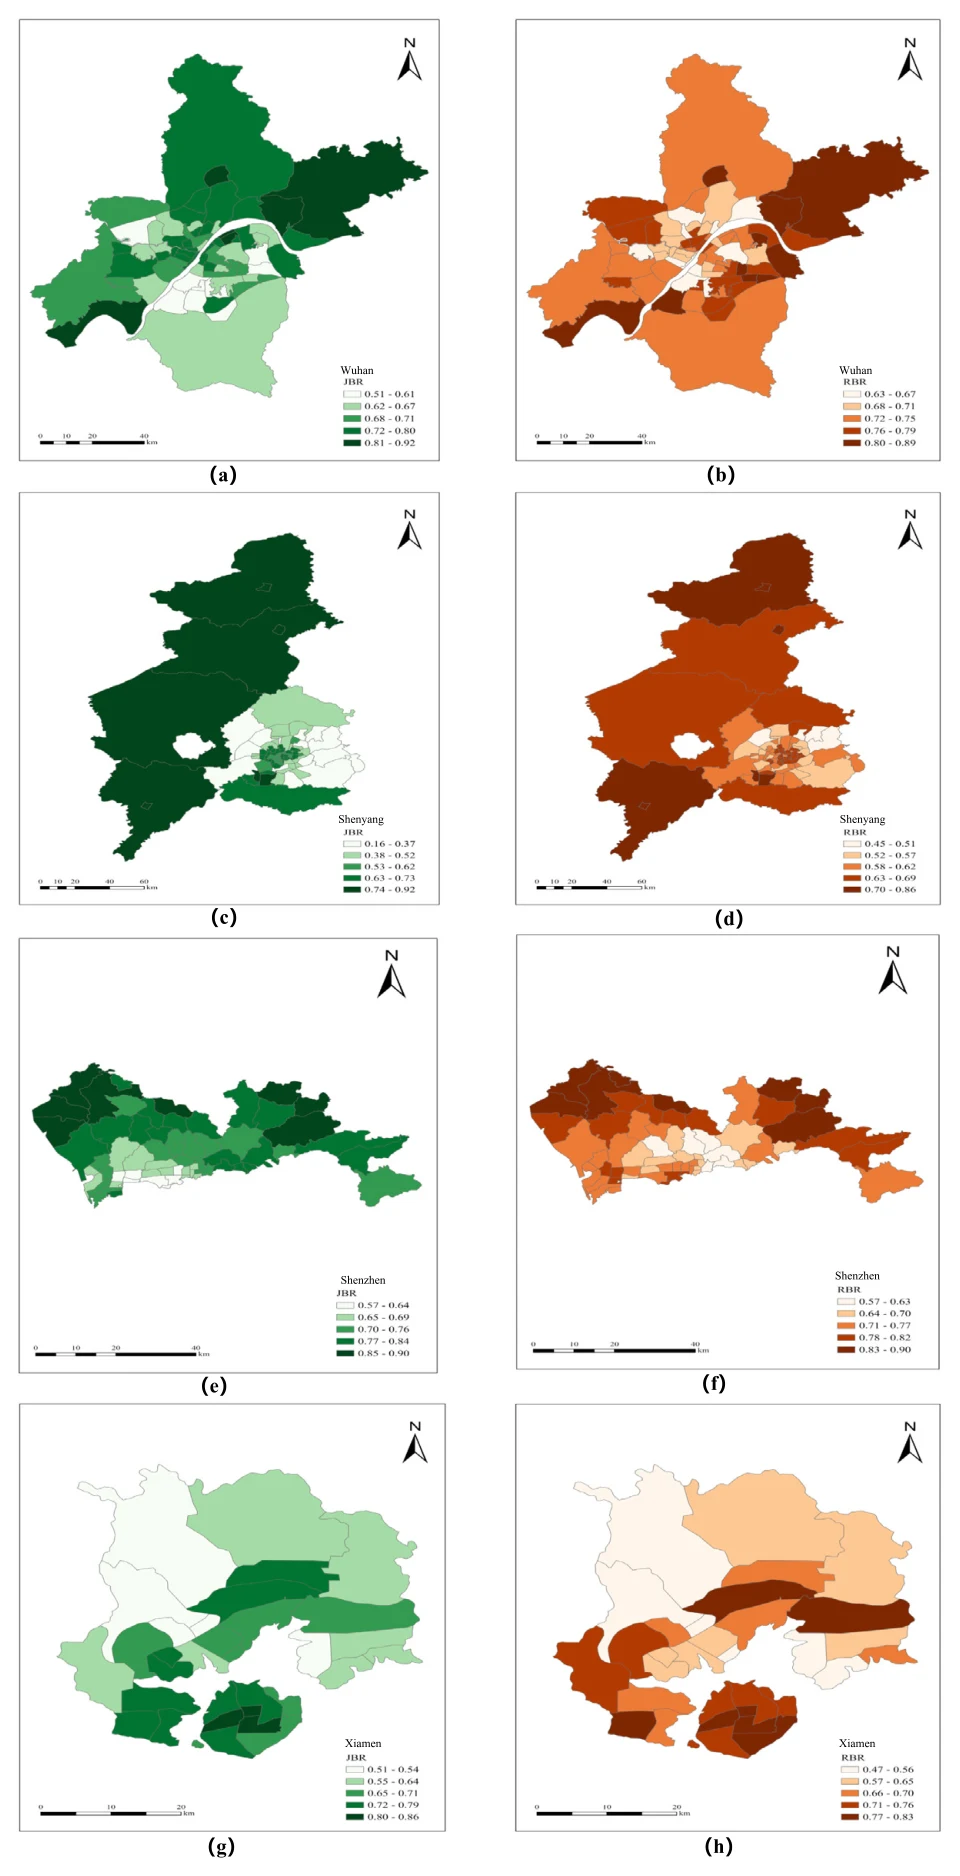
图 4|武汉、沈阳、深圳、厦门的两侧高值区,是否仍然分成中心和外围?
(a)武汉JBR。(b)武汉RBR。两侧深色都较分散,中心有浅色街道。(c)沈阳JBR。(d)沈阳RBR。两侧都有成片深色,也有成片浅色,位置大体相随。(e)深圳JBR。(f)深圳RBR。高值区沿建成区散开,而不是收成单一中心。(g)厦门JBR。(h)厦门RBR。岛内外都有深色街道,两侧格局接近。来源:原论文 Fig. 4。
论文把这四座城市和前三座对照:JBR和RBR的高值都更分散,两侧的空间格局也更一致。分散不等于数值更高。沈阳在下一张分类图里处于总体平衡偏低的位置,即使图4里局部街道颜色很深。
四类城市,分的是几何平均的中位数和哪一侧更高?
单看地图还不方便把七座城市归类。作者为每个街道计算两侧比值的几何平均,也就是√(JBR×RBR)。几何平均要求两侧同时高:一侧接近0,另一侧即使接近1,乘积仍接近0。再取一座城市所有街道这个几何平均的中位数,作为横轴。横轴越靠近1,作者认为这座城市的总体职住平衡越好。
纵轴是该市JBR高于RBR的街道所占比例,分母是街道数,不是人数。越靠近50%,两侧谁更高就越没有系统性偏向。论文写,这个比例靠近50%,表示市内JBR和RBR的差异较小。
七个点再用层次聚类划分。论文只写用Python完成聚类,没有报告距离如何定义、用哪一种连接法,也没有树状图。能够核对的是图5和正文给出的四类名单。
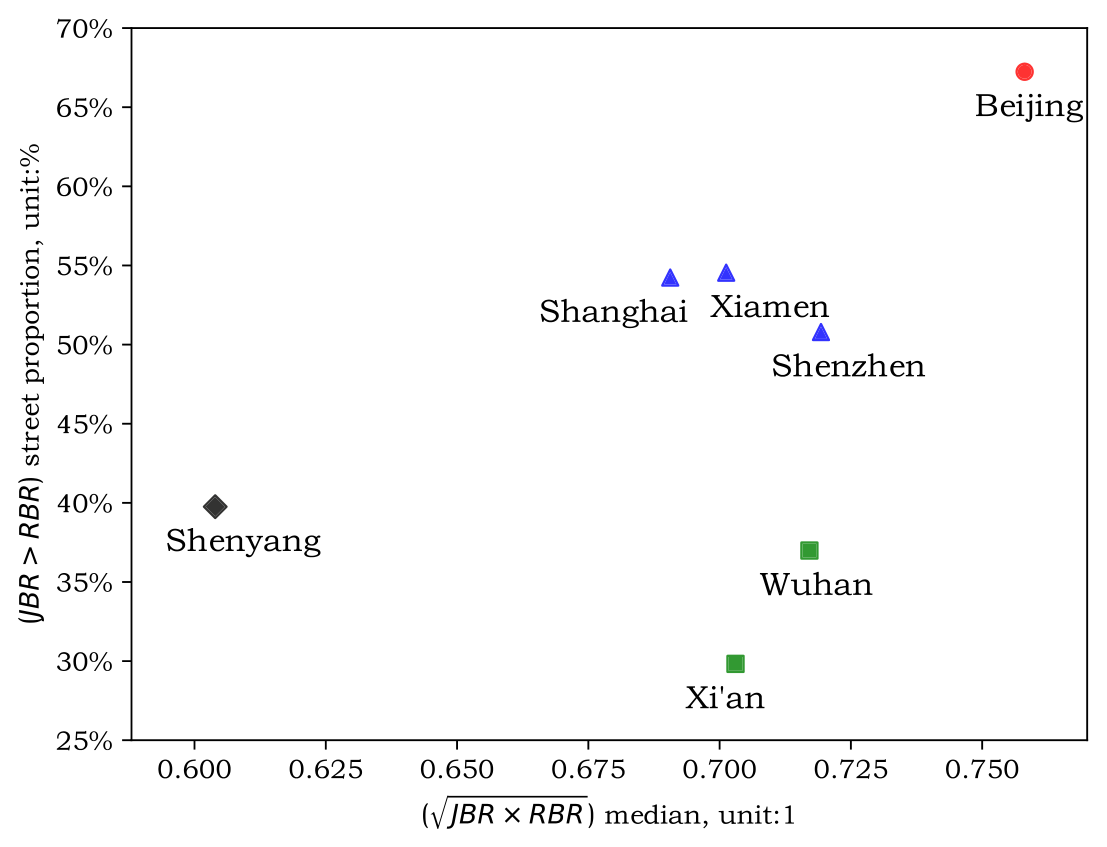
图 5|七座城市在总体平衡和两侧差值上落在哪四个位置?
图中只有一个面板。横轴是各市街道√(JBR×RBR)的中位数,刻度从0.600到0.750。纵轴是JBR高于RBR的街道比例,刻度从25%到70%。红点北京在0.750右侧、65%与70%之间。蓝色三角的上海和厦门在50%与55%之间、横轴0.675与0.700之间;深圳略高于50%,横轴略超过0.700。绿色方块的武汉在35%与40%之间、横轴略超过0.700;西安贴着30%,横轴贴着0.700。灰色菱形沈阳在横轴0.600右侧不远、纵轴贴着40%。这些是对照刻度的读图,论文没有另附七个点的精确坐标。来源:原论文 Fig. 5。
四类名称和成员是:
就业主导且总体较平衡(Job-Centric with Overall Balance)只有北京。几何平均的中位数高,同时JBR高于RBR的街道比例也高。作者据此说,城市层面看起来较平衡,仍可以有很多街道是上班一侧高于居住一侧,并把它解释成居住分布带来的失衡:岗位集中之处,不少居民住得远。论文没有同时报告这七座城市的平均通勤时间,所以“平衡了但通勤仍然长”是结合既有北京研究作出的解释,不是本图新测出的分钟数。
平衡型(Balanced)是上海、深圳、厦门。几何平均的中位数高,JBR高于RBR的街道比例靠近50%。作者用既有文献讨论上海职住的空间相关、多中心和五个新城,并用深圳的多个副中心、厦门较小的城市尺度作为背景。这些机制没有在后文回归里单独检验。
居住主导且总体较平衡(Residence-Centric with Overall Balance)是西安和武汉。几何平均的中位数仍高,但JBR高于RBR的街道比例低,也就是更多街道是JBR低于RBR。作者把失衡解释为岗位分布:人住在住房多的街道,工作得到别处去。这是由两侧比值的相对高低推出的,同样没有通勤时间表。
脱节型(Disjointed)只有沈阳。几何平均的中位数低,正文还写JBR低于RBR的街道比例高。作者把它联系到老工业城市的空间遗留和岗位供给不足。图上的沈阳是七个点里最靠左的一个;只有一座城市进入这一类,后面的回归也只在沈阳市内的街道之间比较。
同一项因素,为什么换一类城市就换了方向?
分类之后,作者用Tobit模型看两侧指标与三类变量的关联。JBR和RBR都落在0到1,Tobit用来处理这种受限结果。变量分三块依次加入:模型1只有城市结构,模型2加入城市设施,模型3再加入人口特征。下文主结果是模型3。附录用普通最小二乘做稳健性检验,并报告R²;正文Tobit表报告的是对数似然,不是R²。
所有解释变量都在街道尺度。城市结构有两项。第三产业比例是该街道第三产业企业数除以企业总数,不是就业人数占比,也不是增加值占比。区位变量是街道到中央商务区或副中心的直线距离;有多个中心时按公式(5)做加权。城市设施是五类密度:公交与地铁站、商场和超市、重点幼儿园到重点高中、各类公园、医院和诊所,都是设施个数除以街道面积。为了把数量级拉齐,区位距离和这五类密度被缩放到0–1。表2的均值已经是缩放后的数。人口比例没有再做这道缩放,分母是该街道的上班者或居民。
在653个街道上,缩放后的区位距离均值0.026,最大0.114。第三产业企业占比均值0.798,最小0.391,最大0.970。表头写了百分号,数字却分布在0到1;按0.798%去读,会和0.391到0.970的取值对不上。公交与地铁密度缩放后均值0.039,最大0.261。商业密度均值0.022,重点教育0.009,公园0.004,医疗0.028。上班者中的高收入比例均值0.074,公务员比例均值0.111,30–49岁比例均值0.538。居民中的对应均值是0.059、0.108和0.472。高收入的收入线、公务员如何从手机数据识别,论文都没有写。
因为区位和设施密度已经缩放到0–1,系数1.699表示这个缩放变量从0增到1时,Tobit方程里的变动,不是“平衡比提高169%”,也不是样本里从最近街道走到最远街道的变化。653个街道的区位变量最大只有0.114,远小于1。人口比例的系数可以直接对着0到1的比例来读,但仍是关联的斜率,不是因果效应。
七座城市先放进同一个方程,样本量是653个街道。完整模型里,区位距离与JBR的系数是1.699(1%显著,t=5.995),与RBR是0.723(1%,t=3.306)。第三产业企业占比分别是0.511(1%,t=9.097)和0.293(1%,t=7.257)。重点教育密度与JBR为−0.815(1%,t=−3.175),与RBR不显著。商业密度与RBR为−0.705(1%,t=−4.586),与JBR不显著。医疗密度与RBR为0.509(1%,t=4.592)。上班者里的高收入比例与JBR为−0.341(10%,t=−1.692),公务员比例为−0.171(1%,t=−2.647),30–49岁比例为0.582(1%,t=5.376)。居民里的高收入比例与RBR为0.309(10%,t=1.762),居民中的公务员比例和30–49岁比例都不显著。
作者特别指出,商业密度与RBR的负关联和直觉相反:商业多的地方似乎应有更多附近岗位。因此他们把这个全样本结果留给分类型模型,不把它当成七座城市的共同机制。
分类型之后,样本量变成街道数:北京232,平衡型三市212,居住主导两市127,沈阳82。下表只列完整模型,也就是三类变量都放入之后的Tobit系数。1%、5%、10%沿用论文的显著性标记。未标显著性的系数,只表示这次检验没有达到10%,不能写成两者没有差别。
| JBR完整模型 | 七城653 | 北京232 | 平衡型212 | 居住主导127 | 沈阳82 |
|---|---|---|---|---|---|
| 区位距离 | 1.699(1%) | 0.225 | 2.228(1%) | 3.527(1%) | 3.101(1%) |
| 第三产业企业占比 | 0.511(1%) | 0.175(5%) | 0.312(1%) | 0.118 | 0.492(5%) |
| 公交与地铁密度 | −0.044 | 1.254(1%) | −0.543 | 0.533 | 1.202(10%) |
| 商业密度 | 0.243 | −2.119 | 1.005(1%) | 0.920 | 0.719 |
| 重点教育密度 | −0.815(1%) | −4.012(10%) | −0.548(5%) | −3.788 | −3.641 |
| 公园密度 | 0.546 | 1.505 | 0.375 | 5.739 | 1.405 |
| 医疗密度 | −0.110 | −0.148 | −1.027(1%) | 0.963 | 0.177 |
| 高收入上班者占比 | −0.341(10%) | −0.010 | 0.253 | −2.463(1%) | −3.218(1%) |
| 公务员上班者占比 | −0.171(1%) | −0.078 | −0.150 | 0.366(5%) | −0.596 |
| 30–49岁上班者占比 | 0.582(1%) | 0.953(1%) | 0.651(1%) | 0.444(5%) | 1.473(10%) |
| RBR完整模型 | 七城653 | 北京232 | 平衡型212 | 居住主导127 | 沈阳82 |
|---|---|---|---|---|---|
| 区位距离 | 0.723(1%) | 0.172 | 2.096(1%) | 1.880(1%) | 2.397(1%) |
| 第三产业企业占比 | 0.293(1%) | 0.236(1%) | 0.260(1%) | −0.026 | 0.176(10%) |
| 公交与地铁密度 | 0.012 | 0.848(5%) | 0.249 | 0.171 | 0.588(5%) |
| 商业密度 | −0.705(1%) | −0.817 | 0.239 | −0.481 | 0.014 |
| 重点教育密度 | −0.069 | 4.598(5%) | −0.375 | 0.836 | 0.197 |
| 公园密度 | 0.367 | 1.682 | 0.661(5%) | −1.130 | 0.855 |
| 医疗密度 | 0.509(1%) | −0.055 | 0.083 | 1.052(5%) | −0.268 |
| 高收入居民占比 | 0.309(10%) | 0.916(10%) | −0.416 | −0.309 | −0.785 |
| 公务员居民占比 | −0.088 | −0.088 | −0.150 | −0.060 | 0.331 |
| 30–49岁居民占比 | −0.054 | 0.221(5%) | 0.224 | −0.277(5%) | −0.169 |
北京和另外三类的距离项不同。只放城市结构时,北京区位距离与JBR的系数是−0.511(5%),与RBR是−0.776(1%):离中心更远,两侧比值更低。设施和人口放进模型以后,两个系数变成0.225和0.172,都不再显著。上海、深圳、厦门,以及西安、武汉和沈阳,完整模型里的区位距离仍为正,而且两侧都达到1%。全样本的1.699是七座城市街道混在一个方程里的斜率;北京在自己的完整模型里已经看不到这道正梯度。
第三产业企业占比在北京、平衡型三市和沈阳的完整模型里为正。西安和武汉在只放城市结构时,JBR一侧是0.315(1%);设施和人口加入后变成0.118,不再显著,RBR一侧三次都不显著。
交通密度的正关联集中在北京和沈阳。北京完整模型里,公交与地铁密度与JBR为1.254(1%,t=2.966),与RBR为0.848(5%,t=2.136),基数都是232个街道。沈阳与RBR为0.588(5%),与JBR为1.202,只到10%(t=1.688),基数是82个街道。平衡型三市在模型2里曾有一个10%的负系数,完整模型不再显著。
商业密度的明确正关联出现在平衡型的JBR:1.005(1%,t=4.307),212个街道。同一模型的RBR是0.239,不显著。全样本RBR的−0.705没有在四类城市的完整模型里保持为显著负值。
重点教育在北京两侧方向相反:JBR为−4.012(10%,t=−1.866),RBR为4.598(5%,t=2.191)。平衡型只有JBR为−0.548(5%)。作者的解释是学区住房贵,在这里上班的人难就近住下,住在这里的人则更容易找到附近工作。回归里没有房价变量,这个价格机制是解释,不是模型测到的价格。
公园密度只在平衡型的RBR上达到5%,系数0.661。医疗密度在平衡型的JBR上为−1.027(1%),在西安和武汉的RBR上为1.052(5%)。作者对负号给出拥堵和医院周边环境的解释,对正号给出中心就业机会更多的解释。车速、拥堵和细菌风险都没有进入数据。
人口比例也随类型变化。30–49岁上班者占比在北京、平衡型和居住主导型都与JBR为正,北京的系数0.953(1%,t=7.893)最大。沈阳这一项是1.473,只到10%(t=1.774)。居民一侧,北京30–49岁占比与RBR为0.221(5%),西安和武汉为−0.277(5%)。作者把后者解释为照顾子女、择校而住得更远,模型里没有子女或入学记录。
高收入上班者占比与JBR的负关联,在居住主导型是−2.463(1%,t=−4.744),在沈阳是−3.218(1%,t=−3.630),在北京是−0.010。公务员上班者占比的正关联只出现在西安和武汉,0.366(5%,t=2.490)。作者把它和单位住房的历史路径放在一起。全样本里公务员占比与JBR为负,分城市后这个负号不再显著。高收入居民占比只在北京的RBR上达到10%,0.916(t=1.732)。
普通最小二乘的R²说明这些变量能跟上多少街道差异,分母仍是对应的街道数。北京只放城市结构时,JBR的R²是0.068;完整模型升到0.367,RBR完整模型是0.488,都是232个街道。平衡型完整模型的JBR是0.374,RBR只有0.150,212个街道。居住主导型分别是0.438和0.326,127个街道。沈阳分别是0.527和0.595,82个街道。R²高不表示找到了唯一机制。沈阳的10%结果在线性检验里更弱:交通密度对JBR的t变成1.571,30–49岁上班者占比的t变成1.651,都不再达到10%。
平衡型把上海、深圳、厦门放进同一个方程,居住主导型把西安和武汉放进同一个方程。论文没有报告城市固定效应,也没有再把类型内部按城市拆开。一个显著系数可能主要由其中一座城市贡献。
这些关联能说到哪一步?
附录用街道到历史地点的距离,作为到中央商务区距离的工具变量,只处理区位距离这一项。北京选德胜门火车站,上海选青龙古镇,深圳选赤湾古渡,厦门选五通渡头,武汉选大智门火车站,西安选城墙,沈阳同时用辽宁总站旧址和皇姑屯车站。外生性Wald检验没有拒绝“区位距离是外生的”这一原假设:北京两侧的统计量是0.83(p=0.363)和0.79(p=0.373);平衡型是1.71(p=0.191)和0.07(p=0.797);西安与武汉是2.59(p=0.107)和2.48(p=0.115);沈阳是1.32(p=0.251)和0.02(p=0.879)。论文同时给出的弱工具变量稳健统计量分别达到2075.06与1914.36、39.95与21.75、1794.11与1642.72、4346.89与4032.41,作者据此认为工具变量和区位距离相关。
没有拒绝外生,不等于已经证明没有反向因果。历史地点是否只通过今天的中心距离影响职住,排除性限制是作者的论证,不是一项直接检验。教育、医疗、收入和商业密度都没有做同样的工具变量处理。人会为了学校和医院选择住址,设施也会跟着人布局,这些系数尤其要保持在关联的级别。
结论里的政策建议是按这些关联的方向写的:北京和沈阳关注公共交通,平衡型关注工作地附近的商业和公园、并避免医疗设施周围的不便,北京和平衡型关注重点教育不要过度集中,居住主导型和沈阳关注高收入上班者在就业地附近的居住条件。建议对应的是城市类型上的系数差异。论文没有报告一项住房、轨道或学校政策实施前后,JBR或RBR上升了多少。
适用范围还可以收得更紧。时间只覆盖2021年10月。空间只覆盖七座城市群核心城市的街道,而且是正式就业者。直线距离短于5公里就被记为0,沿路绕行、过江和换乘都看不见。图1的平均距离和图3、图4使用的城市指标之间,论文没有给出可复核的计算代码。街道级的JBR、RBR数值表也没有随正文公布,数据写的是可向作者申请。
一句话总结
同一条街道要分开问两件事:在这里上班的人住得有多近,住在这里的人上班有多近;2021年10月这七座城市里,两侧地图并不重合,城市类型一变,距离、交通、教育和收入与平衡比的关联也跟着变。
核心来源
Liu, Y., Dong, J., He, Z., Song, Y., & Li, X. (2026). Measuring urban bilateral job-housing balance based on big data: A case study of multiple cities in China. Cities, 173, 106960. https://doi.org/10.1016/j.cities.2026.106960
刘一曦(Yixi Liu)是本文第一作者。论文署名为中金资本管理有限公司、中国科学院大学经济与管理学院,以及北卡罗来纳大学教堂山分校中国城市研究项目。该项目页面记录她于2022年6月至2023年6月做访问学者,列出的研究方向包括职住平衡、区域经济与区域幸福感。文末贡献说明里,她承担写作、可视化、方法、分析、数据整理和概念构思。
董纪昌(Jichang Dong)是中国科学院大学经济与管理学院教授。学校人员页列出的研究方向包括房地产经济与金融、决策理论。本文承担指导、资源、调研、基金和数据工作。
贺舟(Zhou He)是通讯作者,中国科学院大学经济与管理学院教授,邮箱hezhou@ucas.ac.cn与论文通讯地址一致。学校个人页写明他长期从事数字供应链、数字经济等复杂管理系统的建模与仿真。本文参与写作、指导、基金、分析和数据工作。
宋彦(Yan Song)是北卡罗来纳大学教堂山分校城市与区域规划系教授、中国城市研究项目主任。系里页面列出的研究包括低碳与绿色城市、规划评估、土地利用与交通的衔接。本文承担审阅、项目管理和部分方法工作。
李秀婷(Xiuting Li)是中国科学院大学经济与管理学院副教授。学校个人页列出的研究方向为房地产经济、政策分析和行为金融。本文承担审阅和校验。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
图1若被原样用于真实街道,一条只有2个人、10公里的通勤,会和一条有5个人、0公里的通勤一样,各占分母里的三分之一。远距离上的小流量会把平均距离拉高,从而把平衡比压低;人数很多的短距离通勤,只因为距离被记成0,对分子没有贡献。城市若按这个印刷公式考核街道,减少一小波极远通勤,数值上可能比让多数人从6公里变成4公里更“有效”。4公里和6公里之间只差一个5公里门槛,前者在分子里消失,后者整段距离都留下。沿路其实要绕行8公里的4.9公里直线距离,也会被记成和同街道居住一样。
北京的散点同时落在高几何平均和高“就业侧高于居住侧”的位置。只公布全市一个职住比,会把这个组合收成一句总体还行。图3又显示两侧深色不在同一圈层。规划如果只在就业侧平衡比已经较高的外围再加岗位,而不处理中心就业、外围居住这一侧,居住侧地图可以仍然很浅。这需要街道之间的流量矩阵才能核对,论文的公开图只有两侧比值。
系数也不能跨类搬用。北京232个街道上,公交与地铁密度与两侧比值同为正;212个平衡型街道上,显著的是商业密度与JBR的1.005,交通密度不再显著。沈阳只有82个街道,交通和年龄的10%结果换到线性检验就站不稳。把北京的交通斜率套到上海,或者把三座沿海城市合成的商业斜率套到沈阳,都超出了这些方程实际比较过的街道。