客流翻倍,公交班次为什么往往加不到一倍?
论文名片|Siddharth Patwardhan、Şirag Erkol、Filippo Radicchi、Marc Barthelemy,Crowding controls the scaling of bus frequency with demand,Proceedings of the National Academy of Sciences,2026,123(29):e2535998123。DOI:10.1073/pnas.2535998123。正式发表版,2025年12月10日收稿,2026年6月13日接收,2026年7月13日发表。
可以先想一个早高峰,它不是论文里的某条真实线路:一条走廊上的乘客比另一条多出许多,车和司机的工时却是同一笔账。若客流翻倍、单程时间不变,按直觉把班次也翻倍,指数就是1。交通经济学里更老的一条规则没有这么陡:最优班次跟随客流与单程时间之比的平方根,客流翻倍时班次大约只变成1.41倍。这里的1.41倍是2的1/2次方,用来读指数,不是某条线路被跟踪到的实验结果。
这篇论文把19个都市区的常规公交放在一起看。班次对繁忙程度的幂指数,大多落在1/2和2/3之间。2的2/3次方大约是1.59,所以即使走到这条窄带的上沿,客流翻倍仍加不到六成班次。多出来的那一截,对应车上已经挤、一部分人得再等下一辆的情形。
这组规律可以用一个约束优化来复现:在总驾驶时间有限时,把乘客的等车时间和挤车惩罚一起压低。它说明不同机构做出来的班次落在同一条窄带里。它没有记录调度会议,也不能单独证明各城市正在求解这个方程。
先说结论
- 摘要概括为大约3000条公交线路、全年超过40亿乘客、19个都市区。结果部分写超过3000条线路。除两个正文没有点名的离群点外,拟合指数落在0.50到0.67,并且在繁忙程度的近三个数量级上都看得到。
- 拥挤可以忽略时,固定总驾驶时间、只最小化等车,最优指数是1/2。拥挤项占主导时,指数变成2/3。一座城市的有效指数停在中间,是因为只有一部分线路越过转折。
- 奥克兰几乎全部线路在转折之下,有效指数0.53±0.05。迈阿密两侧线路数量接近,指数0.55±0.05。伦敦多数线路在转折之上,指数0.62±0.03。
- 在线路和客流都保持不变的模型重算里,预算增加20%,波士顿每位乘客每个运营日大约少等将近5分钟,巴黎大约少等1分钟。图3另给出起点斜率:预算每增加1%,费城、休斯敦、波士顿分别少等0.11、0.24、0.34分钟。曲线随后变平,不能把起点斜率乘以20当成20%时的结果。
为什么老规则只允许平方根?
1972年,Mohring把一条公交线的发车间隔写成运营商成本和乘客等车成本的平衡。班次越高,运营商成本按比例上升;乘客若随机到达,平均只等半个发车间隔,等车时间则随班次下降。由此得到的最优班次,与客流除以单程时间的平方根成正比。后文把这个客流除以单程时间叫做繁忙程度,记为φ。
在这个最简设定里,平方根几乎是唯一站得住的幂。班次是单位时间里的班数,客流是单位时间里的乘客数,单程时间是一段时长。只用这三个量,能把班次配平的组合就是φ的1/2次方。指数若不是1/2,系统里就还藏着另一个时间或容量尺度。
Jansson,以及后来的Jara-Díaz和Gschwender,把车辆容量、挤车带来的不舒适和多条线路加进同一类模型。那些模型里,最优班次对需求的弹性可以落在1/2到1之间的任何位置。弹性在这里就是幂指数:需求增加1%,最优班次增加百分之几。它们仍是给一条简化线路的处方。真实排班还要看客流、满载标准、准点、可达性、公平、预算和公共争议。处方模型和来回修订过的时刻表之间,差着一整段制度过程。
经验问题因此换成:这么多不同的修订,最后留下的指数是散开的,还是仍挤在一段很窄的范围里。
一条线路在这篇文章里只剩三个数
材料有两类。一类是19个都市区公交机构公布的线路客流,另一类是与之时期匹配的通用公交馈送规范(General Transit Feed Specification,GTFS),也就是公开的时刻表和线路数据,取自Transitland的存档。图1(b)标出的系统包括奥克兰、布里斯班、匹兹堡、费城、温哥华、旧金山、巴黎、迈阿密、西雅图、休斯敦、波士顿、华盛顿、圣迭戈、纽约、洛杉矶、伦敦、多伦多、芝加哥,以及一个在正文里保持匿名的亚洲城市。各城市用到哪一段客流报告,论文放在补充材料。
分析单位是一条线路的一个方向,不是一名乘客,也不是一次换乘。机构报告通常不区分上下行,于是单向日客流d按整线工作日平均客流对半拆开。单向工作日班次f、单程时间t也按两个方向对称来取。t用该月第一个非假日周二全部班次行驶时间的中位数。φ = d/t,单位是每分钟单程时间对应多少名单向日乘客。
进入拟合的线路要同时满足:单向日客流多于25人,单程长于10分钟,每天多于12个班次。有轨电车被拿掉,点名的是多伦多和旧金山;校车被拿掉,点名的是布里斯班、伦敦和奥克兰。留下的是常规公交。因此指数描述的是过滤之后的单向常规线路,不是一座城市全部公共出行,也不能推出某一个人少坐一次车会怎样。
40亿是摘要对这批系统全年乘客规模的概括,正文没有给出分城市加总表,也不能理解成过滤后的日客流乘以365。各机构的客流定义也不完全一样,巴黎引用的是地面网络验票次数,其他城市多为机构自己的上车或客流报告。
十九个系统的指数,为什么挤在同一条窄带里?
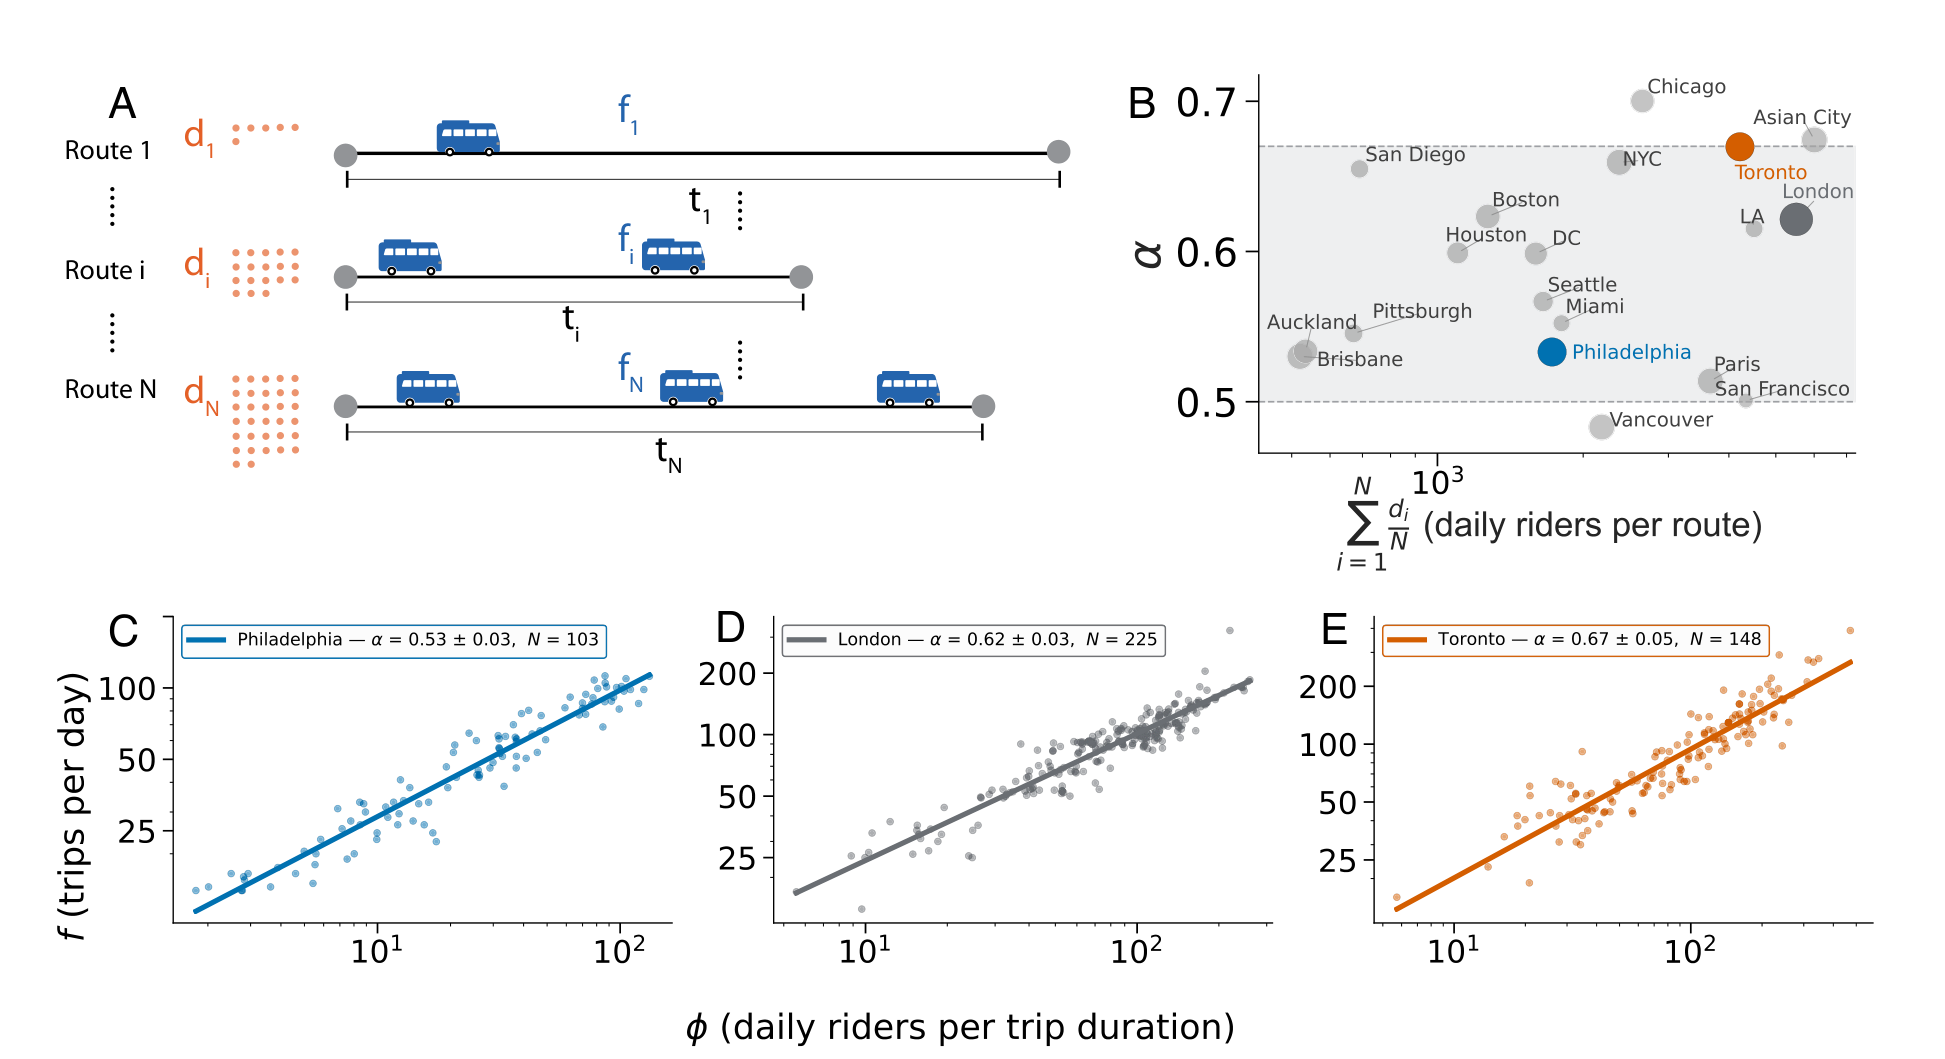
图 1|班次怎样跟着线路繁忙程度增加?
(a)一条线路i由三个数代表:单向日客流dᵢ、单向每日班次fᵢ、单程时间tᵢ。橙点是乘客,蓝车是班次,横向括号是跑完这一程的时间。(b)纵轴是每座城市自己的幂指数α,横轴是该市线路的平均单向日客流,即全部线路dᵢ之和再除以线路数N,坐标按数量级展开。浅色带是模型给出的1/2到2/3。费城、伦敦、多伦多用与后三幅相同的颜色标出。温哥华落在0.5参考线下方,芝加哥和匿名亚洲城市靠近上沿;正文说有两个离群点,但没有在文字里点名。图注没有说明圆点大小代表什么。(c、d、e)每个点是一条单向线路。横轴是φ,纵轴是每天班次,两轴都按数量级展开。直线是log f对log φ的普通线性回归。费城α = 0.53±0.03,相关系数R = 0.96,图例中的线路数N = 103。伦敦α = 0.62±0.03,R = 0.94,N = 225。多伦多α = 0.67±0.05,R = 0.92,N = 148。R是这两个对数量一起升降的程度,不是班次差异被解释掉的百分比。来源:原论文 Fig. 1。
较大或较密的系统,如芝加哥和纽约,指数倾向更高;温哥华和费城更靠近平方根。正文还说指数与总客流、机构规模正相关,并用波士顿和芝加哥近十年的客流与时刻表检查过,剧烈波动之后标度仍在。这些相关的系数、十年里的逐年指数,以及换回归方法、放宽过滤门槛后的对照,都写在补充材料里,主文图没有给出数值。
这一张图支持的是:在差别很大的机构和城市里,班次与φ的关系接近一条幂,指数却很少跑出1/2到2/3。它不支持各机构共用一张排班公式,也不支持把城市大小读成指数升高的原因。点的位置是同时观察到的规模与指数,没有把规模单独拨开。
把挤车写进等车时间,指数为什么会从1/2走到2/3?
模型仍以单向线路为单位。乘客若不管时刻表、随机到达,平均等待是发车间隔的一半,也就是1/(2fᵢ)。一条线全天的等车总量先写成dᵢ/(2fᵢ)。班次若按“每天多少班”计,这个量用“一天”作时间单位,论文因此称它为无量纲的日等待。
挤车另算。τ是一名乘客平均待在车上的时间,κ是一辆车的容量,拥挤参数δ = τ/κ。一名乘客在任意时刻仍在这趟车上的机会大约是τ/tᵢ,所以这条线上同时在车的人数大约是dᵢτ/tᵢ。再除以当天班次,平均每辆车的载客是dᵢτ/(tᵢfᵢ)。论文假定,挤车带来的额外等待与“载客除以容量”成比例。基本等车量于是乘上一个大于1的因子:
Cᵢ(fᵢ) = dᵢ/(2fᵢ) × [1 + δ × dᵢ/(fᵢtᵢ)]。
前一项随班次上升而下降。后一项在人多、班次少时升得更快。这是一条光滑的惩罚,不是逐站模拟谁挤不上车,也不是载客一超过κ就突然换一条规则。
约束是全系统的总驾驶时间B = Σ fᵢtᵢ。班次多、单程长,都会把这笔时间用掉。论文把它当作司机、车辆投放和燃料的代理,并称作每天的车辆小时。图里的φ用分钟作分母,因此t若以分钟计,B的原始乘积是车辆·分钟;正文没有另写换算成小时的步骤。需要记住的是比较方式:预算按班次乘单程时间加总,不是按线路条数平分。
在这条约束下把各线Cᵢ加总后最小化,边际上每多给一条线一单位驾驶时间,省下的乘客时间应当彼此拉平。由此得到两个极端。拥挤项可以忽略时,回到f随φ的1/2次方增长。拥挤项占主导时,f随φ的2/3次方增长。两端之间是平滑过渡,不是一条线路跨过某个人数后指数突然改写。转折繁忙程度φc同时取决于总驾驶时间有多紧,以及δ有多大。φ低于φc的线路更受班次不足支配,高于φc的线路更受容量支配。
这个1/2不要和河流、叶片或电路网络里为了减少能耗而得到的指数混成同一个数。那些系统里,流量和通道粗细会互相调整。这里的线路客流被当成已经给定,城市分配的是班次。代价是乘客时间,不是电流或水流的损耗。
既有模型允许弹性一直高到1。本文的经验结果更窄,停在1/2到2/3。作者指出,若把厌恶拥挤的程度再写成可调的非线性,上沿可以变成(β+1)/(β+2);正文结果对应β = 1。所以2/3是这条拥挤惩罚的指数,不是任何挤车都会出现的常数。
同一套公式,为什么奥克兰近于平方根、伦敦更陡?
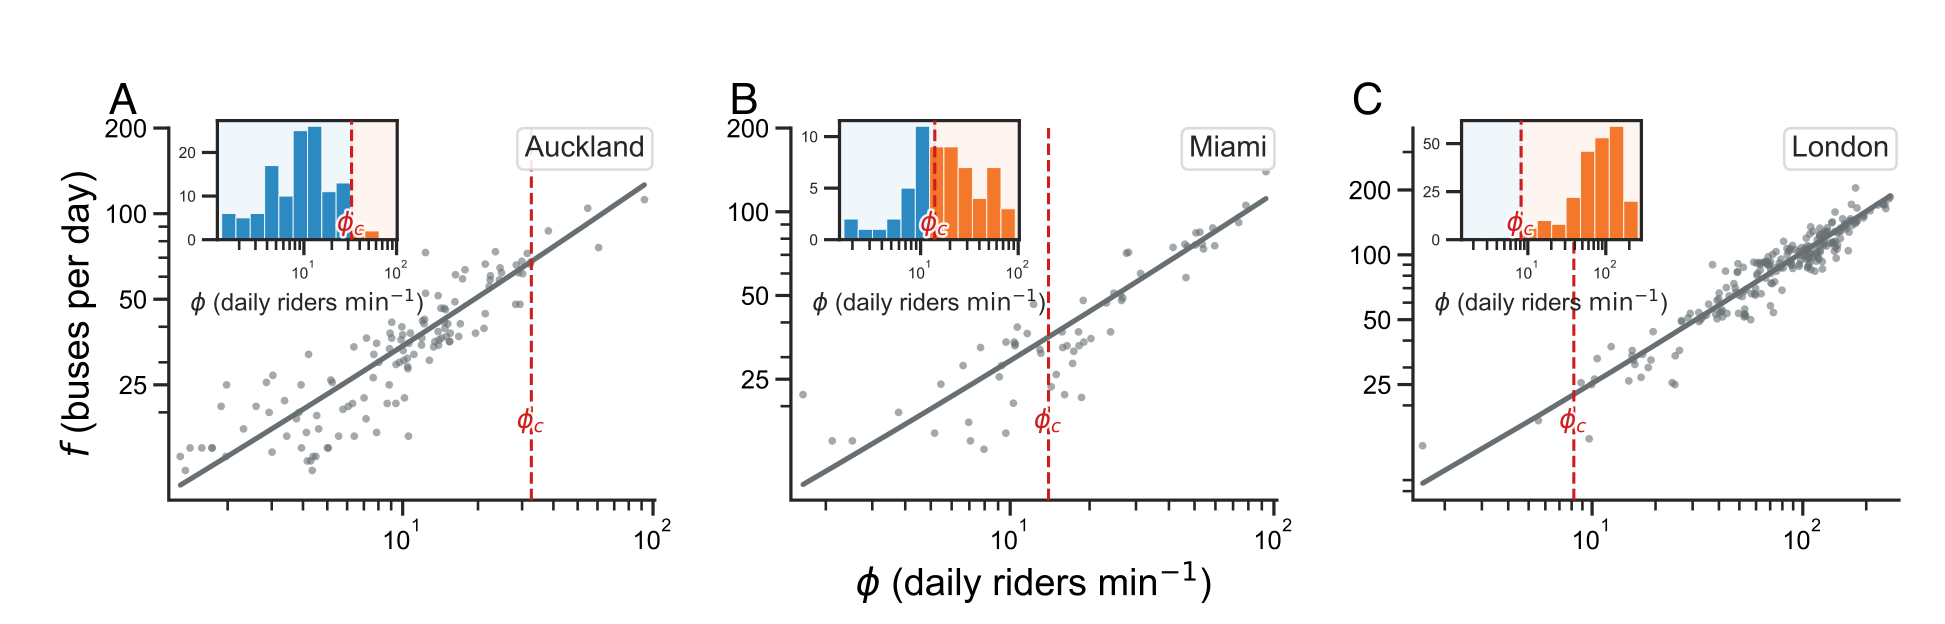
图 2|一座城市的线路落在转折的哪一侧?
三幅图的横轴都是φ,单位是每分钟单程时间的单向日乘客;纵轴是每天班次。灰线是用观测班次拟合出来的模型,红色虚线是转折φc。小图是φ的分布,蓝色在转折之下,橙色在转折之上。(a)奥克兰,δ = 0.78分钟运营时间每名乘客,φc = 32.7名日乘客每分钟单程。几乎全部线路在转折之下,有效指数0.53±0.05。(b)迈阿密,δ = 0.95,φc = 14.0,转折两侧的线路数量接近,有效指数0.55±0.05。(c)伦敦,δ = 1.04,φc = 8.2,多数线路在转折之上,有效指数0.62±0.03。来源:原论文 Fig. 2。
δ是为每座城市拟合出来的复合参数,把车上时间和车辆容量卷在一起。奥克兰的0.78分钟每名乘客不是秒表测出来的乘车时间,伦敦的δ更高也不直接等于伦敦的车更小。φc同样不是满载调查的门槛。它是拟合之后、在该市现有总驾驶时间下算出来的转折。
按单位换算,而不是按某条真实线路:单程30分钟时,奥克兰要到大约980名单向日乘客才碰到φc,伦敦大约250人就碰到。伦敦的门槛更低,已有线路更容易站到拥挤一侧。这只说明转折位置不同,不说明伦敦乘客比奥克兰乘客更不能忍受拥挤。
有效指数可以停在两个极端之间。迈阿密两侧线路数量接近,整座城市仍只拟合出0.55,因为对数图上的一条直线是跨过弯曲处的平均斜率。伦敦已经以转折之上的线路为主,指数升到0.62,也还没有贴到2/3。图1里多伦多的0.67±0.05是三座示例城市中的上沿,主文没有给出它的δ和φc。
日均也会掩盖峰谷。匿名亚洲城市的逐时数据显示,一小时内的班次和客流在一天里变化很大;各线路的小时最高客流、小时最高班次,与各自的日均仍有强的线性相关,所以用日均排序,大致还保留着高峰时谁更忙。运营区间是否因此标对,正文放在补充材料,主文没有给出那条相关的系数。
多出来的驾驶时间,为什么不会平均变成少等的分钟?
频率主导一侧,等车主要随班次下降,车上没有系统性地坐满,再多一些客流也比较容易接住。运力主导一侧,等待更多来自挤不上这辆车。作者从舒适、可靠和对客流波动的余地出发,认为频率主导一侧通常更可取。这句话是运营判断。模型本身只最小化等车加挤车,没有把票价、工资或偏远地区是否有车写进目标。
把一条线路从运力主导一侧推回去,可以增加总驾驶时间,也可以提高车辆容量。二者都会抬高φc。后面的计算保持单程时间和客流不变,用已经拟合的δ重新求解每一条线路的班次。新增的驾驶时间不是按线路条数平分,忙的线路会多分到班次。
城市因此分成三组。费城、奥克兰、匹兹堡多数线路已经在频率主导一侧,再加资源对“有多少线路越过转折”改变不大。纽约、伦敦、芝加哥有很大份额的线路在运力主导一侧,要加很多资源,才会有明显份额离开这一侧。迈阿密、休斯敦、西雅图靠近转折,少量新增资源就能让不少线路换边。
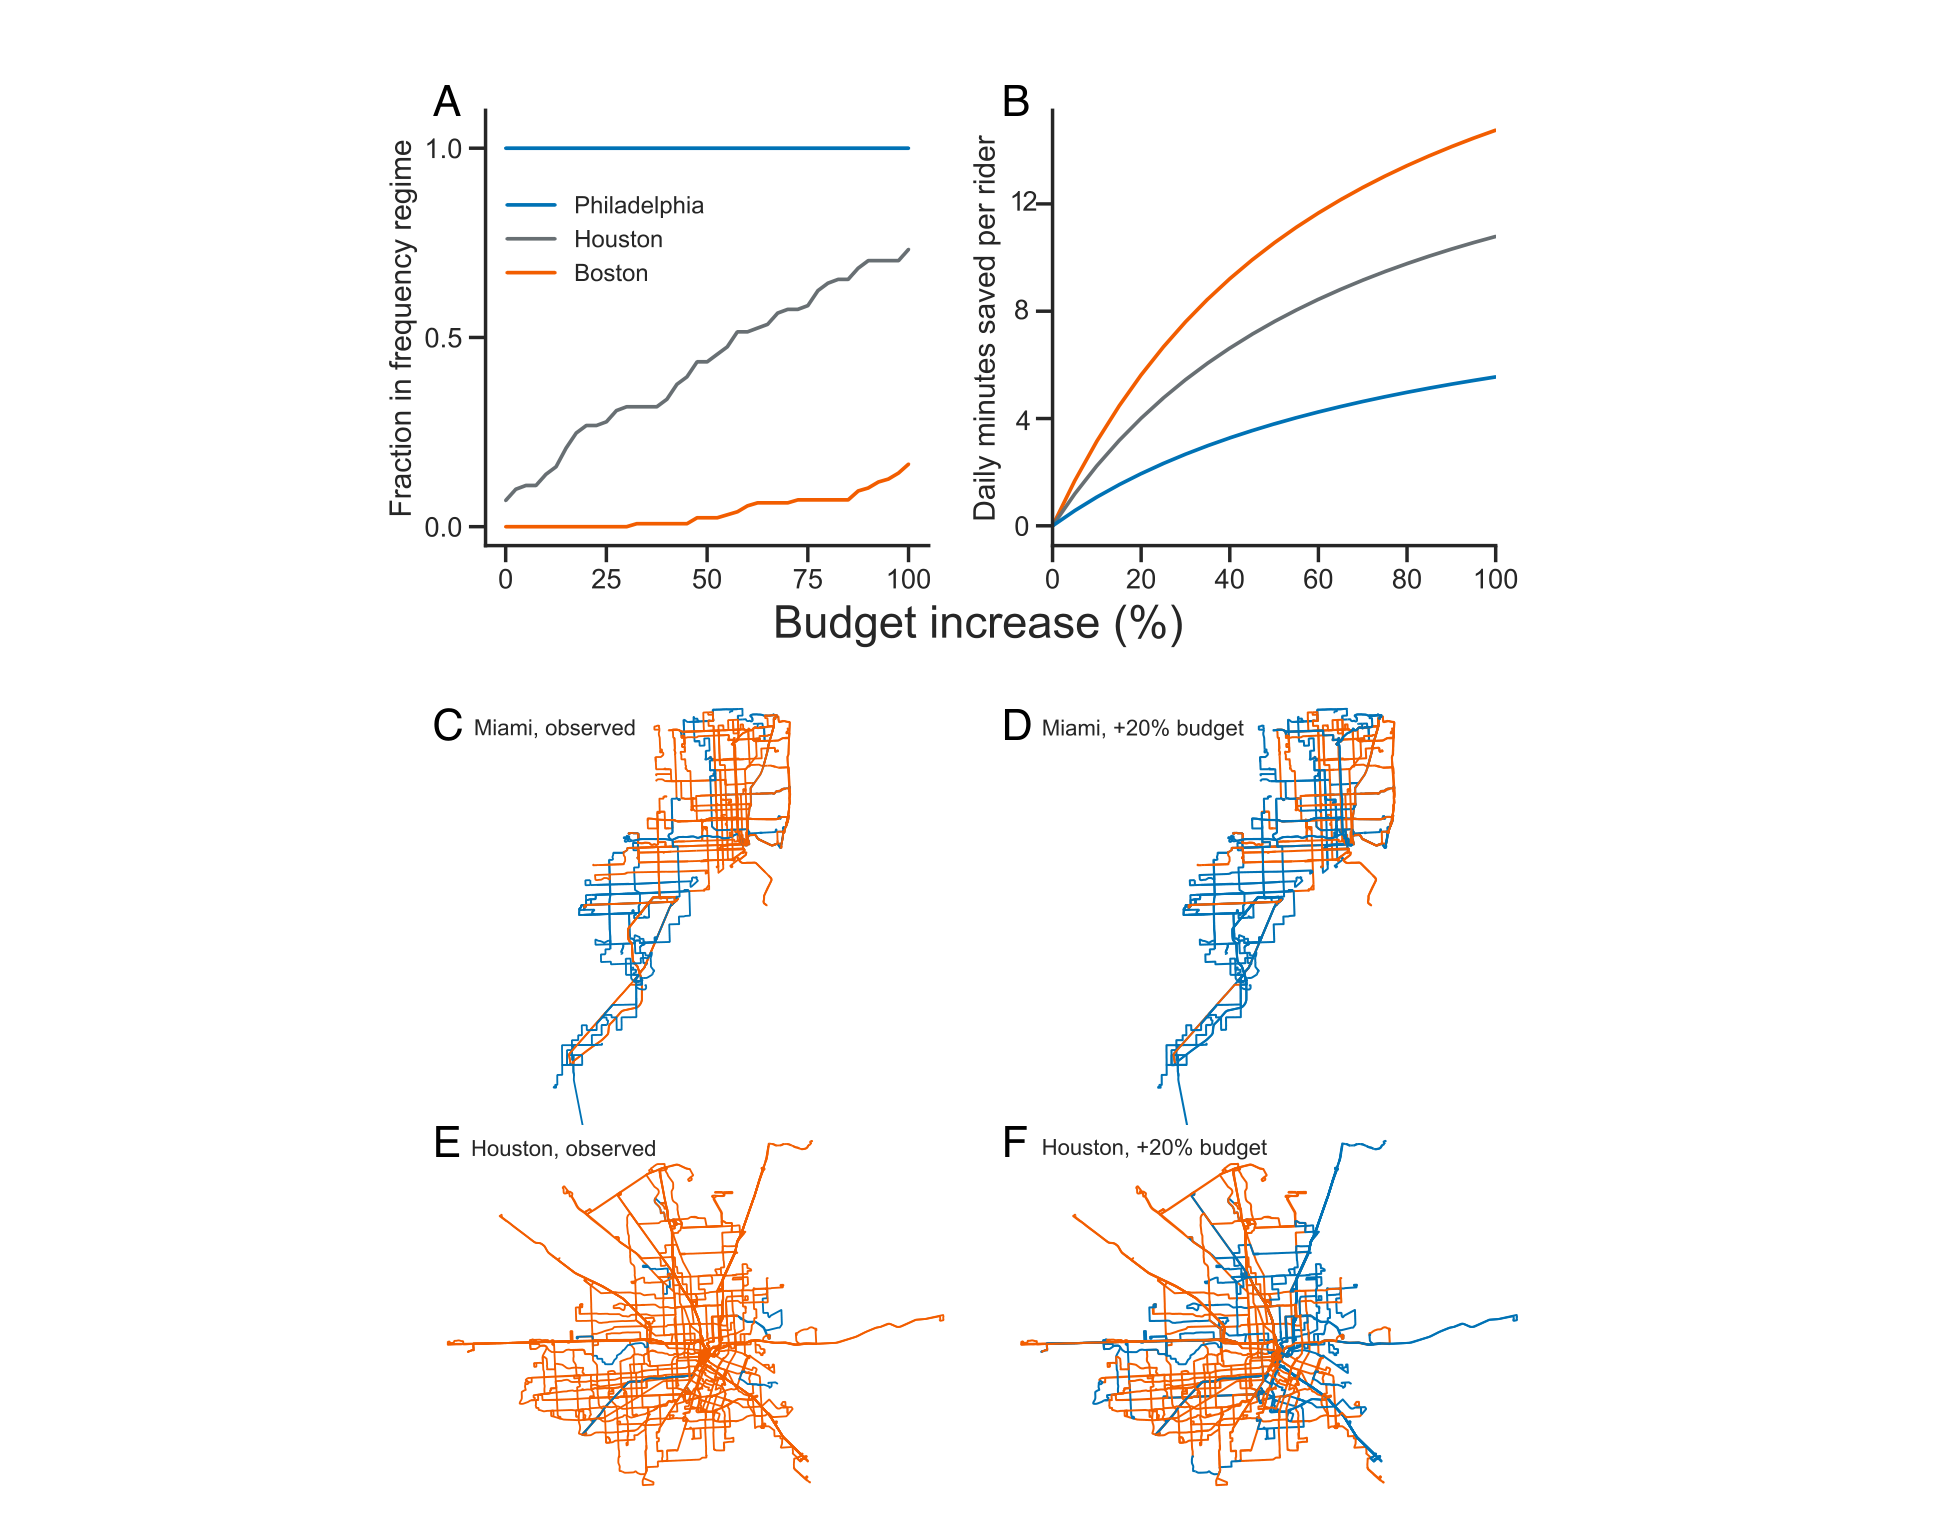
图 3|同样比例的预算,少等的分钟为什么差这么多?
(a)纵轴是落在频率主导一侧的线路占全部线路的比例,横轴是预算增加的百分比。蓝线费城几乎贴在1上。灰线休斯敦从较低比例持续上升。橙线波士顿长期贴近0,预算增加很多以后仍然只有小幅抬升。正文把迈阿密也列为对预算敏感的中间组;图上这条较陡的曲线是休斯敦,迈阿密的线路画在(c、d)。(b)纵轴是每位乘客每个运营日少等的分钟,三座城市与(a)相同。计算假定每条线路有18小时运营窗。起点处,预算每增加1%,费城、休斯敦、波士顿分别少等0.11、0.24、0.34分钟。曲线后来变平。(c、e)是按当前预算、用拟合模型标出的区间,不是车上人数的实测地图。蓝为频率主导,橙为运力主导。迈阿密两种颜色都有,线路较密的一侧橙色更多;休斯敦几乎整网是橙色。(d、f)是预算增加20%并重新求解班次之后的标色。迈阿密有更多线路转为蓝色;休斯敦外围出现蓝色,核心仍以橙色为主。来源:原论文 Fig. 3。
摘要里的20%对照是:波士顿每位乘客每天将近少等5分钟,巴黎大约少等1分钟。巴黎不在图3的三条曲线里。5分钟也不能由0.34乘以20得到;0.34只是原点上的斜率,图上的收益会变缓。相对增加车辆容量的结果与加预算定性相似,图放在补充材料。
这组分钟数是需求不变时的模型输出。讨论里提到,服务变好以后客流可能转向公交,从而减轻道路压力。那个反馈没有放进这张图。若新客流又把忙线推回转折之上,少等的分钟会比冻结客流时更少。
这套指数能说到哪里?
班次来自与客流时期匹配的GTFS时刻表,是计划班次。意义陈述里写的是实际运营呈现的规律。主文没有用车辆定位或实开记录核对停运、加班和计划的差别。客流对半拆进两个方向;若高峰方向远多于一半,φ会被压低或抬高。过滤门槛和回归方法的稳健性、指数与总客流的相关系数,主文只给出方向,不给出数。
一个城市只拟合一个δ,并用全天平均代替高峰。β固定为1。模型能把观测到的指数范围复现出来,没有排除别的目标函数也能画出相近的幂。拟合接近,不等于调度部门采用了这个目标,更不等于1/2或2/3是唯一机制。
加预算的地图是重新求解后的区间标签。橙色线路不是当天被计数的满载班次。图3的分钟数还依赖每条线路18小时运营窗这一假定。
和生物、河流网络的类比也停在问题结构:有限资源要在不均匀的负荷上分配。公交这里是客流给定、城市决定班次。不要把那些网络里的能耗指数直接读成公交班次的指数。
一句话总结
客流增加时班次往往加不到一倍,是因为在有限的驾驶时间里,只计等车会得到平方根,挤车变重则把指数推到2/3;一座城市能少等多长时间,取决于已有多少线路站在挤车这一侧。
核心来源
- PNAS正式论文,核对题目、作者、发表日期与正文图1至图3。
- 补充材料入口,正文把分城市样本、采集时段、十年稳健性和高峰验证放在这里。
- 作者公开的线路级数据与代码。
作者介绍
四人都参与研究设计、研究实施和写作。论文写明由Siddharth Patwardhan分析数据。Patwardhan与Marc Barthelemy为通讯作者。资助说明只涉及Filippo Radicchi的一部分经费,来自美国空军科学研究办公室项目FA9550-24-1-0039,资助方不参与设计、分析和发表决定。
- Siddharth Patwardhan:西北大学凯洛格管理学院科学学与创新研究中心。
- Şirag Erkol:同一中心。
- Filippo Radicchi:印第安纳大学卢迪信息、计算与工程学院复杂网络与系统研究中心。
- Marc Barthelemy:巴黎-萨克雷大学、法国原子能和替代能源委员会与法国国家科研中心的理论物理研究所;法国国家科研中心与法国社会科学高等研究院的社会分析与数学中心;维也纳复杂性科学中心。
本文引用了Patwardhan、Barthelemy、Erkol与Radicchi在2024年发表的最优输运网络研究。那是他们此前的工作,不是这次公交拟合的结果。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若完全按这篇的目标分配驾驶时间,低客流但承担夜间或医院接驳的线路会显得昂贵:φ小,平方根规则本来就少给班次,挤车项也帮不上它们。许多机构另有最低发车间隔或覆盖范围的硬性规定。一个可以核对的推论是,受这类规定保护的线路,班次会系统性地低于本文拟合曲线。若它们同样贴在曲线上,覆盖标准就没有在班次里留下痕迹。
另一处会改写“少等几分钟”的,是高峰而不是全天。模型用全天平均,再假定18小时里乘客随机到达。一名只在早高峰出行的人,等的是高峰发车间隔,挤的也是高峰那几班。匿名亚洲城市的结果只说明线路之间的忙闲次序大体还在,没有说明波士顿那将近5分钟对高峰乘客仍然成立。把φ改成高峰一小时的上车人数除以这一小时的班次和单程时间,再重算20%的预算,城市之间谁受益更多,可能和全天账户不同。