要模仿一个人的一天,先画生活图,还是直接画轨迹?
论文名片|Peiran Li、Haoran Zhang、Wenjing Li、Dou Huang、Zhiling Guo、Jinyu Chen、Junxiang Zhang、Xuan Song、Pengjun Zhao、Jinyue Yan、Shibasaki Ryosuke、Noboru Koshizuka,GeoAvatar: A big mobile phone positioning data-driven method for individualized pseudo personal mobility data generation,Computers, Environment and Urban Systems,2025,119:102252。2025年3月10日在线发表;收稿日期2024年5月30日,修回2025年1月2日,接收2025年1月10日。DOI:10.1016/j.compenvurbsys.2025.102252。本文依据正式发表版解读。方法论文。
城市研究经常需要知道:这一小时,每个网格里有多少人;哪些起点和终点之间有人在移动。手机定位能提供这种个人尺度的记录,也正因为记录可以跟一个人的连续行踪连在一起,直接拿来用会碰到隐私、获取和费用问题。一个替代想法是制造伪个人移动数据:统计上看起来像真实出行,却不把真实用户的轨迹交出去。
已有做法大致分成两条。机制模型给所有人一套共同规则,例如探索新地点、停留或回家,再从分布里抽参数。深度学习模型常常一次生成一段孤立轨迹,轨迹上的经纬度连得像,却不一定属于同一个伪个人的连续一天。GeoAvatar 把顺序倒过来:先生成一张因人而异的生活模式图,沿图走出活动序列,再按推断出的人口属性把地点落到地图上。
方向性的结果是:在跳跃距离和一天访问多少地点这两条宏观分布上,它没有超过一个已经使用真实个体参数的机制基线;在活动构成,以及聚合后的小时网格人口上,它更接近真实数据。起讫流量也强于该基线,但仍低于两半真实用户彼此之间的相关。这些比较都还是分布和聚合计数,不是对某个真实的人逐条核对一天。
先说结论
- 东京手机 GPS 的预分析里,按到访概率取前 3 个重要地点,可以还原 90% 的静态网格人口和 75% 的动态起讫人口。要还原到 99%,静态人口需要 10 个以上重要地点,动态人口需要 15 个或更多。少数地点能过一条及格线,高质量还原依赖长尾地点。
- 跳跃距离的 Kolmogorov–Smirnov 统计量,GeoAvatar 为 0.217,机制基线 FEM 为 0.198;一天访问地点数分别为 0.440 和 0.238。统计量越小,生成分布越接近真实分布。FEM 更近,一天地点数上的差距更大。正文只给这一组数,没有按图中的 500、5000、20000 人分开报告。
- 活动概率的平均绝对误差,GeoAvatar 的整体值为 4.54%,FEM 的平均值为 15.9%。按小时的 Jensen–Shannon 散度分别为 0.0356 和 0.0972;个体生活模式分布的散度分别为 0.047 和 0.075。散度越小越接近。
- 时空检验先取 6 万名用户的一周轨迹,随机分成各 3 万人的真实组 1 和真实组 2,再生成 3 万人的 7 日轨迹。比较的是每小时网格人口和每小时起讫计数的 R²。图 7 上,网格人口的 GeoAvatar 接近两半真实数据彼此的相关;起讫量低于这一自然波动。FEM 两组都更低。
- 正文把东京和上海写成同一组 R²,而这组数字与图 7 的上海标注一致、与东京标注不一致。人口属性由生活模式图和普查对齐来推断,主文没有年龄或性别准确率,也没有单独拆开人口属性模块的消融。
统一规则为什么会在个人尺度上不够用?
个人移动数据被用于流行病、交通规划和灾害情景,是因为需要人在空间和时间上的连续选择。机制模型直观:TimeGeo 用探索、停留、回家这一类共同框架,从联合分布抽取决策参数。后来的 Act2Loc 先把人聚类成有限类型,再按类型生成动作和地点。类型仍然是少数几档。人与人的差别、以及“做什么”和“去哪里”怎样绑在一起,都被压进同一套或少数几套规则。
深度学习另一头,GAN、VAE 和扩散模型可以把一段轨迹一次生成出来。生成的是一串经纬度,或一次出行。下一段不必和上一段属于同一个伪个人,也很少先问这个人是怎样一种生活节奏。模型更像地点之间的转移概率,换一座城市往往要整网重训。
GeoAvatar 要补的是三件事:每个人一张不同的生活模式图;不用个人真实年龄性别标签、改由普查来给伪个人贴人口属性;再让人口属性和地点选择耦合。它生成的是伪个人的连续移动,评估时再看这些人叠到一起之后,还像不像一座城市。
前三个常去地点,能把网格人口还原到多少?
作者先用东京的手机 GPS 做预分析,看重要地点能不能把人的移动拼回去。做法是提取停留、对停留做空间聚类、认出重要地点,再按到访概率从高到低取用。每个人在重要地点的逐小时停留被汇总到网格,和原始网格人口、原始起讫人口比较。具体清洗写在补充材料的数据说明里,主文没有给出这一步的用户数。后文明确用于本研究的东京样本,是家在东京都市圈的 74,693 人;不要把预分析直接等同于这 74,693 人的全部天数。
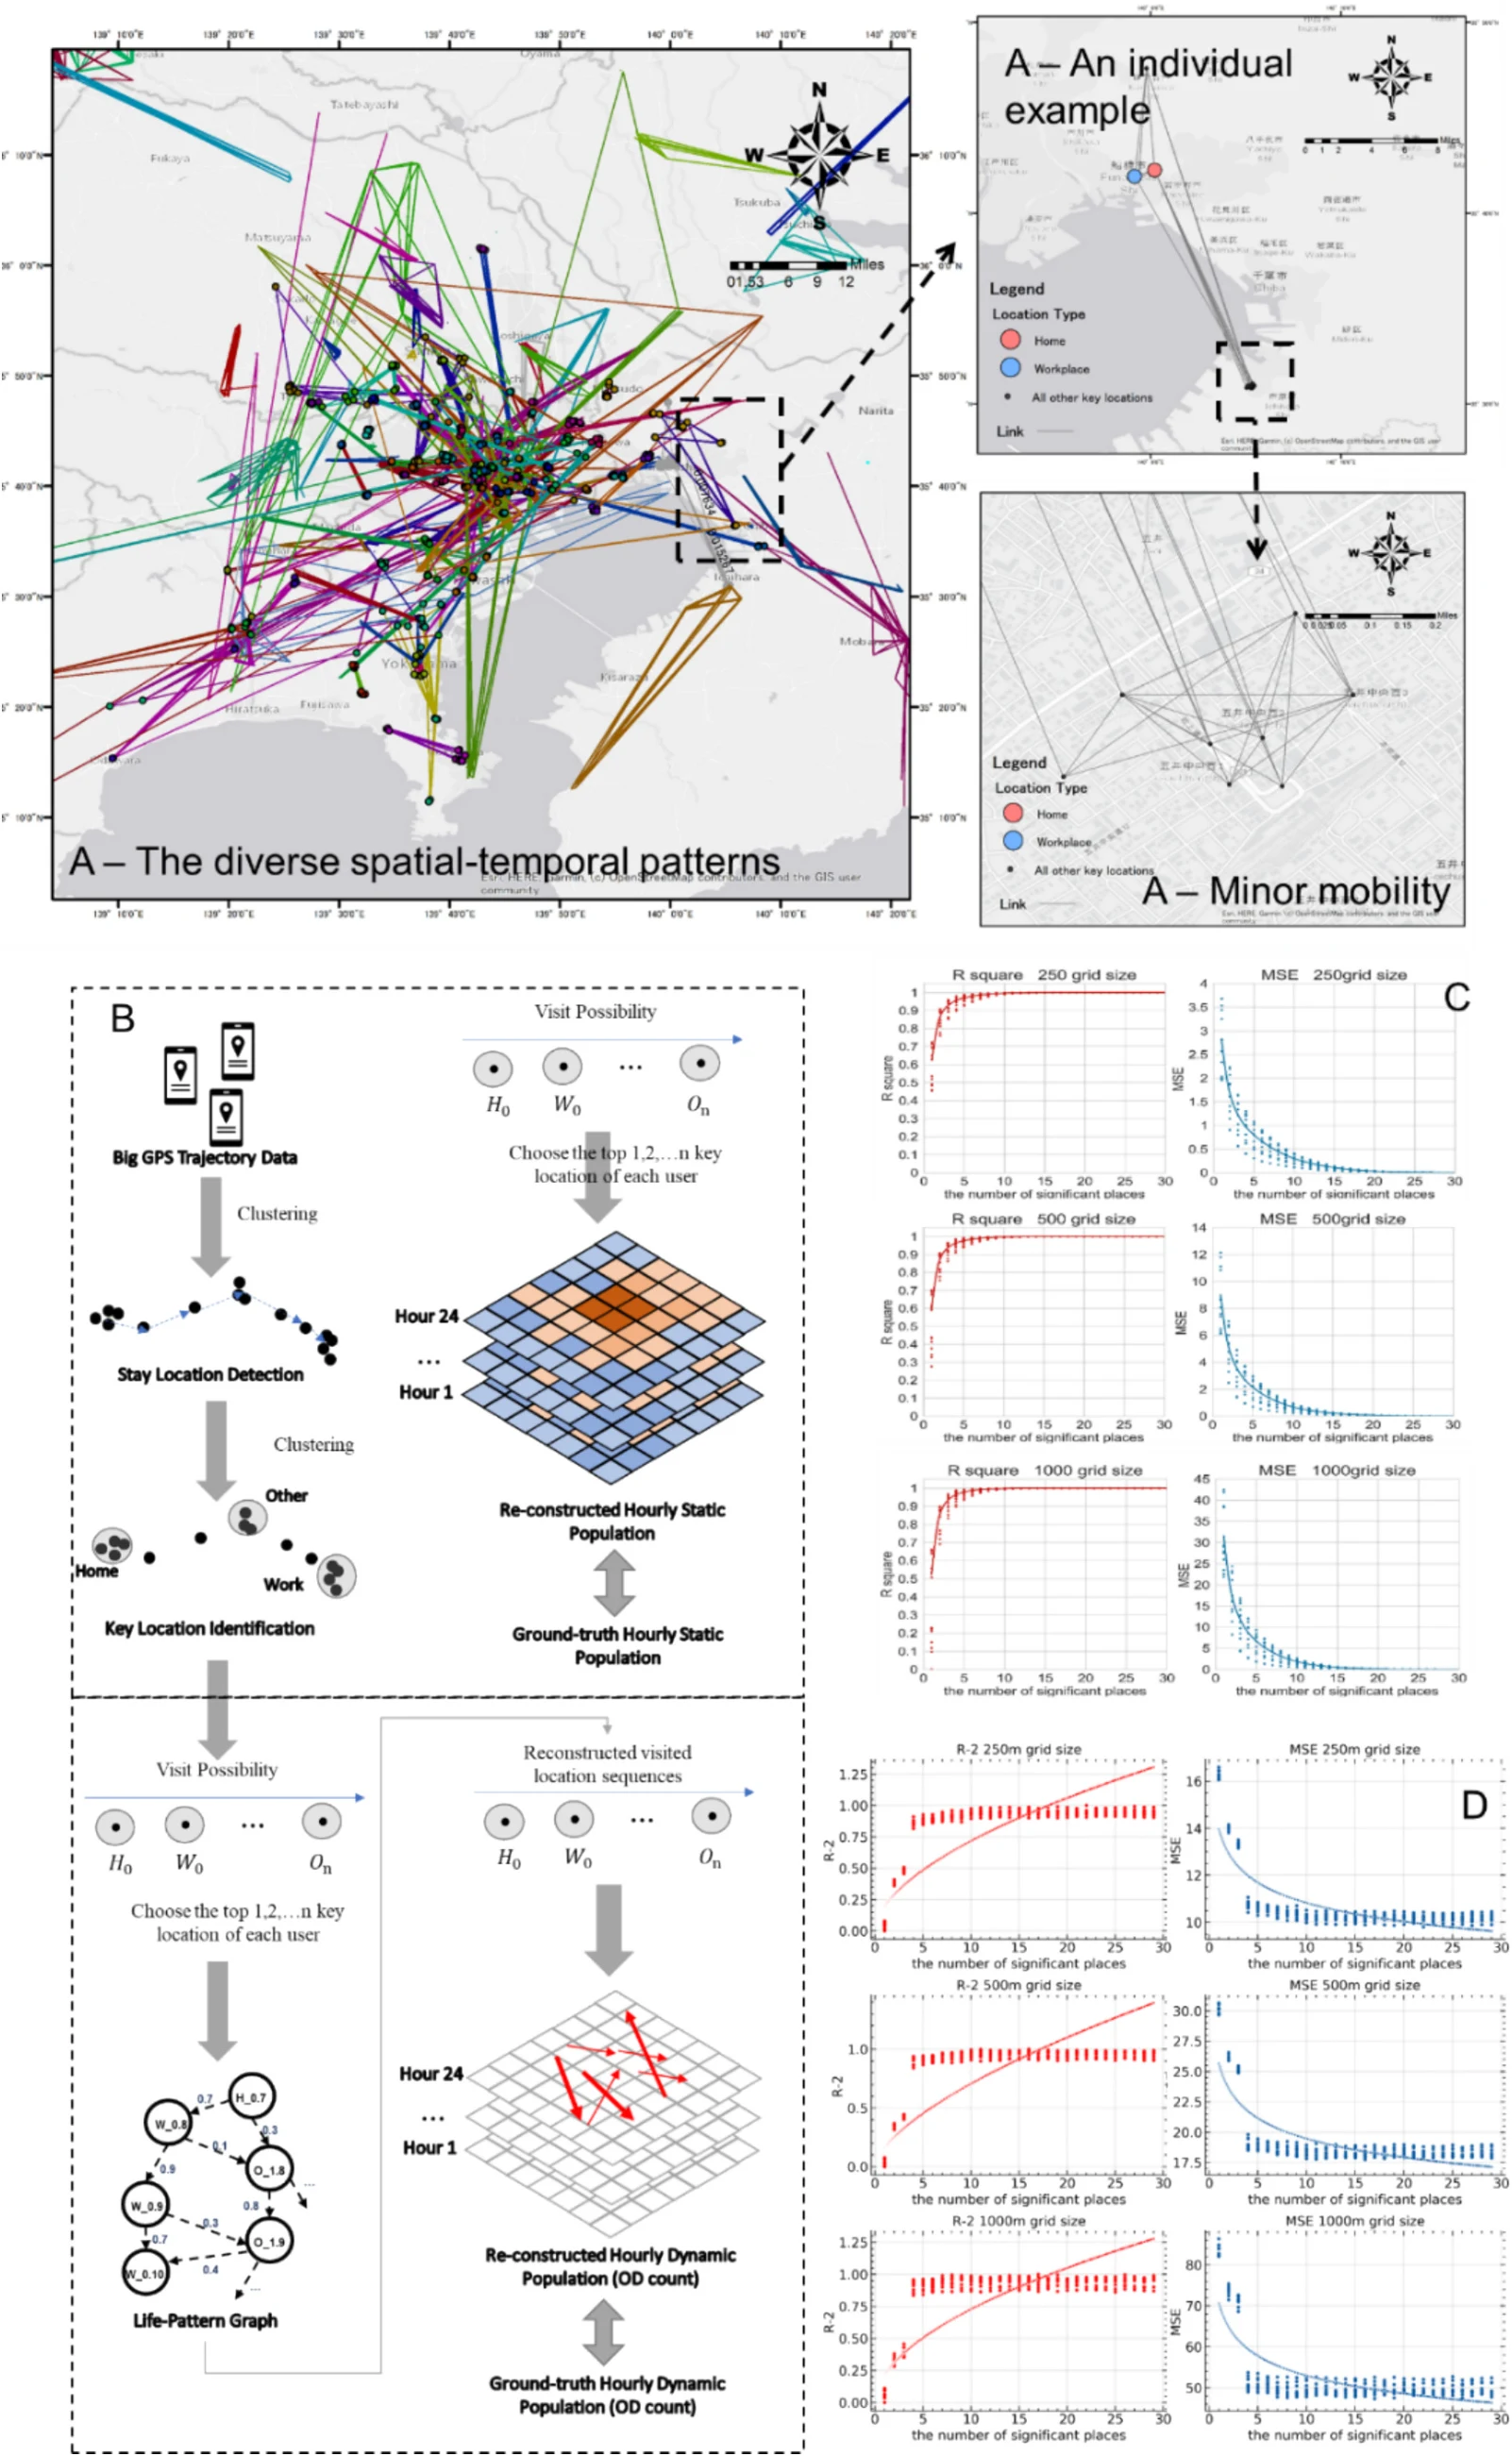
图 2|少数常去地点,能把网格上的人还原到什么程度?
(A)左图是多名用户叠在东京一带的轨迹,颜色区分不同人;右上是一名通勤者的生活模式示意,右下是局部放大。图例里红点为家,蓝点为工作地,黑点为其他关键地点,线是地点之间的联系。(B)上半是静态人口的还原流程:从 GPS 中检测停留、聚类、识别家和工作地等关键地点,按到访概率选取,再汇总成逐小时网格人口,与原始网格人口比较。下半把同一思路用于动态起讫:从生活模式图抽出访问过的地点序列,再汇总逐小时起讫人口。(C)静态人口。横轴是使用的重要地点个数,左列是 R²,右列是均方误差;图中可见 250 grid size 和 500 grid size 等由细到粗的网格档。地点个数从很少开始增加时,R² 先陡升并逐渐靠近 1,均方误差下降,之后变平。(D)动态起讫人口,坐标含义与(C)相同,曲线同样先陡后平。主文给出的读数是人口还原比例,不是直接把某一格的 R² 当成 90%:前 3 个最常去的重要地点对应 90% 的静态人口和 75% 的动态人口;99% 的静态人口需要 10 个以上地点,动态人口需要 15 个或更多。来源:原论文 Fig. 2。
这张图支持一个操作性判断:若只求网格人数大体像样,前几个地点已经能过一条及格线;若要求误差继续下降,就必须保留很多很少出现的地点。它不支持“每个人一天只去三个地方”。90% 和 75% 的分母,是原始静态网格人口和原始动态起讫人口,不是用户人数,也不是 R² 本身。
作者由此认为,用探索—优先返回或引力模型去随机选点,会把本可以钉在重要地点上的选择重新散开。个人尺度要有足够多的选择分支,就得为每个人生成一张不同的生活模式图;只调一套全局参数,分支仍然是共享的。生活模式和人口属性的关联,则被用来在没有个人年龄、性别标签时做推断。主文这一步是动机,人口属性推断的准确率要到后面的方法里才出现,而且后文并没有给出准确率数字。
一张生活模式图,怎样变成伪个人的一天?
生活模式在这里是一张异构图:节点是家、工作地和其他关键地点,边上带着转移的可能性和时间。人与人的图不一样,所以总体分布落在高维空间里的低维流形上。普通生成对抗网络很难沿这种很薄的分布去采样。作者从原始 GAN 出发,改成带梯度惩罚的 Wasserstein GAN 一类模型来生成这些图。网络层数、隐变量维度和训练损失的具体设置在方法补充材料的 Part I,不在正文。
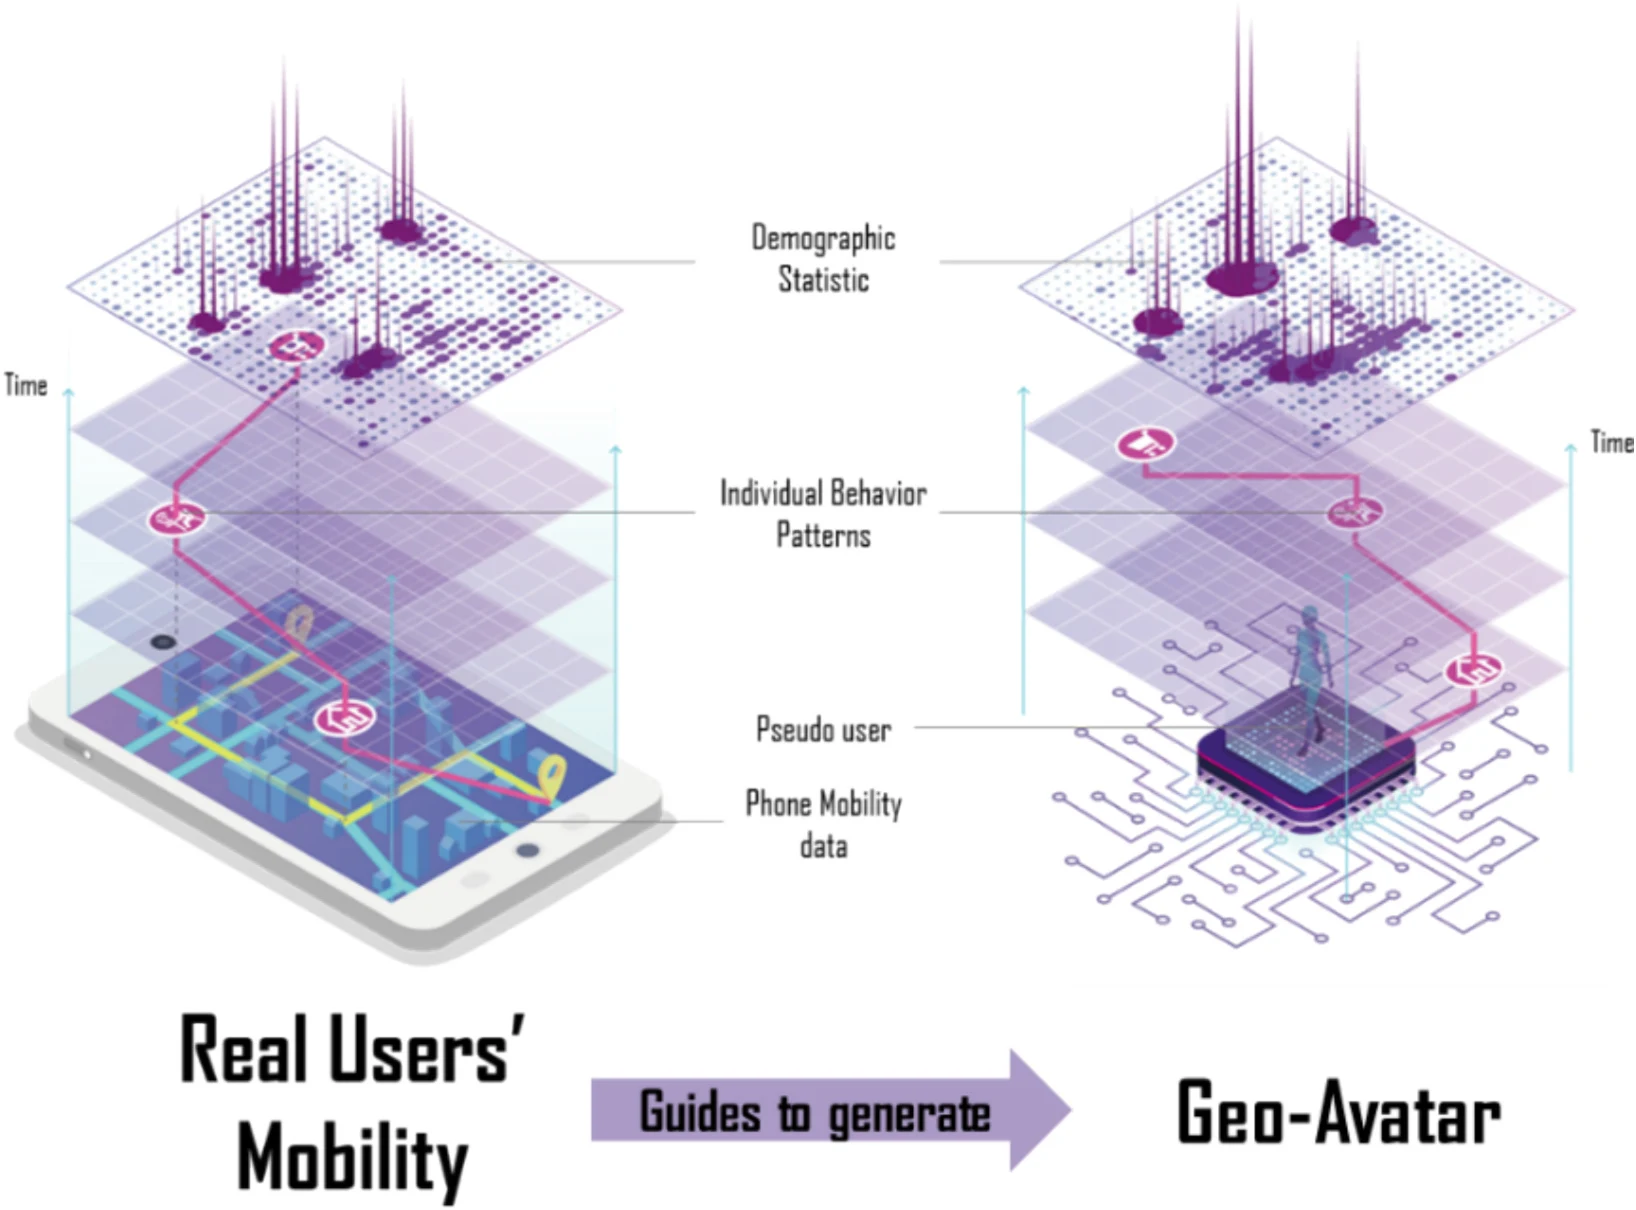
图 1|真实用户的移动,怎样被收成一个伪个人生成器?
无字母子图。上方是许多用户的轨迹示意;中间三块分别标着人口统计、个体行为模式,以及伪用户与手机移动数据。底部箭头从真实用户的移动指向 Geo-Avatar,中间写着由这些模式引导生成。这是框架示意图,不是评估散点,也不能从中读出准确率。来源:原论文 Fig. 1。
生成分成四段。训练阶段用原始手机 GPS 把各模块训好;图注写生成阶段不再需要新的输入,意思是抽样时不必再喂一条真实用户轨迹。生成器仍然来自已经见过的那座城市的数据,不能理解成无需任何城市数据就能凭空造出当地出行。
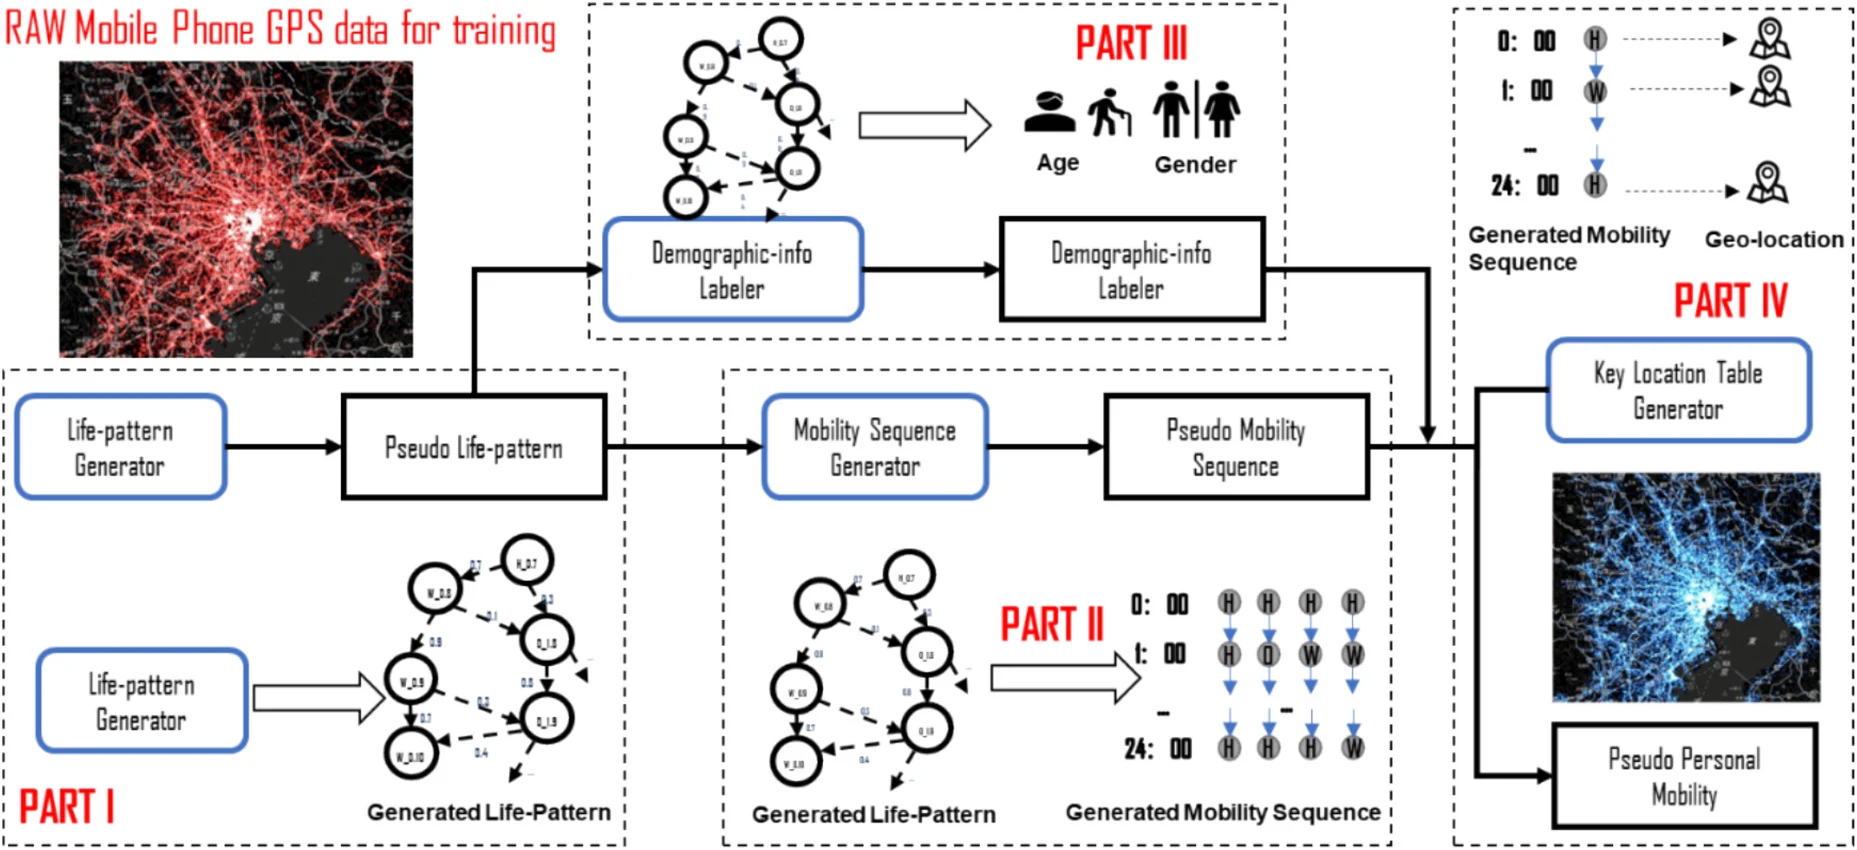
图 3|四个模块怎样串成一次伪个人生成?
无(a)(b)字母,图内部分为 Part I 至 Part IV。(Part I)生活模式生成器把原始手机 GPS 学成伪生活模式图。(Part II)在这张图上行走,得到伪移动序列;图中还画出可选的序列细化。(Part III)人口属性标注器从生活模式给出年龄和性别。(Part IV)关键地点表生成器把属性映射到地理地点,得到伪个人移动。左侧输入是训练用的原始 GPS,右侧输出是生成的移动和地理落点。来源:原论文 Fig. 3。
序列这一步是在个人的生活模式图上行走。另有一个可选组件,图引导的行走(Graph-walk With a Guide,GWG):用深度学习修正采样概率,让序列更贴真实节奏。正文把主结果称为 GeoAvatar,没有单独列出打开或关闭 GWG 的指标,因此后面的数字不能拆成“有 GWG”和“无 GWG”两套。
人口属性标注不用个人真实的年龄和性别。东京 GPS 本身也不含姓名、年龄和性别。作者用元图表示生活模式,投到低维特征,再用变分推断(论文原文写作 variation inference)结合普查做贝叶斯标注。关键地点表则按推断出的年龄和性别,用贝叶斯方法为伪个人选择地点,用来代替只靠随机探索的优先返回。正文没有报告年龄、性别分对了多少,也没有做一个去掉这一模块的对照。所以后面的活动误差和网格 R²,不能单独记到人口属性模块头上。
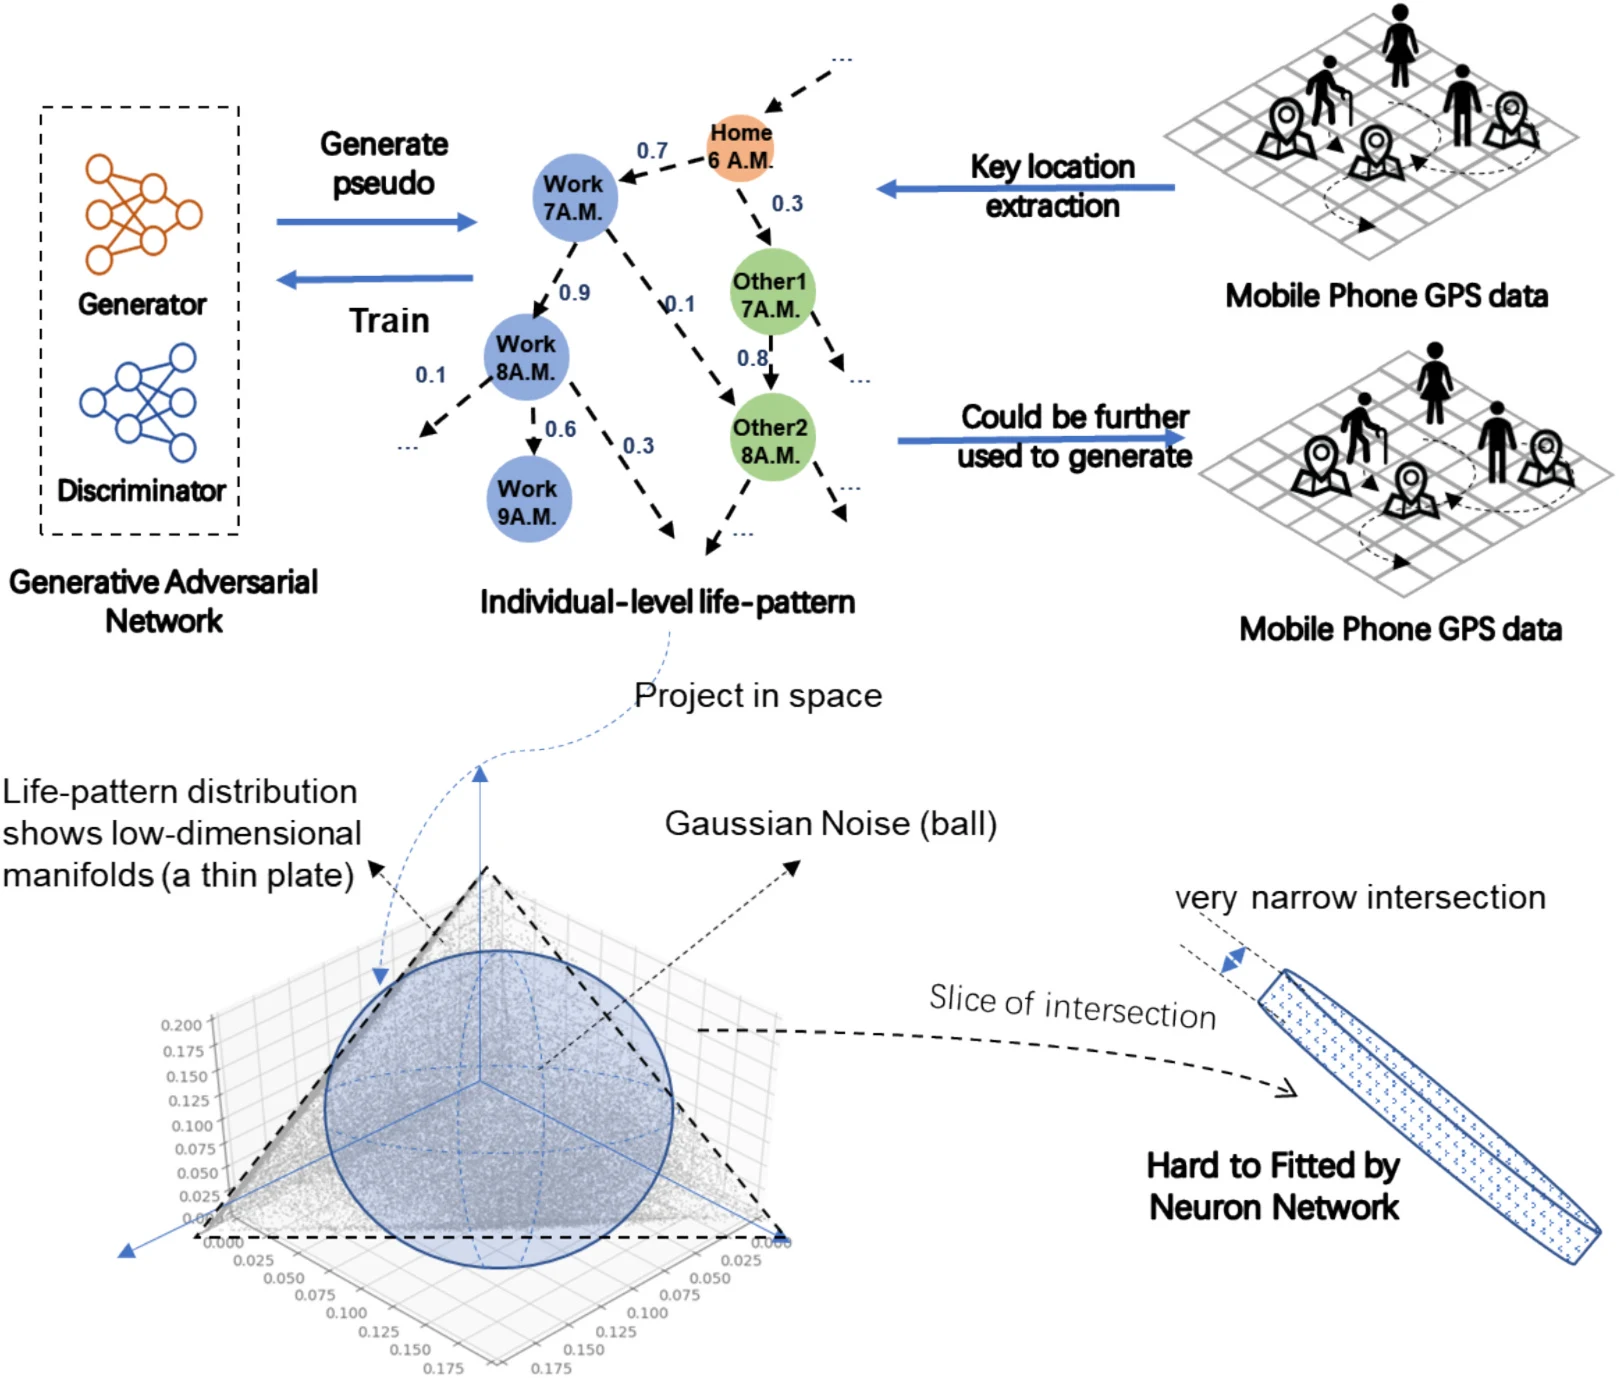
图 4|为什么普通生成模型难画出这种生活图?
无字母子图。左侧是生成器和判别器;中间是一张个体生活模式图,家、工作地和其他地点之间画着转移;右侧是从手机 GPS 抽出关键地点,再放回人群。下方把生活模式的分布画成高维空间里的薄片,高斯噪声是一个球,二者只有很窄的相交,因此普通神经网络难拟合。图上的 0.7、0.3 这类小数是示意的转移概率,不是全文估计出的参数。来源:原论文 Fig. 4。
拿什么数据,跟谁比?
东京用 NTT DOCOMO 应用在用户同意下采集、再经汇总以隐藏个人信息的 Konzatsu-Tokei (R)。原始定位是大约最短 5 分钟一次的 GPS,不含姓名、年龄和性别,预处理后不能连回某部手机。全国约 235 万手机用户、116.7 亿条 GPS 记录;本文取家在东京都市圈的 74,693 人,时间为 2013 年 1 月 1 日至 7 月 31 日,论文记为 211 天。
上海用联通数据,含用户编号、时间和位置。2022 年 6 月至 8 月的可用记录超过 6 亿条,平均每天 2100 万条,对应约 700 万用户的 1300 万次活动。出于计算成本,研究从中随机抽取 10 万用户。图 7 把上海标为通话详单(Call Detail Record),把东京标为手机 GPS。两边的年份、采样方式和空间精度都不同,同一套 R² 不能被读成两座城市的测量误差相同。
基线是改进后的 TimeGeo 类模型。作者认为原 TimeGeo 的参数拟合误差会限制机制模型的真实感,于是提出全真实参数显式建模(Full-true-parameter Explicit Modeling,FEM):把真实的个体参数放进去,用来逼近机制路线在理论上能达到的上限。参数定义在补充材料第 3、4 节,正文没有列出参数名称。这个设计的含义是:如果 GeoAvatar 仍然更好,差距就不只是“对方的参数估偏了”。FEM 已经看到了真实个体的时间选择参数。
作者声明不能公开分享数据。补充材料网页与论文 DOI 相同,但模型结构、FEM 参数和 KS 的计算细节都不在这 12 页正文里。
宏观上像不像人类移动的常见分布?
人类移动性在统计上常呈现两种形态:连续地点之间的跳跃距离,以及一天之内访问的地点个数。作者用 KS 统计量比较生成分布和真实分布。它回答“两条分布差多远”,不回答“某一小时的人数对了百分之几”。
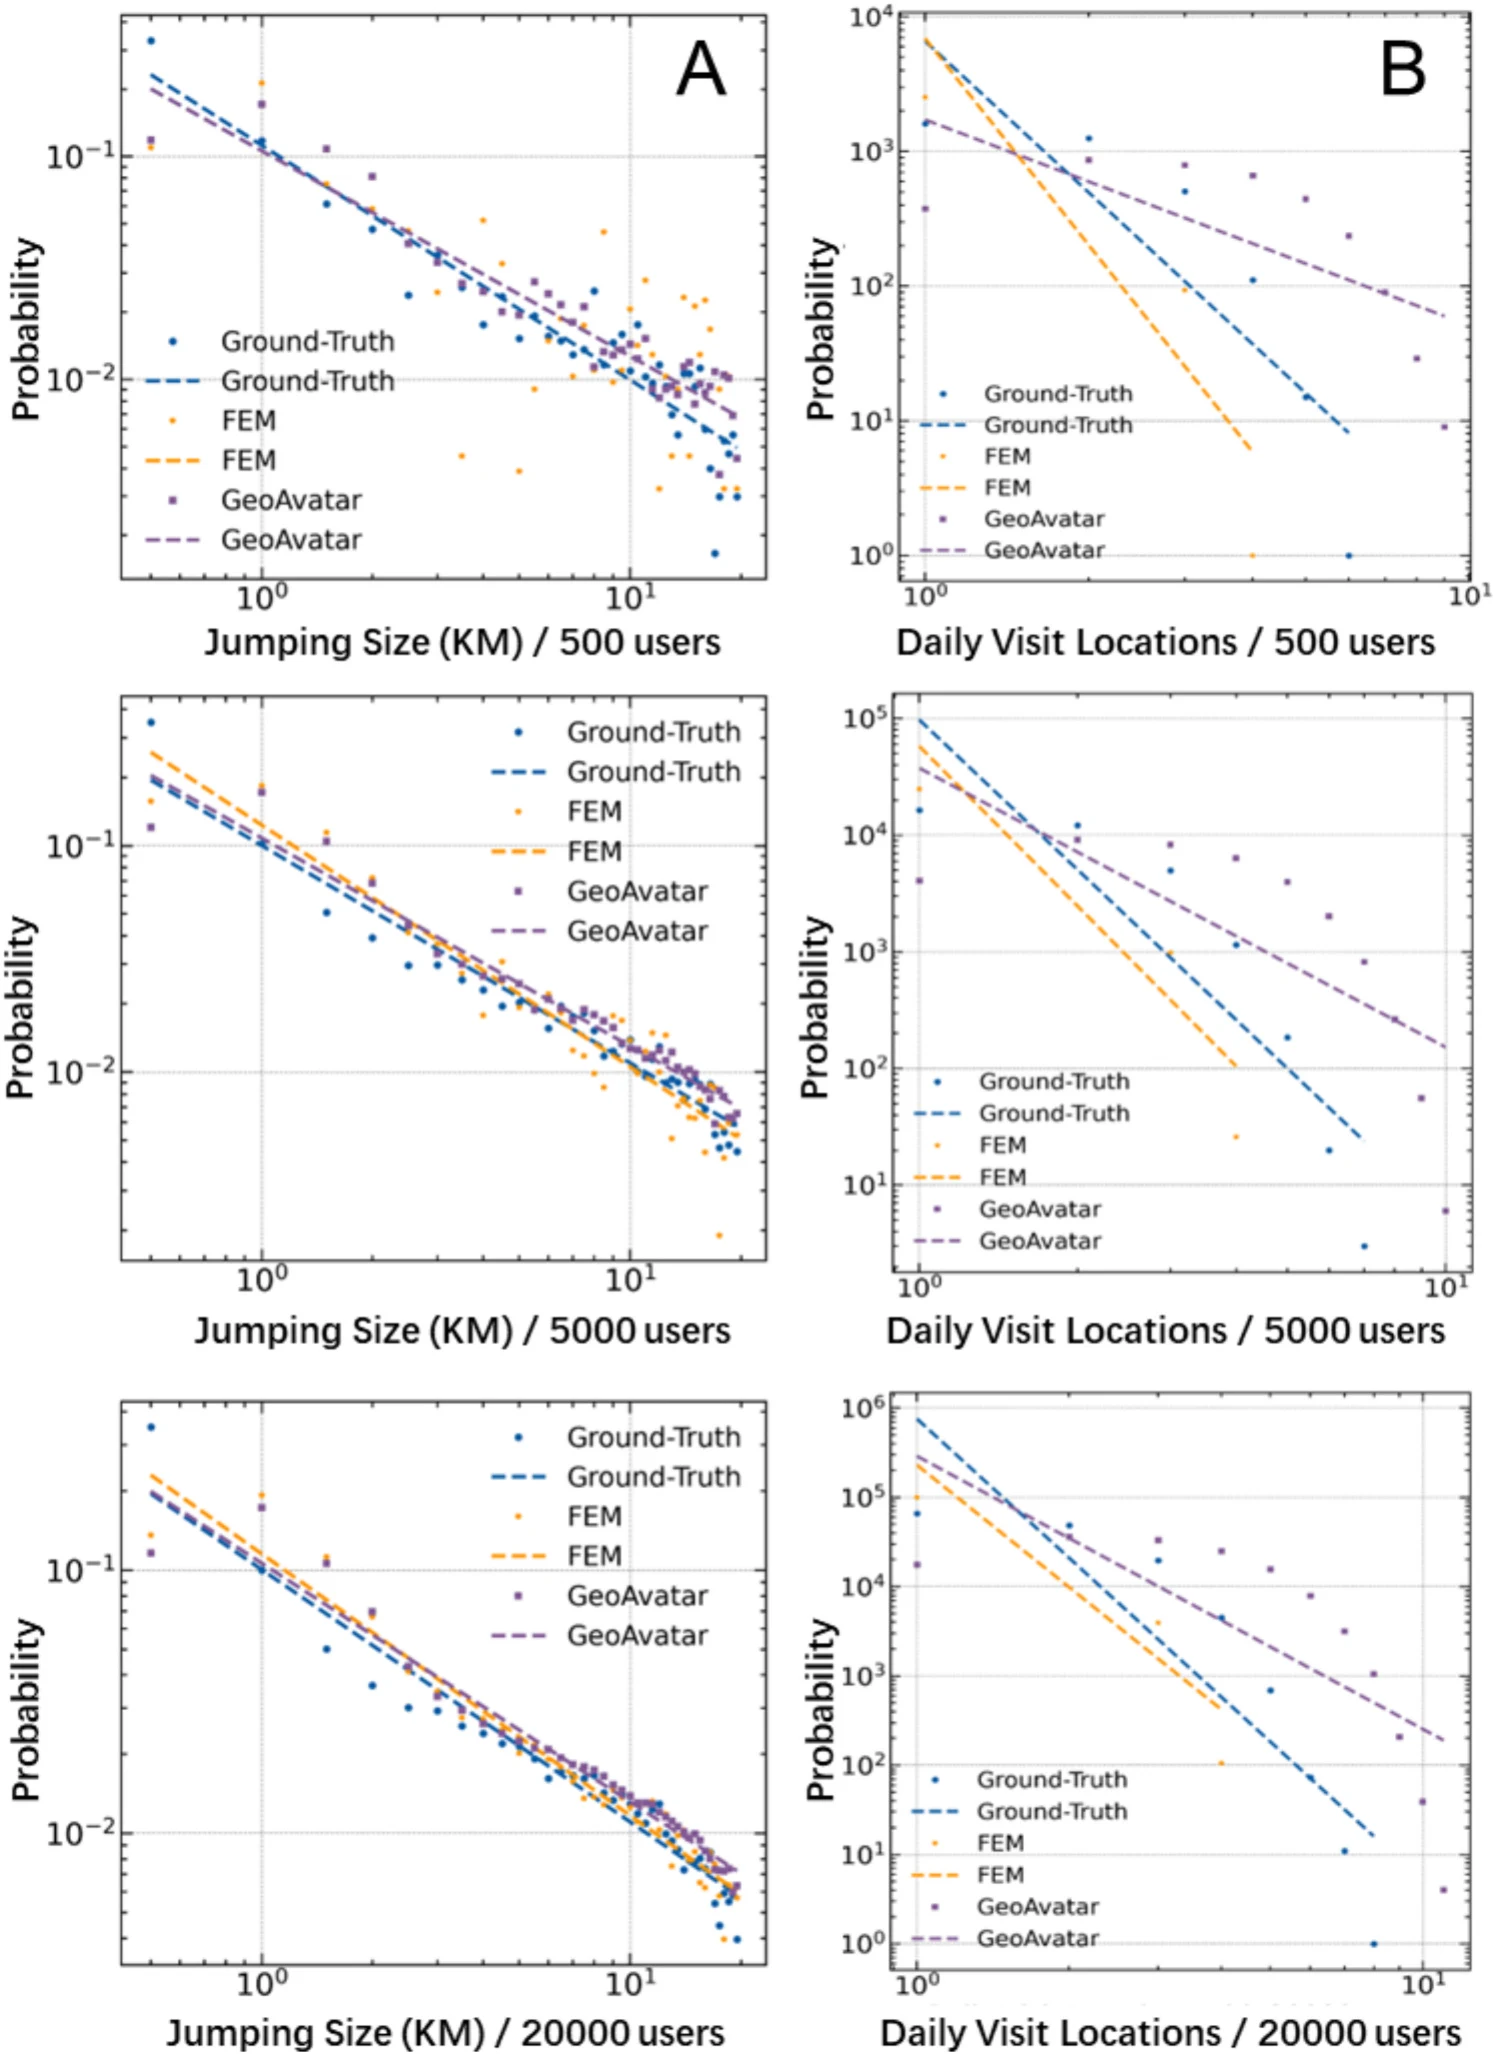
图 5|生成数据是否还服从跳跃距离和单日地点数的分布?
(A)跳跃距离,单位是千米,横轴和纵轴都是对数坐标,纵轴标为概率。三行样本分别为 500、5000、20000 名用户。散点中有真实数据、FEM 和 GeoAvatar,并配有拟合线。三条样本上,长距离都更少,三条曲线大体沿同一下降方向。(B)一天访问的地点数,同样三档样本量,纵轴标为概率。地点数增加时概率下降;GeoAvatar 的拟合线在右端往往高于真实数据和 FEM,也就是更多概率留在“一天去很多地点”的一侧。来源:原论文 Fig. 5。
正文给出的 KS 没有按这三档样本量拆开,图上也没有逐格标出 KS:跳跃距离上 GeoAvatar 为 0.217,FEM 为 0.198;一天地点数上 GeoAvatar 为 0.440,FEM 为 0.238。论文认为二者没有明显性能差距,并写 GeoAvatar 略弱、仍然可比。这里没有另给两种 KS 之差的检验。从数值看,FEM 两次都更接近真实分布,第二天的差距大约是第一天的数倍。图 5 和图 6 都没有标城市,因此这组物理规律数字不能写成东京、上海各一份。
这个结果合乎 FEM 的构造。它使用真实个体的时间参数,又带有会自然产生重尾移动的探索与优先返回机制。GeoAvatar 没有把这条宏观定律写进生成器,从伪个人往上叠,仍然能走出下降的跳跃距离分布。能走出下降趋势,不等于它在 KS 上赢过 FEM。结论里把第二项写成停留时长,图 5B 和 5.1 节写的是一天访问的地点数。比较应以图和结果节为准。
一天里的活动,谁更接近真实节奏?
活动特征看的是人随时间待在哪一类关键地点。作者从三个口径比:全体平均、按小时的分布、以及每个人一张生活模式图的分布。
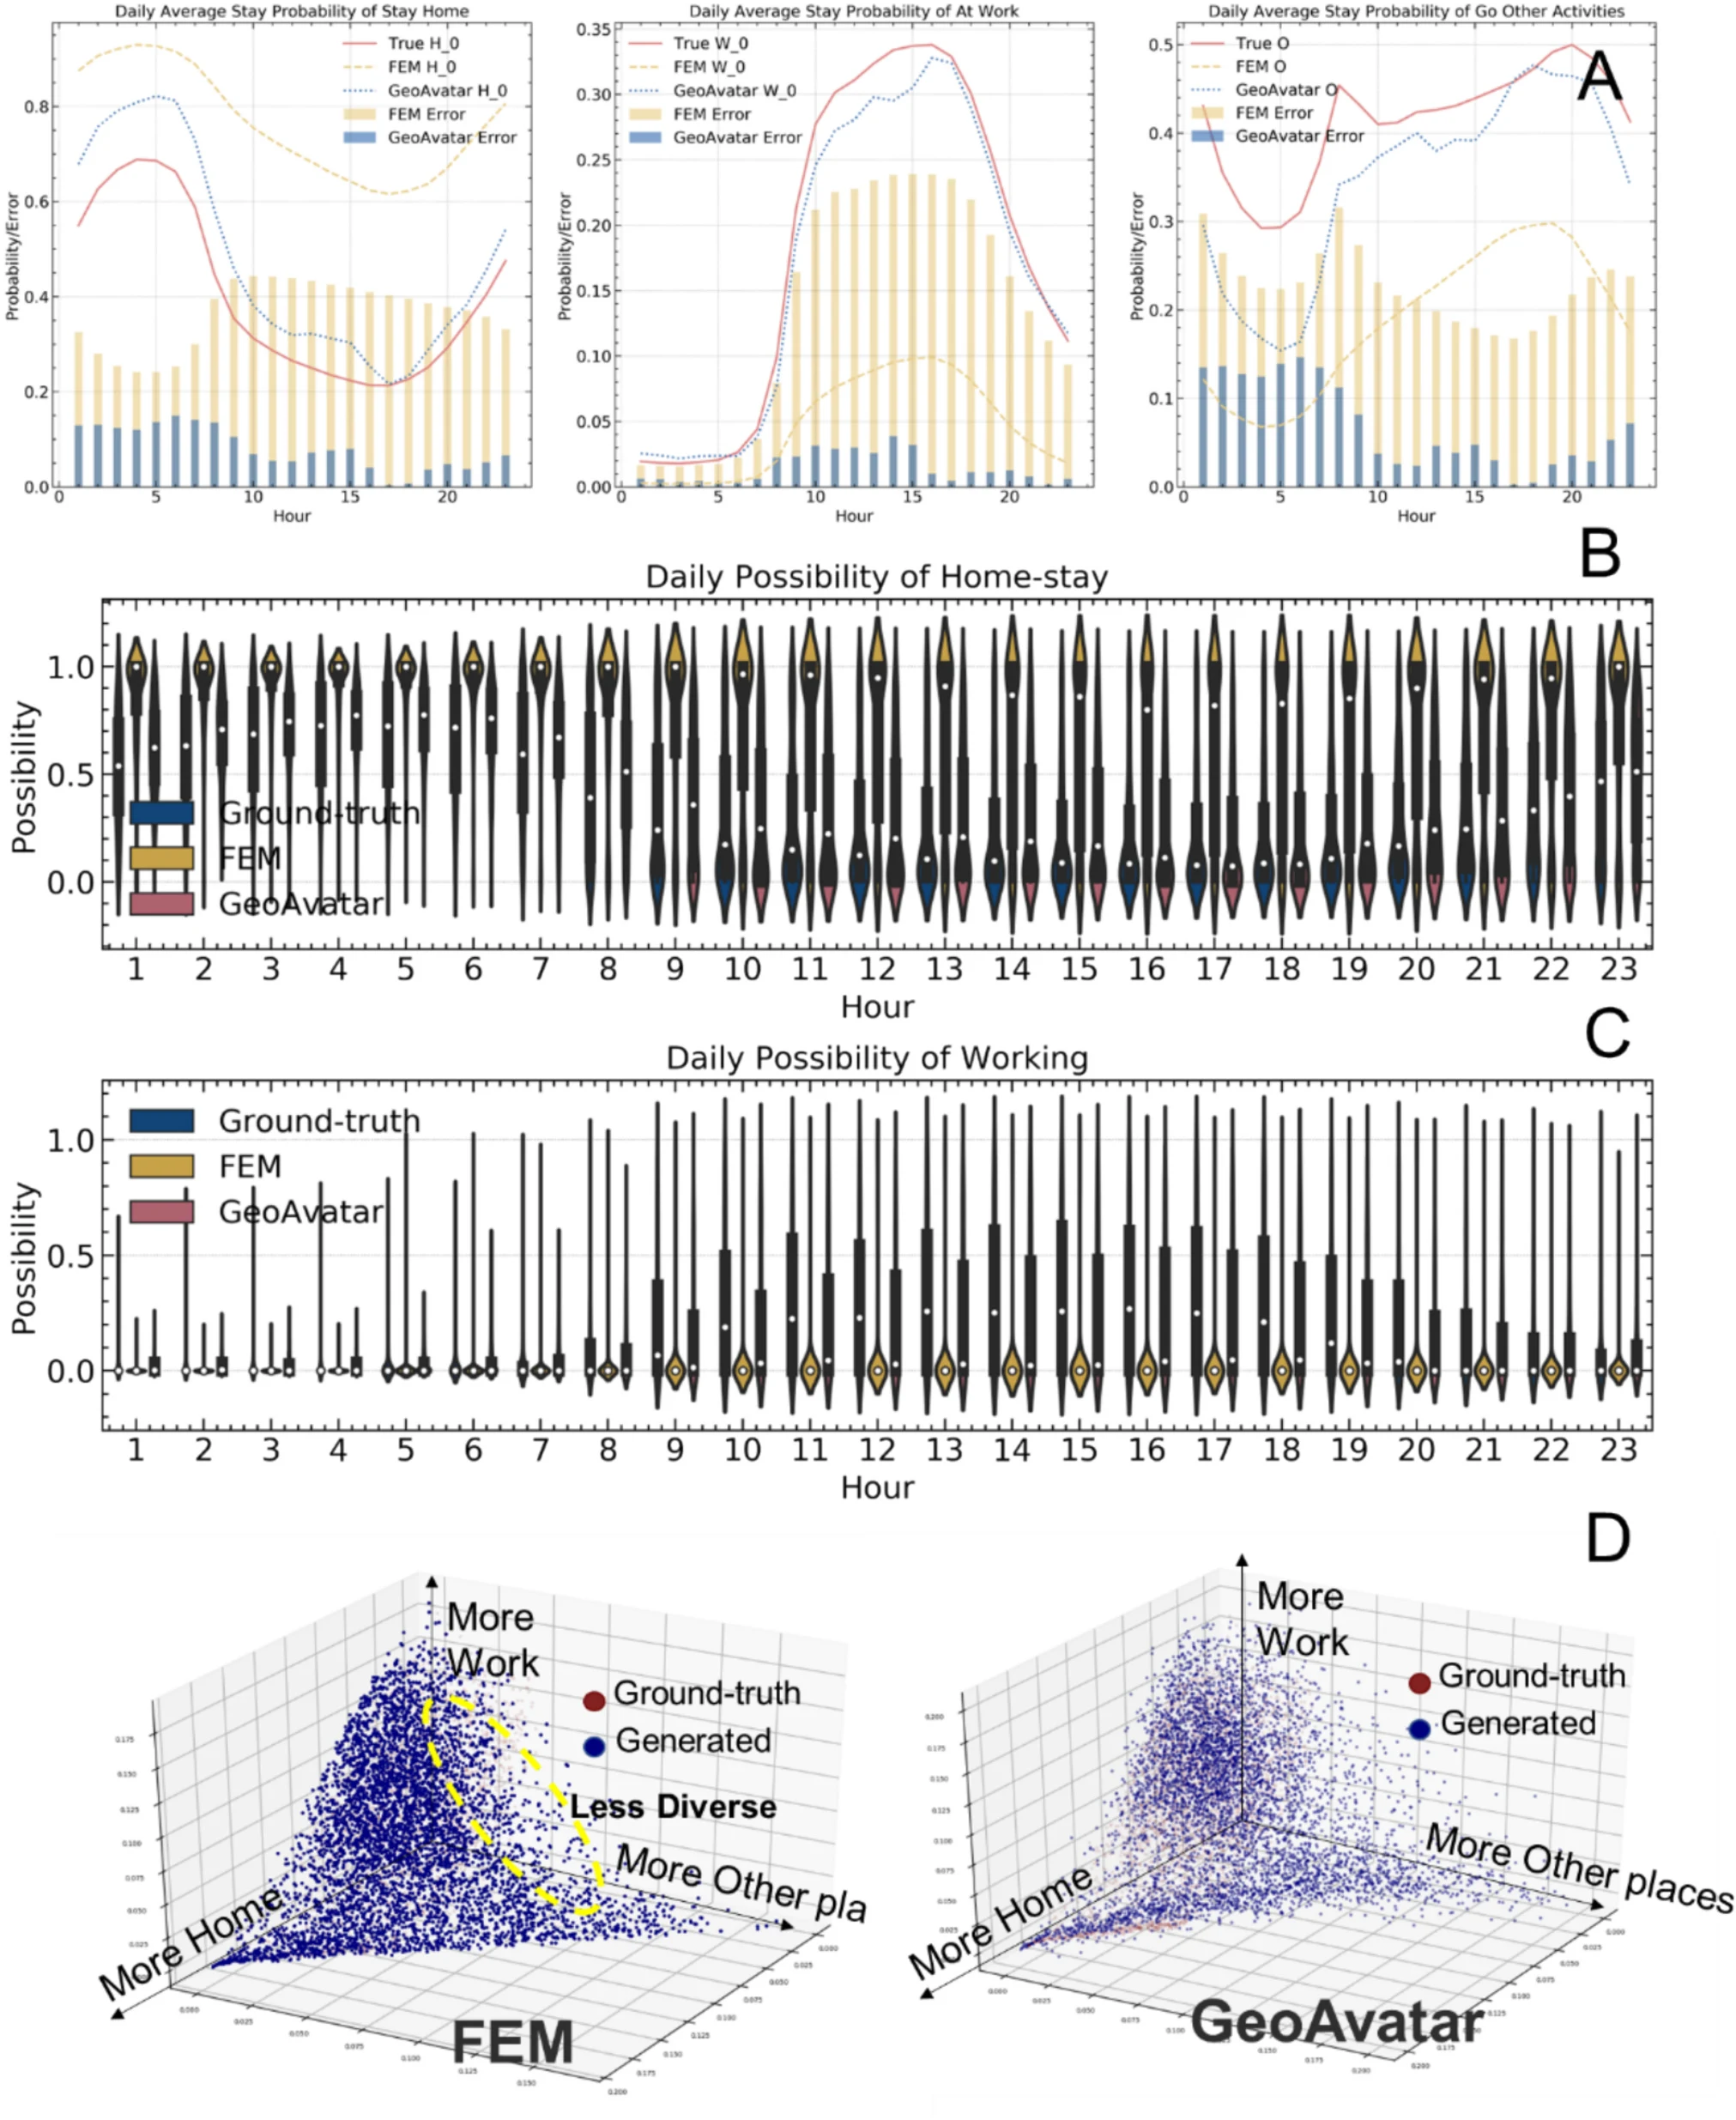
图 6|在家、上班和其他地点的概率,差在平均、小时还是个人?
(A)三块小图从左到右是在家、全部工作、以及其他活动中最常见的一类。横轴是 0 至 23 时,纵轴是停留概率;曲线比较真实、FEM 和 GeoAvatar,柱状是逐小时误差。GeoAvatar 的曲线更贴真实曲线,FEM 在在家和上班上更容易偏高。(B)在家概率的小时分布,小提琴图,横轴为小时,纵轴为概率,图例为真实、FEM、GeoAvatar。(C)上班概率,画法与(B)相同。论文说这两张图对应最常见的两类活动,并给出按小时分布的 JS 散度:GeoAvatar 0.0356,FEM 0.0972。(D)用非负矩阵分解把每张生活模式图投到三维,轴的方向标成更多在家、更多工作、更多其他地点。左为 FEM,右为 GeoAvatar;红点为真实,蓝点为生成,一点代表一名用户的一张生活模式。FEM 在“更多其他地点”一侧更空,GeoAvatar 与真实点云重叠得更开。来源:原论文 Fig. 6。
全体平均的口径是活动概率的平均绝对误差。GeoAvatar 的整体 MAE 为 4.54%,FEM 的平均 MAE 为 15.9%。论文用了整体和平均两个词,没有进一步说明二者的样本是否完全同一批小时。分母是生成与真实的平均活动概率之差,不是用户人数。论文把 FEM 的偏高归到长尾:不保留少见活动,在家和上班的概率会被抬高。图 6A 的误差柱与这一说法同向,主文没有逐小时抄出误差。
个体分布再用 JS 散度:GeoAvatar 相对真实生活模式为 0.047,FEM 为 0.075。注意比较的不对称:GeoAvatar 用的是生成出来的生活模式图,FEM 用的是真实参数。在这种对照下,生成图的分布仍然更近。散度没有写明对数底,这里只比较论文给出的数,不换算成比特。
叠回城市以后,网格人数和起讫量还对得上吗?
城市研究更常用聚合人流。作者用两组 R²:每小时网格人口,以及每小时起讫计数。做法写在分城结果之前:从真实数据里随机抽取 6 万名用户的一周轨迹,拆成真实组 1 和真实组 2,各 3 万人;再用提出的方法和基线各生成 3 万人的 7 日轨迹;把轨迹汇总到网格,算每小时网格人口和每小时起讫量,对真实组做 R²。上海一节用同样的实验接上,没有单独重申是不是另一个 6 万人。图的两列说明两座城市都做了这种散点比较。网格边长的单位,主文没有在这一实验里定义。
自然波动是真实组 1 对真实组 2。它给出一个参照:只换一批真实用户,聚合计数会自己抖到什么程度。GeoAvatar 或 FEM 对真实组 1 的 R² 若低于这个参照,就不能说生成数据已经达到真实样本之间的一致程度。R² 略高于参照,也不表示生成数据比真实更真,因为配对的两组人不同,千分位上的差别没有被论文做成检验。
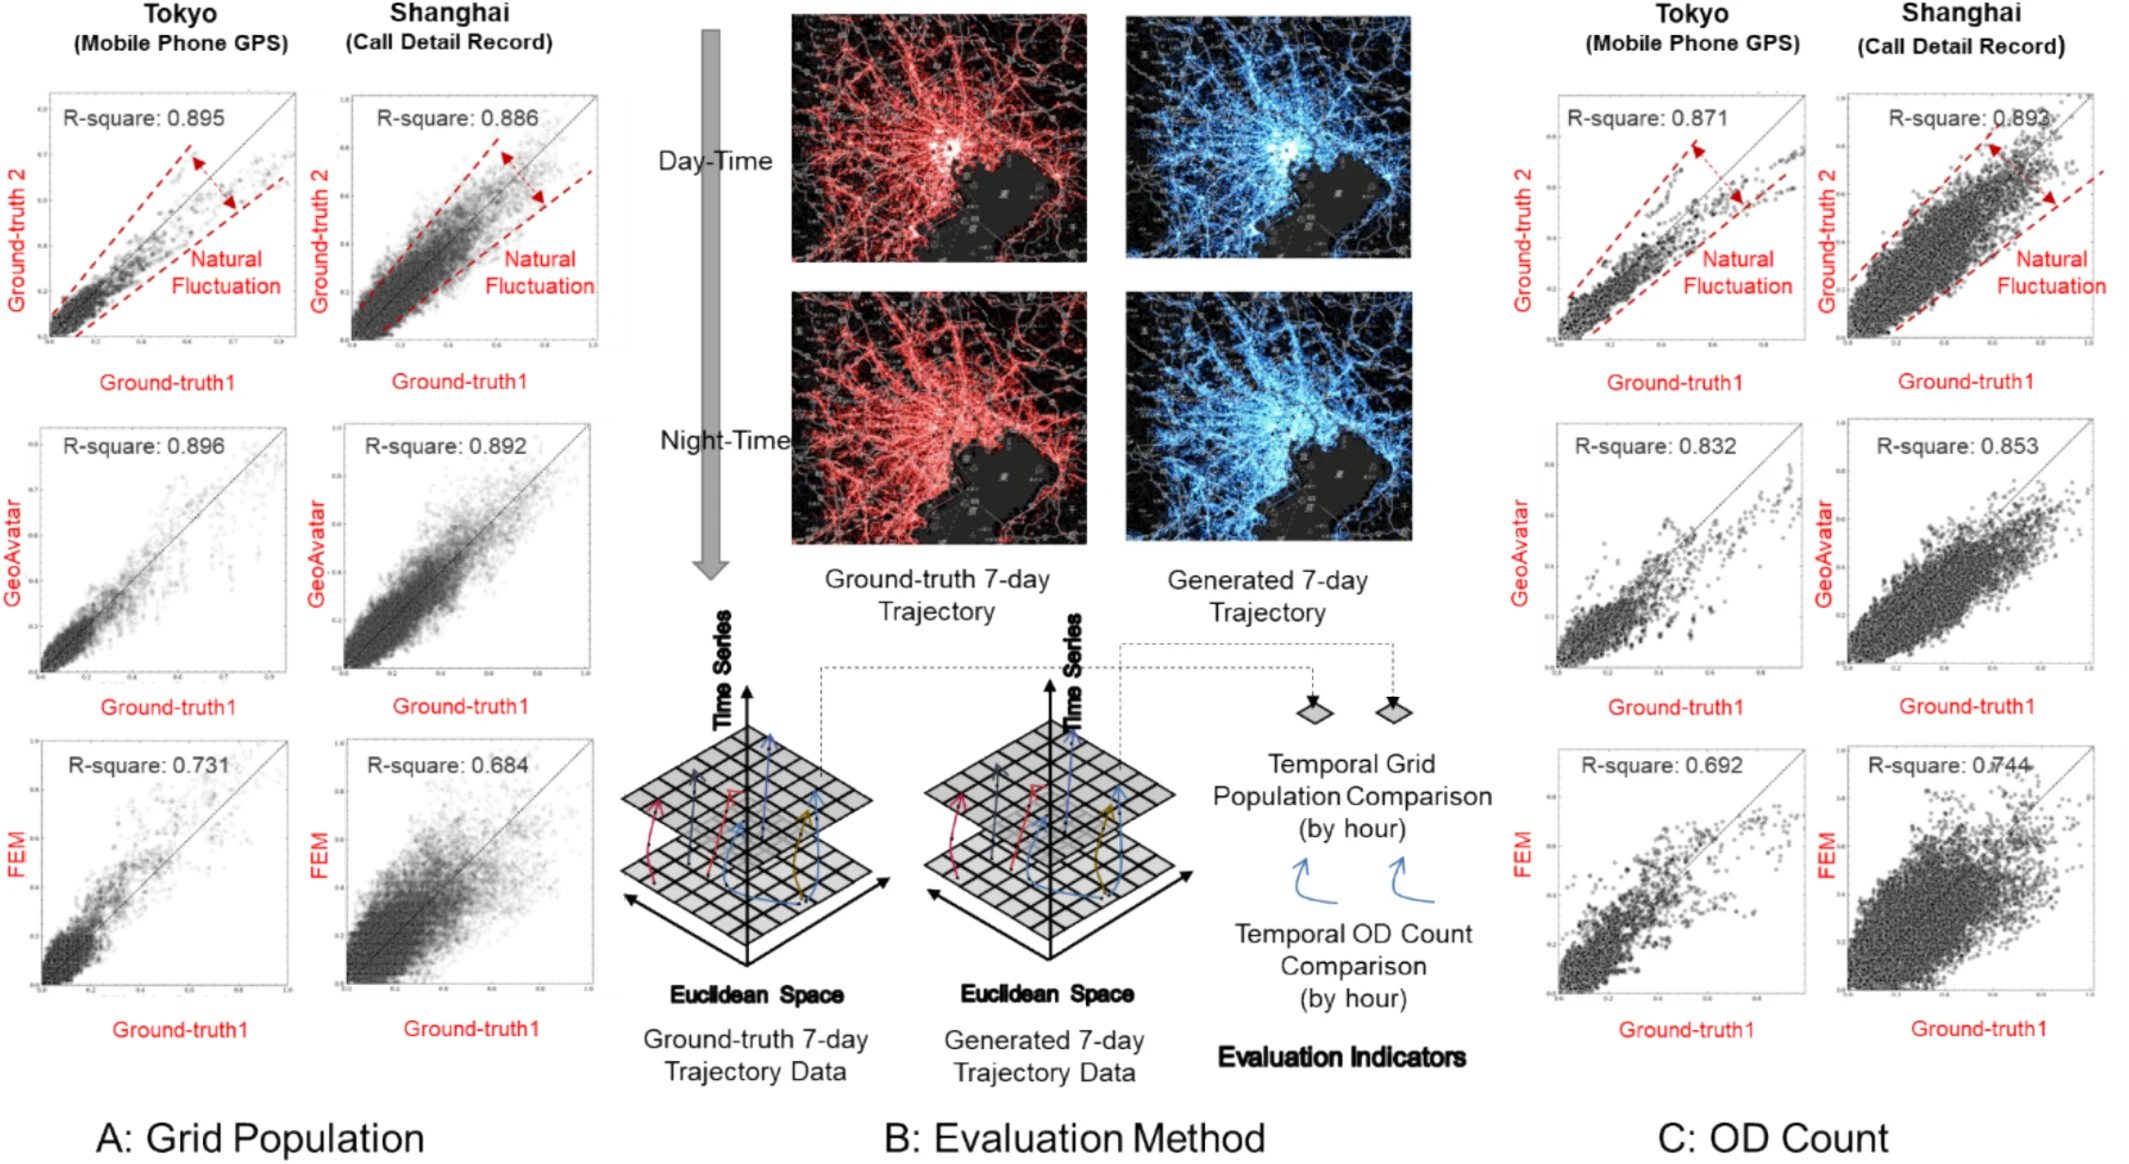
图 7|小时网格人口和小时起讫量,离两半真实数据有多远?
(A)网格人口散点。左列为东京手机 GPS,右列为上海通话详单。上排是真实组 2 对真实组 1,标为自然波动;中排是 GeoAvatar 对真实组 1;下排是 FEM 对真实组 1。横轴为真实组 1,纵轴为对照序列,红字是该图的 R²,虚线标出散点带。(B)评估示意:7 日轨迹落到网格,分别比较逐小时网格人口和逐小时起讫量。中间地图是真实与生成轨迹的昼夜示意,不是第三套准确率。(C)起讫计数,行列与(A)相同。来源:原论文 Fig. 7。图中标注如下。
| 比较 | 东京网格人口 | 上海网格人口 | 东京起讫量 | 上海起讫量 |
|---|---|---|---|---|
| 自然波动:真实组 2 对真实组 1 | 0.895 | 0.886 | 0.871 | 0.893 |
| GeoAvatar 对真实组 1 | 0.896 | 0.892 | 0.832 | 0.853 |
| FEM 对真实组 1 | 0.731 | 0.684 | 0.692 | 0.744 |
每一格的分母都是“网格 × 小时”的计数对,一组 3 万人、7 天,不是 3 万这个人数,也不是全城常住人口。东京网格人口上,GeoAvatar 的 0.896 与自然波动的 0.895 只差 0.001;上海网格人口上,0.892 略高于自然波动的 0.886。起讫量上,东京 GeoAvatar 为 0.832,低于自然波动 0.871;上海为 0.853,低于 0.893。FEM 在四列都明显更低,东京网格人口 0.731,上海 0.684,东京起讫 0.692,上海 0.744。
5.3 节正文另外写了一组数字。它把东京写成:网格人口的自然波动 0.886、GeoAvatar 0.892、FEM 0.684;起讫量 0.893、0.853、0.744。下一句把上海也写成同一组数。这组数与图 7 的上海列一致,与东京列不一致。读东京应以散点图上的标注为准,不应再把正文里重复的那一组当成东京的独立测量。两座城市的方向仍然相同:网格人口上 GeoAvatar 靠近自然波动,起讫量上低于自然波动,FEM 更远。
论文把 FEM 的落后解释为:少数关键地点就能重建一大部分移动,但丢掉长尾会从活动生成一路传到地点选择,误差在聚合人流上显现。图 2 确实显示长尾影响还原误差,图 7 也显示 FEM 的 R² 更低。中间那条“每一步都由长尾造成”的传递,主文没有逐步分解。
这些比较能说到哪一步?
GeoAvatar 展示的是一条生成路线:异构的生活模式图,加上普查约束下的人口属性,再加上按属性选地点,可以在不把宏观定律写死的情况下,仍走出下降的跳跃距离,并在活动概率和小时网格人口上接近真实数据。FEM 说明,把真实个体参数放进统一机制,更够用的是宏观分布,不够用的是活动多样性和聚合起讫。
几条边界要留在结果旁边。相关和拟合都不是因果,生成出的伪个人也不是被跟踪的真人。KS、JS、MAE 和 R² 回答的是分布或聚合计数,没有对某一位真实用户逐小时对齐。图 5 的 KS 没有分城市、分样本量。人口属性没有准确率,GWG 没有单独成绩。图 7 的正文与东京标注不一致,使用东京数字时应引用图注。周末和节假日的不规则移动、尤其是长距离出行,作者写明因时间所限没有纳入。兴趣点带来的更细活动目的、交通方式和下游任务,都列在之后的工作里。作者也没有报告成员推断或重新识别实验,因此“生成数据能保护隐私”仍是任务动机,不是这篇正文已经测过的结果。生成阶段不再输入新轨迹,只说明抽样时不需要另一条真实轨迹;训练仍然用了真实手机数据。
框架被写成可以再接兴趣点和交通方式,也可以比端到端黑箱更容易换地区,因为换地区不必把整条轨迹生成网络从头训一遍。正文的证据是东京 GPS 和上海详单都能跑通同一套比较,而且图 7 的方向一致。它还没有给出第三座城市、或同一批人换一季数据的外部测试。
一句话总结
先为每个人生成一张不同的生活模式图,再落到地点,小时网格人口可以接近两半真实用户彼此的相关;已经吃进真实个体参数的统一机制更贴近跳跃距离和单日地点数,但活动构成和起讫流量差得更远。
核心来源
- Computers, Environment and Urban Systems 正式页面,核对题目、作者、卷期、在线日期与数据可用性。正文为 2025 年第 119 卷文章 102252。作者写明不能公开分享数据。补充材料挂在同一 DOI 下。
- 本文图像为正式 PDF 的 Fig. 1 至 Fig. 7。图 7 的分城 R² 以各散点图标注为准;5.3 节正文把两座城市写成了与上海标注相同的一组数。
作者介绍
以下只采用论文署名单位和 CRediT 贡献,不补充论文未写明的职务。
- Peiran Li:东京大学信息学环。承担初稿、可视化、验证、软件、方法与调查。
- Haoran Zhang:通讯作者,LocationMind Inc.(东京),邮箱 zhang_ronan@locationmind.com。承担指导、资源、项目管理、资助与构思。
- Wenjing Li:LocationMind Inc.,以及东京大学空间信息科学研究中心(千叶)。承担方法、形式分析与数据整理。
- Dou Huang:LocationMind Inc.。承担可视化、软件、调查、形式分析与数据整理。
- Zhiling Guo:香港理工大学建筑环境及能源工程学系。承担资源与调查。
- Jinyu Chen:东京大学信息学环。承担软件与调查。
- Junxiang Zhang:香港理工大学建筑环境及能源工程学系。承担可视化、软件与方法。
- Xuan Song:吉林大学人工智能学院。承担指导与资源。
- Pengjun Zhao:北京大学城市规划与设计学院(深圳)。承担审阅、验证与资源。
- Jinyue Yan:香港理工大学建筑环境及能源工程学系。承担审阅与资源。
- Shibasaki Ryosuke:论文按此姓名顺序署名,单位为东京大学信息学环与 LocationMind Inc.。承担指导、资源、项目管理、调查、数据整理与构思。
- Noboru Koshizuka:东京大学信息学环。承担项目管理与指导。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若把这套伪个人数据用于估计最挤的起讫对,图 7 的起讫 R² 比网格人口更该先看。东京起讫上,GeoAvatar 是 0.832,两半真实用户是 0.871;上海是 0.853 对 0.893。网格人口已经贴着自然波动,起讫仍低大约 0.04。一个只核对“每小时每个网格有多少人”的情景,会觉得生成城市已经够用;一个核对“人从哪到哪”的情景,仍然比真实样本之间的波动更散。论文没有把误差按距离或按流量大小拆开,所以还不知道差的是短途重复出行,还是少数大流量走廊。
另一个可检验的问题出在人口属性。手机数据里没有年龄和性别,模型却用生活模式去对齐普查,再按推断出的属性选地点。若普查里某一年龄段更集中住在某些地区,地点选择就会把这种集中写进伪个人,即使没有任何一条 GPS 标明年龄。这能让聚合后的居住分布更像普查,也会让人误把伪个人身上的年龄当成某部手机的事实。论文没有报告推断准确率,因此在用年龄做分组之前,需要单独的、不泄露个人的核对方式。
前三个重要地点就能还原 90% 静态人口,还带来一个和生成相反的提醒。想重建一座城市的小时人数,攻击者或数据使用方未必需要完整轨迹,家、工作地和另一个常去地点已经覆盖大部分网格人口。生成替身没有取消这一事实:训练生活模式图时,这些地点仍然来自真实停留。若目标是降低可识别性,下一步应直接测量一个伪个人能否被连回训练集里的某人;只报告聚合 R² 还没有回答这件事。