市镇之间的人流,真需要比重力模型复杂得多吗?
论文名片|Oriol Cabanas-Tirapu、Lluís Danús、Esteban Moro、Marta Sales-Pardo、Roger Guimerà,Human mobility is well described by closed-form gravity-like models learned automatically from data,Nature Communications,2025,16:1336。2023年12月14日收稿,2025年1月21日接收,2025年2月4日在线发表。DOI:10.1038/s41467-025-56495-5。
要估计两个市镇之间一周有多少人从甲地到乙地,最省事的算法只看两边人口和距离:人越多、离得越近,流量越大。这就是引力模型(gravity model,也常叫重力模型)。另一端是深重力模型(Deep Gravity)和随机森林,它们可以吃进商店、道路、学校等一共 39 个特征。特征一多,预测往往更贴数据,公式却读不出来。
这篇论文把公式形式交给贝叶斯机器科学家(Bayesian machine scientist,BMS)去搜索。搜索时不预先指定“人口相乘再除以距离的幂”。结果仍反复出现类引力结构。在市镇这一聚合尺度上,只用起点人口、终点人口和距离的闭式公式,总体可以追上使用 39 个特征的模型;换到没参与搜索的州,重新拟合参数后依然站得住。
先说结论
- 六个训练州、四项指标,共 24 次比较。最可信的 BMS 模型在其中 21 次优于深重力,相对随机森林是 13 次更好、11 次更差。六个州平均后,BMS 与随机森林在四项指标上无法区分,并在相对误差和绝对对数比上优于深重力。
- 对 105 个采样公式做人工分类:约 17% 只含类引力项,约 70% 含类引力项以及其他项,约 13% 完全没有类引力项。先验并没有偏向引力形式。
- 大约少于 100 人的流量上,幂律引力、辐射模型和深重力会系统性低估,有时估到不足 1 人。BMS 和随机森林把从很小到很大的流量都跟得更齐。
- 纽约州 25 km × 25 km 方格内的普查区流量上,无论哪一项指标,BMS 都是参与比较的模型里最好的。
- 公式固定、只在佐治亚、伊利诺伊、密歇根、北卡罗来纳、俄亥俄、宾夕法尼亚重新拟合参数后,表现与原来六个州相近;相对随机森林,四项指标里有三项显著更好,另一项无法区分。
- 把 39 个特征都交给 BMS,最可信公式仍然是“起点因子 × 终点因子 / 距离的增函数”。它常常略好于只含人口的类引力模型,差别没有统计显著性。市镇尺度上这些特征彼此高度相关。
这里比较的是非零的市镇间周流量
人类移动性(human mobility)在这里不是一个人一天的轨迹,而是市镇之间的聚合流量。原始材料来自 Kang 等人整理的美国普查区周流量:2019年1月7日至13日一个星期,以及2019年3月4日至9日一个星期。记录来自位置服务应用里的匿名手机轨迹,不区分交通方式;表中同时有 SafeGraph 估计的访客数,以及由访客数推回的人口流量。Kang 等人曾把这套数据与美国社区调查通勤流等资料对照,相关高于 90%。那是数据论文里的核对,不是本文新做的代表性证明。
市镇包括 city、town 和 village。两个市镇之间的流量,是它们所含普查区之间流量的加总。只保留人口不为零的市镇,以及流量不为零的市镇对;同一市镇内部的流动不进入模型。因此后面的分数只回答“已经观察到有人流动的市镇对,流量有多大”,没有回答“这两地之间会不会根本没人来往”。
训练用六个州:纽约、马萨诸塞、加利福尼亚、佛罗里达、华盛顿、得克萨斯。每个州把市镇分成两批。第一批市镇之间的流量构成训练折,再从中随机抽 1000 条,使各州在 BMS 的训练数据里权重相同;1000 这个上限来自市镇最少的州。第二批市镇之间的全部流量构成测试集。测试市镇的特征、市镇之间的距离,对训练好的算法都是新的。任何模型都拿不到市镇的地理位置,不能靠“训练点和测试点在地图上挨着”来抄近路。深重力模型使用比这 1000 条更大的训练样本,正文没有给出那个更大样本的条数。
| 州 | 训练条数 | 训练市镇数 | 训练流量最小–最大 | 测试条数 | 测试市镇数 | 测试流量最小–最大 |
|---|---|---|---|---|---|---|
| 纽约 | 1000 | 217 | 26–122,991 | 5952 | 249 | 20–35,063 |
| 马萨诸塞 | 1000 | 75 | 19–6,6946 | 1180 | 75 | 9–55,499 |
| 加利福尼亚 | 1000 | 260 | 14–91,267 | 11,727 | 319 | 2–41,6696 |
| 佛罗里达 | 1000 | 223 | 7–78,316 | 7092 | 245 | 3–79,624 |
| 华盛顿 | 1000 | 107 | 20–71,796 | 2083 | 109 | 12–54,245 |
| 得克萨斯 | 1000 | 177 | 21–192,660 | 2782 | 192 | 3–112,865 |
条数的分母是起讫市镇对,不是人数,也不是设备数。六个州的训练样本合计 6000 条;测试表列出的流量合计 30,816 条。训练表中的市镇数相加是 1,059,测试表相加是 1,189,这是各州分别计数。马萨诸塞训练和测试都列出 75 个市镇,对应的是两批不同的市镇。马萨诸塞训练集最大流量和加利福尼亚测试集最大流量,PDF 把千分位逗号印在数字中间,表中按原文照录。
距离用千米。训练对最近 1.83 km(纽约)、最远 1078.21 km(加利福尼亚);测试对最近 0.77 km(纽约)、最远 1,196.33 km(得克萨斯)。人口列是该集合里市镇人口的最小和最大:训练集从华盛顿的 20 人到纽约的 8.80×10⁶ 人,测试集从佛罗里达的 78 人到加利福尼亚的 3.9×10⁶ 人。
兴趣点来自 OpenStreetMap 的 18 类要素。随机森林和深重力使用 39 个特征:距离、起点人口、终点人口,以及这 18 类在起点和终点各一份。图7的说法与此相符:距离,加上 19 个起点特征和 19 个终点特征。
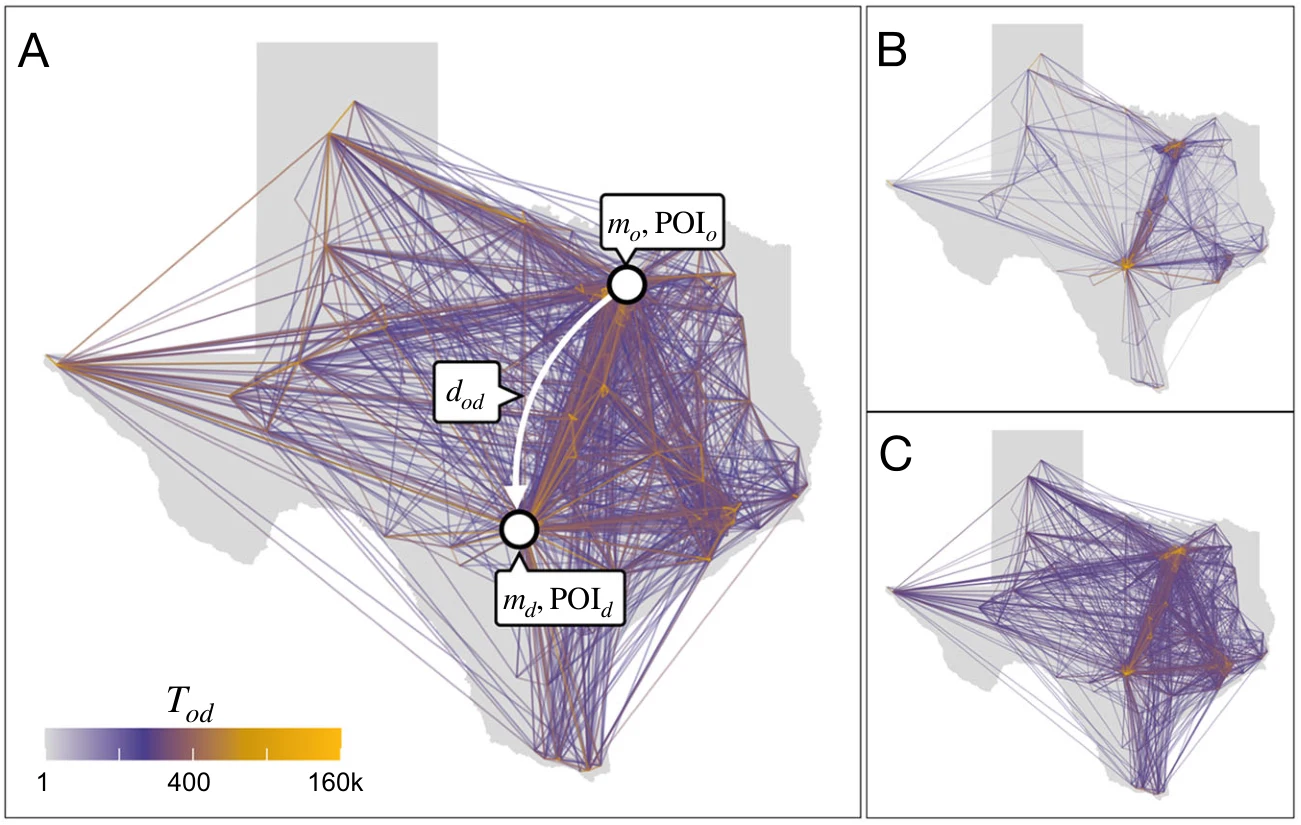
图 1|得克萨斯测试市镇之间,真实流量和两种预测长得像不像?
(A)测试集上的真实流量 Tod。颜色从 1 到 160k,中间刻度 400;连线两端标出起点人口与兴趣点、终点人口与兴趣点,以及距离 dod。(B)深重力模型的预测,用了起点和终点共 39 个特征。(C)BMS 中位预测模型的预测,只用两端人口和距离;图注指明它对应图6B。来源:原论文 Fig. 1。
同一批流量,为什么四种分数会选出不同赢家?
流量从个位数排到十几万,跨多个数量级。方法部分写流量跨五个数量级,所以把噪声加在对数上;图4则把六个州合在一起的观测流量画成六个数量级。模型比较的是 log Tod,而不是 Tod 本身:
log Tod = M(mo, md, dod;参数) + 噪声
噪声假定为无偏、高斯。在这个尺度上,把一个 10 人的流量估成 100 人,和把一个 10,000 人的流量估成 100,000 人,在对数上是同一档偏差。
因此论文同时看四个分数,而且明确它们偏向不同的流量。
通勤者公共部分(common part of commuters,CPC)是
2 × Σ min(预测, 观测) / (Σ 预测 + Σ 观测)
完全一致时为 1;每条预测都是 0 时为 0。分子分母都是全部测试流量之和,大流量占据绝大部分,小流量几乎不影响 CPC。名字来自通勤文献,这里的手机周流量并不只是居住地到工作地。
绝对误差是 |预测 − 观测|,随流量变大而变大,中位数主要反映常见流量,看不出全范围。绝对相对误差是 |预测 − 观测| / 观测,分母是观测流量。它惩罚高估;若观测大于 0 而预测为 0,这个分数等于 1,继续低估也不会再变大。绝对对数比是 |log(预测 / 观测)|。预测变成观测的 2 倍或 1/2,得到同一个值 log 2。高估和低估在对数尺度上对称。
后三个分数都报告整条误差分布,并用中位数比较模型,避免个别极大误差主导平均数。图注把箱体和须线分别写成 50% 与 95% 置信区间。
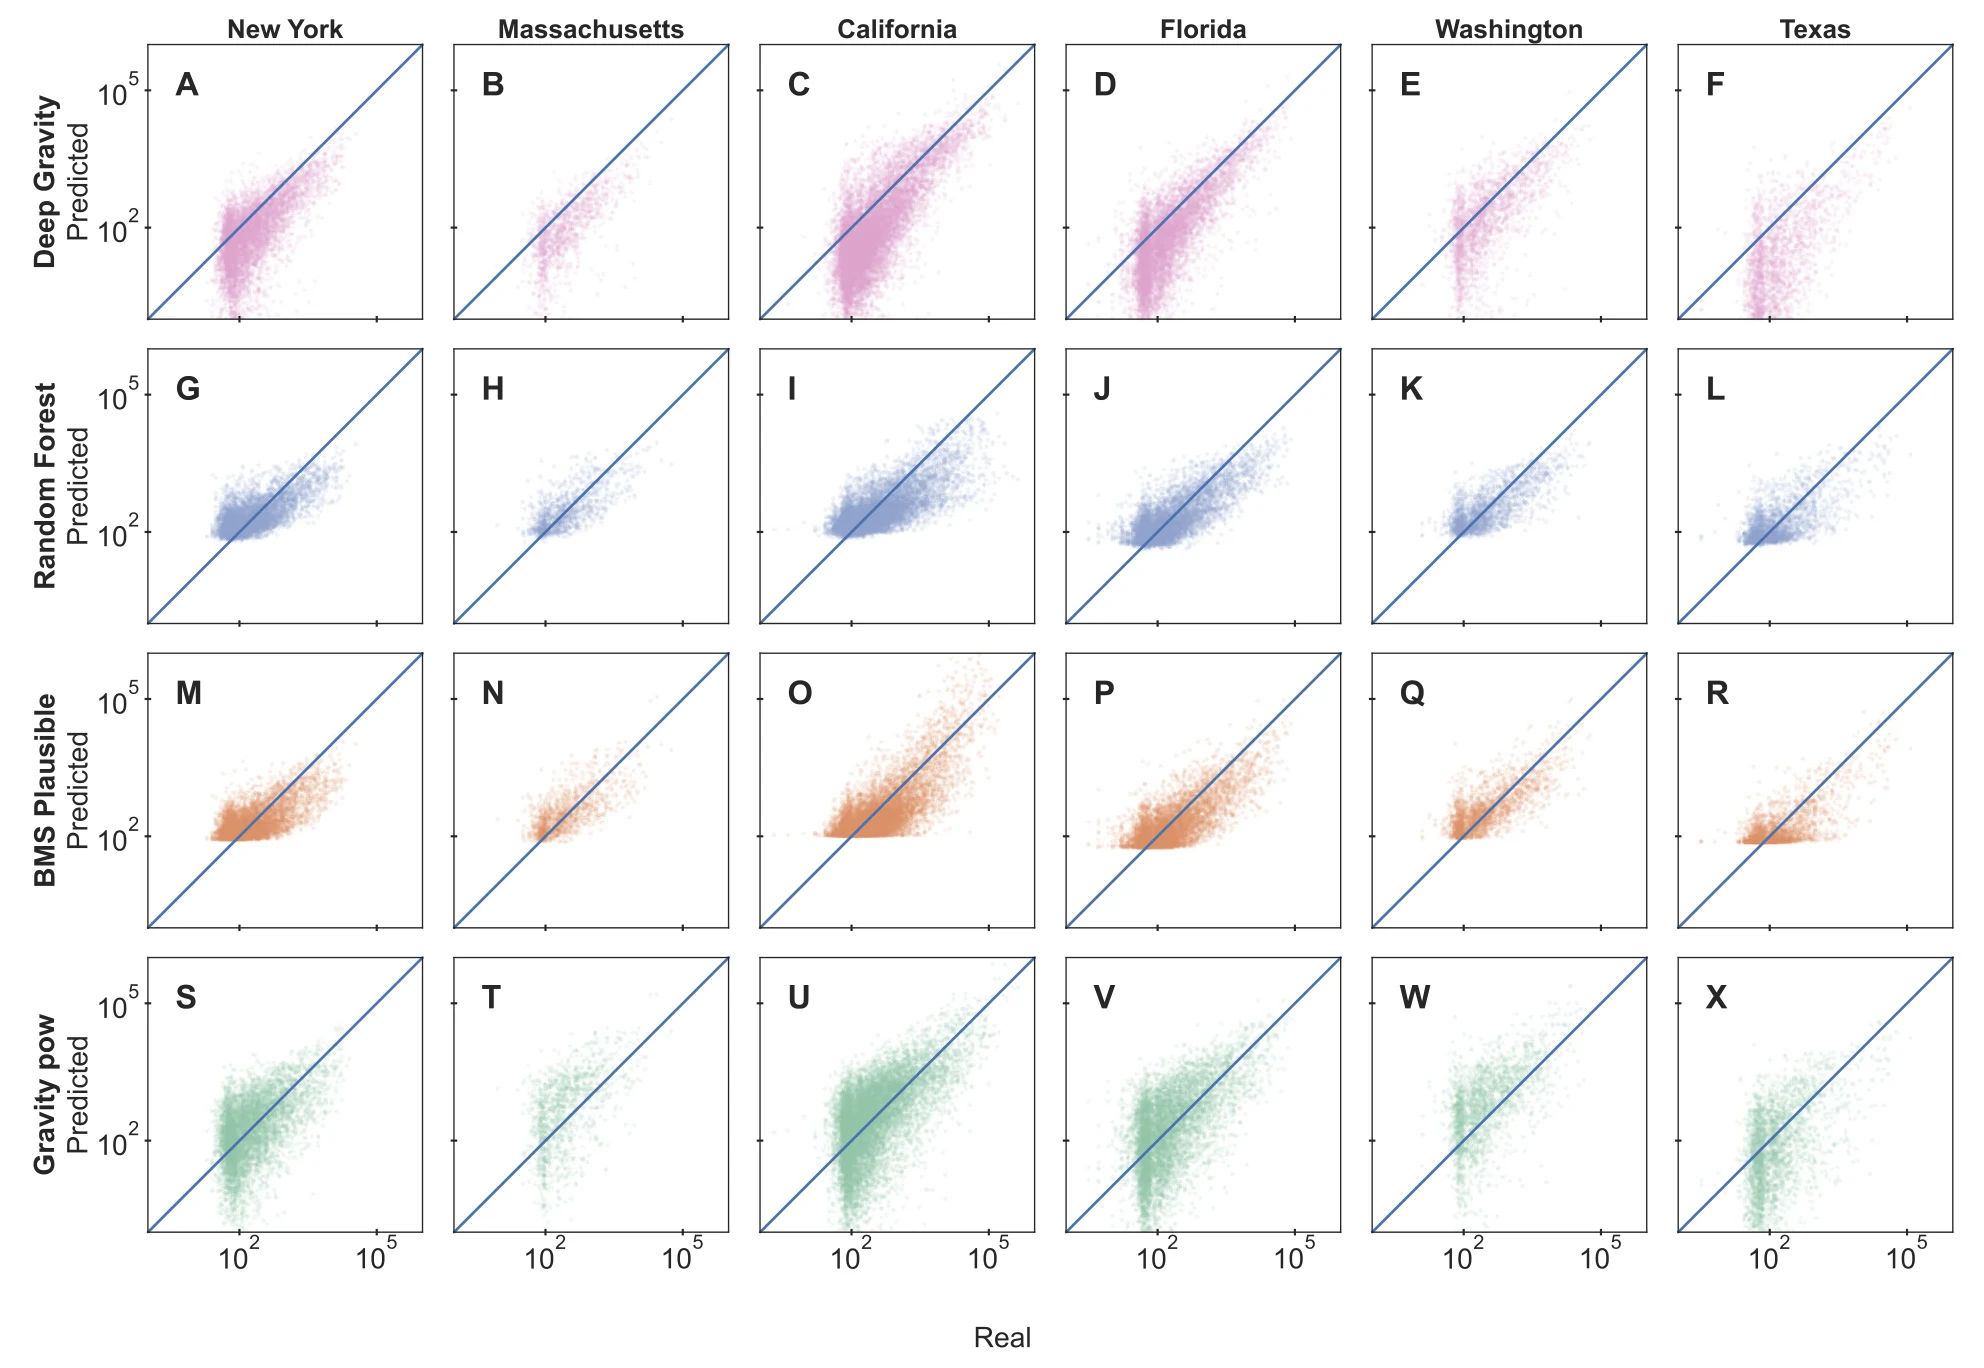
图 2|不同模型是不是只在某一段流量上贴住对角线?
横轴是测试集真实流量,纵轴是预测,都是对数坐标;蓝线是预测等于真实。六列从左到右为纽约、马萨诸塞、加利福尼亚、佛罗里达、华盛顿、得克萨斯。(A–F)深重力。(G–L)随机森林。(M–R)BMS 最可信模型。(S–X)幂律引力。同一列的字母是 A/G/M/S 纽约,B/H/N/T 马萨诸塞,C/I/O/U 加利福尼亚,D/J/P/V 佛罗里达,E/K/Q/W 华盛顿,F/L/R/X 得克萨斯。深重力和幂律引力在小流量一端落到对角线下方,随机森林和 BMS 最可信模型沿对角线的跨度更长。来源:原论文 Fig. 2。
对照模型分三组。引力模型写成 Tij = C × mi × mj / f(dij)。f 可以是距离的 α 次方,也可以是 exp(α × 距离);因为流量跨数量级,报告的引力结果都是在对数流量上拟合的。辐射模型把起点总流出 Ti 乘上前往 j 的概率,概率为 mi × mj / [(mi + sij)(mi + mj + sij)],其中 sij 是比 j 更靠近 i 的其他市镇人口之和。随机森林用 1000 棵树和全部 39 个特征。深重力沿用 Simini 等人的算法,改成预测市镇而不是小方格,特征、预处理和训练设置保持原模型。
正文的判断是:大约少于 100 人的流量上,引力类模型和深重力会低估,有时差几个数量级,甚至预测出小于 1 人的流量。随机森林和 BMS 没有这套系统性偏离。补充图 S1 和 S2 给出更多散点,本地正文没有逐点数字。
少特征的闭式模型,在六个训练州里站在哪里?
BMS 采样的是公式的后验,而不是单次最优拟合。描述长度越短,模型在“它就是生成数据的那个公式”这一意义上越可信。先验来自数学表达式语料里基本函数的出现频率,正文写明这个先验不偏好类引力公式。六个州共用一个公式,各州参数可以不同。搜索使用 5 条独立马尔可夫链,每条 12,000 步。预测用三种读法:描述长度最短的最可信模型;全体采样模型的平均,也就是在模型空间上积分的近似;以及预测最接近这个集合中位数的那一个公式,称为中位预测模型。方法部分用于集成预测的集合,是每条链最后 2,000 步里每 100 步取一个模型,5 条链合计 100 个。后文对类引力结构的人工分类使用 105 个采样模型。两处数目不同,正文没有说明是不是同一批样本。
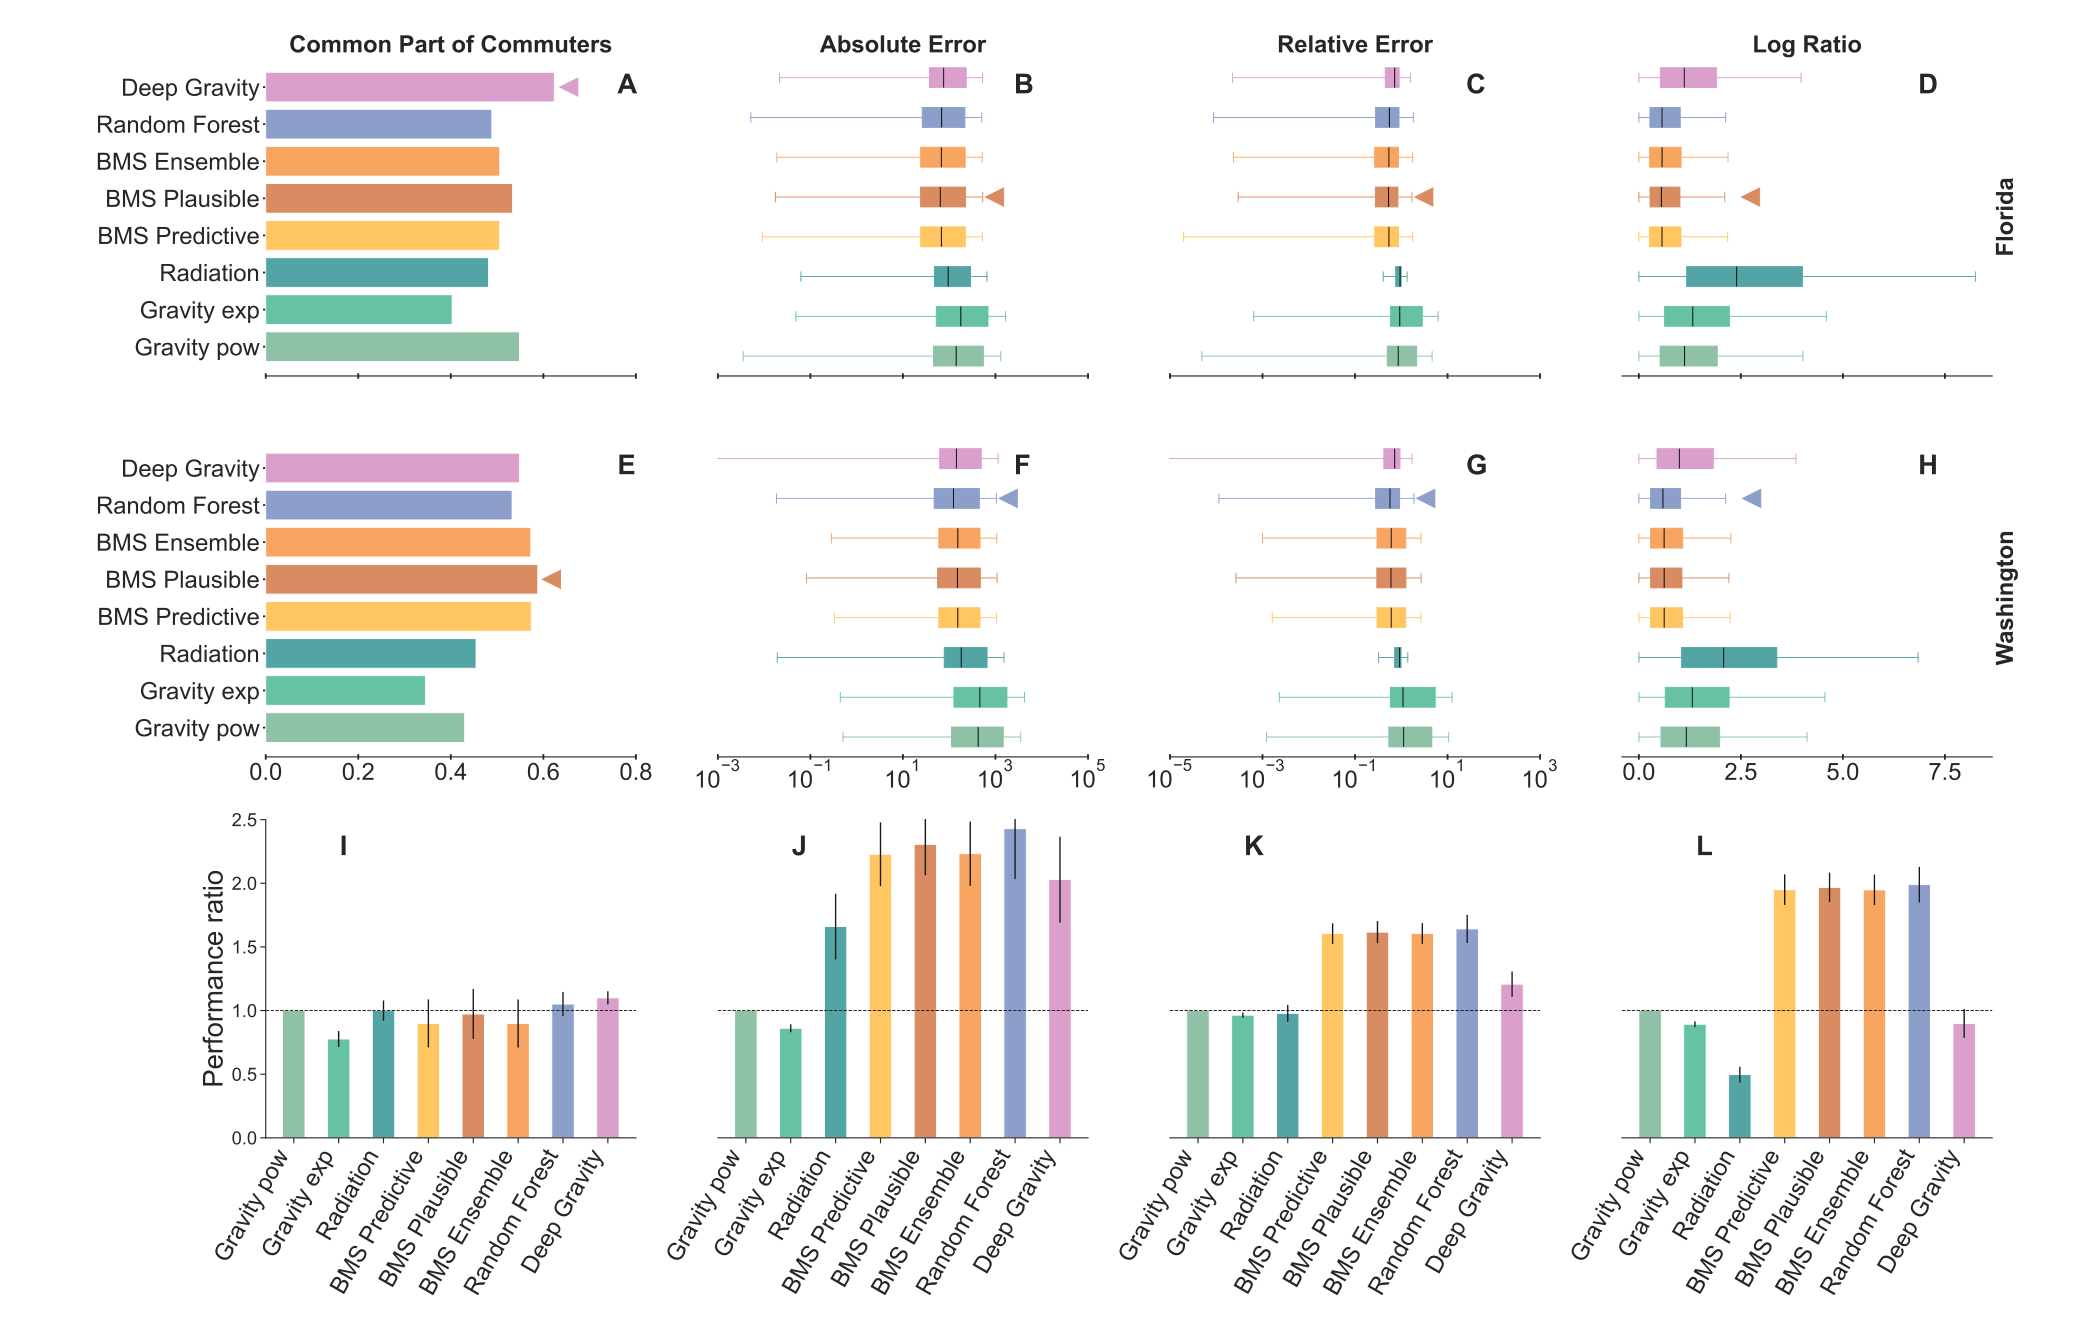
图 3|四项分数并排时,谁比幂律引力更好?
(A–D)佛罗里达,(E–H)华盛顿。每一行一个模型:深重力、随机森林、BMS 集合、BMS 最可信、BMS 中位预测、辐射、指数引力、幂律引力。A、E 是 CPC,越高越好,每个模型只有一个点。B、F 绝对误差,C、G 绝对相对误差,D、H 绝对对数比;箱体和须线按图注分别是 50% 与 95% 置信区间,三角标出该项最优。(I–L)六个训练州平均后的表现比,分母是幂律引力。大于 1 表示比幂律引力好,CPC 也按这个方向画。误差线是各州均值的 95% 置信区间。I 的 CPC 比都靠近 1;J–L 上 BMS 三组和随机森林明显高于 1,深重力在对数比上回到 1 附近或以下。来源:原论文 Fig. 3。
图上能直接看到的例子:佛罗里达 CPC 的三角在深重力,华盛顿 CPC 的三角在 BMS 最可信模型,华盛顿绝对误差的三角在随机森林。这只是两个州。全部 24 次比较是 4 项指标 × 6 个州,明细在补充图 S3 和补充表 S6。正文给出的汇总是:最可信 BMS 优于深重力 21/24,优于随机森林 13/24、劣于随机森林 11/24。六个州平均后,BMS 与随机森林在全部质量指标上无法区分;深重力只在 CPC 上表现最好,而且相对 BMS 和随机森林没有显著更好。相对误差和绝对对数比上,BMS 优于深重力。
引力模型和辐射模型在所有州、所有指标上都不是最好。这与它们形式很紧、以及深重力此前已经优于传统引力的结果一致。公平性用比例人口统计均等(proportional demographic parity)看误差在不同收入组之间是否同样分布。市镇按 2020 年人均收入中位数是否高于本州中位数分成高、低两组,流量因此有低到低、高到低、低到高、高到高四类。正文结论是随机森林和 BMS 在各州之间最一致;分组误差的数值在补充图 S5,正文没有列出具体 PDP。
流量只有几十人时,谁还估得准?
CPC 高,只说明大流量的重叠好。图4把六个州的流量放进同一批数量级区间,再在每个区间里重算四项分数。
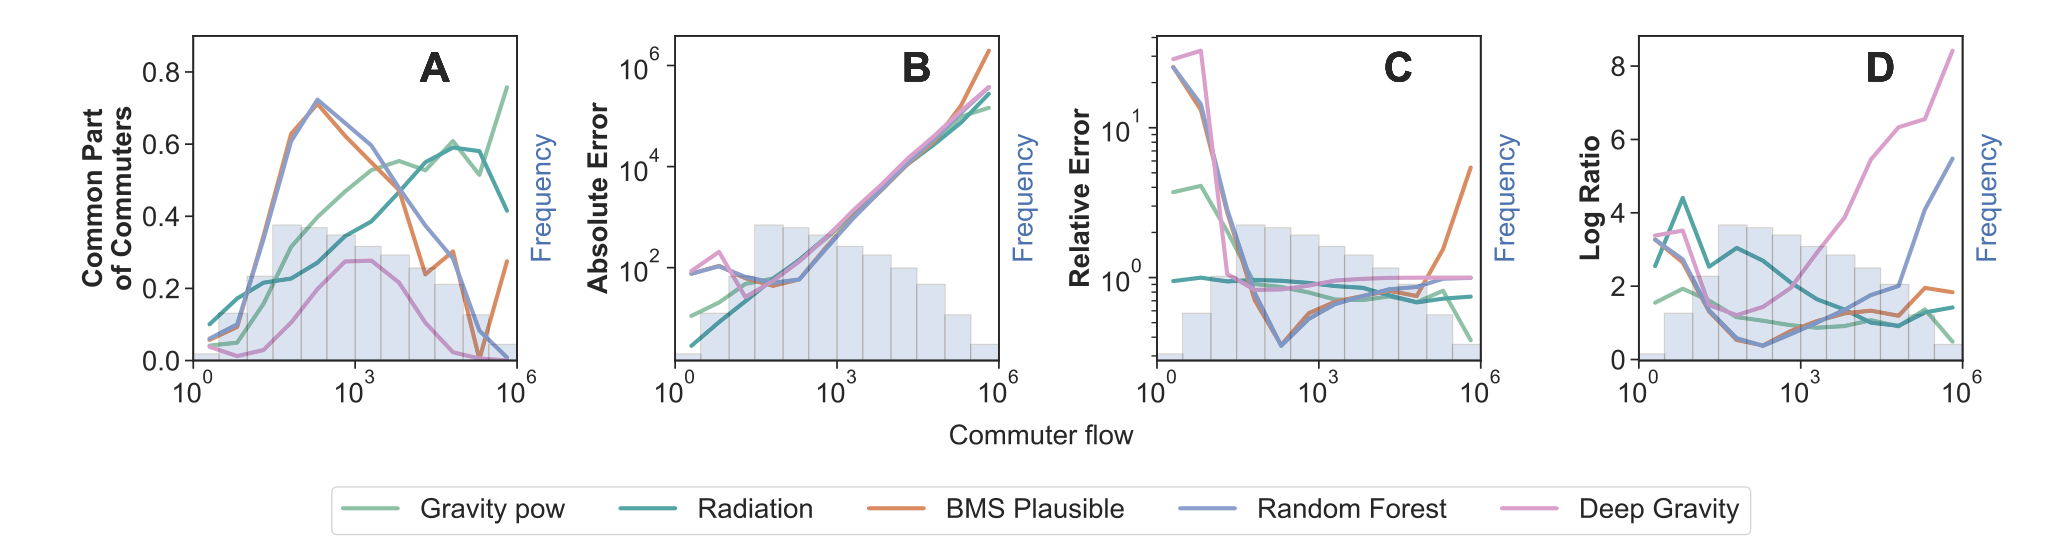
图 4|最常见的那一档流量,误差是不是也最低?
灰色直方图是六个州合在一起的流量频数,横轴为流量,从 10⁰ 到 10⁶。彩线是各模型在该档内的表现:绿为幂律引力,青为辐射,橙为 BMS 最可信,蓝为随机森林,粉为深重力。(A)该档 CPC,越高越好。(B)绝对误差。(C)相对误差。(D)绝对对数比;B–D 越低越好。直方图的高峰在大约 10² 到 10³ 人。随机森林和 BMS 最可信模型在这一常见档上 CPC 更高、误差更低;到 10⁶ 附近,多条误差曲线上升,幂律引力的 CPC 反而抬高。来源:原论文 Fig. 4。
所以“最常见流量估得准”和“最大流量的 CPC 最高”可以落在不同模型上。若决策关心的是小市镇之间几十人的联系,只按 CPC 选模型,会把系统性低估小流量的模型留在前面。
缩到 25 公里见方,人口和距离还够用吗?
市镇可以很大,短距离流动也许更依赖商店和道路。论文改用 Simini 等人深重力模型里的纽约州数据:把州分成 25 km × 25 km 的方格,方格内部看普查区之间的流量。50% 的方格用于训练,其余 50% 用于测试。
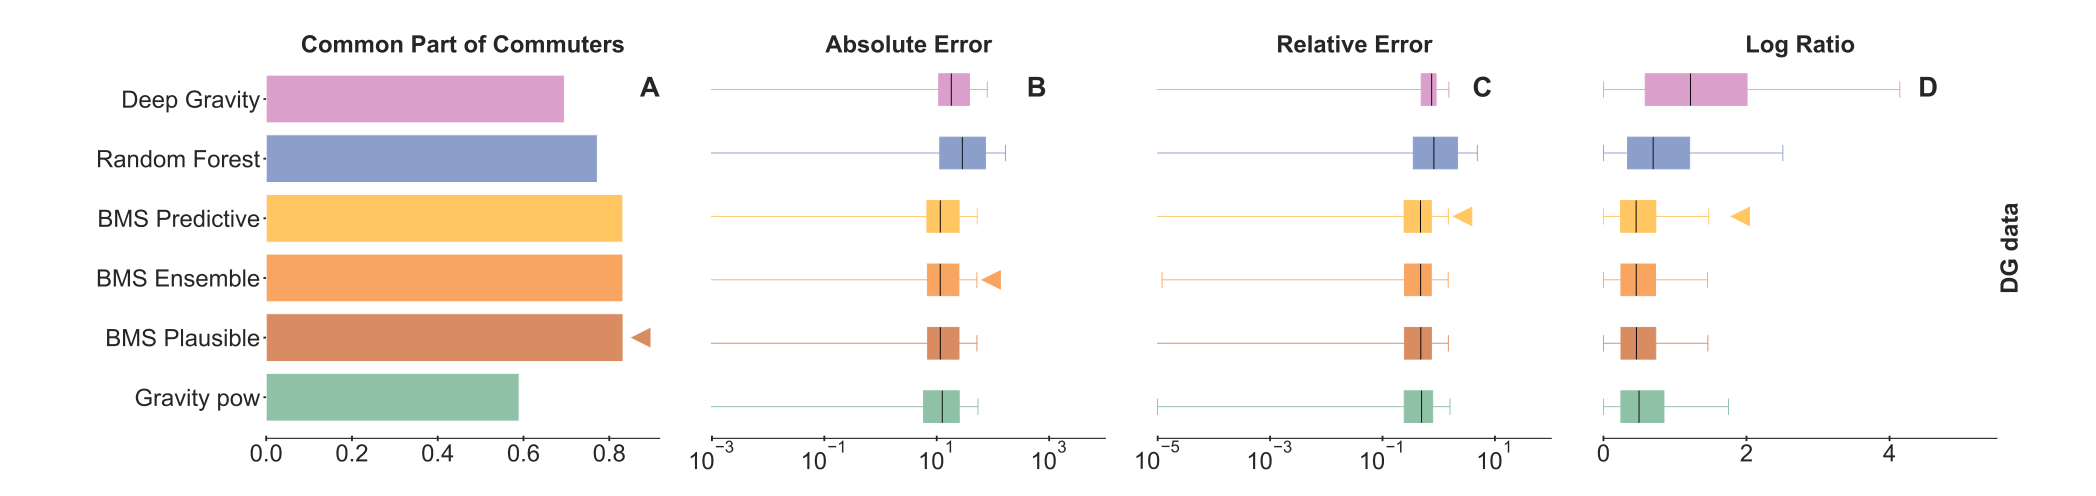
图 5|方格内的短距离流量,闭式模型还会落后吗?
右侧标注 DG data,即深重力论文的纽约方格数据。行从上到下为深重力、随机森林、BMS 中位预测、BMS 集合、BMS 最可信、幂律引力。(A)CPC。(B)绝对误差。(C)绝对相对误差。(D)绝对对数比。三角标出该项最优:A 在 BMS 最可信,B 在 BMS 集合,C 和 D 在 BMS 中位预测。四项最优都在 BMS 的某种输出上。来源:原论文 Fig. 5。
这里的一条记录是方格内的普查区对。在这套 25 km 方格里,只含人口和距离的闭式模型仍然更准。出行目的不在变量里。
搜出来的公式,和重力有多像?
许多公式都能描述同一批数据。这种情形常被叫作罗生门集合(Rashomon set):数据留出一整族都说得通的模型。有用的问题是它们共享什么结构。类引力项在这里的操作定义是:依赖于起点人口和终点人口的乘积,人口可以各自平移,并且随距离的某个增长函数而下降。在 105 个模型里,纯类引力约 17%,类引力再加其他乘项或加项约 70%,完全没有类引力项约 13%。
图6给出两个被单独拿出来的公式。读参数时以图上的式子和图注为准。图注把 A 定为最短描述长度模型,也就是最可信模型;把 B 定为中位预测模型。图1C 使用的就是图6B。
图6A 印出的是
log Tod = log( ( A × ( B × (md×mo + C×md + D) / d^α + 1 ) )^γ )
流量本身因此是那个括号的 γ 次方。图6B 印出的是
log Tod = A × ( 1 + B × ((md + C)×(mo + D))^β / d )^ξ
流量本身是这个右端的指数。起点和终点可以带不同的平移 C、D,所以两个方向的流量不必对称。传统引力把两端人口相乘,做不到这一点。正文说,看参数时纽约和得克萨斯比佛罗里达、马萨诸塞更对称。
正文另有一句把两种形式对调了:它写最可信模型是流量的指数形式、中位预测模型是流量的幂律形式,并把 1/β 放在图6A、把 α 放在图6B。图上的公式、图注,以及图6C 的图例,与这句不一致。图6C 的实心点是 α、空心方块是 1/β;图注又写实心点来自最可信模型、空心方块来自中位预测模型。按图注,α 属于图6A,1/β 属于图6B。
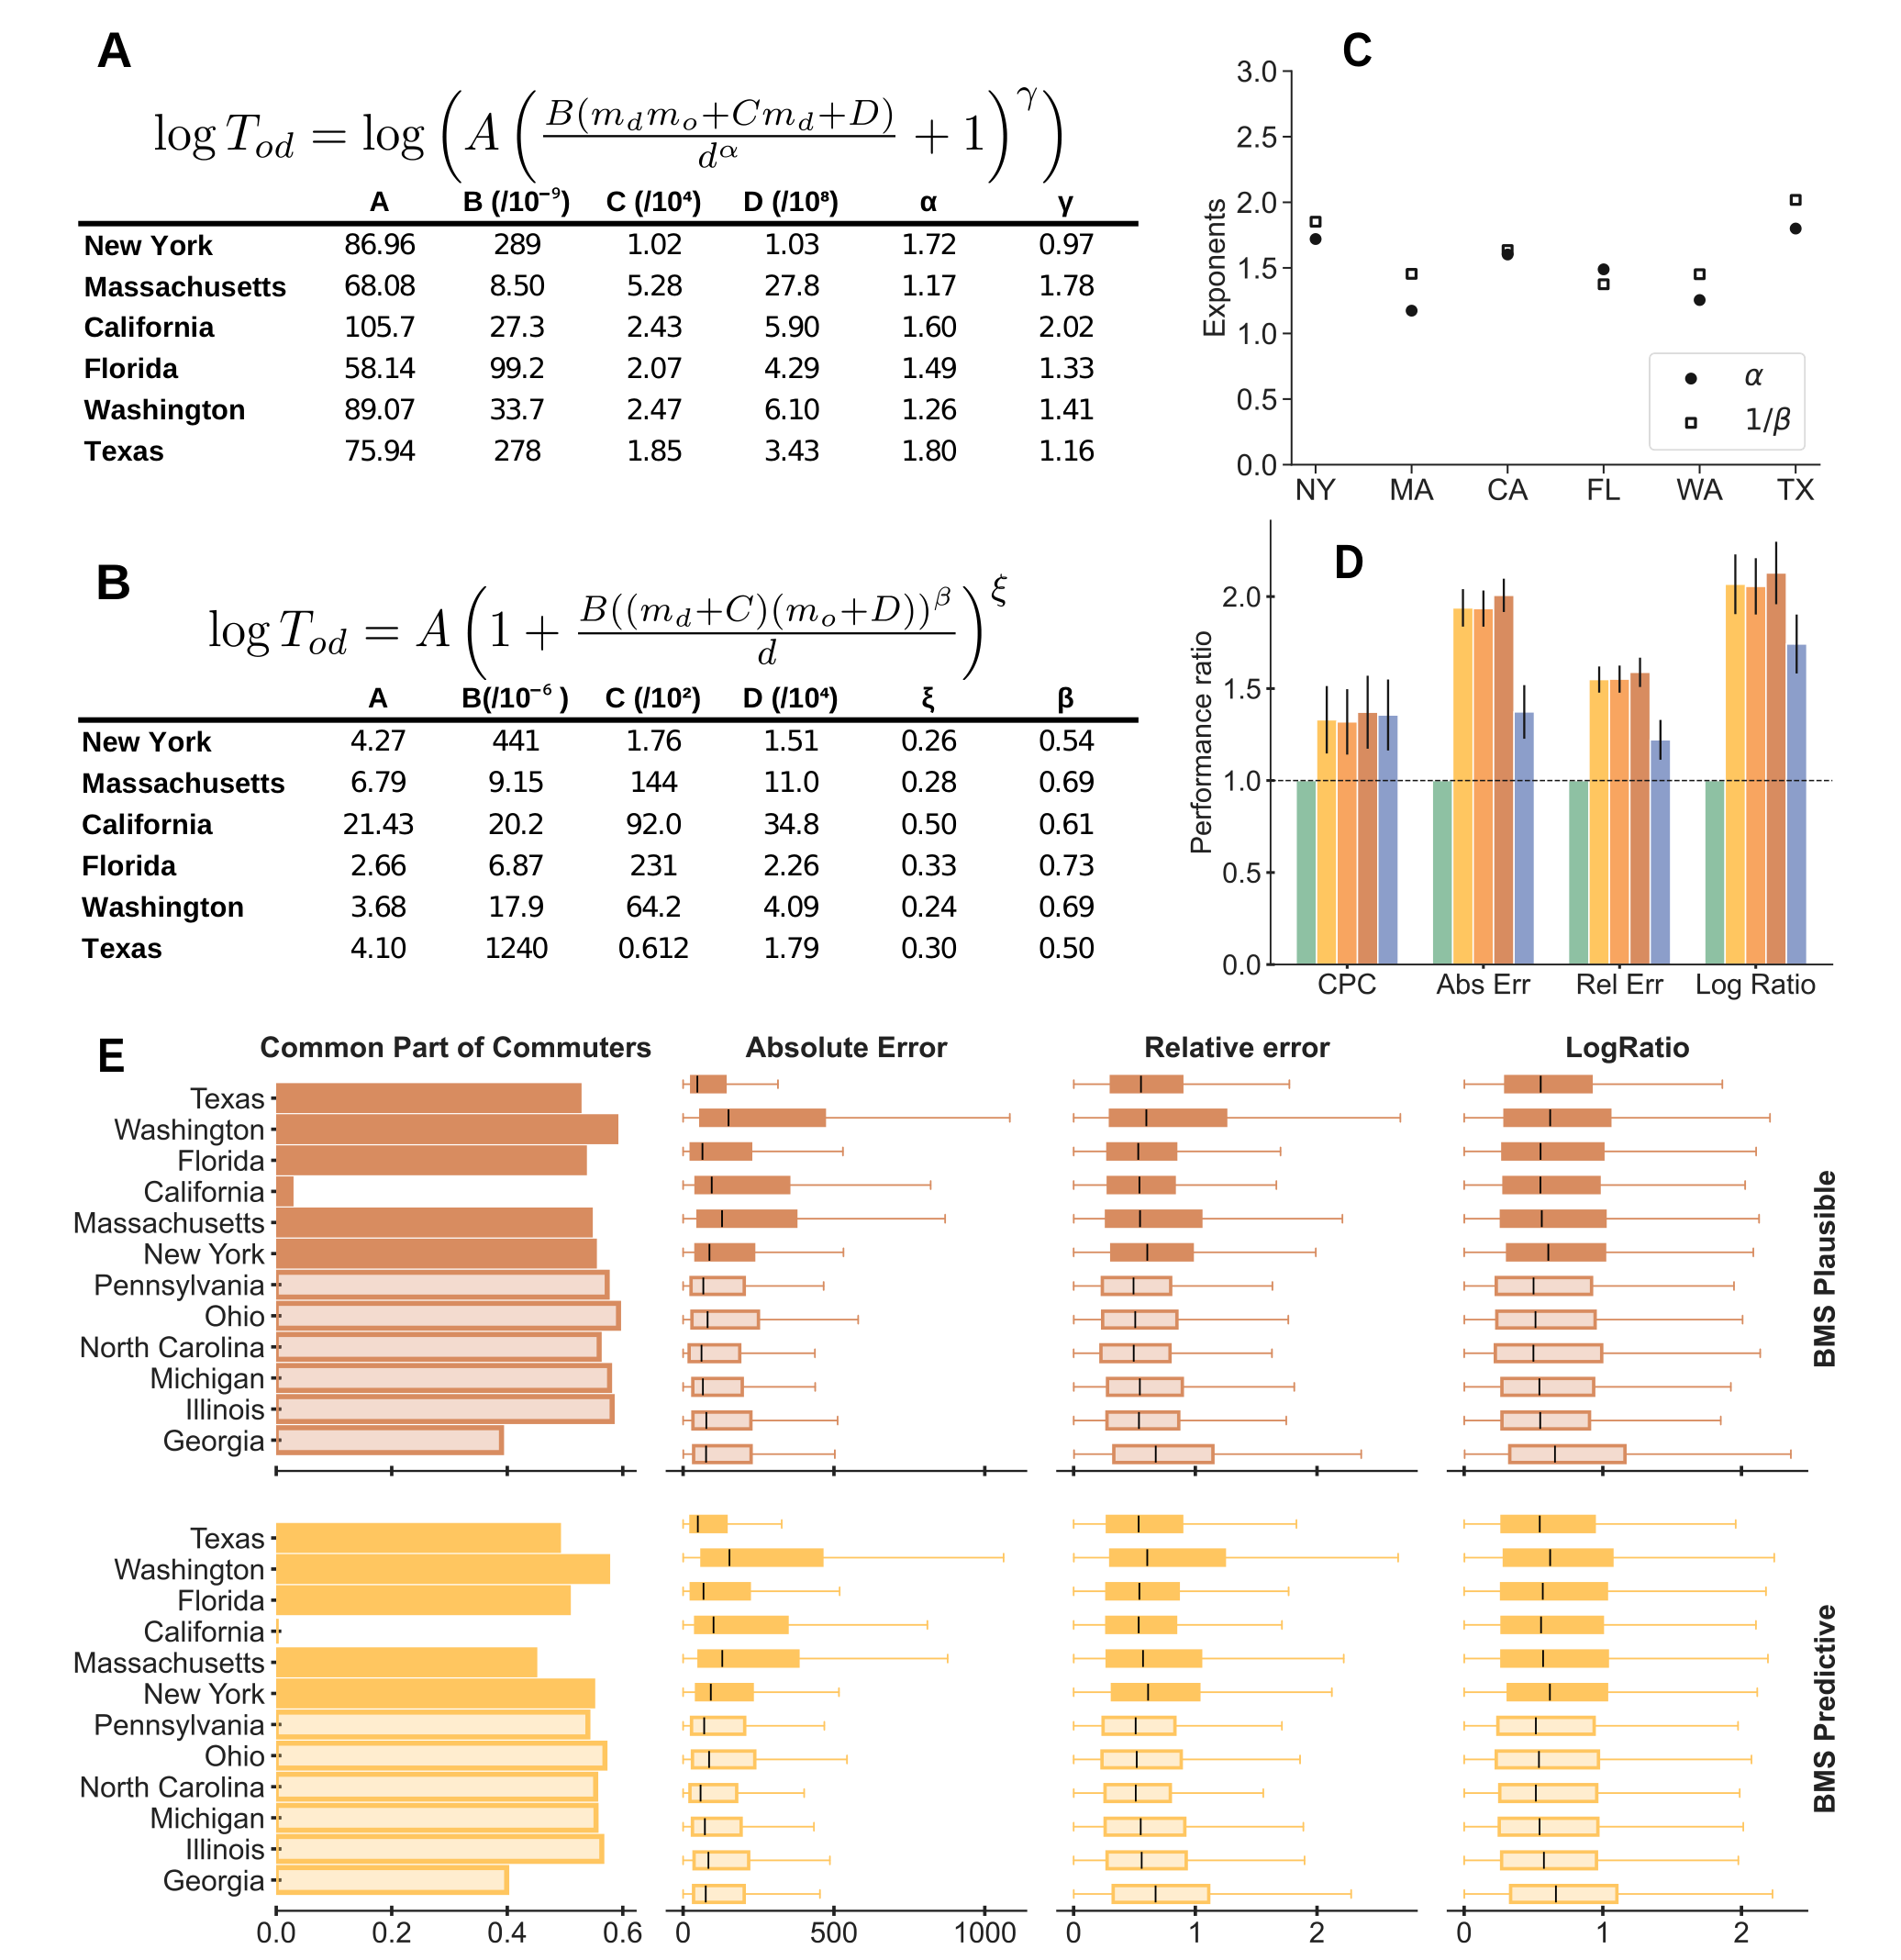
图 6|闭式公式长什么样,换州之后还保持吗?
(A)图注所称的最短描述长度模型,以及六州参数。B 列标题是除以 10⁻⁹,C 列除以 10⁴,D 列除以 10⁸;表中的 289 表示 B = 289×10⁻⁹。α 与 γ 是指数。(B)图注所称的中位预测模型。B 列除以 10⁻⁶,C 列除以 10²,D 列除以 10⁴。ξ 与 β 是指数。(C)纵轴是指数。实心点为 α,空心方块为 1/β,后者由(B)的 β 取倒数。(D)新六个州上、各州平均的表现比,分母仍是幂律引力,高于虚线 1 表示更好。绿柱落在 1 上;黄、橙、蓝与图3里 BMS 中位预测、BMS 最可信和随机森林的配色一致。误差线是州平均的 95% 置信区间。(E)上块为 BMS 最可信,下块为 BMS 中位预测。每块上面六个州是训练州,下面六个是新州;图注说明实心对应训练州、空心对应新州。四列依次是 CPC、绝对误差、相对误差、绝对对数比。来源:原论文 Fig. 6。
按图6A,六个州的 α 是:纽约 1.72,马萨诸塞 1.17,加利福尼亚 1.60,佛罗里达 1.49,华盛顿 1.26,得克萨斯 1.80。按图6B 的 β 取倒数,1/β 是:纽约 1.85,马萨诸塞 1.45,加利福尼亚 1.64,佛罗里达 1.37,华盛顿 1.45,得克萨斯 2.00。同一州的两个数最接近的是加利福尼亚,相差约 0.04;相差最大的是马萨诸塞,1.17 对 1.45。全部落在大约 1.17 到 2.00。正文把这种州际差别称为相对较小,并认为合理的流量模型是类引力,而且人口乘积项和距离项的相对贡献受到约束。α 接近 1/β,说的是两个不同公式里的指数彼此接近,不是同一公式里的自由参数互相推出。
外推时,公式保持不变,只用新州自己的训练市镇重新拟合参数,再在新州的测试市镇上计分。图6E 显示新州与训练州的水平相近。图6D 上,正文写 BMS 在四项指标的三项显著优于随机森林,第四项无法区分;图注的说法更宽,写成显著优于其他所有算法中的三项。随机森林没有可单独重拟合的参数,新州的预测是原来六个随机森林预测的平均。正文还说,BMS 若也不重拟合、同样对六个旧模型取平均,在新州仍然显著更准;那一张比较是补充图 S7。
商店和道路加进去之后,还是同一类公式吗?
若非人口特征通常能提高预测,为什么三个变量已经够用?图7先看相关。
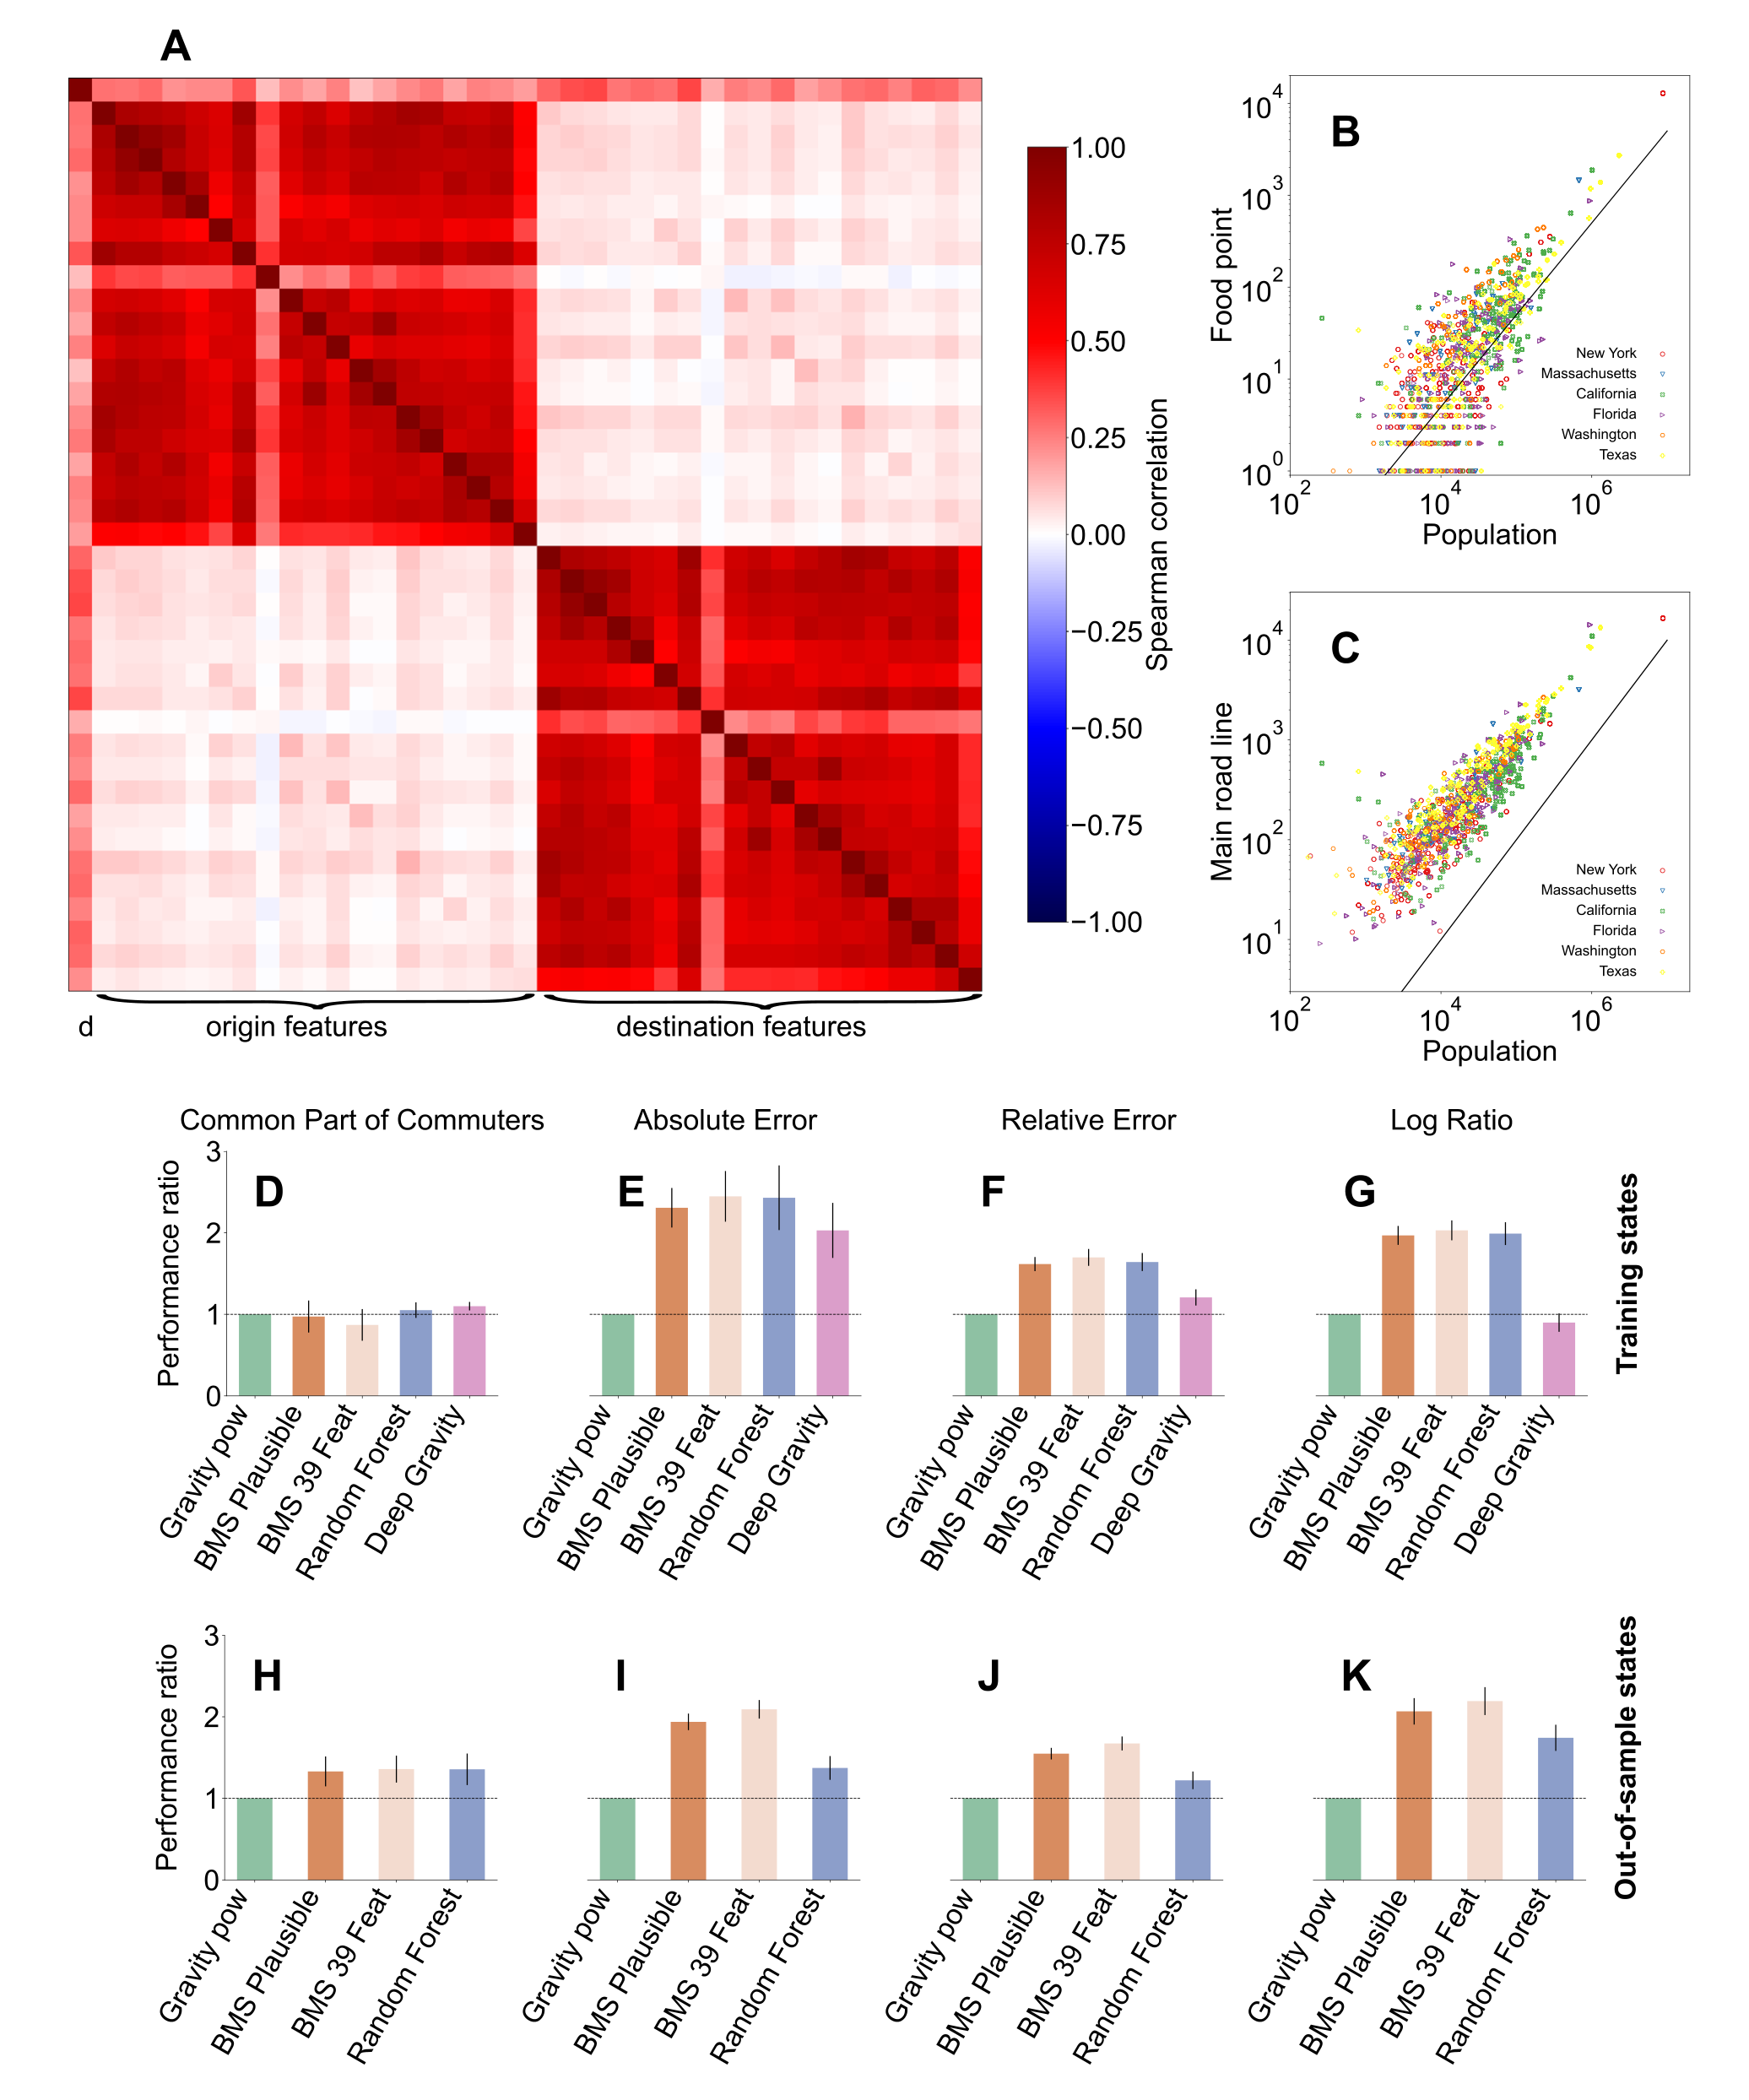
图 7|多出来的特征是新信息,还是人口的另一种写法?
(A)训练六州全部市镇对上,特征两两的斯皮尔曼秩相关。色标从 −1 到 1。横轴分组为距离 d、起点特征、终点特征;起点和终点各自内部多为深红色高相关。(B)终点人口对终点餐饮点数量,(C)终点人口对终点主干道长度。坐标为对数。直线是示意用的线性参照,图注写明它不是拟合。六色对应六个训练州。(D–G)训练州相对幂律引力的表现比,误差线为州平均的 95% 置信区间。D 为 CPC,E 绝对误差,F 相对误差,G 绝对对数比。模型依次为幂律引力、BMS 最可信、BMS 39 特征、随机森林、深重力。(H–K)新六个州的同样四项;这里没有深重力,依次为幂律引力、BMS 最可信、BMS 39 特征、随机森林。来源:原论文 Fig. 7。
相关高,解释了为什么人口和距离单独已经很能预测:餐饮点和道路长度在市镇尺度上大体跟着人口走。把 39 个特征都送进 BMS 后,大多数特征很少出现在采样公式里。反复出现的是终点餐饮点 Fd、起点与终点主干道长度 Mo 和 Md;最可信公式里还有起点零售点 Ro。式子是
log Tod = [ c1 + c2 × (c3 + c2×Fd + Md) × (c4 + Mo + Ro) × exp(c5 的 Ro 次方) / d^α ]^γ
终点因子是餐饮点和终点道路,起点因子是起点道路、零售点以及零售点上的指数。中间仍是两端因子相乘,再除以距离的 α 次方。正文把训练州结果写成图7C–F、新州写成图7G–J;图面和图注是 D–G 与 H–K,字母差一格。无论按哪一种编号,结论相同:39 特征的最可信模型常常略好于只含人口的最可信模型,差别没有统计显著性。新州也是如此。
这些结果能用到哪一步
BMS 在“数据真由一个闭式公式生成”时,渐近上会找到那个公式,并且对未观测数据的预测接近最优。本文的流量是否真由某一个闭式公式生成,搜索本身不能证明。100 到 105 个高分公式同时存在,说明眼下的数据留出了一族模型。类引力反复出现,支持的是这一族的共同形状,不是其中某一个参数表就是行为机制。
数据是位置应用上的设备,再推回人口流量。它覆盖多种交通方式,也漏掉没有进入这些应用的人。两个星期都在 2019 年初。市镇对只保留非零流量,模型没有接受“结构上的零流量”这一任务。收入公平性只按州内人均收入中位数分成高低两组,分组误差的具体数字在补充图里。
讨论部分把聚合流量写成大量个体移动抵消之后显现的性质,并认为它在所研究的数据集里接近普适。这个判断的直接证据是:六个训练州共用公式、六个新州能重拟合参数、纽约短距离方格上三个变量仍然够用、指数落在大约 1.2 到 2 的范围。它还没有在这些州以外的国家、年份和出行目的上检验。个人路线、出行目的和人口统计特征,正文认为在更小尺度上可能需要更复杂的模型;25 km 方格的结果只说明,加进很多兴趣点特征并没有在那套数据上提高预测。
一句话总结
在美国市镇之间的非零周流量上,自动搜出的短公式仍然是类引力的;只用人口和距离,就能在多数误差比较里追上 39 个特征的模型,并在六个新州上更好地外推。
核心来源
- Nature Communications 正式页面,核对题目、作者、发表日期与正文图1–7、表1–2。
- 流量原始数据为 Kang 等,Scientific Data,2020,论文参考文献 26;处理数据和深重力改写代码见 Zenodo:10.5281/zenodo.14501438。
- 贝叶斯机器科学家的方法来自 Guimerà 等,Science Advances,2020,6:eaav6971,即本文参考文献 16。深重力对照来自 Simini 等,Nature Communications,2021,12:6576。
作者介绍
机构与分工以论文署名和作者贡献说明为准。可核的研究方向只取本文引用过的工作。
- Oriol Cabanas-Tirapu:署名罗维拉-威尔吉利大学化学工程系。贡献说明中负责收集数据,并与 Danús 一起写代码、做实验;同时参与设计、分析结果和写作。致谢中的 FPI 项目编号为 PRE2020-095552。
- Lluís Danús:署名罗维拉-威尔吉利大学化学工程系,以及宾夕法尼亚大学安嫩伯格传播学院。参与写代码、做实验、设计、分析结果和写作。
- Esteban Moro:署名麻省理工学院媒体实验室,以及东北大学网络科学研究所。参与设计、分析结果和写作。本文引用了他与合作者关于美国大城市移动模式和收入隔离体验的 Nature Communications 2021 年论文。
- Marta Sales-Pardo:署名罗维拉-威尔吉利大学化学工程系,通讯作者。参与设计、分析结果和写作。本文引用的贝叶斯机器科学家论文和 2020 年 Physical Review Letters 中的多数据集比较,都有她参与。
- Roger Guimerà:署名罗维拉-威尔吉利大学化学工程系和巴塞罗那 ICREA,通讯作者。参与设计、分析结果和写作。贝叶斯机器科学家方法论文以他为主要作者之一;本文也引用了他 2005 年关于全球航空网络的 PNAS 论文。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个规划模型在市镇尺度上同时放入人口、餐饮点和道路长度,图7的高相关意味着后两项很可能是人口的另一种计数。要检验“增加餐饮点是否真的带来流量”,需要找人口几乎不变、餐饮点或道路单独变化的时期或地点,再看只含人口的公式是否开始落后。25 km 方格已经提示,把很多兴趣点加进模型,预测增益有限;那种比较仍然是横截面拟合,还没有这种前后变化。
另一处会改变模型选择的,是分数和流量档。CPC 的分子分母由全部流量之和构成,大流量决定名次;绝对对数比对“估成 2 倍”和“估成一半”一视同仁。若要安排的是小市镇之间几十人的班次,图4里常见档和低流量档的对数比,比全州 CPC 更接近这个任务。六个州的 α 从马萨诸塞的 1.17 到得克萨斯的 1.80,直接把一州的距离指数挪到另一州,会改写远距离流量被压低的程度。论文的做法是保留公式、重拟合参数;延伸的问题是,参数至少要按多大的区域分开估,州是不是合适的一档。